Een scène met twee personen wordt overtuigend wanneer je kunt zien en horen wie welke regel heeft. Om dialoog met meerdere sprekers in Gemini Omni 1.2 Flash gemakkelijk te volgen te maken, geef je elk personage een vaste visuele en vocale identiteit, schrijf je korte regels in spreekvolgorde en beoordeel je de voltooide video met je ogen en oren. De update van Google uit november 2026 ondersteunt natuurlijkere meerstemmige spraak en clips tot 15 seconden, maar een prompt kan niet garanderen dat sprekers bij de eerste render correct worden toegewezen. Begin met een eenvoudige uitwisseling tussen 2 personen en voeg pas een derde beurt of straatambiance toe nadat je de basisoverdracht kunt beoordelen.
Belangrijkste punten
- Gemini Omni 1.2 Flash genereert video met native geluid, inclusief dialoog; dit verschilt van Gemini tekst-naar-spraakmodellen die alleen audio produceren.
- Gebruik benoemde sprekers, exact geciteerde regels, duidelijke posities en een stille luisteraar voor elke beurt.
- Laat ruimte voor pauzes binnen het maximum van 15 seconden en controleer daarna elke regel tegen de clip.
- Prijs een render op basis van de gekozen duur en resolutie, niet op basis van het laagste geadverteerde tarief van een platform.
Wat betekent dialoog met meerdere sprekers in Gemini Omni 1.2 Flash?
Het model maakt een korte scène waarin mensen kunnen spreken als onderdeel van de gegenereerde audio en video. De praktische test is of een kijker kan zien wie elke regel zegt zonder een transcript te lezen. De woorden, stem, zichtbare persoon en mondbeweging moeten op hetzelfde moment overeenkomen. Een clip kan overtuigend lijken met het geluid uitgeschakeld en toch voor die test zakken.
Google kondigde Gemini Omni 1.2 Flash aan op 5 november 2026, met tot 15 seconden gegenereerde of bewerkte video. Het beschrijft vloeiendere dialoog, duidelijkere lip-sync en onderscheidende conditionering voor meerdere sprekers. Dat zijn capaciteitsclaims, geen belofte dat elk script exact wordt uitgevoerd zoals geschreven (de aankondiging van Google uit november 2026).
De gepubliceerde demonstratie van Google toont de capaciteit die werd aangekondigd. Deze staat los van de drie meegeleverde videocases hieronder.
Wat is er veranderd ten opzichte van Gemini Omni 1.1 Flash?
De officiële vergelijking geeft 1.2 een hoger plafond: 15 seconden in plaats van 10. Ook worden verbeteringen genoemd in spraak, lip-sync, het volgen van referenties en conversationele bewerking. De extra 5 seconden maken een uitwisseling van 3 beurten plausibeler om te scripten, maar een langere duur creëert niet meer spreektijd als een regisseur ook pauzes, fysieke reacties en scènewisselingen vraagt.
De veiligste lezing is richtinggevend. Betere conditionering kan dialoog gemakkelijker regisseerbaar maken, maar elke geleverde clip moet nog steeds worden geïnspecteerd. Een maker kan de limiet van 15 seconden gebruiken om een scriptdoel te stellen. Een producent die exacte juridische tekst of een precieze stemmatch belooft, moet gegenereerde output als concept behandelen totdat deze de review doorstaat.
Videodialoog vs. tekst-naar-spraak met meerdere sprekers
Gemini tekst-naar-spraakmodellen accepteren tekst en retourneren audio. Hun sprekerinstellingen en stemkeuzes horen bij die audioworkflow, die Google apart documenteert (de Gemini tekst-naar-spraakdocumentatie van Google, geraadpleegd november 2026). De tekst-naar-videoroute van Gemini Omni 1.2 Flash accepteert een scèneprompt en produceert video met native geluid. Een speech_config-voorbeeld voor tekst-naar-spraak is geen videobesturing voor Gemini Omni 1.2 Flash. Deze voorbeelden beschrijven vocaal karakter in tekst; ze claimen niet een opgenomen stem te uploaden, klonen of selecteren. Als een briefing de stem van een specifieke acteur vereist, verifieer dan die toegang en toestemming apart voordat je de opname plant.
Als je oplevering een podcastgesprek of een definitieve voice-over is, gebruik dan tekst-naar-spraak en monteer het beeld rond die audio. Als het twee mensen zijn die zichtbaar spreken in een gegenereerde scène, gebruik dan Gemini Omni 1.2 Flash-video en test de uitlijning in de daadwerkelijke output.
Waar kun je het uitvoeren, en wat kost een clip?
Kies de tekst-naar-videoroute
Google vermeldt Gemini Omni 1.2 Flash in zijn creatieve en developerproducten. Gebruik voor een reproduceerbare test één route: Atlas Cloud biedt het model, en de Gemini Omni 1.2 Flash Text-to-Video-playground is waar je de onderstaande prompts plakt. De route-ID is google/gemini-omni-1.2-flash/text-to-video. De onderstaande prompts gebruiken alleen tekst, zonder afbeeldings-, bewegings- of stemreferenties.
De prompts vragen 12 seconden in 16:9 voor het kantoor, 15 seconden in 16:9 voor het café en 12 seconden in 16:9 voor het straatinterview. De drie meegeleverde bestanden zijn 720p. Controleer de live-instellingen en geselecteerde waarden voordat je op Run drukt. Een instelling die op een productpagina wordt geadverteerd, is geen bewijs dat een specifieke testrun deze heeft geaccepteerd. Sla de geselecteerde waarden en de prijsopgave op bij elke output. Zo wordt elke render nuttig bewijs: je kunt de prompt vergelijken met de gekozen resolutie en route bij het beoordelen van de output. Deze gids specificeert de tekst-naar-videoroute, dus een resultaat van een beeld-naar-video- of referentie-naar-videoroute moet apart worden geïdentificeerd.
De meegeleverde videobestanden bevatten geen voltooide playground-opname, geselecteerde instellingen of een prijsopgave vóór verzending. Hun route en configuratie blijven daarom ongeverifieerd.
| Route | Input voor deze gids | Beste keuze | Waar kosten te verifiëren |
|---|---|---|---|
| Creatieve producten van Google | Een scèneprompt; instellingen verschillen per product | Handmatige creatie in de editor van Google | Het huidige abonnement of creditscherm |
| Google API | Een videoaanvraag voor developers | Applicatie-integratie | De prijs van Google voor de exacte resolutie |
| Atlas Cloud tekst-naar-video | Prompt, duur, beeldverhouding, resolutie | Deze tekst-only tests in één playground herhalen | De prijsopgave vóór verzending van de gekozen configuratie |
Controleer de prijs voordat je rendert
Google noemt $0.07 per gegenereerde seconde voor 720p via zijn API, 30% onder Gemini Omni 1.1 Flash. Tegen dat opgegeven tarief kost 12 seconden 720p $0.84 vóór eventueel ander factureerbaar werk. Die berekening is geen Atlas Cloud-prijsopgave voor de meegeleverde bestanden; hun route en facturering zijn ongeverifieerd. Credits in Flow of een andere editor volgen de eigen regels van dat product.
Atlas Cloud vermeldt een lager aanvangstarief per seconde in zijn modelcatalogus, maar het minimum kan overeenkomen met een andere resolutie of configuratie. Lees de live-prijsopgave na het kiezen van duur en resolutie. Een 360p-concept kan helpen om een prompt te verkennen; het is een aparte generatie en geen frame-voor-frame preview van een latere 1080p-render.
Twee stemmen in een scène van 15 seconden passen
Geef elke spreker een visuele en vocale identiteit
Schrijf beschrijvingen die een reviewer kan verifiëren. "Spreker A staat links in een donkerblauw shirt" is duidelijker dan "de eerste collega". Voeg een hoorbaar onderscheid toe, zoals een middelhoge stem versus een lagere. Houd namen, kleding, positie en stemmen consistent in de hele prompt. Deze ankers maken een verwisselde regel gemakkelijker te herkennen.
Visuele identiteit is belangrijk omdat audio alleen een reviewer kan misleiden. Als de stemmen verschillen maar de verkeerde mond beweegt, heeft de clip een lip-syncprobleem. Als de juiste mond beweegt maar A's stem verandert bij A's tweede beurt, is er sprake van stemdrift. Het café-voorbeeld laat A terugkomen na B, zodat een reviewer kan controleren of A's stem consistent blijft.
Begroot tijd voor spraak en reactie
Lees het script hardop voor in het beoogde tempo. Voeg een natuurlijke pauze toe bij elke overdracht en laat daarna ruimte voor een luisteraar om te reageren en voor het beginshot om beide gezichten te introduceren. Het herziene kantoorscript heeft 5 beurten in 12 seconden. Het café heeft 8 korte beurten in 15 seconden, waardoor dit de meest veeleisende timingtest hier is. Dit zijn voorbeeldscripts, geen universele woorden-per-seconde-drempel of een belofte over de output.
| Scènebudget | Gesproken volgorde | Benodigde tijd naast woorden |
|---|---|---|
| 12-seconden kantoor | A-B-A-B-A | Beide personen introduceren en 4 overdrachten passen |
| 15-seconden café | Acht afwisselende beurten | Zeven overdrachten met weinig speling |
| 12-seconden straat | A-B-A-B-A | Vier overdrachten over straatambiance |
Een lange regel nodigt uit tot haasten of weglaten aan het einde. Als het concept bijna alle 15 seconden nodig heeft om hardop te worden gelezen, verkort het dan vóór generatie. Als het scenario meer dialoog nodig heeft, plan dan afzonderlijke shots en verifieer continuïteit als een aparte productietaak. Houd gezichten zichtbaar tijdens gesproken regels bij de eerste poging. Snelle cuts en verborgen monden maken het moeilijker om sprekerstoewijzing te beoordelen. Doe een getimede table read met twee personen als de volgorde van de regels belangrijk is. Laat één persoon A spreken en de ander B, terwijl een derde persoon noteert waar elke zin eindigt. Als het laatste woord op de cliplimiet valt, verwijder dan een zinsdeel of een reactiemoment vóór het renderen. Een korter script is gemakkelijker te controleren, omdat de reviewer de hele uitwisseling kan terugspelen zonder te hoeven raden of een regel bedoeld was buiten beeld door te gaan.
Hoe je een prompt schrijft voor Gemini Omni 1.2 Flash met 2 sprekers
Een bruikbare prompt leest als een compacte opnamebriefing: setting en camera, identiteiten, exacte dialoog en daarna geluids- en uitsluitingsregels. Deze volgorde geeft een reviewer ook een checklist. Het is een promptingmethode, geen gedocumenteerde garantie op controle. Houd de personagelabels identiek van de identiteitsparagraaf tot het dialoogblok. Vermijd dat je naar dezelfde persoon zowel als A als “de klant” verwijst in instructies over een latere beurt, tenzij de toewijzing al expliciet is. Een lezer moet twee kolommen kunnen tekenen, één voor elke persoon, en elke gevraagde actie en gesproken regel in precies één kolom kunnen plaatsen.
Gebruik expliciete sprekerlabels en geciteerde regels
Gebruik één regel per beurt met Speaker A: of Speaker B: en geciteerde woorden. Geef aan wie stil blijft. Vragen om "een discussie over lanceringsgereedheid" laat improvisatie toe. Een exact script laat je een ontbrekend of herschreven woord onmiddellijk markeren.
Hier is de eerste prompt om te kopiëren. Deze houdt beide volwassenen in één continu shot, zodat de kijker elke mond kan inspecteren.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
Meegeleverde 12-seconden, 720p kantoorrender. Beide personen blijven zichtbaar; de vijf gesproken regels en lip-sync vereisen nog steeds een luisterreview.
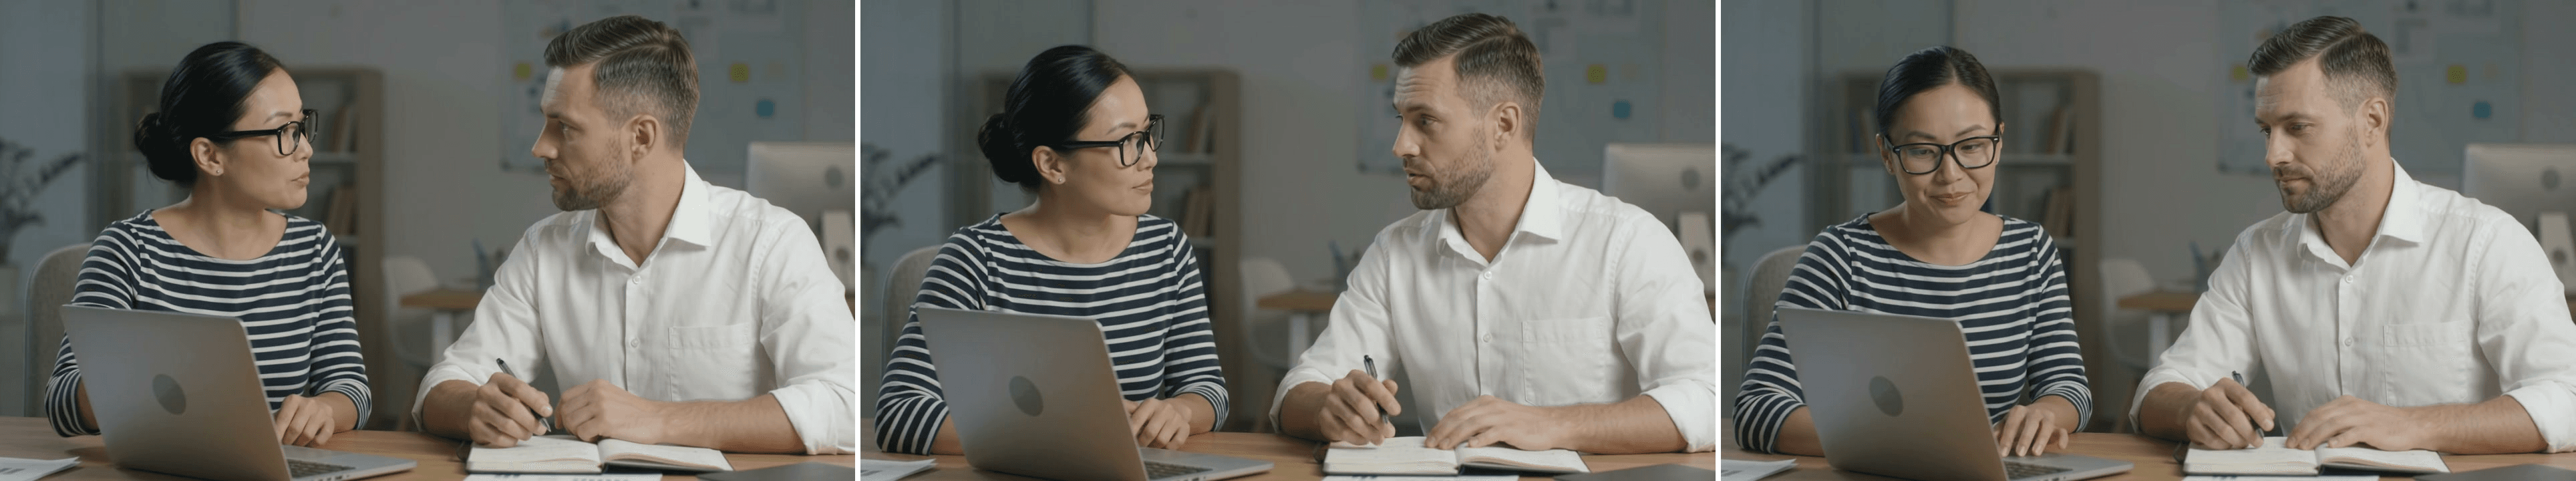 Frames van casus A, van links naar rechts (ongeveer 0:02, 0:05, 0:10): de vrouw kijkt naar haar collega; hij lijkt te antwoorden terwijl beiden in beeld blijven; ze richten hun aandacht weer op de laptop en het notitieboek.
Beheer de camera zonder de spreker te verliezen
Een continu medium 2-shot is een diagnostische keuze. Beide gezichten blijven in beeld, zodat een gemiste overdracht zich niet achter montage kan verschuilen. Het model kan de kadrering alsnog variëren, daarom moet het uiteindelijke bestand worden geïnspecteerd.
Zodra de overdracht voor jouw doel werkt, probeer je een bescheiden beweging die beide gezichten behoudt. De straatprompt vraagt erom in een 16:9-kader dat beide gezichten zichtbaar houdt, waardoor mondbewegingen gemakkelijker te beoordelen zijn. Dat is een reden om eerst de kantoorbasis vast te stellen.
Houd achtergrondaudio onder de dialoog
Benoem de ambiance en de prioriteit ervan. Stille ruimtetoon geeft de kantoorclip weinig dat met spraak concurreert. Zacht cafégeluid voegt context toe terwijl de regels testbaar blijven. De straatprompt vraagt om voetstappen en verre geluiden onder beide stemmen, zonder omstanderspraat.
Negatieve instructies kunnen ongewenste audio verminderen, maar het blijven verzoeken. Luister naar een derde stem, vertelling, muziek en merkaudio. Controleer het beeld ook op ondertitels en logo's.
3 dialoogscènes die tonen wie wanneer spreekt
De drie meegeleverde videobestanden tonen de beoogde kantoor-, café- en straatscènes. Hun visuele inhoud kan hier worden geïnspecteerd, maar de bestanden bewijzen niet welke route of instellingen ze hebben geproduceerd. De onderstaande prompts zijn reproduceerbare verzoeken, geen claim dat de output elk woord correct heeft uitgesproken. Het kantoor controleert 5 beurten, het café test 8 snelle beurten en de straat voegt omgevingsgeluid toe.
| Casus | Promptverzoek | Meegeleverd bestand | Belangrijkste controle |
|---|---|---|---|
| A: kantooroverdracht | 12s, 16:9, 5 beurten | 12s, 16:9, 720p | Vijf regels, correcte monden |
| B: café-uitwisseling | 15s, 16:9, 8 beurten | 15s, 16:9, 720p | Acht regels, stabiele stemmen |
| C: straatinterview | 12s, 16:9, 5 beurten | 12s, 16:9, 720p | Hoorbaarheid op straat en sprekersbeurten |
Een kantooroverdracht met vijf beurten
Gebruik de volledige prompt en video hierboven. Beide collega's blijven in hetzelfde shot, zodat elk van de vijf gevraagde beurten een zichtbaar persoon heeft om te controleren. Noteer elke hoorbare regel tegen de tekst en inspecteer de actieve mond. Het meegeleverde bestand legt de scène en duur vast, maar de woorden en lip-sync zijn niet onafhankelijk geverifieerd.
Een duidelijke overdracht in één clip ondersteunt alleen een conclusie over die clip, niet een succespercentage voor het hele model. Bewaar het eerste resultaat zodat elke revisie met het origineel kan worden vergeleken.
Een café-uitwisseling met acht beurten
Vraag 15 seconden in 16:9. Acht korte beurten zetten herhaald stembezit en timing onder druk. Vergelijk de eerste en laatste regel van elke persoon en controleer daarna of een regel overlapt of verdwijnt. Het meegeleverde bestand is 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
Een buiten-Q&A
Vraag 12 seconden in 16:9. Dit voegt een milde camerabeweging en omgevingsgeluid toe. Het meegeleverde bestand is 16:9 bij 720p en kan worden beoordeeld op vijf sprekersbeurten en hoorbaarheid op straat.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
Gecombineerde weergave: 0:00–0:15 is casus B, de café-uitwisseling; 0:15–0:27 is casus C, het straatinterview. Beide bronclips zijn volledig opgenomen.
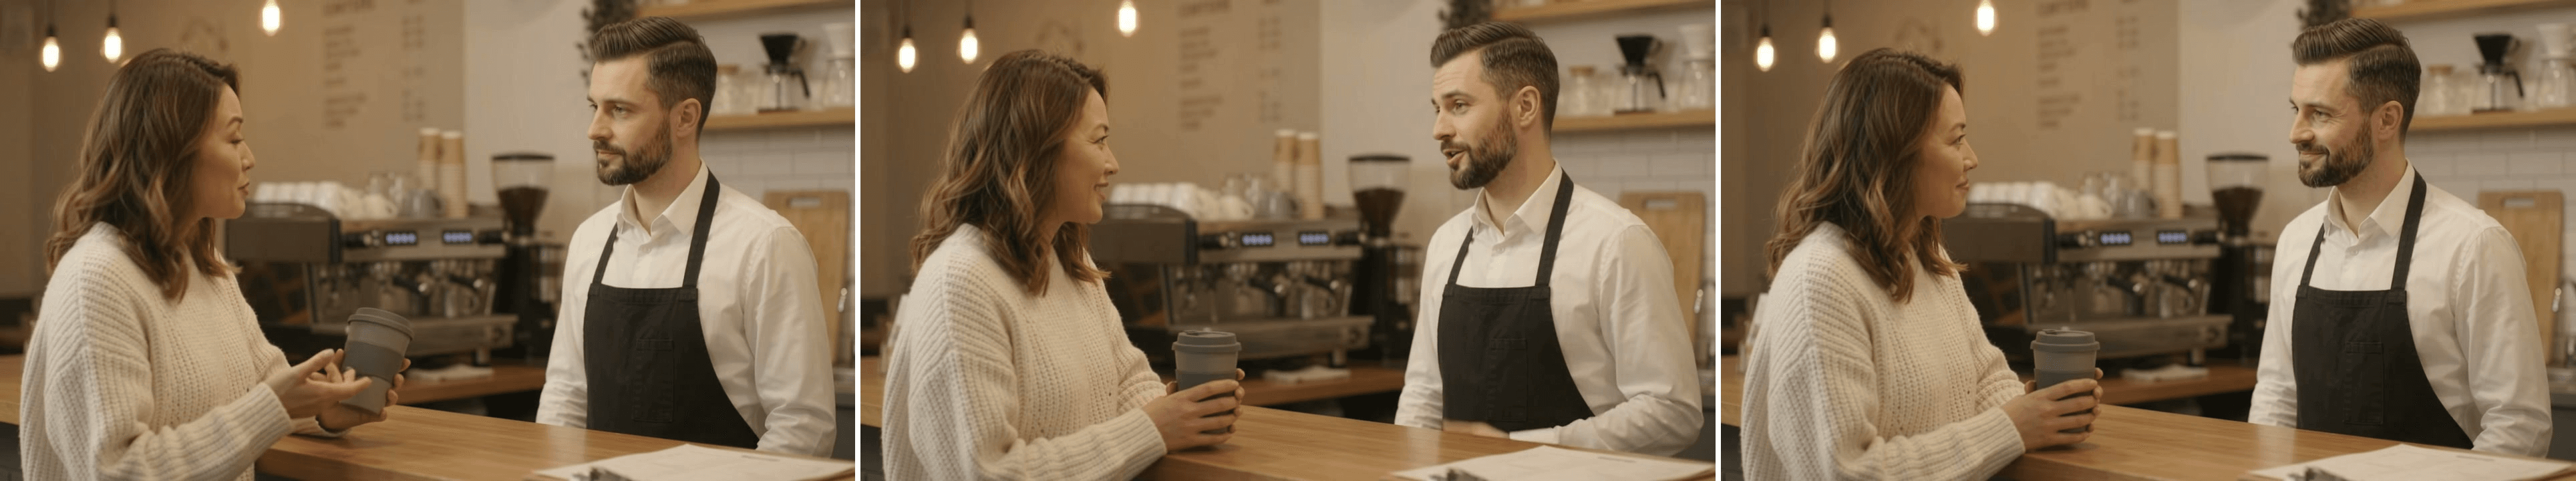 Frames van casus B, van links naar rechts (ongeveer 0:02, 0:08, 0:13 van de gecombineerde video): de klant laat haar beker zien; de cafémedewerker lijkt te antwoorden; ze kijken elkaar aan op het einde.
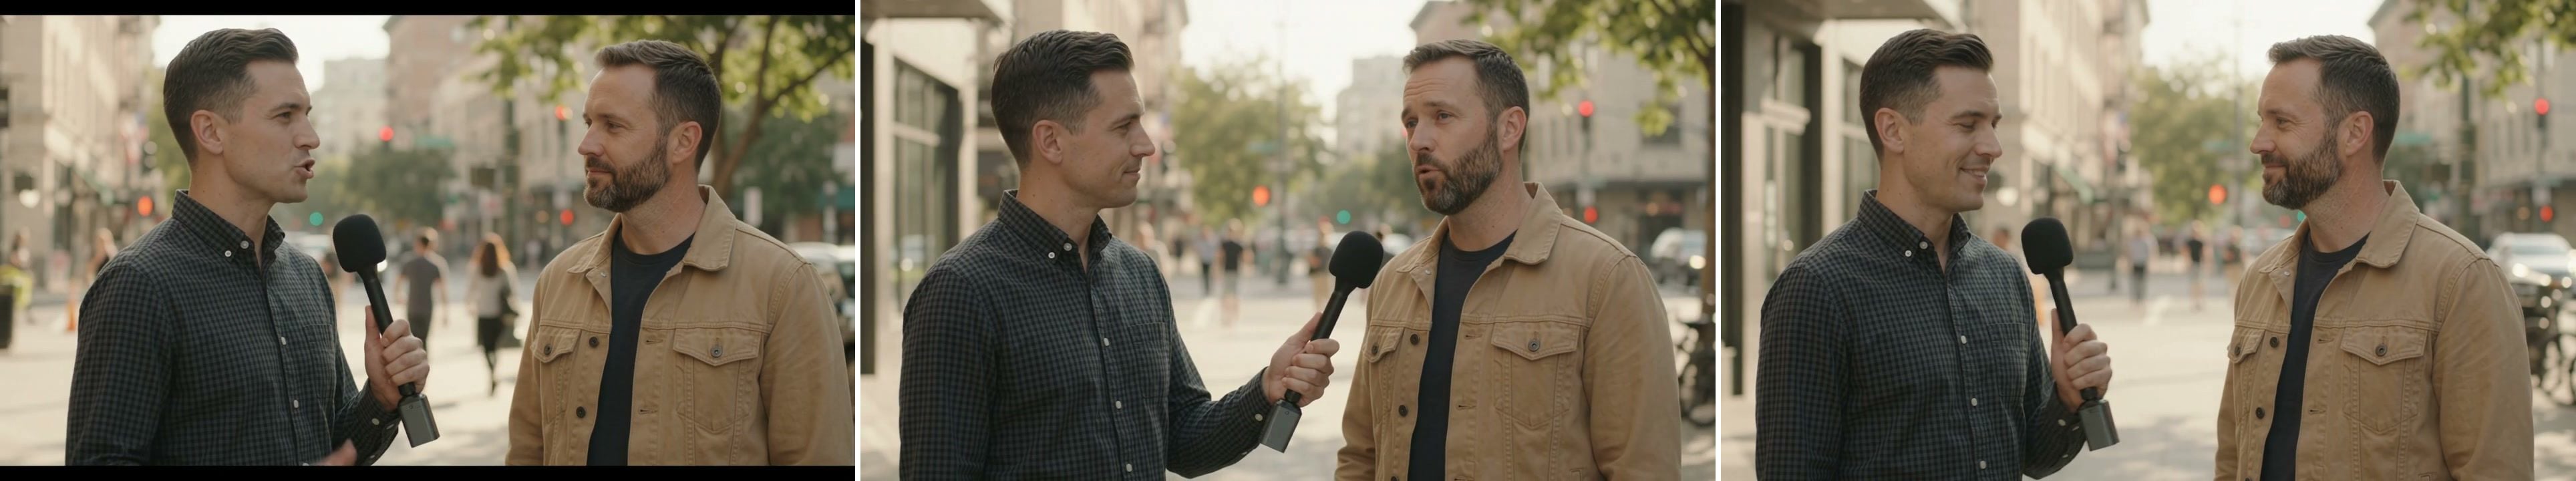
Frames van casus C, van links naar rechts (ongeveer 0:16, 0:19, 0:26 van de gecombineerde video): de interviewer houdt de microfoon vast; hij draait hem naar de geïnterviewde; beiden kijken elkaar aan op het einde.
Controleer sprekersvolgorde, lip-sync en stemdrift vóór publicatie
Beoordeel de clip regel voor regel
Download de video. Speel hem één keer af zonder het script te lezen om duidelijke verwarring te vinden en speel hem daarna opnieuw af met de prompt ernaast. Pauzeer bij elke beurt en schrijf op wat je hoort. Inspecteer beide monden en noteer spraak buiten de gescripte beurten. Log voor een herhaalbare review de start- en eindtijd van elke hoorbare regel, de verwachte spreker, de stem die je hoorde en de zichtbare mond die bewoog. Schrijf “onduidelijk” als een gezicht verborgen is of het geluid een woord maskeert. Maak van een onduidelijke cel geen voldoende omdat de rest van de scène overtuigend lijkt. Een tweede luisteraar die de prompt niet heeft gezien, kan aangeven wie volgens hen spreekt; vergelijk dat oordeel met het script voordat je besluit of een publiek de scène zal begrijpen.
Controleer 4 dingen voor elke regel:
- Woorden: Werden de geciteerde woorden in volgorde gesproken, zonder weggelaten einde of toegevoegde zin?
- Stemeigenaar: Klonk de genoemde persoon als de spreker, vooral toen A terugkwam?
- Zichtbare timing: Bewoog de mond van die persoon terwijl de luisteraar stil bleef?
- Overige inhoud: Voegde de clip een verteller, omstander, ondertitels, logo of muziek toe?
Een tijdlijn met tijdstempels voor kwaliteitsborging blijft openstaan totdat de audio en mondbewegingen regel voor regel zijn beoordeeld.
Pas één beperking per keer aan
Als de laatste regel verdwijnt, verkort dan het script of geef het meer duur binnen de limiet van 15 seconden. Als het verkeerde personage spreekt, herhaal dan de visuele positie en geef aan dat de luisteraar stil blijft. Als ambiance een woord overstemt, verlaag of verwijder die dan. Als een cut de actieve mond verbergt, ga dan terug naar een continu 2-shot. Wijzig één factor per nieuwe poging, zodat de volgende output een duidelijke vraag beantwoordt.
Geen van deze aanpassingen garandeert een oplossing. Als een render moet worden herzien, bewaar dan het bestand, de instellingen en het probleem dat je wilt aanpakken. Een producent kan dan beslissen of een nieuwe render de kosten waard is of dat opgenomen stemmen en handmatige montage de nodige precisie zouden geven. Begin voor een korte, zichtbaar gesproken uitwisseling met de kantoorprompt en accepteer een clip pas na de regel-voor-regelcontrole. Dat is de standaard voor dialoog met meerdere sprekers in Gemini Omni 1.2 Flash.
Veelgestelde vragen
Kan Gemini Omni 1.2 Flash dezelfde stemmen behouden in afzonderlijke clips?
Dat een stem herkenbaar blijft binnen één gegenereerde clip is een smallere eis dan die behouden over afzonderlijke generaties. Deze tekst-only voorbeelden testen het eerste geval. Beloof daaruit geen stemidentiteit over clips heen. Een campagne die één terugkerende spreker nodig heeft, moet een aparte continuïteitstest uitvoeren.
Kan Gemini Omni 1.2 Flash dialoog genereren in andere talen dan Engels?
Het model kan andere talen produceren, maar deze prompts zijn in het Engels. Beoordeel de doeltaal woord voor woord met een vloeiende luisteraar, inclusief namen, getallen en gelokaliseerde claims. Een succesvolle taaltest van een andere maker is bewijs voor die test, geen garantie voor jouw script.
Hoe houd ik elke regel toegewezen aan de juiste spreker?
Geef elke persoon een visuele positie en stem, label elke geciteerde regel en geef aan wie stil blijft tijdens de beurt van de ander. Beoordeel de gegenereerde video regel voor regel. Als een render niet aan de briefing voldoet, verkort dan de uitwisseling of gebruik een gecontroleerde audioworkflow voor exacte levering.
Hoeveel dialoogbeurten passen in een clip van 15 seconden van Gemini Omni 1.2 Flash?
De caféprompt vraagt om acht korte beurten in 15 seconden, terwijl de kantoor- en straatprompts om vijf beurten in 12 seconden vragen. Dit zijn scriptvoorbeelden, geen gegarandeerde limieten. Lees de regels hardop voor, houd rekening met pauzes en verkort ze als de laatste beurt het einde van de clip bereikt.
Heeft Gemini Omni 1.2 Flash een referentieafbeelding nodig voor dialoog met twee sprekers?
Er wordt geen referentieafbeelding gebruikt in deze drie tekst-naar-videoprompts. Ze beschrijven de positie, kleding en stem van elke spreker in tekst. Als een project een specifiek gezicht of een visuele stijl nodig heeft, test dan een route die referenties accepteert en beoordeel de output apart.


