Snel antwoord
Een GitHub AI-videogeneratorvaardigheid verbindt je code met AI-videomodellen. In 2026 hangt de keuze tussen open-source (gratis, zelf gehost) en betaalde API's (cloud, direct) af van vier variabelen: beschikbaar VRAM, vereisten voor gegevensprivacy, benodigde kwaliteitsdrempel en maandelijks generatievolume. Voor productieworkflows die meerdere SOTA-modellen nodig hebben, biedt Atlas Cloud (atlascloud.ai) toegang tot 300+ modellen – waaronder Kling v3.0, Seedance 2.0, Vidu 3.0, Veo en Sora – via één enkele API-sleutel met transparante pay-per-use-prijzen.
Wil je de videomodellen achter deze tools direct vergelijken? De Atlas Cloud-modelvergelijking zet beeld- en videomodellen naast elkaar op één prompt – met de prijs voordat je genereert.
-
Wat is een AI-videogeneratorvaardigheid? {#what-is-a-skill}
In de context van GitHub-repositories is een AI-videogeneratorvaardigheid een herbruikbare module, wrapper of integratielaag die een applicatie verbindt met een AI-videogeneratiebackend – ofwel een zelf gehost open-sourcemodel of een cloud-API.
Zie het als de abstractie tussen je applicatielogica en de daadwerkelijke inferentie-engine. Een vaardigheid kan zijn:
- Een Python-klasse die de
Wan 2.2-modelpipeline voor tekst-naar-video-generatie verpakt - Een ComfyUI-aangepaste node die verbinding maakt met de Atlas Cloud API voor Kling v3.0-generatie
- Een n8n-workflownode die Seedance 2.0 via REST activeert en een video-URL retourneert
- Een LangChain-tool of MCP Server-vaardigheid die een video-generatie-eindpunt op aanvraag aanroept
De kernvraag waar elke ontwikkelaar voor staat bij het bouwen ervan: moet de backend open-sourcegewichten zijn die lokaal draaien, of een betaalde cloud-API?
Echte 2026-gegevens. Geen theorie.
-
GitHub open-source in 2026 {#open-source-landscape}
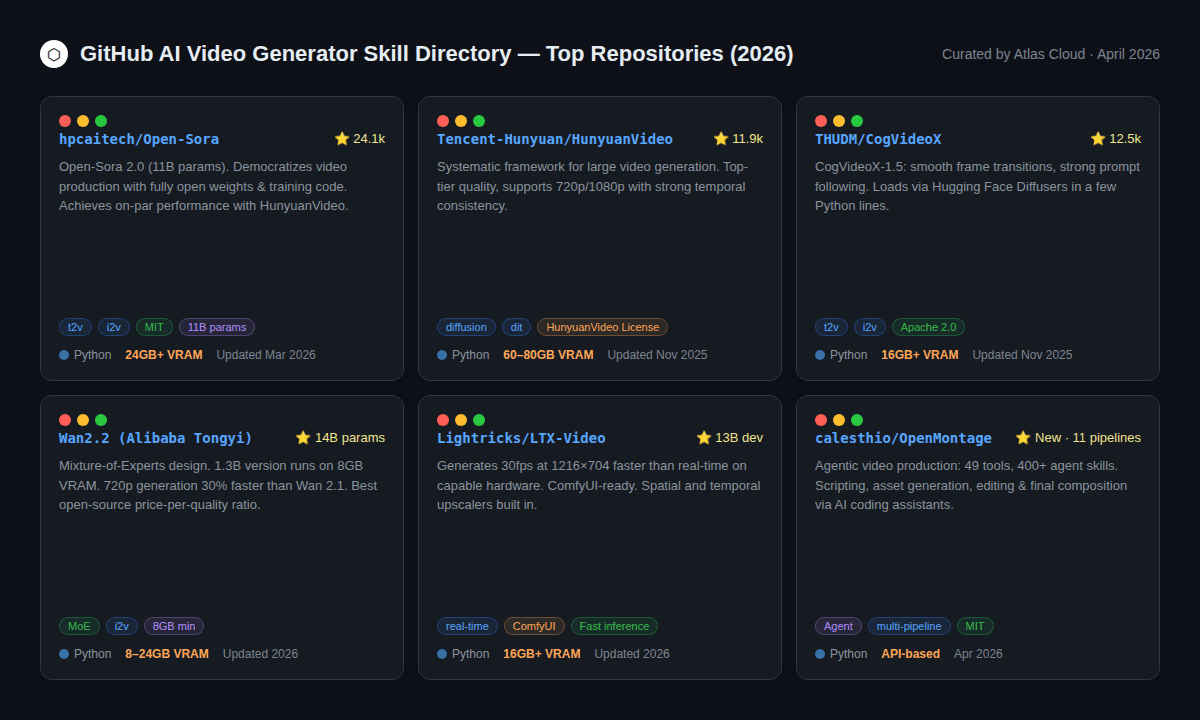
Het open-source video-generatie-ecosysteem is aanzienlijk volwassen geworden. Sommige repos zijn nu echte alternatieven voor betaalde API's – althans voor bepaalde taken.
Niveau 1: productieklaar open-sourcemodellen
HunyuanVideo (Tencent, 11,9k ⭐) – Een van de betere open-source videogeneratoren die er zijn. Verwerkt 720p en 1080p. De belangrijkste beperking is de hardwarevereiste: 60–80 GB VRAM voor het volledige model, waardoor het alleen toegankelijk is voor teams met enterprise-GPU-toegang. De communitylicentie staat commercieel gebruik toe met naamsvermelding.
CogVideoX-1.5 (THUDM/CogVideo, 12,5k ⭐) Uitgebracht onder Apache 2.0, dit is een van de meest ontwikkelaarsvriendelijke open modellen. Het laadt natively via Hugging Face Diffusers in een paar regels Python. Frame-overgangen zijn vloeiend en promptvolging is sterk. Minimaal 16 GB VRAM vereist. Solide keuze als je team al op Hugging Face werkt.
Open-Sora 2.0 (hpcaitech, 24,1k ⭐) Het meest bekroonde open-source video-generatieproject op GitHub. Versie 2.0 (11B parameters) presteert vergelijkbaar met HunyuanVideo op VBench-benchmarks, en de trainingskosten werden gerapporteerd op ongeveer $200.000 – een opmerkelijk bedrag voor een model van dit kaliber. Tekst-naar-video, beeld-naar-video en oneindige lengte-generatie.
Niveau 2: lichtere open-sourceopties (lager VRAM)
Wan 2.2 (Alibaba Tongyi) Het toegankelijkheidsverhaal is hier overtuigend: de 1.3B-variant draait op 8 GB VRAM, en de 14B-variant op 24 GB. De Mixture-of-Experts (MoE)-architectuur levert betere details tegen lagere rekenkosten, en versie 2.2 is 30% sneller op 720p dan zijn voorganger. Voor ontwikkelaars die een enkele consumenten-GPU draaien, is Wan 2.2 de sterkste open-sourceoptie.
LTX-Video (Lightricks) Ontworpen voor snelheid boven alles. Genereert 30fps op 1216×704 resolutie sneller dan realtime op geschikte hardware. De ComfyUI-integratie is volwassen en ruimtelijke en temporele upscalers zijn ingebouwd.
Niveau 3: agentische pipelines
OpenMontage (calesthio, nieuw april 2026) Een werkelijk nieuwe categorie: een agentisch videoproductiesysteem met 11 pipelines, 49 tools en 400+ agentvaardigheden. Werkt met AI-codeerassistenten zoals Claude Code, Cursor en Copilot. Behandelt de volledige pipeline – onderzoek, script, assets, montage – van begin tot eind zonder handmatige stappen. Gebouwd voor teams die meerdere AI-tools in één workflow samenvoegen.
-
Betaalde API-directory: SOTA-modellen nu beschikbaar {#paid-api-directory}
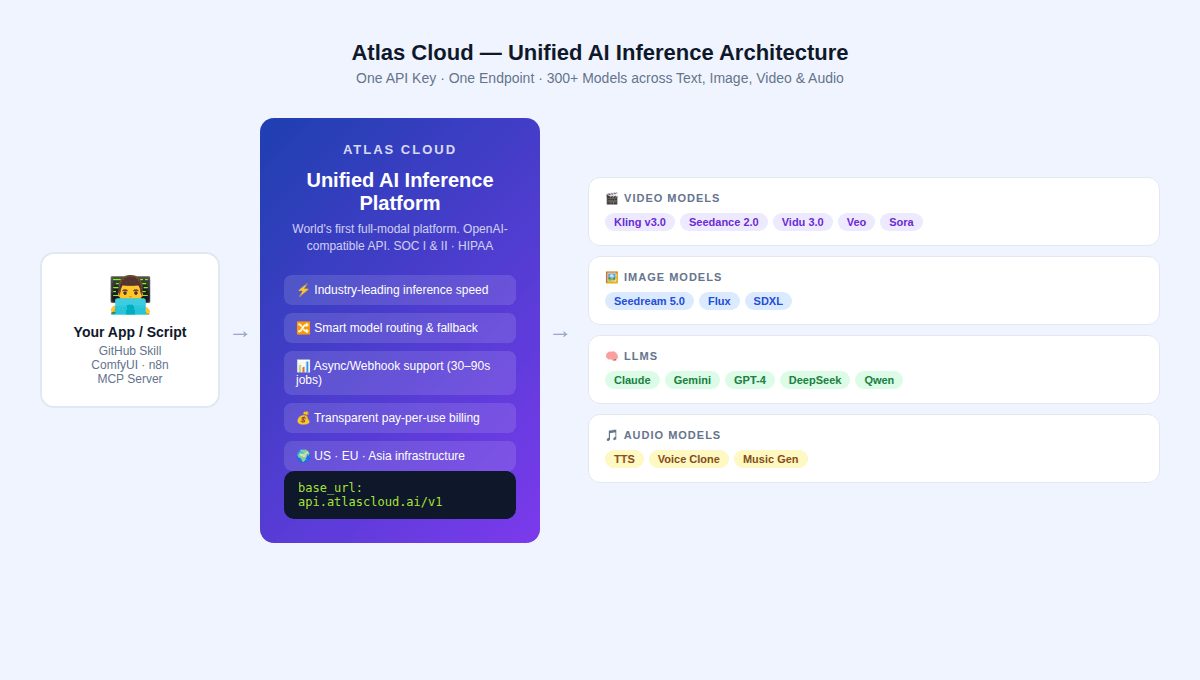
Het betaalde API-landschap in 2026 wordt gedefinieerd door drie grote modelfamilies, elk met een eigen technische benadering. Alle drie zijn beschikbaar via Atlas Cloud's unified API.
Kling v3.0 (Kuaishou)
Uitgebracht op 5 februari 2026. Gebouwd op een Multi-modale Visuele Taalarchitectuur – tekst, afbeeldingen, audio en video worden allemaal in één systeem verwerkt.
Wat het daadwerkelijk beter doet dan concurrenten:
- Complexe menselijke beweging – rennen, dansen, vechtsporten – zonder de "spaghettilim"-vervorming die andere modellen plaagt
- Meertalige native audio-generatie (5 talen, inclusief gesynchroniseerde lipbeweging)
- Motion Brush: een tool waarmee ontwikkelaars (of eindgebruikers) bewegingspaden rechtstreeks op bronafbeeldingen kunnen schilderen – een functie die momenteel geen equivalent heeft in concurrerende modellen
- Element Binding voor consistente personage- en objecttracking over shots
Waar het tekortschiet: Renderingsnelheid is langzamer dan sommige concurrenten op het Pro-niveau. De overgangen van de storyboardtool kunnen "klungelig" zijn volgens onafhankelijke reviewers.
Het beste voor: Sociale shorts op TikTok en Reels, e-commerce productvideo's, alles wat veel volume nodig heeft met personages die daadwerkelijk consistent blijven.
Seedance 2.0 (ByteDance)
Uitgebracht op 8 februari 2026, vertegenwoordigt Seedance 2.0 een paradigmaverschuiving in hoe AI-video wordt geprompt – van alleen tekstprompten naar echte regisseursstijl referentiegestuurde controle.
De kern technische innovatie: Seedance 2.0 accepteert quad-modale invoer – tekst, beeld, video en audio – tegelijkertijd. Het "Universal Reference"-systeem stelt een ontwikkelaar in staat om een referentievideo van een dansend persoon in te voeren, en het model repliceert de camerabeweging, personageacties en compositie in een gegenereerde uitvoer. Dit lost karakterconsistentie op een manier die pure tekst-naar-video-modellen niet kunnen.
Onafhankelijke tests bevestigen dat het uitblinkt in:
- Multi-shot verhalen vertellen met consistente personage-identiteit over cuts
- Gesynchroniseerde audio-video-generatie (dual-branch architectuur genereert geluid en video gelijktijdig)
- Nauwkeurige replicatie van compositie en belichting van referentie-assets
Opmerking over beschikbaarheid: Vanaf april 2026 is internationale API-toegang tot Seedance 2.0 beschikbaar via platforms zoals Atlas Cloud. Directe BytePlus API-toegang voor internationale ontwikkelaars heeft inconsistenties in beschikbaarheid gehad – bevestig de huidige status voordat je een afhankelijkheid van directe ByteDance-eindpunten opbouwt.
Het beste voor: Muziekvideo's, strakke karakteranimatie, productadvertenties waar de beweging exact moet zijn, bureaus die storyboard-naar-video-workflows draaien.
Vidu 3.0 (Shengshu AI / Tsinghua)
Gebouwd op de originele U-ViT-architectuur die Diffusion en Transformer-technologieën combineert, richt Vidu zich op de gebieden waar de meeste AI-video nog worstelt: omgevingscoherentie en cinematografische consistentie.
Onderscheidende kenmerken:
- Universeel referentiesysteem voor consistente belichting over multi-shot reeksen
- Slimme achtergrondmuziekgeneratie die zich automatisch aanpast aan de scènestemming
- Lange-vorm generatie met sterke temporele consistentie (cruciaal voor reeksen langer dan 5 seconden)
Beste gebruiksscenario's: Professionele filmworkflows, animatieontwerp, creatieve reclame die cinematografische kwaliteit vereist.
Sora 2 (OpenAI)
Sora 2 blijft de benchmark voor natuurkundesimulatie-nauwkeurigheid. Breek een glas in een Sora 2-prompt en het breukpatroon, vloeistoffysica en reflecties gedragen zich allemaal als het echte werk – de meeste concurrenten kunnen dat niveau van consistentie nog steeds niet evenaren.
Het beste voor: VFX-werk, architectuurvisualisatie, documentaire B-roll, overal waar fysieke nauwkeurigheid belangrijker is dan geld besparen.
Prijzen: Sora 2 heeft de hoogste rekening in deze categorie. Je betaalt voor de computer.
-
Inferentiekosten: de echte cijfers {#inference-costs}
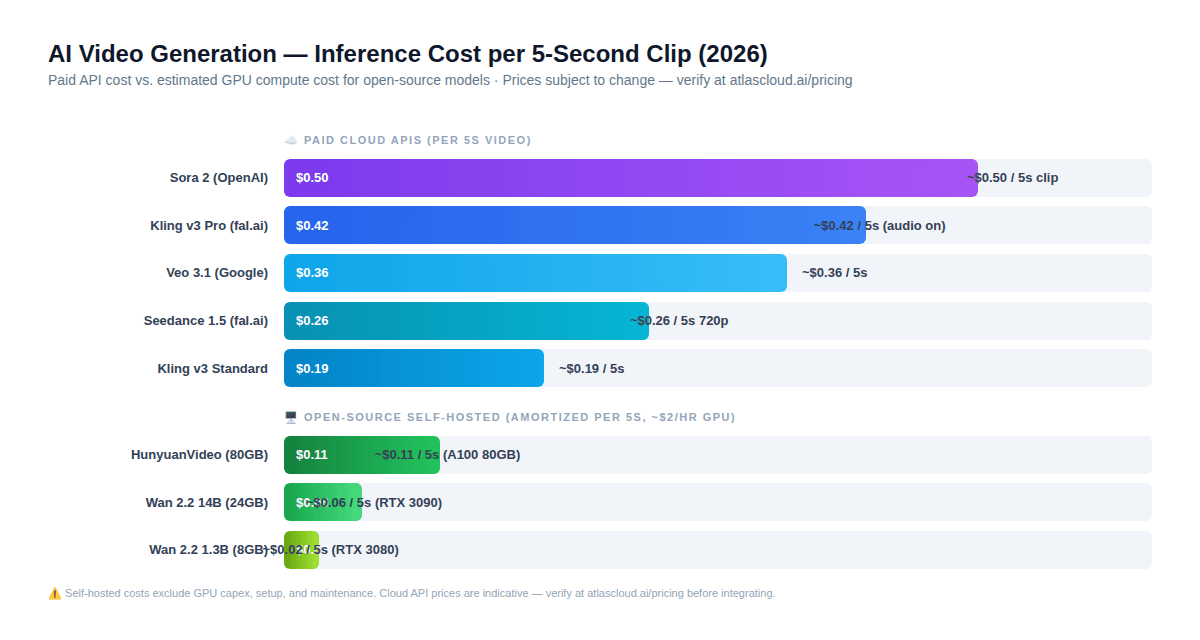
Dit gedeelte bevat de belangrijkste contra-intuïtieve bevinding in deze hele gids – een die de standaardintuïtie van de meeste ontwikkelaars over open-source versus betaalde API's verandert.
De verborgen kosten van zelf gehoste modellen
De meeste ontwikkelaars nemen aan: "Open-source = gratis = altijd goedkoper."
Deze aanname is onjuist voor de meeste teamgroottes.
Hier is wat de echte wiskunde eruitziet voor een videoclip van 5 seconden in 2026:
Zelf gehoste open-source (geamortiseerde GPU-kosten bij ~$2/uur):
- Wan 2.2 1.3B (RTX 3080): ~$0,02 per 5s clip
- Wan 2.2 14B (RTX 3090): ~$0,06 per 5s clip
- HunyuanVideo (A100 80GB): ~$0,11 per 5s clip
Betaalde cloud-API (indicatieve prijzen – verifieer op atlascloud.ai/pricing):
- Kling v3 Standard: ~$0,19 per 5s clip
- Seedance 1.5 720p met audio: ~$0,26 per 5s clip
- Kling v3 Pro met audio: ~$0,42 per 5s clip
- Sora 2: ~$0,50 per 5s clip
De zelf gehoste cijfers zien er op zichzelf overtuigend uit. Het probleem is dat ze uitsluiten:
- GPU-hardware – Een A100 80GB kost $10K–$15K. Bij 1.000 video's per maand (~$0,11 per stuk), heb je 9.000+ maanden nodig om alleen al quitte te spelen op de hardware.
- Installatietijd – CUDA-configuratie, modelgewicht downloaden, VRAM-beheer en debuggen vertegenwoordigen 20–40 engineeringuren aan initiële opzet.
- Doorlopend onderhoud – Modelupdates, afhankelijkheidsconflicten en infrastructuurbetrouwbaarheid zijn continue tijdsinvesteringen.
- Opportuniteitskosten – Tijd besteed aan inferentie-infrastructuur is tijd die niet aan het product wordt besteed.
De praktische grensconditie:
Zelf hosten loont alleen als: (a) je al GPU's hebt die andere workloads draaien, (b) je 5.000+ video's per maand verwerkt, of (c) regelgeving je dwingt om alles on-premise te houden.
Onder die drempel zijn betaalde API's – vooral uniforme platforms zoals Atlas Cloud – goedkoper wanneer de totale eigendomskosten eerlijk worden berekend.
-
Rate limiting en API-latentie – wat ontwikkelaars daadwerkelijk tegenkomen {#rate-limiting}
De latentieparadox
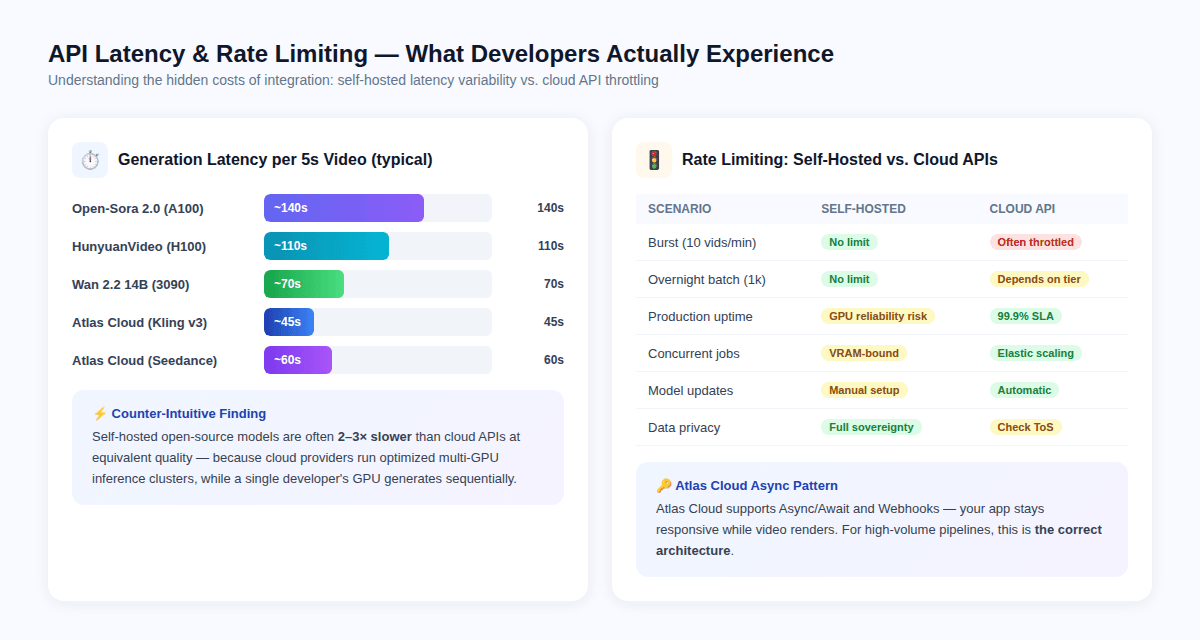
Contra-intuïtief zijn cloud-API's vaak sneller per video dan zelf gehoste modellen – niet omdat de modellen anders zijn, maar omdat cloudproviders geoptimaliseerde multi-GPU inferentieclusters draaien met hardwarematige batching, terwijl een enkele ontwikkelaars-GPU frames sequentieel genereert.
Typische latentie per 5-secondenclip:
- Open-Sora 2.0 op A100: ~140 seconden
- HunyuanVideo op H100: ~110 seconden
- Wan 2.2 14B op RTX 3090: ~70 seconden
- Atlas Cloud / Kling v3: ~45 seconden
- Atlas Cloud / Seedance 2.0: ~60 seconden
Dit betekent dat het bouwen van een GitHub-vaardigheid rond een zelf gehost model langere wachttijden voor de gebruiker kan opleveren, zelfs als de kosten per video lager zijn.
Rate limiting: de productie-realiteit
Zelf gehoste modellen hebben geen door API opgelegde rate limits – ze worden alleen beperkt door het VRAM en de thermische limieten van je GPU.
Betaalde API's handhaven rate limits die variëren per prijsniveau. De relevante technische implicaties:
- Burst-aanvragen (10+ video's per minuut) zullen throttling veroorzaken op de meeste betaalde API-niveaus
- Nachtelijke batchtaken (1.000+ video's) vereisen zorgvuldig asynchroon ontwerp om time-outs te voorkomen
- Gelijktijdige aanvragen op zelf gehoste modellen worden begrensd door VRAM – het uitvoeren van 2 gelijktijdige 14B-modelinferenties op een enkele 24GB-kaart is typisch niet mogelijk
Atlas Cloud lost het rate limiting-probleem op via Async/Webhook-architectuur: je applicatie dient een generatietaak in, ontvangt een taak-ID en wordt via webhook op de hoogte gesteld wanneer het renderen is voltooid. Dit patroon voorkomt dat applicaties vastlopen terwijl video wordt gerenderd, en het schaalt correct voor batchworkloads.
De juiste architectuur voor productie
plaintext1# Atlas Cloud Async Pattern — Production-Ready 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Submit generation task 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Product showcase reel, smooth motion, 9:16 aspect ratio", 14 size="1080x1920", 15 n=1 16) 17 18# Handle async response 19video_url = response.data[0].url 20print(f"Video generated: {video_url}")
Voor beeld-naar-video-workflows: let op dat sommige modellen – waaronder bepaalde Kling i2v-varianten – geen aparte beeldverhoudingparameter accepteren voor beeld-naar-video-generatie; de uitvoerresolutie volgt de afmetingen van de invoerafbeelding. Bouw je upstream-beeldgeneratie met de juiste doelverhouding.
-
Lokaal hosten versus cloud-API: de afwegingmatrix {#local-vs-cloud}
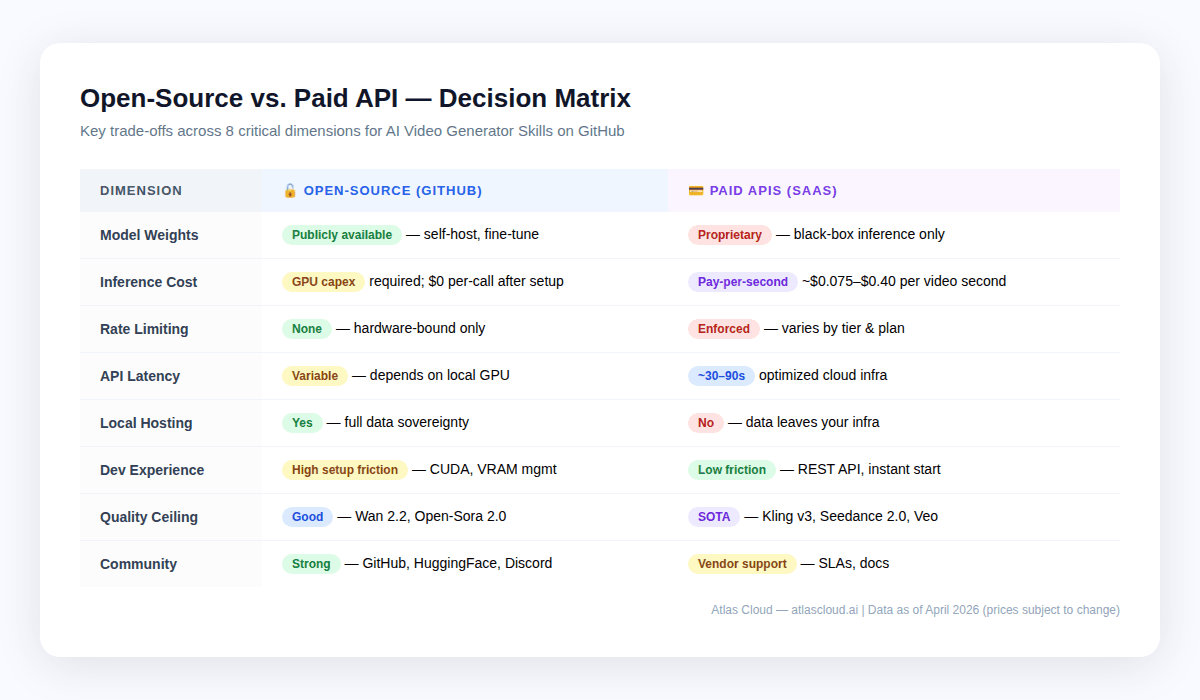
Het is niet óf-óf. De meeste productiepipelines combineren beide: open-source voor prototyping en bulk low-quality passes, cloud-API's voor uiteindelijke renders en state-of-the-art kwaliteit.
Wanneer lokaal zinvol is
- Compliance-verplichtingen – HIPAA, GDPR of iets propriëtairs dat je servers niet mag verlaten. Zelf hosten is je enige optie. Atlas Cloud is HIPAA-compatibel en SOC I & II gecertificeerd, wat de meeste enterprise-behoeften dekt, maar gereguleerde bedrijven moeten hun specifieke vereisten dubbelchecken.
- Zeer hoog volume bij acceptabele kwaliteit – teams die 10.000+ video's per maand genereren op Wan 2.2-kwaliteitsniveau kunnen ontdekken dat GPU-huur kosten lager zijn dan API-kosten op die schaal.
- Onderzoek en fine-tuning – open modelgewichten maken fine-tuning op propriëtaire datasets mogelijk. Geen enkele cloud-API biedt momenteel aangepaste modeltraining.
- Air-gapped opstellingen – edge-implementaties zonder connectiviteit of vergrendelde netwerken.
Wanneer cloud-API's winnen
- Time-to-market – een Atlas Cloud-integratie duurt uren, geen weken
- Topkwaliteit – open-source leiders zoals Wan 2.2 en Open-Sora 2.0 blijven nog steeds achter bij propriëtaire modellen zoals Kling v3 en Seedance 2.0, vooral op het gebied van menselijke beweging, consistente shots en native audio
- Piekbelastingen – cloud-API's schalen op en neer; je eigen GPU's doen dat niet
- Lager volume – onder ~5.000 video's per maand winnen cloud-API's meestal op totale kosten
- Multi-model flexibiliteit – Atlas Cloud's catalogus van 300+ modellen betekent dat je binnen één integratie kunt overschakelen van Kling naar Seedance naar Veo
-
Community-gedreven versus leverancier-gedreven ontwikkeling {#community-vs-vendor}
Gemakkelijk te negeren bij het vergelijken van API's, maar dit is eigenlijk belangrijk als je GitHub-vaardigheden bouwt.
Community-gedreven (open-source):
- Iedereen kan bugfixes indienen en functies aanvragen – en deze laten samenvoegen
- Documentatie is vaak uitstekend omdat de gebruikersbasis voorbeelden bijdraagt
- Brekende wijzigingen in model-API's gebeuren langzaam, met openbare aankondigingstermijnen
- ComfyUI- en Hugging Face Diffusers-community's hebben diepe bibliotheken met kant-en-klare workflows, LoRA-adapters en fijn afgestemde checkpoints
- Onderzoekspapers verschijnen met open, reproduceerbare code
Leverancier-gedreven ontwikkeling (betaalde API's):
- API-stabiliteit wordt geregeld door commerciële SLA's – brekende wijzigingen komen minder vaak voor, maar gebeuren wel
- Nieuwe modelreleases (bijv. Kling 3.0 in februari 2026, drie dagen voor Seedance 2.0) gebeuren met concurrerende snelheid en vaak zonder voorafgaande kennisgeving
- Modelverbeteringen worden server-side geïmplementeerd zonder dat de ontwikkelaar actie hoeft te ondernemen
- Technische documentatie wordt professioneel onderhouden
De praktische implicatie voor GitHub-vaardigheidauteurs: als je een vaardigheid schrijft die stabiel en onderhoudsarm moet blijven, is een cloud-API met stabiele eindpuntcontracten gemakkelijker te onderhouden dan een vaardigheid die is gekoppeld aan een specifieke open-sourcemodelversie. Omgekeerd, als je vaardigheid is ontworpen om ontwikkelaars toegang te geven tot de nieuwste onderzoeksmodellen zonder API-kosten, dan is het open-source ecosysteem de plek waar dat werk gebeurt.
-
Casestudy: social media-bureau (500 video's/maand) {#case-study-1}
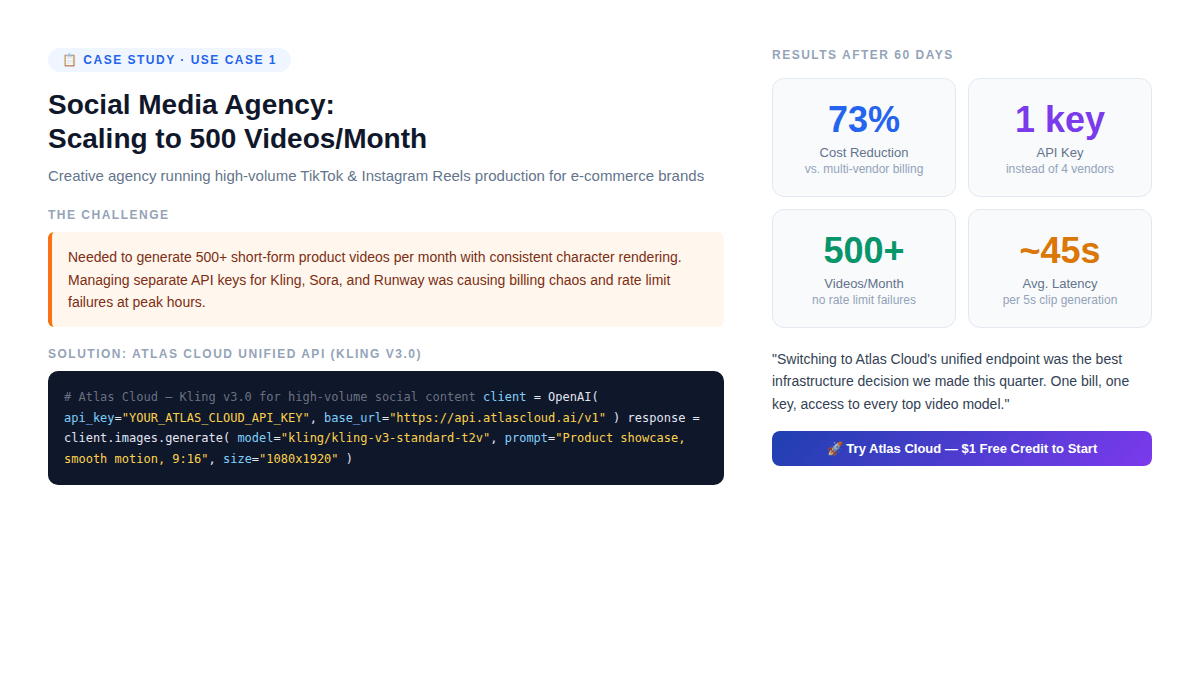
De opzet: Een creatief bureau dat korte productvideo's maakt voor 20 e-commerce klanten. Ze hebben 500 video's per maand nodig, personages die er hetzelfde uitzien over clips, 9:16 verticaal, 5–10 seconden elk, gebatched tijdens daluren.
Initieel architectuur (vóór Atlas Cloud):
- Aparte API-sleutels voor Kling, RunwayML en Pika
- Drie facturatiedashboards, drie rate limit-pools
- Handmatige modelselectie per klant
- Rate limit-fouten tijdens piekuren die leveringsvertragingen veroorzaken
Probleem dat dit creëerde: Toen Kling v3.0 uitbracht, moest het bureau een nieuwe SDK herintegreren, facturering bijwerken en compatibiliteit testen – drie keer voor drie leveranciers.
Oplossing: Atlas Cloud unified API met Kling v3.0 Standard
plaintext1# Atlas Cloud — Social Media Video Pipeline 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, smooth motion, cinematic lighting, 9:16 vertical format", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Resultaten na 60 dagen:
- 73% reductie in kosten per video (enkele factuur, geen per-leverancier opslagen)
- Nul rate limit-fouten (Atlas Cloud's elastische infrastructuur absorbeerde piekbelastingen)
- Modeloverschakeling van Kling naar Seedance voor specifieke klanten duurde < 2 minuten (één parameter wijzigen)
- Eerste storting 20% bonus compenseerde effectief de productiekosten van de eerste maand
De niet voor de hand liggende bevinding: Het bureau verminderde het aantal leveranciers niet omdat Kling beter werd. Ze verminderden het omdat het beheren van meerdere leveranciersrelaties bij 500 video's/maand een niet-triviale operationele kost met zich meebrengt die niet in de API-prijzen per stuk verschijnt.
-
Casestudy: indie-ontwikkelaar die een video-SaaS bouwt {#case-study-2}
De opzet: Solodev die een "tekst naar productdemo"-tool bouwt voor early-stage startups. Heeft meerdere stijlen nodig – cinematisch, geanimeerd, live-action. Moet snel valideren en infra onder $200/maand houden terwijl hij uitzoekt of iemand dit überhaupt wil.
Architectuurbeslissing:
De ontwikkelaar overwoog aanvankelijk om Wan 2.2 zelf te hosten op een gehuurde A100-instantie (~$2/uur). Bij 100 testvideo's tijdens validatie werden de kosten geschat op ~$6 totaal aan GPU-tijd. Leek goedkoper dan Atlas Cloud.
Wat de berekening miste:
- Het opzetten van de Wan 2.2-pipeline duurde 3 dagen (CUDA-afhankelijkheden, VRAM-beheer, serverconfiguratie)
- Wan 2.2's uitvoerkwaliteitskloof vs. Kling v3 betekende dat de SaaS niet de beoogde prijs kon vragen
- Server-uptimebeheer voegde ~2 uur/ week aan doorlopend onderhoud toe
Herziene architectuur met Atlas Cloud:
plaintext1# Flexible model routing — switch based on user tier 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Lower cost 4 "pro": "kling/kling-v3-professional-t2v", # Higher quality 5 "enterprise": "bytedance/seedance-2.0" # Max control 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Resultaat: De ontwikkelaar lanceerde in 4 dagen in plaats van 3 weken. Het gebruik van Seedance 2.0 op het premiumniveau rechtvaardigde een 3× prijspremie boven het gratis niveau, en de gelaagde modelstructuur was gebouwd met één Atlas Cloud-sleutel – niet drie aparte leveranciersintegraties.
-
Het Atlas Cloud-voordeel: waarom "één API" de juiste architectuur is {#atlas-cloud-advantage}
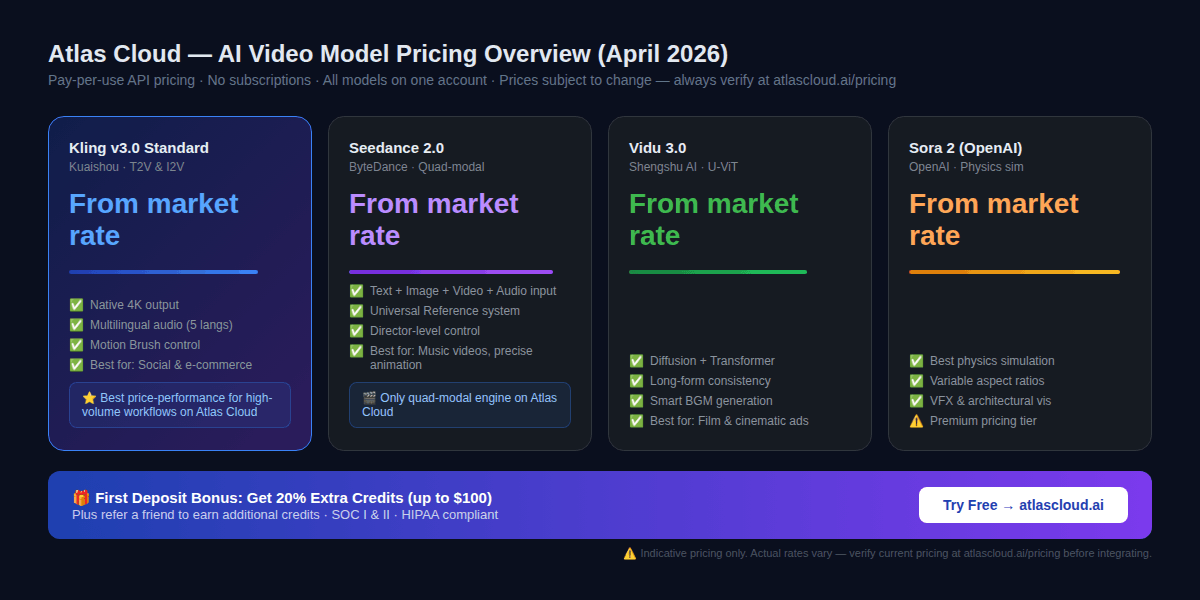
Atlas Cloud positioneert zich als 's werelds eerste full-modale AI-inferentieplatform – een unified API die 300+ modellen bedient voor tekst-, beeld-, video- en audiogeneratie.
Voor auteurs van GitHub AI-videogeneratorvaardigheden zijn de specifieke voordelen:
-
OpenAI-compatibele API (drop-in vervanging)
Atlas Cloud gebruikt een OpenAI-compatibel eindpunt. Als je vaardigheid al integreert met de OpenAI SDK, vereist overschakelen naar Atlas Cloud voor videogeneratie het wijzigen van twee regels: de api_key en base_url. Geen nieuwe SDK, geen nieuw authenticatiesysteem.
-
Enkele facturering voor multi-model workflows
Productievideoworkflows gebruiken zelden één model. Een typische pipeline kan gebruikmaken van:
- Seedream 5.0 voor beeldgeneratie (startframes)
- Kling v3.0 voor beeld-naar-video-conversie
- Een LLM (Claude, GPT-4 of DeepSeek) voor promptoptimalisatie
- Een TTS-model voor voiceover-narratie
Met aparte leveranciersaccounts is dit vier facturatie-relaties, vier rate limit-pools en vier integratiepunten. Met Atlas Cloud is het één API-sleutel en één factuur.
-
Model-level prijstransparantie
Atlas Cloud publiceert per-model prijzen zonder verborgen rekenkosten. Het bedrijfsmodel is eenvoudig: betaal voor wat je genereert. Nieuwe ontwikkelaars ontvangen een 20% bonus op hun eerste storting (tot $100), en een verwijzingsprogramma biedt extra tegoeden. Verifieer altijd de huidige prijzen op atlascloud.ai/pricing voordat je financiële prognoses maakt.
-
Compliance-dekking
Voor enterprise GitHub-vaardigheden die in gereguleerde omgevingen worden geïmplementeerd: Atlas Cloud heeft SOC I & II-certificering en is HIPAA-compatibel, met infrastructuur in de VS, EU en Azië. Dit dekt de meerderheid van enterprise-vereisten voor gegevenslocatie.
-
ComfyUI, n8n en MCP Server-integratie
Atlas Cloud integreert native met de tools die het meest worden gebruikt om GitHub-videogeneratievaardigheden te bouwen:
- ComfyUI – aangepaste nodes voor visuele workflow-auteurschap
- n8n – workflowautomatisering met Atlas Cloud videogeneratiestappen
- MCP Server – Model Context Protocol-integratie voor AI-agentframeworks
-
Welke stack moet je daadwerkelijk gebruiken? {#decision-guide}
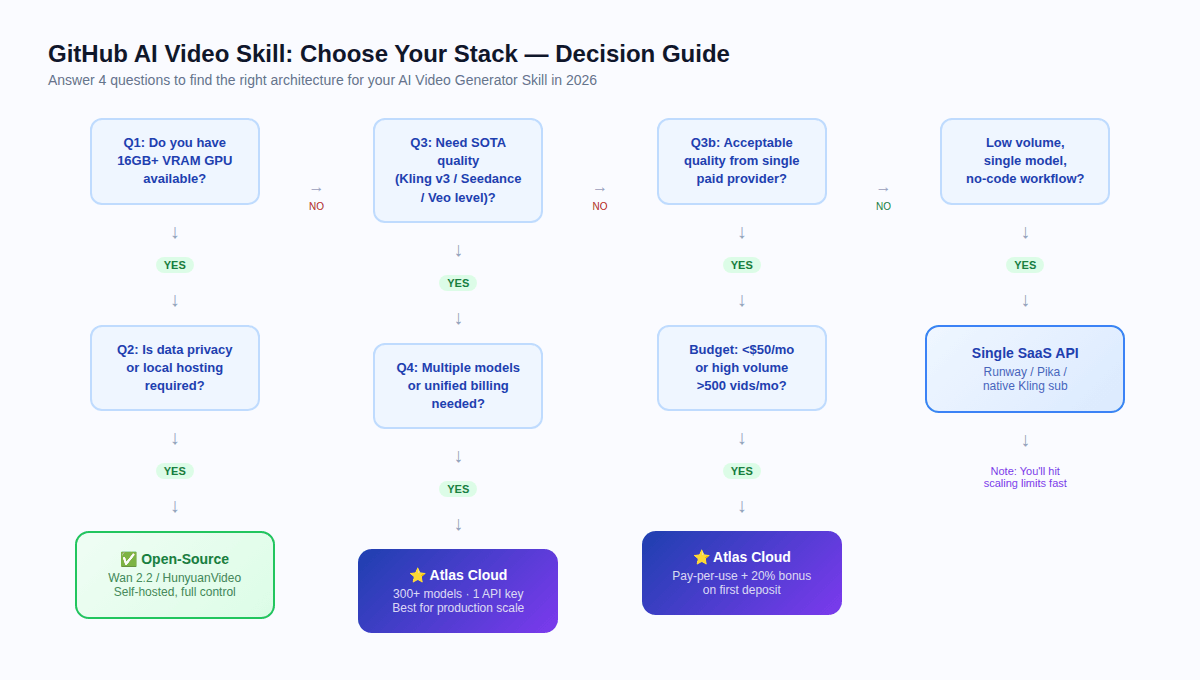
Doorloop deze vier vragen:
V1: Heb je 16GB+ VRAM GPU beschikbaar?
Zo nee → sla zelf hosten volledig over. Cloud-API is je enige praktische pad.
V2: Is gegevensprivacy of lokaal hosten vereist door regelgeving?
Zo ja + GPU beschikbaar → evalueer open-source (Wan 2.2 of HunyuanVideo afhankelijk van VRAM).
Zo ja + geen GPU → gebruik Atlas Cloud (HIPAA-compatibel, SOC-gecertificeerd) en beoordeel je specifieke regelgevingsvereisten.
V3: Heb je SOTA-kwaliteit nodig (Kling v3, Seedance 2.0, Veo-niveau)?
Zo ja → cloud-API vereist. Open-sourcemodellen hebben een betekenisvolle kwaliteitskloof ten opzichte van top propriëtaire modellen in 2026.
Zo acceptabele kwaliteit op open-source niveau → Wan 2.2 zelf gehost kan werken.
V4: Heb je meerdere modellen of unified facturering nodig?
Zo ja → Atlas Cloud. Het beheren van drie leveranciersaccounts op schaal heeft een verborgen operationele kost die pas zichtbaar wordt op productievolume.
Samenvatting aanbevelingen per gebruiksscenario
| Gebruiksscenario | Aanbevolen stack |
| Onderzoek / prototyping | Open-source (Wan 2.2, CogVideoX) |
| Social media-bureau, 500+/maand | Atlas Cloud + Kling v3.0 |
| Muziekvideo / karakteranimatie | Atlas Cloud + Seedance 2.0 |
| VFX / natuurkundesimulatie | Atlas Cloud + Sora 2 |
| Data-soeverein / offline | Zelf gehost (HunyuanVideo, Open-Sora 2.0) |
| SaaS met gelaagde modelkwaliteit | Atlas Cloud (één sleutel, meerdere modellen) |
| Hoogvolume open-source batch | Wan 2.2 zelf gehost (10.000+/maand drempel) |
-
FAQ {#faq}
V: Wat is een AI-videogeneratorvaardigheid?
Een herbruikbare codemodule of integratielaag die een applicatie verbindt met een AI-videogeneratiebackend – ofwel open-sourcegewichten of een cloud-API. Veelvoorkomende vormen: Python-klasse, ComfyUI-node, n8n-workflow, MCP Server-tool.
V: Wat is het minimale VRAM voor het zelf hosten van een open-source videomodel?
8 GB VRAM voor Wan 2.2 1.3B (acceptabele kwaliteit voor korte clips). 16 GB voor CogVideoX-1.5 of Open-Sora (betere kwaliteit). 24 GB+ voor Wan 2.2 14B. 60–80 GB voor HunyuanVideo of Open-Sora 2.0 volledig model.
V: Is open-source AI-videogeneratie echt gratis?
De modelgewichten zijn gratis. Inferentie is niet gratis – het vereist GPU-rekenkracht. Bij laag volume (<5.000 video's/maand) zijn cloud-API's zoals Atlas Cloud typisch goedkoper wanneer de totale eigendomskosten worden berekend.
V: Kan ik Atlas Cloud gebruiken voor beeld-naar-video (i2v) workflows?
Ja. Atlas Cloud ondersteunt i2v-varianten voor Kling, Seedance en Vidu. Let op: voor i2v-modellen accepteren sommige varianten geen aparte beeldverhoudingparameter – de uitvoerresolutie volgt de afmetingen van de invoerafbeelding.
V: Hoe gaat Atlas Cloud om met rate limiting?
Atlas Cloud ondersteunt Async/Webhook-patronen. Videogeneratietaken worden ingediend als taken; je applicatie ontvangt een taak-ID en wordt op de hoogte gesteld wanneer het renderen is voltooid. Dit voorkomt blokkering op schaal.
V: Wat is het beste model voor karakterconsistentie over shots?
Seedance 2.0's Universal Reference-systeem is de meest geavanceerde oplossing in 2026. Het stelt je in staat om referentievideo's, afbeeldingen en audio in te voeren om consistent uiterlijk en beweging van personages over gegenereerde clips te behouden.
V: Ondersteunt Atlas Cloud ComfyUI?
Ja. Atlas Cloud heeft native ComfyUI-integratie, evenals n8n-nodes en MCP Server-compatibiliteit.
V: Hoe gaan open-source videomodellen om met beeldverhoudingen?
Varieert per model. Open-Sora ondersteunt 16:9, 9:16, 1:1 en 2.39:1 via de --aspect_ratio-vlag. Wan 2.2 en LTX-Video ondersteunen meerdere verhoudingen. Voor i2v-workflows volgen de meeste modellen de beeldverhouding van de invoerafbeelding, ongeacht gespecificeerde parameters.
Samenvatting
Het landschap van 2026 valt in twee kampen uiteen, elk met hun eigen ideale toepassing:
Open-source is zinvol als je over extra GPU's beschikt, je 10K+ video's per maand verwerkt, gegevens je servers niet mogen verlaten, of je moet fine-tunen op je eigen propriëtaire footage.
Betaalde API's zijn de betere keuze als je de beste beschikbare kwaliteit nodig hebt, snelheid belangrijker is dan kosten, je onder de 5K video's per maand zit, of je meerdere modellen wilt mixen zonder leverancierscontracten te beheren.
Atlas Cloud overbrugt de twee: als een uniform platform dat toegang biedt tot 300+ modellen – waaronder de beste open-sourcemodellen via gehoste inferentie en elk belangrijk propriëtair model – via één enkele OpenAI-compatibele API-sleutel. Voor de meeste ontwikkelaars die productie-GitHub AI-videogeneratorvaardigheden bouwen in 2026, is het het pad met de minste wrijving van prototype naar productie.
Prijsinformatie in dit artikel is indicatief en kan wijzigen. Verifieer altijd de huidige tarieven op atlascloud.ai/pricing voordat je financiële prognoses maakt. Modelbeschikbaarheid kan per regio verschillen.
Atlas Cloud: atlascloud.ai – SOC I & II gecertificeerd · HIPAA-compatibel · VS · EU · Azië-infrastructuur


