GPT Image 2.5-snelheidslimieten variëren momenteel van 5 tot 250 afbeeldingen per minuut over de betaalde API-niveaus op OpenAI's Flare- en Sunburst-modelpagina's. Beide pagina's vermelden ook tokenlimieten. Controleer je daadwerkelijke accountconfiguratie voordat je werk inplant: ChatGPT-gebruikslimieten, OpenAI API-limieten en Atlas Cloud-endpointbeperkingen vereisen afzonderlijke controles.
De ongemakkelijke situatie ontstaat wanneer een campagne bijna klaar is en de laatste paar afbeeldingen nog ontbreken. Opnieuw op Generate klikken kan je laten zitten met een oorspronkelijke taak, een duplicaat, en geen duidelijk idee welke het eerst klaar zal zijn.
Deze handleiding verbindt de gepubliceerde limieten met een praktisch opleverplan. Je vindt een diagnostische tabel, een wachtrijprocedure, een uitgewerkte berekening voor 100 afbeeldingen en een gecontroleerde methode om te controleren of een succesvolle afbeelding daadwerkelijk aan de opdracht voldoet. Het bruikbare doel is een map met goedgekeurde assets vóór je deadline.
Documentatie gecontroleerd op 16 september 2026. Accountspecifieke capaciteit en exacte geconfigureerde kosten vereisen afzonderlijke verificatie.
Redactionele status: de toegangscontrole van de testomgeving verhinderde de zes geplande generaties. Het artikel bevat het reproduceerbare protocol en het officiële bronbewijs, maar de drie outputvergelijkingen en de vastlegging van een voltooide run blijven ontbreken.
Belangrijkste punten
- Bepaal je toegangsroute voordat je een limiet toepast.
- Controleer het account, project, model en eventuele gedeelde limiet.
- Stel de fout vast voordat je beslist of je opnieuw probeert.
- Houd rekening met goedgekeurde afbeeldingen, inclusief controle en herwerk.
GPT Image 2.5-snelheidslimieten zijn afhankelijk van je toegangsroute
Begin op de plek waar je op Generate hebt gedrukt. Een ChatGPT-abonnement, een OpenAI API-project en een Atlas Cloud-account zijn verschillende toegangsroutes. Een screenshot van de ene route kan de limiet van een andere niet vaststellen.
Controleer in ChatGPT je huidige abonnement, de toegang tot de afbeeldingsfunctie en het bericht dat wordt getoond wanneer het genereren stopt. Een betaald abonnement betekent geen onbeperkte limiet. Plan een werkdag niet rond een dagelijkse afbeeldingslimiet die je van het account van iemand anders hebt gekopieerd.
De release-discussie bevat gebruikers die vragen of Plus nog steeds een dagelijkse afbeeldingslimiet heeft. Dat bevestigt een zorg onder lezers; de getallen in die vragen vormen geen beleid. (Reddit-release-discussie, september 2026.)
Noteer voor de API de organisatie, het project en de exacte modelidentificatie die je applicatie gebruikt. Identificeer voor Atlas het geselecteerde endpoint en het account dat dit draait. Bepaal vervolgens het type limiet op basis van het zichtbare signaal.
| Limiettype | Zichtbaar signaal | Volgende controle |
|---|---|---|
| Productgebruikslimiet | ChatGPT zegt dat het maken van afbeeldingen tijdelijk niet beschikbaar is | Lees het huidige bericht van het account en eventuele reset-tijd |
| Afbeeldingen per minuut, IPM | Beperking van de afbeeldingssnelheid bij herhaalde inzendingen | Bevestig de afbeeldingslimiet voor die route en dat model |
| Tokens per minuut, TPM | Foutmelding of accountpaneel vermeldt een tokenlimiet | Inspecteer de betreffende tokenlimiet |
| Gelijktijdig werk | Taken wachten terwijl andere taken actief blijven | Tel het werk in uitvoering en verifieer het gelijktijdigheidsbeleid |
| Saldo of facturatiequotum | Facturatiewaarschuwing of quotumfout | Controleer tegoed, facturatiestatus en uitgavenbeperkingen |
| Modeltoegang | Machtiging- of model-niet-beschikbaar-reactie | Bevestig accountgeschiktheid en het exacte endpoint |
Houd dit onderscheid zichtbaar in het takenoverzicht van je team. Een marketeer die zegt 'ik zit aan de limiet' moet de route en het bericht noteren voordat een collega met troubleshooting begint.
Identificeer ook wie er nog meer gebruikmaakt van dezelfde accountresources. Een tweede werkstation biedt niet automatisch extra capaciteit. Vraag de accounteigenaar of de website, het interne hulpmiddel en nachtelijke taken uit dezelfde pool putten.
De vermelding 'Free: not supported' in de API-tabel betreft die API-modelcategorie. Het stelt niet vast of ChatGPT's gratis product afbeeldingen kan genereren.
GPT Image 2.5-snelheidslimieten per API-niveau
De officiële modelpagina's publiceren momenteel de volgende tabel voor beide varianten. Dit zijn openbare cijfers per gebruiksniveau, gecontroleerd op 16 september 2026, en geen garantie dat elk account exact deze configuratie heeft.
| OpenAI API-gebruiksniveau | TPM | IPM |
|---|---|---|
| Free | Niet ondersteund | Niet ondersteund |
| Tier 1 | 100,000 | 5 |
| Tier 2 | 250,000 | 20 |
| Tier 3 | 800,000 | 50 |
| Tier 4 | 3,000,000 | 150 |
| Tier 5 | 8,000,000 | 250 |
Bronnen: (OpenAI Flare-modelpagina, gecontroleerd september 2026) en (OpenAI Sunburst-modelpagina, gecontroleerd september 2026).
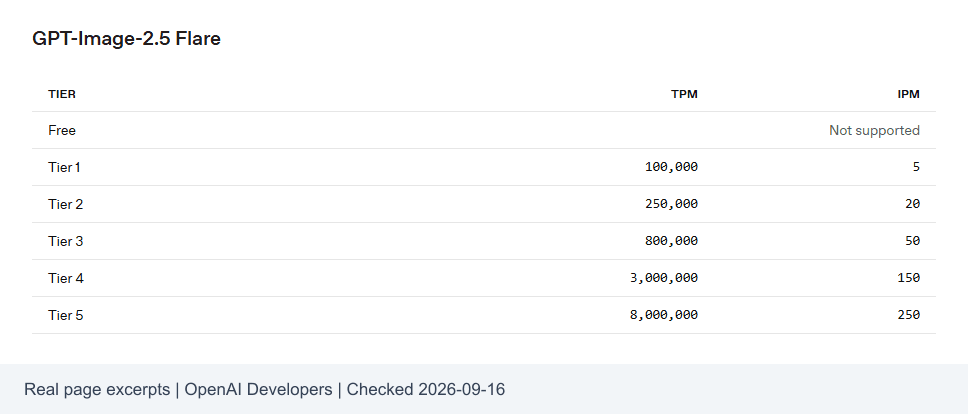 Officiële OpenAI-modelpagina met GPT Image 2.5-snelheidslimieten per gebruiksniveau
Bewijs van de officiële modelpagina. Controledatum: 16 september 2026.
IPM telt afbeeldingen; RPM telt verzoeken. Houd dat onderscheid aan in je planningsspreadsheet. Met één afbeelding per succesvol verzoek kunnen de twee tellingen in een eenvoudige schatting overeenkomen. Meerdere outputs, herhaalpogingen of ander endpointgedrag kunnen die aanname doorbreken.
Gebruik de tabel als uitgangspunt voor een gesprek over capaciteit. Noteer het gepubliceerde niveau en vergelijk dit met de limieten die zichtbaar zijn op het account dat het werk daadwerkelijk uitvoert. Als ze verschillen, onderzoek dan eerst voordat je je vastlegt op een deadline.
Overeenkomende tabellen tonen niet aan dat Flare en Sunburst een taak in dezelfde tijd voltooien. Ze bewijzen ook niet dat het wisselen tussen de varianten hun limieten bij elkaar optelt. Bevestig eventuele gedeelde limieten in de accountconfiguratie.
Een team dat een campagne voor vrijdag voorbereidt, kan dit omzetten in een korte preflight: identificeer de productieroute, verifieer de huidige limiet, controleer andere geplande workloads en wijs één persoon aan om de wachtrij in de gaten te houden. Sla de controledatum op, zodat een oude screenshot geen blijvende operationele aanname wordt.
Vermenigvuldig een minuutlimiet niet met het aantal minuten in een dag en beloof niet net zoveel afgewerkte afbeeldingen. Zo'n berekening houdt geen rekening met idle-tijd, generatielatentie, andere beperkingen en afgekeurde outputs.
Diagnosticeer GPT Image 2.5-snelheidslimieten voordat je opnieuw probeert
Sla de fouttekst, HTTP-status, tijdstempel en eventuele requestidentificatie op voordat je iets wijzigt. Een screenshot met alleen '429' laat te veel onbekend.
OpenAI's documentatie beschrijft organisatie- en projectlimieten, gedeelde modelpools, responseheaders en de verwerking van tijdelijke fouten. Het adviseert om minimaal zo lang te wachten als een opgegeven Retry-After aangeeft, jitter toe te voegen en snelle herhaalde fouten te vermijden, omdat die de minuutlimiet kunnen verbruiken. (OpenAI-snelheidslimieten, gecontroleerd september 2026.)
De volgende diagnostische procedure is een voorstel voor applicatieontwerp. Foutlabels en herstelopties moeten worden gekoppeld aan het platform dat je daadwerkelijk gebruikt.
| Zichtbare situatie | Controleer eerst | Actie |
|---|---|---|
| Tijdelijke 429 | Fouttekst en eventuele wacht- of reset-hint | Pauzeer de betreffende wachtrij en verlaag daarna het verzendtempo |
OpenAI insufficient_quota | Saldo, facturatiestatus en accountgeschiktheid | Los het accountprobleem op; stop automatische herhaalpogingen |
| Time-out na verzending | Origineel requestrecord, taak-ID indien beschikbaar, geschiedenis | Verifieer de oorspronkelijke taak voordat je opnieuw verzendt |
| Lange wachtrij | Wachtende status en aantal actieve taken | Blijf wachten zolang de taak geldig is; onderzoek vertragingen afzonderlijk |
| Afwijzing op parameter of inhoud | Specifieke validatie- of afwijsreden | Corrigeer het verzoek; classificeer dit niet als een herhaalpoging vanwege een snelheidslimiet |
De OpenAI-code in de tabel is een OpenAI-specifiek diagnostisch voorbeeld. Het is geen belofte dat Atlas hetzelfde foutobject retourneert of dezelfde headers ondersteunt.
Bij een time-out moet je onderscheid maken tussen wat je weet en wat je vermoedt. 'Mijn client is gestopt met wachten' bewijst niet of de server de taak heeft aanvaard. Markeer het lokale record als onzeker en controleer de oorspronkelijke bewerking via het status- of geschiedenismechanisme dat de route biedt.
Als er geen verificatiemechanisme bestaat, geef die onzekerheid dan door aan een operator. Blind opnieuw verzenden kan een nieuwe factureerbare taak opleveren. Leg dat risico vast voordat iemand besluit om opnieuw te proberen.
Gebruik voor de reset-timing de response of het accountbericht dat relevant is voor de limiet die je hebt bereikt. Ga er niet vanuit dat elke beperking om middernacht of precies 60 seconden na de fout wordt gereset.
Bewaar het bewijsmateriaal na herstel. Een klein incidentrecord met de route, de oorspronkelijke fout, de wachtduur en de uiteindelijke uitkomst helpt de volgende operator om een accountprobleem te onderscheiden van een verkeerspiek.
Ga met GPT Image 2.5-snelheidslimieten om met een wachtrij
Een wachtrij geeft je team één plek om te beslissen wat er als volgende wordt uitgevoerd. Voor een kleine campagne zijn een spreadsheet en één operator misschien voldoende. Een applicatie kan dezelfde beslissingen implementeren in een duurzame taakopslag.
Gebruik deze SOP in zes stappen:
- Wijs een stabiel bedrijfs-ID toe. Noteer de promptversie, gewenste output, model, afmetingen, kwaliteit en deadline. Een herziene opdracht krijgt een nieuwe versie.
- Controleer bestaand werk. Retourneer de opgeslagen output voor een voltooide taak. Laat een actieve of onzekere taak in verificatie in plaats van een nieuwe inzending te maken.
- Stuur tempo en gelijktijdigheid afzonderlijk aan. Laat werk alleen toe wanneer het lokale ratebudget en een actieve slot beschikbaar zijn. Herhaalpogingen gebruiken dezelfde toelatingscontroles.
- Volg een wachtaanwijzing van de server. Wacht bij een bevestigde fout die opnieuw kan worden geprobeerd ten minste de aangegeven duur en voeg wat willekeur toe.
- Gebruik anders een begrensde backoff. Verhoog de vertragingen tussen pogingen, voeg jitter toe en stel een maximum aan de vertraging. Houd de algehele deadline van de taak in zicht.
- Stop bewust. Wanneer het budget voor herhaalpogingen of de deadline is bereikt, sla dan het laatste bewijsmateriaal op en stuur de taak ter beoordeling.
Deze platformneutrale pseudocode illustreert planningsbeslissingen. Het is geen Atlas SDK of endpointcontract.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt_after(delay + random_jitter) 18 19save_final_state_for_review()
De atomaire claim is belangrijk wanneer twee workers dezelfde wachtrijregel zien. Beide mogen niet onafhankelijk concluderen dat de taak vrij is om te verzenden. Bewaar de verzendstatus voordat een worker verdwijnt of opnieuw start.
Application-level-deduplicatie laat nog steeds een lastig venster: een service kan een verzoek accepteren vlak voordat de client de response verliest. Endpoint-idempotentie kan sommige risico's op dubbele verzending aanpakken wanneer dit is gedocumenteerd. Een lokaal bedrijfs-ID kan alleen geen exactly-once-uitvoering garanderen, en deze handleiding gaat er niet vanuit dat Atlas een bepaalde idempotentieheader accepteert.
Prioriteer op basis van de leveringsbehoefte. Voltooi de ontbrekende afbeelding van de goedgekeurde campagne voordat je optionele varianten toelaat. Houd een korte operatornotitie bij met de reden waarom het werk is gestopt, zodat een collega kan hervatten zonder te gissen.
Plan 100 afbeeldingen rond GPT Image 2.5-snelheidslimieten
Gebruik twee tellers: gegenereerde outputs en geaccepteerde deliverables. De tweede teller vertelt een campagne-eigenaar of het werk gereed is.
Beschouw een hypothetisch planningsvoorbeeld, met één output per taak. Ga uit van een effectieve limiet van 5 IPM, een gemiddelde bezettingstijd van 60 seconden en maximaal 2 gelijktijdige taken. Deze invoerwaarden zijn illustratief, niet gemeten door Atlas of OpenAI.
| Planningsinput of -berekening | Hypothetische waarde | Interpretatie |
|---|---|---|
| Benodigde goedgekeurde afbeeldingen | 100 | Het daadwerkelijke leveringsdoel |
| Effectieve afbeeldingslimiet | 5 IPM | Veronderstelde accountcapaciteit |
| Benodigde afbeeldingslimiet voor 100 outputs | 100 ÷ 5 = 20 minuten | Quotumcapaciteitsvereiste, geen voltooiingsbelofte |
| Gelijktijdige taken | 2 | Verondersteld maximum in uitvoering |
| Gemiddelde slotbezetting | 60 seconden | Van inzending tot voltooiing |
| Capaciteit op basis van gelijktijdigheid | 2 × 60 ÷ 60 = 2 afbeeldingen/minuut | Lager dan de afbeeldingslimiet |
| Verondersteld acceptatiepercentage | 80% | Vereenvoudigde schatting voor planning |
| Generatielimiet voor 100 geaccepteerde afbeeldingen | 100 ÷ 0.8 = 125 outputs | Inclusief een ruw herwerkbudget |
| Capaciteitstijd bij 2 outputs/minuut | 125 ÷ 2 = 62.5 minuten | Exclusief extra controle- en overdrachtswerk |
Een nuttige benadering is:
plaintext1sustainable images/minute ≈ minimum of: 2 image allowance 3 request allowance × images per request 4 token allowance ÷ applicable tokens per image 5 concurrency × 60 ÷ average occupancy seconds
Gebruik vergelijkbare eenheden en daadwerkelijke accountmetingen. Als tokenverbruik niet beschikbaar is, laat die term dan open in plaats van deze te schatten op basis van het aantal woorden in de prompt. Deze formule beschrijft een planningsmodel, niet de implementatie van de provider.
De schatting van 125 outputs gaat uit van een stabiele acceptatiekans over pogingen heen. Echt herwerk kan gecorreleerd zijn: een prompt die herhaaldelijk objecten verkeerd telt, kan blijven falen totdat iemand deze aanpast. Bekijk terugkerende defecten voordat je meer pogingen koopt.
Verschillend werk vereist verschillende acceptatiecriteria:
- Wekelijkse inhoudsillustraties: het onderwerp moet overeenkomen met het artikel en de uitsnede moet werken op publicatieformaat.
- Productconceptmateriaal: de afbeelding moet de vereiste vorm en plaatsing behouden. Een conceptafbeelding kan geen vervanging zijn voor geverifieerde productfotografie.
- Educatieve of receptillustraties: aantallen, objecten en volgordebijzonderheden moeten aansluiten bij de uitleg. Een extra ingrediënt kan lezers misleiden.
Voeg tijd voor downloaden, controle, revisie en overdracht toe aan het schema. Als één persoon elke asset beoordeelt, meet dan ook het tempo van die persoon.
Splits vóór een deadline essentiële afbeeldingen van optionele varianten. Volg gereed, afgekeurd, actief en onzeker onafhankelijk van elkaar. Een map met 100 bestanden kan nog steeds enkele goedgekeurde deliverables tekortkomen.
Verminder herwerk voordat je je limieten verhoogt
Definieer een goedgekeurd resultaat voordat je op Generate drukt. Dat maakt de beslissing herhaalbaar en voorkomt dat een overtuigend ogende afbeelding doorglipt met een verkeerd aantal of onbruikbare tekst.
Het gecontroleerde protocol hier gebruikt GPT Image 2.5 Flare Text-to-Image, één PNG per taak, op 2048x1152. Voer voor elke opdracht eerst max uit en daarna high, terwijl alle andere beschikbare instellingen ongewijzigd blijven. Bewaar de originelen en bekijk beide op hetzelfde weergaveformaat.
Bewijsstatus: De zes Flare-outputs hieronder zijn gegenereerd voor de drie opdrachten op 2048x1152. Elk paar bevat één MAX- en één HIGH-resultaat. Deze voorbeelden ondersteunen de hier getoonde controles, maar zes outputs vormen geen brede kwaliteitsrangschikking of claim over acceptatiepercentages.
A. Objecttelling en compositie
Kopieer deze prompt ongewijzigd:
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged in two neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Tel elke tomaat, controleer de twee rijen en inspecteer alle vier de randen van de plank. Kijk daarna naar verboden objecten. Accepteer het beeld alleen wanneer de volledige opdracht slaagt. Een correct aantal tomaten met een afgesneden plank vereist nog steeds een beslissing over herstel of regeneratie.
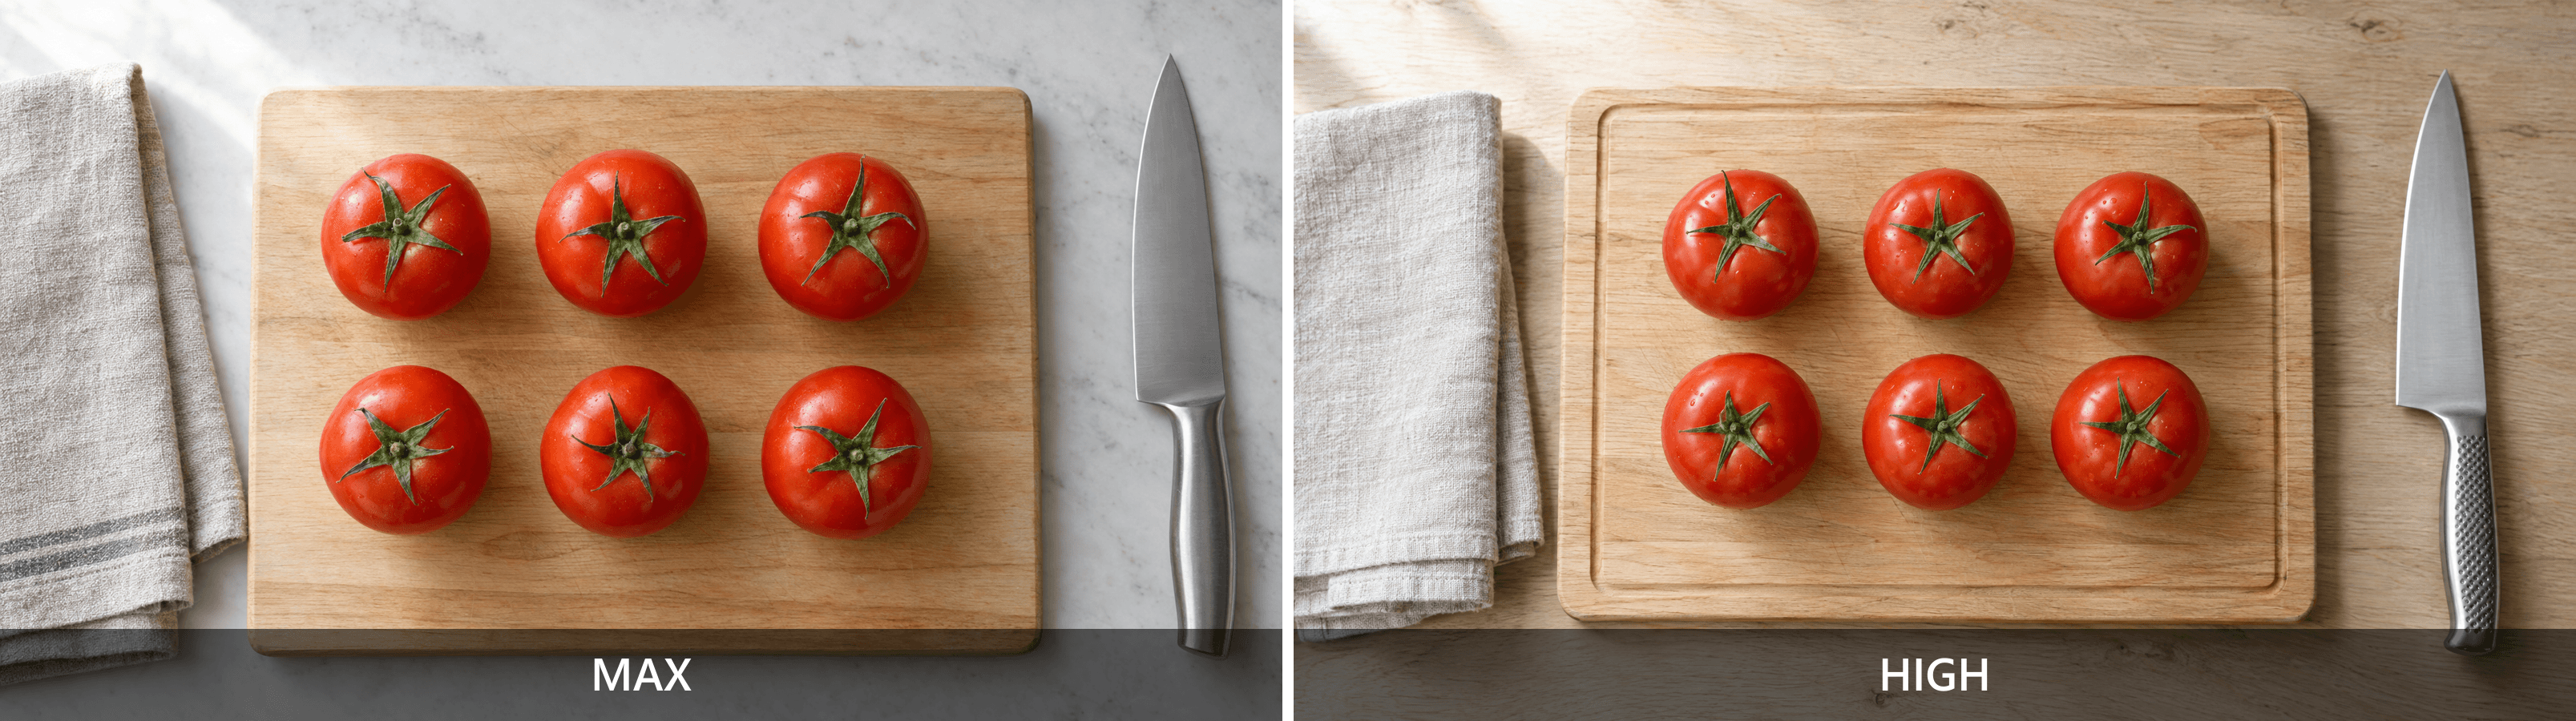 High en max Flare-outputs voor de zes-tomaten-telling en volledige-plank-controle
Links: MAX. Rechts: HIGH. Beide outputs tonen zes tomaten in twee rijen; inspecteer de volledige plank, het mes, de handdoek en eventuele verboden objecten voordat je een van beide resultaten goedkeurt.
B. Ruimte voor een krantenkop
plaintext1Create a realistic editorial still-life photograph for a home-office 2article. Place an open unbranded notebook, one black pen, and one plain 3ceramic coffee cup entirely within the left half of a pale oak desk. 4Keep the right 45 percent of the frame empty, showing only the desk 5surface so a designer can add a headline later. No laptop, no phone, 6no plants, no visible writing, no text, and no logos. 7Use soft daylight and a slightly elevated camera angle. 8Horizontal 16:9 composition.
Bij een breedte van 2048 pixels begint de meest rechtse 45% ongeveer bij x = 1126. Controleer dat gebied op het origineel. Plaats vervolgens een echte kop in een lokaal lay-outvoorbeeld om de leesbaarheid te beoordelen. Een hulplijn is een postproductie-annotatie, geen onderdeel van de gegenereerde scène.
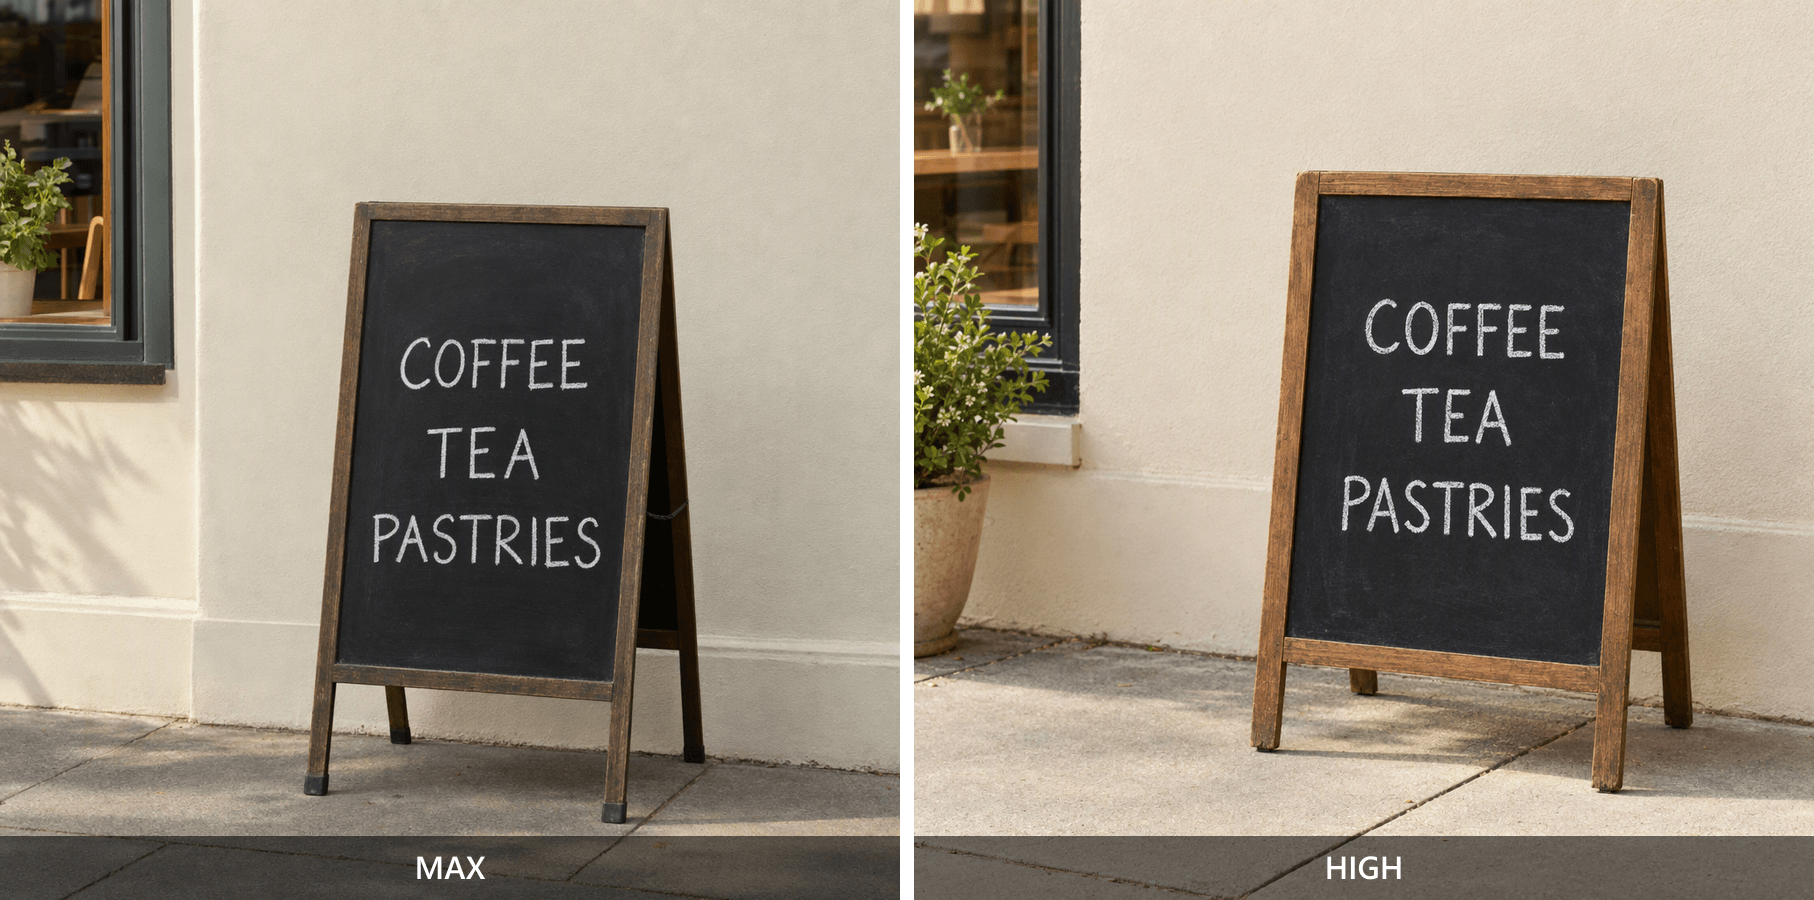 High- en max-home-office-outputs met het gevraagde kopgebied aan de rechterkant gemarkeerd
Links: MAX. Rechts: HIGH. Beide outputs behouden een bruikbaar bureaublad aan de rechterkant voor een kop; beoordeel dat lege gebied op het uiteindelijke weergaveformaat.
C. Exacte korte tekst
plaintext1Create a realistic photograph of a small freestanding black chalkboard 2outside a quiet neighborhood cafe. The board must contain exactly 3these three lines of clearly readable white lettering: 4COFFEE 5TEA 6PASTRIES 7Do not add prices, extra words, logos, or other readable signs. 8Show the full board with a simple cream-colored wall behind it, 9warm morning daylight, and a small area of clean pavement. 10No people. Horizontal 16:9 composition.
Lees elke letter in het origineel en in het voorbeeld op publicatieformaat. Controleer de achtergrond op extra leesbare borden. Dit is een door AI gegenereerde testscène, geen foto van een echt café. Bewaar spelfouten in het bewijsmateriaal in plaats van ze weg te retoucheren.
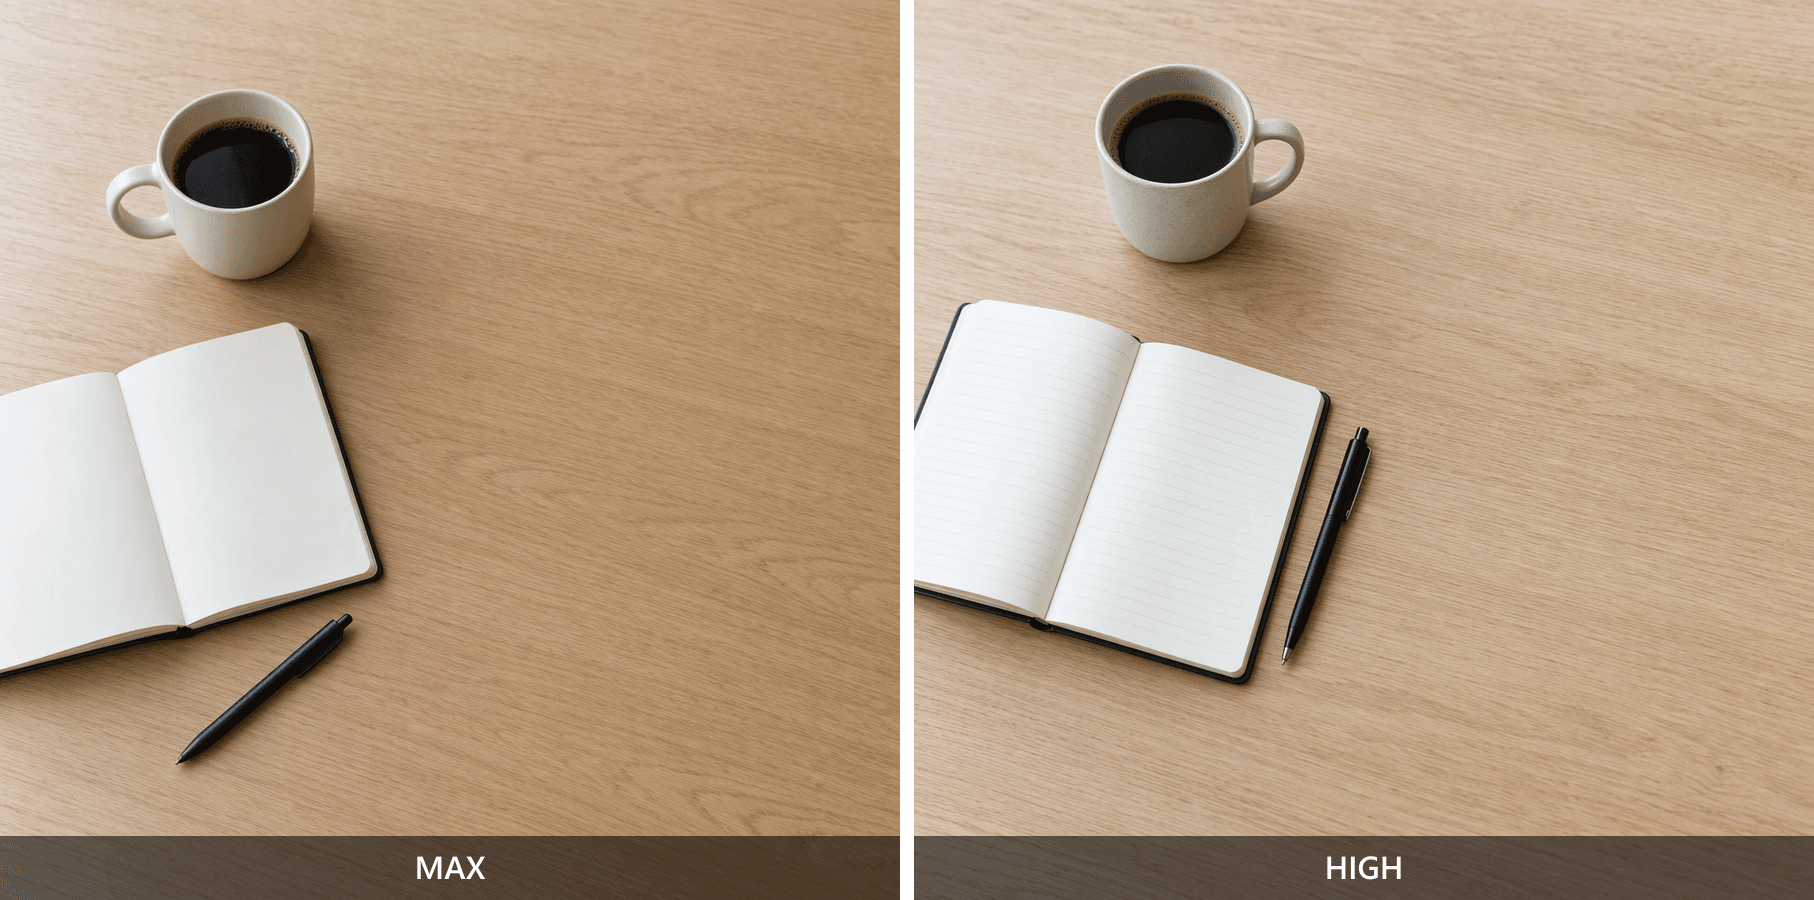
High- en max-AI-gegenereerde caféborden voor het controleren van COFFEE, TEA en PASTRIES
Links: MAX. Rechts: HIGH. Lees elke regel op publicatieformaat en controleer de achtergrond op extra leesbare tekst voordat je een resultaat goedkeurt.
Zes outputs kunnen een inspectieproces demonstreren. Ze kunnen geen succespercentage van het platform, productiedoorvoer of een plafond voor de snelheidslimiet vaststellen. Een enkel paar kan ook geen effecten van kwaliteitsinstellingen isoleren van de variabiliteit van de generatie.
Beoordeel een instelling op basis van de geaccepteerde asset en de geregistreerde kosten. Zonder exacte kosten blijft een kostenconclusie tussen high en max ongemeten. Als beide slagen, leg dat vast; als beide falen, herzie dan de opdracht voordat je dezelfde fout herhaalt.
Evalueer Atlas Cloud voor je afbeeldingsworkflow
Gebruik dezelfde representatieve taak om een toegangsroute te evalueren. Zo blijft de evaluatie verbonden met het werk dat je team moet opleveren.
De geselecteerde GPT Image 2.5 Flare Text-to-Image-pagina is het endpoint voor dit protocol. Open de pagina, bevestig de modelnaam, plak een van de bovenstaande volledige prompts en selecteer het gevraagde formaat en de kwaliteit.
Controleer wat het formulier daadwerkelijk bewaart nadat je een veld verlaat. Een ingetypte breedte die vóór verzending terugvalt, levert geen 2048-pixel-test op. Noteer de vastgelegde instellingen, voer één taak uit, wacht op een eindstatus en download de daadwerkelijke output.
Sla de taakidentificatie indien weergegeven, de verzendtijd, de voltooiingstijd en het resultaatbestand samen op. Maak voor de vergelijkingsrun een afzonderlijke taak en wijzig alleen de kwaliteit. Leid geen nieuwe output af uit voorbeeldafbeeldingen die al op de modelpagina worden getoond.
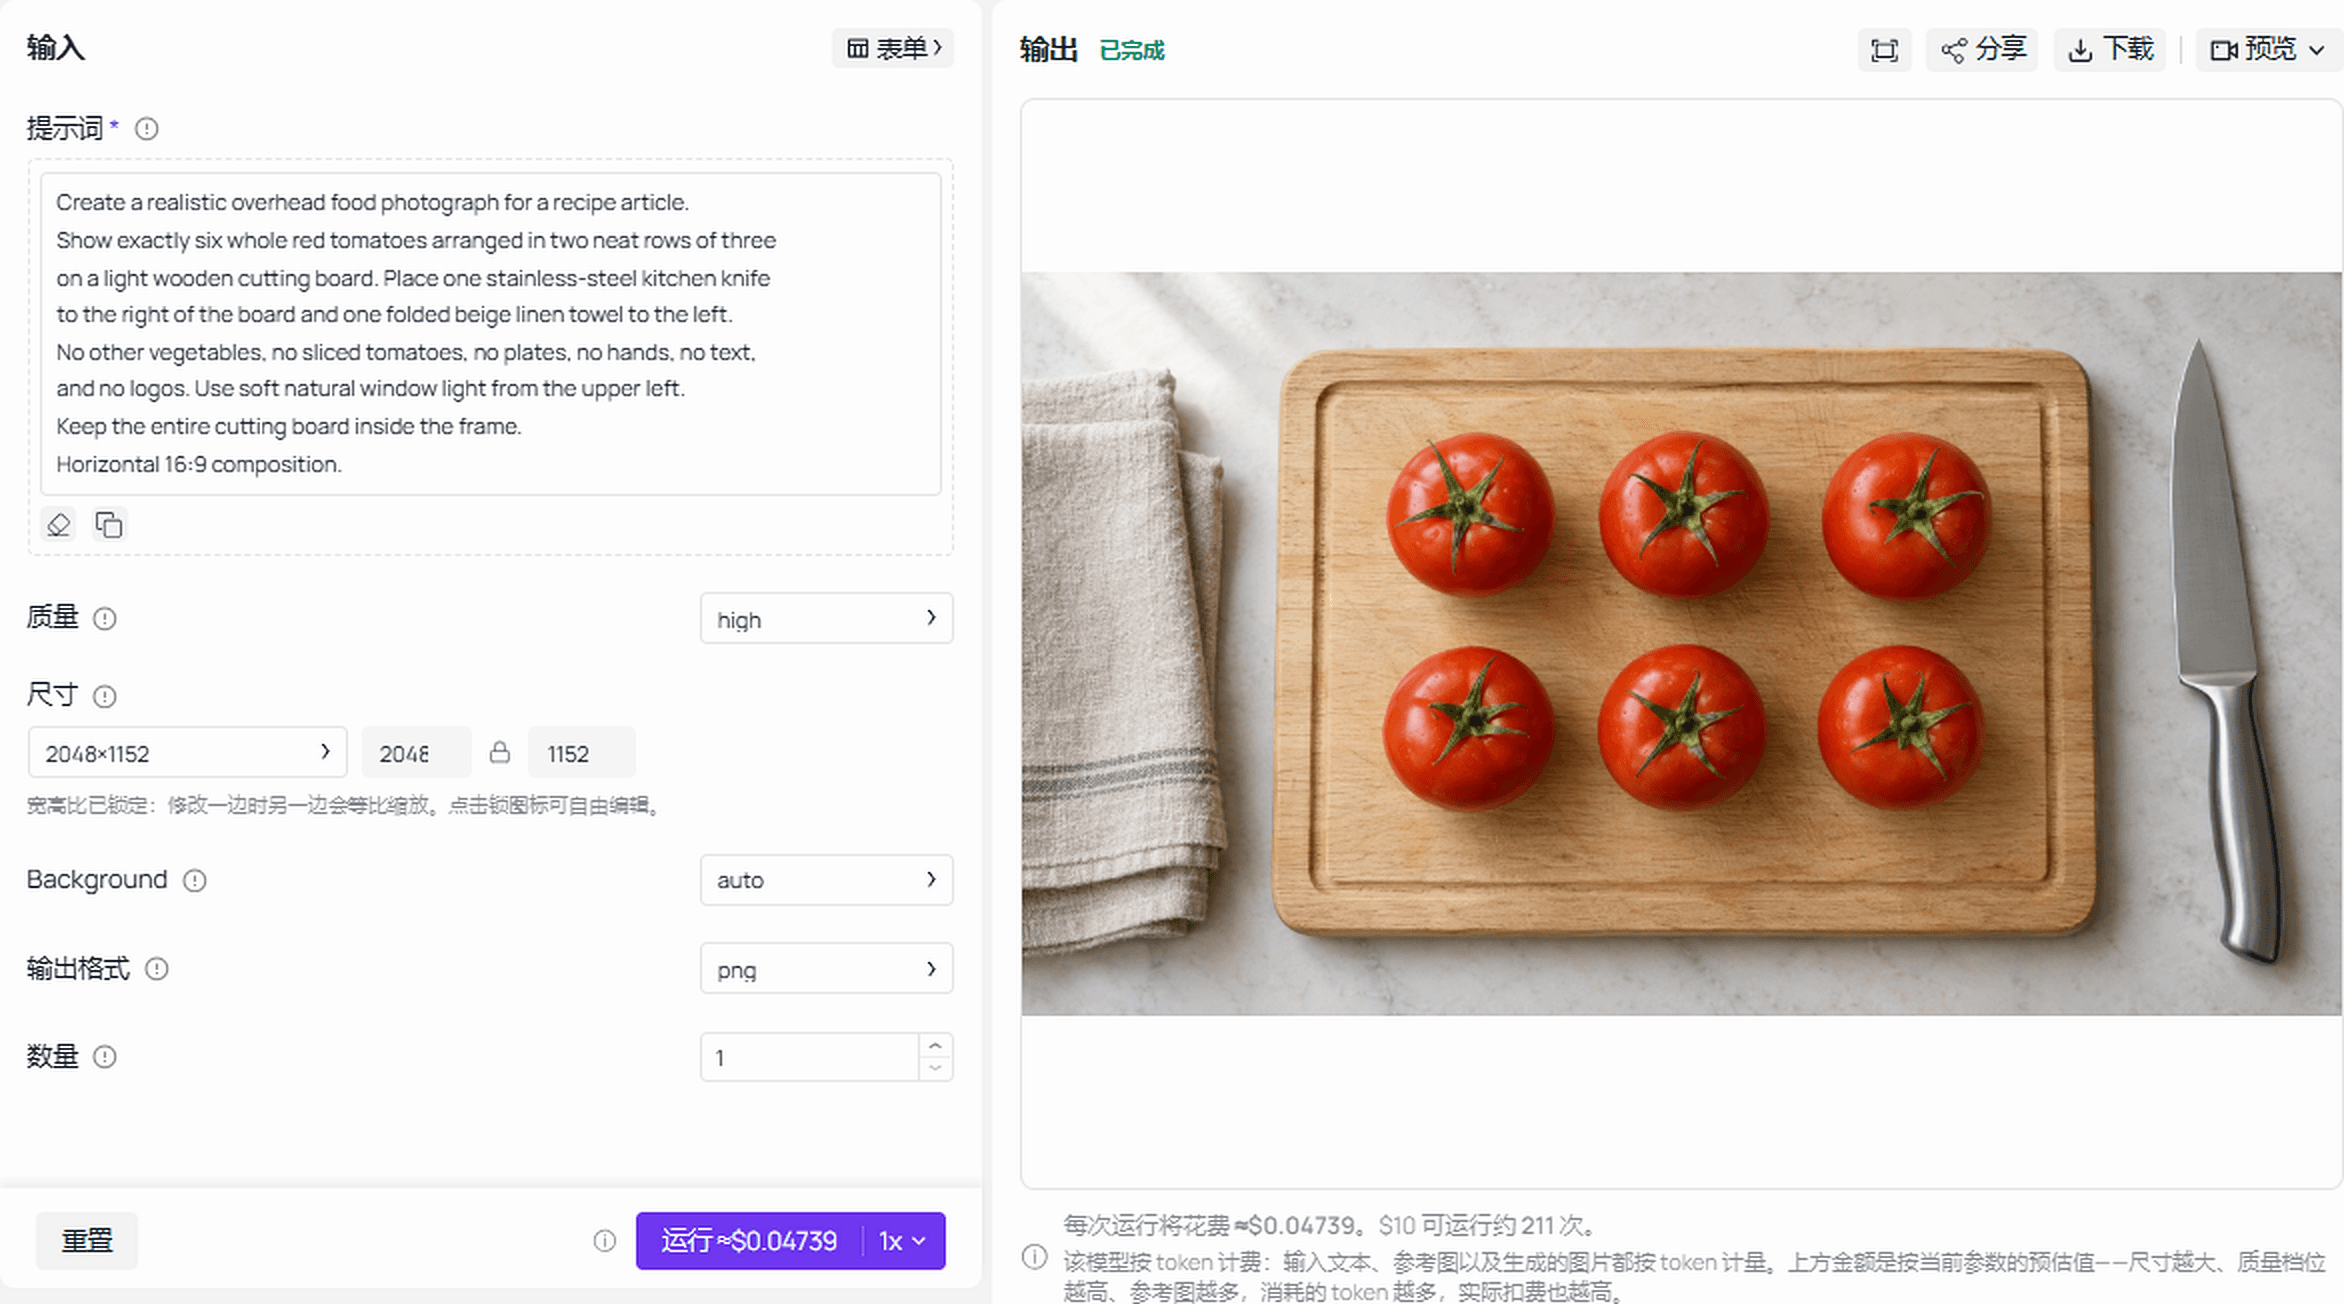 Voltooide Flare-run met de tomatenopdracht, actieve instellingen en gegenereerd resultaat
Voltooide Flare-run: het scherm toont de tomatenopdracht, HIGH-kwaliteit, formaat 2048x1152, PNG-output en het geretourneerde resultaat met zes tomaten.
Evalueer de route op vijf gebieden:
- Model en endpoint: bevestig Flare text-to-image in plaats van een edit-endpoint of een andere variant.
- Snelheidslimiet en gelijktijdigheid: verkrijg de toepasselijke accountlimieten en of workloads deze delen.
- Taakherstel: verifieer hoe het account actief werk, definitieve fouten en resultaten na een time-out weergeeft.
- Geconfigureerde kosten: controleer de eenheid, geselecteerde afmetingen, kwaliteit en eventuele kortingsvoorwaarden.
- Acceptatie en herwerk: bewaar de originele output en een korte reden voor elke afgewezen asset.
Gebruik de huidige modeldirectory als startpunt voor prijscontrole en inspecteer daarna de geselecteerde configuratie. Een afgeronde startprijs stelt de kosten voor 2048x1152 + max niet vast.
Atlas-accountgelijktijdigheid, productiedoorvoer, gedeelde limieten en facturering van mislukte taken zijn voor dit artikel niet onafhankelijk vastgesteld. Bevestig deze via het account. Taaktijden in een testomgeving kunnen ook geen productie-API-prestaties vaststellen.
Voer één representatieve prompt uit, inspecteer het resultaat en controleer je accountlimieten voordat je opschaalt.
GPT Image 2.5-snelheidslimieten FAQ
Hoeveel GPT Image 2.5-afbeeldingen kan ik per minuut genereren?
De betaalde OpenAI API-modelpagina's vermelden 5 tot 250 IPM. Gebruik de huidige instellingen van je account voor operationele planning, inclusief token- en eventuele andere toepasselijke beperkingen. Een gepubliceerde afbeeldingslimiet garandeert niet dat elke afbeelding binnen die minuut klaar is of door de controle komt.
Heeft ChatGPT Plus een vast dagelijks afbeeldingslimiet?
Dit artikel stelt geen universeel vast dagelijks aantal voor Plus vast. Controleer de huidige afbeeldingsgeneratieboodschap en abonnementsgegevens van je account. Gebruikersmeldingen kunnen helpen om een vraag te identificeren om te onderzoeken, maar een getal uit de sessie van iemand anders kan niet veilig het dagelijkse productiebudget van je team worden.
Hebben Flare en Sunburst dezelfde snelheidslimieten?
Hun officiële modelpagina's toonden bij controle op 16 september 2026 overeenkomende niveautabellen. Dat bewijst geen overeenkomende generatietijden of afzonderlijke capaciteitspools. Voordat je een gesplitste workload plant, bevestig je de limieten en delingsregels die voor beide varianten in je account gelden.
Waarom krijg ik een 429-fout terwijl ik nog tegoed heb?
Een saldo geeft antwoord op de vraag of er nog geld is; het geeft geen antwoord op de vraag of het huidige verzoek binnen een snelheidsbeperking past. Lees de fouttekst en eventuele wachtaanwijzing. Als de fout een account- of quotumprobleem identificeert, los dat probleem dan op in plaats van aan te nemen dat herhaalde vertraagde inzendingen het zullen oplossen.
Wanneer worden de snelheidslimieten van GPT Image 2.5 gereset?
Gebruik de relevante responseheaders of accountmelding. Verschillende beperkingen kunnen verschillende vensters hebben en er is hier geen enkele reset-tijd voor alle routes vastgesteld. Volg een opgegeven minimale wachttijd, verlaag het tempo van de wachtrij en behoud de oorspronkelijke taakstatus terwijl je beslist of een herhaalpoging gepast is.
Verwijdert Atlas Cloud de snelheidslimieten van GPT Image 2.5?
Nee. Evalueer Atlas als een toegangsoptie met zijn eigen endpointgedrag en accountbeperkingen. Bevestig die details voordat je het volume verhoogt. Een praktisch plan voor GPT Image 2.5-snelheidslimieten combineert geverifieerde capaciteit, gecontroleerde inzendingen, taakherstel en acceptatiecontroles die vermijdbaar herwerk verminderen.


