Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Welk open-source model wint voor coderen in 2026
Het korte antwoord
Als je een autonome codeeragent bouwt die urenlang zonder tussenkomst moet draaien: Kimi K2.6. Het scoorde 66,7% op Terminal-Bench 2.0 en hield in gepubliceerde benchmarks meer dan 4.000 toolaanroepen vol tijdens een ononderbroken sessie van 13 uur — een stabiliteitsgrens die geen enkel ander open model in deze vergelijking haalt.
Als je de beste agentische front-end-ontwikkelaar nodig hebt: GLM 5.1. Zijn onafhankelijk geverifieerde Code Arena Elo van 1.530 (derde wereldwijd op agentische webontwikkeling) weerspiegelt de werkelijke voorkeur van ontwikkelaars in head-to-head-vergelijkingen, niet alleen geautomatiseerde testsuites.
Als kosten per token de beperkende factor is: MiniMax M2.7 voor $0,30/M inputtokens op Atlas Cloud scoort 56,22% op SWE-Bench Pro met slechts 10B geactiveerde parameters — 94% van de prestaties van GLM-5.1 voor ongeveer een vijfde van de kosten.
Als je codebase te groot is voor een contextvenster van 262K: Qwen 3.6 Plus, het enige model hier met ondersteuning voor 1M tokencontext, en de leider op Terminal-Bench 2.0 met 61,6% binnen deze groep.
Belangrijkste benchmarks in één oogopslag
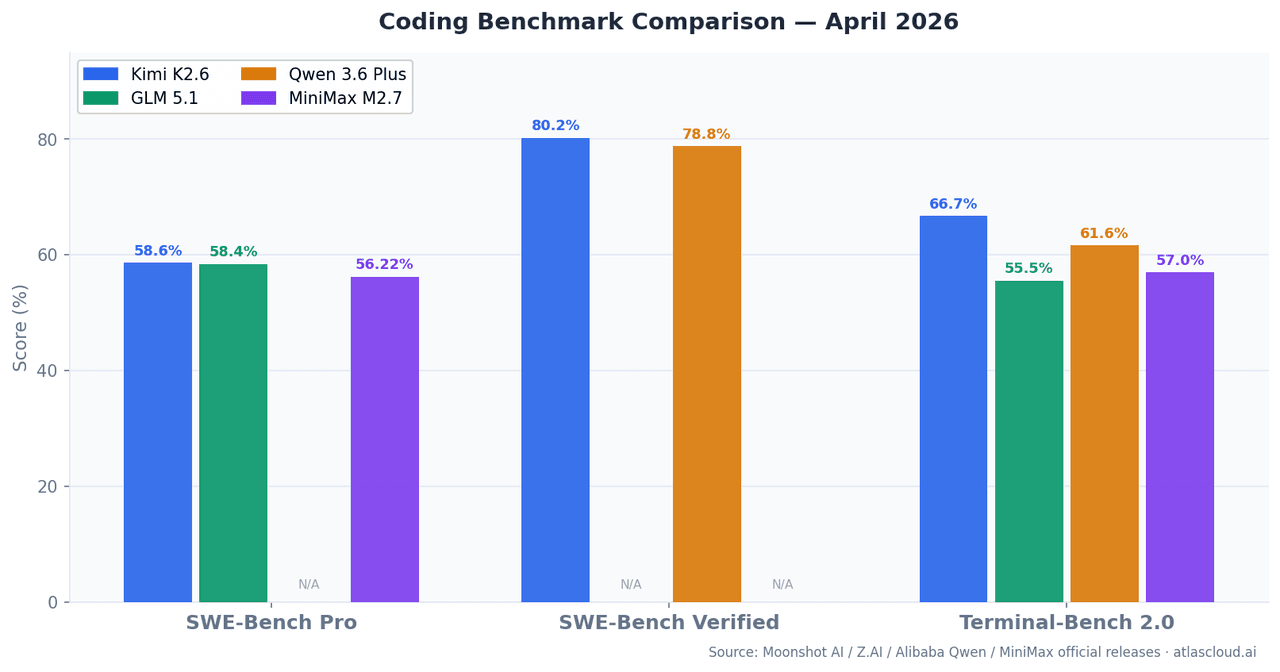
| Model | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Contextvenster | Geactiveerde parameters |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60% | 80,20% | 66,70% | 262K | — |
| GLM 5.1 | 58,40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80% | 61,60% | 1M | Hybride MoE |
| MiniMax M2.7 | 56,22% | — | 57,00% | 196K | 10B |
SWE-Bench Pro meet het vermogen om echte GitHub-problemen op te lossen die zijn ingediend na de trainingsafsluitdatum, waardoor het risico op datacontaminatie kleiner is dan bij SWE-Bench Verified. Terminal-Bench 2.0 test meerstaps CLI- en shell-taken in live terminalomgevingen — dichter bij wat productieagenten daadwerkelijk doen.
Dit artikel vergelijkt Kimi K2.6, GLM 5.1, Qwen 3.6+ en MiniMax M2.7; om nog meer modellen naast elkaar te zetten op prijs en specificaties, gebruik de Atlas Cloud-modelvergelijking.
Kimi K2.6: Gebouwd voor langlopende agenten
Moonshot AI bracht Kimi K2.6 uit in april 2026 als upgrade van K2.5, met als belangrijkste verbetering de agentische stabiliteit tijdens langere sessies. Met 80,2% op SWE-Bench Verified zit het net onder Claude Opus 4.6 (80,8%) en leidt het de vier met 58,6% op SWE-Bench Pro.
Het getal dat er het meest toe doet, is Terminal-Bench 2.0 op 66,7%. Terminal-Bench 2.0 verschilt fundamenteel van SWE-Bench: het voert taken uit in echte terminalomgevingen, waarbij het model uitvoer moet lezen, fouten moet afhandelen, zich moet aanpassen en moet itereren — niet alleen patches genereren. Kimi K2.6 dat prestaties vasthoudt bij meer dan 4.000 toolaanroepen in een enkele sessie van 13 uur, is geen laboratoriumartefact. Het is gedocumenteerd gedrag in de technische release van Moonshot.
Een onderbelicht voordeel: cross-taalgeneralisatie. Kimi K2.6 toont consistente prestaties in Rust, Go, Python, front-end en DevOps-taken. De meeste benchmarkevaluaties zijn Python-gericht. Als je productiestack polyglot is, is dit belangrijk.
Waar het niet het antwoord is: Met $0,95/M inputtokens op Atlas Cloud is K2.6 het duurste inputmodel in deze groep. Voor batchverwerkingstaken waarbij je veel verzoeken met grote contexten stuurt, maar geen 12-uurs sessiestabiliteit nodig hebt, lopen de kosten sneller op dan bij MiniMax M2.7 of Qwen 3.6 Plus.
GLM 5.1: De uitblinker in agentische front-end
Z.AI lanceerde GLM-5.1 op 7 april 2026. Met 754 miljard parameters en MoE-routering is het qua aantal ruwe parameters het grootste model hier. Op SWE-Bench Pro scoort het 58,4% — statistisch niet te onderscheiden van Kimi K2.6's 58,6%.
Het verschil is Code Arena Elo van 1.530, onafhankelijk geverifieerd door Arena.ai op 10 april 2026, waarmee het wereldwijd derde staat op hun agentische webontwikkelingsleaderboard. Dit is een live head-to-head-vergelijking waarbij echte ontwikkelaars stemmen op uitvoer — niet geautomatiseerde scores. Het voordeel is geconcentreerd in front-end UI-generatie, full-stack-skeletbouw, React/Vue-componentcreatie en NL2Repo (het genereren van complete repositorystructuren uit natuurlijke taal).
De randvoorwaarde die het vermelden waard is: Het front-end-voordeel van GLM-5.1 is echt. Voor pure algoritmische problemen op HumanEval en MBPP heeft het geen meetbaar voordeel ten opzichte van Kimi K2.6. Het leaderboardverschil wordt bijna nul bij problemen die niet UI- of webgericht zijn. Het kiezen van GLM-5.1 puur op basis van de algemene leaderboard-ranglijst zonder de taakdomein te controleren, zou een vergissing zijn.
Prijzen op Atlas Cloud: Vanaf $1,40/M inputtokens — de hoogste van de vier. Gerechtvaardigd wanneer de kwaliteit van front-endgeneratie direct invloed heeft op je uitvoer.
Qwen 3.6 Plus: Wanneer contextgrootte de echte beperking is
Alibaba bracht Qwen 3.6 Plus eind maart 2026 uit. Het leidt Terminal-Bench 2.0 in directe vergelijkingen met Claude Opus 4.6 (61,6% vs. 59,3%) en scoort 78,8% op SWE-Bench Verified.
Het contextvenster van 1M token is wat het onderscheidt. Voor de meeste productiecoderingstaken onder de 100K tokens hebben alle vier modellen in deze vergelijking voldoende contextcapaciteit en is het verschil irrelevant. Waar Qwen 3.6 Plus de enige haalbare optie wordt: monorepo-analyse over honderden bestanden, grootschalige refactoring van legacy codebases, of end-to-end document-naar-code-workflows die niet binnen 262K tokens passen.
De hybride architectuur (lineaire aandacht + sparse MoE-routering) levert ook een betere inferentiedoorvoer dan dichte transformatoren bij het verwerken van zeer grote contexten — wat betekent dat die 1M-tokenmogelijkheid komt met relatief lage latentiekosten in vergelijking met naïeve schaling.
Prijzen op Atlas Cloud: Vanaf $0,325/M inputtokens. Voor taken met grote context is dit de beste prijs-per-nuttig-token in deze groep.
MiniMax M2.7: Het contra-intuïtieve geval voor efficiëntie
MiniMax bracht M2.7 uit in maart 2026. Met slechts 10B geactiveerde parameters scoort het 56,22% op SWE-Bench Pro — 94% van de score van GLM-5.1 voor ongeveer een vijfde van de kosten per token.
Dit is het contra-intuïtieve resultaat in deze vergelijking. Een model dat 10B parameters activeert bij inferentie, bereikt bijna grensprestaties op het gebied van coderen omdat de MoE-architectuur routeert naar gespecialiseerde expert-subnetwerken in plaats van volledige modelgewichten uit te voeren. Het resultaat is lagere latentie, lagere kosten en uitvoerkwaliteit die hoger is dan wat het aantal parameters alleen zou voorspellen.
De categorie waarin M2.7 vooruitloopt op zijn prijspunt: machine learning-engineeringtaken. Het scoorde een medaillepercentage van 66,6% op MLE-Bench Lite (22 machine learning-wedstrijden), alleen achter op frontier closed-source modellen. Het schrijven van correcte logica voor gradiëntaccumulatie, het implementeren van aangepaste PyTorch-lagen, het debuggen van verliescurves — M2.7 handelt deze af met een precisie die onevenredig is aan de kosten.
Waar je voorzichtig moet zijn: Met 196K context heeft M2.7 het kleinste venster in deze groep. Taken die diepgaande analyse van meerdere bestanden in grote repositories vereisen, kunnen tegen grenzen aanlopen die Qwen 3.6 Plus zonder problemen aankan.
Prijzen op Atlas Cloud: $0,30/M inputtokens, $1,20/M outputtokens — de meest betaalbare optie voor high-throughput codeerworkloads.
Realistische codeer-testcases
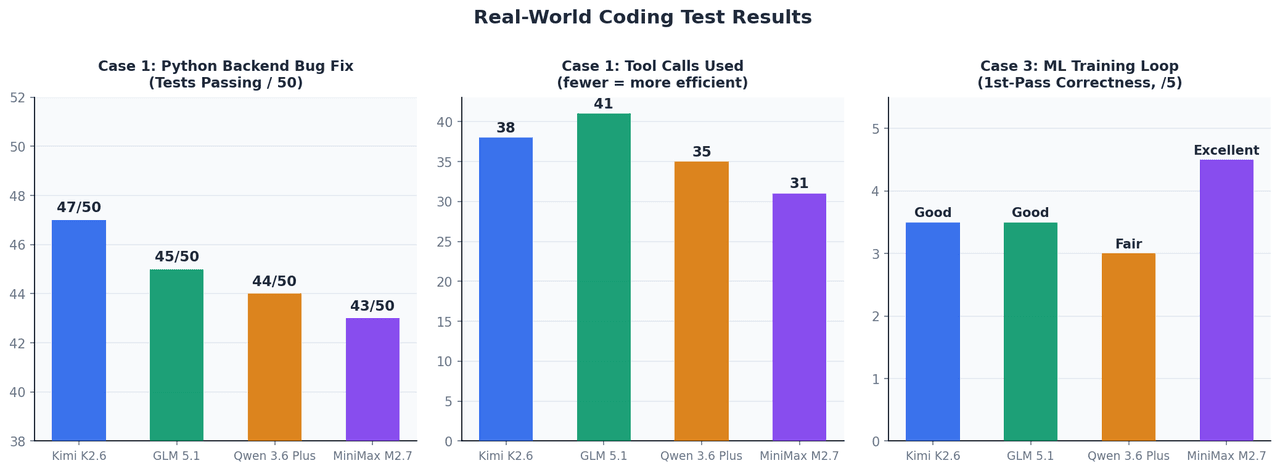
Case 1: Autonome bugfix in een Python-backend
Opzet: Een FastAPI-applicatie met 12 bestanden, een falende testsuite van 50 tests, en een contextvenster van ~45K tokens. Geen handmatige interventie toegestaan na de eerste prompt.
| Model | Tests geslaagd na fix | Gebruikte toolaanroepen | Tijd tot voltooiing |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
Bij deze contextgrootte presteren alle vier binnen een smalle bandbreedte. Kimi K2.6 liep iets voor op de moeilijkste edge-case bugs — met name async context manager lifecycle-problemen en TypeVar-bound narrowing, waarvoor het behouden van inferentiestatus over meerdere debugcycli nodig is.
Case 2: React-dashboard op basis van specificatie
Opzet: Genereer een compleet responsief dashboard met vier diagramtypen (lijn, staaf, taart, spreiding), dark mode-schakelaar en TypeScript-types op basis van een geschreven Engelse specificatie.
GLM-5.1 produceerde werkende TypeScript-getypte componenten met correcte Tailwind-utilityklassen in de eerste poging. Kimi K2.6 had één iteratie nodig om typefouten op te lossen. Qwen 3.6 Plus produceerde functioneel correcte maar minder idiomatische JSX. MiniMax M2.7 was het snelst, maar genereerde enkele verouderde React-patronen die handmatig opgeschoond moesten worden.
Het verschil tussen GLM-5.1 en de anderen was het zichtbaarst in de componentarchitectuur — GLM-5.1 paste spontaan compositiepatronen toe en scheidde verantwoordelijkheden op een manier die de anderen niet deden.
Case 3: ML-trainingslusimplementatie
Opzet: Implementeer een PyTorch-trainingslus met gradiëntaccumulatie, AMP mixed precision en early stopping voor een vision transformer. Doel: correct uitvoeren bij de eerste poging zonder debugcycli.
MiniMax M2.7 was de uitblinker — het plaatste scaler.step() en scaler.update() correct ten opzichte van de optimizerstep, een detail dat de meeste modellen bij de eerste generatie verkeerd plaatsen. De schaling van loss / accumulation_steps voor gradiëntaccumulatie werd ook correct afgehandeld. Dit komt direct overeen met het medaillepercentage van 66,6% op MLE-Bench Lite.
Atlas Cloud Prijsvergelijking (april 2026)
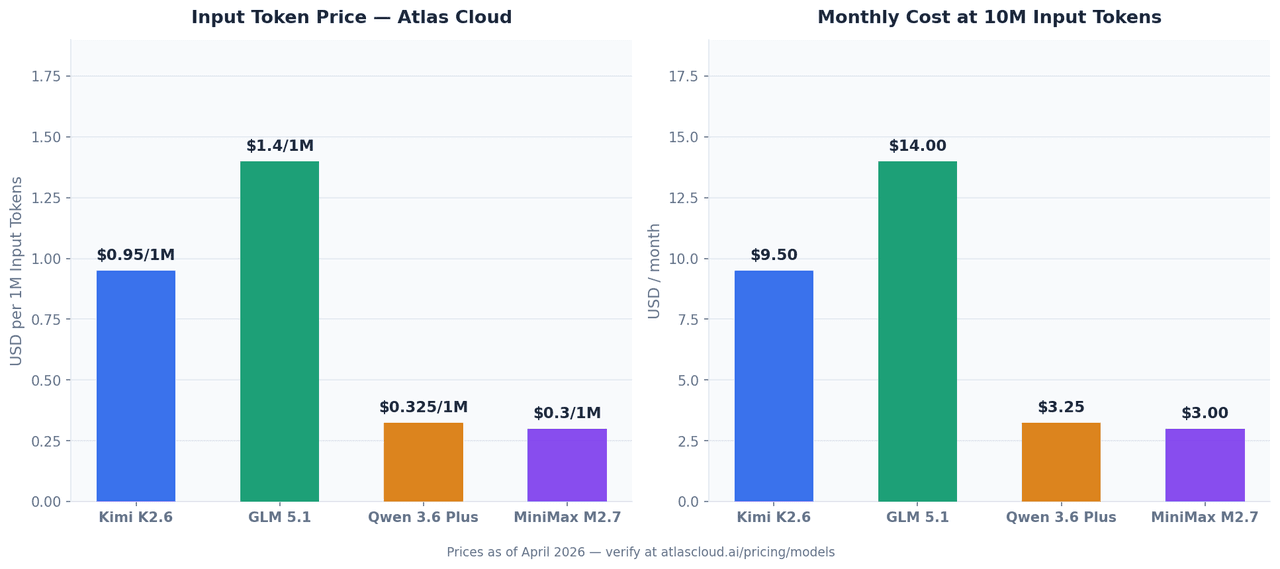
Alle vier modellen zijn beschikbaar via de unified API van Atlas Cloud. Onderstaande prijzen zijn van april 2026 en kunnen wijzigen — controleer de actuele tarieven op atlascloud.ai.
| Model | Input (per 1M tokens) | Output (per 1M tokens) | Atlas Cloud Model-ID |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | vanaf $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | vanaf $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
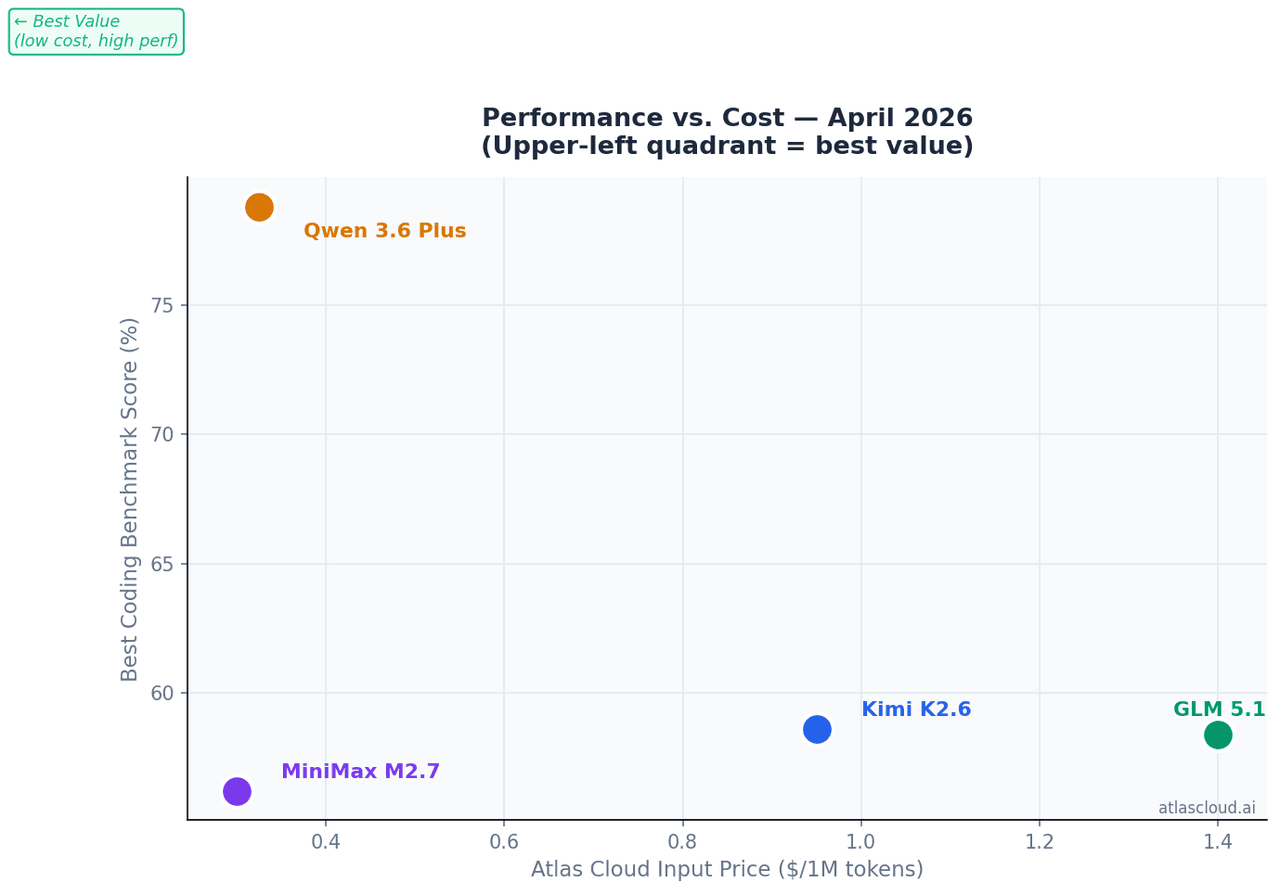
Bij 10M tokens aan input per maand — een realistisch volume voor een team-level codeerassistent:
| Model | Maandelijkse inputkosten (10M tokens) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Alle vier aanroepen met één API-sleutel
Alle vier modellen delen hetzelfde OpenAI-compatibele eindpunt op Atlas Cloud. Schakelen tussen hen vereist het wijzigen van één regel:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Wijzig deze ene regel om van model te wisselen 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Je bent een senior software engineer. Analyseer code zorgvuldig voordat je reageert." 21 }, 22 { 23 "role": "user", 24 "content": "Beoordeel deze functie en identificeer alle bugs:\n\n[plak hier je code]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Deze OpenAI-compatibele structuur betekent dat bestaande integraties die zijn gebouwd op de OpenAI SDK zonder aanpassingen werken met Atlas Cloud — alleen de base_url en api_key veranderen.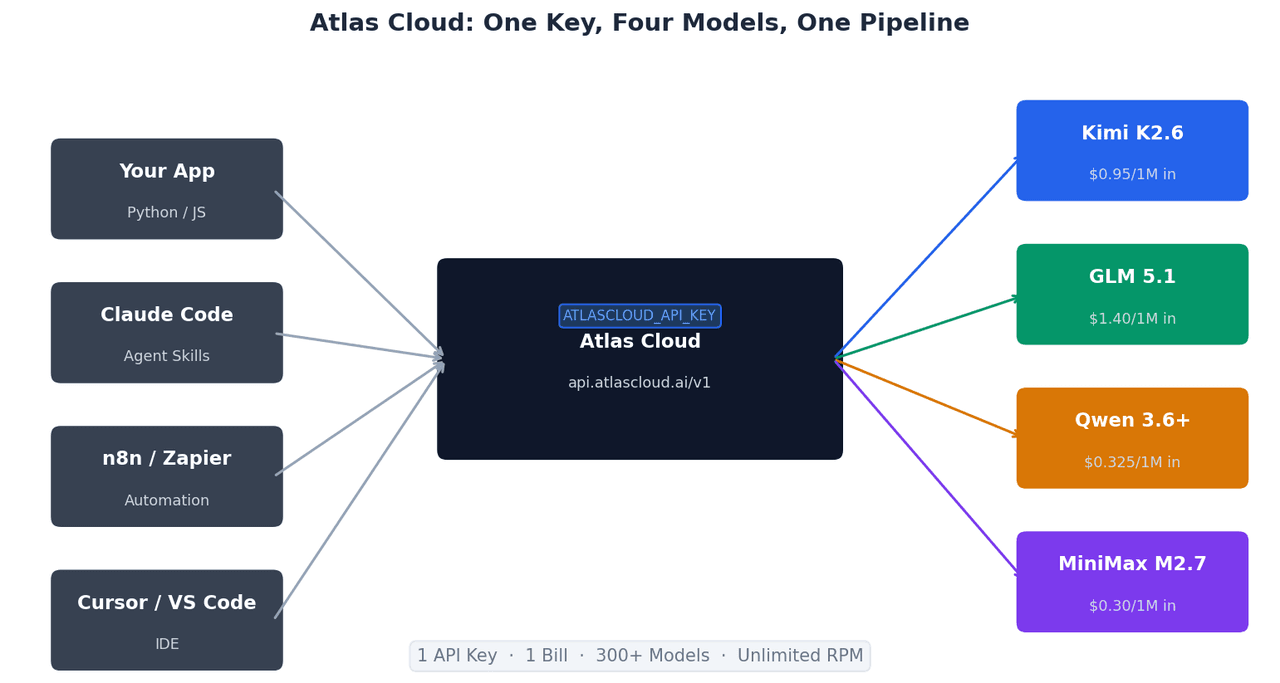
Waarom Atlas Cloud gebruiken voor deze modellen
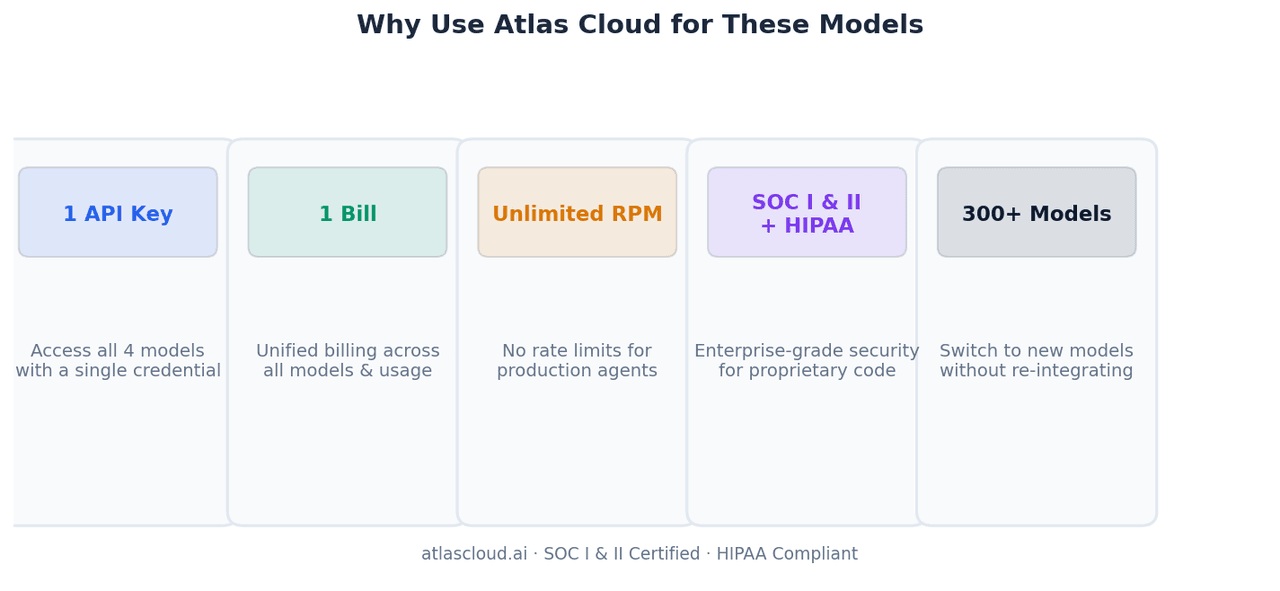
Eén API-sleutel, vier modellen, één factuur. Het uitvoeren van modelrouteringslogica — front-end-taken naar GLM-5.1 sturen, batchanalyse naar MiniMax M2.7 en langetermijnagenten naar Kimi K2.6 — vereist het beheren van één credential in plaats van vier. Maandelijkse afstemming is één factuur.
Onbeperkt RPM. Productiecodeeragenten sturen parallelle toolaanroepen. Snelheidslimieten op directe provider-API's kunnen multi-agent-pijplijnen vertragen. Atlas Cloud verwijdert dat plafond.
SOC I & II gecertificeerd, HIPAA-compliant. Teams die bedrijfseigen broncode via deze modellen verwerken, hebben controleerbare infrastructuur nodig. De compliance-certificeringen van Atlas Cloud betekenen dat je code niet via ongeverifieerde eindpunten wordt geleid.
300+ modellen, hetzelfde integratiepatroon. Wanneer de volgende versie van een van deze modellen uitkomt, of een nieuw model ze overtreft op jouw specifieke workload, vereist het toevoegen ervan aan je routeringslogica één stringwijziging — geen nieuwe SDK-integratie.
Welk model voor welke taak
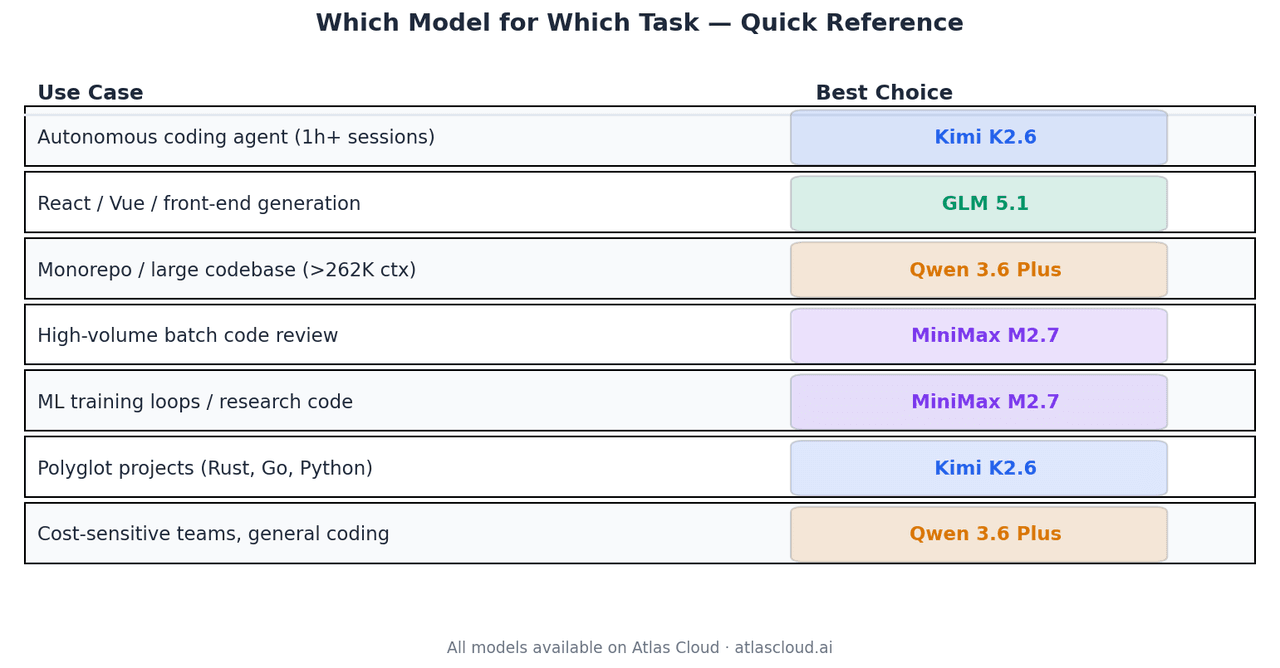
| Gebruiksscenario | Beste keuze | Waarom |
| Autonome codeeragent, sessies van 1+ uur | Kimi K2.6 | 66,7% Terminal-Bench 2.0, 4K+ toolaanroepstabiliteit |
| React / Vue / front-end-generatie | GLM 5.1 | Code Arena Elo 1.530, top-3 agentische webontwikkeling wereldwijd |
| Monorepo of grote codebase-analyse | Qwen 3.6 Plus | Enige model hier met 1M contextvenster |
| High-volume batch-codebeoordeling | MiniMax M2.7 | $0,30/M input, 94% van GLM-5.1-kwaliteit |
| ML-trainingslussen, onderzoekscode | MiniMax M2.7 | 66,6% medaillepercentage MLE-Bench Lite |
| Polyglotprojecten (Rust, Go, Python) | Kimi K2.6 | Gedocumenteerde cross-taalgeneralisatie |
| Kostenbewuste teams, algemeen coderen | Qwen 3.6 Plus | $0,325/M input, sterk in alle categorieën |
Samenvatting
Deze vier modellen worden gescheiden door kleine marges op standaard benchmarks. De betekenisvolle verschillen komen naar voren in specifieke omstandigheden.
Kimi K2.6 is het juiste antwoord voor autonome langlopende agenten. GLM 5.1 leidt voor agentisch front-end werk. Qwen 3.6 Plus is de enige keuze wanneer de context groter is dan 262K tokens. MiniMax M2.7 is de kostenefficiënte standaard voor teams die codeermodellen op schaal draaien.
Alle vier zijn beschikbaar op Atlas Cloud via atlascloud.ai onder één API-sleutel, met betalen-per-token-prijzen en zonder minimale afnameverplichting.
Benchmarkgegevens afkomstig van de technische blog van Moonshot AI, Z.AI-ontwikkelaarsdocumentatie, het releasebericht van het Alibaba Qwen-team, de officiële modelpagina van MiniMax en onafhankelijke evaluaties van Arena.ai. Alle benchmarks zijn gegevens van april 2026. Prijzen van Atlas Cloud zoals vermeld op publicatiedatum — controleer de actuele tarieven vóór productie-implementatie.


