

Een nuttige geheugentest lijkt minder op de vraag: “Wat weet je nog over mij?” en meer op een toets met gesloten boek, met één correctie en een paar afleidingen. Om een muse wonder active memory test uit te voeren, geef je Muse Wonder fictieve details in één gesprek, corrigeer je een van die details en vraag je in een nieuw gesprek naar de relevante actuele feiten. Noteer wat het ophaalt, wat het fout doet en of het onzekerheid toegeeft.
De onderstaande procedure kost ongeveer 10 minuten om op te zetten en te scoren. Dat is geen bewijs van geheugen over dagen, accounts of elk productoppervlak van Muse. Het is een herhaalbare eerste controle. Gebruik verzonnen details in plaats van privé-informatie.
Belangrijkste punten
- Test ophalen, correcties, weerstand tegen afleidingen, onzekerheid en traceerbaarheid afzonderlijk.
- Voer de test uit in het productoppervlak dat je wilt gebruiken, met de geheugeninstellingen ervan gedocumenteerd.
- Een nieuwe API-aanvraag test alleen persistent geheugen als de applicatie of service dit aanlevert.
- Meta’s MemoryBench is een veel langere interne evaluatie; deze korte controle reproduceert die niet.
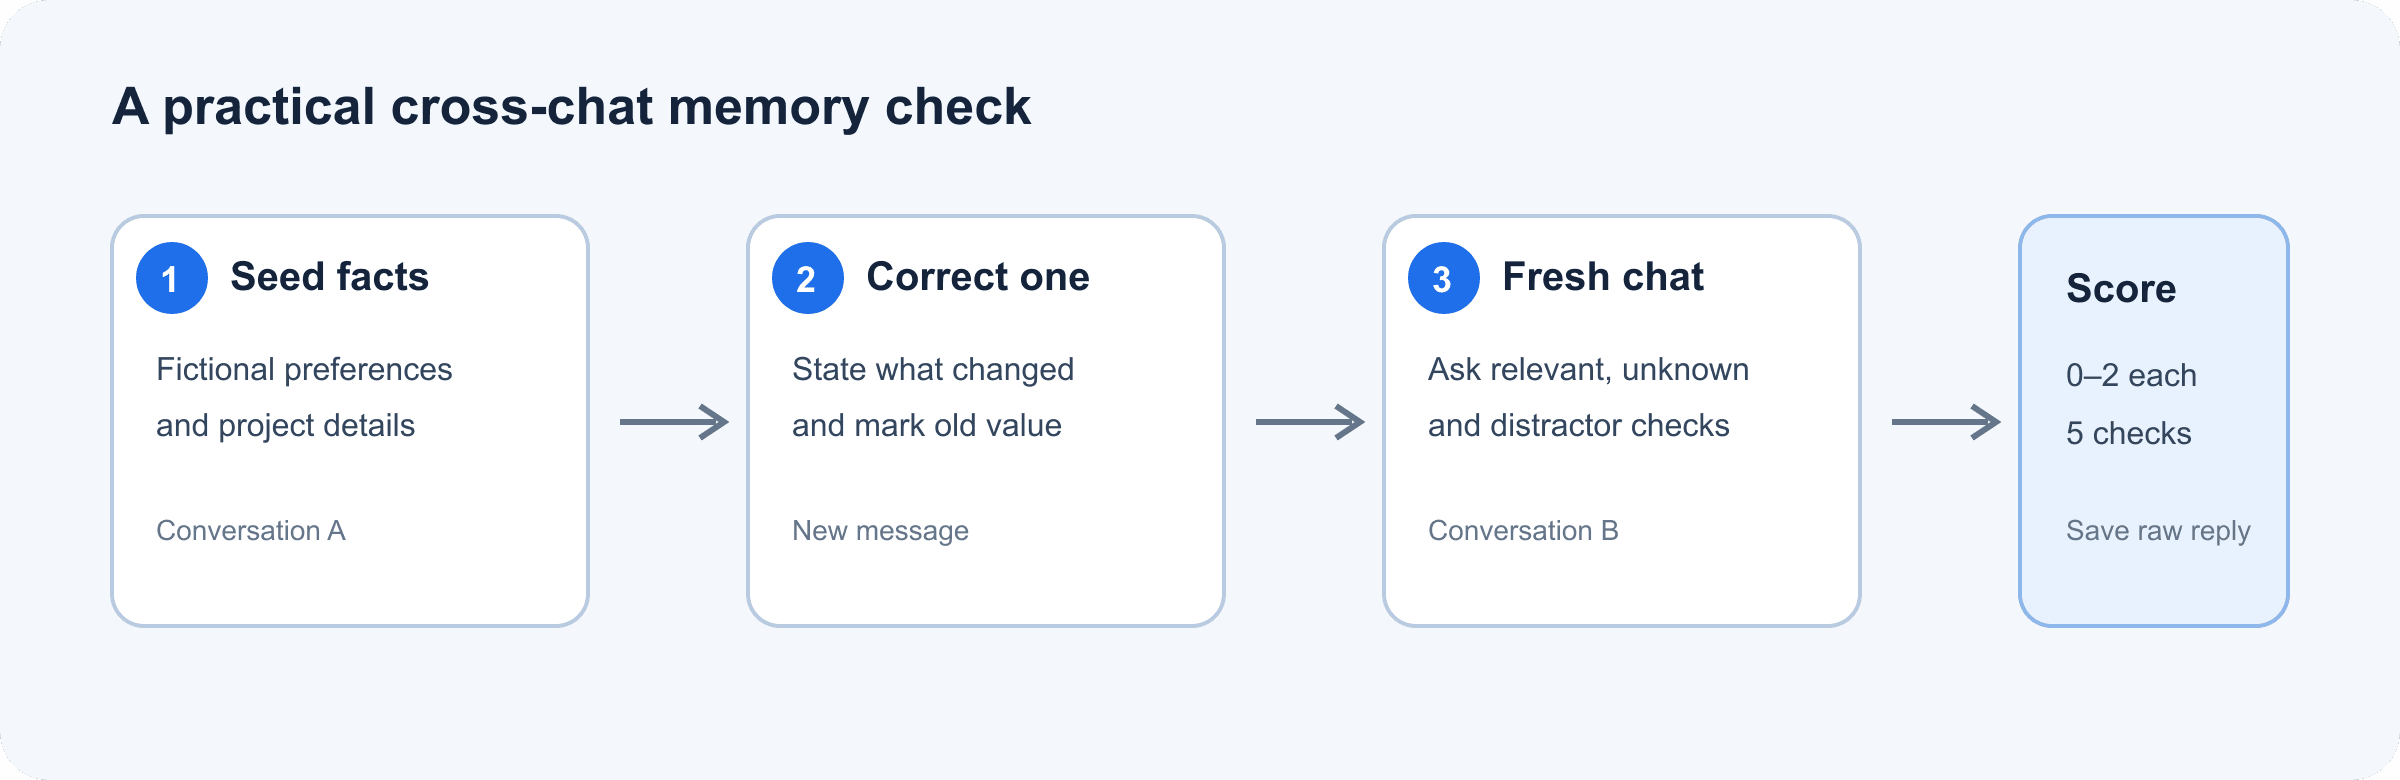
Testflow van de Muse Wonder Active Memory-test: van fictieve details via correctie en ophalen in een nieuw gesprek tot scoren
De testflow scheidt de initiële feiten, een expliciete correctie en het ophalen in een nieuw gesprek.
Waarvoor Muse Wonder Active Memory bedoeld is
Meta beschrijft Active Memory als het meenemen van belangrijke context over een persoon door gesprekken heen en het ophalen van details wanneer ze van belang zijn voor een latere taak. Active Focus verwijst naar het blijven werken aan een doel, inclusief het proberen van alternatieven wanneer je vastloopt en het aanpassen aan nieuwe informatie. Die ideeën zijn verwant, maar ze beantwoorden verschillende vragen: geheugen gaat over welke context wordt opgehaald; focus gaat over hoe het werk verloopt.
Die beschrijving is een claim over productmogelijkheden, geen garantie dat elke interface of API-aanroep automatisch de geschiedenis van een gebruiker deelt. Meta zegt dat Muse Wonder beschikbaar is via zijn Model API en Muse Code. De ontwikkelaarsdocumentatie vermeldt een contextvenster van 1.048.576 tokens en ondersteunde reasoning-instellingen, maar een contextvenster is de hoeveelheid context die een aanvraag kan bevatten, niet het bewijs dat eerdere aanvragen blijven bestaan. Controleer welke geschiedenis of welk geheugen het door jou gekozen product daadwerkelijk biedt.
Hoe je een Muse Wonder-geheugentest uitvoert
Gebruik één account en dezelfde modelvariant gedurende één run. Schakel voor een chatproduct de geheugenfunctie in die je wilt evalueren en noteer de instelling ervan. Noteer voor een API-integratie of je eigen applicatie eerdere beurten, een opgeslagen profiel of opgehaalde notities in de aanvraag opneemt. Zonder die informatie kun je het ophalen niet alleen aan het model toeschrijven.
1. Geef het relevante feiten
Plak in het eerste gesprek dit fictieve profiel. Vraag alleen om een bevestiging, zodat het model de feiten niet meteen omzet in een plan.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Open een werkelijk nieuw gesprek in hetzelfde product en vraag:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Een goed antwoord gebruikt de voorkeur voor rustige buitenactiviteiten. Het hoeft het budget of schaaldieren niet te noemen, omdat geen van beide details nodig is om een activiteit aan te bevelen. Let op verzonnen voorkeuren. Als het product geen toegang heeft tot eerdere chats of als geheugen uit staat, noteer dan “geheugen niet beschikbaar in dit oppervlak” in plaats van het model te scoren alsof het de feiten had ontvangen.
2. Corrigeer een verouderd feit
Introduceer in een andere testthread een afspraak en vervang die vervolgens expliciet. Houd de correctie in een afzonderlijk bericht, zodat je kunt zien of de latere update wint.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Vraag ernaar in een nieuw gesprek:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Slagen als het donderdag 10.00 uur geeft en dinsdag als verouderd behandelt. Een gemengd antwoord of zelfverzekerd gebruik van dinsdag is een betekenisvolle fout, zelfs als het oorspronkelijke detail perfect werd opgehaald.
3. Voeg afleidingen toe en test wat onbekend is
Voeg twee of drie onschuldige fictieve feiten toe aan het eerste gesprek, zoals een verzonnen projectkleur of een nep-pakketnummer. Start na een vertraging een nieuw gesprek en stel één vraag over een relevante voorkeur plus één over een feit dat je nooit hebt verstrekt. Houd de vragen gescheiden, zodat elk antwoord gemakkelijk te scoren is.
Een sterk resultaat gebruikt de relevante voorkeur, laat ongerelateerde details weg en zegt dat het het ontbrekende feit niet kent. Herhaal voor een strengere vertragingstest dezelfde prompt de volgende dag. Tien minuten kan een grens voor een nieuw gesprek controleren, maar kan geen retentie van een week vaststellen.
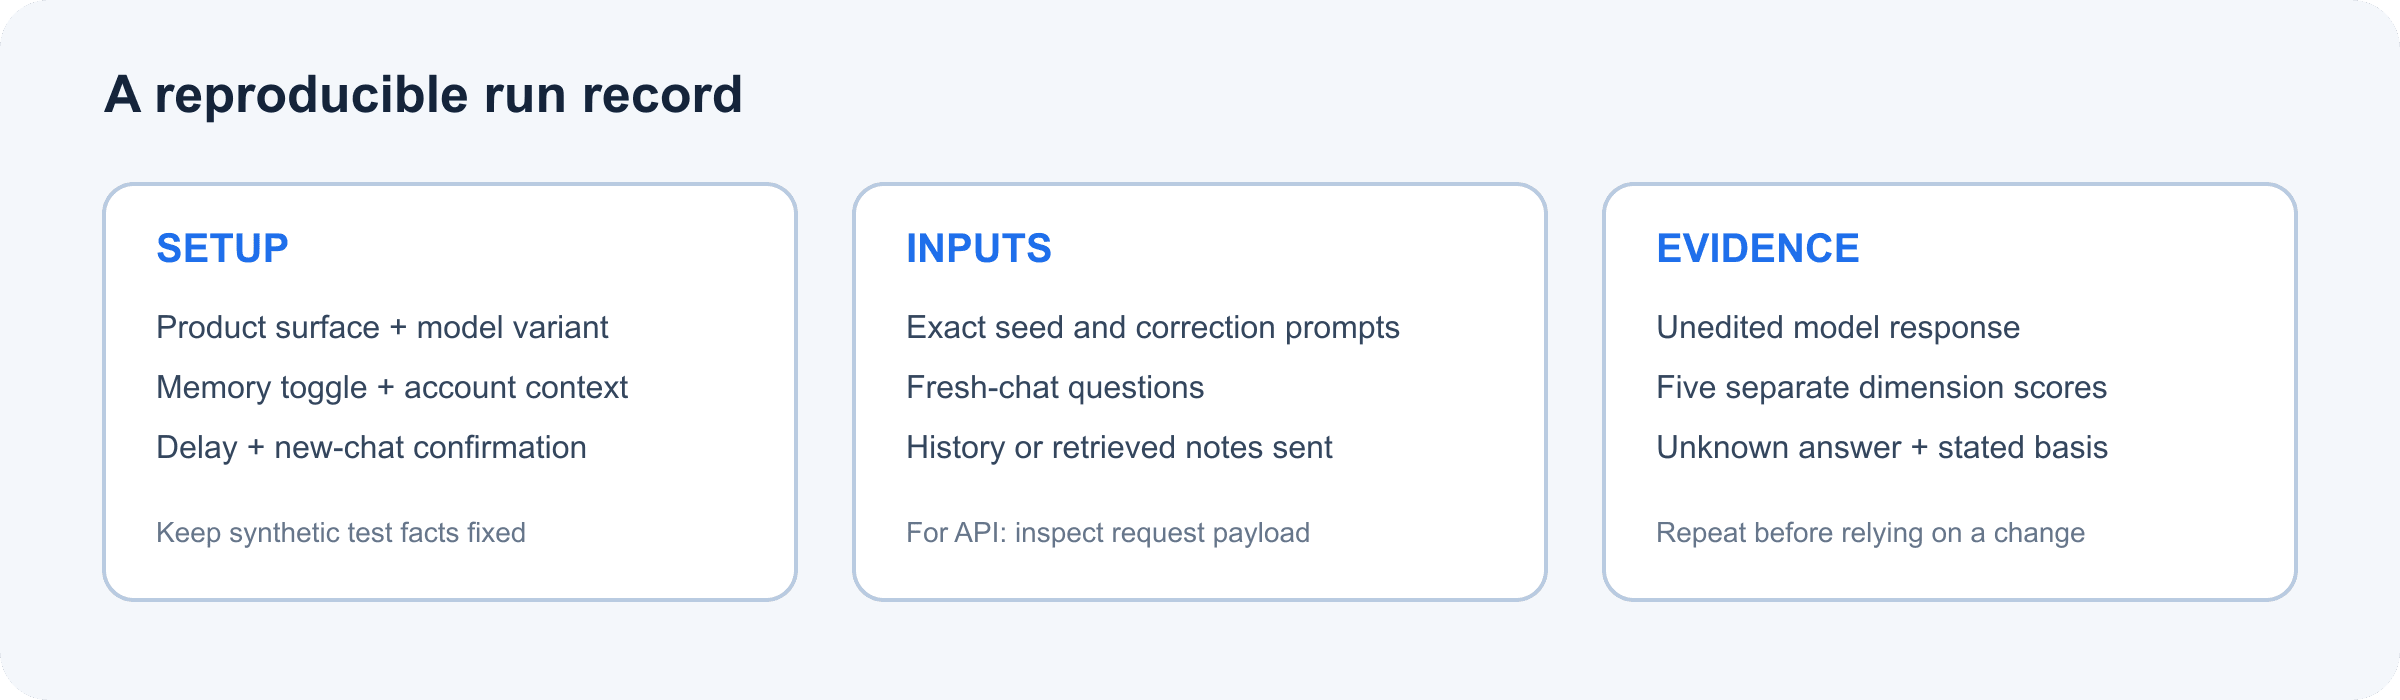
Testkaart voor Muse Wonder Active Memory met opzet, vragen voor een nieuw gesprek en vast te leggen bewijs
Houd de prompt, het productoppervlak, de geheugeninstelling, de vertraging en het onbewerkte antwoord bij elkaar, zodat een andere beoordelaar de controle kan reproduceren.
Hoe je de Active Memory-test scoort
Geef elk gedrag een score van 0 tot 2. Gebruik het resultaat om runs in je eigen workflow te vergelijken, niet om modellen universeel te rangschikken.
| Dimensie | 0 punten | 1 punt | 2 punten |
|---|---|---|---|
| Ophalen van relevante feiten | Mist of verzint het benodigde feit | Gedeeltelijk correct | Selecteert het juiste feit nauwkeurig |
| Omgaan met correcties | Gebruikt de oude waarde | Vaag of mengt beide | Gebruikt de nieuwste waarde en markeert de oude als verouderd |
| Beheersing van afleidingen | Wordt richting irrelevante feiten getrokken | Neemt enig irrelevant detail op | Gebruikt alleen context die relevant is voor de vraag |
| Onzekerheid | Gokt met vertrouwen | Zwakt af maar gokt nog steeds | Zegt duidelijk dat het antwoord niet is verstrekt |
| Traceerbaarheid | Geeft geen basis | Noemt slechts een deel van de basis | Somt kort de context op waarop het zich baseerde |
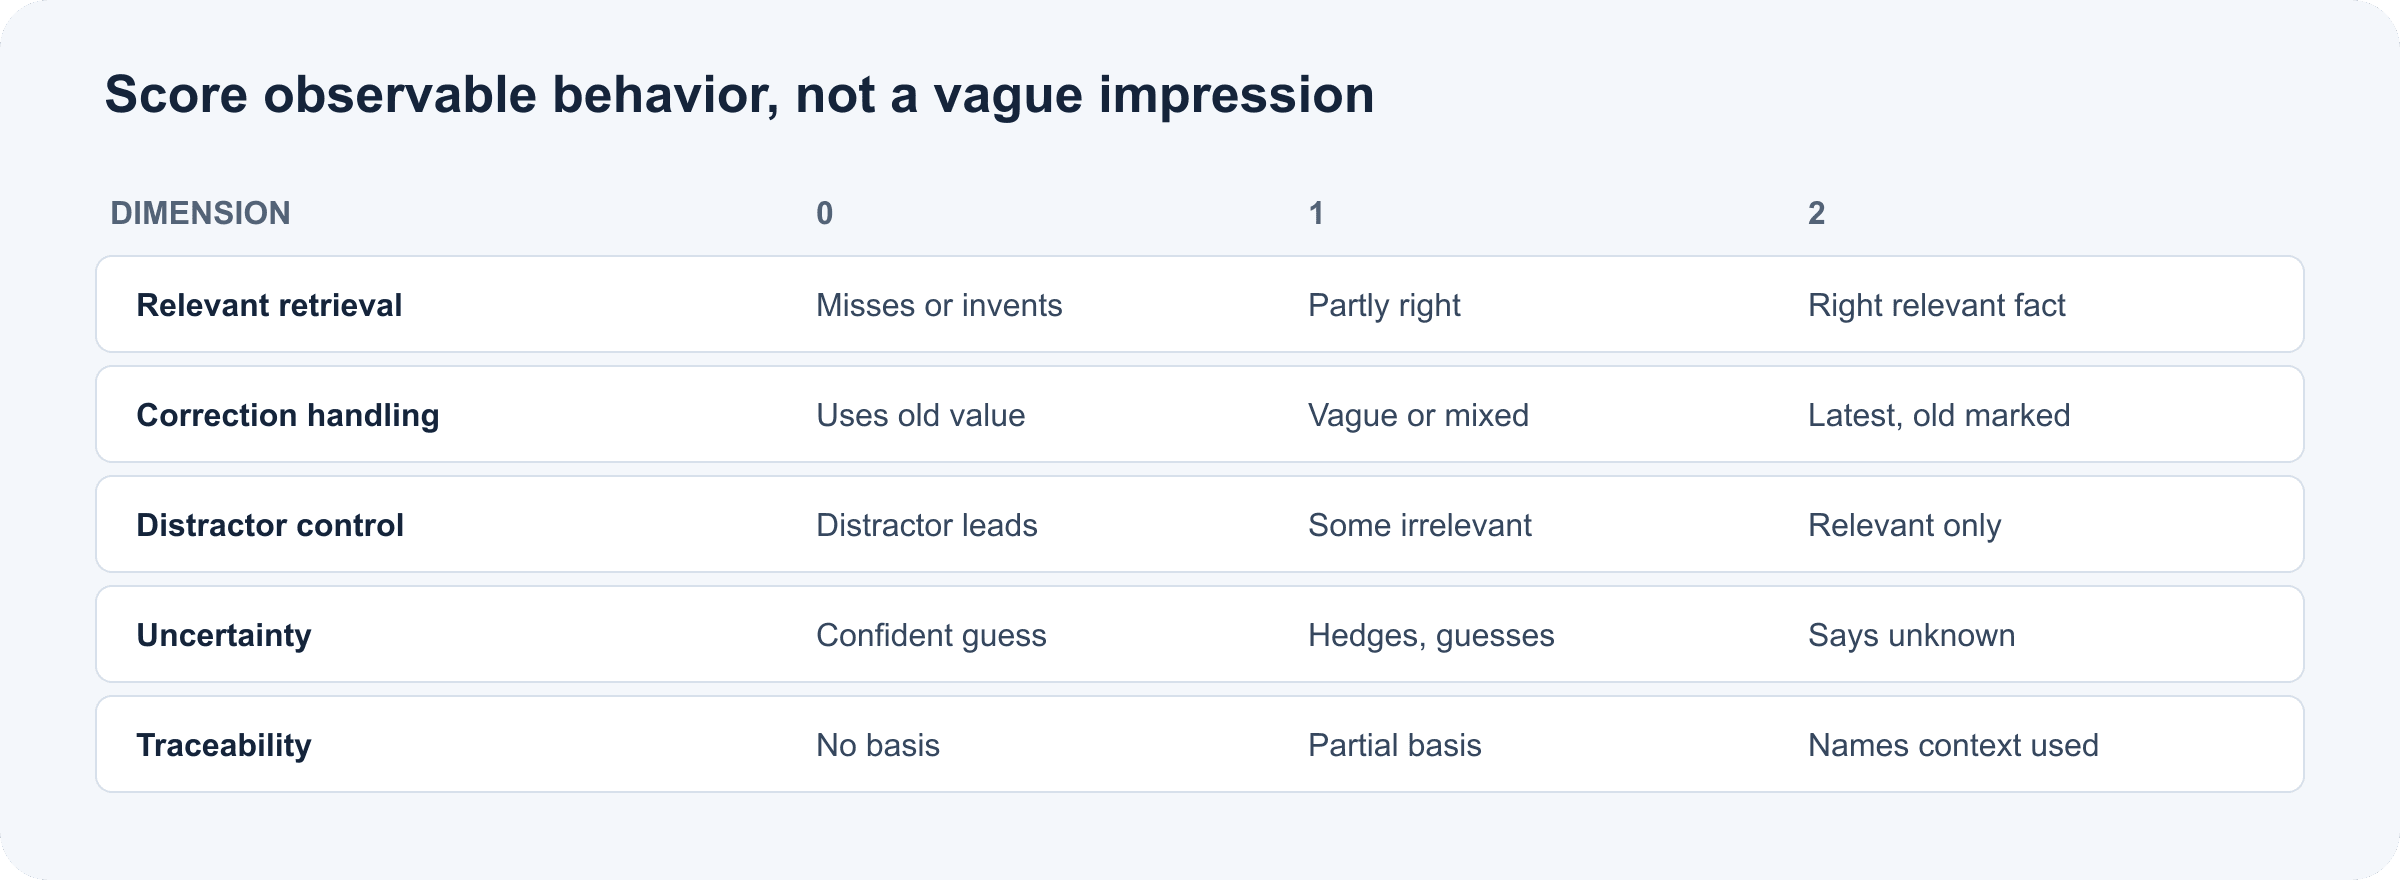
Vijf scoredimensies voor Active Memory van nul tot twee punten, met waarneembare slagingscriteria
De rubric van 0–2 verandert een subjectieve indruk in vijf waarneembare controles.
Tien punten is een handige interne score, geen gevalideerde drempel. Houd de afzonderlijke dimensiescores bij: een totaal kan een ernstige correctiefout verbergen achter goed ophalen elders. Bewaar de exacte prompts en onbewerkte uitvoer en herhaal de run voordat je je deploymentbeslissing wijzigt.
Wat MemoryBench je wel en niet kan vertellen
Meta’s modelkaart beschrijft MemoryBench als een interne evaluatie over lange, complexe gesprekken van 64K tot 100K tokens. De taken omvatten meerdere feiten, afleidingsgesprekken en geïnjecteerde beurten die conflicteren met of later doeldetails bijwerken; een LLM-beoordelaar scoort antwoorden aan de hand van gewogen, vraagspecifieke criteria. Dat is nuttige context om de reikwijdte van de benchmark te begrijpen, maar het is niet hetzelfde als de persoonlijke geheugeninstelling van een gebruiker die door chats heen werkt.
De modelkaart legt het taakontwerp uit; die maakt van deze oefening van 10 minuten geen replicatie. Meta’s gepubliceerde score is bewijs over de gerapporteerde evaluatieopzet. Jouw run beantwoordt een smallere operationele vraag: haalt dit specifieke productoppervlak, deze configuratie en dit account de feiten op die jouw workflow nodig heeft? Geen van beide stelt op zichzelf betrouwbaar geheugen vast voor elke gebruiker of taak.
Muse Wonder vs. Muse Wonder Full: waar te testen
De twee varianten hebben niet dezelfde toegangsroutes. Meta’s huidige ontwikkelaarsdocumentatie zegt dat Muse Wonder (muse-wonder-1.0) beschikbaar is op Model API en in Muse Code. Muse Wonder Full is alleen beschikbaar in Muse Code op de plannen Power Usage en Maximum Usage. Als je de reasoning effort van Muse Wonder op “max” zet, schakel je niet over naar Wonder Full.
| Variant | Gedocumenteerde toegang | Wat te noteren |
|---|---|---|
| Muse Wonder | Model API en Muse Code | API-model-ID of Muse Code-oppervlak, plus of eerdere context wordt aangeleverd |
| Muse Wonder Full | Muse Code op de plannen Power Usage en Maximum Usage | Plan, geselecteerde variant en beschikbare geheugeninstelling in dat oppervlak |
Voer hetzelfde fictieve profiel afzonderlijk uit in elk beschikbaar oppervlak. Vergelijk een Muse Code-test die opgeslagen profieldetails kan ophalen niet met een stateless API-aanroep die alleen de huidige prompt ontving. Dat zou verschillende systemen vergelijken, niet alleen twee modelvarianten.
Privacy en herhaalbare tests
Gebruik verzonnen voorkeuren, datums en projectdetails. Inspecteer voordat je echte data probeert de geheugenbediening, het verwijderingspad, de retentie-informatie en de instelling voor datagebruik van het product. Meta’s API-documentatie zegt dat content in Standard mode niet wordt gebruikt om Meta-modellen te trainen; Muse Code biedt ook Contributor mode, die standaard aan staat en content voor training kan gebruiken tenzij deze wordt uitgeschakeld. Controleer de huidige instellingen en voorwaarden voor het product dat je gebruikt in plaats van aan te nemen dat alle oppervlakken hetzelfde met data omgaan.
Scheid voor een API het model van de geheugenlaag van je applicatie. Een database, retrievalsysteem of promptgeschiedenis die je software verzendt, doet misschien het onthouden. Log wat de applicatie heeft opgehaald en wat ze in elke aanvraag heeft doorgegeven, en houd testrecords synthetisch.
Teams kunnen de drie rondes omzetten in een kleine, geversioneerde evaluatieset. Houd het feitenprofiel, de correctie, afleidingen, modelvariant, productinstellingen, vertraging en onbewerkte respons vast. Voer de run opnieuw uit na configuratie- of modelwijzigingen en beoordeel fouten per dimensie. Voor teams die al gehoste modellen vergelijken in een herhaalbare harness, biedt Atlas Cloud een catalogus en een unified LLM API guide. Je kunt de model directory bekijken voor een afzonderlijke vergelijking. De directory vermeldt momenteel geen Muse Wonder, en het gebruik van een ander model daar zou alleen de context testen die expliciet aan dat model wordt aangeleverd, tenzij je applicatie een geheugenlaag toevoegt.
Veelgestelde vragen
Hoe test ik de Active Memory van Muse Wonder tussen chats?
Geef fictieve feiten in één gesprek en vraag vervolgens in een nieuw gesprek naar relevante details. Neem een correctie en een ontbrekend feit op, en noteer het productoppervlak en de geheugeninstellingen.
Onthoudt Muse Wonder correcties of alleen eerdere details?
Meta’s MemoryBench-beschrijving bevat beurten die eerdere details bijwerken of ermee conflicteren. Je eigen correctietest controleert of de huidige productopzet de update volgt; herhaal deze, want één resultaat stelt geen consistent gedrag vast.
Is deze chatgeschiedenistest hetzelfde als Meta’s MemoryBench?
Nee. Meta beschrijft MemoryBench als een interne long-contextbenchmark met gesprekken van 64K tot 100K tokens, afleidingen, conflicterende of bijgewerkte feiten en een LLM-beoordelaar. Deze korte controle is een praktische smoke test, geen replicatie.
Kan ik Muse Wonder Active Memory via de API testen?
Je kunt het ophalen door het API-model testen van context die de aanvraag bereikt. Verifieer voor persistentie tussen aanvragen wat de API of je applicatie opslaat en verzendt. De beschikbaarheid van een groot contextvenster toont op zichzelf niet aan dat afzonderlijke aanvragen geheugen delen.
Hoe onderscheid ik modelgeheugen van door de app opgeslagen geheugen?
Inspecteer de volledige aanvraag die naar het model wordt verzonden. Als je applicatie een profiel, opgehaalde notitie of eerder gesprek invoegt, heeft die softwarelaag het geheugen aangeleverd. Vergelijk waar passend met een gecontroleerde run waarin dat wordt weggelaten.
Is het veilig om persoonlijke informatie te gebruiken in een Active Memory-test?
Gebruik fictieve informatie voor de test. Als je later echte data evalueert, bekijk dan eerst de geheugen-, verwijderings-, retentie- en datagebruiksinstellingen van het specifieke product.
Een muse wonder active memory test is het nuttigst wanneer deze blootlegt welke stap is mislukt: toegang tot eerdere context, ophalen, correctie, filteren of onzekerheid. Bewaar de onbewerkte run en herhaal deze onder de exacte opzet die je van plan bent te vertrouwen.
Bronnen: Muse Wonder-aankondiging van Meta (12 oktober 2026); Modeldocumentatie van Meta Model API (geraadpleegd op 15 oktober 2026); Muse Wonder-modelkaart (oktober 2026).





