

Een voorsprong in benchmarks kan overtuigend lijken totdat hetzelfde model bij de volgende run een vereiste mist. Een nuttige Muse Wonder-betrouwbaarheidstest stelt een engere vraag: voltooit het model je taak, volgens jouw norm, herhaaldelijk, onder dezelfde omstandigheden?
Vroeg bewijs is gemengd omdat de tests verschillende dingen meten. Eén takenreeks op de lanceerdag gaf standaard Muse Wonder een zeer hoge score na één run per taak. Een andere evaluatie vond sterke punten in onderzoeksanalyse naast zwakkere surveyontwerp, verkoopclaims en dia-indeling. Geen van beide resultaten bewijst hoe consistent het met je codebase of agent-workflow zal omgaan.
Belangrijkste conclusies
- Beschouw lanceerbenchmarks als capaciteitssignalen, niet als productiegaranties.
- Muse Wonder en Muse Wonder Full zijn afzonderlijke varianten. Houd hun resultaten gescheiden.
- Meet slagingspercentage, herhaalbaarheid, voltooiing en herstel als verschillende uitkomsten.
- Begin met 10 tot 20 echte taken, bevries de opzet en herhaal belangrijke taken minstens drie keer.
- Kies een drempel op basis van de kosten van een fout antwoord en je menselijke beoordelingsproces.
Is Muse Wonder betrouwbaar? Het korte antwoord
Het beschikbare bewijs per 15 oktober 2026 ondersteunt een evaluatie per taak, geen universeel betrouwbaarheidsoordeel. Muse Wonder presteerde goed op sommige vroege controles, terwijl andere runs fouten of presentatiewerk blootlegden dat nog beoordeeld moest worden. De onderzoeken verschillen in prompts, reasoning-instellingen, beoordelaars, steekproefgroottes en aantal pogingen.
(Meta, 12 oktober 2026) zegt dat Muse Wonder en Muse Wonder Full zijn gebouwd voor professionele en persoonlijke agenttaken, met functies die het Active Memory en Active Focus noemt. Dat zijn productclaims over beoogd gedrag. Een claim dat een model kan herstellen van fouten is een reden om herstel in je eigen workflow te testen, niet een bewijs dat het betrouwbaar zal herstellen.
Houd standaard Wonder gescheiden van Wonder Full. Meta vermeldt standaard Muse Wonder voor zijn Model API en Muse Code, terwijl Full wordt aangeboden via Muse Code-abonnementen. Standaard Wonder met een hogere reasoning-instelling uitvoeren maakt er geen Full van.
Test voor een verdedigbare beslissing de exacte variant en route die je van plan bent te implementeren. Tel een taak alleen als succesvol als deze voldoet aan een opgeschreven acceptatieregel en het resultaat controleerbaar is.
Wat een Muse Wonder-betrouwbaarheidstest moet meten
Nauwkeurigheid en consistentie zijn verschillend
Een slagingspercentage meet hoeveel pogingen aan een gedefinieerde rubric voldoen. Consistentie meet of herhaalde runs van dezelfde taak elke keer acceptabele uitkomsten opleveren. Een model kan een hoog slagingspercentage hebben en toch op manieren variëren die belangrijk zijn voor je workflow.
Volg vier dimensies afzonderlijk:
| Meting | Wat te registreren | Voorbeeldcontrole |
|---|---|---|
| Nauwkeurigheid | Pogingen die aan de rubric voldoen | Komt het geëxtraheerde totaal overeen met het brondocument? |
| Consistentie | Of herhaalde pogingen slagen en overeenkomen | Behouden drie runs dezelfde vereiste beperkingen? |
| Voltooiingskwaliteit | Of elke gevraagde oplevering aanwezig is | Zijn alle bestanden, citaties en gevraagde velden opgenomen? |
| Herstel | Of de run correct wordt hervat na een fout | Meldt het een toolfout, probeert het veilig opnieuw en verifieert het daarna de eindstatus? |
Een antwoord dat compleet klinkt, is niet noodzakelijk compleet. Een codewijziging heeft tests nodig; een onderzoekssamenvatting heeft traceerbare bronnen nodig; een agent-run heeft bewijs nodig dat de laatste actie heeft plaatsgevonden.
Scheid modelfouten van workflowfouten
Registreer voldoende context om een modelfout te onderscheiden van een serving- of toolprobleem. Log minimaal de modelvariant en -versie, reasoning-instelling, prompt, toolconfiguratie, datum, runtime, token- of taakkosten en ruwe uitvoer.
Classificeer fouten voordat je ze scoort:
- Model: onjuist feit, slechte redenering of gemiste vereiste.
- Tool: mislukte API-aanroep, ongeldige toolargumenten of verkeerd resultaat van een extern systeem.
- Serving: time-out, onderbreking of niet-beschikbaar eindpunt.
- Evaluatie: onduidelijke rubric of een controle die acceptabel werk niet van onacceptabel werk kan onderscheiden.
Als je alle vier combineert tot één faalpercentage, weet je niet wat je moet oplossen.
Wat huidige Muse Wonder-tests laten zien
De gepubliceerde benchmarkvergelijkingen van Meta zijn leveranciersbewijs over benchmarkprestaties. Ze zijn niet hetzelfde als een onafhankelijk uitgevoerde workflowevaluatie. Onafhankelijke tests hebben ook beperkingen: een kleine openbare takenreeks, één poging, een specifieke modelroute of een menselijke preferentiemeting beantwoordt slechts een smalle vraag.
De onderstaande tabel scheidt het bewijs naar bron en scope. Het is een gids voor wat elk resultaat kan ondersteunen, geen gecombineerde score.
| Bewijsbron | Wat het testte | Datum en opzet | Wat het je kan vertellen | Belangrijkste beperking |
|---|---|---|---|---|
| Meta-aankondiging en modelmaterialen | Capaciteitsbenchmarks en beoogde agentfuncties | Aangekondigd op 12 oktober 2026; door leverancier gerapporteerde vergelijkingen | Welke capaciteiten Meta benadrukt en welke varianten het heeft uitgebracht | Leverancierstests stellen geen herhaalbaarheid in je workflow vast |
| (Spring Prompt, 13 oktober 2026) | Enquêtes, productvermeldingen, dia's, advertentieplanning, schaken en visueel zoeken | 13 oktober; standaard API-model, doorgaans medium reasoning; openbare taken | Prestaties varieerden per taak; sommige evaluaties bevatten herhaalde runs voor productvermeldingen | De meeste taken waren kleine steekproeven; veel resultaten waren één run per taak; geen coding- of Muse Code-test |
| (Quantslant, 12 oktober 2026) | 23 taken over agents, coding, schrijven, redeneren en één lang document | 12 oktober; standaardmodel via OpenRouter, lage reasoning; één run per taak | Het model slaagde onder die opzet met een hoog percentage voor die gedefinieerde takenreeks | Een enkele run kan consistentie tussen runs niet meten; resultaten dicht bij 100% vereisen inspectie op taakniveau |
| Communityposts | Individuele coding-, agent- en benchmarkreacties | Posts uit de lanceerperiode; zelfgeselecteerde gebruikers en taken | Nuttige aanwijzingen voor wat je hierna moet testen | Anekdotes en stemmen zijn geen gemeten slagingspercentages |
Het contrast tussen bronnen is belangrijk. Quantslant rapporteerde 99,7% over zijn takenreeks van 23 taken, met één run per taak en een lage reasoning-instelling. Het vermeldde ook één mislukte unittest in een codingtaak voor getallen naar woorden. Dat resultaat is bewijs over die specifieke suite, niet bewijs dat 99,7% van alledaagse taken zal slagen of dat herhaalde runs overeen zullen komen.
Spring Prompt rapporteerde op 13 oktober een gevarieerder beeld voor standaard Wonder met API-standaardinstellingen. De score voor onderzoeksanalyse was 93,6/100 over negen openbare taken, terwijl slechts drie van de negen surveyplannen alle controles doorstonden. Voor productvermeldingen was het aandeel dat na drie herhalingen betrouwbaar publicatieklaar werd geacht 66,1% voor feitelijke briefs en 51,8% voor verkoopbriefs. Vijf van de zes diapresentaties hadden lay-outaanpassingen nodig, en één werd als presentabel beoordeeld. Dit zijn afzonderlijke metingen met afzonderlijke noemers, geen stukjes van één totaalscore.
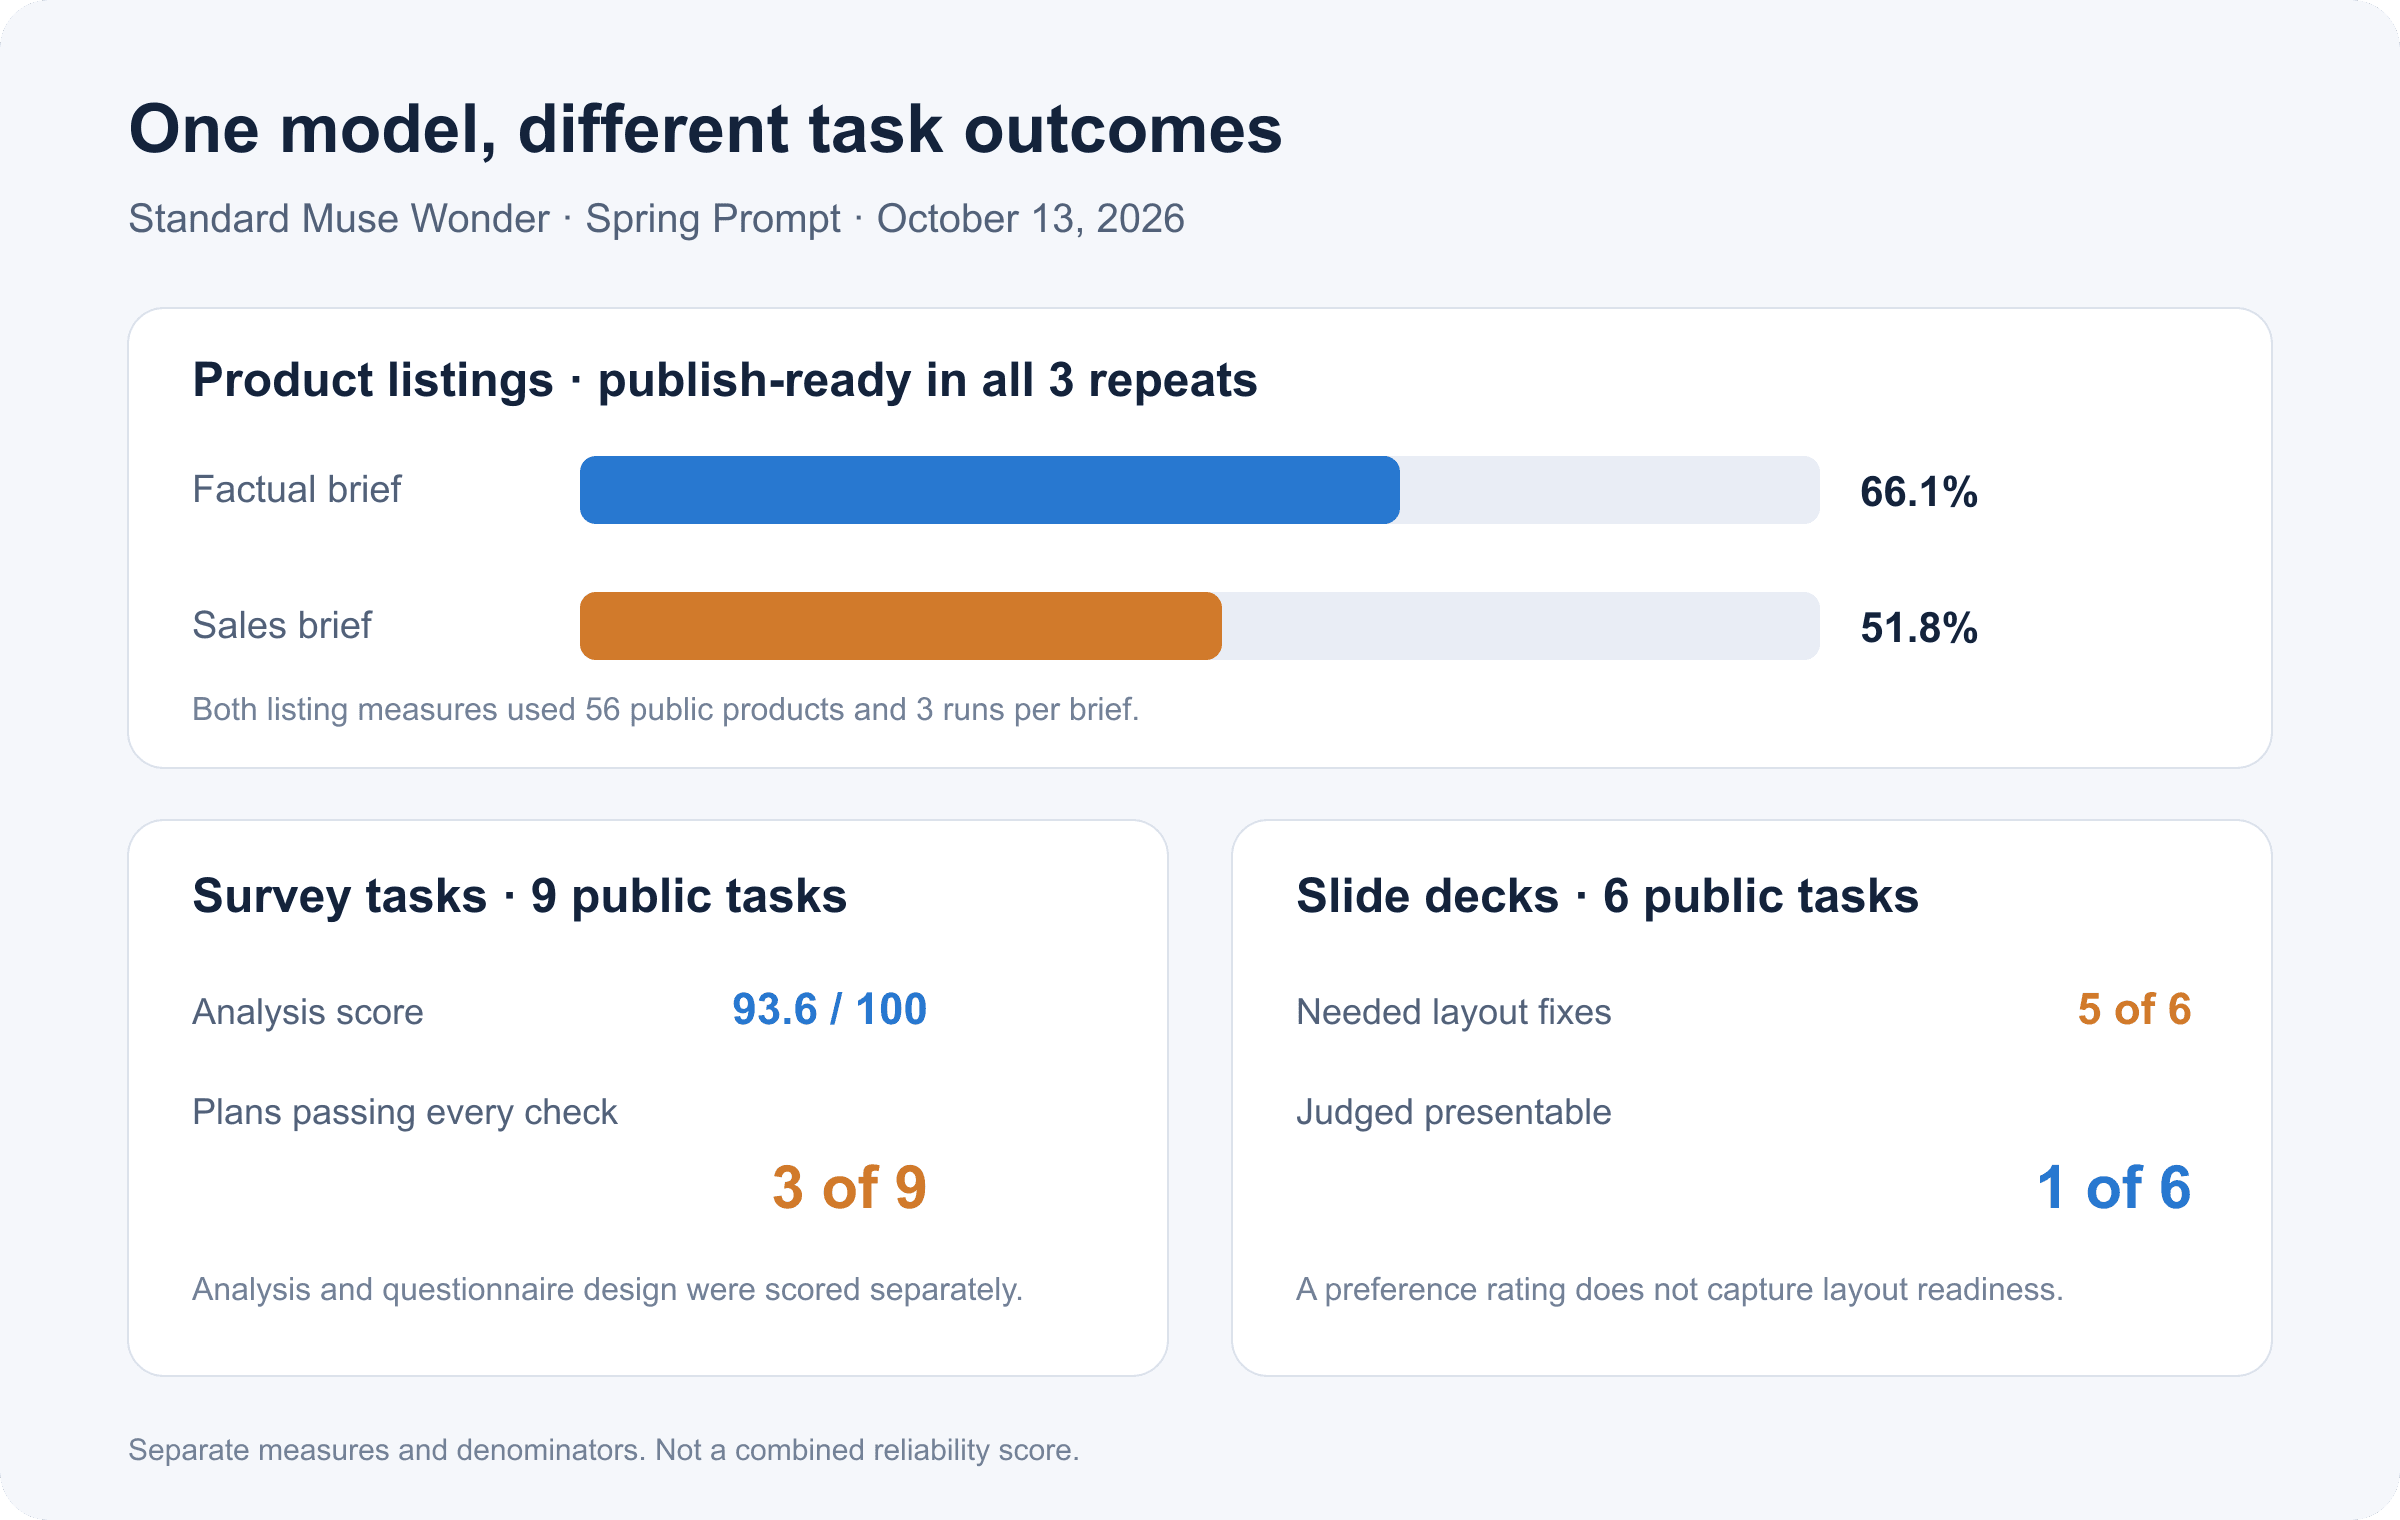
Spring Prompts standaard Muse Wonder-resultaten van 13 oktober 2026: herhaald geteste slagingspercentages voor vermeldingen, uitkomsten van surveyanalyse en dia-beoordeling
Onafhankelijke taakresultaten uit één evaluatie. Metingen gebruiken verschillende noemers en worden afzonderlijk weergegeven, niet gecombineerd tot een score.
De tests van Spring Prompt maten geen coding, persistent geheugen of Muse Code. De vergelijking kan daarom niet bepalen of Wonder betrouwbaar is voor coding of of Full beter presteert. Ze laat wel zien waarom één breed label belangrijke taakverschillen verbergt.
Het lanceerartikel van Meta zegt dat standaard Muse Wonder beschikbaar is via de Meta Model API en Muse Code, terwijl Wonder Full beschikbaar is voor Muse Code-abonnees. Het beschrijft Active Memory en Active Focus als functies voor het vasthouden van nuttige details en het voortzetten van werk bij fouten. Die beschrijvingen helpen testcases definiëren, maar het lanceerartikel is geen onafhankelijke studie met herhaalde runs.
Behandel berichten over coding- en 3D-buildclaims in communitythreads tijdens de lanceerweek als hypotheses. Zet een specifieke klacht om in een reproduceerbare taak en verifieer de uitvoer. Zet reacties of upvotes niet om in een succespercentage.
Hoe je een herhaalbare Muse Wonder-betrouwbaarheidstest uitvoert
1. Stel een kleine takenreeks samen uit echt werk
Kies 10 tot 20 taken waarvan je team daadwerkelijk verwacht dat het model ze aankan. Verdeel ze in categorieën zoals coding, feitenextractie, instructies volgen, lange context en toolgebruik. Geef de voorkeur aan taken met objectieve tests, referentieantwoorden of een duidelijke rubric.
Voeg realistische edge cases toe: ontbrekende invoer, tegenstrijdige vereisten, een niet-beschikbare tool en een taak die een verduidelijkingsvraag zou moeten uitlokken. Houd gevoelige of gereguleerde data erbuiten, tenzij je goedgekeurde proces dit toestaat.
2. Bevries de prompt, het model en de instellingen
Schrijf de exacte prompt en systeeminstructies op. Registreer de modelnaam en -versie, reasoningniveau, tools, geleverde context, datum en eventuele tijdslimiet. Vergelijk standaard Wonder niet met Full alsof het hetzelfde model is.
Een nuttige testprompt kan het model vragen zijn bewijs te tonen en niet-testbare vereisten te identificeren:
Lees de bijgevoegde specificatie en implementatie. Geef alleen terug: (1) elke vereiste gemarkeerd als PASS, FAIL of NOT TESTABLE; (2) het exacte bewijs voor elke status; (3) elke ontbrekende vereiste; (4) een minimale reproduceerbare test voor elke FAIL. Beweer niet dat een test is geslaagd, tenzij je naar de uitvoer kunt verwijzen.
Dit is een evaluatie-invoer, geen garantie dat het model zich eraan houdt. Scoor het resulterende antwoord en verifieer elke geclaimde testuitvoer onafhankelijk.
3. Herhaal taken en scoor elke poging
Voer elke taak met grote impact minstens drie keer uit met dezelfde opzet. Als het budget slechts één poging toelaat, label het resultaat dan als een eerste steekproef in plaats van een consistentieresultaat. Bewaar elk ruw antwoord; rapporteer niet alleen het beste.
Gebruik een rij voor elke poging. Houd de acceptatieregel stabiel over alle runs.
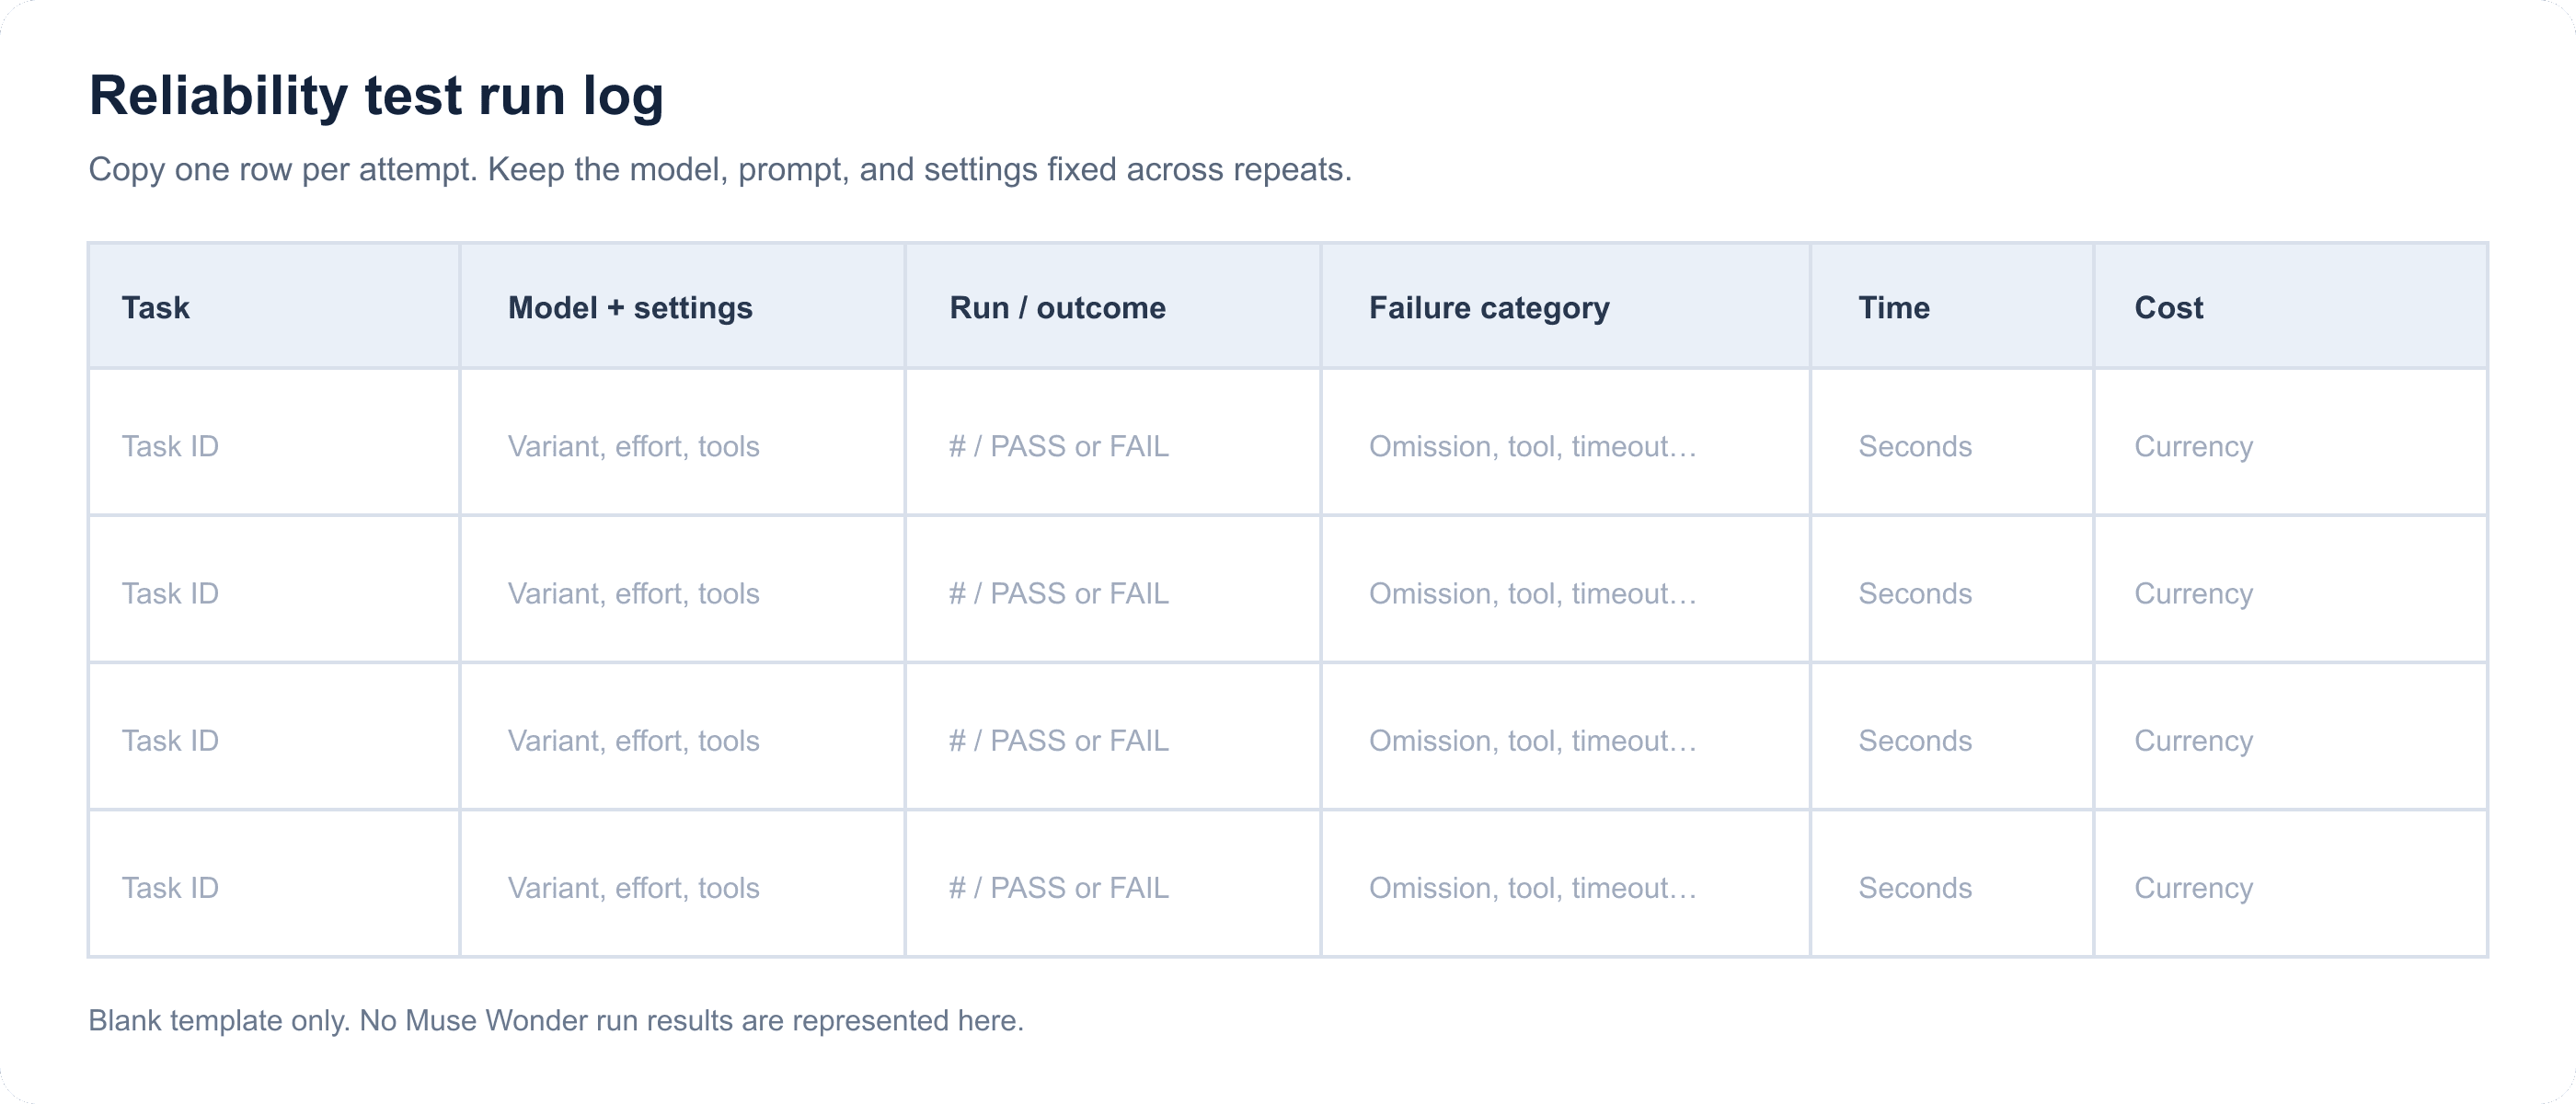
Leeg Muse Wonder-betrouwbaarheidstestlog met velden voor taak, model, run, uitkomst, fout, tijd en kosten
Herbruikbaar leeg registratiesjabloon. Vul één rij per poging in; het bevat geen gemeten Muse Wonder-resultaten.
4. Houd een foutenlog bij en verifieer herstel
Gebruik specifieke categorieën: feitelijke fout, weglating, mislukte codetest, toolfout, time-out, niet-onderbouwde voltooiingsclaim of formaatafwijking. Noteer bij meerstapswerk waar de run stopte en of een nieuwe poging voltooide acties herhaalde of de eindstatus verifieerde.
Een agent die 'klaar' zegt zonder bewijs is niet door een voltooiingscontrole gekomen. Eis een testresultaat, opgeslagen bestand, bronvermelding of geverifieerde status die bij de taak past.
5. Stel een beslissingsdrempel in op basis van faalkosten
Er is geen bruikbare universele afkapwaarde voor het slagingspercentage. Een concept dat iemand regel voor regel controleert, heeft een ander risicoprofiel dan een databasemigratie of een geautomatiseerde betaling.
Stel de drempel in op basis van drie factoren:
- Hoe schadelijk of duur is een verkeerd resultaat?
- Kan een persoon de fout opvangen voordat deze iemand beïnvloedt?
- Faalt de workflow veilig, met een duidelijke stop en audittrail?
Voor concepten met laag risico kan beoordeling voldoende zijn. Gebruik voor codewijzigingen, financiën, juridische zaken, gezondheid of acties die gebruikers beïnvloeden sterkere tests en onafhankelijke verificatie. Laat een hoog gemiddelde niet één ernstige faalmodus verbergen.
Muse Wonder-betrouwbaarheid per taaktype
Coding en meerstapsbuilds
Voer de daadwerkelijke testsuite van de repository uit en controleer het gevraagde gedrag. Scoor vereiste-dekking, regressiefouten en of de geclaimde wijzigingen van het model overeenkomen met de bestanden en testuitvoer. Een overtuigende schermopname of uitleg is geen vervanging voor een uitvoerbare controle.
De vroege Quantslant-suite bevatte vier codingtaken en rapporteerde 15 van 16 unit tests die slaagden bij één taak voor getallen naar woorden. Dat is een klein signaal uit één run. Spring Prompt testte expliciet geen coding, dus de bevindingen moeten niet worden gebruikt om te generaliseren over de betrouwbaarheid van coding-agents.
Onderzoek en feitenextractie
Gebruik een bronpakket of referentieantwoorden die je beoordelaar kan inspecteren. Controleer elke feitelijke claim tegen een primaire bron, en volg verzonnen citaties en onjuiste toeschrijving afzonderlijk van de algemene antwoordkwaliteit.
De surveyanalyse van Spring Prompt was een relatieve sterkte in de kleine evaluatie, maar het ontwerp van surveyvragen was zwakker. Een hoge analysescore mag het surveyinstrument of de bronnen achter een nieuwe onderzoekstaak niet stilzwijgend certificeren.
Lange-context- en agentworkflows
Controleer of het model elke beperking behoudt, elke tool correct gebruikt en de eindstatus verifieert. Test onderbrekingsherstel bewust: stop een run na een bekende stap en kijk of deze vanaf een checkpoint wordt hervat of een neveneffect herhaalt.
De aankondiging van Meta beschrijft geheugen- en herstelcapaciteiten, maar de hier aangehaalde openbare vroege evaluaties stellen geen consistentie op lange termijn vast voor persistent geheugen of agentherstel. Meet die gedragingen direct voordat je erop vertrouwt.
Muse Wonder vs. Muse Wonder Full: houd bewijs gescheiden
Muse Wonder en Muse Wonder Full zijn afzonderlijke varianten. De lanceerinformatie van Meta beschrijft afzonderlijke toegangsroutes, en onafhankelijke API-tests van standaard Wonder worden geen Full-resultaten alleen omdat de reasoning-instelling verandert.
| Vergelijkingsvraag | Wat het beschikbare bewijs ondersteunt |
|---|---|
| Is Full hetzelfde als standaard Wonder bij maximale reasoning? | Nee. Behandel ze als afzonderlijke varianten en registreer de exacte naam. |
| Testte de aangehaalde Spring Prompt API-evaluatie Full? | Nee. Deze testte standaard Wonder; Full viel buiten die vergelijking. |
| Kunnen de aangehaalde standaard-API-cijfers Full rangschikken? | Nee. Ze testen Full niet. |
| Wat zou een eerlijke vergelijking mogelijk maken? | Dezelfde takenreeks, scoringsrubric, datumvenster, tooltoegang en gedocumenteerde instellingen, met herhalingen voor beide varianten. |
Een eerlijke vergelijking begint met gepaarde taken en overeenkomende omstandigheden. Als toegangsroutes verschillende prompts, tools of facturatie opleggen, documenteer die verschillen en noem de vergelijking verkennend.
Kosten, toegang en waar je Muse Wonder kunt testen
Vergelijk kosten per geaccepteerde taak, niet alleen de vermelde prijs per token. Lange prompts, nieuwe pogingen, reasoning-tokens, toolaanroepen, time-outs en menselijke beoordeling veranderen allemaal de kosten van een bruikbaar resultaat. Quantslant rapporteerde de tokenprijzen van standaard Wonder als $4 per miljoen invoertokens en $20 per miljoen uitvoertokens op 12 oktober 2026, en de eigen 23-takenrun kostte $0.64. Dat is één gerapporteerde route en workload, geen universele taakprijs.
De huidige lanceeraankondiging van Meta vermeldt standaard Wonder via de Meta Model API en Muse Code, en Full via Muse Code-abonnementen. Bevestig toegang, regionale geschiktheid en huidige facturatie in de officiële interface voordat je budgetteert.
Begin bij Atlas Cloud voor een breder beeld van het ontwikkelaarsplatform. Op 15 oktober 2026 kon ik Muse Wonder niet bevestigen in de modelcatalogus, dus dit artikel presenteert Atlas Cloud niet als uitvoeringsroute voor dit model. Als je team andere modellen vergelijkt die daar al staan, kan de Atlas Cloud-modellenbibliotheek je helpen kandidaten te identificeren om tegen dezelfde takenreeks te draaien.
De nuttige uitkomst van een Muse Wonder-betrouwbaarheidstest is een implementatiebeslissing die aan bewijs is gekoppeld: welke taak slaagde, hoe vaak deze slaagde, wat het kostte en welke beoordeling nog nodig is.
Veelgestelde vragen
Is Muse Wonder betrouwbaar voor coding?
Vroege lanceertests bieden slechts een kleine codingsteekproef. Quantslant rapporteerde vier codingtaken, met een gemiste unittest in één taak, terwijl Spring Prompt geen coding testte. Voer repositorytests uit op je eigen taken en herhaal belangrijke taken voordat je een beslissing neemt over een coding-workflow.
Hoe test ik Muse Wonder-betrouwbaarheid zelf?
Gebruik een vaste set echte taken, bewaar de exacte model- en promptinstellingen, definieer slaagcriteria vooraf en bewaar elke uitvoer. Herhaal belangrijke taken en verifieer resultaten met tests of brondocumenten.
Hoe vaak moet ik elke Muse Wonder-taak herhalen?
Gebruik minstens drie runs voor taken met grote impact als eerste consistentiecontrole. Drie pogingen blijven een kleine steekproef, dus breid de set uit wanneer fouten kostbaar zijn of de uitvoer varieert.
Wat is het verschil tussen Muse Wonder en Muse Wonder Full?
Het zijn afzonderlijke modelvarianten met verschillende beschikbaarheidsroutes. Behandel standaard Wonder bij maximale reasoning niet als Full, en draag resultaten niet tussen hen over zonder een overeenkomende test.
Kan ik de Muse Wonder-benchmarkscores van Meta vertrouwen?
Gebruik ze als door de leverancier gerapporteerd capaciteitsbewijs en lees de benchmarkopzet. Ze bewijzen geen consistente prestaties over je prompts, tools en herhaalde runs.
Is Muse Wonder beschikbaar op Atlas Cloud?
Ik kon het per 15 oktober 2026 niet verifiëren in de modelcatalogus van Atlas Cloud. Controleer de live catalogus voordat je een uitvoeringsprovider kiest.





