

Een stem kan klinken alsof iemand tranen inhoudt, terwijl het geanimeerde gezicht neutraal blijft. Bij OmniHuman 2.0 emotionele stem- en gezichtsuitdrukkingsmatching is de eerste oplossing vaak beter luisteren, niet meer bijvoeglijke naamwoorden toevoegen. De audio bevat al woorden, timing en vocale nadruk; een korte prompt moet de zichtbare performance aansturen die die signalen ondersteunt.
Deze gids biedt makers een herhaalbare manier om een portret en track voor te bereiden, een gerichte prompt te schrijven en het resultaat te beoordelen op betekenisvolle mismatches. Het behandelt spraak en zang, en scheidt gedocumenteerde informatie van richtlijnen van derden en niet-geverifieerde productclaims.
Belangrijkste punten
- Behandel de audio als de basis van de performance en stuur alleen zichtbare acties, kadrering en scènedetails aan.
- Markeer emotionele momenten voordat je een prompt schrijft en controleer diezelfde momenten met het geluid uit en aan.
- Wijzig één variabele per nieuwe poging; een prompt kan niet elk probleem met de bronaudio of generatie oplossen.
Hoe OmniHuman 2.0 audio, gezichtsuitdrukking en beweging met elkaar verbindt
Een nuttige manier om over een audiogestuurd portretmodel na te denken, is elke input een taak toe te wijzen. De afbeelding verankert het zichtbare subject. De opname levert de spraak of het lied, inclusief timing en voordracht. Optionele tekstuele sturing kan de performance of scène beschrijven. Het exacte gedrag en de bediening kunnen per productimplementatie verschillen, dus behandelt algemeen OmniHuman-onderzoek of de instructies van een externe studio niet als officiële specificaties van OmniHuman 2.0.
Het oorspronkelijke OmniHuman-1-onderzoek beschrijft menselijke animatie die is geconditioneerd op combinaties van beeld, tekst, audio en pose. Dat paper vestigt de bredere framing van de onderzoeksfamilie, niet de exacte interface, limieten of kwaliteit van OmniHuman 2.0 (ICCV 2025, OmniHuman-1 paper).
| Input | Waarschijnlijke bijdrage | Wat je kunt voorbereiden |
|---|---|---|
| Referentieportret | Uiterlijk en beginpose van de persoon | Kies een duidelijk gezicht en kadrering die passen bij de beoogde beweging |
| Gesproken of gezongen audio | Woorden, cadans, pauzes, vocale energie | Gebruik een schone track met bewuste voordracht en trim irrelevante stilte |
| Optionele stuurprompt | Zichtbare acties, kadrering, scène- of stemmingssignalen | Geef een paar concrete aanwijzingen die overeenkomen met de opname |
Lip-synchronisatie en emotionele performance zijn verwant, maar het zijn niet dezelfde kwaliteitscontrole. Een mond kan lettergrepen volgen terwijl de ogen, het hoofd of een gebaar niet bij de zin passen. Omgekeerd kan een gezicht expressief lijken terwijl de timing afwijkt van de stem. Beoordeel beide.
Gidsen van derden over OmniHuman 2.0 beschrijven een workflow met afbeelding plus audio en optionele tekstuele sturing, maar die pagina's zijn geen technische documentatie van BytePlus. De openbaar toegankelijke Atlas-documentatie gaat over het eigen Avatar Omni Human 1.5-model, niet over OmniHuman 2.0. De veiligste werkassumptie is daarom praktisch in plaats van absoluut: laat de audio suggereren wat de performance nodig heeft, en gebruik de prompt om zichtbare keuzes aan te vragen die je kunt inspecteren.
Kies een portret en audiotrack die emotie leesbaar maken
Een model kan niet inspelen op signalen die moeilijk te zien of te horen zijn. Begin met inputs die het een eerlijke, eenvoudige taak geven, en houd ze vervolgens vast terwijl je de promptformulering test.
| Startinput | Waarom het kan helpen | Complicatie om op te letten |
|---|---|---|
| Een scherp, onbelemmerd gezicht met gelijkmatig licht | Maakt gezichtskenmerken makkelijk leesbaar | Sterke schaduwen, haar, handen of rekwisieten kunnen belangrijke delen bedekken |
| Neutrale of licht expressieve beginpose | Laat ruimte voor de performance om te veranderen | Een sterke vaste uitdrukking kan conflicteren met een andere vocale stemming |
| Eén duidelijke voorgrondstem | Maakt spraak en pauzes makkelijker te volgen | Muziek, kamerruis of overlappende sprekers kunnen signalen maskeren |
| Bewuste frasering met hoorbare pauzes | Geeft je momenten om aan zichtbare acties te koppelen | Vlakke voordracht biedt mogelijk minder duidelijke emotionele veranderingen |
| Een lied met de stem voorop en duidelijke frases | Maakt gezongen woorden en dynamiek makkelijker te herkennen | Instrumentale passages bieden minder vocale signalen voor mondbeweging |
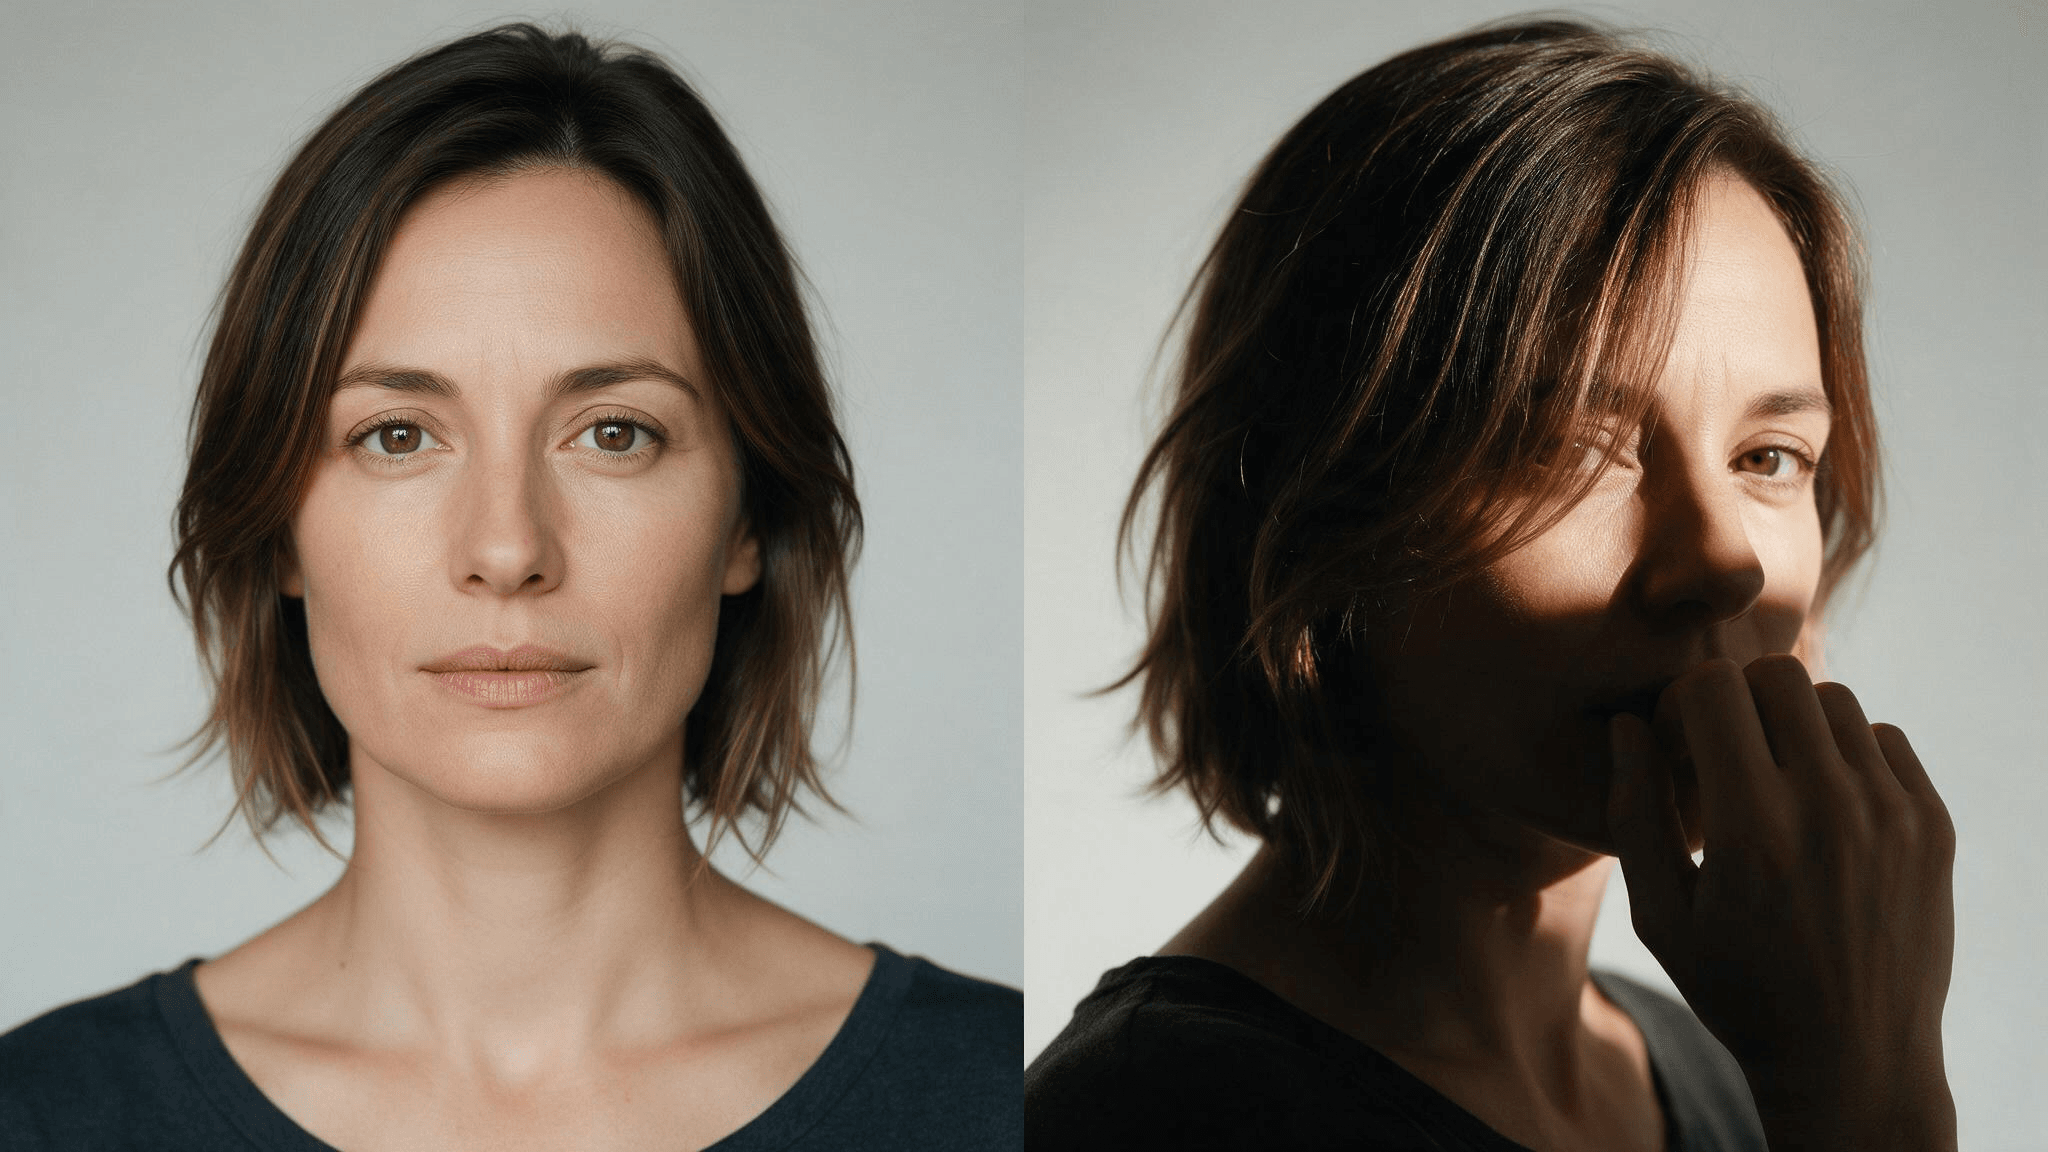 Illustratieve portretvergelijking: de duidelijke, frontale weergave maakt gezichtssignalen makkelijker te inspecteren dan de schaduwrijke, deels verduisterde weergave. Dit is geen vergelijking van modeloutput.
Dit zijn productiecontroles, geen garanties. Een goede input kan nog steeds een zwakke take opleveren, en een visueel expressief portret garandeert geen coherente animatie. Gebruik voor een eerste test één portret, één kort audiosegment en één enkele prompt. Vermijd het tegelijk wijzigen van de uitsnede, opname en sturing; anders weet je niet welke aanpassing hielp.
Luister bij zang naar frase-einden, aangehouden noten en veranderingen in intensiteit. De prompt kan een hoofdkanteling of handbeweging rond een muzikale beat aansturen, maar mag geen songtekst herhalen die al in de opname zit. Markeer bij gesproken dialoog pauzes en nadrukwoorden. Een prompt die vraagt om een grote stemmingomslag tijdens een continue kalme zin kan een performance opleveren die opgelegd aanvoelt.
Een promptraamwerk voor het afstemmen van stem en gezichtsuitdrukking
Houd de sturing kort genoeg om te kunnen beoordelen. Een praktische structuur is:
Kadrering + spreker en voordracht + emotie consistent met de track + een of twee zichtbare acties + optionele camerasturing.
Bijvoorbeeld, als een spreker warm en beheerst klinkt, kun je schrijven:
Statische medium close-up. De vrouw spreekt warm tegen de camera, begint beheerst en laat een kleine glimlach verschijnen op de laatste zin. Ze knikt één keer zachtjes na de pauze. Houd de kadrering stabiel.
Dit is een illustratieve prompt, geen gerapporteerde OmniHuman 2.0-run. Het nuttige kenmerk is dat elke instructie aan iets zichtbaars gekoppeld is: het shot blijft stabiel, de uitdrukking verschuift tegen het einde, en de knik heeft een cue. Je kunt de uitkomst vergelijken met de track in plaats van een brede opdracht zoals “wees emotioneel” te beoordelen.
Een promptgids van een derde partij adviseert beknopte sturing in natuurlijke taal en het afstemmen van de gevraagde emotie op de stem. Behandel dat als een praktische heuristiek, niet als een garantie of officiële productregel (KreatorFlow-promptgids).
Controleer een prompt voordat je hem gebruikt tegen de opname:
- Als de stem zacht en ingehouden is, vraag dan om een subtiele uitdrukking in plaats van een brede grijns.
- Als de voordracht zelfverzekerder wordt, plaats de zichtbare verandering dan na de hoorbare verschuiving.
- Als de opname een lach, pauze of zucht bevat, bepaal dan of het gezicht op dat moment moet vasthouden, reageren of bewegen.
- Als het startportret al de gewenste uitdrukking toont, vermijd die dan opnieuw te beschrijven, tenzij je wilt dat de uitdrukking verandert.
Gebruik temporele woorden zoals “eerst”, “dan” en “ten slotte” alleen wanneer de audio duidelijke momenten heeft. Vermijd het stapelen van tegenstrijdige instructies zoals “statische kadrering” en “ronddraaiende camera”, of “kalm” en “woedend”. Een prompt is sturing voor een bestaande performance, geen vervangende stemtrack.
Drie promptpatronen voor spraak, emotionele verschuivingen en zang
Kies het kleinste patroon dat bij je audio past. Deze voorbeelden zijn templates om aan te passen, geen geverifieerde outputclaims.
Kalme uitleg
Stabiele medium close-up. De spreker legt het punt kalm uit, met een beheerste uitdrukking en één klein nadrukkelijk gebaar. Houd de camera stil.
Gebruik dit wanneer de track rustig en consistent is. Eén gebaar kan nadruk zichtbaar maken zonder een eenvoudige uitleg in een theatrale performance te veranderen.
Een verandering in emotie
Statische close-up. De spreker begint serieus en verzacht dan tot een kleine glimlach na de pauze voor de laatste zin. Houd de beweging ingehouden.
Gebruik dit alleen wanneer de opname een pauze of hoorbare verandering bevat die de verschuiving ondersteunt. Als er geen cue is, kan de overgang willekeurig lijken.
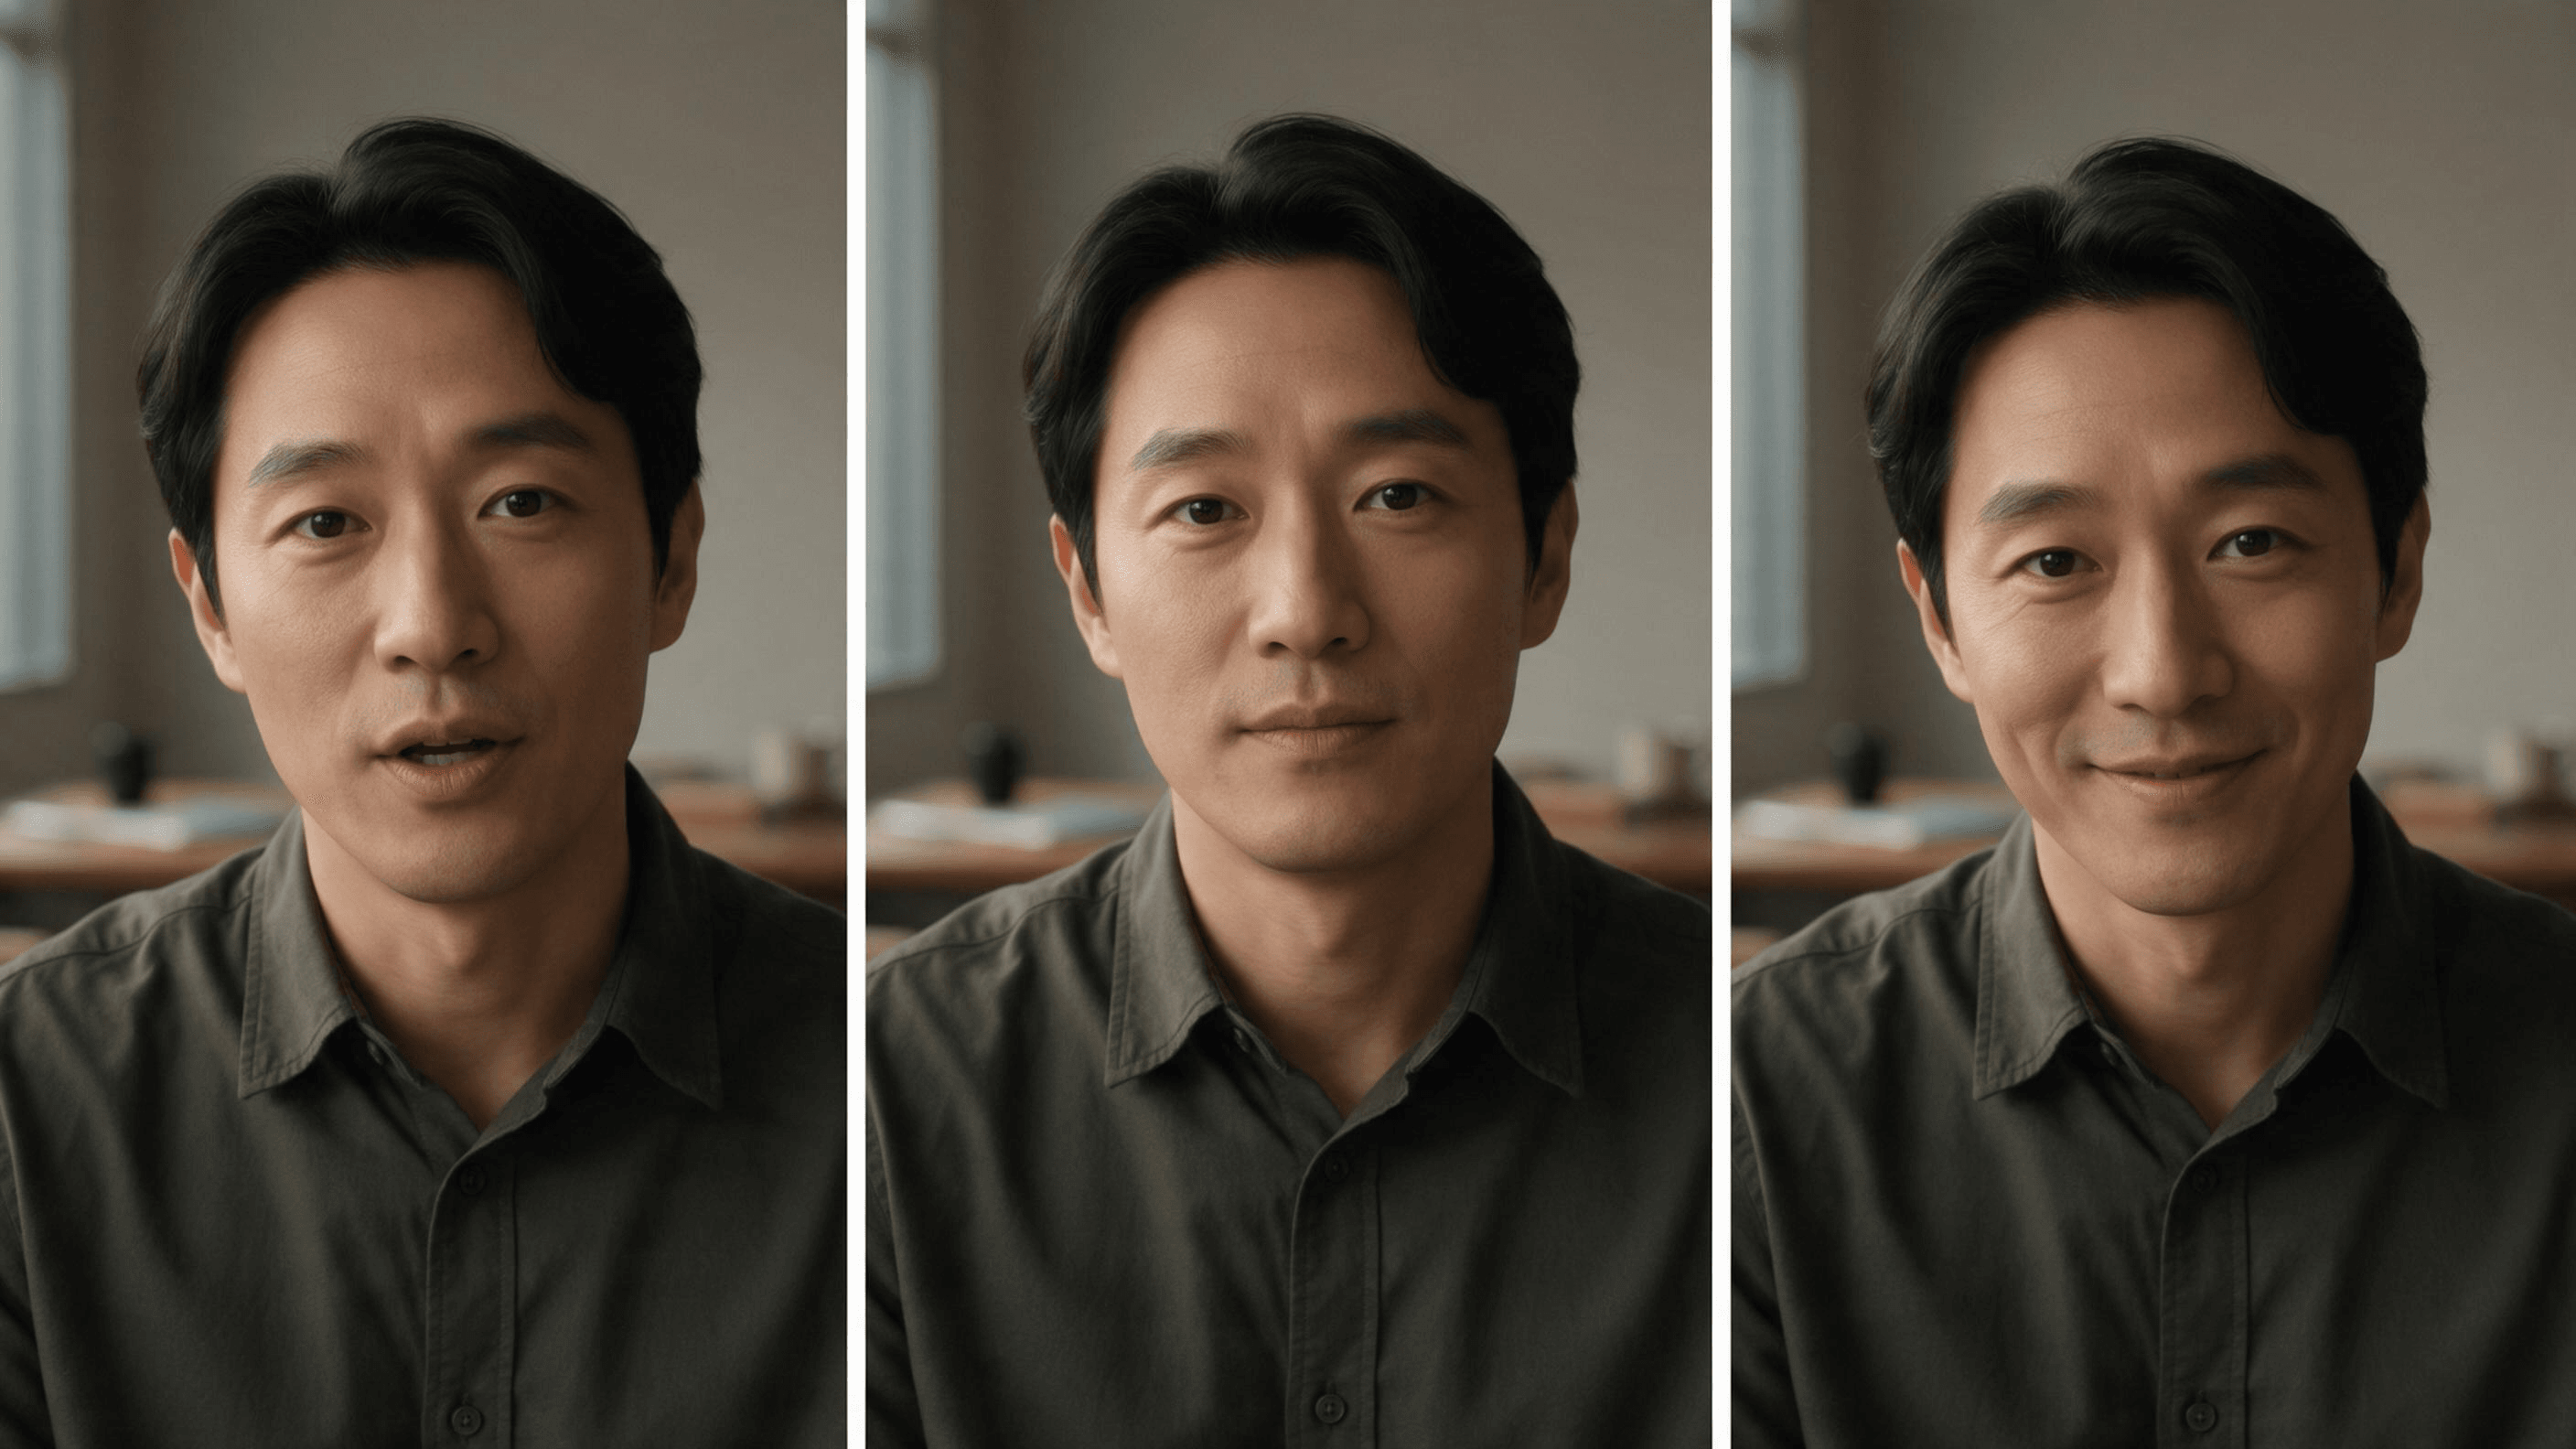 Conceptueel storyboard voor de spraakprompt: serieuze voordracht, een pauze en dan een ingehouden glimlach. Dit zijn geplande gezichts-momenten, geen frames uit een OmniHuman 2.0-generatie.
Zang
Medium close-up. De zangeres zingt met een gefocuste uitdrukking, sluit kort haar ogen op de aangehouden noot en laat dan haar kin zakken aan het einde van de frase. Houd de kadrering stabiel.
Stuur de performance aan rond muzikale gebeurtenissen in plaats van songtekst te herhalen. De prompt kan zichtbare actie suggereren; de aangeleverde track blijft de bron van de gezongen woorden en timing.
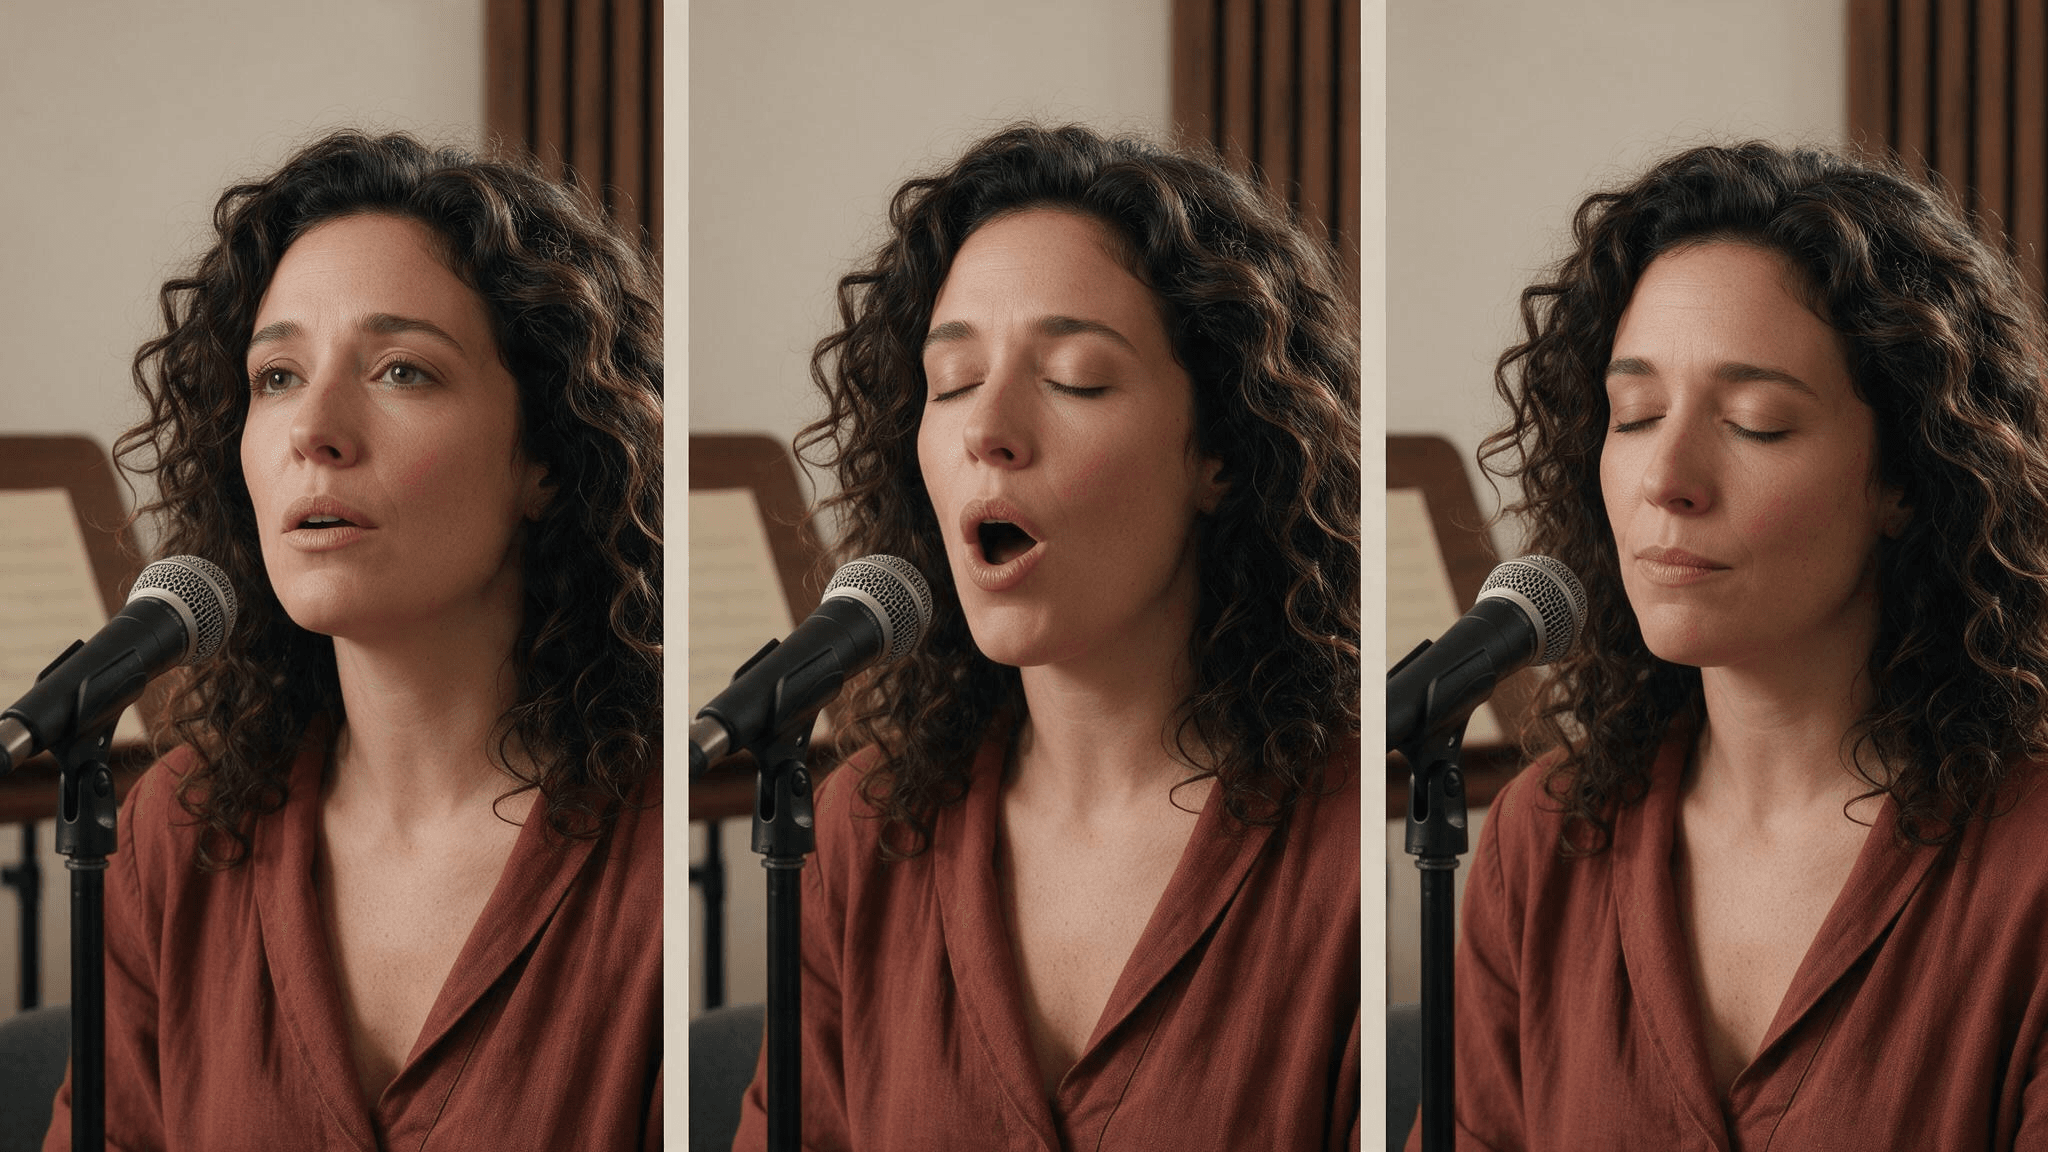 Conceptueel storyboard voor de zangprompt: begin de frase, houd een noot vast en kom dan tot rust aan het einde. Stilstaande beelden tonen geen audiosynchronisatie aan.
Vergelijk “wees emotioneel en cinematisch” met “spreek warm en glimlach dan na de pauze”. De eerste laat de emotie, timing en zichtbare actie open voor interpretatie. De tweede geeft je één specifiek moment om te inspecteren. Als het resultaat dat moment mist, heb je een gerichte volgende test: verplaats de cue, verzacht de uitdrukking of kies een andere audiobewerking.
Een controle in drie ronden voor het afstemmen van stem en gezicht
Een snelle beoordelingsmethode kan onthullen of het probleem in de audio, de visuele sturing of de gegenereerde take zit. Gebruik dezelfde tijdstempels bij alle drie de rondes.
De stille loop hieronder laat je het zichtbare deel van een sprekende performance inspecteren: mondbeweging, blik en gezichtsveranderingen. Gebruik de originele clip met geluid voor de stem-naar-gezicht-controle.
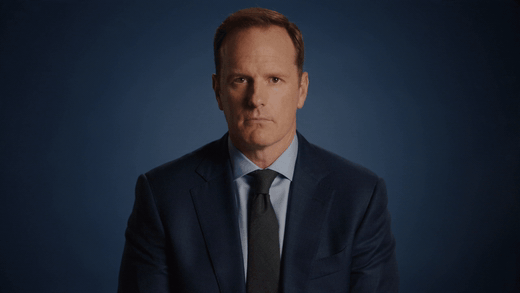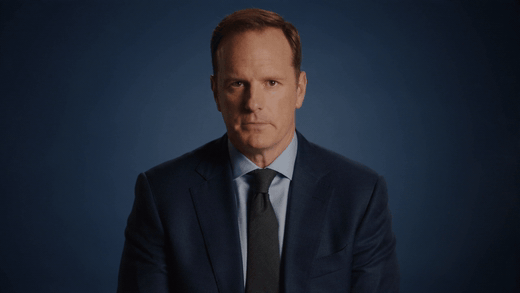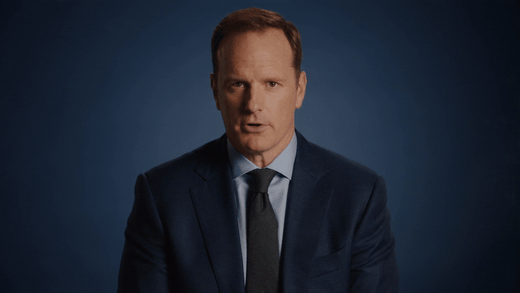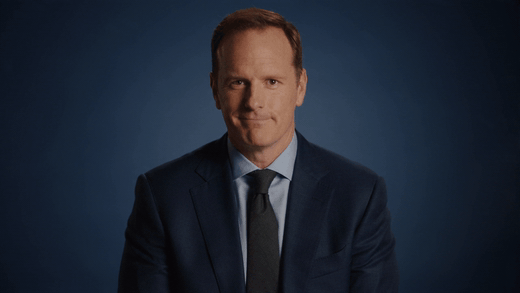
Stille GIF geconverteerd van de aangeleverde avatarvideo. Het toont zichtbare beweging, maar kan op zichzelf geen audiosynchronisatie of OmniHuman 2.0-performance vaststellen.
- Luister zonder te kijken. Markeer emotionele veranderingen, pauzes, nadruk, lachen, fluisteringen en frase-einden. Schrijf op wat een luisteraar alleen uit de stem zou kunnen afleiden.
- Kijk met het geluid uit. Noteer op die tijdstempels het gezicht, de blik, hoofdbeweging en gebaren. Leg vast wat de performance zonder geluid lijkt te communiceren.
- Speel ze samen af. Markeer alleen mismatches die de betekenis veranderen of afleiden van de zin. Een kleine glimlach onder een verontruste zin kan belangrijk zijn; een kleine knipperbeweging meestal niet.
Een beoordelingstabel zet die observaties om in één volgende actie:
| Tijd | Stemsignaal | Zichtbaar signaal | Match? | Kleinste volgende test |
|---|---|---|---|---|
| 00:04 | Stille, gespannen zin | Brede glimlach | Nee | Verminder de gevraagde glimlachintensiteit |
| 00:09 | Pauze voor een geruststellende zin | Gezicht blijft stil | Misschien | Voeg één subtiele knik toe na de pauze |
| 00:13 | Gelach in de opname | Uitdrukking blijft serieus | Nee | Controleer of de audiobewerking het gelach duidelijk behoudt |
De vermeldingen hierboven zijn hypothetische voorbeelden van hoe je de tabel gebruikt, geen observaties uit een modelrun. Je beoordelingsnotities moeten naar je eigen clip verwijzen. Wijzig één ding tegelijk: herzie de prompt, pas de audiobewerking aan of probeer een ander portret. Herhaal vervolgens dezelfde controles op dezelfde momenten.
Als de mismatch aanhoudt ondanks een duidelijke cue en een gerichte sturing, behandel die dan als een generatielimiet voor die take. Meer bijvoeglijke naamwoorden kunnen ruis toevoegen zonder het timing- of performanceprobleem op te lossen. Bepaal of een andere input of workflow het testen waard is, of dat de take al geschikt is voor de beoogde context.
Problemen met vlakke of niet-passende uitdrukkingen oplossen
Gebruik het symptoom om een gecontroleerde volgende stap te kiezen. Dit zijn algemene hypotheses voor probleemoplossing, geen geverifieerde defectclaims over OmniHuman 2.0.
| Wat je opmerkt | Mogelijke oorzaak | Eén volgende test |
|---|---|---|
| Het gezicht ziet er de hele clip neutraal uit | De stem heeft weinig contrast, of de sturing heeft geen zichtbaar signaal | Gebruik een expressiever audiogedeelte of vraag om één concrete actie op een duidelijke beat |
| Het gezicht overdrijft een subtiele zin | De prompt vraagt om sterkere emotie dan de track ondersteunt | Verwijder extra acties en verlaag de emotionele intensiteit |
| De mond lijkt niet synchroon | De opname heeft ruis, overlappende stemmen, lange stilte of moeilijke cuts | Probeer een schonere bewerking met strakkere timing voordat je de prompt herschrijft |
| Een luisteraar lijkt te spreken in een groepsafbeelding | De rollen van spreker en luisteraar kunnen onduidelijk zijn in de geteste workflow | Identificeer elke persoon op positie en geef aan wie spreekt, als de interface dat ondersteunt |
| Identiteit of fijne details verschuiven tijdens beweging | De bronkadrering of gevraagde beweging kan consistentie moeilijker te beoordelen maken | Vereenvoudig beweging en vergelijk een kortere, stabielere take |
Ga niet uit van een oplossing alleen via de prompt voor een audioprobleem. Controleer eerst of de woorden duidelijk zijn en of stilte of bewerkingen het ritme verstoren. Als die in orde zijn, vereenvoudig dan de zichtbare sturing. Een gerichte nieuwe poging geeft je beter bewijs dan elke input tegelijk herschrijven.
Is OmniHuman 2.0 beschikbaar op Atlas Cloud?
De huidige openbare modelpagina's van Atlas Cloud vermelden Avatar Omni Human 1.5 en documenteren de inputs voor afbeelding, audio en optionele prompt. Ik heb OmniHuman 2.0 tijdens deze controle niet gevonden in de Atlas-modelvermelding. Dat betekent dat het exacte 2.0-model niet moet worden gepresenteerd als uitvoerbaar via Atlas Cloud.
Als je een gerelateerde audiogestuurde avatartaak op Atlas wilt verkennen, bekijk dan de Avatar Omni Human 1.5-modelpagina en de gedocumenteerde inputs. De documentatie specificeert een referentieafbeelding, een audio-URL en een optionele prompt; ze beschrijft audio tot 60 seconden en raadt 15 seconden of minder aan voor de beste kwaliteit. Dat zijn v1.5-details, geen specificaties van OmniHuman 2.0. Controleer de huidige Atlas-modelcatalogus op actuele beschikbaarheid en prijs voordat je een workflow kiest. Ik kon tijdens het onderzoek geen actuele openbare prijs voor dit model bevestigen, dus dit artikel noemt er geen.
Controleer rechten en context voordat je publiceert
Voordat je een geanimeerd persoon deelt, bevestig dat je toestemming hebt om het portret en de stem voor het beoogde doel te gebruiken. Controleer ook muziek-, gelijkenis-, stem- en distributierechten voor de specifieke context. Vereisten kunnen verschillen per bronmateriaal en gebruik; deze checklist is praktische begeleiding, geen juridische conclusie.
Label synthetische of bewerkte media wanneer kijkers het redelijkerwijs kunnen aanzien voor documentairemateriaal of een actuele uitspraak van een echt persoon. Houd projectnotities bij over de bronbestanden en bewerkingen, vooral voor klant- of campagnewerk. Een technisch goed afgestemde performance heeft nog steeds een verantwoordelijke publicatiecontext nodig.
Voor OmniHuman 2.0 emotionele stem- en gezichtsuitdrukkingsmatching is de volgende nuttige stap een gecontroleerde test: kies een duidelijk portret, markeer de emotionele momenten in de audio, schrijf één korte sturing en beoordeel dezelfde tijdstempels met geluid uit en aan. Als je een door Atlas gehoste optie overweegt, verifieer dan eerst het exacte model en de actuele prijs.
Veelgestelde vragen
Genereert OmniHuman 2.0 de stem?
De workflow die door gidsen van derden wordt beschreven, begint met aangeleverde audio en animeert een portret daarnaar. Ga er niet van uit dat het model een stem genereert, tenzij de specifieke productinterface die mogelijkheid documenteert.
Kan OmniHuman 2.0 zowel zang als spraak animeren?
Gidsen van derden over OmniHuman 2.0 beschrijven zowel gesproken als gezongen audio. Gebruik voor een zangtest een gedeelte met de stem voorop en duidelijke frasering, en stuur vervolgens zichtbare acties aan rond een aangehouden noot of frase-einde.
Moet de prompt de dialoog of songtekst herhalen?
Meestal niet. De opname levert de woorden al. Gebruik de prompt voor zichtbare sturing zoals uitdrukking, gebaar, kadrering of een scène-cue, en vermijd het toevoegen van formuleringen die conflicteren met de track.
Wat moet ik eerst wijzigen als de uitdrukking verkeerd aanvoelt?
Gebruik de controle in drie ronden om de mismatch te lokaliseren. Als de audio zelf onduidelijk of emotioneel vlak is, test dan eerst een audiobewerking. Als de cue duidelijk is maar het gezicht die mist, vereenvoudig en hertim dan één promptsturing.
Staat OmniHuman 2.0 op Atlas Cloud?
Ik heb OmniHuman 2.0 tijdens dit onderzoek niet gevonden in de openbare modelcatalogus van Atlas Cloud. Atlas documenteert Avatar Omni Human 1.5 als een gerelateerde optie; verifieer de huidige vermelding voordat je die kiest.





