

Je vraagt een personage om door het kader te gebaren, maar je bron is een close-up van een gezicht. Geen enkele slimme zin kan de ontbrekende schouders, handen of kledingdetails met zekerheid herstellen. OmniHuman 2.0-generatie van volledige-lichaamsgebaren vanuit één afbeelding werkt het beste als een gecoördineerde keuze: geef het model een kader met de lichaamsdelen die je wilt laten bewegen, audio met een duidelijke cue voor de performance, en een korte prompt die één actie beschrijft.
OmniHuman is een audiogestuurd systeem voor het genereren van menselijke video's. De geadverteerde workflow combineert een stilstaand beeld en audio, met optionele tekststuring voor beweging of cameragedrag. Zie 'volledig lichaam' als het soort performance dat je wilt, niet als een garantie dat elk portret een complete, stabiele figuur kan produceren. De hier aangehaalde openbaar gedocumenteerde specificaties zijn voor OmniHuman 1.5, dus er mag niet van worden uitgegaan dat ze elke OmniHuman 2.0-interface of -implementatie beschrijven.
Belangrijkste punten
- De bronafbeelding bepaalt het zichtbare lichaamsgebied en de begincompositie.
- Audio levert timing voor spraak of zang; een prompt voegt visuele sturing toe.
- Stem de uitsnede af op het gebaar en houd de gevraagde actie binnen het zichtbare kader.
- Controleer versie, invoerlimieten en prijs op de actuele officiële productpagina voordat je je vastlegt.
Wat OmniHuman 2.0 doet voor gebaren met het hele lichaam
OmniHuman 2.0 wordt gepresenteerd als een beeld- en audiogestuurde manier om een video van een menselijke performance te maken. Het stilstaande beeld bepaalt het onderwerp en het beginbeeld. De audio geeft de performance een stem, ritme en timingreferentie. Optionele tekst kan de scène, beweging of camerarichting beschrijven. De gegenereerde clip combineert deze cues tot een bewegend resultaat.
Daardoor is de taak breder dan een stilstaande mond laten bewegen. Een bruikbare take kan lipbewegingen, expressie, hoofdbeweging, houding en handgebaren omvatten. Die onderdelen moeten overeenkomen met dezelfde performance. Voor een gesproken uitleg kan een klein gebaar met open handpalm bij een belangrijke zin natuurlijker overkomen dan continue armbeweging. Bij zang kan het lichaam de frasering en energie van de track volgen.
Het model ontvangt niet een complete 3D-registratie van de persoon vanuit één foto. Het moet afleiden wat zich buiten de uitsnede bevindt en hoe verborgen oppervlakken eruit moeten zien wanneer het onderwerp beweegt. Een verzoek om een actie met het hele lichaam brengt daarom meer onzekerheid met zich mee wanneer de input alleen het gezicht toont. De praktische controle is om de referentieafbeelding te kiezen rond de actie die je nodig hebt en vervolgens tekst te gebruiken om te verfijnen wat al visueel wordt ondersteund.
De onderzoeksprojectpagina voor OmniHuman 1.5 beschrijft audiogestuurde animatie vanuit één afbeelding en bespreekt bewegings- en promptsturing. Dat is nuttige achtergrond voor de modelfamilie, maar het is geen bewijs dat een bepaalde OmniHuman 2.0-prompt elke keer een specifiek gebaar oplevert (projectpagina van OmniHuman 1.5).
Definieer voordat je inputs kiest de beoogde opname in één zin: 'een presentator in beeld vanaf de taille benadrukt één punt', 'een artiest in volledig lichaamsbeeld verplaatst zijn gewicht tijdens het zingen', of 'een spreker in close-up brengt een kalme zin'. Het kader en de audio kunnen dan dat ene doel dienen.
Kies een bronafbeelding die ruimte laat voor het gebaar
Begin voor gebaren met het hele lichaam met de breedste bronafbeelding die nog bij de uiteindelijke compositie past. Als het resultaat bedoeld is als een close-up talking-headvideo, kan een strak portret geschikt zijn. Als de kijker moet zien dat een hand naar een object wijst of dat het onderwerp zijn gewicht verplaatst, neem die delen dan op in de bronafbeelding.
| Beoogd resultaat | Bruikbare beginuitsnede | Redelijke beweging om aan te vragen |
|---|---|---|
| Close-upvertelling | Hoofd en schouders | Expressie, hoofdbewegingen, ingehouden schouderbeweging |
| Productuitleg | Taillebreed met zichtbare handen | Kort wijzen, presenteren of benadrukken met open handpalm |
| Staande performance | Volledige figuur met ruimte rond het lichaam | Houdingsveranderingen, gewichtsverplaatsingen en grotere gebaren |
Dit zijn productiekeuzes, geen gepubliceerde BytePlus-vereisten of succesgaranties. Laat bij een kader voor het hele lichaam wat ruimte rond handen, ellebogen en voeten. Een hand die al tegen de rand staat, kan worden afgesneden zodra die beweegt. Houd het gezicht duidelijk genoeg leesbaar, gebruik waar mogelijk gelijkmatig licht en vermijd een bron waarin een ander persoon het onderwerp kruist. Een schone achtergrond maakt ongewenste achtergrondbeweging ook gemakkelijker te herkennen.
De afbeelding moet lijken op de opname die je wilt publiceren. Een portretbron die in een liggende uitvoer wordt geplaatst, kan meer verzonnen achtergrond en lichaamsgebied vereisen. Een verticaal gekaderde bron is vaak gemakkelijker te beoordelen voor een staand personage dat bedoeld is voor een verticale socialpost. Dit zijn compositierichtlijnen; controleer de actuele bediening van de doeltool voor eventuele werkelijke limieten voor beeldverhouding of resolutie.
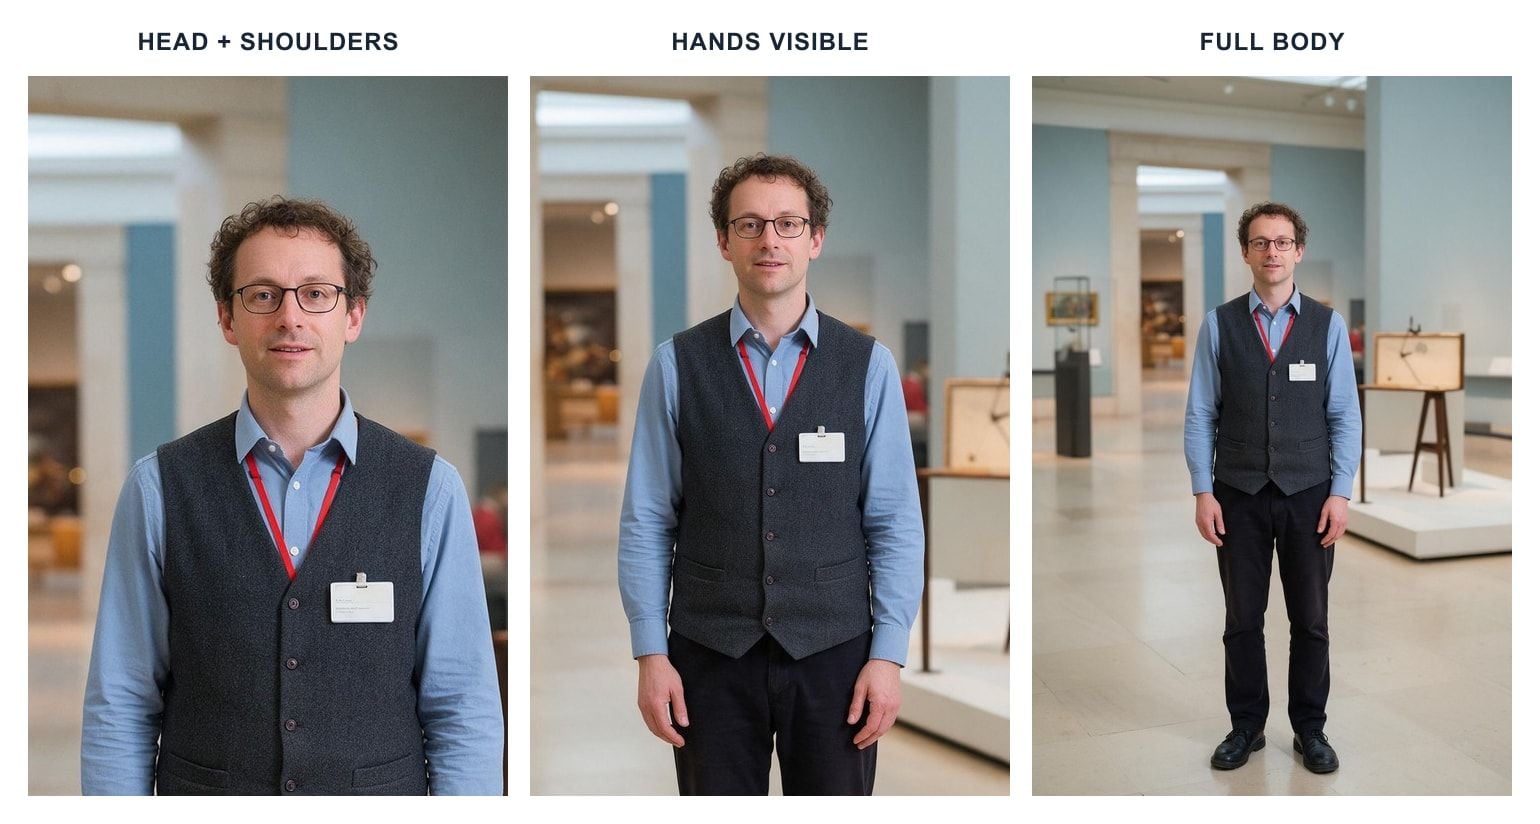
Dezelfde voorbeeldbronfoto in drie uitsneden: een close kader past bij gezichtsuitdrukking, zichtbare handen geven een presentator ruimte om te gebaren, en de volledige figuur ondersteunt een staande performance.
Een eenvoudige beslistest helpt: wijs het lichaamsdeel aan dat in de uiteindelijke opname moet bewegen. Als het ontbreekt in de bron, wijzig dan de afbeelding of verlaag het bewegingsdoel. Gebruik bijvoorbeeld een taillebrede afbeelding met zichtbare handen voor een presentator die 'drie praktische stappen' wil benadrukken. Een portret met alleen een gezicht past beter bij een korte begroeting of close-upvertelling.
Bouw een performance vanuit één afbeelding op basis van audio en sturing
Zie de inputs als drie verschillende taken. De afbeelding bepaalt wie in beeld is en hoe de opname begint. Audio draagt de daadwerkelijke woorden, pauzes en vocale energie. Tekststuring vraagt om visueel gedrag dat bij die cues past. Houd de inputs op elkaar afgestemd; een kalme stem gecombineerd met 'wild, constant dansen' geeft het model tegenstrijdige sturing en kan een ongemakkelijke performance opleveren.
Een nuttige workflow voor een eerste poging is:
- Kies de opname. Bepaal of de kijker een close gezicht, zichtbare handen of de volledige figuur nodig heeft. Kies een bron waarin dat gebied in het kader staat.
- Bereid representatieve audio voor. Gebruik een kort fragment van de echte voice-over of het echte nummer, inclusief de zin waarin het gebaar moet plaatsvinden. De test moet het uiteindelijke ritme en de uiteindelijke voordracht vertegenwoordigen.
- Voeg één bewegingsidee toe. Beschrijf één gebaar en waar het in de performance thuishoort. Houd andere acties en cameraverzoeken beperkt.
- Genereer en beoordeel. Controleer het gezicht, de handen, het lichaam, de achtergrond en de algehele framing. Wijzig bij de volgende poging steeds één input tegelijk.
Voor een productuitleg kan een originele testzin zijn: 'We behandelen drie praktische stappen, daarna kun je degene kiezen die bij jouw team past.' Neem die op met een korte pauze voor de zin 'drie praktische stappen'. Gebruik een taillebrede afbeelding met beide handen zichtbaar. Dat geeft het beoogde gebaar een duidelijke semantische cue en een zichtbaar bewegingsbereik.
De officiële BytePlus-documentatie die hier kan worden geverifieerd, verwijst naar OmniHuman 1.5, niet naar 2.0. Voor 1.5 noemt deze een afbeelding en audio als vereiste inputs, een optionele prompt, ondersteunde prompttalen en 720p- of 1080p-uitvoer. Het overzicht vermeldt ook een audiolimiet van 60 seconden en raadt kortere audio aan voor kwaliteit. Deze details helpen het gedocumenteerde 1.5-product te onderscheiden; verifieer de 2.0-interface of officiële documentatie voordat je een van deze punten op 2.0 toepast (BytePlus-documentatie voor OmniHuman-videogeneratie, bijgewerkt oktober 2026).
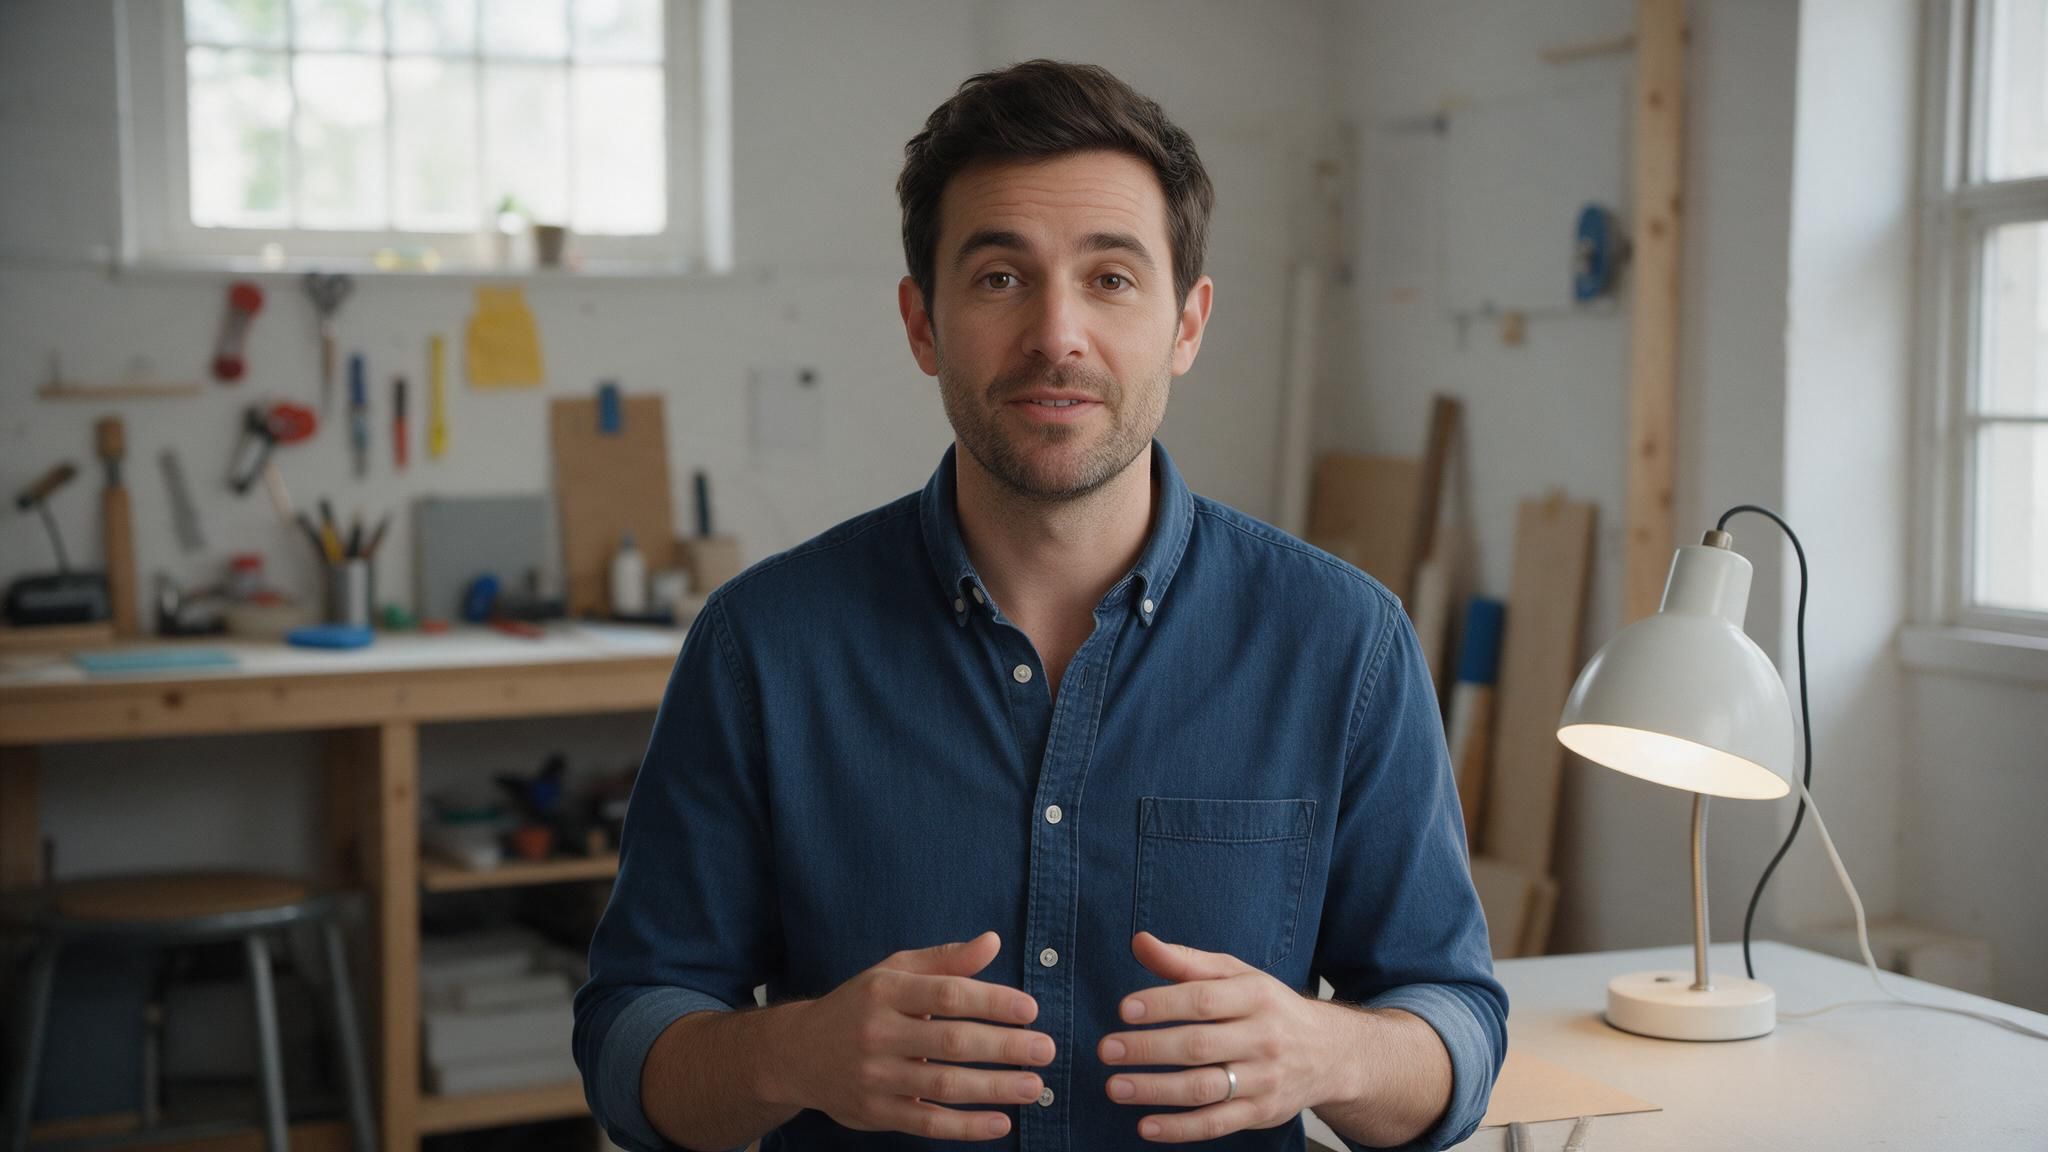
Voorbeeld van een stilstaand bronbeeld voor de productuitleg: het gezicht van de presentator, beide handen en de lamp zijn zichtbaar, waardoor een klein getimed handgebaar gemakkelijk te beoordelen is. Dit is een invoerfoto, geen OmniHuman-uitvoer.
Gebruik één representatief sample voordat je een lange opname voorbereidt. Een korte proef maakt het sneller om een niet-passende uitsnede, een zin zonder gebarencue of een prompt die te veel vraagt op te merken. Het is een kwaliteitskeuze, geen claim over een specifieke duurlimiet van 2.0.
Schrijf gebarenprompts met een duidelijke cue
Een prompt is gemakkelijker te beoordelen wanneer deze een actie, de cue, de omvang of het tempo en eventuele kaderbeperkingen benoemt. Een brede instructie zoals 'maak de persoon naturel en expressief' laat meerdere beslissingen open. Een gerichte instructie vertelt het model welke zichtbare actie belangrijk is en wanneer die moet plaatsvinden.
Probeer dit voorbeeld met de voorbeeldzin hierboven:
De spreker brengt de zin met een kalme, zelfverzekerde toon. Houd de camera stabiel. Wanneer de spreker 'drie praktische stappen' zegt, hef je één hand kort op om het punt te benadrukken en laat je die daarna natuurlijk zakken. Gebruik kleine, ontspannen gebaren die binnen het zichtbare kader blijven.
De geciteerde zin verbindt de actie met een moment in de audio. 'Hef één hand kort op' geeft een begrensd gebaar, en 'blijf binnen het zichtbare kader' voorkomt dat er beweging buiten de uitsnede wordt gevraagd. Dit is een template voor het schrijven van prompts, geen getest of gegarandeerd OmniHuman 2.0-commando. Als het systeem exacte woorden of timing niet consistent volgt, houd de zin dan als brede cue aan en beoordeel de gerenderde beweging in plaats van uit te gaan van frame-nauwkeurige choreografie.
Wijzig tussen pogingen slechts één hoofdvariabele. Als het gebaar te vroeg verschijnt, pas dan de cue of audiopauze aan. Als de handbeweging te groot is, verklein dan de gevraagde amplitude. Als de arm onstabiel is of deels verzonnen, kies dan een bron waarin de arm al zichtbaar is. Als je de afbeelding, audio, beweging en camerarichting tegelijk wijzigt, is het moeilijk te leren welke wijziging hielp.
Stapel geen niet-gerelateerde verzoeken op: een handzwaai, een aanwijzing, een draai, een wandeling, een camera-orbit en een emotionele verschuiving allemaal in één korte zin. Elk voegt een extra eis toe aan dezelfde performance. Begin met één doelgerichte beweging; voeg pas een tweede toe als het eerste resultaat leesbaar blijft en de scène erom vraagt.
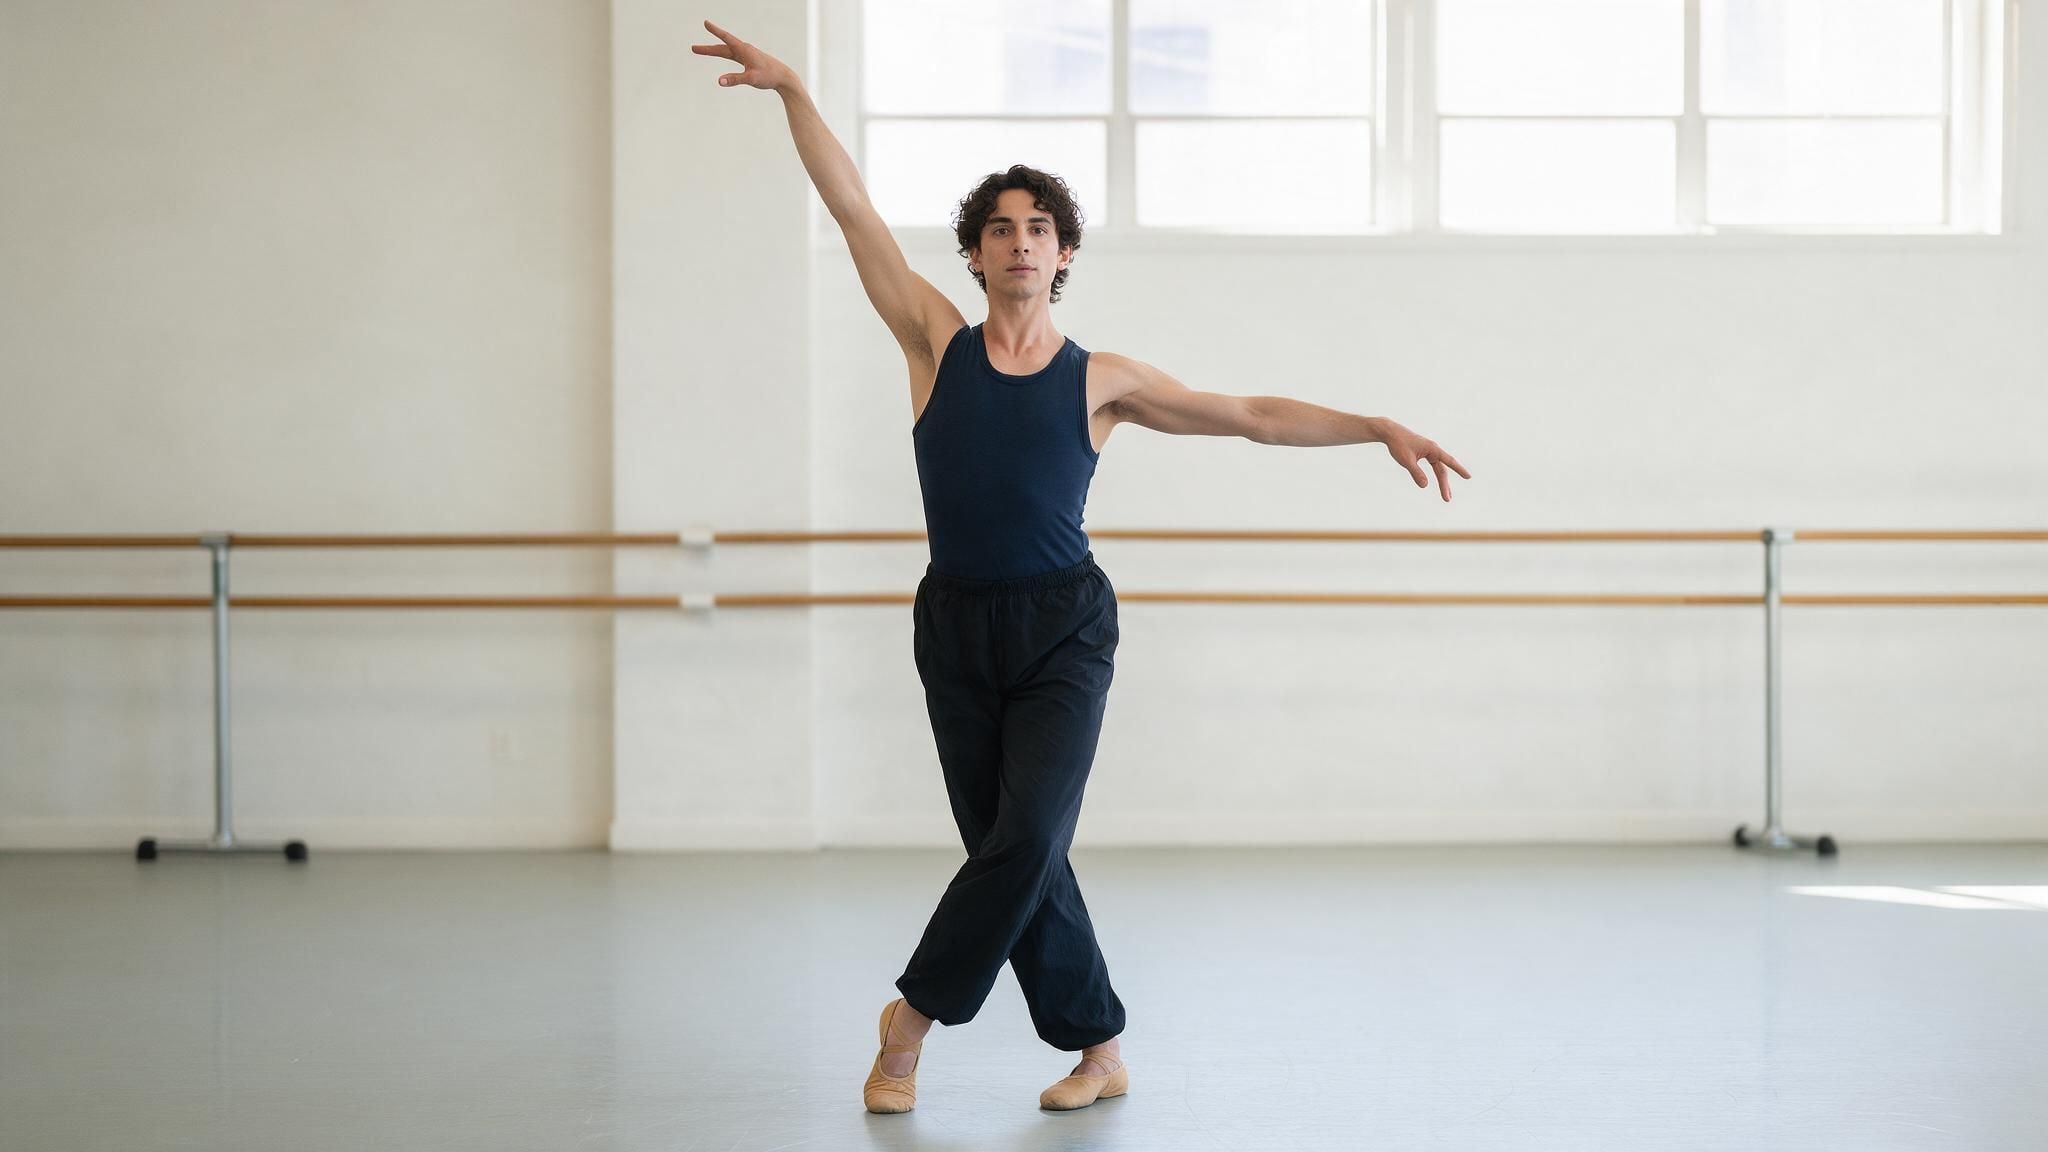
Voorbeeld van een stilstaand bronbeeld voor een gecoördineerde pose met het hele lichaam: de opgeheven arm, gestrekte arm en stappende voeten blijven binnen het kader. Dit is een referentieafbeelding voor het plannen van een gebaar, geen door OmniHuman gegenereerd frame.
Beoordeel het resultaat voordat je publiceert
Bekijk het resultaat één keer voor de algehele performance en daarna nog eens voor specifieke details. De tweede keer kijken is nuttig omdat een clip bij normale snelheid geloofwaardig kan aanvoelen, maar bij nadere inspectie een probleem met een hand of achtergrond kan onthullen.
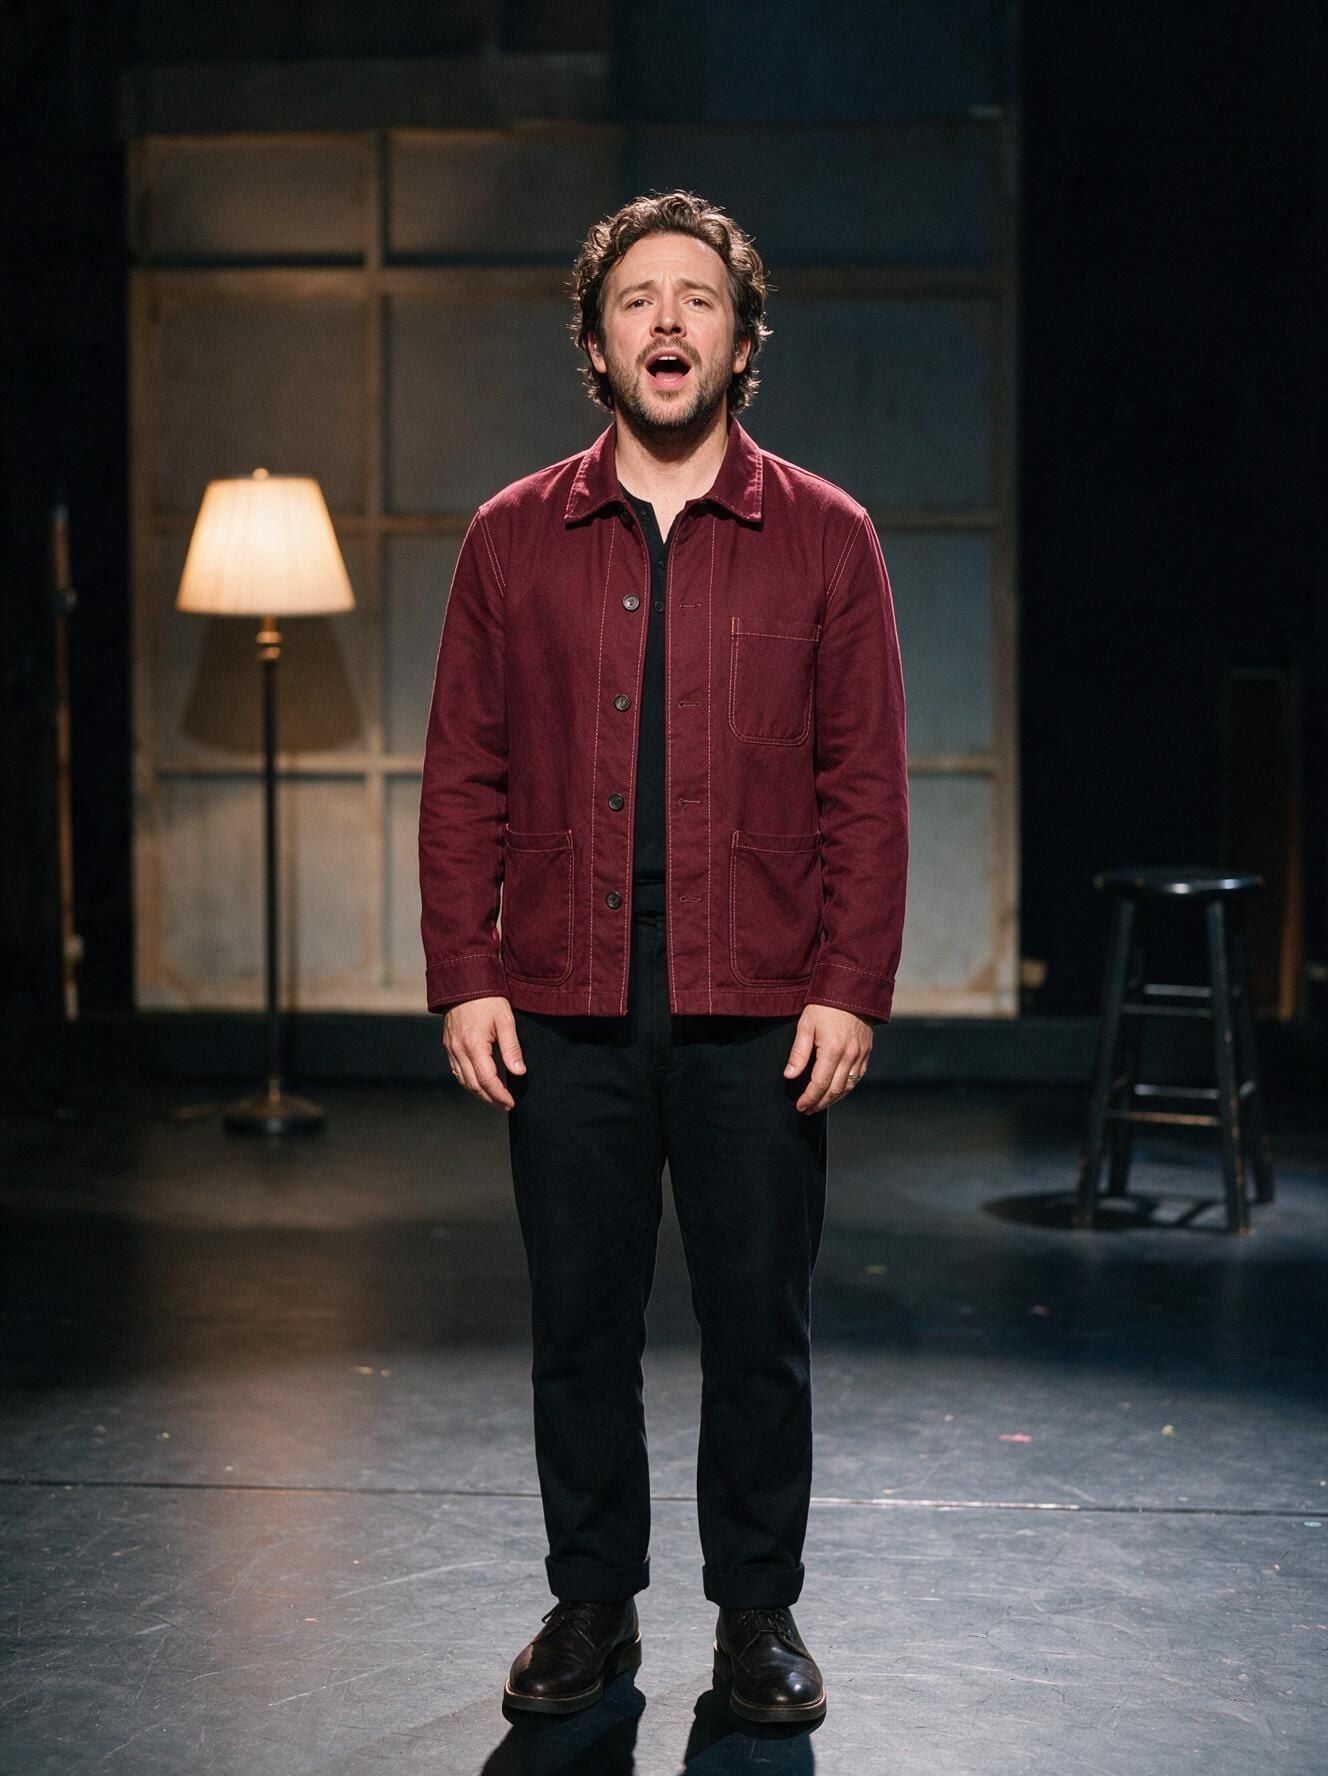
Voorbeeld van een stilstaand bronbeeld voor een staande performance: vergelijk elke gegenereerde take met het zichtbare gezicht, de handen, het jasje, de schoenen, de lamp en de kruk bij het controleren van identiteit en scèneconsistentie. Dit is een invoerfoto, geen gegenereerd frame.
Controleer deze vijf gebieden:
- Spraak en expressie: Volgt de mond grofweg de gesproken of gezongen zin? Passen de expressies bij de vocale voordracht?
- Timing van gebaren: Verschijnt de beweging rond het beoogde idee of de pauze? Stopt die wanneer de nadruk eindigt?
- Handen en lichaam: Let op kortstondig versmolten vingers, gebogen gewrichten, veranderende mouwen of lichaamsverhoudingen die tussen frames verschuiven.
- Identiteit en scène: Blijft het gezicht herkenbaar? Blijven kleding, achtergrondobjecten en belichting redelijk consistent?
- Framing van de voordracht: Zijn de handen of voeten afgesneden? Blijft het onderwerp duidelijk in de beeldverhouding en uitsnede die je nodig hebt?
Wanneer iets mislukt, koppel je de volgende poging aan de waargenomen oorzaak. Vervang de afbeelding wanneer het benodigde lichaamsgebied ontbreekt of de uitsnede geen bewegingsruimte laat. Vervang of verkort de audio wanneer de kernzin gehaast, onduidelijk of emotioneel niet passend is. Herschrijf de sturing wanneer de actie op het verkeerde moment komt of te breed is. Als de clip voor een publiekscampagne is, bevestig dan ook dat je toestemming hebt om de afbeelding te animeren en de stemopname te gebruiken, en verkrijg alle vereiste toestemming voor de mensen die worden weergegeven.
Een bruikbaar resultaat is niet noodzakelijk het resultaat met de meeste beweging. Voor een cursusintro of productuitleg kan een terughoudend gebaar dat de identiteit behoudt en het onderwerp binnen het kader houdt beter communiceren dan een uitgebreide actie die de aandacht op visuele fouten vestigt. Houd de take die de boodschap ondersteunt en aan het publicatieformaat voldoet, en bewaar de bronafbeelding, audio, prompt en geselecteerde uitvoer samen voor latere herzieningen.
OmniHuman 2.0-toegang, versies en prijzen
BytePlus vermeldt OmniHuman V2.0 in de documentatie over zijn spaarplannen voor videomodellen. Dat bevestigt dat de versienaam in BytePlus-materialen voorkomt, maar het bewijst geen publieke 2.0-playground, gedetailleerde invoerlimieten of een Atlas Cloud-endpoint (BytePlus AI Savings Plans). Controleer de exacte modelversie voordat je er een workflow omheen bouwt. De naam 'OmniHuman 2.0' mag niet als uitwisselbaar met 'OmniHuman 1.5' worden behandeld. De BytePlus-documentatie die momenteel voor dit artikel naar voren komt, is gelabeld als OmniHuman 1.5. Deze documenteert het eigen invoerschema en de servicebeperkingen, die niet naar 2.0 mogen worden overgedragen zonder een overeenkomstige officiële bron.
Op het moment dat dit voor dit artikel werd gecontroleerd, toonde de publieke modeldirectory van Atlas Cloud een brede modelcatalogus, maar daar kon geen detailpagina voor OmniHuman 2.0 worden geverifieerd. De specifieke Avatar Omni Human-modelpagina verwijst naar het aangrenzende 1.5-aanbod. De weergegeven vanaf-prijs is in de officiële materialen gerapporteerd als $0.12 per seconde, maar prijzen en kortingen kunnen veranderen. Controleer de detailpagina en de Atlas Cloud-modeldirectory opnieuw voordat je budgetteert of publiceert. Gebruik de 1.5-prijs niet als schatting voor 2.0.
Als je specifiek OmniHuman 2.0 nodig hebt, bevestig dan de officiële toegangsroute, huidige invoervereisten en prijs bij BytePlus voordat je productieassets voorbereidt. Als je openstaat voor een aangrenzende versie, kan de directory van Atlas Cloud je helpen verifiëren welke momenteel vermelde video- en avatarmodellen beschikbaar zijn vanuit één catalogus. Zie dat als een aparte productkeuze: een 1.5-run kan een 2.0-prompt of -resultaat niet valideren.
Veelgestelde vragen
Kan OmniHuman 2.0 een video van het hele lichaam genereren vanuit een afbeelding met alleen een gezicht?
Een afbeelding met alleen een gezicht toont niet de lichaamsdetails die nodig zijn om een performance met het hele lichaam te sturen. Een systeem kan ontbrekende gebieden afleiden, maar hun uiterlijk en beweging zijn minder direct gebaseerd op de bron. Gebruik voor een handgebaar een bron die de hand en voldoende arm toont. Begin voor een staande actie met een afbeelding van het hele lichaam.
Heeft OmniHuman 2.0 audio nodig, of kan een tekstprompt de afbeelding alleen animeren?
De beschreven OmniHuman-workflow wordt aangestuurd door een afbeelding en audio, met optionele tekststuring. Ga er niet van uit dat animatie van een afbeelding met alleen tekst wordt ondersteund door de exacte 2.0-service die je van plan bent te gebruiken. Controleer de huidige productpagina van die service voor de geaccepteerde inputs.
Hoe lang mag een audio-input voor OmniHuman 2.0 zijn?
Ik kon geen actuele officiële audioduurlimiet voor 2.0 verifiëren. Het gepubliceerde 1.5-overzicht van BytePlus vermeldt een limiet van minder dan 60 seconden en raadt kortere inputs aan voor kwaliteit, maar dat is een 1.5-specificatie. Bevestig de 2.0-limiet via het officiële toegangspunt voordat je een lange track opneemt of uploadt.
Is OmniHuman 2.0 al beschikbaar op Atlas Cloud?
Er kon geen openbare vermelding van OmniHuman 2.0 in de Atlas Cloud-directory worden geverifieerd toen dit artikel werd gecontroleerd. De aangrenzende OmniHuman-pagina van Atlas Cloud is voor 1.5. Controleer de directory opnieuw voor gebruik, omdat de beschikbaarheid in de catalogus kan veranderen.
Voordat je je volgende poging voor OmniHuman 2.0-generatie van volledige-lichaamsgebaren vanuit één afbeelding start, neem je eerst één beslissing: bepaal welk lichaamsgebied de uiteindelijke opname moet tonen en kies vervolgens een bron die dat al bevat. Verifieer de exacte versie en huidige limieten bij de service die je gaat gebruiken, en test één korte, representatieve audiopassage voordat je de volledige productieopname voorbereidt.





