MiniMax heeft H3 op vrijdag uitgebracht. Binnen vierentwintig uur was Seedance 2.5 in handen van mensen, en de tijdlijn stortte in tot één gesprek: dertig seconden, native 4K, vijftig referentie-inputs. H3's aankondigingspost stond er stil onder, met bijna niemand die er een echte test op draaide.
Ik snap waarom. Dertig seconden is een mooi getal. Het past in een kop.
Maar als je daadwerkelijk verticale korte drama's maakt, weet je dat het ding dat je nacht verpest niet seconde dertig is. Het is shot 4. De kaaklijn van de mannelijke hoofdrolspeler verschuift een halve centimeter, zijn cravatte verliest een plooi, en de kijker veegt weg voordat de haak landt. Niemand haakt af omdat een clip vijftien seconden was in plaats van dertig. Ze haken af omdat de man in de close-up niet de man uit de wide shot is.
Dus ik sloeg het specificatieblad-duel over. Ik bouwde één character turnaround sheet, één zes-panel locatiebord, schreef één 15-seconden gothic short-drama prompt, en stuurde het identieke pakket naar beide kanten. Toen staarde ik naar het gezicht.
Belangrijkste conclusies
- Alleen H3 is vandaag aanroepbaar — Seedance 2.5's API is uit bij ByteDance, maar nog een Day-0 pagina op dit platform.
- Specificaties splitsen duidelijk: Seedance 2.5 = 30s in één shot, native 4K, tot 50 referenties; H3 = 5–15s, 2K, stereo audio op elke clip.
- Karakterstabiliteit is een verpakkingsprobleem — één goed referentiepakket, niet een groter model, houdt het gezicht vast.
- Beide genereren native audio; H3 koppelt ook een stem aan maximaal drie audio-referenties.
- Beoordeel pixels per frame, niet seconden — op dezelfde run leverde H3 1440p tegen Seedance's 720p.
Het Seedance 2.5 vs MiniMax H3 Resultaat, Zonder Theorie
Zonder theorie, hier is wat de workflow produceert. Dit zijn vier shots uit een afgewerkte 15-seconden verticale clip, getegeld. Het is MiniMax's eigen H3-referentierun, gebouwd van exact het character sheet en locatiebord dat je in Stap 1 en Stap 2 zult zien, op native 1440x2560. Mijn eigen runs van hetzelfde pakket komen later, in de tutorial, met de playground-status zichtbaar.
Ze bereikt de gebeeldhouwde deur, paneel 4 van het locatiebord, dan de gang-standoff, dan een strakke close-up van hem, dan de two-shot. Zijn haarlijn scheidt op dezelfde manier in het profiel en in de close-up. Haar half-opgestoken gevlochten kroon overleeft een close-up van het hele gezicht, precies waar de meeste modellen stilletjes een gezicht herbouwen. De crèmen kanten lijfje behoudt dezelfde halslijn en manchet van het eerste frame tot het laatste.
Dat is de hele test. Geen dertig seconden. Vier shots en een kaaklijn.
Waarom Seedance 2.5 vs MiniMax H3 dezelfde week uitkwamen, en waarom de meeste karaktertesten nutteloos zijn
MiniMax bracht H3 uit op 30 juli, een algemeen multimodaal videomodel dat tekst, afbeeldingen, video en audio als één context leest en 5 tot 15 seconden clips retourneert tot 2K met native stereogeluid. Het kan ook bestaande beelden bewerken en beweging van de ene clip naar de andere overdragen, en MiniMax zei dat gewichten binnen enkele dagen zouden volgen (Reuters, juli 2026).
Seedance 2.5 landde in hetzelfde venster met een luider getal: 30 seconden in één enkele generatie, native 4K, en tot 50 multimodale referentie-inputs in één taak (The Next Web, juli 2026). De API is al in handen van ontwikkelaars, met gelokaliseerde bewerking die een deel van een frame hertekent terwijl prestatie, belichting en cameragedrag intact blijven, referentie-naar-video dat green-screen plates of 3D white-model blockouts accepteert, elf talen, en een experimentele lange video-modus die 180 seconden bereikt (CineD, juli 2026).
De aandachtsscheiding is het interessante deel. Bijna elke post die ik kon vinden was een 2.5-clip. Ondertussen zeggen de publieke arena-nummers iets anders: op de Artificial Analysis image-to-video leaderboard, leidt Seedance 2.0 op 720p met 1.196 Elo, Gemini Omni Flash volgt met 1.195, en MiniMax H3 is al derde met 1.185, vier dagen na de lancering. Seedance 2.5 heeft nog geen rating daar (Artificial Analysis, juli 2026). Het model met de minste buzz is degene met de hoogste verhouding van score tot aandacht.
Nu het gedeelte dat daadwerkelijk je output bepaalt, omdat het bijna niets te maken heeft met welk logo je kiest.
De meeste karakterconsistentie-testen falen voordat het model er zelfs bij betrokken is. Vier faalmodi, en alle vier zijn aan jou om op te lossen:
| Faalmodus | Wat je ziet in de output | De oplossing |
|---|---|---|
| Multi-view referenties gestuurd als losse bestanden | Elk shot's gezicht is "bijna goed" en geen twee komen overeen | Compositie de weergaven in één afbeelding, wijs dan rollen toe in de prompt ("de man LINKS", "de vrouw RECHTS") |
| De karakterbeschrijving per shot herschrijven | Kleding en accessoires drijven per shot | Schrijf het identiteitsblok eenmaal en hergebruik het letterlijk; alleen camera en actie veranderen per shot |
| Verlichting met de scène laten meebewegen | Het gezicht wordt structureel herbouwd in het nieuwe licht | Bouw een apart locatiebord dat lichtrichting, mist en vloerreflectie vastzet, en voer het als referentie |
| Maximale duur behandelen als kwaliteitsmaat | Eén drift binnen 30 seconden vernietigt alle 30 | Snijd naar de granulariteit die je kunt herrollen, praat dan over lengte |
Wil je Seedance 2.5 en MiniMax H3 zelf voor dezelfde prompt zetten? Atlas Cloud's modelvergelijking draait ze naast elkaar in één pas — identieke prompt en instellingen, met de kosten geschat voordat je genereert — zodat je gezichten, beweging en tekst op het scherm kunt beoordelen zonder twee aparte tests te boeken.
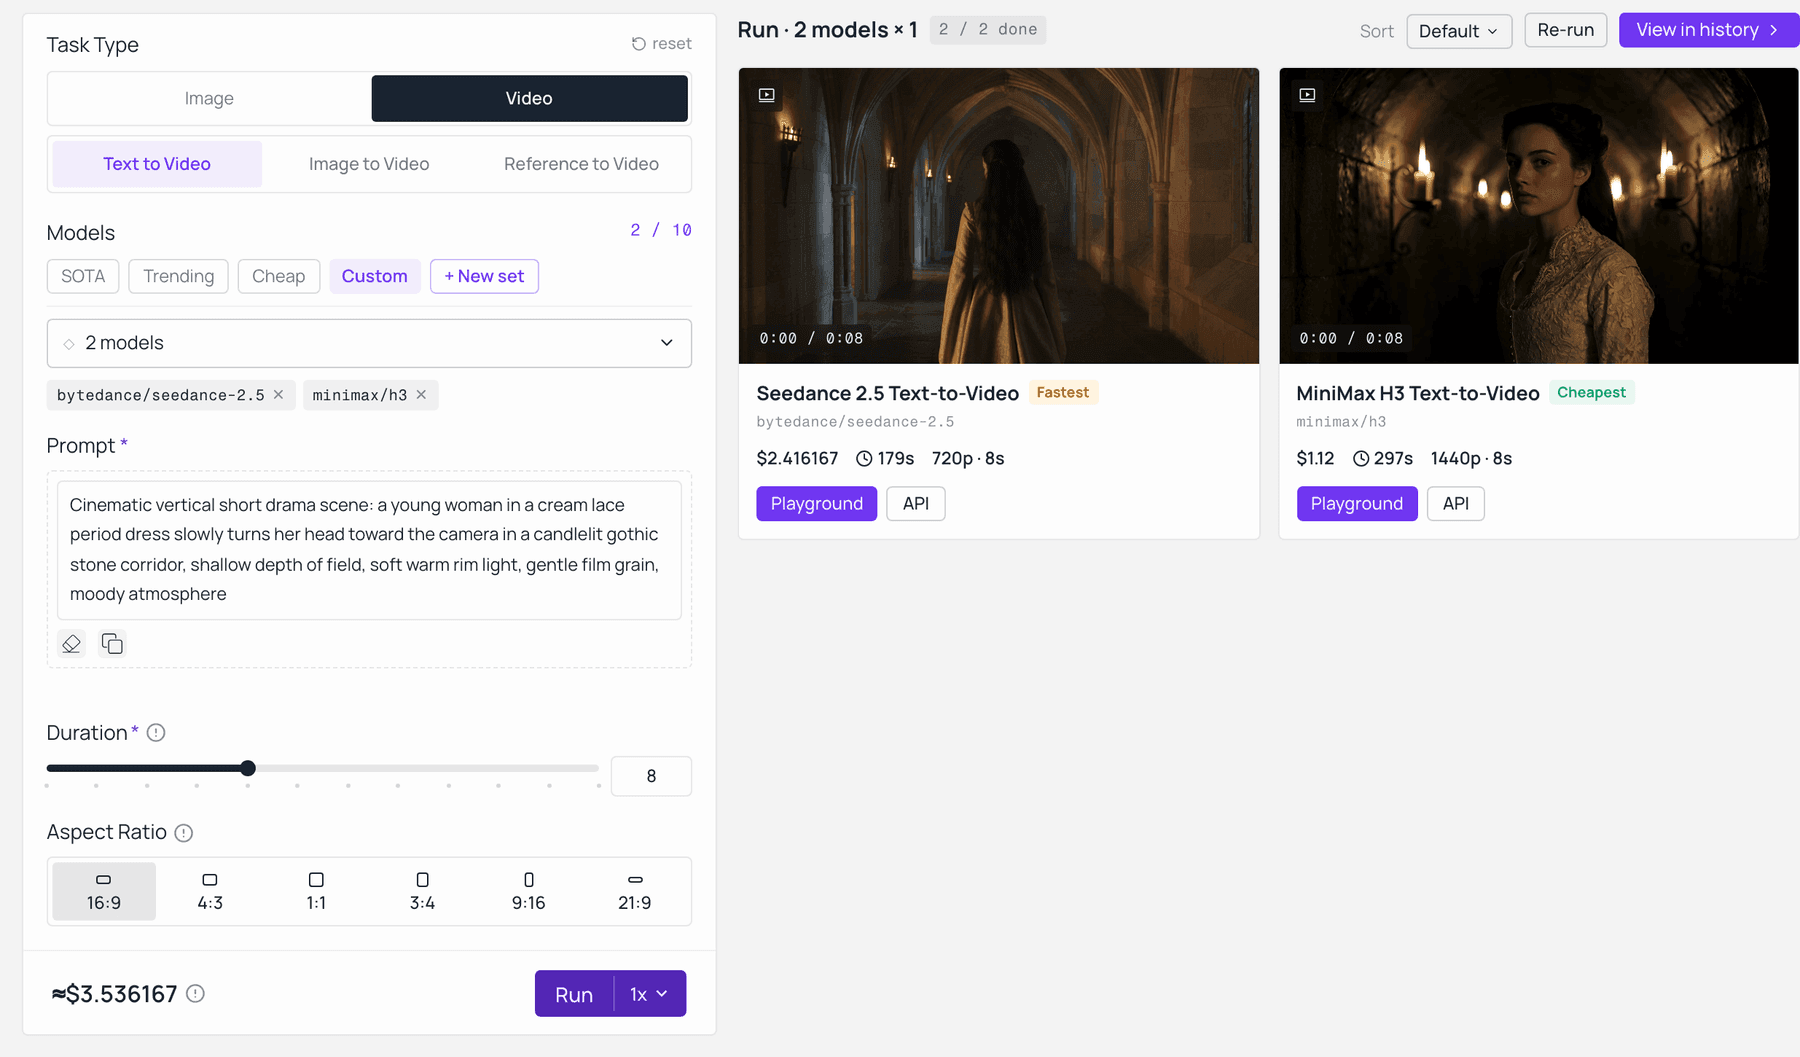
Seedance 2.5 en MiniMax H3 op de identieke prompt in Atlas Cloud's modelvergelijking. Seedance 2.5 leverde 720p voor $2,42; MiniMax H3 leverde 1440p voor $1,12, en beide prijzen werden geschat vóór de run. Live vastgelegd op de model-explorer.
Rij één is degene die mensen het vaakst fout doen. Stuur zes enkelweergave-afbeeldingen en het model behandelt ze als zes kandidaat-personen en middelt ze. Stuur één schone composiet en het behandelt ze als één persoon van drie kanten gezien. Zelfde pixels, compleet ander resultaat.
Seedance 2.5 vs MiniMax H3 Specificatieblad, en wat je vandaag daadwerkelijk kunt aanroepen
Splits capaciteit van beschikbaarheid en de spanning wordt duidelijk. Op ruwe capaciteit leidt Seedance 2.5 in duur, resolutieplafond, referentieaantal en bewerkingsgranulariteit. Op beschikbaarheid is H3 degene met drie live endpoints op een algemeen modelplatform deze week. Als je AI-videomodelvergelijking doet voor planning van 2026, telt die tweede kolom net zo veel als de eerste.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video (wat ik draaide) | |
|---|---|---|---|
| Maximale lengte, één generatie | 5 tot 15 s | tot 30 s, geen stitching (bètamodus tot 180 s, experimenteel) | korte clip-menu, zie modelpagina |
| Resolutie | native 2K, 1440p korte zijde bij 16:9 tot 9:16; een 768p-tier is aangekondigd | native 4K, 10-bit kleur | tot 720p op dit endpoint |
| Framesnelheid | 24 fps | niet apart gepubliceerd | niet apart gepubliceerd |
| Referentie-inputs | 9 afbeeldingen + 3 video's + 3 audio, 12 bestanden totaal | tot 50 multimodale referenties | 9 afbeeldingen + 3 video's + 3 audio |
| Native audio | ja, elke output, stereo | ja, plus 11 ondertitel- en stemtalen | ja |
| Bewerkingsgranulariteit | hele-clip instructiebewerkingen (wissel karakter, achtergrond, belichting, dialoog) | regio-niveau bewerkingen die een deel van een frame hertekenen | hele-clip instructiebewerkingen |
| Promptlimiet | 7.000 karakters | niet gepubliceerd | niet gepubliceerd |
| Open gewichten | aangekondigd voor dagen na lancering | niet aangekondigd | niet aangekondigd |
| Artificial Analysis I2V Elo, 31 jul 2026 | 1.185 (3e) | nog niet beoordeeld | 1.196 (1e, Dreamina 720p entry) |
| Aanroepbaar op het platform dat ik testte | ja, 3 endpoints | nog niet, Day-0 pagina | ja |
Volledige openheid over de testopstelling. Seedance 2.5 was niet open op mijn platform toen ik dit draaide, dus de Seedance-kant is Seedance 2.0 Reference-to-Video, het huidige verzendende lid van dezelfde familie met hetzelfde quad-modale referentiesysteem. Waar 2.5 het antwoord zou veranderen, zeg ik het. De Seedance 2.5 pagina is voorlopig een Day-0 kennisgeving.
Alles hieronder draait in één browsertabblad, op één sleutel, in totaal drie modellen:
| Stap | Model | Wat het produceert | Belangrijkste instellingen | Wat de kosten drijft |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | het character turnaround sheet | quality high, 16:9 | per afbeelding, pay as you go, huidig tarief op modelpagina |
| 2 | zelfde model, tweede run | het zes-panel locatie- en belichtingsbord | quality high, 16:9 | per afbeelding, pay as you go |
| 3 | MiniMax H3 Reference-to-Video | de 9:16 clip met native audio | 9:16, 2K, duur 5 voor een test en 15 voor de echte cut | seconden x resolutie, gefactureerd per seconde |
| 4 | Seedance 2.0 Reference-to-Video | de controlerun, identieke inputs | 9:16, hoogste beschikbare resolutie, zelfde duur | seconden x resolutie, gefactureerd per seconde |
| 5 | H3 Reference-to-Video, clip als input | één vast shot zonder alles opnieuw te rollen | zelfde resolutie, korte duur | seconden x resolutie, gefactureerd per seconde |
H3 heeft ook text-to-video en image-to-video entries als je een pure tekstbaseline of eerste-en-laatste-frame controle wilt.
Nog iets dat de moeite waard is om te weten voordat je een batch plant: tekst op het scherm. Deze 15-seconden H3 titelreeks houdt Engelse credits door acht harde cuts zonder een enkele spelfout, wat een van de moeilijkste dingen is om stabiel te houden in gegenereerde video.
De Seedance 2.5 vs MiniMax H3 Korte-Drama Workflow, Stap voor Stap
Vijf stappen. Kopieer de prompts exact zoals ze zijn geschreven, inclusief de lelijke delen. Ik heb ze niet opgeschoond voor het artikel en jij moet ze niet opschonen voor het model.
Stap 1: Bouw het character sheet met GPT Image 2
Maak het referentiepakket voordat je enige video maakt. Eén afbeelding, twee karakters, drie weergaven elk, pure witte naadloze achtergrond, egale studiolamp. Dat verwijdert elke dubbelzinnigheid behalve degene waar je om geeft: hoe ziet deze persoon eruit?
plaintext1Een full-body character turnaround reference sheet op een pure witte naadloze achtergrond, twee karakters naast elkaar, zes figuren totaal, egale neutrale studiolamp, geen schaduwen op de vloer, geen tekst, geen labels, geen watermerk. 2 3LINKSHELFT, mannelijke hoofdrol, drie weergaven op een rij: vooraan, rechts profiel, achteraan. Late 20s, bleke teint, donker golvend halflang haar, scherpe kaaklijn. Gekleed in een vloerlange zwarte fluwelen frock coat met subtiele tone-on-tone borduursels op de revers en manchetten, een zwart brokaat vest, een zwarte zijden cravatte, rechte zwarte broek, gepolijste zwarte leren derby-schoenen. Armen ontspannen langs zijn zij, neutrale uitdrukking. 4 5RECHTSHELFT, vrouwelijke hoofdrol, drie weergaven op een rij: vooraan, rechts profiel, achteraan. Vroege 20s, lichte teint, lang golvend kastanjebruin haar met een half-opgestoken gevlochten kroon. Gekleed in een crèmen Victoriaanse katoenen-kanten jurk, lange mouwen met kanten manchetten, getailleerd lijfje met kleine knopen, volledige enkellange rok, crèmen enkelband lage hakschoenen. Armen ontspannen langs haar zij, neutrale uitdrukking. 6 7Fotografisch realisme, consistente schaal tussen alle zes figuren, voeten uitgelijnd op dezelfde basislijn, scherpe focus van rand tot rand.
Instellingen: model OpenAI GPT Image 2 Text-to-Image, Quality high, Aspect ratio 16:9, al het andere standaard.
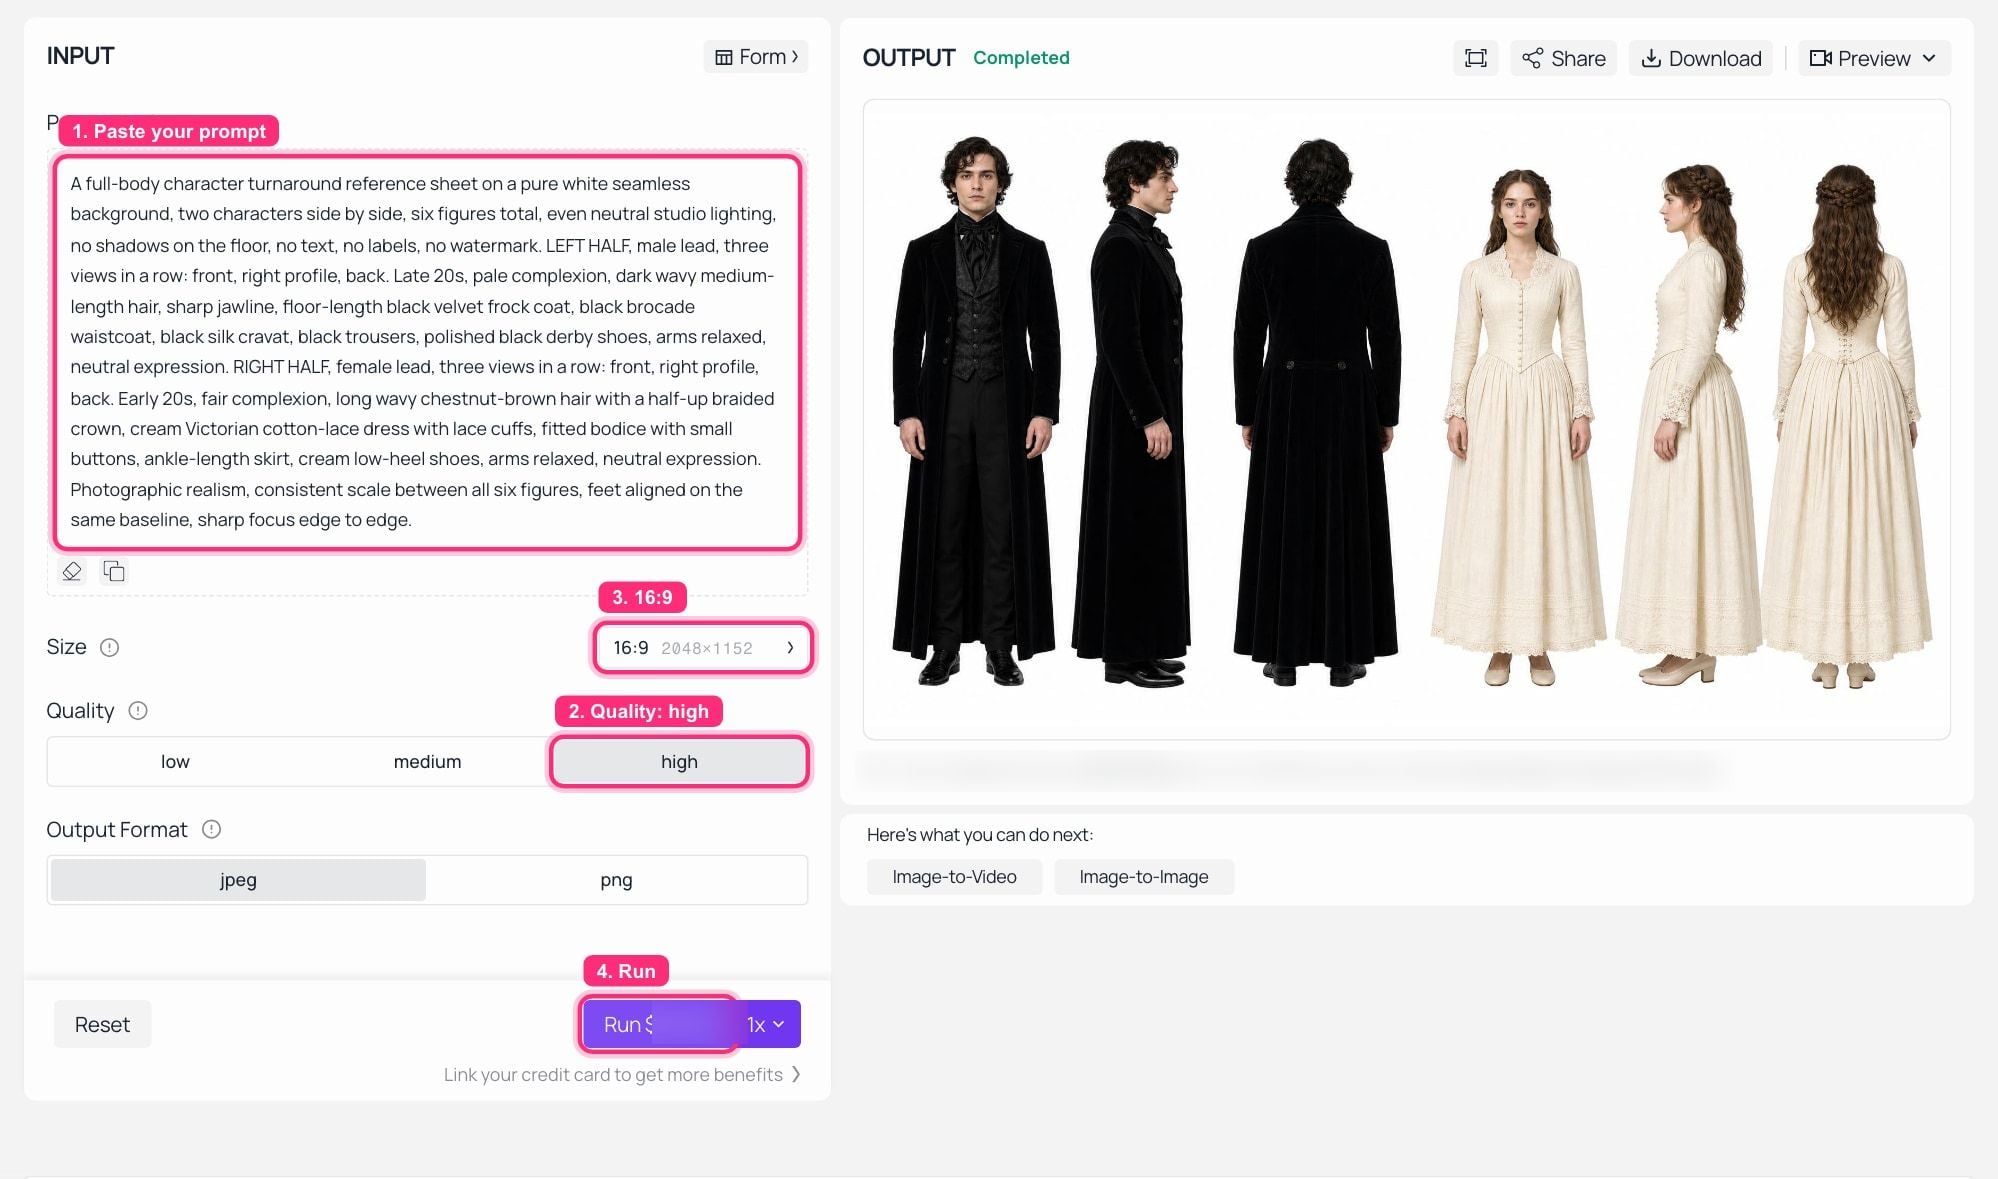 GPT Image 2 Text-to-Image op Atlas Cloud, run voltooid: de turnaround prompt aan de linkerkant, zes figuren op één wit vel in het OUTPUT paneel.
Dit is de doelvorm. Zes figuren, één basislijn, niets op de achtergrond om over te twisten:
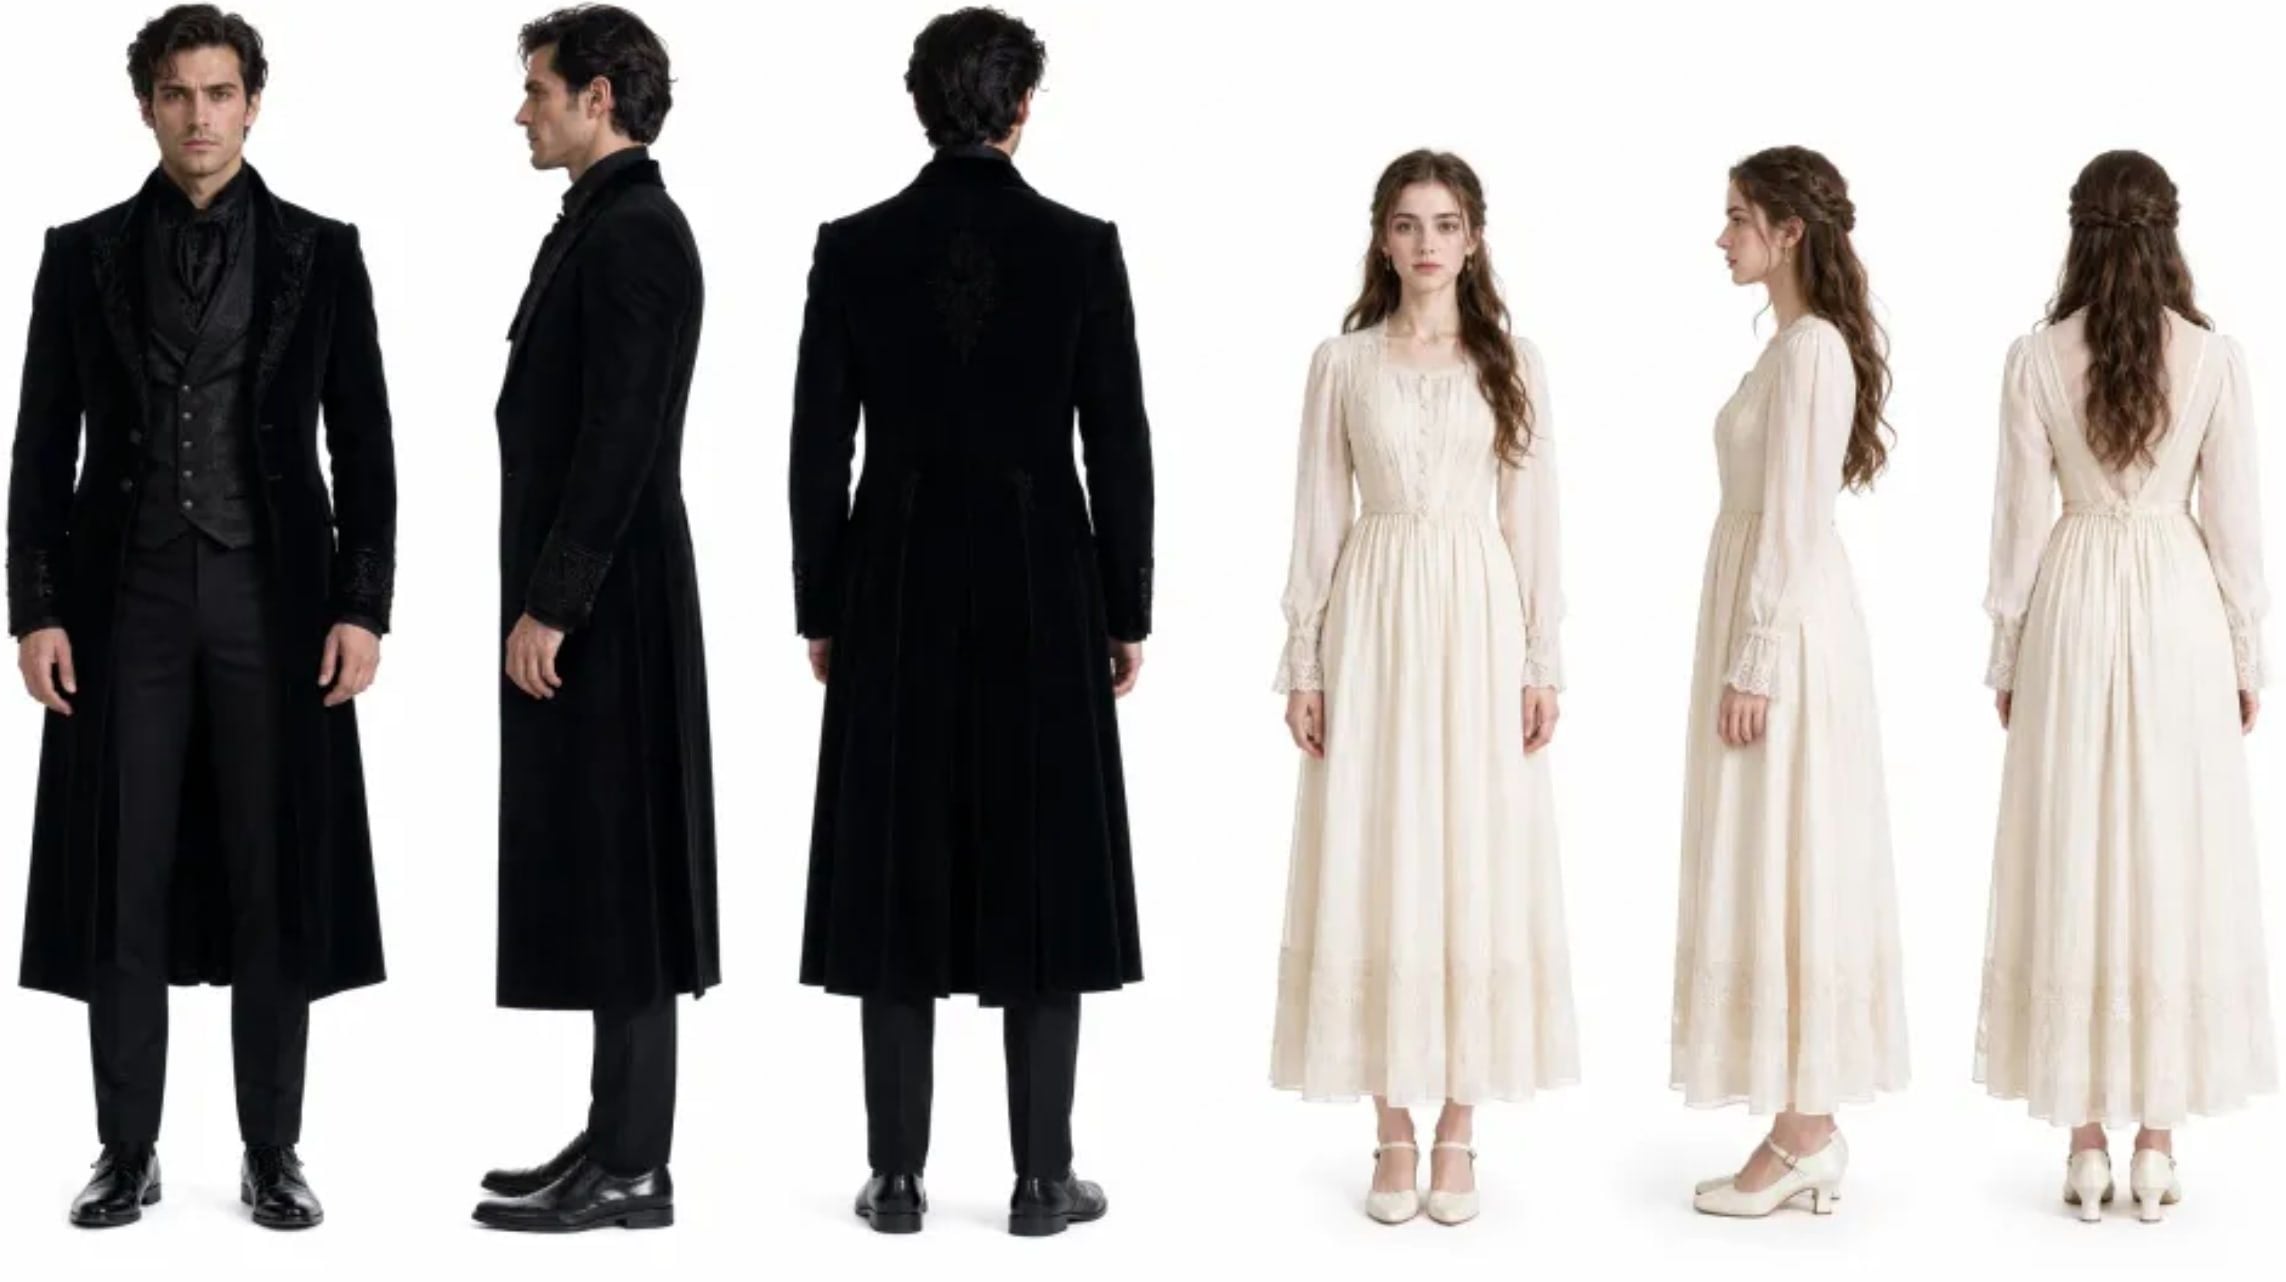 Het referentiepakket dat de democlipp dreef: mannelijke hoofdrol in zwart fluweel, vrouwelijke hoofdrol in crèmen Victoriaanse kant, drie weergaven elk, één bestand.
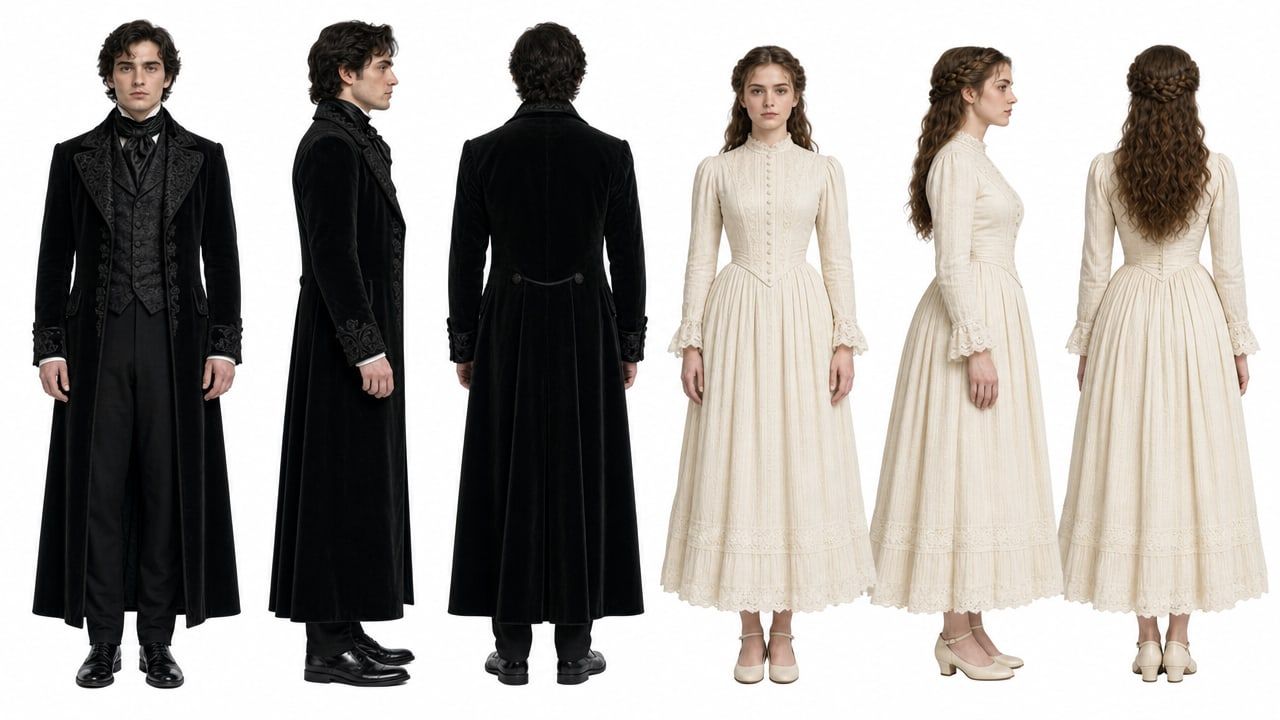 Mijn eigen GPT Image 2 run van de Stap 1 prompt, ter vergelijking met de referentie hierboven.
Stap 2: Zet de locatie vast met een zes-panel scene board
Je hebt het gezicht vastgehouden. Licht zal je nog steeds verraden. De tweede referentieafbeelding zet zes cameraposities vast, de richting van het maanlicht, hoeveel mist er in de lucht hangt en hoe nat de vloer eruitziet. Je vertelt het model dat deze film exact één belichtingsopstelling heeft.
plaintext1Een zes-panel cinematic location board, 2 rijen bij 3 kolommen, dunne zwarte tussenruimtes tussen panelen, elk paneel bijschrift in kleine elegante witte kapitalen gespatieerde letters onderaan dat paneel. Onderwerp: het interieur van een verlaten gotisch kasteel 's nachts. Koud blauw maanlicht, drijvende lage mist, natte reflecterende stenen vloer, hoge gebrandschilderde ramen, ijzeren kaarsenhouders met kleine warme vlammen, diepe onverzadigde zwarttinten, zware fluwelen gordijnen. Geen mensen in enig paneel. 2 3Paneel 1, bijschrift "WIDE ESTABLISHING VIEW - CORRIDOR": een lange zuilengang die wegloopt naar een verlicht gebrandschilderd raam. 4Paneel 2, bijschrift "LOW ANGLE - MOONLIGHT ACROSS FLOOR": lage camera, een straal maanlicht die over natte plavuizen strijkt. 5Paneel 3, bijschrift "DOORWAY & STAIRCASE COMPOSITION": een gebogen deuropening die een gebogen stenen trap omlijst. 6Paneel 4, bijschrift "CLOSE DETAIL - CARVED DOOR": strakke opname van een zware gebeeldhouwde houten deur met een ijzeren handgreep. 7Paneel 5, bijschrift "WINDOW-SIDE VIEW - FOG & CURTAINS": hoog raam, mist die binnenrolt, gordijnrand op de voorgrond. 8Paneel 6, bijschrift "FINAL POSTER FRAME - EMPTY HALL": symmetrische lege gang, patroonloper leidend naar het raam. 9 10Fotografisch, cinematisch, filmkorrel, consistente kleurcorrectie over alle zes panelen.
Instellingen: zelfde model, Quality high, Aspect ratio 16:9.
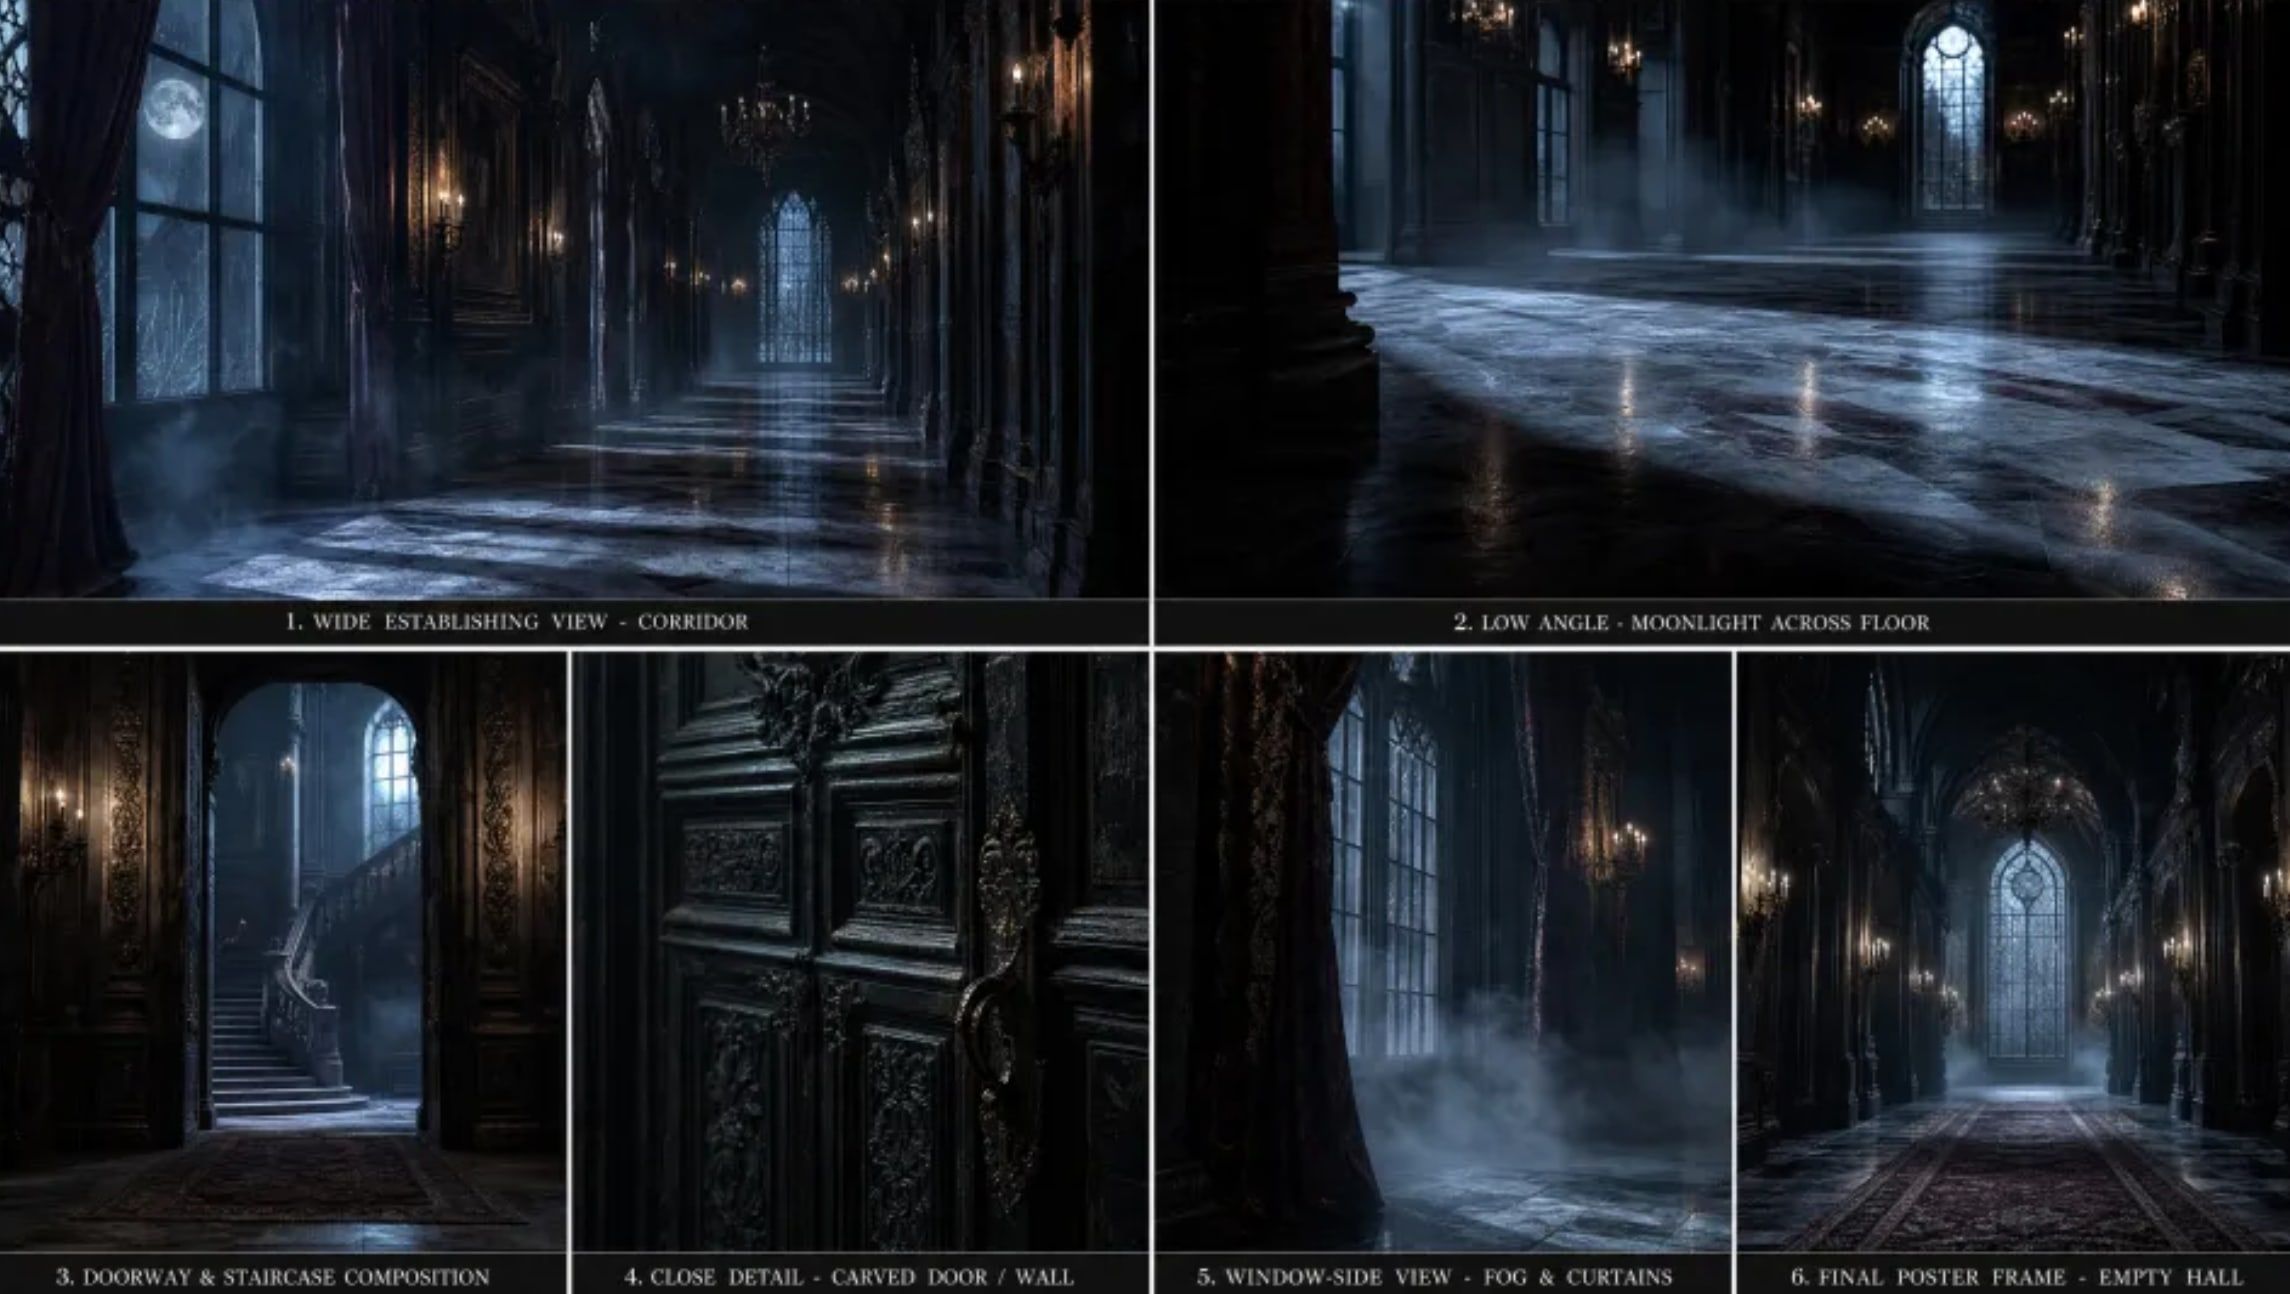 Het locatiebord dat de democlipp dreef: zes gotische kasteelinterieurs, één kleurcorrectie, bijschriften leesbaar.
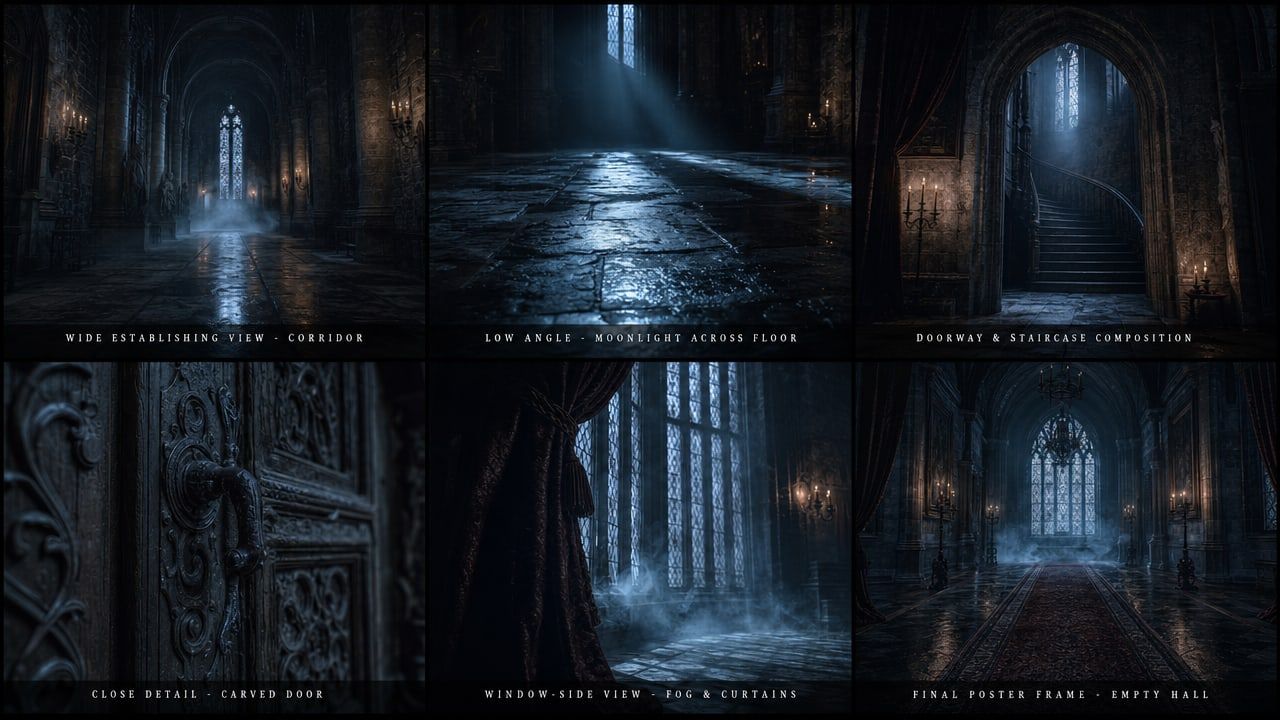 Mijn eigen GPT Image 2 run van de Stap 2 bord prompt.
Stap 3: Genereer het shot met MiniMax H3 reference-to-video
Twee referentieafbeeldingen plus één prompt met cameraposities en audiorichting. Geluid wordt in dezelfde pas geproduceerd, dus er is geen aparte stem- of muziekstap. Houd de duur kort terwijl je aan het tunen bent, en duw hem dan naar 15 voor de echte cut.
plaintext1Referentieafbeelding 1 is het character sheet: de man LINKS is de mannelijke hoofdrol, de vrouw RECHTS is de vrouwelijke hoofdrol. Behoud beide identiteiten exact zoals getoond: zijn kaaklijn, donker golvend haar, zwart fluwelen frock coat, zwart brokaat vest en zwarte zijden cravatte; haar kastanjebruine half-opgestoken gevlochten haar en crèmen Victoriaanse kanten jurk. Referentieafbeelding 2 is het locatie- en belichtingsbord: match het koude blauwe maanlicht, drijvende mist, natte reflecterende stenen vloer en onverzadigde zwarttinten. 2 39:16 verticaal, premium live-action short-drama look, ondiepe scherptediepte, cinematisch contrast, geen ondertitels, geen tekst op het scherm, geen watermerk. 4 5Shot 1: Medium close-up, camera langzaam inzoomen. De vrouwelijke hoofdrol staat in de maanverlichte gang, oppervlakkig ademhalend, ogen gefixeerd op iets off-frame rechts. Mist beweegt langs haar op kniehoogte. 6Shot 2: Harde cut. Over-the-shoulder van achter haar, de mannelijke hoofdrol stapt uit de donkere boog in het maanlicht, jas vangt het licht, uitdrukking koud en nieuwsgierig. 7Shot 3: Strakke close-up op zijn gezicht, half verlicht door het raam, dan een bijpassende close-up op haar terwijl ze weigert weg te kijken. 8 9Audio: lage aanhoudende basdron, verre steenecho, haar onregelmatige adem, één zware voetstap als hij in het licht stapt, een enkele zachte strijkerszwel bij de laatste cut.
Instellingen: model MiniMax H3 Reference-to-Video, Resolution 2K, Duration 8 (de slider-standaard; duw naar 15 voor de echte cut), Aspect Ratio adaptive, en beide bestanden in Reference Materials. Het paneel telt ze als 2 van 9, dus je hebt genoeg ruimte om later kleding- of prop-plates toe te voegen.
Het is vermeldenswaard wat er gebeurde met de verhouding. Ik liet Aspect Ratio op adaptive staan en schreef alleen "9:16 vertical" in de prompt. H3 kwam toch verticaal terug, dus het las de kadrering uit de tekst in plaats van het formulierveld nodig te hebben.
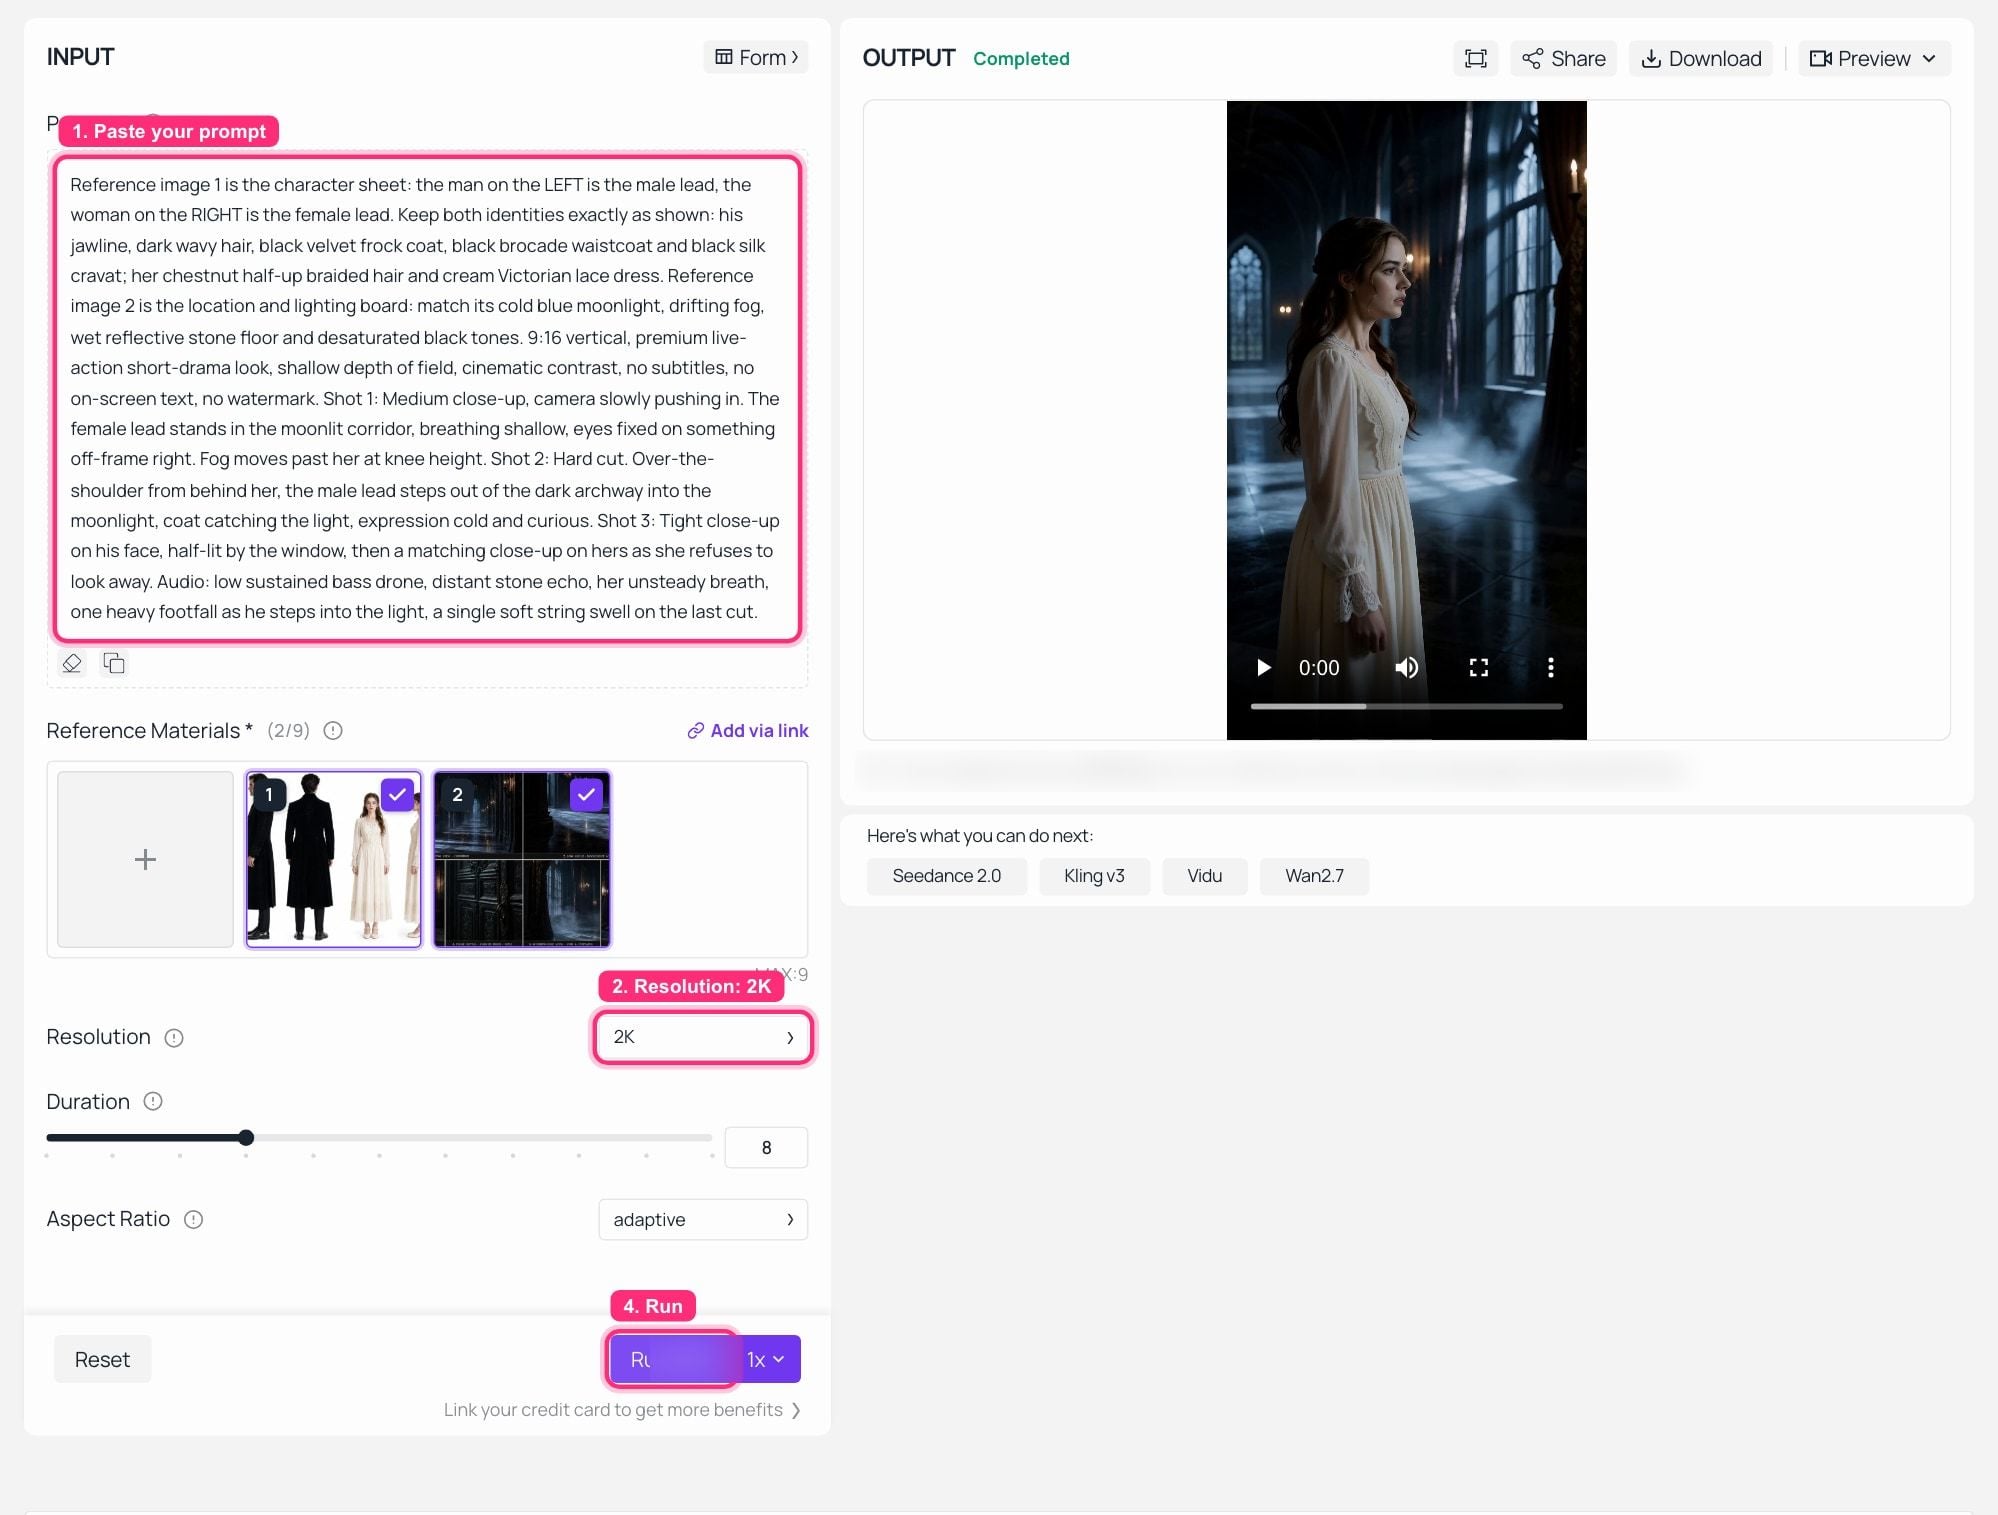 MiniMax H3 Reference-to-Video op Atlas Cloud, run voltooid: beide referentiebestanden geladen als 2 van 9, resolutie 2K, en de gegenereerde verticale clip afspelend in het OUTPUT paneel.
Het eerste frame is de vrouwelijke hoofdrol in het crèmen kanten lijfje, staand in de gang van bordpaneel 1, met mist op kniehoogte en het maanlicht dat de natte vloer raakt precies waar het bord het plaatste. Beide referentieafbeeldingen landden.
Stap 4: Draai de Seedance 2.5 vs MiniMax H3 controle met het identieke pakket
Verander geen woord. Zelfde twee referentieafbeeldingen, zelfde prompt, ander model. Ik liet de eigen duur-standaard van elke pagina met rust in plaats van een match te forceren, en ik zeg wat elke pagina teruggaf hieronder. Een prompt herformuleren "voor" het andere model is precies hoe vergelijkingen beginnen te liegen.
plaintext1Zelfde prompt als Stap 3, letterlijk. Herformuleer het niet voor het andere model.
Instellingen: model Seedance 2.0 Reference-to-Video, Resolution 720p, zelfde twee referentieafbeeldingen in Reference Images (weer 2 van 9, met aparte slots voor maximaal 3 referentievideo's en 3 referentie-audiobestanden). Duur gelaten op de paginastandaard, die terugkwam als een 10-seconden clip.
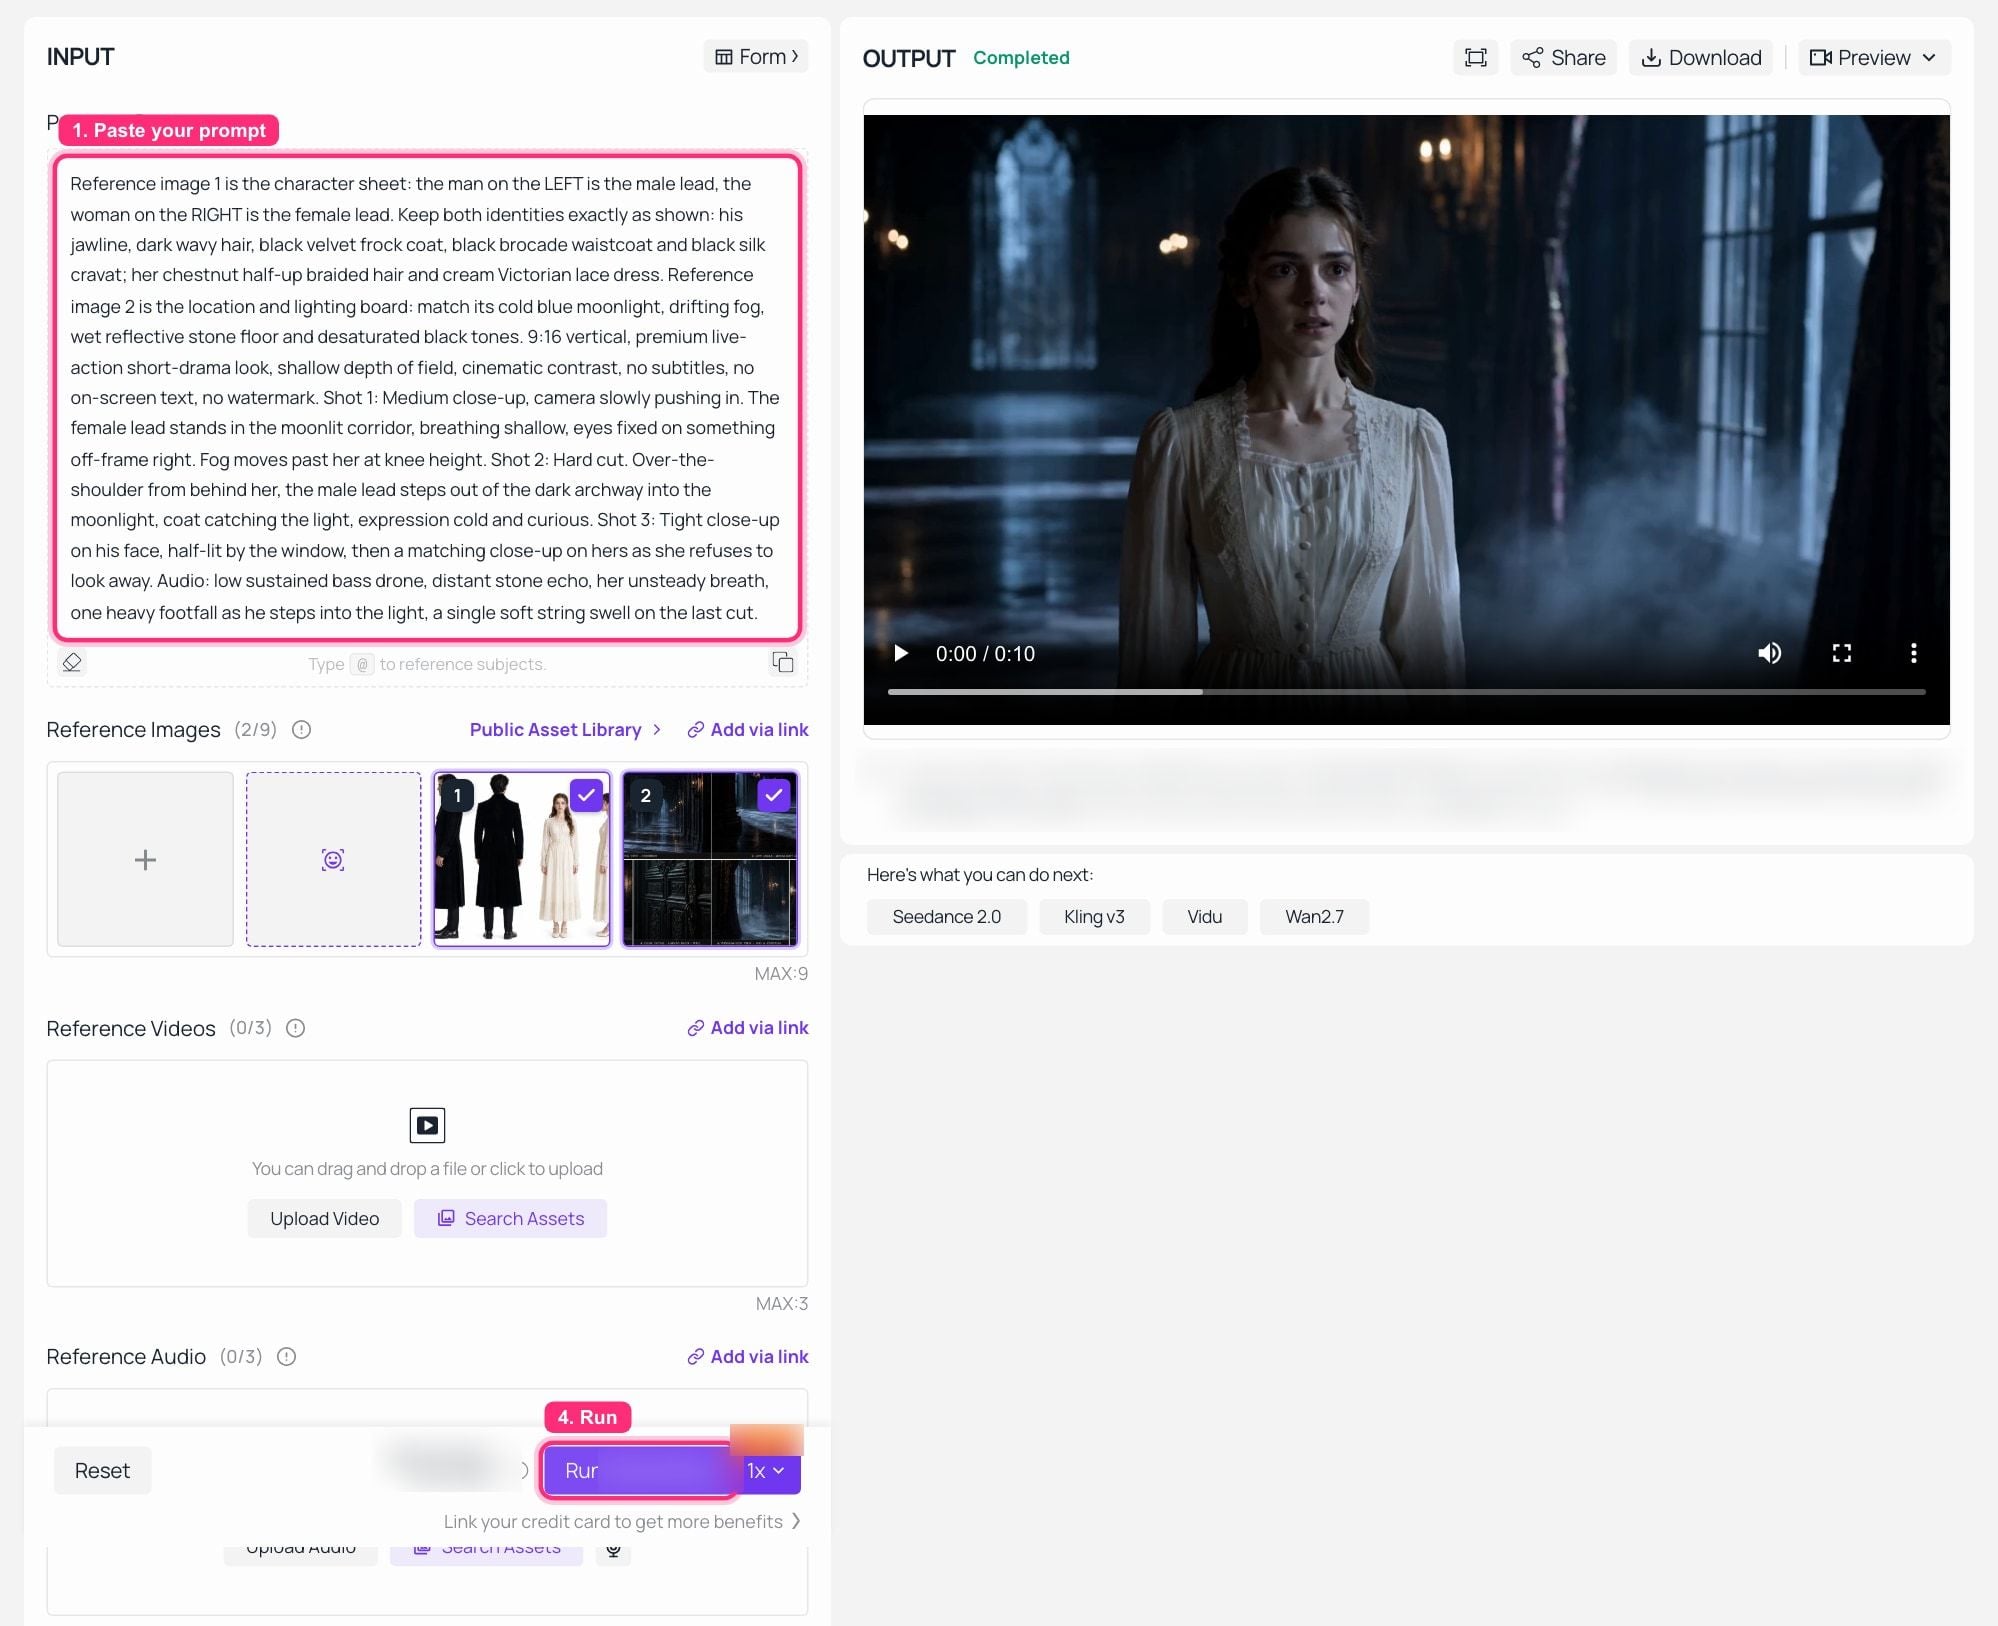 Seedance 2.0 Reference-to-Video op Atlas Cloud, run voltooid met het identieke referentiepakket en prompt van Stap 3, en een 10-seconden resultaat in het OUTPUT paneel.
Hier is wat de twee OUTPUT-panelen daadwerkelijk lieten zien, en ik rapporteer het vlak in plaats van een winnaar te kiezen.
Beide runs hielden het karakter vast. Zelfde crèmen kanten jurk met dezelfde halslijn en manchetten, zelfde kastanjebruine haar, zelfde mist-en-maanlichtgang van het bord. Geen van beide verzon een andere vrouw. Het referentiepakket deed dat werk aan beide kanten, wat de bevinding is die me het meest interesseert.
De verschillen gingen over de vorm, niet over het gezicht. Dit Seedance-endpoint leverde 720p; H3 leverde 2K van identieke inputs. En de kadrering splitste: H3 las "9:16 vertical" rechtstreeks uit de prompttekst en keerde verticaal terug, terwijl de Seedance-run 16:9 teruggaf omdat die pagina zijn eigen beeldverhouding-controle heeft en de prompttekst alleen deze niet overschreef. Als je aan het knippen bent voor TikTok, zal dat verschil je een run kosten de eerste keer dat je het formulierveld vergeet. Seedance 2.5 zou waarschijnlijk de resolutiehelft hiervan veranderen en region-level herrollen toevoegen, en ik ga niet doen alsof ik dat heb gemeten.
Stap 5: Repareer één shot zonder de hele clip opnieuw te rollen
De echte kosten van een korte drama zijn niet generatie één. Het is revisie zeven. H3 accepteert een bestaande clip als input en bewerkt op instructies, waarbij het vasthoudt wat je niet noemde. Seedance 2.5's pitch hier is fijner: herteken een regio van het frame en laat prestatie, belichting en camera met rust.
plaintext1Gebruik de geleverde clip: behoud de twee karakters, hun kleding, de camerabewegingen en het snijritme exact zoals ze zijn. Verander alleen de omgeving, vervang de maanverlichte stenen gang door dezelfde kasteelbalzaal, hoge gebogen ramen, een verlichte kroonluchter en warm kaarslicht, en herbelicht beide karakters zodat hun sleutellicht van de kroonluchter links in beeld komt in plaats van van het raam. Herbouw haar enige gesproken regel naar "Je hebt nooit geslapen, of wel." Houd haar timing van de prestatie op dezelfde beats.
Instellingen: MiniMax H3 Reference-to-Video met de Stap 3-clip als referentie-input, Duration 5, Resolution 2K.
Voorbij de Seedance 2.5 vs MiniMax H3 Test: Vier Manieren om een Referentiepakket te Duwen
Zelfde karakter, volgende aflevering. Sla het Stap 1-vel op als asset en verander alleen de shotlijst en het verhaalblok in de prompt. Identiteit komt van een bestand, niet van je geheugen van hoe je het vorige dinsdag formuleerde.
Zet ook de stem vast. H3 neemt maximaal drie audio-referenties, 2 tot 15 seconden elk, en ze moeten vergezeld gaan van een afbeelding of video-input. Geef het een stemvoorbeeld en het karakter spreekt in dat timbre, zodat je geen stemacteur opnieuw cast tussen afleveringen.
Blokkeer de camera voordat je betaalt voor de render. Seedance 2.5's reference-to-video accepteert 3D white-model blockouts en green-screen plates, zodat je kadrering kunt vastzetten op grijze geometrie en pas daarna committeren aan een afgewerkte look. Dit voorbeeld draaide op Seedance 2.1, een eerder lid van de familie, maar de vorm van de workflow is hetzelfde.
Lokaliseer één mastercut in plaats van hem opnieuw te schieten. Region-level vervanging wisselt een gezicht, een product of een gesproken taal terwijl camera, timing en lipduur blijven staan. Hier wordt één master beauty cut opnieuw gecast en opnieuw ingesproken voor Spaans, Koreaans en Hindi, met de ruimte, de kadrering en de lipduur vastgehouden.
En omdat iemand zal vragen hoe bewegingsoverdracht eruitziet als je stopt met verstandig te zijn: drie mannen in pakken, vervangen door drie fotorealistische capibara's, die het bewegingspad van de originele clip beat voor beat volgen tot ze een piramide stapelen.
Er is ook de simpele versie van dit alles, die niemand post: een statische poster wordt een bewegende poster, en de lay-out overleeft.
 De statische bronposter. Voer hem aan reference-to-video met "behoud het frame, het palet en de lay-out, animeer het lettertype" en je krijgt een bewegende versie van hetzelfde ontwerp.
Wat een Seedance 2.5 vs MiniMax H3 Korte Film Je Werkelijk Kost
Geen getallen hier, omdat de getallen bewegen en de structuur niet. Beide families factureren per seconde, pay as you go, geen zitplek en geen abonnement. Dat laat drie variabelen over: seconden, resolutietier, en herrollen.
De derde is de hele rekening. Een 15-seconden clip die bij de eerste poging landt, is één lading. Dezelfde clip bij de zevende poging is zeven. Dus de geldbesparende zet is niet het goedkopere per-seconde model kiezen, het is het referentiepakket goed krijgen voordat je iets genereert. Die twee afbeeldingsaanroepen in Stap 1 en Stap 2 zijn de goedkoopste regel in de hele pijplijn en degene die bepaalt hoeveel video-aanroepen je doet. Hoogste rendement op uitgaven in de hele keten, met afstand.
Corrigeer dan het per-seconde instinct. Zelfde referentiepakket, zelfde looptijd: H3's reference-to-video geeft 1440p terug, dit Seedance reference-to-video endpoint geeft 720p terug. Per seconde is de verkeerde eenheid. Pixels per frame, en of je dan moet betalen voor een aparte upscale-pas, is de juiste.
Audio hoort ook in de rekenkunde. Beide kanten produceren native synchroon geluid in dezelfde pas. Als je huidige pijplijn videomodel plus TTS plus een editor is die tracks uitlijnt, wat je bespaart is twee API-aanroepen en een middag van een persoon, en die besparing verschijnt op geen enkele prijslijst.
Welke voor welke klus:
| Klus | Kies | Waarom | Let op |
|---|---|---|---|
| Verticaal korte drama, 9:16, TikTok of ReelShort | MiniMax H3 | 1440p verticaal met native stereo, nu aanroepbaar, 15 s is een volledige haak | je snijdt op 15 s, plan beats dienovereenkomstig |
| Eén continue 30-seconden brandfilm | Seedance 2.5 | enkele generatie, geen stitching, native 4K | controleer eerst beschikbaarheid op je platform |
| Eén shot repareren in een goedgekeurde cut | Seedance 2.5 | region-level hertekening laat de rest met rust | H3 hele-clip bewerken komt er vandaag het dichtst bij |
| Product- en e-commerce cutdowns | allebei | beide houden tekst op scherm en merktekens goed vast | verifieer tekst op de resolutie die je verzendt |
| Game- of interfacedemo's | MiniMax H3 | UI en typografiestabiliteit op 2K is sterk | 15 s plafond voor een enkele pas |
| Meertalige versies van één master | Seedance 2.5 | regio-vervanging plus meertalige stem | lokalisatiekwaliteit heeft nog steeds een native check nodig |
| Vanavond verzenden | MiniMax H3 | drie endpoints live, plus alle Seedance 2.0 | Seedance 2.5 toegang varieert per platform |
Voordat je verzendt. MiniMax zei dat H3's gewichten binnen dagen na lancering zouden volgen, en open gewichten zijn niet hetzelfde als een commerciële licentie, dus lees de voorwaarden voordat je zelf host. Watermerk- en commercieel gebruik-beleid verschilt ook tussen consumentenapps en API-toegang aan beide kanten, en ik kon geen van beide bevestigen vanaf een primaire voorwaardenpagina terwijl ik dit schreef, dus controleer de voorwaarden van de provider in plaats van mijn woord ervoor te nemen. En niets in enige modellicentie dekt gelijkenis of handelsmerk. Als een echt persoon, een echt merk of iemand anders' IP in je referentiepakket zit, is dat een aparte juridische vraag en de modelvoorwaarden zullen die niet beantwoorden.
Elk model in de tabellen hierboven draait op dezelfde sleutel, en de modelpagina's dragen de huidige tarieven plus copy-paste code, inclusief eventuele promoties die deze week op de Seedance-lijn lopen.
Veelgestelde Vragen
Is Seedance 2.5 beter dan MiniMax H3 voor karakterconsistentie?
Op papier zou het moeten, met tot 50 multimodale referenties tegen H3's 12 bestanden, plus region-level herrollen. Maar per 31 juli 2026 is er geen gepaarde openbare test waar ik naar kan verwijzen, en Seedance 2.5 heeft nog geen arena-rating. In de runs die ik daadwerkelijk kon maken, was de variabele die identiteitsstabiliteit bepaalde de referentiepakketstructuur, niet de modelgeneratie: met één composiet turnaround sheet plus één belichtingsbord, hielden beide kanten het karakter vast. Zorg dat het pakket goed is voordat je tijd besteedt aan het shoppen van modellen.
Kan ik Seedance 2.5 nu gebruiken, of moet ik wachten?
De API is live bij ByteDance. Beschikbaarheid op third-party modelplatformen is ongelijk, en op degene die ik testte is het nog steeds een Day-0 kennisgeving. Als je vanavond output nodig hebt, zijn de aanroepbare opties MiniMax H3's drie endpoints en de hele verzendende Seedance 2.0-lijn.
Doet MiniMax H3 echt 30-seconden video?
Nee. De specificatie is 5 tot 15 seconden per generatie bij 24fps. Iets langer is extensie of stitching, wat een ander ding is met een ander driftrisico. De 30-seconden enkele generatie is van Seedance 2.5. Laat de twee claims niet vervagen.
Genereren beide modellen audio, en kan ik één stem over afleveringen houden?
Beide produceren native synchroon geluid in dezelfde pas, en H3 levert stereo op elk resultaat. Voor een blijvende stem accepteert H3 maximaal drie audio-referenties van 2 tot 15 seconden elk, die moeten worden ingediend samen met een afbeelding of video-input, niet op zichzelf.
Hoeveel referentieafbeeldingen moet ik eigenlijk sturen?
Minder dan je denkt, beter gestructureerd dan je denkt. Eén goed samengestelde composiet verslaat over het algemeen zes losse crops, omdat aparte bestanden het model uitnodigen om ze te middelen tot een persoon die niet bestaat. Geef het twee duidelijke taken, identiteit en belichting, en neem geen stijlvoorbeelden op die elkaar tegenspreken.
Welk model moet ik gebruiken voor TikTok- of ReelShort-achtig verticaal korte drama?
Deze week verzenden, in 9:16, in hoge resolutie met geluid al gemengd: MiniMax H3. Een 30-seconden continue scène plannen waar je verwacht losse regio's opnieuw te rollen in plaats van hele clips: bouw voor Seedance 2.5 en controleer wanneer je platform het opent.


