Productie-agentische pijplijnen crashen regelmatig door onverwachte schemaschendingen. Zelfs toonaangevende autoregressieve LLM's falen bij het parsen van JSON tijdens grootschalige tool-calls, waardoor ontwikkelaars complexe retry-lussen en aangepaste foutafhandelaars moeten bouwen.
TypeSafe Jev lost deze structurele fout op door sequentiële, token-voor-token-generatie volledig los te laten. Als niet-autoregressief beslissingsmodel neemt Jev de applicatiestatus op en evalueert vooraf gedeclareerde schemavragen in één enkele parallelle forward pass. Omdat mogelijke uitvoerkeuzes strikt begrensd zijn vóór uitvoering, elimineert Jev wiskundig misvormde JSON, ongeldige toolnamen en tekst buiten het schema.
Snelle samenvatting: Wat is TypeSafe Jev AI? Prestaties en snelheidsbenchmarks
TypeSafe Jev AI is een niet-autoregressief beslissingsmodel dat speciaal is gebouwd voor sub-seconde classificatie, intentiescoring en gestructureerde microservice-routing. Anders dan autoregressieve LLM's evalueert Jev vooraf gedeclareerde schemakeuzes in één enkele forward pass.
- Nul hallucinatie op typeniveau: Vervangt stringdecoderingslussen door begrensde state-schemaprimitieven, met een typefoutpercentage van 0%.
- Uitvoering onder 500 ms: Niet-autoregressieve parallelle sampling behaalt P95-latentie van 70 ms–500 ms, tot 200x sneller dan standaard LLM's.
- Gratis uitvoertokens: Nul gegenereerde sequentiële tokens betekent dat uitvoertokens volledig gratis zijn: $0.042/1M invoertokens.
- Het beste voor: Microservice-routing, agentische tool-dispatching, ticket-triage en intentie-gating.
De AI-stack heroverwegen: System 1-intuïtie versus System 2-redenering
Bij het ontwikkelen van schaalbare backendsoftware veroorzaakt het forceren van eenvoudige conditionele checks via een zwaar chat completion-endpoint ernstige systeemlaten. De meeste microservices vereisen geen creatief proza of meerstaps chain-of-thought-generatie; ze vereisen een onmiddellijke, deterministische selectie uit bekende keuzes.
Het Kahneman-cognitieve kader toepassen op softwarearchitectuur
TypeSafe-medeoprichter Diogo Almeida, die eerder Reinforcement Learning from Human Feedback bij OpenAI mede-oprichtte, introduceerde een structurele koerswijziging met TypeSafe Jev om deze inefficiëntie op te lossen. Direct geïnspireerd op het cognitieve kader van Kahneman verdeelt het platform de verwerking in twee afzonderlijke operationele lagen binnen moderne AI-stackarchitectuur:
- System 2 — langzame, weloverwogen redenering: Standaard autoregressieve LLM's die werken via sequentiële, token-voor-token-generatie. Deze modellen blinken uit in het opstellen van lange documenten, het behandelen van ambigue redeneringen en het schrijven van complexe code.
- System 1 — snelle, intuïtieve beslissingen: Een toegewijd System One AI-model dat is getraind via Reinforcement Learning for Calibrated Decisions in plaats van traditionele RLHF. Het is specifiek ontworpen voor sub-seconde classificatie, intentiescoring en uitvoeringsroutering zonder conversationele overhead.
Jev vs LLM — kosten en architectuur: beslissingsmodellen versus chatmodellen
Het vervangen van algemene chatmodellen door gespecialiseerde getypeerde beslissingsmodellen optimaliseert microservice-workflows fundamenteel door snelle evaluatie te scheiden van diepe generatie.
| Architectuurdimensie | Autoregressieve LLM's (System 2) | TypeSafe Jev (System 1) |
| Primaire taak | Open tekstsynthese | Discrete keuze en schema-evaluatie |
| Uitvoeringslatentie | 3.000 ms tot 30.000 ms+ | 70 ms tot 500 ms |
| Uitvoerformaat | Ongestructureerde tekststroom | Strikt getypeerde schemaprimitieven |
| Compute-lus | Sequentiële tokendecodering | Evaluatie in één forward pass |
| Trainingsdoel | Menselijke voorkeur (RLHF) | Gekalibreerd beslissingsvertrouwen (RLCD) |
Het offloaden van routing, safety guardrails en functie-dispatching van standaard chatmodellen lost de prestatieknelpunten op die inherent zijn aan autoregressieve LLM's. Het opnemen van een System One AI-model zorgt ervoor dat zware redeneerengines alleen worden geactiveerd wanneer open generatie echt nodig is.
Hoe het TypeSafe Jev-model nul hallucinatie op typeniveau realiseert
Zelfs met strikte JSON-modus ingeschakeld retourneren frontier-LLM's regelmatig sleutels buiten het schema of gehallucineerde enumwaarden tijdens productieruns met hoge gelijktijdigheid, waardoor 0,5% tot 5% van de pijplijnverzoeken mislukt. Productiemicroservices vereisen absolute typedeterminisme, maar autoregressieve modellen blijven inherent kwetsbaar voor stringgeneratiefouten.
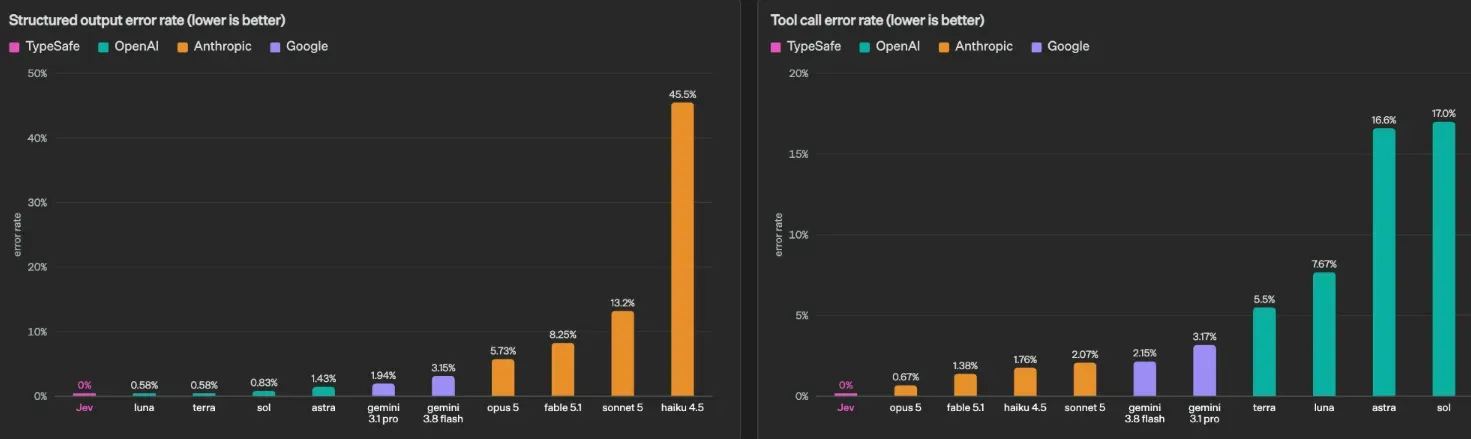
TypeSafe Jev lost dit op door stringdecoderingslussen te vervangen door een begrensde state-architectuur. In plaats van willekeurige tekst te genereren en deze in JSON-syntaxis te proberen te dwingen, evalueert Jev invoergegevens tegen vooraf gedefinieerde schemabeperkingen in één enkele pass. Deze structurele verschuiving levert echte zero-hallucination AI op typeniveau op, wat resulteert in 0% typefouten in geautomatiseerde workflows.
De drie kernprimitieven van het schema
Jev verwerkt alle invoervragen via drie expliciete primitieven:
- Choice-primitief: Selecteert precies één optie uit een vooraf gedefinieerde lijst van maximaal 255 categorische keuzes, en retourneert het winnende label samen met volledige kansverdelingen.
- Score-primitief: Evalueert invoer tegen een geordende numerieke schaal of beschrijvende rubric, en levert beoordelingen samen met kansspreidingen over elk niveau.
- Noul-primitief: Berekent de exacte waarschijnlijkheid van een ja- of nee-conditie als een float tussen 0,0 en 1,0, waardoor tussentijdse tekstuele onderbouwing wordt geëlimineerd.
Omdat elke query strikt aan deze drie primitieven wordt toegewezen, kan de uitvoeringsengine geen ongeldige sleutels, toolnamen buiten de lijst of misvormde payloads uitsturen.
Typeveiligheid bij het evalueren van gestructureerde uitvoer
Traditionele chatmodellen genereren syntaxis teken voor teken, wat constante parseerrisico's in backend-pijplijnen oplevert.
| Evaluatiemetriek | Autoregressieve JSON-modus | TypeSafe Jev System One |
| Afdwinging van uitvoertype | Stringvalidatie na generatie | Native wiskundig begrensde primitieven |
| Frequentie van typefouten | Variabel (0,5% tot 5%+ uitvalpercentage) | 0% typefouten (schemabegrensd) |
| Risico op ongeldige enum | Hoog zonder aangepaste retry-lussen | Nul (onmogelijk door ontwerp) |
Het beperken van modeluitvoering tot een begrensde state garandeert betrouwbare evaluatie van gestructureerde uitvoer. Applicaties verbruiken Jev-uitvoer direct zonder uitzonderingsafhandelaars te schrijven voor kapotte JSON-schema's.
Opmerking over typedeterminisme versus waarschijnlijkheid: TypeSafe Jev garandeert door het ontwerp 0% typefouten en schemamatching, waardoor misvormde syntaxis, ontbrekende sleutels en enumwaarden buiten de lijst wiskundig worden geëlimineerd. Zoals alle beslissingsmodellen blijven de uitvoerkeuzes echter probabilistisch. Bij inherent ambigue invoer moeten vertrouwensscores worden gebruikt om de uitvoering te sturen in plaats van absolute semantische zekerheid te veronderstellen.
Hoe niet-autoregressieve parallelle sampling leidt tot latentie onder 500 ms en gratis uitvoer
Het gebruik van standaard chat-endpoints voor eenvoudige classificatietags zoals {"category": "billing"} introduceert onnodige latentie in productiemicroservices. Omdat autoregressieve modellen afhankelijk zijn van sequentiële tokendecodering, blijven backend-threads geblokkeerd terwijl ze wachten op generatielussen per teken.
De werking van evaluatie in één pass
Traditionele transformers voeren autoregressieve generatielussen uit waarbij elk nieuw token een afzonderlijke pass door de netwerkstack vereist. Deze sequentiële afhankelijkheid veroorzaakt hoge latentie en blaast de infrastructuurkosten op op basis van het volume aan gegenereerde tokens.
TypeSafe Jev elimineert sequentiële generatie door niet-autoregressieve parallelle sampling te gebruiken. Zoals beschreven in de TypeSafe-lanceringsaankondiging neemt Jev de contextstate op en evalueert alle vooraf gedeclareerde schemakeuzes gelijktijdig binnen één enkele forward pass.
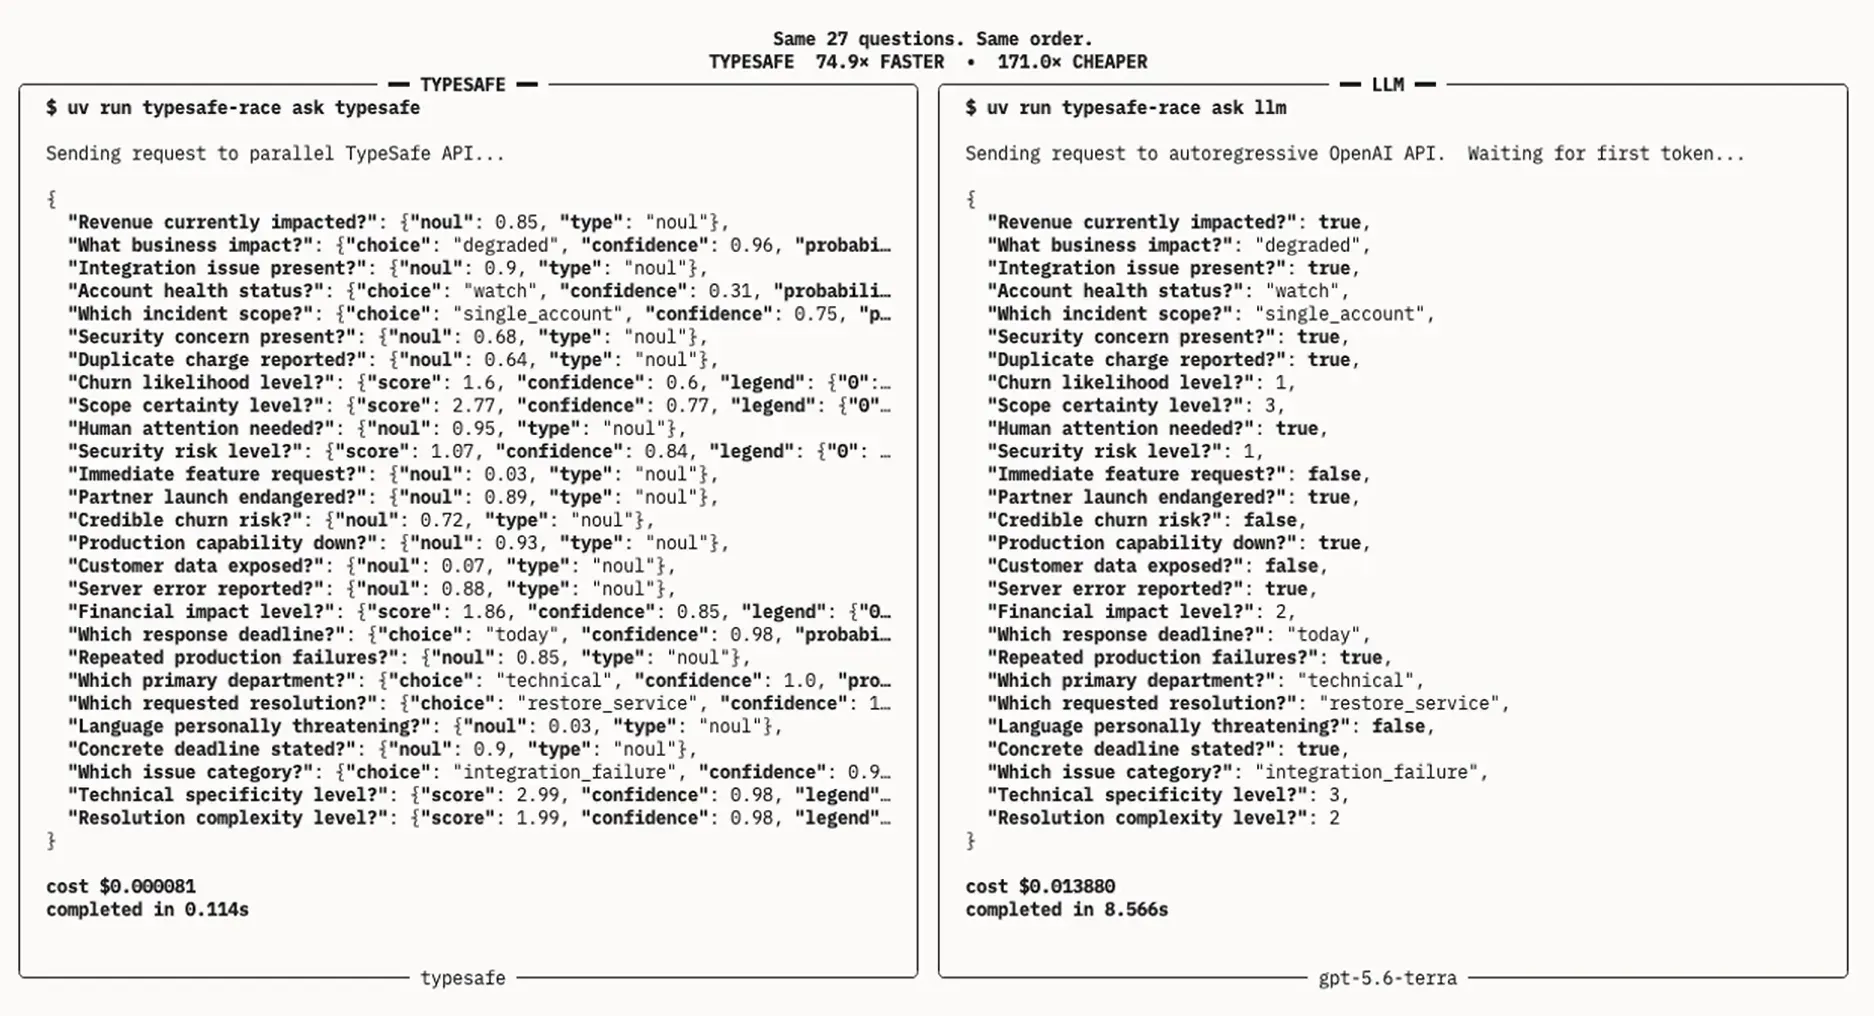
Terminal-benchmarkvergelijking met 27 gelijktijdige schemavragen op TypeSafe Jev versus het GPT 5.6 Terra-endpoint
Omdat het model kansverdelingen berekent over vooraf gedefinieerde uitvoer in plaats van vrije tekst te genereren, verdwijnen uitvoerdecoderingslussen volledig. Deze structurele verschuiving levert drie primaire prestatievoordelen op:
- Gratis uitvoertokens (te goedkoop om te meten): Omdat Jev keuzes evalueert in één enkele forward pass zonder sequentiële tokens te genereren, brengt uitvoerevaluatie vrijwel geen extra compute met zich mee, waardoor uitvoertokens effectief gratis zijn.
- Voorspelbare prijsstelling: Contextverwerking kost een vast bedrag van $0.042 per miljoen invoertokens. Het evalueren van statische prompt-schema's met Jev voorkomt exponentiële inflatie van API-rekeningen in vergelijking met traditionele overhead bij long-context-uitvoering die gepaard gaat met zware chat-endpoints.
- Sub-seconde-uitvoering: Gepubliceerde TypeSafe Jev-latentiebenchmarks tonen P95-responsijden consistent tussen 70 ms en 500 ms, tot 200 keer sneller dan frontier-chatmodellen.
Architecturale prestatie-uitsplitsing
| Metriek / dimensie | Traditionele autoregressieve LLM's (System 2) | TypeSafe Jev System One Engine |
| Uitvoeringslus | Sequentiële tokendecodering, token voor token | Eén parallelle pass over vooraf gedeclareerd schema |
| Uitvoertype | Ongestructureerde tekststrings / JSON-strings | Getypeerde beslissingsprimitieven (Choice, Score, Noul) |
| Schemauitvalpercentage | 0,58% tot 45%+ afhankelijk van model/prompt | 0% typefoutpercentage (wiskundig begrensd) |
| P95-latentieprofiel | 3.000 ms tot 30.000 ms+ | 70 ms tot 500 ms |
| Uitvoereconomie | Variabel per token ($15 tot $60 / MTok) | GRATIS (te goedkoop om te meten) Geen generatie van sequentiële uitvoertokens |
| Primair domein | Redeneren, conceptteksten schrijven, open synthese | Classificatie, toolselectie, vertrouwensgating |
Het knelpunt van geheugenbandbreedte omzeilen
Bij standaard LLM-inferentie raakt de geheugenbandbreedte verzadigd doordat modelgewichten voor elk afzonderlijk token opnieuw in de geheugenlogica worden geladen. Door beslissingsevaluaties in één enkele forward pass af te ronden, omzeilt Jev dit geheugenknelpunt volledig en behoudt het stabiele responssnelheden, zelfs onder zwaar gelijktijdig verkeer.
Reinforcement Learning for Calibrated Decisions en vertrouwensgates
Standaard chatmodellen geven regelmatig onjuiste uitspraken weer met 99% zelfgerapporteerd vertrouwen, omdat conventionele fine-tuning overtuigende formuleringen beloont in plaats van statistische waarheid. In productiemicroservices leidt een overmoedige verkeerde beslissing direct tot beschadigde databaserecords, kapotte toolargumenten en onverwachte systeemuitval.
Modelvertrouwen afstemmen op empirische nauwkeurigheid
Om deze structurele overmoed op te lossen introduceerde TypeSafe Reinforcement Learning for Calibrated Decisions. Anders dan traditionele RLHF-methodologie die optimaliseert voor subjectieve menselijke voorkeur, traint RLCD beslissingsmodellen specifiek om gekalibreerde waarschijnlijkheden te produceren.
Via nauwkeurig afgestemd vertrouwen betekent een waarschijnlijkheidsuitvoer van 0,90 van Jev dat de kandidaatkeuze in 90% van de gevallen empirisch correct is over de testsets. Deze wiskundige kalibratie maakt betrouwbare probabilistische besluitvorming mogelijk zonder dat ontwikkelaars complexe prompt-heuristieken hoeven te schrijven om de zekerheid van de uitvoer te schatten.
Vertrouwensgestuurde routing implementeren in productie
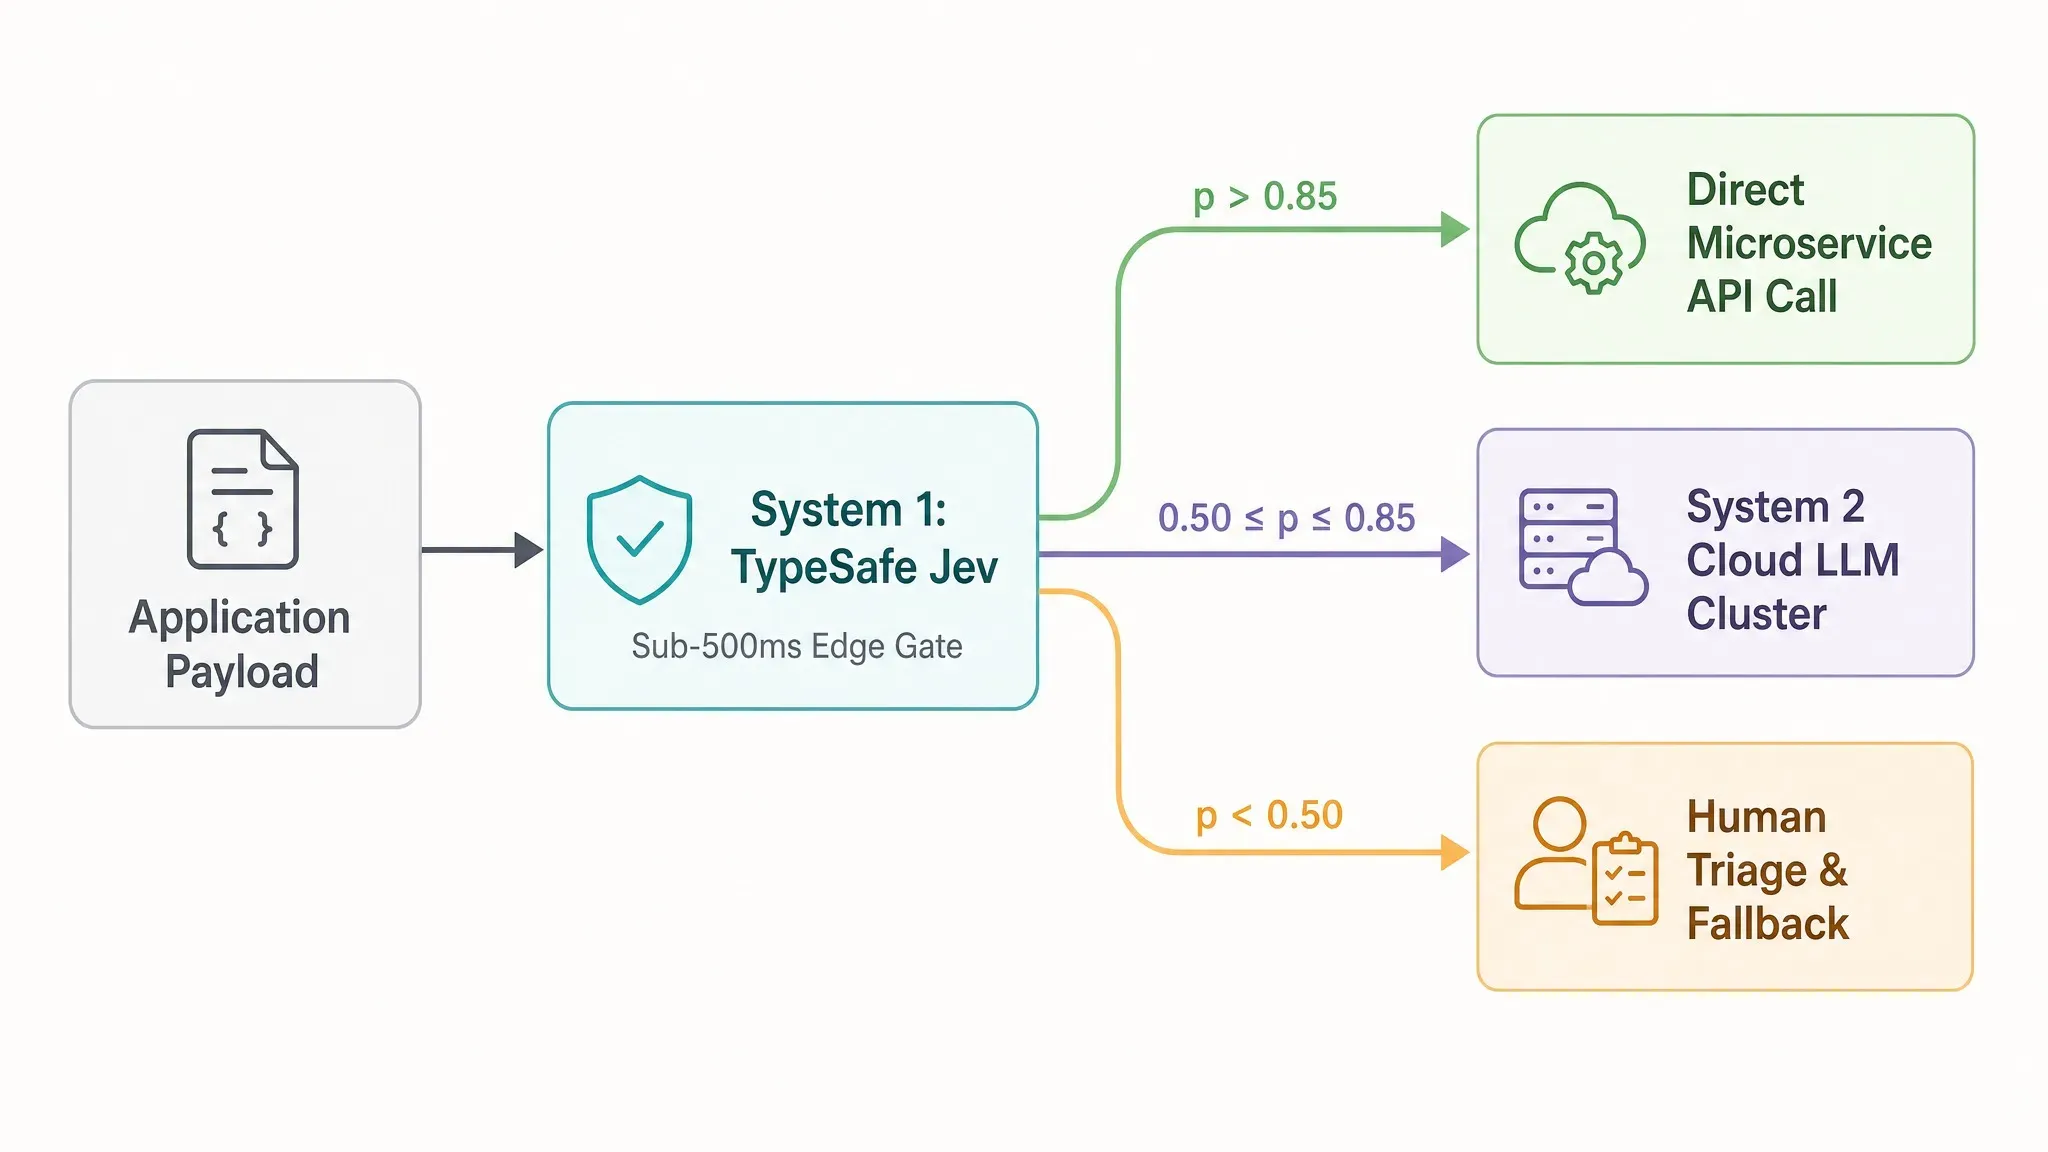
Engineers kunnen deze gekalibreerde kansverdelingen benutten om drempelgebaseerde beslissingspoorten te configureren, bijvoorbeeld in een typische productieopstelling:
p > 0.85(Fast-Path-uitvoering): Voer onmiddellijk uit in het hogesnelheidspad, waarbij langzame LLM-endpoints volledig worden omzeild.0.50 ≤ p ≤ 0.85(System 2-escalatie): Geef grensgevallen door aan een redeneer-LLM om ambigue edge-cases af te handelen.p < 0.50(Fallback-triage): Activeer veiligheidsstandaarden of stuur het verzoek naar een menselijke beoordelingswachtrij.
Voor grensgevallen 0.50 ≤ p ≤ 0.85 leidt vertrouwensgestuurde routing de payload door naar een enterprise-redeneerlaag. Het gebruik van GPT 5.6 Terra op Atlas Cloud biedt een optimaal fallback-doel voor deze geëscaleerde verzoeken, met gebruik van het contextvenster van 1.050K en kostenefficiënte tokenprijzen van $2/$12 om diepe analyse uit te voeren zonder de infrastructuurkosten van microservices op te blazen.
Ruwe logprobs van autoregressieve LLM's zijn berucht ongekalibreerd en verschuiven telkens wanneer systeemprompts veranderen. Door RLCD direct in het kerntrainingsproces te integreren, maakt Jev vertrouwensgestuurde routing productieklaar, zodat softwareteams grootschalige pijplijnen veilig kunnen automatiseren en tegelijk edge-cases kunnen isoleren.
Productieontwerppatronen: hogesnelheids-AI-pijplijnen in de praktijk
Productie-AI-agents crashen vaak wanneer een LLM een niet-bestaande functiesignatuur zoals get_user_billing_v2() verzint of ongeldige parametertypen doorgeeft aan een interne API-endpoint. Het koppelen van meerdere conditionele checks via standaard chat completion-endpoints versterkt de totale systeemlaten, waardoor klantgerichte microservices time-out lopen.
Kernarchitectuurpatronen voor grootschalige microservices
Het integreren van sub-seconde beslissingsengines in productie-AI-pijplijnen stelt softwareteams in staat onvoorspelbare prompt-lussen te vervangen door deterministische backend-ontwerppatronen:
- Agentische toolselectie: Bij het kiezen van tools binnen geautomatiseerde agentworkflows evalueert Jev beschikbare functiesignaturen tegen de huidige applicatiestatus. Omdat kandidaatfuncties als expliciete keuzes in het aanvraagschema worden doorgegeven, kan Jev geen ongedefinieerde functienamen retourneren, wat stille runtime-fouten tijdens agentische toolselectie elimineert. Deze snelle voorfiltering garandeert geldige schemapayloads voordat instructies worden doorgegeven aan autonome LLM-coderingsagent-pijplijnen.
- Parallelle evaluatie van meerdere vragen: Standaard chat-endpoints dwingen applicaties om conditionele vragen sequentieel te evalueren, waardoor de totale latentie wordt vermenigvuldigd met het aantal uitgevoerde checks. Jev maakt parallelle evaluatie van meerdere vragen mogelijk door tientallen schemavragen over één enkele state-payload in één parallelle forward pass te evalueren. Het uitvoeren van vijftien afzonderlijke classificatiechecks duurt hetzelfde venster van 100 ms als het uitvoeren van één.
- Automatisering van ticket-triage: Voor grootschalige microservices die inkomende klanttickets verwerken, parseert Jev tegelijkertijd het klantsentiment, routeert de technische prioriteit en controleert de terugbetalingsgeschiktheid. Het implementeren van ticket-triage-automatisering met sub-seconde-responstijden voorkomt wachtrijachterstanden tijdens plotselinge verkeerspieken.
System One-beslissingsnodes implementeren via SDK
Ontwikkelaars instantiëren beslissingsnodes met lage latentie door de officiële typesafe-sdk te integreren in bestaande microservices. De uitvoeringspayload stuurt de applicatiestatus samen met vooraf gedeclareerde schemaprimitieven rechtstreeks naar het https://api.typesafe.ai/v1/systemone-endpoint.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Traditionele tool-calling-opstellingen hertokeniseren de volledige promptcontext voor elke afzonderlijke functie-evaluatie. Door staterepresentatie los te koppelen van beslissingsvragen, voert Jev classificatiepijplijnen met meerdere vertakkingen uit in backendsystemen zonder de contexttokenoverhead te vermenigvuldigen, de API-rekening op te blazen of de P95-latentiegrenzen op te geven.
Bekende beperkingen en architecturale afwegingen van TypeSafe Jev (wat Jev niet kan)
Het inzetten van een niet-autoregressief beslissingsmodel met de verwachting dat het een beleefd e-mailantwoord schrijft of regelitems op een factuur optelt, breekt onvermijdelijk productiecode. Technische teams die proberen general-purpose LLM's volledig te vervangen door System One-modellen lopen snel tegen fysieke architecturale grenzen aan.
Structurele grensanalyse
Het begrijpen van specifieke Jev-faalmodi is cruciaal voordat Jev in microservice-workflows wordt ingebouwd. Het ontwerp met één forward pass van Jev legt strikte grenzen op voor verschillende kerntaken:
- Open tekstgeneratie: Jev produceert geen enkele conversationele tekst. Het kan geen essays schrijven, documenten samenvatten of natuurlijke taalverklaringen voor zijn selecties genereren.
- Beperkingen voor meerstapsredenering: De architectuur evalueert onmiddellijke staterepresentaties. Complexe, sequentiële logische ketens of meerstapsredeneerbeperkingen vereisen dat taken worden teruggedelegeerd naar traditionele autoregressieve LLM's.
- Rekenkundige beperkingen: Jev kan geen wiskundige berekeningen uitvoeren of items in een contextstring betrouwbaar tellen. Rekenkundige beperkingen vereisen dat financiële berekeningen en array-bewerkingen in standaard backendcode blijven.
- Letterlijke interpretatie van criteria: Het model volgt promptregels letterlijk zonder niet-vermelde bedrijfslogica af te leiden. Ambigue schemaopties leiden tot onverwachte kansspreidingen.
- Contextverval bij zware payloads: Het doorgeven van enorme, ongestructureerde logs veroorzaakt contextverval, wat de evaluatienauwkeurigheid aantast. Het wegfilteren van ruis uit invoerstate-payloads voordat verzoeken worden verzonden blijft essentieel.
Architecturale mapping: System One- versus System Two-capaciteiten
| Operationele taak | TypeSafe Jev System One | Autoregressieve LLM System Two |
| Categorische classificatie | Native (sub-500 ms) | Traag (sequentiële tekst) |
| Tekstsynthese en concepten | Onmogelijk (geen decoderingslus) | Native (open tekstgeneratie) |
| Wiskundige berekening | Niet ondersteund (rekenkundige beperkingen) | Variabel (vereist code-uitvoering) |
| Ruisbestendigheid | Vatbaar voor contextverval in grote states | Hogere veerkracht van contextvenster |
Jev behandelen als een sub-seconde beslissingsnode in plaats van als een universele redeneerengine zorgt voor een correct systeemontwerp in productiemicroservices.
Toekomstige cloudinfrastructuur: snelle beslissingsnodes orkestreren
Elk inkomend gebruikersverzoek rechtstreeks naar een redeneermodel met 70 miljard parameters routeren verbrandt duizenden dollars aan verspilde GPU-cycli en dwingt gebruikers om enkele seconden te wachten op basale beveiligingschecks en payload-routing. Moderne microservicestacks kunnen het zich niet veroorloven om elke inkomende HTTP-payload als een open redeneerprobleem te behandelen.
De verschuiving naar hybride AI-architectuur
Cloudomgevingen verschuiven van monolithische LLM-endpoints naar een ontkoppelde hybride AI-architectuur. In dit opkomende paradigma plaatsen cloud-orchestrators snelle beslissingsnodes aan de netwerkrand om inkomende payloads onmiddellijk te evalueren.
Door edge-AI-routing, schemaverificatie en vertrouwensscoring binnen uitvoeringsvensters van minder dan 500 ms af te handelen, filteren snelle beslissingsnodes verkeer voordat het zwaardere modelclusters bereikt. Deze topologie optimaliseert de resourcetoewijzing over drie afzonderlijke cloudoperationele lagen:
- Edge-guardrails en routing: Snelle beslissingsnodes evalueren gebruikersintentie, schonen invoer op en verifiëren schemanaleving in één enkele forward pass.
- State-overdracht en orkestratie: Cloud-orchestrators analyseren vertrouwensscores, voeren verzoeken met hoge zekerheid onmiddellijk uit en sturen complexe redeneertaken door.
- Gecentraliseerde System 2-redenering: Zware LLM-clusters ontvangen alleen voorgefilterde, gestructureerde payloads wanneer meerturnige synthese of open generatie strikt noodzakelijk is.
System One-modellen op schaal implementeren
Naarmate cloudplatforms hun hostingmogelijkheden uitbreiden, biedt het opnemen van een TypeSafe Jev-implementatie in AI-infrastructuur een efficiënt patroon voor edge-microservices. Het draaien van niet-autoregressieve beslissingsmodellen dicht bij eindgebruikers vermindert de round-trip-tijden drastisch en verlaagt de computekosten voor toepassingen met hoge doorvoer.
Het bouwen van pijplijnen met toegewijde beslissingslagen zorgt ervoor dat backendnetwerken responsief blijven onder zware belasting, terwijl frontier-redeneermodellen zich uitsluitend richten op taken die diepe berekening vereisen.


