Laatste update: Wan 3.0 is live sinds 24 augustus 2026.
Je hebt een map gemaakt voor één 15-seconden advertentie. Twee karakterfoto's. Een brand-tone video die de klant stuurde. Een brandbook dat alleen als PDF bestaat. Een stemvoorbeeld van de acteur die je eigenlijk wilt.
Daarna opende je je videomodel en het vroeg om één afbeelding.
Dus deed je wat iedereen doet. Je vertaalde de map naar een prompt van 800 woorden en bad. Het gezicht verschoof in shot drie. De jas veranderde van kleur. De stem was van iemand anders.
Wan 3.0's omni-referentie is de eerste keer dat een videomodel zegt: oké, geef die map maar. Tot 20 assets in één enkele aanroep, verdeeld over vijf soorten invoer, aan elkaar geregen in één continue opname van 30 seconden.
Dit artikel doet drie dingen en laat de rest achterwege. Het legt uit wat die 20 assets daadwerkelijk zijn, het gebruikt Alibaba's eigen gegenereerde clips als bewijs, en het geeft je een equivalente workflow die je vandaag kunt draaien, want Wan 3.0 is nog in publieke bèta op Alibaba's eigen cloud en nog niet aanroepbaar vanaf derde partijen.
Belangrijkste punten
- Wan 3.0's multimodale referentie accepteert tot 20 assets in één aanroep, variërend van afbeeldingen, video's, audio, documenten en live webpagina's, en houdt ze consistent gedurende één enkele opname van 30 seconden.
- Het is het eerste mainstream videomodel dat een PDF, een slide-deck of een URL als creatieve invoer behandelt, in plaats van iets dat je parafraseert in een prompt.
- Wan 3.0 ging op 6 augustus 2026 in publieke bèta op Alibaba Cloud Model Studio en Qwen Cloud als
wan3.0-video. Het heeft gesloten gewichten. Iedereen die zegt dat het al Apache 2.0 is, gokt. - De headline van 20 assets is niet waar het model echt uitblinkt. Referentie-naar-video modellen die je nu kunt aanroepen, accepteren al meer assets dan 20. Het verschil zit in documenten en webpagina's, niet in aantallen.
- Je kunt het twee-karakter, referentie-vergrendelde, volledig ingesproken formaat gratis testen met Atlas Cloud's gratis AI-advertentieskit-generator: vier productfoto's erin, een gesproken skit van 15 seconden eruit, zonder creditcard.
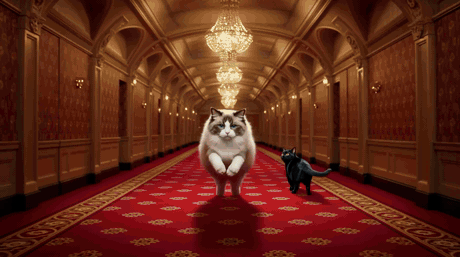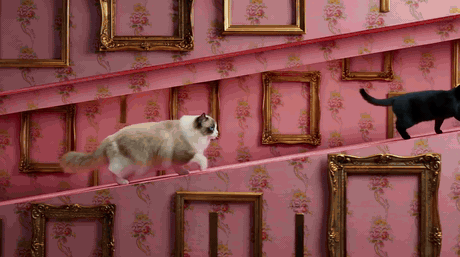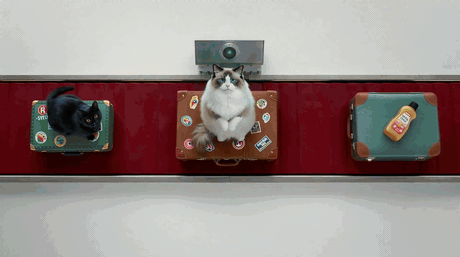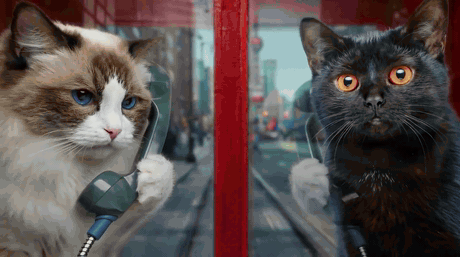
Twee katten achtervolgd door vijf verschillende decors door Wan 3.0 zonder karakterdrift_Twee referentieafbeeldingen. Vijf totaal verschillende decors, van een hotelgang tot een wasmachinetrommel tot een rode telefooncel. Geen enkele frame drift. Bron: Alibaba's officiële_ Wan 3.0 creator handbook , augustus 2026, waar ook alle andere Wan 3.0 clips in dit artikel vandaan komen.
Waarom Multi-Referentie Video Uit Elkaar Valt, en Wat Wan 3.0 Multimodale Referentie Verandert
Videomodellen hebben geen geheugen tussen clips. Elke gegenereerde video begint vanaf nul. Dat is het hele probleem in één zin.
Dus zodra je verhaal meer dan één shot nodig heeft, ben je aan het aan elkaar plakken. Shot één geeft je een gezicht waar je van houdt. Shot twee geeft je een neef van dat gezicht. Shot drie verandert stilletjes de jas van pruim naar bordeaux, en tegen de tijd dat je het merkt, heb je al betaald voor elf renders.
Enkelvoudige afbeeldingsreferentie hielp, maar het vergrendelde maar één ding. Een gezicht. Het kon niet tegelijkertijd een gezicht, een outfit, een rekwisiet, een locatie en een stem vasthouden, want er was één plek en vijf taken.
Er zijn twee manieren om hieruit te komen. Geef het model meer plekken, of stop met het opnieuw laten beginnen. Wan 3.0 doet beide tegelijk, en daarom zijn de twee headlinerfuncties eigenlijk één functie. Een native opname van 30 seconden betekent dat er geen snede is waar het karakter overheen kan drijven. Twintig referentie-assets betekent dat elk element dat vast moet blijven, zijn eigen speciale plek krijgt in plaats van te vechten om één plek.
Dit is hoe dat eruitziet als er niets aan elkaar is geplakt. Dertig seconden, één continue camera, een kind in een winkelwagentje dat uiteindelijk in een billboard belandt en er dan onderuit loopt.
Een volledige 30 seconden in één keer, zonder cuts, met de soundtrack gegenereerd in dezelfde pas. Bron: Alibaba's officiële Wan 3.0 creator handbook.
Wat "20 Assets" Echt Betekent Binnen Wan 3.0 Multimodale Referentie
Twintig is een headlinenummer. Wat ertoe doet, is dat de twintig niet allemaal hetzelfde soort ding zijn. Wan 3.0's omni-referentie omvat vijf invoertypen, en elk type bestuurt een andere as van de uitvoer.
Afbeeldingen controleren identiteit. Een karakterkaart, een productfoto, een locatieplaatje. Wan 3.0 noemt dit pixel-niveau consistentie, en in Alibaba's eigen voorbeelden strekt de vergrendeling zich uit voorbij het gezicht naar de kleding: de gelaagde grijze mantel, de leren riemvest, de donkere taillewrap overleven allemaal een gevecht van zestien seconden, hand-tot-hand, op drie locaties.
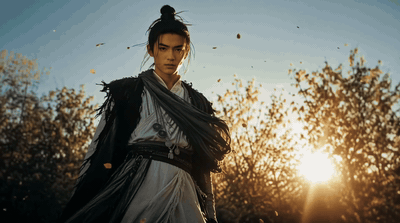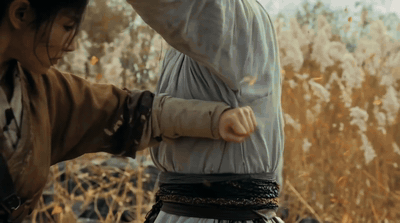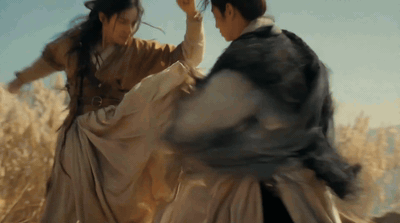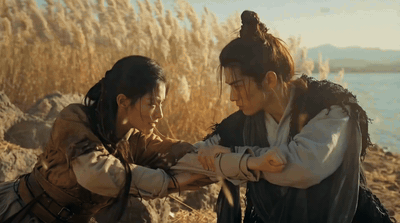
Twee karakterkaarten die een wuxia-vechtscène aansturen met kostuumdetails die frame voor frame behouden blijven
Twee karakterkaarten plus één locatieplaatje van het rietveld. De kleding en de omgeving blijven behouden tijdens elke worp. Getoond als stille GIF; het geleverde bestand heeft een 44.1kHz stereo mix. Bron: Alibaba's officiële Wan 3.0 creator handbook.
Audio bestuurt stem. Dit is het deel dat "multimodaal" meer maakt dan marketing. Je voegt een stemvoorbeeld per karakter toe, schrijft de regels in de prompt, en de dialoog komt terug in dat timbre, lip-sync, in dezelfde pas als het beeld. Twee mensen, twee stemreferenties, één sportschool.
Twee onderwerpafbeeldingen plus twee aparte stemvoorbeeldclips, en de dialoog komt terug in die twee stemmen. Het is de moeite waard om het geluid aan te zetten voor deze. Bron: Alibaba's officiële Wan 3.0 creator handbook.
Video bestuurt timing. Een referentievideo is er niet om gekopieerd te worden. Het is er om zijn ritme te doneren: hoe lang een beat duurt, hoe een overgang beweegt. In deze leveren vijf keyframes de onderwerpen en een referentievideo de horizontale kaart-flip cadans ertussen.
Vijf keyframes geflipt met de pacing van een referentievideo_Vijf_ keyframe-afbeeldingen voor de onderwerpen, één referentievideo voor het flip-ritme. Bron: Alibaba's officiële Wan 3.0 creator handbook.
Documenten en webpagina's controleren structuur. Dit is het echt nieuwe. Wan 3.0 accepteert documentbestanden en live URLs als creatieve invoer, en rapportage over de bèta vermeldt .doc, .xls, .ppt, .pdf en .txt onder de geaccepteerde formaten (AlphaSignal, augustus 2026). Dezelfde logica werkt al met een storyboardafbeelding: één bord erin, zes shots eruit, in de eigen volgorde van het bord.
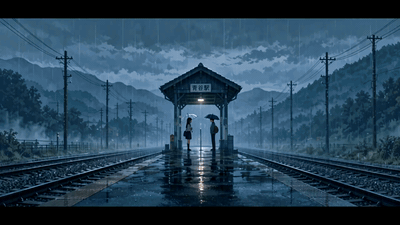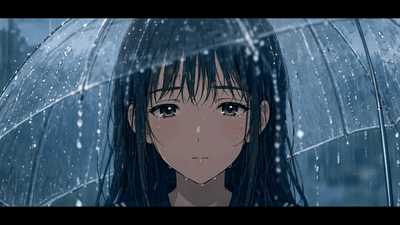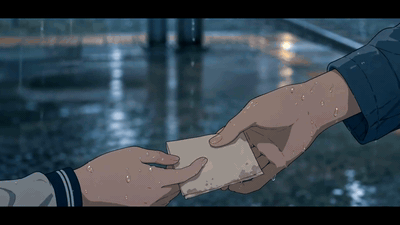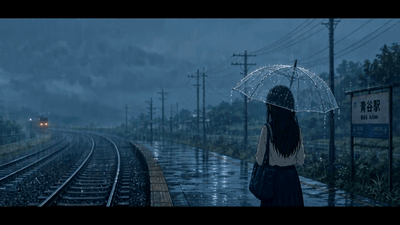
Een enkel storyboardvel uitgebreid tot zes opeenvolgende shots op een regenachtig treinstationperron
Eén storyboardvel als referentie, zes shots gegenereerd in zijn volgorde, tot het doorgeven van een briefje in shot vijf toe. Bron: Alibaba's officiële Wan 3.0 creator handbook.
Eerste en laatste frames bepalen eindpunten. De oudste truc in het boek, nog steeds ondersteund, nog steeds de snelste manier om een shot af te bakenen.
Hier is hoe dat zich verhoudt tot de versie die de meeste mensen vandaag daadwerkelijk gebruiken.
| Wan 2.7 Referentie-naar-Video | Wan 3.0 omni-referentie | |
|---|---|---|
| Referentie-assets | één afbeelding per onderwerp, tot 3 video's, 1 stemclip | tot 20 assets in totaal |
| Modalities | afbeelding, video, audio | afbeelding, video, audio, document, webpage |
| Maximale duur, één pas | 10 s | 30 s native, plus smart duration |
| Audio in dezelfde pas | ja | ja |
| Videobewerking en extensie | niet blootgesteld | instructie- en referentiegebaseerde bewerking, plus extensie |
| Beschikbaarheid | live op API's van derden | Alibaba Cloud Model Studio en Qwen Cloud bèta |
Er is één regel die niemand in de documentatie zet en die iedereen op de harde manier leert: één referentie, één taak. Afbeelding1 vergrendelt het gezicht en de outfit. Video1 doneert alleen beweging. Audio1 doneert alleen timbre. Op het moment dat je een enkele asset twee conflicterende taken geeft, of een referentieafbeelding uploadt met twee mensen erin, moet het model gaan raden, en raden is precies wat je probeerde te stoppen. Alibaba's handboek is hier ook duidelijk over: één onderwerp per referentieafbeelding.
De Wan 3.0 Multimodale Referentie Workflow Die Je Vandaag Kunt Draaien
Eerst het directe antwoord. Wan 3.0 is in publieke bèta op Alibaba's eigen cloud, onder de model-id wan3.0-video (Alibaba Wan, augustus 2026). Het is nog niet geland op API-platforms van derden, Atlas Cloud inbegrepen. Iedereen die je nu Wan 3.0 API-toegang verkoopt, verkoopt iets anders.
Wat wel geland is, is de workflowvorm. Referentiepakket erin, één aanroep, afgewerkte clip met geluid eruit. Dat draait vandaag op referentie-naar-video modellen die je in een browsertabblad kunt aanroepen, en zodra je ze allemaal op een rijtje zet, ziet de headliner van 20 assets er anders uit.
| Model | Referentie-assets | Modalities | Maximale duur | Native audio | Prijs per seconde |
|---|---|---|---|---|---|
| Wan 3.0 (Alibaba bèta, niet op Atlas) | 20 totaal | afbeelding, video, audio, document, webpage | 30 s | Ja | gerapporteerd $0,05 tot $0,20 per resolutie |
| Wan 2.7 Referentie-naar-Video | 1 afbeelding per onderwerp, 3 video's, 1 stemclip | afbeelding, video, audio | 10 s | Ja | $0,10 |
| Seedance 2.5 Referentie-naar-Video | 50 (30 afbeelding / 10 video / 10 audio) | afbeelding, video, audio | 30 s | Ja | $0,13 |
| MiniMax H3 Referentie-naar-Video | gemengd, geen opgegeven limiet | afbeelding, video, audio | 15 s | Ja | $0,10 |
| Kling Video O3 Pro Referentie-naar-Video | 7 afbeeldingen, of 4 afbeeldingen + 1 video | afbeelding, video | 15 s | Ja | $0,10 |
| Vidu Q3-Mix Referentie-naar-Video | 4 afbeeldingen | afbeelding | 16 s | Ja | $0,11 |
| Veo 3.1 Referentie-naar-Video | 3 afbeeldingen | afbeelding | 8 s | Optioneel | $0,20 |
Prijzen zijn Atlas Cloud-tarieven per augustus 2026. De cijfers van Wan 3.0 zijn de gerapporteerde voor de Alibaba Cloud-bèta, geen Atlas-tarief, en Alibaba heeft nog geen openbare prijzenpagina voor het model gepubliceerd, dus beschouw die rij als voorlopig.
Lees die tabel twee keer en het echte verhaal wordt duidelijk. De headliner van 20 assets is niet waar Wan 3.0 uitblinkt, want Seedance 2.5 neemt er al 50 en haalt de 30 seconden. Wat niets anders op die lijst accepteert, is een PDF.
Voor de onderstaande walkthrough draait de demo op Wan 2.7 Referentie-naar-Video, omdat de invoervorm het dichtst in de buurt komt van omni-referentie: meerdere onderwerpafbeeldingen, een optionele referentievideo en een stemclip, allemaal toegewezen aan character1 en character2 labels in de prompt. Drie modellen, één browsertabblad, geen lokale installatie.
Voor een huidige gehoste run, open Wan 3.0 op Atlas Cloud en test een prompt zoals die hieronder voordat je de workflow publiceert.
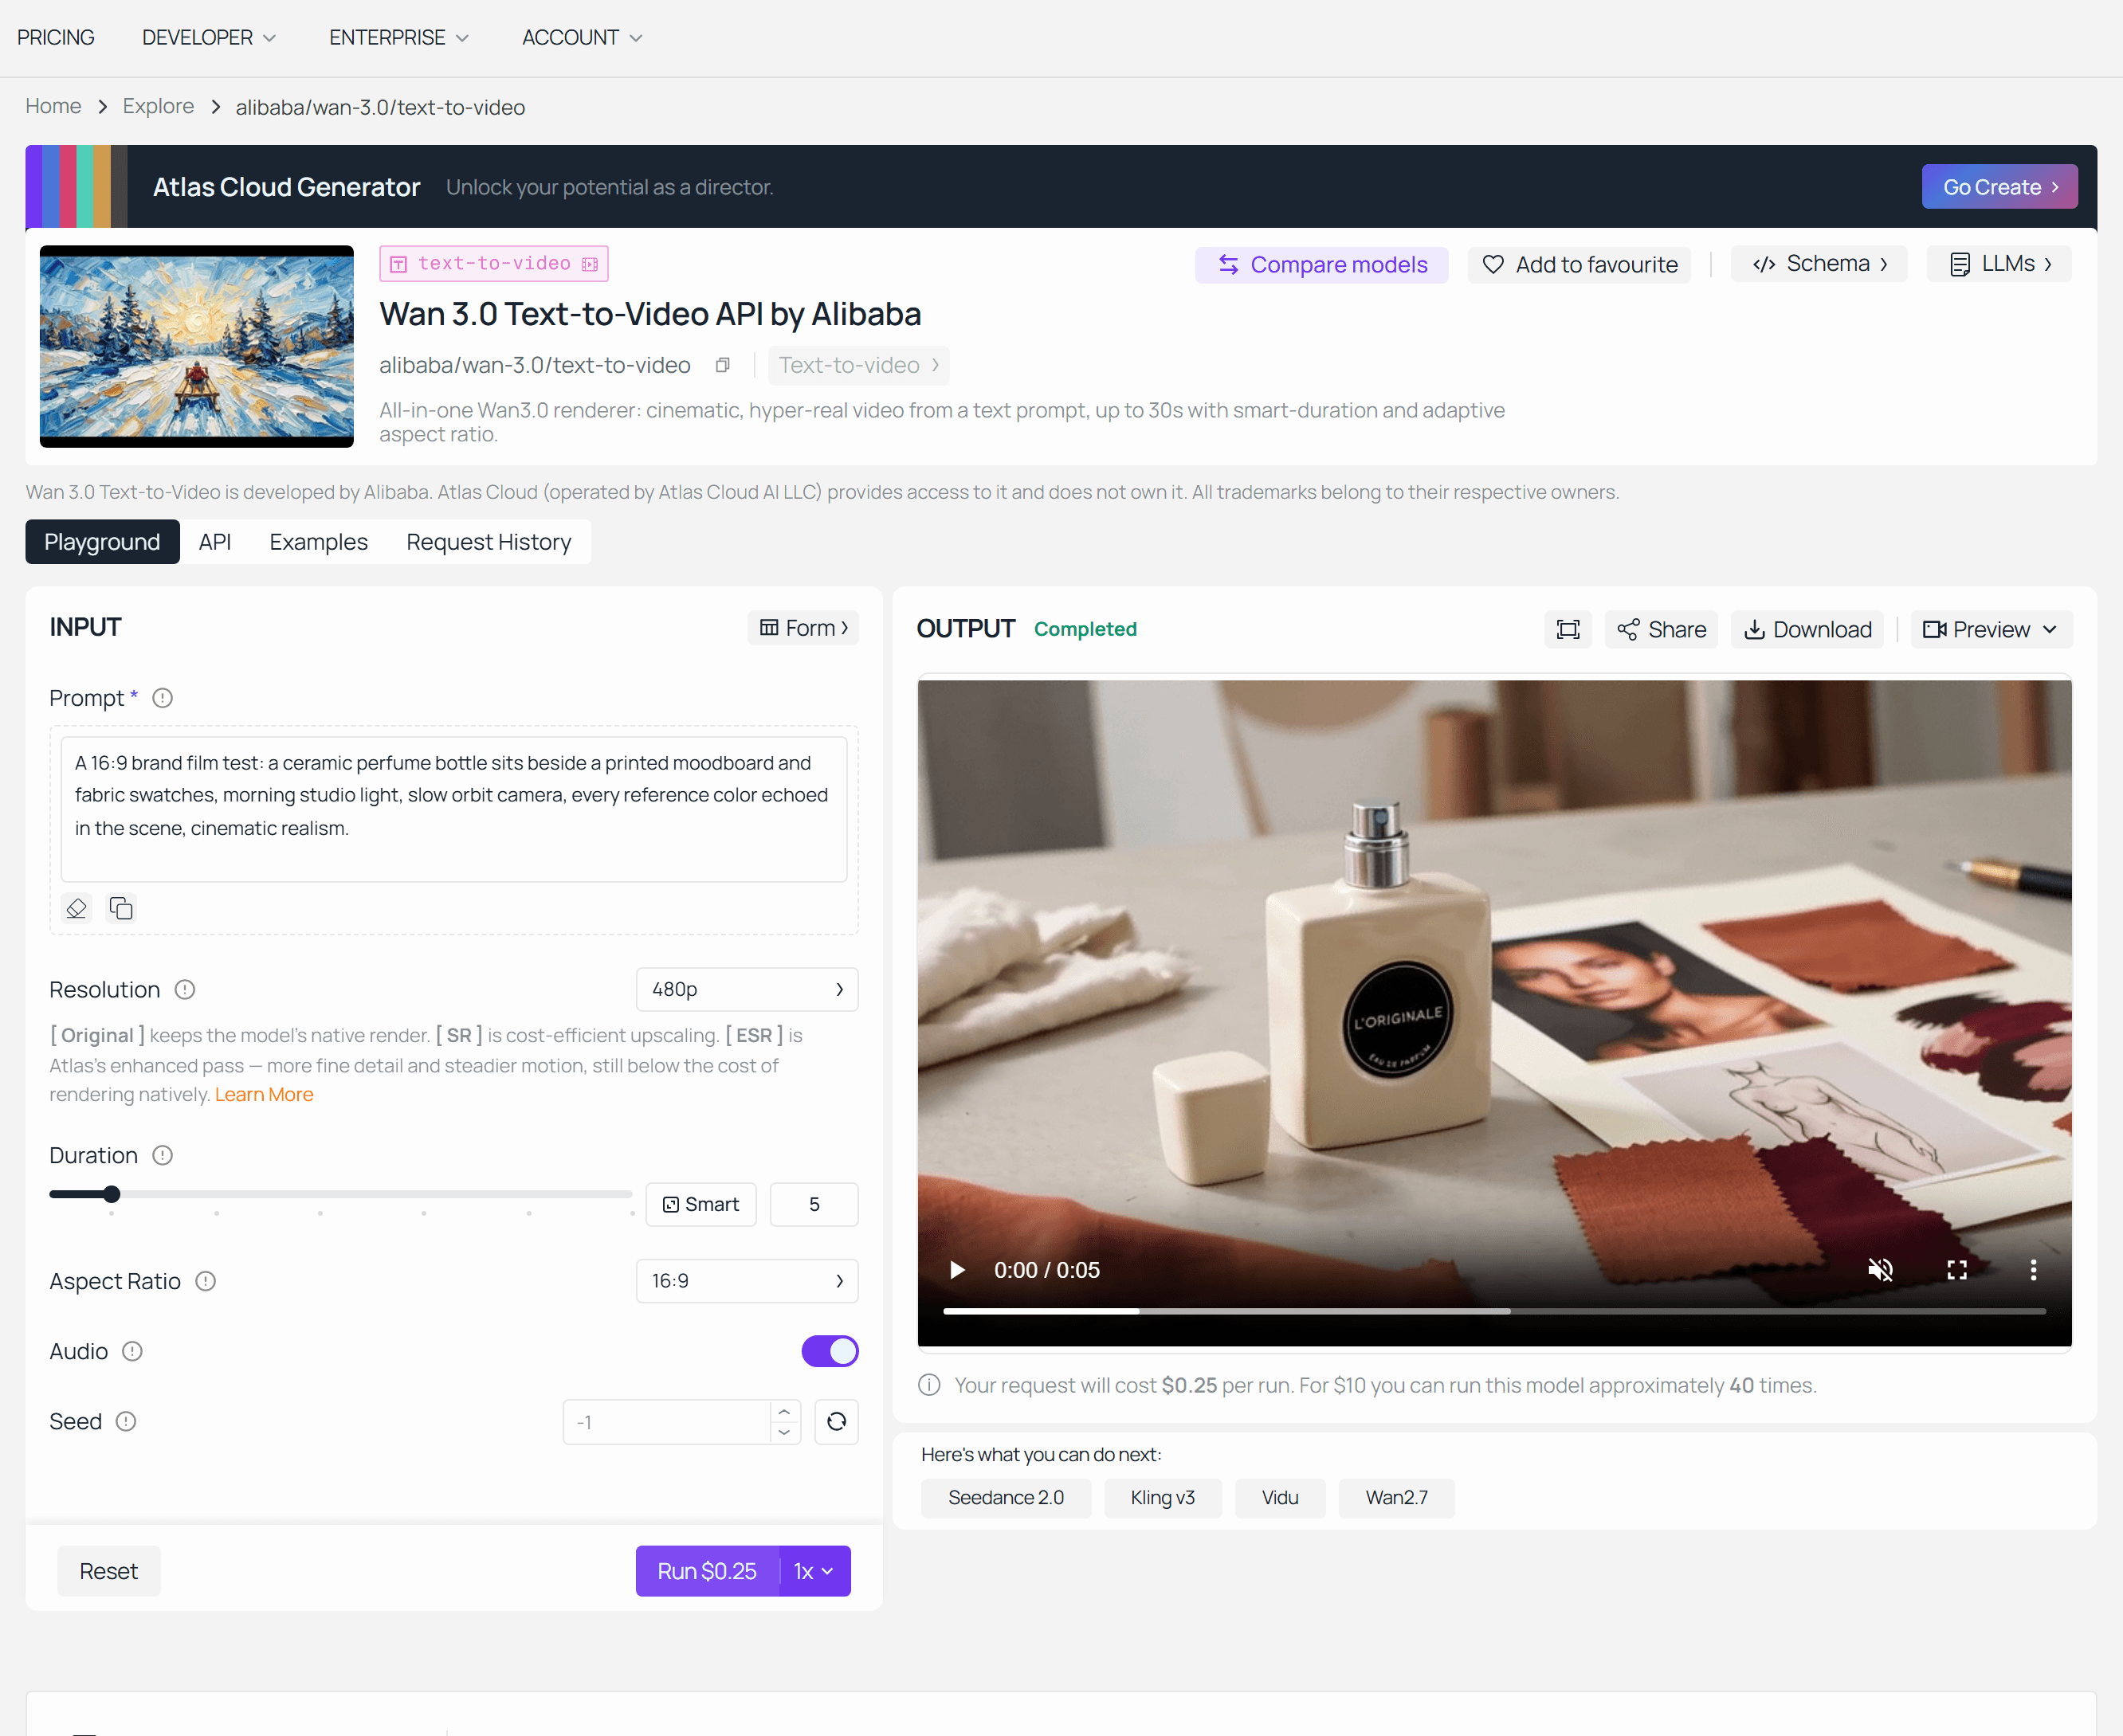
Wan 3.0 prompt-naar-resultaat screenshot: 20-referentie brand-handoff.
Bouw Het Zelf: Een Multimodale Referentiescène in Vier Stappen
De scène: een pastelkleurige hotelbalie. Een doodserieuze conciërge. Een reiziger met een lapjeskat in haar armen. De conciërge kijkt recht in de lens en zegt "De kat heeft een reservering. U niet."
Twee afbeeldingen plus één stemclip, dat zijn drie referentie-assets verdeeld over twee modaliteiten. Dat is de kleinste opbouw die eerlijk gezegd multimodaal is in plaats van alleen multi-afbeelding.
Stap 1. Genereer referentieafbeelding 1, het onderwerp dat je moet vergrendelen
Referentieafbeeldingen hebben drie taken en slechts drie: één onderwerp, naar de camera gericht, schone achtergrond. Al het andere is decoratie. Gebruik GPT Image 2 met kwaliteit high, formaat 16:9, n=1.
Plain1Full-body studio portret van een middelbare hotelconciërge met een doodserieuze uitdrukking, staand exact in het midden tegen een effen stoffig roze muur. Hij draagt een pruimkleurig dubbelrijig bellhop-uniform met gouden biezen en koperen knopen, een kleine ronde pillbox-hoed en een dunne snor. Perfect symmetrische kadrering, gelijkmatig zacht voorlicht, geen schaduw op de muur, 35mm filmkorrel, gedempt pastelpalet. Slechts één onderwerp, geen andere mensen, geen tekst, geen logo, geen rekwisieten in beeld. 2
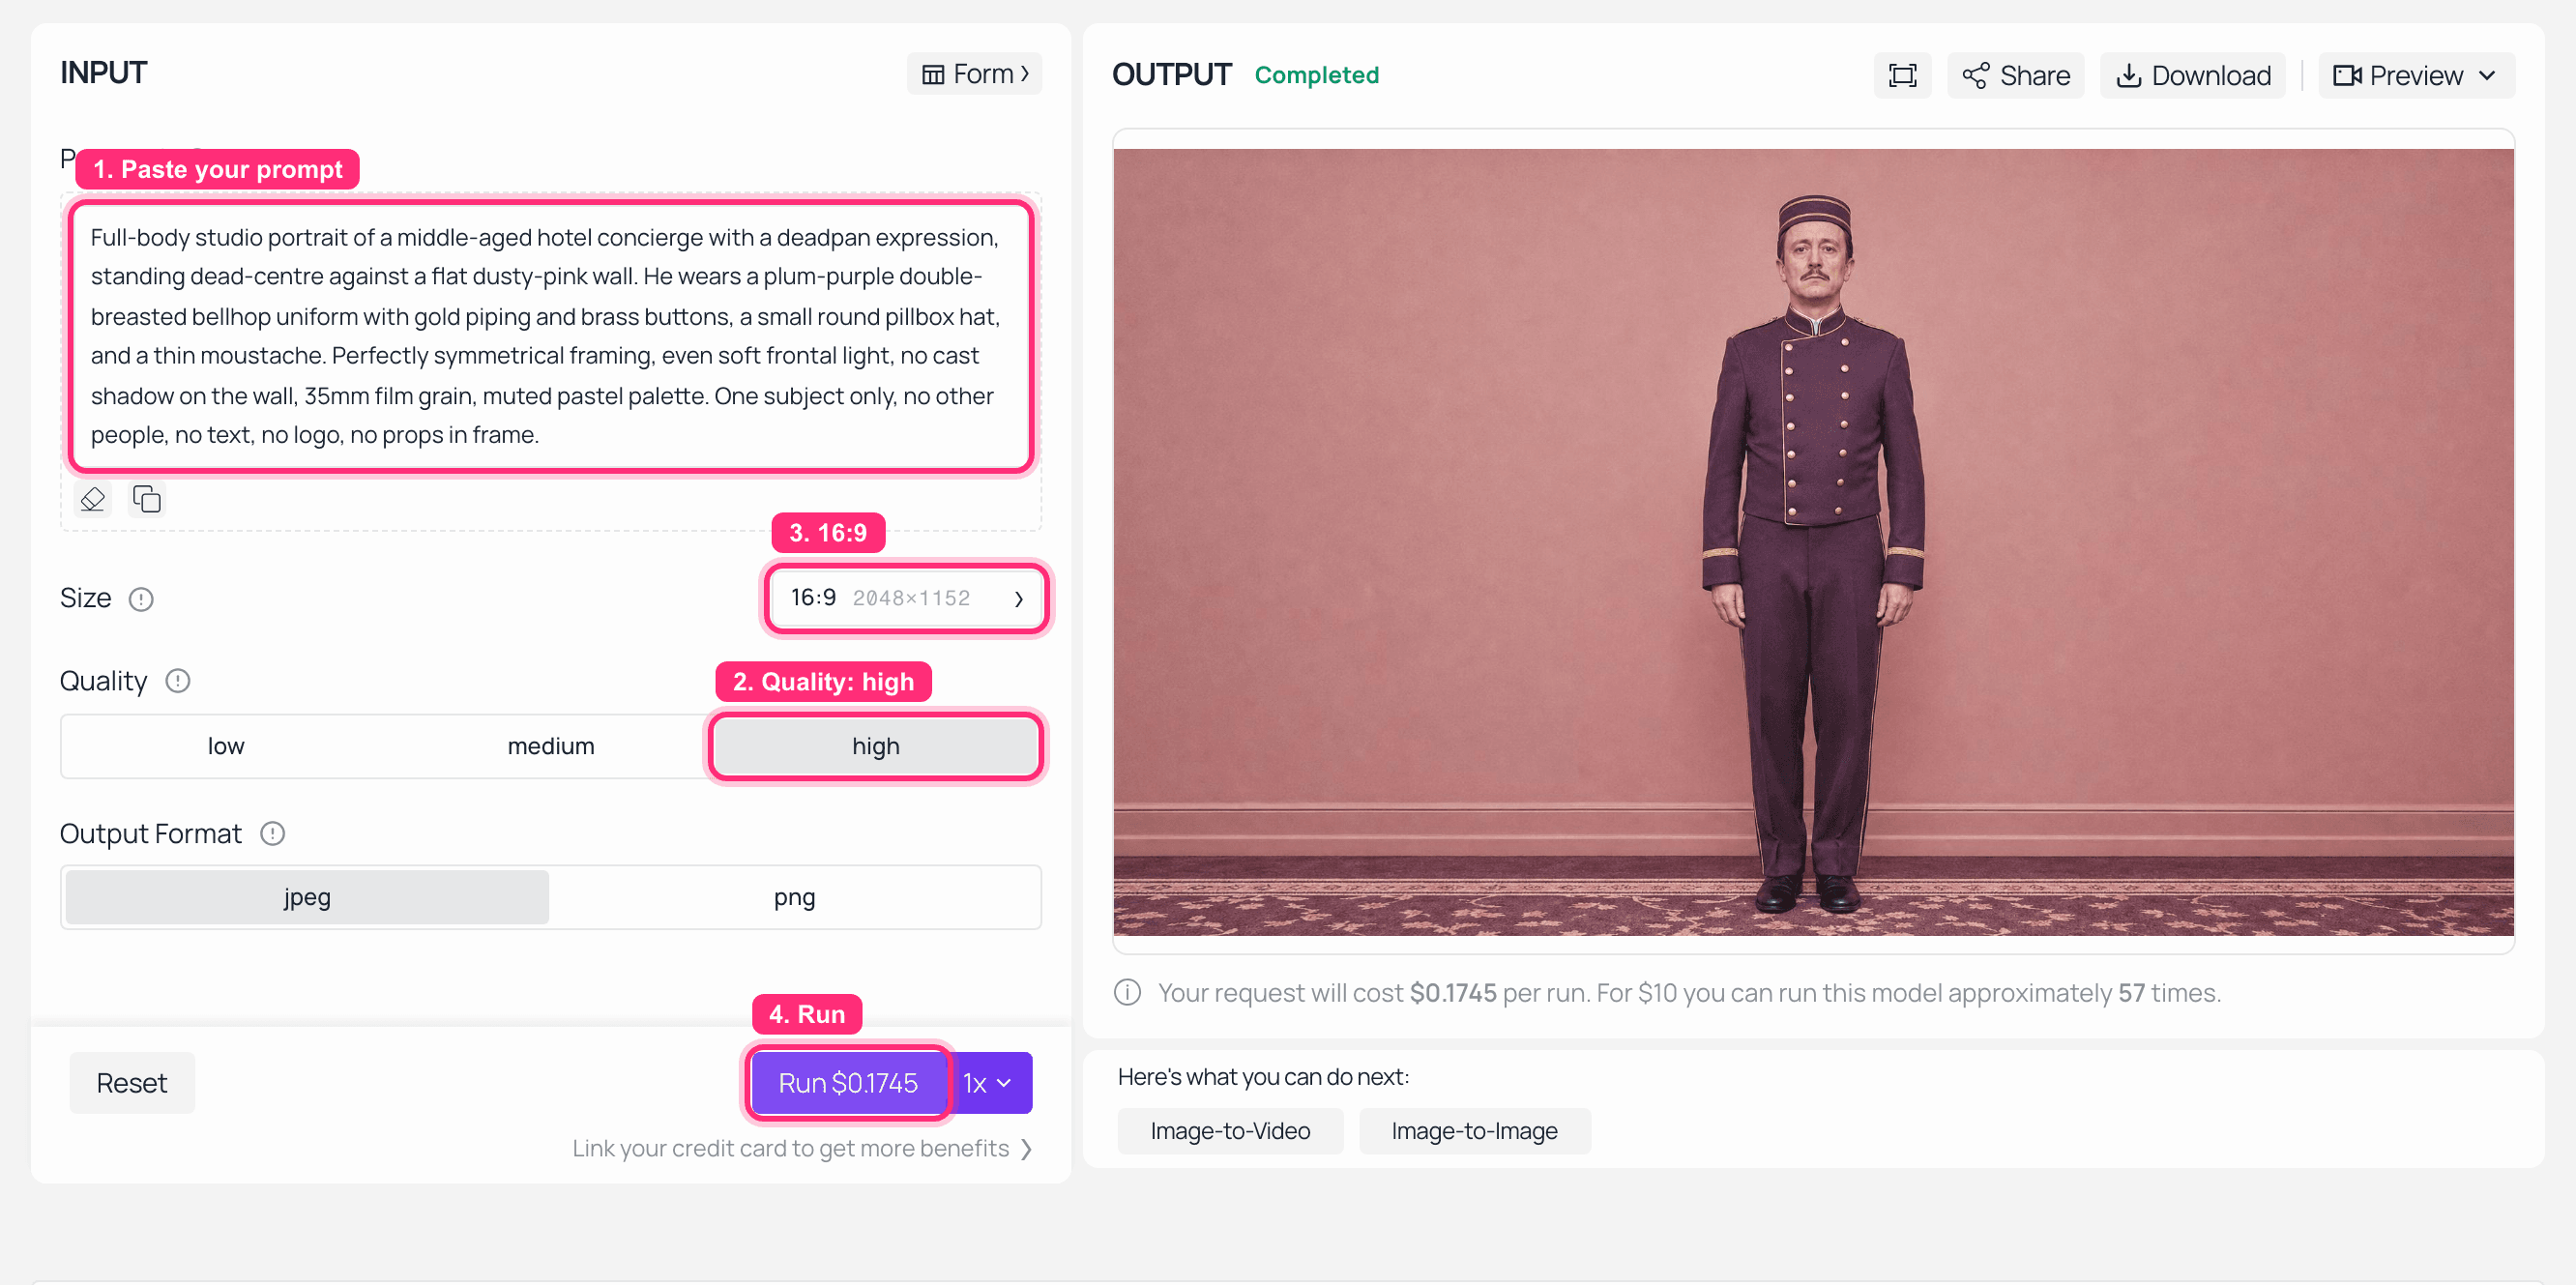
GPT Image 2 playground op Atlas Cloud met het conciërge-referentieportret weergegeven in het uitvoerpaneel
GPT Image 2 op Atlas Cloud: kwaliteit high, 16:9, één onderwerp, effen achtergrond. Dit is het bestand dat character1 wordt.
Stap 2. Genereer referentieafbeelding 2, het tweede vergrendelde onderwerp
Zelfde model, zelfde instellingen. Het kleurcontrast tussen de twee karakters is bewust, omdat het het model een gemakkelijke manier geeft om ze uit elkaar te houden wanneer ze een frame delen.
Plain1Full-body studio portret van een jonge vrouwelijke reiziger die een pluizige lapjeskat tegen haar borst houdt, staand exact in het midden tegen een effen mosterdgele muur. Ze draagt een mosterdkleurige wollen jas, een rode baret en een rond schildpadbril, en houdt in haar vrije hand een kleine vintage leren koffer. Perfect symmetrische kadrering, gelijkmatig zacht voorlicht, geen schaduw op de muur, 35mm filmkorrel, gedempt pastelpalet. Slechts één onderwerp, geen andere mensen, geen tekst, geen logo. 2
Stap 3. Genereer de stemreferentie, het daadwerkelijke multimodale onderdeel
De stemclip is wat dit van een multi-afbeeldingstaak in een multimodale verandert. Wan 2.7's audio-slot wil een kort voorbeeld, ongeveer 1 tot 10 seconden, dus houd de regel kort. Gebruik MiniMax Speech 2.6 HD en kies een lage, vlakke, onverstoorbare mannenstem.
Plain1Goedenavond. Inchecken? Natuurlijk. Iedereen wel. 2
Stap 4. Eén aanroep, drie referenties, één afgewerkte clip
Nu gaat het hele pakket tegelijk in op Wan 2.7 Referentie-naar-Video. Instellingen: resolution: 1080P, ratio: 16:9, duration: 10, wat het plafond van dit model is, prompt_extend: false, seed: -1. Laad images in volgorde, stap 1 eerst, zodat het aan character1 wordt toegewezen, dan stap 2 als character2, en koppel het bestand van stap 3 aan audio.
Plain1Symmetrisch, exact middenkader breed shot van een pastelkleurige hotellobbybalie, stoffig roze muren en een mosterdgele sleutelrek erachter. character1 is de conciërge die achter de balie staat; character2 is de reiziger die ervoor staat, nog steeds met haar lapjeskat. De camera beweegt langzaam naar binnen langs een perfecte centrale as en kantelt nooit. character1 kijkt recht in de lens en zegt vlak: "De kat heeft een reservering. U niet." character2 knippert een keer, draait langzaam haar hoofd naar de kat, dan terug naar de balie. De kat staart recht in de camera zonder te bewegen. 35mm filmkorrel, gelijkmatig zacht licht, gedempt pastelpalet, geen camerabeweging, geen cuts. 2
Negatieve prompt:
Plain1handheld schudden, jump cuts, ondertiteling, tekst op beeld, watermerk, extra mensen, misvormde handen, gezichtsmorfing, kleurverschuiving, bewegingsonscherpte 2
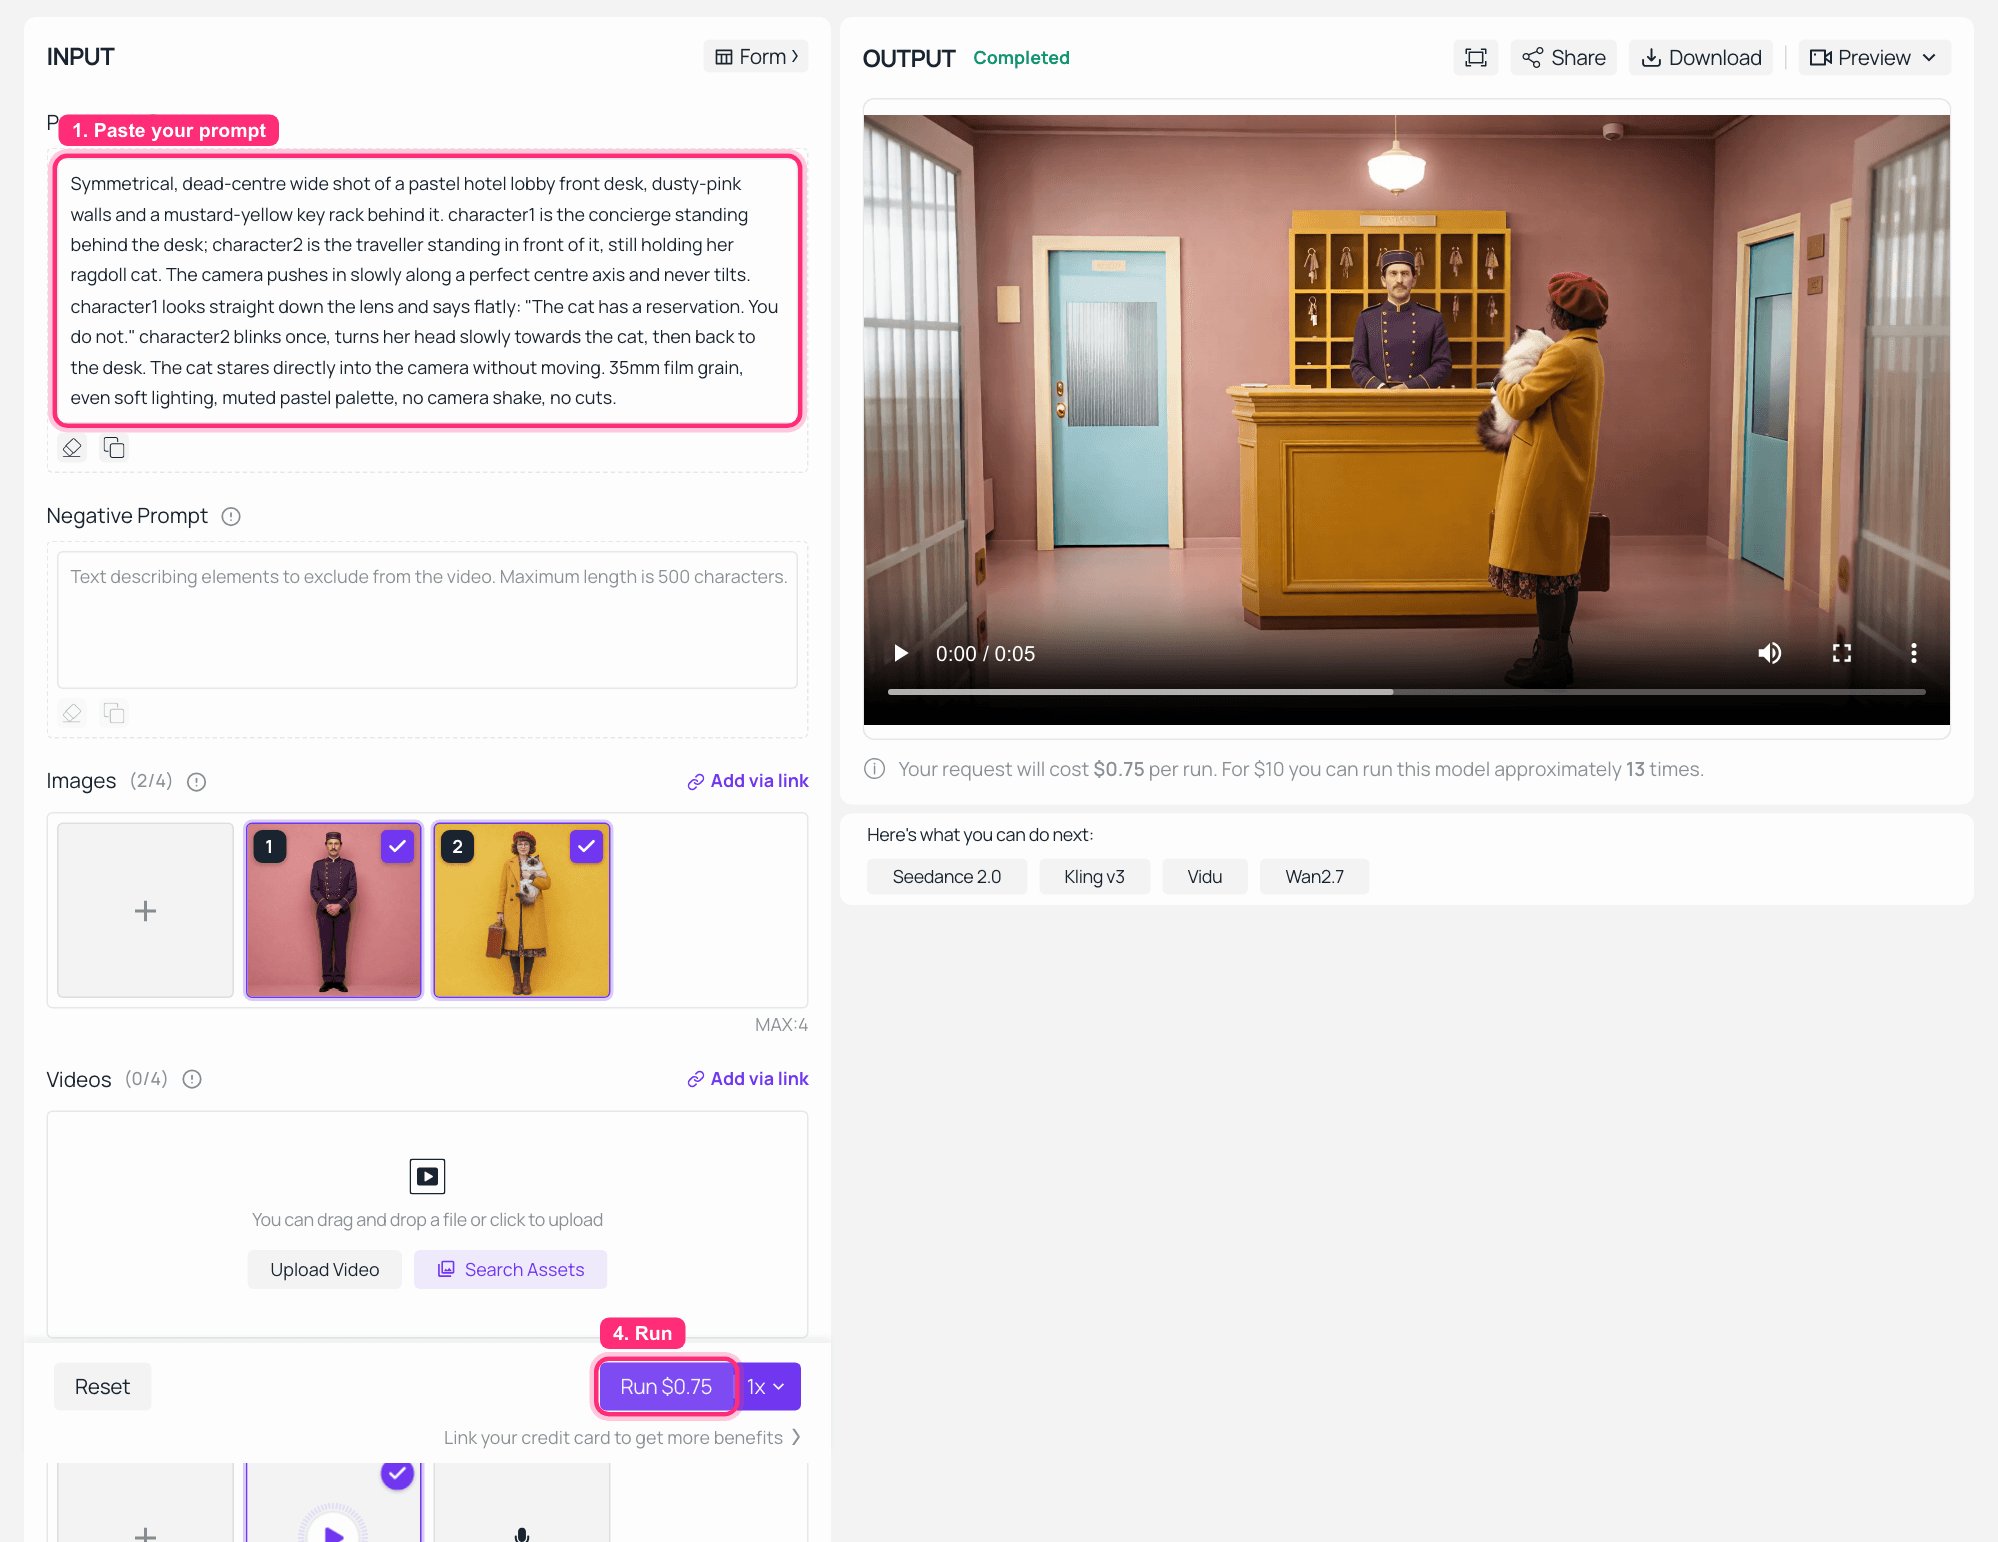
Wan 2.7 Referentie-naar-Video playground op Atlas Cloud met twee referentieafbeeldingen en één audiobestand geladen en de afgewerkte clip in het uitvoerpaneel
Wan 2.7 Referentie-naar-Video op Atlas Cloud: twee referentieafbeeldingen en één stemclip aan de linkerkant, de afgewerkte take speelt rechts af op 1080P en 16:9. Deze opname liep op de standaardduur van het model; zet het op 10 voor de volledige versie hieronder.
De afgewerkte clip. Beide gezichten behouden, beide outfits behouden, en de regel geleverd in de gekloonde stem van stap 3, dus deze is het waard om met geluid af te spelen.
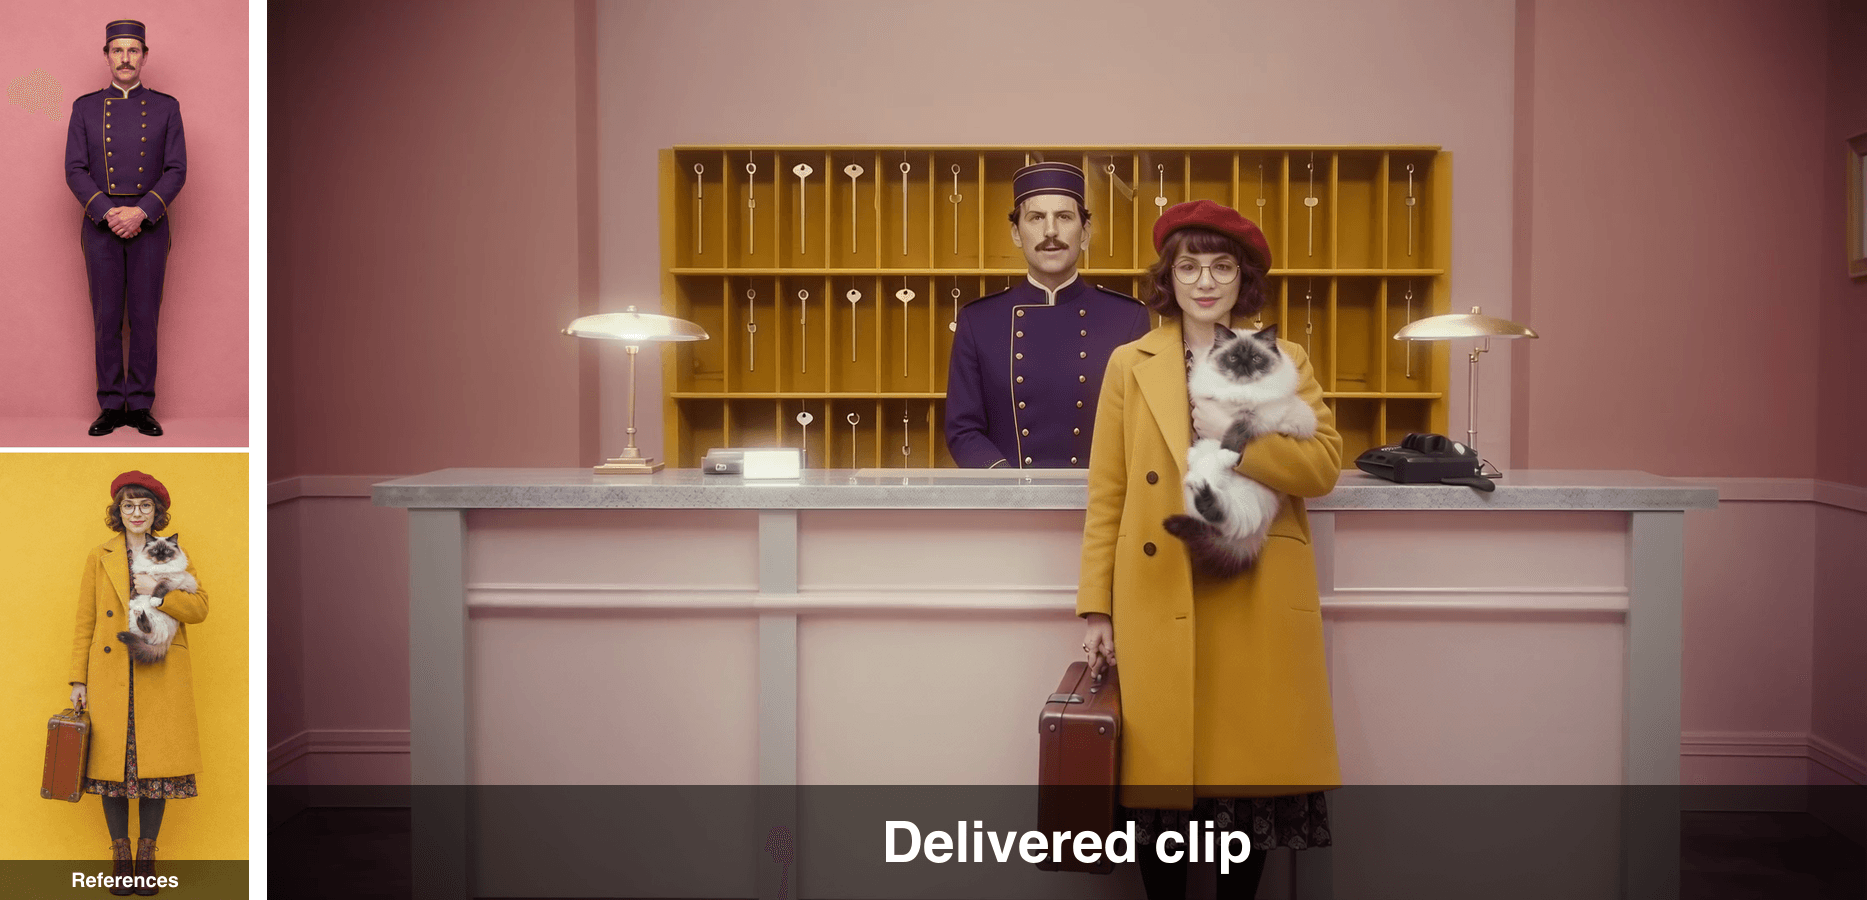
De twee referentieportretten naast een frame uit de afgewerkte clip, met dezelfde gezichten en outfits
Referenties links, een frame uit de geleverde clip rechts. Uniformbiezen, baret, bril en kat overleven de reis.
Variaties op de Wan 3.0 Multimodale Referentie Workflow
Duwh het naar 30 seconden. Hetzelfde referentiepakket draait op Seedance 2.5 Referentie-naar-Video met duration: 30, wat je de lengte geeft die Wan 3.0 belooft zonder te wachten op de bèta. Het neemt tot 30 referentieafbeeldingen, 10 video's en 10 audioclips, dus het pakket heeft ruimte om te groeien. Schrijf de extra 20 seconden als beats in de prompt, niet als sferen, anders zal het model opvullen.
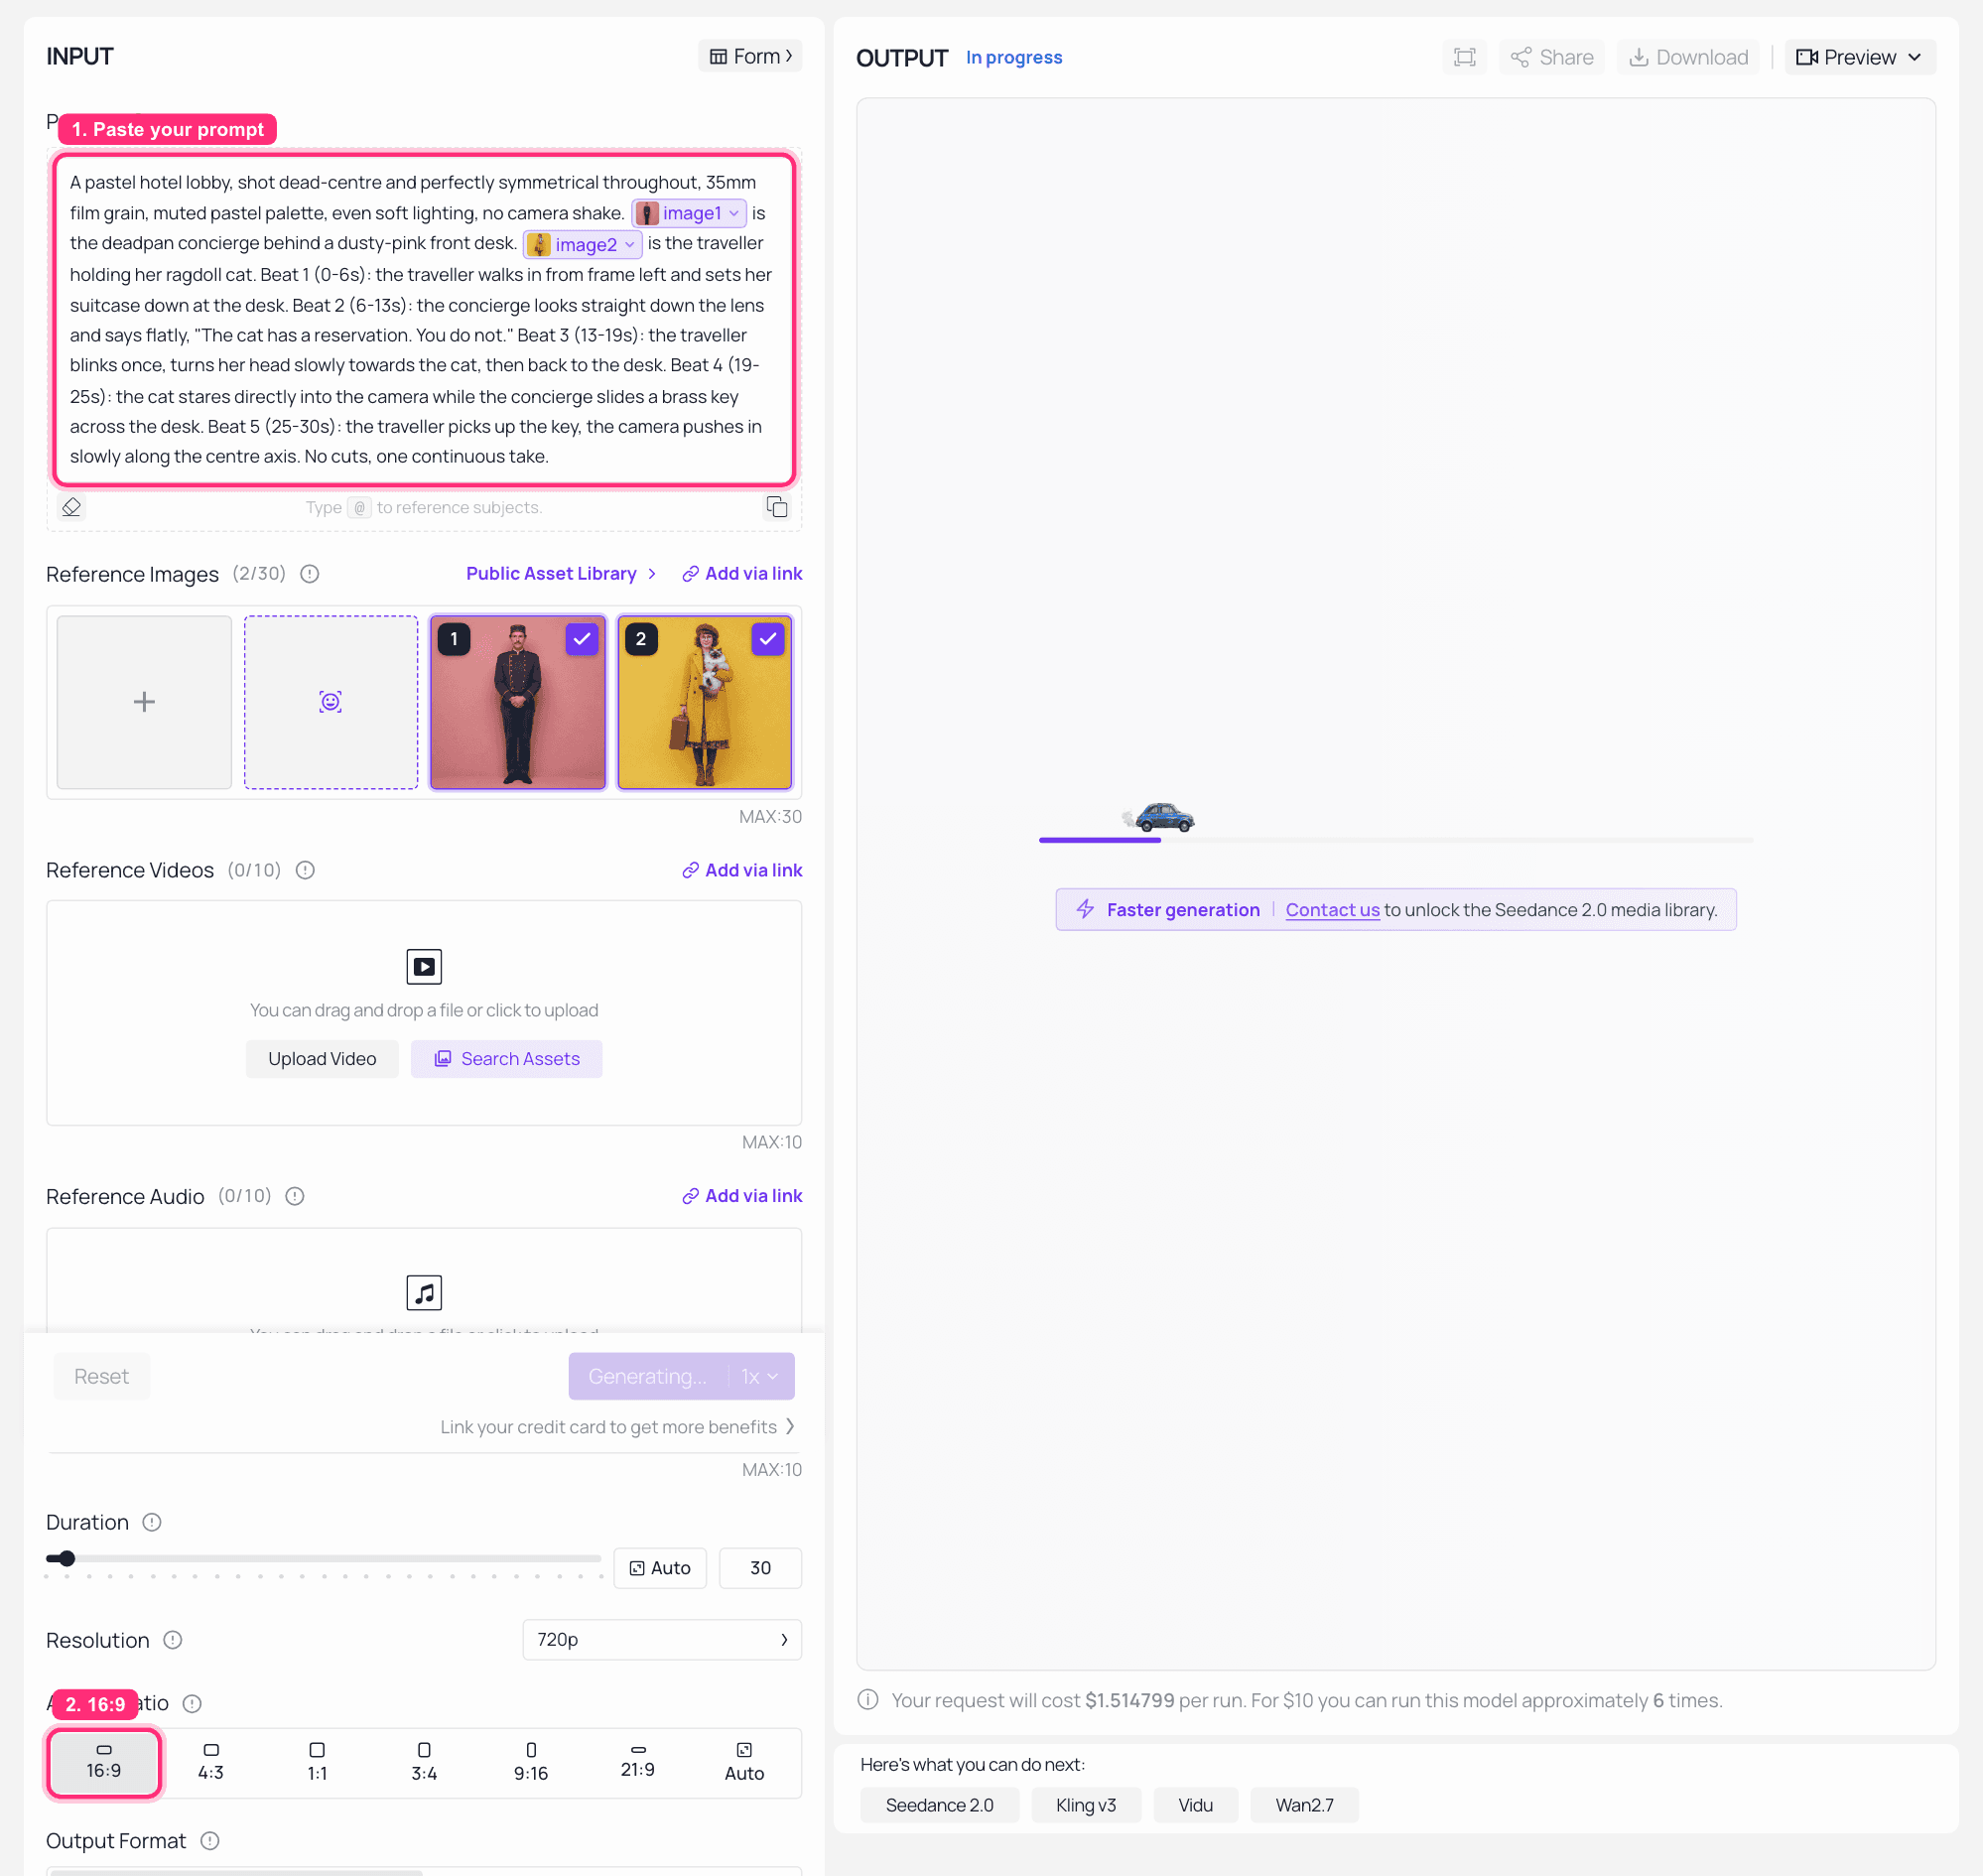
Seedance 2.5 Referentie-naar-Video playground op Atlas Cloud met duur ingesteld op 30 en de lange take gerenderd
Seedance 2.5 Referentie-naar-Video op Atlas Cloud met duur ingesteld op 30 en dezelfde twee referentieportretten bijgevoegd, halverwege de generatie. Let op de @image1 en @image2 chips in de prompt: zo vertel je Seedance welke referentie welke rol speelt. Controleer de geprijsde prijs op de Run-knop voordat je bevestigt, omdat deze de duur weerspiegelt die de taak daadwerkelijk zal indienen.
De 30-secondenversie van dezelfde scène, hetzelfde referentiepakket, beats uitgeschreven shot voor shot.
Voeg een referentievideo toe voor alleen beweging. Koppel een clip waarvan je de pacing leuk vindt en vermeld dat expliciet in de prompt, zoiets als "volg de referentievideo voor snijritme alleen, negeer de onderwerpen en setting". Dat is de truc achter het kaart-flip voorbeeld hierboven.
Los drift op met de negatieve prompt voordat je de positieve aanraakt. Gezichtsmorfing, kleurverschuiving en handheld schudden zijn de drie die referentie-vergrendelde shots verpesten, en ze zijn meestal goedkoper te onderdrukken dan te overbeschrijven.
Probeer het Multimodale Referentie Formaat Gratis
Als je de vorm hiervan wilt voordat je de parameters wilt, heeft Atlas Cloud vorige week een gratis AI-advertentieskit-generator gelanceerd die dezelfde keten draait zonder enige knoppen.
Je schrijft één regel over je product en de verkoopargumenten. Het schrijft een twee-karakters komediescript voor je, hook, conflict, twist, en rendert vervolgens een video van 15 seconden met gesproken dialoog en geluidseffecten ingebouwd. Je kunt tot vier echte productfoto's als referenties bijvoegen, en de advertentie behoudt hun vorm, kleur, label en logo van script tot laatste frame. Zes stijlen worden meegeleverd, van grappige meme via plot twist en sitcom tot luxe en harde verkoop, en de dialoog komt terug in de taal waarin je de beschrijving schreef.
Dat is dezelfde twee-karakters-plus-referentieafbeeldingen-plus-stemketen uit de tutorial, minus het prompt schrijven en minus de rekening. Wat het een goede manier maakt om erachter te komen of dit formaat bij je product past voordat je iets uitgeeft aan afstemmen.
Voor een idee van wat een stapel referentiestills doet voor een productstuk, hier is Wan 3.0's eigen versie van de taak: vijf afbeeldingen erin, één lanceringreel eruit, elke still verankert één beat van de montage.
Vijf referentiestills uitgebreid tot een productlanceringreel in Material Design-stijl_Vijf referentieafbeeldingen die een productfilm van negen seconden aansturen, elk verankert een beat en geeft door aan de volgende. Bron: Alibaba's officiële Wan 3.0 creator handbook._
Wat een Wan 3.0 Multimodale Referentieclip Kost
| Stap | Model | Eenheidsprijs | Aantal | Kosten |
|---|---|---|---|---|
| 1 en 2, twee referentieafbeeldingen | GPT Image 2 | $0,009 per afbeelding | 2 | $0,02 |
| 3, stemreferentie | MiniMax Speech 2.6 HD | $0,08 per 1K tekens | 49 tekens | $0,00 |
| 4, de 10-seconden take op 1080P | Wan 2.7 Referentie-naar-Video | $0,15 per seconde op 1080P | 10 s | $1,50 |
| Tutorial totaal | ongeveer $1,52 | |||
| Variatie, 30 seconden | Seedance 2.5 Referentie-naar-Video | $0,134 per seconde op 480P | 30 s | ongeveer $4,02 |
| Gratis route | Gratis AI Advertentieskit Generator | gratis | 1 clip, 15 s | $0 |
Dat zijn de tarieven van het platform zelf, gecontroleerd in augustus 2026 en betaald per gebruik. Twee dingen bewegen het totaal meer dan mensen verwachten. Resolutie is de eerste: de $0,10 per seconde in de vergelijkingstabel is Wan 2.7's basistarief, en 1080P wordt gefactureerd op $0,15, wat de oorsprong is van de $1,50 hierboven. De tweede is dat Seedance prijst op basis van pixelcount, dus de vermelde $0,134 per seconde is het 480P-cijfer en een 720P take kost meer dan een simpele vermenigvuldiging suggereert. Ter referentie: het gerapporteerde Wan 3.0 bètatarief van $0,20 per seconde op 1080p zou een volledige 30-seconden take op ongeveer $6 brengen, wat meer is dan de Seedance-route op 480P vandaag.
Een opmerking over het gebruik van dit spul. Wan 3.0 is een bèta en de voorwaarden kunnen veranderen, dus lees ze opnieuw voordat je een pijplijn bouwt. Als je referentieafbeeldingen echte mensen zijn, vraag dan eerst hun toestemming, want referentie-naar-video is precies de mogelijkheid die dat belangrijk maakt. De voorbeeldclips in dit artikel zijn Alibaba's eigen gegenereerde resultaten uit het openbare creator-handbook, hier gereproduceerd voor commentaar.
Veelgestelde Vragen
Hoeveel referenties kan Wan 3.0's multimodale referentie daadwerkelijk accepteren?
Tot 20 assets in één enkele aanroep, afkomstig van afbeeldingen, video's, audio, documenten en webpagina's. De praktische limiet is lager dan de technische. Wijs elke asset precies één taak toe, één onderwerp per afbeelding, en je zult voor de meeste scènes veel minder dan 20 gebruiken.
Kan Wan 3.0 echt een PDF of een webpagina in een video veranderen?
Ja, dat is het echt unieke deel. Naast tekst, afbeelding, audio en video accepteert het documentbestanden en live URLs, met rapportage over de bèta die .doc, .xls, .ppt, .pdf en .txt vermeldt. Geen enkel ander referentie-naar-video model in de bovenstaande vergelijkingstabel accepteert een document.
Is Wan 3.0 open source? Kan ik het in ComfyUI draaien?
Nee, en nu niet. Wan 3.0 is een gesloten bèta die draait op Alibaba's eigen cloud. Eerdere Wan-generaties werden openlijk uitgebracht, vandaar dat de verwachting bestaat, maar Alibaba heeft geen gewichten voor 3.0 bevestigd. Pagina's die beweren een 1.3B of 14B Apache 2.0-release van Wan 3.0 te zijn, worden niet ondersteund door iets officieels.
Is Wan 3.0 beschikbaar via API's van derden?
Nog niet, Atlas Cloud inbegrepen. Het dichtstbijzijnde dat je vandaag kunt aanroepen, is Wan 2.7 Referentie-naar-Video, waarvan de invoervorm bijna exact overeenkomt met omni-referentie, afgezien van de document- en webpaginamodaliteiten, of Seedance 2.5 Referentie-naar-Video als je de volledige 30 seconden nodig hebt.
Wat is de goedkoopste manier om een referentie-vergrendelde, twee-karakters video te testen?
De gratis AI-advertentieskit-generator hierboven gelinkt. Vier referentiefoto's erin, een gesproken clip van 15 seconden met twee karakters eruit, geen parameters en geen uitgaven. Als het je product en je formaat vasthoudt, ga dan de betaalde keten afstemmen.
Waarom drijven mijn karakters nog steeds weg, zelfs met referentieafbeeldingen?
Drie oorzaken, in volgorde van frequentie. Eén referentie voert twee taken uit, dus het wordt gevraagd om zowel het gezicht als de locatie vast te zetten. De referentieafbeelding heeft meer dan één persoon of een drukke achtergrond, dus het model weet niet welk deel het moet vergrendelen. Of de drift is een rendering-artefact in plaats van een referentiefout, in welk geval je gezichtsmorfing, kleurverschuiving in de negatieve prompt plaatst voordat je iets herschrijft.


