En grön API-testrapport känns betryggande tills du märker att varje assertion bara kontrollerar HTTP 200. Svaret skulle kunna innehålla fel kunds post och ändå godkännas.
Välj AI-verktyg för API-testning utifrån det arbete du redan har. Utvärdera Postman Agent Mode om ditt team underhåller samlingar, KushoAI om en specifikation är din utgångspunkt, och Keploy om du behöver genererade flöden eller regressionstester byggda från inspelad trafik. Granska och kör de resulterande testerna innan du litar på dem.
Den här guiden handlar om AI-stöd för att testa vanliga API:er. Att testa träffsäkerheten i en AI-models svar är ett separat utvärderingsproblem.
Viktiga slutsatser
- Ange kontraktet, begärandeberoenden och godkända affärsförväntningar.
- Kontrollera om assertioner avvisar fel data, saknade fält och trasiga typer.
- Köp först efter att de granskade testerna körs upprepade gånger i din avsedda CI-miljö.
Produktjämförelsen nedan återspeglar officiell dokumentation kontrollerad den 21 september 2026. Det är inte en direkt jämförelse mellan tre betalkonton.
Det genomarbetade exemplet använder en fastställd Swagger Petstore-specifikation och separerar kontraktsförväntningar, observerat beteende och avsiktligt ändrade svarskopior.
Vår lokala körning godkände 5 live-tester och avvisade alla 3 avsiktligt ändrade svarskopior. En separat probe med saknat name returnerade fortfarande 200, vilket visar varför omfattningen av en grön rapport spelar roll.
Vad AI-verktyg för API-testning faktiskt gör
AI-stöd kommer vanligtvis in i fyra delar av API-testning. En modell läser din specifikation, föreslår scenarier, utformar assertioner och hjälper till att förklara fel. Varje del kräver olika bevis. En rimlig förklaring av ett fel fastställer inte att den föreslagna åtgärden är korrekt.
För specifikationsgranskning, tillhandahåll OpenAPI-filen och de relevanta affärsreglerna. För scenarioplanering, lägg till exempel på giltig data och kända gränser. För körbara skript, inkludera din runner, autentiseringsuppsättning och fixture-konventioner. För diagnos, tillhandahåll den faktiska begäran, svaret och felmeddelandet efter att hemligheter tagits bort.
Håll dessa fyra mekanismer åtskilda när du utvärderar produkter:
- LLM-generering: föreslår tester från språk, scheman och exempel. En granskare måste kontrollera de förväntade utfallen.
- Trafikuppspelning: jämför senare beteende med inspelade interaktioner, ofta med inspelade beroendesvar.
- Egenskaapsbaserad testning: konstruerar systematiskt indata för att utmana egenskaper som schemaöverensstämmelse.
- Testkörning: skickar begäranden, utvärderar assertioner och returnerar rapporter och exitkoder.
En produkt kan kombinera flera mekanismer. Fråga vilken mekanism som producerade varje test och vad som avgör dess förväntade resultat. Att spela in ett felaktigt svar kan bevara samma fel som en regressionsbaslinje. Att generera ett polerat testnamn kan dölja en förväntan som saknar stöd.
Tänk på assertioner i tre djupnivåer. För det första: svarade servern framgångsrikt? För det andra: har bodyn de dokumenterade fälten och typerna? För det tredje: representerar denna body resursen och operationen du begärde?
För en husdjursuppslagning misslyckas ett giltigt objekt med ett heltals-ID fortfarande med den tredje kontrollen om ID:t tillhör ett annat husdjur. Omvänt bevisar ett matchande begärt ID inte att varje fält uppfyller schemat. Använd båda kontrollerna och lägg bara till affärsregler där teamet har en överenskommen källa för dem.
Den praktiska output du vill ha är en underhållbar testtillgång med ett förklarligt oracle: ett tydligt skäl till varför varje resultat bör godkännas eller misslyckas. Räkna användbara scenarier efter granskning, inklusive de du avvisar, i stället för att fira längden på den initialt genererade listan.
AI-verktyg för API-testning jämförda efter arbetsflöde
Börja med den artefakt ditt team kan tillhandahålla i dag. Att migrera en etablerad samling, rekonstruera saknade affärsregler och konfigurera beroendeinspelning är olika projekt. Ett verktyg som passar en utgångspunkt kan skapa extra arbete vid en annan.
| Verktyg eller metod | Användbar indata | AI- eller automatiseringsroll | Körning och CI-väg | Granskningsbar utdata | Huvudfråga för utvärdering |
|---|---|---|---|---|---|
| Postman Agent Mode | Samlingar, begäranden, svar, miljöer, specifikationer | Utformar och redigerar testskript i arbetsytans kontext | Collection Runner och kompatibelt CLI-arbetsflöde | Standard-JavaScript-assertioner i Postman | Bevarar den dina variabler och testar den kontraktet? |
| KushoAI | OpenAPI, Postman-samling, cURL | Genererar scenarier och testsviter; stöder förfinning på naturligt språk | Plattformskörning och dokumenterad CI-integrering; kontrollera behörighet | Granska genererade begäranden, beroenden och förväntade utfall | Kan din valda plan köra och behålla sviten där du behöver den? |
| Keploy | Specifikationer eller begärandedefinitioner; alternativt verklig trafik | AI-generering och en separat record/replay-väg | Genererade flöden eller inspelade tester i lokala/CI-miljöer som stöds | Granska testdefinitioner, baslinjer och beroendemockar | Vilken väg täcker dina faktiska fellägen? |
| Befintlig runner plus en LLM | Godkänd matris, specifikation, fixture-konventioner | Utformar kod för granskning | Din pytest eller annan etablerad runner | Kod som checkats in i ditt repositorium | Är granskning billigare än att skriva samma tester direkt? |
Postman Agent Mode för befintliga samlingar
Postman är en rimlig första utvärdering när din samling redan innehåller användbar begärandeordning, miljövariabler och autentiseringsuppsättning. Agent Mode kan använda den kontexten för att generera standardiserade JavaScript-testskript. Dessa skript kan gå in i det befintliga arbetsflödet för samlingskörning i stället för att kräva ett nytt assertionsspråk.
En fokuserad utvärdering är mer avslöjande än att be den testa allt. Välj den begäran som hämtar en resurs som skapades tidigare i samlingen. Ange dess schema och be om validering av obligatoriska fält, dokumenterade fälttyper och en assertion som kopplar det returnerade ID:t till det lagrade skapande-ID:t.
Granska sedan de föreslagna ändringarna innan du accepterar dem. Ett svarexempel kan innehålla ett husdjur som heter Milo. Likhet med Milo är meningsfullt om din fixture uttryckligen skapade Milo; det är skört om generatorn kopierade ett namn från en delad exempelpost. Samma litteral kan vara en giltig assertion eller ett oavsiktligt beroende, beroende på dess källa.
Kontrollera variabelomfånget noggrant. Ett ID som lagras i en miljövariabel måste vara tillgängligt för den senare begäran och måste tillhöra den körningen. Delade variabler mellan samtidiga körningar kan skapa intermittenta fel som liknar serverdefekter. Be generatorn att förklara setup och cleanup liksom assertionerna.
För det första acceptanstestet, kör samlingen två gånger mot isolerad data och granska sedan den exporterade eller versionshanterade representationen. Bekräfta att en kollega kan granska de ändrade skripten utan att upprepa AI-konversationen. Verifiera också att ditt valda CLI, din reporter och din plan stöder den körningsväg du avser att använda.
Ingen körd Postman-generering presenteras här. Den användbara utvärderingsfrågan är om dess arbetsytskontext minskar ditt granskningsarbete på en befintlig samling. Det kräver din egen samling och en utvärdering på kontonivå, inte en slutsats från en produktskärmbild.
KushoAI för specifikationsbaserad testgenerering
KushoAI accepterar Swagger/OpenAPI-, Postman- och cURL-indata och dokumenterar testgenerering, förfinning på naturligt språk och CI-körning. Det gör det till en kandidat när ett team har användbara API-definitioner men en backlog av oskrivna tester. Dessa är leverantörsbeskrivna funktioner, inte uppmätta resultat för defektupptäckt. (KushoAI-dokumentation, september 2026)
Välj det indata med rikast tillförlitlig kontext. En cURL-begäran kan beskriva en giltig begäran, men den säger vanligtvis lite om valfria fält, tillåtna enum-värden eller dokumenterade fel. En OpenAPI-fil lägger till struktur; en godkänd scenariomatris lägger till den avsikt som strukturen kan lämna tvetydig.
För en Petstore-utvärdering, be om separata fall för ett giltigt husdjur, ett saknat obligatoriskt name, ett ID med fel typ och ett ogiltigt statusfilter. Granska om verktyget skiljer krav på request-body från krav på response-schema. Dessa kan se liknande ut i ett exempel men ställer olika krav.
Undersök sedan ett sammankopplat create-read-update-flöde. Läsningen måste använda ID:t som är kopplat till den aktuella setupen. Uppdateringen måste rikta in sig på samma resurs, och en senare läsning måste verifiera det ändrade fältet. Fyra oberoende begäranden med tilltalande testnamn fastställer inte att beroendekedjan fungerar.
Behandla den första genereringen som ett förslag. Behåll dokumenterade förväntningar, revidera skript med felaktigt dataflöde och flagga underspecificerade utfall för ett kravbeslut. Om verktyget föreslår flera likvärdiga fall med saknade fält, behåll de användbara skillnaderna i stället för att betala för att underhålla dubbletter.
Fråga innan du köper om att köra sviten från din avsedda pipeline och granska felartefakten. Bekräfta aktuella CI-behörigheter, hantering av autentiseringsuppgifter och tillgängliga exportformat i den valda planen. Anta inte att en kostnadsfri interaktiv utvärdering ger samma automationsrättigheter som en teamdistribution.
Keploy för genererade tester och trafikuppspelning
Keploys dokumentation presenterar två tydliga startvägar. AI-generering accepterar resurser som OpenAPI, Postman, cURL eller endpoints och bygger sammankopplade API-flöden. Record and replay fångar API-interaktioner och deras beroenden för senare körning med mockar. Beskrivningen av AI-flödet och beskrivningen av beroendeinspelning bör inte behandlas som identiska mekanismer. (Keploy-dokumentation, september 2026)
Om din svårighet är att reproducera vad en applikation gjorde med en databas eller uppströmstjänst, utvärdera inspelningsvägen. Fånga en liten create-read-update-resa i en isolerad miljö, granska de fångade beroendena och spela upp efter en kontrollerad applikationsändring. Kontrollera vad runtime stöder innan du planerar en större utrullning.
Om din svårighet är att härleda fall från en specifikation, utvärdera genereringsvägen separat. Fråga hur dess föreslagna begäranden får autentiseringsuppgifter, bär ID:n mellan steg och rensar upp data. Förekomsten av inspelningsfunktioner någon annanstans i produkten besvarar inte dessa frågor för en genererad svit.
Dynamiska värden kräver bedömning. En tidsstämpel kan variera legitimt; ett resurs-ID kan koppla samman två begäranden och behöver därför jämföras. Att brett ignorera varje föränderligt fält kan dölja fel. Granska undantag fält för fält och behåll jämförelser som uttrycker meningsfulla relationer.
Granska också baslinjen innan du accepterar den. En inspelning som innehåller fel summa, ett oavsiktligt reservsvar eller inaktuell data kan spelas upp konsekvent. Konsekvens hjälper till att upptäcka förändring, men teamet avgör fortfarande om det fångade beteendet var korrekt.
Ett användbart komplement: Schemathesis erbjuder schemadriven egenskapsbaserad API-testning. Det kan utmana ett API med genererade indata vid sidan av granskade exempel. Behandla det som en annan testmekanism, inte som en synonym för en LLM-testgenerator. Dess fynd behöver fortfarande tolkas mot kontraktet och implementeringen.
Kostnadsfria AI-verktyg för API-testning: gränser och kostnader
”Gratis” kan beskriva en klient, en begränsad AI-kvot, en runner med öppen källkod eller en tillfällig utvärderingsperiod. Dessa erbjudanden täcker olika delar av arbetsflödet. En gratis klient fastställer inte att automatiserad generering, schemalagd körning eller rapportexport också är gratis.
Per den 21 september 2026 listar Postmans Free-plan 50 AI-krediter per månad. Krediter är dess faktureringsenhet; de betyder inte 50 tester eller 50 kompletta sviter. Dess jämförelsetabell skiljer AI-kvot från körning, datadrivna funktioner och resultatexport. (Postman-priser, september 2026)
KushoAIs nuvarande prispresentation använder Developer Edition och Enterprise. Keploy skiljer mellan Playground, Pro och Enterprise, vid sidan av sitt erbjudande med öppen källkod. Använd den aktuella köpskärmen för att bekräfta de relevanta gränserna. Äldre verktygssammanställningar kan beskriva pensionerade plannamn eller kombinera kvoter som faktureras separat.
| Kostnadskomponent | Vad som ska registreras i en utvärdering | Vad som kan göra räkningen missvisande |
|---|---|---|
| Platser och plan | Redaktörer, granskare, faktureringsintervall, nödvändiga funktioner | Jämföra årliga rubrikpriser med månatliga åtaganden |
| AI-generering | Kreditanvändning för samma godkända uppgift, inklusive omförsök | Anta att en kredit motsvarar ett test |
| Körning | Lokala körningar, hostade körningar, CI-jobb, scheman, rapporter | Behandla interaktiva körningar som tillstånd för varje automationsväg |
| Oberoende modell | Input- och output-tokens för utformning och granskning | Ignorera upprepade inlämningar av hela specifikationen |
| Ingenjörstid | Granskning, fixture-reparation, feltriage, underhåll | Räkna initial genereringstid som total leveranstid |
Använd en liten acceptansuppgift för att uppskatta kostnaden. Ge varje kandidat samma operationer och förväntningar och registrera sedan hur många scenarier som överlever granskning. Håll genereringstid, praktisk granskningstid och körningstid i separata kolumner. Att vänta på en modell och att korrigera en farlig assertion innebär olika kostnader för teamet.
En användbar nämnare är granskade, körbara scenarier som ditt team skulle behålla. Det förhindrar att en generator med många redundanta fall framstår som billigare bara för att dess utdata är längre. Registrera fall som saknade stöd och som du tog bort, samt krav som fortfarande är olösta.
Den här artikeln gör inte anspråk på en uppmätt tidsbesparingsprocent eller jämför genomströmning för betalplaner. Dessa siffror kräver en kontrollerad utvärdering med likvärdiga indata. För ett köpbeslut, inkludera en realistisk underhållsändring, till exempel att lägga till ett obligatoriskt fält, så att uppskattningen täcker nästa sprint liksom den första demon.
AI-verktyg för API-testning: OpenAPI till en första körning
Använd en isolerad lokal instans av det riktiga Swagger Petstore-projektet. Lås commit d57941e8fe959e508796b27469b1e8bba73392dc; dess specifikation deklarerar OpenAPI 3.0.4 och applikationsversion 1.0.29-SNAPSHOT. Läs den låsta filen i stället för en oberoende uppdaterad offentlig demo. (Swagger Petstore-specifikation, september 2026)
1. Förbered tjänsten och registrera miljön. Hämta repositoriet via den källsidan, checka ut den låsta revisionen och installera ett kompatibelt JDK och Maven. Projektets README anger detta startkommando från repositoriets katalog:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty använder port 8080. Ställ in BASE_URL till din loopback-HTTP-origin på den porten med /api/v3 tillagt. Bekräfta att /openapi.json är läsbar relativt den basen före testning.
Den här körningen använde Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 och jsonschema 4.26.0. Registrera dina versioner också. Källbygget laddar ned beroenden och Swagger UI, så en låst applikationscommit är inte ensam ett fullt hermetskt bygge.
2. Importera den låsta specifikationen. Välj /pet, /pet/{petId} och /pet/findByStatus. Behåll delete tillgängligt för cleanup. Åsidosätt specifikationens offentliga serverplats med din lokala bas. Kontrollera denna inställning innan du skickar någon skrivbegäran.
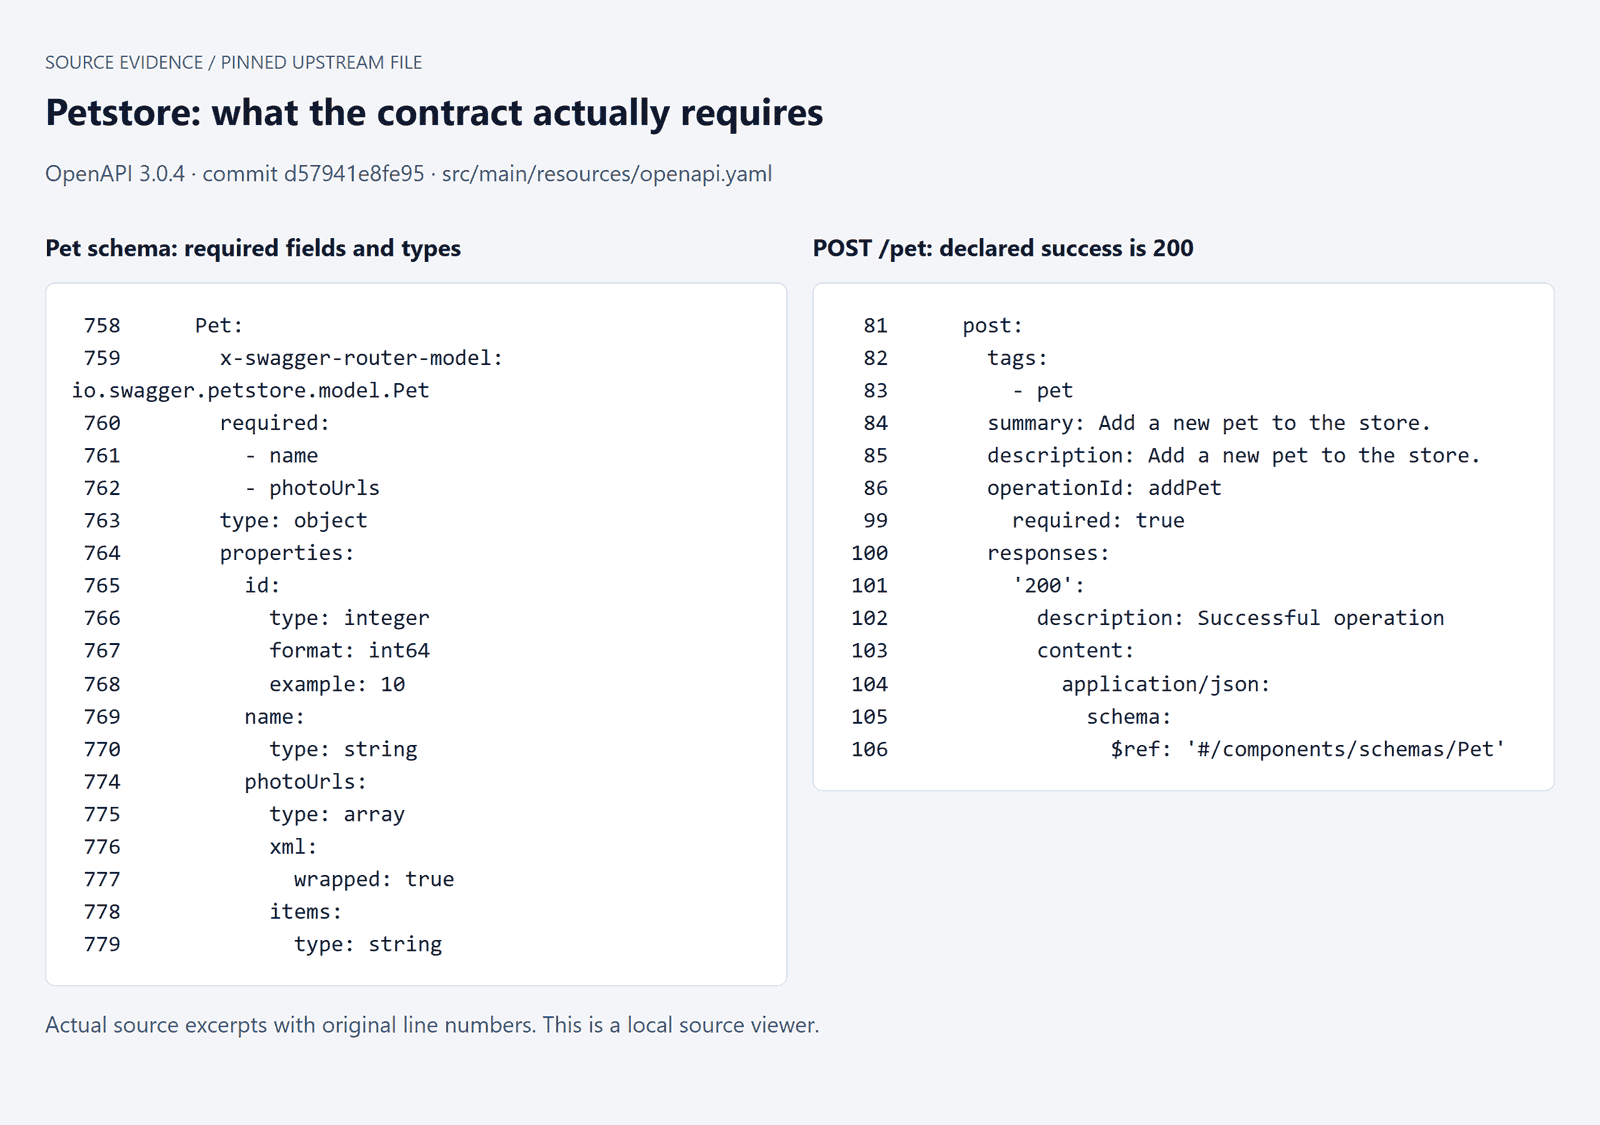 Fastställd OpenAPI Petstore-källa som visar obligatoriska fält och valda operationdefinitioner
Verkliga källutdrag renderade lokalt: Pet kräver name och photoUrls; POST /pet deklarerar 200 för framgång. Ursprungliga radnummer bevaras.
3. Generera en matris före körbar kod (Prompt A). Bifoga specifikationen och klistra in denna prompt i din valda generator:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Granska oraclet för varje scenario. Petstore dokumenterar en lyckad create som 200. Dess Pet-schema kräver name och photoUrls; id har en heltalstyp men finns inte i den obligatoriska listan. Validering av saknade fält och identitet mellan begäran och svar behöver därför olika kontroller.
| Operation | Indata eller sekvens | Bevis för förväntat utfall | Assertion att granska | Körningsstatus |
|---|---|---|---|---|
| addPet, getPetById | Skapa, läs sedan aktuellt ID | Dokumenterad 200 och Pet-schema; explicit flödesförväntan | Validera body och jämför returnerat ID | Godkänd lokalt |
| updatePet, getPetById | Ändra name och läs igen | Uppdateringsoperation plus godkänd fixture-avsikt | Samma ID, nytt name, giltigt schema | Godkänd lokalt |
| findPetsByStatus | Fråga efter available efter setup | Dokumenterad enum och lyckat array-svar | Alla returnerade statusar matchar; skapat ID finns | Godkänd lokalt |
| getPetById | Icke-heltals-ID i path | Dokumenterad 400 för ogiltigt ID | Exakt status för detta dokumenterade fall | Godkänd: 400 |
| findPetsByStatus | Odokumenterat enum-värde | Dokumenterad 400 för ogiltig status | Exakt status, behåll eventuell avvikelse | Godkänd: 400 |
| addPet | Utelämna obligatoriskt name | Obligatoriskt schemafält; 400- och 422-beskrivningar täcker inte varje variation | Registrera beteende; lös exakt mappning före gating | Returnerade 200 utan name; avvikelse behållen |
5. Generera och granska körningsfilen (Prompt B). Bifoga den godkända matrisen och specifikationen med denna prompt:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Kör, bevara och rensa upp. Använd ett körningsspecifikt husdjurs-ID, fånga skapandesvaret och skicka dess ID vidare till senare begäranden. Validera uppdateringen genom en ny läsning. Ett lyckat uppdateringssvar ensamt bevisar inte att servern bevarade ändringen.
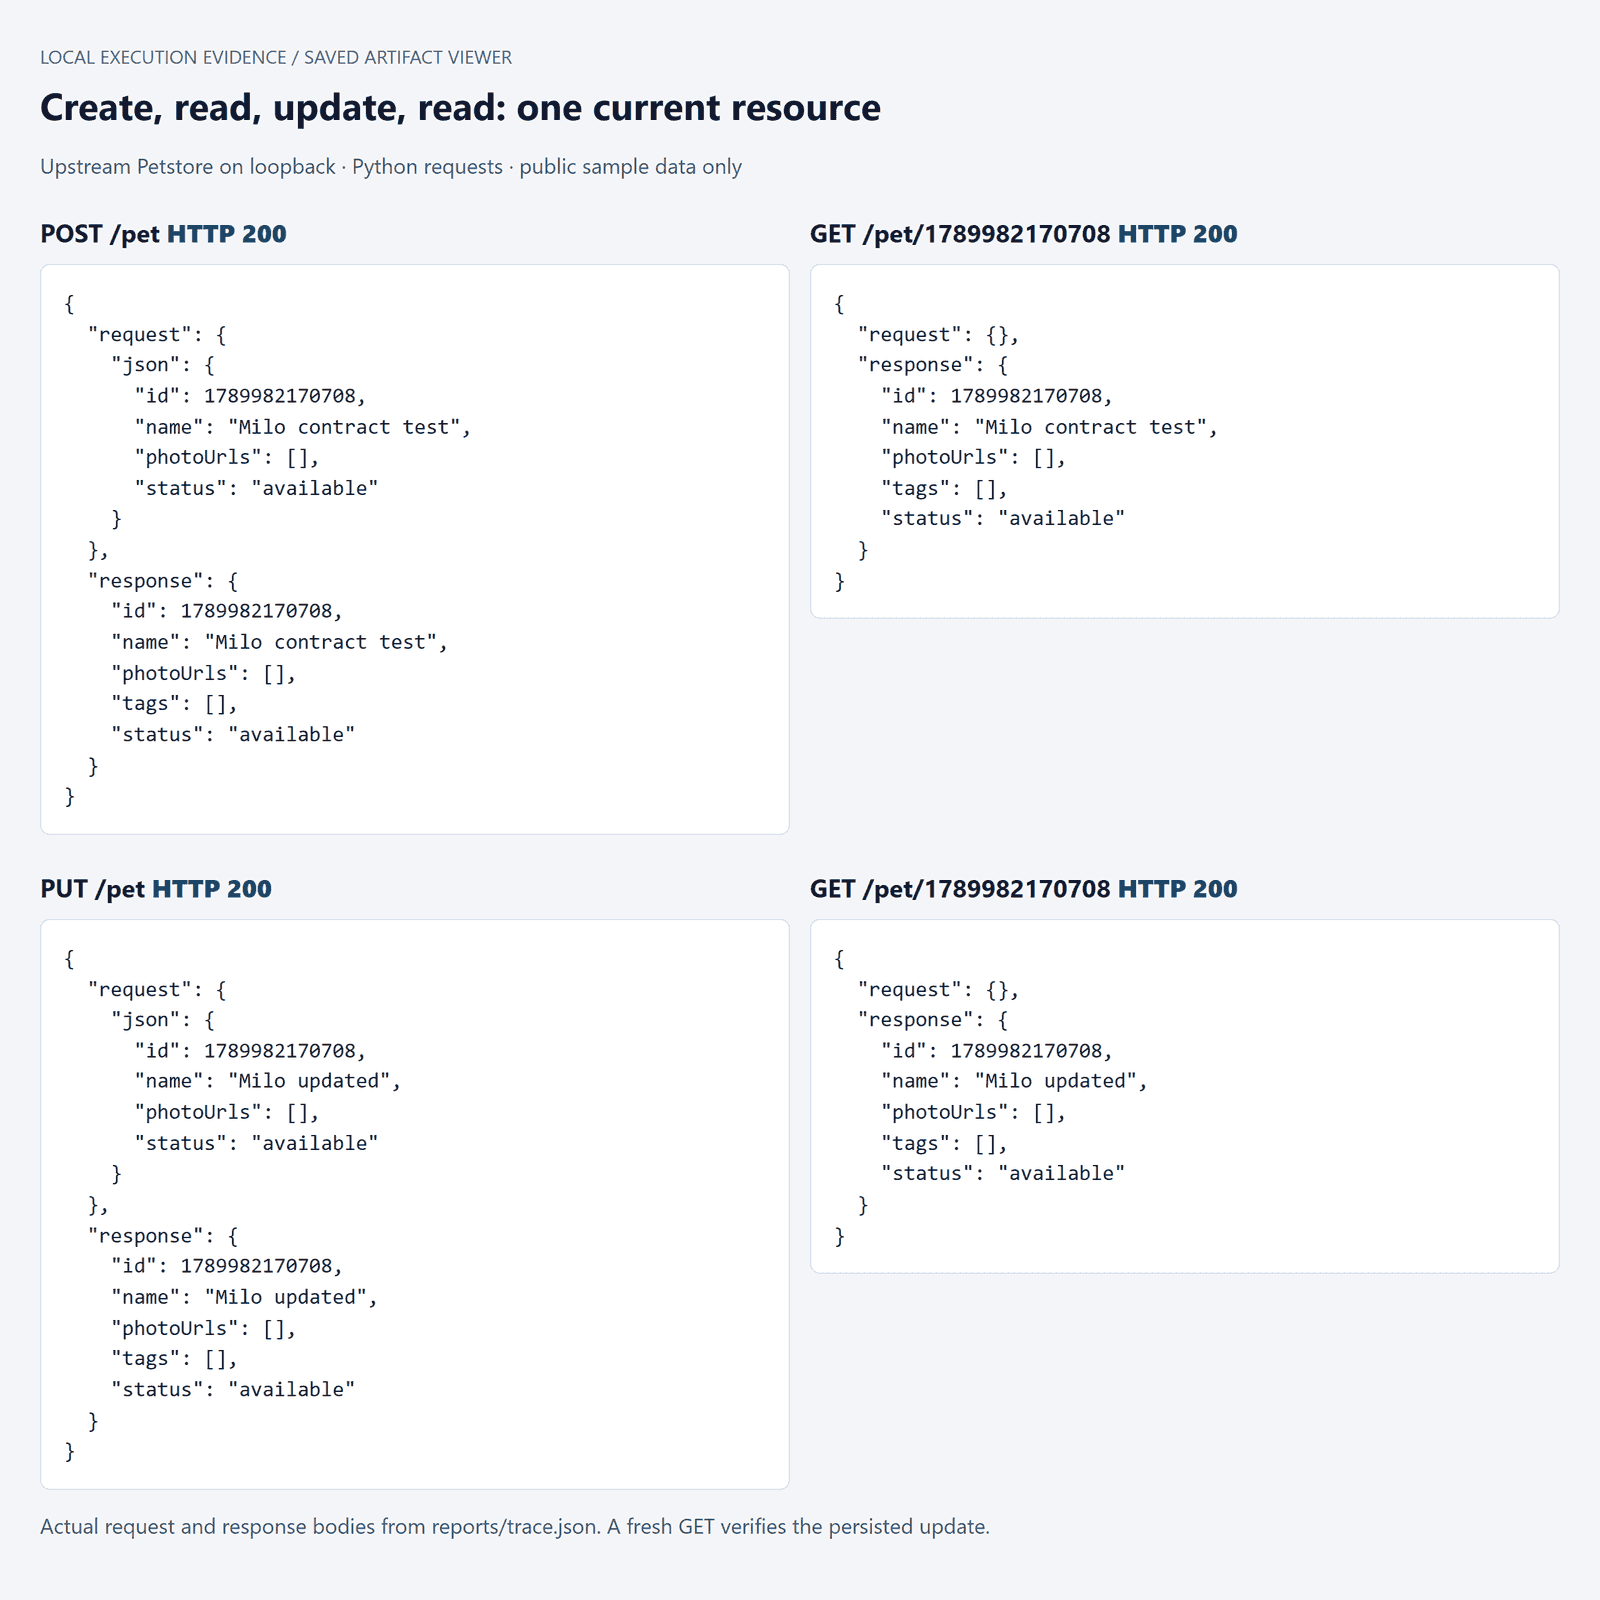 Lokalt Petstore-bevis för begärandekedja som visar skapande, uppslagning, uppdatering och ID-överföring
Sparade lokala begäranden och svar: samma körningsspecifika ID överlever create, read, update och en ny read. Alla 4 visade begäranden returnerade 200.
Spara request-bodies, svar, assertion-fel och cleanup-resultatet. Begränsa borttagning till ID:n som skapades av denna körning. Behåll oväntade svar som fynd, inklusive fall där demonstrationsimplementationen accepterar ogiltig indata. Justera inte assertioner bara för att få en grön skärmbild.
Vad denna körning hittade: de 5 live-testfunktionerna godkändes, inklusive kontroller för ogiltigt ID och ogiltig status som returnerade 400. Den separata proben med saknat name returnerade 200 och en body utan name. Vi behöll den schemaavvikelsen utanför den gröna sviten; dess exakta avsedda felmappning behöver fortfarande klargöras. Båda skapade posterna raderades framgångsrikt.
De lokala testerna utformades i denna artikelkörning, oberoende av de tre kommersiella verktygen. Alla 5 live-tester behölls; inga togs bort eller fick sina förväntningar mildrade efter körning. Mänsklig granskningstid mättes inte. Evidensmappen innehåller testfilerna, beroendelåset, råa svar och reproduktionsinstruktioner.
Så validerar du AI-verktyg för API-testning
En användbar assertion bör avvisa ett relevant felaktigt svar. Du kan testa den egenskapen utan att ändra den körande tjänsten: spara ett verkligt lyckat svar, kopiera det och ändra avsiktligt ett fält i taget. Dessa är kontrollerade svarsmutationer, inte produktionssårbarheter eller en fullständig benchmark för mutationstestning.
Håll originalstatus och body tillsammans. Kör först validatorn mot det omodifierade svaret och verifiera att den accepterar baslinjen. Skapa sedan tre oberoende kopior. Ändra ID:t, ändra namnets typ och ta bort det obligatoriska namnet. Varje kopia bör misslyckas av ett skäl som matchar ändringen.
| Sparad baslinje | Kontrollerad modifiering | Relevant kontroll | Faktiskt resultat |
|---|---|---|---|
| Lyckad uppslagning av aktuellt husdjur | Ersätt med ett annat heltals-ID; behåll status 200 | Returnerat ID är lika med denna körnings förväntade ID | Misslyckades: förväntat och faktiskt ID skiljer sig |
Sträng name | Ersätt name med ett nummer | Pet-schemats strängtyp | Misslyckades: 42 är inte en sträng |
Obligatoriskt name finns | Ta bort name | Pet-schemats obligatoriska lista | Misslyckades: name är obligatoriskt |
ID-exemplet blottar en vanlig svaghet. En schemavalidator kan acceptera fel heltal eftersom formen förblir giltig. Relationsassertionen tillhandahåller den saknade begränsningen. I de andra två exemplen ger schemavalidering begränsningar som en status-only-kontroll inte kan se.
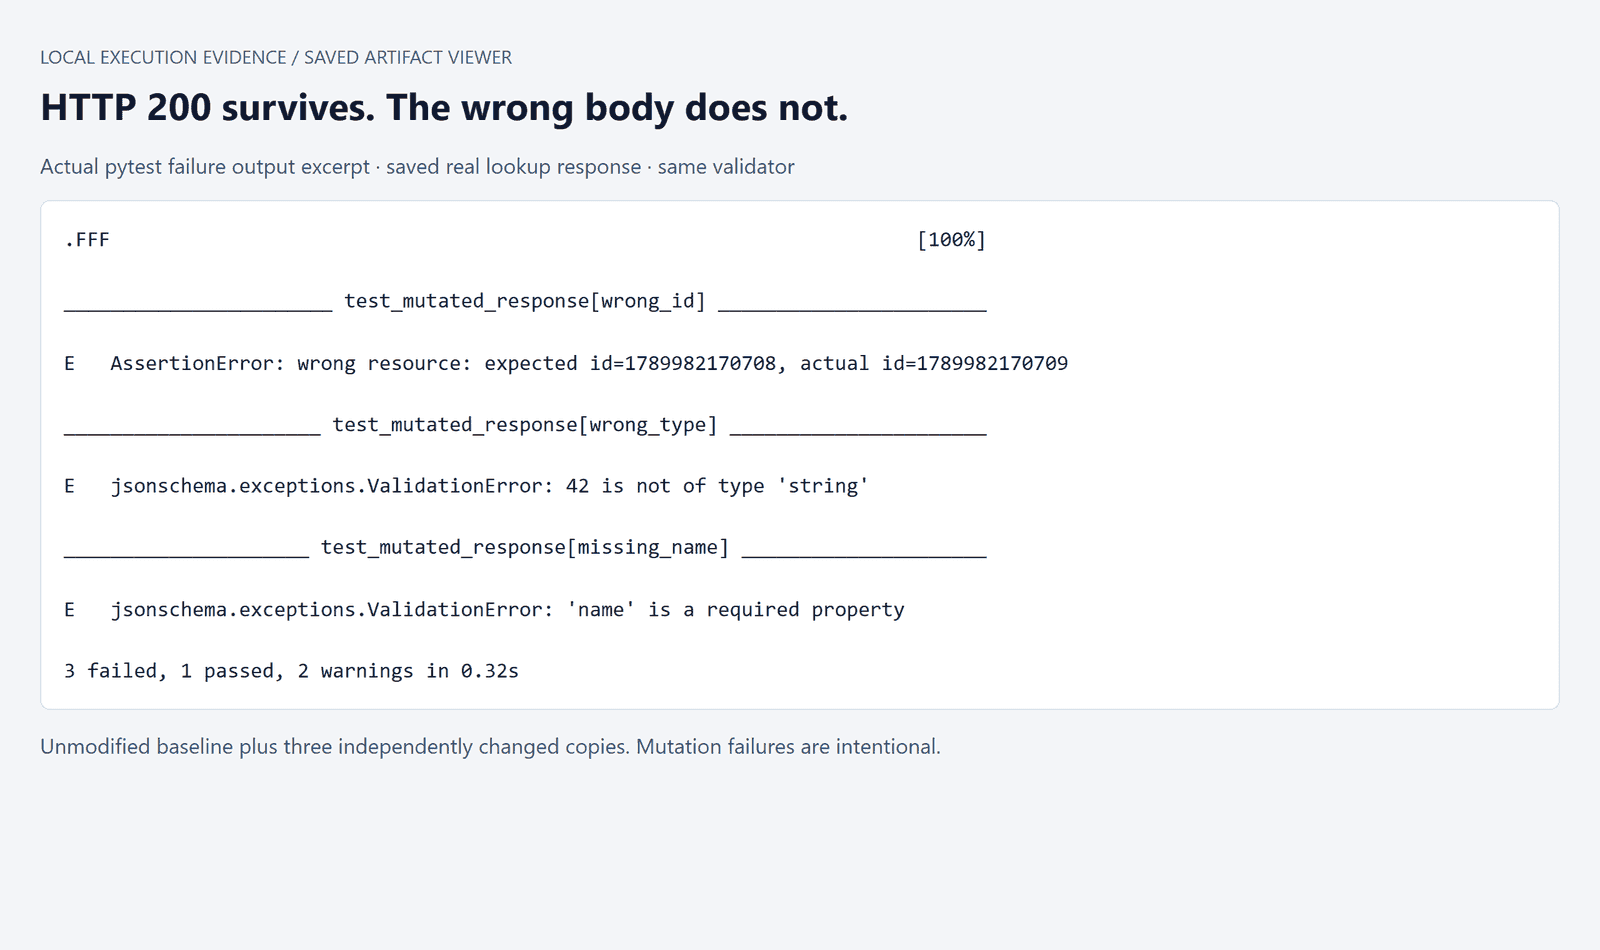 Faktisk utdata för assertion-fel vid kontrollerade Petstore-svarsmutationer
Faktiska pytest-felutdrag: det ursprungliga svaret godkändes och alla 3 oberoende mutationer misslyckades. Dessa fel framkallades avsiktligt i sparade kopior.
I denna körning godkändes den oförändrade baslinjen och 3 av 3 ändrade kopior misslyckades. Mutationskörningen returnerade exitkod 1, vilket bevarade felsignalen. Validatorn tillämpar Pet-schemats relevanta strukturella begränsningar och en separat ID-relationskontroll; denna lilla demonstration är inte en fullständig validator för OpenAPI-överensstämmelse.
För en repeterbar revision, bifoga testfilen och den låsta specifikationen till Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Granska föreslagna ”självläkande” ändringar med särskild omsorg. Att ersätta en förväntad 400 med 200 kan dölja en regression. En legitim kontraktsändring behöver en kravreferens och en granskad teständring. Det observerade svaret är bevis för utredning, inte automatiskt tillstånd att omdefiniera korrekthet.
Separera felkategorier innan du ber AI om en åtgärd. En timeout kan indikera en otillgänglig miljö. Ett uppslagsfel kan komma från en trasig fixture. Ett importfel tillhör testkoden. En reproducerbar avvikelse från det överenskomna kontraktet kan tillhöra produkten. Bevara tillräckligt med kontext för att skilja dem åt.
Rapportera nämnaren ärligt. Att upptäcka tre valda svarsändringar bevisar känslighet för dessa tre ändringar. Det fastställer inte endpoint-täckning, kodtäckning, säkerhetstäckning eller en allmän defektupptäcktsfrekvens. På samma sätt säger ett stort antal tester lite om dubblerade scenarier eller styrkan i deras assertioner.
Autentisering och auktorisering förtjänar oberoende tester i en lämplig applikation: saknade autentiseringsuppgifter, utgångna autentiseringsuppgifter och åtkomst till en annan användares resurser. Petstores demonstrationsbeteende kan inte fastställa att dina produktionsåtkomstkontroller fungerar.
AI-verktyg för API-testning i CI/CD
När en granskare har accepterat sviten, checka in exakt den versionen. Ett bygge bör köra kända förväntningar mot kandidatapplikationen. Att regenerera tester under varje bygge introducerar ännu en föränderlig komponent och gör fel svårare att reproducera.
Lås runner, beroenden, fixtures och specifikation. Lagra ett beroendelås tillsammans med testerna och bevara applikationsrevisionen i rapporten. Hämta hemligheter från CI-miljön, håll dem borta från genererade filer och kontrollera att felloggar inte exponerar dem.
Med pytest är den grundläggande rapportformen enkel:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Tillhandahåll BASE_URL via jobbets miljö. Starta den lokala tjänsten i jobbets livscykel, vänta på readiness och kör sedan sviten. Samla alltid in rapporten och serviceloggen, även vid fel. Avsluta genom att stoppa jobbets egen tjänst och rensa dess data; undvik processomfattande cleanup-kommandon på delade agenter.
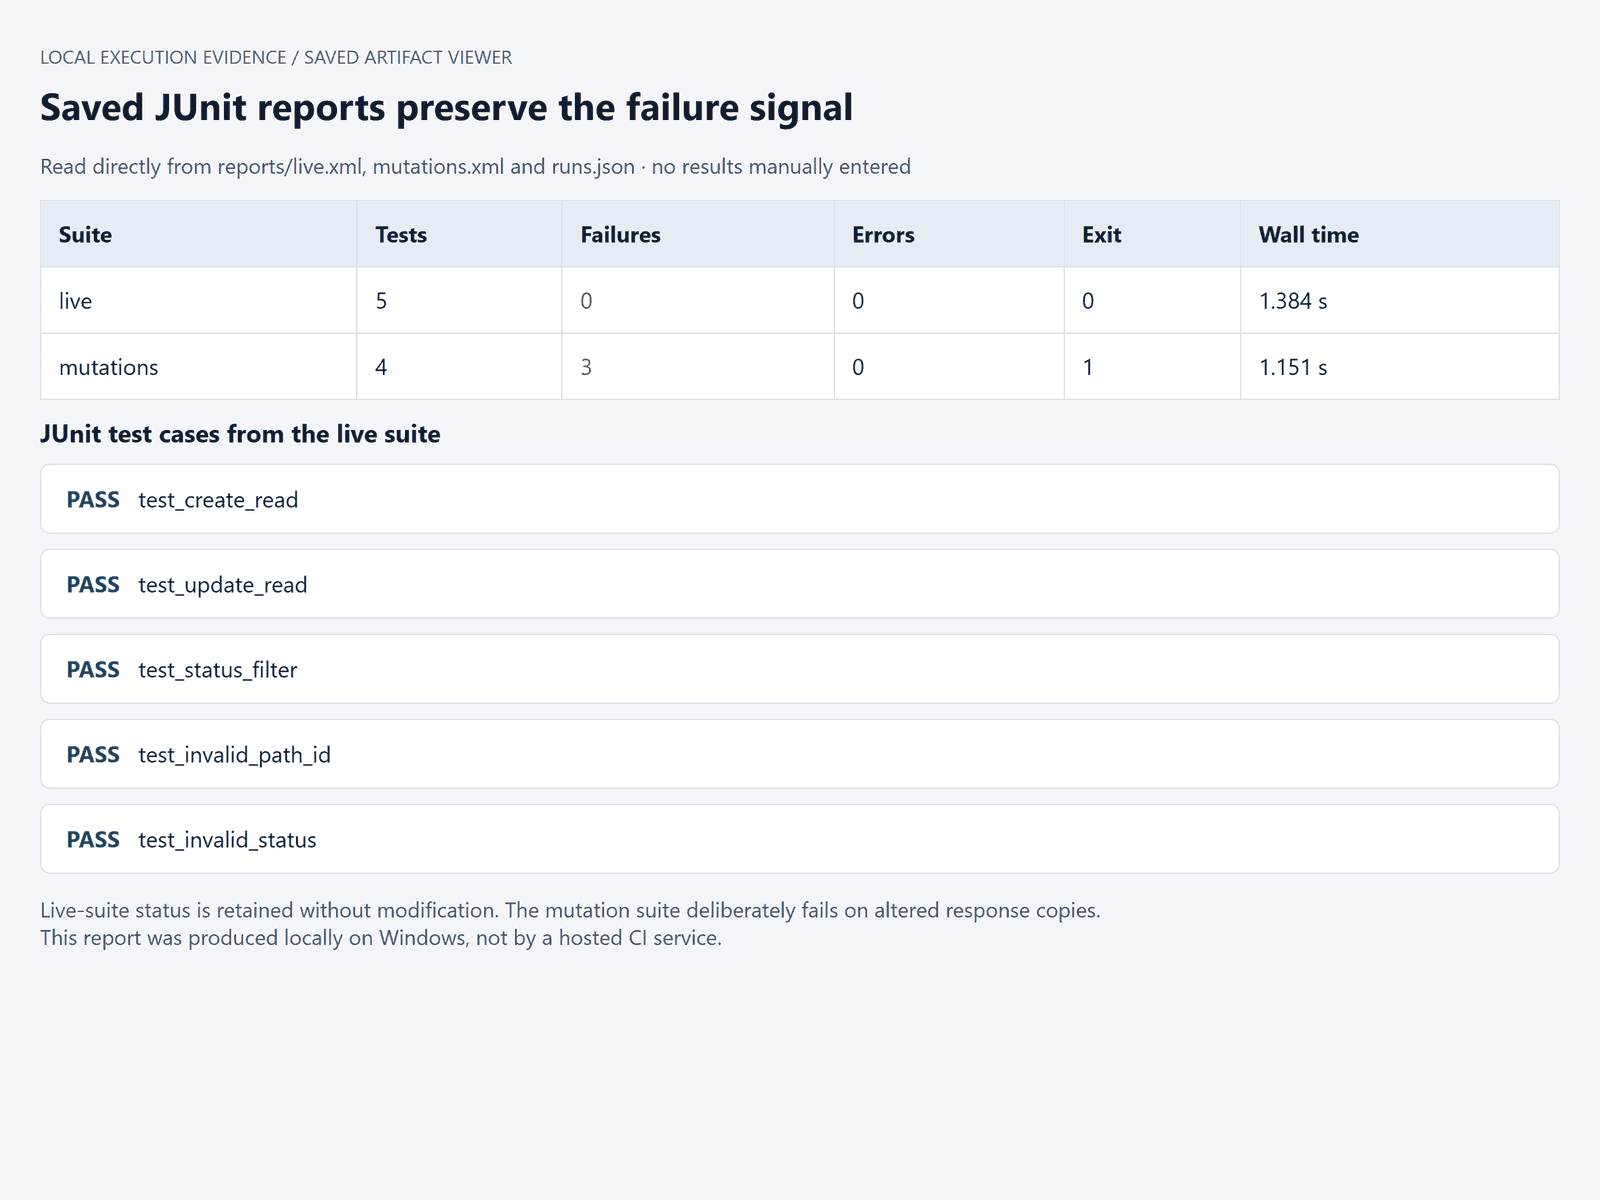 Lokal pytest JUnit-rapport med separata live-kontrakt- och assertion-kontrollresultatsAktuell lokal
JUnit-resultat: 5 live-tester godkändes; den kontrollerade kopian-sviten innehåller 1 godkänd baslinje och 3 avsiktliga fel. Ingen hostad CI-körning görs anspråk på.
De uppmätta wall times, inklusive Python-processuppstart, var 1,384 sekunder för live-sviten och 1,151 sekunder för den kontrollerade kopian-sviten. Dessa utesluter servicebygge/uppstart, beroendeinstallation, utformning och granskning. JUnit-filer och de oavkortade loggarna sparas separat.
Testa felvägen innan du förlitar dig på gaten. En misslyckad assertion måste producera en misslyckad jobb-exitkod. Omförsök bör vara begränsade och motiverade för kända transienter i infrastrukturen; upprepade omförsök som till slut döljer ett produktfel gör gaten mindre informativ.
Hantera cleanup-fel explicit. Håll det primära assertion-felet synligt, registrera vilken resurs som återstår och låt teardown rapportera sitt eget problem. Parallella jobb behöver separata identifierare eller namnrymder. Ett test som godkänns ensamt men läser ett annat jobbs data är inte redo för obevakad användning.
Om du redan har pytest kan du välja utformningsmodellen separat. Atlas Cloud passar denna smalare roll: ett modellager för ett anpassat arbetsflöde vars körning och rapportering redan finns. Det presenteras här inte som en fullständig API-testplattform eller en inbyggd backend för de tre produkterna ovan.
För den utvärderingen, öppna DeepSeek V4.1 Flash, modell-ID deepseek-ai/deepseek-v4.1-flash, och tillhandahåll samma offentliga specifikation och granskade matris som användes lokalt. Använd Prompt B och spara sedan det returnerade utkastet separat från det granskade testet. Jämför dess antaganden med kontraktet innan du kör något.
Om det exponeras av gränssnittet är en temperatur på 0,2 en startinställning för utformning, inte en garanti för determinism. Kontrollera den tillgängliga utdatagränsen mot storleken på din svit. Se aktuell modellkatalog för tokenpriser i stället för att budgetera från en gammal artikel.
Arbetsfördelningen förblir explicit: modellen föreslår kod, en granskare godkänner förväntningar och runnern producerar resultat. Åtkomstgrinden till testmiljön hindrade en slutförd Atlas-körning för denna artikel, så detta är ett utvärderingsrecept snarare än ett uppmätt modellresultat. Du kan utvärdera denna väg utan att migrera en fungerande testrunner eller lämna över dess körningsansvar till en chattmodell.
Att välja AI-verktyg för API-testning för ditt team
Välj den minsta utvärdering som kan ändra ditt beslut. Använd ett sammankopplat arbetsflöde, ett dokumenterat negativt fall och några kontrollerade felaktiga svar. Håll indata likvärdiga mellan kandidater. En polerad onboarding-upplevelse bör inte väga tyngre än ett test som inte kan identifiera fel resurs.
För ett moget samlingsarbetsflöde, börja med att utvärdera AI-funktionerna i den arbetsytan. Befintlig miljökonfiguration och begärandeberoenden är värdefull kontext. Mät om de genererade ändringarna sparar granskningsarbete utan att införa sköra antaganden.
För ett team med en stabil specifikation och en skrivbacklog, utvärdera specifikationsbaserad generering. Var uppmärksam på vad som händer när specifikationen är ofullständig. En generator som tydligt flaggar saknade förväntningar är lättare att granska än en som självsäkert hittar på dem.
För en applikation vars fel beror på uppströmsbeteende, utvärdera inspelning och uppspelning. Granska fångade baslinjer och beroendestöd innan du investerar i stora inspelningar. Bestäm vilka dynamiska fält som får variera och vilka relationer som måste förbli intakta.
För ett team med en stabil runner, utvärdera en oberoende modell för utformning och granskning. Du behåller det körningsformat du redan känner till, men du äger också integrationen, fixture-designen och underhållet. Inkludera det ägandet i kostnadsberäkningen.
Innan du betalar för AI-verktyg för API-testning, kräv fem konkreta demonstrationer:
- Den granskade sviten körs mot din avsedda miljö.
- Relevanta kontrollerade fel får lämpliga assertioner att misslyckas.
- Tester och användbara rapporter kan bevaras i ett acceptabelt format.
- Upprepade körningar, inklusive CI-körning, bevarar isolering och felsignaler.
- Kostnader för generering, körning och underhåll passar teamets budget.
Utse någon att underhålla den accepterade sviten. En specifikationsändring bör utlösa en granskning av berörda assertioner, fixtures och konsumenter. Behåll de gamla felfynden tills ändringen är förstådd. Det gör nästa release lättare att bedöma och ger teamet en anledning att lita på en grön rapport.
Vanliga frågor
Vilket AI-verktyg bör jag använda för API-testning?
Börja med dina befintliga indata. Utvärdera Postman Agent Mode för etablerade samlingar, KushoAI för specifikationsledd generering och Keploy för dess distinkta vägar för genererade flöden och inspelning. Om ditt team redan underhåller pytest eller en annan runner kan en separat utformningsmodell passa. Använd samma lilla arbetsflöde för att utvärdera varje kandidats assertioner, körning och granskningsinsats.
Finns det kostnadsfria AI-verktyg för API-testning?
Det finns gratisklienter, testverktyg med öppen källkod och begränsade AI-kvoter. De täcker olika behov. Postmans Free-plan listar 50 månatliga AI-krediter per den 21 september 2026; det är inte ett testantal. Kontrollera om dina nödvändiga funktioner för export, automatisering, rapportering och samarbete ingår innan du behandlar en interaktiv utvärdering som en gratis CI-lösning.
Kan AI generera API-tester från en OpenAPI-specifikation?
Ja, en generator kan använda operationer, scheman, parametrar och svarsdefinitioner för att föreslå tester. Specifikationen kan fortfarande utelämna affärsregler eller lämna felmappningar tvetydiga. Tillhandahåll godkända förväntningar och granska resultatet. I det låsta Petstore-exemplet dokumenteras en lyckad create som 200, vilket illustrerar varför bekanta REST-konventioner inte kan ersätta det faktiska kontraktet.
Hur vet jag om AI-genererade assertioner är användbara?
Kontrollera tre saker: dokumenterade schemabegränsningar, relationer mellan begäranden och svar samt känslighet för avsiktligt felaktig data. Spara ett verkligt svar, ändra en relevant egenskap och kör samma validator igen. Behåll felmeddelandet. Detta ger smala, reproducerbara bevis om dessa assertioner medan bredare täckning och säkerhetsfrågor lämnas öppna för separat testning.
Kan jag köra AI-genererade API-tester i CI/CD?
Ja, när det genererade formatet, runnern, miljön och planen stöder den vägen. Checka in granskade tester, installera låsta beroenden, använd isolerade fixtures och exportera en strukturerad rapport som JUnit. Verifiera att fel returnerar en icke-noll exitkod. En lyckad lokal körning förbereder sviten för CI; den bevisar inte att en hostad pipeline har körts.
Kan AI ersätta manuell API-testning?
AI kan minska repetitiv utformning och hjälpa granskare att hitta svaga assertioner. Människor avgör fortfarande avsett beteende, utreder tvetydiga fel och utforskar risker utanför de angivna exemplen. Använd AI-verktyg för API-testning för att producera granskningsbara testtillgångar och bedöm dem sedan utifrån reproducerbara bevis. En mindre svit som fångar meningsfulla misstag är lättare att lita på än en oförklarad samling gröna kontroller.


