DeepSeek Harness ingick inte i det riktmärket. Det släpptes två dagar senare. Det innebär att den användbara frågan inte är "vilken vann?" Den användbara frågan är hur man kör samma uppgift genom båda verktygen, på samma modell, och läser räkningen utan att lura sig själv.
Viktiga insikter
- Valet av harness kan ändra tokenanvändningen med ungefär 7x i jämförbara agentuppgifter.
- Mät DeepSeek Harness och OpenCode med samma modell och samma repo-status.
- Använd separata API-nycklar innan du väljer en för dagligt arbete.
Två laptops som kör samma kodningsuppgift genom två agent-harnessar
Den rättvisa uppställningen: en modell, en uppgift, två terminaler.
Vad det offentliga riktmärket berättar
Composio körde 30 komplexa multi-app-workflows genom 8 agent-harnessar, alla med DeepSeek V4 Flash, en gräns på 900 sekunder per uppgift och binär programmatisk betygssättning över 240 körningar (Composio, augusti 2026). Samma modell, olika harness.
| Harness | Godkännandegrad | Median tid | Genomsnittliga tokens per uppgift |
|---|---|---|---|
| Pi Agent | 66,7% | 132,2s | 559 000 |
| Prime Agent | 62,5% | 242,1s | 1 400 000 |
| OMP | 56,7% | 272,4s | 742 000 |
| Claude Code | 53,3% | 122,7s | 742 000 |
| Codex | 53,3% | 245,0s | 678 000 |
| DeepAgents | 53,3% | 187,1s | 665 000 |
| Hermes Agent | 50,0% | 175,5s | 192 000 |
| OpenCode | 46,7% | 129,7s | 692 000 |
Token-kolumnen är viktigare än rankingen. Spridningen går från 192 000 till 1 400 000 genomsnittliga tokens per uppgift. Det är samma modell som gör jämförbart arbete genom olika körningar.
OpenCode ger oss en källbaserad baslinje: 692 000 tokens per uppgift, 46,7% godkännandegrad och 129,7 sekunders median tid. DeepSeek Harness har ingen offentlig direkt jämförelse från detta riktmärke eftersom DeepSeek släppte det den 13 augusti 2026, två dagar efter att riktmärket publicerades.
Använd tabellen som en varning, inte en dom. Den visar att harnesset kan dominera kostnaden. Den bevisar inte om DeepSeek Harness slår OpenCode på ditt repo.
Vad som förändras när du byter harness
Innan testning, jämför de två verktygen baserat på delarna som påverkar en arbetande utvecklare: installationsyta, mognad, tokensynlighet och hur mycket av agentloopen du kan ersätta.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Från | DeepSeek AI | Anomaly (ursprungligen SST) |
| Släppt | 13 augusti 2026 | Slutet av 2025 |
| GitHub-stjärnor | ~143k | ~198k |
| Licens | MIT | MIT |
| Språk | TypeScript | Go |
| Gränssnitt | Webbgränssnitt på 127.0.0.1:3080 | Terminal-TUI |
| Status | Utvecklare förhandsversion, brytande ändringar förväntas | Mogen, brett utplacerad |
| Arkitektur | Utbytbara plugins för modeller, verktyg, sessioner, sandlådor, lagring, loopar och UI | Fast kärna med bygg-/planeringsagenter, MCP-stöd och LSP-tillägg |
| Konfiguration | $DSH_HOME/settings.yaml | opencode.json |
| Tokenredovisning | Tokenmätare med kontexttryck och nedbrytningsprognoser | Per-session token- och kostnadsspårning i TUI |
| Bäst för | Team som vill modifiera agentloopen själva | Team som vill ha en kodningsagent som fungerar idag |
OpenCode ger dig en stabil kodningsagent med förlängningspunkter runt kanterna. DeepSeek Harness ger dig en körning där själva loopen kan bytas ut. Den flexibiliteten hjälper om du bygger agentinfrastruktur. Den innebär risk om du behöver ett standardverktyg för produktionskod den här veckan.
Båda verktygen kan nå samma OpenAI-kompatibla slutpunkt. Det gör ett rättvist test möjligt: en modell, en bas-URL, en uppgift och ett startrepo-status.
För den här genomgången körs DeepSeek V4 Flash genom Atlas Cloud, som exponerar en OpenAI-kompatibel slutpunkt som accepteras av båda verktygen. Listningen för deepseek-v4-flash-0731 visar $0,14 per miljon inmatningstokens, $0,28 per miljon utmatningstokens, ett kontextfönster på 1 048 576 tokens och max 393 216 utmatning från och med augusti 2026. Vilken leverantör som helst fungerar om båda harnessarna använder samma slutpunkt och modell-id.
OpenCode publicerar också aggregerad användningsdata. DeepSeek-modeller har flyttat 233 biljoner tokens genom OpenCode, där V4 Flash står för 85,5% och V4 Pro för 14,5% (OpenCode, augusti 2026). Det användningsmönstret gör V4 Flash till ett praktiskt standardval för jämförelsen.
Steg 1: Peka båda verktygen mot samma modell
Skapa en API-nyckel och en bas-URL, mata sedan båda verktygen med samma par. Skapa nyckeln i Atlas Cloud-konsolen och exportera den en gång:
plaintext1export ATLAS_API_KEY="your-api-key" 2
Kontrollera slutpunkten innan du ger den till något av harnessarna:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }' 8
Det anropet bevisar att routen, nyckeln och modell-id fungerar innan ett harness lägger till verktyg, försök eller konversationsuppspelning.
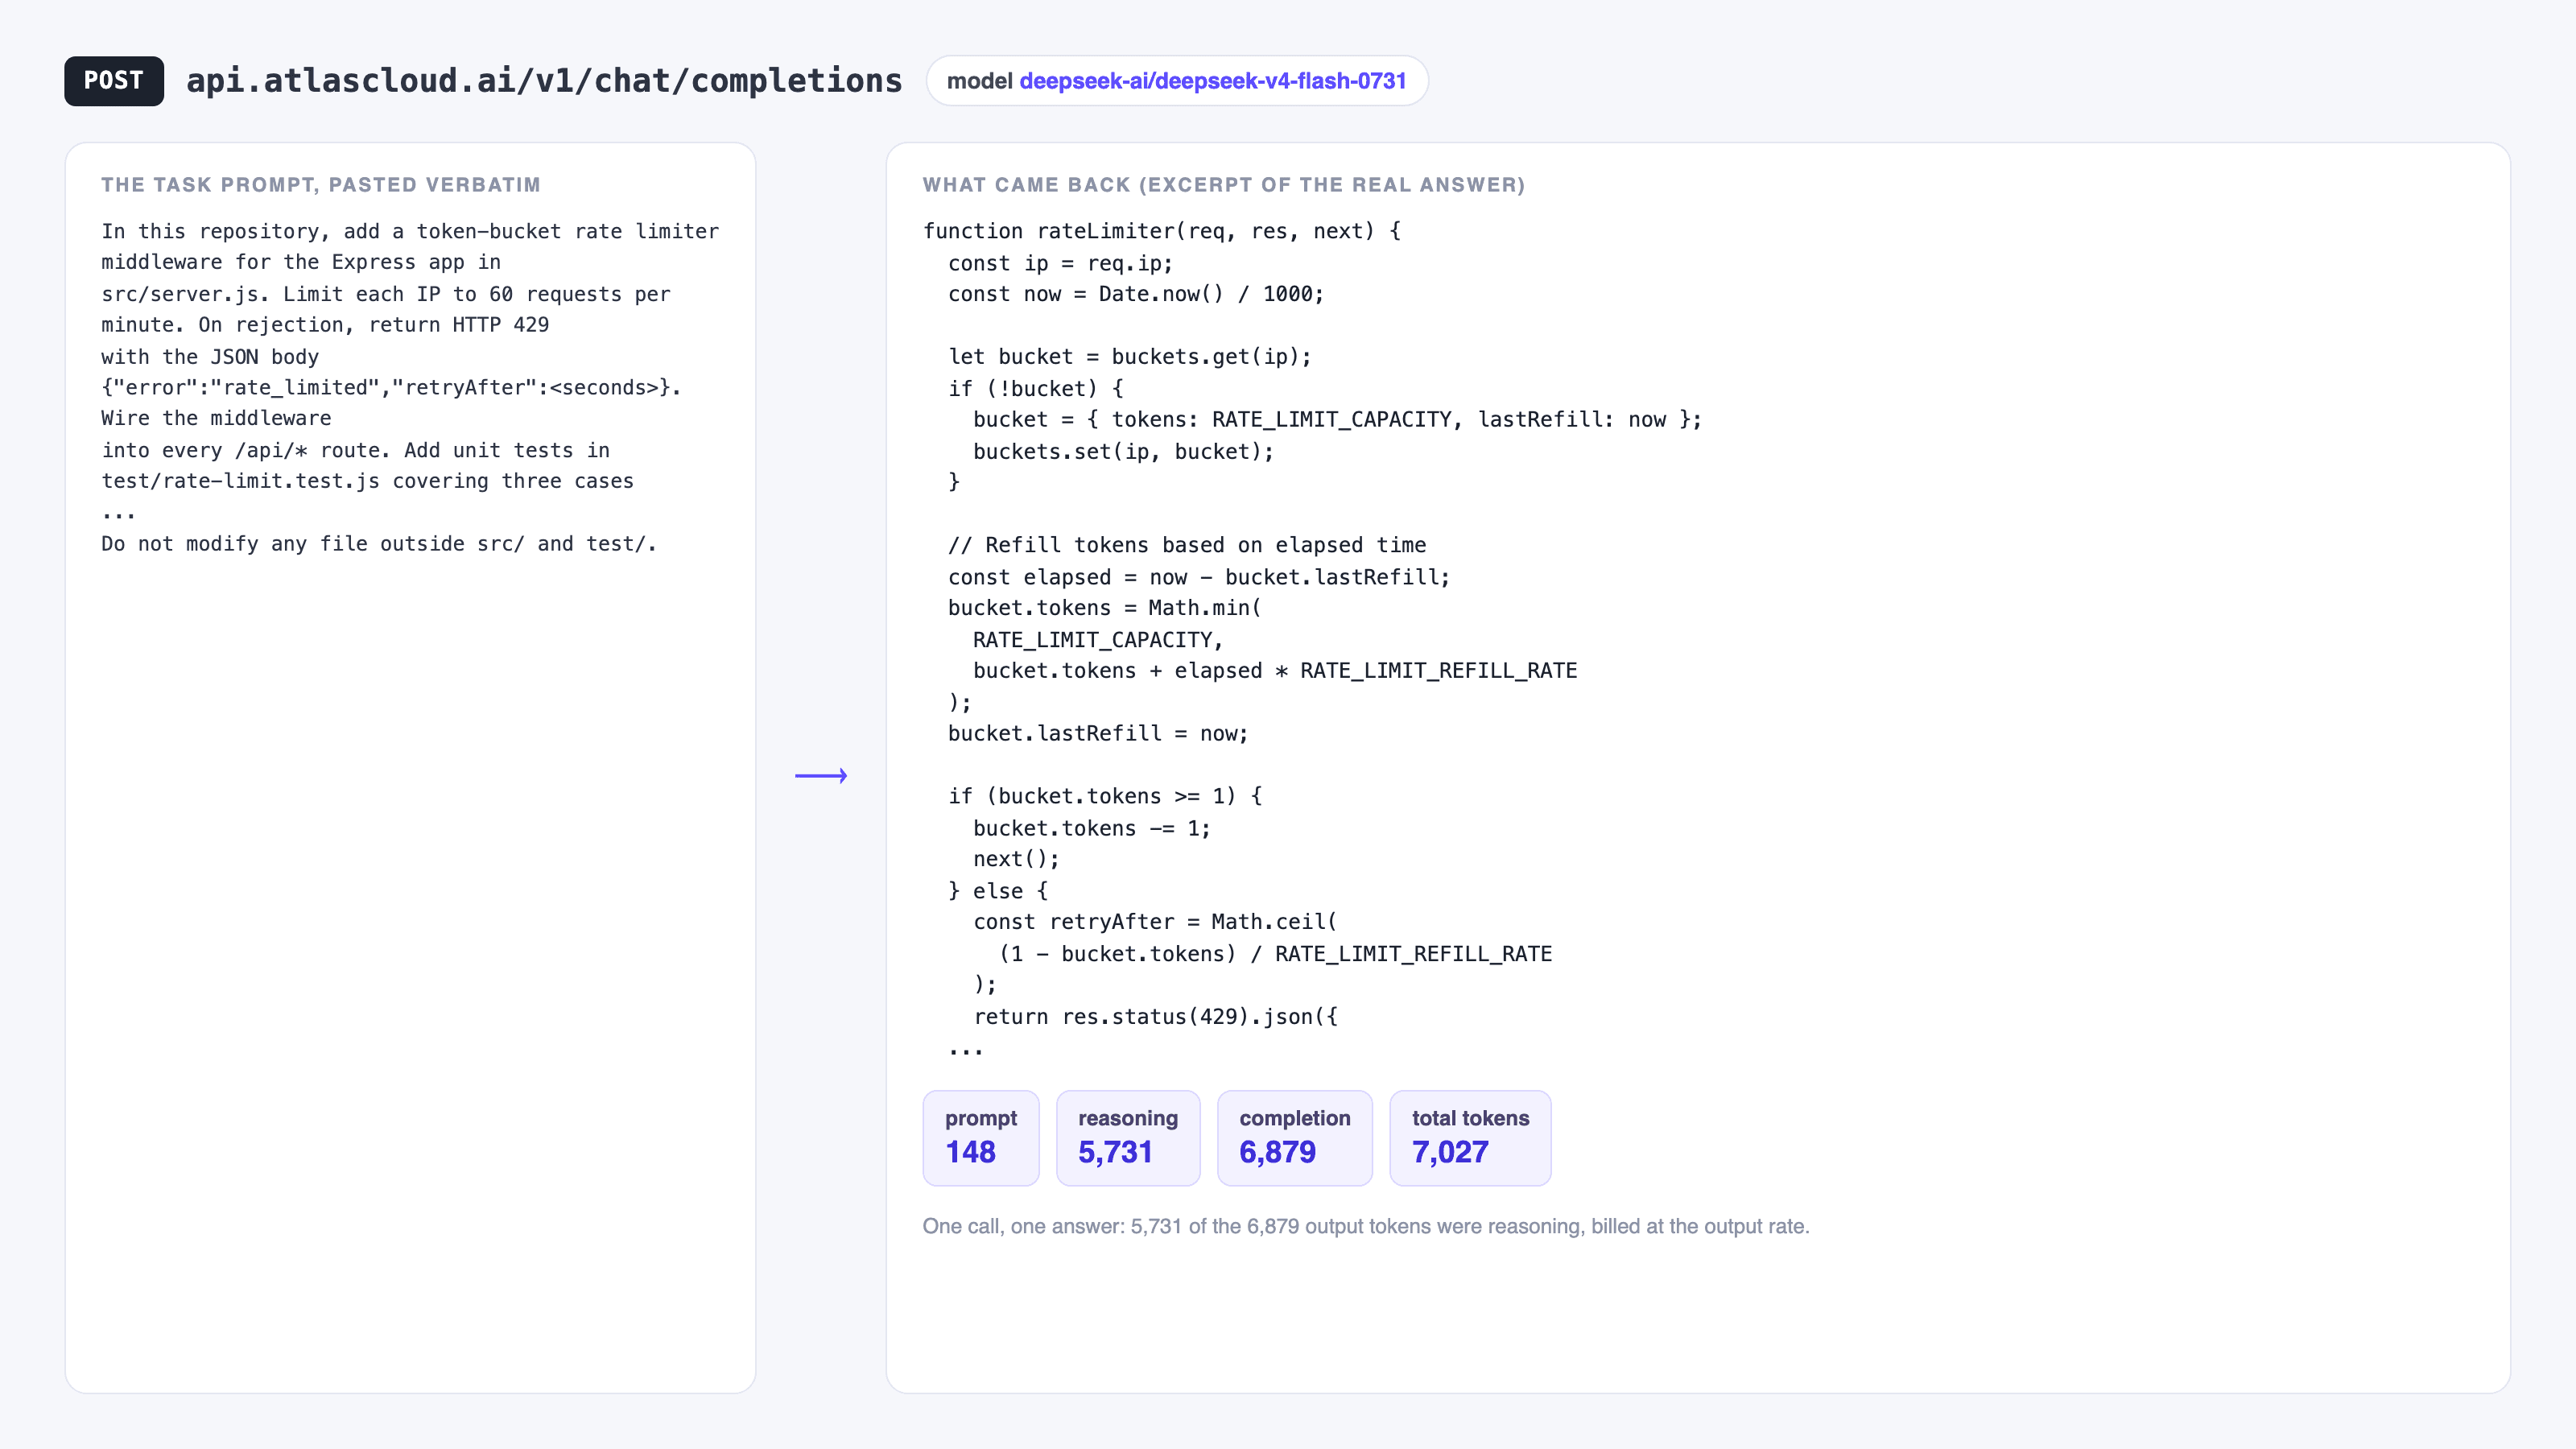
Kodningsuppmaning, genererad kod och tokenstatistik från ett modellanrop
Ett direkt anrop till deepseek-ai/deepseek-v4-flash-0731: 148 prompt-tokens in, 6 879 utmatningstokens tillbaka, inklusive 5 731 resonemangstokens. Betrakta det som golvet innan ett harness lägger till verktygsscheman och historik.
DeepSeek Harness läser $DSH_HOME/settings.yaml, och anpassade OpenAI-kompatibla leverantörer läggs under llm-pi-ai-pluginen (DeepSeek Harness-dokumentation, augusti 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Använd openai-completions för denna slutpunkt. Webbgränssnittet kan skriva samma leverantörsblock från Inställningar, Modeller, Lägg till anpassad leverantör, och sedan lagra nyckeln i $DSH_HOME/.credentials.yaml.
OpenCode läser opencode.json i din projektrot eller globala konfigurationskatalog (OpenCode-dokumentation, augusti 2026):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Använd @ai-sdk/openai-compatible, eftersom denna slutpunkt betjänar /v1/chat/completions. Ställ in de verkliga kontext- och utmatningsgränserna. OpenCode använder dem när den bestämmer när den ska sammanfatta, och felaktiga gränser kan snedvrida tokenjämförelsen.
Steg 2: Kör samma riktmärkesuppgift i DeepSeek Harness
Välj en uppgift som är tillräckligt stor för att kräva flera verktygsanrop och tillräckligt liten för att betygsätta. Använd samma repo-status för båda körningarna, så commita eller stash innan du börjar.
Klistra in denna exakta uppgift i båda verktygen:
plaintext1I detta repo, lägg till en token-bucket rate limiter-middleware för Express-appen i 2src/server.js. Begränsa varje IP till 60 förfrågningar per minut. Vid avslag, 3returnera HTTP 429 med JSON-kroppen {"error":"rate_limited","retryAfter":<sekunder>}. 4Koppla in middlewaren i varje /api/*-rutt. Lägg till enhetstester i 5test/rate-limit.test.js som täcker tre fall: en förfrågan under gränsen tillåts, 6en förfrågan över gränsen blockeras med 429, och räknaren återställs efter att 7fönstret har löpt ut. Kör testsviten och åtgärda fel tills den passerar. 8Ändra inga filer utanför src/ och test/. 9
Starta Harness från din projektkatalog:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web 3
Gränssnittet körs på http://127.0.0.1:3080. Välj atlas-leverantören och modellen deepseek-ai/deepseek-v4-flash-0731, klistra in uppgiften och låt den slutföras. Lägg inte till tips efter att körningen startat. Extra hjälp för ett verktyg ogiltigförklarar jämförelsen.
När Harness är klar, öppna Trajectory-vyn. Den sessionsposten är där dess tokennummer finns.
Steg 3: Upprepa körningen i OpenCode
Återställ repot till exakt startstatus. Det andra harnesset får inte ärva filer som det första redan har ändrat.
plaintext1git checkout -- . && git clean -fd 2
Kör sedan OpenCode mot samma modell:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Klistra in samma uppgiftsprompt från Steg 2. Använd standardagenten build. Låt den slutföras utan tips.
Betygsätt båda körningarna med samma kommando:
plaintext1npm test 2
En körning som lämnar sviten röd misslyckas, även om agentsammanfattningen låter självsäker. Använd binär betygssättning: godkänd eller underkänd.
Steg 4: Läs tokenanvändning
Båda verktygen spårar användning, men ingen av räknarna bör vara din slutliga fakturasiffra.
DeepSeek Harness levereras med en tokenmätare monterad som standard. Den exponerar tokenUsage, contextPressure och contextBreakdown i Trajectory-vyn. contextBreakdown berättar om fakturan kom från systemprompt, verktygsscheman, filläsningar eller konversationsuppspelning. Mätaren uppskattar ungefär en token per fyra tecken, så använd den som en diagnostisk vy.
OpenCode spårar tokens och kostnad per session och skriver ut dem i TUI-statusraden. Dess inbyggda nedbrytning är mindre, så team som behöver per-verktyg-attribuering inspekterar ofta sessionsdatabasen med externa analysatorer.
Använd leverantörssidans siffror för jämförelsen:
| Vad som ska jämföras | Var du får det |
|---|---|
| Totala inmatningstokens | Leverantörens användningsdashboard, per API-nyckel |
| Totala utmatningstokens | Leverantörens användningsdashboard, per API-nyckel |
| Antal modellanrop | Harness-trajectory-vy / OpenCode-sessionslogg |
| Verklig tid | Stoppur, från start till sista filskrivning |
| Godkänd eller underkänd | npm test-avslutningskod |
Skapa två API-nycklar, harness-test och opencode-test, och använd varje nyckel för en körning. Leverantörens dashboard ger dig då rena sida vid sida-användning utan att behöva jämka två interna uppskattningar.
Varför räkningen ändras
Tokenanvändning ändras av konkreta anledningar. Dessa fem spelar oftast större roll än modellpriset.
Konversationsuppspelning ackumuleras. Agenter skickar den växande konversationen på varje steg. En uppgift med 40 steg kostar närmare summan av 40 växande prompter än 40 identiska prompter. Harnessar som sammanfattar tidigt hamnar närmare den låga änden av riktmärkesspridningen.
Cacheträffar minskar inmatningskostnaden. DeepSeek V4 Flash-cacheträffar prissätts runt $0,0028 per miljon tokens mot $0,14 per miljon vid en miss, ungefär 98% billigare. Cachelagring kräver ett byte-för-byte stabilt prefix. Om ett harness blandar om systemprompt-text mellan anrop, förvandlar det träffar till missar.
Verktygsscheman följer med. Tjugo anslutna MCP-servrar innebär tjugo schemauppsättningar i prompten, även om uppgiften använder två av dem. Koppla bort verktyg du inte behöver innan du benchmarkar, annars mäter du din verktygskonfiguration istället för harnesset.
Stora verktygsutmatningar förgiftar kontexten. En cat av en 3000-raders fil eller en utförlig misslyckad testlogg stannar kvar i konversationen för senare anrop. DeepSeek Harness kan trimma överdimensionerade verktygsresultat innan sammanfattning. Slå på det när uppgiften producerar brusig utmatning.
Försök döljs i anropsantalet. Ett harness som försöker igen en misslyckad testloop spenderar tokens varje gång. Jämför modellanrop bredvid totala tokens så att du kan separera en försöksloop från en dyr prompt.
Med Atlas Cloud-priset för DeepSeek V4 Flash landar en uppgift på 692 000 tokens viktad mot inmatning i låga ensiffriga cent. Det är lite för en körning och mycket för ett team som kör agenter hela dagen. Bläddra i hela modellkatalogen om du vill upprepa testet på en andra modell och separera modeleffekter från harnesseffekter.
DeepSeek Harness är fortfarande en utvecklare förhandsversion, och dess README varnar för brytande ändringar. Benchmarka det om du vill ha kontroll över agentloopen. Standardisera på det endast om ditt team kan absorbera förändringar. OpenCode är det stabilare valet för team som behöver ett verktyg idag.
Vanliga frågor
Är DeepSeek Harness bättre än OpenCode?
Inte för de flesta team än. OpenCode är moget, terminalnativt, har ungefär 198k stjärnor och en stor leverantörskatalog, och det fungerar idag. DeepSeek Harness är nyare, i utvecklare förhandsversion, och varnar för brytande ändringar. Välj Harness om du vill modifiera agentens interna delar. Välj OpenCode om du vill ha en kodningsagent för dagligt arbete.
Fungerar DeepSeek Harness bara med DeepSeek-modeller?
Nej. Det är modellagnostiskt. Det levereras med katalogleverantörer för DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure och Codex, och du kan lägga till vilken anpassad leverantör som helst som talar openai-completions, openai-responses eller anthropic-messages i $DSH_HOME/settings.yaml. Konfigurationen i Steg 1 pekar det mot en OpenAI-kompatibel slutpunkt utan adapterkod.
Hur kontrollerar jag DeepSeek Harness tokenanvändning?
Använd den inbyggda tokenmätaren i Trajectory-vyn. Den exponerar tokenUsage, contextPressure och contextBreakdown. Betrakta det som en uppskattning eftersom den använder ungefär en token per fyra tecken. För faktureringsnoggrannhet, läs leverantörens användningsdashboard, helst med en dedikerad API-nyckel för varje körning.
Vilket harness använder färre tokens, DeepSeek Harness eller OpenCode?
Inget offentligt direkt jämförande riktmärke svarar på det än. Composio-riktmärket mätte OpenCode till 692 000 genomsnittliga tokens per uppgift, men det kördes innan DeepSeek Harness släpptes. Kör testet från Steg 2 till Steg 4 på ditt eget repo eftersom tokenanvändning beror på kodbasens storlek, verktygskonfiguration och uppgiftsform.
Kan jag köra DeepSeek Harness och OpenCode mot samma API-nyckel?
Ja, för ett enkelt test. För en ren mätning, använd två separata nycklar, en per harness. Leverantörens dashboard tillskriver då varje token till rätt körning.
Vad är skillnaden mellan en agent och ett harness?
DeepSeek beskriver en agent som Modell plus Harness. Modellen resonerar. Harnesset kopplar modellen till filer, shell-kommandon, verktyg, sessioner, godkännanden och loopen som bestämmer nästa handling. Ändra harnesset, och samma modell kan spendera ett annat antal tokens på samma uppgift.


