

Ett projektarkiv på 900 sidor är lätt att ladda upp. Den svårare frågan är om modellen kan peka på exakt den klausul, commit eller datapunkt du behöver. Användningsområden för DeepSeek V4.1 Flash med 1M-kontextfönster är relevanta när flera relaterade källor måste beaktas tillsammans, till exempel en kodbas, en forskningskorpus eller flera års projektanteckningar. Det större fönstret minskar behovet av att dela upp materialet i förväg, medan beviskontroller fortfarande avgör om ett svar är tillförlitligt.
De starkaste användningsområdena är kodgranskning över filer, forskningssammanställning, policyjämförelse, feedbackanalys, projekttidslinjer och långa multimodala poster. DeepSeek anger en kontext på 1M token, men den kapaciteten är inte en garanti för att varje detalj återges korrekt. Kontrollera modellens och API:ets gränser för din väg och testa sedan ditt eget material innan du förlitar dig på resultatet.
Viktiga slutsatser
- Använd ett fönster på en miljon token när frågan beror på samband mellan många relevanta källor.
- Be om fil-, avsnitts- eller sidreferenser och separera direkta bevis från slutsatser.
- Börja med ett test med känt svar och utöka kontexten endast när det förbättrar resultatet.
- Uppskatta kostnaden utifrån indata, utdata och cachehantering, inte enbart utifrån kontextgränsen.
Vad innebär ett kontextfönster på 1M token?
Ett kontextfönster är mängden information som en modell kan beakta i en förfrågan eller konversationstillstånd, inklusive medföljande material och omgivande instruktioner. DeepSeeks nuvarande API-prissida listar DeepSeek-V4.1-Flash med en kontextlängd på 1M och en maximal utdata på 384K token. Det är leverantörens angivna gräns; din applikation, slutpunkt eller förfrågningskonfiguration kan införa en lägre gräns. ( DeepSeek API-dokumentation )
Token är textbitar, inte ord eller sidor. Ett källarkiv som innehåller kod, tabeller, uppmärkning, upprepad boilerplate och skanningar kan tokeniseras mycket annorlunda än ren prosa med samma sidantal. För en verklig arbetsbelastning, uppskatta token med tokeniseraren eller användningsrapporteringen för det API du ska anropa. Inkludera systeminstruktioner, filnamn, metadata, frågetext och svarsbudgeten i din uppskattning.
Den praktiska fördelen är kontinuitet. Du kan fråga om beroenden mellan flera moduler eller motsägelser mellan en aktuell policy och dess bilagor utan att först manuellt sy ihop sammanfattningar. Avvägningen är att en mycket stor prompt kan innehålla irrelevant eller duplicerat material, ta längre tid att bearbeta och ändå göra exakt hämtning svårare. Betrakta "får plats i fönstret" som en kapacitetskontroll och testa sedan om modellen kan hitta de fakta din uppgift behöver.
De bästa användningsområdena för DeepSeek V4.1 Flash med 1M-kontext
Den rätta frågan är inte "Kan jag ladda upp allt?" Den är "Vilka källor måste jämföras för att besvara detta?" Använd en lång kontext när svaret beror på kopplingar mellan material, och definiera hur du ska verifiera det svaret innan du skickar hela arkivet.
| Användningsområde | Varför en lång kontext hjälper | Vad som ska ingå | Vad som ska verifieras |
|---|---|---|---|
| Granskning av stor kodbas | Gränssnitt och konventioner sträcker sig över moduler | Relevant källkod, tester, arkitekturanteckningar | Filsökvägar, symboler, testbevis |
| Forskningssammanställning | Metoder och resultat behöver jämföras sida vid sida | Artiklar, rapporter, begränsningar | Varje påståendes källa och förbehåll |
| Jämförelse av avtal eller policy | Definitioner och undantag återkommer i olika avsnitt | Aktuella och tidigare versioner, bilagor | Klausulnummer och exakt formulering |
| Feedbackanalys | Teman förekommer i många kommentarer | Avidentifierad feedback och kodningsregler | Representativa citat och räknemetod |
| Projekthistorikens tidslinje | Beslut utvecklas över mötesprotokoll | Protokoll, beslutsloggar, versionsanteckningar | Datum, ägare, motstridiga poster |
| Lång incidentgranskning | Loggar, ärenden och efteranalyser förklarar olika stadier | Relevant tidsintervall och incidentdokument | Tidsstämpel, händelsekälla, osäkerhet |
| Granskning av multimodala dokument | Text och visuella bevis kan behöva läsas tillsammans | Bildtyper som stöds och deras bildtexter eller kontext | Om slutpunkten stöder medietypen |
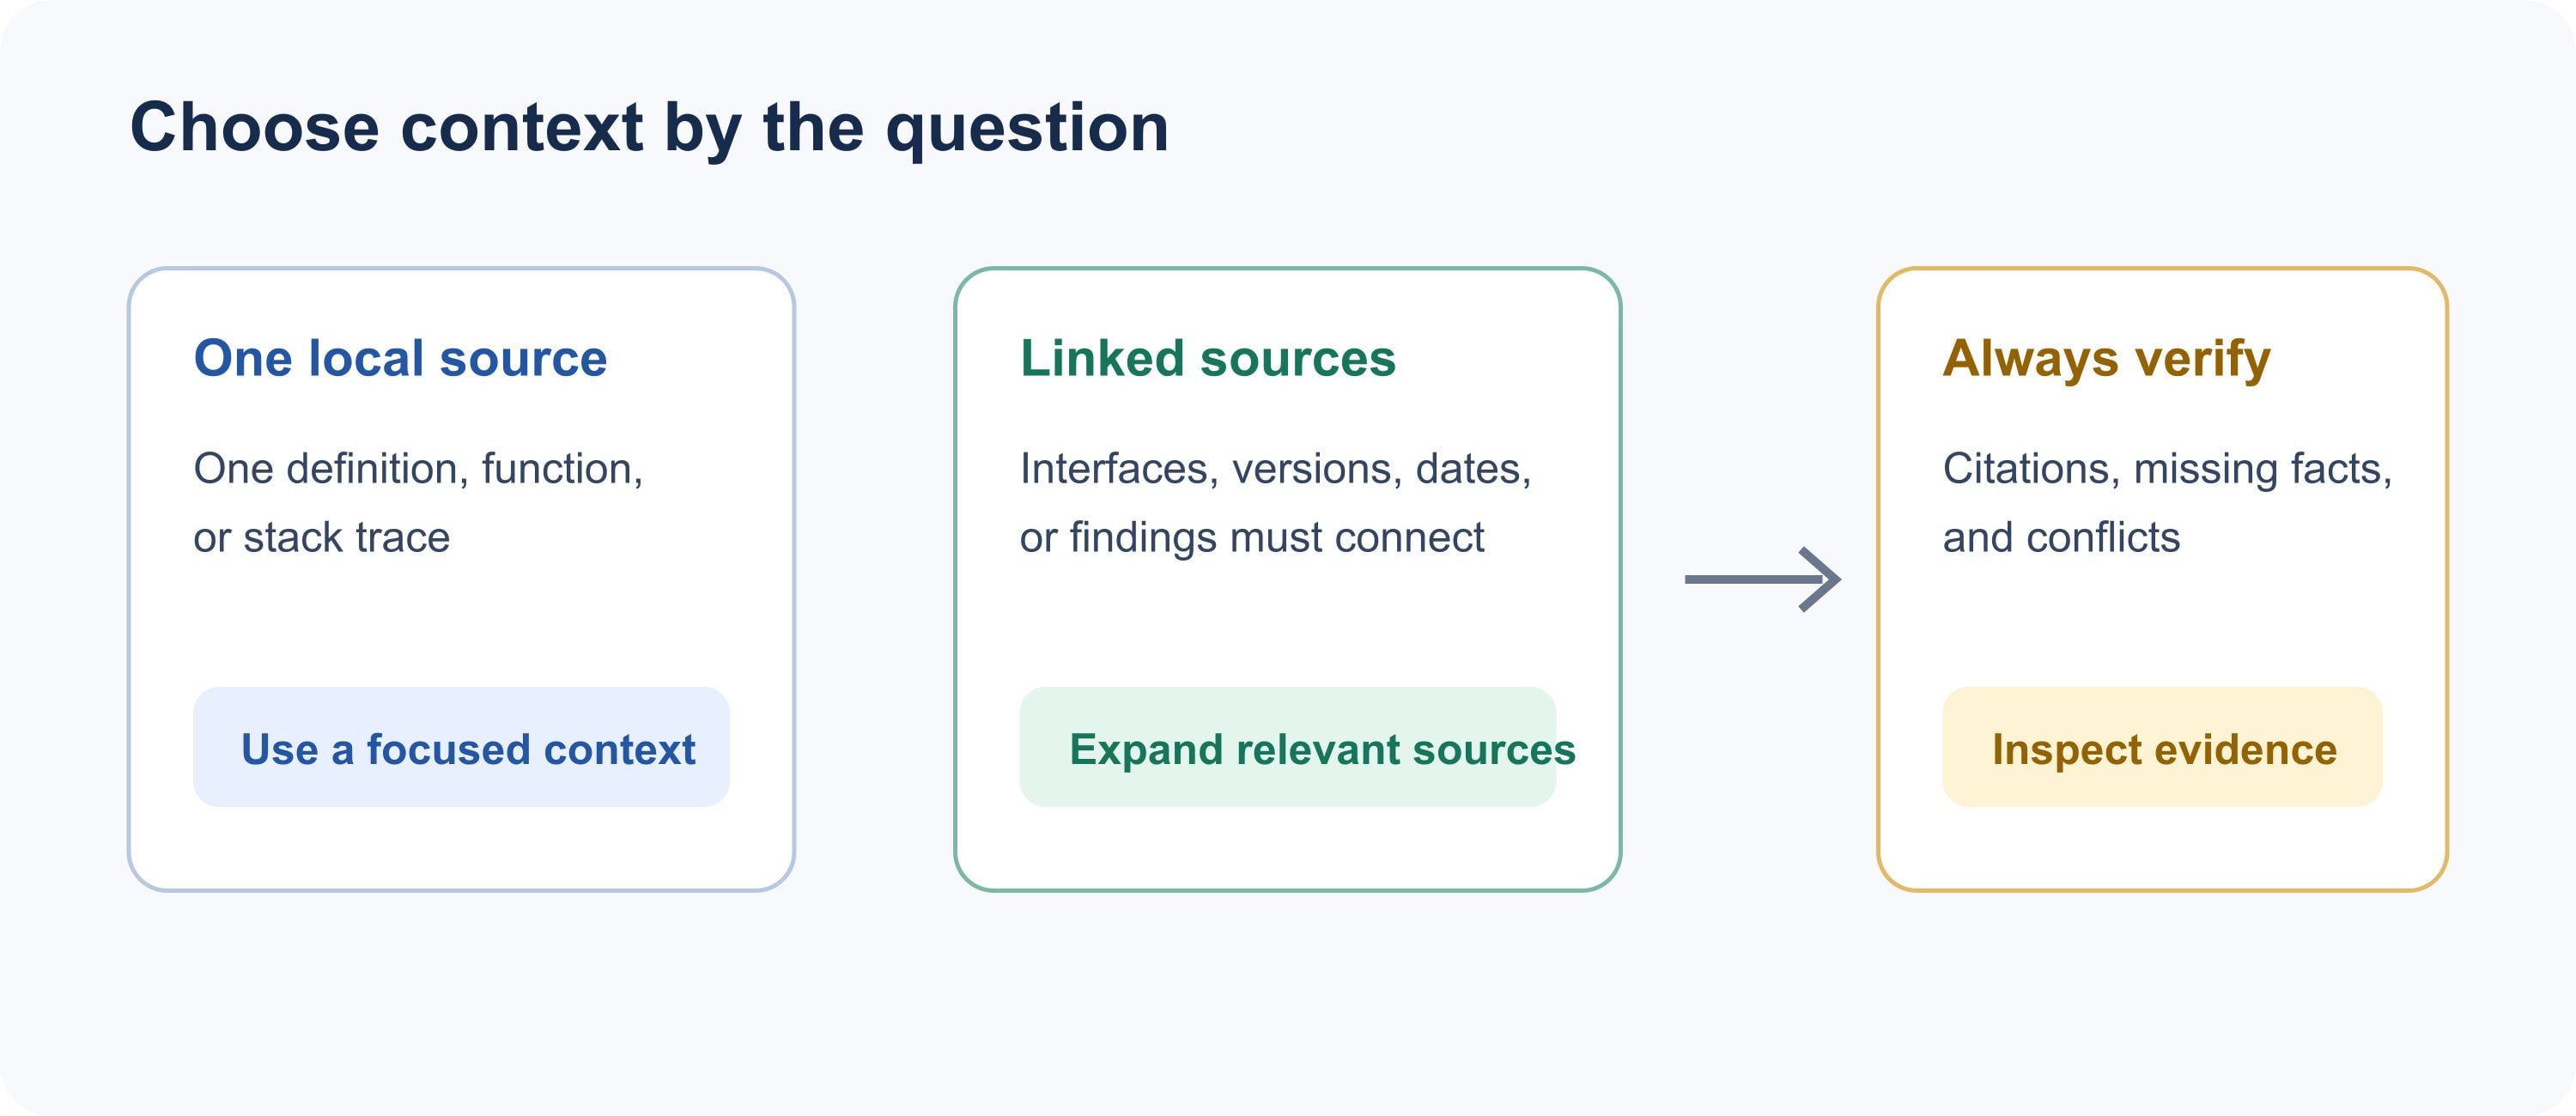
Använd en fokuserad kontext för en lokal fråga; utöka när källor måste kopplas samman och granska sedan bevisen.
Granska en stor kodbas över filer
En kontext på en miljon token kan hjälpa en ingenjör att spåra en datastruktur från en API-gräns genom servicelogik, lagring och tester. Det är användbart för arkitektursammanfattningar, att hitta troligt påverkade moduler och att utforma en refaktoreringsplan som följer konventioner dokumenterade på flera ställen.
Ge modellen en avgränsad ögonblicksbild av arkivet i stället för en ofiltrerad diskdump. Inkludera källfiler som är relevanta för ändringen, de närmaste testerna, beroendemanifest och arkitekturanteckningar. Exkludera byggutdata, leverantörsberoenden (vendored dependencies), genererade paket och dubbletter om inte frågan gäller dem. Be om filsökvägar och symbolnamn för varje föreslaget beroende, samt en åtskillnad mellan observerat beteende och ett antagande.
Använd utdata som en granskningsplan. Bekräfta att varje citerad symbol finns, granska de citerade raderna och kör projektets kontroller själv. Modellen bör inte hävda att tester har godkänts om inte ett verktyg faktiskt körde dem och returnerade resultatet. För en lokaliserad bugg i en funktion är en mindre kontext ofta snabbare och lättare att granska.
Sammanställ forskning från artiklar och rapporter
En lång kontext hjälper när studier använder olika metoder, populationer, mått eller definitioner. Be om en jämförelsetabell med en rad per källa och kolumner för forskningsfråga, data, metod, resultat, begränsningar och relevans för din fråga. Håll påståenden på källnivå kopplade till sin källa i stället för att låta en sammanslagen sammanfattning sudda ut oenighet.
Till exempel, när du jämför utvärderingar av ett verktyg, skilj på ett benchmarkresultat från en fältstudie och från en författares tolkning. Be modellen att flagga inkompatibla mått i stället för att rangordna resultat som inte kan jämföras. Öppna sedan källavsnitten bakom de mest beslutsrelevanta påståendena. En sammanställning är en karta över bevis, inte en ersättning för att kontrollera artiklarna.
Jämför långa avtal, policyer eller specifikationer
Avtal och policyer definierar ofta en term en gång och kvalificerar den någon annanstans. Att tillsammans tillhandahålla den gällande versionen, ändringar, bilagor och relevant äldre utkast kan hjälpa till att synliggöra ändrade definitioner, korsreferenser, saknade villkor och uppenbara konflikter.
Begär det exakta avsnittet eller klausulen för varje observation och ett kort utdrag som en granskare kan hitta. Separera textliga skillnader från deras möjliga konsekvenser. Modellen kan hjälpa till att organisera en granskning, men juridisk tolkning, efterlevnadsbeslut och undertecknandebefogenhet ligger kvar hos kvalificerade personer som kan beakta jurisdiktion och sammanhang.
Analysera kundfeedback i stor skala
En stor mängd feedback kan avslöja återkommande önskemål och invändningar över kanaler eller tidsperioder. Tillhandahåll ett definierat urval, ta bort personlig information som inte behövs och ange ett kodningsschema som "onboardingfriktion", "saknad integration" eller "prisförvirring". Be om representativa exempel och motexempel, inte bara en lista över teman.
Presentera inte modellgenererade temaprocentandelar som undersökningsstatistik. Om du behöver antal, definiera enheten (meddelande, kund eller ärende), deduplicera poster, tillämpa en konsekvent märkningsregel och verifiera antalet med ett repeterbart skript eller ett mänskligt granskat urval. Modellen är användbar för att föreslå kategorier och hitta exempel; en dokumenterad metod stöder kvantitativa påståenden.
Bygg en tidslinje från projektdokument
För en överlämning eller efteranalys kan relevanta bevis vara utspridda över mötesprotokoll, versionsanteckningar, beslutsloggar och ärenden. Be om en kronologisk tabell med datum, händelse, namngiven ägare där så anges, källplats och tillförlitlighet eller oklarhet. Instruera modellen att bevara motstridiga datum i stället för att tyst välja ett.
En användbar tidslinje hjälper en ny teammedlem att se vad som beslutades, när ett krav ändrades och vilket dokument som stöder varje händelse. Verifiera kritiska övergångar mot källposten, särskilt när en anteckning skrevs senare eller sammanfattar ett möte i stället för att dokumentera det direkt.
Granska långa incidentposter och multimodalt material
Incidentgranskning kan dra nytta av att hålla larm, driftanteckningar, ärenden och efteranalysen i en och samma bevisuppsättning. Be om en sekvens av observerade händelser och skilj uttryckligen på tidsstämplar i loggar från senare uppskattningar i berättande anteckningar. Detta kan göra den första genomgången mer sammanhängande, medan jouringenjören fortfarande kontrollerar källsystemen innan åtgärder vidtas.
DeepSeeks officiella tillkännagivande säger att V4.1-Flash är live på deras API med inbyggt multimodalt stöd. De exakta bildformaten, förfrågningsmetoderna och gränserna beror på slutpunkten och integrationen, så bekräfta dessa detaljer innan du antar att en textbudget på en miljon token också beskriver bildhantering. ( DeepSeek V4.1-Flash tillkännagivande )
När hjälper en miljon token, och när tillför det brus?
Mer kontext hjälper när källor behöver korsrefereras. En kodändring som involverar ett delat gränssnitt kan kräva flera moduler och tester. En versionsjämförelse behöver båda kompletta versionerna och deras bilagor. En projekttidslinje kan behöva poster utspridda över månader.
En lokal bugg med en tydlig stackspårning kan bara behöva funktionen, dess anropare och det relevanta testet. En fråga som söker en enda definition kan bara behöva det auktoritativa avsnittet. För sådana uppgifter ökar ett helt arkiv sökutrymmet och kan begrava det användbara avsnittet.
Innan du utökar prompten, ta bort upprepade exporter, föråldrade utkast, orelaterade mappar, boilerplate och poster utanför frågans tidsintervall. Behåll en manifest över vad du inkluderade och varför. Om svaret ändras när du lägger till en stor mängd orelaterade filer, är det en signal att strama åt källuppsättningen och köra om testet.
Ett praktiskt arbetsflöde för tillförlitliga långkontextsvar
Använd ett konsekvent bevisprotokoll så att ett flytande svar inte misstas för ett verifierat. Märk först källorna med stabila filnamn och, där det är möjligt, sidnummer, rubriker, radnummer, datum eller versionsidentifierare. Bevara tillräckligt med omgivande kontext för att tolka utdrag korrekt.
Ange sedan ett beslut eller en forskningsfråga. Ange utdatans form och de platser som modellen måste citera. En återanvändbar prompt är:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
För en kodbas, lägg till: "Citera arkivsökvägar och funktions- eller klassnamn. Innan du föreslår en ändring, lista de påverkade filerna och de testbevis som stöder förslaget. Säg inte att ett test kördes om inte resultatet ingår i de medföljande bevisen."
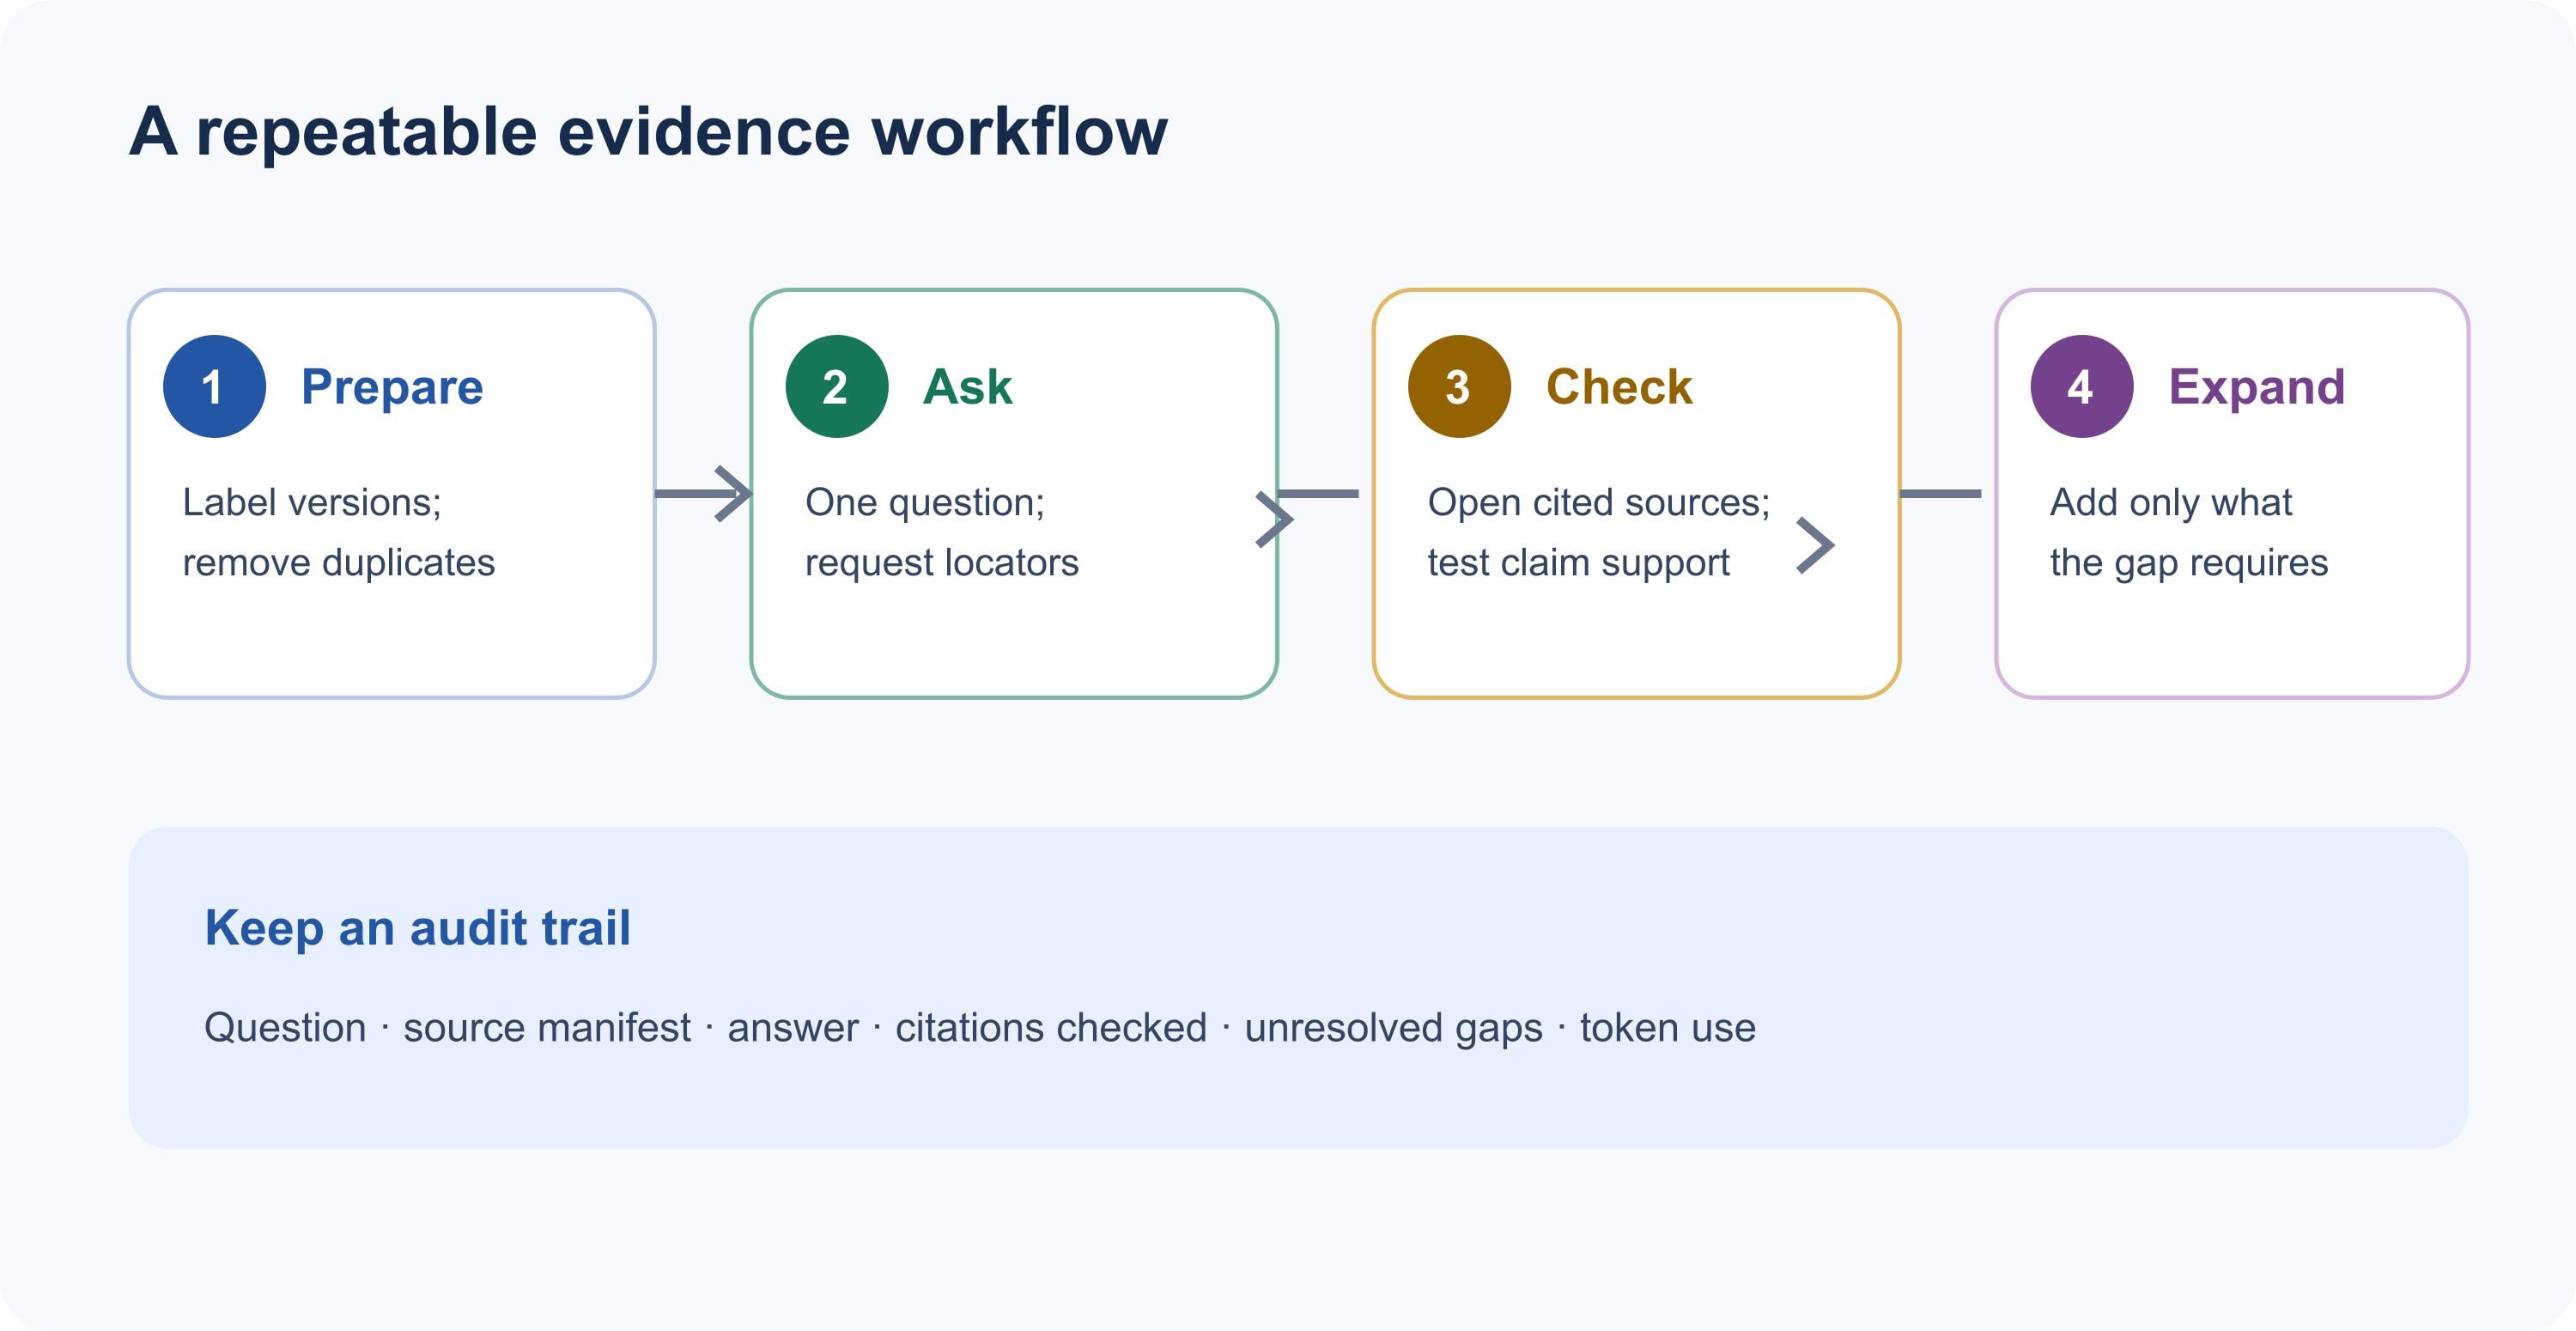
Förbered källor, ställ en avgränsad fråga, kontrollera citeringar och utöka endast för att lösa en lucka.
Granska sedan svaret i tre steg. Kontrollera om varje citering pekar på en verklig plats. Kontrollera om det citerade avsnittet stöder påståendet, i stället för att bara nämna ämnet. Granska slutligen utelämnanden och konflikter genom att ställa riktade uppföljningsfrågor mot samma källuppsättning. För beslut med höga insatser, låt en kvalificerad granskare läsa källmaterialet direkt.
Beviskarta för långkontextarbetsflöde
| Steg | Åtgärd | Behåll | Stoppsignal |
|---|---|---|---|
| 1. Förbered | Märk, deduplicera och avgränsa källor | Källmanifest och versioner | Okänt ursprung eller inaktuell dubblett |
| 2. Fråga | Ange en fråga och ett bevisformat | Filnamn och lokaliserare i svaret | Bred begäran utan beslutsmål |
| 3. Kontrollera | Öppna citerade avsnitt och jämför påståenden | Stödda påståenden och uttalade luckor | Citering stöder inte påståendet |
| 4. Utöka | Lägg endast till källor som behövs för olösta länkar | Förbättring på tester med känt svar | Mer indata utan bättre bevis |
Hur du testar om 1M-kontext är användbar för din uppgift
Skapa en liten utvärderingsuppsättning innan du laddar hela arkivet. Skriv frågor vars svar du redan känner till från källmaterialet. Placera några fakta nära början, några i mitten och några nära slutet. Lägg till minst en fråga som kräver att två dokument kopplas samman och en som inte kan besvaras från de medföljande källorna.
Kör samma frågor på en mindre, relevant delmängd först och öka sedan kontexten i uppmätta steg. Registrera faktisk korrekthet, lokaliserarens noggrannhet, missade bevis, ostödda påståenden, vägran på den obesvarbara frågan, latens och tokenanvändning. Håll prompten och avkodningsinställningarna stabila så att ändringar kan tolkas. Upprepa en fråga om utdata varierar väsentligt mellan körningar.
| Kontroll | Vad ett godkänt svar visar | Vad du ska göra efter ett misslyckande |
|---|---|---|
| Känd fakta tidigt, i mitten, sent | Hämtning över källintervallet | Kontrollera indexering, filetiketter och promptlängd |
| Länk mellan dokument | Bevis kan sammanfogas mellan källor | Be om båda citeringarna och begränsa sedan länkfrågan |
| Obesvarbar fråga | Modellen kan rapportera saknade bevis | Strama åt "använd endast medföljande källor" och testa igen |
| Citeringsgranskning | Lokaliserare och utdrag stöder påståendet | Behandla påståendet som overifierat tills det korrigeras |
| Jämförelse med större kontext | Extra material förbättrar måluppgiften | Ta bort brus om noggrannhet eller latens försämras |
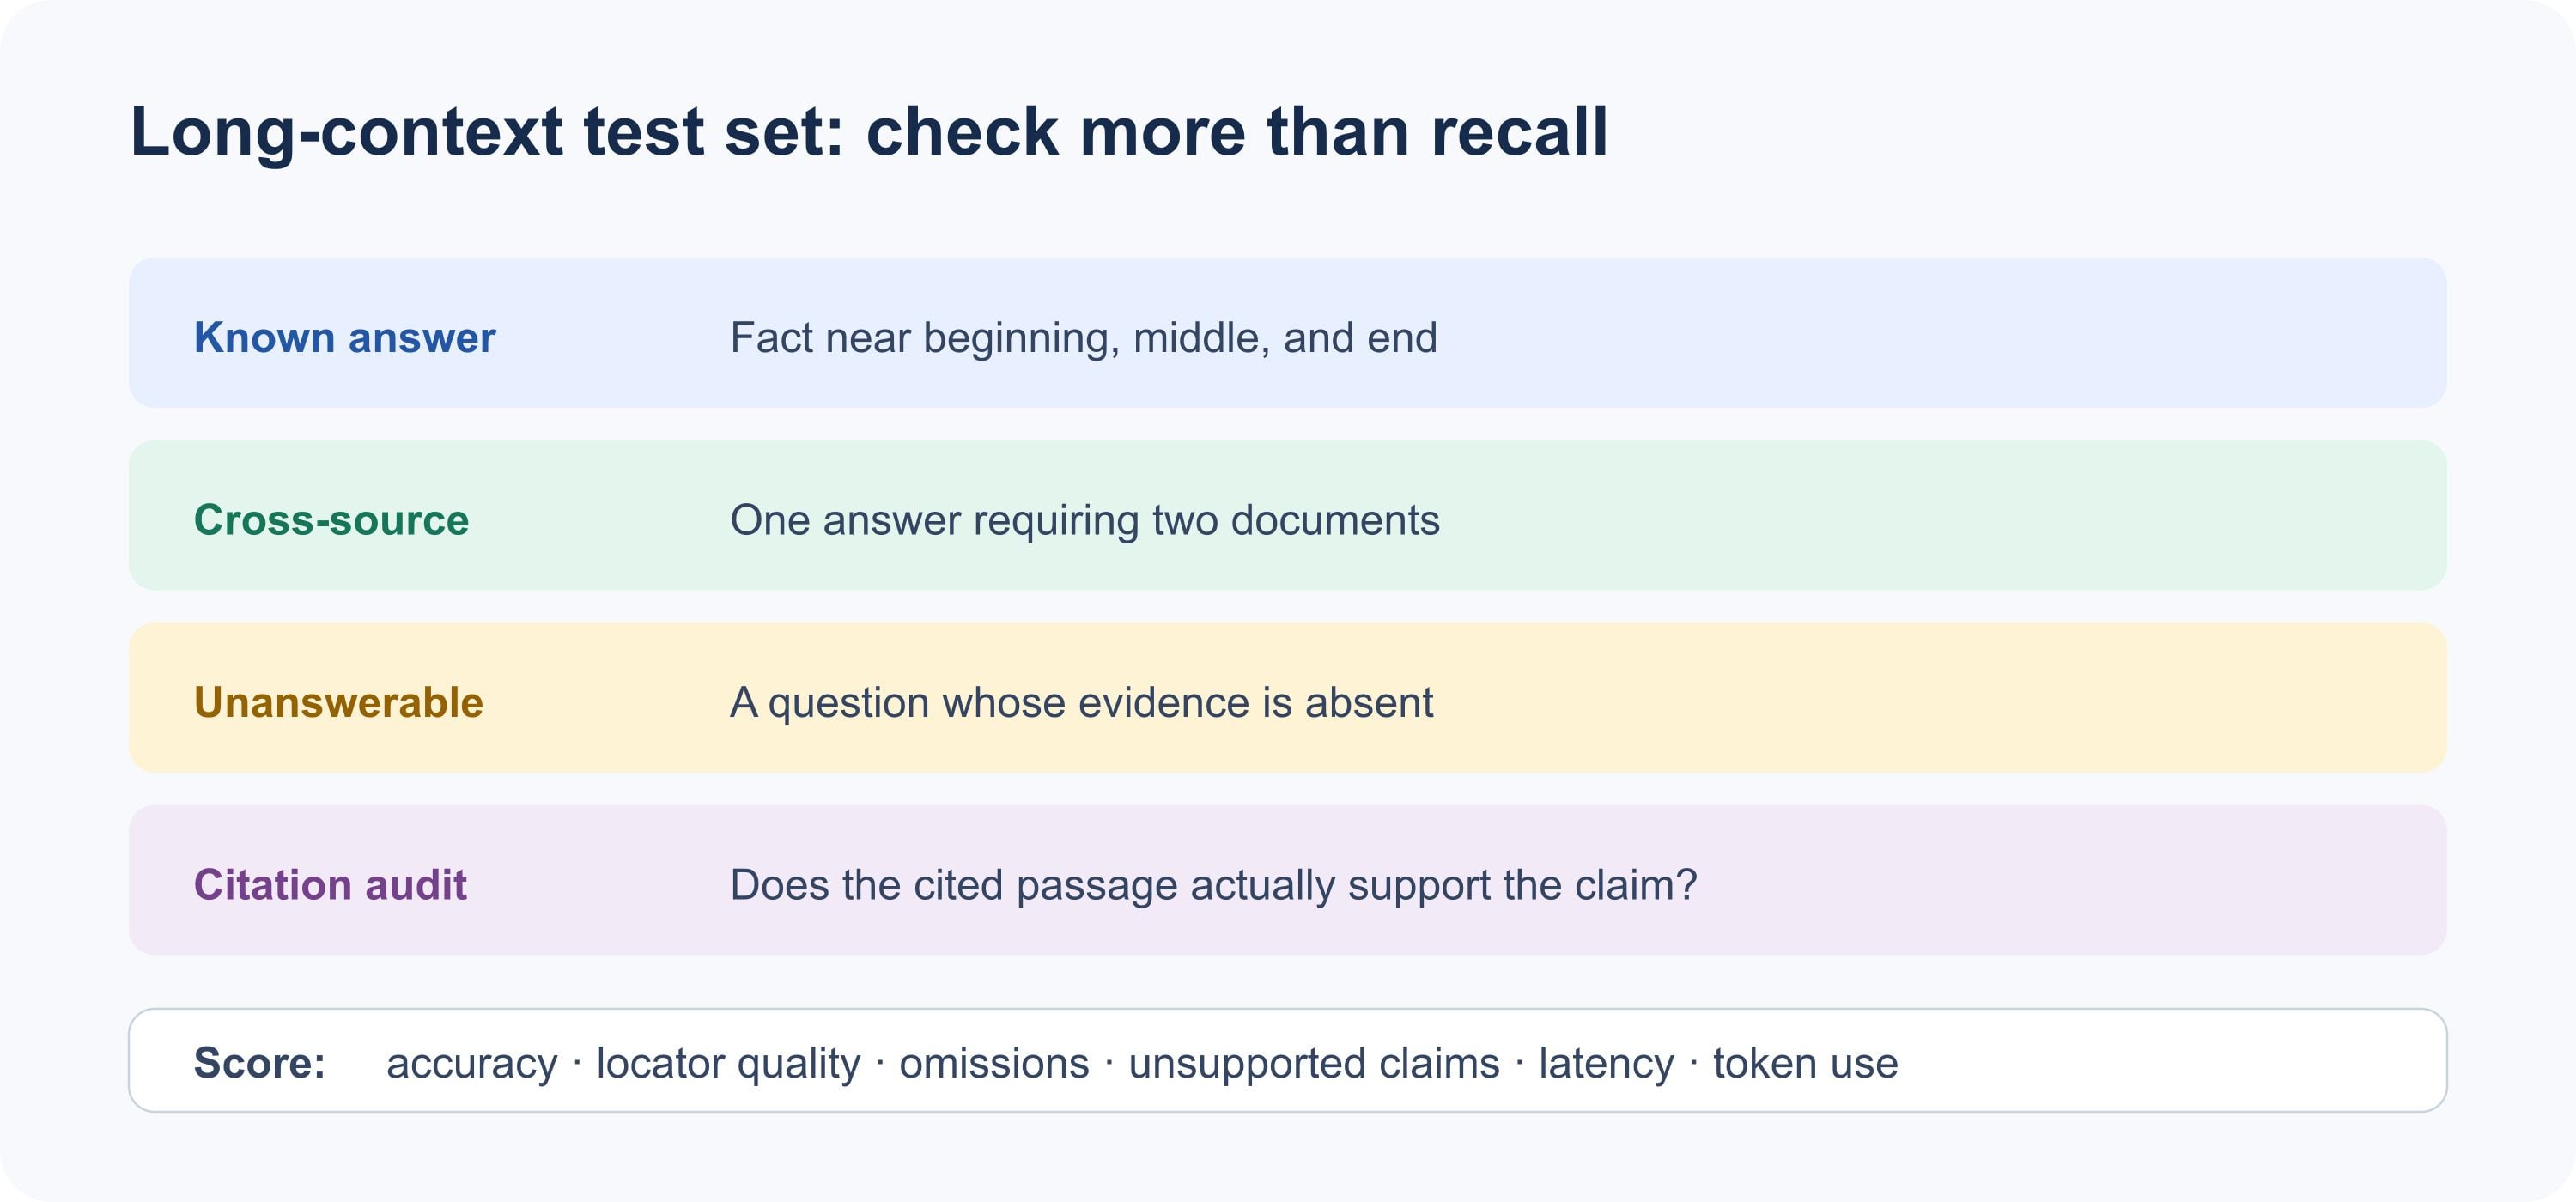
Poängsätt hämtning, citeringsstöd, utelämnanden, ostödda påståenden, latens och tokenanvändning.
Community-rapporter är blandade och uppgiftsberoende. En Reddit-användare delade en harness-specifik ökning av felaktiga verktygsargument vid större kontextstorlekar, medan kommentatorer beskrev framgångsrikt arbete vid högre tokenantal i andra uppsättningar. Det är en användbar anledning att benchmarka din egen harness, inte bevis för en universell feltröskel. ( DeepSeek-kontextdiskussion på Reddit )
En förnuftig uppskalning är: validera prompten på ett litet urval, lägg till de källgrupper som behövs för frågor mellan dokument och testa sedan en representativ stor förfrågan. Behåll den minsta kontext som besvarar den verkliga frågan med tillförlitliga bevis. Detta gör också jämförelser av latens och kostnad lättare att tolka.
Prissättning och åtkomst för DeepSeek V4.1 Flash API
På Atlas Cloud visar modelllistningen för närvarande DeepSeek V4.1 Flash med en 1M-kontext och priser på $0.30 per miljon indatatoken, $1.20 per miljon utdatatoken och $0.03 per miljon cache-lästa token. Listningen visar ingen rabatt för denna modell. Dessa är Atlas Cloud-priser, åtskilda från DeepSeeks egna tidsberoende topp- och off-peak-priser. Kontrollera Atlas Clouds modellkatalog och prissida för modeller igen innan du publicerar eller budgeterar, eftersom priserna kan ändras.
Vid de listade priserna kostar en förfrågan med 100 000 icke-cachade indatatoken och 2 000 utdatatoken cirka $0.03 för indata plus $0.0024 för utdata, eller $0.0324 totalt före eventuella andra tillämpliga avgifter. Om indata faktureras som cache-läsningar skulle 100 000 cachade token i stället kosta $0.003. Exemplet antar dessa tokenantal och priser; det är inte en offert för en specifik arbetsbelastning. Hela 1M-kapaciteten debiteras inte bara för att den finns. Fakturering följer användning och cachehantering.
För team som vill ha en enda API-ingångspunkt tillhandahåller DeepSeek V4.1 Flash modellsida modellen och anropsinformation. Jämför din uppmätta tokenanvändning och integrationsbehov med den officiella slutpunkten också; modellnamn, gränser och priser kan skilja sig mellan leverantörer.
Vanliga frågor
Är ett kontextfönster på 1M token samma sak som 1M ord?
Nej. Token kan vara delar av ord, skiljetecken, kodfragment eller andra enheter. Antalet ord eller sidor som får plats beror på materialet och dess tokenisering. Använd uppmätta tokenantal i stället för en fast sidomvandling.
Använder DeepSeek V4.1 Flash alltid hela kontextfönstret?
Nej. En miljon token är en maximal kontextspecifikation, inte ett mål för varje förfrågan. En kort prompt använder mindre, och ett visst gränssnitt eller API-väg kan tillämpa en lägre gräns. Kontrollera slutpunktsdokumentationen och de faktiska användningsfälten.
Räcker 1M-kontext för en hel kodbas?
Det kan räcka för vissa kodbaser räknat i token, men det gör inte varje fil relevant eller varje svar tillförlitligt. Inkludera de filer som behövs för frågan, verifiera citerade sökvägar och symboler och testa ändringar med projektets verkliga kontroller.
Bör jag lägga alla tillgängliga dokument i en prompt?
Endast om dokumenten gäller samma fråga. Börja från ett källmanifest, ta bort dubbletter och orelaterat material och lägg sedan till mer när ett test mellan dokument kräver det. De bästa användningsområdena för DeepSeek V4.1 Flash med 1M-kontextfönster definieras av bevis som måste jämföras, inte av arkivets storlek.





