Två team kan rapportera hundratals tokens per sekund för DeepSeek V4.1 Flash och ändå mäta olika saker. Det ena kan avse avkodningshastighet för en enskild begäran; det andra kan avse aggregerad utdata över dussintals samtidiga begäranden. För att förbättra DeepSeek V4.1 Flash inferens-genomströmningsoptimering, välj först det mätvärde din tjänst behöver, benchmarka sedan din egen begärandemix, ändra en serveringsvariabel i taget och verifiera latens, kvalitet och kostnad tillsammans. Modellfamiljen inkluderar nu uppdateringen Flash-1017 från 17 oktober, så registrera den exakta checkpointen innan du jämför resultat. Offentliga rapporter visar användbara optimeringsvägar, men ingen av dem ersätter ett matchat test på din egen hårdvara.
Viktiga insikter
- Aggregerade utdatatokens/s mäter kapacitet över begäranden; avkodningshastighet per begäran mäter en enskild användares upplevelse.
- Reproducera dina promptlängder, utdatagränser, samtidighet, uppvärmt tillstånd och latensmål innan du justerar.
- V4.1 Flashs komprimerade KV-cache och begränsade replay minskar minnesbelastningen, men garanterar inte en fast snabbare svarstid från början till slut.
- Jämför vLLM och SGLang endast under matchade förhållanden vad gäller modell, hårdvara, arbetsbelastning och mätmetod.
Vad betyder genomströmning för DeepSeek V4.1 Flash?
Genomströmning är en hastighet, men täljaren och testgränsen spelar roll. För en inferenstjänst, registrera minst fem mätvärden:
| Mätvärde | Vad det berättar för dig | Typisk användning |
|---|---|---|
| Aggregerade utdatatokens/s | Utdatatokens som produceras av alla aktiva begäranden per sekund | Kapacitetsplanering och flotteffektivitet |
| Avkodningstokens/s per begäran | Genereringshastighet som upplevs av en enskild begäran | Interaktiv responsivitet under generering |
| Prefill-tokens/s | Indatatokens som bearbetas per sekund | Långa prompter och hämtningstunga arbetsbelastningar |
| Tid till första token (TTFT) | Tid från begäran ankommer till första utdatatoken | Upplevd startfördröjning |
| Svarstid från början till slut, p50/p95 | Total begärandetid över trafikfördelningen | Servicenivåmål och svansbeteende |
En server kan öka aggregerad genomströmning genom att batcha fler sekvenser samtidigt som varje användare får vänta längre mellan tokens. Omvänt kan en uppsättning inställd för låg samtidighet leverera snabba individuella svar medan acceleratorerna lämnas underutnyttjade. Inget av resultaten är universellt bättre. Rätt mål är en punkt på genomströmnings-latens-kurvan som uppfyller din produkts servicemål.
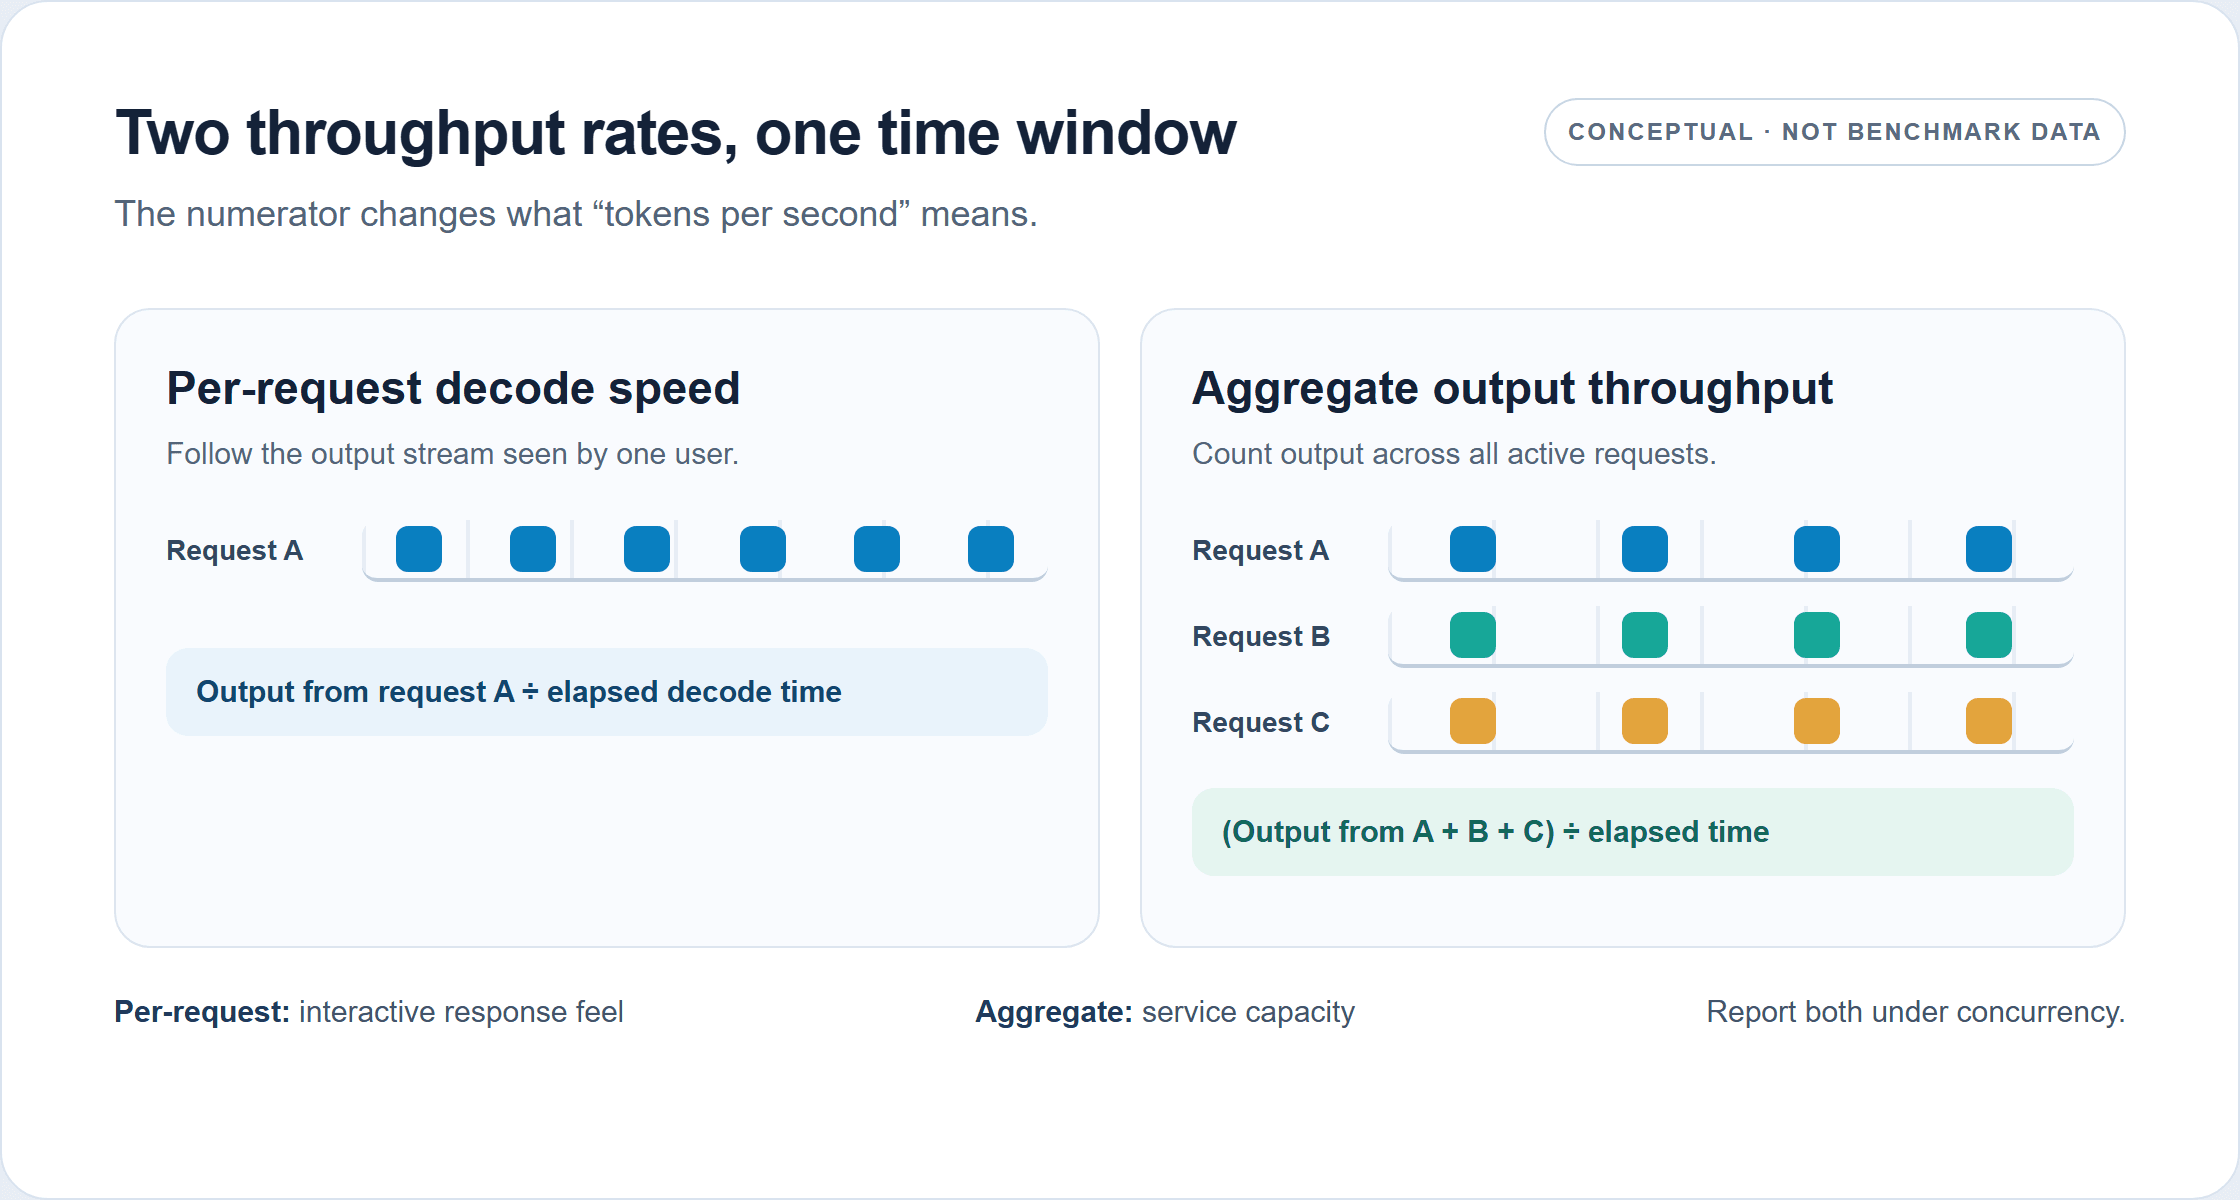
De två hastigheterna räknar olika utdataströmmar. Detta är ett konceptdiagram, inte uppmätt DeepSeek V4.1 Flash-prestanda.
Ange om genomströmning inkluderar prefill, avkodning eller båda. Ange om du dividerar med antalet GPU:er. Rapportera lyckade utdatatokens snarare än begärda maximala tokens, och redovisa avbrott eller fel. Utan dessa detaljer kan en tokens/s-siffra inte berätta för en operatör om den förutsäger deras applikation.
Bygg en reproducerbar DeepSeek V4.1 Flash-baslinje
En användbar baslinje liknar produktionstrafik tillräckligt mycket för att avslöja dess flaskhals. En enda kort prompt är en dålig proxy för en agent som upprepade gånger skickar en stor konversationshistorik, och en fast utdata på 1 024 tokens missar arbetsbelastningar som stoppar tidigt eller varierar kraftigt.
Fastställ arbetsbelastning och mätfönster
Skapa begärandekorgar från observerad trafik. För varje korg, bevara ungefärlig indatalängd, förväntad utdatalängd, ankomstmönster och eventuella delade prefix. Inkludera verktygs- eller resonemangsturer om de utgör en del av den verkliga begärandevägen. Håll prompter, samplingsinställningar, stoppvillkor och utdatagränser fasta mellan körningar.
Kör både ett lågsamtidighetsfall och den samtidighet din tjänst förväntar sig vid toppbelastning. Lägg sedan till mellanliggande samtidighetsnivåer för att avslöja var genomströmningen slutar öka eller latensen överskrider sin gräns. Använd ett stabilt mätfönster efter uppvärmning, upprepa varje punkt och rapportera medianen plus intervallet. En kort burst kan mäta uppstartsbeteende snarare än stabil servicekapacitet.
Separera kallstartsmätningar från varm servering. Kalla körningar inkluderar modellinläsning, graf-capture eller cache-populering beroende på stacken; varma körningar beskriver ett system som är redo att serva. För en prefix-cachad arbetsbelastning, mät cache-hit- och cache-miss-trafik separat. Kombinera dem inte till ett medelvärde om inte mixen matchar produktionen.
För en benchmark-logg
Spara en rad för varje körning med dessa fält: checkpoint eller modellrevision; runtime och commit; GPU-modell och antal; interconnect; precision och kvantisering; tensor-, expert- eller pipeline-parallell layout; indata- och utdatatokenfördelning; samtidighet och begäranankomstmönster; varmt eller kallt tillstånd; körningens varaktighet; framgångsgrad; aggregerad genomströmning; avkodningshastighet per begäran; TTFT; och p50/p95-svarstid från början till slut.
Denna logg är mer användbar än en leaderboard-siffra eftersom den gör nästa experiment reproducerbart. Frys den innan du justerar. Om arbetsbelastningen eller checkpointen ändras, starta en ny baslinje snarare än att tillskriva skillnaden en serveringsflagga.
Diagnostisera prefill, avkodning, KV-cache eller schemaläggning
Använd symptom för att välja nästa mätning, inte för att gissa på en lösning. Hög TTFT med acceptabel avkodningshastighet pekar mot indatabearbetning, köbildning, cache-missar eller uppstartsomkostnader. Långsam avkodning vid låg samtidighet tyder på att undersöka kernels, minnesbandbredd, parallell kommunikation och modellens exekveringsväg. Aggregerad genomströmning som planar ut när samtidigheten ökar kan indikera minnesbelastning, schemaläggarbegränsningar, kommunikationsomkostnader eller en mättad beräkningsväg. Försämring vid lång kontext kräver mätning av cache-residens, prefill-arbete och värd-till-enhet-förflyttning.
| Observation | Första kontroller |
|---|---|
| TTFT växer med promptlängd | Prefill-hastighet, kötid, prefix-cache-träfffrekvens, graf- eller kompileringsuppvärmning |
| Avkodningshastighet är låg även vid samtidighet 1 | Runtime-modellväg, kernel-stöd, precision, GPU-användning, kommunikationsomkostnader |
| Aggregerade tokens/s planar ut när samtidigheten ökar | KV-cache-kapacitet, schemaläggarbatchning, minnesbandbredd, parallell topologi |
| p95-latens ökar kraftigt medan aggregerad utdata förbättras | Batchstorlek, köpolicy, begärandelängdmix, servicemål |
| Långa prompter vräker ut användbara aktiva begäranden | KV-cache-residens, cache-allokering, kontextfördelning, värdminnestrafik |
V4.1 Flash har arkitektoniska funktioner avsedda att lindra några av dessa påfrestningar. Modellrapporten beskriver CSA2 med återanvändning av cache över lager och FP4 global KV-cachning, vilket ger ett rapporterat globalt KV-avtryck på 890 byte per token, ungefär en fjärdedel av V4-Flashs motsvarande avtryck. SWA Bounded Replay hanterar en annan lagringsavvägning: istället för att bevara allt tillstånd för sliding-window attention kan en distribution rekonstruera saknat tillstånd genom att spela upp det senaste fönstret. DeepSeek rapporterar persistent KV-cache nära en åttondel av V4-Flashs avtryck för denna design, med en liten mängd ytterligare prefill-omberäkning. Dessa är arkitektur- och distributionsresultat, inte ett åttafaldigt genomströmningslöfte. (DeepSeek teknisk rapport, september 2026)
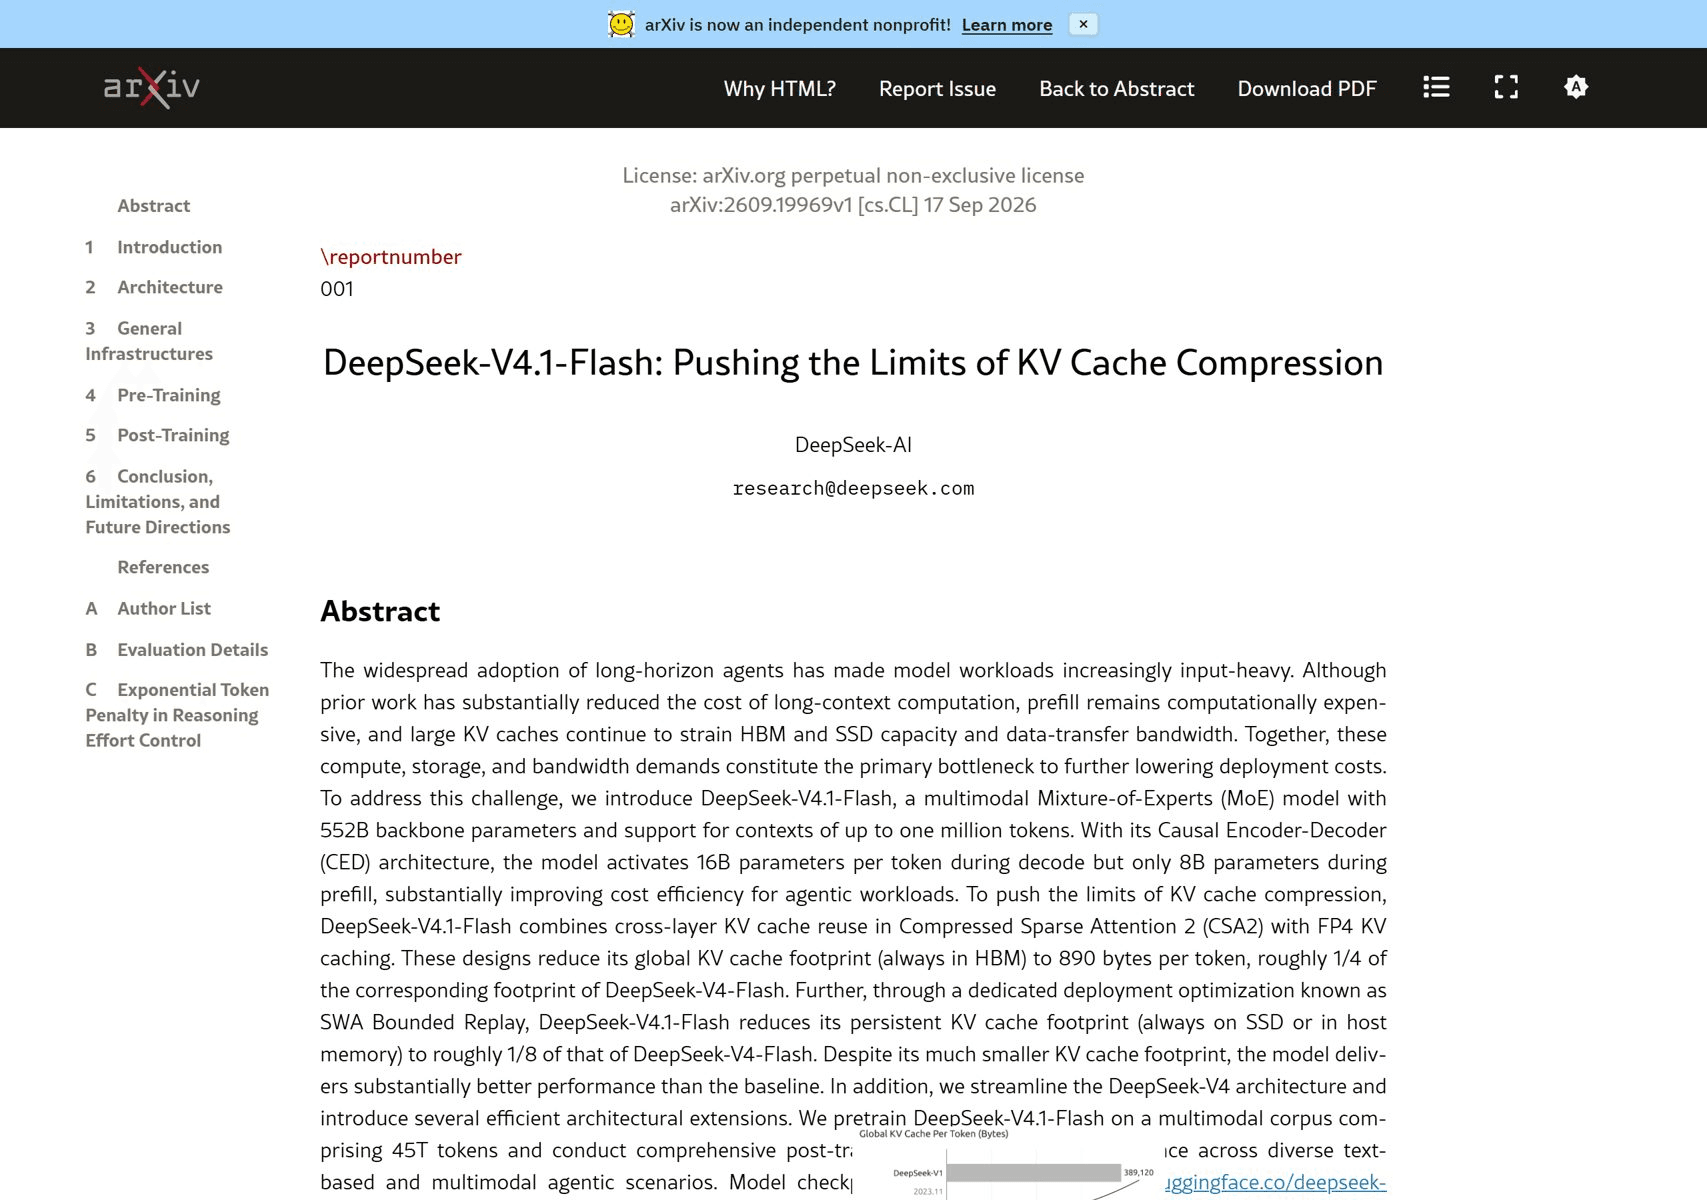
Källfiguren beskriver cache-kapacitet, inte en genomströmningsmultiplikator från början till slut för varje distribution.
När diagnosen är oklar, profiler en representativ körning och inspektera kötid, GPU-användning, minnesanvändning och tidsmätning per steg. Ändra en variabel, kör samma arbetsbelastning igen och kontrollera utdatakorrekthet eller uppgiftskvalitet. Detta förhindrar att en skenbar hastighetsökning maskerar en regression i tjänsten eller svaren.
Justera vLLM eller SGLang mot samma mål
Välj en runtime vars aktuella modellväg stöder den checkpoint och hårdvara du avser att distribuera. Verifiera den exakta utgåvan, kernels, grafbeteende och parallell layout. Att en modell listas som stödd betyder inte att varje kvantisering eller topologi är lika optimerad.
vLLM: validera den utgåvespecifika modellvägen
vLLM-teamets oktoberrapport beskriver en utveckling på deras AgentX-benchmark: cirka 1,9× förbättring i deras låglatensresultat och cirka 5,3× genomströmning under en begränsning på 150 TPS jämfört med deras dag-noll-baslinje. Arbetet inkluderade SWA bounded replay med CUDA-grafer och modellspecifik kernel-integration. Betrakta dessa värden som bevis på att stacken förändrades väsentligt över tid under den benchmarken, inte som multiplikatorer att applicera på ett annat kluster. ( vLLM ingenjörsrapport, oktober 2026)
För din körning, etablera först en stödd utgåva och en känd fungerande konfiguration. Mät sedan graf-capture eller replay-beteende, batchning och parallellism individuellt. Bevara latensbegränsningen som användes för att välja en punkt med högre genomströmning. Om graf-capture ändrar uppstart eller minnesbehov, inkludera dessa kostnader i distributionsbeslutet.
SGLang: matcha dess samtidighetsprofil
SGLang-teamets rapport ger ett ovanligt tydligt exempel på varför testkontext spelar roll. På 8 H200 GPU:er steg deras optimerade körning utan spekulativ avkodning från cirka 76 till 168 tokens/s per användare vid samtidighet ett, och från cirka 96 till 221 utdatatokens/s per GPU vid samtidighet 64. Den använde fasta indata på 8 192 tokens och utdata på 1 024 tokens. Deras separata 4×GB300-resultat använde olika promptlängder, parallellinställningar och DSpark spekulativ avkodning. Rapporten stöder därför utvärdering av SGLangs optimeringar på din trafik, inte en direkt rangordning mot vLLM:s AgentX-siffror. ( LMSYS/SGLang optimeringsrapport, september 2026)
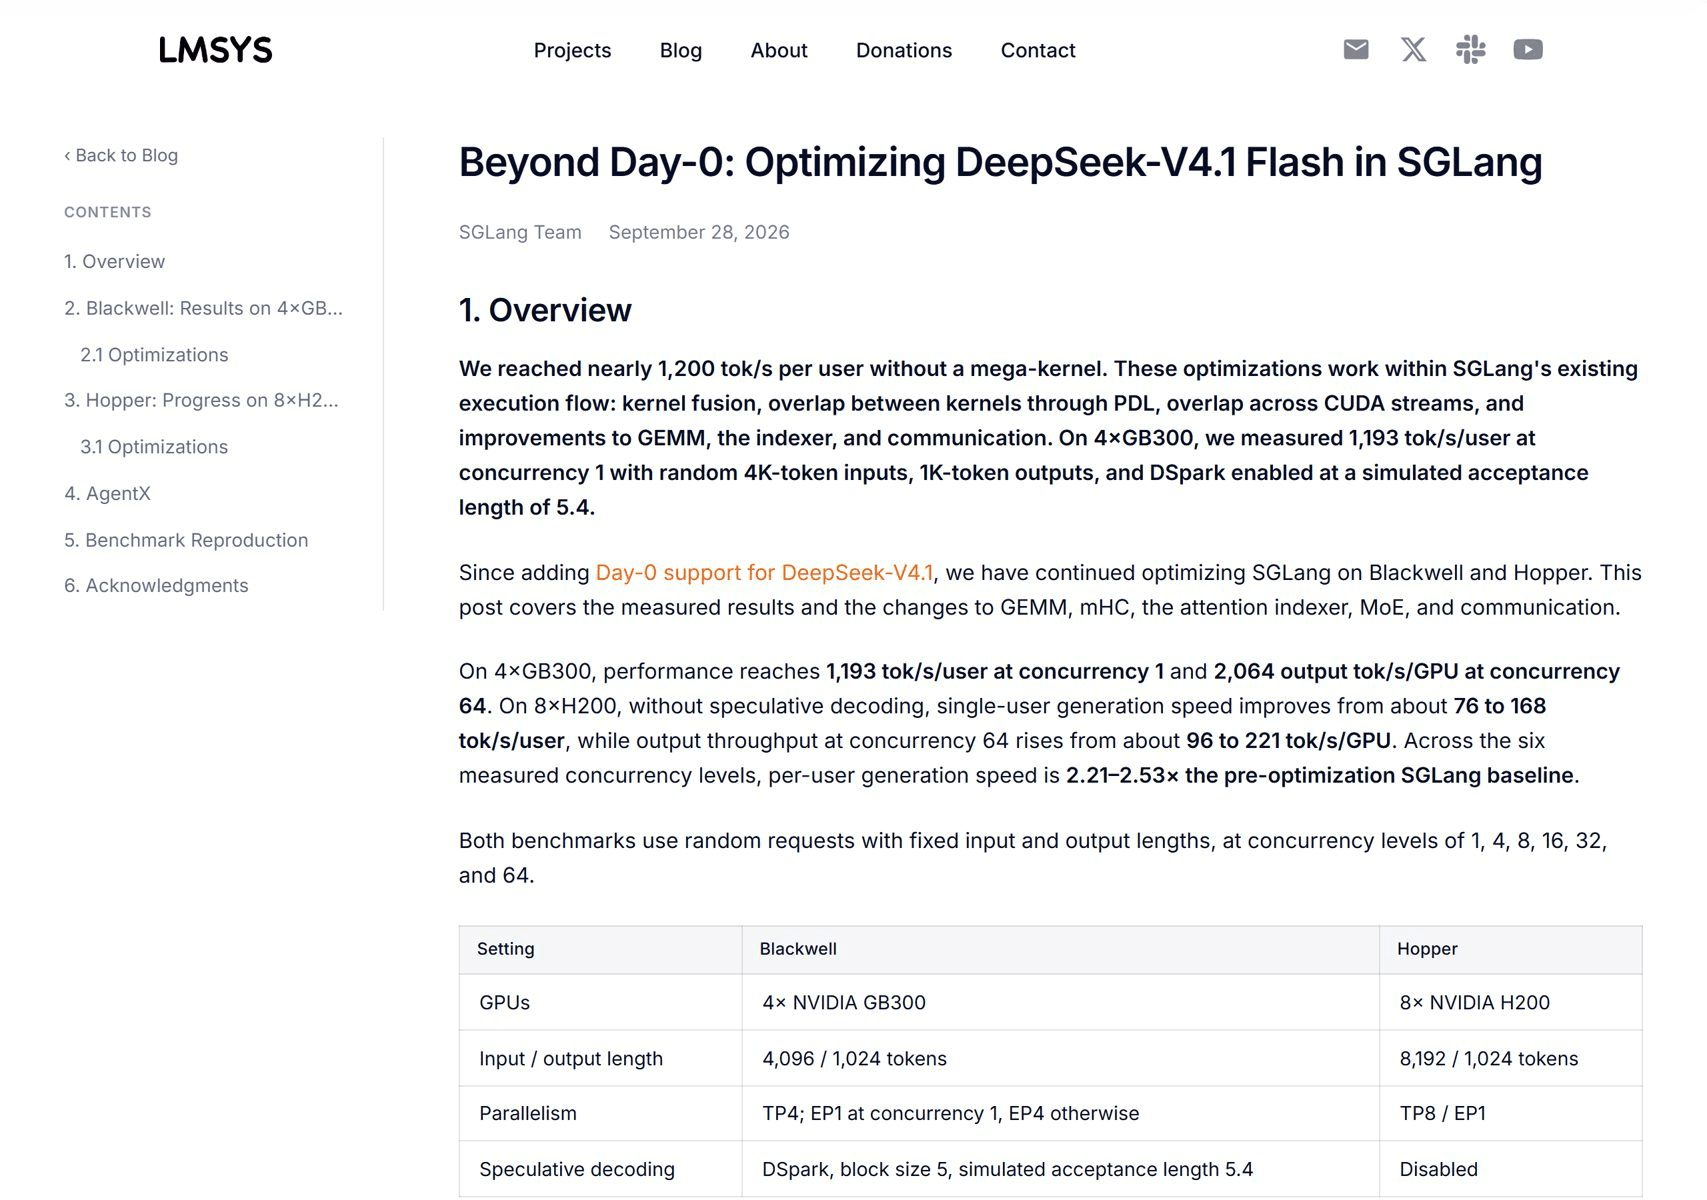
Källrapporterna använder olika arbetsbelastningar och hårdvara; deras siffror bör inte läsas som ett head-to-head-diagram.
Börja med en runtime och optimera dess stödda väg. Bygg bara en jämförelse av en andra runtime om du kan hålla checkpoint, GPU-allokering, prompt- och utdatafördelningar, samtidighet, uppvärmning och servicemål konstanta. Den jämförelsen kostar ingenjörstid, så bekräfta först att den nuvarande stacken faktiskt är den begränsande faktorn.
Optimera samtidighet och lång kontext utan att bryta SLO:n
Öka samtidigheten i steg och fånga aggregerad utdata, avkodningshastighet per begäran, TTFT, p95-latens, minnesanvändning och fel vid varje steg. Behåll endast punkten med högst genomströmning om dess latens och felfrekvens fortfarande uppfyller ditt servicemål. Om begäranden köas före generering kan en större batch förbättra enhetsutnyttjandet samtidigt som produkten känns långsammare.
För långkontexttrafik, mät den aktiva kontextfördelningen och cache-träfffrekvensen. Ett angivet maximalt kontextfönster betyder inte att varje begäran kan servas samtidigt vid den längden. KV-cache konkurrerar om minne med vikter, aktiveringar, grafpöler och runtime-buffertar. Lämna utrymme för varierande begärandelängder och mät eviction eller preemption under realistisk trafik.
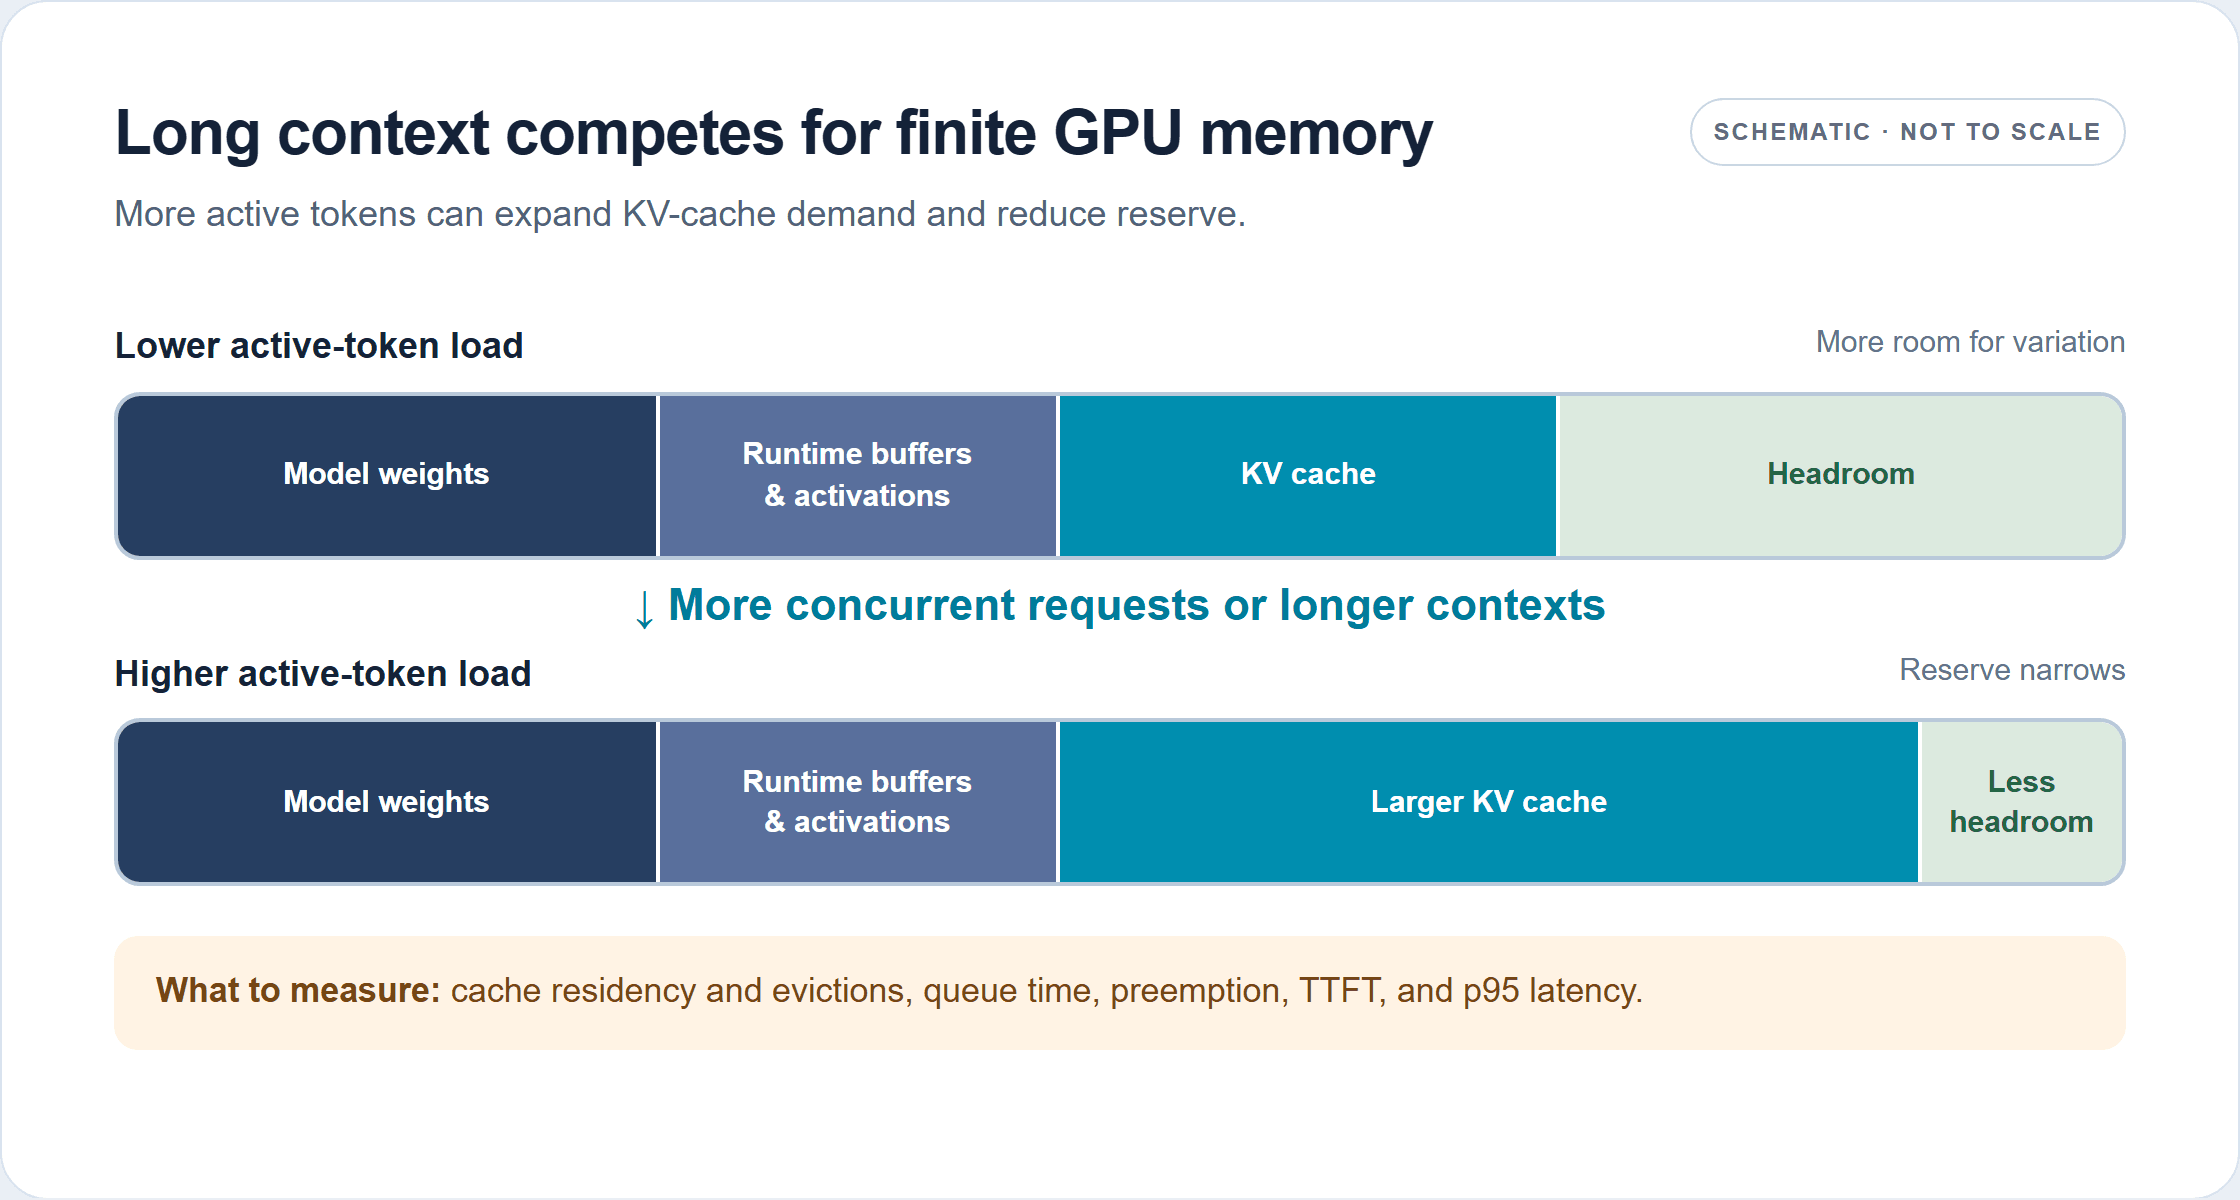
Längre kontexter eller fler samtidiga begäranden kan öka KV-cache-behovet. Minnesblocken är schematiska och inte skalenliga.
Behandla kvantisering, KV-cache-precision, tensor-parallellism, expert-parallellism och prefill/avkodning-disaggregering som separata experiment. De kan ändra minnesanvändning, kommunikation, kernel-val, utdatakvalitet och latens. Den bästa layouten beror på GPU-typ och interconnect; att lägga till fler GPU:er kan öka kommunikationskostnaderna eller lämna vissa resurser oanvända. Verifiera exakt utdatakvalitet och fellägen efter att ha ändrat precision eller modellexekvering.
Den praktiska sekvensen är enkel: reproducera baslinjen, identifiera mätvärdet som inte når sitt mål, formulera en flaskhalshypotes, ändra en inställning och upprepa. Om inställningen förbättrar ett mätvärde men skadar ett annat, avgör explicit om den avvägningen passar produkten. Detta gör optimering till ett kontrollerat beslut istället för en hög med flaggor.
Validera spekulativ avkodning och varje påstådd hastighetsökning
Spekulativ avkodning kan minska seriellt målmodellarbete när utkaststokens accepteras effektivt och runtimemiljön implementerar verifiering väl. Dess fördel beror på utkastvägen, acceptansbeteende, batchform, hårdvara och prompt/utdata-mix. Den kan hjälpa avkodningsbunden trafik och ha litet värde när prefill, köbildning eller kommunikation dominerar.
Kör ett A/B-test med spekulation aktiverad och inaktiverad. Håll modell-checkpoint, promptuppsättning, token-gräns, ankomstmönster, samtidighet, uppvärmning och mätfönster fasta. Registrera accepterade tokens per verifieringssteg om tillgängligt, tillsammans med aggregerad genomströmning, hastighet per begäran, TTFT, p95-latens, GPU-användning, fel och uppgiftskvalitet. En simulerad acceptanslängd i en publicerad benchmark är ett testvillkor, inte ett värde att anta för dina prompter.
En påstådd hastighetsökning är bara användbar om den överlever tre kontroller: samma servicemål, acceptabel svarskvalitet och en rättvis kostnadsjämförelse. Rapportera den fullständiga kontexten med varje siffra du publicerar. Undvik att jämföra olika antal GPU:er, promptlängder, utdatalängder, precisionslägen, modellrevisioner eller mätvärden som om de vore ett kontrollerat experiment.
Självhosta eller använda ett hanterat DeepSeek V4.1 Flash-API?
Självhosting är vettigt när trafiken är tillräckligt stabil för att hålla GPU:erna användbara, teamet kan driva inferensinfrastruktur och kontroll över hårdvara eller exekvering motiverar det operativa arbetet. Inkludera den fulla kostnaden för acceleratorer, kapacitetsutrymme, ström, nätverk, lagring, underhåll och ingenjörstid. Ett högt toppresultat för tokens/s ensamt fastställer inte lägre kostnad per lyckad uppgift.
Ett hanterat API är användbart när ett team snabbt behöver validera produktbehov, undvika att driva en serveringsflotta eller jämföra en API-baslinje med sin egen distribution. Atlas Cloud listar DeepSeek V4.1 Flash under modell-ID:t deepseek-ai/deepseek-v4.1-flash med ett OpenAI-kompatibelt API. DeepSeek V4.1 Flash modellsidan visar för närvarande $0.30 per miljon indatatokens, $1.20 per miljon utdatatokens och $0.03 per miljon cache-lästa tokens, utan rabatt visad i oktober 2026. Kontrollera den aktuella prislistan innan du uppskattar utgifter. En hanterad endpoint tar inte bort behovet av att mäta din egen begäranlatens eller trafikekonomi.
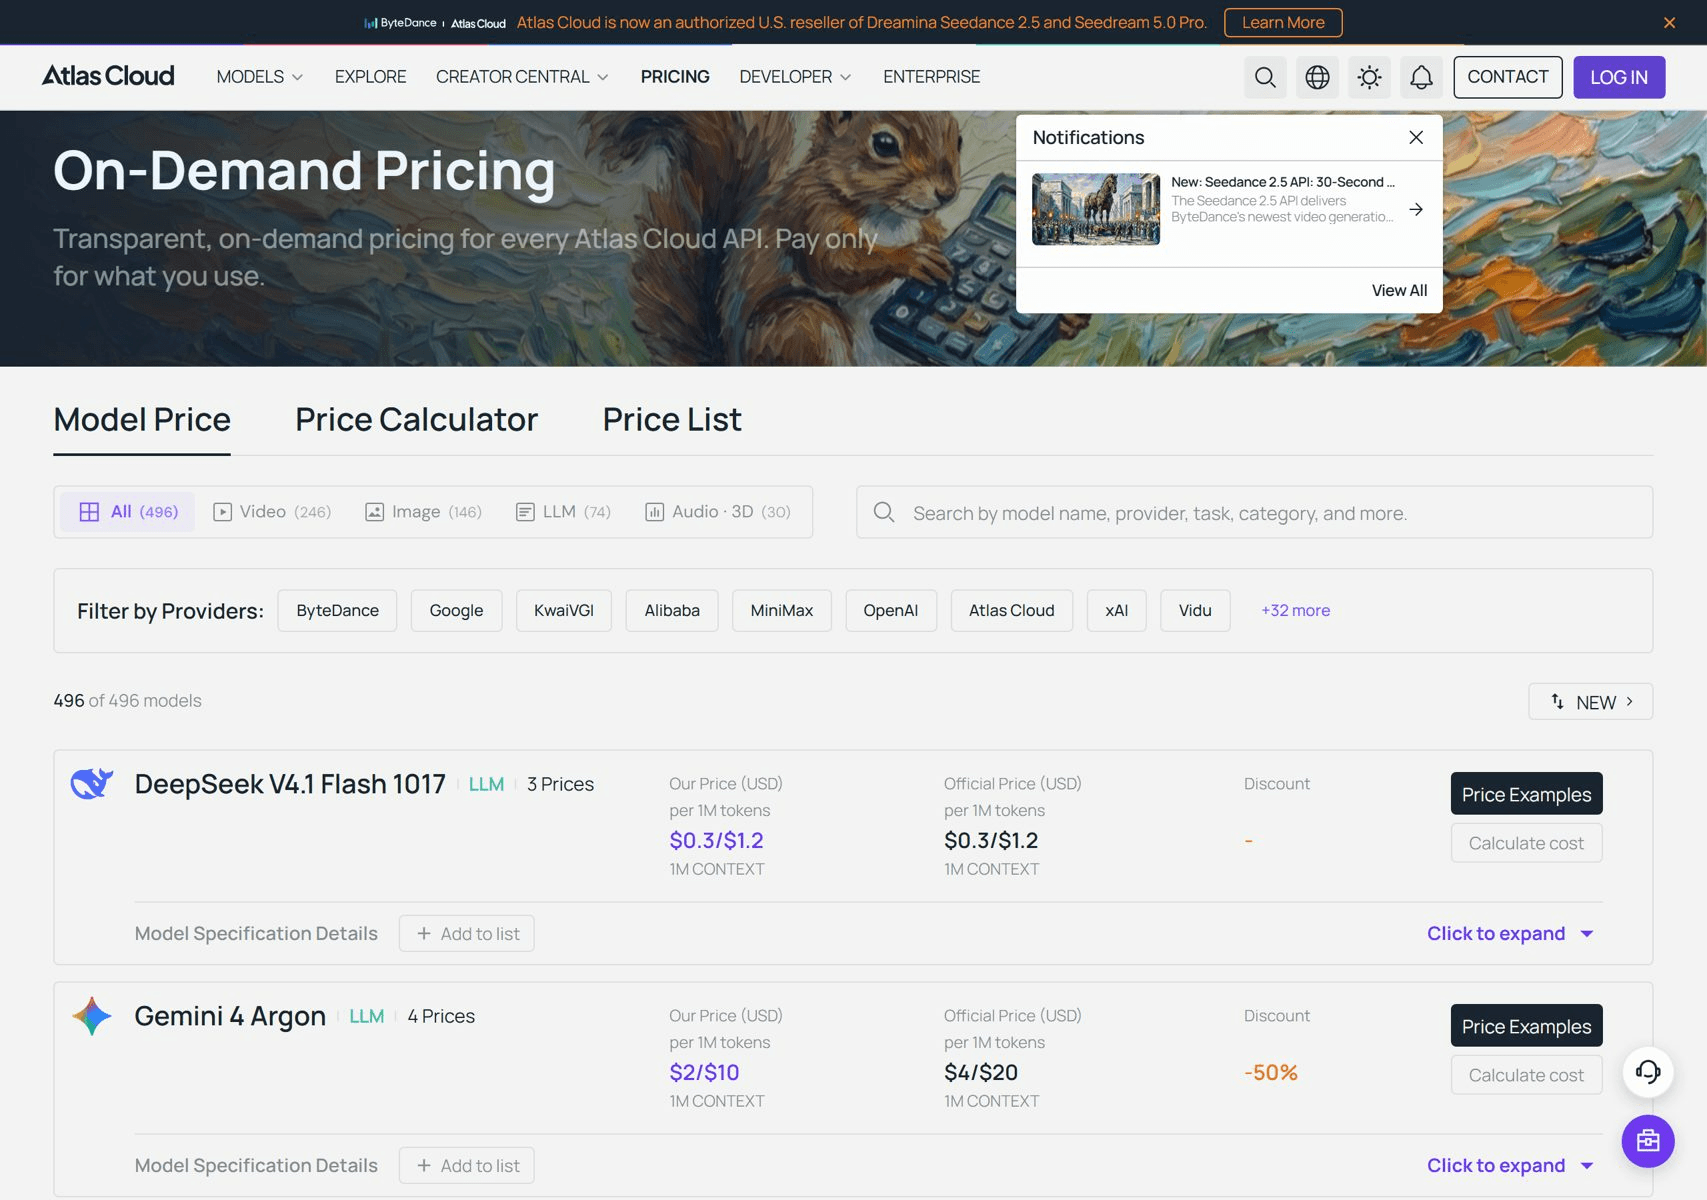
Listningen identifierar ett hanterat API-alternativ; det är inte en serveringsbenchmark.
För ett rättvist distributionsbeslut, spela upp samma affärsbegäranden mot den självhostade tjänsten och den hanterade endpointen. Jämför kostnad per slutförd uppgift, latensfördelning, tillförlitlighet och den personaltid som krävs för att underhålla varje alternativ. Om ditt primära mål är DeepSeek V4.1 Flash inferens-genomströmningsoptimering, behåll samma arbetsbelastning och framgångskriterier för båda vägarna.
Vanliga frågor
Vad är skillnaden mellan genomströmning och tokens per sekund per användare?
Aggregerad genomströmning räknar utdata över aktiva begäranden. Tokens/s per användare mäter en begärans avkodningshastighet. Batchning kan öka det första medan det andra minskar, så rapportera båda för interaktiva tjänster.
Förbättrar ökad samtidighet alltid genomströmningen?
Nej. Aggregerad utdata kan öka tills beräkning eller minne mättas, och planar sedan ut. Köbildning och svanslatens kan fortsätta försämras efter den punkten. Sluta öka samtidigheten när servicemålet misslyckas.
Kan vLLM- och SGLang-benchmarksiffror jämföras direkt?
Endast om modellrevision, hårdvara, prompt- och utdatalängder, samtidighet, varmt tillstånd, mätgräns och latensbegränsning matchar. Publicerade rapporter använder olika uppsättningar, så de demonstrerar optimeringsvägar snarare än en direkt runtime-vinnare.
När bör jag använda ett hanterat API istället för självhosting?
Använd ett hanterat API när integrationshastighet och minskat infrastrukturarbete är viktigare än att äga serveringsstacken. Självhosta när utnyttjandegrad, operativ expertis, kontroll och ett uppmätt totalkostnadsfall motiverar att driva GPU:erna.





