Ett kontextfönster på en miljon tokens säger hur mycket text en modell kan ta emot, inte hur tillförlitligt den tolkar varje klausul. För DeepSeek V4.1 Flash long document analysis accuracy är de offentliga underlagen användbara men ofullständiga: DeepSeeks modellkort rapporterar 45,2 exakt matchning på LongBench-V2 för V4.1 Flash-basmodellen i en 1-shot-inställning, medan API:t sedan dess har flyttats till en nyare 1017-build. Det benchmarkresultatet är en signal om en utvärderingsuppställning, inte en godkännandegrad för ditt avtal, din årsredovisning eller ditt forskningsarkiv.
Det praktiska svaret är att använda Flash för snabb hämtning och första sammanställning, och sedan kräva belägg på sidnivå och mänsklig granskning för beslut som spelar roll. Ingen offentlig källa som citeras här tillhandahåller en reproducerbar utvärdering av aktuell build över de fem dokumentuppgifterna nedan. Testplanen är ett körklart protokoll, inte ett påstående att dessa körningar redan har ägt rum.
Viktiga insikter
- Modellfamiljen stöder upp till 1M tokens, men en kontextgräns är inte en garanti för träffsäkerhet.
- Den publicerade LongBench-V2-poängen 45,2 gäller basmodellen och en 1-shot-benchmarkuppställning.
- DeepSeeks API tillhandahåller nu V4.1-Flash-1017; versionsanteckningarna publicerar ingen ny poäng för långa dokument.
- Be om platser för belägg, kontrollera dem mot källan och mät fel på dina egna dokument.
Vad 1M-tokenfönstret innebär för dokumentanalys
DeepSeeks modellkort beskriver V4.1 Flash som stöd för kontexter upp till en miljon tokens. API-dokumentationen identifierar för närvarande den modell som tillhandahålls som DeepSeek-V4.1-Flash-1017 och anger en kontextlängd på 1M. Det är kapacitetsspecifikationer. De fastställer inte hur ofta modellen hittar en fotnot, håller två dokumentversioner åtskilda eller medger att ett efterfrågat faktum saknas. (DeepSeek modellkort)
En token är inte en sida. Sidantal varierar med tabeller, fotnoter, layout, språk och extraktionskvalitet. En skannad PDF kan behöva OCR; en tabell kan förlora sina radetiketter när den konverteras till text; sidhuvuden och återkommande siddekoration kan förbruka kontext utan att hjälpa frågan. Prompten och det efterfrågade svaret använder också tokens. Ett nominellt tak på en miljon tokens betyder därför inte att varje fil på en miljon tokens kommer fram intakt genom varje chattgränssnitt eller API-klient.
Innan ett test, registrera den exakta modellidentifieraren, klienten och inmatningsmetoden. Kontrollera om hela den extraherade texten skickades, om leverantören trunkerade den och om begäran nådde den förväntade modellversionen. Det aktuella DeepSeek-API:t använder deepseek-flash för den senaste Flash-builden. Om din gateway eller SDK använder ett annat alias, registrera det aliaset och verifiera dess routning. Team som ställer in repeterbara hostade anrop kan börja från Atlas Clouds modellplattform, och sedan öppna dess API-listning för DeepSeek V4.1 Flash.
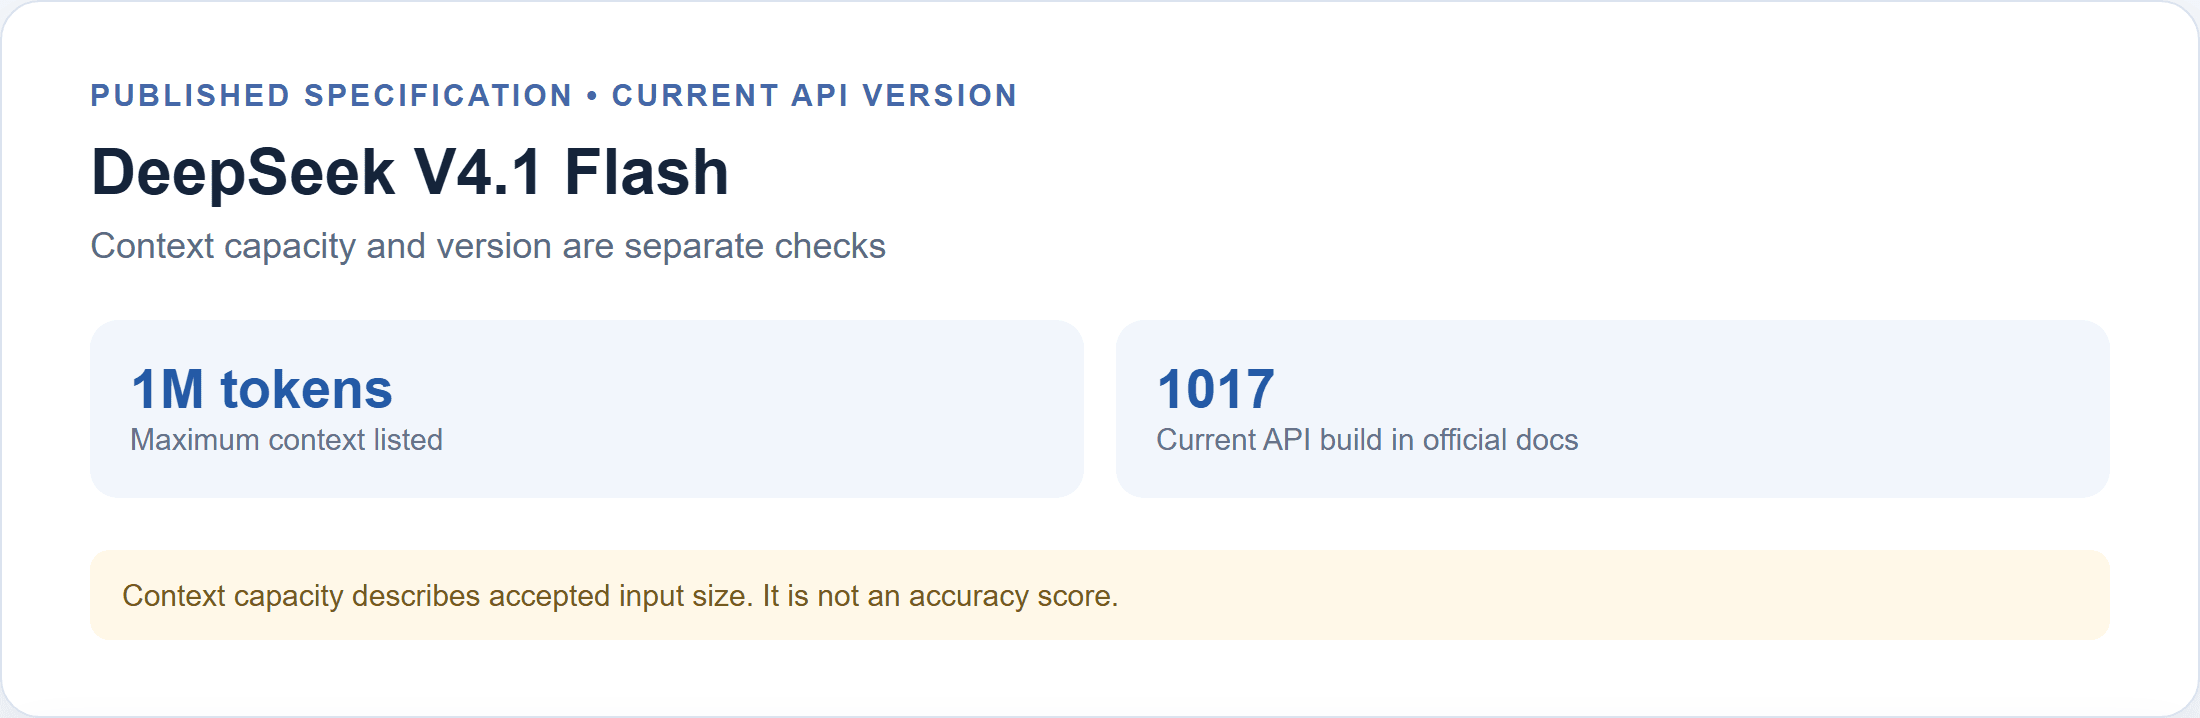
Den publicerade specifikationen anger max 1M kontext; den aktuella API-dokumentationen identifierar 1017-builden.
En lyckad uppladdning eller begäran visar bara att systemet accepterade en indata. För att fastställa att en relevant detalj påverkade svaret, be om en exakt plats, hämta det stycket och bekräfta att den omgivande texten stöder påståendet.
Vad LongBench-V2-poängen visar och inte visar
Modellkortets LongBench-V2-rad rapporterar exact-match-poäng i en 1-shot-inställning. Dess tabell märker resultaten som utvärderingar av basmodeller och säger att alla basmodeller använder samma interna utvärderingsramverk. Den anger också att poäng inom 0,3 anses likvärdiga. Värdena är:
| Basmodell i modellkortet | LongBench-V2 (EM) | Shots |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
Glappet på 0,5 poäng mellan V4-Flash-Base och V4.1-Flash-Base är större än kortets angivna ekvivalensband på 0,3, men det är fortfarande en smal benchmarkjämförelse. 45,2 är inte ”45,2 % träffsäkerhet på långa PDF:er”. Det är en exact-match-poäng för en viss basmodell, benchmarkuppsättning, promptuppställning och utvärderare. Den mäter inte direkt en hostad instruct-/API-modell som besvarar dina frågor med en annan prompt.
LongBench-V2 innehåller 503 flervalsfrågor över sex kategorier, inklusive frågebesvarande för enstaka och flera dokument, lång dialog, kodarkiv och strukturerad data. Dess kontexter sträcker sig från 8 000 till 2 miljoner ord. Benchmarkförfattarna rapporterar 53,7 % genomsnittlig träffsäkerhet för experter inom en 15-minutersgräns, och 50,1 % för den bästa direktsvarande modellen i deras rapporterade utvärdering. Dess bredd gör den till ett användbart stresstest, men ett aggregerat tal kan inte diagnostisera vilken dokumentoperation som är stark eller svag. (LongBench-V2-artikel)
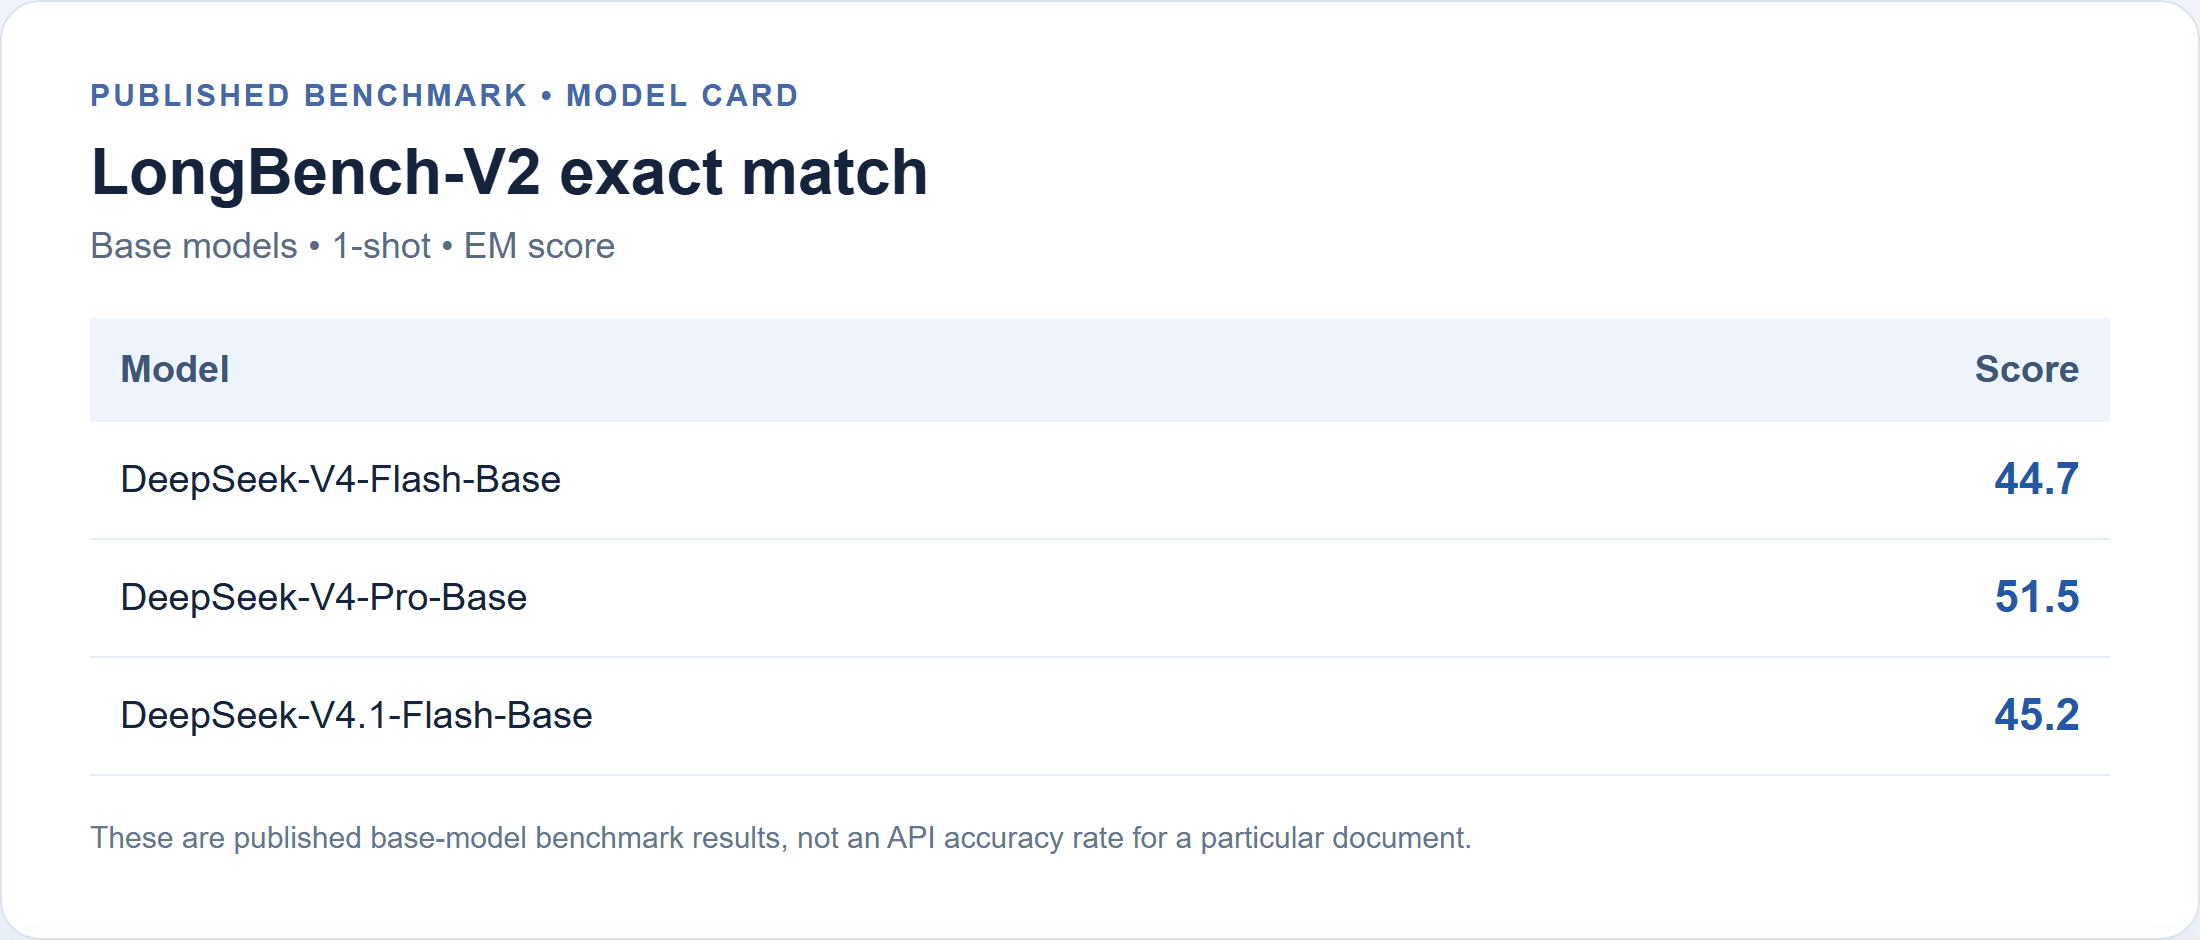
Den publicerade raden är ett 1-shot-resultat för basmodellen. Det är inte en uppmätt godkännandegrad för API:t.
Det finns ett förbehåll om version. DeepSeeks versionsanteckningar från 17 oktober säger att API:t och webbappen har uppgraderats till V4.1-Flash-1017, och API-modellnamnet är fortfarande deepseek-flash. Anteckningarna listar uppdaterade agent- och resonemangsbenchmarks, men rapporterar inte ett nytt LongBench-V2-resultat. Så 45,2 är fortfarande en användbar publicerad referens för V4.1 Flash-basmodellen, medan träffsäkerheten för den aktuella API-builden på långdokumentfrågor förblir okvantifierad i dessa källor. Överför inte orelaterade benchmarkvinster till dokument-QA. (Uppdatering av DeepSeek V4.1-Flash-1017)
Så här kör du ett rättvist träffsäkerhetstest för långa dokument
En användbar utvärdering behöver en fast källa, ett facit och poängsättningsregler. Börja med en offentlig årsredovisning eller teknisk rapport vars version och sidstruktur kan delas. Spara PDF:en och den extraherade texten, registrera käll-URL:en och hämtningsdatumet, och notera om du använde inbyggd textextraktion eller OCR. Undvik att välja ett dokument eftersom du redan vet att modellen hanterar det bra.
Innan du promptar modellen, skriv facit själv utifrån källan. För varje fråga, registrera det förväntade svaret och exakt sida eller avsnitt. Detta förhindrar att ett övertygande svar blir rättningsstandarden. Håll frågorna tillräckligt specifika för att kunna poängsättas, samtidigt som du bevarar den tvetydighet en läsare faktiskt skulle möta.
Använd samma dokument, frågeuppsättning, modellidentifierare, prompt, resonemangsinställning och utdataformat för varje körning. Om API:t exponerar temperatur- eller resonemangsinställningar, registrera dem. Kör uppsättningen mer än en gång om du vill uppskatta variationen; en körning är ett stickprov, inte en stabil frekvens. Reparera inte utdata tyst innan du poängsätter dem.
En kompakt uppsättning kan täcka fem olika felmöjligheter:
| Uppgift | Exempel på frågeformulering | Vad som ska verifieras |
|---|---|---|
| Uppslagning av enstaka uppgift | ”Vilket datum anger rapporten för den reviderade policyn?” | Exakt värde och angiven sida |
| Koppling mellan avsnitt | ”Hur relaterar risken i avsnitt 2 till kontrollen i avsnitt 7?” | Båda styckena och om kopplingen anges eller antas |
| Undantagshantering | ”Vilka är undantagna från den angivna täckningen?” | Fotnot, omfattning och förbehåll |
| Versionskonflikt | ”Vilket värde gäller efter revidering, och vad ersatte det?” | Datum, versionsbeteckningar och båda platserna |
| Saknad information | ”Vilken bevarandetid anger rapporten för leverantörskopior?” | Medgivande om dokumentet inte säger något |
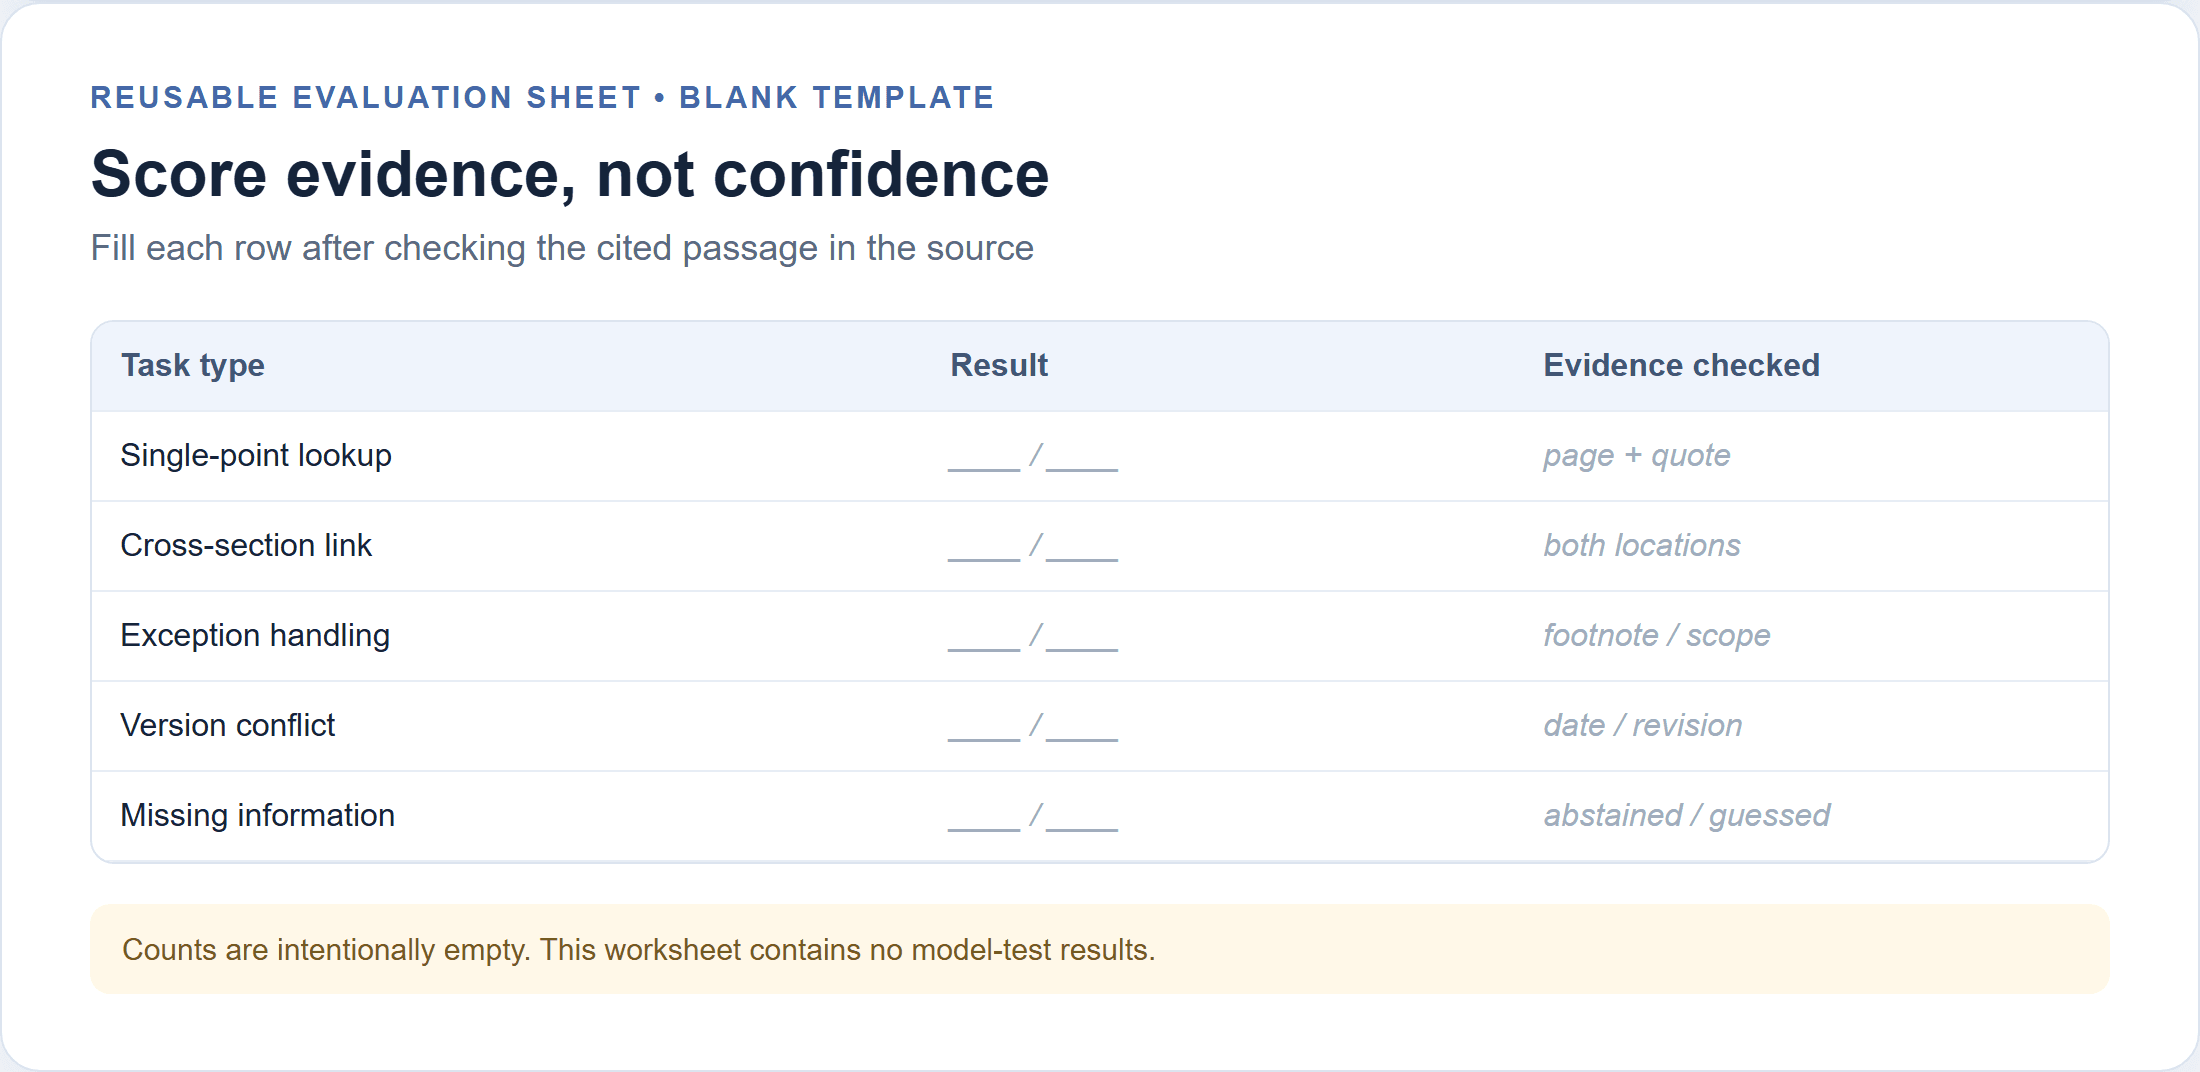
Detta är ett tomt poängsättningsblad, inte en resultattabell. Fyll i det först efter att ha kontrollerat varje svar mot källdokumentet.
Poängsätt varje svar som korrekt, delvis korrekt, fel, utan stöd eller korrekt avstått. Räkna påståenden utan stöd separat från fel svar, eftersom ett svar kan ge rätt huvudsvar och hitta på en detalj. Kontrollera om varje citering pekar på stycket som stöder påståendet. Rapportera antalet frågor och kategorier tillsammans. En övergripande procentandel döljer om modellen missade fotnoter eller hade svårt bara när information var utspridd över avsnitt.
Bevara den exakta källfilen, extraktionen, prompterna, råsvaren och poängsättningsbladet. Publicera endast material som du har tillstånd att dela, och maska konfidentiella namn eller kontouppgifter. En granskare bör kunna spåra varje poängsatt svar från modellens utdata till en sida i den sparade källan.
Var långdokumentsvar tenderar att misslyckas
Utan en körning av aktuell build mot ett angivet dokument skulle det vara fel att påstå att V4.1 Flash uppvisade en viss felfrekvens eller ett visst felmönster. Kategorierna nedan är saker att granska, inte uppmätta resultat om denna modell.
Börja med förlust av omfattning. Ett brödtextstycke kan ange en regel medan en fotnot begränsar den till en region, ett datumintervall eller en kundkategori. Be uttryckligen om undantaget och granska om det citerade stycket inkluderar det. Ett citat från enbart huvudstycket kan vara otillräckligt.
Kontrollera sedan versionsförvirring. Rapporter kan upprepa liknande värden i ett utkast och ett reviderat avsnitt. Be modellen ange datumet eller versionen som är kopplad till varje värde i stället för att bara begära ”det aktuella talet”. Om den väljer ett utan att säga det, poängsätt svaret som ofullständigt även om det råkar välja rätt.
Frågor mellan avsnitt inbjuder till slutledning. En modell kan kombinera två korrekta fakta till en kausal förklaring som dokumentet aldrig gör. Kräv att den märker direkta påståenden separat från slutledningar. Jämför sedan slutledningen med beläggen och avgör om den är rimlig för uppgiften.
Testa slutligen förmågan att avstå. Inkludera en fråga vars svar saknas. En säker gissning är ett misslyckande även om den låter rimlig. För avtal, efterlevnad, kliniskt material eller konsekvensbärande finansiell analys, be en kvalificerad person kontrollera originaltexten innan en slutsats används.
Ett verifieringsarbetsflöde för säkrare svar
Denna prompt gör svaren lättare att granska. Den kan inte garantera korrekthet eller ersätta källgranskning. Använd den med en extraktion som bevarar sidetiketter, och ställ sedan fokuserade frågor i stället för att begära en allmän sammanfattning av en enorm fil.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
För en lång rapport, dela upp arbetet efter uppgift, inte automatiskt efter godtyckligt sidantal. Be först om en källkarta: avsnittstitlar, datum, definierade termer och relevanta tabeller. Fråga sedan om ett specifikt ämne och begär dess stödjande stycken. För en slutsats mellan avsnitt, tillhandahåll eller hämta båda styckena i samma tur och be modellen förklara kopplingen medan den markerar eventuella slutledningar.
Använd en mänsklig verifieringsloop:
- Kontrollera den citerade sidan och citatet i originalfilen.
- Bekräfta att citatet inkluderar angränsande undantag och tabellrubriker.
- Markera varje påstående som direkt, slutlett, utan stöd eller motsagt.
- Åtgärda prompten eller dela upp uppgiften om extraktionen utelämnade viktig struktur.
- Spara den råa begäran och responsen så att en granskare kan reproducera beslutet.
När du använder en hostad endpoint, inkludera tokenanvändning i körloggen. Atlas Clouds modellprissida listar för närvarande DeepSeek V4.1 Flash till $0.30 per 1M indatatokens, $1.20 per 1M utdatatokens och $0.03 per 1M cache-lästa tokens, utan listad rabatt. Kontrollera aktuell listning innan du budgeterar. Denna prisreferens gäller Atlas Cloud, inte ett universellt pris för DeepSeek API.
Vid dessa listade priser kostar 100 000 icke-cachade indatatokens och 3 000 utdatatokens cirka $0.033: $0.030 för indata plus $0.0036 för utdata.
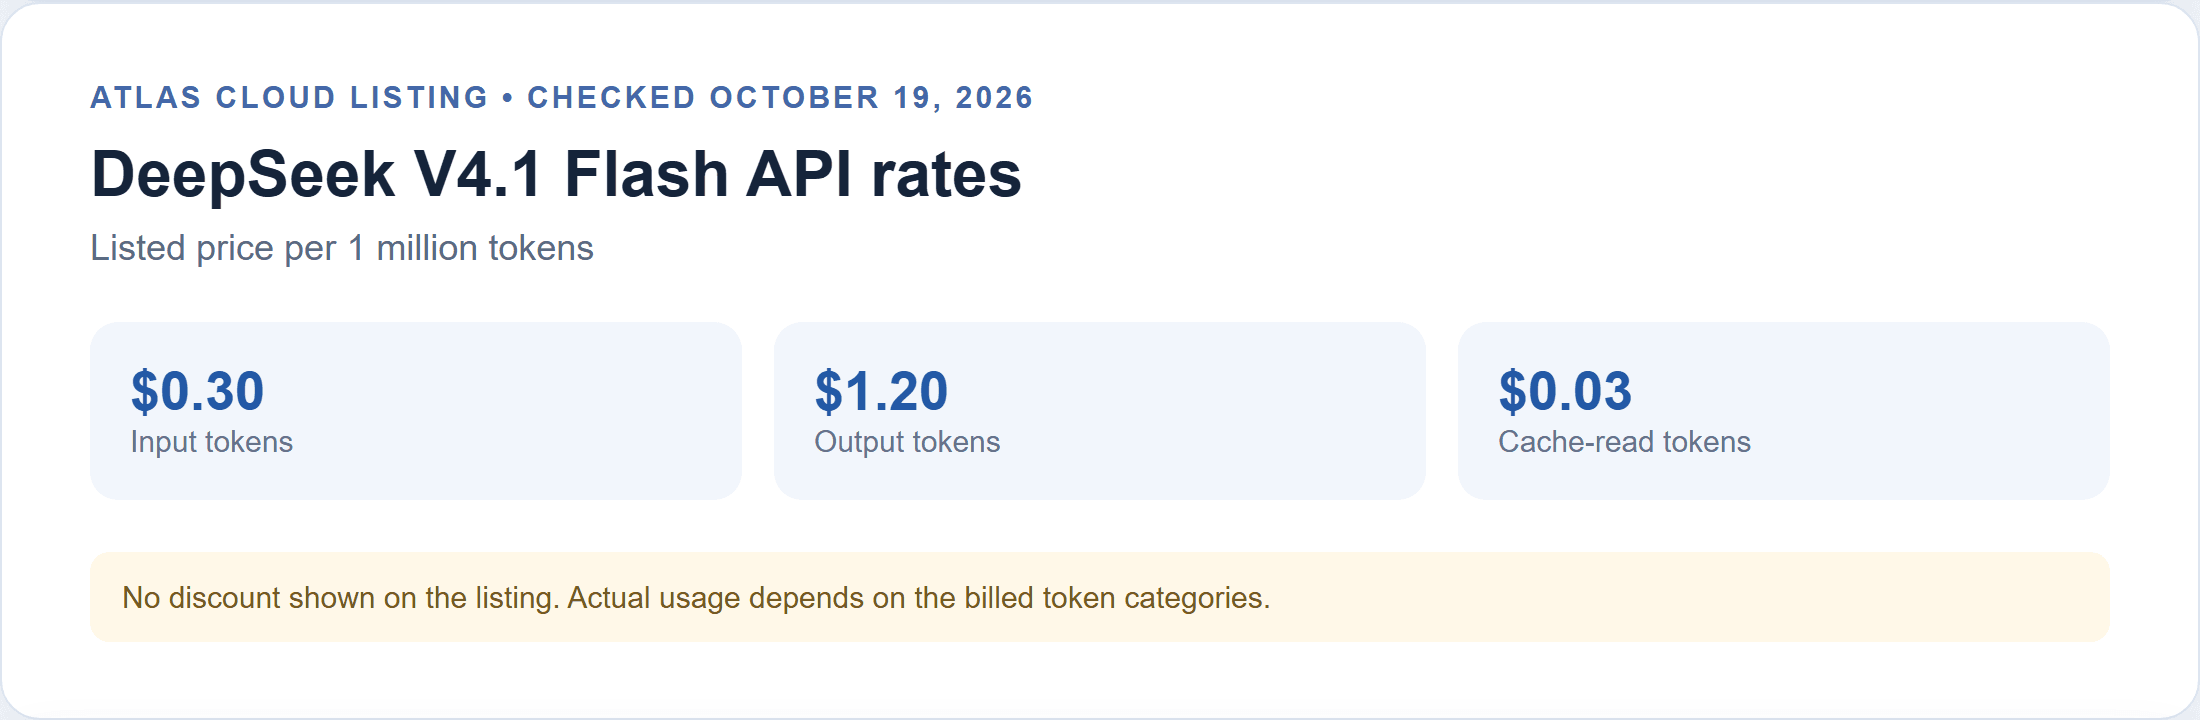
Atlas Cloud-priser kontrollerade 19 oktober 2026; listningen visar ingen rabatt. En indata på 1M tokens och ett svar på 20 000 tokens skulle kosta cirka $0.324 vid samma priser, före cachehantering eller andra debiterbara poster. Detta är räkneexempel, inte uppmätta dokumenttestkostnader. Faktisk indata inkluderar prompten och den extraherade texten; upprepade anrop ökar användningen. Använd leverantörens returnerade tokenantal i stället för att uppskatta från sidantal.
När du bör använda DeepSeek V4.1 Flash för långa dokument
Flash är en rimlig första genomgång när du behöver hitta definitioner, samla datum, skapa en avsnittskarta eller utforma en sammanfattning som en person kommer att kontrollera. Dessa uppgifter har synliga beviskedjor och är lätta att köra igen med snävare frågor. För återkommande arbete, behåll frågor med kända svar och kör dem igen när modellversionen, extraktionspipelinen eller prompten ändras.
Lägg till kontroller när en fråga kombinerar avlägsna avsnitt, är beroende av en fotnot eller jämför revisioner. Använd citeringar som navigationshjälpmedel, inte som bevis i sig. Om ett svar kommer att påverka en avtalsförpliktelse, efterlevnadsställning, finansiell upplysning eller ett annat beslut med stor påverkan, låt en kvalificerad granskare verifiera varje väsentligt påstående i källan.
Den användbara frågan är om denna modell, på din version av dokumentet och i ditt exakta arbetsflöde, returnerar svar med belägg som klarar granskning. Det är testet som kan fastställa DeepSeek V4.1 Flash long document analysis accuracy för ditt eget användningsfall.
Vanliga frågor
Innebär ett kontextfönster på 1M tokens att en modell kan analysera ett dokument på 1M tokens korrekt?
Nej. Det beskriver stödd kontextkapacitet. Den faktiska begäran inkluderar även instruktioner och utdatabudget, medan extraktion, gränssnittsbegränsningar och frågans svårighetsgrad påverkar om användbara belägg finns tillgängliga och tolkas korrekt.
Är LongBench-V2 samma sak som träffsäkerhet för dokumentfrågebesvarande?
Nej. Det innehåller flera kategorier av långkontextuppgifter och rapporterar prestanda under en specifik uppställning. Det är en jämförelsesignal, inte en garanti för en viss PDF, API-build, prompt eller domän.
Bör jag använda en prompt eller dela upp ett långt dokument i avsnitt?
Använd en källkarta och fokuserade frågor när strukturen spelar roll. Håll stycken som måste jämföras tillgängliga tillsammans för syntessteget, och bevara sidetiketter så att du kan verifiera svaret.
Hur bör jag verifiera citeringar från en AI-genererad sammanfattning?
Öppna varje citerad sida i originalfilen, kontrollera citatet och den omgivande texten, och bekräfta att stycket stöder det specifika påståendet. Verifiera tabellrubriker och fotnoter samt den citerade meningen.
Hur påverkar indata- och utdatatokens kostnaden?
Indatatokens täcker dokumentet, instruktionerna och frågan. Utdatatokens täcker svaret. Längre prompter, flera anrop och upprepade stycken ökar användningen; använd debiterade tokenantal och leverantörens aktuella pristabell för uppskattningar.


