

En utvecklare ser "1M tokens" och förbereder sig på att skicka ett helt kodarkiv, dess ärendehistorik och en lång designrapport i en enda begäran. Den viktiga detaljen i gemini 4 Argon 1M-kontextfönster är att 1 048 576 tokens delas av indata, tänkande och utdata. Det är inte en miljon indatatokens plus ytterligare en miljon för svaret. Google anger en standardgräns för synkron utdata på 65 536 tokens, medan lång avkodning kan förlänga genereringen upp till den återstående delade kapaciteten. Googles modellspecifikation anger gränserna; den här guiden omvandlar dem till en budget och ett beslut om lång kontext, hämtning och chunkning.
Viktiga lärdomar
- Kontexten på 1 048 576 tokens är en kombinerad budget för indata, tänkande och utdata.
- Standardutdata för synkron generering är begränsad till 65 536 tokens; lång avkodning tillför inte mer kontext.
- Använd lång kontext när relationer mellan en känd källuppsättning är viktiga; använd hämtning eller chunkning när de inte är det.
Vad innebär Gemini 4 Argons 1M-kontextfönster?
Budgeten på 1 048 576 tokens delas
Ett kontextfönster är den tokenbegränsning som är tillgänglig för en begäran. För Argon dokumenterar Google en enhetlig total på 1 048 576. Prompten, bifogat källmaterial, tänkandetokens och det genererade svaret dras från denna tilldelning. Det beskriver kapacitet, inte ett löfte om att varje detalj blir lika lätt att hämta eller resonera kring.
Om en begäran innehåller 900 000 källtokens återstår högst 148 576 för tänkande och utdata, före gränssnittsspecifika begränsningar. Ett program som antar att det sedan kan begära ett svar på 200 000 tokens har överskridit samma budget.
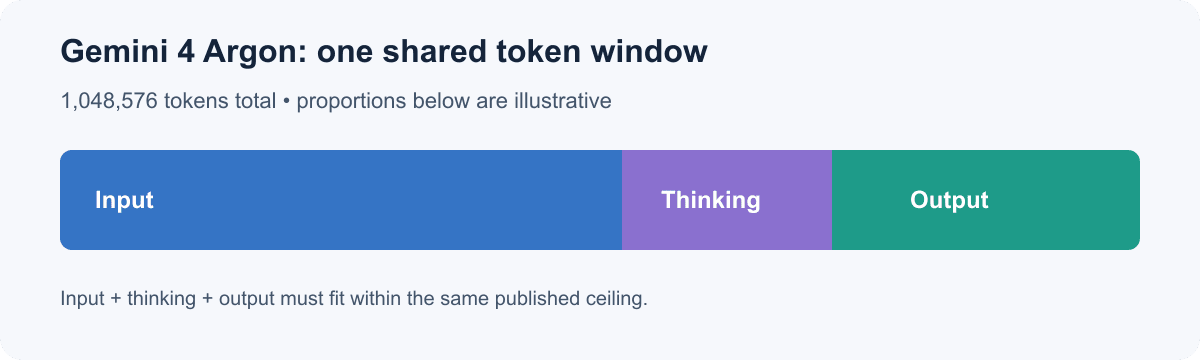
Det publicerade fönstret är ett gemensamt tak. Segmentstorlekar är begreppsmässiga, inte en fast fördelning.
Indata, tänkande och utdata dras från ett fönster
En användbar planeringsekvation är:
input tokens + thinking tokens + output tokens <= 1,048,576
Detta är en budgetkontroll, inte ett påstående att utvecklare kan ange ett exakt antal tänkandetokens för varje anrop. Google listar tänkandeinställningarna låg, medel och hög; den interna förbrukningen kan variera beroende på uppgift och inställningar. Reservera utrymme för resonemang i stället för att behandla den teoretiska återstoden som garanterad svarskapacitet.
Argon accepterar indata i form av text, bild, video, ljud och PDF, med textutdata. Mediaräkning motsvarar inte vanlig text, så ett antal filer eller sidor kan inte tillförlitligt förutsäga det totala antalet tokens. Granska användningsmetadata från en representativ begäran.
Kontextfönster kontra utdatagräns: den avgörande skillnaden
Standardgränsen för utdata
Modellsidan anger en maximal utdata på 65 536 tokens för standardmässig synkron generering, ungefär en sextondel av det totala fönstret. En begäran kan rymmas inom den övergripande kontextgränsen och ändå överskrida den aktiva utdatagränsen.
För många program är standardvärdet tillräckligt. En granskning av ett kodarkiv eller en dokumentsammanställning behöver vanligtvis ett fokuserat svar, inte ett svar som är lika långt som källuppsättningen. En begränsad utdata är enklare att granska, lagra och skicka vidare till ett annat steg.
Vad lång avkodning förändrar
Lång avkodning stöder mycket längre generering, upp till 1 048 576 tokens enligt modellspecifikationen. Den utökar inte det totala fönstret. Om prompten redan upptar större delen av det återstår mindre kapacitet för tänkande och utdata. API-vägen, SDK:n, begärans inställningar och svarshanteringen spelar också roll, så kontrollera den aktuella integrationsvägledningen innan du förlitar dig på ett långt svar i produktion.
Använd lång avkodning endast när leveransen verkligen behöver omfattande genererat material, till exempel en stor strukturerad transformation som returneras i en enda operation. Om svaret kan delas upp i validerade avsnitt kan stegvis generering göra ofullständiga resultat enklare att upptäcka och återställa.
Så budgeterar du indata-, tänkande- och utdatatokens
Börja med leveransen och uppskatta sedan källtokens med den valda modellens räkningsväg där sådan finns. Räkna även med instruktioner, verktygsresultat, schematext och konversationshistorik. Reservera en marginal för tänkande och uppskattningsfel i stället för att spendera den teoretiska återstoden.
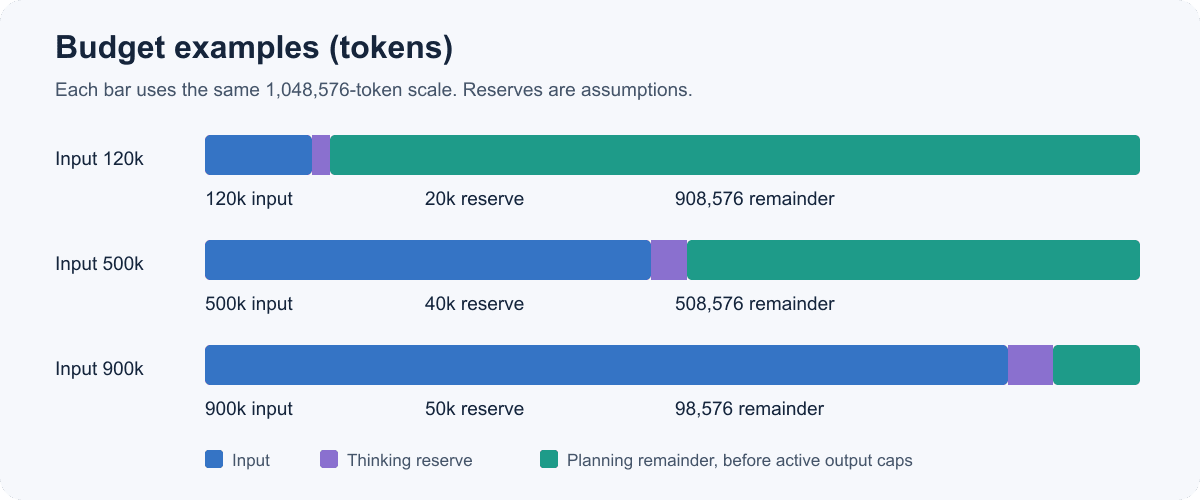
Siffrorna nedan är aritmetiska exempel, inte fast resonemangsförbrukning. "Planeringsåterstod" är summan efter antagen indata och reserverad tänkandetilldelning. Faktiska tjänstegränser gäller fortfarande.
| Antagen indata | Tänkandereserv | Planeringsåterstod för utdata | Exempel |
|---|---|---|---|
| 120 000 | 20 000 | 908 576 | Flera manualer, kortfattad sammanställning |
| 500 000 | 40 000 | 508 576 | Granskning av kodbas med filreferenser |
| 900 000 | 50 000 | 98 576 | Arkivjämförelse med ett begränsat svar |
Illustrativ aritmetik från ett tak på 1 048 576 tokens; reserver är planeringsantaganden.
Använd denna checklista för begäransplanering:
- Indata: uppskattade käll- och prompttokens.
- Tänkande: reservera kapacitet utifrån uppgiftens komplexitet och inställningar som stöds.
- Utdata: välj en gräns som passar leveransen.
- Kontroll: summera de tre mängderna och lämna utrymme för uppskattningsfel.
- Väg: bekräfta att den valda slutpunkten eller SDK:n stöder utdatalängden och fortsättningsbeteendet.
För en granskning av en kodbas på 500 000 tokens kan ett team reservera 40 000 tokens för tänkande och sikta på ett svar på 25 000 tokens. Den planen använder 565 000 tokens på papper och lämnar utrymme för ofullkomliga uppskattningar eller extra instruktioner. Teamet bör ändå verifiera faktisk användning och konfigurerade genereringsgränser. Reserven är ett planeringsverktyg, inte en förutsägelse av privat resonemang.
Innan en batchkörning, ta ett urval av mer än en typ av begäran. En kort dokumentationssida, en kodtung modul och en PDF med tabeller kan ge olika tokenantal även när filstorlekarna verkar lika. Räkna representativa indata och jämför sedan uppskattningar med användning som returneras av API:t. Om modellens faktiska rapportering av tänkande eller utdata skiljer sig från dina antaganden uppdaterar du reserven och gränsen innan du ökar batchstorleken. Detta lilla kalibreringssteg hjälper till att hålla ett långkontextarbetsflöde inom sin token- och budgetram.
Vad får plats i en miljon tokens?
Dokument, kod och multimodalt material
En miljon tokens kan göra analys i ett svep rimlig för en uppsättning manualer, flera kontrakt, en stor källträdstruktur eller en lång transkription med anteckningar. Google har använt grova illustrationer som omkring 1 500 sidor text eller 30 000 rader kod. Betrakta dessa som skalaexempel, inte garantier. Layout, kodtäthet, språk, formatering och tokenisering påverkar alla antalet.
För arbete med kodarkiv bör du inkludera byggfiler, genererad kod, kommentarer, beroendemetadata, tester och relevant ärendekontext i uppskattningen. Fråga sedan om uppgiften behöver allt. En arkitekturgranskning över flera moduler kan dra nytta av en bred källuppsättning; en fråga om ett felmeddelande gör det förmodligen inte.
Multimodala indata komplicerar också uppskattningarna. En videos varaktighet, sampling av bildrutor, ljud, upplösning och API-hantering kan påverka användningen och de underlag modellen ser. För en smal fråga, inkludera endast relevant media och granska användningen från en representativ begäran innan du skalar upp.
Tokenantal är inte sidantal
En token är en modellbearbetningsenhet, inte ett ord, tecken, en sida eller en rad. Identifierare, tabeller, källkod och icke-engelsk text kan tokeniseras annorlunda än vanlig prosa. En siduppskattning kan inte säga om just din samling får plats.
Kapacitet skiljer sig också från kvalitet. Att en källuppsättning får plats bevisar inte att modellen hittar varje dolt undantag, bevarar varje beroende eller löser motstridiga avsnitt korrekt. Specifikationen fastställer en gräns, inte uttömmande återkallning eller en uppgiftsspecifik träffsäkerhetspoäng. För viktiga slutsatser bör du begära källhänvisningar och validera viktiga påståenden mot originalen.
När ett 1M-fönster hjälper, och när det inte gör det
Lång kontext är mest användbart när ett svar beror på relationer utspridda i material som en enkel fråga kanske inte hämtar. Det är mindre övertygande för upprepade smala frågor mot en föränderlig korpus, där hämtning kan välja en mindre uppsättning underlag. Detta är avvägningar i arbetsflödet, inte en universell rangordning av träffsäkerhet.
| Metod | Överväg den när | Avvägning |
|---|---|---|
| Långkontextbegäran | En engångsanalys behöver relationer mellan en känd källuppsättning | Stora indata kan öka kostnad och latens; verifiera täckning |
| Hämtning | Användare ställer upprepade frågor mot en föränderlig korpus | Indexering och hämtning avgör vilket underlag som når modellen |
| Chunkning | Dokument kan bearbetas som oberoende enheter eller steg | Relationer mellan chunkar behöver stämmas av |
| Hybrid | Du behöver bred orientering följt av fokuserade underlagskontroller | Mer orkestrering och tillståndshantering |
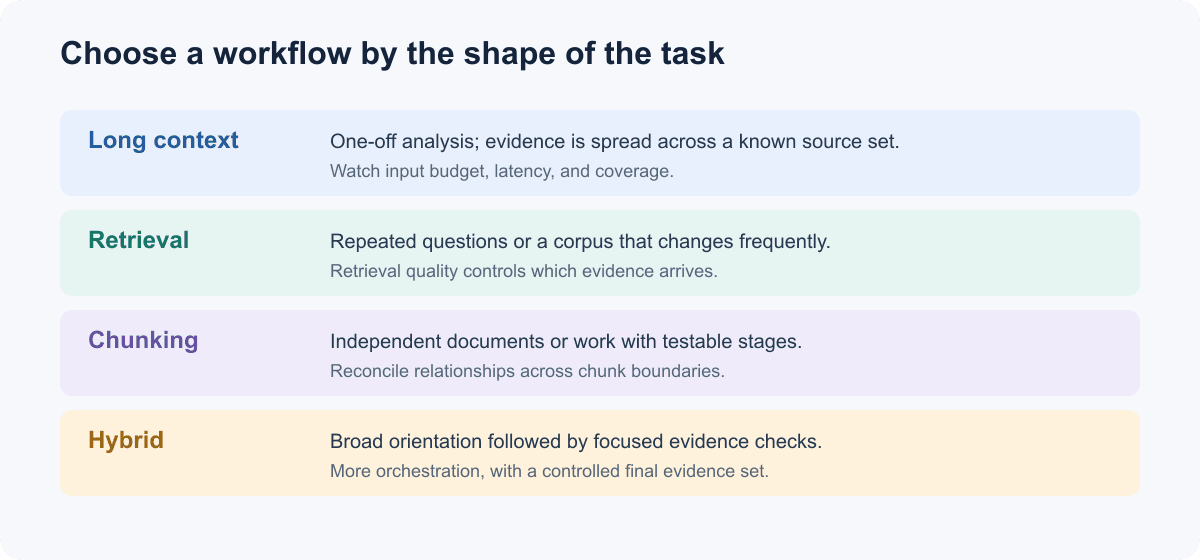 Välj utifrån uppgiftens form och frågemönster och validera sedan på representativa indata.
Överväg lång kontext för att jämföra policyer vars klausuler påverkar varandra, granska en ändring över många mjukvarumoduler eller sammanställa dokument där en detalj i en källa ändrar tolkningen av en annan. Hämtning passar för upprepade supportfrågor mot en växande kunskapsbas. Chunkning fungerar när källenheterna är oberoende eller varje steg har en testbar utdata. Ett hybridarbetsflöde kan kartlägga samlingen först och sedan hämta och verifiera avsnitt för ett slutligt svar.
Utvärdera alternativen mot samma representativa frågor. Följ upp om nödvändigt underlag ingick, om citeringar pekar på rätt avsnitt, tokenanvändning, svarstid och återställningsinsats efter ett ofullständigt svar. Det ger teamet underlag för sin arbetsbelastning i stället för att anta att ett större fönster automatiskt förbättrar den.
Använda Gemini 4 Argon för långkontextuppgifter
Bekräfta modell-ID och begärans väg
Google listar Gemini API:s modell-ID som gemini-4-argon. Bekräfta att det är aktiverat för ditt konto och att den exakta API-ytan stöder de funktioner du behöver. Samma modellnamn garanterar inte att varje proxy, SDK, konsol eller klient exponerar identiska gränser eller beteende för lång avkodning.
Innan produktion, verifiera:
- Modell-ID och tillgänglighet för ditt konto eller din region.
- Gränsen för synkron utdata och hur lång avkodning begärs eller returneras.
- Om SDK:n hanterar fortsättning och hur den rapporterar partiella eller misslyckade svar.
- Tänkandeinställningar, verktyg, cachelagring och modaliteter som stöds för det valda API:t.
- Begärans faktiska fält för indata- och utdataanvändning.
Googles guide för lång kontext beskriver den enhetliga budgeten. Dess SDK- och API-vägledning kan ändras, så lås en SDK-version som stöds, granska det aktuella exemplet och integrationstesta samma transport och svarshantering som planeras för produktion. Kopiera inte parameternamn från en äldre modellintegration utan att kontrollera att de fortfarande gäller.
Gör utdatakontraktet mindre än källuppsättningen
Ge modellen en avgränsad uppgift och svarsform. För en granskning av ett kodarkiv, begär fynd grupperade efter allvarlighetsgrad med filsökvägar och radhänvisningar, och ange om hypoteser ska inkluderas eller endast bekräftade defekter. För en kontraktsjämförelse, namnge klausulerna och begär avsnittsidentifierare eller korta stödjande utdrag. Detta är enklare att granska än "analysera allt". För stora svar, planera för fortsättning och partiellt slutförande. Bevara identifierare och svarschunkar när SDK:n exponerar dem, validera strukturerad utdata före användning nedströms och försök bara igen med den misslyckade delen när det är möjligt. Detta är skyddsåtgärder att implementera och verifiera, inte ett påstående att varje SDK hanterar avbrott på identiskt sätt.
Priser och åtkomst: vad du bör verifiera innan du kör
Googles tillkännagivande listar för närvarande introduktionspriser på $2 per miljon indatatokens och $10 per miljon utdatatokens fram till den 30 november 2026, följt av angivna priser på $4 och $20 per miljon. Detta är tidskänsligt: kontrollera igen Googles officiella tillkännagivande om Gemini 4 Argon innan du publicerar eller prognostiserar utgifter. Uppskatta indata och utdata separat eftersom prompttunga och genereringstunga arbetsbelastningar har olika kostnadsprofiler.
Tillgänglighet för Argon via Atlas Cloud bekräftas inte på de katalogsidor som kontrollerades för den här artikeln. Atlas Gemini-modellkatalogen visar de Gemini-modeller och åtkomstdetaljer som för närvarande listas där; den fastställer inte att Argon är tillgänglig. Bekräfta en modellspecifik detaljsida, protokoll och pris innan du dirigerar begäranden eller jämför kostnader.
Börja med en representativ begäran och registrera modell- och SDK-versioner, tokenanvändning, latens, fel och uppgiftsspecifika kvalitetskontroller. Se över budgeten och valet av hämtning när källuppsättningar eller frågemönster ändras. Gemini 4 Argon 1M-kontextfönster är användbart när dess bredd löser ett verkligt källöverskridande problem och din begäran har en tydlig budget och verifieringsplan.
Vanliga frågor
Delas Gemini 4 Argons 1M-fönster av indata och utdata?
Ja. Google definierar ett enda fönster på 1 048 576 tokens som delas av indata, tänkande och utdata. Mängden som återstår för ett svar beror på begäran och tillämpliga gränssnittsbegränsningar.
Vad är Gemini 4 Argons standardgräns för utdata?
Specifikationen anger 65 536 tokens för standardmässig synkron utdata. Lång avkodning kan stödja större generering, beroende på den återstående delade kapaciteten och API-vägen.
Kan Gemini 4 Argon generera 1M tokens i ett svar?
Modellsidan anger lång avkodning upp till 1 048 576 utdatatokens, men detta är en övre kapacitet, inte en garanti för att en begäran som innehåller indata också kan returnera en miljon tokens. Indata och tänkande upptar samma totala fönster.
Innebär ett 1M-kontextfönster att varje detalj återges korrekt?
Nej. Det beskriver den maximala tokenbudgeten, inte perfekt hämtning eller resonemang. Kräv underlagsreferenser och testa kända kantfall från ditt eget material.
Är Gemini 4 Argon för närvarande tillgänglig via Atlas Cloud?
Jag kunde inte bekräfta en Argonspecifik modellpost eller detaljsida i Atlas Cloud-katalogen som kontrollerades för den här artikeln. Kontrollera den aktuella katalogen innan du antar att stöd finns; Gemini-kataloglänken ovan fastställer inte i sig att Argon är tillgänglig.


