

En videouppladdning kan innehålla svaret du behöver och ändå misstolkas. Gemini 4 Argon kan ta text, bilder, video, ljud och PDF:er som indata och sedan returnera text som analyserar eller kopplar samman detaljer mellan dem. De multimodala funktionerna i gemini 4 Argon är mest användbara när uppgiften är att granska befintligt material, inte att skapa nya medier. Gränsen för dess enhetliga kontext är 1 048 576 tokens, men det är en kapacitetsgräns, inte en garanti för träffsäkerhet. Nedan finns en uppgiftsvis guide till vad den kan analysera, hur du verifierar svaret och var det nuvarande API:et och Atlas Cloud passar in.
Viktiga slutsatser
- Argon accepterar text, bilder, video, ljud och PDF som indata; dess dokumenterade utdata är text.
- Kontexten på 1 048 576 tokens delas av indata och utdata. Standardutdata för synkrona anrop är begränsade till 65 536 tokens.
- Bildgenerering, ljudgenerering och Live API stöds inte av Argon-modellen.
- Verifiera påståenden mot sidnummer, tidsstämplar eller synliga bevis innan de används i ett arbetsflöde.
Vad ”multimodal” innebär för Gemini 4 Argon
För Gemini API innebär multimodal att Argon kan ta emot olika typer av källmaterial i en begäran och resonera kring materialet tillsammans med textinstruktioner. Den aktuella modellsidan för Gemini API listar text-, bild-, video-, ljud- och PDF-indata, med text som utdata. Den listar också strukturerad utdata, funktionsanrop, kodexekvering, filsökning och sökförankring bland de funktioner som stöds. Dessa verktyg kan forma ett arbetsflöde, men de ändrar inte utdatamodaliteten till en bild, ett ljudspår eller en livekonversationsström. (Google AI for Developers, oktober 2026)
Token-siffrorna måste läsas noggrant. Google listar ett enhetligt kontextfönster på 1 048 576 tokens för indata och utdata tillsammans. En normal synkron begäran har maxutdata på 65 536 tokens; lång avkodning kan nå upp till 1 048 576 enligt det dokumenterade flödet för bakgrundsfortsättning. Om din prompt och ditt bifogade innehåll förbrukar större delen av det delade fönstret återstår mindre utrymme för resonemang och svarstext. Rubriken "1M kontext" betyder inte att varje begäran på en miljon tokens får plats i ett vanligt svar.
| Material du tillhandahåller | Dokumenterad indata? | Argons utdata | En användbar första uppgift | Bevis att kontrollera |
|---|---|---|---|---|
| Text och PDF | Ja | Text | Sammanfatta en rapport eller jämför påståenden mellan avsnitt | Sida, rubrik, tabellrad eller citerat stycke |
| Bild | Ja | Text | Läs ett diagram, identifiera objekt eller jämför två bilder | Etiketter, värden, platser och bildbeskärning |
| Video | Ja | Text | Beskriv händelseordning eller hitta ett ögonblick i ett klipp | Tidsstämpel och den faktiska bildrutan |
| Ljud | Ja | Text | Svara på frågor om en uppladdad inspelning | Ljudsegment, transkription, talare eller ljud |
| Genererade medier | Ingen bild-/ljudgenerering listad | Text | Returnera en skriftlig analys eller ett strukturerat resultat | Schema och källstöd |
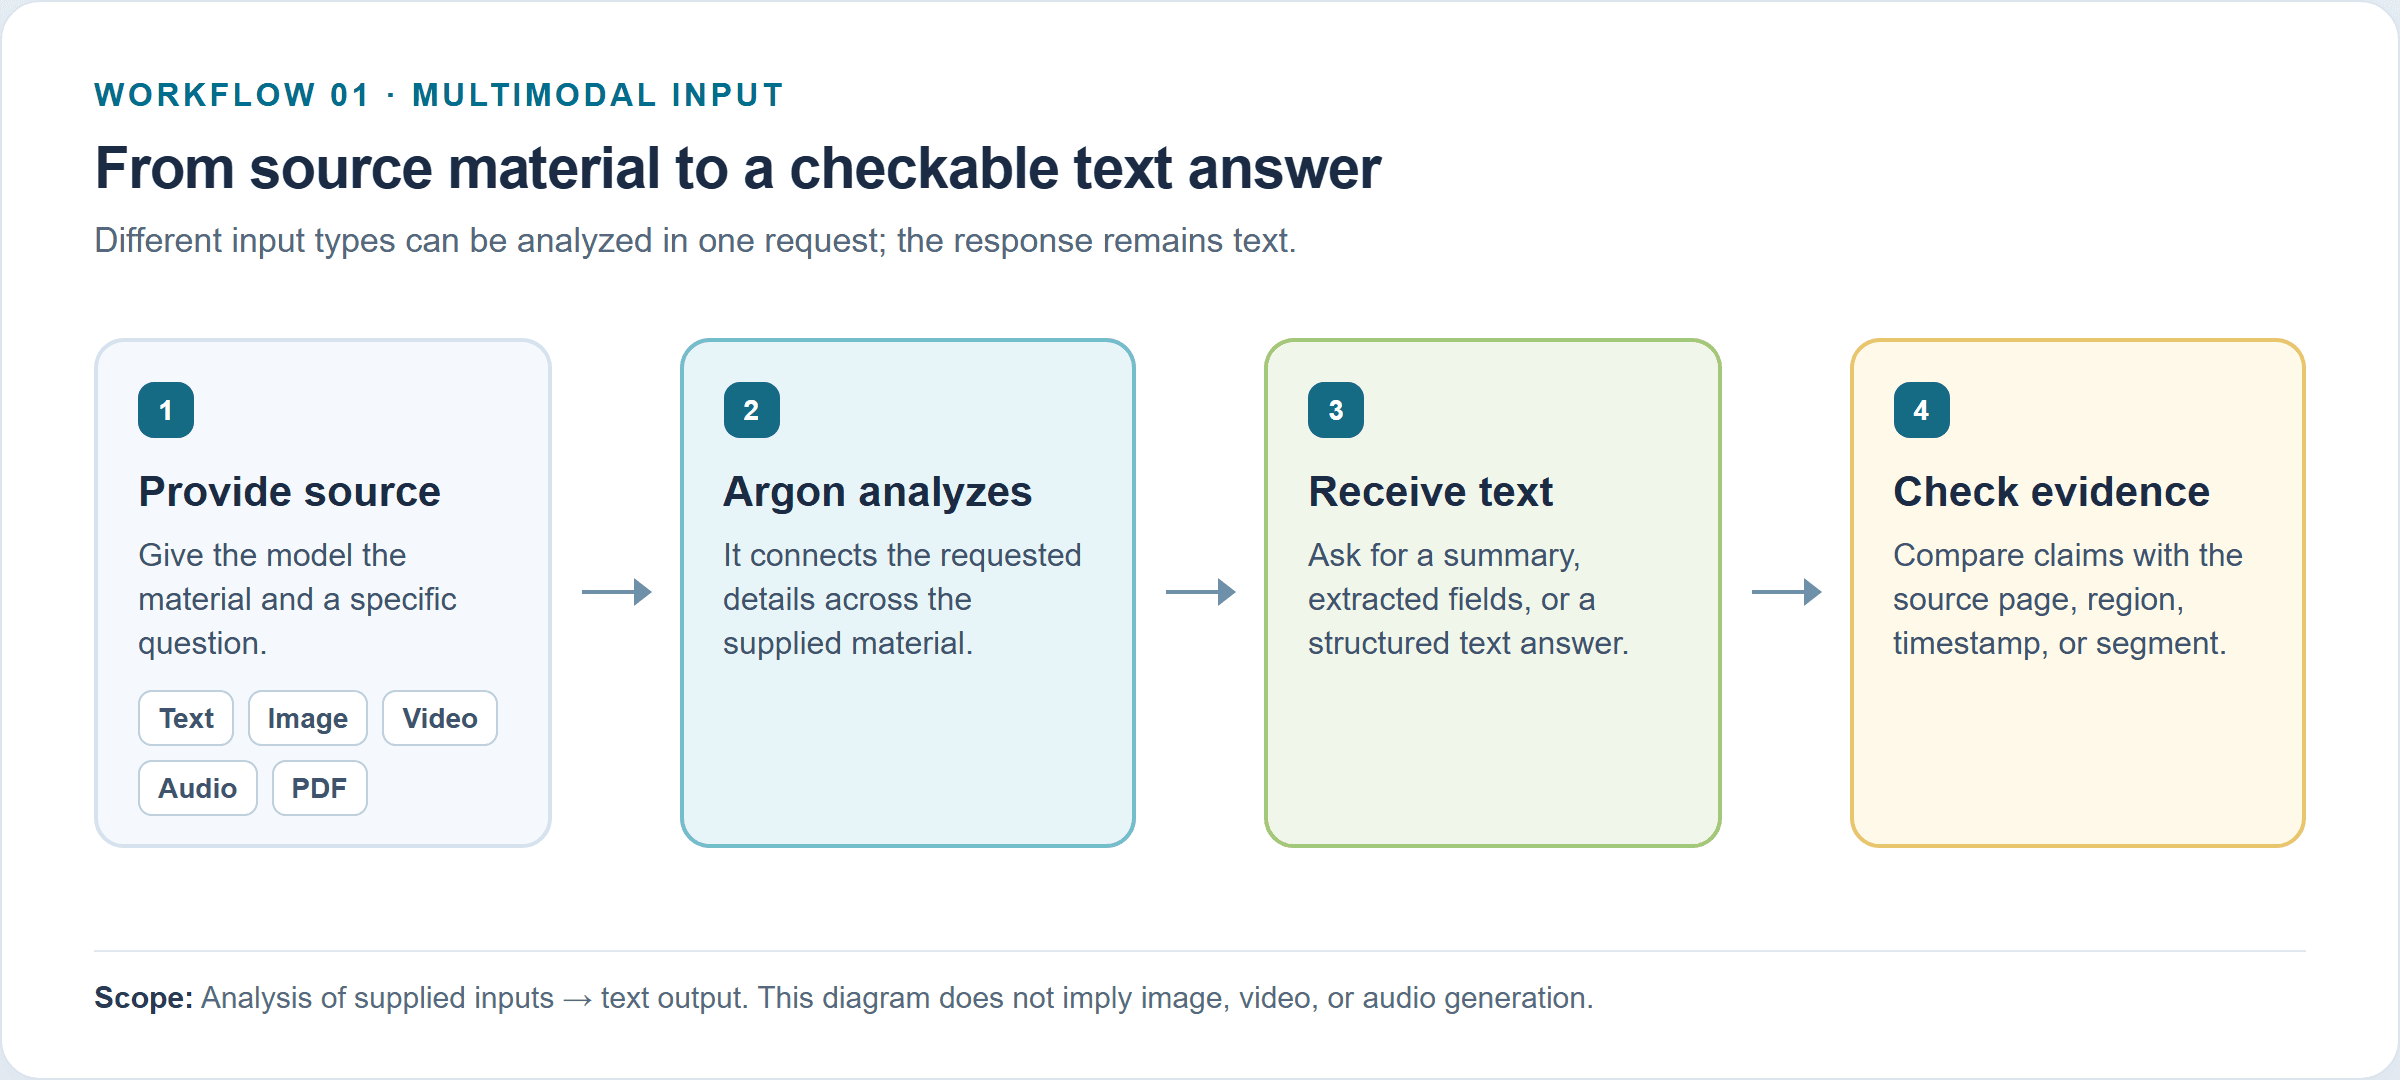 Arbetsflödesillustration: tillhandahållen text, bild, video, ljud eller PDF analyseras till ett textsvar och kontrolleras sedan mot källbevis.
Gemini-appen kan erbjuda funktioner som komponerar eller skapar medier via andra modeller och verktyg. Anta inte att dessa funktioner på appnivå är funktioner i själva API-modellen gemini-4-argon. För ett implementationsbeslut bör du använda API:ets funktionstabell och exakt modell-ID i stället för en produktfamiljsbeteckning.
Vad Gemini 4 Argon kan analysera i bilder, video, ljud och PDF:er
Det bästa sättet att avgöra om Argon passar är att namnge vilket bevis din uppgift behöver. "Förstå en video" är för brett. "Hitta varje gång operatören lägger en del i facket och ange sedan tidsstämpeln" är testbart.
Bilder: granska, jämför och extrahera visuell information
En bildbegäran kan be Argon beskriva en scen, jämföra två tillhandahållna bilder, extrahera synlig text, tolka ett diagram eller returnera visuella fynd i ett strukturerat format. Detta är analystuppgifter: utdata är text eller strukturerad text. De kan hjälpa ett supportteam att triagera produktfoton, en forskare att skanna figurer eller en operatör att extrahera etiketter från en bilduppsättning.
Oberoende tester ger en användbar verklighetskontroll, förutsatt att du behandlar dem som en enda benchmarkuppsättning snarare än en prognos för dina egna bilder. Roboflows Vision Evals från oktober 2026 rapporterar Argon bland de bästa modellerna i sina testade uppgifter för objektdetektering, OCR och visuellt resonemang. Dess OCR-utvärdering skiljer på exakt transkription och relaterade deluppgifter, och dess artikel rapporterar svagheter som små eller suddiga texter och svårare visuella avläsningar. Dess uppsättning, valda bilder, prompter och poängsättning definierar dessa resultat; de fastställer inte en generell framgångsfrekvens för varje skanning eller diagram. (Roboflow, oktober 2026)
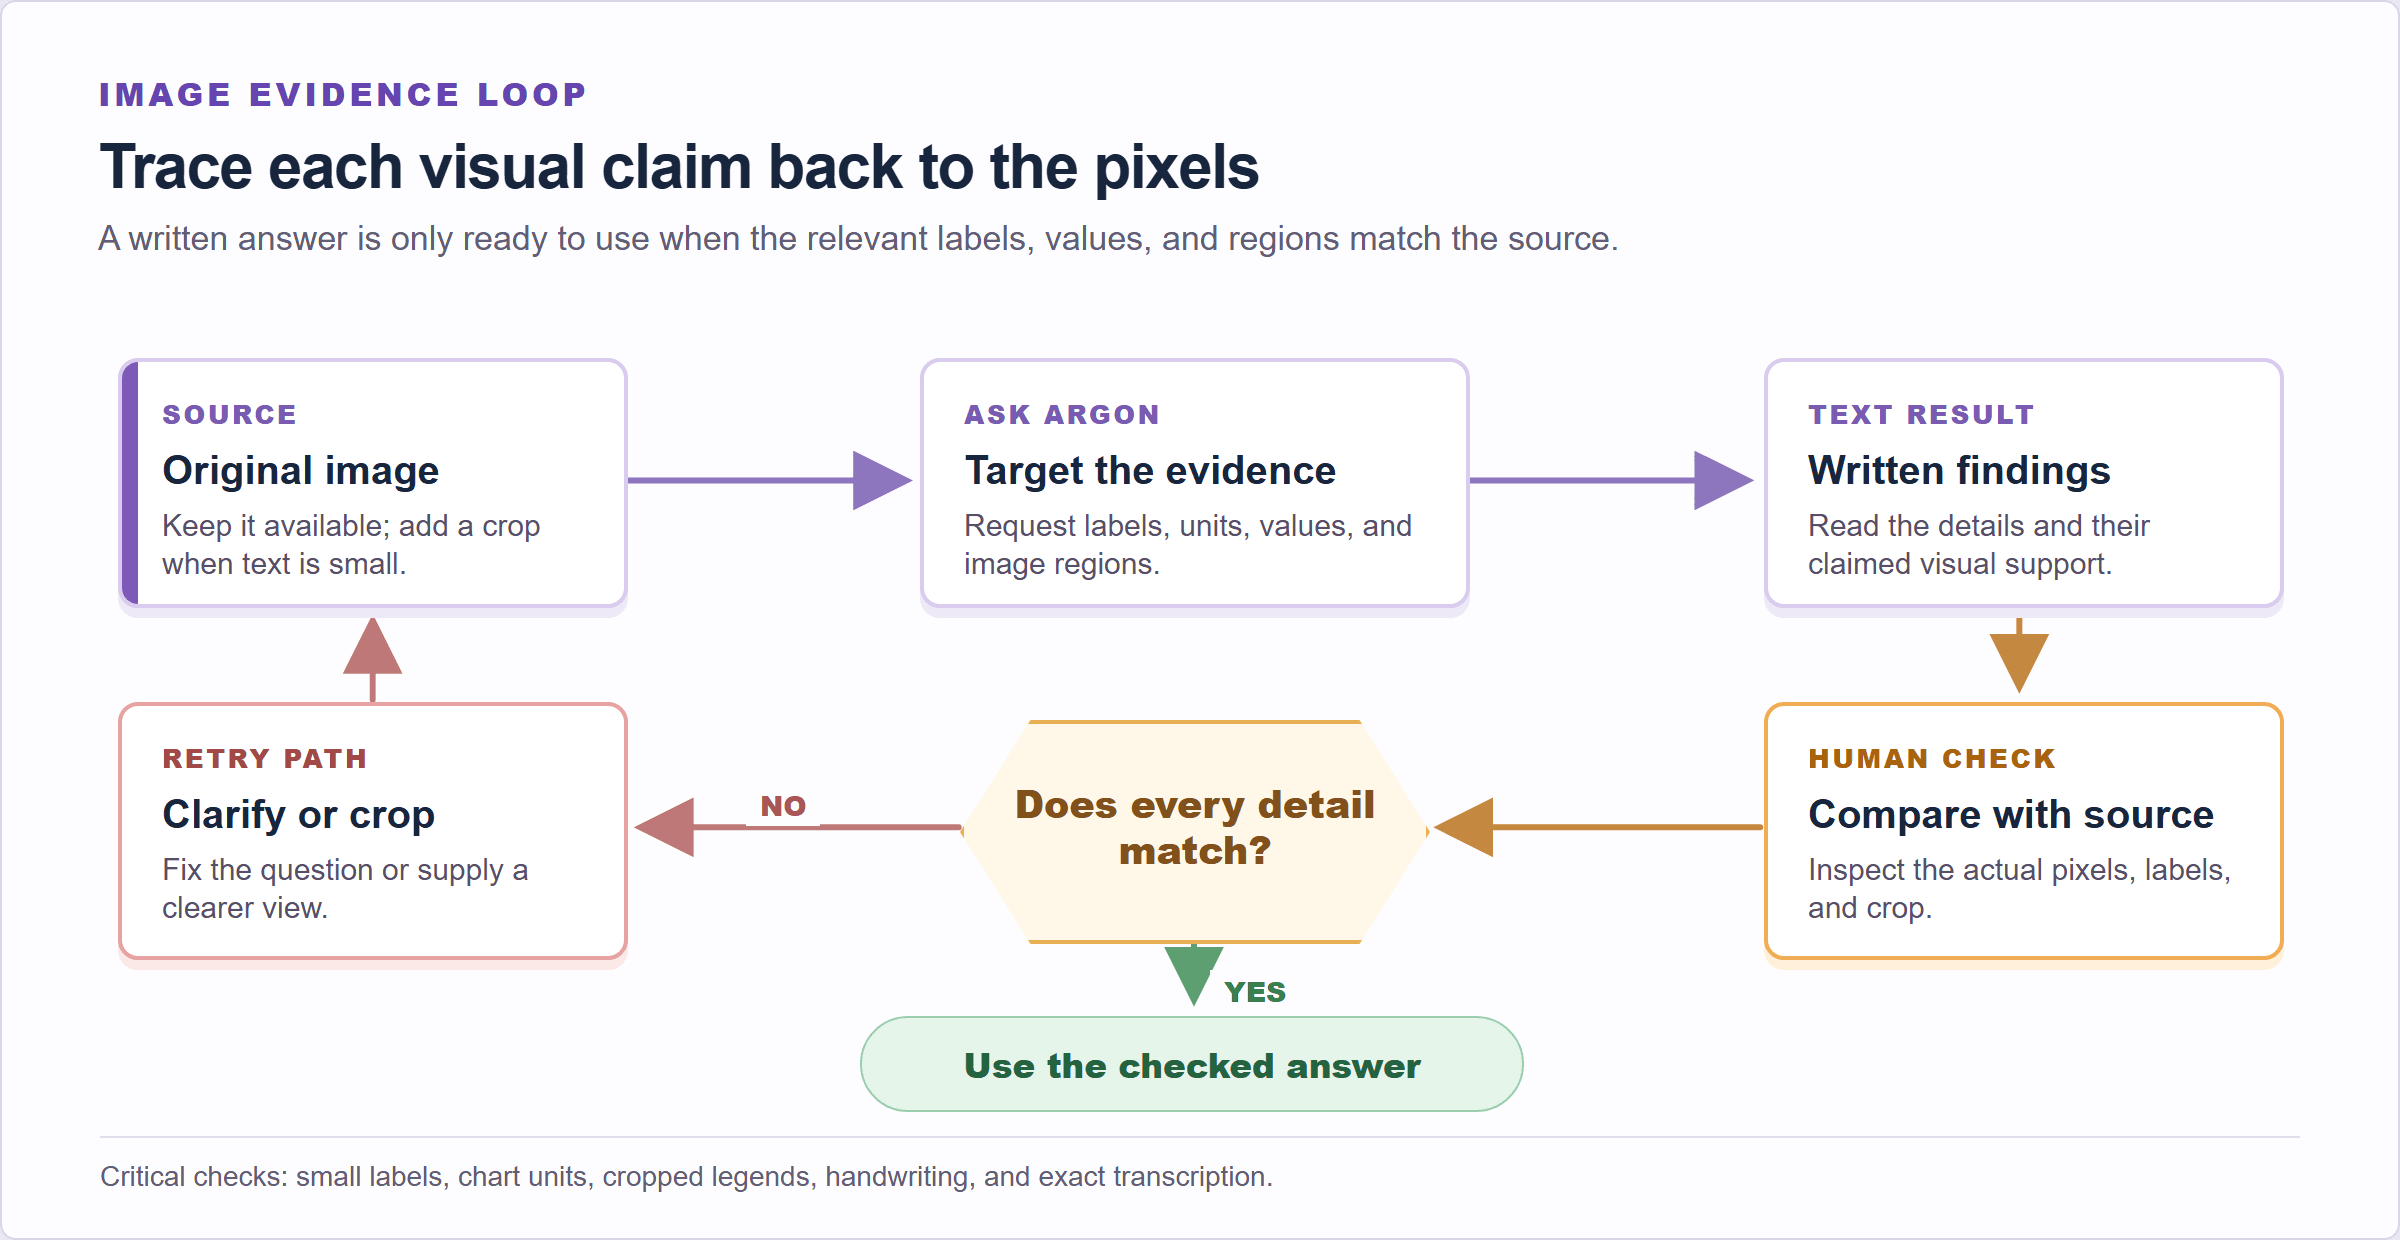 Arbetsflödesillustration: be om bilddetaljer och deras stödjande regioner och verifiera sedan varje påstående mot originalbilden.
För ett diagram: be om titeln, axlarna, enheterna, relevanta värden och den bildregion som stöder varje värde. Jämför sedan detaljerna med källan. Små etiketter, skärmbilder med låg upplösning, handskrift, överlappande markeringar eller en beskuren teckenförklaring bör granskas manuellt. Om exakt transkription är viktig bör du inkludera en tydlig beskärning och bevara originalet så att en granskare kan kontrollera varje tecken.
Video: resonera om händelser över tid
Video tillför ordning och tid. Argon kan svara på frågor om åtgärder, förändringar och händelser över bildrutor. API:et stöder agentisk videoförståelse, ett alternativ som dynamiskt kan granska tidslinjen; dess dokumenterade standardläge är statiskt. Kontrollera videoguiden och begärans inställningar för vilket läge din integration faktiskt använder.
En användbar produktionsfråga kan vara: "Vid vilken tid tar teknikern bort filtret, och vad händer omedelbart före och efter?" Kräv tidsstämplar och granska sedan dessa ögonblick. En flytande beskrivning utan tidsanpassade bevis räcker inte för incidentgranskning, kvalitetskontroller eller träningsdata.
Googles robotikteam beskriver ett Argon-arbetsflöde som analyserar en 136 sekunder lång inspelning ovanifrån av en tvåarmad robot som viker papper till en origamiräv. Systemet producerar en hierarki av tidsanpassade annoteringar, från övergripande uppgift till deluppgifter och kontaktnivååtgärder, med kvalitetskontrollsetiketter kring omförsök. Detta är ett konkret exempel på att videoanalysutdata är etiketter och struktur knutna till filmmaterialet. Artikeln är ett forskningsexempel, inte en garanti för att ett allmänt API-anrop kommer att återskapa en robotikpipeline. (Google Developers Blog, oktober 2026)
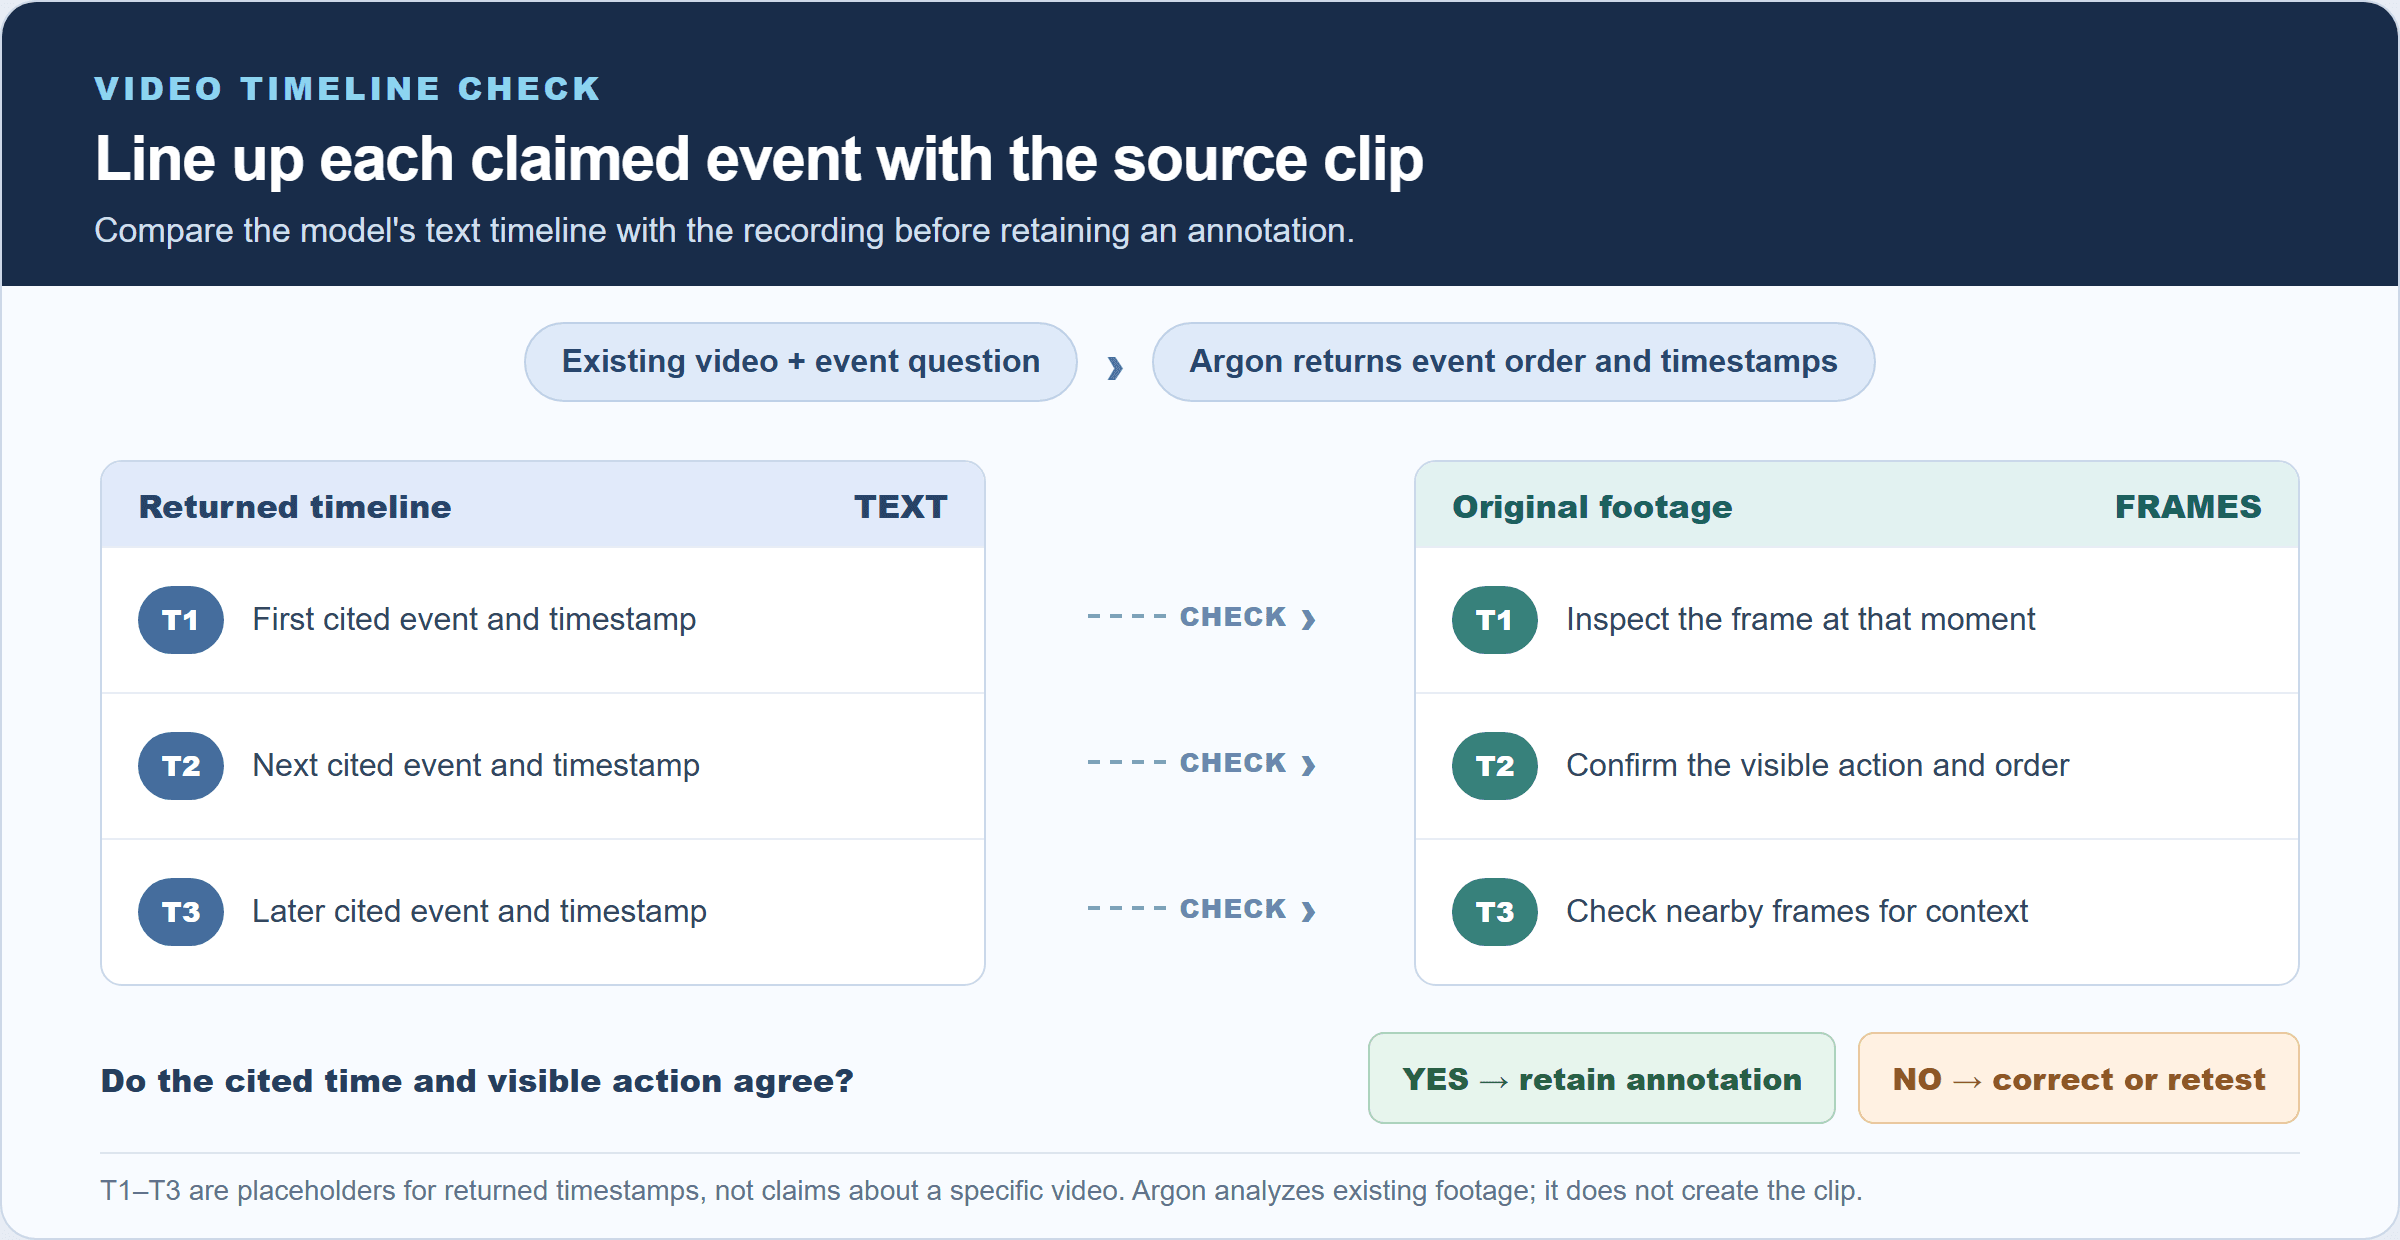 Arbetsflödesillustration: be om händelseordning och tidsstämplar och verifiera sedan varje citerat ögonblick mot originalinspelningen.
Rörelse kan vara lätt att misstolka när kameran rör sig, händer skymmer ett objekt eller två åtgärder sker tätt inpå varandra. Stickprovskontrollera de returnerade tidsstämplarna mot originalfilmen. Om ett svar påverkar säkerhet eller ett godkänt/underkänt-beslut bör en person eller ett specialbyggt visionssystem verifiera de kritiska bildrutorna.
Ljud: analysera tillhandahållna inspelningar
Ljudindata låter dig ställa frågor baserade på en inspelning, till exempel vad som sades, vilket ljud som inträffade först eller om en viss fras förekommer. Innan du utformar en integration bör du kontrollera den aktuella dokumentationen för ljudindata avseende format som stöds, begränsningar för varaktighet och sampling samt den exakta begärans utformning. "Ljudindata stöds" ensamt anger inte alla transkriptionsbeteenden eller garanterar att en bilaga faktiskt skickades genom din klient.
Bygg en liten testuppsättning med kända svar från inspelningar som du har tillstånd att bearbeta. Inkludera rent tal, överlappande talare, bakgrundsbrus, tystnad och icke-talljud om sådana förekommer i produktionen. Be om tidsstämplar eller ett kort bevis citat där gränssnittet stöder det. Verifiera att bilagan nådde modellen och jämför sedan resultatet med inspelningen. Detta fångar både modellfel och integrationsfel som utelämnade fildelar eller kodning som inte stöds.
PDF:er och blandade dokument: koppla samman detaljer mellan källor
PDF-stöd är värdefullt när en fråga sträcker sig över prosa, tabeller och figurer. En granskare kan fråga om en sammanfattning i en rapport stämmer med en tabell senare i dokumentet, eller extrahera ett påstående och dess stödjande figur. Flera dokument kan tillhandahållas för jämförelse, med förbehåll för begärans token- och filbegränsningar.
Be om en källplats för varje påstående. Sidhänvisningar är användbara, men validera dem eftersom PDF-sidnumrering kan skilja sig från den tryckta sidetiketten. För en tabell: begär både radetiketten och kolumnrubriken samt värdet. För ett diagram: be modellen att namnge det visuella element den använde. Om en PDF är skannad, roterad, svag eller tättsatt bör du testa representativa sidor i stället för att anta att alla sidor parsades lika bra.
Ett kompakt utdataschema kan göra granskningen enklare: påstående, källplats, stödjande utdrag eller visuell detalj samt konfidens eller "hittades inte". Strukturerade utdata kan framtvinga en form, men ett giltigt JSON-objekt kan fortfarande innehålla en felaktig läsning. Formatvalidering och faktavalidering är separata kontroller.
Så testar du Gemini 4 Argons multimodala förståelse
Använd en kort utvärdering innan du kopplar modellen till en stor batch. Välj en källa där en människa kan fastställa rätt svar och definiera vad som räknas som ett korrekt resultat. Poängen är att testa hela vägen från filval till modellsvar, inte bara att se om svaret låter rimligt.
- Välj en offentlig rapport med ett diagram eller en kort video med tydligt identifierbara händelser. Behåll en människokontrollerad svarsnyckel.
- Be modellen att endast använda det bifogade materialet och koppla en plats till varje påstående.
- Jämför varje påstående med källan. Registrera utelämnanden, felaktiga läsningar, ogrundade slutsatser och platser som inte kan kopplas till bevis.
- Upprepa med flera exempel som liknar dina faktiska filer, inklusive svåra fall.
- Sätt en godkännandetröskel baserad på kostnaden för ett fel. Skicka osäkra eller högriskresultat till mänsklig granskning.
Du kan anpassa denna prompt:
Analysera endast det bifogade materialet. Svara på frågorna nedan i en tabell. För varje påstående, ange sidnummer, tidsstämpel eller synligt bevis som stöder det. Om materialet inte innehåller svaret, säg "hittades inte". Dra inte slutsatser om saknade fakta.
För en bild, ersätt "sidnummer, tidsstämpel" med "bildregion och synlig etikett". För en PDF, be om sidan och tabellens eller avsnittets namn. För ljud, begär en tidsstämpel och de ord eller ljud som stöder svaret. Dessa små ändringar gör utdata lättare att granska.
Spåra fel efter typ i stället för att använda en enda övergripande träffsäkerhetssiffra. En felaktig siffra i ett diagram, en missad händelse och en hänvisning till fel sida har olika konsekvenser. Denna utvärderingsram omvandlar en imponerande funktionslista till ett repeterbart beslut om modellen är tillförlitlig för dina filer.
Gränser för Gemini 4 Argon: vad multimodalt stöd inte betyder
Stöd för indata innebär inte matchande stöd för utdata. API:et listar för närvarande bildgenerering, ljudgenerering och Live API som icke stödda för Argon. Om uppgiften är att skapa en ny bild, ett ljudspår eller en realtidsröstinteraktion bör du välja en modell eller ett verktyg som uttryckligen listar den utdataformen. Du kan fortfarande använda Argon för att analysera prompten, källmaterialet eller det genererade resultatet.
Ett fönster på en miljon tokens garanterar inte heller fullständig återkallning. Det delas mellan begäran och svaret, och långa indata kan öka latens och kostnad. Modellen kan förbise en detalj, dra slutsatser om information som saknas eller returnera en felaktig tidsstämpel samtidigt som den låter säker. Lång avkodning är en API-körningsväg med ytterligare krav, inte standardbeteendet för varje klient.
Benchmarks är riktningsgivande bevis. Roboflow rapporterar resultat från specifika uppgiftsdatauppsättningar och utvärderingsinställningar, medan Googles modellkort sammanfattar en bredare uppsättning interna och offentliga utvärderingar. Inget av dem ersätter ett test som använder din kamerakvalitet, dokumentlayouter, vokabulär, språk och feltolerans. En hög poäng i en kategori kan inte bevisa tillförlitlig prestanda för en annan uppgift.
Använd en granskare när svaret påverkar ett finansiellt, juridiskt, säkerhetsrelaterat, medicinskt eller anställningsrelaterat beslut. Håll originalindata och returnerade bevis tillsammans så att en person kan granska slutsatsen. För återkommande arbetsflöden, logga modellversion, prompt, relevanta inställningar, källidentifierare och granskningsresultat. Den posten hjälper till att skilja en modelländring från ett fil- eller integrationsproblem.
| Uppgift | Bra första test | Granska noga |
|---|---|---|
| Diagramläsning | Be om märkta värden med axelenheter | Små typsnitt, täta teckenförklaringar, ungefärliga visuella avläsningar |
| OCR | Använd en ren beskärning med en känd transkription | Oskärpa, handskrift, rotation, blandade skriftsystem |
| Videohändelser | Be om tidsstämplade åtgärder i sekvens | Ocklusion, snabba klipp, antagna orsaker |
| Ljud-Q&A | Ställ en känd fråga om en kort inspelning | Brus, flera talare, bilagehantering |
| PDF-jämförelse | Be om påstående, sida och stödjande passage | Skannade sidor, felaktig sidnumrering, slutsatser över sidor |
Åtkomst, prissättning och var Atlas Cloud passar in
Det publika API-modell-ID:t är gemini-4-argon; Google listar för närvarande Gemini API och AI Studio som åtkomstvägar. Googles aktuella meddelande listar ett introduktionspris på $2 per miljon indata-tokens och $10 per miljon utdata-tokens fram till den 30 november 2026, därefter $4 respektive $20. Cachad indata har separata villkor, så uppskatta inte den som vanlig indata. (Google, oktober 2026)
Atlas Clouds aktuella All Models-lista visade inte Gemini 4 Argon när den kontrollerades för den här artikeln. Det betyder att det inte finns någon verifierad Atlas-modellsida för Argon eller något Atlas-pris att ange här. Behandla inte en allmän plattformslista som bevis på tillgänglighet. Om ditt team jämför leverantörer eller bygger ett bredare modellarbetsflöde kan Atlas Cloud vara en plats att bläddra bland andra listade modeller, men bekräfta den exakta modellsidan och de åtgärder som stöds innan du planerar kring en leverantör.
Källkontrollen påverkar också rekommendationen: använd Googles officiella väg för att testa Argon i dag och behandla Atlas Cloud som ett separat upptäcktsalternativ för modeller som faktiskt är listade. Det finns inget påstående här om att Argon finns på Atlas Cloud.
Är Gemini 4 Argon rätt för din uppgift?
Sätt Argon på en kortlista när jobbet kräver resonemang över blandat material, extrahering av visuella detaljer, uppföljning av händelser genom en video eller granskning av en lång rapport. Dess stora delade kontext och textutdata kan hjälpa till att sammanställa bevis i en tabell eller ett strukturerat resultat. Nästa steg är en liten, människokontrollerbar utvärdering med dina egna representativa indata.
Välj en annan modell eller ett annat verktyg när den nödvändiga leveransen är genererad bild, genererat ljud eller en livekonversation med ljud/video. För OCR eller operativa beslut, jämför dess utdata med ett specialbyggt alternativ om exakthet, hastighet eller förutsägbar kostnad är viktigare än brett resonemang.
Om utvärderingen klarar din uppgiftsspecifika tröskel kan du pilottesta den med loggning och mänsklig granskning innan du ökar volymen. Om den misslyckas, klassificera felen och avgör om tydligare indata, en ändrad prompt, en annan modell eller ett separat OCR-/transkriptionssystem är rätt lösning. Den användbara frågan är om Gemini 4 Argons multimodala funktioner uppfyller din felbudget.
Vanliga frågor
Kan Gemini 4 Argon analysera video och ljud?
Ja. Dess API listar både video och ljud som indata som stöds. Videoförståelse kan returnera beskrivningar eller tidsstämplad analys; ljud kan tillhandahållas för ljudbaserade frågor. Kontrollera den aktuella dokumentationen för filformat och begäranden och verifiera sedan svaret mot originalmediet.
Genererar Gemini 4 Argon bilder eller ljud?
Nej. Den aktuella funktionstabellen för API:et markerar bildgenerering och ljudgenerering som icke stödda för den här modellen. Dess dokumenterade utdatamodalitet är text, även när indata innehåller bilder, ljud eller video.
Vad betyder Gemini 4 Argons kontextfönster på 1M tokens?
Gränsen på 1 048 576 tokens delas av indata och utdata. Standardutdata för synkrona anrop är begränsade till 65 536 tokens. Google dokumenterar ett separat flöde för lång avkodning för större utdata, upp till den delade gränsen, med bakgrundskörning och fortsättningssteg.
Hur mycket kostar åtkomst till Gemini 4 Argon API?
Från och med den 16 oktober 2026 listar Google $2 per miljon indata-tokens och $10 per miljon utdata-tokens fram till den 30 november 2026. De listade efterföljande priserna är $4 och $20. Kontrollera den aktuella prissättningen och villkoren för cachade tokens innan du uppskattar ett projekt.


