Snabbt svar
En GitHub AI-videogenereringsfärdighet kopplar din kod till AI-videomodeller. Under 2026 beror valet mellan öppen källkod (gratis, egen hosting) och betalda API:er (moln, direkt) på fyra variabler: tillgänglig VRAM, datasekretesskrav, nödvändig kvalitetsnivå och månatlig genereringsvolym. För produktionsskalor som kräver flera modeller i toppklass erbjuder Atlas Cloud (atlascloud.ai) tillgång till 300+ modeller – inklusive Kling v3.0, Seedance 2.0, Vidu 3.0, Veo och Sora – via en enda API-nyckel med transparent prissättning per användning.
Vill du jämföra videomodellerna bakom dessa verktyg direkt? Atlas Cloud-modelljämförelsen ställer bild- och videomodeller sida vid sida på en prompt – med priset synligt innan du genererar.
-
Vad är en AI-videogenereringsfärdighet? {#what-is-a-skill}
I GitHubs sammanhang är en AI-videogenereringsfärdighet en återanvändbar modul, ett omslag eller ett integrationslager som kopplar en applikation till en backend för AI-videogenerering – antingen en egenhanterad modell med öppen källkod eller ett moln-API.
Tänk på det som abstraktionen mellan din applikationslogik och själva inferensmotorn. En färdighet kan vara:
- En Python-klass som omsluter pipeline för modellen
Wan 2.2för text-till-video-generering - En ComfyUI-anpassad nod som ansluter till Atlas Cloud API för Kling v3.0-generering
- En n8n-arbetsflödesnod som utlöser Seedance 2.0 via REST och returnerar en videolänk
- Ett LangChain-verktyg eller en MCP Server-färdighet som anropar en videogenereringsslutpunkt på begäran
Den centrala frågan varje utvecklare möter när de bygger en: ska backend vara vikter med öppen källkod som körs lokalt, eller ett betalt moln-API?
Verklig data från 2026. Inte teori.
-
GitHub med öppen källkod 2026 {#open-source-landscape}
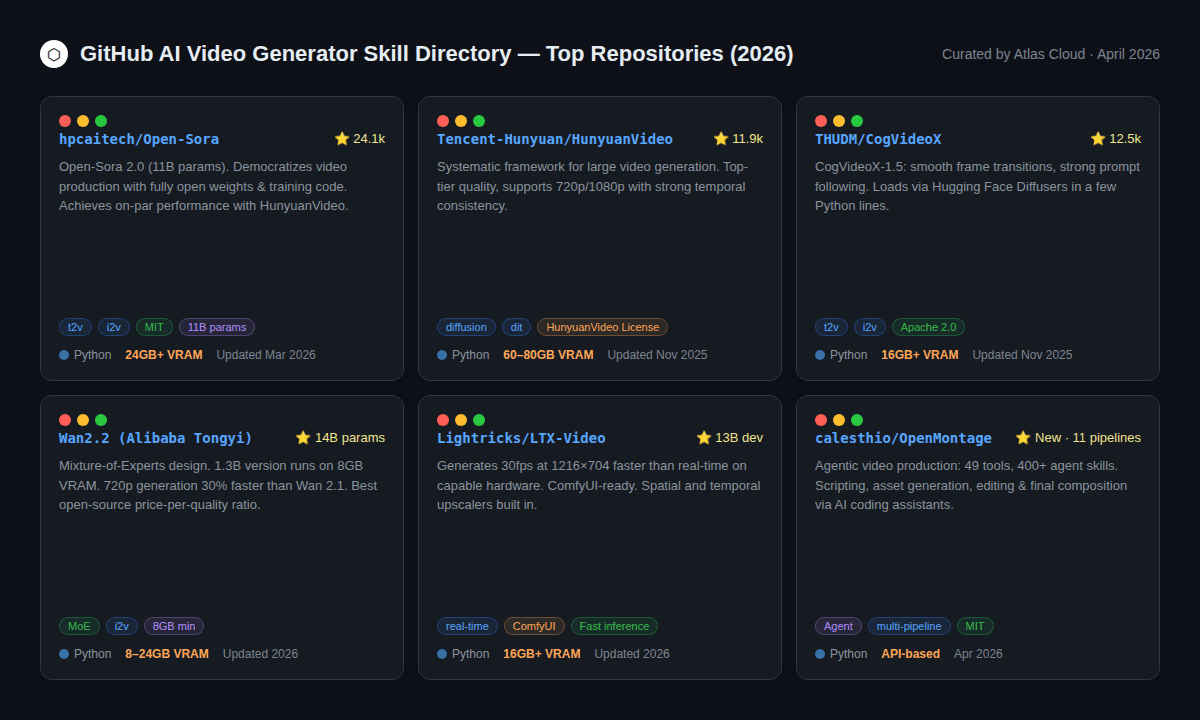
Ekossystemet för videogenerering med öppen källkod har mognat avsevärt. Vissa repos är nu genuina alternativ till betalda API:er – åtminstone för vissa uppgifter.
Nivå 1: Produktionsklara modeller med öppen källkod
HunyuanVideo (Tencent, 11,9k ⭐) – En av de bättre videogeneratorerna med öppen källkod. Hanterar 720p och 1080p. Den främsta begränsningen är hårdvarukravet: 60–80 GB VRAM för hela modellen, vilket gör den tillgänglig endast för team med företags-GPU-åtkomst. Community-licensen tillåter kommersiell användning med attribution.
CogVideoX-1.5 (THUDM/CogVideo, 12,5k ⭐) Släppt under Apache 2.0, detta är en av de mest utvecklarvänliga öppna modellerna. Den laddas inbyggt via Hugging Face Diffusers med några rader Python. Bildövergångar är smidiga och promptföljning är stark. Kräver minst 16 GB VRAM. Ett stabilt val om ditt team redan lever på Hugging Face.
Open-Sora 2.0 (hpcaitech, 24,1k ⭐) Det mest stjärnmärkta projektet för videogenerering med öppen källkod på GitHub. Version 2.0 (11B parametrar) uppnår prestanda jämförbar med HunyuanVideo på VBench-riktmärken, och träningskostnaden rapporterades till cirka 200 000 $ – en anmärkningsvärd siffra för en modell av denna kaliber. Text-till-video, bild-till-video och oändlig längd-generering.
Nivå 2: Lättare alternativ med öppen källkod (lägre VRAM)
Wan 2.2 (Alibaba Tongyi) Tillgänglighetshistorien här är övertygande: 1,3B-varianten körs på 8 GB VRAM och 14B-varianten på 24 GB. Mixture-of-Experts (MoE)-arkitekturen ger bättre detaljer till lägre beräkningskostnad, och version 2.2 är 30 % snabbare vid 720p än sin föregångare. För utvecklare som kör ett enda konsument-GPU är Wan 2.2 det starkaste alternativet med öppen källkod.
LTX-Video (Lightricks) Designad för hastighet framför allt annat. Genererar 30 fps vid 1216×704 upplösning snabbare än realtid på kapabel hårdvara. ComfyUI-integrationen är mogen, och rumsliga och temporala uppskalare är inbyggda.
Nivå 3: Agentiska pipelines
OpenMontage (calesthio, ny april 2026) En genuint ny kategori: ett agentiskt videoproduktionssystem med 11 pipelines, 49 verktyg och 400+ agentfärdigheter. Fungerar med AI-kodningsassistenter som Claude Code, Cursor och Copilot. Hanterar hela pipelinen – forskning, manus, tillgångar, redigering – från början till slut utan manuella steg. Byggt för team som kopplar ihop flera AI-verktyg i ett arbetsflöde.
-
Katalog över betalda API:er: SOTA-modeller tillgängliga nu {#paid-api-directory}
Landskapet för betalda API:er 2026 definieras av tre stora modellfamiljer, var och en med en distinkt teknisk ansats. Alla tre finns tillgängliga via Atlas Cloud's enhetliga API.
Kling v3.0 (Kuaishou)
Släppt 5 februari 2026. Byggd på en multimodal visuell språkarkitektur – text, bilder, ljud och video hanteras alla i ett system.
Vad den faktiskt gör bättre än konkurrenter:
- Komplex mänsklig rörelse – springa, dansa, kampsport – utan deformationen av "spagettilemmar" som plågar andra modeller
- Inbyggd ljudgenerering på flera språk (5 språk, inklusive synkroniserad läpprörelse)
- Motion Brush: ett verktyg som låter utvecklare (eller slutanvändare) måla rörelsebanor direkt på källbilder – en funktion som för närvarande saknar motsvarighet i konkurrerande modeller
- Element Binding för konsekvent karaktärs- och objektspårning över bilder
Var den brister: Renderingshastigheten är långsammare än vissa konkurrenter på Pro-nivå. Storyboard-verktygets övergångar kan vara "klumpiga" enligt oberoende granskare.
Bäst för: Sociala klipp på TikTok och Reels, e-handelsproduktvideor, allt som behöver mycket volym med karaktärer som faktiskt förblir konsekventa.
Seedance 2.0 (ByteDance)
Släppt 8 februari 2026, Seedance 2.0 representerar ett paradigmskifte i hur AI-video promptas – från enbart textprompter till sann regissörsliknande referensbaserad kontroll.
Den centrala tekniska innovationen: Seedance 2.0 accepterar kvadmodala indata – text, bild, video och ljud – samtidigt. Dess "Universal Reference"-system gör att en utvecklare kan mata in en referensvideo av en person som dansar, och modellen kommer att replikera kamerarörelsen, karaktärens handlingar och kompositionen i en genererad utdata. Detta löser karaktärskonsistens på ett sätt som rena text-till-video-modeller inte kan.
Oberoende tester bekräftar att den utmärker sig på:
- Berättelse med flera bilder med konsekvent karaktärsidentitet över klipp
- Synkroniserad ljud-video-generering (dubbelgrenad arkitektur genererar ljud och video samtidigt)
- Exakt replikering av komposition och belysning från referenstillgångar
Notering om tillgänglighet: Från och med april 2026 är Seedance 2.0 internationell API-åtkomst tillgänglig via plattformar som Atlas Cloud. Direkt BytePlus API-åtkomst för internationella utvecklare har haft tillgänglighetsinkonsekvenser – bekräfta aktuell status innan du bygger ett beroende av direkta ByteDance-slutpunkter.
Bäst för: Musikvideor, tight karaktärsanimation, produktannonser där rörelsen måste vara exakt, byråer som kör storyboard-till-video-arbetsflöden.
Vidu 3.0 (Shengshu AI / Tsinghua)
Byggd på den ursprungliga U-ViT-arkitekturen som kombinerar Diffusion och Transformer-teknologier, fokuserar Vidu på de områden där det mesta av AI-video fortfarande kämpar: miljökoherens och filmisk konsekvens.
Utmärkande funktioner:
- Universal referencesystem för konsekvent belysning över bildsekvenser med flera bilder
- Smart bakgrundsmusikgenerering som automatiskt anpassar sig till scenernas stämning
- Långformsgenerering med stark temporal konsistens (avgörande för sekvenser längre än 5 sekunder)
Bästa användningsfall: Professionella filmskaparflöden, animationsdesign, kreativ reklam som kräver filmisk kvalitet.
Sora 2 (OpenAI)
Sora 2 förblir riktmärket för noggrannhet i fysiksimulering. Krossa ett glas i en Sora 2-prompt så beter sig sprickmönstret, vätskefysiken och reflektionerna som på riktigt – de flesta konkurrenter kan fortfarande inte matcha den nivån av konsekvens.
Bäst för: VFX-arbete, arkitektonisk visualisering, dokumentär B-roll, överallt där fysisk noggrannhet är viktigare än att spara pengar.
Pris: Sora 2 har den högsta prislappen i denna kategori. Du betalar för datorn.
-
Inferenskostnader: De verkliga siffrorna {#inference-costs}
Det här avsnittet innehåller det viktigaste kontraintuitiva fyndet i hela denna guide – ett som förändrar de flesta utvecklares standardintuition om öppen källkod vs. betalda API:er.
Den dolda kostnaden för egenhanterade modeller
De flesta utvecklare antar: "Öppen källkod = gratis = alltid billigare."
Detta antagande är felaktigt för de flesta teamstorlekar.
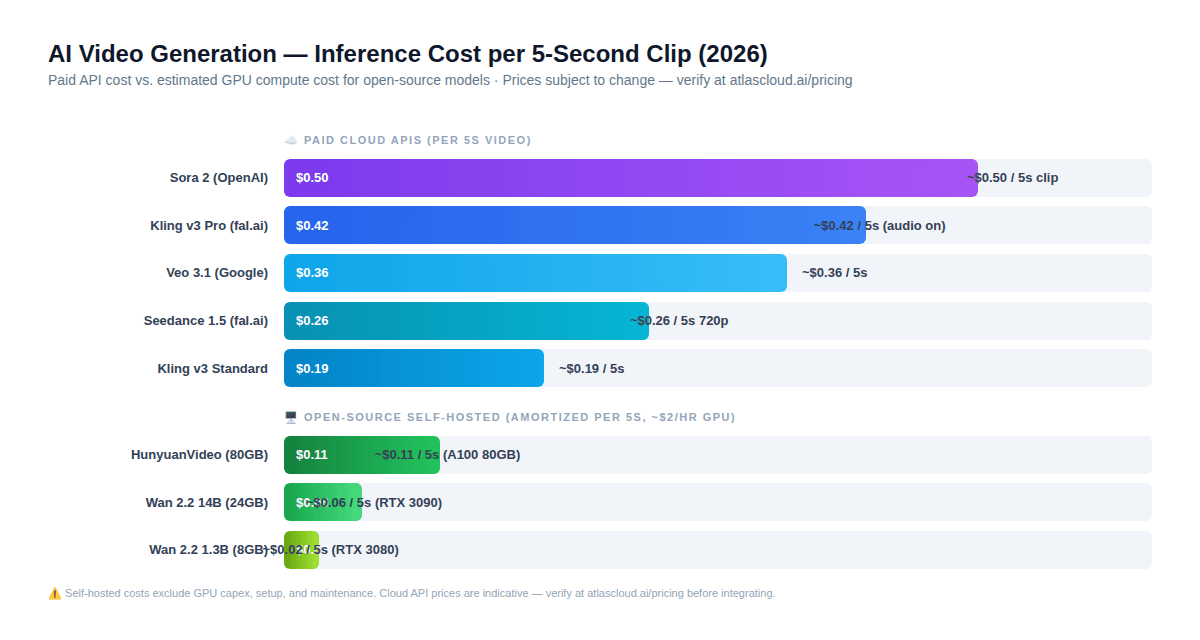
Så här ser den faktiska matematiken ut för ett 5-sekunders videoklipp 2026:
Egenhanterad öppen källkod (amorterad GPU-kostnad på ~$2/timme):
- Wan 2.2 1.3B (RTX 3080): ~$0,02 per 5s klipp
- Wan 2.2 14B (RTX 3090): ~$0,06 per 5s klipp
- HunyuanVideo (A100 80GB): ~$0,11 per 5s klipp
Betalt moln-API (indikativ prissättning – verifiera på atlascloud.ai/pricing):
- Kling v3 Standard: ~$0,19 per 5s klipp
- Seedance 1.5 720p med ljud: ~$0,26 per 5s klipp
- Kling v3 Pro med ljud: ~$0,42 per 5s klipp
- Sora 2: ~$0,50 per 5s klipp
De egenhanterade siffrorna ser övertygande ut isolerat. Problemet är att de exkluderar:
- 1. GPU-hårdvara – En A100 80GB kostar $10K–$15K. Vid 1 000 videor i månaden (~$0,11 var) ser du över 9 000 månader bara för att nå break-even på hårdvaran.
- Installationstid – CUDA-konfiguration, nedladdning av modellvikter, VRAM-hantering och felsökning representerar 20–40 ingenjörstimmar av initial installation.
- Löpande underhåll – Modelluppdateringar, beroendekonflikter och infrastrukturtillförlitlighet är kontinuerliga tidskostnader.
- Alternativkostnad – Tid som läggs på inferensinfrastruktur är tid som inte läggs på produkt.
Den praktiska gränsvillkoren:
Egen hosting lönar sig bara om: (a) du redan har GPU:er som kör andra arbetsbelastningar, (b) du producerar 5 000+ videor i månaden, eller (c) regler tvingar dig att behålla allt på plats.
Under den tröskeln är betalda API:er – särskilt enhetliga plattformar som Atlas Cloud – billigare när total ägandekostnad beräknas ärligt.
-
Rate Limiting & API-latens – Vad utvecklare faktiskt möter {#rate-limiting}
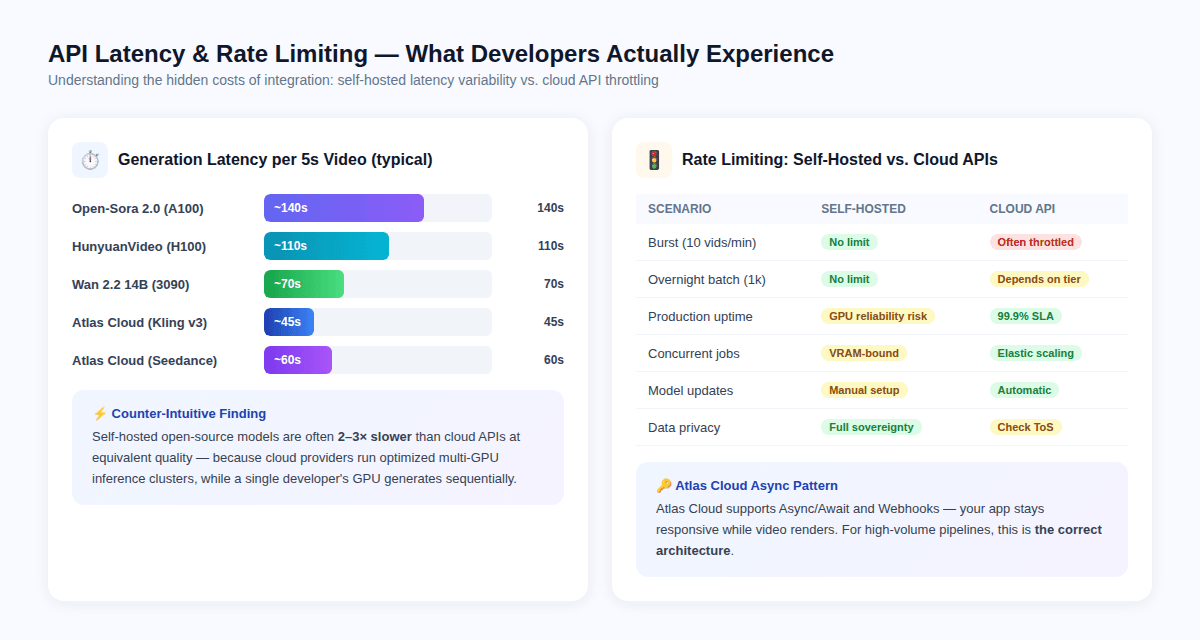
Latensparadoxen
Kontraintuitivt nog är moln-API:er ofta snabbare per video än egenhanterade modeller – inte för att modellerna är olika, utan för att molnleverantörer kör optimerade multi-GPU-inferenskluster med hårdvarunivå-batching, medan en enskild utvecklar-GPU genererar bildrutor sekventiellt.
Typisk latens per 5-sekunders klipp:
- Open-Sora 2.0 på A100: ~140 sekunder
- HunyuanVideo på H100: ~110 sekunder
- Wan 2.2 14B på RTX 3090: ~70 sekunder
- Atlas Cloud / Kling v3: ~45 sekunder
- Atlas Cloud / Seedance 2.0: ~60 sekunder
Detta innebär att bygga en GitHub-färdighet kring en egenhanterad modell kan producera längre väntetider för användaren även när kostnaden per video är lägre.
Rate Limiting: Produktionsverkligheten
Egenhanterade modeller har inga API-pålagda rate limits – de begränsas endast av ditt GPUs VRAM och termiska gränser.
Betalda API:er tillämpar rate limits som varierar beroende på prisnivå. De relevanta tekniska implikationerna:
- Burst-förfrågningar (10+ videor per minut) kommer att utlösa begränsning på de flesta betalda API-nivåer
- Övernattningsbatchjobb (1 000+ videor) kräver noggrann asynkron design för att undvika timeout
- Samtidiga förfrågningar på egenhanterade modeller begränsas av VRAM – att köra 2 samtidiga 14B-modellinferenser på ett enda 24 GB-kort är vanligtvis inte möjligt
Atlas Cloud** löser rate limiting-problemet** genom Async/Webhook-arkitektur: din applikation skickar in ett genereringsjobb, får ett uppgifts-ID och meddelas via webhook när renderingen är klar. Detta mönster förhindrar applikationshänger medan videon renderas och skalar korrekt för batcharbetsbelastningar.
Den korrekta arkitekturen för produktion
plaintext1# Atlas Cloud Async Pattern – Produktionsredo 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Skicka in genereringsuppgift 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Produktpresentationsrulle, smidig rörelse, 9:16 bildförhållande", 14 size="1080x1920", 15 n=1 16) 17 18# Hantera asynkront svar 19video_url = response.data[0].url 20print(f"Video genererad: {video_url}")
För bild-till-video-arbetsflöden, notera att vissa modeller – inklusive vissa Kling i2v-varianter – inte accepterar en separat bildförhållande-parameter för bild-till-video-generering; utdatarpsupplösningen följer indatabildens dimensioner. Bygg din uppströms bildgenerering med rätt målbildförhållande.
-
Lokal hosting vs. moln-API: Avvägningsmatrisen {#local-vs-cloud}
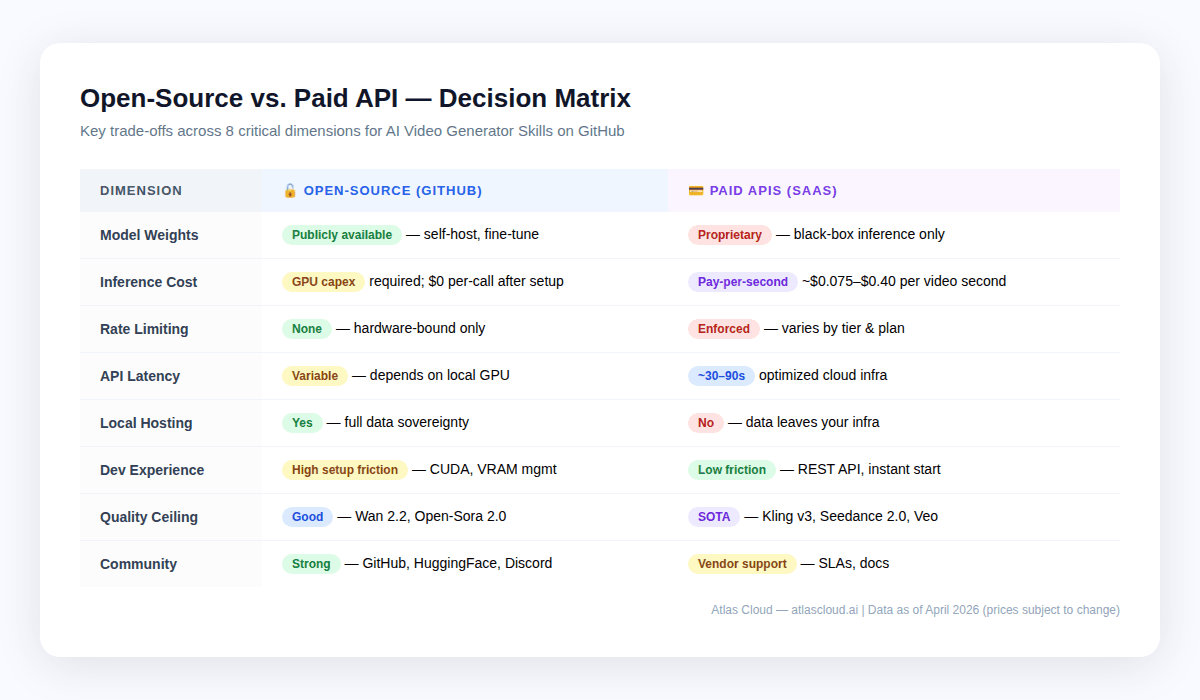
Det är inte antingen eller. De flesta produktionspipelines blandar båda: öppen källkod för prototypning och bulk-genomgångar av låg kvalitet, moln-API:er för slutliga renderingar och banbrytande kvalitet.
När lokal hosting är vettigt
- Efterlevnadsspärrar – HIPAA, GDPR eller något proprietärt som inte kan lämna dina servrar. Egen hosting är ditt enda alternativ. Atlas Cloud är HIPAA-kompatibelt och SOC I & II-certifierat, vilket täcker de flesta företagsbehov, men reglerade verksamheter bör dubbelkolla sina specifika krav.
- Mycket hög volym vid acceptabel kvalitet – team som genererar 10 000+ videor per månad på Wan 2.2-kvalitetsnivåer kan finna att GPU-hyreskostnader är lägre än API-avgifter i den skalan.
- Forskning och finjustering – öppna modellvikter möjliggör finjustering på proprietära datamängder. Inget moln-API erbjuder för närvarande anpassad modellträning.
- Luftgapade installationer – kantdistributioner utan anslutning eller låsta nätverk.
När moln-API:er vinner
- Time-to-market – en Atlas Cloud-integration tar timmar, inte veckor
- Toppkvalitet – ledare med öppen källkod som Wan 2.2 och Open-Sora 2.0 ligger fortfarande efter proprietära modeller som Kling v3 och Seedance 2.0, särskilt på mänsklig rörelse, att hålla bilder konsekventa och inbyggt ljud
- Spikiga arbetsbelastningar – moln-API:er skalar upp och ner; dina egna GPU:er gör inte det
- Lägre volym – under ~5 000 videor i månaden vinner moln-API:er vanligtvis på total kostnad
- Flexibilitet med flera modeller – Atlas Clouds katalog med 300+ modeller innebär att du kan växla från Kling till Seedance till Veo inom en enda integration
-
Community-driven vs. leverantörsdriven utveckling {#community-vs-vendor}
Lätt att ignorera när man jämför API:er, men detta har faktiskt betydelse om du bygger GitHub-färdigheter.
Community-driven (öppen källkod):
- Vem som helst kan skicka in buggfixar och begära funktioner – och få dem sammanslagna
- Dokumentationen är ofta utmärkt eftersom användarbasen bidrar med exempel
- Brytande ändringar i modell-API:er sker långsamt, med offentliga varselperioder
- ComfyUI och Hugging Face Diffusers-communityn har djupa bibliotek av färdiga arbetsflöden, LoRA-adaptrar och finjusterade kontrollpunkter
- Forskningsartiklar publiceras med öppen, reproducerbar kod
Leverantörsdriven utveckling (betalda API:er):
- API-stabilitet styrs av kommersiella SLA:er – brytande ändringar är mindre frekventa men förekommer
- Nya modellversioner (t.ex. Kling 3.0 i februari 2026, tre dagar före Seedance 2.0) sker i konkurrenstakt och ofta utan förvarning
- Modellförbättringar distribueras serversida utan att utvecklaren behöver göra något
- Teknisk dokumentation underhålls professionellt
Den praktiska implikationen för GitHub-färdighetsförfattare: om du skriver en färdighet som måste förbli stabil och underhållsfri, är ett moln-API med stabila slutpunktskontrakt lättare att underhålla än en färdighet kopplad till en specifik open source-modellversion. Omvänt, om din färdighet är utformad för att ge utvecklare tillgång till de senaste forskningsmodellerna utan API-kostnader, är ekosystemet med öppen källkod där det arbetet sker.
-
Fallstudie: Sociala medier-byrå (500 videor/månad) {#case-study-1}
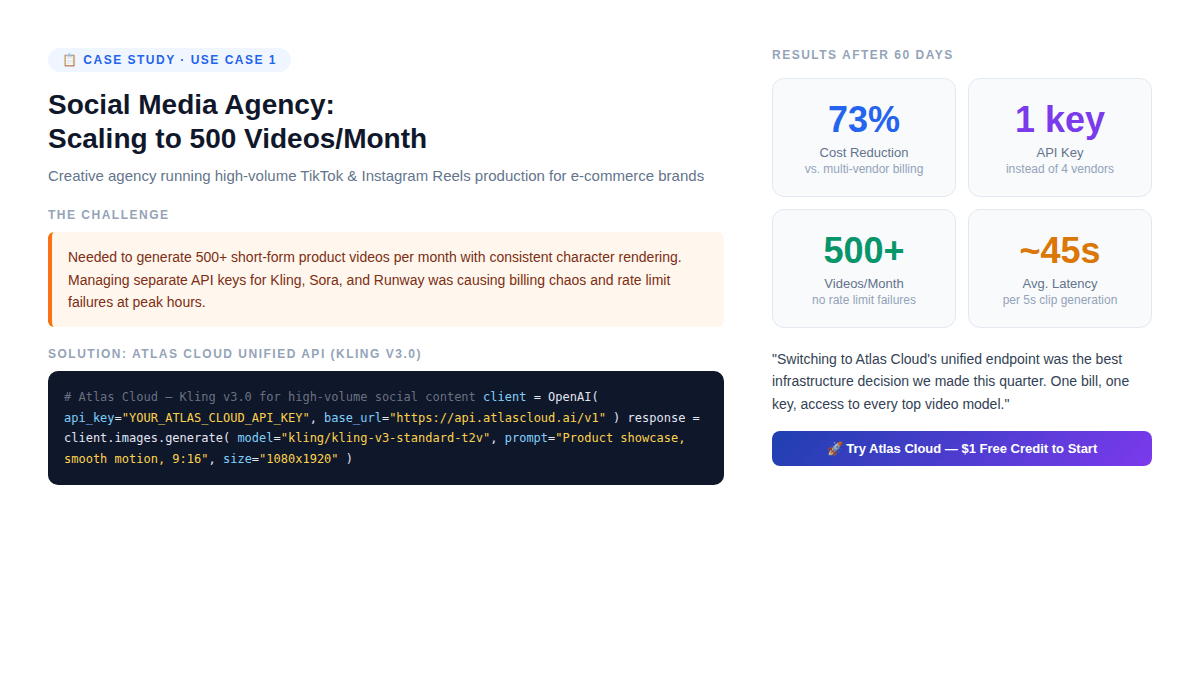
Upplägget: En kreativ verkstad som gör korta produktvideor för 20 e-handelskunder. De behöver 500 videor i månaden, karaktärer som ser likadana ut över klipp, 9:16 vertikalt, 5–10 sekunder var, batchade under lediga timmar.
Inledande arkitektur (före Atlas Cloud):
- Separata API-nycklar för Kling, RunwayML och Pika
- Tre faktureringsinstrumentpaneler, tre rate limit-pooler
- Manuellt modellval per kund
- Rate limit-fel under högtrafik som orsakar leveransförseningar
Problemet detta skapade: När Kling släppte v3.0 var byrån tvungen att återintegrera en ny SDK, uppdatera fakturering och testa kompatibilitet – tre gånger för tre leverantörer.
Lösning: Atlas Cloud enhetligt API med Kling v3.0 Standard
plaintext1# Atlas Cloud – Pipeline för sociala medier-video 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, smidig rörelse, filmisk belysning, 9:16 vertikalt format", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Resultat efter 60 dagar:
- 73 % minskning av kostnad per video (en enda faktura, inga påslag per leverantör)
- Noll rate limit-fel (Atlas Clouds elastiska infrastruktur absorberade toppbelastningar)
- Modellbyte från Kling till Seedance för specifika kunder tog < 2 minuter (ändra en parameter)
- Första insättning 20 % bonus kompenserade effektivt första månadens produktionskostnader
Den icke-uppenbara upptäckten: Byrån minskade inte antalet leverantörer för att Kling blev bättre. De minskade det för att hantera flera leverantörsrelationer vid 500 videor/månad har en icke-trivial operativ kostnad som inte syns i API-prissättningen per styck.
-
Fallstudie: Oberoende utvecklare som bygger en videotjänst {#case-study-2}
Upplägget: Solo-utvecklare som bygger ett "text till produktdemo"-verktyg för nystartade företag. Behöver flera stilar – filmisk, animerad, live-action. Måste validera snabbt och hålla infra under $200/månad medan han tar reda på om någon faktiskt vill ha detta.
Arkitekturbeslut:
Utvecklaren övervägde initialt att egenhärbärgera Wan 2.2 på en hyrd A100-instans (~$2/timme). Vid 100 testvideor under validering uppskattades kostnaden till ~$6 totalt i GPU-tid. Verkade billigare än Atlas Cloud.
Vad beräkningen missade:
- Att sätta upp Wan 2.2-pipelinen tog 3 dagar (CUDA-beroenden, VRAM-hantering, serverkonfiguration)
- Wan 2.2:s kvalitetsgap jämfört med Kling v3 innebar att tjänsten inte kunde ta ut det avsedda priset
- Serverdriftidshantering tillkom ~2 timmar/vecka i löpande underhåll
Reviderad arkitektur med Atlas Cloud:
plaintext1# Flexibel modellrouting – växla baserat på användarnivå 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Lägre kostnad 4 "pro": "kling/kling-v3-professional-t2v", # Högre kvalitet 5 "enterprise": "bytedance/seedance-2.0" # Max kontroll 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Utfall: Utvecklaren lanserade på 4 dagar istället för 3 veckor. Premium-nivåns användning av Seedance 2.0 motiverade ett 3× prispremium jämfört med gratissnivån, och den nivåindelade modellstrukturen byggdes med en enda Atlas Cloud-nyckel – inte tre separata leverantörsintegrationer.
-
Atlas Cloud-fördelen: Varför "Ett API" är rätt arkitektur {#atlas-cloud-advantage}
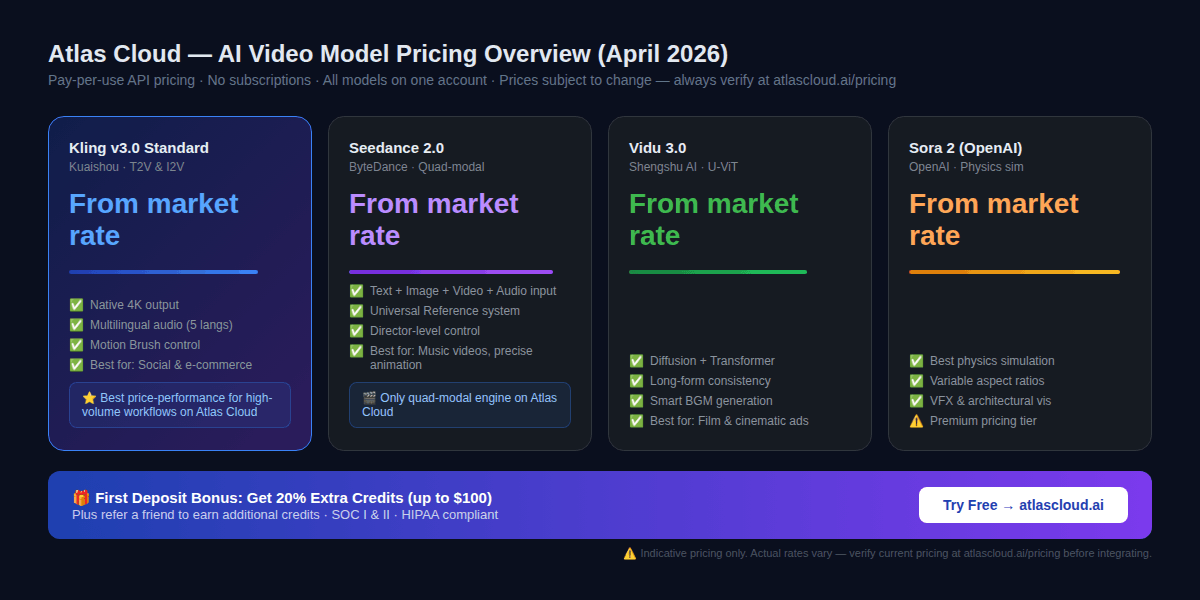
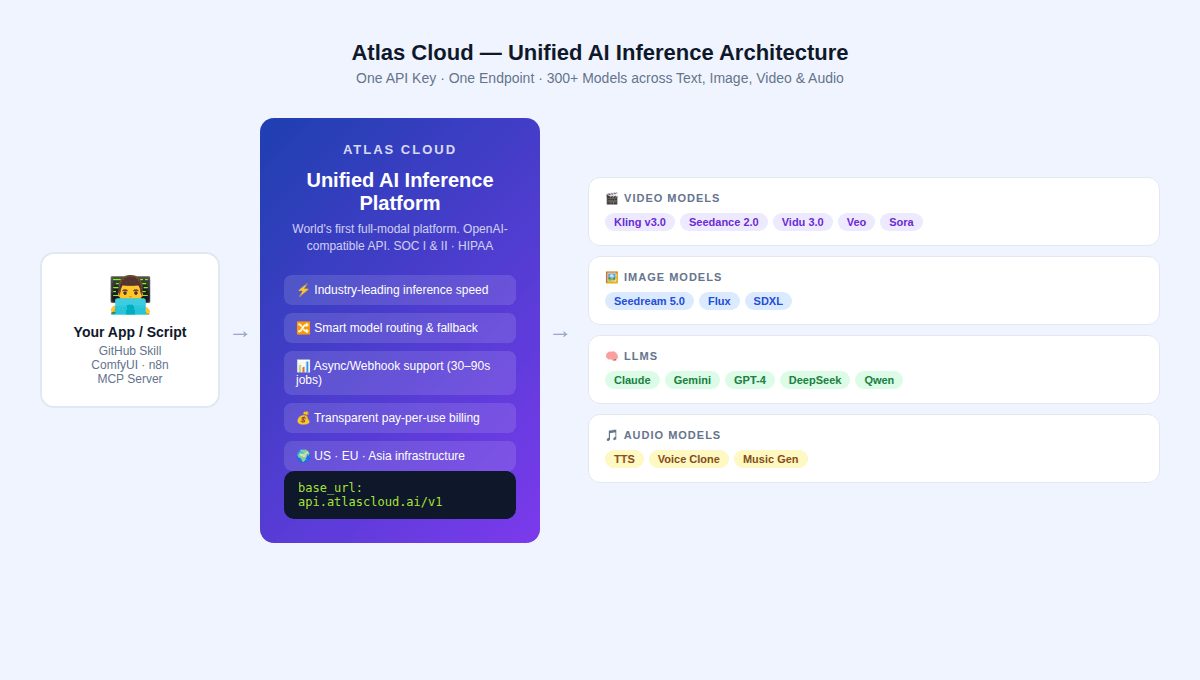
Atlas Cloud positioneras som världens första fullmodala AI-inferensplattform – ett enhetligt API som betjänar 300+ modeller över text-, bild-, video- och ljudgenerering.
För författare av GitHub AI-videogenereringsfärdigheter är de specifika fördelarna:
-
OpenAI-kompatibelt API (Drop-In-ersättning)
Atlas Cloud använder en OpenAI-kompatibel slutpunkt. Om din färdighet redan integrerar med OpenAI SDK kräver byte till Atlas Cloud för videogenerering att du ändrar två rader: api_key och base_url. Ingen ny SDK, inget nytt autentiseringssystem.
-
En enda fakturering för arbetsflöden med flera modeller
Produktionsvideoarbetsflöden använder sällan en modell. En typisk pipeline kan använda:
- Seedream 5.0 för bildgenerering (startbilder)
- Kling v3.0 för bild-till-video-omvandling
- En LLM (Claude, GPT-4 eller DeepSeek) för promptoptimering
- En TTS-modell för berättarröst
Med separata leverantörskonton är detta fyra faktureringsrelationer, fyra rate limit-pooler och fyra integrationspunkter. Med Atlas Cloud är det en API-nyckel och en faktura.
-
Prisgenomskinlighet på modellnivå
Atlas Cloud publicerar prissättning per modell utan dolda beräkningsavgifter. Affärsmodellen är enkel: betala för det du genererar. Nya utvecklare får en 20% bonus på sin första insättning (upp till $100), och ett hänvisningsprogram ger ytterligare krediter. Verifiera alltid aktuell prissättning på atlascloud.ai/pricing innan du bygger ekonomiska prognoser.
-
Efterlevnadstäckning
För GitHub-färdigheter i företagsmiljöer som används i reglerade miljöer: Atlas Cloud innehar SOC I & II-certifiering och är HIPAA-kompatibelt, med infrastruktur över USA, EU och Asien. Detta täcker majoriteten av företagens krav på dataresidens.
-
ComfyUI, n8n och MCP Server-integration
Atlas Cloud integreras inbyggt med de verktyg som oftast används för att bygga GitHub-videogenereringsfärdigheter:
- ComfyUI – anpassade noder för visuellt arbetsflödesskapande
- n8n – arbetsflödesautomation med Atlas Cloud videogenereringssteg
- MCP Server – Model Context Protocol-integration för AI-agentramverk
-
Vilken stack bör du faktiskt använda? {#decision-guide}
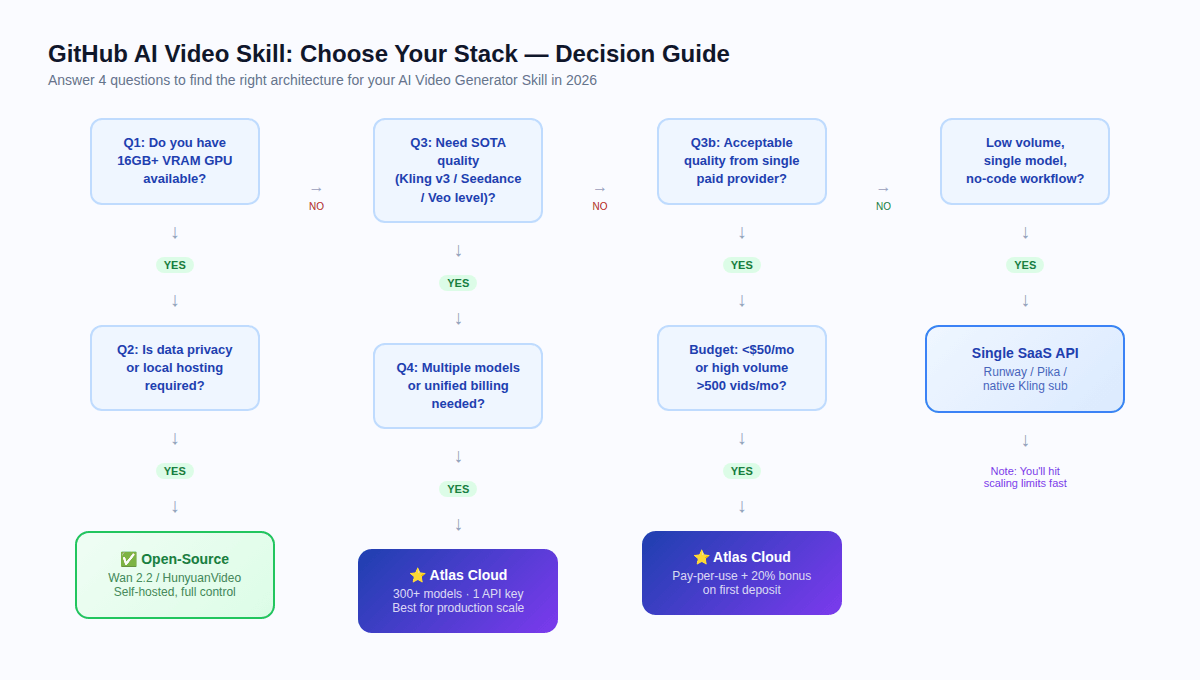
Gå igenom dessa fyra frågor:
F1: Har du 16 GB+ VRAM GPU tillgängligt?
Om nej → hoppa över egen hosting helt. Moln-API är din enda praktiska väg.
F2: Kräver datasekretess eller lokal hosting enligt regler?
Om ja + GPU tillgänglig → utvärdera öppen källkod (Wan 2.2 eller HunyuanVideo beroende på VRAM).
Om ja + ingen GPU → använd Atlas Cloud (HIPAA-kompatibelt, SOC-certifierat) och granska dina specifika regulatoriska krav.
F3: Kräver du SOTA-kvalitet (Kling v3, Seedance 2.0, Veo-nivå)?
Om ja → moln-API krävs. Modeller med öppen källkod har ett betydande kvalitetsgap jämfört med topproprietära modeller 2026.
Om acceptabel kvalitet på öppen källkod-nivå → Wan 2.2 egenhärbärgerad kan fungera.
F4: Behöver du flera modeller eller enhetlig fakturering?
Om ja → Atlas Cloud. Att hantera tre leverantörskonton i skala har en dold operativ kostnad som bara blir synlig vid produktionsvolym.
Sammanfattande rekommendationer per användningsfall
| Användningsfall | Rekommenderad stack |
| Forskning / prototypning | Öppen källkod (Wan 2.2, CogVideoX) |
| Sociala medier-byrå, 500+/månad | Atlas Cloud + Kling v3.0 |
| Musikvideo / karaktärsanimation | Atlas Cloud + Seedance 2.0 |
| VFX / fysiksimulering | Atlas Cloud + Sora 2 |
| Datasuverän / offline | Egenhärbärgerad (HunyuanVideo, Open-Sora 2.0) |
| SaaS med nivåindelad modellkvalitet | Atlas Cloud (en nyckel, flera modeller) |
| Högvolym open source-batch | Wan 2.2 egenhärbärgerad (10 000+/månad tröskel) |
-
FAQ {#faq}
F: Vad är en AI-videogenereringsfärdighet?
En återanvändbar kodmodul eller integrationslager som kopplar en applikation till en backend för AI-videogenerering – antingen vikter med öppen källkod eller ett moln-API. Vanliga former: Python-klass, ComfyUI-nod, n8n-arbetsflöde, MCP Server-verktyg.
F: Vad är minsta VRAM för egen hosting av en videomodell med öppen källkod?
8 GB VRAM för Wan 2.2 1.3B (acceptabel kvalitet för korta klipp). 16 GB för CogVideoX-1.5 eller Open-Sora (bättre kvalitet). 24 GB+ för Wan 2.2 14B. 60–80 GB för HunyuanVideo eller Open-Sora 2.0 full modell.
F: Är AI-videogenerering med öppen källkod faktiskt gratis?
Modellvikterna är gratis. Inferens är inte gratis – det kräver GPU-beräkning. Vid låg volym (<5 000 videor/månad) är moln-API:er som Atlas Cloud vanligtvis billigare när total ägandekostnad beräknas.
F: Kan jag använda Atlas Cloud för bild-till-video (i2v)-arbetsflöden?
Ja. Atlas Cloud stöder i2v-varianter för Kling, Seedance och Vidu. Notera: för i2v-modeller accepterar vissa varianter inte en separat bildförhållande-parameter – utdatarpsupplösningen följer indatabildens dimensioner.
F: Hur hanterar Atlas Cloud rate limiting?
Atlas Cloud stöder Async/Webhook-mönster. Videogenereringsjobb skickas in som uppgifter; din applikation får ett uppgifts-ID och meddelas när renderingen är klar. Detta förhindrar blockering i skala.
F: Vilken är den bästa modellen för karaktärskonsistens över bilder?
Seedance 2.0:s Universal Reference-system är den mest avancerade lösningen 2026. Det gör att du kan mata in referensvideor, bilder och ljud för att upprätthålla konsekvent karaktärsutseende och rörelse över genererade klipp.
F: Stöder Atlas Cloud ComfyUI?
Ja. Atlas Cloud har inbyggd ComfyUI-integration, samt n8n-noder och MCP Server-kompatibilitet.
F: Hur hanterar videomodeller med öppen källkod bildförhållanden?
Varierar per modell. Open-Sora stöder 16:9, 9:16, 1:1 och 2.39:1 via flaggan --aspect_ratio. Wan 2.2 och LTX-Video stöder flera bildförhållanden. För i2v-arbetsflöden följer de flesta modeller indatabildens bildförhållande oavsett angivna parametrar.
Sammanfattning
Landskapet 2026 delas i två läger, var och en med sin sweet spot:
Öppen källkod är vettigt om du har reserv-GPU:er, du producerar 10K+ videor i månaden, data inte kan lämna dina servrar, eller du behöver finjustera på ditt eget proprietära material.
Betalda API:er är det bättre valet om du behöver bästa tillgängliga kvalitet, hastighet är viktigare än kostnad, du är under 5K videor i månaden, eller du vill blanda flera modeller utan att jonglera med leverantörskontrakt.
Atlas Cloud** överbryggar de två:** som en enhetlig plattform som ger tillgång till 300+ modeller – inklusive de bästa modellerna med öppen källkod via hanterad inferens och varje större proprietär modell – via en enda OpenAI-kompatibel API-nyckel. För de flesta utvecklare som bygger produktionsredo GitHub AI-videogenereringsfärdigheter 2026 är det vägen med lägst friktion från prototyp till produktion.
Prissättningsinformation i denna artikel är indikativ och kan komma att ändras. Verifiera alltid aktuella priser på atlascloud.ai/pricing innan du bygger ekonomiska prognoser. Modelltillgänglighet kan variera per region.
Atlas Cloud: atlascloud.ai – SOC I & II-certifierad · HIPAA-kompatibel · US · EU · Asien-infrastruktur


