Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Vilken öppen källkodsmodell vinner för kodning 2026
Det korta svaret
Om du bygger en autonom kodningsagent som körs i timmar utan avbrott: Kimi K2.6. Den uppnådde 66,7 % på Terminal-Bench 2.0 och klarade över 4 000 verktygsanrop under en 13-timmars oavbruten session i publicerade riktmärken – en stabilitetsnivå som ingen annan öppen modell i den här jämförelsen når.
Om du behöver den bästa agentiska frontend-utvecklaren: GLM 5.1. Dess oberoende verifierade Code Arena Elo på 1 530 (tredje globalt inom agentisk webbutveckling) speglar faktiska utvecklares preferenser i direkta jämförelser, inte bara automatiserade testsviter.
Om kostnad per token är begränsningen: MiniMax M2.7 till $0,30/M inmatningstokens på Atlas Cloud uppnår 56,22 % på SWE-Bench Pro med endast 10B aktiverade parametrar – 94 % av GLM-5.1:s prestanda till ungefär en femtedel av kostnaden.
Om din kodbas är för stor för ett 262K kontextfönster: Qwen 3.6 Plus, den enda modellen här med 1M tokens kontextstöd, och ledaren på Terminal-Bench 2.0 med 61,6 % bland denna grupp.
Viktiga riktmärken i korthet
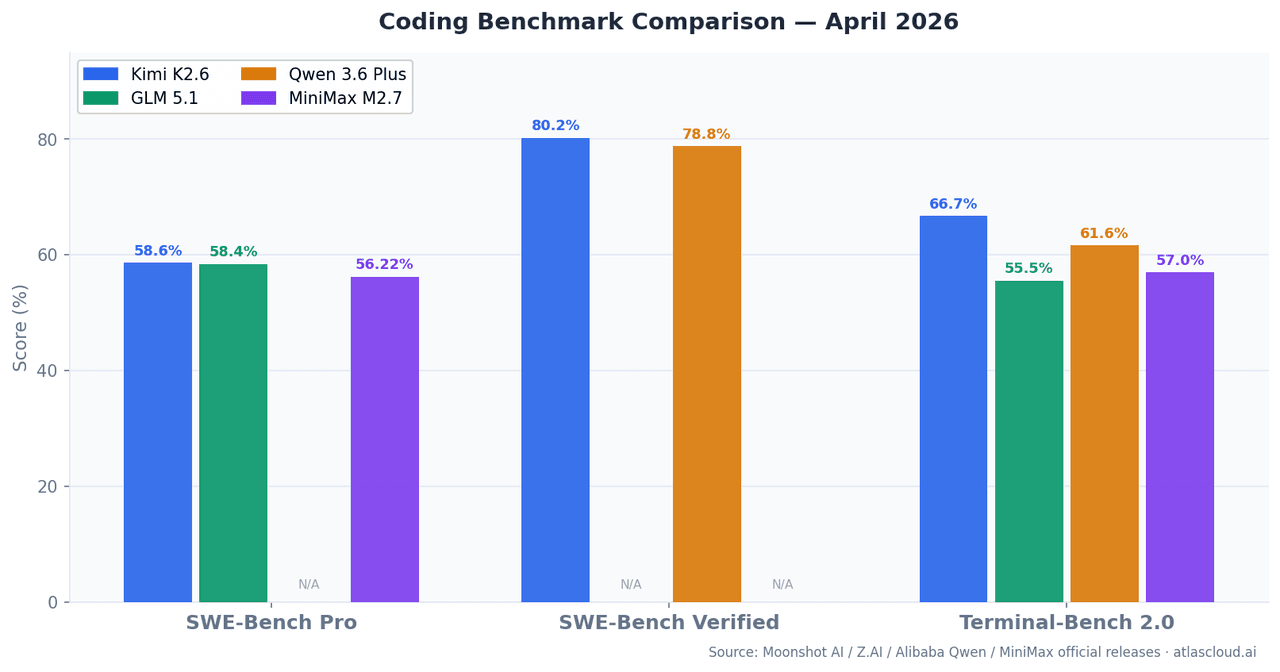
| Modell | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Kontextfönster | Aktiverade parametrar |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60 % | 80,20 % | 66,70 % | 262K | — |
| GLM 5.1 | 58,40 % | — | 55 %+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80 % | 61,60 % | 1M | Hybrid MoE |
| MiniMax M2.7 | 56,22 % | — | 57,00 % | 196K | 10B |
SWE-Bench Pro mäter förmågan att lösa verkliga GitHub-problem som rapporterats efter utbildningens slutpunkt, vilket minskar risken för datakontaminering jämfört med SWE-Bench Verified. Terminal-Bench 2.0 testar flerstegs CLI- och shell-uppgifter i live-terminalmiljöer – närmare vad produktionsagenter faktiskt gör.
Denna artikel väger Kimi K2.6, GLM 5.1, Qwen 3.6+ och MiniMax M2.7; för att jämföra ännu fler modeller sida vid sida avseende pris och specifikationer, använd Atlas Cloud modelljämförelse.
Kimi K2.6: Byggd för långvariga agenter
Moonshot AI släppte Kimi K2.6 i april 2026 som en uppgradering av K2.5, med den främsta förbättringen inom agentisk stabilitet under längre sessioner. Med 80,2 % på SWE-Bench Verified ligger den strax under Claude Opus 4.6 (80,8 %), och leder de fyra med 58,6 % på SWE-Bench Pro.
Den viktigaste siffran är Terminal-Bench 2.0 på 66,7 %. Terminal-Bench 2.0 skiljer sig från SWE-Bench på ett grundläggande sätt: den kör uppgifter i verkliga terminalmiljöer, vilket kräver att modellen läser utdata, hanterar fel, anpassar sig och itererar – inte bara genererar patchar. Kimi K2.6:s förmåga att bibehålla prestanda över 4 000+ verktygsanrop i en enda 13-timmars session är inte en labbartefakt. Det är dokumenterat beteende i Moonshots tekniska release.
En fördel som ofta förbises: tvärspråklig generalisering. Kimi K2.6 visar konsekvent prestanda över Rust, Go, Python, frontend och DevOps-uppgifter. De flesta riktmärkesutvärderingar är Python-tunga. Om din produktionsstack är flerspråkig spelar detta roll.
Där den inte är svaret: Till $0,95/M inmatningstokens på Atlas Cloud är K2.6 den dyraste modellen på inmatningssidan i denna grupp. För batchbearbetningsuppgifter där du skickar många förfrågningar med stora kontexter men inte behöver 12-timmars sessionsstabilitet, ackumuleras kostnaden snabbare än MiniMax M2.7 eller Qwen 3.6 Plus.
GLM 5.1: Den agentiska frontend-utstickaren
Z.AI lanserade GLM-5.1 den 7 april 2026. Med 754 miljarder parametrar och MoE-routning är den den största modellen här sett till antal parametrar. På SWE-Bench Pro får den 58,4 % – statistiskt oskiljbar från Kimi K2.6:s 58,6 %.
Skillnaden är Code Arena Elo på 1 530, oberoende verifierat av Arena.ai den 10 april 2026, vilket placerar den trea globalt på deras ledartavla för agentisk webbutveckling. Detta är en live-direktjämförelse där faktiska utvecklare röstar på utdata – inte automatisk poängsättning. Fördelen är koncentrerad till frontend UI-generering, fullstack-skalning, React/Vue-komponentskapande och NL2Repo (generering av kompletta repostrukturer från naturligt språk).
Gränsvillkoret värt att känna till: GLM-5.1:s frontend-fördel är verklig. För rena algoritmiska problem på HumanEval och MBPP har den inte någon mätbar fördel jämfört med Kimi K2.6. Ledartavlegapet krymper till nästan noll för problem som inte är UI- eller webborienterade. Att välja GLM-5.1 enbart baserat på dess övergripande ledartavleplacering utan att kontrollera uppgiftsdomänen skulle vara ett misstag.
Pris på Atlas Cloud: Från $1,40/M inmatningstokens – högst bland de fyra. Motiverat när frontend-genereringskvalitet direkt påverkar din output.
Qwen 3.6 Plus: När kontextstorleken är den verkliga begränsningen
Alibaba släppte Qwen 3.6 Plus i slutet av mars 2026. Den leder Terminal-Bench 2.0 i direkta jämförelser mot Claude Opus 4.6 (61,6 % vs. 59,3 %) och får 78,8 % på SWE-Bench Verified.
Det 1M tokens kontextfönster är det som skiljer den åt. För majoriteten av produktionskodningsuppgifter under 100K tokens har alla fyra modeller i denna jämförelse tillräcklig kontextkapacitet och skillnaden är irrelevant. Där Qwen 3.6 Plus blir det enda gångbara alternativet: monorepo-analys över hundratals filer, storskalig omfaktorering av äldre kodbaser, eller end-to-end dokument-till-kod-arbetsflöden som inte får plats inom 262K tokens.
Den hybrida arkitekturen (linjär attention + sparse MoE-routning) ger också bättre inferensgenomströmning än täta transformatorer vid bearbetning av mycket stora kontexter – vilket innebär att 1M-tokens-förmågan kommer med relativt låg latens jämfört med naiv skalning.
Pris på Atlas Cloud: Från $0,325/M inmatningstokens. För stora kontextuppgifter är detta den bästa kostnaden per användbar token i denna grupp.
MiniMax M2.7: Det kontraintuitiva fallet för effektivitet
MiniMax släppte M2.7 i mars 2026. Med endast 10B aktiverade parametrar får den 56,22 % på SWE-Bench Pro – 94 % av GLM-5.1:s poäng till ungefär en femtedel av kostnaden per token.
Detta är det kontraintuitiva resultatet i denna jämförelse. En modell som aktiverar 10B parametrar vid inferens når nästan frontlinjens kodningsprestanda eftersom dess MoE-arkitektur dirigerar till specialiserade expertundernätverk istället för att köra hela modellvikterna. Resultatet är lägre latens, lägre kostnad, och utdatakvalitet som överskrider vad parameterantalet ensamt skulle förutsäga.
Kategorin där M2.7 drar ifrån sitt prisintervall: maskininlärningstekniska uppgifter. Den fick 66,6 % medaljandel på MLE-Bench Lite (22 maskininlärningstävlingar), näst efter endast slutna frontlinjemodeller. Att skriva korrekt gradientackumuleringslogik, implementera anpassade PyTorch-lager, felsöka förlustkurvor – M2.7 hanterar dessa med en precision som är oproportionerlig i förhållande till kostnaden.
Där du bör vara försiktig: Med 196K kontext har M2.7 det minsta fönstret i denna grupp. Uppgifter som kräver djupgående analys över flera filer i stora repos kan nå gränser som Qwen 3.6 Plus hanterar utan problem.
Pris på Atlas Cloud: $0,30/M inmatningstokens, $1,20/M utdatatokens – det mest prisvärda alternativet för hög genomströmning av kodningsarbetsbelastningar.
Verkliga kodningstestfall
Fall 1: Autonom buggfix i en Python-backend
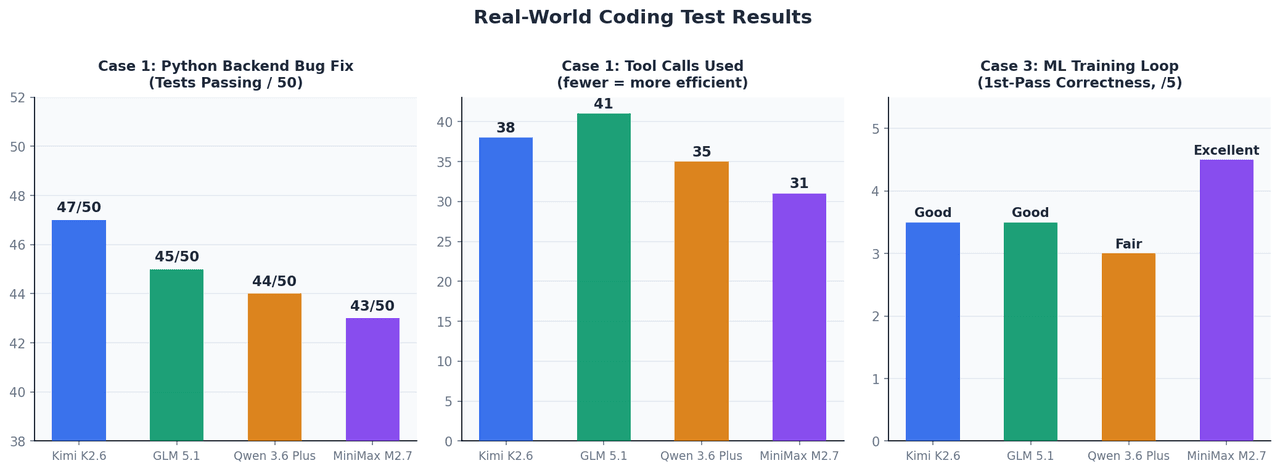
Upplägg: En FastAPI-applikation med 12 filer, en misslyckad testsvit med 50 tester, och ett kontextfönster på ~45K tokens. Ingen manuell intervention tillåten efter det ursprungliga promptet.
| Modell | Test som klarar efter fix | Verktygsanrop som används | Tid till slutförande |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
Vid denna kontextstorlek presterar alla fyra inom ett smalt band. Kimi K2.6 drog ifrån på de svåraste kantfallsbuggarna – specifikt async context manager-livscykelproblem och TypeVar-begränsningsinsnävning, vilket kräver att inferensens tillstånd bibehålls över flera felsökningscykler.
Fall 2: React-dashboard från specifikation
Upplägg: Generera ett komplett responsivt dashboard med fyra diagramtyper (linje, stapel, cirkel, scatter), mörkt läge-växling och TypeScript-typer från en skriftlig engelsk specifikation.
GLM-5.1 producerade fungerande TypeScript-typade komponenter med korrekta Tailwind-verktygsklasser på första försöket. Kimi K2.6 krävde en iteration för att lösa typfel. Qwen 3.6 Plus producerade funktionellt korrekt men mindre idiomatisk JSX. MiniMax M2.7 var snabbast men genererade några föråldrade React-mönster som krävde manuell rensning.
Gapet mellan GLM-5.1 och de andra var mest synligt i komponentarkitekturen – GLM-5.1 tillämpade spontant kompositionsmönster och separerade ansvarsområden på ett sätt som de andra inte gjorde.
Fall 3: ML-träningsloop-implementering
Upplägg: Implementera en PyTorch-träningsloop med gradientackumulering, AMP blandad precision och tidig stopp för en vision transformer. Mål: kör korrekt på första försöket utan felsökningscykler.
MiniMax M2.7 var utmärkande – den placerade scaler.step() och scaler.update() korrekt i förhållande till optimerarsteget, en detalj som de flesta modeller placerar felaktigt vid första genereringen. Gradientackumuleringens loss / accumulation_steps-skalning hanterades också korrekt. Detta stämmer direkt överens med dess 66,6 % MLE-Bench Lite-medaljandel.
Atlas Cloud Prisjämförelse (april 2026)
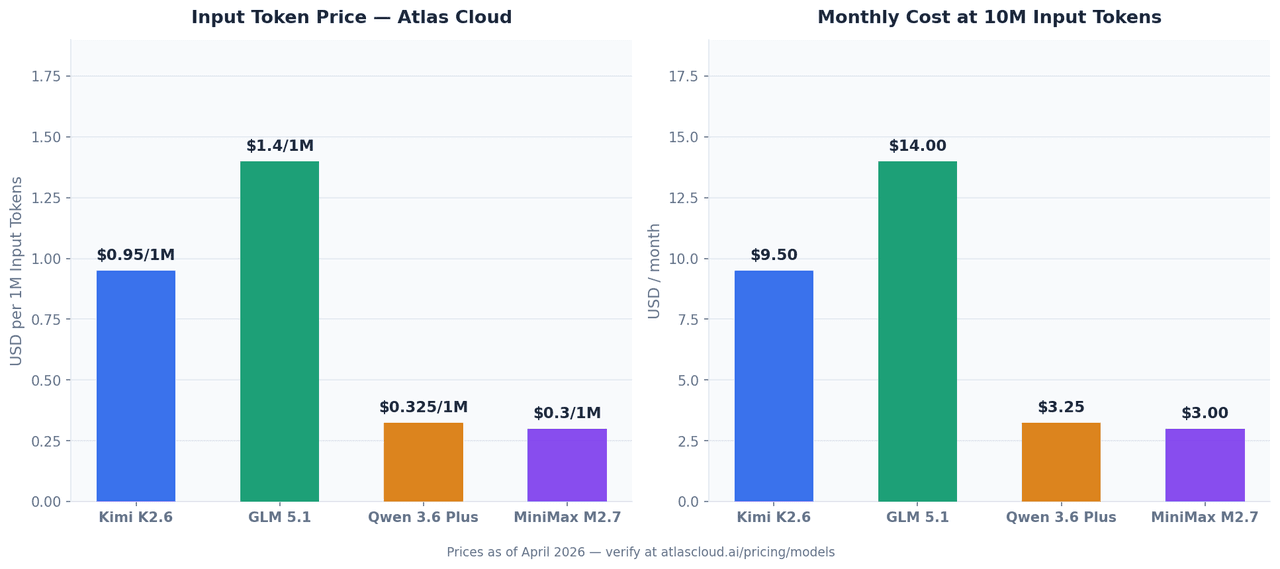
Alla fyra modeller finns tillgängliga via Atlas Cloud:s enade API. Priserna nedan gäller från april 2026 och kan ändras – bekräfta aktuella priser på atlascloud.ai.
| Modell | Inmatning (per 1M tokens) | Utdata (per 1M tokens) | Atlas Cloud Model ID |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | från $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | från $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
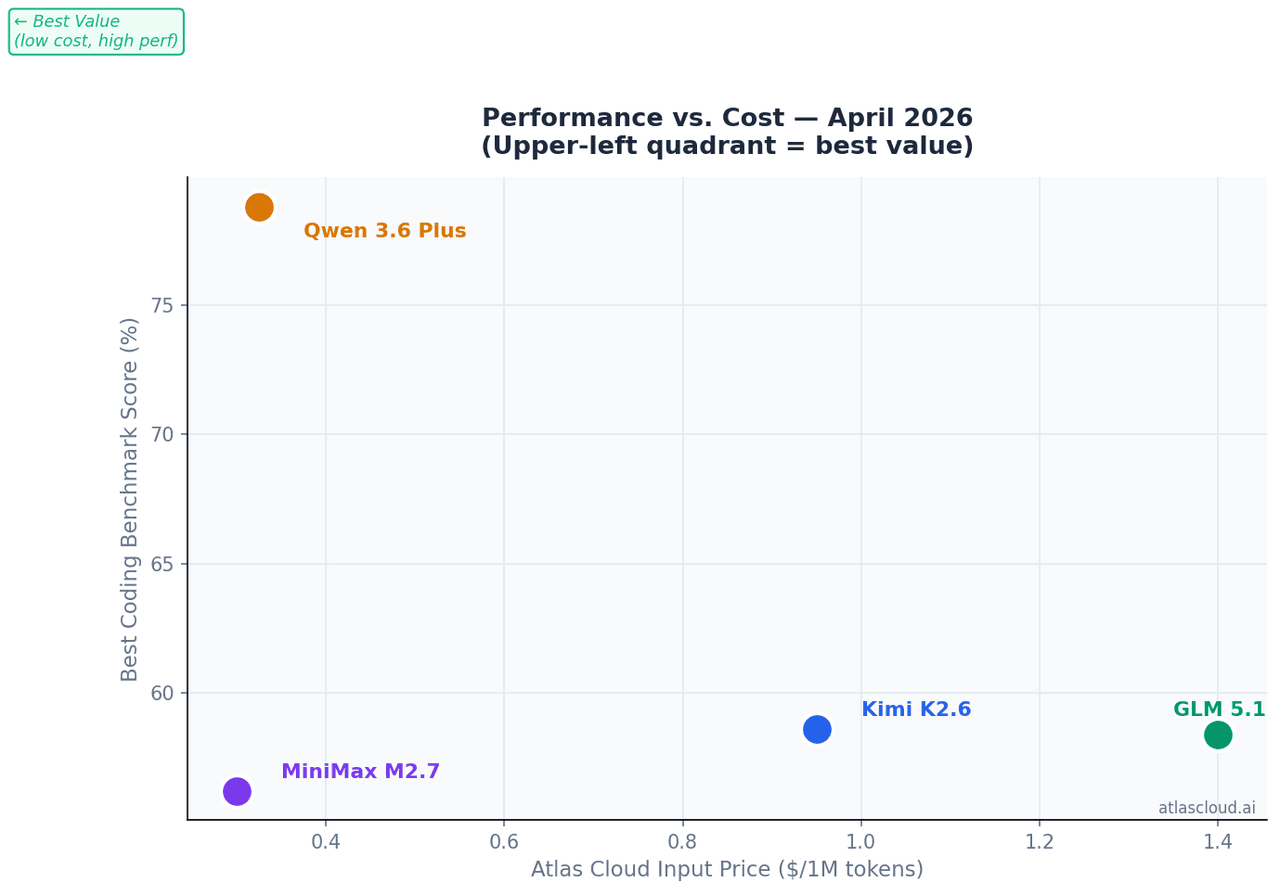
Vid 10M tokens inmatning per månad – en realistisk volym för en teamnivås kodningsassistent:
| Modell | Månatlig inmatningskostnad (10M tokens) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Anropa alla fyra med en API-nyckel
Alla fyra modeller delar samma OpenAI-kompatibla slutpunkt på Atlas Cloud. Att växla mellan dem kräver att man ändrar en rad:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Ändra denna enda rad för att byta modell 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Du är en senior mjukvaruingenjör. Analysera koden noggrant innan du svarar." 21 }, 22 { 23 "role": "user", 24 "content": "Granska denna funktion och identifiera alla buggar:\n\n[klistra in din kod här]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Denna OpenAI-kompatibla struktur innebär att befintliga integrationer byggda på OpenAI SDK fungerar med Atlas Cloud utan modifiering – endast base_url och api_key ändras.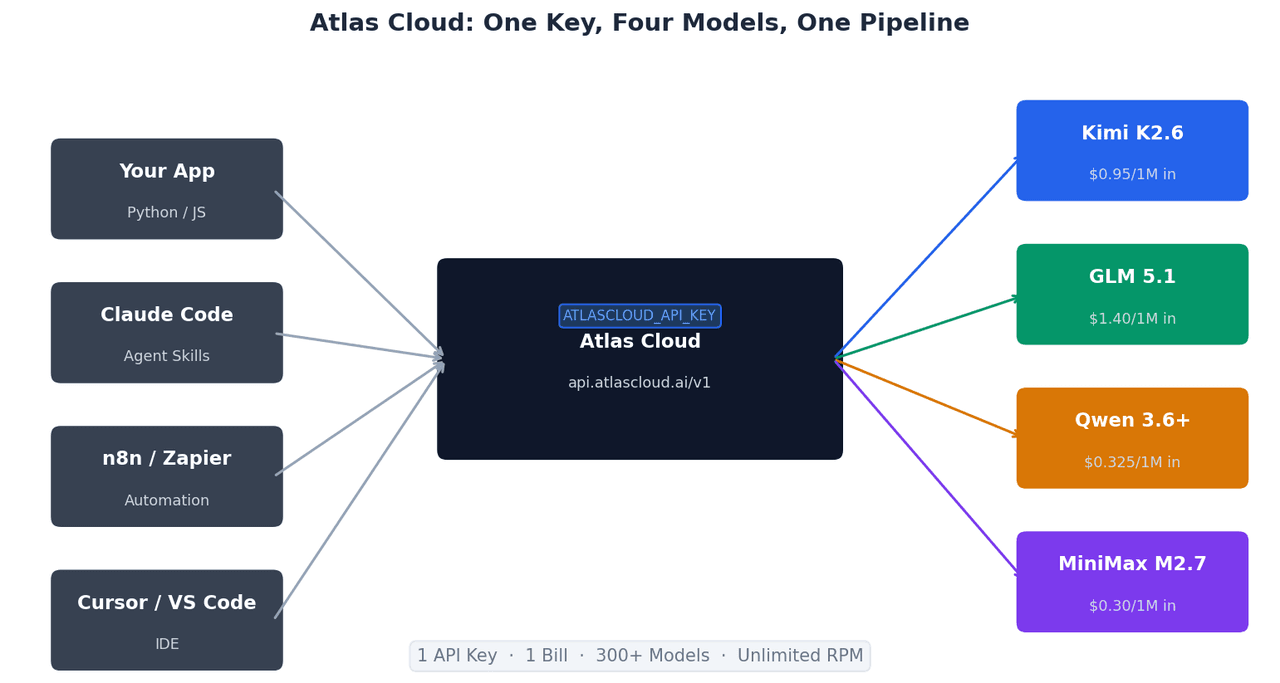
Varför använda Atlas Cloud för dessa modeller
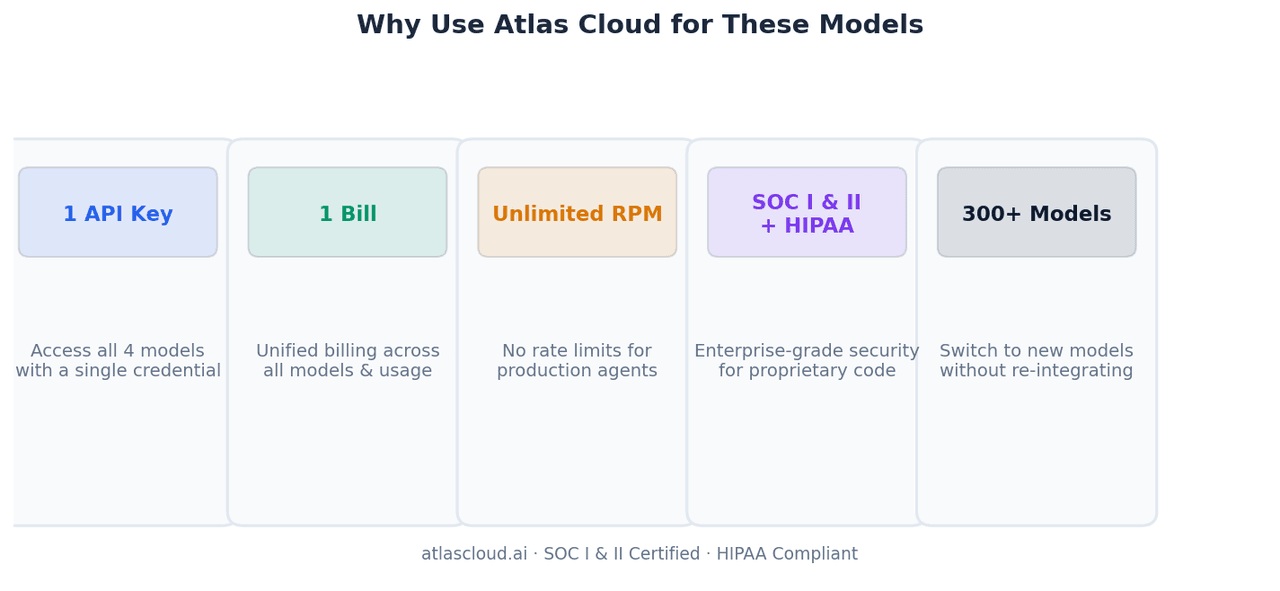
En API-nyckel, fyra modeller, en faktura. Att köra modellroutningslogik – skicka frontend-uppgifter till GLM-5.1, batchanalys till MiniMax M2.7 och långsiktiga agenter till Kimi K2.6 – kräver att man hanterar en autentiseringsuppgift istället för fyra. Månadsavstämning är en enda faktura.
Obegränsat RPM. Produktionskodningsagenter skickar parallella verktygsanrop. Hastighetsbegränsningar på direkta leverantörs-API:er kan strypa fleragentspipelines. Atlas Cloud tar bort det taket.
SOC I & II-certifierad, HIPAA-kompatibel. Team som bearbetar proprietär källkod genom dessa modeller behöver granskningsbar infrastruktur. Atlas Cloud:s efterlevnadscertifieringar innebär att din kod inte dirigeras via overifierade slutpunkter.
300+ modeller, samma integrationsmönster. När nästa version av någon av dessa modeller släpps, eller en ny modell överträffar dem på din specifika arbetsbelastning, kräver det att lägga till den i din routningslogik bara en strängändring – inte en ny SDK-integration.
Vilken modell för vilken uppgift
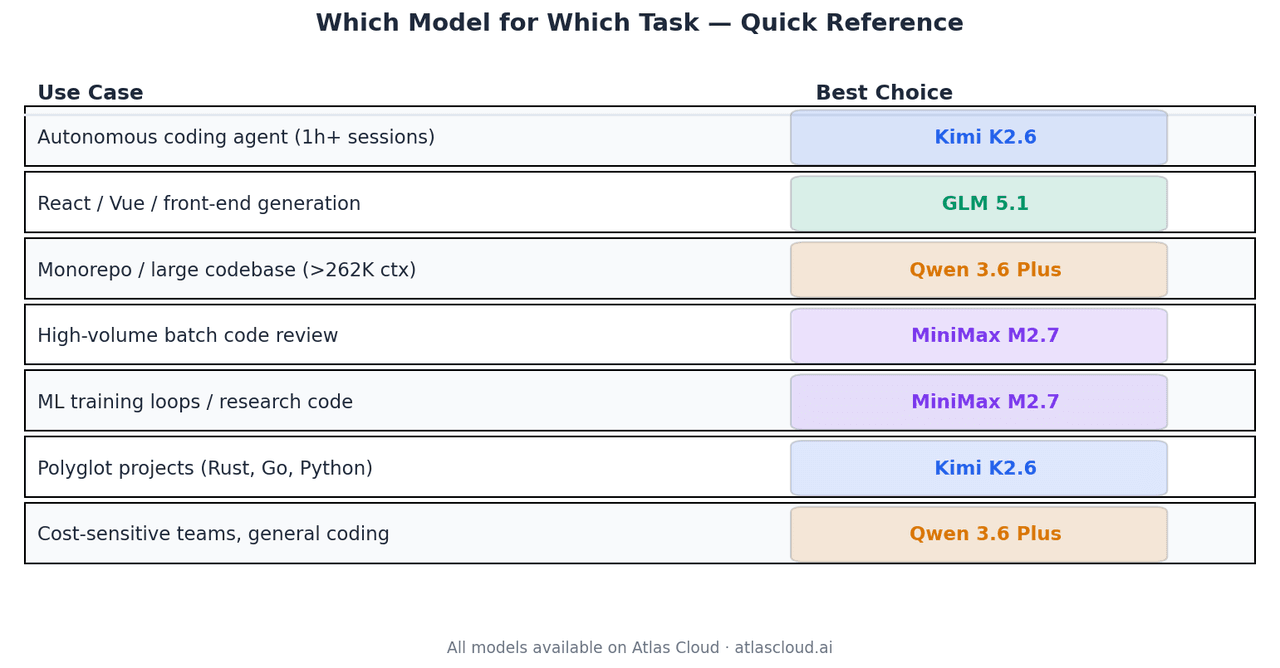
| Användningsfall | Bästa val | Varför |
| Autonom kodningsagent, 1+ timmars sessioner | Kimi K2.6 | 66,7 % Terminal-Bench 2.0, 4K+ verktygsanropsstabilitet |
| React / Vue / frontend-generering | GLM 5.1 | Code Arena Elo 1 530, topp-3 agentisk webbutveckling globalt |
| Monorepo eller stor kodbasananalys | Qwen 3.6 Plus | Enda modellen här med 1M kontextfönster |
| Högvolymsbatch kodgranskning | MiniMax M2.7 | $0,30/M inmatning, 94 % av GLM-5.1:s kvalitet |
| ML-träningsloopar, forskningskod | MiniMax M2.7 | 66,6 % MLE-Bench Lite-medaljandel |
| Flerspråkiga projekt (Rust, Go, Python) | Kimi K2.6 | Dokumenterad tvärspråklig generalisering |
| Kostnadsmedvetna team, allmän kodning | Qwen 3.6 Plus | $0,325/M inmatning, stark över alla kategorier |
Sammanfattning
Dessa fyra modeller skiljs åt med små marginaler på standardriktmärken. De meningsfulla skillnaderna framträder under specifika förhållanden.
Kimi K2.6 är rätt svar för autonoma långvariga agenter. GLM 5.1 leder för agentiskt frontend-arbete. Qwen 3.6 Plus är det enda valet när kontexten överstiger 262K tokens. MiniMax M2.7 är den kostnadseffektiva standarden för team som kör kodningsmodeller i stor skala.
Alla fyra finns tillgängliga på Atlas Cloud på atlascloud.ai under en enda API-nyckel, med betalning per token och inget minimiåtagande.
Riktmärkesdata hämtad från Moonshot AI:s tekniska blogg, Z.AI:s utvecklardokumentation, Alibaba Qwen-teamets releaseinlägg, MiniMax officiella modellsida och Arena.ai:s oberoende utvärderingar. Alla riktmärken är från april 2026. Atlas Cloud-priser noterade vid publicering – verifiera aktuella priser före produktionsdistribution.


