

Ett användbart minnestest är mindre som att fråga: "Vad kommer du ihåg om mig?" och mer som en kontroll utan hjälpmedel med en rättelse och några distraktioner. För att köra ett muse wonder active memory test, ge Muse Wonder påhittade detaljer i en konversation, rätta en av dem och fråga sedan efter de relevanta aktuella fakta i en ny konversation. Anteckna vad den hämtar, vad den får fel och om den erkänner osäkerhet.
Sekvensen nedan tar cirka 10 minuter att ställa in och poängsätta. Det är inte bevis för minne över dagar, konton eller alla Muse-produktytor. Det är en repeterbar första kontroll. Använd påhittade detaljer i stället för privat information.
Viktiga slutsatser
- Testa hämtning, rättelser, motståndskraft mot distraktorer, osäkerhet och spårbarhet separat.
- Kör testet i den produktyta du tänker använda, med dess minnesinställningar dokumenterade.
- En ny API-förfrågan testar bara beständigt minne om applikationen eller tjänsten tillhandahåller det.
- Metas MemoryBench är en mycket längre intern utvärdering; den här korta kontrollen återskapar den inte.
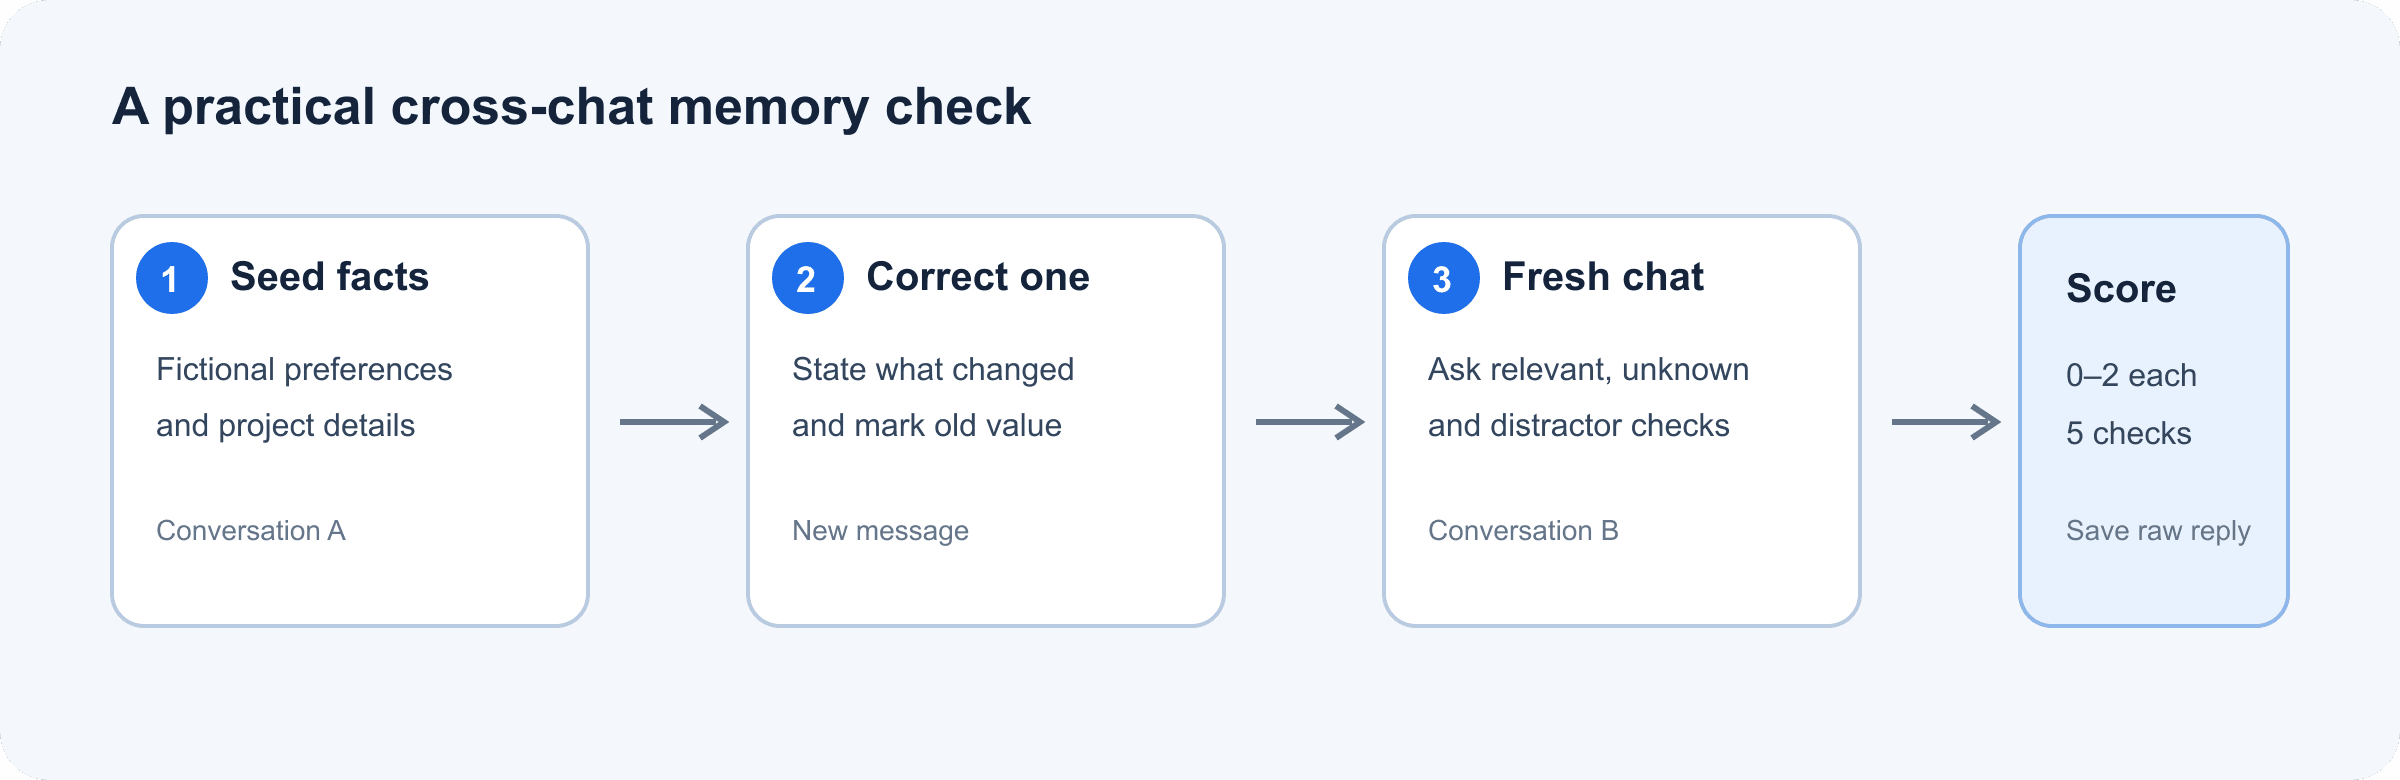
Muse Wonder Active Memory-testflöde från fiktiva detaljer via rättelse, hämtning i ny chatt och poängsättning
Testflödet separerar de inledande fakta, en uttrycklig rättelse och hämtning i en ny konversation.
Vad Muse Wonder Active Memory är tänkt att göra
Meta beskriver Active Memory som att bära viktig kontext om en person mellan konversationer och att hämta detaljer när de spelar roll för en senare uppgift. Active Focus avser fortsatt arbete mot ett mål, inklusive att prova alternativ när man kör fast och anpassa sig till ny information. Idéerna hänger samman, men de svarar på olika frågor: minne handlar om vilken kontext som återkallas; fokus handlar om hur arbetet fortskrider.
Den beskrivningen är ett påstående om produktens förmåga, inte en garanti för att varje gränssnitt eller API-anrop automatiskt delar en användares historik. Meta säger att Muse Wonder är tillgängligt via sitt Model API och Muse Code. Dess utvecklardokumentation listar ett kontextfönster på 1 048 576 tokens och stödda resonemangsinställningar, men ett kontextfönster är mängden kontext en förfrågan kan innehålla, inte bevis för att tidigare förfrågningar består. Kontrollera vilken historik eller vilket minne din valda produkt faktiskt tillhandahåller.
Så kör du ett Muse Wonder-minnestest
Använd ett enda konto och samma modellvariant under en hel körning. För en chattprodukt: aktivera minnesfunktionen du avser att utvärdera och anteckna dess inställning. För en API-integrering: notera om din egen applikation inkluderar tidigare turer, en lagrad profil eller hämtade anteckningar i förfrågan. Utan den informationen kan du inte tillskriva återkallelsen enbart modellen.
1. Ge den relevanta fakta
I den första konversationen: klistra in denna fiktiva profil. Be bara om en bekräftelse, så att modellen inte omedelbart förvandlar fakta till en plan.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Öppna en genuint ny konversation i samma produkt och fråga sedan:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Ett bra svar använder preferensen för lugna utomhusaktiviteter. Det behöver inte nämna budgeten eller skaldjuren, eftersom ingen av detaljerna behövs för att föreslå en aktivitet. Se upp för påhittade preferenser. Om produkten inte kan komma åt tidigare chattar eller minnet är avstängt, anteckna ”minne ej tillgängligt i denna yta” i stället för att poängsätta modellen som om den hade fått fakta.
2. Rätta ett inaktuellt faktum
I en annan testtråd: inför en bokning och ersätt den sedan uttryckligen. Håll rättelsen i ett separat meddelande så att du kan avgöra om den senare uppdateringen vinner.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Fråga om det i en ny konversation:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Godkänt om den anger torsdag kl. 10.00 och behandlar tisdag som inaktuell. Ett sammanslaget svar eller självsäker användning av tisdag är ett betydande misslyckande, även om den återkallade den ursprungliga detaljen perfekt.
3. Lägg till distraktorer och testa det okända
Lägg till två eller tre ofarliga fiktiva fakta i den inledande konversationen, till exempel en påhittad projektfärg eller ett påhittat paketnummer. Efter en fördröjning, starta en ny konversation och ställ en fråga om en relevant preferens plus en om ett faktum du aldrig angav. Håll frågorna åtskilda så att varje svar är lätt att poängsätta.
Ett starkt resultat använder den relevanta preferensen, utelämnar irrelevanta detaljer och säger att den inte känner till det saknade faktumet. För ett striktare fördröjningstest, upprepa samma prompt nästa dag. Tio minuter kan kontrollera en gräns för ny chatt, men det kan inte fastställa veckolång retention.
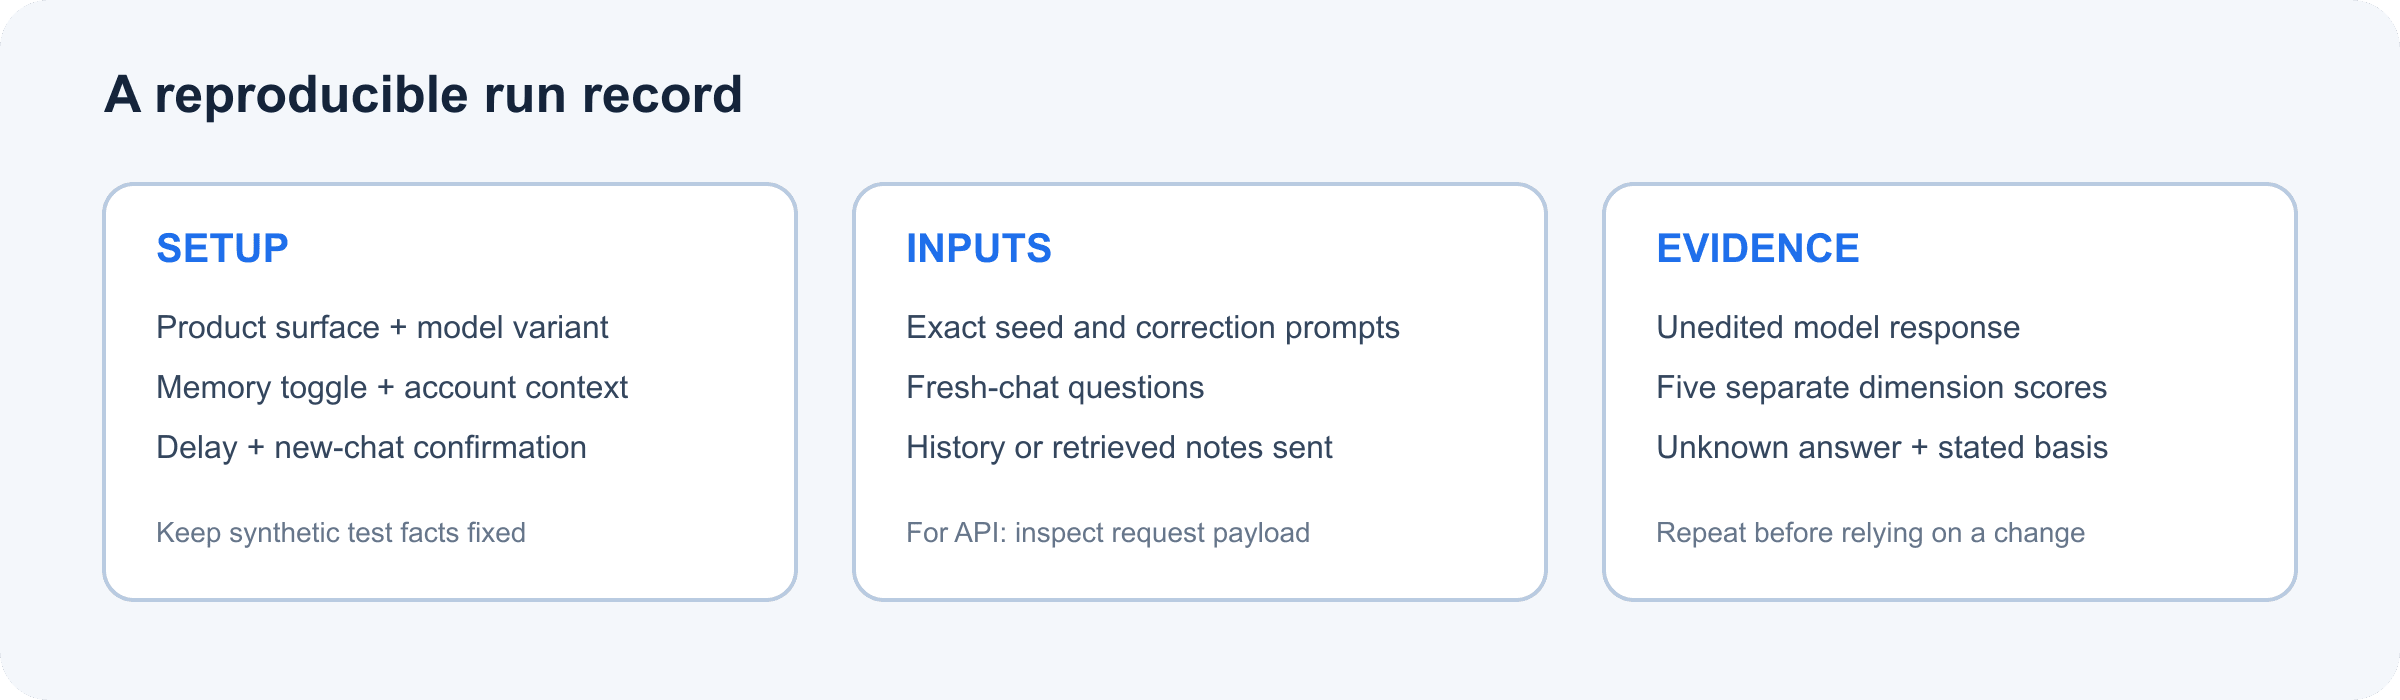
Muse Wonder Active Memory-testkort som visar uppsättning, frågor för ny chatt och bevis att anteckna
Behåll prompten, produktytan, minnesinställningen, fördröjningen och det råa svaret tillsammans så att en annan granskare kan reproducera kontrollen.
Så poängsätter du Active Memory-testet
Poängsätt varje beteende från 0 till 2. Använd resultatet för att jämföra körningar i ditt eget arbetsflöde, inte för att rangordna modeller universellt.
| Dimension | 0 poäng | 1 poäng | 2 poäng |
|---|---|---|---|
| Hämtning av relevanta fakta | Missar eller hittar på det nödvändiga faktumet | Delvis korrekt | Väljer rätt faktum korrekt |
| Hantering av rättelser | Använder det gamla värdet | Vag eller blandar båda | Använder det senaste värdet och identifierar det gamla som inaktuellt |
| Distraktorkontroll | Dras mot irrelevanta fakta | Inkluderar vissa irrelevanta detaljer | Använder endast kontext som är relevant för frågan |
| Osäkerhet | Gissar med självförtroende | Reserverar sig men gissar ändå | Säger tydligt att svaret inte tillhandahölls |
| Spårbarhet | Anger ingen grund | Anger bara en del av sin grund | Listar kort kontexten den förlitade sig på |
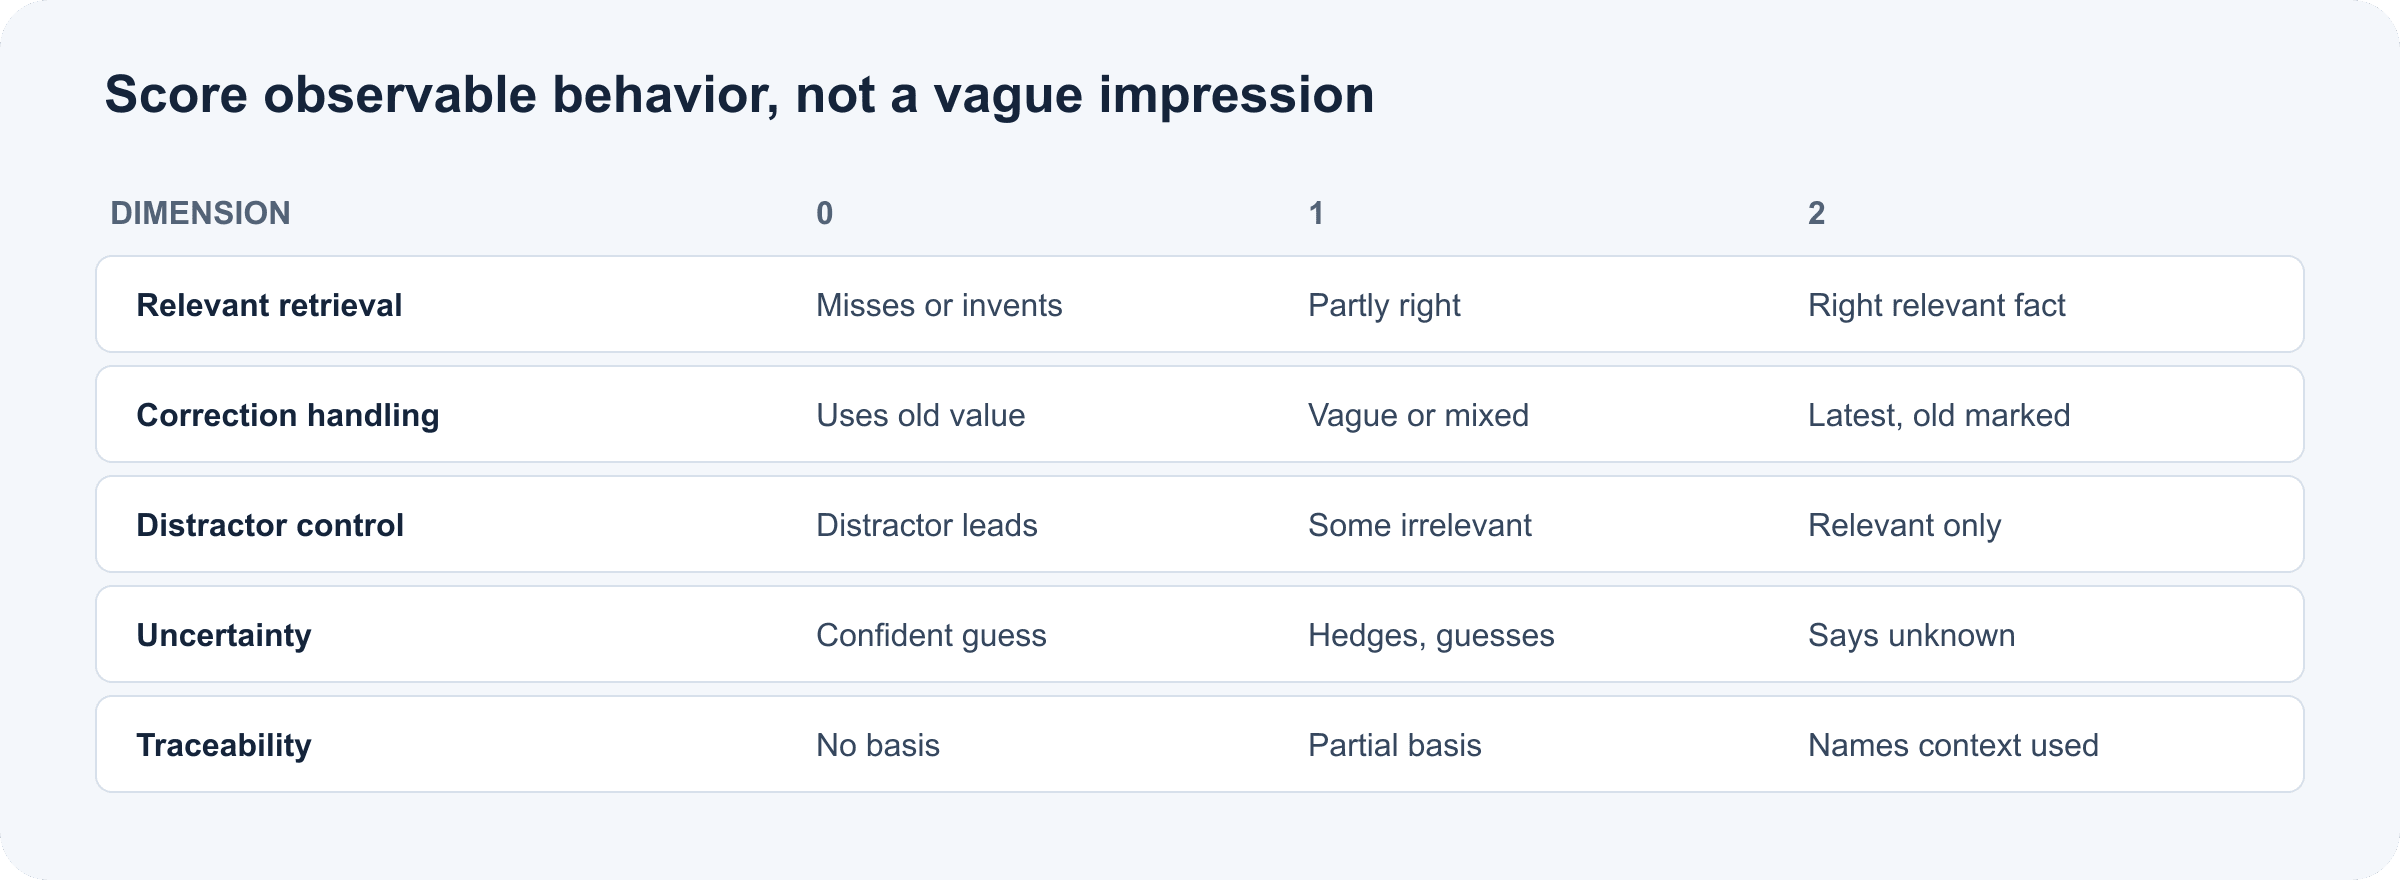
Fem Active Memory-poängdimensioner från noll till två poäng, med observerbara godkännandekriterier
0–2-rubriken gör ett subjektivt intryck till fem observerbara kontroller.
Tio poäng är en praktisk intern poäng, inte en validerad tröskel. Behåll poängen för varje enskild dimension: en totalsumma kan dölja ett allvarligt rättelsefel bakom bra återkallelse någon annanstans. Spara de exakta prompterna och oredigerade utdata och upprepa sedan körningen innan du ändrar ditt distributionsbeslut.
Vad MemoryBench kan och inte kan säga dig
Metas modellkort beskriver MemoryBench som en intern utvärdering över långa, komplexa konversationer på 64K till 100K tokens. Dess uppgifter inkluderar flera fakta, distraktorkonversationer och injicerade turer som motsäger eller senare uppdaterar måldetaljer; en LLM-domare poängsätter svar mot viktade, frågespecifika kriterier. Det är användbar kontext för att förstå benchmarkens omfattning, men det är inte samma sak som att en användares personliga minnesinställning fungerar mellan chattar.
Modellkortet förklarar uppgiftsdesignen; det gör inte den här 10-minutersövningen till en replikering. Metas publicerade poäng är bevis om det rapporterade utvärderingsupplägget. Din körning svarar på en snävare operativ fråga: hämtar just denna produktyta, konfiguration och detta konto de fakta som ditt arbetsflöde behöver? Ingen av dem ensam fastställer tillförlitligt minne för alla användare eller uppgifter.
Muse Wonder vs. Muse Wonder Full: var du ska testa
De två varianterna har inte identiska åtkomstvägar. Metas aktuella utvecklardokumentation säger att Muse Wonder (muse-wonder-1.0) är tillgängligt på Model API och i Muse Code. Muse Wonder Full är endast tillgängligt i Muse Code på planerna Power Usage och Maximum Usage. Att ställa in Muse Wonders resonemangsinsats på ”max” växlar inte över den till Wonder Full.
| Variant | Dokumenterad åtkomst | Vad du ska anteckna |
|---|---|---|
| Muse Wonder | Model API och Muse Code | API-modell-ID eller Muse Code-yta, plus om tidigare kontext tillhandahålls |
| Muse Wonder Full | Muse Code på planerna Power Usage och Maximum Usage | Plan, vald variant och minnesinställning som är tillgänglig i den ytan |
Kör samma fiktiva profil separat i varje tillgänglig yta. Jämför inte ett Muse Code-test som kan hämta sparade profildetaljer med ett tillståndslöst API-anrop som endast fick den aktuella prompten. Det skulle jämföra olika system, inte bara två modellvarianter.
Integritet och repeterbar testning
Använd påhittade preferenser, datum och projektinformation. Innan du provar riktiga data, granska produktens minneskontroller, raderingsväg, retentioninformation och inställning för dataanvändning. Metas API-dokumentation säger att innehåll i Standard mode inte används för att träna Metas modeller; Muse Code erbjuder också Contributor mode, som är på som standard och kan använda innehåll för träning om det inte stängs av. Kontrollera aktuella inställningar och villkor för produkten du använder i stället för att anta att alla ytor hanterar data likadant.
För ett API: separera modellen från din applikations minneslager. En databas, ett hämtningssystem eller en prompthistorik som din programvara skickar kan vara den som kommer ihåg. Logga vad applikationen hämtade och vad den skickade in i varje förfrågan, medan testposterna hålls syntetiska.
Team kan göra de tre omgångarna till en liten versionshanterad utvärderingsuppsättning. Håll faktaprofilen, rättelsen, distraktorerna, modellvarianten, produktinställningarna, fördröjningen och det råa svaret fasta. Kör om efter konfigurations- eller modelländringar och granska fel per dimension. För team som redan jämför hostade modeller i en repeterbar testrigg tillhandahåller Atlas Cloud en katalog och en enhetlig guide för LLM-API. Du kan bläddra i dess modellkatalog för en separat jämförelse. Katalogen listar för närvarande inte Muse Wonder, och att använda en annan modell där skulle endast testa den kontext som uttryckligen tillhandahålls den modellen om inte din applikation lägger till ett minneslager.
Vanliga frågor
Hur testar jag Muse Wonders Active Memory mellan chattar?
Ange fiktiva fakta i en konversation och fråga sedan om relevanta detaljer i en ny konversation. Inkludera en rättelse och ett saknat faktum, och anteckna produktytan och minnesinställningarna.
Kommer Muse Wonder ihåg rättelser eller bara tidigare detaljer?
Metas beskrivning av MemoryBench innehåller turer som uppdaterar eller motsäger tidigare detaljer. Ditt eget rättelsetest kontrollerar om den aktuella produktkonfigurationen följer uppdateringen; upprepa det eftersom ett resultat inte fastställer ett konsekvent beteende.
Är detta chatthistoriktest samma som Metas MemoryBench?
Nej. Meta beskriver MemoryBench som en intern långkontext-benchmark med konversationer på 64K till 100K tokens, distraktorer, motstridiga eller uppdaterade fakta och en LLM-domare. Den här korta kontrollen är ett praktiskt smoke test, inte en replikering.
Kan jag testa Muse Wonder Active Memory via API:et?
Du kan testa API-modellens återkallelse av kontext som når förfrågan. För beständighet mellan förfrågningar, verifiera vad API:et eller din applikation lagrar och skickar. Tillgången till ett stort kontextfönster visar i sig inte att separata förfrågningar delar minne.
Hur skiljer jag modellminne från app-lagrat minne?
Granska den kompletta förfrågan som skickas till modellen. Om din applikation infogar en profil, en hämtad anteckning eller en tidigare konversation, tillhandahöll det programvarulagret minnet. Jämför med en kontrollerad körning som utelämnar det, där så är lämpligt.
Är det säkert att använda personlig information i ett Active Memory-test?
Använd fiktiv information för testet. Om du senare utvärderar riktiga data, granska den specifika produktens minnes-, raderings-, retention- och dataanvändningsinställningar först.
Ett muse wonder active memory test är mest användbart när det avslöjar vilket steg som misslyckades: åtkomst till tidigare kontext, hämtning, rättelse, filtrering eller osäkerhet. Spara den råa körningen och upprepa den sedan under exakt den konfiguration du planerar att lita på.
Källor: Meta’s Muse Wonder announcement (12 oktober 2026); Meta Model API model documentation (hämtad 15 oktober 2026); Muse Wonder Model Card (oktober 2026).





