

En ledning i ett benchmark kan se avgörande ut tills samma modell missar ett krav vid nästa körning. Ett användbart tillförlitlighetstest av Muse Wonder ställer en snävare fråga: slutför modellen din uppgift, enligt din standard, upprepade gånger, under samma förhållanden?
Tidiga bevis är blandade eftersom testerna mäter olika saker. En uppsättning uppgifter från lanseringsdagen gav standardversionen av Muse Wonder en mycket hög poäng efter en körning per uppgift. En annan utvärdering fann styrkor inom researchanalys vid sidan av svagare enkätutformning, säljpåståenden och bildlayout. Ingetdera resultatet bevisar hur konsekvent den hanterar din kodbas eller ditt agentarbetsflöde.
Viktiga slutsatser
- Behandla lanseringsbenchmarks som kapacitetssignaler, inte produktionsgarantier.
- Muse Wonder och Muse Wonder Full är separata varianter. Håll deras resultat åtskilda.
- Mät godkännandegrad, repeterbarhet, slutförande och återhämtning som olika utfall.
- Börja med 10 till 20 verkliga uppgifter, lås upplägget och upprepa viktiga uppgifter minst tre gånger.
- Välj ett tröskelvärde utifrån kostnaden för ett felaktigt svar och din mänskliga granskningsprocess.
Är Muse Wonder tillförlitligt? Det korta svaret
De bevis som finns tillgängliga per 15 oktober 2026 stöder en uppgift-för-uppgift-utvärdering, inte en generell tillförlitlighetsdom. Muse Wonder presterade bra på vissa tidiga kontroller, medan andra körningar blottade fel eller presentationsarbete som fortfarande behövde granskas. Studierna skiljer sig åt vad gäller prompter, resonemangsinställningar, bedömare, urvalsstorlekar och antal försök.
(Meta, 12 oktober 2026) säger att Muse Wonder och Muse Wonder Full är byggda för professionella och personliga agentuppgifter, med funktioner som de kallar Active Memory och Active Focus. Det är produktpåståenden om avsett beteende. Ett påstående om att en modell kan återhämta sig från fel är ett skäl att testa återhämtning i ditt eget arbetsflöde, inte ett bevis på att den kommer att återhämta sig tillförlitligt.
Håll standard-Wonder åtskilt från Wonder Full. Meta listar standard-Muse Wonder för sitt Model API och Muse Code, medan Full erbjuds via Muse Code-prenumerationer. Att köra standard-Wonder med en högre resonemangsinställning gör den inte till Full.
För ett beslut du kan försvara: testa den exakta variant och den väg du avser att driftsätta. Räkna en uppgift som lyckad endast när den uppfyller en skriftlig acceptansregel och resultatet kan kontrolleras.
Vad ett tillförlitlighetstest av Muse Wonder bör mäta
Noggrannhet och konsekvens är olika saker
En godkännandegrad mäter hur många försök som uppfyller en definierad bedömningsmall. Konsekvens mäter om upprepade körningar av samma uppgift ger godtagbara resultat varje gång. En modell kan ha en hög godkännandegrad men ändå variera på sätt som spelar roll för ditt arbetsflöde.
Följ fyra dimensioner separat:
| Mått | Vad som ska registreras | Exempelkontroll |
|---|---|---|
| Noggrannhet | Försök som klarar bedömningsmallen | Matchar den extraherade summan källdokumentet? |
| Konsekvens | Om upprepade försök godkänns och stämmer överens | Behåller tre körningar samma obligatoriska begränsningar? |
| Slutförandekvalitet | Om varje efterfrågad leverabel finns | Ingår alla filer, citeringar och efterfrågade fält? |
| Återhämtning | Om körningen återupptas korrekt efter ett fel | Rapporterar den ett verktygsfel, försöker igen säkert och verifierar sedan sluttillståndet? |
Ett svar som låter komplett är inte nödvändigtvis komplett. En kodändring behöver tester; en researchsammanfattning behöver spårbara källor; en agentkörning behöver bevis för att dess slutliga åtgärd inträffade.
Separera modellfel från arbetsflödesfel
Registrera tillräckligt med kontext för att skilja ett modellfel från ett serverings- eller verktygsproblem. Logga minst modellvariant och version, resonemangsinställning, prompt, verktygskonfiguration, datum, körtid, token- eller uppgiftskostnad och råutdata.
Klassificera fel innan du poängsätter dem:
- Modell: felaktigt faktum, dåligt resonemang eller missat krav.
- Verktyg: misslyckat API-anrop, ogiltiga verktygsargument eller felaktigt resultat från ett externt system.
- Servering: timeout, avbrott eller otillgänglig slutpunkt.
- Utvärdering: otydlig bedömningsmall eller en kontroll som inte kan skilja godtagbart från oacceptabelt arbete.
Om du slår samman alla fyra till en felfrekvens vet du inte vad som ska åtgärdas.
Vad nuvarande tester av Muse Wonder visar
Metas publicerade benchmarkjämförelser är leverantörsbevis om benchmarkprestanda. De är inte samma sak som en oberoende genomförd arbetsflödesutvärdering. Oberoende tester har också gränser: en liten offentlig uppsättning uppgifter, ett försök, en viss modellväg eller en mänsklig preferensbedömning besvarar bara en snäv fråga.
Tabellen nedan separerar bevisen efter källa och omfattning. Den är en vägledning till vad varje resultat kan stödja, inte en sammanvägd poäng.
| Beviskälla | Vad som testades | Datum och upplägg | Vad den kan säga dig | Huvudsaklig begränsning |
|---|---|---|---|---|
| Metas tillkännagivande och modellmaterial | Kapacitetsbenchmarks och avsedda agentfunktioner | Tillkännagavs 12 oktober 2026; leverantörsrapporterade jämförelser | Vilka kapaciteter Meta betonar och vilka varianter som släpptes | Leverantörstestning fastställer inte repeterbarhet i ditt arbetsflöde |
| (Spring Prompt, 13 oktober 2026) | Enkäter, produktlistningar, bildspel, annonsplanering, schack och visuell sökning | 13 oktober; standard-API-modell, i allmänhet medelresonemang; offentliga uppgifter | Prestandan varierade per uppgift; vissa utvärderingar inkluderade upprepade körningar för produktlistningar | De flesta uppgifter var små urval; många resultat var en körning per uppgift; inte ett kod- eller Muse Code-test |
| (Quantslant, 12 oktober 2026) | 23 uppgifter som spänner över agenter, kodning, skrivande, resonemang och ett långt dokument | 12 oktober; standardmodell via OpenRouter, lågt resonemang; en körning per uppgift | Modellen klarade den definierade uppgiftsuppsättningen med hög frekvens under det upplägget | En enskild körning kan inte mäta konsekvens mellan körningar; resultat nära 100 % kräver granskning på uppgiftsnivå |
| Communityinlägg | Individuella reaktioner på kodning, agenter och benchmarks | Inlägg från lanseringsperioden; självvalda användare och uppgifter | Användbara ledtrådar för vad som bör testas härnäst | Anekdoter och röster är inte uppmätta godkännandegrader |
Kontrasten mellan källorna spelar roll. Quantslant rapporterade 99,7 % över sin uppsättning på 23 uppgifter, med en körning per uppgift och en låg resonemangsinställning. Den noterade också ett misslyckat enhetstest i en kodningsuppgift för siffer-till-ord. Det resultatet är bevis om den specifika sviten, inte bevis för att 99,7 % av vardagliga uppgifter kommer att godkännas eller att upprepade körningar kommer att stämma överens.
Spring Prompt rapporterade en mer varierad bild för standard-Wonder vid API-standardinställningar den 13 oktober. Dess researchanalyspoäng var 93,6/100 över nio offentliga uppgifter, medan endast tre av nio enkätplaner klarade alla kontroller. För produktlistningar var andelen som bedömdes tillförlitligt publiceringsklara över tre upprepningar 66,1 % för faktabriefar och 51,8 % för säljbriefar. Fem av sex bildspel behövde layoutkorrigeringar, och ett bedömdes presentabelt. Dessa är separata mått med separata nämnare, inte delar av en övergripande poäng.
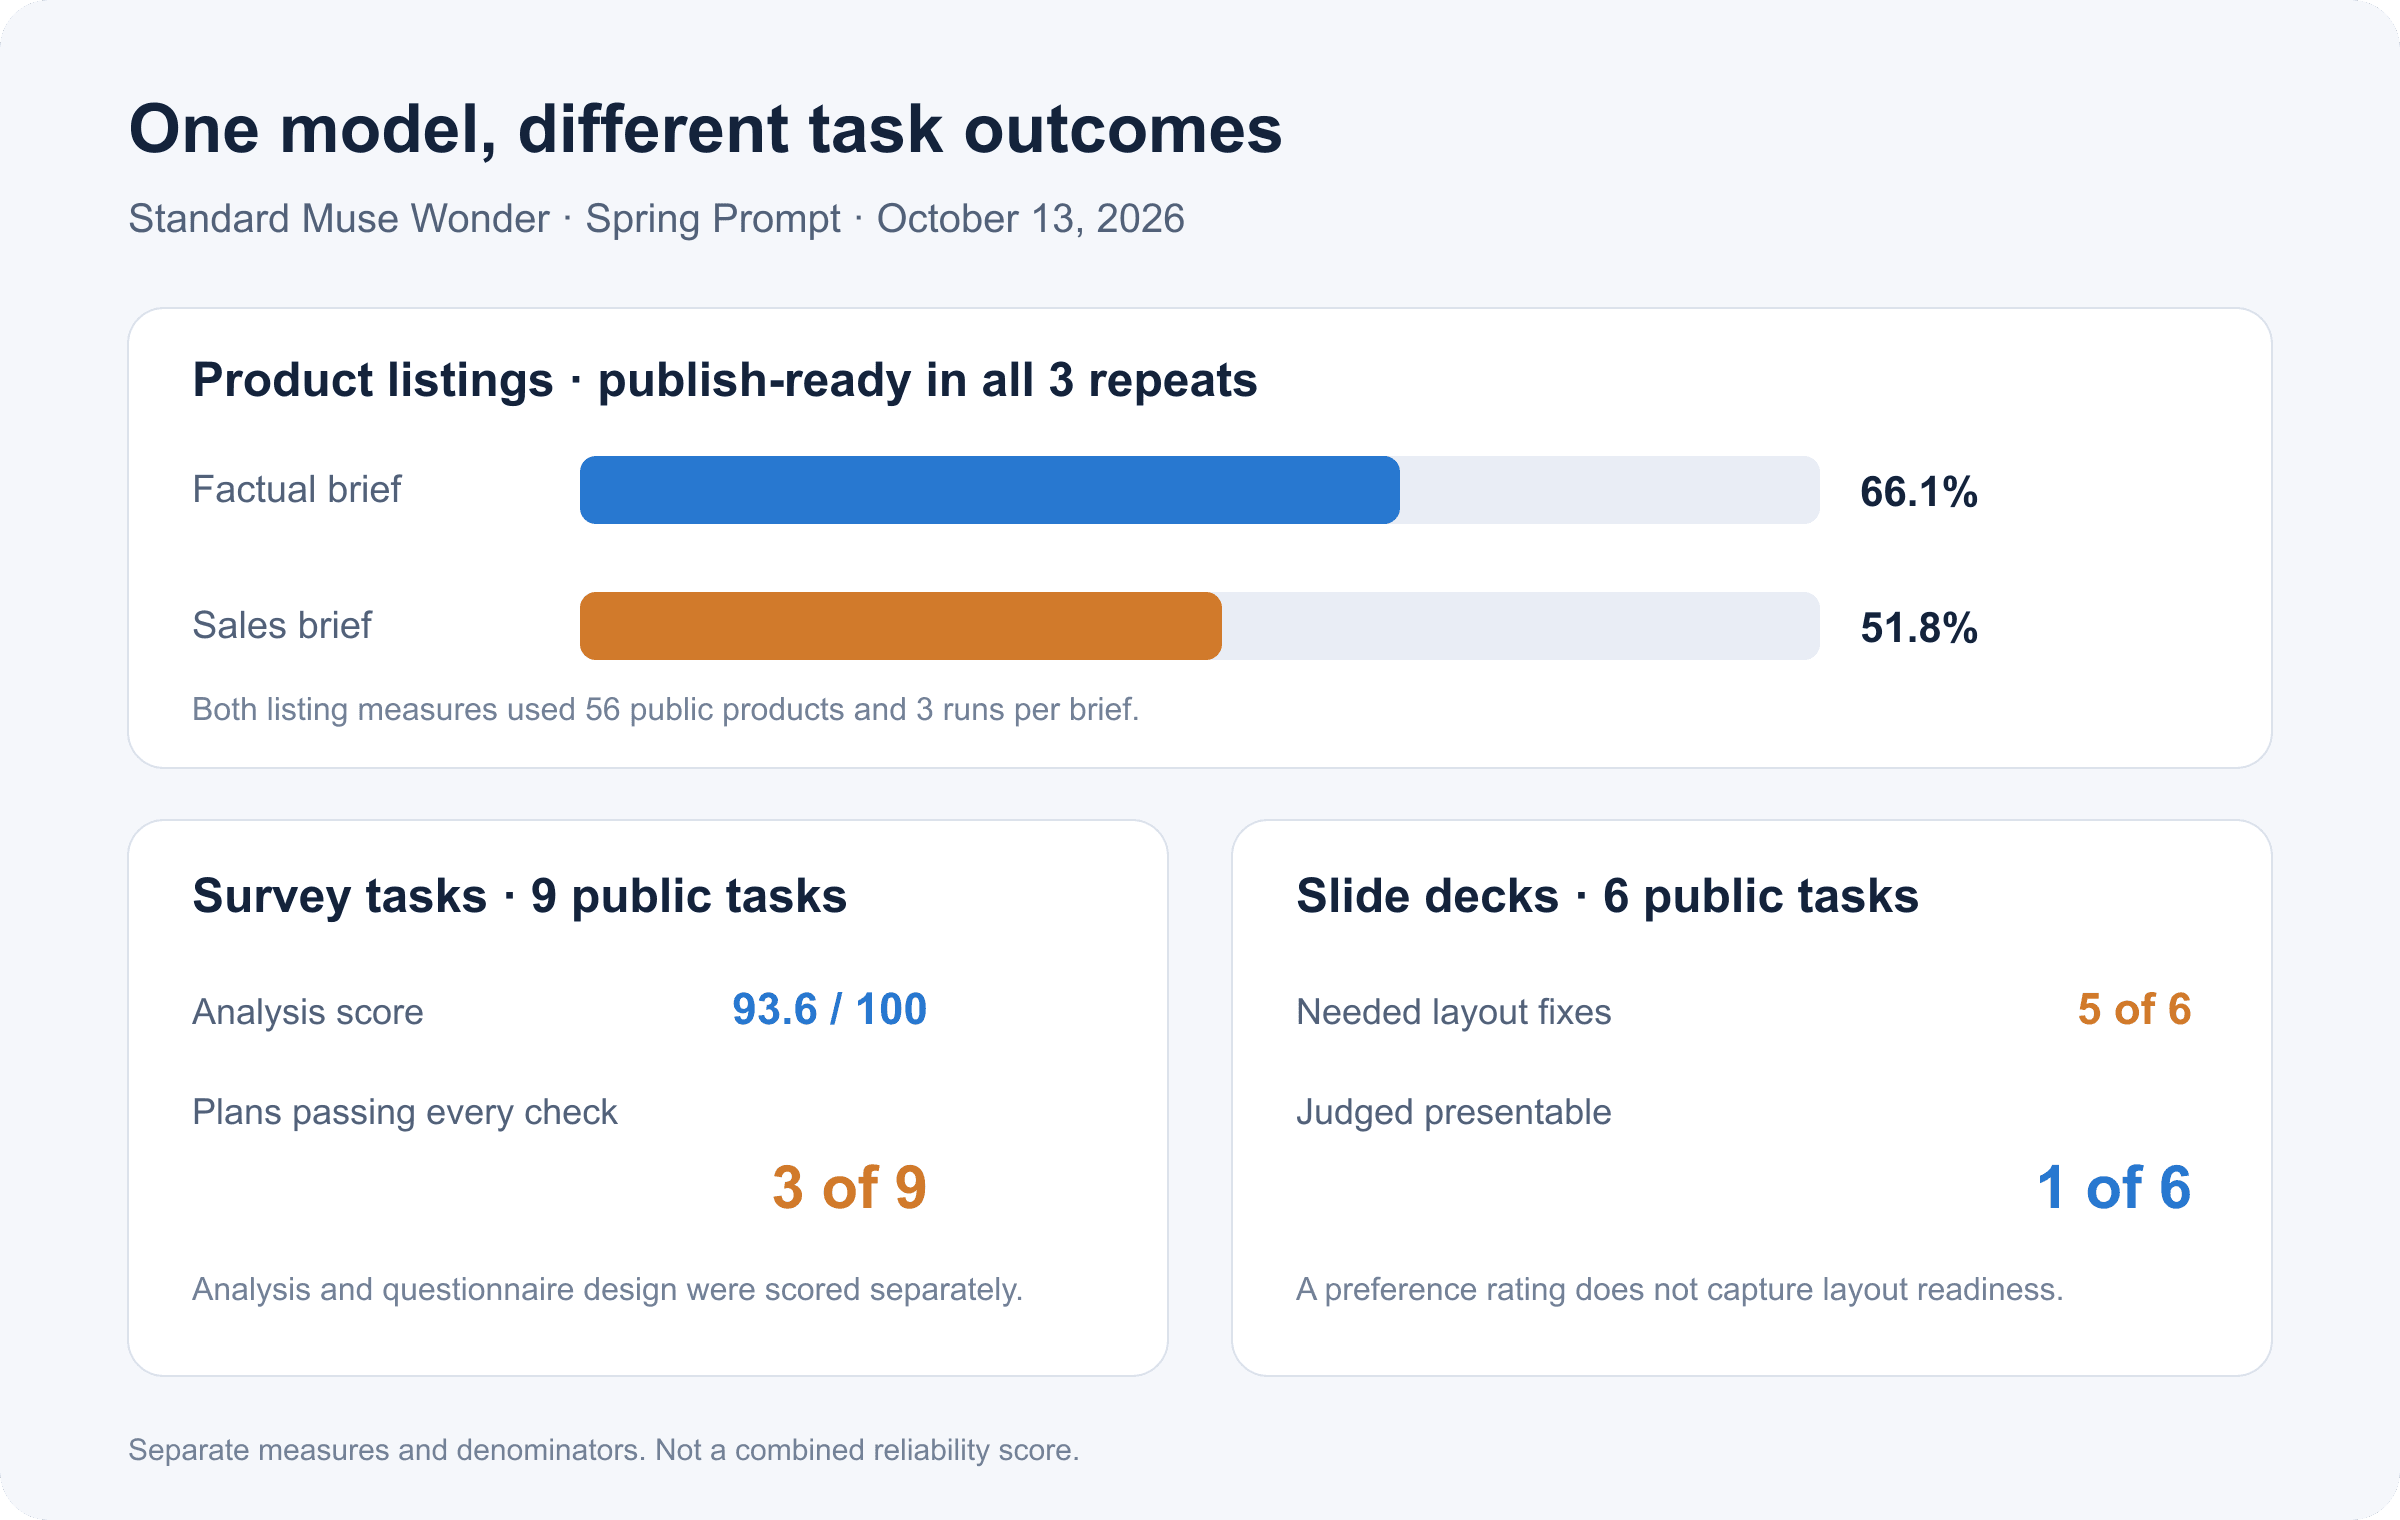
Spring Prompts resultat för standard-Muse Wonder den 13 oktober 2026: upprepningstestade godkännandegrader för listningar, enkätanalys och resultat från bildspelsgranskning
Oberoende uppgiftsresultat från en utvärdering. Måtten använder olika nämnare och visas separat, inte sammanvägda till en poäng.
Spring Prompts tester mätte inte kodning, beständigt minne eller Muse Code. Dess jämförelse kan därför inte avgöra huruvida Wonder är tillförlitligt för kodning eller huruvida Full presterar bättre. Den visar dock varför en enda bred etikett döljer viktiga uppgiftsskillnader.
Metas lanseringsartikel säger att standard-Muse Wonder är tillgängligt via Meta Model API och Muse Code, medan Wonder Full är tillgängligt för Muse Code-prenumeranter. Den beskriver Active Memory och Active Focus som funktioner för att behålla användbara detaljer och fortsätta arbetet genom fel. Dessa beskrivningar hjälper till att definiera testfall, men lanseringsartikeln är inte en oberoende studie med upprepade körningar.
För påståenden om kodning och 3D-byggen som diskuteras i communitytrådar under lanseringsveckan: behandla inlägg som hypoteser. Omvandla ett specifikt klagomål till en reproducerbar uppgift och verifiera resultatet. Omvandla inte kommentarer eller uppröstningar till en framgångsfrekvens.
Så kör du ett repeterbart tillförlitlighetstest av Muse Wonder
1. Bygg en liten uppsättning uppgifter från verkligt arbete
Välj 10 till 20 uppgifter som ditt team faktiskt förväntar sig att modellen ska hantera. Dela in dem i kategorier som kodning, faktautdragning, instruktionsföljning, lång kontext och verktygsanvändning. Föredra uppgifter med objektiva tester, referenssvar eller en tydlig bedömningsmall.
Inkludera realistiska gränsfall: saknad indata, motstridiga krav, ett otillgängligt verktyg och en uppgift som bör utlösa en klargörandefråga. Håll känsliga eller reglerade data utanför om inte din godkända process tillåter det.
2. Lås prompten, modellen och inställningarna
Skriv ned den exakta prompten och systeminstruktionerna. Registrera modellnamn och version, resonemangsnivå, verktyg, medföljande kontext, datum och eventuell tidsgräns. Jämför inte standard-Wonder med Full som om de vore samma modell.
En användbar testprompt kan be modellen visa sina bevis och identifiera icke-testbara krav:
Läs den bifogade specifikationen och implementationen. Returnera endast: (1) varje krav markerat GODKÄNT, MISSLYCKAT eller INTE TESTBART; (2) de exakta bevisen för varje status; (3) eventuella saknade krav; (4) ett minimalt reproducerbart test för varje krav som misslyckas. Påstå inte att ett test har godkänts om du inte kan hänvisa till dess utdata.
Detta är ett utvärderingsunderlag, inte en garanti för att modellen följer det. Poängsätt det resulterande svaret och verifiera alla påstådda testutdata oberoende.
3. Upprepa uppgifter och poängsätt varje försök
Kör varje högriskuppgift minst tre gånger med samma upplägg. Om budgeten bara tillåter ett försök, märk resultatet som ett initialt urval snarare än ett konsekvensresultat. Bevara varje råsvar; rapportera inte bara det bästa.
Använd en rad för varje försök. Håll acceptansregeln stabil mellan körningar.
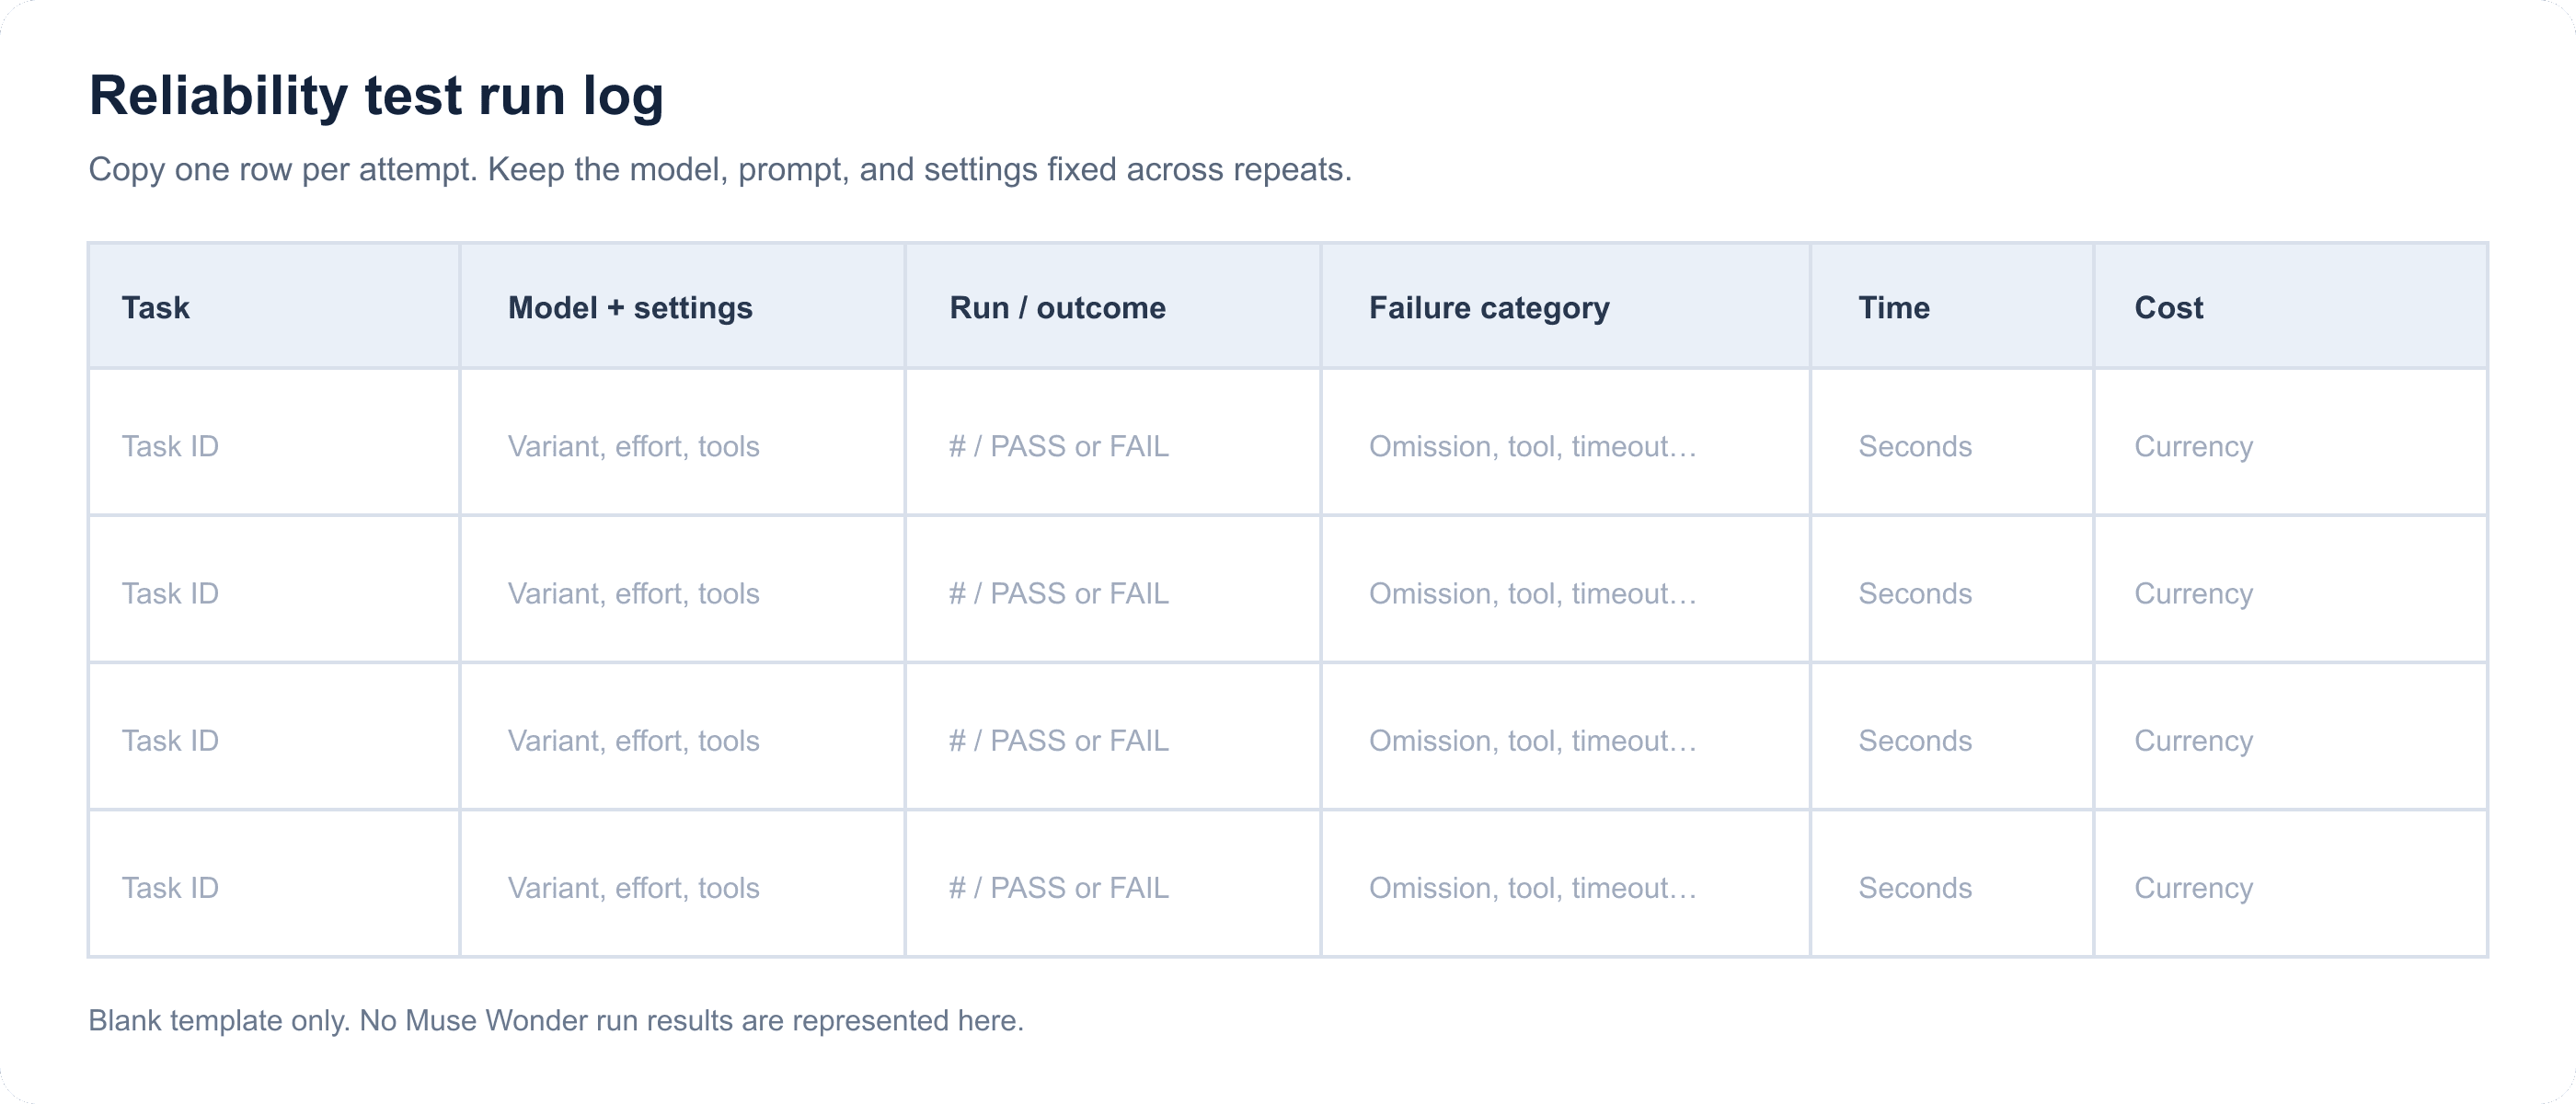
Tom logg för tillförlitlighetstest av Muse Wonder med fält för uppgift, modell, körning, utfall, fel, tid och kostnad
Återanvändbar tom registreringsmall. Fyll i en rad per försök; den innehåller inga uppmätta Muse Wonder-resultat.
4. För en fellogg och verifiera återhämtning
Använd specifika kategorier: sakfel, utelämnande, misslyckat kodtest, verktygsfel, timeout, obestyrkt slutförandepåstående eller formatavvikelse. För arbete i flera steg, notera var körningen stoppade och huruvida ett nytt försök upprepade slutförda åtgärder eller verifierade sluttillståndet.
En agent som säger ”klart” utan bevis har inte klarat en slutförandekontroll. Kräv ett testresultat, en sparad fil, en källhänvisning eller ett verifierat tillstånd som matchar uppgiften.
5. Sätt ett beslutströskelvärde utifrån felkostnad
Det finns ingen användbar universell gräns för godkännandegrad. Ett utkast som en person kontrollerar rad för rad har en annan riskprofil än en databasmigrering eller en automatiserad betalning.
Sätt tröskelvärdet utifrån tre faktorer:
- Hur skadligt eller dyrt är ett felaktigt resultat?
- Kan en person upptäcka felet innan det påverkar någon?
- Misslyckas arbetsflödet säkert, med ett tydligt stopp och revisionsspår?
För lågriskutkast kan granskning räcka. För kodändringar, finans, juridik, hälsa eller åtgärder som påverkar användare: använd starkare tester och oberoende verifiering. Låt inte ett högt genomsnitt dölja ett allvarligt felmod.
Tillförlitlighet för Muse Wonder per uppgiftstyp
Kodning och byggen i flera steg
Kör repositoriet faktiska testsvit och kontrollera det efterfrågade beteendet. Poängsätt kravtäckning, regressionsfel och huruvida modellens påstådda ändringar matchar filerna och testutdata. En övertygande skärminspelning eller förklaring är ingen ersättning för en körbar kontroll.
Den tidiga Quantslant-sviten innehöll fyra kodningsuppgifter och rapporterade att 15 av 16 enhetstester godkändes i en siffer-till-ord-uppgift. Det är en liten signal från en enda körning. Spring Prompt testade uttryckligen inte kodning, så dess resultat bör inte användas för att generalisera om tillförlitlighet för kodningsagenter.
Research och faktautdragning
Använd ett källpaket eller referenssvar som din granskare kan inspektera. Kontrollera varje faktapåstående mot en primärkälla och spåra påhittade citeringar och felaktig tillskrivning separat från den allmänna svarskvaliteten.
Spring Prompts enkätanalys var en relativ styrka i dess lilla utvärdering, men utformningen av enkätfrågor var svagare. En hög analyspoäng bör inte tyst certifiera enkätinstrumentet eller källorna bakom en ny researchuppgift.
Lång kontext och agentarbetsflöden
Kontrollera huruvida modellen behåller varje begränsning, använder varje verktyg korrekt och verifierar sluttillståndet. Testa återhämtning efter avbrott avsiktligt: stoppa en körning efter ett känt steg och se om den återupptas från en kontrollpunkt eller upprepar en sidoeffekt.
Metas tillkännagivande beskriver minnes- och återhämtningsfunktioner, men de tidiga offentliga utvärderingar som citeras här fastställer inte långsiktig konsekvens för beständigt minne eller agentåterhämtning. Mät dessa beteenden direkt innan du förlitar dig på dem.
Muse Wonder vs. Muse Wonder Full: håll bevisen åtskilda
Muse Wonder och Muse Wonder Full är distinkta varianter. Metas lanseringsinformation beskriver separata åtkomstvägar, och oberoende API-tester av standard-Wonder blir inte Full-resultat bara för att resonemangsinställningen ändras.
| Jämförelsefråga | Vad de tillgängliga bevisen stöder |
|---|---|
| Är Full samma sak som standard-Wonder vid maximalt resonemang? | Nej. Behandla dem som distinkta varianter och registrera det exakta namnet. |
| Testade den citerade Spring Prompt-API-utvärderingen Full? | Nej. Den testade standard-Wonder; Full låg utanför den jämförelsen. |
| Kan de citerade standard-API-siffrorna rangordna Full? | Nej. De testar inte Full. |
| Vad skulle göra en jämförelse rättvis? | Samma uppsättning uppgifter, bedömningsmall, datumfönster, verktygsåtkomst och dokumenterade inställningar, med upprepningar för båda varianterna. |
En rättvis jämförelse börjar med parade uppgifter och matchade förhållanden. Om åtkomstvägar medför olika prompter, verktyg eller fakturering, dokumentera dessa skillnader och kalla jämförelsen explorativ.
Kostnad, åtkomst och var du kan testa Muse Wonder
Jämför kostnad per accepterad uppgift, inte bara det listade priset per token. Långa prompter, nya försök, resonemangstokens, verktygsanrop, timeouts och mänsklig granskning förändrar alla kostnaden för ett användbart resultat. Quantslant rapporterade standard-Wonders tokenpriser som $4 per miljon indatatokens och $20 per miljon utdatatokens den 12 oktober 2026, och sin egen 23-uppgiftskörning till $0.64. Det är en rapporterad väg och arbetsbelastning, inte ett universellt uppgiftspris.
Metas aktuella lanseringstillkännagivande listar standard-Wonder via Meta Model API och Muse Code, och Full via Muse Code-prenumerationer. Bekräfta åtkomst, regional behörighet och aktuell fakturering i det officiella gränssnittet innan du budgeterar.
Börja på Atlas Cloud för en bredare bild av dess utvecklarplattform. Per 15 oktober 2026 kunde jag inte bekräfta Muse Wonder i modellkatalogen, så den här artikeln presenterar inte Atlas Cloud som en körningsväg för den här modellen. Om ditt team jämför andra modeller som redan är listade där, kan Atlas Clouds modellbibliotek hjälpa dig att identifiera kandidater att köra mot samma uppsättning uppgifter.
Det användbara resultatet av ett tillförlitlighetstest av Muse Wonder är ett driftsättningsbeslut kopplat till bevis: vilken uppgift som godkändes, hur ofta den godkändes, vad den kostade och vilken granskning som fortfarande är nödvändig.
Vanliga frågor
Är Muse Wonder tillförlitligt för kodning?
Tidiga lanseringstester ger bara ett litet kodningsexempel. Quantslant rapporterade fyra kodningsuppgifter, med en enhetstestmiss i en uppgift, medan Spring Prompt inte testade kodning. Kör repositorytester på dina egna uppgifter och upprepa viktiga sådana innan du fattar beslut om ett kodningsarbetsflöde.
Hur testar jag tillförlitligheten hos Muse Wonder själv?
Använd en fast uppsättning verkliga uppgifter, bevara exakta modell- och promptinställningar, definiera godkännandekriterier i förväg och behåll varje utdata. Upprepa viktiga uppgifter och verifiera resultaten med tester eller källdokument.
Hur många gånger bör jag upprepa varje Muse Wonder-uppgift?
Använd minst tre körningar för högriskuppgifter som en initial konsekvenskontroll. Tre försök är fortfarande ett litet urval, så utöka uppsättningen när fel är kostsamma eller utdata varierar.
Vad är skillnaden mellan Muse Wonder och Muse Wonder Full?
De är separata modellvarianter med olika tillgänglighetsvägar. Behandla inte standard-Wonder vid maximalt resonemang som Full, och överför inte resultat mellan dem utan ett matchat test.
Kan jag lita på Metas benchmarkpoäng för Muse Wonder?
Använd dem som leverantörsrapporterade kapacitetsbevis och läs upplägget för benchmarken. De bevisar inte konsekvent prestanda över dina prompter, verktyg och upprepade körningar.
Finns Muse Wonder på Atlas Cloud?
Jag kunde inte verifiera det i Atlas Clouds modellkatalog per 15 oktober 2026. Kontrollera den live-katalogen innan du väljer en körningsleverantör.





