

En röst kan låta som om någon håller tillbaka tårar medan det animerade ansiktet förblir neutralt. Med OmniHuman 2.0 emotionell röst- och ansiktsuttrycksmatchning är den första åtgärden ofta att lyssna närmare, inte att lägga till fler adjektiv. Ljudet bär redan ord, timing och röstbetoning; en kort prompt bör styra den synliga framställningen som stödjer dessa signaler.
Den här guiden ger skapare ett repeterbart sätt att förbereda ett porträtt och ett spår, skriva en fokuserad prompt och granska resultatet för betydelsefulla avvikelser. Den täcker tal och sång, samtidigt som den skiljer dokumenterad information från tredjepartsvägledning och overifierade produktpåståenden.
Viktiga slutsatser
- Behandla ljudet som framställningens grund och styr endast synliga handlingar, inramning och scendetaljer.
- Markera känslolägen innan du promptar och kontrollera sedan samma ögonblick med ljudet av och på.
- Ändra en variabel per nytt försök; en prompt kan inte åtgärda alla problem med källjudet eller genereringen.
Hur OmniHuman 2.0 kopplar samman ljud, ansiktsuttryck och rörelse
Ett användbart sätt att tänka på en ljuddriven porträttmodell är att ge varje indata en uppgift. Bilden förankrar det synliga subjektet. Inspelningen tillhandahåller talet eller sången, inklusive timing och framförande. Valfri textvägledning kan beskriva framförandet eller scenen. Det exakta beteendet och kontrollerna kan variera mellan produktimplementationer, så behandla inte allmän OmniHuman-forskning eller en tredjepartsstudios instruktioner som officiella specifikationer för OmniHuman 2.0.
Den ursprungliga OmniHuman-1-forskningen beskriver human animering som betingas av kombinationer av bild, text, ljud och pose. Den artikeln etablerar forskningsfamiljens bredare inramning, inte det exakta gränssnittet, begränsningarna eller kvaliteten hos OmniHuman 2.0 (ICCV 2025, OmniHuman-1-artikeln).
| Indata | Troligt bidrag | Vad du kan förbereda |
|---|---|---|
| Referensporträtt | Subjektets utseende och startpose | Välj ett tydligt ansikte och en inramning som passar den avsedda rörelsen |
| Talat eller sjunget ljud | Ord, kadens, pauser, röstenergi | Använd ett rent spår med avsiktligt framförande och trimma irrelevant tystnad |
| Valfri riktningsprompt | Synliga handlingar, inramning, scen eller stämningssignaler | Ge några konkreta instruktioner som stämmer med inspelningen |
Läppsynkronisering och emotionellt framförande är relaterade, men de är inte samma kvalitetskontroll. En mun kan följa stavelser medan ögonen, huvudet eller gesten känns fel för repliken. På samma sätt kan ett ansikte se uttrycksfullt ut medan timingen glider ifrån rösten. Granska båda.
Tredjepartsguider för OmniHuman 2.0 beskriver ett arbetsflöde med bild plus ljud och valfri textvägledning, men dessa sidor är inte BytePlus tekniska dokumentation. Den offentligt tillgängliga Atlas-dokumentationen täcker dess egen Avatar Omni Human 1.5-modell, inte OmniHuman 2.0. Den säkraste arbetshypotesen är därför praktisk snarare än absolut: låt ljudet antyda vad framförandet behöver och använd prompten för att begära synliga val som du kan granska.
Välj ett porträtt och ett ljudspår som gör känslor läsbara
En modell kan inte agera på signaler som är svåra att se eller höra. Börja med indata som ger den en rimlig, enkel uppgift och håll dem sedan fasta medan du testar promptformuleringar.
| Startindata | Varför det kan hjälpa | Komplikation att se upp med |
|---|---|---|
| Ett skarpt, oskymt ansikte med jämnt ljus | Gör ansiktsdrag lätta att läsa | Kraftiga skuggor, hår, händer eller rekvisita kan täcka viktiga områden |
| Neutral eller milt uttrycksfull startpose | Lämnar utrymme för framförandet att förändras | Ett starkt fast uttryck kan krocka med en annan röststämning |
| En tydlig förgrundsröst | Gör tal och pauser lättare att följa | Musik, rumsljud eller överlappande talare kan dölja signaler |
| Avsiktlig frasering med hörbara pauser | Ger dig ögonblick att mappa till synliga handlingar | Platt framförande kan erbjuda färre tydliga känslomässiga förändringar |
| En sång med rösten i förgrunden och tydliga fraser | Gör sjungna ord och dynamik lättare att identifiera | Instrumentala partier ger färre vokala signaler för munrörelser |
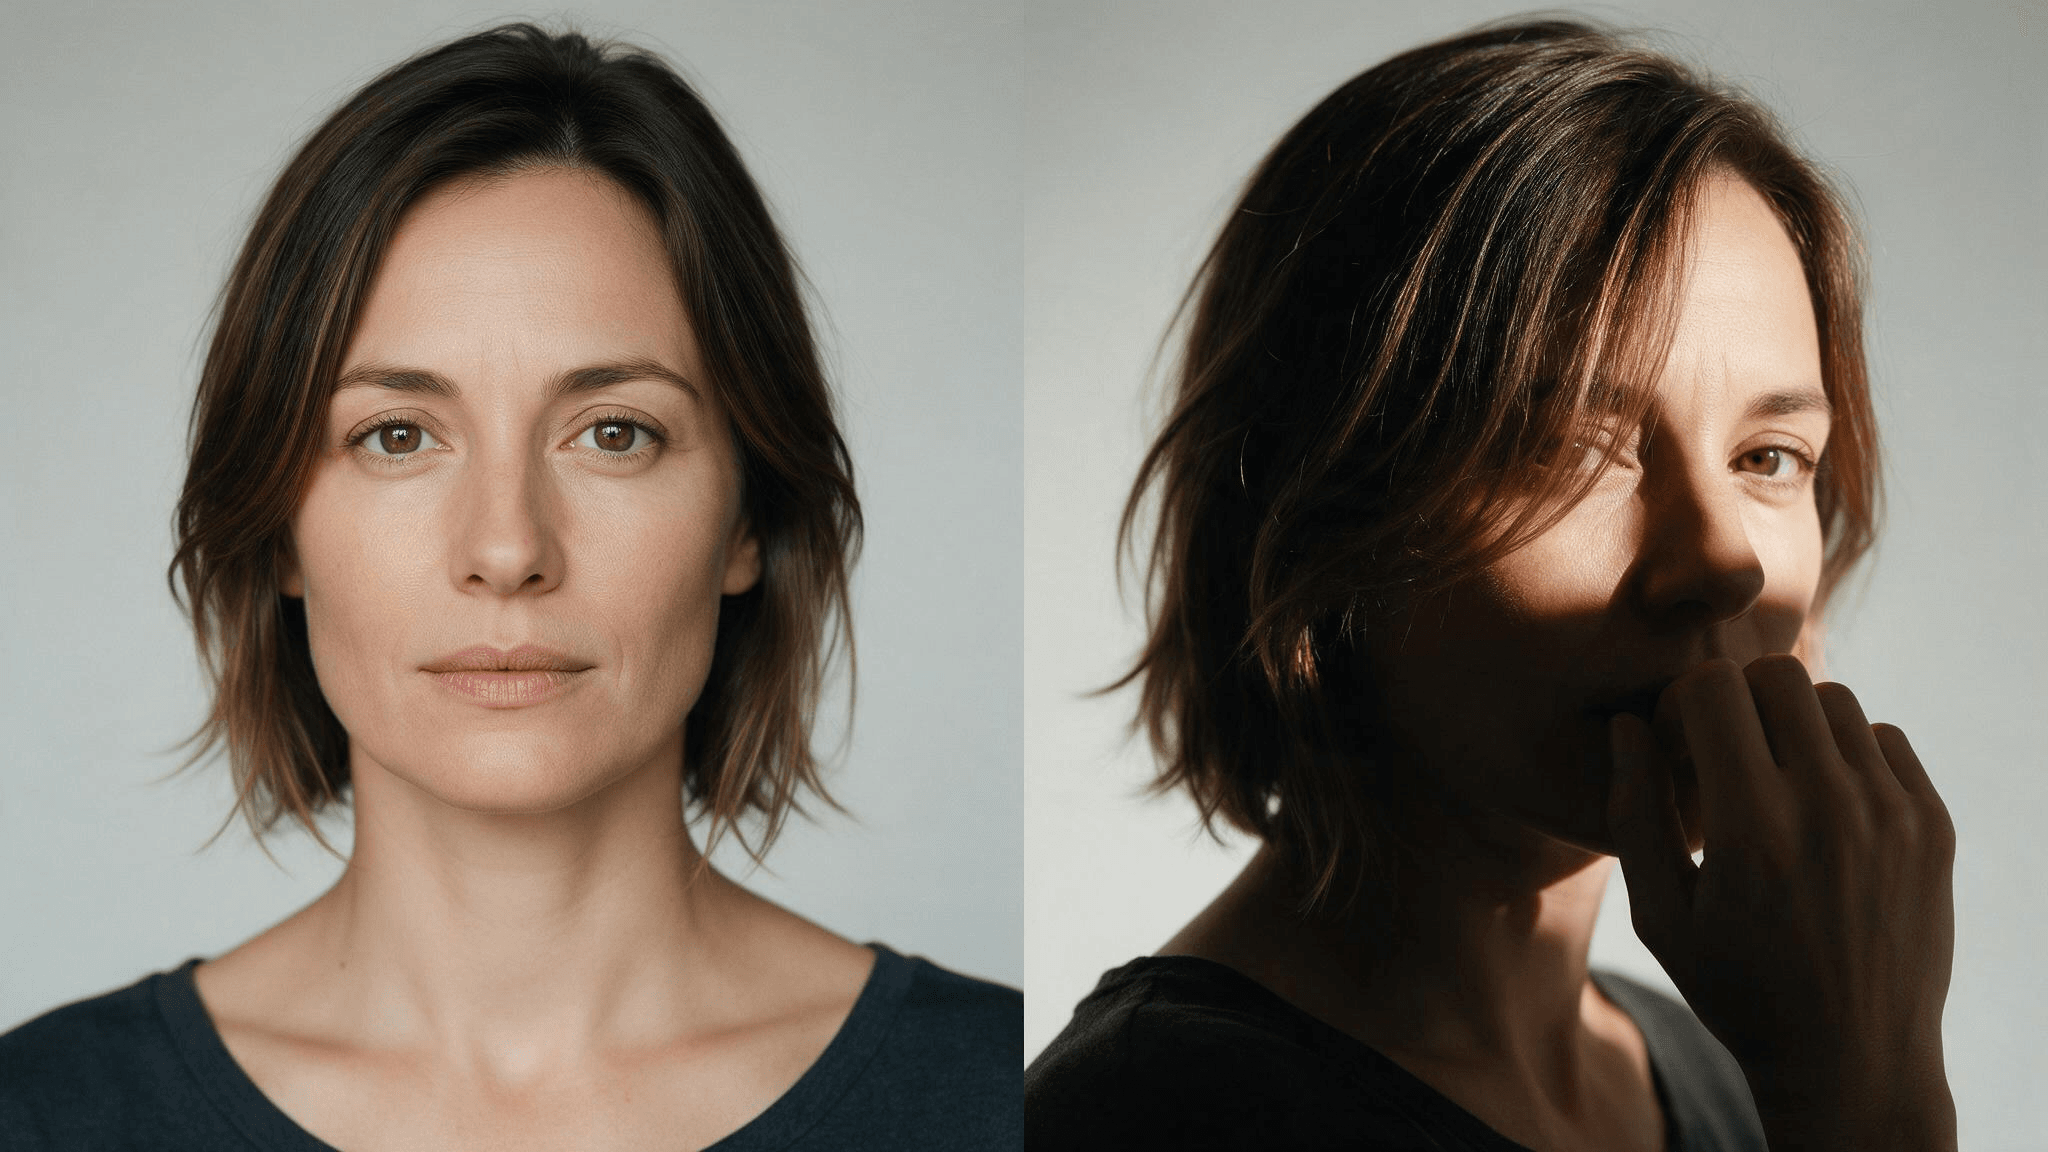 Illustrativ porträttjämförelse: den tydliga, framåtvända vyn gör ansiktssignaler lättare att granska än den skuggade, delvis skymda vyn. Detta är inte en jämförelse av modellutdata.
Dessa är produktionskontroller, inte garantier. Ett bra indata kan fortfarande ge en svag tagning, och ett visuellt uttrycksfullt porträtt garanterar inte en sammanhängande animering. Använd ett porträtt, en kort ljudsekvens och en enda prompt för ett första test. Undvik att ändra beskärning, inspelning och riktning samtidigt; annars vet du inte vilken justering som hjälpte.
För sång, lyssna efter frasslut, hållna toner och förändringar i intensitet. Prompten kan styra ett huvudlut eller en handrörelse kring en musikalisk takt, men den bör inte upprepa text som redan finns i inspelningen. För talad dialog, markera pauser och betonade ord. En prompt som begär en stor stämningsförändring under en sammanhängande lugn mening kan skapa ett framförande som känns påtvingat.
Ett promptramverk för att matcha röst och ansiktsuttryck
Håll riktningen kort nog att utvärdera. En praktisk struktur är:
Inramning + talare och framförande + känsla som stämmer med spåret + en eller två synliga handlingar + valfri kamerariktning.
Om en talare till exempel låter varm och samlad kan du skriva:
Statisk medelnärbild. Kvinnan talar varmt till kameran, börjar samlad och låter ett litet leende synas på den sista repliken. Hon nickar en gång mjukt efter pausen. Håll inramningen stadig.
Detta är en illustrativ prompt, inte en rapporterad OmniHuman 2.0-körning. Dess användbara egenskap är att varje instruktion motsvarar något synligt: tagningen förblir stadig, uttrycket förändras mot slutet och nickningen har en signal. Du kan jämföra resultatet mot spåret i stället för att bedöma en bred begäran som ”var känslosam”.
En tredjepartsguide för promptar rekommenderar kortfattad riktning i naturligt språk och att matcha den begärda känslan mot rösten. Behandla det som en praktisk tumregel, inte en garanti eller en officiell produktregel (KreatorFlow promptguide).
Innan du använder en prompt, kontrollera den mot inspelningen:
- Om rösten är tyst och återhållen, begär ett subtilt uttryck i stället för ett brett flin.
- Om framförandet blir mer självsäkert, placera den synliga förändringen efter den hörbara förändringen.
- Om inspelningen innehåller ett skratt, en paus eller en suck, bestäm om ansiktet ska hålla kvar, reagera eller röra sig vid den punkten.
- Om startporträttet redan visar det önskade uttrycket, undvik att beskriva det igen om du inte vill att uttrycket ska förändras.
Använd tidsord som ”först”, ”sedan” och ”slutligen” endast när ljudet har tydliga markeringar. Undvik att stapla motstridiga instruktioner som ”statisk inramning” och ”kamera i omloppsbana”, eller ”lugn” och ”rasande”. En prompt är riktning för ett befintligt framförande, inte ett ersättande röstspår.
Tre promptmönster för tal, känslomässiga skiften och sång
Välj det minsta mönster som passar ditt ljud. Dessa exempel är mallar att anpassa, inte verifierade påståenden om utdata.
Lugn förklaring
Stadig medelnärbild. Talaren förklarar poängen lugnt, med ett samlat uttryck och en liten betonande gest. Håll kameran stilla.
Använd detta när spåret är avmätt och konsekvent. En gest kan göra betoningen synlig utan att förvandla en enkel förklaring till en teatralisk föreställning.
En känslomässig förändring
Statisk närbild. Talaren börjar allvarlig och mjuknar sedan till ett litet leende efter pausen före den sista meningen. Håll rörelsen återhållen.
Använd detta endast när inspelningen innehåller en paus eller hörbar förändring som stödjer skiftet. Om det inte finns någon signal kan övergången verka godtycklig.
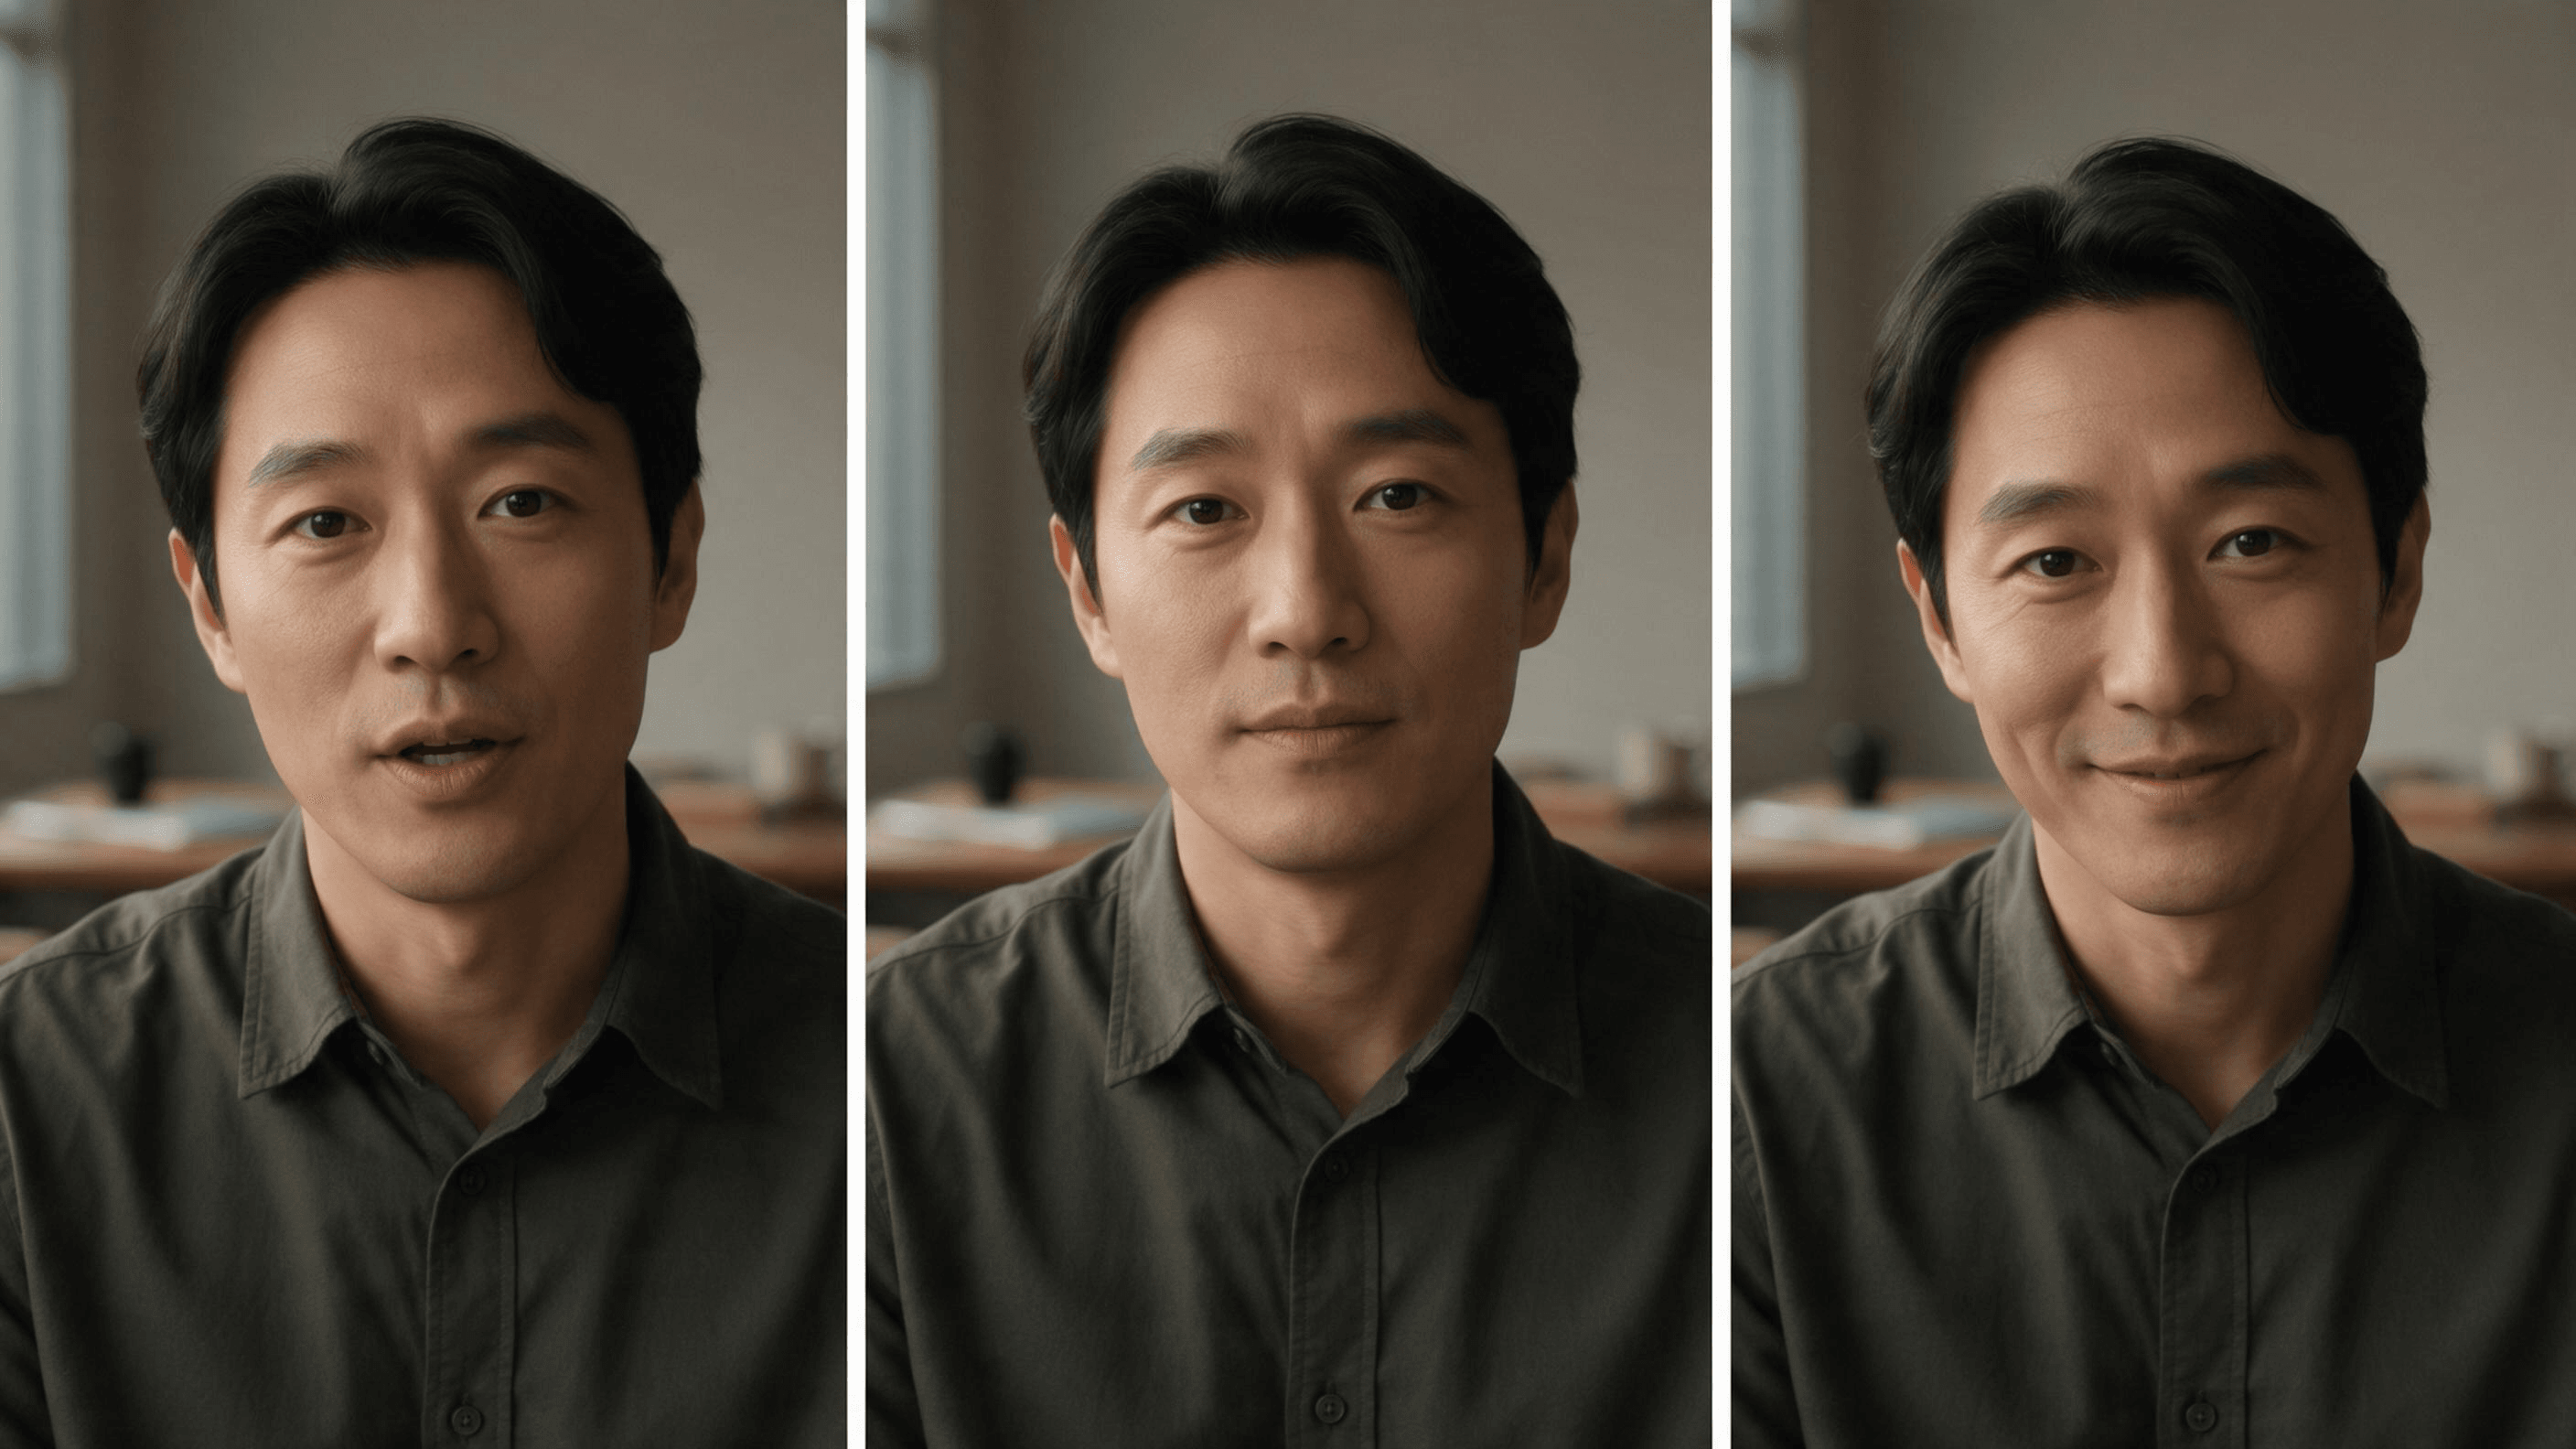 Konceptuell storyboard för talprompten: allvarligt framförande, en paus, sedan ett återhållet leende. Dessa är planerade ansiktsmarkeringar, inte bildrutor från en OmniHuman 2.0-generering.
Sång
Medelnärbild. Sångerskan framför med fokuserat uttryck, sluter ögonen kort på den hållna tonen och sänker sedan hakan när frasen slutar. Håll inramningen stadig.
Styr framförandet kring musikaliska händelser i stället för att upprepa sångtexten. Prompten kan föreslå synlig handling; det medföljande spåret förblir källan till de sjungna orden och timingen.
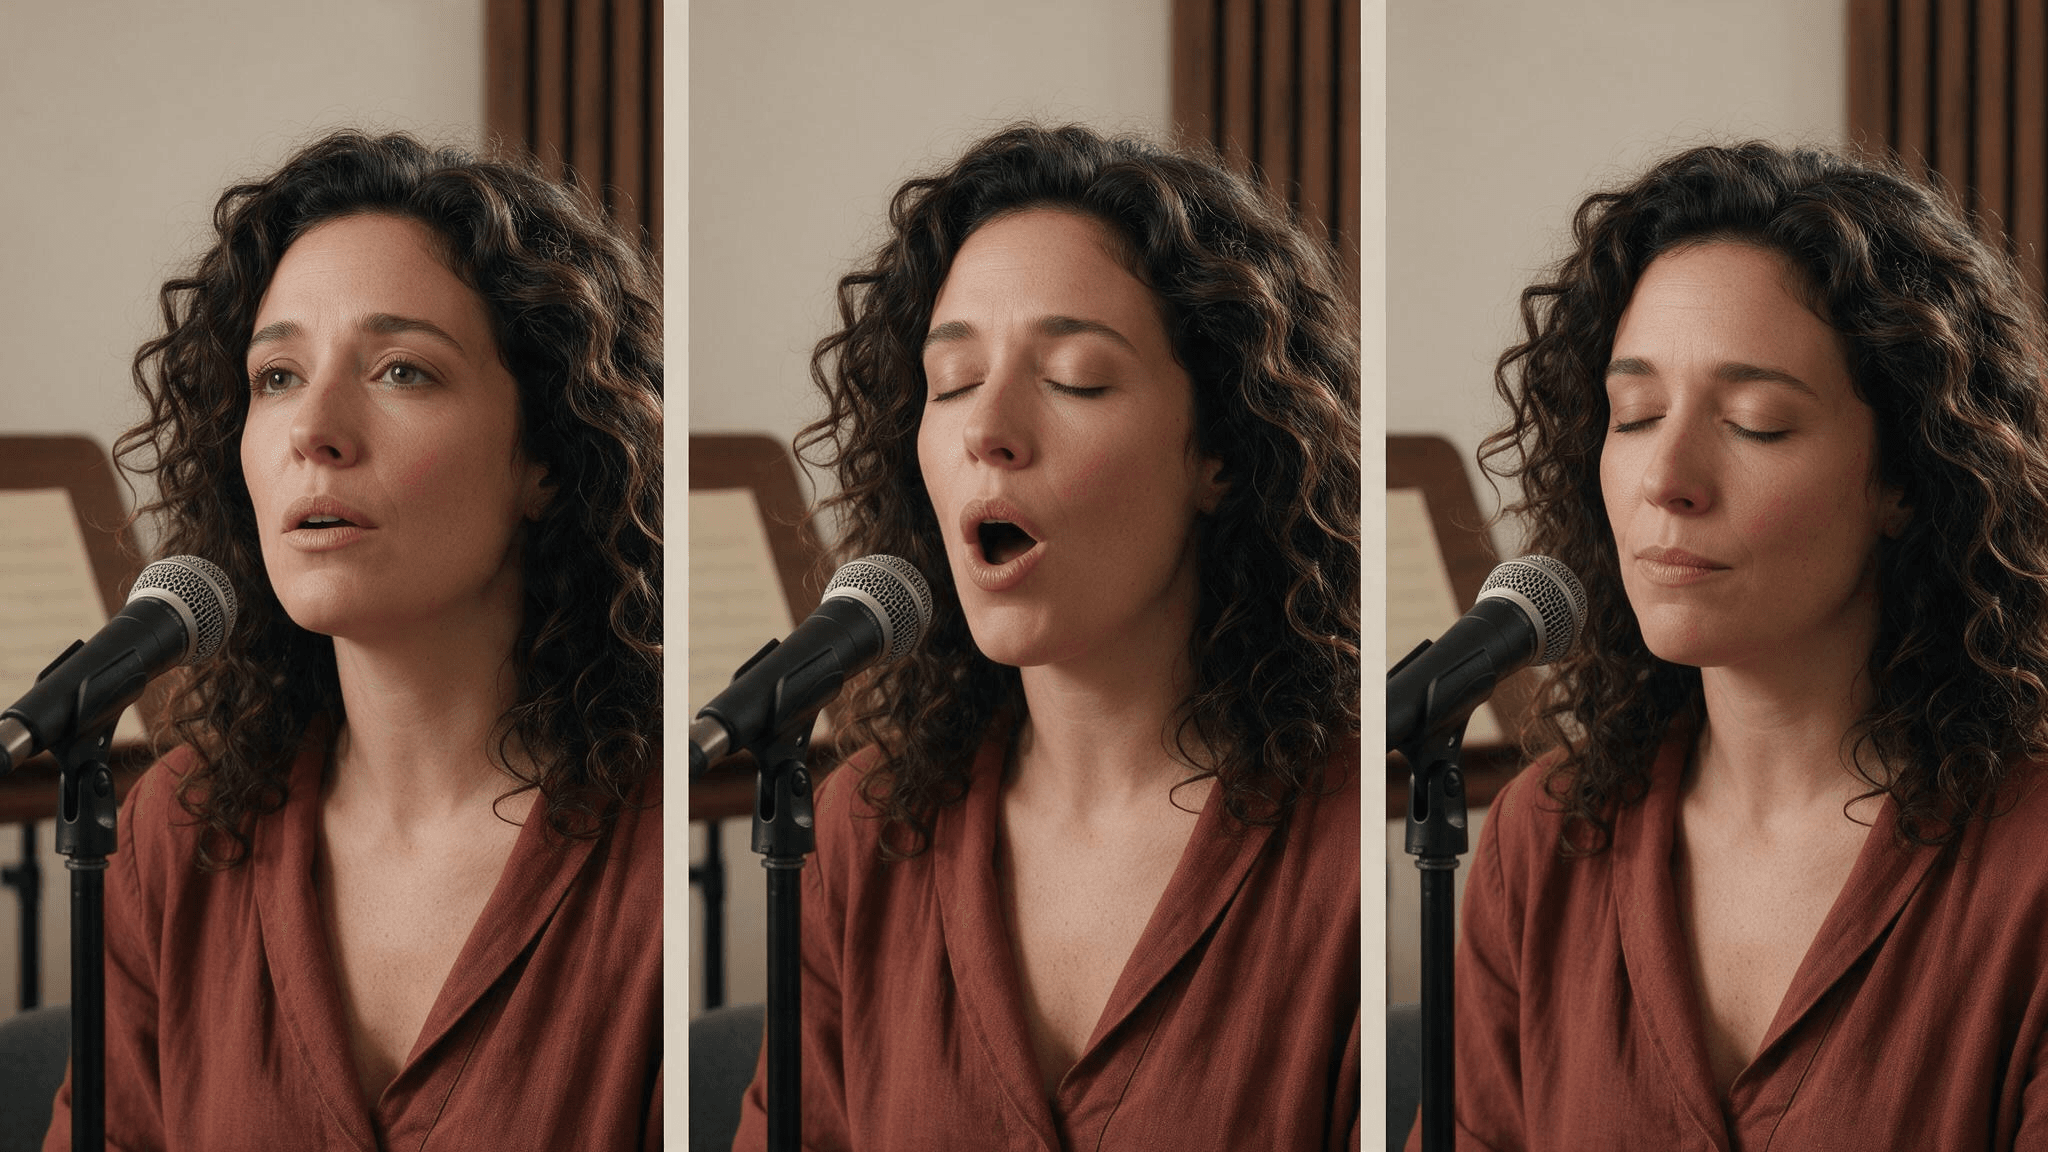 Konceptuell storyboard för sångprompten: börja frasen, håll en ton och landa sedan i slutet. Stillbilder visar inte ljudsynkronisering.
Jämför ”var känslosam och filmisk” med ”tala varmt och le sedan efter pausen”. Den första lämnar känsla, timing och synlig handling öppna för tolkning. Den andra ger dig ett specifikt ögonblick att granska. Om resultatet missar det ögonblicket har du ett riktat nästa test: flytta signalen, mjuka upp uttrycket eller välj en annan ljudredigering.
En kontroll i tre steg för röst- och ansiktslinjering
En snabb granskningsmetod kan visa om problemet ligger i ljudet, den visuella riktningen eller den genererade tagningen. Använd samma tidsstämplar i alla tre stegen.
Den tysta loopen nedan låter dig granska den synliga delen av ett talat framförande: munrörelser, blick och ansiktsförändringar. Använd det ursprungliga klippet med ljud för röst-till-ansikte-kontrollen.
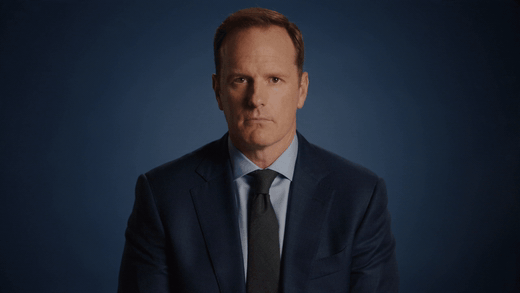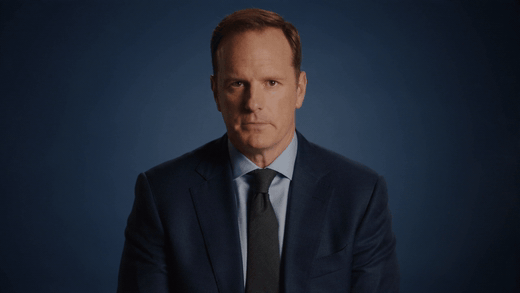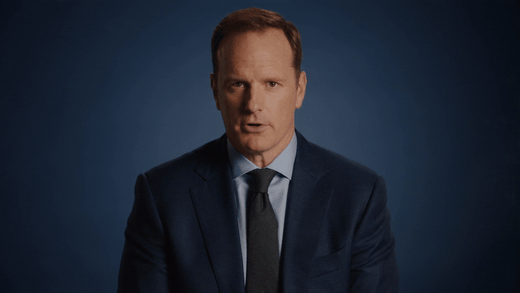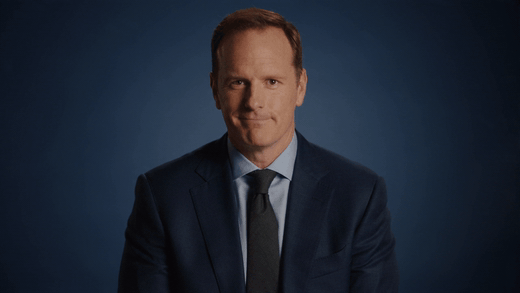
Tyst GIF konverterad från den medföljande avatarvideon. Den visar synlig rörelse men kan inte fastställa ljudsynkronisering eller OmniHuman 2.0-prestanda på egen hand.
- Lyssna utan att titta. Markera känslomässiga förändringar, pauser, betoning, skratt, viskningar och frasslut. Skriv ner vad en lyssnare skulle kunna sluta sig till enbart från rösten.
- Titta med ljudet av. Vid dessa tidsstämplar, notera ansikte, blick, huvudrörelse och gester. Anteckna vad framförandet verkar förmedla utan ljud.
- Spela upp dem tillsammans. Flagga endast avvikelser som förändrar betydelsen eller distraherar från repliken. Ett litet leende under en plågad mening kan spela roll; en mindre blinkning gör det vanligtvis inte.
En granskningstabell omvandlar dessa observationer till en nästa åtgärd:
| Tid | Röstsignal | Synlig signal | Matchning? | Minsta nästa test |
|---|---|---|---|---|
| 00:04 | Tyst, spänd fras | Brett leende | Nej | Minska den begärda leendeintensiteten |
| 00:09 | Paus före en lugnande replik | Ansiktet förblir stilla | Kanske | Lägg till en subtil nickning efter pausen |
| 00:13 | Skratt i inspelningen | Uttrycket förblir allvarligt | Nej | Kontrollera om ljudredigeringen bevarar skrattet tydligt |
Posterna ovan är hypotetiska exempel på hur tabellen kan användas, inte observationer från en modellkörning. Dina granskningsanteckningar bör avse ditt eget klipp. Ändra en sak i taget: revidera prompten, justera ljudredigeringen eller prova ett annat porträtt. Upprepa sedan samma kontroller vid samma ögonblick.
Om avvikelsen kvarstår trots en tydlig signal och en fokuserad riktning, behandla den som en genereringsbegränsning för den tagningen. Fler adjektiv kan tillföra brus utan att lösa problemet med timing eller framförande. Bestäm om ett annat indata eller arbetsflöde är värt att testa, eller om tagningen redan är lämplig för sitt avsedda sammanhang.
Felsök platta eller felmatchade uttryck
Använd symtomet för att välja ett kontrollerat nästa steg. Dessa är allmänna felsökningshypoteser, inte verifierade påståenden om defekter i OmniHuman 2.0.
| Vad du märker | Möjlig orsak | Ett nästa test |
|---|---|---|
| Ansiktet ser neutralt ut genom hela klippet | Rösten har lite kontrast, eller riktningen har ingen synlig signal | Använd ett mer uttrycksfullt ljudparti eller be om en konkret handling vid en tydlig takt |
| Ansiktet överagerar en subtil replik | Prompten begär starkare känsla än spåret stödjer | Ta bort extra handlingar och sänk den känslomässiga intensiteten |
| Munnen verkar hamna ur takt | Inspelningen har brus, överlappande röster, lång tystnad eller svåra klipp | Prova en renare redigering med tightare timing innan du skriver om prompten |
| En lyssnare verkar tala i en gruppbild | Talar- och lyssnarroller kan vara tvetydiga i det testade arbetsflödet | Identifiera varje person efter position och ange vem som talar, om gränssnittet stödjer det |
| Identitet eller fina detaljer förändras under rörelse | Källinramningen eller den begärda rörelsen kan göra enhetligheten svårare att bedöma | Förenkla rörelsen och jämför en kortare, stadigare tagning |
Anta inte att ett ljudproblem kan åtgärdas enbart med prompten. Kontrollera först om orden är tydliga och om tystnad eller redigeringar stör rytmen. Om de är okej, förenkla den synliga riktningen. Ett fokuserat nytt försök ger dig bättre bevis än att skriva om varje indata samtidigt.
Finns OmniHuman 2.0 på Atlas Cloud?
Atlas Clouds nuvarande offentliga modellsidor listar Avatar Omni Human 1.5 och dokumenterar dess bild-, ljud- och valfria promptindata. Jag hittade inte OmniHuman 2.0 i Atlas modelllista under den här kontrollen. Det betyder att den exakta 2.0-modellen inte bör presenteras som körbar via Atlas Cloud.
Om du vill utforska en relaterad ljuddriven avatareuppgift på Atlas, granska modellsidan för Avatar Omni Human 1.5 och dess dokumenterade indata. Dokumentationen anger en referensbild, en ljud-URL och en valfri prompt; den beskriver ljud upp till 60 sekunder och rekommenderar 15 sekunder eller mindre för bästa kvalitet. Det är detaljer för v1.5, inte specifikationer för OmniHuman 2.0. Kontrollera Atlas aktuella modellkatalog för aktuell tillgänglighet och prissättning innan du väljer ett arbetsflöde. Jag kunde inte bekräfta ett aktuellt offentligt pris för den här modellen under efterforskningen, så den här artikeln citerar inget.
Kontrollera rättigheter och sammanhang före publicering
Innan du delar en animerad person, bekräfta att du har tillstånd att använda porträttet och rösten för det avsedda syftet. Granska även musik-, avbildnings-, röst- och distributionsrättigheter för det specifika sammanhanget. Kraven kan variera beroende på källmaterial och användning; den här checklistan är praktisk vägledning, inte en juridisk slutsats.
Märk syntetisk eller redigerad media när tittare rimligen skulle kunna missta den för dokumentärt material eller en verklig persons aktuella uttalande. För projektanteckningar om källfilerna och redigeringarna, särskilt för kund- eller kampanjarbete. Ett tekniskt korrekt framförande behöver fortfarande ett ansvarsfullt publiceringssammanhang.
För OmniHuman 2.0 emotionell röst- och ansiktsuttrycksmatchning är nästa användbara steg ett kontrollerat test: välj ett tydligt porträtt, markera ljudets känslolägen, skriv en kort riktning och granska samma tidsstämplar med ljudet av och på. Om du överväger ett Atlas-hostat alternativ, verifiera först den exakta modellen och aktuellt pris.
Vanliga frågor
Genererar OmniHuman 2.0 rösten?
Arbetsflödet som beskrivs av tredjepartsguider börjar med medföljande ljud och animerar ett porträtt till det. Anta inte att modellen genererar en röst om inte det specifika produktgränssnittet dokumenterar den förmågan.
Kan OmniHuman 2.0 animera sång lika väl som tal?
Tredjepartsguider för OmniHuman 2.0 beskriver både talat och sjunget ljud. För ett sångtest, använd en sektion med rösten i förgrunden och tydlig frasering och styr sedan synliga handlingar kring en hållen ton eller ett frasslut.
Bör prompten upprepa dialogen eller sångtexten?
Vanligtvis inte. Inspelningen tillhandahåller redan orden. Använd prompten för synlig riktning som uttryck, gest, inramning eller en scensignal, och undvik att lägga till formuleringar som krockar med spåret.
Vad bör jag ändra först om uttrycket känns fel?
Använd kontrollen i tre steg för att lokalisera avvikelsen. Om ljudet i sig är otydligt eller känslomässigt platt, testa en ljudredigering först. Om signalen är tydlig men ansiktet missar den, förenkla och tidsjustera en promptriktning.
Finns OmniHuman 2.0 på Atlas Cloud?
Jag hittade inte OmniHuman 2.0 i Atlas Clouds offentliga modellkatalog under den här efterforskningen. Atlas dokumenterar Avatar Omni Human 1.5 som ett relaterat alternativ; verifiera aktuell listning innan du väljer det.





