

Du ber en karaktär att gestikulera över bildrutan, men din källa är en närbild på ett ansikte. Ingen smart formulering kan med säkerhet återskapa de saknade axlarna, händerna eller klädseldetaljerna. OmniHuman 2.0 generering av helkroppsgester från en bild fungerar bäst som ett samordnat val: ge modellen en bildruta som innehåller de kroppsdelar du vill ska röra sig, ljud med en tydlig framförandesignal och en kort prompt som beskriver en åtgärd.
OmniHuman är ett ljuddrivet system för generering av videor med människor. Arbetsflödet som marknadsförs kombinerar en stillbild och ljud, med valfri textstyrning för rörelse eller kamerabeteende. Betrakta ”helkropp” som den typ av framträdande du vill ha, inte som en garanti för att varje porträtt kan producera en komplett, stabil figur. De offentligt dokumenterade specifikationer som citeras här gäller OmniHuman 1.5, så de bör inte antas beskriva alla OmniHuman 2.0-gränssnitt eller distributioner.
Viktiga slutsatser
- Källbilden anger det synliga kroppsområdet och startkompositionen.
- Ljudet tillhandahåller timing för tal eller sång; en prompt tillför visuell riktning.
- Matcha beskärningen mot gesten och håll den begärda åtgärden inom den synliga bildrutan.
- Kontrollera version, indatagränser och pris på den aktuella officiella produktsidan innan du går vidare.
Vad OmniHuman 2.0 gör för helkroppsgester
OmniHuman 2.0 presenteras som ett bild- och ljuddrivet sätt att skapa en video med mänskligt framträdande. Stillbilden etablerar subjektet och initial vy. Ljudet ger framträdandet en röst, rytm och tidsreferens. Valfri text kan beskriva scenen, rörelsen eller kamerariktningen. Det genererade klippet kombinerar dessa signaler till ett rörligt resultat.
Det gör uppgiften bredare än att få en stilla mun att röra sig. En användbar tagning kan omfatta läpprörelser, mimik, huvudrörelser, hållning och handgester. Dessa delar måste stämma överens med samma framträdande. För en talad förklaring kan en liten gest med öppen handflata vid en viktig fras uppfattas mer naturligt än kontinuerlig armrörelse. För sång kan kroppen följa frasering och energi genom låten.
Modellen får inte en komplett 3D-registrering av personen från ett fotografi. Den måste sluta sig till vad som finns utanför beskärningen och hur dolda ytor bör se ut när subjektet rör sig. En begäran om en helkroppsåtgärd innebär därför mer osäkerhet när indata endast visar ansiktet. Den praktiska styrningen är att välja referensbilden utifrån den åtgärd du behöver och sedan använda text för att förfina det som redan stöds visuellt.
Forskningsprojektsidan för OmniHuman 1.5 beskriver ljuddriven animering från en enda bild och diskuterar rörelse- och promptstyrning. Det är användbar bakgrund för modellfamiljen, men det är inte bevis för att en specifik OmniHuman 2.0-prompt kommer att producera en viss gest varje gång (OmniHuman 1.5-projektsidan).
Innan du väljer indata, definiera den avsedda tagningen i en mening: ”en presentatör i midjebild betonar en punkt”, ”en helkroppsartist förskjuter tyngden medan han/hon sjunger” eller ”en talare i närbild levererar en lugn replik”. Bildrutan och ljudet kan sedan tjäna den enda uppgiften.
Välj en källbild som lämnar utrymme för gesten
För helkroppsgester, börja med den bredaste källbild som fortfarande passar den slutliga kompositionen. Om resultatet är avsett som en närbildsvideo av en talande person kan ett tight porträtt vara lämpligt. Om tittaren behöver se en hand peka på ett objekt eller subjektet förskjuta sin tyngd, inkludera dessa delar i källbilden.
| Avsett resultat | Användbar startbeskärning | Rimlig rörelse att begära |
|---|---|---|
| Närbildsberättande | Huvud och axlar | Mimik, huvudvridningar, återhållsam axelrörelse |
| Produktförklaring | Från midjan och uppåt med synliga händer | Kort pekande, presenterande eller betoning med öppen handflata |
| Stående framträdande | Hel figur med utrymme runt kroppen | Hållningsförändringar, tyngdförskjutningar och större gester |
Dessa är produktionsval, inte publicerade BytePlus-krav eller framgångsgarantier. För en helkroppsbildruta, lämna lite andrum runt händer, armbågar och fötter. En hand som redan ligger mot kanten kan klippas så snart den rör sig. Håll ansiktet tillräckligt tydligt för att kunna läsas, använd jämnt ljus där det är möjligt och undvik en källa med en annan person som korsar subjektet. En ren bakgrund gör det också lättare att upptäcka oönskad bakgrundsrörelse.
Bilden bör likna den tagning du planerar att publicera. En porträttkälla som placeras i en liggande utdata kan kräva mer påhittad bakgrund och kroppsområde. En vertikalt inramad källa är ofta lättare att bedöma för en stående karaktär avsedd för ett vertikalt inlägg i sociala medier. Dessa är kompositionsriktlinjer; kontrollera målverktygets aktuella kontroller för eventuella faktiska gränser för bildförhållande eller upplösning.
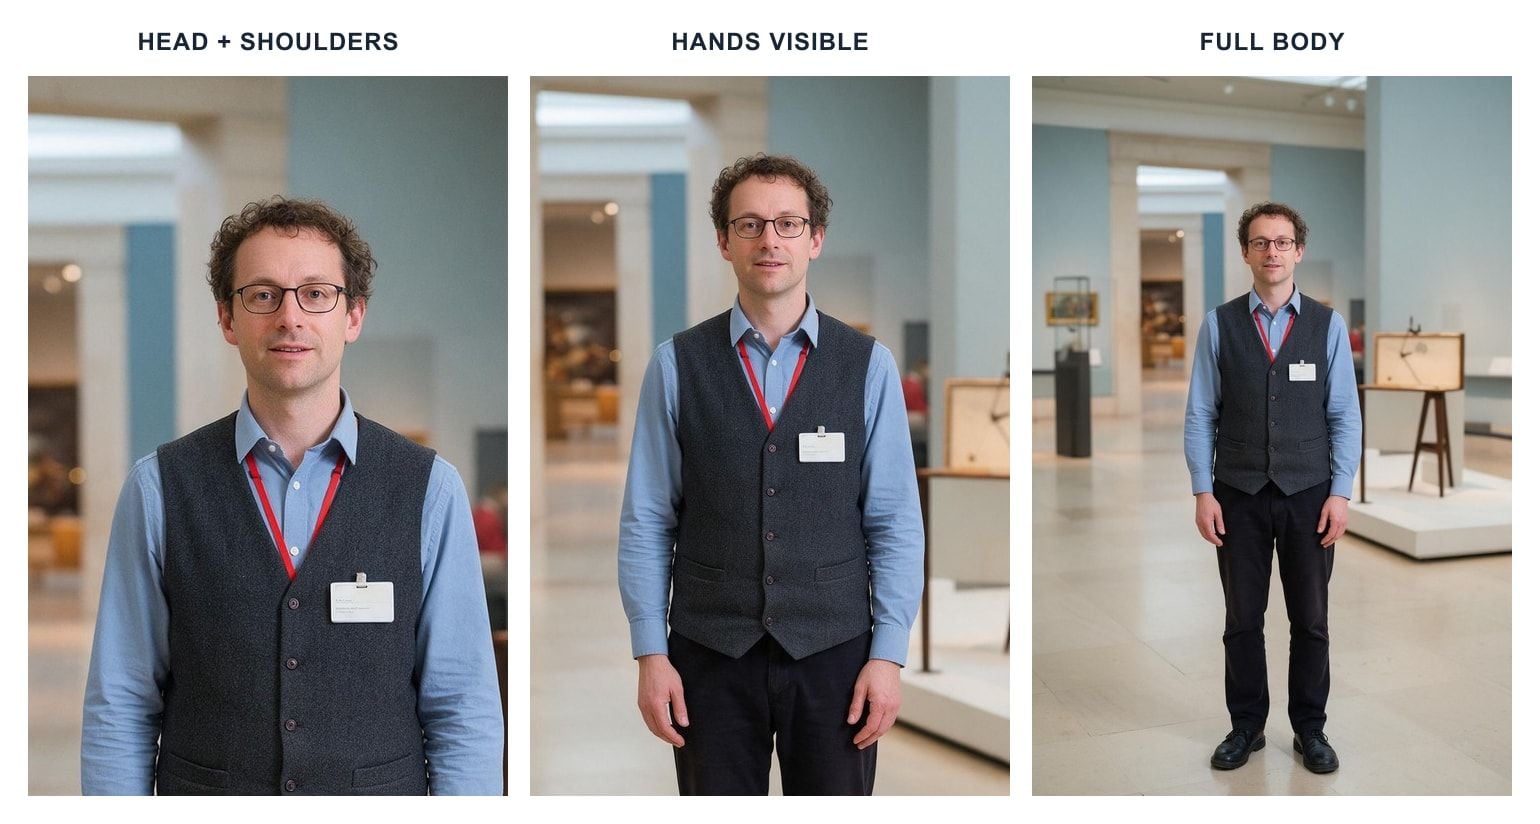
Samma exempelkällfoto i tre beskärningar: en nära bildruta passar ansiktsuttryck, synliga händer ger en presentatör utrymme att gestikulera och hela figuren stöder ett stående framträdande.
Ett enkelt beslutstest hjälper: peka på den kroppsdel som måste röra sig i den färdiga tagningen. Om den saknas i källan, ändra antingen bilden eller sänk rörelsemålet. Använd till exempel en midjebild med synliga händer för en presentatör som ska betona ”tre praktiska steg”. Ett porträtt med endast ansikte passar bättre för en kort hälsning eller närbildsberättande.
Skapa ett framträdande från en bild med ljud och riktning
Se indata som tre olika uppgifter. Bilden svarar på vem som är på skärmen och hur tagningen börjar. Ljudet bär de faktiska orden, pauserna och den vokala energin. Textriktning efterfrågar ett visuellt beteende som passar dessa signaler. Håll indata samstämmiga; en lugn röst parad med ”vilt, konstant dansande” ger modellen motstridig riktning och kan producera ett besvärande framträdande.
Ett användbart arbetsflöde för första omgången är:
- Välj tagningen. Bestäm om tittaren behöver ett nära ansikte, synliga händer eller hela figuren. Välj en källa med det området i bildrutan.
- Förbered representativt ljud. Använd ett kort avsnitt av den riktiga röstinspelningen eller låten, inklusive frasen där gesten ska ske. Testet bör representera den slutliga rytmen och framförandet.
- Lägg till en rörelseidé. Beskriv en enda gest och var den hör hemma i framträdandet. Håll andra åtgärder och kamerabegäranden återhållsamma.
- Generera och granska. Kontrollera ansiktet, händerna, kroppen, bakgrunden och den övergripande inramningen. Ändra en indata i taget vid nästa försök.
För en produktförklaring kan en egen testreplik vara: ”Vi går igenom tre praktiska steg, sedan kan du välja det som passar ditt team.” Spela in den med en kort paus före frasen ”tre praktiska steg”. Använd en midjebild med båda händerna synliga. Det ger den avsedda gesten en tydlig semantisk signal och ett synligt rörelseomfång.
Den officiella BytePlus-dokumentation som kan verifieras här avser OmniHuman 1.5, inte 2.0. För 1.5 listar den en bild och ljud som obligatoriska indata, en valfri prompt, språk som stöds för prompten och utdata i 720p eller 1080p. Översikten listar också en ljudgräns på 60 sekunder och rekommenderar kortare ljud för kvalitet. Dessa detaljer hjälper till att skilja den dokumenterade 1.5-produkten; verifiera 2.0-gränssnittet eller den officiella dokumentationen innan du tillämpar något av detta på 2.0 (BytePlus OmniHuman-dokumentation för videogenerering, uppdaterad oktober 2026).
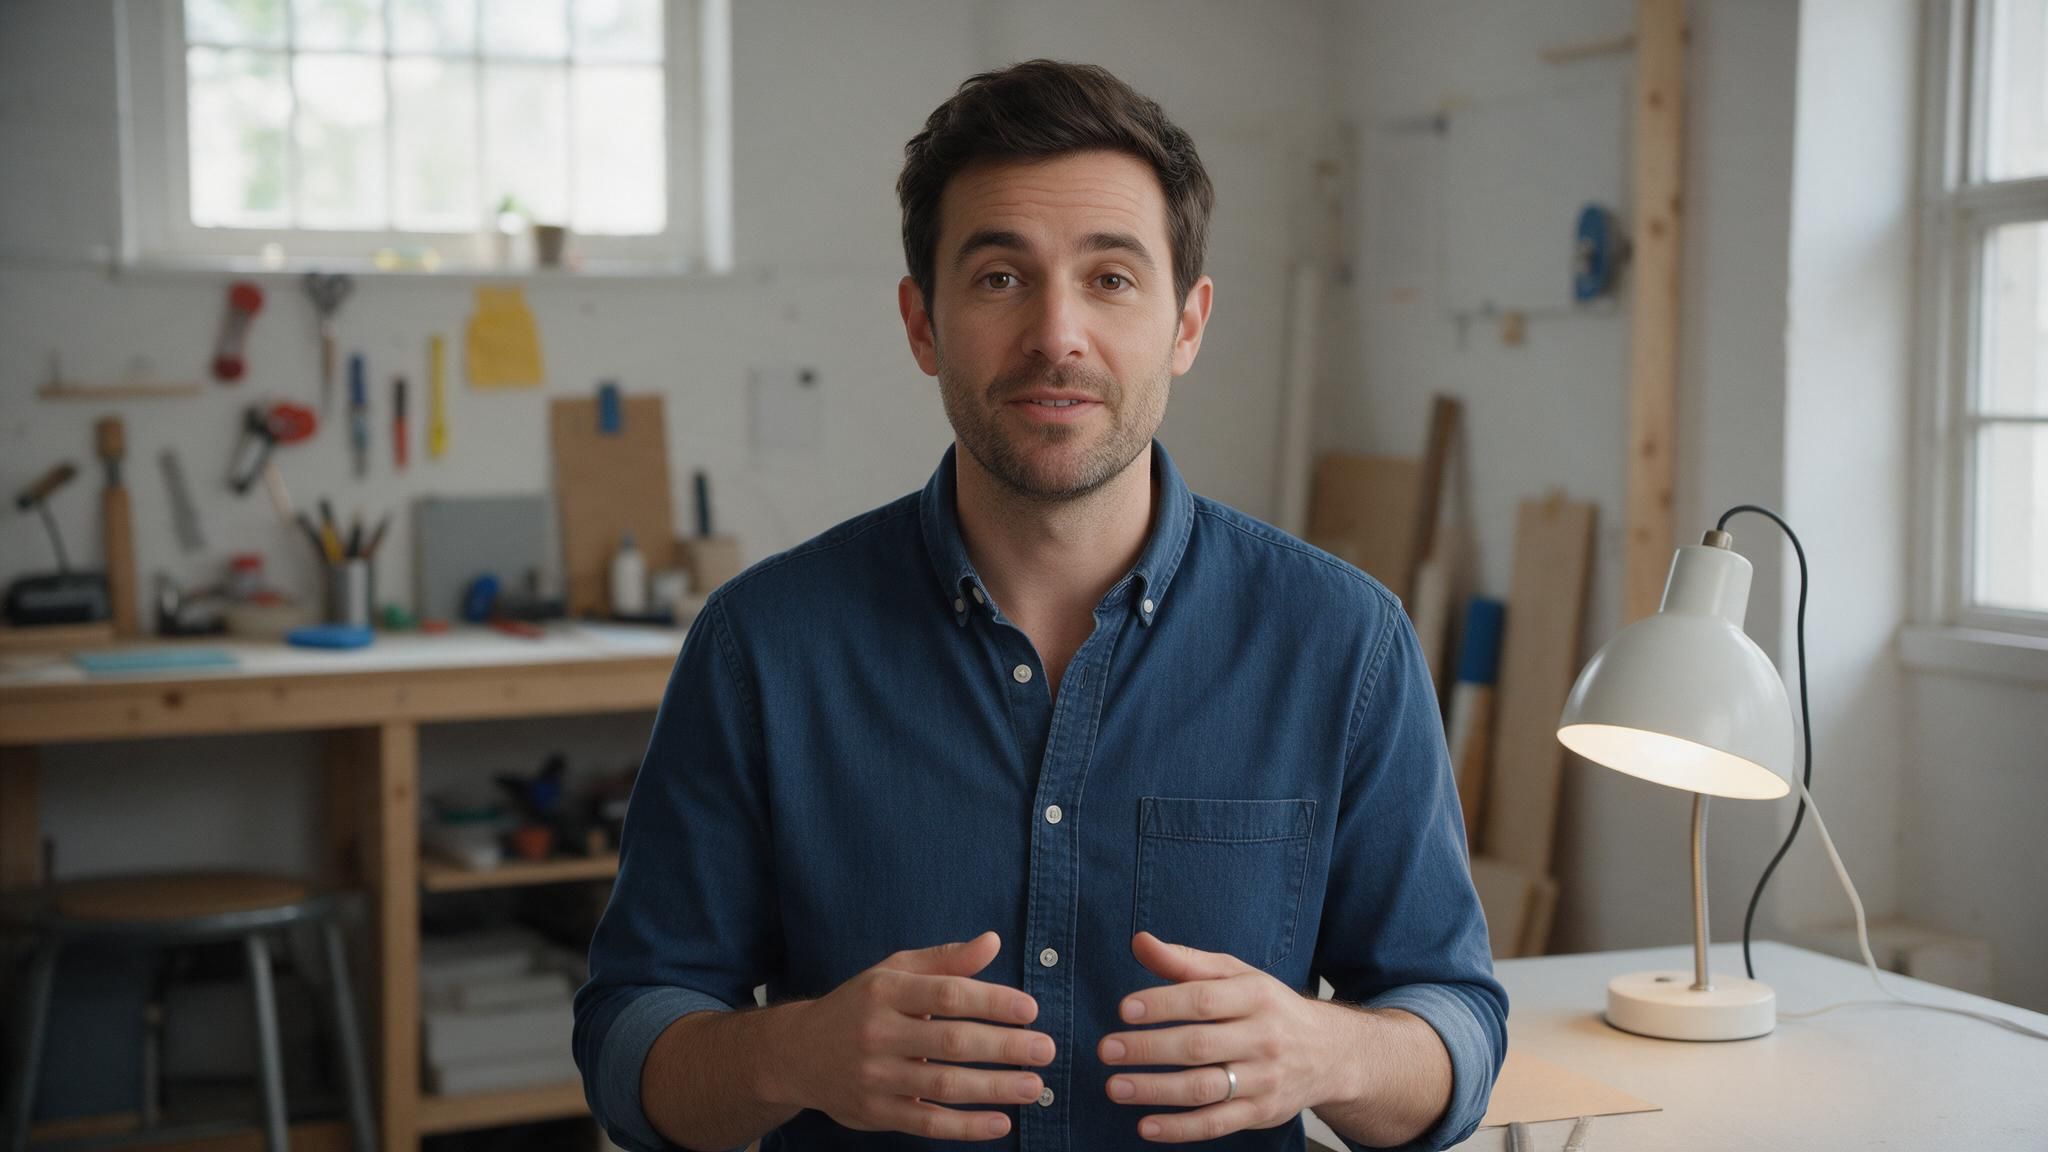
Exempel på källstillbild för produktförklaringen: presentatörens ansikte, båda händerna och lampan är synliga, vilket gör en liten tidsatt handgest lätt att bedöma. Detta är ett indatafoto, inte en OmniHuman-utdata.
Använd ett representativt urval innan du förbereder en lång inspelning. Ett kort test gör det snabbare att upptäcka en felmatchad beskärning, en fras utan gestsignal eller en prompt som begär för mycket. Det är ett kvalitetskontrollval, inte ett påstående om en specifik 2.0-varaktighetsgräns.
Skriv gestpromptar med en tydlig signal
En prompt blir lättare att utvärdera när den namnger en åtgärd, dess signal, dess storlek eller tempo och eventuella inramningsbegränsningar. En bred instruktion som ”gör personen naturlig och uttrycksfull” lämnar flera beslut öppna. En fokuserad instruktion talar om för modellen vilken synlig åtgärd som är viktig och när den ska ske.
Prova det här exemplet med exempelrepliken ovan:
Talaren levererar repliken med en lugn, självsäker ton. Håll kameran stadig. När talaren säger ”tre praktiska steg”, lyft en hand kort för att betona poängen och sänk den sedan naturligt. Använd små, avslappnade gester som håller sig inom den synliga bildrutan.
Den citerade frasen kopplar åtgärden till ett ögonblick i ljudet. ”Lyft en hand kort” ger en avgränsad gest, och ”håll dig inom den synliga bildrutan” undviker att be om rörelse utanför beskärningen. Detta är en mall för promptskrivning, inte ett testat eller garanterat OmniHuman 2.0-kommando. Om systemet inte följer exakta ord eller timing konsekvent, behåll frasen som en bred signal och bedöm den renderade rörelsen i stället för att anta bildruteexakt koreografi.
Ändra bara en huvudvariabel mellan försöken. Om gesten visas för tidigt, justera signalen eller ljudpausen. Om handrörelsen är för stor, minska den begärda amplituden. Om armen är instabil eller delvis påhittad, välj en källa där armen redan är synlig. Att ändra bild, ljud, rörelse och kamerariktning samtidigt gör det svårt att lära sig vilken ändring som hjälpte.
Undvik att stapla orelaterade begäranden: en handvinkning, en pekning, en vändning, en promenad, en kamerabana och en känslomässig förändring allt i en kort rad. Var och en lägger till ytterligare ett krav på samma framträdande. Börja med en avsiktlig rörelse; lägg bara till en andra om det första resultatet fortfarande är tydligt och scenen kräver det.
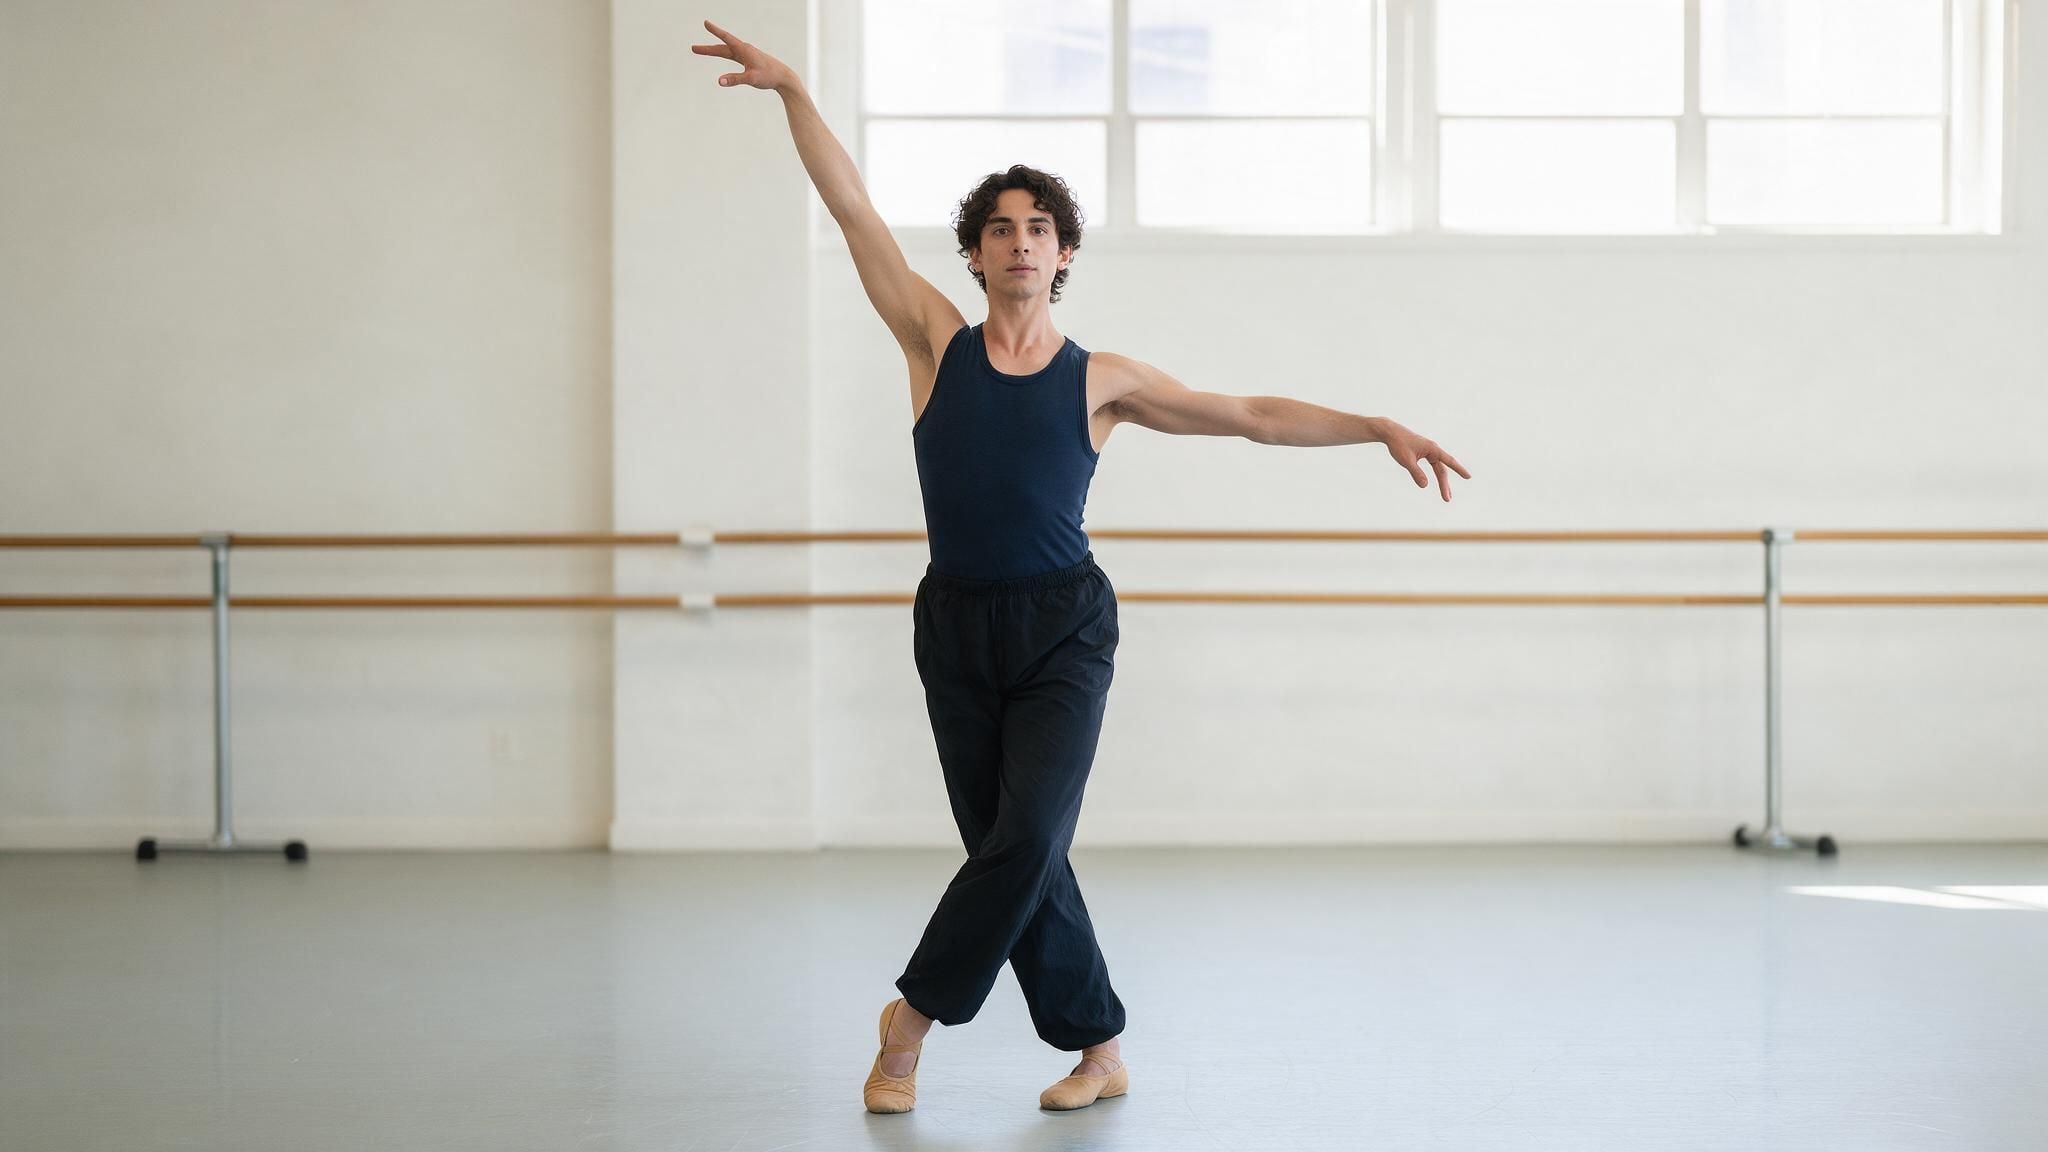
Exempel på källstillbild för en samordnad helkroppspose: den lyfta armen, den utsträckta armen och de stegande fötterna stannar inom bildrutan. Detta är en referensbild för att planera en gest, inte en OmniHuman-genererad bildruta.
Granska resultatet innan du publicerar
Titta på resultatet en gång för det övergripande framträdandet och sedan igen för specifika detaljer. Den andra visningen är användbar eftersom ett klipp kan kännas troligt i normal hastighet men avslöja ett hand- eller bakgrundsproblem vid närmare granskning.
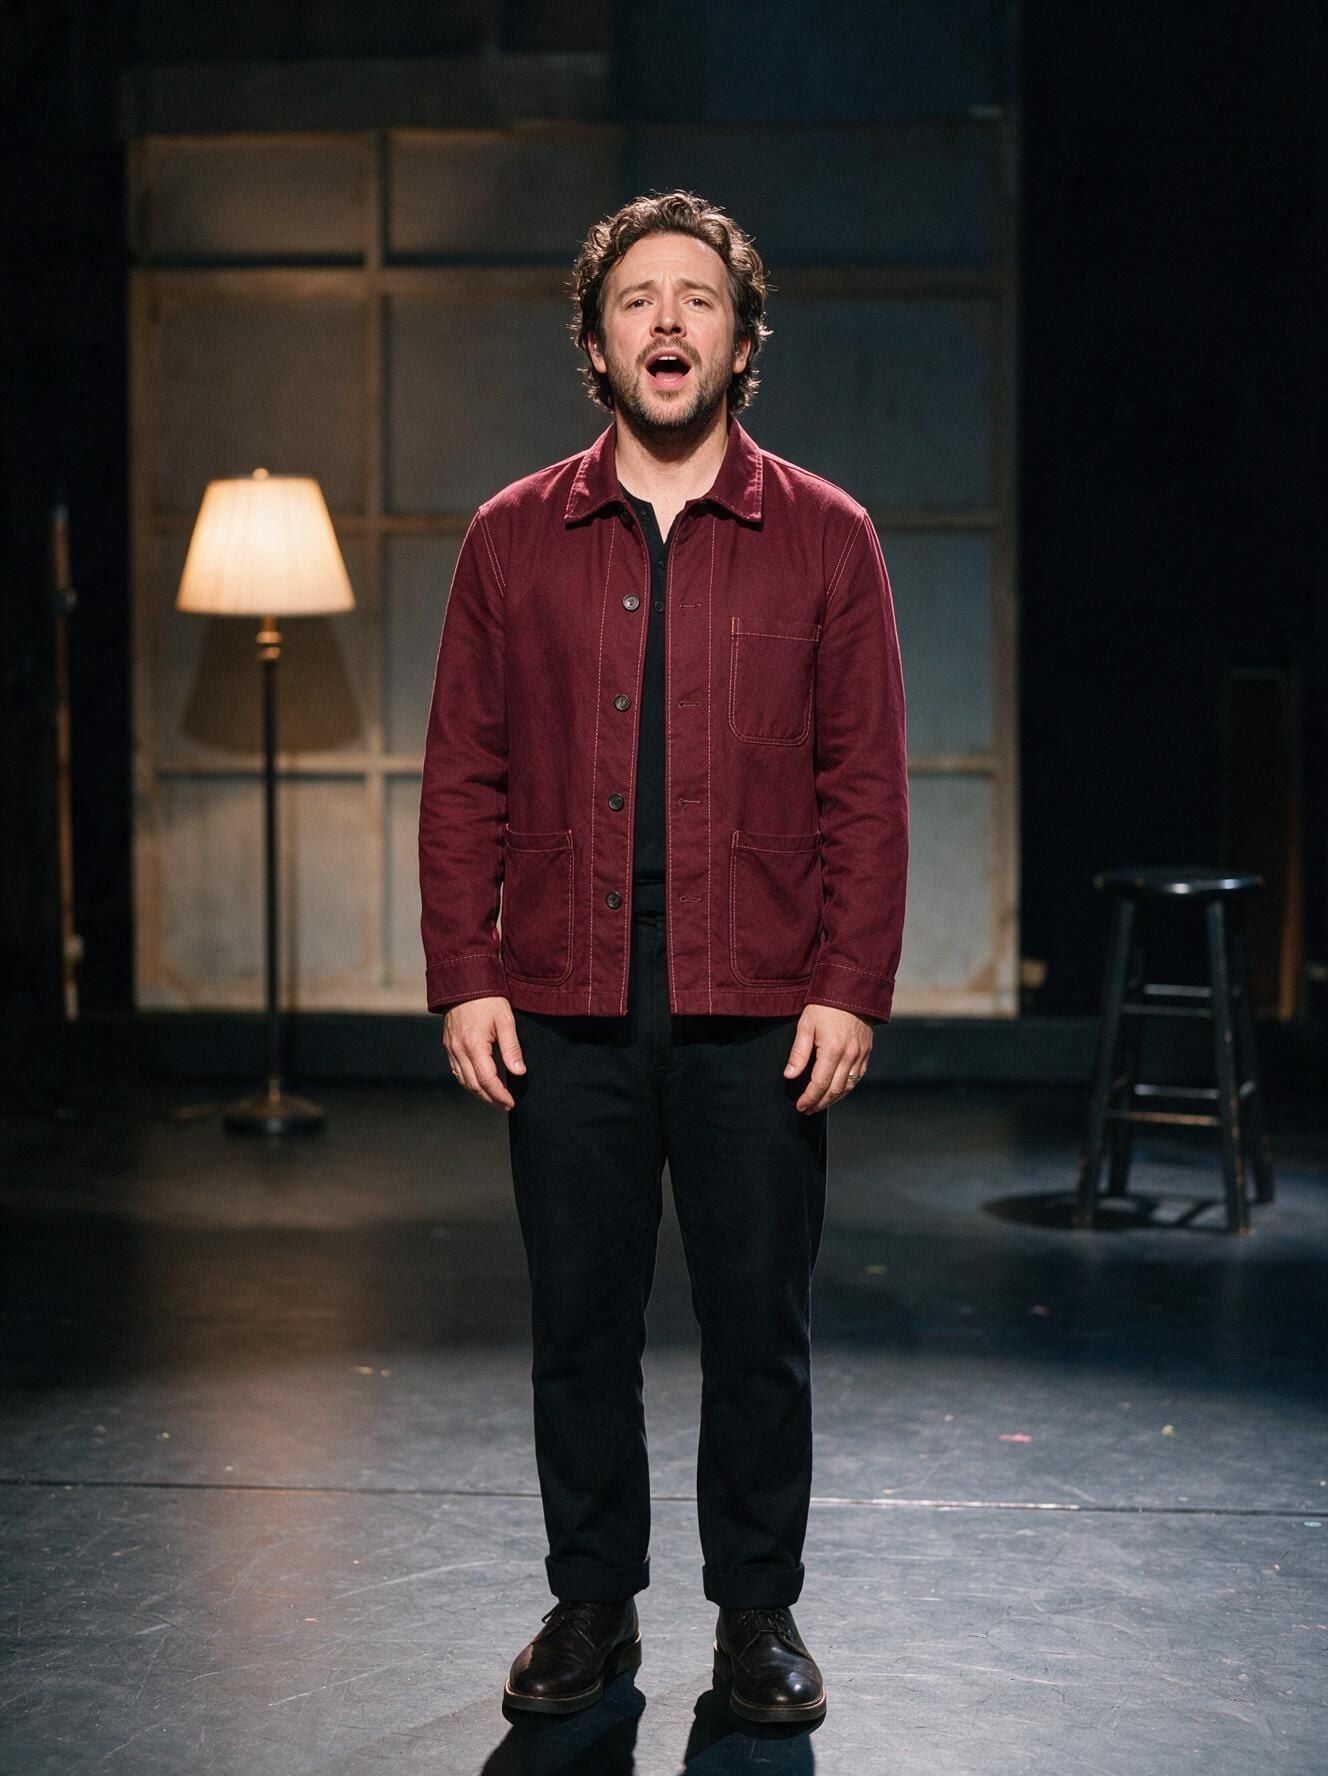
Exempel på källstillbild för ett stående framträdande: jämför varje genererad tagning mot det synliga ansiktet, händerna, jackan, skorna, lampan och pallen när du kontrollerar identitet och scensammanhang. Detta är ett indatafoto, inte en genererad bildruta.
Kontrollera dessa fem områden:
- Tal och uttryck: Följer munnen i stort sett den talade eller sjungna frasen? Passar uttrycken det vokala framförandet?
- Gesttiming: Visas rörelsen nära den avsedda idén eller pausen? Stannar den när betoningen slutar?
- Händer och kropp: Leta efter kortvarigt sammansmälta fingrar, böjda leder, föränderliga ärmar eller kroppsproportioner som skiftar mellan bildrutor.
- Identitet och scen: Förblir ansiktet igenkännbart? Håller kläder, bakgrundsobjekt och belysning sig någorlunda konsekventa?
- Framförandeinramning: Är händerna eller fötterna avskurna? Förblir subjektet tydligt i det bildförhållande och den beskärning du behöver?
När något misslyckas, knyt nästa försök till den observerade orsaken. Byt ut bilden när det nödvändiga kroppsområdet saknas eller beskärningen inte lämnar något rörelseutrymme. Byt ut eller korta ljudet när nyckelfrasen är stressad, otydlig eller känslomässigt felmatchad. Skriv om riktningen när åtgärden kommer vid fel tillfälle eller är för bred. Om klippet är för en offentlig kampanj, bekräfta också att du har tillstånd att animera bilden och använda röstinspelningen, och inhämta eventuellt samtycke som krävs för personerna som representeras.
Ett användbart resultat är inte nödvändigtvis det med mest rörelse. För en kursintroduktion eller produktförklaring kan en återhållsam gest som bevarar identiteten och håller subjektet inom bildrutan kommunicera bättre än en utarbetad åtgärd som drar uppmärksamhet till visuella fel. Behåll tagningen som stöder budskapet och uppfyller publiceringsformatet, och spara sedan källbilden, ljudet, prompten och den valda utdata tillsammans för senare revideringar.
OmniHuman 2.0-åtkomst, versioner och prissättning
BytePlus listar OmniHuman V2.0 i sin dokumentation om sparplaner för videomodeller. Det bekräftar att versionsnamnet förekommer i BytePlus-material, men det fastställer inte en offentlig testmiljö för 2.0, detaljerade indatagränser eller en Atlas Cloud-slutpunkt (BytePlus AI Savings Plans). Kontrollera den exakta modellversionen innan du bygger ett arbetsflöde kring den. Namnet ”OmniHuman 2.0” bör inte behandlas som utbytbart mot ”OmniHuman 1.5”. Den BytePlus-dokumentation som för närvarande visas för den här artikeln är märkt OmniHuman 1.5. Den dokumenterar sitt eget indataschema och sina tjänstebegränsningar, vilka inte bör föras över till 2.0 utan en matchande officiell källa.
Vid tidpunkten för kontrollen för den här artikeln visade Atlas Clouds offentliga modellkatalog ett brett modellutbud, men ingen detaljsida för OmniHuman 2.0 kunde verifieras där. Den specifika Avatar Omni Human-modellsidan identifierar det närliggande 1.5-erbjudandet. Dess visade startpris har rapporterats som $0.12 per sekund i officiella material, men priser och rabatter kan ändras. Kontrollera detaljsidan och Atlas Cloud-modellkatalogen igen innan du budgeterar eller publicerar. Använd inte 1.5-priset som en uppskattning för 2.0.
Om du specifikt behöver OmniHuman 2.0, bekräfta dess officiella åtkomstväg, aktuella indatakrav och pris med BytePlus innan du förbereder produktionsresurser. Om du är öppen för en närliggande version kan Atlas Clouds katalog hjälpa dig att verifiera vilka video- och avatarmodeller som för närvarande listas och är tillgängliga från en katalog. Betrakta det som ett separat produktval: en 1.5-körning kan inte validera en 2.0-prompt eller ett 2.0-resultat.
Vanliga frågor
Kan OmniHuman 2.0 generera en helkroppsvideo från en bild med bara ansikte?
En bild med bara ansikte visar inte den kroppsdetalj som behövs för att styra ett helkroppsframträdande. Ett system kan sluta sig till saknade områden, men deras utseende och rörelse är mindre direkt förankrade i källan. För en handgest, använd en källa som visar handen och tillräckligt mycket arm. För en stående åtgärd, börja med en helkroppsbild.
Behöver OmniHuman 2.0 ljud, eller kan en textprompt animera bilden ensam?
Det beskrivna OmniHuman-arbetsflödet drivs av en bild och ljud, med valfri textriktning. Anta inte att animering av en bild med endast text stöds av den exakta 2.0-tjänst du planerar att använda. Kontrollera den tjänstens aktuella produktsida för vilka indata som accepteras.
Hur lång kan en OmniHuman 2.0-ljudindata vara?
Jag kunde inte verifiera en aktuell officiell ljudvaraktighetsgräns för 2.0. BytePlus publicerade 1.5-översikt anger en gräns under 60 sekunder och rekommenderar kortare indata för kvalitet, men det är en specifikation för 1.5. Bekräfta 2.0-gränsen vid dess officiella åtkomstpunkt innan du spelar in eller laddar upp ett långt spår.
Finns OmniHuman 2.0 på Atlas Cloud ännu?
Ingen offentlig listning av OmniHuman 2.0 gick att verifiera i Atlas Cloud-katalogen när den här artikeln kontrollerades. Atlas Clouds närliggande OmniHuman-sida gäller 1.5. Kontrollera katalogen igen före användning, eftersom katalogens tillgänglighet kan ändras.
Innan du startar ditt nästa försök med OmniHuman 2.0 generering av helkroppsgester från en bild, fatta först ett beslut: identifiera det kroppsområde som den färdiga tagningen måste visa och välj sedan en källa som redan innehåller det. Verifiera den exakta versionen och aktuella gränser hos tjänsten du ska använda, och testa ett kort, representativt ljudstycke innan du förbereder den fullständiga produktionstagningen.





