MiniMax släppte H3 i fredags. Inom tjugofyra timmar fanns Seedance 2.5 i människors händer, och tidslinjen kollapsade till en konversation: trettio sekunder, inbyggd 4K, femtio referensinmatningar. H3:s lanseringsinlägg låg under, tyst, med nästan ingen som körde ett riktigt test på det.
Jag förstår varför. Trettio sekunder är ett bra nummer. Det passar i en rubrik.
Men om du faktiskt gör vertikala kortdramer, vet du att det som förstör din natt inte är sekund trettio. Det är tagning 4. Den manliga huvudrollsinnehavarens käklinje flyttar sig en halv centimeter, hans halsduk tappar ett veck, och tittaren sveper bort innan kroken landar. Ingen slutar titta för att ett klipp var femton sekunder istället för trettio. De slutar för att killen i närbilden inte är killen från helbilden.
Så jag hoppade över spec-duellen. Jag byggde ett karaktärsblad, en sexpanels platskarta, skrev en 15-sekunders gotisk kortdrama-prompt, och skickade det identiska paketet till båda sidorna. Sedan stirrade jag på ansiktet.
Viktiga slutsatser
- Endast H3 är anropsbar idag — Seedance 2.5:s API är ute hos ByteDance, men fortfarande en dag-0-sida på denna plattform.
- Specifikationerna delar sig tydligt: Seedance 2.5 = 30s i ett tag, inbyggd 4K, upp till 50 referenser; H3 = 5–15s, 2K, stereo-ljud på varje klipp.
- Karaktärsstabilitet är ett paketeringsproblem — ett bra referenspaket, inte en större modell, håller ansiktet.
- Båda genererar inbyggt ljud; H3 kan också låsa en röst från upp till tre ljudreferenser.
- Döm pixlar per bildruta, inte sekunder — på samma körning returnerade H3 1440p medan Seedance returnerade 720p.
Resultatet Seedance 2.5 vs MiniMax H3, Innan Någon Teori
Innan någon teori, här är vad arbetsflödet producerar. Det är fyra tagningar tagna ur ett färdigt 15-sekunders vertikalt klipp och satta i ett rutnät. Det är MiniMax egen H3-referenskörning byggd från exakt det karaktärsblad och den platskarta som du kommer att se i Steg 1 och Steg 2, i inbyggd 1440x2560. Mina egna körningar av samma paket kommer senare, i handledningen, med lekplatsens tillstånd synligt.
Hon når den snidade dörren, som är panel 4 på platskartan, sedan korridoren, sedan en tight närbild på honom, sedan tvåbilden. Hans hårfäste delar sig på samma sätt i profilen och i närbilden. Hennes halvuppsatta flätade krona överlever en helbildsnärbild, vilket är precis där de flesta modeller tyst bygger om ett ansikte. Den krämfärgade spetsklänningen behåller samma halsringning och ärmslut från första bilden till sista.
Det är hela testet. Inte trettio sekunder. Fyra tagningar och en käklinje.
Varför Seedance 2.5 vs MiniMax H3 Bröt Samma Vecka, och Varför De Flesta Karaktärstester Är Värdelösa
MiniMax släppte H3 den 30 juli, en allmän multimodal videomodell som läser text, bilder, video och ljud som ett sammanhang och returnerar 5 till 15 sekunders klipp i upp till 2K med inbyggt stereoljud. Den kan också redigera befintligt material och överföra rörelse från ett klipp till ett annat, och MiniMax sa att vikter skulle följa inom dagar (Reuters, juli 2026).
Seedance 2.5 landade i samma fönster med ett högre nummer: 30 sekunder i en enda generering, inbyggd 4K, och upp till 50 multimodala referensinmatningar i ett jobb (The Next Web, juli 2026). Dess API är redan i utvecklares händer, med lokaliserad redigering som omritar en del av en bildruta medan prestanda, belysning och kamerabeteende bibehålls, referens-till-video som accepterar green-screen-plattor eller 3D-vitmodell-blockouts, elva språk, och ett experimentellt långvideoläge som når 180 sekunder (CineD, juli 2026).
Uppmärksamhetsgapet är den intressanta delen. Nästan varje inlägg jag kunde hitta var ett 2.5-klipp. Samtidigt säger de offentliga arenanumren något annat: på Artificial Analysis bild-till-video-ledartavlan leder Seedance 2.0 i 720p med 1 196 Elo, Gemini Omni Flash följer med 1 195, och MiniMax H3 är redan trea med 1 185, fyra dagar efter lansering. Seedance 2.5 har ingen rating där än (Artificial Analysis, juli 2026). Modellen med minst prat är den med högst förhållande mellan poäng och uppmärksamhet.
Nu den del som faktiskt avgör din utdata, eftersom den har nästan ingenting att göra med vilken logotyp du väljer.
De flesta karaktärskonsistenstest misslyckas innan modellen ens är involverad. Fyra felfall, och alla fyra är dina att fixa:
| Felfall | Vad du ser i utdatan | Fixen |
|---|---|---|
| Multi-vy-referenser skickas som separata filer | Varje tagnings ansikte är "nästan rätt" och inga två stämmer överens | Kompositera vyerna till en bild, tilldela sedan roller i prompten ("mannen till VÄNSTER", "kvinnan till HÖGER") |
| Karaktärsbeskrivningen skrivs om per tagning | Kläder och accessoarer driver tagning till tagning | Skriv identitetsblocket en gång och återanvänd det ordagrant; endast kamera och handling ändras per tagning |
| Låta belysning följa med scenen | Ansiktet byggs om strukturellt i det nya ljuset | Bygg en separat platskarta som låser ljusriktning, dimma och golvreflektion, och mata in den som referens |
| Behandla maxlängd som en kvalitetsmåttstock | En drift inom 30 sekunder dödar alla 30 | Kapa till den granularitet du kan göra om, prata sedan om längd |
Vill du sätta Seedance 2.5 och MiniMax H3 framför samma prompt själv? Atlas Cloud's modelljämförelse kör dem sida vid sida i ett pass — identisk prompt och inställningar, med kostnaden uppskattad innan du genererar — så att du kan bedöma ansikten, rörelse och text på skärmen utan att boka två separata tester.
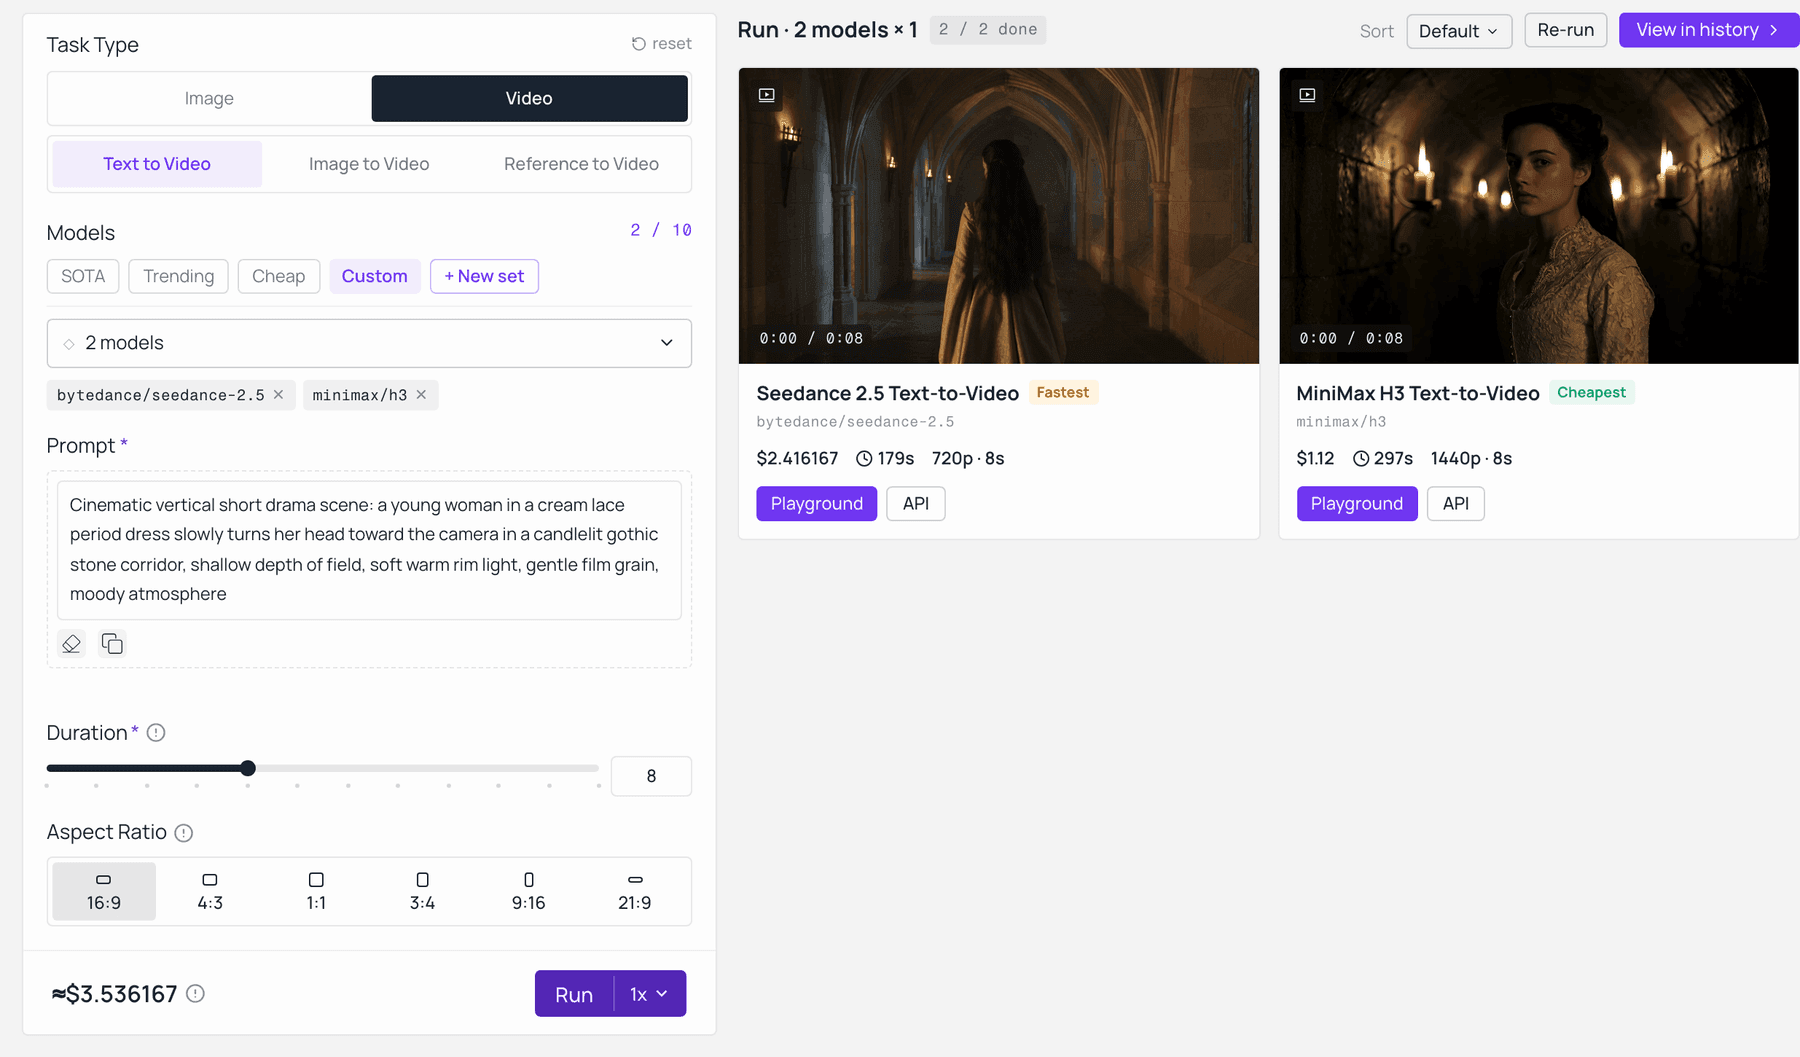
Seedance 2.5 och MiniMax H3 på identisk prompt i Atlas Cloud's modelljämförelse. Seedance 2.5 returnerade 720p för $2,42; MiniMax H3 returnerade 1440p för $1,12, och båda priserna uppskattades före körningen. Fångad live på model-explorer.
Rad ett är den som folk får fel mest på. Skicka sex enkelvy-bilder och modellen behandlar dem som sex kandidatpersoner och genomsnittar dem. Skicka en ren komposit och den behandlar dem som en person sedd från tre sidor. Samma pixlar, helt olika resultat.
Seedance 2.5 vs MiniMax H3 Specifikationsblad, och Vad Du Faktiskt Kan Anropa Idag
Dela förmåga från tillgänglighet och spänningen blir tydlig. I rå förmåga leder Seedance 2.5 på längd, upplösningstak, referensantal och redigeringsgranularitet. I tillgänglighet är H3 den med tre live-endpoints på en allmän modellplattform denna vecka. Om du gör AI-videomodelljämförelse för 2026-planering spelar den andra kolumnen lika stor roll som den första.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-till-Video (vad jag körde) | |
|---|---|---|---|
| Maxlängd, en generation | 5 till 15 s | upp till 30 s, utan sömning (beta-läge till 180 s, experimentellt) | kortklippsmeny, se modellsida |
| Upplösning | inbyggd 2K, 1440p kortsida vid 16:9 till 9:16; en 768p-nivå är listad som kommande | inbyggd 4K, 10-bitars färg | upp till 720p på denna endpoint |
| Bildhastighet | 24 fps | inte separat publicerad | inte separat publicerad |
| Referensinmatningar | 9 bilder + 3 videor + 3 ljud, 12 filer totalt | upp till 50 multimodala referenser | 9 bilder + 3 videor + 3 ljud |
| Inbyggt ljud | ja, varje utdata, stereo | ja, plus 11 undertext- och röstspråk | ja |
| Redigeringsgranularitet | helaklipps instruktionsredigering (byta karaktär, bakgrund, belysning, dialog) | regionnivå-redigering som omritar en del av en bildruta | helaklipps instruktionsredigering |
| Promptgräns | 7 000 tecken | inte publicerad | inte publicerad |
| Öppna vikter | annonserade för dagar efter lansering | inte annonserade | inte annonserade |
| Artificial Analysis I2V Elo, 31 jul 2026 | 1 185 (3:e) | inte rankad än | 1 196 (1:a, Dreamina 720p-entry) |
| Anropsbar på plattformen jag testade | ja, 3 endpoints | inte än, dag-0-sida | ja |
Fullständig redovisning av testupplägget. Seedance 2.5 var inte öppen på min plattform när jag körde detta, så Seedance-sidan är Seedance 2.0 Reference-to-Video, den nuvarande levererande medlemmen av samma familj med samma fyrmodala referenssystem. Där 2.5 skulle ändra svaret säger jag det. Seedance 2.5-sidan är en dag-0-notis för nu.
Allt nedan körs i en webbläsarflik, på en nyckel, totalt tre modeller:
| Steg | Modell | Vad den producerar | Nyckelinställningar | Vad driver kostnaden |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | karaktärsbladet | quality high, 16:9 | per bild, pay as you go, aktuell taxa på modellsidan |
| 2 | samma modell, andra körning | sexpanels plats- och belysningskarta | quality high, 16:9 | per bild, pay as you go |
| 3 | MiniMax H3 Reference-to-Video | det 9:16 vertikala klippet med inbyggt ljud | 9:16, 2K, längd 5 för test och 15 för riktiga klippet | sekunder x upplösning, debiterad per sekund |
| 4 | Seedance 2.0 Reference-to-Video | kontrollkörningen, identiska inmatningar | 9:16, högsta tillgängliga upplösning, samma längd | sekunder x upplösning, debiterad per sekund |
| 5 | H3 Reference-to-Video, klipp som inmatning | en fixad tagning utan att göra om allt | samma upplösning, kort längd | sekunder x upplösning, debiterad per sekund |
H3 har också text-to-video och image-to-video om du vill ha en ren textbaslinje eller första-och-sista-bildruta-kontroll istället.
En sak till värd att veta innan du planerar en batch: text på skärmen. Denna 15-sekunders H3-titelsekvens håller engelska texter genom åtta hårda klipp utan ett enda stavfel, vilket är en av de svåraste sakerna att hålla stabil i genererad video.
Seedance 2.5 vs MiniMax H3 Kortdrama-arbetsflöde, Steg för Steg
Fem steg. Kopiera promptarna exakt som de är skrivna, inklusive de fula delarna. Jag rengjorde dem inte för artikeln och du bör inte rengöra dem för modellen.
Steg 1: Bygg karaktärsbladet med GPT Image 2
Gör referenspaketet innan du gör någon video. En bild, två karaktärer, tre vyer var, ren vit sömlös bakgrund, jämn studioljus. Det tar bort all tvetydighet utom den du bryr dig om: hur ser denna person ut.
plaintext1Ett helkroppskaraktärsblad på en ren vit sömlös bakgrund, två karaktärer sida vid sida, sex figurer totalt, jämn neutral studioljus, inga skuggor på golvet, ingen text, inga etiketter, ingen vattenstämpel. 2 3VÄNSTER HALVA, manlig huvudroll, tre vyer i rad: framifrån, höger profil, bakifrån. Sent 20-årsåldern, blek hy, mörkt vågigt medellångt hår, skarp käklinje. Klädd i en golvlång svart sammetsrock med subtil ton-i-ton-broderi på slag och ärmslut, en svart brokadväst, en svart sidenhalsduk, raka svarta byxor, polerade svarta läderderbyskor. Armarna avslappnade vid sidorna, neutralt uttryck. 4 5HÖGER HALVA, kvinnlig huvudroll, tre vyer i rad: framifrån, höger profil, bakifrån. Tidigt 20-årsåldern, ljus hy, långt vågigt kastanjebrunt hår med en halvuppsatt flätad krona. Klädd i en krämfärgad viktoriansk bomullsspetsklänning, långa ärmar med spetsmanschetter, åtsittande livstycke med små knappar, full anklång kjol, krämfärgade ankelbandsskor med låg klack. Armarna avslappnade vid sidorna, neutralt uttryck. 6 7Fotografisk realism, konsekvent skala mellan alla sex figurer, fötter i linje på samma baslinje, skarpt fokus kant till kant.
Inställningar: modell OpenAI GPT Image 2 Text-to-Image, Quality high, Aspect ratio 16:9, allt annat standard.
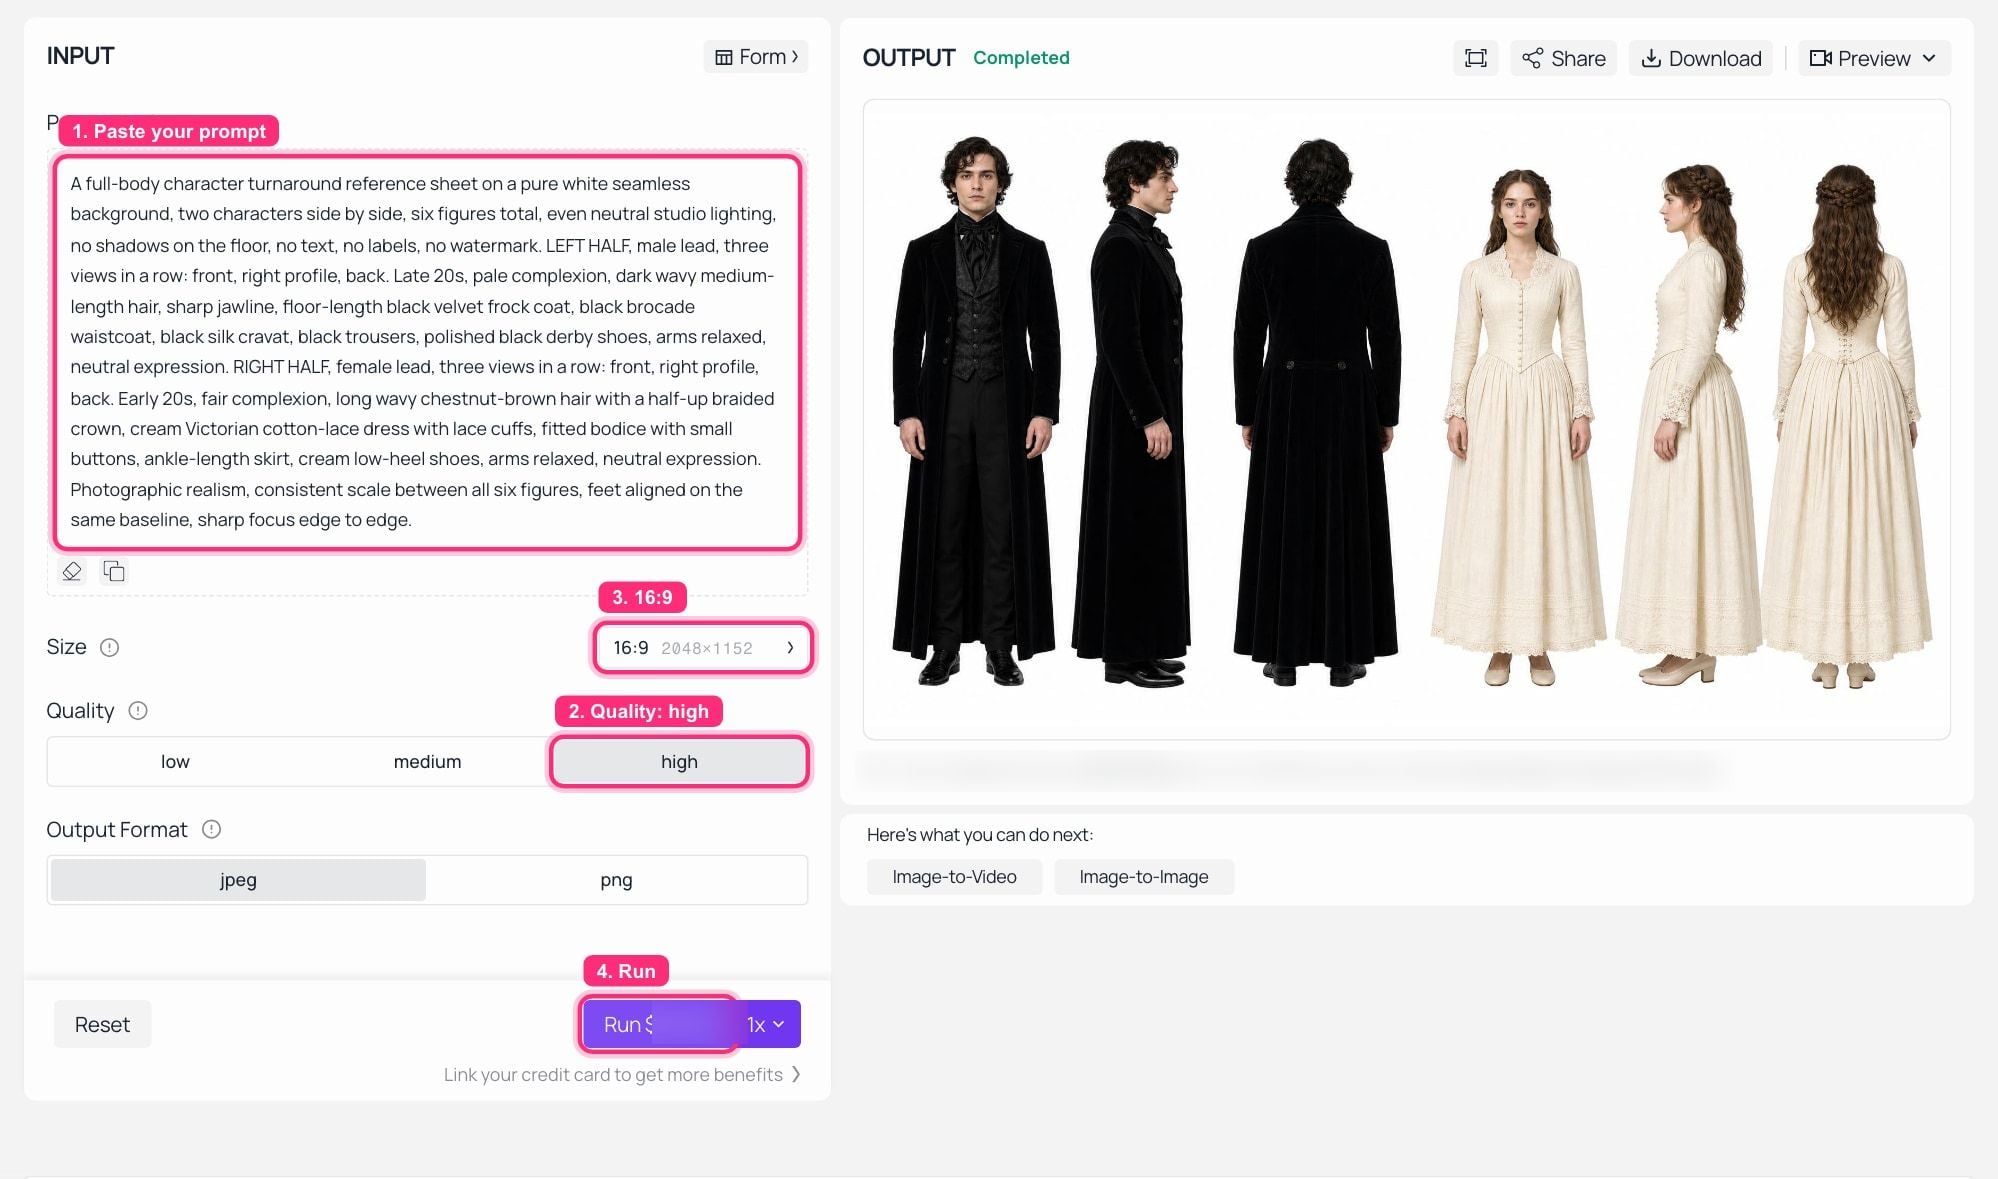 GPT Image 2 Text-to-Image på Atlas Cloud, körning slutförd: karaktärsbladsprompten till vänster, sex figurer på ett vitt ark i OUTPUT-panelen.
Detta är målformen. Sex figurer, en baslinje, inget i bakgrunden att bråka om:
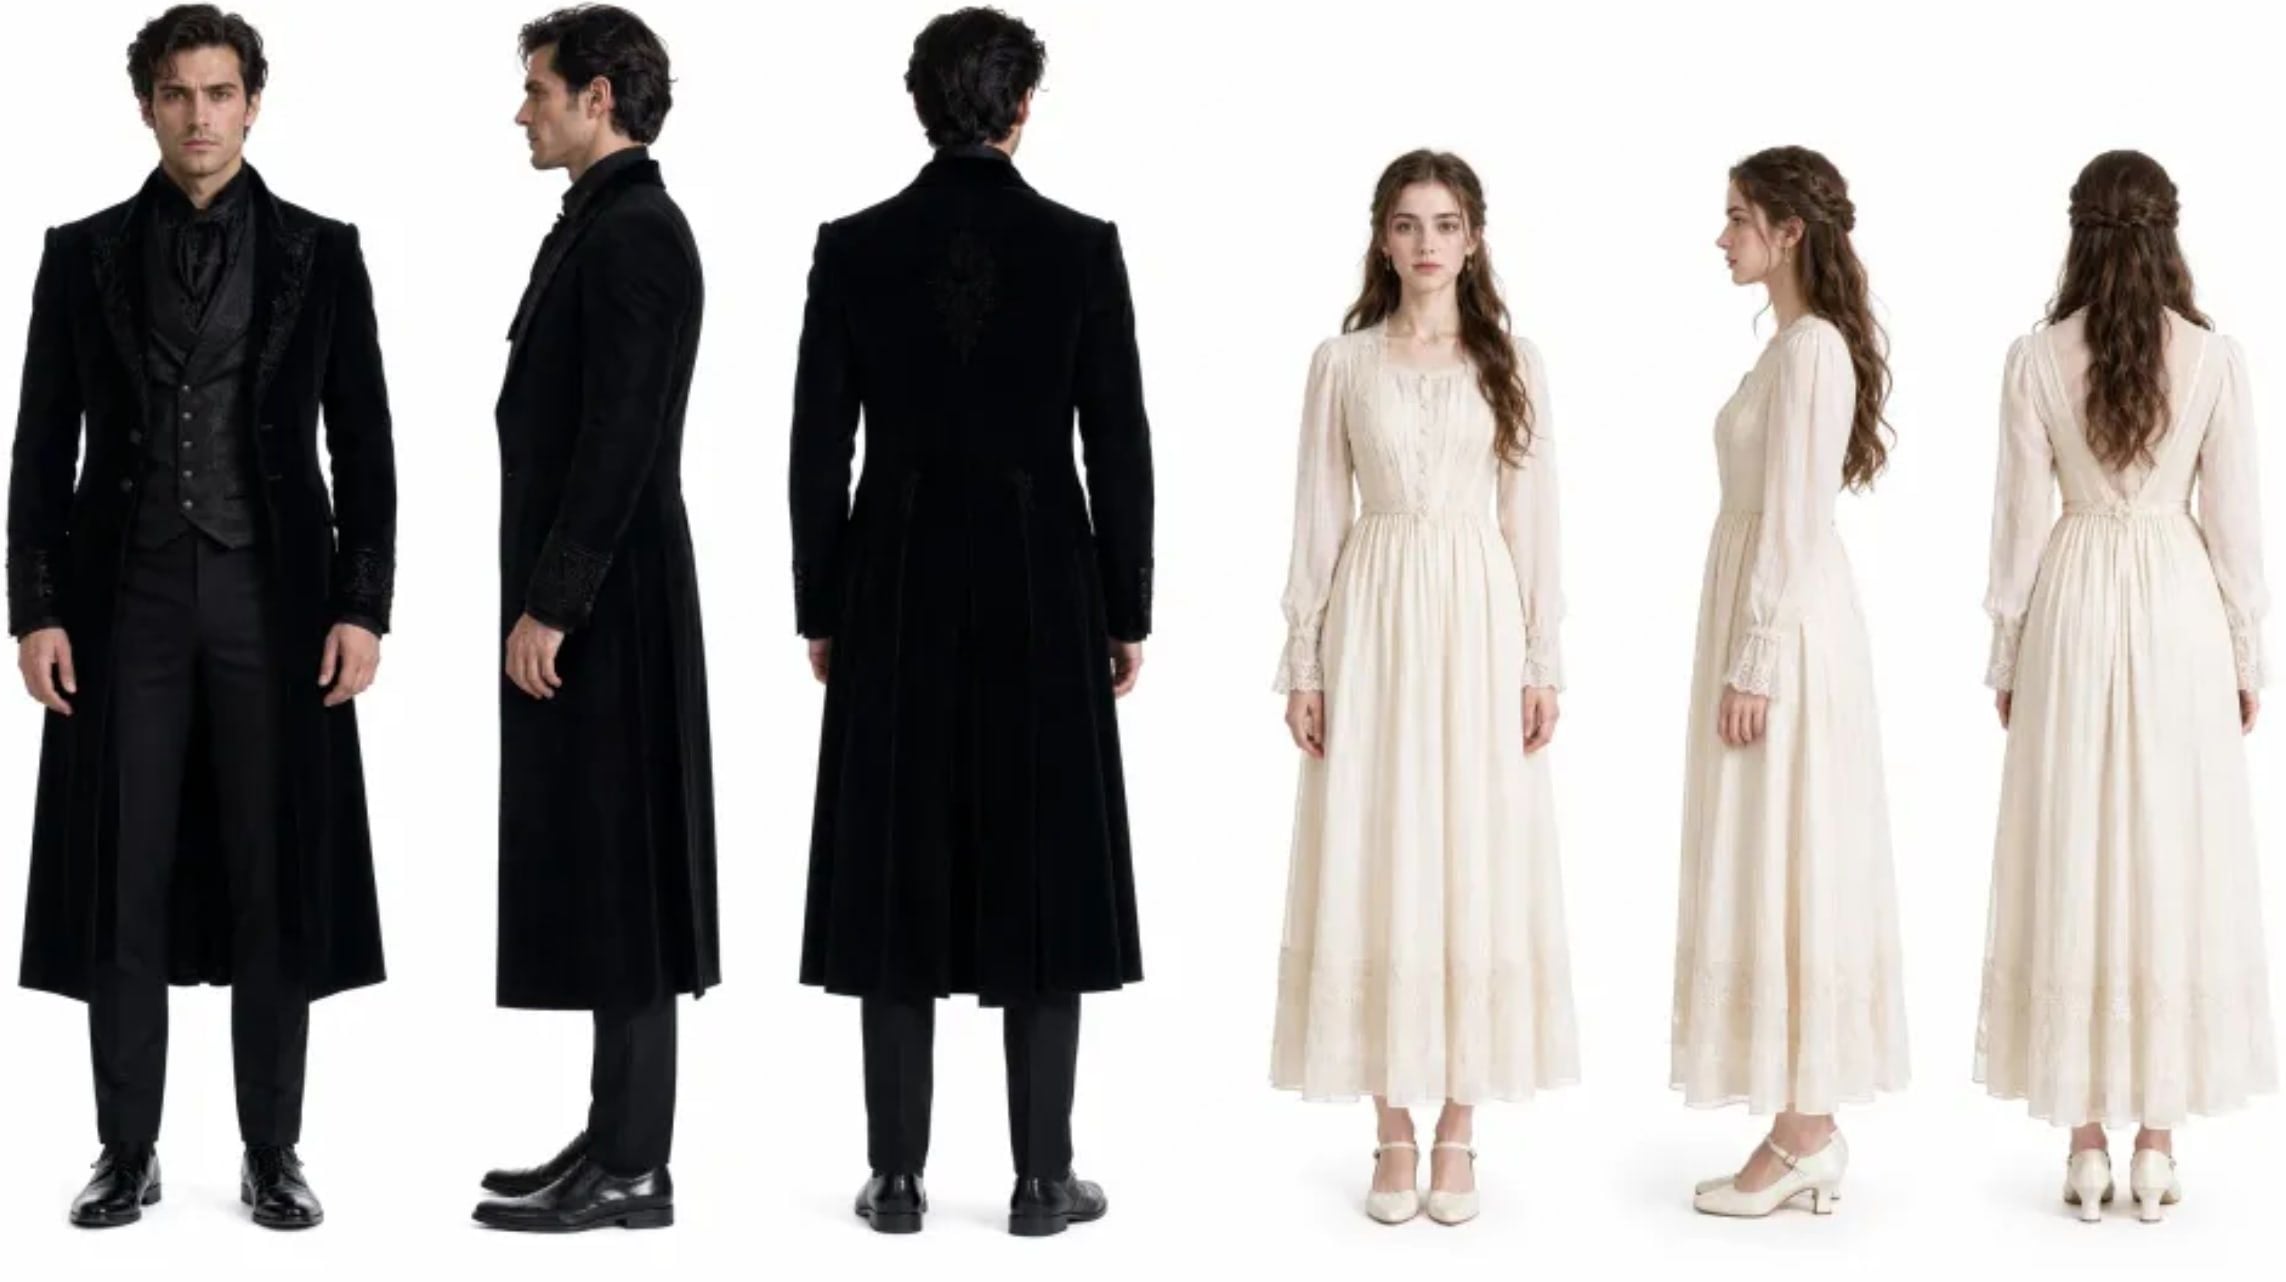 Referenspaketet som drev demolippet: manlig huvudroll i svart sammet, kvinnlig huvudroll i krämfärgad viktoriansk spets, tre vyer var, en fil.
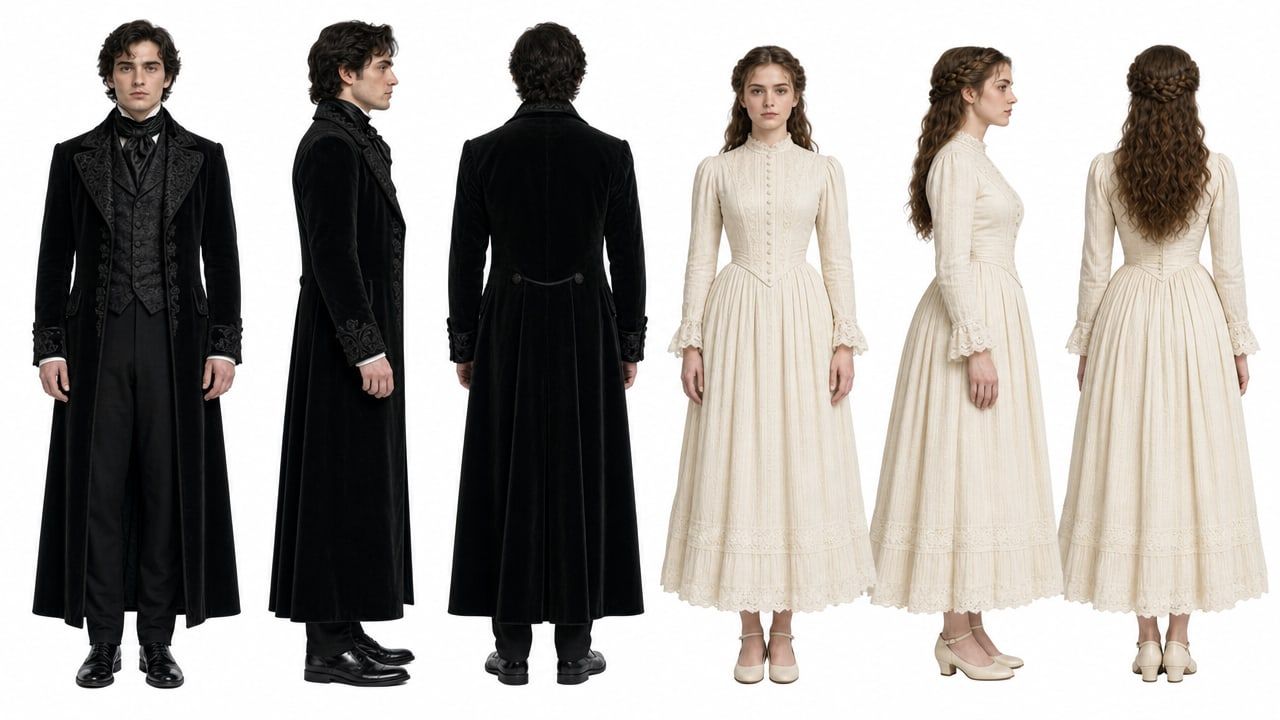 Min egen GPT Image 2-körning av Steg 1-prompten, för jämförelse med referensen ovan.
Steg 2: Lås platsen med en sexpanels scenkarta
Du höll ansiktet. Ljus kommer fortfarande att förråda dig. Den andra referensbilden spikar sex kamerapositioner, månljusets riktning, hur mycket dimma som ligger i luften och hur vått golvet ser ut. Du talar om för modellen att denna film har exakt en ljussättning.
plaintext1En sexpanels filmisk platskarta, 2 rader med 3 kolumner, tunna svarta mellanrum mellan panelerna, varje panel med bildtext i liten elegant vit versal med bokstavsmellanrum längst ner på panelen. Motiv: interiören av ett övergivet gotiskt slott på natten. Kallt blått månljus, drivande låg dimma, vått reflekterande stengolv, höga glasmålningar, järnljushållare med små varma lågor, djupa avmättade svarta, tunga sammetsgardiner. Inga människor i någon panel. 2 3Panel 1, bildtext "VID ETABLERINGSBILD - KORRIDOR": en lång pelargång som försvinner mot ett upplyst glasmålningsfönster. 4Panel 2, bildtext "LÅG VINKEL - MÅNLJUS ÖVER GOLV": låg kamera, en stråle månljus som sveper över våta stenplattor. 5Panel 3, bildtext "DÖRR & TRAPPA KOMPOSITION": en välvd dörröppning som inramar en svängd stentrappa. 6Panel 4, bildtext "NÄRBILD DETALJ - SNIDAD DÖRR": tight bild av en tung snidad trädörr med järnhandtag. 7Panel 5, bildtext "FÖNSTER VY - DIMMA & GARDINER": högt fönster, dimma rullar in, gardinkant i förgrunden. 8Panel 6, bildtext "SLUTLIG POSTERBILD - TOM HALL": symmetrisk tom hall, mönstrad löpare som leder till fönstret. 9 10Fotografiskt, filmiskt, filmkorn, konsekvent färggradering över alla sex paneler.
Inställningar: samma modell, Quality high, Aspect ratio 16:9.
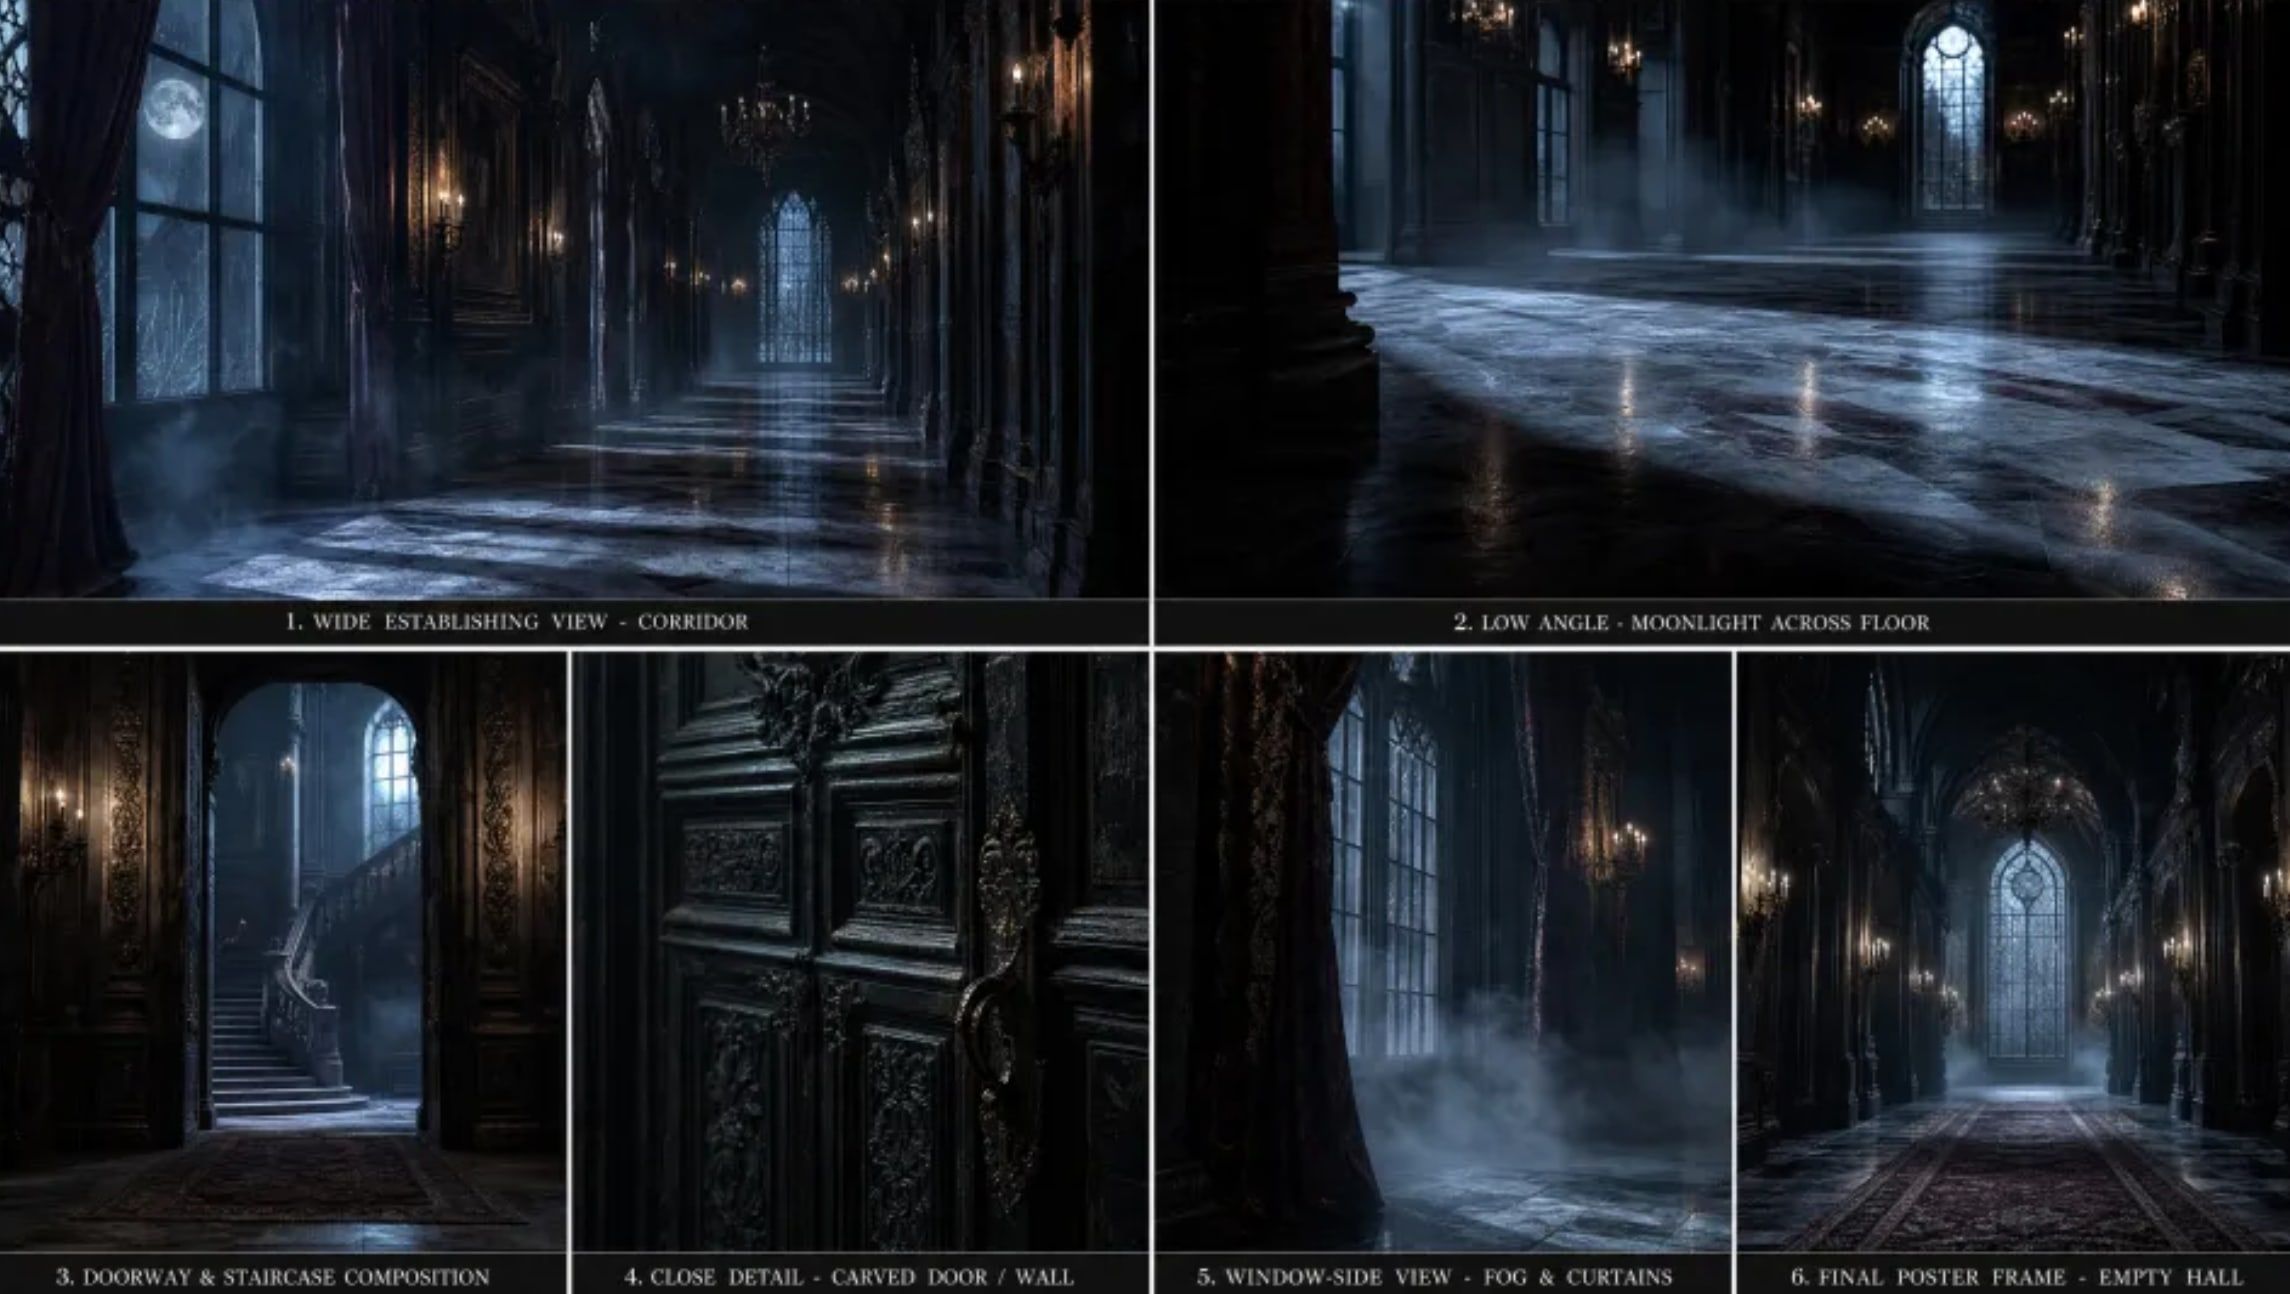 Platskartan som drev demolippet: sex gotiska slottsinteriörer, en färggradering, bildtexter läsbara.
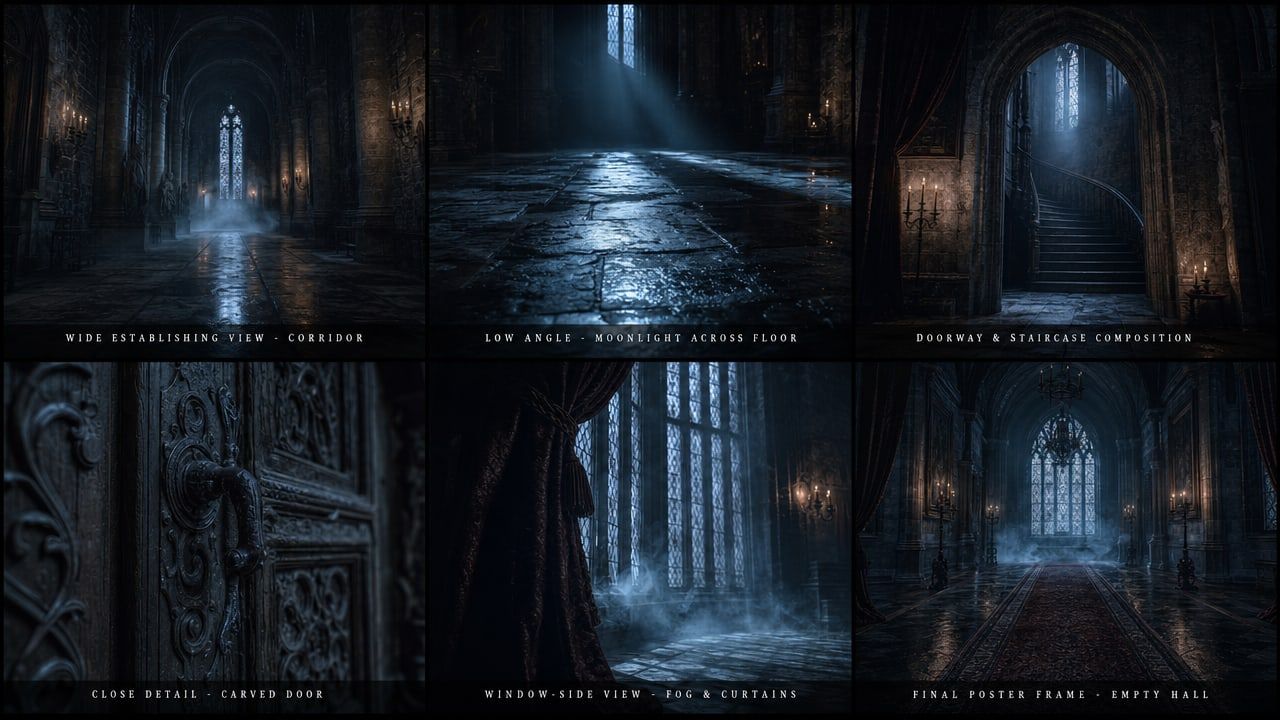 Min egen GPT Image 2-körning av Steg 2-platskartaprompten.
Steg 3: Generera tagningen med MiniMax H3 reference-to-video
Två referensbilder plus en prompt som bär kamerapositioner och ljudriktning. Ljud produceras i samma pass, så det finns ingen separat röst- eller musikdel. Håll längden kort medan du ställer in, öka sedan till 15 för det riktiga klippet.
plaintext1Referensbild 1 är karaktärsbladet: mannen till VÄNSTER är den manliga huvudrollen, kvinnan till HÖGER är den kvinnliga huvudrollen. Behåll båda identiteterna exakt som visade: hans käklinje, mörka vågiga hår, svarta sammetsrock, svarta brokadväst och svarta sidenhalsduk; hennes kastanjebruna halvuppsatta flätade hår och krämfärgade viktorianska spetsklänning. Referensbild 2 är plats- och belysningskartan: matcha dess kalla blå månljus, drivande dimma, våta reflekterande stengolv och avmättade svarta toner. 2 39:16 vertikal, premium live-action kortdrama-look, grunt skärpedjup, filmisk kontrast, inga undertexter, ingen text på skärmen, ingen vattenstämpel. 4 5Tagning 1: Medium närbild, kamera som långsamt zoomar in. Den kvinnliga huvudrollen står i den månljusa korridoren, andas ytligt, blicken fäst på något utanför bild till höger. Dimma rör sig förbi henne i knähöjd. 6Tagning 2: Hård klippning. Över axeln bakifrån henne, den manliga huvudrollen kliver ut ur den mörka valvöppningen in i månljuset, rocken fångar ljuset, uttrycket kallt och nyfiket. 7Tagning 3: Tight närbild på hans ansikte, halvt upplyst av fönstret, sedan en matchande närbild på hennes när hon vägrar att titta bort. 8 9Ljud: låg ihållande basdron, avlägset stenecho, hennes ostadiga andetag, ett tungt steg när han kliver in i ljuset, en enda mjuk stråkstigning på den sista klippningen.
Inställningar: modell MiniMax H3 Reference-to-Video, Resolution 2K, Duration 8 (skjutreglagets standard; öka till 15 för det riktiga klippet), Aspect Ratio adaptive, och båda filerna i Reference Materials. Panelerna räknar dem som 2 av 9, så du har gott om utrymme för att lägga till garderobs- eller rekvisitabilder senare.
Värt att notera vad som hände med proportionen. Jag lät Aspect Ratio stå på adaptive och skrev bara "9:16 vertical" inuti prompten. H3 kom ändå tillbaka vertikalt, så den läste inramningen ur texten istället för att behöva formulärfältet.
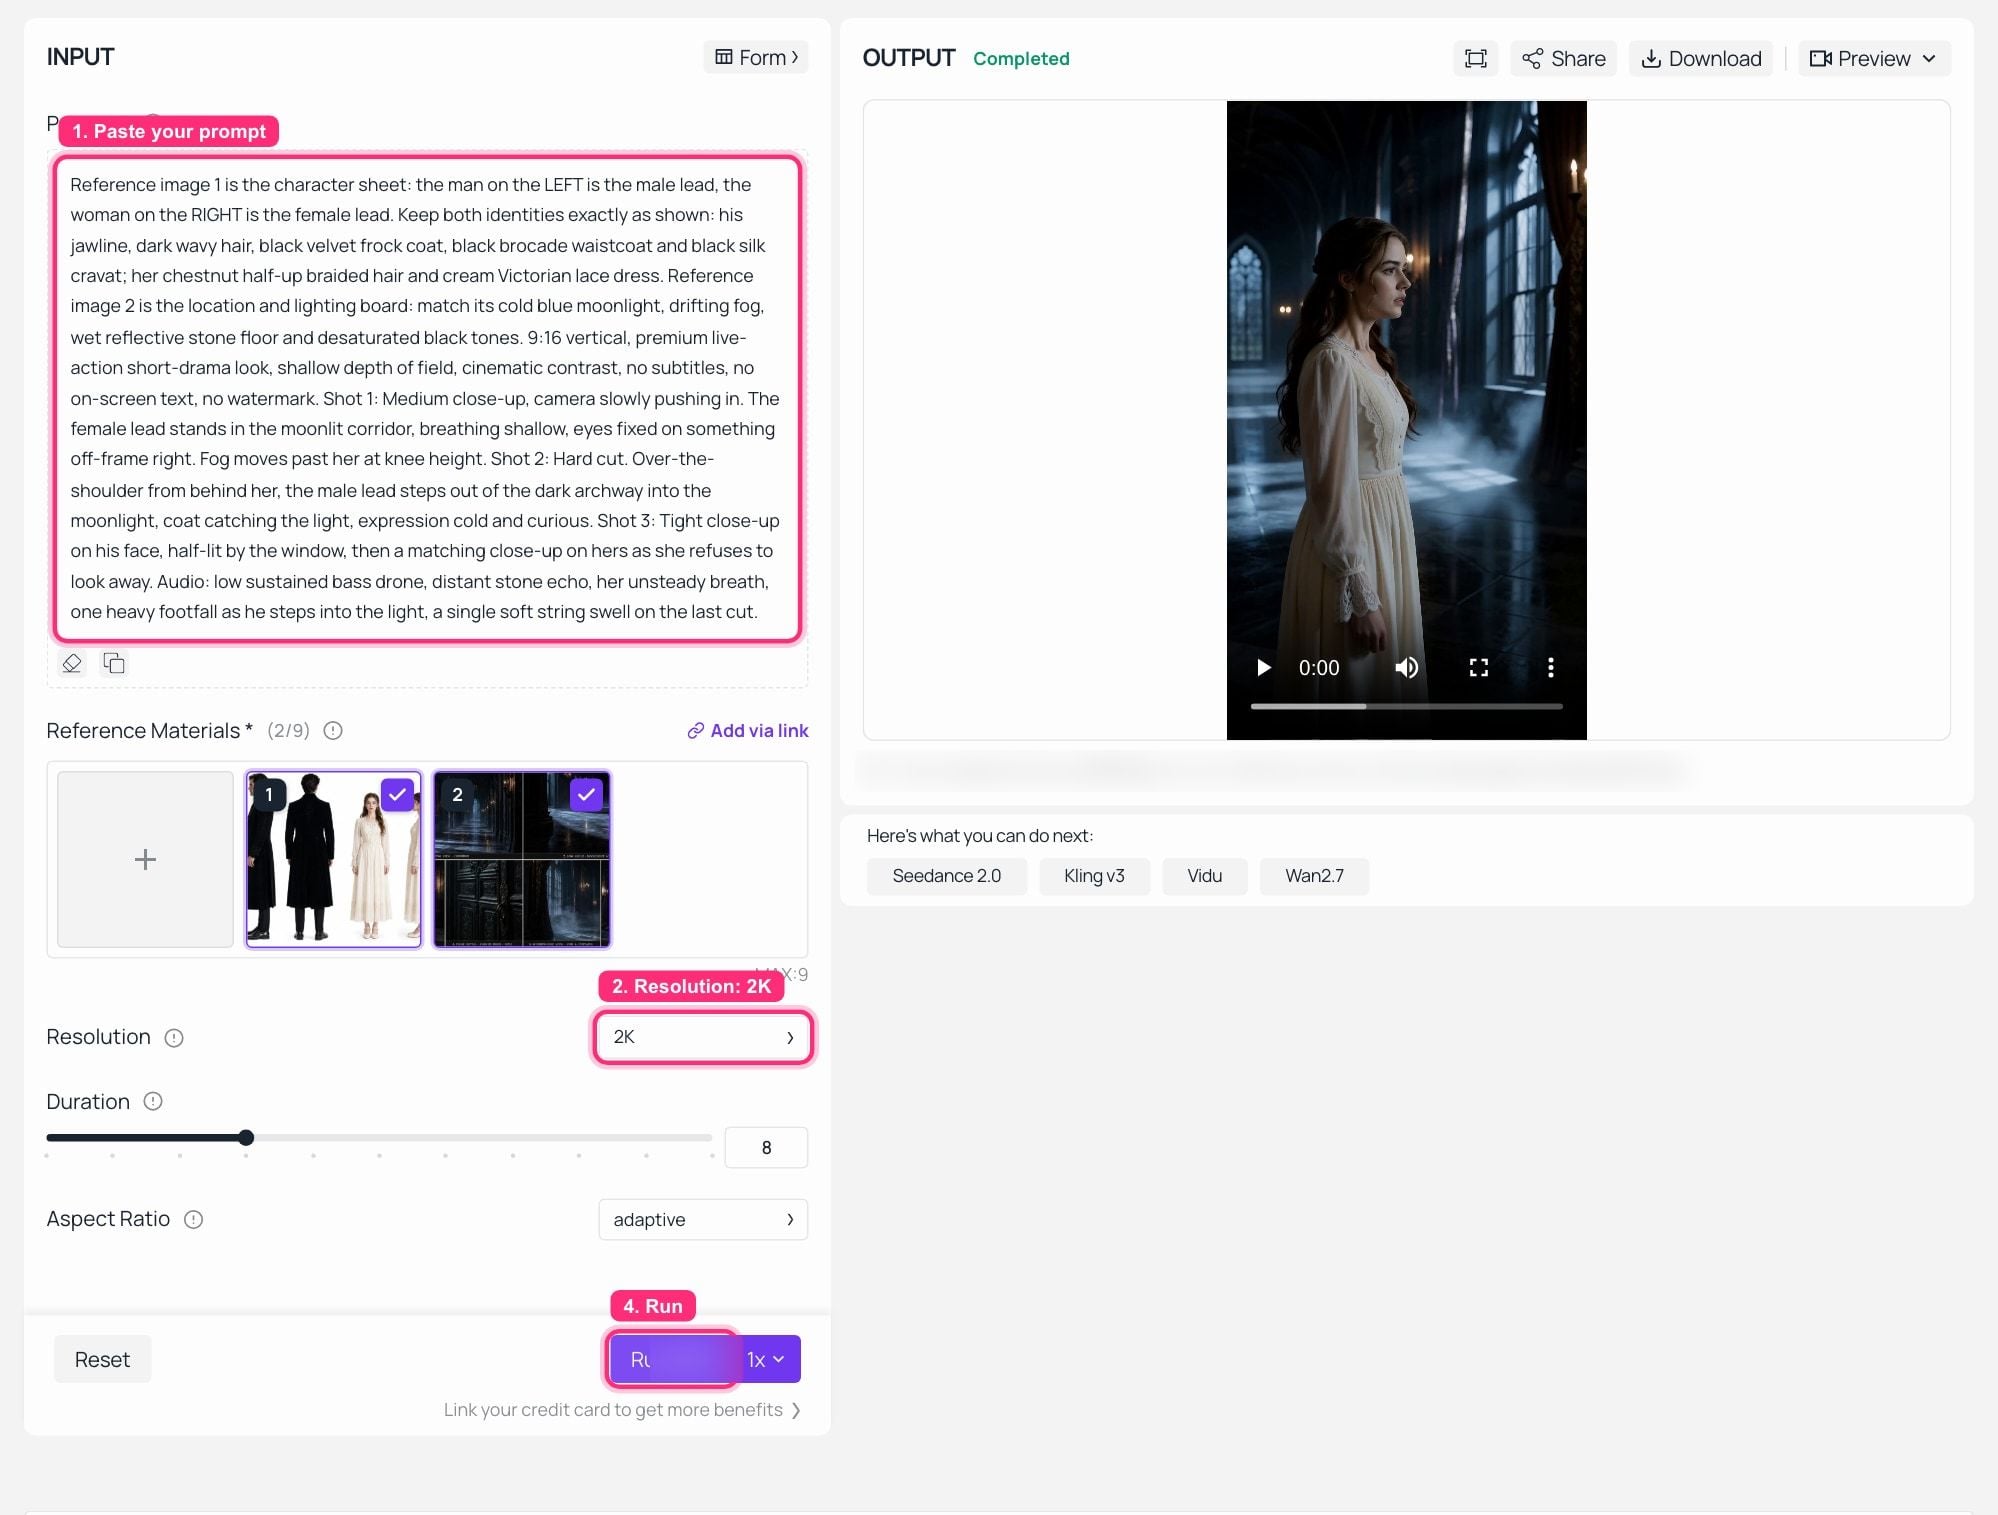 MiniMax H3 Reference-to-Video på Atlas Cloud, körning slutförd: båda referensfilerna laddade som 2 av 9, upplösning 2K, och det genererade vertikala klippet spelas i OUTPUT-panelen.
Den första bildrutan är den kvinnliga huvudrollen i den krämfärgade spetsklänningen, stående i korridoren från kartpanel 1, med dimma i knähöjd och månljuset som träffar det våta golvet precis där kartan placerade det. Båda referensbilderna landade.
Steg 4: Kör Seedance 2.5 vs MiniMax H3 kontrollen med identiskt paket
Ändra inte ett ord. Samma två referensbilder, samma prompt, annan modell. Jag lämnade varje sidas egen standardlängd ifred istället för att tvinga en matchning, och jag säger vad varje returnerade nedan. Att omformulera en prompt "för" den andra modellen är precis hur jämförelser börjar ljuga.
plaintext1Samma prompt som Steg 3, ordagrant. Omformulera den inte för den andra modellen.
Inställningar: modell Seedance 2.0 Reference-to-Video, Resolution 720p, samma två referensbilder i Reference Images (återigen 2 av 9, med separata platser för upp till 3 referensvideor och 3 referensljudfiler). Längd lämnad vid sidans standard, som kom tillbaka som ett 10-sekunders klipp.
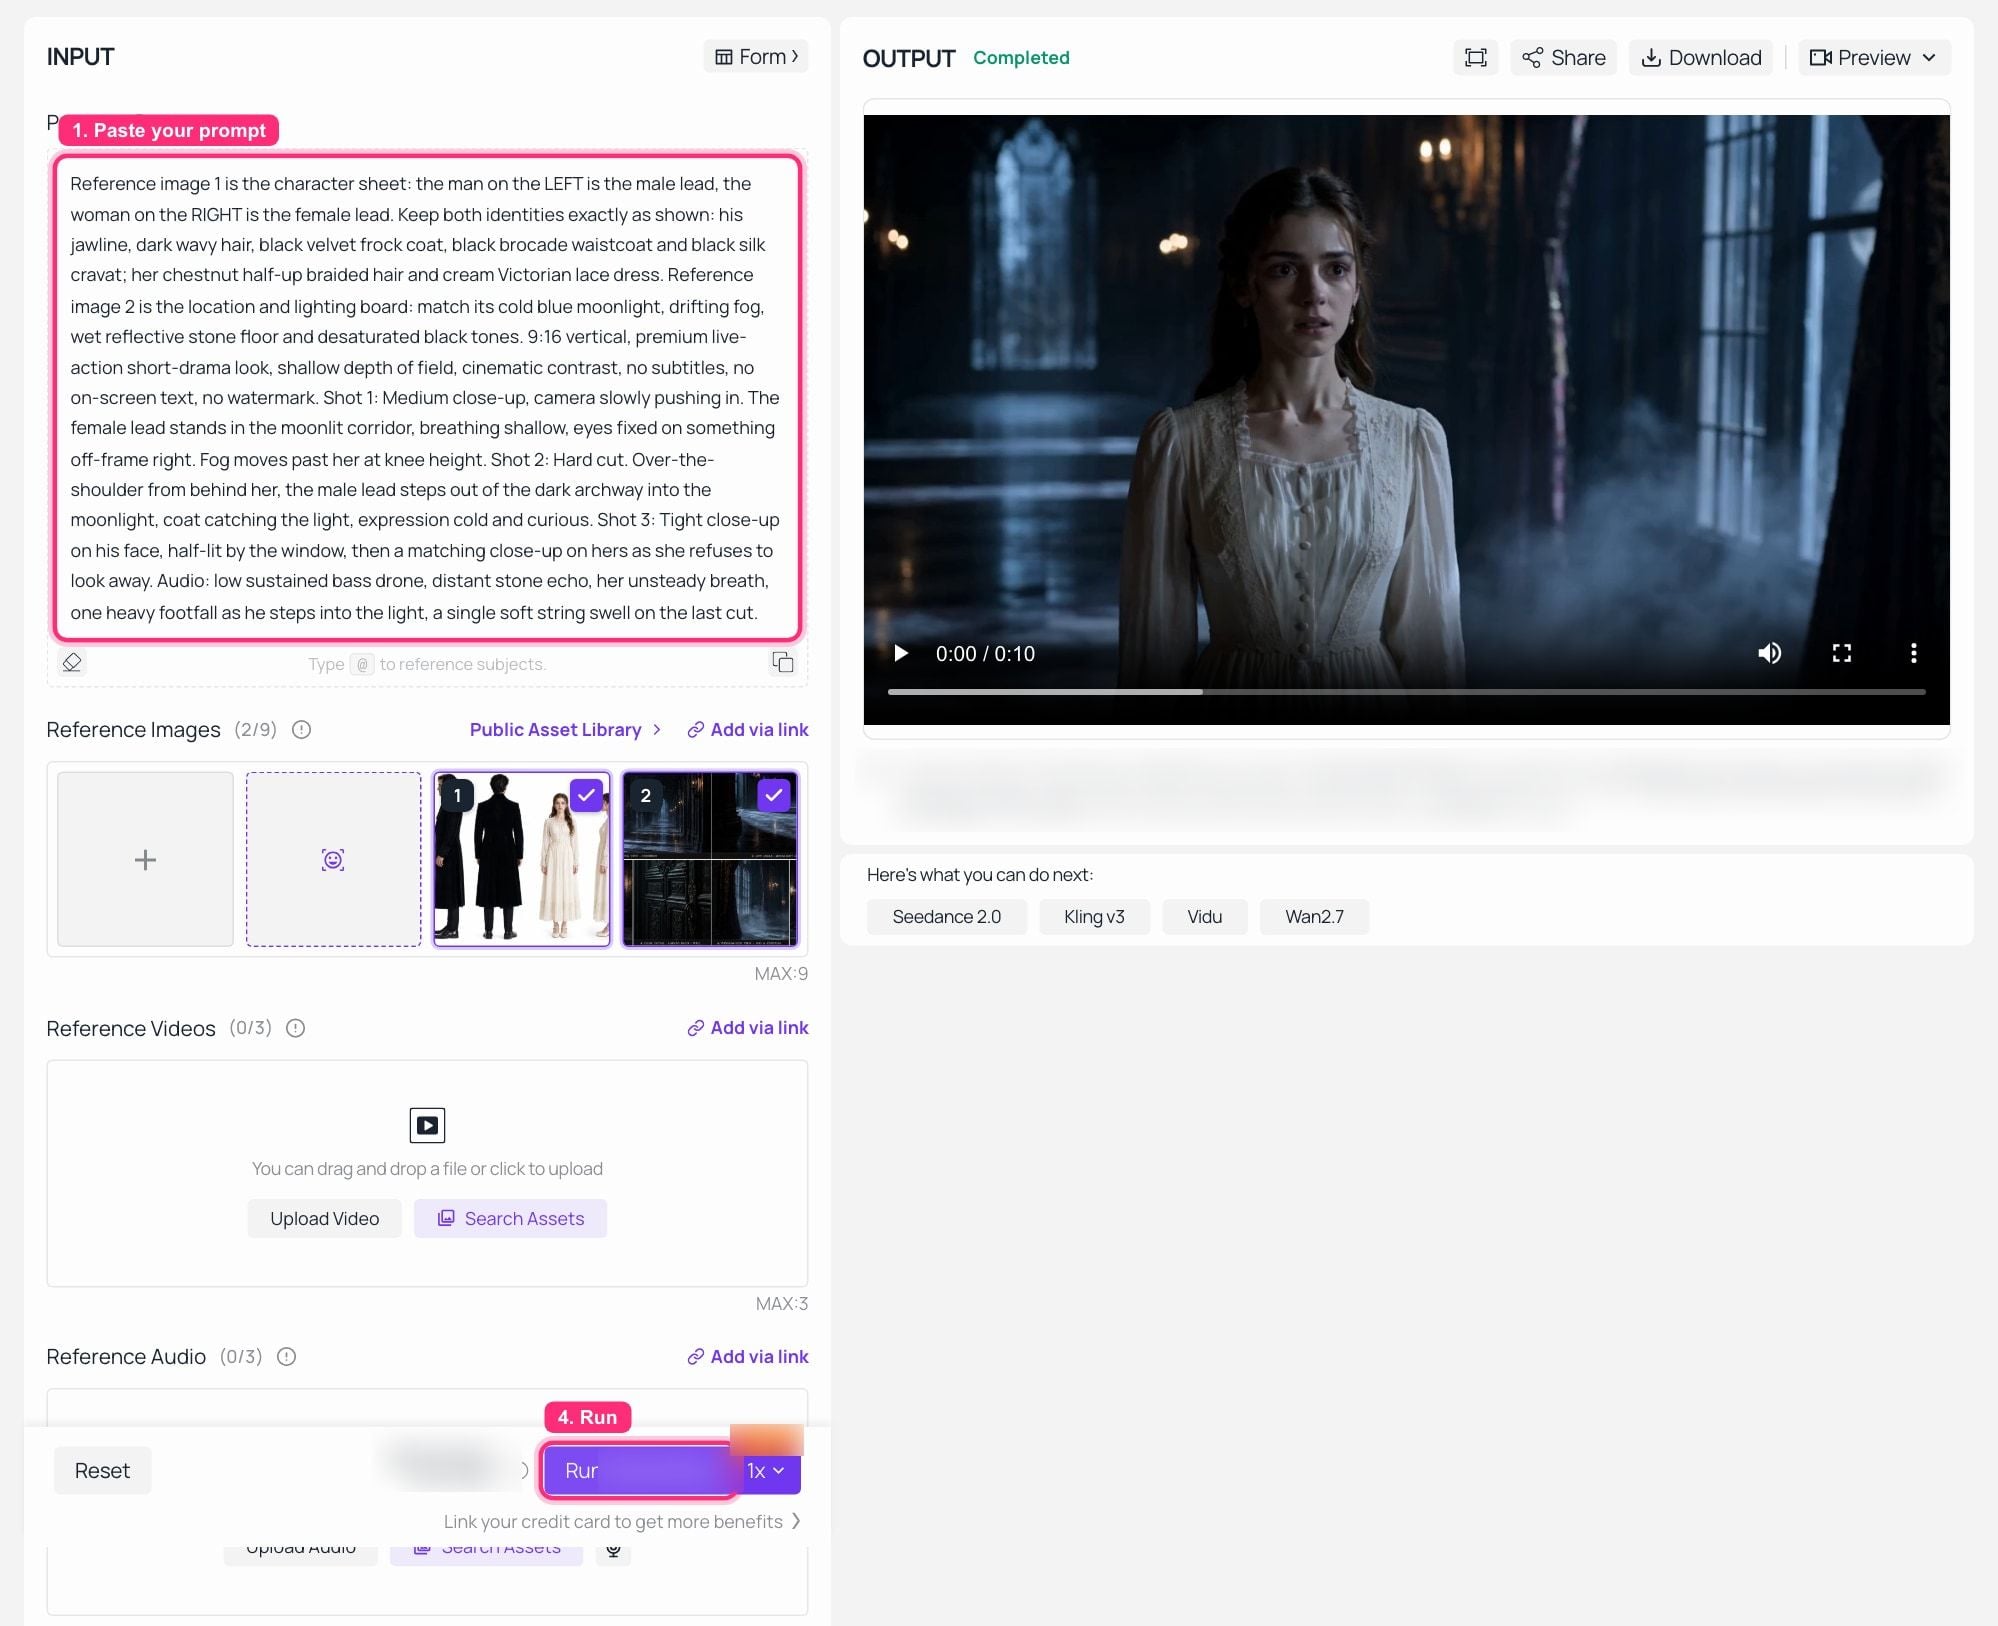 Seedance 2.0 Reference-to-Video på Atlas Cloud, körning slutförd med identiskt referenspaket och prompt från Steg 3, och ett 10-sekunders resultat i OUTPUT-panelen.
Här är vad de två OUTPUT-panelerna faktiskt visade, och jag rapporterar det rakt av snarare än att välja en vinnare.
Båda körningarna höll karaktären. Samma krämfärgade spetsklänning med samma halsringning och ärmslut, samma kastanjebruna hår, samma dimma-och-månljus-korridor hämtad från kartan. Ingen av dem uppfann en annan kvinna. Referenspaketet gjorde det arbetet på båda sidor, vilket är det fynd jag bryr mig mest om.
Skillnaderna handlade om formen, inte ansiktet. Denna Seedance-endpoint levererade 720p; H3 levererade 2K från identiska inmatningar. Och inramningen skilde sig: H3 läste "9:16 vertical" direkt ur prompttexten och returnerade vertikalt, medan Seedance-körningen kom tillbaka 16:9 eftersom den sidan bär sin egen proportionkontroll och prompttexten ensam inte åsidosatte den. Om du klipper för TikTok kommer den skillnaden att kosta dig en körning första gången du glömmer formulärfältet. Seedance 2.5 skulle sannolikt ändra upplösningshalvan av detta och lägga till regionnivå-omtagningar, och jag kommer inte att låtsas att jag mätte det.
Steg 5: Fixa en tagning utan att göra om hela klippet
Den verkliga kostnaden för ett kortdrama är inte generation ett. Det är revision sju. H3 accepterar ett befintligt klipp som inmatning och redigerar mot instruktioner, och håller det du inte nämnde. Seedance 2.5:s pitch här är finare: rita om en region av bildrutan och lämna prestanda, belysning och kamera ifred.
plaintext1Använd det medföljande klippet: behåll de två karaktärerna, deras kläder, kamerarörelserna och klippningsrytmen exakt som de är. Ändra endast miljön, ersätt den månljusa stenkorridoren med samma slotts balsal, höga välvda fönster, en upplyst ljuskrona, och varmt ljus från ljus. Ombelys båda karaktärerna så att deras nyckelljus kommer från ljuskronan till vänster i bild istället för från fönstret. Skriv om hennes enda talade replik till "Du sov aldrig, eller hur." Behåll hennes prestationstiming på samma beats.
Inställningar: MiniMax H3 Reference-to-Video med Steg 3-klippet som referensinmatning, Duration 5, Resolution 2K.
Bortom Seedance 2.5 vs MiniMax H3 Testet: Fyra Sätt att Driva Ett Referenspaket
Samma karaktär, nästa avsnitt. Spara Steg 1-arket som en tillgång och ändra endast taggningslistan och storyblocket i prompten. Identitet kommer från en fil, inte från ditt minne av hur du formulerade det förra tisdagen.
Lås rösten också. H3 tar upp till tre ljudreferenser, 2 till 15 sekunder var, och de måste åtfölja en bild- eller videoinmatning. Ge den ett röstprov och karaktären talar i den klangen, så du inte behöver ombesätta en röstskådespelare mellan avsnitt.
Blockera kameran innan du betalar för renderingen. Seedance 2.5:s reference-to-video accepterar 3D-vitmodell-blockouts och green-screen-plattor, så att du kan låsa inramning på grå geometri och först sedan förbinda dig till ett färdigt utseende. Detta exempel kördes på Seedance 2.1, en tidigare medlem av familjen, men arbetsflödets form är densamma.
Lokalisera en masterklippning istället för att spela in den på nytt. Regionnivå-ersättning byter ansikte, produkt eller talat språk medan kamera, timing och läpplängd förblir desamma. Här har en masterklippning ombesatts och röstlagts om för spanska, koreanska och hindi, med rummet, inramningen och läpplängden bibehållen.
Och eftersom någon kommer att fråga hur rörelseöverföring ser ut när du slutar vara vettig: tre män i kostymer, ersatta med tre fotorealistiska kapybaror, som följer originalklippets rörelsebana slag för slag tills de staplar sig till en pyramid.
Det finns också den enkla versionen av allt detta, den som ingen postar: en statisk affisch blir en rörlig affisch, och layouten överlever.
 Den statiska källaffischen. Mata den till reference-to-video med "behåll ramen, paletten och layouten, animera typen" så får du en rörlig version av samma design.
Vad En Seedance 2.5 vs MiniMax H3 Kortfilm Faktiskt Kostar Dig
Inga siffror här, för siffrorna rör sig och strukturen gör det inte. Båda familjerna debiterar per sekund, pay as you go, inget säte och ingen prenumeration. Det lämnar tre variabler: sekunder, upplösningsnivå och omtagningar.
Den tredje är hela räkningen. Ett 15-sekunders klipp som landar på första försöket är en avgift. Samma klipp på sjunde försöket är sju. Så pengarna sparas inte genom att välja den billigare per-sekund-modellen, det är att få referenspaketet rätt innan du genererar något. De två bildanropen i Steg 1 och Steg 2 är den billigaste raden i hela pipelinen och den som avgör hur många videoanrop du gör. Högst avkastning på investering i hela kedjan, med råge.
Rätta sedan per-sekund-instinkten. Samma referenspaket, samma körtid: H3:s reference-to-video ger tillbaka 1440p, denna Seedance reference-to-video-endpoint ger tillbaka 720p. Per sekund är fel enhet. Pixlar per bildruta, och om du sedan måste betala för en separat uppskalningspass, är rätt enhet.
Ljud hör hemma i aritmetiken också. Båda sidor producerar inbyggt synkroniserat ljud i samma pass. Om din nuvarande pipeline är videomodell plus TTS plus en redigerare som synkar spår, vad du sparar är två API-anrop och en persons eftermiddag, och den besparingen syns på ingen prislista någonstans.
Vilken för vilket jobb:
| Jobb | Välj | Varför | Varning |
|---|---|---|---|
| Vertikalt kortdrama, 9:16, TikTok eller ReelShort | MiniMax H3 | 1440p vertikalt med inbyggd stereo, anropsbart nu, 15 s är en full hook | du klipper vid 15 s, så planera beatsen därefter |
| En kontinuerlig 30-sekunders varumärkesfilm | Seedance 2.5 | en generation, ingen sömning, inbyggd 4K | kontrollera tillgänglighet på din plattform först |
| Fixa en tagning inuti en godkänd klippning | Seedance 2.5 | regionnivå-omritning lämnar resten ifred | H3 helaklippsredigering kommer dig större delen av vägen idag |
| Produkt- och e-handelsnedskärningar | endera | båda håller text på skärmen och varumärkesmärken bra | verifiera text vid den upplösning du levererar |
| Spel- eller gränssnittsdemonstrationer | MiniMax H3 | UI och typografistabilitet vid 2K är stark | 15 s tak för ett enda pass |
| Flerspråkiga versioner av en master | Seedance 2.5 | regionersättning plus flerspråkig röst | lokaliseringskvalitet behöver fortfarande en modersmålskontroll |
| Leverans ikväll | MiniMax H3 | tre endpoints live, plus hela Seedance 2.0 | Seedance 2.5-tillgång varierar per plattform |
Innan du levererar. MiniMax sa att H3:s vikter skulle följa inom dagar efter lansering, och öppna vikter är inte samma sak som en kommersiell licens, så läs villkoren innan du självhostar. Vattenstämpel och kommersiell användningspolicy skiljer sig också mellan konsumentappar och API-åtkomst på båda sidor, och jag kunde inte bekräfta någon av dem från en primär villkorssida medan jag skrev detta, så kontrollera leverantörens villkor snarare än att ta mitt ord för det. Och inget i någon modelllicens täcker likhet eller varumärke. Om en verklig person, ett verkligt varumärke eller någon annans IP finns i ditt referenspaket, är det en separat juridisk fråga och modellens villkor kommer inte att besvara den.
Varje modell i tabellerna ovan körs på samma nyckel, och modellsidorna bär aktuella priser plus kopiera-klistra-kod, inklusive eventuella kampanjer som råkar löpa på Seedance-linjen denna vecka.
Vanliga frågor
Är Seedance 2.5 bättre än MiniMax H3 för karaktärskonsistens?
På papper borde den vara det, med upp till 50 multimodala referenser mot H3:s 12 filer, plus regionnivå-omtagningar. Men per den 31 juli 2026 finns det inget parat offentligt test jag kan peka på, och Seedance 2.5 har ingen arenaranking än. I de körningar jag faktiskt kunde göra, var variabeln som avgjorde identitetsstabilitet referenspaketets struktur, inte modellgeneration: med ett sammansatt karaktärsblad plus en belysningskarta höll båda sidor karaktären. Få paketet rätt innan du lägger tid på att shoppa modeller.
Kan jag använda Seedance 2.5 just nu, eller måste jag vänta?
Dess API är live hos ByteDance. Tillgänglighet på tredjepartsmodellplattformar är ojämn, och på den jag testade är det fortfarande en dag-0-notis. Om du behöver utdata ikväll, är de anropsbara alternativen MiniMax H3:s tre endpoints och hela den levererande Seedance 2.0-linjen.
Gör MiniMax H3 verkligen 30-sekunders video?
Nej. Specifikationen är 5 till 15 sekunder per generation vid 24 fps. Allt längre är förlängning eller sömning, vilket är en annan sak med annan driftrisk. 30-sekunders enskild generation tillhör Seedance 2.5. Låt inte de två påståendena smälta samman.
Genererar båda modellerna ljud, och kan jag behålla en röst över avsnitt?
Båda producerar inbyggt synkroniserat ljud i samma pass, och H3 matar ut stereo på varje resultat. För en ihållande röst accepterar H3 upp till tre ljudreferenser på 2 till 15 sekunder var, som måste skickas in tillsammans med en bild- eller videoinmatning snarare än ensamma.
Hur många referensbilder bör jag faktiskt skicka?
Färre än du tror, bättre strukturerade än du tror. En välsammansatt komposit slår i allmänhet sex lösa beskärningar, eftersom separata filer uppmanar modellen att genomsnitta dem till en person som inte existerar. Ge den två tydliga jobb, identitet och belysning, och inkludera inte stilprover som slåss mot varandra.
Vilken modell ska jag använda för TikTok- eller ReelShort-stil vertikalt kortdrama?
Levererar denna vecka, i 9:16, i hög upplösning med ljud redan mixat: MiniMax H3. Planerar en 30-sekunders kontinuerlig scen där du förväntar dig att göra om enskilda regioner snarare än hela klipp: bygg för Seedance 2.5 och kontrollera när din plattform öppnar den.


