Produktionsagenter och agentiska pipelines kraschar ofta på grund av oväntade schemaöverträdelser. Även toppmoderna autoregressiva LLM:er misslyckas med JSON-tolkning vid högvolymsanrop av verktyg, vilket tvingar utvecklare att bygga komplexa återförsöksloopar och anpassade felhanterare.
TypeSafe Jev löser detta strukturella problem genom att helt överge sekventiell generering token för token. Jev fungerar som en icke-autoregressiv beslutsmodell, tar in applikationstillstånd och utvärderar fördefinierade schemafrågor i en enda parallell framåtpassning. Eftersom möjliga utdataalternativ är strikt begränsade före körning eliminerar Jev matematiskt felaktig JSON, ogiltiga verktygsnamn och text utanför schemat.
Snabba insikter: Vad är TypeSafe Jev AI? Prestanda- och hastighetsriktmärken
TypeSafe Jev AI är en icke-autoregressiv beslutsmodell byggd specifikt för klassificering under en sekund, avsiktsbedömning och strukturerad mikrotjänstroutning. Till skillnad från autoregressiva LLM:er utvärderar Jev fördefinierade schemaval i en enda framåtpassning.
- Noll hallucination på typnivå: Ersätter strängavkodningsloopar med begränsade schema-primitiver, vilket ger 0 % typpfelsfrekvens.
- Körning under 500 ms: Icke-autoregressiv parallell sampling uppnår 70 ms–500 ms P95-latens, upp till 200x snabbare än vanliga LLM:er.
- Gratis utdatatokens: Noll genererade sekventiella tokens innebär att utdatatokens är helt gratis $0,042/1M indatatokens.
- Bäst för: Mikrotjänstroutning, agentisk verktygsdirigering, ärendehantering och avsiktsgrindning.
Att tänka om AI-stacken: System 1-intuition kontra System 2-resonemang
När man utvecklar skalbar backend-programvara skapar tvingade enkla villkorskontroller genom en tung chattavslutningsändpunkt allvarlig systemlatens. De flesta mikrotjänster kräver inte kreativ prosa eller flerstegsresonemang; de kräver omedelbart, deterministiskt val bland kända alternativ.
Att tillämpa Kahnemans kognitiva ramverk på mjukvaruarkitektur
TypeSafe-medgrundaren Diogo Almeida, som tidigare var med och skapade Reinforcement Learning from Human Feedback på OpenAI, introducerade en strukturell pivot med TypeSafe Jev för att lösa denna ineffektivitet. Med direkt inspiration från Kahnemans kognitiva ramverk delar plattformen upp bearbetningen i två distinkta operativa lager inom modern AI-stackarkitektur:
- System 2 Långsamt, överlagt resonemang: Standard autoregressiva LLM:er som arbetar via sekventiell generering token för token. Dessa modeller är utmärkta på att skriva långa dokument, hantera tvetydigt resonemang och skriva komplex kod.
- System 1 Snabba, intuitiva beslut: En dedikerad System One AI-modell tränad via Reinforcement Learning for Calibrated Decisions snarare än traditionell RLHF. Den är utformad specifikt för klassificering under en sekund, avsiktsbedömning och körningsroutning utan konversationsoverhead.
Jev kontra LLM: Kostnad och arkitektur: Beslutsmodeller kontra chattmodeller
Att ersätta allmänna chattmodeller med specialiserade typade beslutsmodeller optimerar i grunden mikrotjänstarbetsflöden genom att isolera snabb utvärdering från djup generering.
| Arkitektonisk dimension | Autoregressiva LLM:er (System 2) | TypeSafe Jev (System 1) |
| Primär uppgift | Öppen textsyntes | Diskret val och schemautvärdering |
| Körningslatens | 3 000 ms till 30 000 ms+ | 70 ms till 500 ms |
| Utdataformat | Ostrukturerad textström | Strikt typade schema-primitiver |
| Beräkningsloop | Sekventiell tokenavkodning | Enkel framåtpassningsutvärdering |
| Träningsmål | Mänsklig preferens (RLHF) | Kalibrerad beslutsäkerhet (RLCD) |
Att avlasta routning, säkerhetsräcken och funktionsdirigering från vanliga chattmodeller löser de prestandaflaskhalsar som är inneboende i autoregressiva LLM:er. Att införliva en System One AI-modell säkerställer att tunga resonemangsmotorer bara utlöses när öppen generering verkligen krävs.
Hur TypeSafe Jev-modellen levererar noll hallucination på typnivå
Även med strikt JSON-läge aktiverat returnerar ledande LLM:er regelbundet nycklar utanför schemat eller hallucinerade enumvärden under produktionskörningar med hög samtidighet, vilket gör att 0,5 % till 5 % av pipeline-förfrågningarna misslyckas. Produktionsmikrotjänster kräver absolut typdeterminism, men autoregressiva modeller är fortfarande i sig sårbara för stränggenereringsfel.
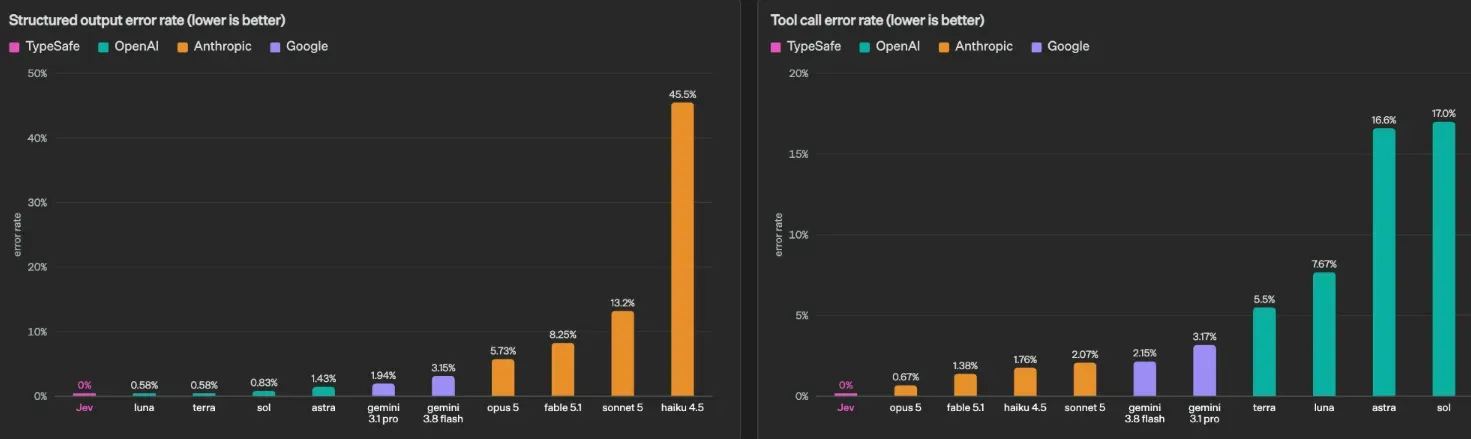
TypeSafe Jev löser detta genom att ersätta strängavkodningsloopar med en begränsad tillståndsarkitektur. Istället för att generera godtycklig text och försöka tvinga in den i JSON-syntax, utvärderar Jev indata mot fördefinierade schemabegränsningar i en enda passning. Denna strukturella förändring levererar äkta noll-hallucination AI på typnivå, vilket resulterar i 0 % typpfel över automatiserade arbetsflöden.
De tre centrala schema-primitiverna
Jev behandlar alla indatafrågor genom tre explicita primitiver:
- Choice-primitiv: Väljer exakt ett alternativ från en fördefinierad lista med upp till 255 kategoriska val, och returnerar den vinnande etiketten tillsammans med fullständiga sannolikhetsfördelningar.
- Score-primitiv: Utvärderar indata mot en ordnad numerisk skala eller beskrivande bedömningsmall och ger betyg tillsammans med sannolikhetsspridning över varje nivå.
- Noul-primitiv: Beräknar den exakta sannolikheten för ett ja- eller nej-villkor som ett flyttal mellan 0,0 och 1,0, vilket eliminerar mellanliggande textmotiveringar.
Eftersom varje fråga strikt mappas till dessa tre primitiver kan körningsmotorn inte sända ut ogiltiga nycklar, verktygsnamn utanför listan eller felaktiga nyttolaster.
Typsäkerhet vid utvärdering av strukturerad utdata
Traditionella chattmodeller genererar syntax tecken för tecken, vilket skapar ständiga tolkningsrisker i backend-pipelines.
| Utvärderingsmått | Autoregressivt JSON-läge | TypeSafe Jev System One |
| Tvingande av utdatatyp | Strängvalidering efter generering | Inbyggda matematiskt begränsade primitiver |
| Frekvens av typpfel | Variabel (0,5 % till 5 %+ felfrekvens) | 0 % typpfel (schemabegränsat) |
| Risk för ogiltig enum | Hög utan anpassade återförsöksloopar | Noll (omöjligt genom design) |
Att begränsa modellkörning strikt till ett bundet tillstånd garanterar tillförlitlig utvärdering av strukturerad utdata. Applikationer konsumerar Jev-utdata direkt utan att skriva undantagshanterare för trasiga JSON-scheman.
Notering om typdeterminism kontra sannolikhet: TypeSafe Jev garanterar 0 % typpfel och schemamatchning genom design, vilket matematiskt eliminerar felaktig syntax, saknade nycklar och enumvärden utanför listan. Men liksom alla beslutsmodeller förblir dess utdataval probabilistiska. Vid inneboende tvetydiga indata bör konfidenspoäng användas för att grinda körning snarare än att anta absolut semantisk säkerhet.
Hur icke-autoregressiv parallell sampling driver latens under 500 ms och gratis utdata
Att använda vanliga chattändpunkter för enkla klassificeringstaggar som {"category": "billing"} introducerar onödig latens i produktionsmikrotjänster. Eftersom autoregressiva modeller förlitar sig på sekventiell tokenavkodning förblir backend-trådar blockerade medan de väntar på genereringsloopar för enskilda tecken.
Mekaniken bakom utvärdering i en enda passning
Traditionella transformers kör autoregressiva genereringsloopar där varje ny token kräver en separat passning genom nätverksstacken. Detta sekventiella beroende skapar hög latens och blåser upp infrastrukturkostnaderna baserat på genererad tokenvolym.
TypeSafe Jev eliminerar sekventiell generering genom att använda icke-autoregressiv parallell sampling. Som beskrivs i TypeSafe:s lanseringsmeddelande tar Jev in kontexttillståndet och utvärderar alla fördefinierade schemaval samtidigt inom en enda framåtpassning.
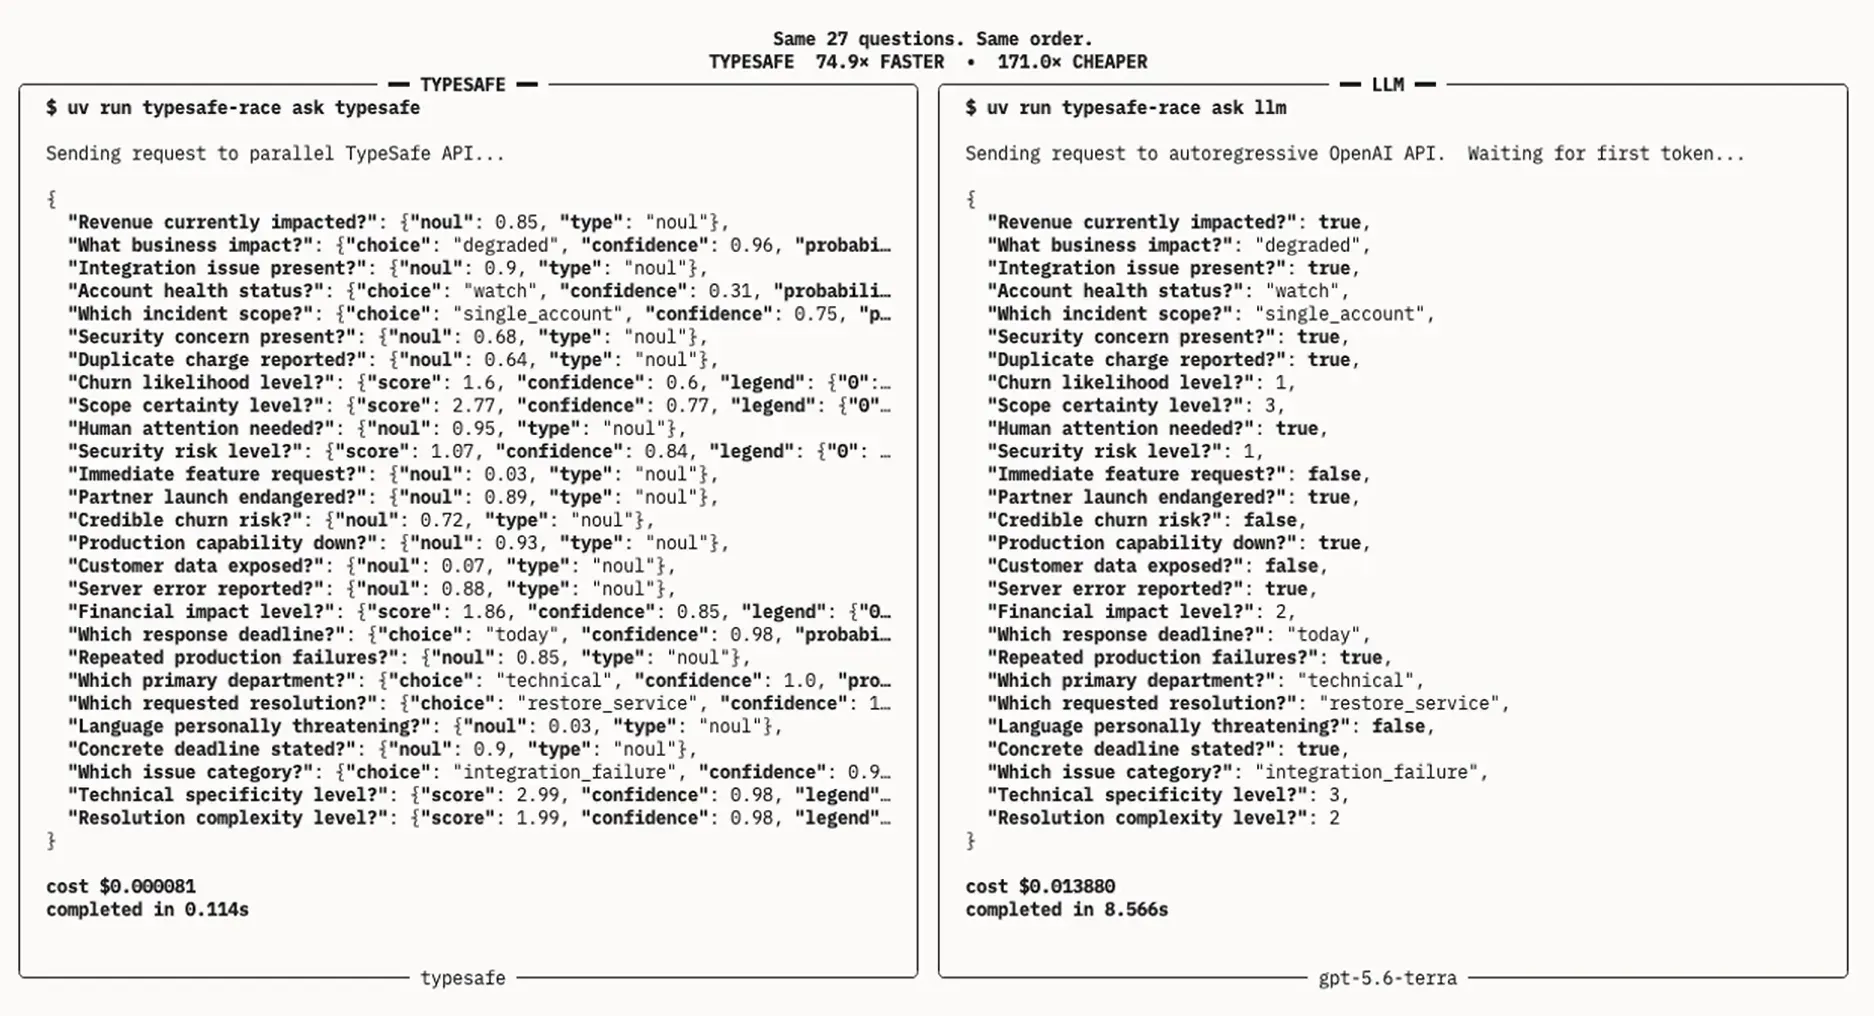
Terminalriktmärkesjämförelse som kör 27 samtidiga schemautvärderingsfrågor på TypeSafe Jev kontra GPT 5.6 Terra-ändpunkt
Eftersom modellen beräknar sannolikhetsfördelningar över fördefinierade utdata istället för att generera fri text, försvinner utdataavkodningsloopar helt. Denna strukturella förändring ger tre primära prestandavinster:
- Gratis utdatatokens (för billiga att mäta): Eftersom Jev utvärderar val i en enda framåtpassning utan att generera sekventiella tokens, medför utdatautvärdering i praktiken noll inkrementell beräkning, vilket gör utdatatokens i praktiken gratis.
- Förutsägbar prissättning: Kontextbearbetning kostar en fast avgift på $0,042 per miljon indatatokens. Att utvärdera statiska prompt-scheman med Jev förhindrar exponentiell uppblåsning av API-räkningar jämfört med traditionell overhead för lång kontextkörning förknippad med tunga chattändpunkter.
- Körning under en sekund: Publicerade latensriktmärken för TypeSafe Jev visar P95-svarstider konsekvent mellan 70 ms och 500 ms, vilket är upp till 200 gånger snabbare än ledande chattmodeller.
Arkitektonisk prestandauppdelning
| Mått / dimension | Traditionella autoregressiva LLM:er (System 2) | TypeSafe Jev System One-motor |
| Körningsloop | Sekventiell avkodning token för token | Enkel parallell passning över fördefinierat schema |
| Utdatatyp | Ostrukturerade textsträngar / JSON-strängar | Typade beslutsprimitiver (Choice, Score, Noul) |
| Schemafelfrekvens | 0,58 % till 45 %+ beroende på modell/prompt | 0 % typpfelsfrekvens (matematiskt begränsad) |
| P95-latensprofil | 3 000 ms till 30 000 ms+ | 70 ms till 500 ms |
| Utdataekonomi | Variabel per token ($15 till $60 / MTok) | GRATIS (för billiga att mäta) Ingen sekventiell generering av utdatatokens |
| Primär domän | Resonemang, utkastskrivning, öppen syntes | Klassificering, verktygsval, konfidensgrindning |
Att kringgå flaskhalsen för minnesbandbredd
Vid vanlig LLM-inferens mättas minnesbandbredden när modellvikter laddas om till minneslogik för varje enskild token. Genom att slutföra beslutsutvärderingar i en enda framåtpassning kringgår Jev denna minnesflaskhals helt och upprätthåller stabila svarstider även under tung samtidig trafik.
Reinforcement Learning for Calibrated Decisions och konfidensgrindar
Standardchattmodeller ger regelbundet felaktiga påståenden med 99 % självrapporterad säkerhet eftersom konventionell finjustering belönar övertygande formuleringar snarare än statistisk sanning. I produktionsmikrotjänster leder ett överdrivet säkert felaktigt beslut direkt till korrupta databasposter, trasiga verktygsargument och oväntad systemavbrottstid.
Att anpassa modellens säkerhet till empirisk noggrannhet
För att lösa denna strukturella översäkerhet introducerade TypeSafe Reinforcement Learning for Calibrated Decisions. Till skillnad från traditionell RLHF-metodik som optimerar för subjektiv mänsklig preferens, tränar RLCD beslutsmodeller specifikt för att producera kalibrerade sannolikheter.
Genom noggrannhetsanpassad säkerhet innebär en 0,90-sannolikhetsutdata från Jev att det valda alternativet är empiriskt korrekt 90 % av tiden över testuppsättningar. Denna matematiska kalibrering möjliggör pålitligt probabilistiskt beslutsfattande utan att utvecklare behöver skriva komplexa promptheuristiker för att uppskatta utdatasäkerhet.
Att implementera konfidensgrindad routning i produktion
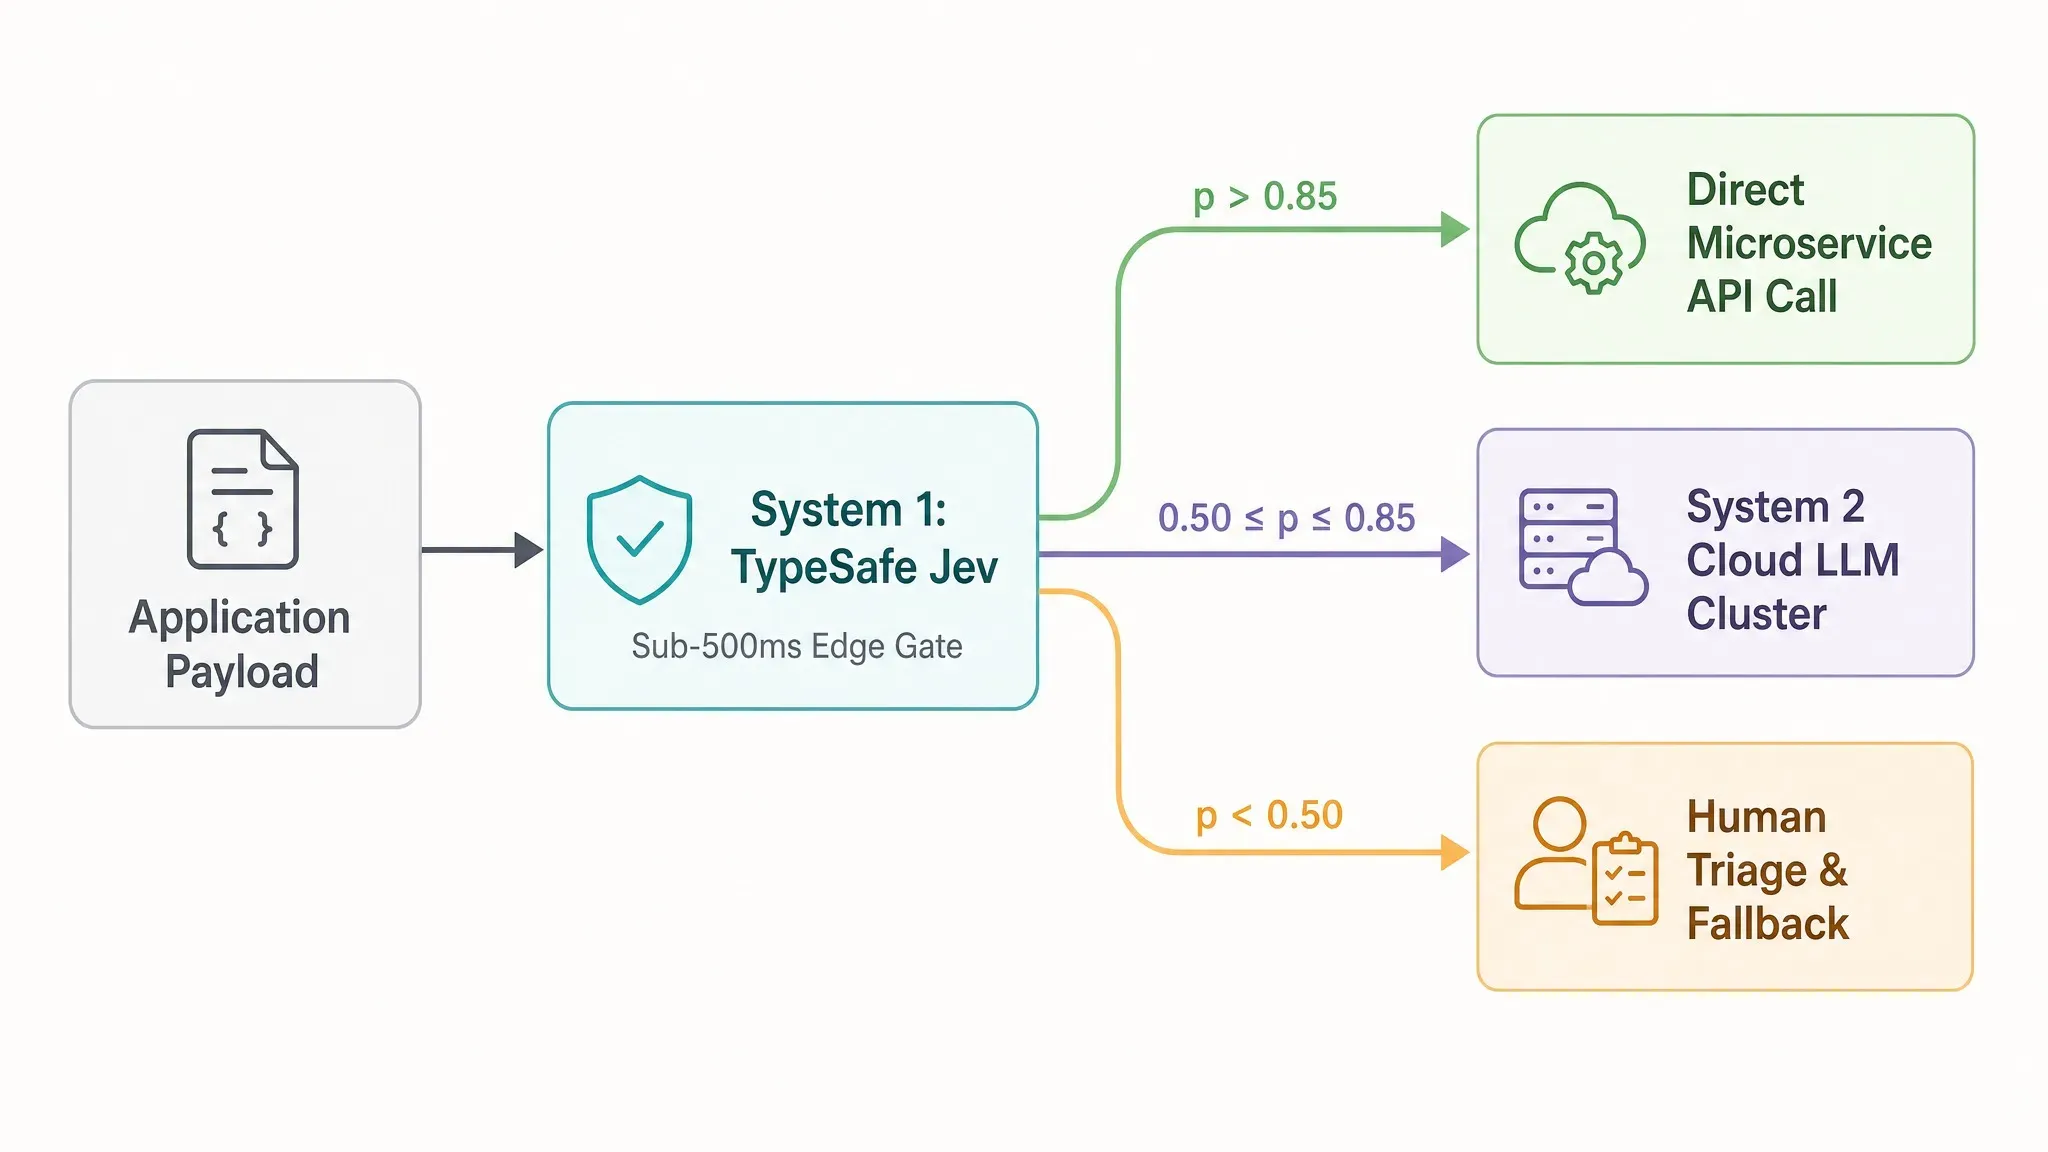
Ingenjörer kan utnyttja dessa kalibrerade sannolikhetsfördelningar för att konfigurera tröskelbaserade beslutsgrindar, t.ex. i en typisk produktionskonfiguration:
p > 0.85(Snabbvägskörning): Kör omedelbart i höghastighetsvägen och kringgå långsamma LLM-ändpunkter helt.0.50 ≤ p ≤ 0.85(System 2-eskalering): Skicka gränsfall till en resonemangs-LLM för att hantera tvetydiga kantfall.p < 0.50(Reservhantering): Utlös säkerhetsstandarder eller skicka förfrågan till en kö för mänsklig granskning.
För gränsfall där 0,50 ≤ p ≤ 0,85 omdirigerar konfidensgrindad routning nyttolasten till en företagsresonemangsnivå. Att använda GPT 5.6 Terra på Atlas Cloud erbjuder ett optimalt reservmål för dessa eskalerade förfrågningar och utnyttjar dess 1 050K-kontextfönster och kostnadseffektiva tokenprissättning på $2/$12 för att utföra djupanalys utan att blåsa upp mikrotjänstens infrastrukturkostnader.
Råloggsannolikheter från autoregressiva LLM:er är notoriskt okalibrerade och förskjuts när systemprompter ändras. Genom att integrera RLCD direkt i kärnträningsprocessen gör Jev konfidensgrindad routning produktionsklar, vilket gör att mjukvaruteam säkert kan automatisera högvolymspipelines samtidigt som kantfall isoleras.
Designmönster för produktion: Höghastighets-AI-pipelines i praktiken
Produktions-AI-agenter kraschar ofta när en LLM hittar på en obefintlig funktionssignatur som get_user_billing_v2() eller skickar ogiltiga parametertyper till en intern API-ändpunkt. Att kedja flera villkorskontroller genom vanliga chattavslutningsändpunkter förstärker den totala systemlatensen, vilket gör att kundvända mikrotjänster får timeout.
Centrala arkitekturmönster för högvolymsmikrotjänster
Att integrera beslutsmodeller under en sekund i produktions-AI-pipelines gör att mjukvaruteam kan ersätta oförutsägbara promptloopar med deterministiska backend-designmönster:
- Agentiskt verktygsval: När verktyg väljs inuti automatiserade agentarbetsflöden utvärderar Jev tillgängliga funktionssignaturer mot det aktuella applikationstillståndet. Eftersom kandidatfunktioner skickas som explicita val i förfrågans schema kan Jev inte returnera odefinierade funktionsnamn, vilket eliminerar tysta körtidsfel under agentiskt verktygsval. Denna snabba förfiltrering garanterar giltiga schemanyttolaster innan instruktioner skickas vidare till autonoma LLM-kodningsagentpipelines.
- Parallell utvärdering av flera frågor: Vanliga chattändpunkter tvingar applikationer att utvärdera villkorsfrågor sekventiellt, vilket multiplicerar den totala latensen med antalet utförda kontroller. Jev möjliggör parallell utvärdering av flera frågor genom att utvärdera dussintals schemafrågor över en enda tillståndsnyttolast i en parallell framåtpassning. Att köra femton diskreta klassificeringskontroller tar samma 100 ms-fönster som att köra en.
- Automatisering av ärendehantering: För högvolymsmikrotjänster som bearbetar inkommande kundärenden analyserar Jev kundsinnesstämning, dirigerar teknisk prioritet och kontrollerar återbetalningsberättigande samtidigt. Att implementera automatisering av ärendehantering med svarstider under en sekund förhindrar köstockningar vid plötsliga trafiktoppar.
Att implementera System One-beslutsnoder via SDK
Utvecklare instansierar låglatensbeslutsnoder genom att integrera det officiella typesafe-sdk i befintliga mikrotjänster. Körningsnyttolasten skickar applikationstillståndet tillsammans med fördefinierade schema-primitiver direkt till ändpunkten https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Traditionella uppsättningar för verktygsanrop re-tokeniserar hela promptkontexten för varje enskild funktionsutvärdering. Genom att frikoppla tillståndsrepresentation från beslutsfrågor kör Jev flergrenade klassificeringspipelines i backendsystem utan att multiplicera kontexttokenoverhead, blåsa upp API-räkningar eller offra P95-latensgarantier.
Kända begränsningar och arkitektoniska avvägningar för TypeSafe Jev (vad Jev inte kan göra)
Att distribuera en icke-autoregressiv beslutsmodell med förväntan att den ska skriva ett artigt e-postsvar eller summera radposter på en faktura bryter oundvikligen produktionskod. Ingenjörsteam som försöker ersätta allmänna LLM:er helt med System One-modeller stöter snabbt på fysiska arkitektur gränser.
Strukturell gränsanalys
Att förstå specifika Jev-felfallslägen är avgörande innan man kopplar in Jev i mikrotjänstarbetsflöden. Jevs design med en enda framåtpassning upprätthåller strikta gränser över flera kärnuppgifter:
- Öppen textgenerering: Jev producerar noll konversationstext. Den kan inte skriva uppsatser, sammanfatta dokument eller generera naturliga språkförklaringar för sina val.
- Begränsningar för flerstegsresonemang: Arkitekturen utvärderar omedelbara tillståndsrepresentationer. Komplexa, sekventiella logikkedjor eller flerstegsresonemang kräver att uppgifter delegeras tillbaka till traditionella autoregressiva LLM:er.
- Aritmetiska begränsningar: Jev kan inte utföra matematiska beräkningar eller tillförlitligt räkna objekt i en kontextsträng. Aritmetiska begränsningar kräver att finansiella beräkningar och arrayoperationer hålls kvar i standardbackend-kod.
- Litterär kriterietolkning: Modellen följer promptregler bokstavligt utan att sluta sig till outtalad affärslogik. Tvetydiga schemalternativ leder till oväntade sannolikhetsspridningar.
- Kontextförfall under tunga nyttolaster: Att skicka massiva, ostrukturerade loggar skapar kontextförfall som försämrar utvärderingsnoggrannheten. Att filtrera bort brus från indata-tillståndsnyttolaster innan förfrågningar skickas förblir avgörande.
Arkitektonisk kartläggning: System One kontra System Two-förmågor
| Operativ uppgift | TypeSafe Jev System One | Autoregressiv LLM System Two |
| Kategorisk klassificering | Inbyggd (under 500 ms) | Långsam (sekventiell text) |
| Textsyntes och utkast | Omöjlig (ingen avkodningsloop) | Inbyggd (öppen textgenerering) |
| Matematisk beräkning | Stöds inte (aritmetiska begränsningar) | Variabel (kräver kodkörning) |
| Brusmotstånd | Benägen till kontextförfall i stora tillstånd | Högre motståndskraft i kontextfönster |
Att behandla Jev som en beslutsnod under en sekund snarare än en universell resonemangsmotor säkerställer korrekt systemdesign över produktionsmikrotjänster.
Framtida molninfrastruktur: Orkestrering av snabba beslutsnoder
Att dirigera varje inkommande användarförfrågan direkt till en resonemangsmodell med 70 miljarder parametrar bränner tusentals dollar i slösade GPU-cykler samtidigt som användare tvingas vänta flera sekunder på grundläggande säkerhetskontroller och nyttolastroutning. Moderna mikrotjänststackar har inte råd att behandla varje inkommande HTTP-nyttolast som ett öppet resonemangsproblem.
Skiftet mot hybrid AI-arkitektur
Molnmiljöer rör sig bort från monolitiska LLM-ändpunkter mot en frikopplad hybrid AI-arkitektur. I detta framväxande paradigm placerar molnorkestratorer snabba beslutsnoder vid nätverkskanten för att utvärdera inkommande nyttolaster omedelbart.
Genom att hantera edge AI-routning, schemaverifiering och konfidensbedömning inom körningsfönster under 500 ms filtrerar snabba beslutsnoder trafik innan den når tyngre modellkluster. Denna topologi optimerar resursallokering över tre distinkta operativa molnlager:
- Edge-skyddsräcken och routning: Snabba beslutsnoder utvärderar användaravsikt, sanerar indata och verifierar schemaefterlevnad i en enda framåtpassning.
- Tillståndsöverlämning och orkestrering: Molnorkestratorer analyserar konfidenspoäng, kör förfrågningar med hög säkerhet omedelbart och vidarebefordrar komplexa resonemangsuppgifter.
- Centraliserat System 2-resonemang: Tunga LLM-kluster tar endast emot förfiltrerade, strukturerade nyttolaster när flertursyntes eller öppen generering är strikt nödvändig.
Att distribuera System One-modeller i skala
När molnplattformar utökar sina hostingkapaciteter ger införlivandet av en TypeSafe Jev-distribution i AI-infrastrukturen ett effektivt mönster för edge-mikrotjänster. Att köra icke-autoregressiva beslutsmodeller nära slutanvändare minskar dramatiskt tur-och-retur-tider och sänker beräkningskostnaderna för applikationer med hög genomströmning.
Att bygga pipelines med dedikerade besluteslager säkerställer att backend-nätverk förblir responsiva under tung belastning samtidigt som ledande resonemangsmodeller hålls fokuserade uteslutande på uppgifter som kräver djup beräkning.


