Senaste uppdatering: Wan 3.0 är nu live sedan 24 augusti 2026.
Du skapade en mapp för en 15-sekundersreklam. Två karaktärsbilder. En varumärkesvideo som kunden skickade. En varumärkesbok som bara finns som PDF. Ett röstprov från skådespelaren du faktiskt vill ha.
Sedan öppnade du din videomodell och den bad om en enda bild.
Så du gjorde vad alla gör. Du översatte mappen till en prompt på 800 ord och bad. Ansiktet förändrades i bild tre. Jackan bytte färg. Rösten var någon helt annan.
Wan 3.0:s omni-reference är första gången en videomodell säger: okej, ge mig mappen. Upp till 20 tillgångar i ett enda anrop, över fem typer av indata, sammanhållna i en enda kontinuerlig 30-sekunderstagning.
Den här artikeln gör tre saker och hoppar över resten. Den bryter ner vad de 20 tillgångarna faktiskt är, den använder Alibabas egna genererade klipp som bevis, och den ger dig ett motsvarande arbetsflöde du kan köra idag, eftersom Wan 3.0 fortfarande är i offentlig beta på Alibabas eget moln och ännu inte kan anropas från tredjepartsplattformar.
Viktiga slutsatser
- Wan 3.0:s multimodala referens accepterar upp till 20 tillgångar i ett anrop, inklusive bilder, videor, ljud, dokument och live-webbsidor, och håller dem konsekventa under en enda 30-sekunderstagning.
- Det är den första mainstream-videomodellen som behandlar en PDF, en presentation eller en URL som en kreativ indata snarare än något du parafraserar till en prompt.
- Wan 3.0 gick in i offentlig beta den 6 augusti 2026 på Alibaba Cloud Model Studio och Qwen Cloud som
wan3.0-video. Det är stängda vikter. Alla som säger att det redan är Apache 2.0 gissar. - Rubriken om 20 tillgångar är inte där den faktiskt ligger i framkant. Referens-till-video-modeller du kan anropa just nu accepterar redan fler än 20 tillgångar. Gapet är dokument och webbsidor, inte antal.
- Du kan testa formatet med två karaktärer, referenslåst och fullt röststyrt, gratis med Atlas Cloud's kostnadsfria AI-reklamskitgenerator: fyra produktbilder in, en 15-sekunders talad sketch ut, inget kort.
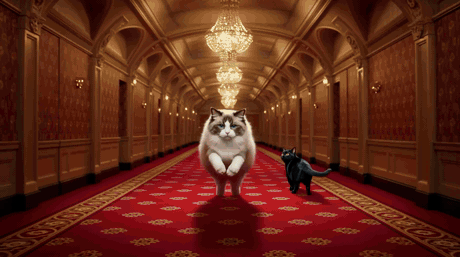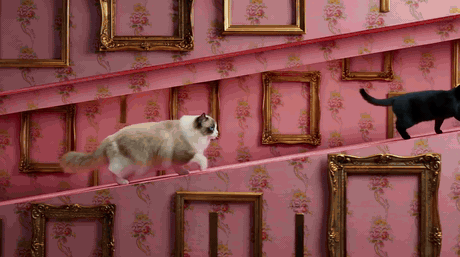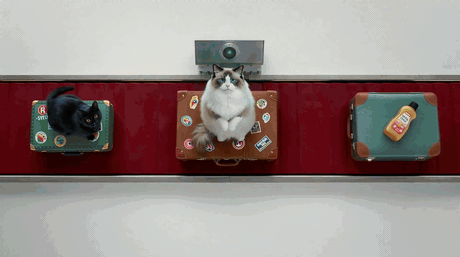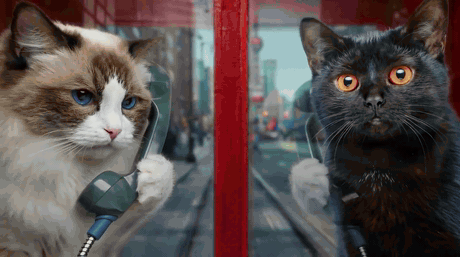
Två katter jagade genom fem olika set med Wan 3.0 utan karaktärsdrift_Två referensbilder. Fem helt olika set, från en hotellkorridor till en tvättmaskinstrumma till en röd telefonkiosk. Inte en enda bildruta med drift. Källa: Alibabas officiella Wan 3.0 creator handbook , augusti 2026, vilket också är källan till alla andra Wan 3.0-klipp i den här artikeln.
Varför multi-referensvideo faller isär, och vad Wan 3.0 Multimodal Reference förändrar
Videomodeller har inget minne mellan klipp. Varje generation börjar från noll. Det är hela problemet i en mening.
Så fort din berättelse behöver mer än en tagning syr du ihop. Tagning ett ger dig ett ansikte du älskar. Tagning två ger dig en kusin till det ansiktet. Tagning tre byter tyst jackan från plommon till bordeaux, och när du märker det har du redan betalat för elva renderingar.
Enkelbildsreferens hjälpte, men den låste bara en sak. Ett ansikte. Den kunde inte samtidigt hålla ett ansikte, en outfit, en rekvisita, en plats och en röst, eftersom det fanns en plats och fem jobb.
Det finns två vägar ut. Ge modellen fler platser, eller sluta få den att börja om. Wan 3.0 gör båda samtidigt, och det är därför de två rubrikfunktionerna egentligen är en funktion. En inbyggd 30-sekunderstagning innebär att det inte finns någon klippning för karaktären att driva över. Tjugo referenstillgångar innebär att varje element som måste förbli fast får sin egen dedikerade plats istället för att slåss om en.
Här är vad det ser ut som när inget är ihopsytt. Trettio sekunder, en kontinuerlig kamera, ett barn i en shoppingvagn som hamnar inbäddad i en reklamskylt och sedan går ut underifrån.
En hel 30 sekunder i ett pass, utan klipp, med ljudspåret genererat i samma pass. Källa: Alibabas officiella Wan 3.0 creator handbook.
Vad "20 tillgångar" faktiskt betyder inom Wan 3.0 Multimodal Reference
Tjugo är en rubriksiffra. Det som betyder något är att de tjugo inte alla är samma typ av sak. Wan 3.0:s omni-reference täcker fem indatatyper, och varje typ styr en annan axel av utdata.
Bilder styr identitet. Ett karaktärskort, en produktbild, en platskarta. Wan 3.0 kallar detta pixel-level consistency, och i Alibabas egna exempel sträcker sig låset bortom ansiktet till garderoben: den lagerlagda grå manteln, den remmade läderrocken, den mörka midjelinningen överlever en sexton sekunder lång närkamp på tre platser.
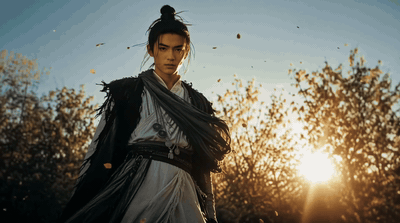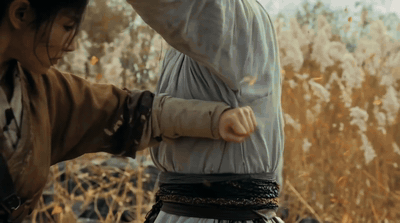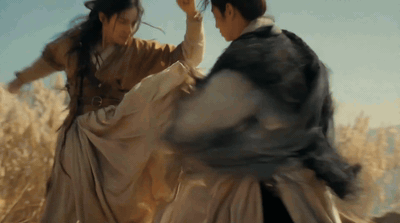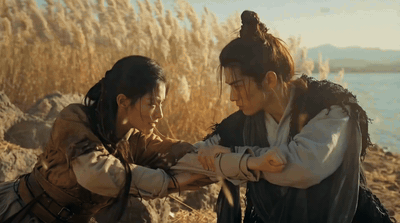
Två karaktärskort som driver en wuxia-slagsmålsscen med kostymdetaljer hållna bildruta för bildruta
Två karaktärskort plus en platskarta av vassbanken. Garderoben och miljön håller genom varje kast. Visad som en tyst GIF; den levererade filen har en 44,1 kHz stereomix. Källa: Alibabas officiella Wan 3.0 creator handbook.
Ljud styr röst. Det här är delen som gör "multimodal" mer än marknadsföring. Du bifogar ett röstprov per karaktär, skriver replikerna i prompten, och dialogen kommer tillbaka i den klangen, läppsynkad, i samma pass som bilden. Två personer, två röstreferenser, ett gym.
Två motivbilder plus två separata röstreferensklipp, och dialogen kommer tillbaka i de två rösterna. Värt att slå på ljudet för den här. Källa: Alibabas officiella Wan 3.0 creator handbook.
Video styr timing. En referensvideo är inte till för att kopieras. Den är till för att donera sin rytm: hur länge en bild håller, hur en övergång rör sig. I den här levererar fem nyckelbilder motiven och en referensvideo levererar den horisontella kortflipprytmen mellan dem.
Fem nyckelbilder flippade med tajming från en referensvideo_Fem nyckelbilder för motiven, en referensvideo för flipprytmen. Källa: Alibabas officiella Wan 3.0 creator handbook.
Dokument och webbsidor styr struktur. Det här är den verkligt nya. Wan 3.0 accepterar dokumentfiler och live-URL:er som kreativ indata, och rapportering om betalistan listar .doc, .xls, .ppt, .pdf och .txt bland de accepterade formaten (AlphaSignal, augusti 2026). Samma logik fungerar redan med en storyboardbild: en board in, sex tagningar ut, i boardens egen ordning.
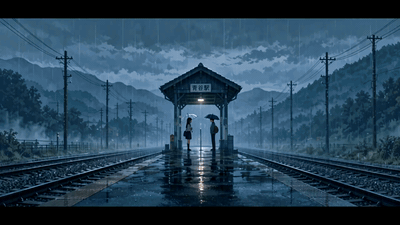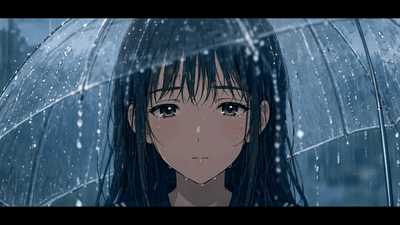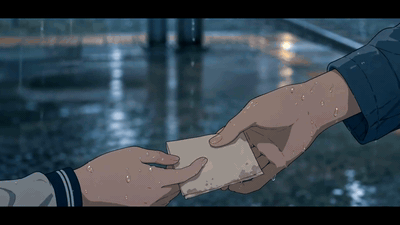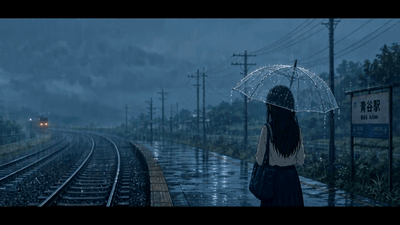
En enda storyboard utökad till sex sekventiella tagningar på en regnig tågstationsplattform
En storyboard som referens, sex tagningar genererade i dess ordning, ända ner till lappen som överlämnas i tagning fem. Källa: Alibabas officiella Wan 3.0 creator handbook.
Första och sista bildrutor styr ändpunkter. Det äldsta tricket i boken, fortfarande stött, fortfarande det snabbaste sättet att avgränsa en tagning.
Här är hur det staplas mot den version de flesta faktiskt använder idag.
| Wan 2.7 Reference-to-Video | Wan 3.0 omni-reference | |
|---|---|---|
| Referenstillgångar | en bild per motiv, upp till 3 videor, 1 röstklipp | upp till 20 tillgångar totalt |
| Modaliteter | bild, video, ljud | bild, video, ljud, dokument, webbsida |
| Max längd, ett pass | 10 s | 30 s inbyggt, plus smart duration |
| Ljud i samma pass | ja | ja |
| Videoredigering och förlängning | inte exponerad | instruktions- och referensbaserad redigering, plus förlängning |
| Tillgänglighet | live på tredjeparts-API:er | Alibaba Cloud Model Studio och Qwen Cloud beta |
Det finns en regel som ingen skriver i dokumentationen och alla lär sig den hårda vägen: en referens, ett jobb. Bild1 låser ansiktet och outfiten. Video1 donerar endast rörelse. Ljud1 donerar endast klang. I samma ögonblick som du ger en enda tillgång två motstridiga jobb, eller laddar upp en referensbild med två personer i, måste modellen gissa, och gissning är precis vad du försökte stoppa. Alibabas handbok är också tydlig med detta: ett motiv per referensbild.
Wan 3.0 Multimodal Reference-arbetsflödet du kan köra idag
Rakt svar först. Wan 3.0 är i offentlig beta på Alibabas eget moln, under modell-ID wan3.0-video (Alibaba Wan, augusti 2026). Det har inte landat på tredjeparts-API-plattformar än, Atlas Cloud inkluderat. Alla som säljer Wan 3.0 API-åtkomst just nu återförsäljer något annat.
Vad som har landat är arbetsflödets form. Referenspaket in, ett anrop, färdigt klipp med ljud ut. Det körs idag på referens-till-video-modeller som du kan anropa i en webbläsarflik, och när du väl ställer upp dem alla ser rubriken om 20 tillgångar annorlunda ut.
| Modell | Referenstillgångar | Modaliteter | Max längd | Inbyggt ljud | Pris per sekund |
|---|---|---|---|---|---|
| Wan 3.0 (Alibaba beta, inte på Atlas) | 20 totalt | bild, video, ljud, dokument, webbsida | 30 s | Ja | Rapporterat $0,05 till $0,20 per upplösning |
| Wan 2.7 Reference-to-Video | 1 bild per motiv, 3 videor, 1 röstklipp | bild, video, ljud | 10 s | Ja | $0,10 |
| Seedance 2.5 Reference-to-Video | 50 (30 bild / 10 video / 10 ljud) | bild, video, ljud | 30 s | Ja | $0,13 |
| MiniMax H3 Reference-to-Video | blandad, ingen angiven gräns | bild, video, ljud | 15 s | Ja | $0,10 |
| Kling Video O3 Pro Reference-to-Video | 7 bilder, eller 4 bilder + 1 video | bild, video | 15 s | Ja | $0,10 |
| Vidu Q3-Mix Reference-to-Video | 4 bilder | bild | 16 s | Ja | $0,11 |
| Veo 3.1 Reference-to-Video | 3 bilder | bild | 8 s | Valfritt | $0,20 |
Priserna är Atlas Cloud-priser från augusti 2026. Wan 3.0:s siffror är de som rapporterats för Alibaba Cloud-beta, inte en Atlas-pris, och Alibaba har inte publicerat en offentlig prissida för modellen än, så behandla den raden som preliminär.
Läs tabellen två gånger så dyker den verkliga historien upp. Rubriken om 20 tillgångar är inte där Wan 3.0 ligger i framkant, eftersom Seedance 2.5 redan tar 50 och matchar 30 sekunder. Vad inget annat på den listan tar är en PDF.
För genomgången nedan körs demon på Wan 2.7 Reference-to-Video, eftersom dess indataform är den närmaste levande släktingen till omni-reference: flera motivbilder, en valfri referensvideo och ett röstklipp, alla mappade till character1 och character2-etiketter i prompten. Tre modeller, en webbläsarflik, ingen lokal installation.
För en aktuell värdkörning, öppna Wan 3.0 på Atlas Cloud och testa en prompt som den nedan innan du publicerar arbetsflödet.
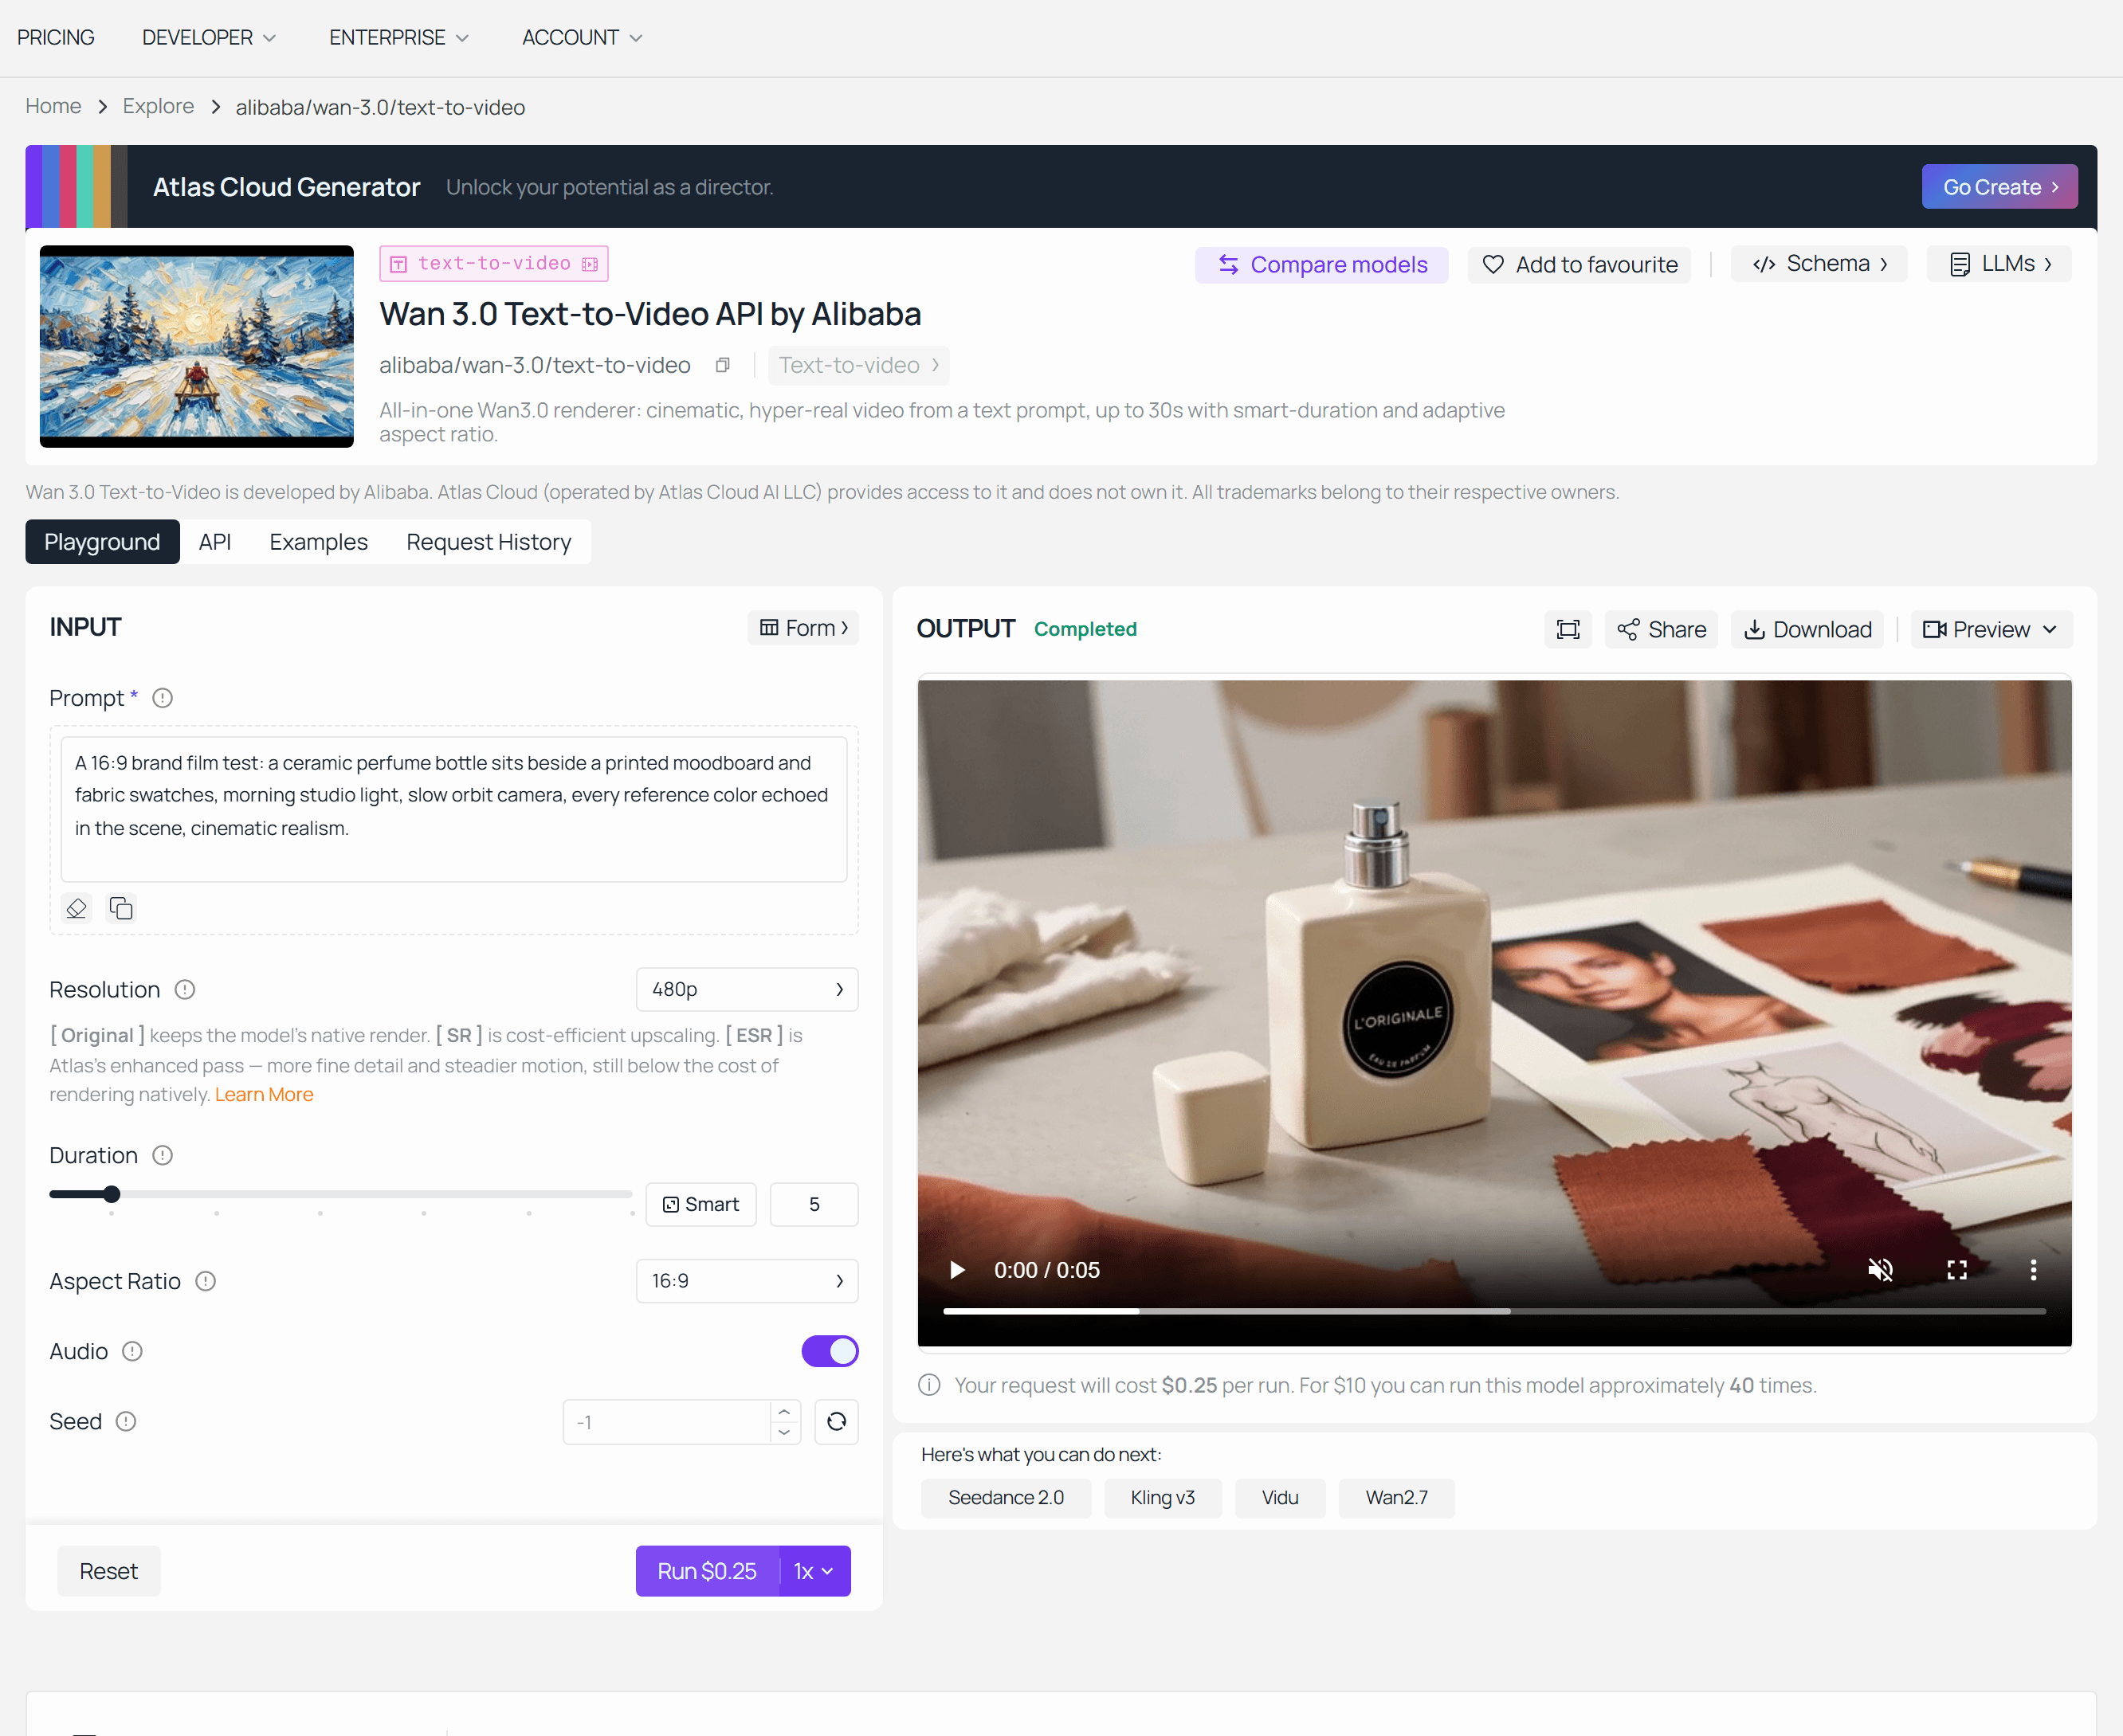
Wan 3.0 prompt-till-resultat-skärmdump: 20-referens varumärkesöverlämning.
Bygg det själv: En multimodal referensscen i fyra steg
Scenen: En pastellfärgad hotellreception. En dödpan concierge. En resenär som håller en ragdollkatt. Conciergen tittar rakt in i linsen och säger "Katten har en bokning. Det har inte du."
Två bilder plus ett röstklipp, vilket är tre referenstillgångar över två modaliteter. Det är den minsta byggnationen som är ärligt multimodal snarare än bara multi-bild.
Steg 1. Generera referensbild 1, motivet du måste låsa
Referensbilder har tre jobb och bara tre: ett motiv, vänd mot kameran, ren bakgrund. Allt annat är dekoration. Använd GPT Image 2 med kvalitet high, storlek 16:9, n=1.
Plain1Helkroppsstudioporträtt av en medelålders hotellconcierge med ett dödlägesuttryck, stående mitt i bild mot en platt dammrosa vägg. Han bär en plommonlila dubbelknäppt bellhopuniform med guldgaloner och mässingsknappar, en liten rund pillboxhatt och en tunn mustasch. Perfekt symmetrisk inramning, jämnt mjukt frontljus, ingen skugga på väggen, 35mm filmkorn, dämpad pastellpalett. Endast ett motiv, inga andra personer, ingen text, ingen logotyp, ingen rekvisita i bild. 2
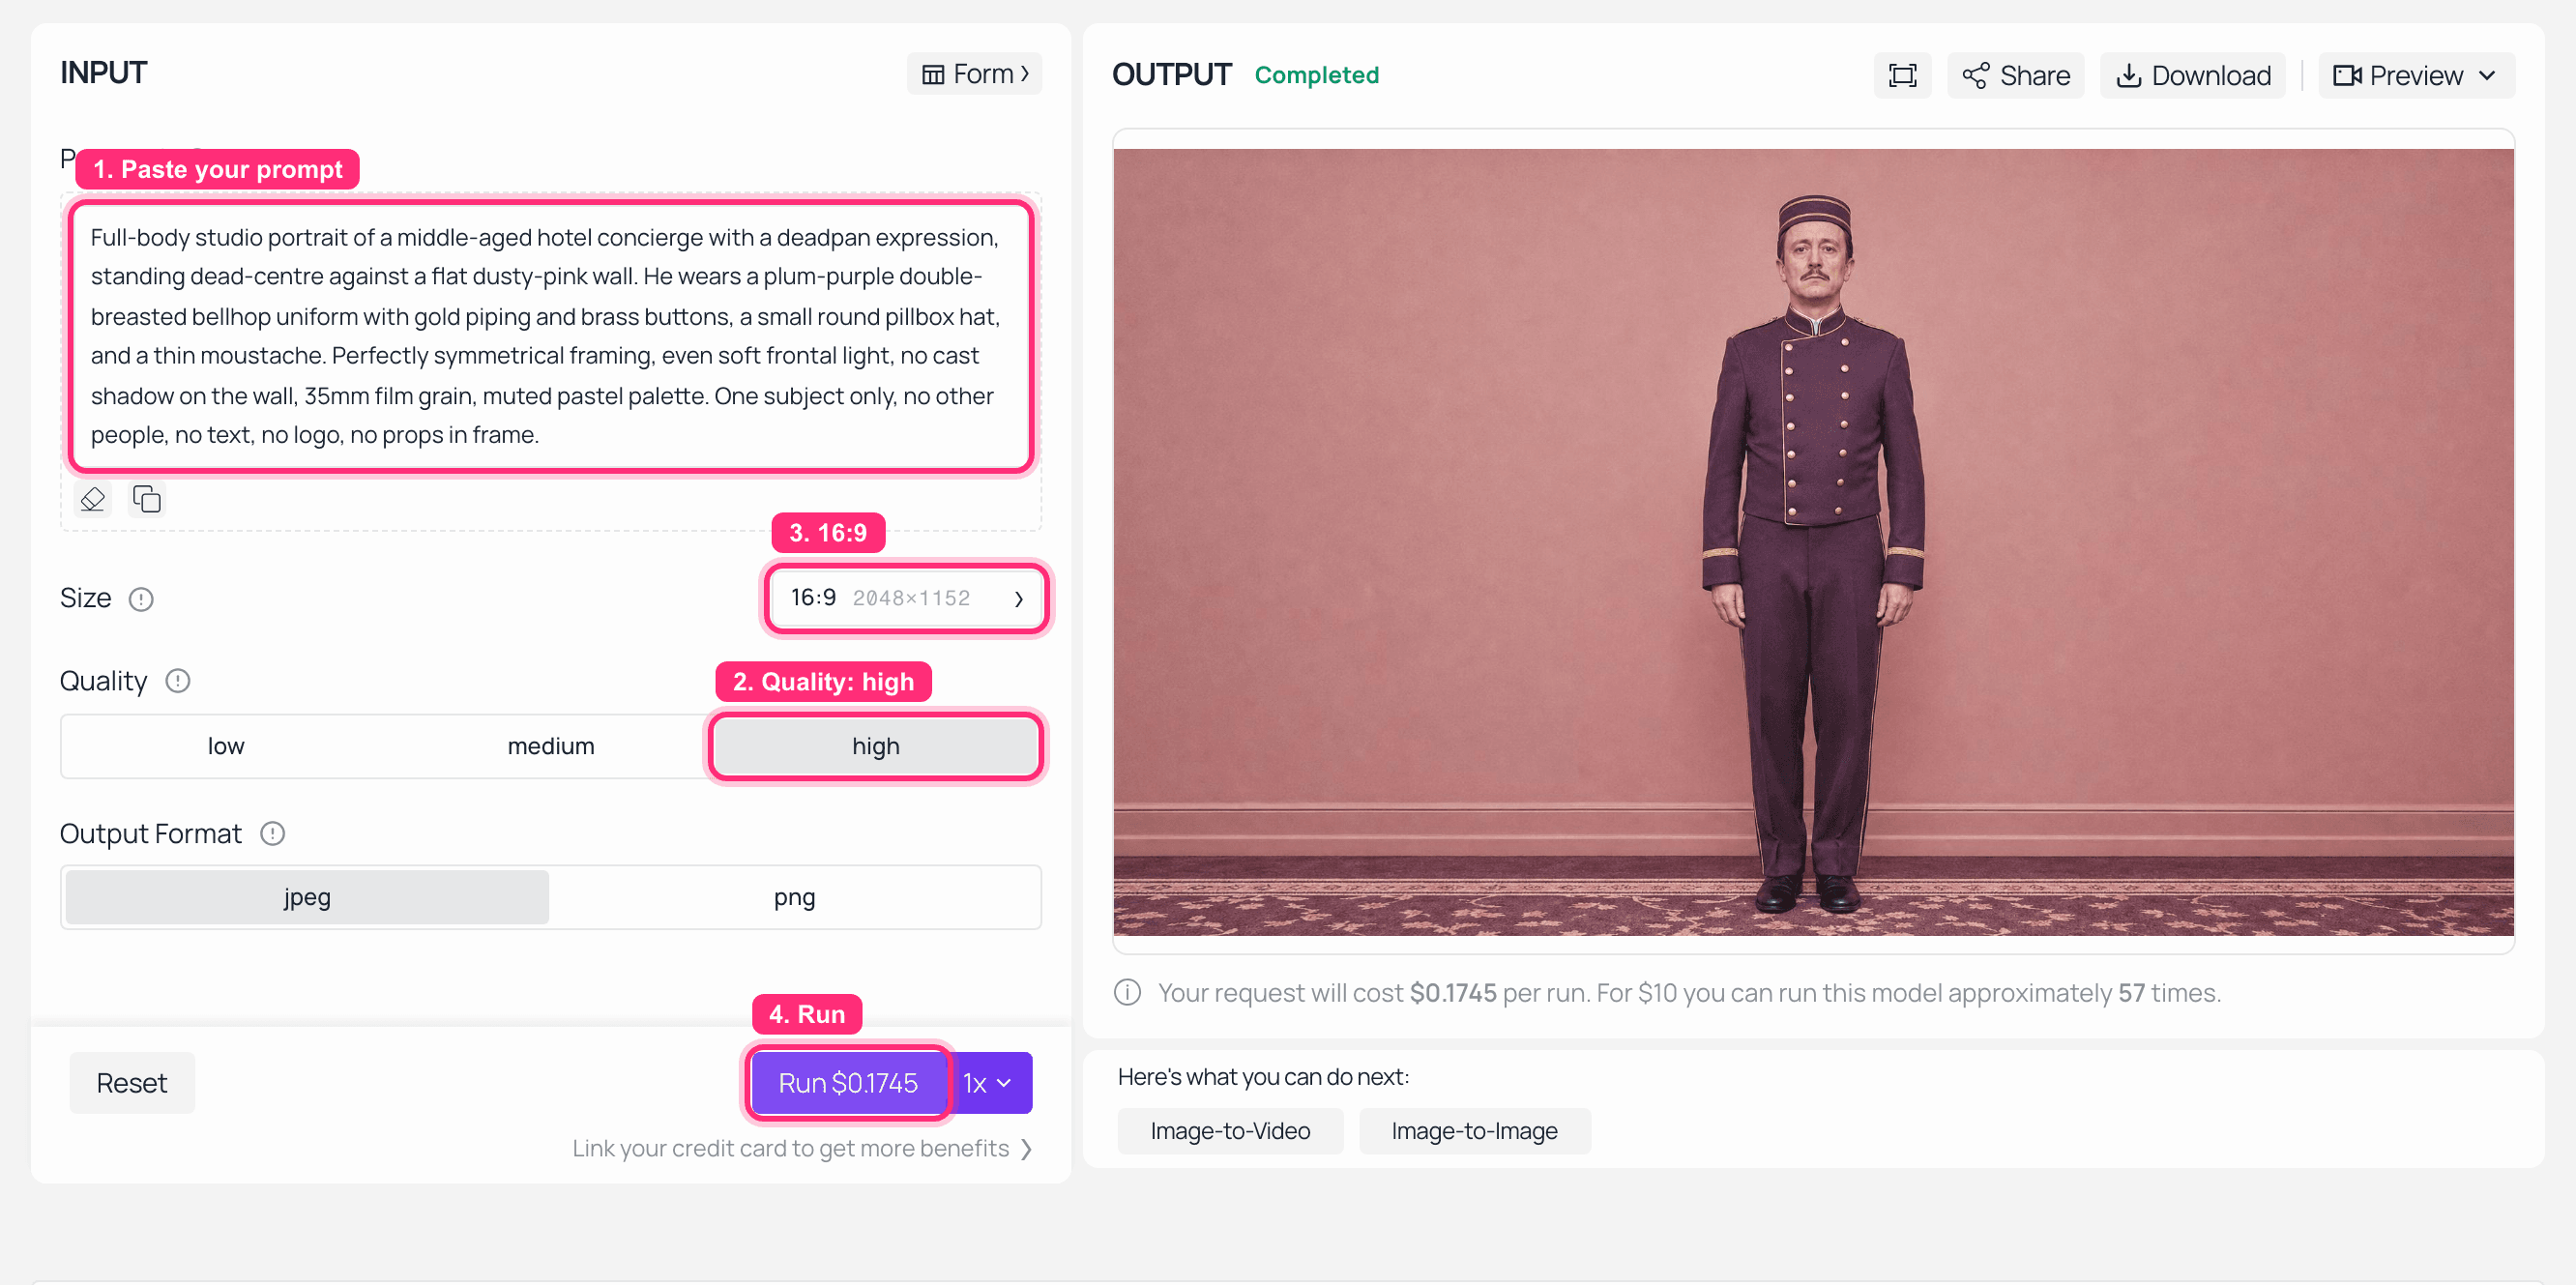
GPT Image 2-lekplatsen på Atlas Cloud med concierge-referensporträttet renderat i utdatapanelen
GPT Image 2 på Atlas Cloud: kvalitet high, 16:9, ett motiv, platt bakgrund. Det här är filen som blir character1.
Steg 2. Generera referensbild 2, det andra låsta motivet
Samma modell, samma inställningar. Färgkontrasten mellan de två karaktärerna är avsiktlig, eftersom den ger modellen ett enkelt sätt att hålla isär dem när de delar en bildruta.
Plain1Helkroppsstudioporträtt av en ung kvinnlig resenär som håller en fluffig ragdollkatt mot bröstet, stående mitt i bild mot en platt senapsgul vägg. Hon bär en senapsgul yllekappa, en röd basker och runda sköldpaddsglasögon, och håller en liten vintage läderresväska i sin fria hand. Perfekt symmetrisk inramning, jämnt mjukt frontljus, ingen skugga på väggen, 35mm filmkorn, dämpad pastellpalett. Endast ett motiv, inga andra personer, ingen text, ingen logotyp. 2
Steg 3. Generera röstreferensen, som är den faktiska multimodala delen
Röstklippet är det som förvandlar detta från ett multi-bildjobb till ett multimodalt. Wan 2.7:s ljudplats vill ha ett kort prov, ungefär 1 till 10 sekunder, så håll repliken kort. Använd MiniMax Speech 2.6 HD och välj en låg, platt, obrydd manlig röst.
Plain1God kväll. Checkar in? Självklart. Det gör alla. 2
Steg 4. Ett anrop, tre referenser, ett färdigt klipp
Nu läggs hela paketet in tillsammans på Wan 2.7 Reference-to-Video. Inställningar: resolution: 1080P, ratio: 16:9, duration: 10, vilket är denna modells tak, prompt_extend: false, seed: -1. Ladda images i ordning, steg 1 först, så det mappas till character1, sedan steg 2 som character2, och bifoga steg 3-filen till audio.
Plain1Symmetrisk, mitt-i-bild vidvinkelbild av en pastellfärgad hotellobbyreception, dammrosa väggar och en senapsgul nyckelställning bakom. character1 är conciergen som står bakom disken; character2 är resenären som står framför den, fortfarande hållande sin ragdollkatt. Kameran zoomar långsamt in längs en perfekt mittaxel och lutar aldrig. character1 tittar rakt in i linsen och säger flatt: "Katten har en bokning. Det har inte du." character2 blinkar en gång, vänder långsamt huvudet mot katten, sedan tillbaka till disken. Katten stirrar direkt in i kameran utan att röra sig. 35mm filmkorn, jämn mjuk belysning, dämpad pastellpalett, ingen kameraskakning, inga klipp. 2
Negativ prompt:
Plain1handhållen skakning, hoppklipp, undertexter, text på skärmen, vattenstämpel, extra personer, deformerade händer, ansiktsförändring, färgskiftning, rörelseoskärpa 2
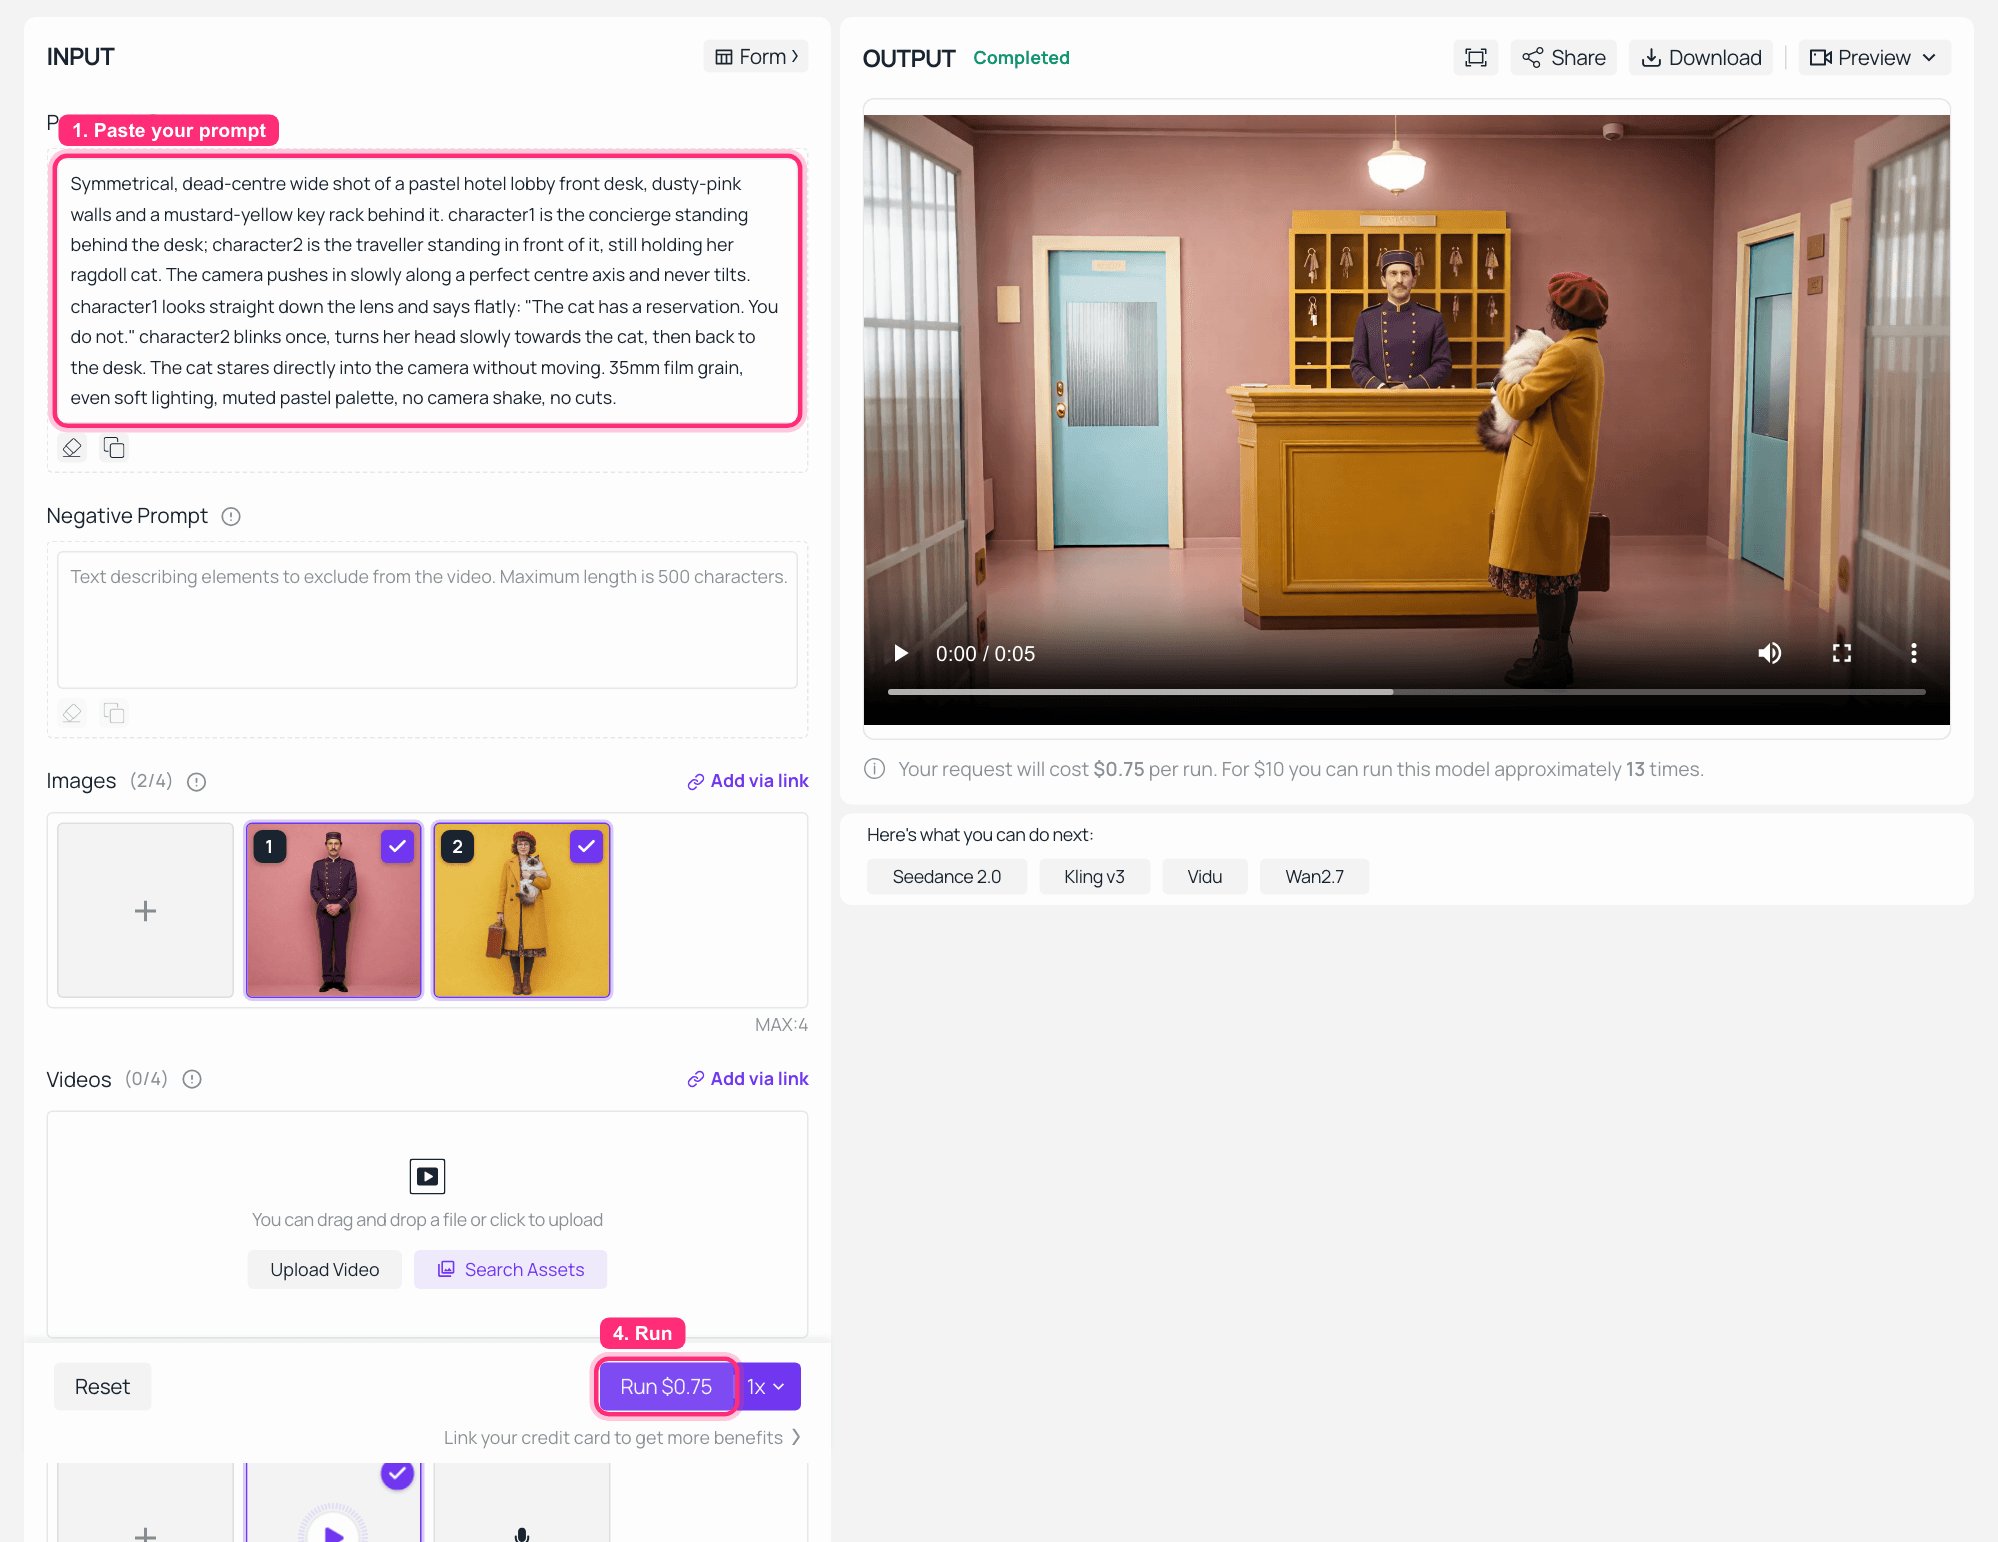
Wan 2.7 Reference-to-Video-lekplatsen på Atlas Cloud med två referensbilder och en ljudfil inlästa och det färdiga klippet i utdatapanelen
Wan 2.7 Reference-to-Video på Atlas Cloud: två referensbilder och ett röstklipp bifogat till vänster, den färdiga tagningen spelas upp till höger i 1080P och 16:9. Denna inspelning kördes med modellens standardlängd; ställ in den på 10 för fullversionen nedan.
Det färdiga klippet. Båda ansikten höll, båda outfiterna höll, och repliken levererades i den klonade rösten från steg 3, så den här är värd att spela med ljud.
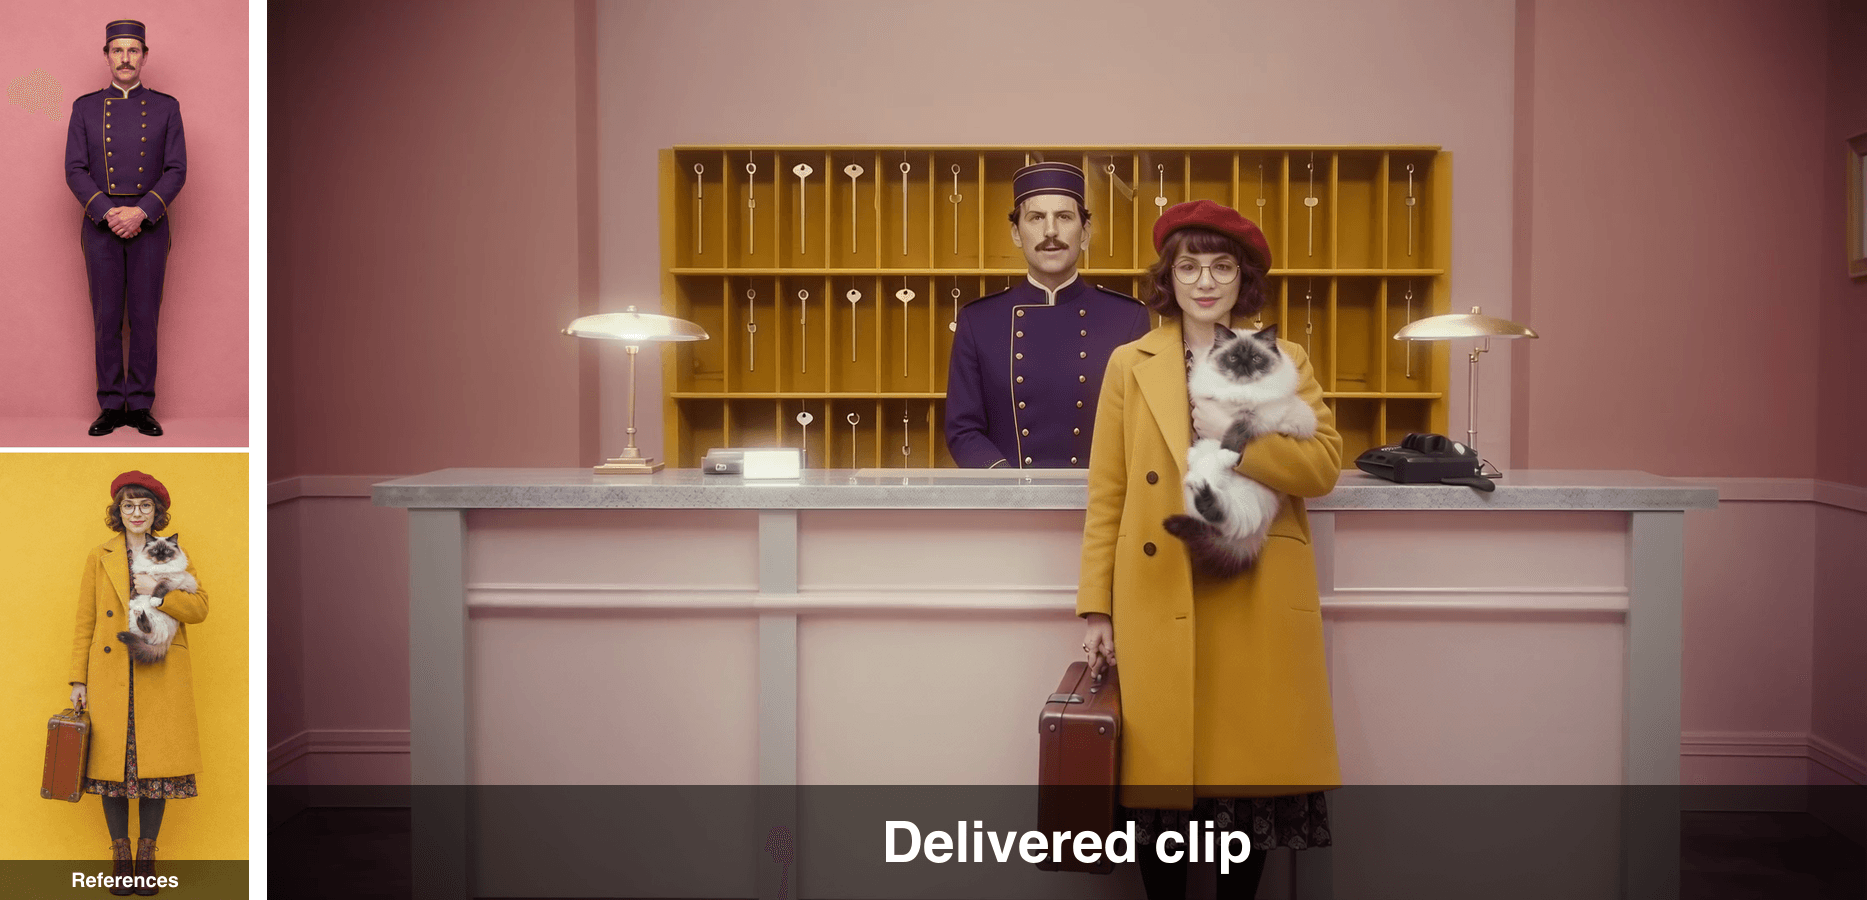
De två referensporträtten bredvid en bildruta från det färdiga klippet, som visar samma ansikten och outfit
Referenser till vänster, en bildruta från det levererade klippet till höger. Uniformsgaloner, basker, glasögon och katt överlever resan.
Variationer på Wan 3.0 Multimodal Reference-arbetsflödet
Pressa det till 30 sekunder. Samma referenspaket körs på Seedance 2.5 Reference-to-Video med duration: 30, vilket ger dig längden Wan 3.0 lovar utan att vänta på betan. Den tar upp till 30 referensbilder, 10 videor och 10 ljudklipp, så paketet har utrymme att växa. Skriv de extra 20 sekunderna som beats i prompten, inte som vibbar, annars fyller modellen ut.
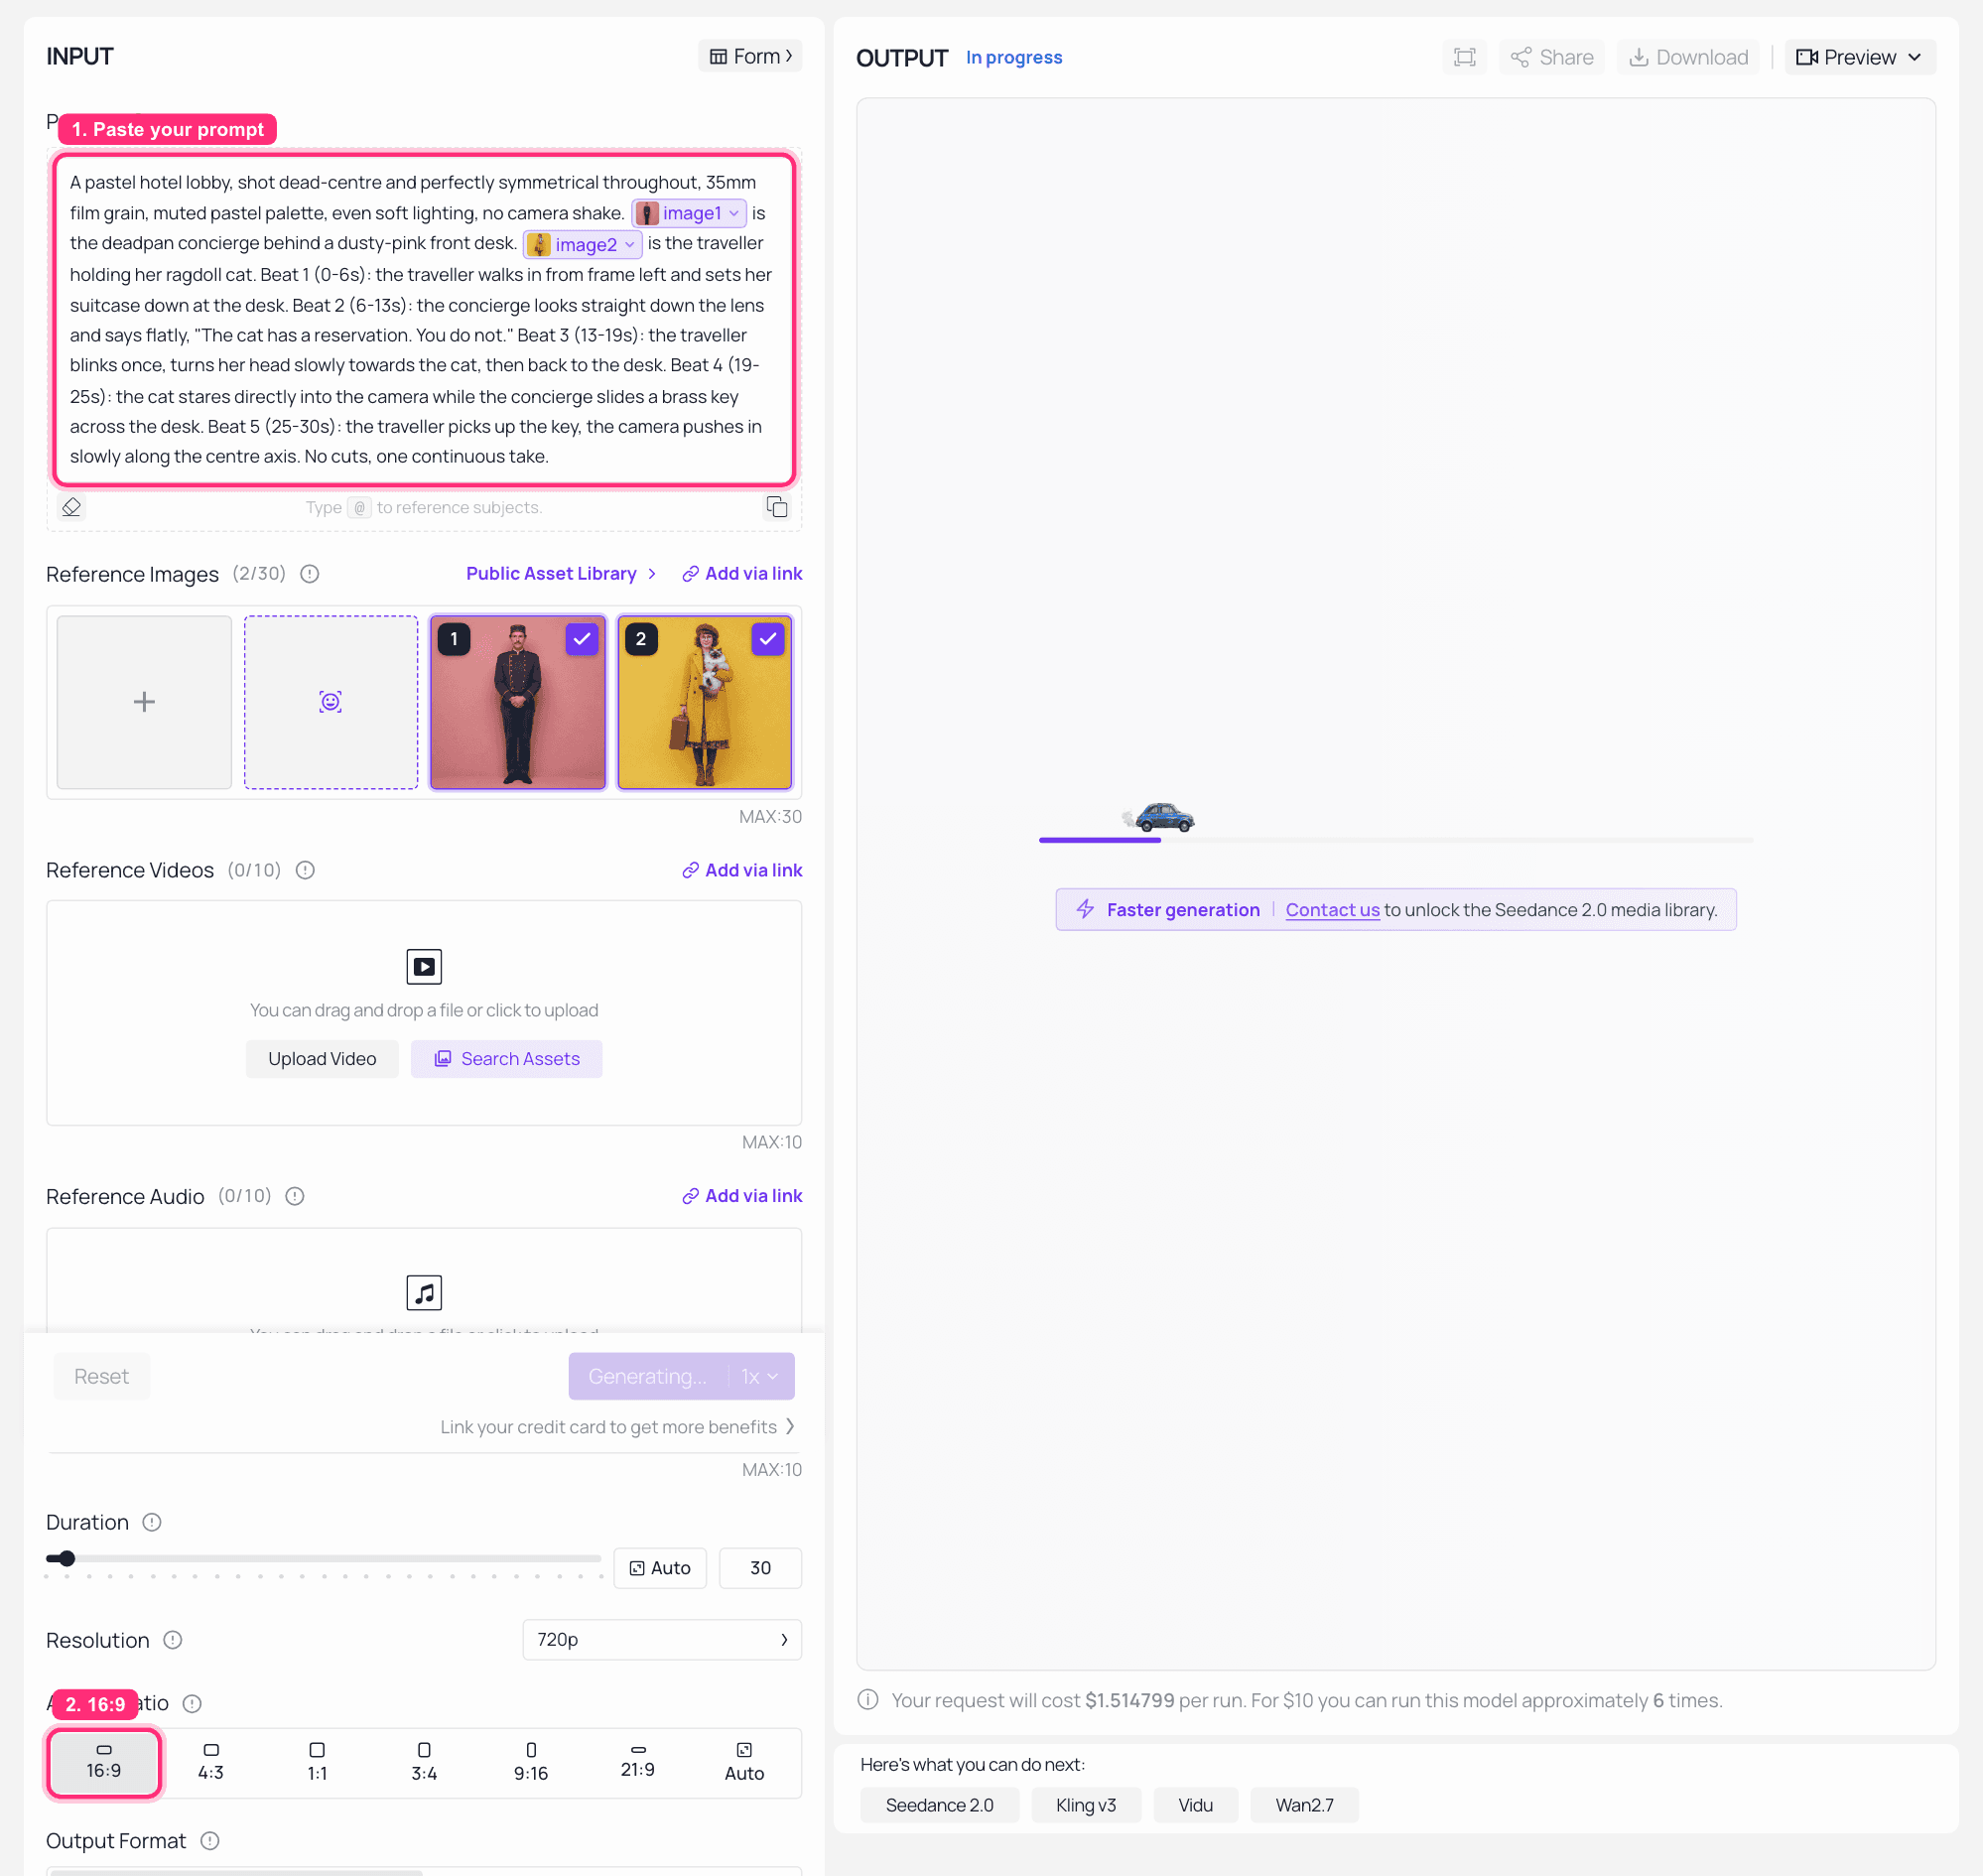
Seedance 2.5 Reference-to-Video-lekplatsen på Atlas Cloud med duration inställd på 30 och den långa tagningen renderad
Seedance 2.5 Reference-to-Video på Atlas Cloud med duration inställd på 30 och samma två referensporträtt bifogade, fångad mitt i generationen. Notera @image1 och @image2 -chipsen i prompten: det är så du berättar för Seedance vilken referens som spelar vilken roll. Kontrollera det angivna priset på Kör-knappen innan du bekräftar, eftersom det återspeglar längden jobbet faktiskt kommer att skicka.
30-sekundersversionen av samma scen, samma referenspaket, beats utskrivna tagning för tagning.
Lägg till en referensvideo endast för rörelse. Bifoga ett klipp vars pacing du gillar och säg det explicit i prompten, något i stil med "följ referensvideon för klipprytm endast, ignorera dess motiv och miljö". Det är tricket bakom kortflipp-exemplet ovan.
Åtgärda drift med negativ prompt innan du rör den positiva. Ansiktsförändring, färgskiftning och handhållen skakning är de tre som förstör referenslåsta tagningar, och de är vanligtvis billigare att undertrycka än att beskriva bort.
Prova det multimodala referensformatet gratis
Om du vill ha formen på detta innan du vill ha parametrarna, skickade Atlas Cloud förra veckan en kostnadsfri AI-reklamskitgenerator som kör samma kedja utan några rattar.
Du skriver en rad om din produkt och dess säljargument. Den skriver ett tvåkaraktärs komedimanus åt dig, hook, konflikt, twist, och renderar sedan en 15-sekundersvideo med talad dialog och ljudeffekter inbyggda. Du kan bifoga upp till fyra riktiga produktbilder som referenser, och annonsen behåller deras form, färg, etikett och logotyp från manus till sista bildruta. Sex stilar medföljer, från rolig meme genom plot twist och sitcom till lyx och hård sälj, och dialogen kommer tillbaka på det språk du skrev beskrivningen på.
Det är samma två-karaktärer-plus-referensbilder-plus-röst-kedja från handledningen, minus promptskrivande och minus räkningen. Vilket gör det till ett anständigt sätt att ta reda på om detta format passar din produkt innan du spenderar något på att finjustera det.
För en känsla av vad en hög med referensbilder gör för en produktbit, här är Wan 3.0:s egen version av jobbet: fem bilder in, en lanseringsfilm ut, varje bild förankrar en bild av redigeringen.
Fem referensbilder utökade till en produktlanseringsfilm i Material Design-stil_Fem referensbilder som driver en niosekunders produktfilm, varje bild förankrar en bild och överlämnar till nästa. Källa: Alibabas officiella Wan 3.0 creator handbook.
Vad ett Wan 3.0 Multimodal Reference-klipp kostar
| Steg | Modell | Enhetspris | Kvantitet | Kostnad |
|---|---|---|---|---|
| 1 och 2, två referensbilder | GPT Image 2 | $0,009 per bild | 2 | $0,02 |
| 3, röstreferens | MiniMax Speech 2.6 HD | $0,08 per 1K tecken | 49 tecken | $0,00 |
| 4, 10-sekunderstagningen i 1080P | Wan 2.7 Reference-to-Video | $0,15 per sekund i 1080P | 10 s | $1,50 |
| Handledning totalt | cirka $1,52 | |||
| Variation, 30 sekunder | Seedance 2.5 Reference-to-Video | $0,134 per sekund i 480P | 30 s | cirka $4,02 |
| Gratis väg | Kostnadsfri AI-reklamskitgenerator | gratis | 1 klipp, 15 s | $0 |
Det är plattformens egna priser, kontrollerade i augusti 2026 och debiterade löpande. Två saker flyttar summan mer än folk förväntar sig. Upplösning är den första: $0,10 per sekund i jämförelsetabellen är Wan 2.7:s baspris, och 1080P debiteras till $0,15, vilket är var $1,50 ovan kommer ifrån. Den andra är att Seedance prissätter efter pixelantal, så dess listade $0,134 per sekund är 480P-siffran och en 720P-tagning kostar mer än en rak multiplikation antyder. Som referens skulle den rapporterade Wan 3.0 beta-priset på $0,20 per sekund i 1080P placera en hel 30-sekunderstagning på cirka $6, vilket är mer än Seedance-vägen i 480P idag.
En notering om att använda det här. Wan 3.0 är en beta och dess villkor kan ändras, så läs dem igen innan du bygger en pipeline på den. Om dina referensbilder är riktiga personer, skaffa deras tillstånd först, eftersom referens-till-video är precis den förmågan som gör det viktigt. Exempelklippen i den här artikeln är Alibabas egna genererade resultat från dess offentliga creators handbok, reproducerade här för kommentar.
Vanliga frågor
Hur många referenser kan Wan 3.0:s multimodala referens faktiskt ta?
Upp till 20 tillgångar i ett enda anrop, hämtade från bilder, videor, ljud, dokument och webbsidor. Den praktiska gränsen är lägre än den tekniska. Tilldela varje tillgång exakt ett jobb, ett motiv per bild, och du kommer att använda mycket färre än 20 för de flesta scener.
Kan Wan 3.0 verkligen omvandla en PDF eller en webbsida till en video?
Ja, det är den verkligt unika delen. Tillsammans med text, bild, ljud och video accepterar den dokumentfiler och live-URL:er, med rapportering om betalistan som listar .doc, .xls, .ppt, .pdf och .txt. Ingen annan referens-till-video-modell i jämförelsetabellen ovan tar ett dokument alls.
Är Wan 3.0 öppen källkod? Kan jag köra det i ComfyUI?
Nej, och inte just nu. Wan 3.0 är en sluten beta som körs på Alibabas eget moln. Tidigare Wan-generationer släpptes öppet, vilket är varför förväntningen finns, men Alibaba har inte bekräftat vikter för 3.0. Sidor som påstår en 1,3B eller 14B Apache 2.0-release av Wan 3.0 stöds inte av något officiellt.
Är Wan 3.0 tillgängligt via tredjeparts-API:er än?
Inte än, Atlas Cloud inkluderat. Det närmaste du kan anropa idag är Wan 2.7 Reference-to-Video, vars indataform matchar omni-reference nästan exakt förutom dokument- och webbside-modaliteterna, eller Seedance 2.5 Reference-to-Video om du behöver hela 30 sekunderna.
Vad är det billigaste sättet att testa en referenslåst, tvåkaraktärsvideo?
Den kostnadsfria AI-reklamskitgeneratorn länkad ovan. Fyra referensbilder in, ett 15-sekunders talat tvåkaraktärsklipp ut, inga parametrar och ingen kostnad. Om den håller din produkt och ditt format, gå sedan och finjustera den betalda kedjan.
Varför driver mina karaktärer fortfarande även med referensbilder?
Tre orsaker, i frekvensordning. En referens bär två jobb, så den ombeds fixa både ansiktet och platsen. Referensbilden har mer än en person eller en rörig bakgrund, så modellen vet inte vilken del den ska låsa. Eller så är driften ett renderingsartefakt snarare än ett referensmisslyckande, i vilket fall sätt face morphing, colour shift i den negativa prompten innan du skriver om något.


