Seedance 2.0 Mini & Fast API till världens lägsta priser — upp till 68 % rabatt på det officiella priset

AI-avatargenerator som får ett foto att tala med ditt ljud

Ladda upp ett porträtt och en ljudfil. Modellerna för ljud till video animerar ansiktet så att läppar och miner följer inspelningen, och den färdiga videon är klar att ladda ner.

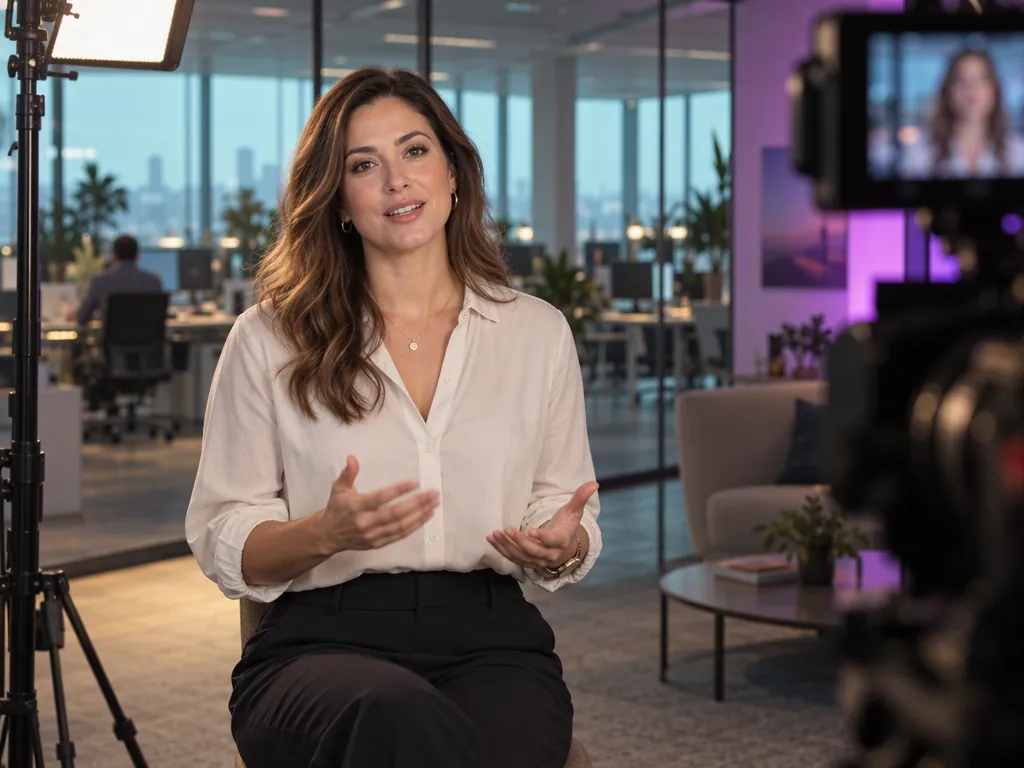
Avatarvideo från ett enda porträtt

Korta uttrycksfulla klipp eller tio minuter långa genomgångar, samma två filer räcker.

Talande AI-avatar

Ladda upp ett porträtt rakt framifrån och en MP3 eller WAV. Avatar Omni Human 1.5 ger tillbaka en video där personen talar eller sjunger spåret, med läppsynk, miner och gester genererade direkt ur ljudet. Utdata i 720p eller 1080p.

Klippen kan bli upp till 60 sekunder, och 15 sekunder eller kortare ger skarpast resultat. Lägg till en prompt för att styra scen, handling eller uttryck — den läser kinesiska, engelska, japanska, koreanska, spanska och indonesiska.

Läppsynk för långa inspelningar

När manuset är en hel lektion snarare än ett kort klipp tar InfiniteTalk samma porträtt och upp till 10 minuter ljud. Läppsynken ligger kvar på fonemnivå genom hela inspelningen, och ansikte, frisyr, kläder och bakgrund håller sig stabila. Utdata i 480p eller 720p.

Generera speakern under fliken Ljud och ta med filen hit, och styr sedan uttryck och hållning med en prompt. En kursmodul eller en produktgenomgång blir klar utan att du bokar kamera eller presentatör.

AI-avatarmodeller på ett ställe

Två modeller för olika längder. Välj Avatar Omni Human 1.5 för korta, uttrycksfulla klipp i upp till 1080p, och InfiniteTalk när ljudet är långt.

Så gör du en avatarvideo i tre steg

1

Ladda upp porträttet

Använd ett tydligt foto rakt framifrån på en person. Enkel bakgrund och fritt ansikte ger modellen mest att arbeta med.

2

Lägg till ljudet

Bifoga en MP3 eller WAV: en inspelning, eller tal du genererat under fliken Ljud.

3

Generera och ladda ner

Välj modell och upplösning, generera och ladda ner det färdiga klippet.

Vad kan du göra med en talande avatar?

Välj fliken som ligger närmast ditt arbete och se var en talande avatar ersätter en inspelning.

En talesperson på varje marknad

Ett porträtt, många språk. Spela in eller generera manuset på varje språk, kör samma ansikte genom modellen, och kampanjen får samma presentatör överallt utan att någon behöver flygas in.

Lektioner i bild utan studio

Gör en tio minuter lång föreläsningsinspelning till video med InfiniteTalk. Läraren syns i bild hela modulen igenom, och att uppdatera lektionen handlar om att byta ljudfil, inte att spela in igen.

Produktgenomgångar med avatar

Ge varje produkt en presentatör. Kombinera produkttexten från fliken Ljud med ett porträtt som passar varumärket, så är genomgången klar för produktsidan eller en annons i UGC-stil.

Introduktionsfilmer som uppdateras utan ny inspelning

Spela in policygenomgången en gång som ljud och ge den en och samma presentatör med InfiniteTalk, som håller läppsynken genom en lång inspelning. När en rutin ändras byter du ljudfil och samma ansikte levererar den nya versionen.

Fler AI-verktyg från Atlas Cloud runt din avatar

Vanliga frågor

En AI-avatargenerator är ljud till video: den animerar ett stillbildsporträtt så att det talar ett givet ljudspår. Du laddar upp ett foto och en ljudfil, modellen skapar munrörelser, miner och gester ur ljudet, och du får tillbaka en video där personen talar.

Atlas Cloud har Avatar Omni Human 1.5 från ByteDance och InfiniteTalk. Båda tar ett porträtt plus ljud och skiljer sig främst i klipplängd och upplösning.

Avatar Omni Human 1.5 gör klipp på upp till 60 sekunder, med 15 sekunder eller kortare som rekommendation. InfiniteTalk tar upp till 10 minuter ljud i en körning.

Avatar Omni Human 1.5 ger 720p eller 1080p. InfiniteTalk ger 480p eller 720p.

Ett porträtt rakt framifrån på en person med ansiktet tydligt synligt. Båda modellerna är gjorda för en talare per klipp.

Ja. Avatar Omni Human 1.5 är gjord för både tal och sång, och skapar gester och miner ur ljudet snarare än ur ett manus.

Avatar Omni Human 1.5 nämner kinesiska, engelska, japanska, koreanska, spanska och indonesiska bland språken den arbetar med. Läppsynken följer ljudet, så det är inspelningens språk som avgör.

Ja. Generera speakern med en modell för text till tal, ladda ner filen och lägg den som ljudingång här. Avataren läppsynkar till den genererade rösten precis som till en inspelning.

Ja. Båda modellerna finns via Atlas Cloud API med samma autentisering som bild- och videoanropen. Bläddra bland avatarmodellerna för att komma igång.

Guider för AI-avatarvideo

Porträttförberedelse, ljudlängd och språktester.

Börja med ett porträtt. Låt det sköta snacket.