Thanh tải xuống chạm mốc 65 GB, quạt bắt đầu quay, và câu hỏi thật sự xuất hiện: liệu nó có thực sự tải được không? Câu trả lời ngắn cho yêu cầu bộ nhớ GPT-OSS-120B là khoảng 61 GB cho trọng số, cộng thêm một chút cho không gian làm việc, đó là lý do OpenAI quảng bá nó như một mô hình chạy trên một GPU 80GB.
Bên dưới, chúng tôi chia con số đó thành các phần, trình bày phần cứng đã chạy nó với tốc độ đo được, và đề cập đến phương án được host khi máy của bạn không đủ.
Những điểm chính
- GPT-OSS-120B được phát hành dưới dạng checkpoint MXFP4 60,8 GiB, đó là lý do OpenAI nhắm đến một GPU 80GB.
- Độ dài ngữ cảnh chỉ thêm rất ít bộ nhớ: KV cache chỉ đạt khoảng 4,5 GiB ở mức đầy đủ 131K token.
- Với ít hơn 80GB VRAM, llama.cpp có thể offload các lớp expert sang RAM hệ thống và vẫn chạy được nó.
- Mac có hơn 96GB bộ nhớ và mini PC 128GB có thể chứa toàn bộ mô hình trên một máy.
- Không có phần cứng phù hợp? Gọi Qwen3.5 122B A10B trên Atlas Cloud qua một API tương thích OpenAI.
Yêu cầu bộ nhớ GPT-OSS-120B: Trọng số cộng KV Cache
OpenAI phát hành gpt-oss-120b vào ngày 5 tháng 8 năm 2025, theo giấy phép Apache 2.0. Đây là mô hình mixture-of-experts, nên chỉ 5,1B trong số 116,8B tham số hoạt động trên mỗi token. Điều đó giúp tăng tốc độ, không giúp bộ nhớ: mọi expert vẫn phải nằm trong bộ nhớ sẵn sàng được chọn.
Thủ thuật giữ cho nó nhỏ là MXFP4. Theo thẻ mô hình gpt-oss, trọng số expert, chiếm hơn 90% tham số, được lưu ở 4,25 bit mỗi trọng số. Bản sao 16-bit của cùng mô hình sẽ cần dung lượng lớn hơn khoảng bốn lần.
| Thông số | GPT-OSS-120B |
|---|---|
| Tổng tham số | 116.8B |
| Tham số hoạt động mỗi token | 5.1B |
| Lớp và expert | 36 lớp, 128 expert, 4 hoạt động mỗi token |
| Định dạng trọng số | MXFP4 cho lớp expert, BF16 cho phần còn lại |
| Kích thước checkpoint | 60.8 GiB |
| Cửa sổ ngữ cảnh | 131,072 token |
Cửa sổ ngữ cảnh thay đổi bộ nhớ GPT-OSS-120B như thế nào
Mỗi token để lại một key và một value trong mỗi lớp attention. Kho lưu đó là KV cache, và khi mọi lớp attention xử lý toàn bộ ngữ cảnh, nó tăng theo độ dài ngữ cảnh.
GPT-OSS-120B né được phần lớn điều đó. Một nửa trong 36 lớp của nó dùng cửa sổ trượt chỉ nhìn lại 128 token, và mỗi lớp chỉ lưu 8 KV head có 64 chiều. Chỉ 18 lớp giữ toàn bộ ngữ cảnh. Chúng tôi tính KV cache từ config của mô hình và kết quả khớp với tổng đo được trong hướng dẫn gpt-oss của llama.cpp.
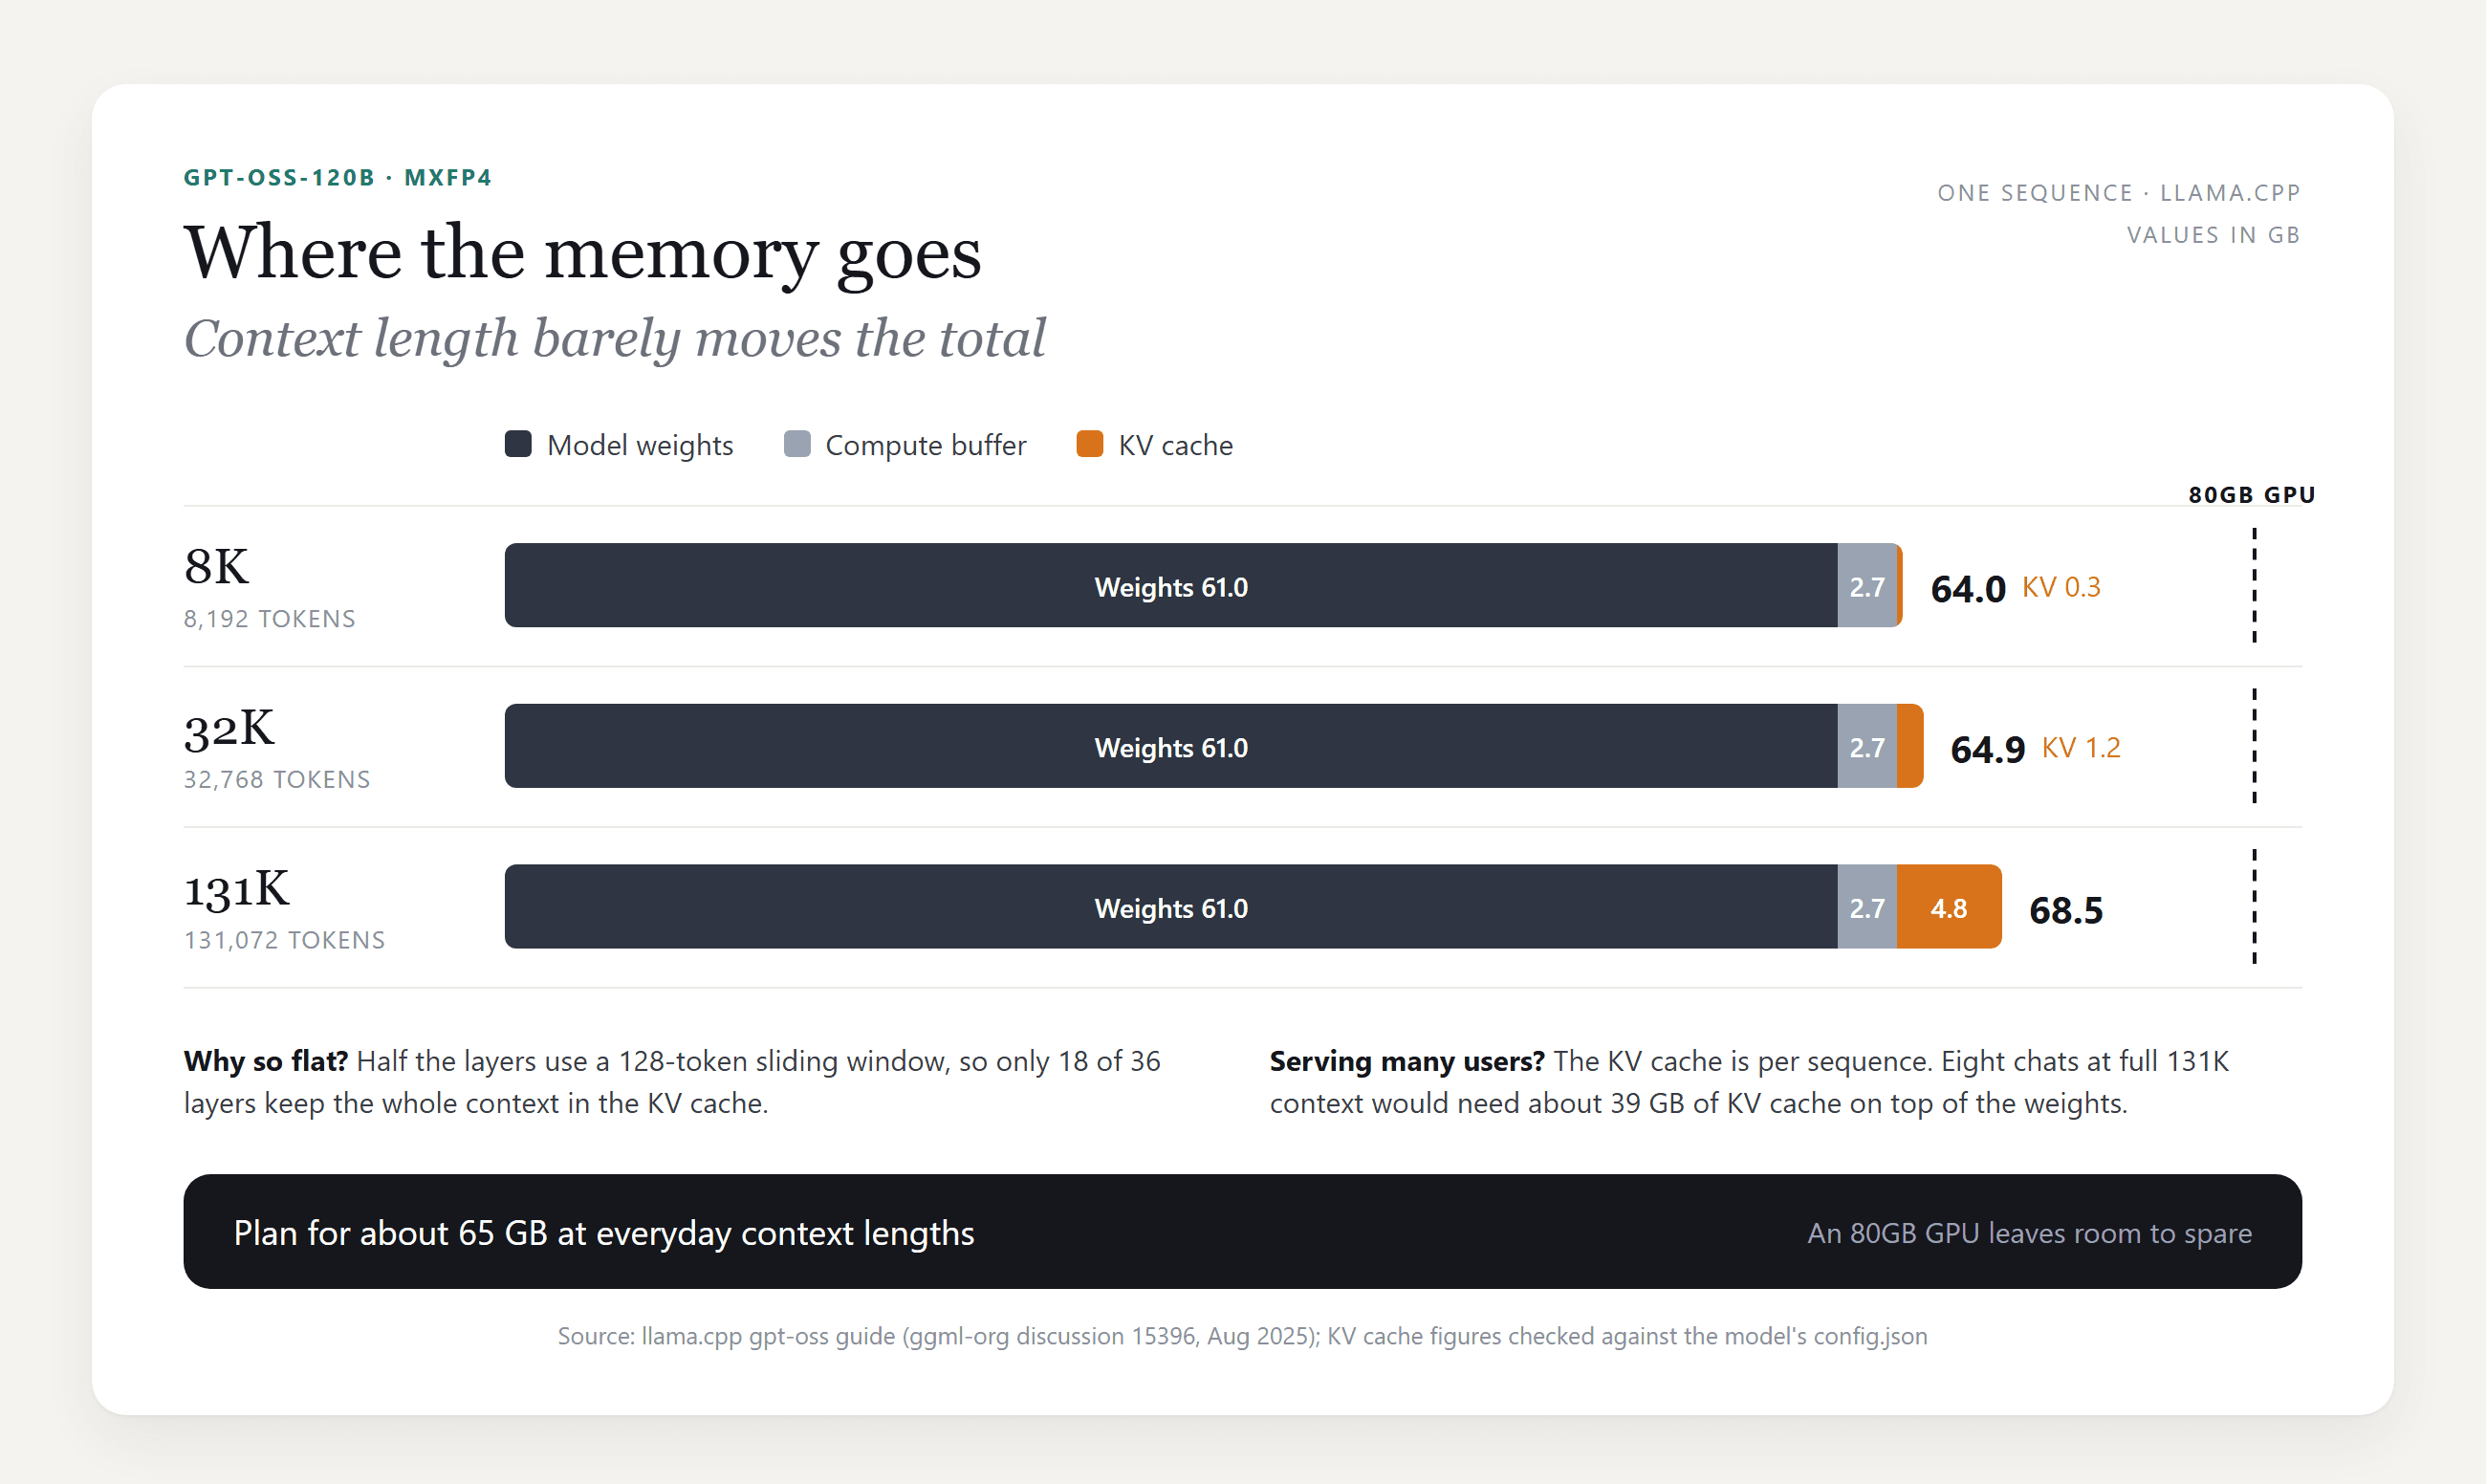
Đi từ 8K lên đầy đủ 131K tốn dưới 5 GB. Điểm cộng dồn là tính đồng thời: KV cache tính theo từng cuộc hội thoại, nên một máy chủ giữ tám cuộc trò chuyện đủ độ dài cần thêm khoảng 39 GB ngoài trọng số.
Tôi có thể chạy GPT-OSS-120B cục bộ không? Yêu cầu phần cứng theo từng cấu hình
Có, nếu bạn có thể đặt khoảng 65 GB ở đâu đó đủ nhanh: một GPU lớn, một GPU cộng RAM hệ thống, hoặc một máy có bộ nhớ hợp nhất.
Yêu cầu GPU cho GPT-OSS-120B
Trường hợp đơn giản nhất là một card trung tâm dữ liệu 80GB. Công thức vLLM cho gpt-oss nói rằng mô hình 120b "sẽ vừa trên một A100 (80GB)", và việc chia nó qua nhiều GPU giúp tăng thông lượng.
Dưới 80GB, hướng dẫn llama.cpp đưa ra một cách xử lý. Cờ --n-cpu-moe của nó giữ một số lớp expert trong RAM hệ thống và phần còn lại trên GPU. Hướng dẫn đặt mức tối thiểu khoảng 8GB VRAM, miễn là bộ nhớ GPU và hệ thống cộng lại vẫn chứa được mô hình.
| Cấu hình | Trọng số nằm ở đâu | Tốc độ sinh được báo cáo |
|---|---|---|
| RTX Pro 6000, 96GB | Tất cả trên GPU | 196 token/s (hướng dẫn llama.cpp) |
| A100 hoặc H100, 80GB | Tất cả trên GPU | Vừa trên một card (công thức vLLM) |
| RTX 5090, 32GB, cộng RAM hệ thống | 21 lớp expert được giữ trong RAM hệ thống | Khoảng 30 token/s ở ngữ cảnh bằng không (hướng dẫn llama.cpp) |
Một cạm bẫy trên Windows từ cùng hướng dẫn: driver có thể âm thầm tràn vào RAM hệ thống khi VRAM cạn, khiến mô hình tải được rồi chạy rất chậm. Hãy theo dõi GPU Memory trong Task Manager và tăng số lượng offload cho đến khi nó nằm dưới dung lượng card của bạn.
Chạy GPT-OSS-120B trên Mac hoặc mini PC 128GB
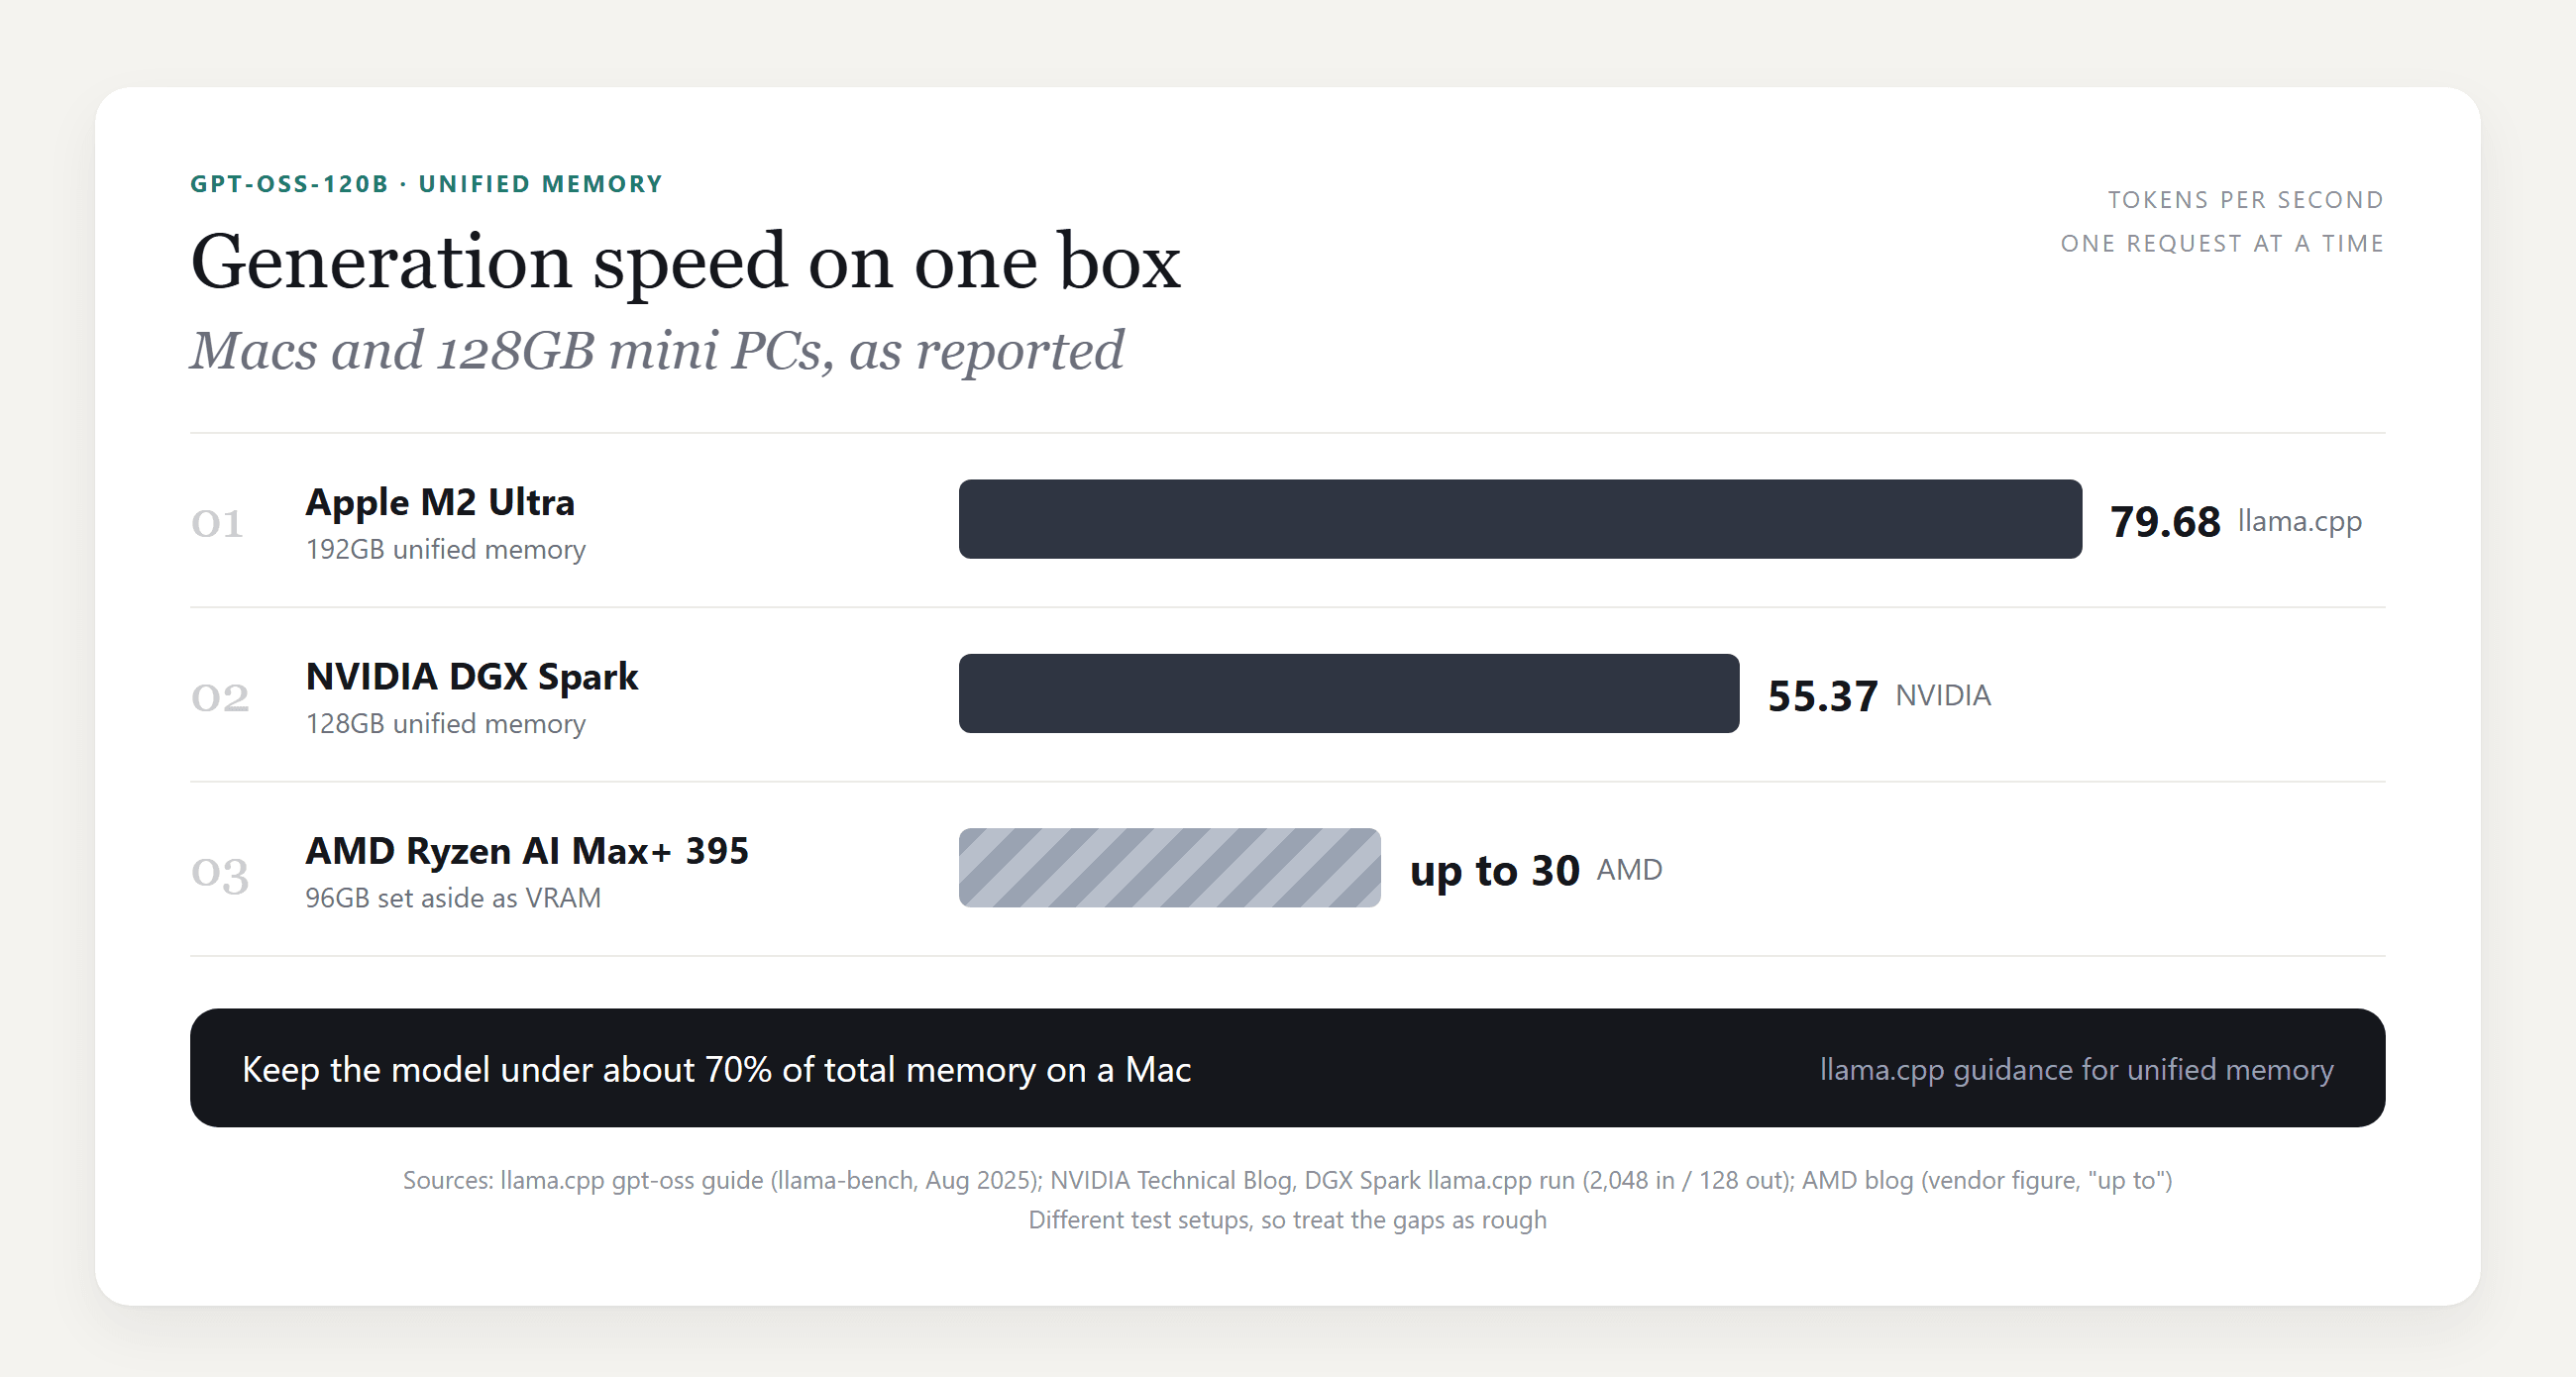
Bộ nhớ hợp nhất loại bỏ sự chia tách giữa GPU và RAM. Hướng dẫn llama.cpp nói rằng Mac có hơn 96GB RAM, chẳng hạn máy M2 Ultra hoặc M3 Max, có thể chạy mô hình ở ngữ cảnh đầy đủ, và khuyến nghị giữ dưới khoảng 70% tổng bộ nhớ.
macOS giới hạn mức bộ nhớ mà GPU có thể wire theo mặc định. Trên máy 192GB, hướng dẫn nâng giới hạn đó từ 154GB lên 180GB bằng một lệnh:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
Các mini PC 128GB mới nằm cùng hạng. NVIDIA báo cáo 55,37 token/s cho gpt-oss-120b trên một DGX Spark chạy llama.cpp. AMD nói rằng máy Ryzen AI Max+ 395 với 96GB được dành làm VRAM đạt "tối đa 30 token mỗi giây", đây là số liệu của chính công ty.
Không đủ bộ nhớ? Dùng mô hình trọng số mở được host qua API
Nếu không có chiếc máy nào trong số đó trên bàn của bạn, một mô hình trọng số mở được host sẽ bỏ qua hoàn toàn câu hỏi về phần cứng.
Atlas Cloud cung cấp Qwen3.5 122B A10B, một phần trong dòng mô hình Qwen của nền tảng. Trên lý thuyết, nó gần như tương đương với gpt-oss-120b: một mô hình mixture-of-experts Apache 2.0 từ đội Qwen của Alibaba, với tổng 122B và 10B tham số hoạt động. Nó đọc tối đa 262.144 token ngữ cảnh.
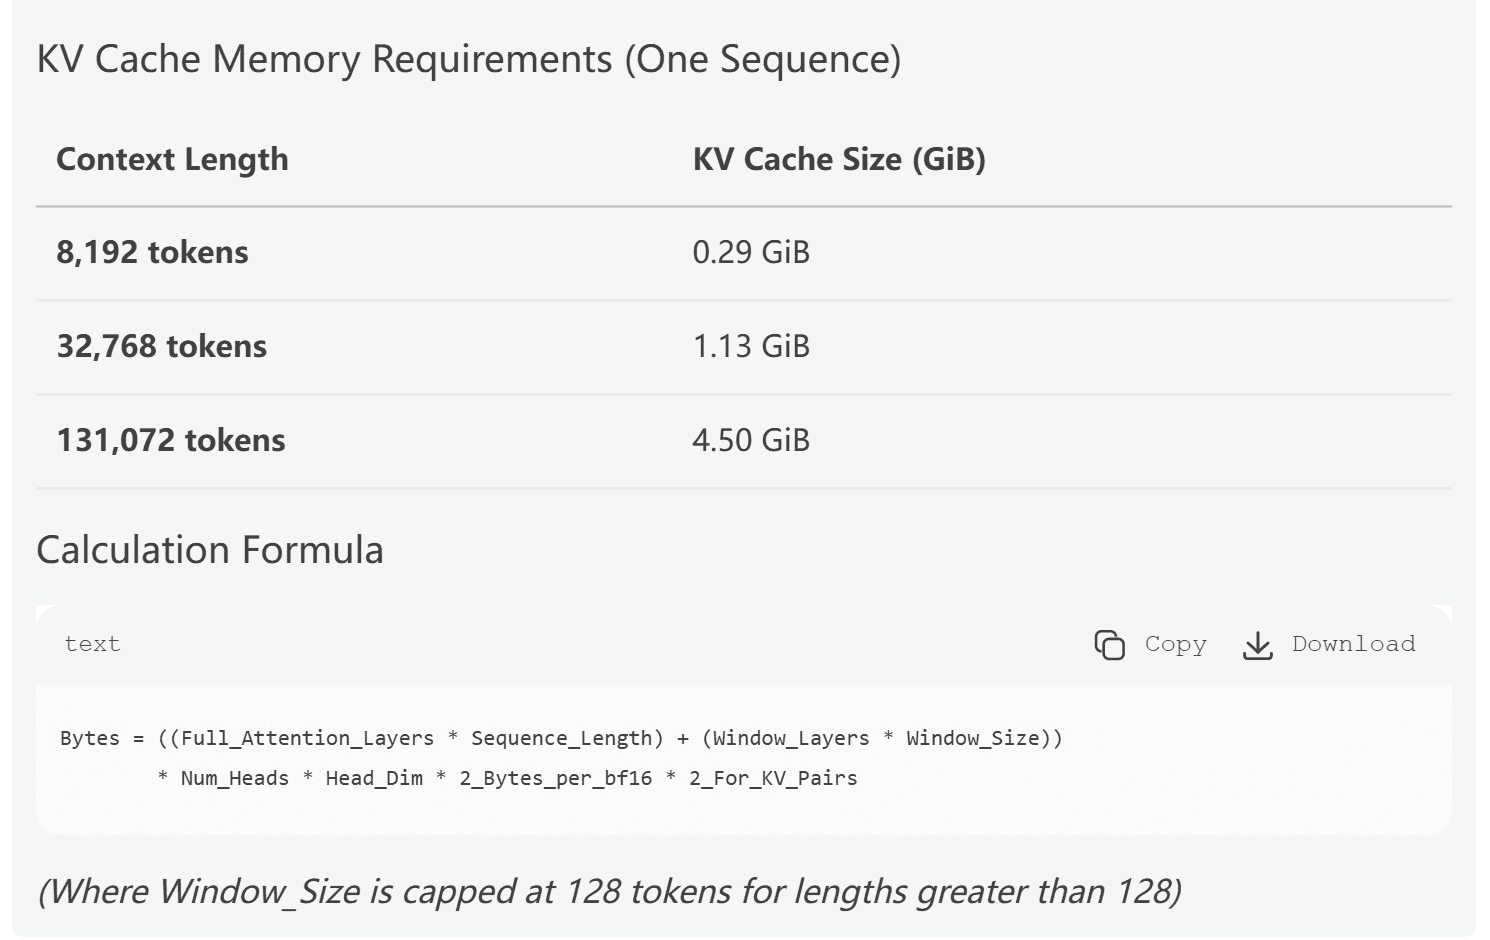
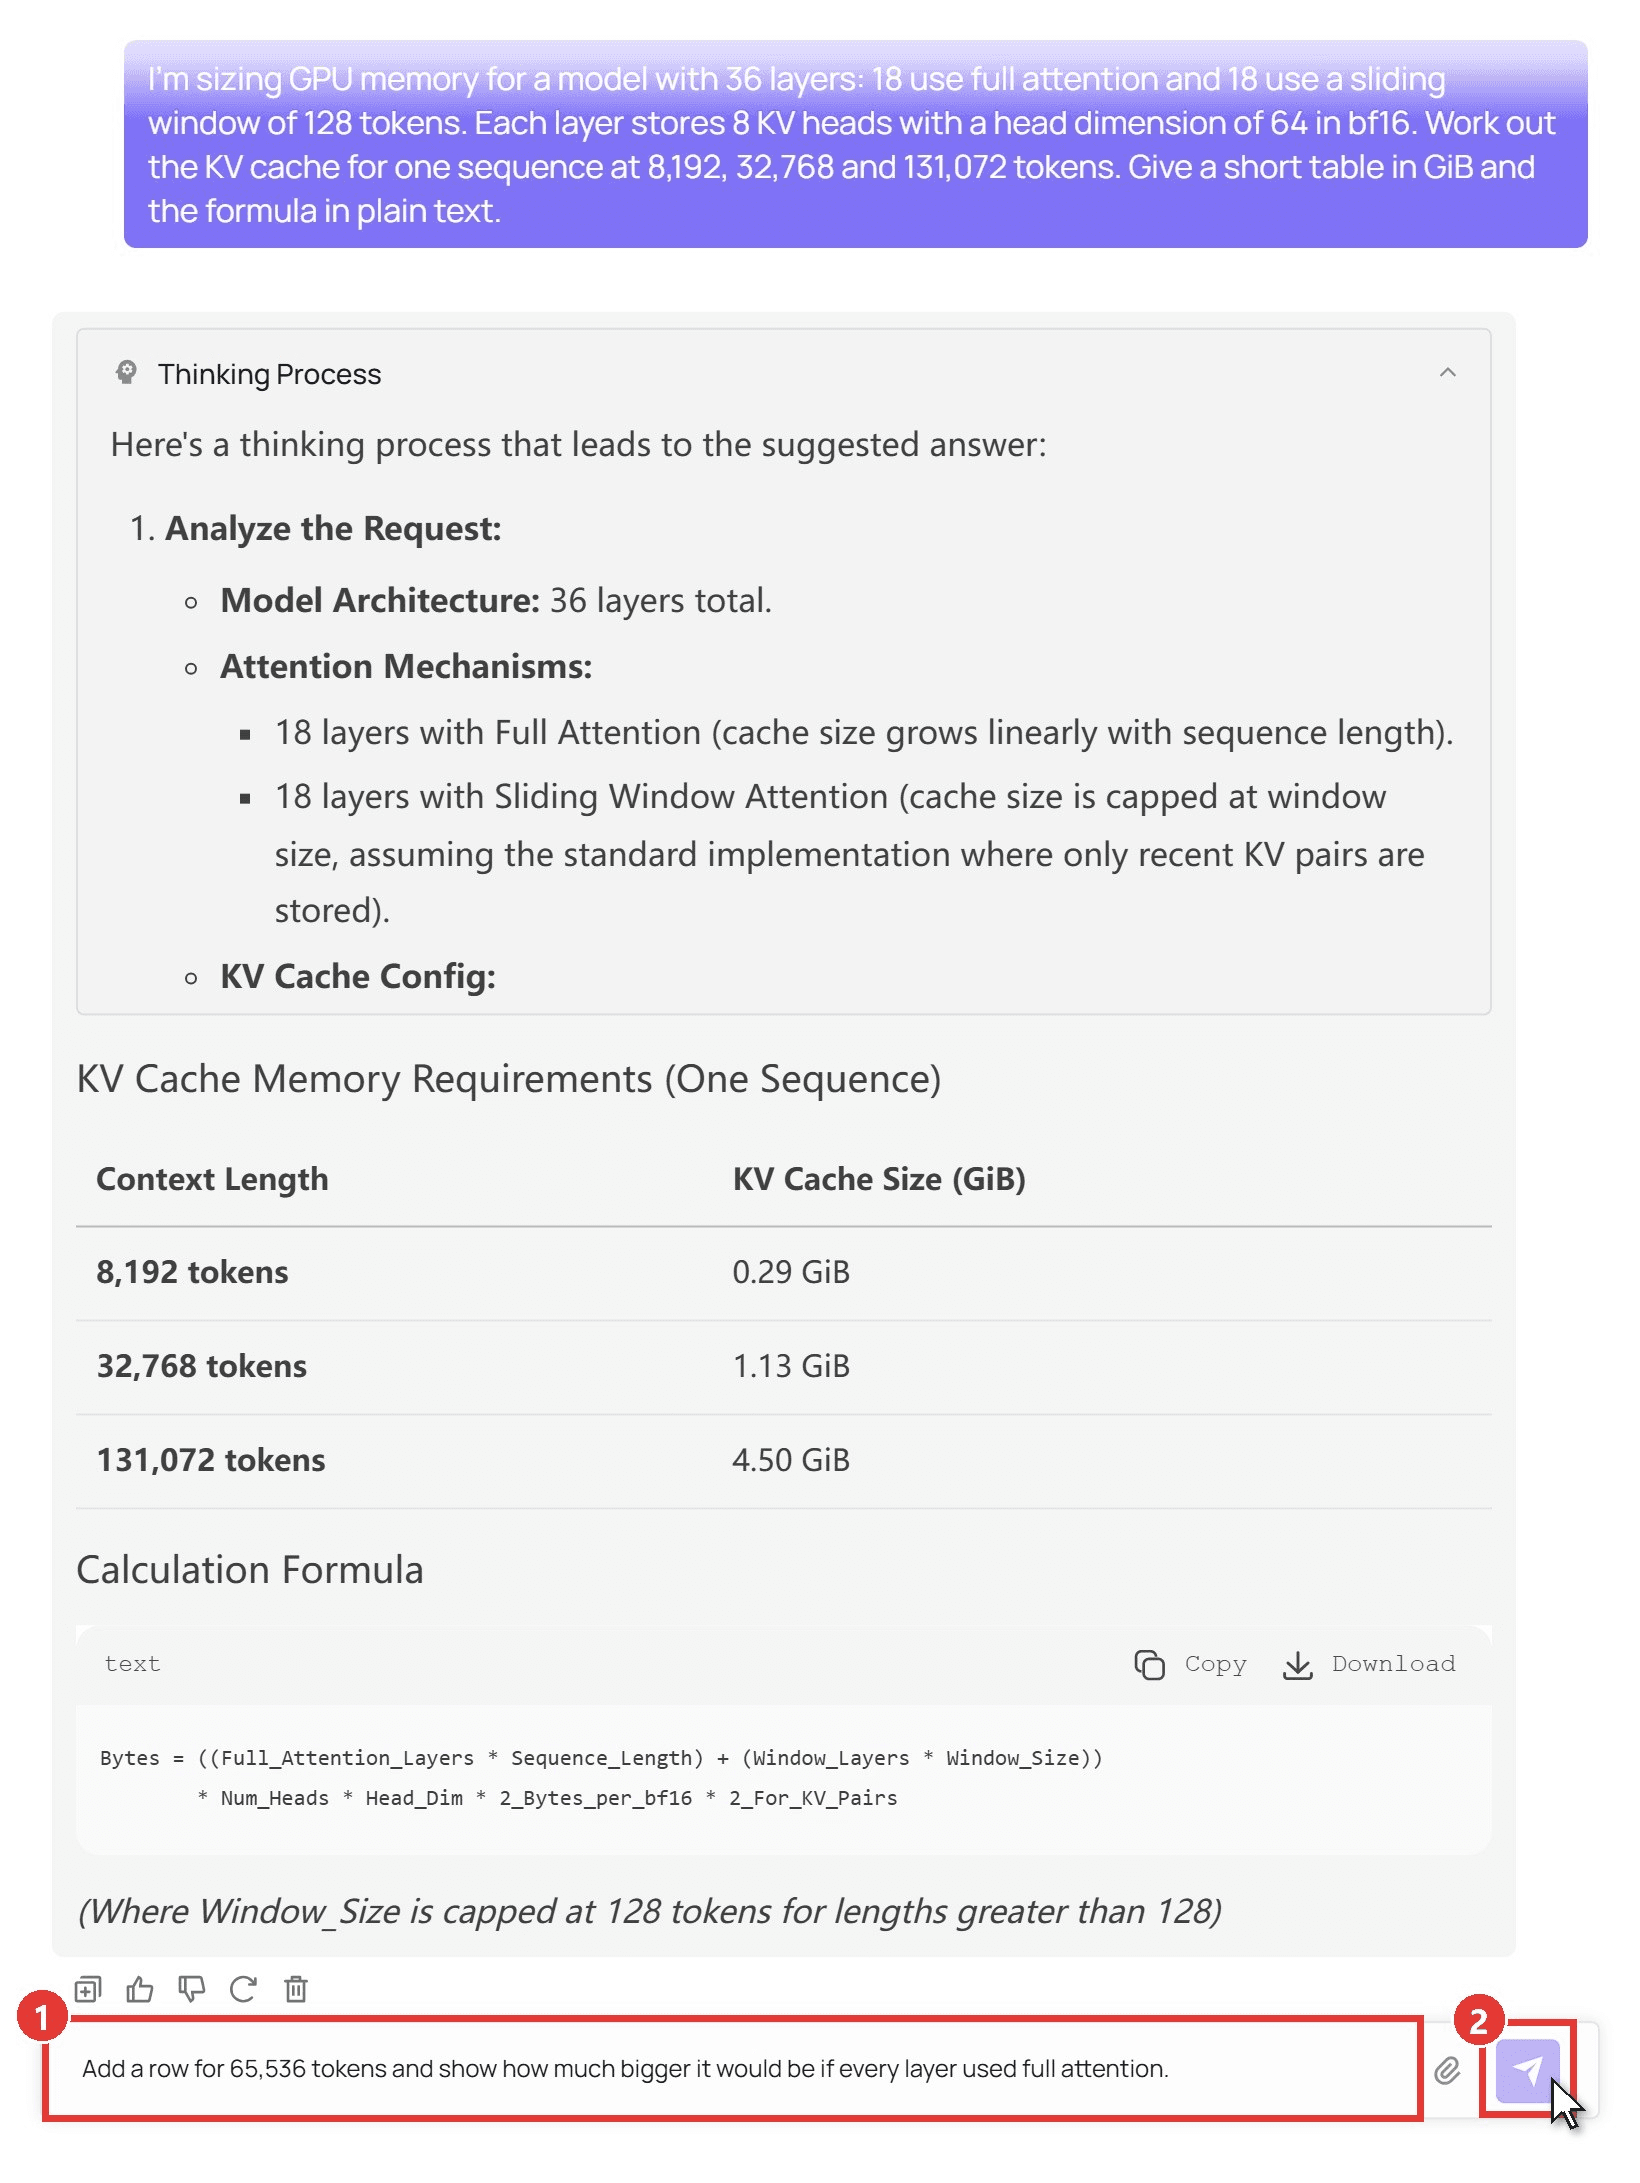
Chúng tôi đưa cho nó bố cục attention từ config gpt-oss và yêu cầu tính KV cache ở ba độ dài. Bảng của nó khớp với phép tính của chúng tôi đến hai chữ số thập phân. Nếu sau này bạn muốn một Qwen cho máy của riêng mình, hướng dẫn của chúng tôi về mô hình Qwen tốt nhất cho lập trình cục bộ sẽ định cỡ chúng theo RAM.
Cách 1: Dùng thử Qwen3.5 122B A10B trong Playground
Đăng nhập và mở playground Qwen3.5 122B A10B, sau đó:
- Nhập câu hỏi của bạn vào hộp tin nhắn.
- Nhấp vào mũi tên gửi. Phần suy luận xuất hiện trong bảng Thinking Process phía trên câu trả lời.
Cách 2: Gọi Qwen3.5 122B A10B bằng API Atlas Cloud
Cho script và ứng dụng:
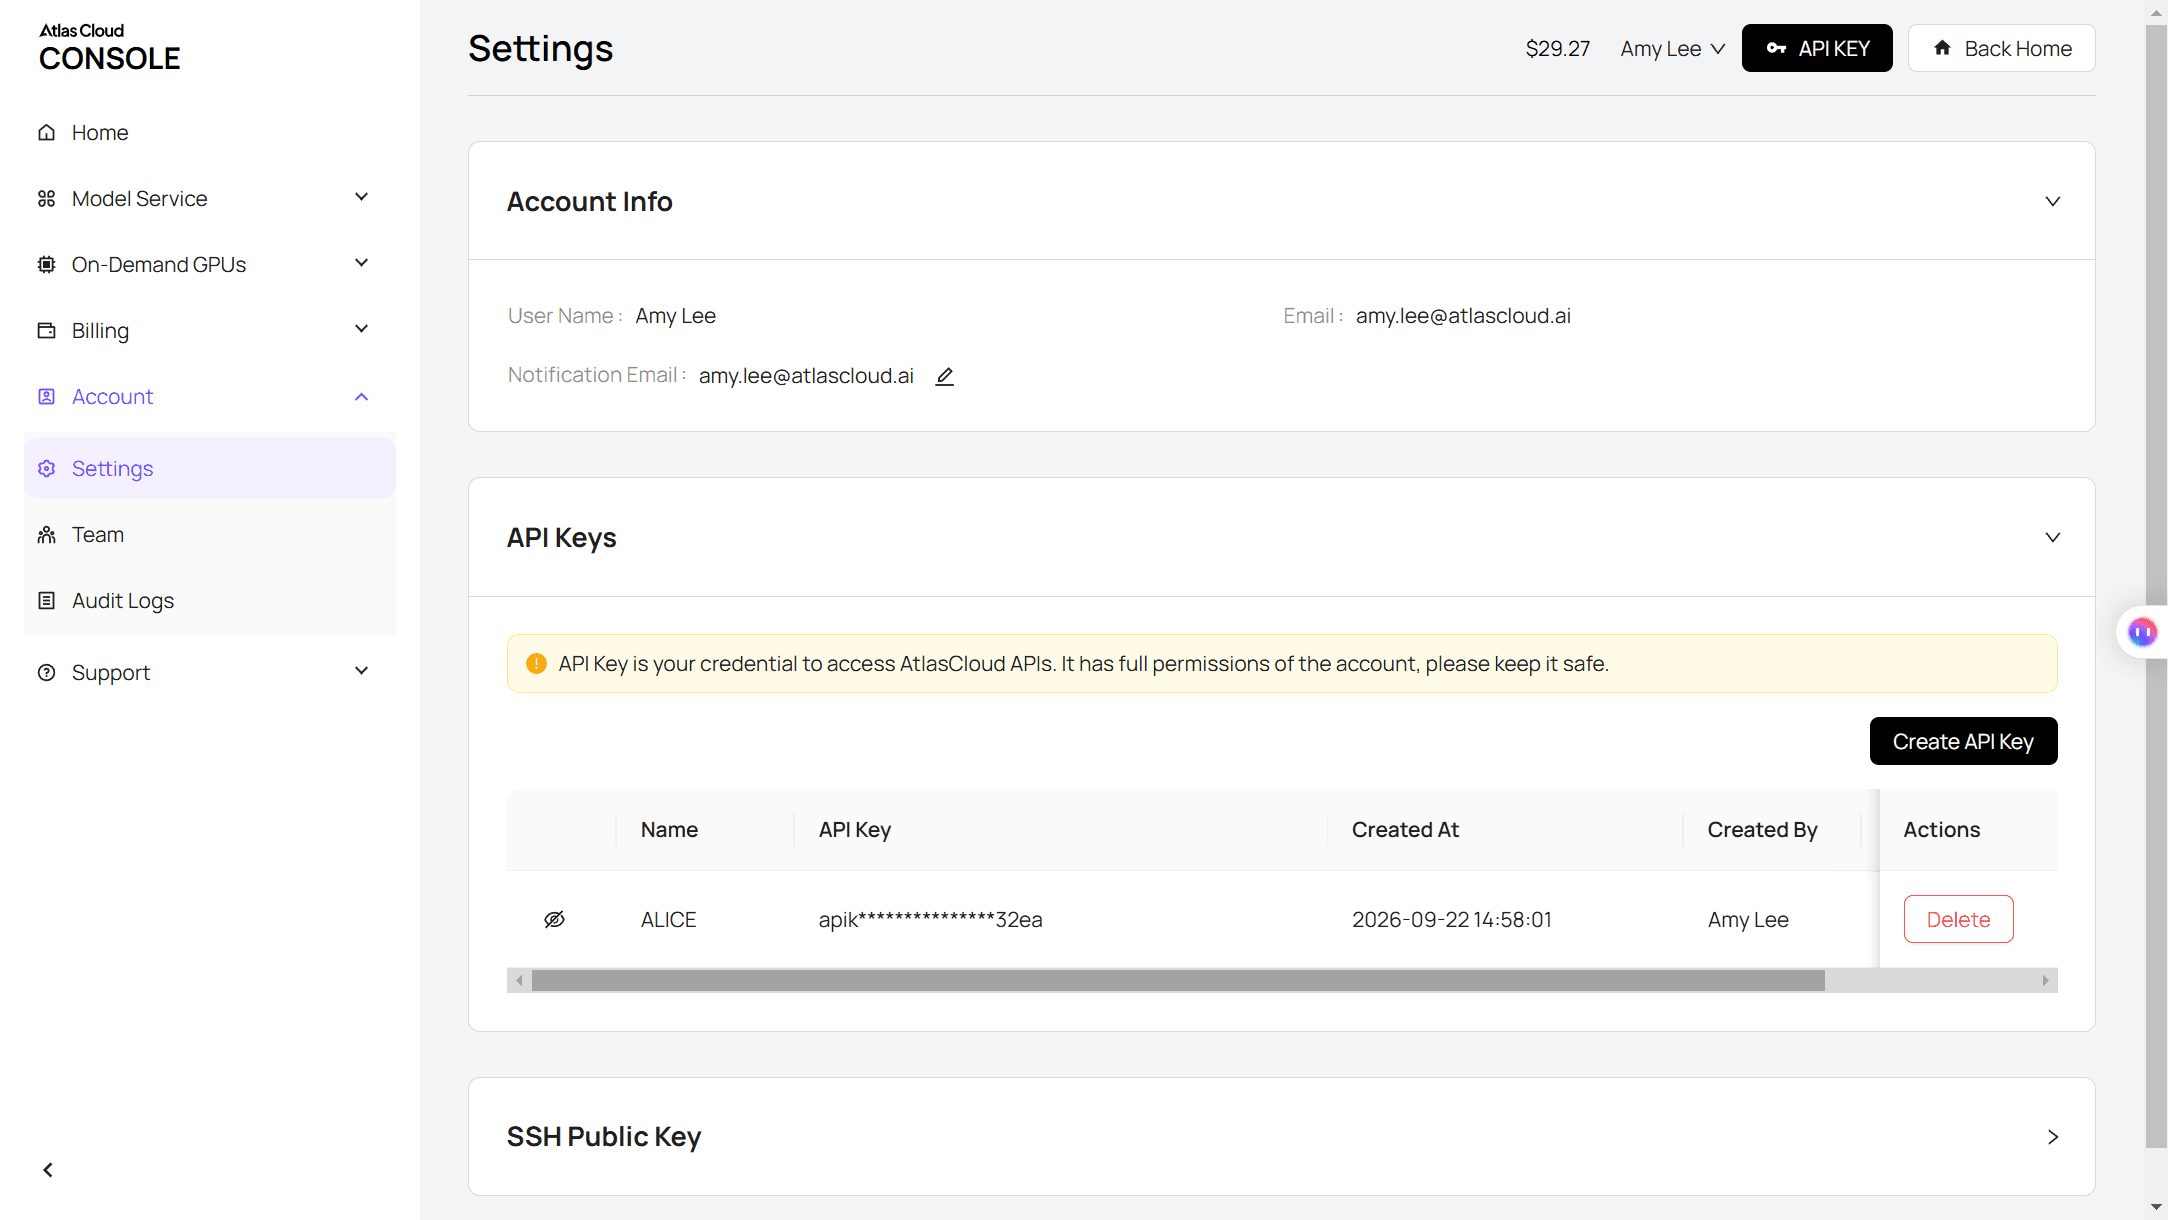
Bước 1: Tạo API key. Mở Settings trong console, vào API Keys, và nhấp Create API Key. Hãy giữ nó ở phía máy chủ.
Bước 2: Kiểm tra định dạng yêu cầu. Tài liệu API đề cập đến định dạng chat completions, và trang mô hình có tab API với ví dụ làm sẵn.
Bước 3: Gửi yêu cầu đầu tiên của bạn.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
Câu trả lời trả về trong choices[0].message.content. Vì endpoint tuân theo định dạng OpenAI, code viết cho máy chủ gpt-oss cục bộ thường chỉ cần base URL, key và chuỗi model mới. Cùng key đó cũng hoạt động với các mô hình chat khác trên nền tảng, như bài viết của chúng tôi về cổng API LLM hợp nhất trình bày chi tiết.
GPT-OSS-120B vs GPT-OSS-20B: Đánh đổi bộ nhớ và benchmark
Phiên bản nhỏ hơn cần một phần năm bộ nhớ. gpt-oss-20b có 20,9B tham số với 3,6B hoạt động, và OpenAI nói nó chạy trên "chỉ từ 16GB bộ nhớ". Câu hỏi là bạn phải đánh đổi điều gì.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Bộ nhớ tại ngữ cảnh 8K (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (không công cụ) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (không công cụ) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
Điểm số đến từ thẻ mô hình ở mức reasoning effort cao. Khoảng cách lập trình dưới hai điểm trên SWE-Bench Verified, trong khi khoảng cách kiến thức khoảng 9 điểm ở khoa học trình độ sau đại học và 15 điểm trên HealthBench. Nếu chủ yếu là code trên card 16GB đến 24GB, 20b là lựa chọn hợp lý. Cần thêm kiến thức? Đó là lúc 120b xứng đáng với hóa đơn bộ nhớ của nó.
GGUF, Ollama hay vLLM: Chọn runtime cho ngân sách bộ nhớ của bạn
Mỗi lựa chọn chạy trọng số MXFP4 mà OpenAI phát hành; chúng khác nhau ở chỗ trọng số đó có thể nằm ở đâu.
| Runtime | Tải xuống | Phù hợp nhất |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Một người dùng trên máy chứa được toàn bộ mô hình |
| LM Studio | 65 GB | Ứng dụng desktop trên Mac hoặc PC Windows |
| llama.cpp (ggml-org GGUF) | Khoảng 63 GB | Dưới 65 GB VRAM, với các lớp expert được offload sang RAM |
| vLLM | Khoảng 65 GB safetensors | Phục vụ nhiều người dùng từ một hoặc nhiều GPU trung tâm dữ liệu |
Để bắt đầu nhanh trên máy có bộ nhớ lớn:
plaintext1ollama run gpt-oss:120b
Với GPU nhỏ hơn, dùng llama.cpp và tinh chỉnh số lượng offload:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Cả bốn đều xử lý định dạng chat harmony của OpenAI, thứ mà mô hình cần để hoạt động đúng. Điều này chỉ quan trọng nếu bạn tự viết code phục vụ.
Câu hỏi thường gặp
GPT-OSS-120B có tốt hơn GPT-5 hay Gemini 3 Pro không?
Chúng nằm ở các hạng mục khác nhau: GPT-5 và Gemini là mô hình đóng mà bạn truy cập qua ứng dụng hoặc API, còn gpt-oss-120b chạy trên phần cứng của riêng bạn. Gemini 3 Pro Preview cũng đã bị ngừng vào ngày 9 tháng 3 năm 2026, và tên của nó giờ trỏ đến Gemini 3.1 Pro Preview. Nếu khả năng kiểm soát cục bộ quan trọng, dòng trọng số mở của Google là gia đình Gemma 4.
Tại sao một số trang nói GPT-OSS-120B cần 255 GB?
Những con số đó giả định trọng số 16-bit: khoảng 117B tham số nhân 2 byte, cộng thêm chi phí phụ trợ. Checkpoint OpenAI phát hành đã là MXFP4, nên dung lượng tải xuống thực tế nằm trong khoảng 61 GB.
Reasoning effort có thay đổi mức sử dụng bộ nhớ không?
Không thay đổi đối với trọng số. Các cài đặt low, medium và high thay đổi thời gian mô hình suy nghĩ. Mức high viết nhiều token suy luận hơn, làm đầy cửa sổ ngữ cảnh và tăng KV cache, nên các phiên dài sẽ dần tiến tới tổng lớn hơn trong biểu đồ ở trên.
Tại sao mọi người nói GPT-OSS-120B gặp khó khăn với game dạng văn bản?
Bằng chứng chỉ mang tính giai thoại. Trên trang thảo luận Hugging Face của mô hình, một số người dùng báo cáo bị từ chối khi viết tiểu thuyết bạo lực, trong khi những người khác nói nhập vai vẫn hoạt động tốt. Với tiểu thuyết tương tác, hãy thử prompt của riêng bạn trước khi mua phần cứng cho nó.
Một mô hình lớp 120B được host có giá bao nhiêu?
Tính đến tháng 10 năm 2026, Qwen3.5 122B A10B có giá $0.3 mỗi triệu token đầu vào và $2.4 mỗi triệu token đầu ra trên Atlas Cloud. Đó là mức giảm giá 25% so với mức giá thông thường $0.4 và $3.2. Câu hỏi định cỡ của chúng tôi dùng khoảng 5.000 token đầu ra sau khi tính cả phần suy luận, tức khoảng một xu ở mức giá đã giảm.
Kết luận
GPT-OSS-120B dễ vừa hơn so với số lượng tham số của nó gợi ý. Hãy tính khoảng 65 GB ở các độ dài ngữ cảnh thường ngày và dưới 70 GB ở mức đầy đủ 131K. Một GPU 80GB, một Mac có hơn 96GB, hoặc một mini PC 128GB sẽ chứa được nó, và các card nhỏ hơn có thể chạy nó bằng cách chuyển các lớp expert vào RAM hệ thống.
Nếu những con số đó loại trừ máy của bạn, hãy hạ xuống gpt-oss-20b cho công việc chủ yếu là lập trình, hoặc gọi một mô hình trọng số mở được host khi bạn cần bộ não lớn hơn mà không phải mua phần cứng. Dù thế nào, yêu cầu bộ nhớ gpt oss 120b không còn là trò đoán mò khi bạn biết trọng số chiếm 61 GB và phần còn lại là khoảng dự phòng.


