MiniMax 在週五發布了 H3。二十四小時內,Seedance 2.5 就已送到人們手中,時間軸因此縮成一個話題:三十秒、原生 4K、五十個參考輸入。H3 的發布貼文靜靜躺在下方,幾乎沒人真正對它進行測試。
我懂為什麼。三十秒是個很棒的數字。適合放在標題裡。
但如果你真的在製作垂直短劇,你會知道毀掉你夜晚的不是第三十秒,而是第四個鏡頭。男主角的下巴線條偏移了半公分,他的領巾少了一個褶,觀眾在鉤子落地之前就滑走了。沒有人因為一段影片只有十五秒而不是三十秒就流失。他們流失,是因為特寫裡的那個人,不是全景裡的那個人。
所以我跳過了規格表的對決。我製作了一張角色轉面圖、一塊六格場景板,寫了一段十五秒的哥德式短劇提示詞,然後把一模一樣的套件發給兩邊。接著,我盯著那張臉看。
關鍵要點
- 目前只有 H3 可呼叫 — Seedance 2.5 的 API 在字節跳動上線了,但在這個平台上仍是 Day-0 頁面。
- 規格清楚分開: Seedance 2.5 = 一次生成 30 秒、原生 4K、最多 50 個參考;H3 = 5–15 秒、2K、每個片段都有立體聲。
- 角色穩定性是包裝問題 — 一張好的參考包,而不是更大的模型,才能留住那張臉。
- 兩者都能生成原生音訊; H3 還能從最多三個音訊參考中固定一個聲音。
- 以每幀畫素來判斷,而不是秒數 — 在同一輪測試中,H3 輸出 1440p,而 Seedance 是 720p。
在理論之前,Seedance 2.5 與 MiniMax H3 的結果
在理論之前,以下是這個工作流程產出的結果。這是從一段完成的 15 秒垂直片段中擷取的四個鏡頭,並排版在一起。這是 MiniMax 自己的 H3 參考執行結果,完全使用你在步驟 1 和步驟 2 中看到的角色表和場景板,以原生 1440x2560 解析度輸出。我之後在教學中會展示我使用相同套件的執行結果,並顯示遊樂場的狀態。
她走到雕花門前,那是場景板中的第 4 格,接著是走廊對峙,然後是他緊湊的特寫,最後是雙人鏡頭。他的髮際線在側面和特寫中都以相同方式分開。她的半盤辮冠在整個臉部特寫中完好無損,而這正是大多數模型會悄悄重建臉部的地方。奶油色蕾絲緊身胸衣從第一幀到最後一幀都保持著相同的領口和袖口。
這就是整個測試。不是三十秒。而是四個鏡頭和一個下巴線條。
為什麼 Seedance 2.5 與 MiniMax H3 在同一週發布,以及為什麼大多數角色測試毫無用處
MiniMax 於 7 月 30 日發布了 H3,這是一個通用多模態影片模型,可將文字、圖像、影片和音訊作為一個上下文讀取,並以高達 2K 的原生立體聲返回 5 到 15 秒的片段。它還能編輯現有素材,並將動作從一個片段轉移到另一個片段,而 MiniMax 表示權重將在幾天內發布(Reuters,2026 年 7 月)。
Seedance 2.5 在同一時間窗口內登場,帶來了更響亮的數字:一次生成 30 秒、原生 4K,以及一次作業中最多 50 個多模態參考輸入(The Next Web,2026 年 7 月)。其 API 已在開發者手中,具備局部編輯功能,可重繪畫面的一部分,同時保持表演、燈光和攝影機行為不變;參考轉影片功能可接受綠幕或 3D 白色模型塊狀圖;支援十一種語言,以及實驗性的長影片模式,可達 180 秒(CineD,2026 年 7 月)。
注意力差距是很有趣的部分。我幾乎能找到的每一篇貼文都是 2.5 的片段。然而,公開競技場的數字卻說明了另一件事:在 Artificial Analysis 的圖像轉影片排行榜上,Seedance 2.0 在 720p 解析度下以 1,196 Elo 領先,Gemini Omni Flash 以 1,195 緊隨其後,而 MiniMax H3 在發布僅四天後,就以 1,185 分位居第三。Seedance 2.5 在那裡還沒有評分(Artificial Analysis,2026 年 7 月)。獲得最少關注的模型,正是分數與關注度比率最高的那一個。
現在來說說真正決定你輸出結果的部分,因為這幾乎與你選擇哪個標誌無關。
大多數角色一致性測試在模型參與之前就已失敗。四個失敗模式,而這四個都歸你管:
| 失敗模式 | 你在輸出中看到的結果 | 修正方法 |
|---|---|---|
| 將多視角參考作為分開的檔案發送 | 每個鏡頭的臉都「差不多對」,但沒有一張彼此一致 | 將這些視角組合成一張圖像,然後在提示詞中分配角色(「左邊的男人」、「右邊的女人」) |
| 為每個鏡頭重寫角色描述 | 服裝和配件在鏡頭間飄移 | 寫一次身份描述區塊,然後逐字重複使用;每個鏡頭只變更攝影機和動作 |
| 讓燈光隨場景移動 | 臉部在新燈光下被結構性地重建 | 建立一個單獨的場景板,鎖定光線方向、霧氣和地板反射,並將其作為參考輸入 |
| 將最大時長視為品質指標 | 一個 30 秒內的飄移毀掉全部 30 秒 | 將內容切割到你可以重新生成的粒度,然後再談論長度 |
想親自將 Seedance 2.5 和 MiniMax H3 放在同一個提示詞前嗎?Atlas Cloud 的模型比較工具 可以在一次操作中並排運行它們 — 相同的提示詞和設定,並在生成前預估成本 — 讓你可以判斷臉部、動作和螢幕上的文字,而無需預約兩次測試。
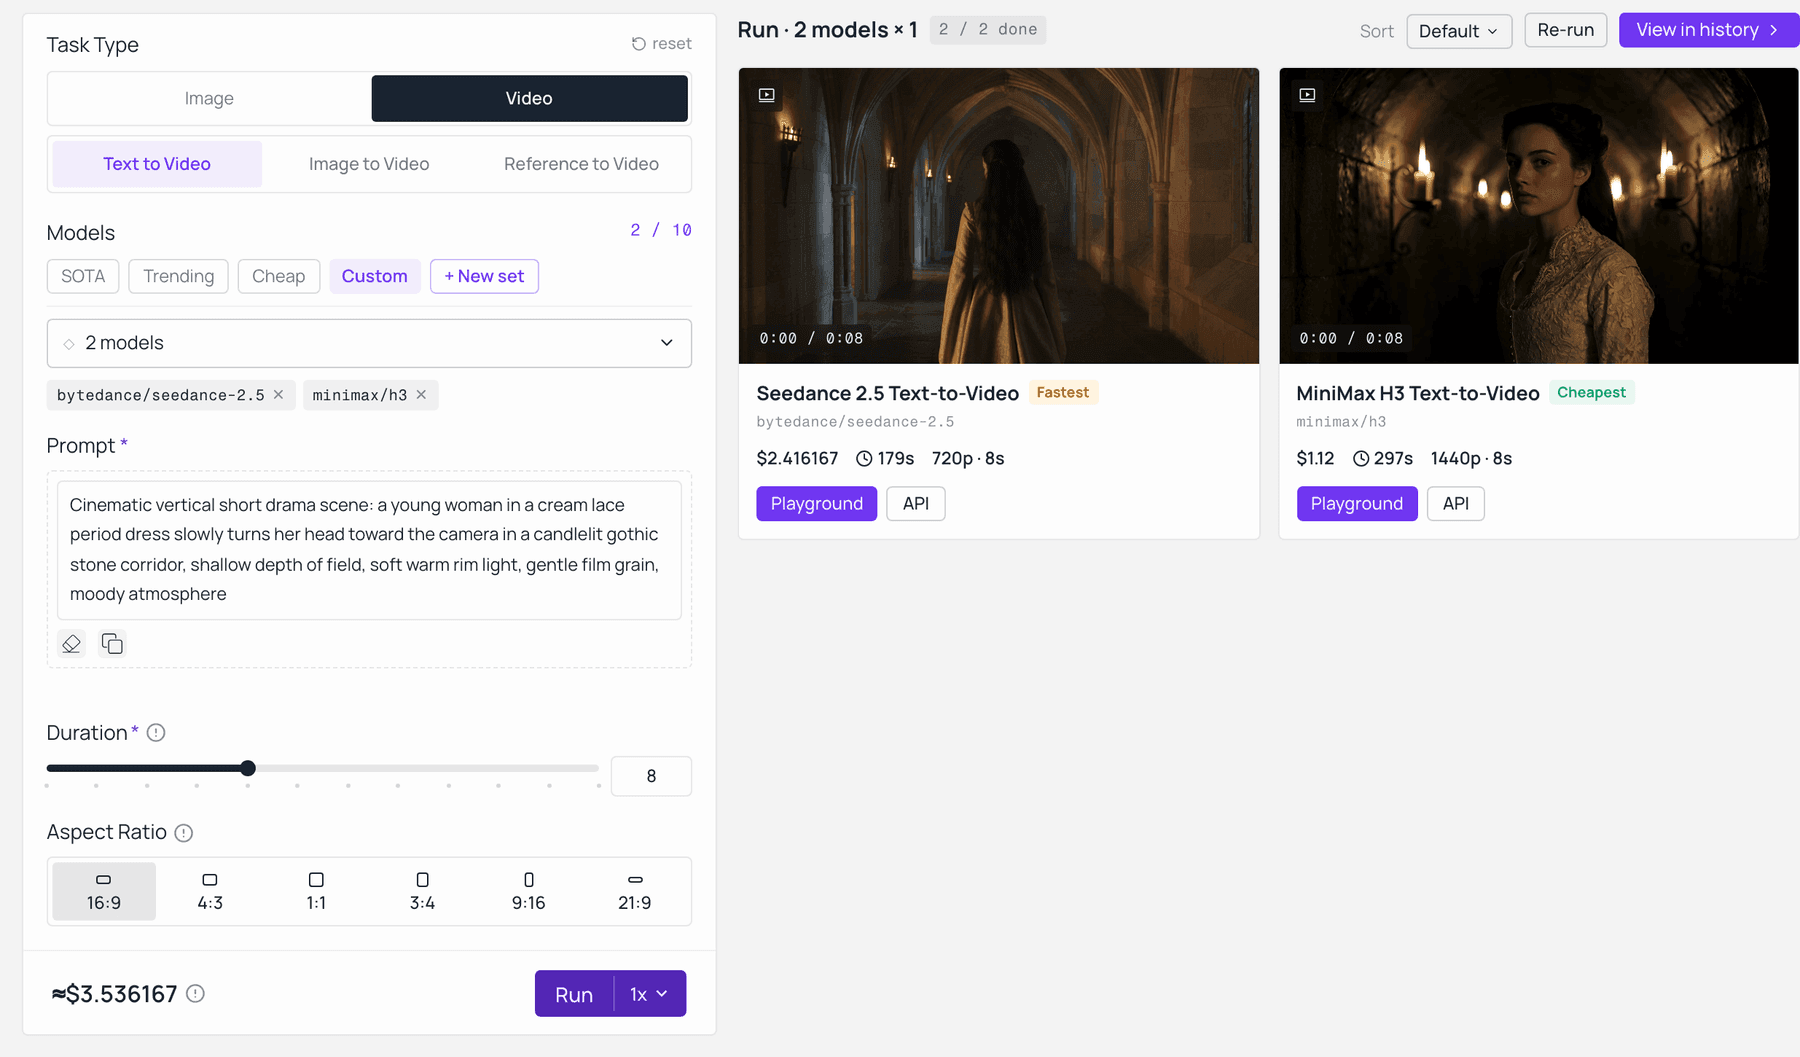
在 Atlas Cloud 的模型比較中,使用相同提示詞的 Seedance 2.5 和 MiniMax H3。Seedance 2.5 返回 720p,價格 $2.42;MiniMax H3 返回 1440p,價格 $1.12,兩者價格均在運行前預估。在模型探索器上即時擷取。
第一行是人們最容易搞錯的。發送六張單視角圖像,模型會將它們視為六個候選人並取平均。發送一張乾淨的合成圖,它會將其視為從三個角度看到的同一個人。相同的畫素,完全不同的結果。
Seedance 2.5 與 MiniMax H3 規格表,以及你今天實際上可以呼叫什麼
將能力與可用性分開,緊張關係就會變得清晰。就原始能力而言,Seedance 2.5 在時長、解析度上限、參考數量以及編輯粒度上領先。就可用性而言,H3 是這個週在通用多模態模型平台上擁有三個即時端點的模型。如果你正在為 2026 年的規劃進行 AI 影片模型比較,那麼第二欄和第一欄同等重要。
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 參考轉影片(我執行的項目) | |
|---|---|---|---|
| 一次生成的最大長度 | 5 至 15 秒 | 最多 30 秒,無需拼接(測試版模式可達 180 秒,實驗性) | 短片段選單,請參閱模型頁面 |
| 解析度 | 原生 2K,16:9 至 9:16 的短邊為 1440p;列出 768p 層級即將推出 | 原生 4K,10 位元色彩 | 在此端點上最高 720p |
| 幀率 | 24 fps | 未單獨公佈 | 未單獨公佈 |
| 參考輸入 | 9 張圖片 + 3 段影片 + 3 段音訊,共 12 個檔案 | 最多 50 個多模態參考 | 9 張圖片 + 3 段影片 + 3 段音訊 |
| 原生音訊 | 有,每個輸出都有,立體聲 | 有,另加 11 種字幕和語音語言 | 有 |
| 編輯粒度 | 整段片段指令編輯(替換角色、背景、燈光、對話) | 區域級編輯,可重繪幀的一部分 | 整段片段指令編輯 |
| 提示詞上限 | 7,000 個字元 | 未公佈 | 未公佈 |
| 開放權重 | 發布後數天內已宣布 | 未宣布 | 未宣布 |
| Artificial Analysis I2V Elo,2026 年 7 月 31 日 | 1,185(第 3 名) | 尚未評級 | 1,196(第 1 名,Dreamina 720p 項目) |
| 在我測試的平台上的可呼叫性 | 有,3 個端點 | 尚未,Day-0 頁面 | 有 |
關於測試設定的完整揭露。 我執行此測試時,Seedance 2.5 在我使用的平台上尚未開放,因此 Seedance 方面的測試是 Seedance 2.0 參考轉影片,這是同一家族中目前正在出貨的成員,具有相同的四模態參考系統。在 2.5 會改變答案的地方,我會說明。Seedance 2.5 頁面 目前是 Day-0 通知。
以下所有內容都在一個瀏覽器分頁中執行,使用一個金鑰,總共三個模型:
| 步驟 | 模型 | 產出內容 | 關鍵設定 | 成本驅動因素 |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 文字轉圖像 | 角色轉面圖 | 品質高,16:9 | 每張圖片,按用量付費,當前費率在模型頁面上 |
| 2 | 相同模型,第二次執行 | 六格場景及燈光板 | 品質高,16:9 | 每張圖片,按用量付費 |
| 3 | MiniMax H3 參考轉影片 | 帶原生音訊的 9:16 片段 | 9:16,2K,測試用時長 5,正式剪輯用時長 15 | 秒數 x 解析度,按秒計費 |
| 4 | Seedance 2.0 參考轉影片 | 對照執行,相同輸入 | 9:16,最高可用解析度,相同時長 | 秒數 x 解析度,按秒計費 |
| 5 | H3 參考轉影片,以片段作為輸入 | 修正一個鏡頭,無需重新生成整個片段 | 相同解析度,短時長 | 秒數 x 解析度,按秒計費 |
H3 也有文字轉影片和圖像轉影片的入口,如果你想要純文字基準或首尾幀控制的話。
在規劃批次之前,還有一件事值得知道:螢幕上的文字。這個 15 秒的 H3 標題序列在八次硬切中保持英文字幕完整,沒有出現任何拼寫錯誤,這是在生成影片中最難保持穩定的項目之一。
Seedance 2.5 與 MiniMax H3 短劇工作流程,逐步說明
五個步驟。完全按照所寫的提示詞複製,包括那些看起來不美觀的部分。我沒有為了文章而清理它們,你也不應該為了模型而清理它們。
步驟 1:使用 GPT Image 2 建立角色表
在你製作任何影片之前,先建立參考包。一張圖像,兩個角色,每個角色三個視角,純白色無縫背景,均勻的攝影棚燈光。這消除了除了你關心的那個問題之外的所有歧義:這個人長什麼樣子。
plaintext1一張全身角色轉面參考表,背景為純白色無縫背景,兩個角色並排,總共六個人物,均勻中性的攝影棚燈光,地板上沒有陰影,沒有文字,沒有標籤,沒有浮水印。 2 3左半邊,男主角,三個視角排成一列:正面、右側面、背面。二十多歲,蒼白膚色,深色波浪中長髮,尖銳的下巴線條。穿著一件長及地板的黑色天鵝絨大衣,衣領和袖口有低調的同色系刺繡,一件黑色錦緞背心,一條黑色絲綢領巾,直筒黑色長褲,拋光黑色皮革德比鞋。雙臂放鬆垂於身體兩側,中性表情。 4 5右半邊,女主角,三個視角排成一列:正面、右側面、背面。二十歲出頭,白皙膚色,長波浪栗色頭髮,帶有半盤辮冠。穿著一件奶油色維多利亞時代棉質蕾絲連衣裙,長袖帶蕾絲袖口,合身緊身胸衣配小紐扣,全長及踝裙,奶油色踝帶低跟鞋。雙臂放鬆垂於身體兩側,中性表情。 6 7攝影寫實風格,所有六個人物比例一致,腳部在同一基準線上對齊,從邊緣到邊緣清晰對焦。
設定: 模型 OpenAI GPT Image 2 文字轉圖像,品質高,長寬比 16:9,其餘預設。
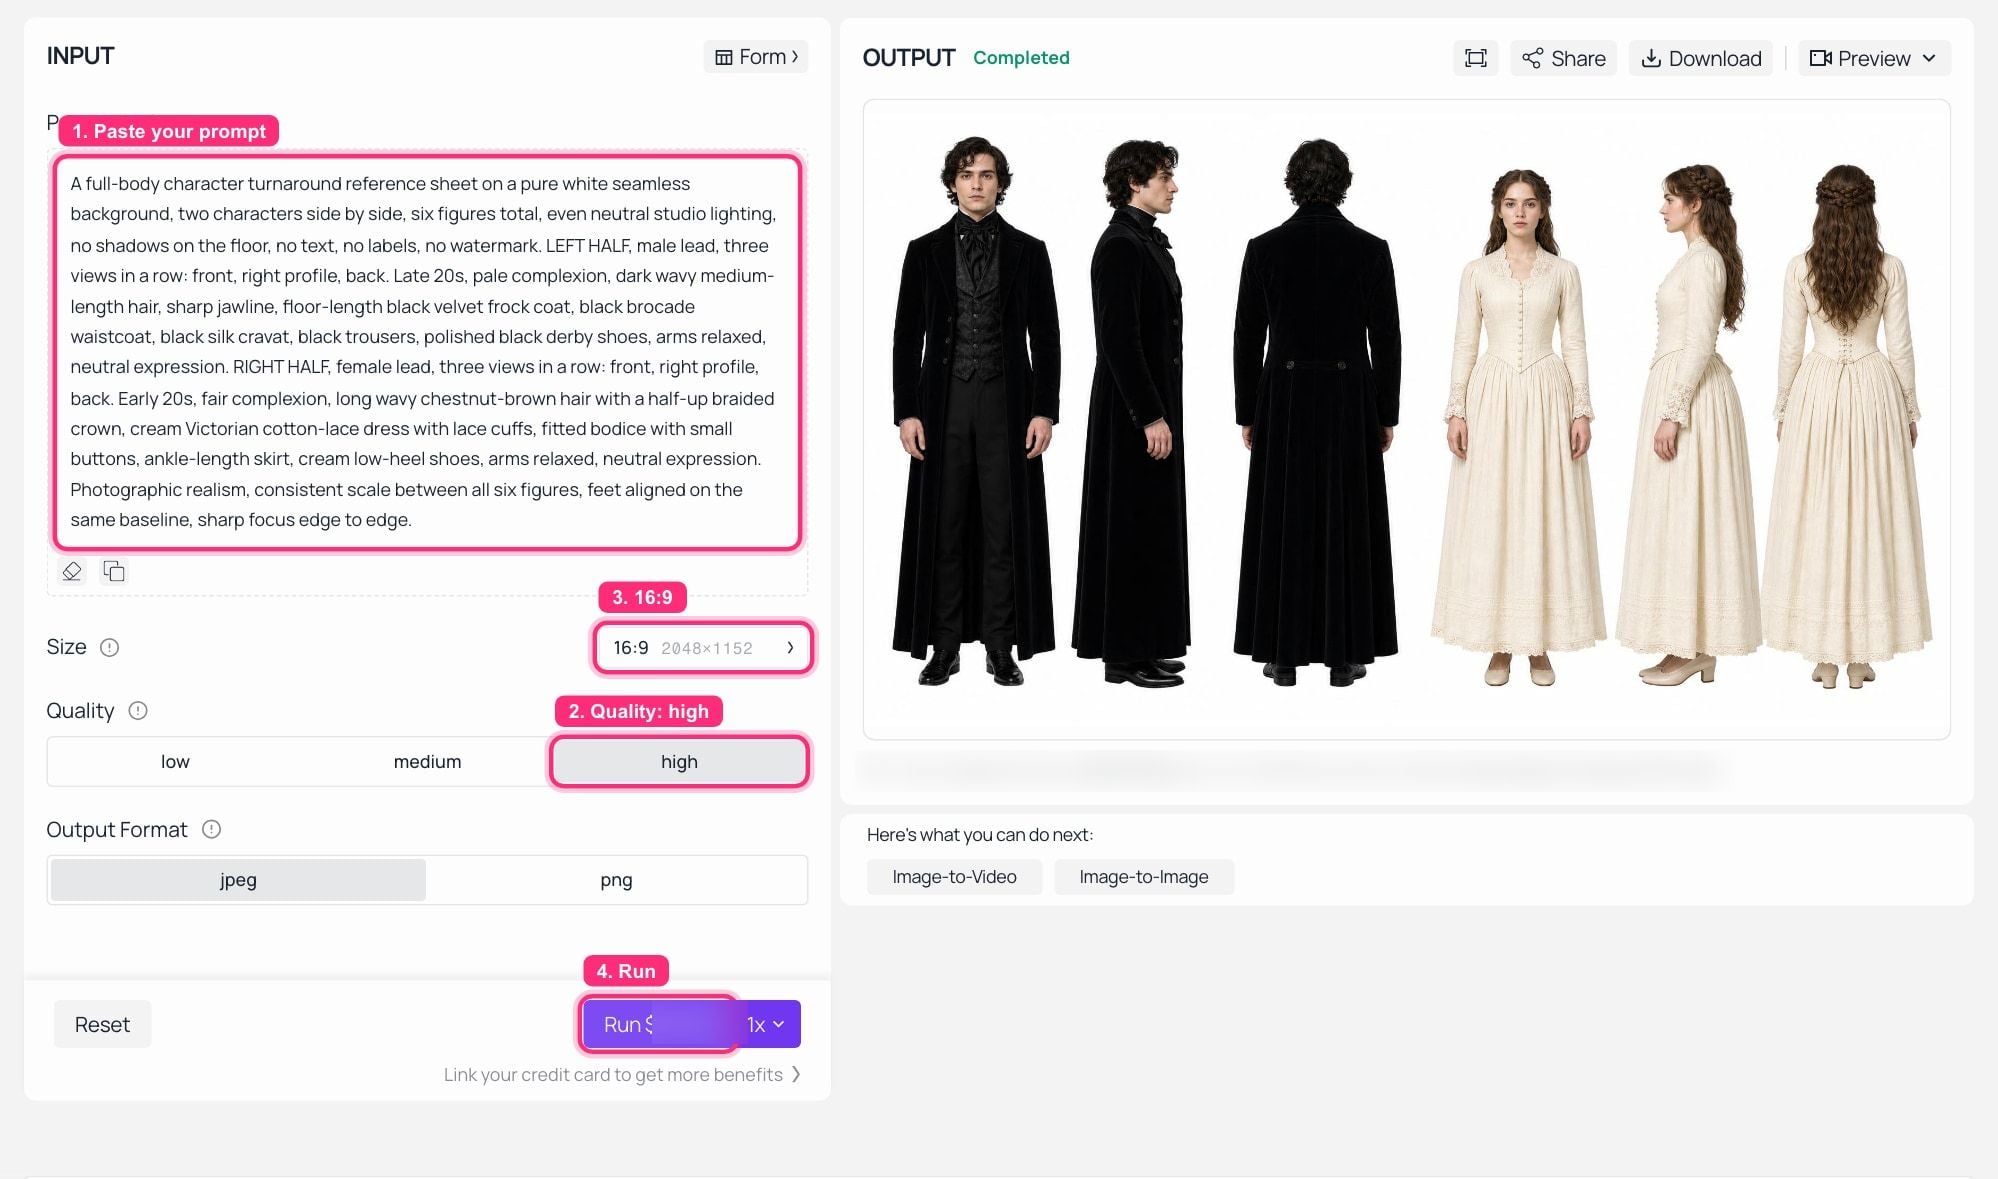 在 Atlas Cloud 上的 GPT Image 2 文字轉圖像,執行完成:左側的轉面提示詞,右側 OUTPUT 面板中一張白色紙上的六個人物。
這是目標形狀。六個人物,一個基準線,背景中沒有任何可以爭論的東西:
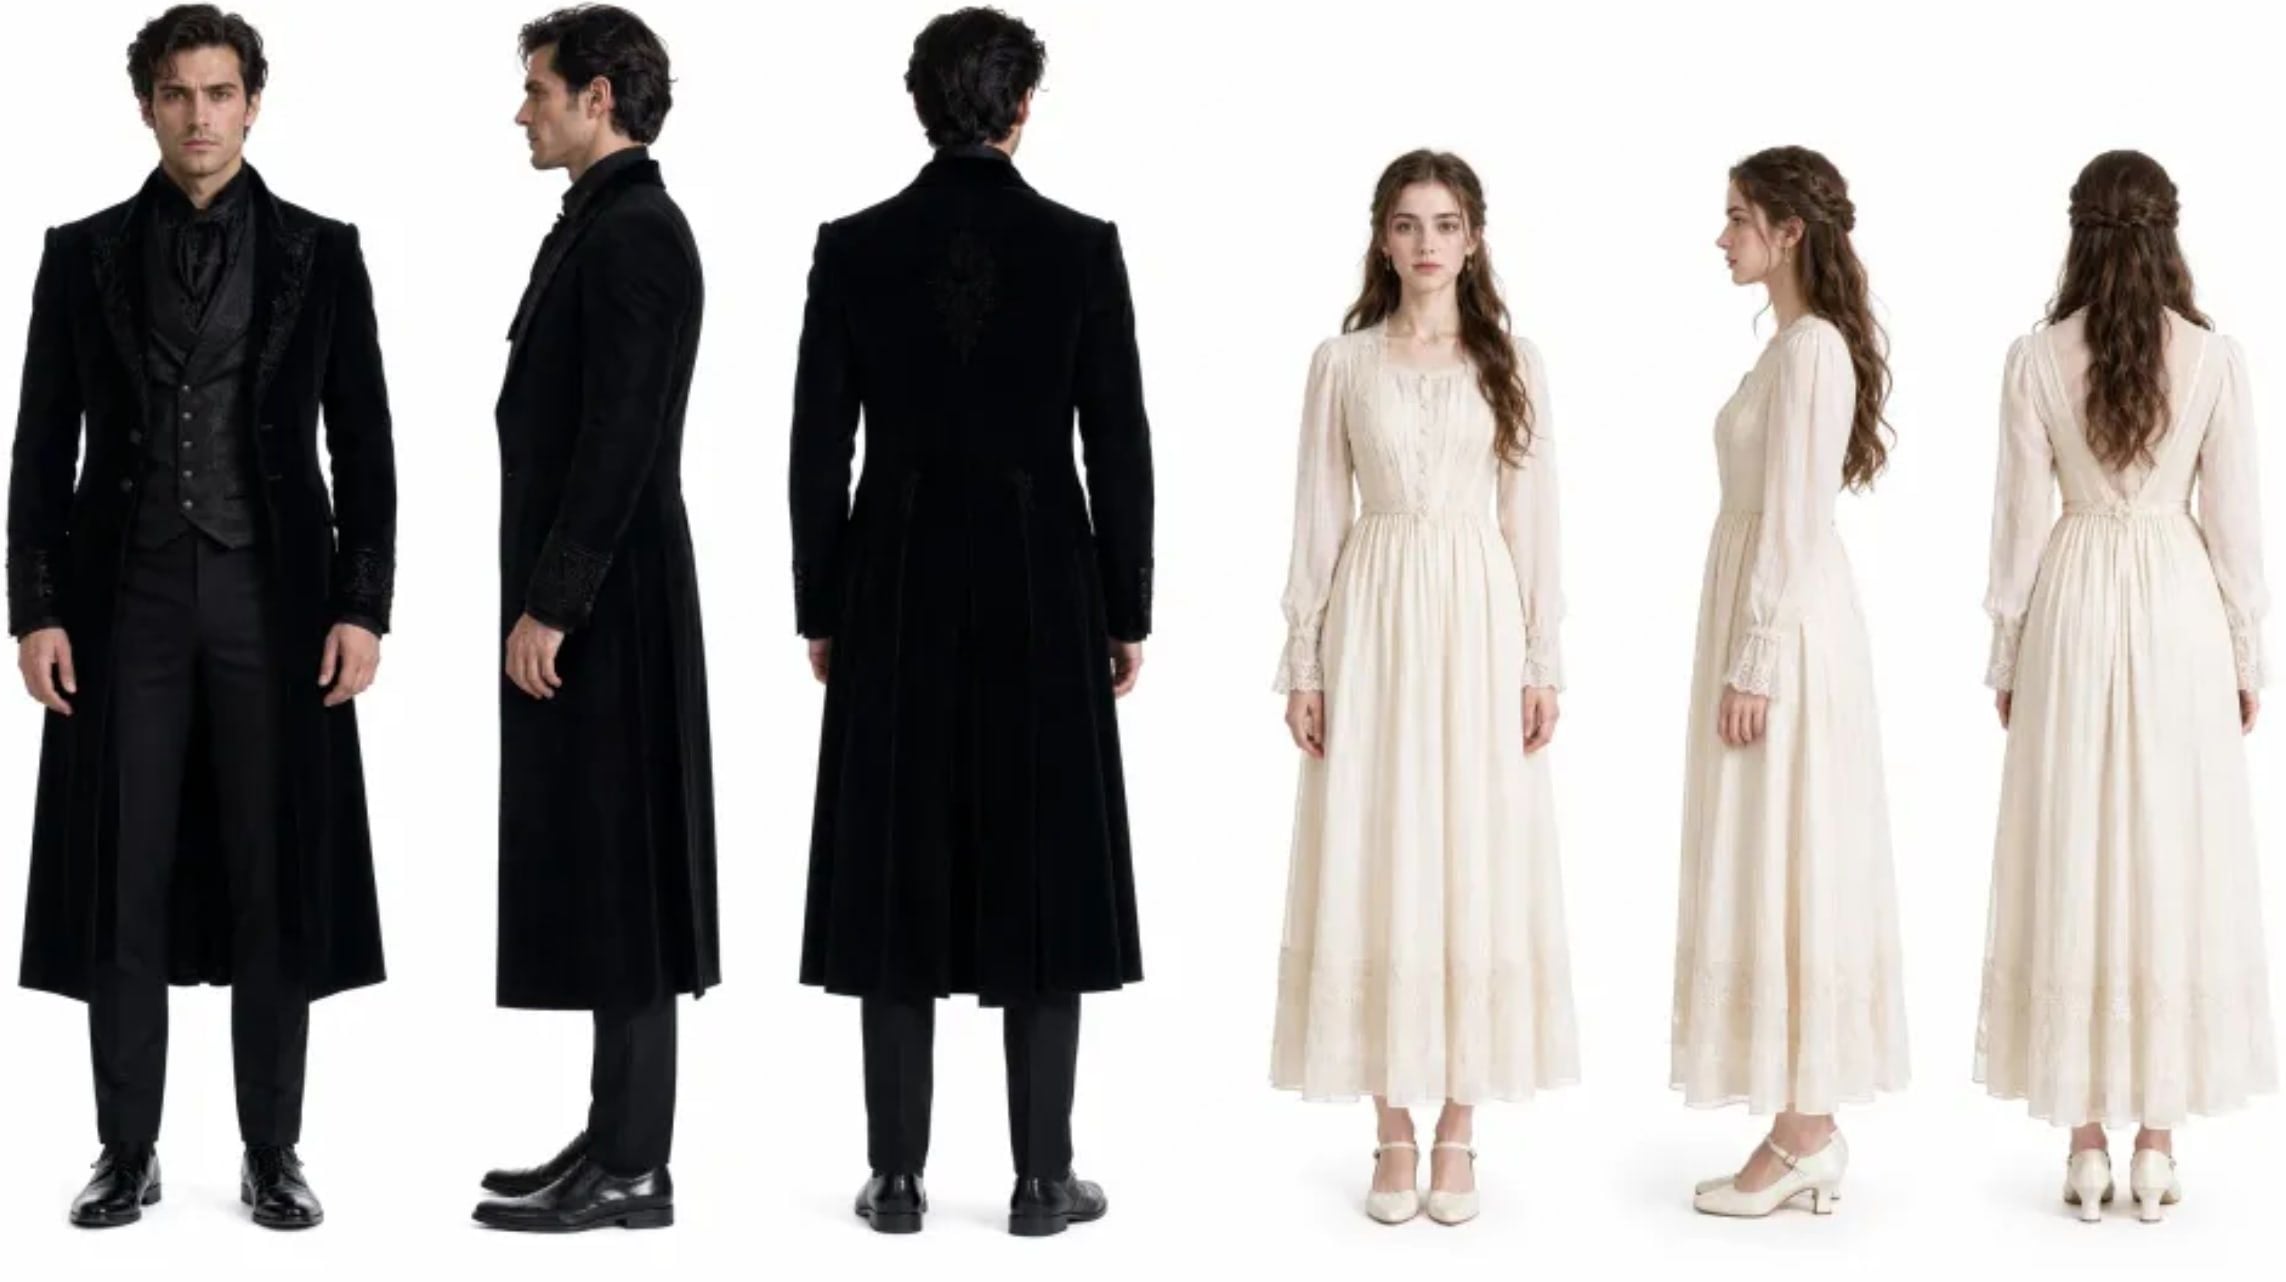 驅動示範片段的參考包:男主角穿黑色天鵝絨,女主角穿奶油色維多利亞蕾絲,三個視角各一個,一個檔案。
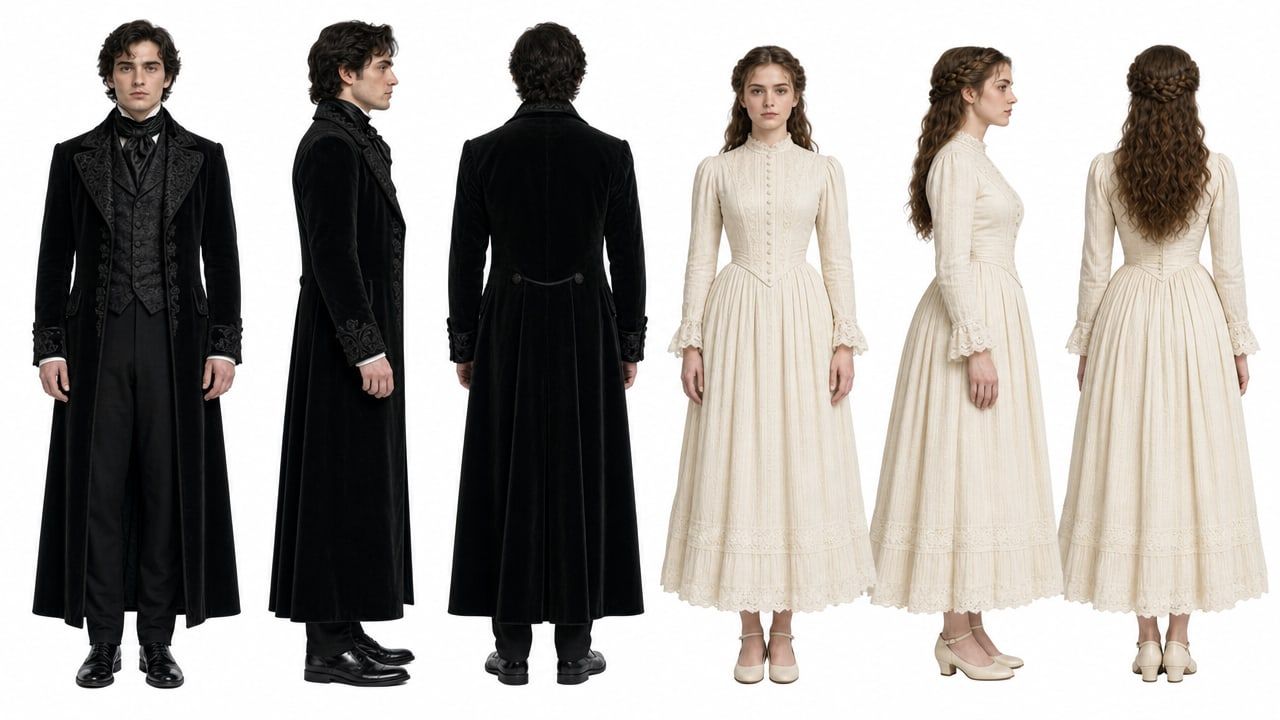 我自己執行的步驟 1 提示詞的 GPT Image 2 結果,與上方參考進行比較。
步驟 2:用六格場景板鎖定地點
你固定住了臉。但燈光仍然會背叛你。第二張參考圖像固定了六個攝影機位置、月光的方向、空氣中的霧氣量以及地板的潮濕程度。你在告訴模型,這部電影只有一個燈光設定。
plaintext1一塊六格電影場景板,2 行 3 列,面板之間有細黑色間距,每個面板底部以小型優雅白色全大寫字母間距字體標註說明。主題:廢棄哥德式城堡的內部,夜晚。冷藍色月光,飄動的低矮霧氣,潮濕反光的石地板,高大的彩色玻璃窗,帶小溫暖火焰的鐵製燭台,深層去飽和的黑色,厚重的天鵝絨窗簾。所有面板中均無人物。 2 3面板 1,說明「廣角建立鏡頭 - 走廊」:一條有柱子的長走廊,通向發光的彩色玻璃窗。 4面板 2,說明「低角度 - 月光橫掃地板」:低角度攝影機,一道月光斜射過潮濕的石灰板。 5面板 3,說明「門口與樓梯構圖」:一個拱形門口,框住一座彎曲的石樓梯。 6面板 4,說明「近距離細節 - 雕花門」:一扇厚重雕花木門的特寫,帶有鐵製把手。 7面板 5,說明「窗邊視角 - 霧氣與窗簾」:高大的窗戶,霧氣湧入,前景有窗簾邊緣。 8面板 6,說明「最終海報幀 - 空蕩大廳」:對稱的空蕩大廳,有圖案的地毯跑向窗戶。 9 10攝影風格,電影感,底片顆粒,所有六個面板色彩分級一致。
設定: 相同模型,品質高,長寬比 16:9。
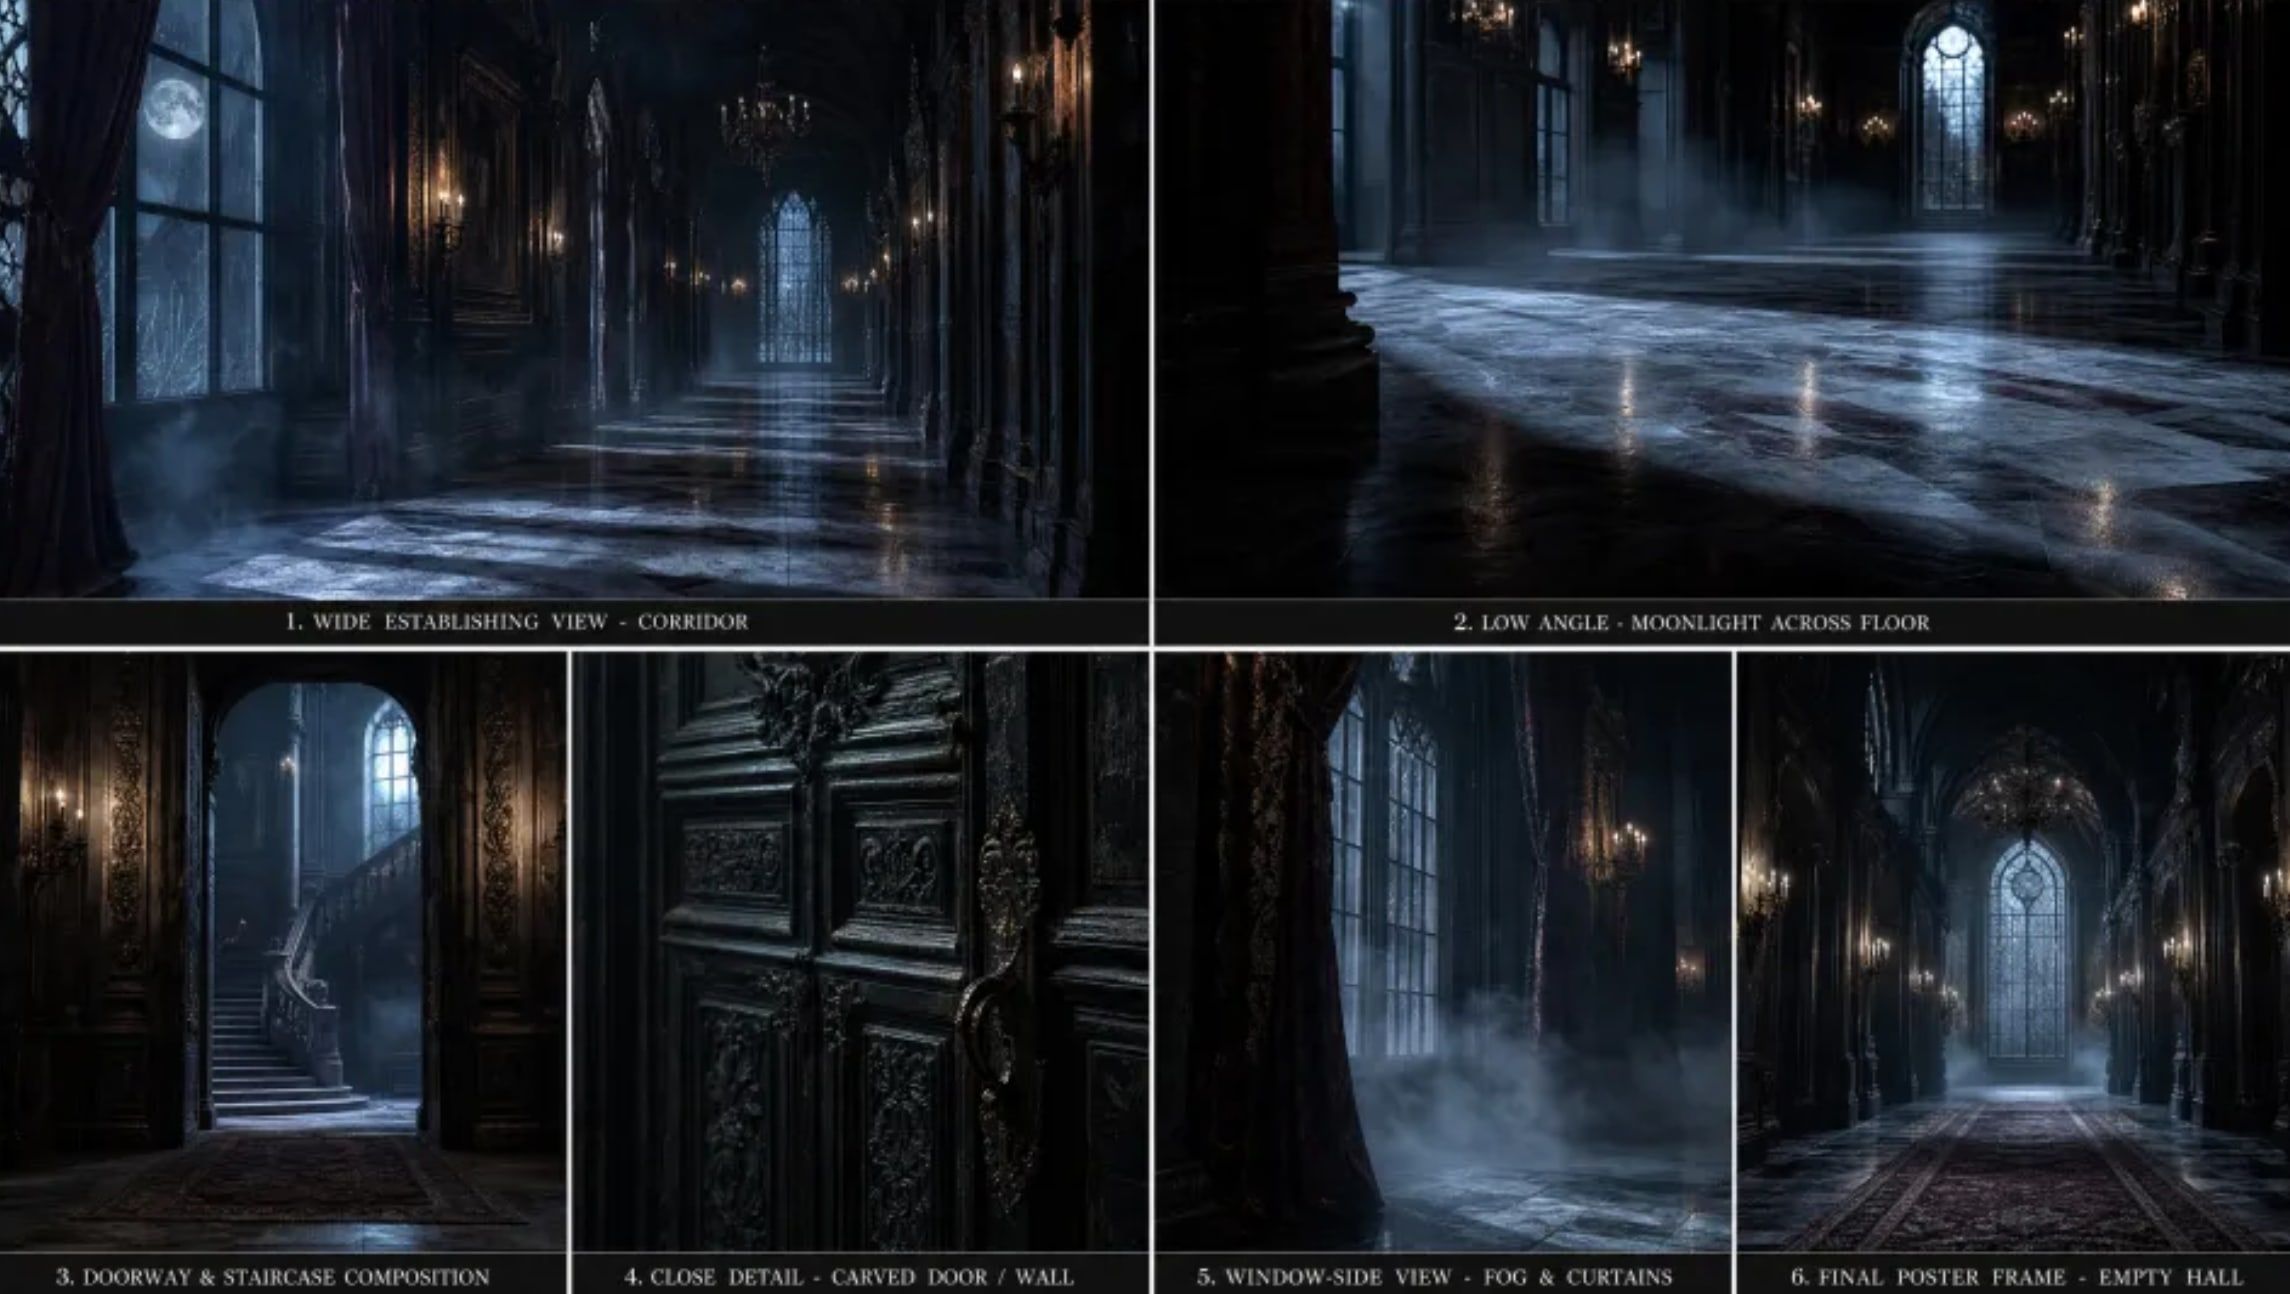 驅動示範片段的場景板:六個哥德式城堡內部,一種色彩分級,說明文字可讀。
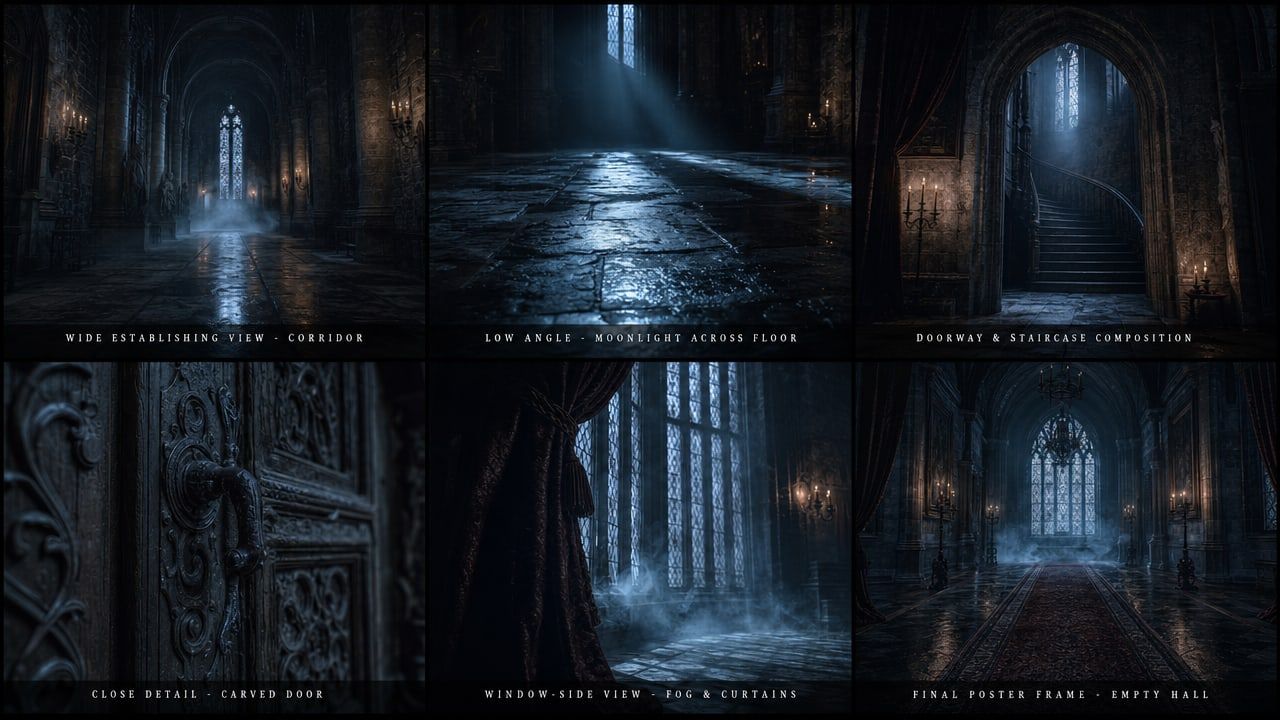 我自己執行的步驟 2 場景板提示詞的 GPT Image 2 結果。
步驟 3:使用 MiniMax H3 參考轉影片生成鏡頭
兩張參考圖像加上一個提示詞,其中包含攝影機位置和音訊方向。聲音在同一輪中生成,因此沒有單獨的語音或配樂步驟。在調整時保持時長較短,然後在正式剪輯時將其增加到 15 秒。
plaintext1參考圖像 1 是角色表:左邊的男人是男主角,右邊的女人是女主角。保持兩者的身份與所示完全相同:他的下巴線條、深色波浪髮、黑色天鵝絨大衣、黑色錦緞背心和黑色絲綢領巾;她的栗色半盤辮髮和奶油色維多利亞蕾絲連衣裙。參考圖像 2 是場景和燈光板:匹配其冷藍色月光、飄動的霧氣、潮濕反光的石地板和去飽和的黑色調。 2 39:16 垂直,優質真人短劇外觀,淺景深,電影對比,無字幕,無螢幕文字,無浮水印。 4 5鏡頭 1:中近景,攝影機緩慢推近。女主角站在月光照亮的走廊中,呼吸淺促,目光注視著畫框右側之外的某處。霧氣在膝蓋高度從她身邊飄過。 6鏡頭 2:硬切。從她身後越肩拍攝,男主角從暗色拱門中走出,進入月光,大衣捕捉光線,表情冷酷而好奇。 7鏡頭 3:他臉部的緊密特寫,半被窗戶照亮,然後是她臉部的匹配特寫,她拒絕移開視線。 8 9音訊:低沉持續的低音嗡鳴,遙遠的石頭回聲,她不穩定的呼吸,他步入光線時的一聲沉重腳步,最後一次切換時的一聲柔和弦樂漸強。
設定: 模型 MiniMax H3 參考轉影片,解析度 2K,時長 8(滑桿預設值;正式剪輯時增加到 15),長寬比自適應,並將兩個檔案放入參考素材。面板會將它們計為 9 個中的 2 個,因此你之後有足夠的空間添加服裝或道具圖。
值得注意的是長寬比的情況。我將長寬比保持為自適應,只在提示詞中寫了「9:16 垂直」。H3 仍然以垂直方向返回,因此它從文字中讀取了構圖,而不是需要表單欄位。
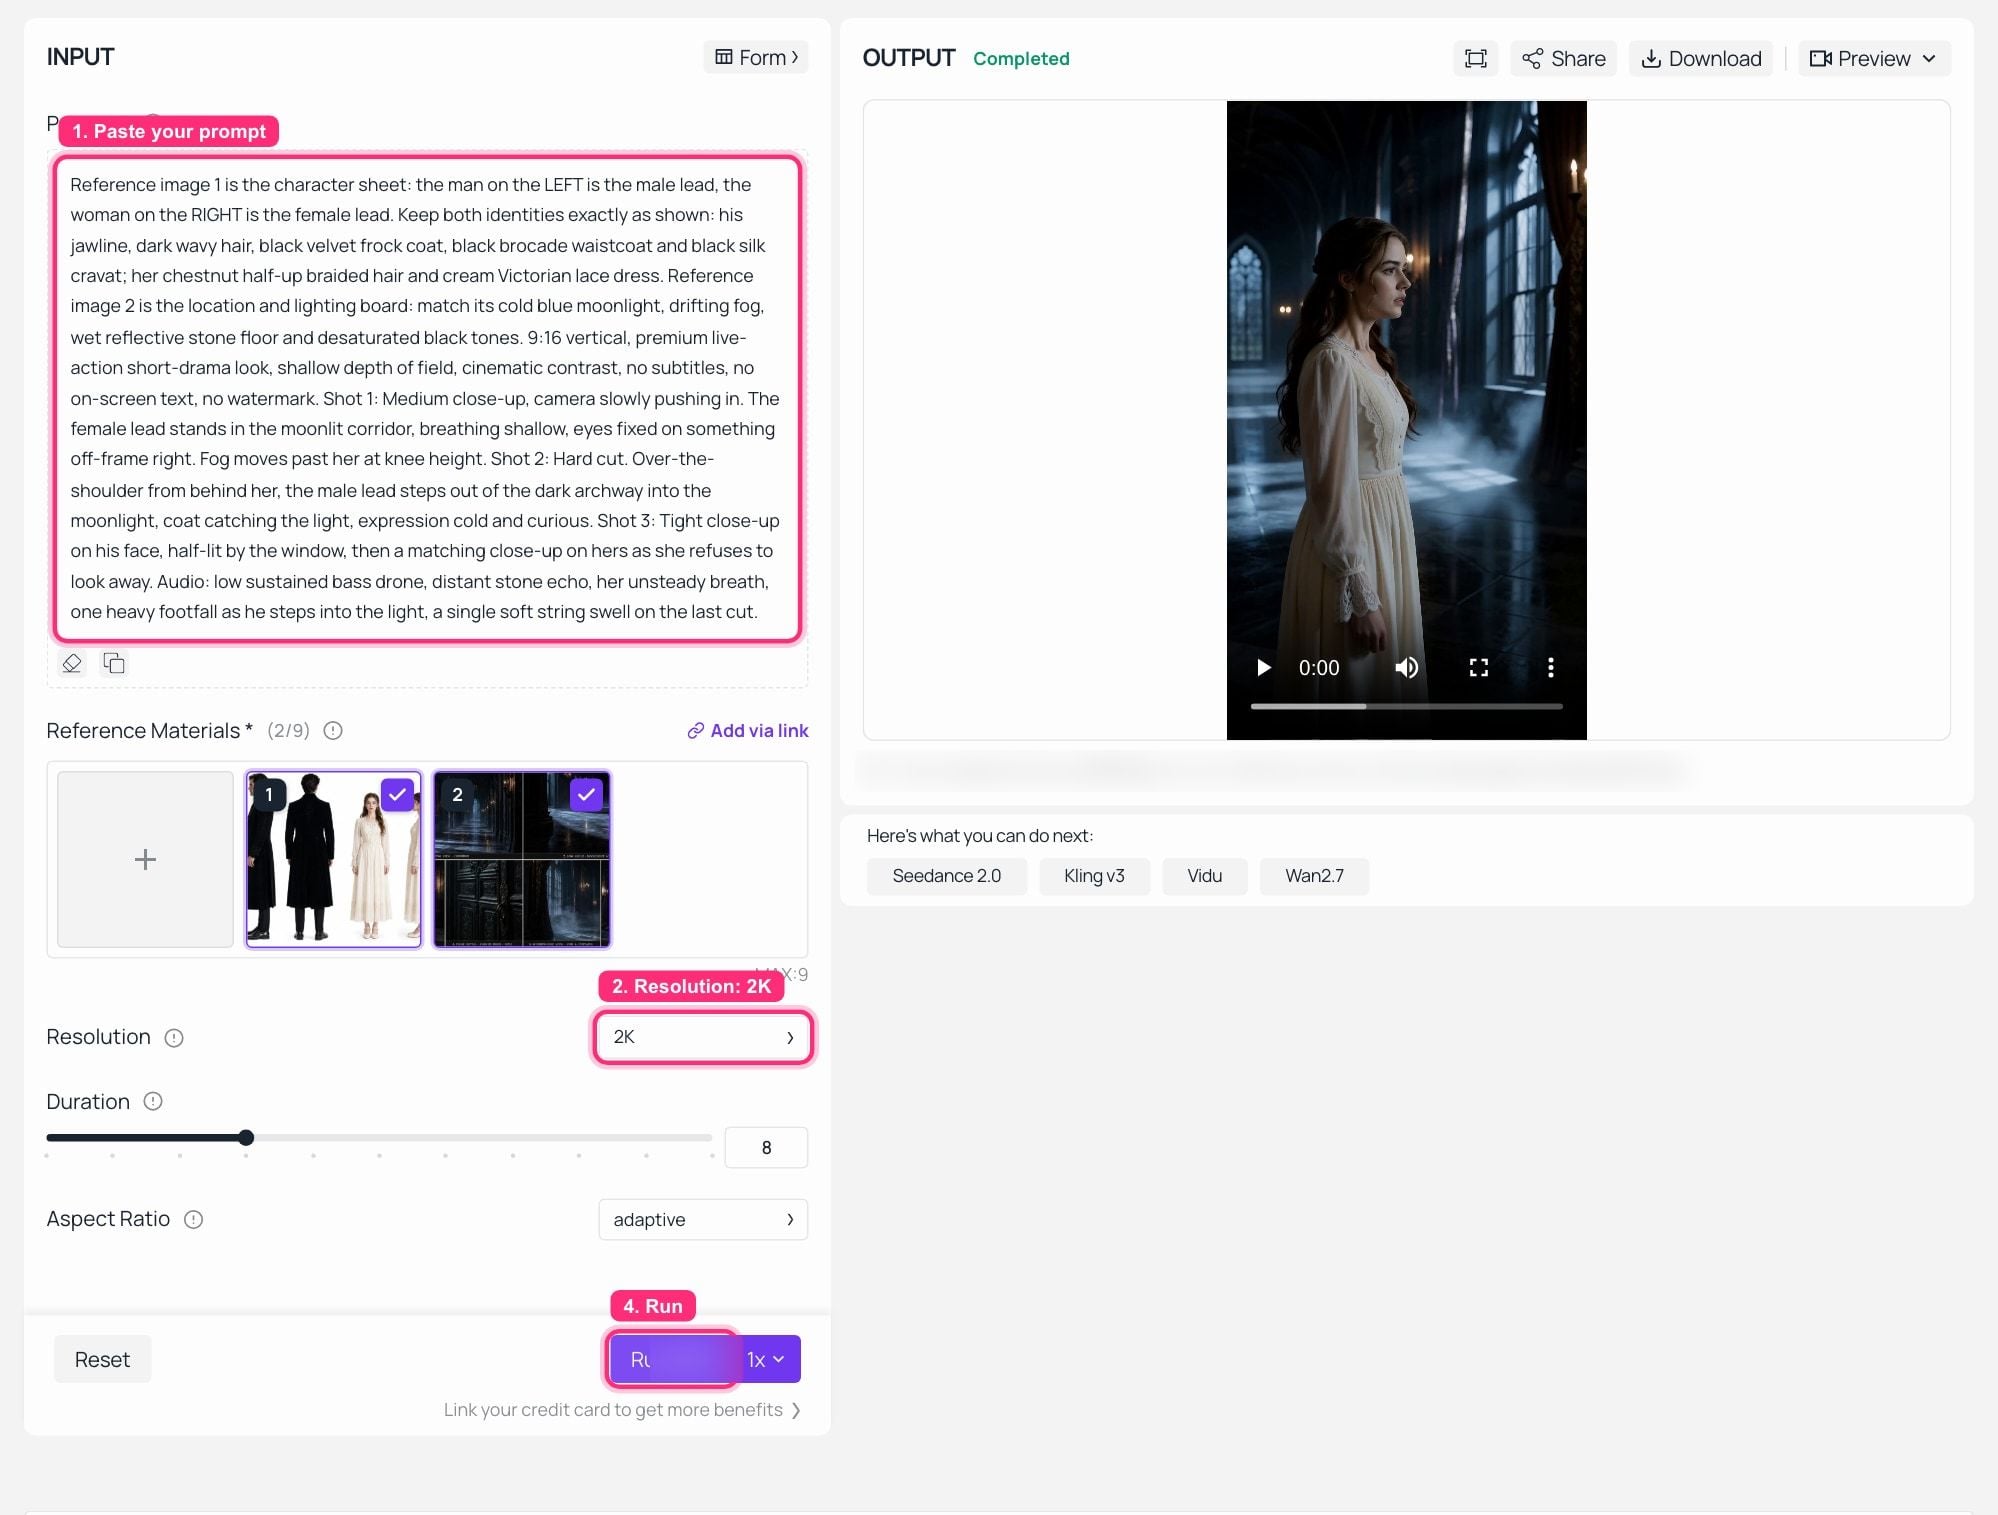 在 Atlas Cloud 上的 MiniMax H3 參考轉影片,執行完成:兩個參考檔案已載入(9 個中的 2 個),解析度 2K,生成的垂直片段在 OUTPUT 面板中播放。
第一幀是女主角穿著奶油色蕾絲緊身胸衣,站在場景板第 1 格的走廊中,霧氣在膝蓋高度,月光正好打在場景板所放置的潮濕地板上。兩個參考圖像都成功落地。
步驟 4:使用相同套件執行 Seedance 2.5 與 MiniMax H3 的對照組
不要改變任何一個字。相同的兩張參考圖像,相同的提示詞,不同的模型。我讓每個頁面自己的時長預設值保持不變,而不是強制匹配,我會在下面說明每個模型返回的結果。為了「配合」另一個模型而改寫提示詞,正是比較開始說謊的方式。
plaintext1與步驟 3 相同的提示詞,逐字複製。不要為了另一個模型而改寫它。
設定: 模型 Seedance 2.0 參考轉影片,解析度 720p,在參考圖像中放入相同的兩張參考圖像(同樣是 9 個中的 2 個,另有單獨的欄位可放最多 3 個參考影片和 3 個參考音訊檔案)。時長保留頁面預設值,結果返回為一段 10 秒的片段。
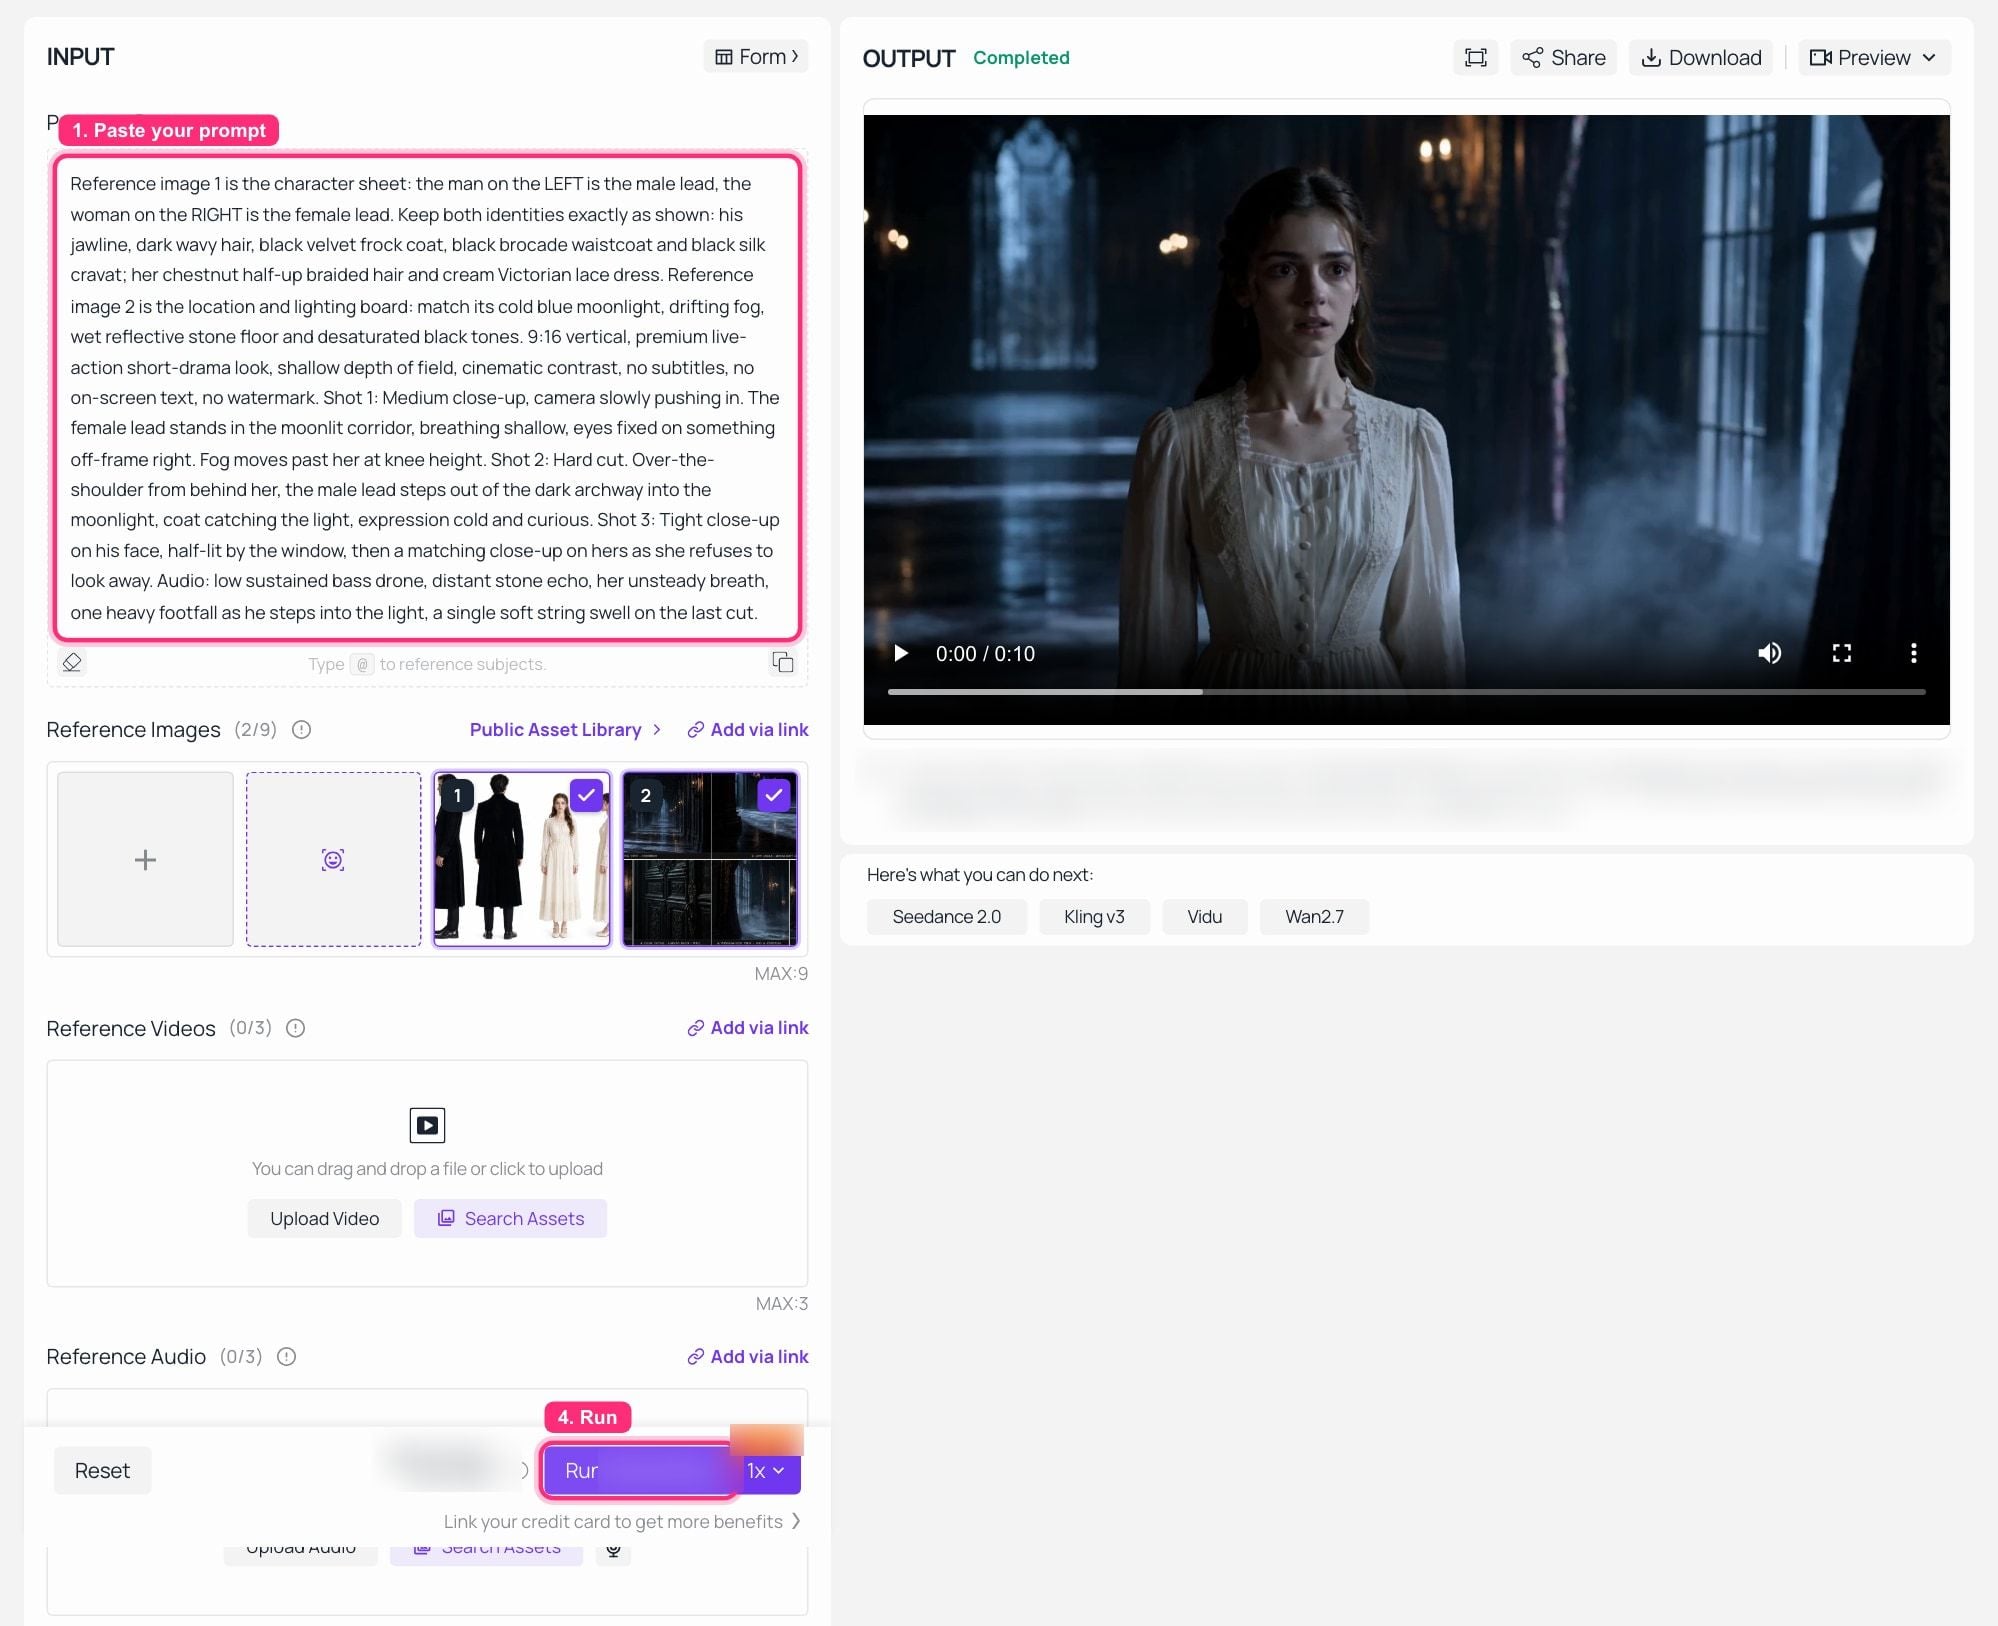 在 Atlas Cloud 上的 Seedance 2.0 參考轉影片,執行完成,使用與步驟 3 相同的參考套件和提示詞,OUTPUT 面板中顯示 10 秒的結果。
以下是兩個 OUTPUT 面板實際顯示的內容,我如實報告,而不是挑選贏家。
兩次運行都保持了角色。相同的奶油色蕾絲連衣裙,相同的領口和袖口,相同的栗色頭髮,相同的從場景板中提取的霧氣與月光走廊。兩者都沒有創造出一個不同的女人。參考套件在兩邊都完成了這項工作,這是我最關心的發現。
差異在於形式,而不是臉部。這個 Seedance 端點輸出 720p;H3 在相同輸入下輸出 2K。而且構圖也出現了分歧:H3 直接從提示詞文字中讀取「9:16 垂直」並返回垂直方向,而 Seedance 運行則返回 16:9,因為該頁面有自己的長寬比控制,而提示詞文字本身並未覆蓋它。如果你正在為 TikTok 剪輯,第一次忘記表單欄位時,這個差異就會讓你損失一次執行。Seedance 2.5 很可能會改變解析度這部分,並增加區域級重新生成,我不會假裝我測量過這個。
步驟 5:在不重新生成整個片段的情況下修正一個鏡頭
短劇的真實成本不是第一次生成,而是第七次修改。H3 接受現有片段作為輸入,並根據指令進行編輯,保留你未提及的部分。Seedance 2.5 在此處的賣點更精細:重繪畫面的某個區域,同時保持表演、燈光和攝影機不變。
plaintext1使用提供的片段:保持兩個角色、他們的服裝、攝影機運動和剪輯節奏完全如原樣。僅更改環境,將月光照亮的石走廊替換為同一城堡的舞廳,高大的拱形窗戶,點亮的吊燈,溫暖的燭光,並重新為兩個角色打光,使他們的關鍵光來自畫面左側的吊燈,而不是窗戶。將她唯一的台詞改寫為「你從來沒有睡著過,對吧。」保持她表演的時機在相同的節拍上。
設定: MiniMax H3 參考轉影片,以步驟 3 的片段作為參考輸入,時長 5,解析度 2K。
超越 Seedance 2.5 與 MiniMax H3 測試:四種擴展參考套件的方法
相同角色,下一集。 將步驟 1 的表單儲存為資產,只更改提示詞中的鏡頭列表和故事區塊。身份來自一個檔案,而不是你對上週二如何措辭的記憶。
也固定聲音。 H3 最多可接受三個音訊參考,每個 2 到 15 秒,且必須與圖像或影片輸入一起提交。給它一個聲音樣本,角色就會以該音色說話,這樣你就不需要在各集之間重新選角。
在付費渲染之前先鎖定攝影機。 Seedance 2.5 的參考轉影片接受 3D 白色模型塊狀圖和綠幕,因此你可以在灰色幾何體上鎖定構圖,然後再投入最終外觀。這個範例是在 Seedance 2.1 上運行的,這是該家族的早期成員,但工作流程的形狀是相同的。
在地化一個母版剪輯,而不是重新拍攝。 區域級替換可以交換臉部、產品或口語語言,而攝影機、時機和嘴唇持續時間保持不變。這裡,一個母版美容剪輯被重新選角和重新配音為西班牙語、韓語和印地語,而房間、構圖和嘴唇持續時間保持不變。
而且,因為一定會有人問,當你停止保持理智時,動作轉移會是什麼樣子:三個穿著西裝的男人,被三隻寫實的水豚取代,逐拍跟隨原始片段的動作路徑,直到它們堆疊成一個金字塔。
還有這一切的樸素版本,也就是沒有人會發布的那種:一張靜態海報變成動態海報,而佈局保持不變。
 靜態來源海報。將其輸入參考轉影片,並帶有「保持框架、調色板和佈局,為文字添加動畫」的指令,你就會得到同一設計的動態版本。
Seedance 2.5 與 MiniMax H3 短片的實際成本
這裡沒有數字,因為數字會變動,但結構不會。兩個家族都按秒計費,按用量付費,沒有席位費,也沒有訂閱費。這留下了三個變數:秒數、解析度層級和重新生成次數。
第三個是整個帳單。一個一次就成功的 15 秒片段是一次收費。同一個片段在第七次嘗試時是七次收費。因此,省錢的舉動不是選擇更便宜的每秒模型,而是在你生成任何東西之前,先把參考套件弄對。步驟 1 和步驟 2 中的那兩個圖像呼叫是整個管線中最便宜的一行,卻決定了你要進行多少次影片呼叫。在整個鏈條中,投資回報率最高,遙遙領先。
然後糾正每秒的直覺。相同的參考套件,相同的運行時間:H3 的參考轉影片返回 1440p,而這個 Seedance 參考轉影片端點返回 720p。每秒是錯誤的單位。每幀畫素,以及你是否需要為單獨的放大處理付費,才是正確的單位。
音訊也應該納入計算。兩邊都在同一輪中產生原生同步聲音。如果你目前的管線是影片模型加 TTS 再加編輯器對齊音軌,那麼你節省的是兩次 API 呼叫和一個人的下午,而這個節省不會出現在任何價格清單上。
對於不同的工作,該選哪一個:
| 工作 | 選擇 | 原因 | 注意事項 |
|---|---|---|---|
| 垂直短劇,9:16,TikTok 或 ReelShort | MiniMax H3 | 1440p 垂直,帶原生立體聲,可立即呼叫,15 秒足以完成一個鉤子 | 你在 15 秒處剪輯,因此相應地規劃節拍 |
| 連續 30 秒品牌影片 | Seedance 2.5 | 一次生成,無需拼接,原生 4K | 首先在你的平台上檢查可用性 |
| 在已批准的剪輯中修正一個鏡頭 | Seedance 2.5 | 區域級重繪,其餘部分保持不變 | H3 的整段片段編輯今天已能滿足大部分需求 |
| 產品和電商精簡版 | 兩者均可 | 兩者都能很好地保持螢幕文字和品牌標誌 | 在你出貨的解析度下驗證文字 |
| 遊戲或介面演示 | MiniMax H3 | 2K 下的 UI 和排版穩定性很強 | 單次傳遞的上限為 15 秒 |
| 一個母版的多語言版本 | Seedance 2.5 | 區域替換加上多語言語音 | 在地化品質仍需母語人士檢查 |
| 今晚就要出貨 | MiniMax H3 | 三個端點已上線,加上整個 Seedance 2.0 系列 | Seedance 2.5 的可用性因平台而異 |
出貨前須知。 MiniMax 表示 H3 的權重將在發布後數天內跟進,而開放權重與商業授權不是同一回事,因此在自行託管之前,請閱讀條款。浮水印和商業使用政策在消費者應用程式和 API 訪問之間也有所不同,我在撰寫本文時無法從主要條款頁面確認任何一項,因此請查閱提供者的條款,而不是相信我的話。而且,沒有任何模型授權涵蓋肖像權或商標。如果一個真實人物、真實品牌或他人的智慧財產權出現在你的參考套件中,那是另一個法律問題,模型的條款無法回答。
上表中的所有模型都在同一個金鑰上運行,模型頁面 包含了當前費率以及可複製貼上的程式碼,包括本週在 Seedance 系列上可能正在進行的任何促銷活動。
常見問題
在角色一致性方面,Seedance 2.5 比 MiniMax H3 好嗎?
理論上應該如此,因為它擁有最多 50 個多模態參考,而 H3 只有 12 個檔案,加上區域級重新生成。但截至 2026 年 7 月 31 日,我還沒有看到任何可以引用的配對公開測試,而且 Seedance 2.5 還沒有競技場評分。在我實際能夠進行的運行中,決定身份穩定性的變數是參考套件的結構,而不是模型的生成能力:使用一張合成轉面紙加上一張燈光板,兩邊都保持了角色。在你花時間比較模型之前,先把套件弄對。
我現在就可以使用 Seedance 2.5 嗎,還是必須等待?
其 API 在字節跳動上已上線。在第三方模型平台上的可用性參差不齊,在我測試的那個平台上,它仍然是一個 Day-0 通知。如果你今晚就需要輸出,可呼叫的選項是 MiniMax H3 的三個端點以及整個正在出貨的 Seedance 2.0 系列。
MiniMax H3 真的能做到 30 秒影片嗎?
不能。規格是每次生成 5 到 15 秒,24fps。更長的時間是透過擴展或拼接,這是一種不同的東西,具有不同的飄移風險。30 秒的一次生成屬於 Seedance 2.5。不要讓這兩個主張混淆。
兩個模型都能生成音訊嗎?我可以在各集之間保持同一個聲音嗎?
兩者都能在同一輪中生成原生同步音訊,H3 在每個結果上都輸出立體聲。對於持續的聲音,H3 最多接受三個 2 到 15 秒的音訊參考,這些參考必須與圖像或影片輸入一起提交,而不是單獨提交。
我實際上應該發送多少張參考圖像?
比你認為的少,但結構要比你認為的好。一張精心構圖的合成圖通常勝過六張鬆散的裁切,因為分開的檔案會讓模型將它們平均成一個不存在的人。給它兩個明確的工作:身份和燈光,不要包含互相衝突的風格樣本。
對於 TikTok 或 ReelShort 風格的垂直短劇,我應該使用哪個模型?
本週可以出貨,9:16,高解析度,聲音已經混好:MiniMax H3。計劃一個 30 秒的連續場景,並且預計會重新生成單個區域而不是整個片段:為 Seedance 2.5 做好準備,並檢查你的平台何時開放它。


