다운로드 바가 65GB에 도달하고, 팬이 돌아가기 시작하면 진짜 질문이 떠오릅니다. 과연 실제로 로드될까? GPT-OSS-120B 메모리 요구 사항에 대한 짧은 답은 가중치에 약 61GB, 그리고 작업 공간을 위한 몇 GB가 더 필요하다는 것이며, 이 때문에 OpenAI가 이를 단일 80GB GPU 모델로 홍보하는 것입니다.
아래에서는 이 숫자를 부분별로 나누고, 측정된 속도로 이를 실행한 하드웨어를 보여드리며, 여러분의 장비가 부족할 때를 위한 호스팅 경로도 다룹니다.
핵심 요약
- GPT-OSS-120B는 60.8 GiB MXFP4 체크포인트로 제공되며, 이 때문에 OpenAI는 단일 80GB GPU를 목표로 합니다.
- 컨텍스트 길이는 메모리를 거의 추가하지 않습니다. KV 캐시는 최대 131K 토큰에서 약 4.5 GiB에 불과합니다.
- VRAM이 80GB 미만이면 llama.cpp가 전문가 레이어를 시스템 RAM으로 오프로드하여 여전히 실행할 수 있습니다.
- 96GB 이상의 메모리를 갖춘 Mac과 128GB 미니 PC는 한 대의 장비에 전체 모델을 담을 수 있습니다.
- 적합한 하드웨어가 없으신가요? OpenAI 호환 API 하나로Atlas Cloud의 Qwen3.5 122B A10B를 호출하세요.
GPT-OSS-120B 메모리 요구 사항: 가중치와 KV 캐시
OpenAI는 2025년 8월 5일 Apache 2.0 라이선스로 gpt-oss-120b를 출시했습니다. 이는 전문가 혼합(mixture-of-experts) 모델이므로 116.8B 파라미터 중 5.1B만이 각 토큰에서 작동합니다. 이는 속도에 도움이 될 뿐 메모리에는 도움이 되지 않습니다. 모든 전문가는 선택될 준비를 위해 여전히 메모리에 상주해야 하기 때문입니다.
이를 작게 유지하는 비결은 MXFP4입니다. gpt-oss 모델 카드에 따르면, 파라미터의 90% 이상을 차지하는 전문가 가중치는 각각 4.25비트로 저장됩니다. 동일 모델의 16비트 사본은 약 네 배의 공간이 필요합니다.
| 사양 | GPT-OSS-120B |
|---|---|
| 총 파라미터 | 116.8B |
| 토큰당 활성 파라미터 | 5.1B |
| 레이어 및 전문가 | 36개 레이어, 128개 전문가, 토큰당 4개 활성 |
| 가중치 형식 | 전문가 레이어는 MXFP4, 나머지는 BF16 |
| 체크포인트 크기 | 60.8 GiB |
| 컨텍스트 윈도우 | 131,072 토큰 |
컨텍스트 윈도우가 GPT-OSS-120B 메모리를 바꾸는 방식
모든 토큰은 각 어텐션 레이어에 키와 값을 남깁니다. 이 저장소가 KV 캐시이며, 모든 레이어가 전체 컨텍스트에 어텐션할 때 컨텍스트 길이에 따라 함께 증가합니다.
GPT-OSS-120B는 대부분 이를 회피합니다. 36개 레이어 중 절반은 128개 토큰만 되돌아보는 슬라이딩 윈도우를 사용하며, 각 레이어는 64차원의 KV 헤드 8개만 저장합니다. 전체 컨텍스트를 유지하는 레이어는 18개뿐입니다. 모델의 config에서 KV 캐시를 계산해 보았으며, 이는 llama.cpp gpt-oss 가이드의 측정된 총계와 일치합니다.
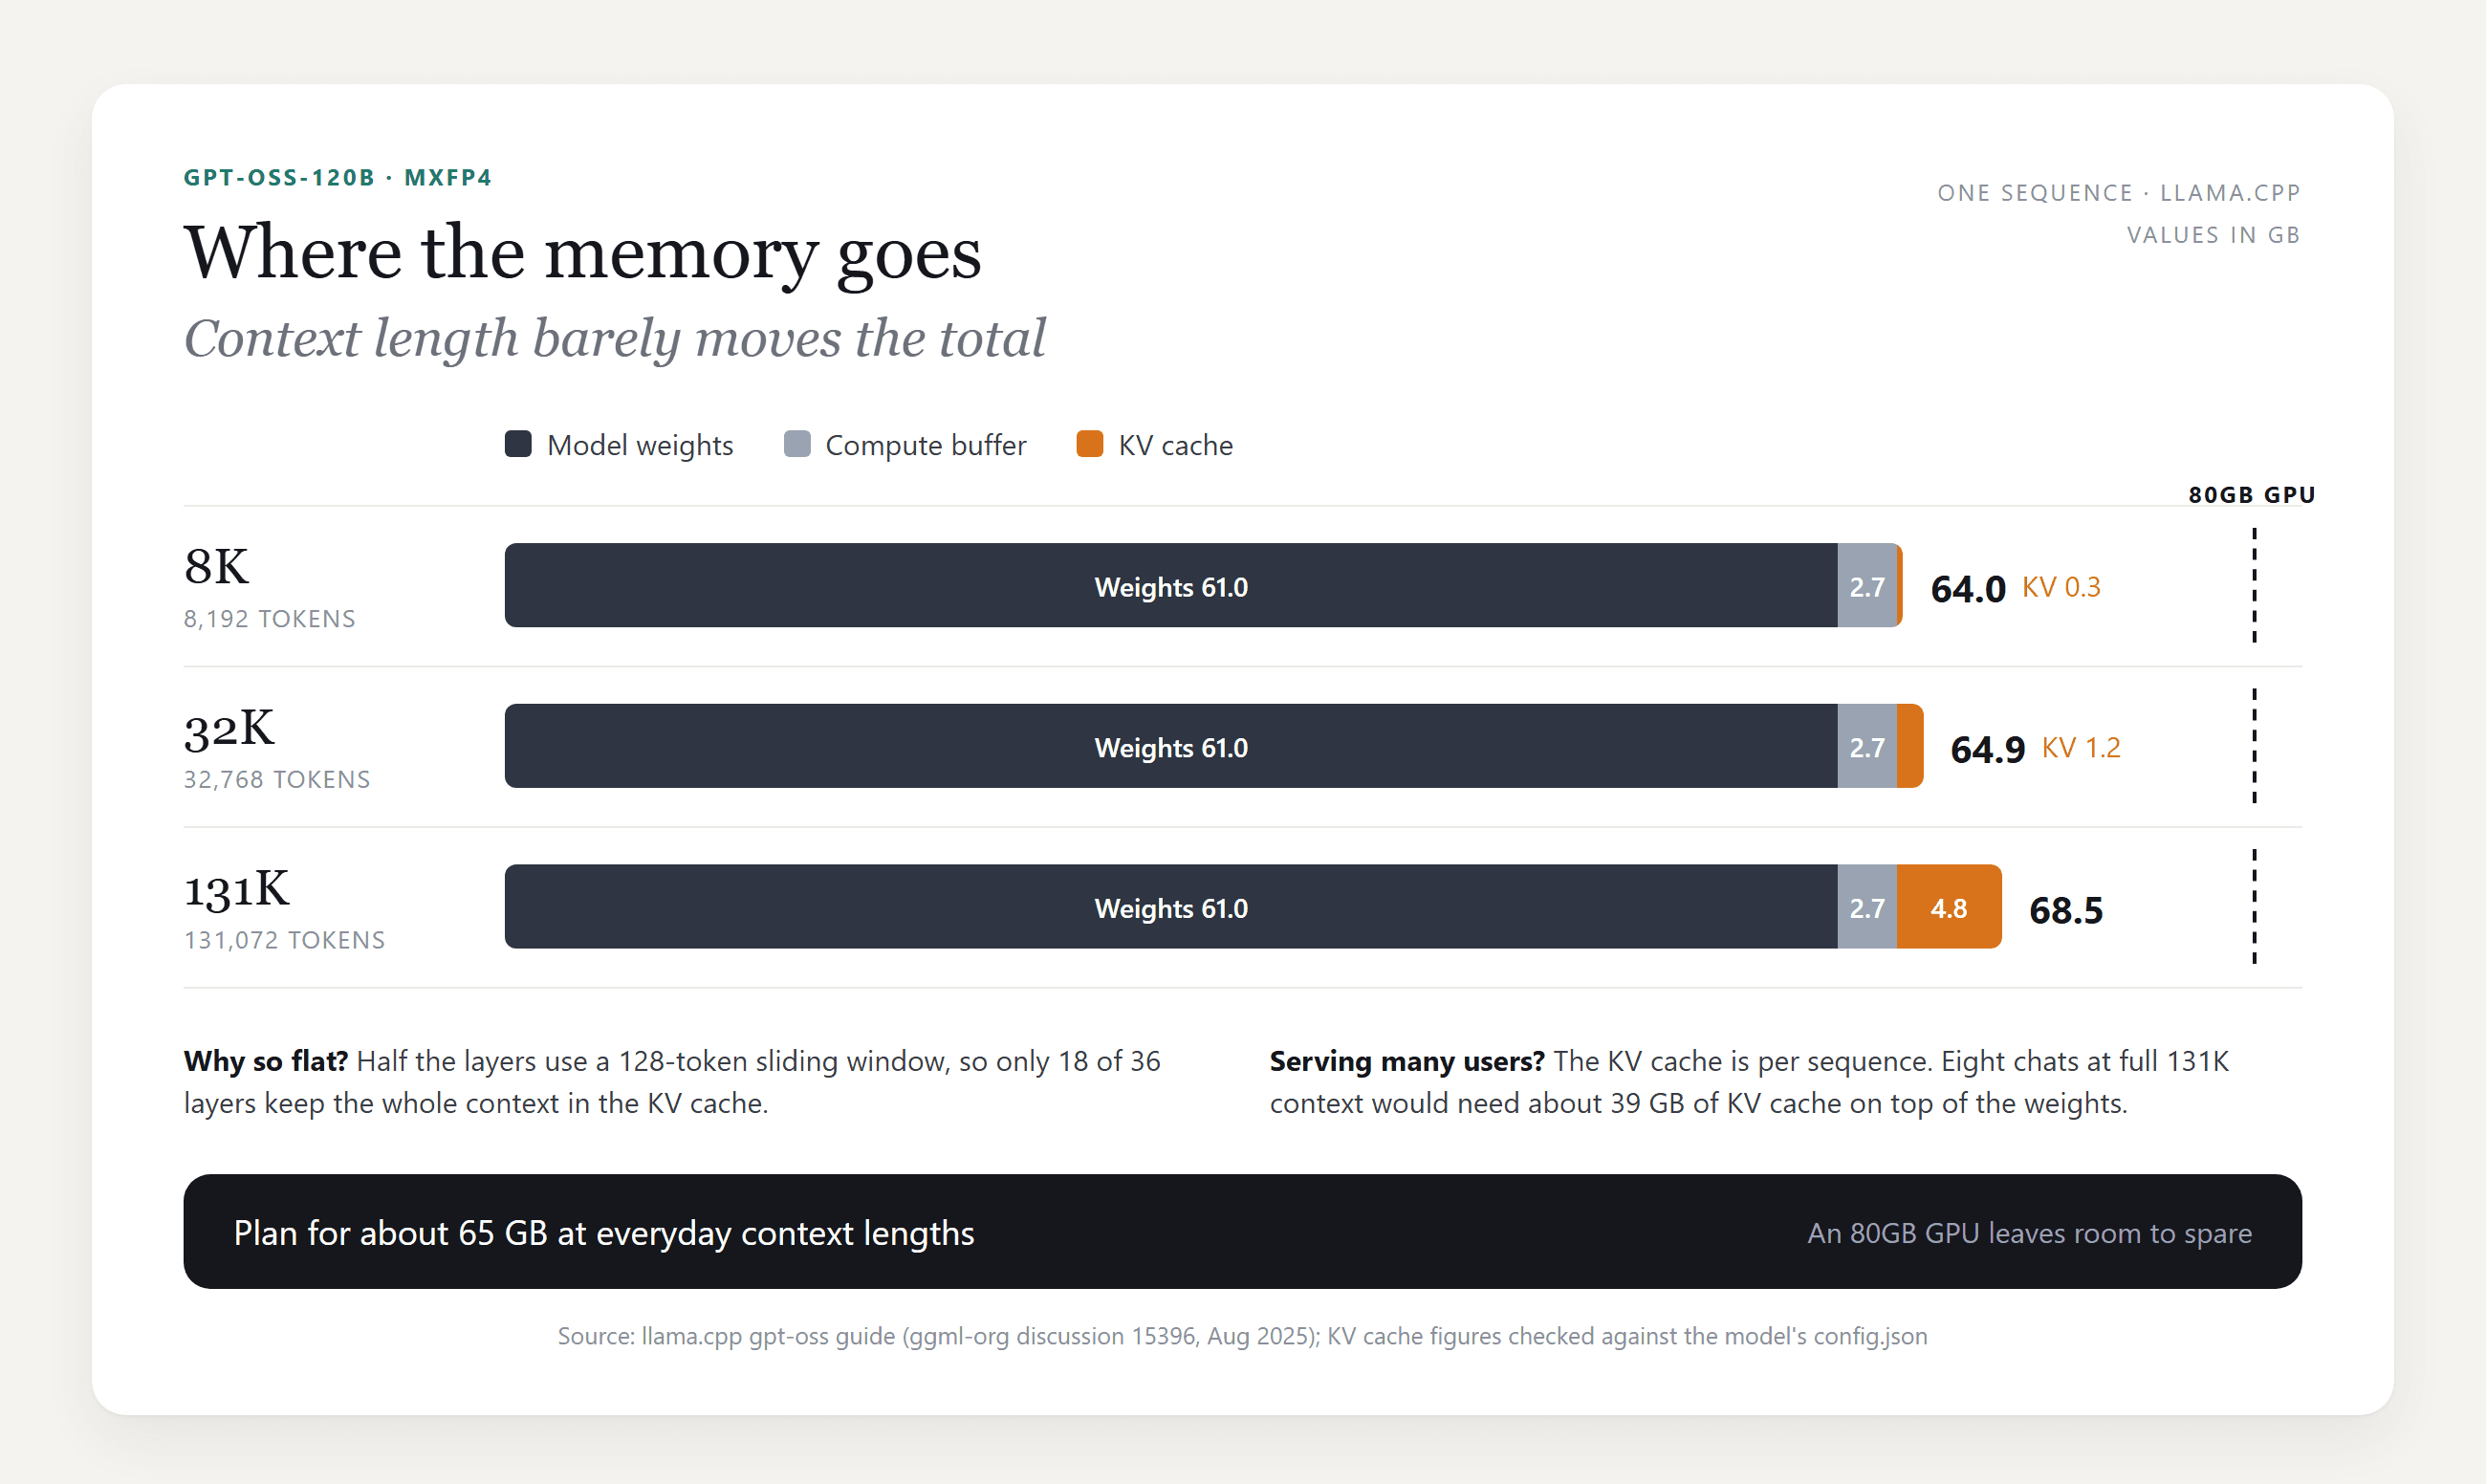
8K에서 전체 131K로 가는 데 드는 비용은 5GB 미만입니다. 여기서 누적되는 것은 동시성입니다. KV 캐시는 대화별로 존재하므로, 8개의 전체 길이 채팅을 보유하는 서버는 가중치 위에 약 39GB가 더 필요합니다.
GPT-OSS-120B를 로컬에서 실행할 수 있나요? 설정별 하드웨어 요구 사항
네, 약 65GB를 빠른 곳에 둘 수 있다면 가능합니다. 큰 GPU 하나, GPU와 시스템 RAM, 또는 통합 메모리를 갖춘 장비입니다.
GPT-OSS-120B GPU 요구 사항
가장 간단한 경우는 80GB 데이터 센터 카드 하나입니다. gpt-oss용 vLLM 레시피에 따르면 120b 모델은 "단일 A100(80GB)에 맞으며", 여러 GPU로 나누면 처리량에 도움이 된다고 합니다.
80GB 미만의 경우, llama.cpp 가이드가 해결책을 제시합니다. --n-cpu-moe 플래그는 일부 전문가 레이어를 시스템 RAM에 유지하고 나머지를 GPU에 둡니다. 이 가이드는 GPU와 시스템 메모리를 합쳐 여전히 모델을 담을 수 있다면 최소 약 8GB의 VRAM이 필요하다고 봅니다.
| 설정 | 가중치 위치 | 보고된 생성 속도 |
|---|---|---|
| RTX Pro 6000, 96GB | 모두 GPU에 | 196 tokens/s (llama.cpp 가이드) |
| A100 또는 H100, 80GB | 모두 GPU에 | 카드 한 장에 맞음 (vLLM 레시피) |
| RTX 5090, 32GB, 시스템 RAM 추가 | 21개 전문가 레이어를 시스템 RAM에 유지 | 컨텍스트 0에서 약 30 tokens/s (llama.cpp 가이드) |
같은 가이드에서 나온 Windows 함정 하나: 드라이버는 VRAM이 부족할 때 조용히 시스템 RAM으로 흘러넘칠 수 있어, 모델이 로드된 후 느려집니다. 작업 관리자에서 GPU 메모리를 확인하고, 카드 크기 미만으로 유지될 때까지 오프로드 수를 늘리세요.
Mac 또는 128GB 미니 PC에서 GPT-OSS-120B 실행하기
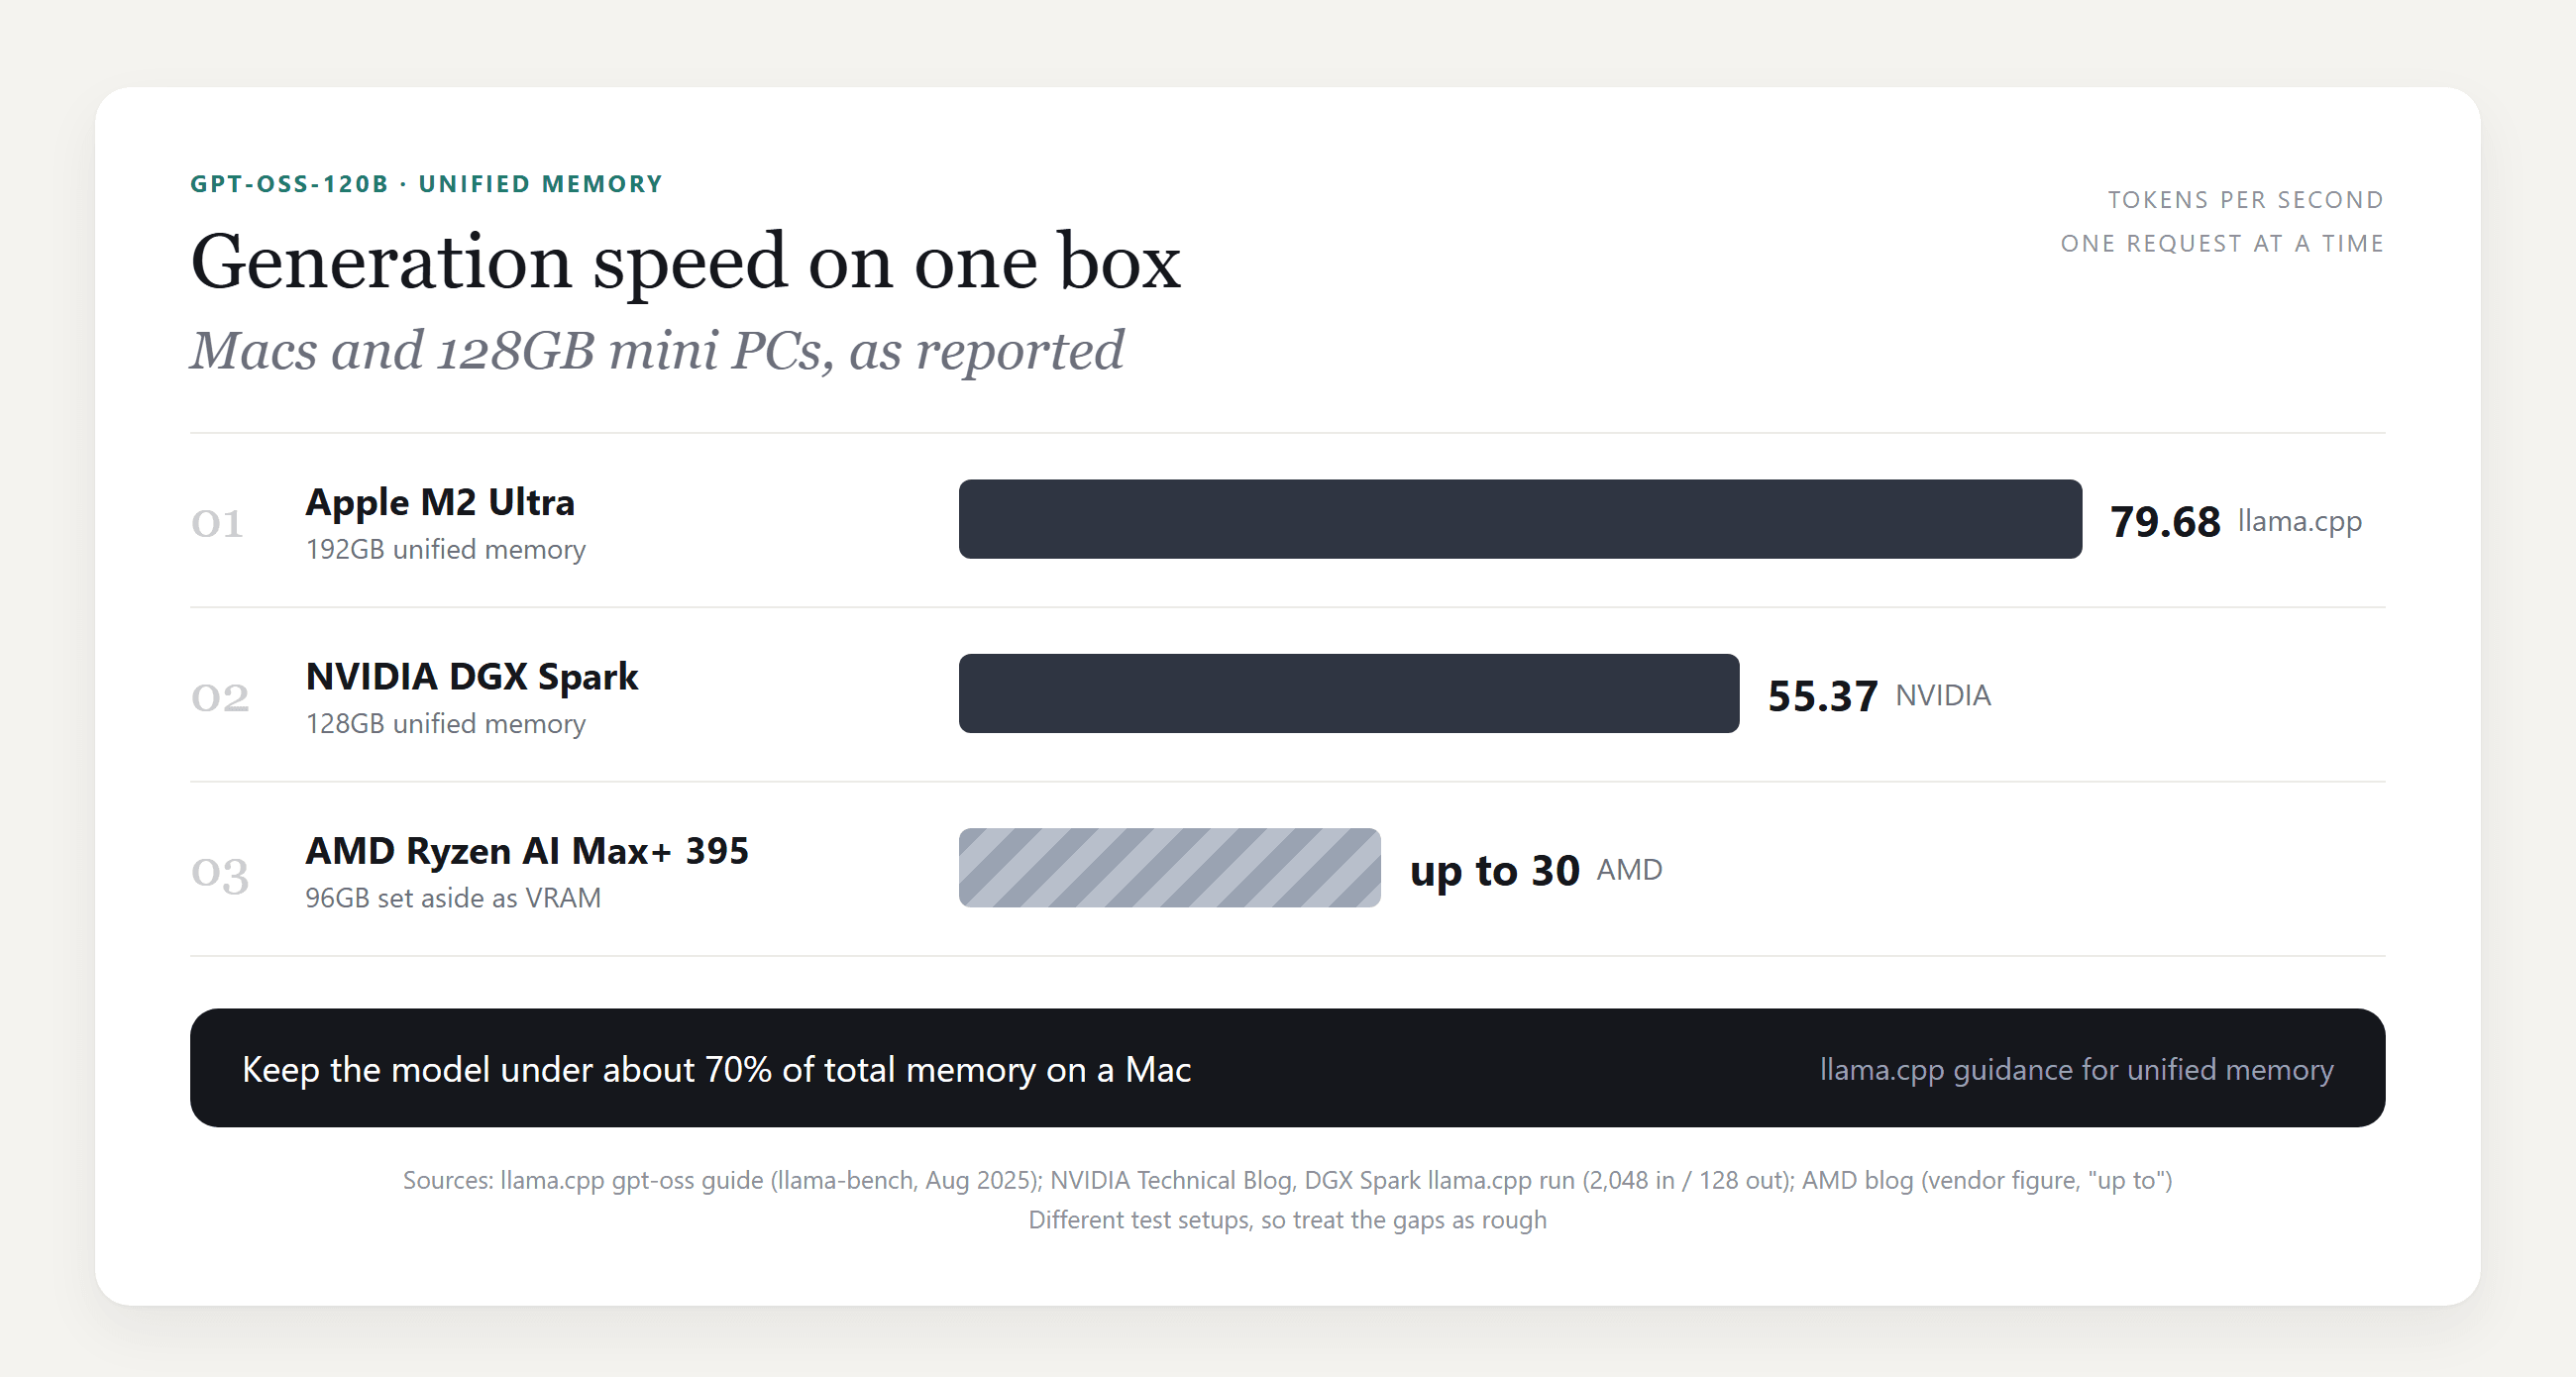
통합 메모리는 GPU와 RAM 분리를 없애줍니다. llama.cpp 가이드에 따르면 M2 Ultra나 M3 Max 같은 96GB 이상의 RAM을 갖춘 Mac은 전체 컨텍스트에서 모델을 실행할 수 있으며, 총 메모리의 약 70% 미만으로 유지할 것을 권장합니다.
macOS는 기본적으로 GPU가 연결할 수 있는 메모리 양을 제한합니다. 192GB 장비에서 이 가이드는 명령 하나로 이 상한을 154GB에서 180GB로 올립니다:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
새로운 128GB 미니 PC도 같은 등급에 속합니다. NVIDIA는 llama.cpp를 실행하는 DGX Spark에서 gpt-oss-120b가 55.37 tokens/s라고 보고합니다. AMD는 VRAM으로 96GB를 할당한 Ryzen AI Max+ 395 장비가 "최대 초당 30 토큰"에 도달한다고 밝히며, 이는 회사 자체 수치입니다.
메모리가 부족한가요? API를 통해 호스팅된 오픈 웨이트 모델 사용하기
이런 장비 중 어느 것도 책상 위에 없다면, 호스팅된 오픈 웨이트 모델은 하드웨어 문제를 완전히 건너뜁니다.
Atlas Cloud는 Qwen 모델 라인업의 일부인 Qwen3.5 122B A10B를 제공합니다. 이론상 gpt-oss-120b와 매우 유사합니다. Alibaba의 Qwen 팀이 만든 Apache 2.0 전문가 혼합 모델로, 총 122B, 활성 파라미터 10B입니다. 최대 262,144 토큰의 컨텍스트를 읽습니다.
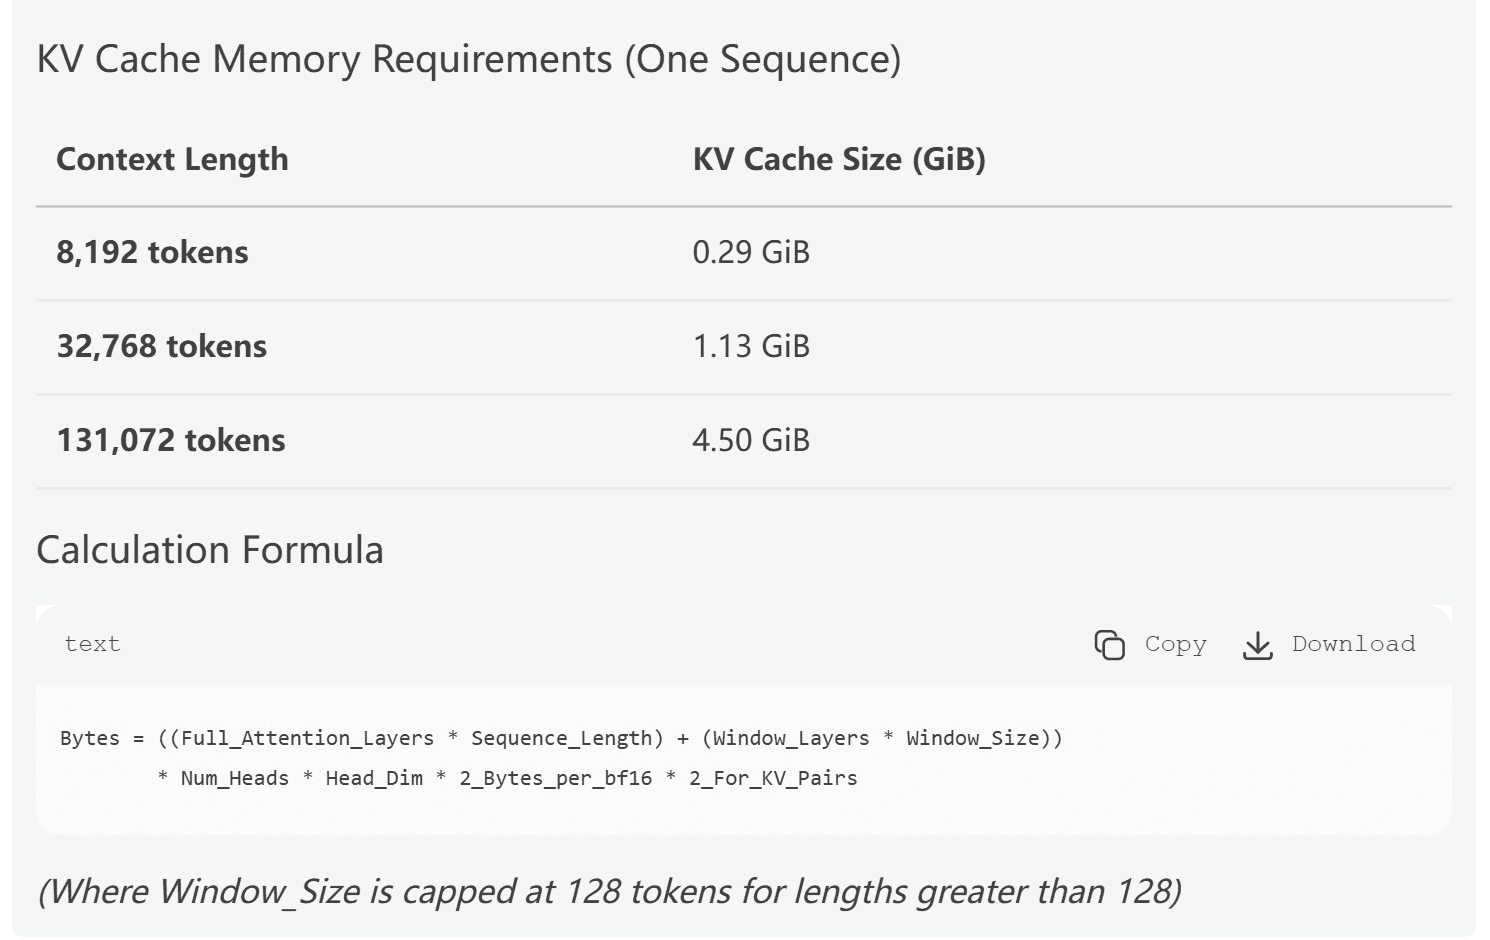
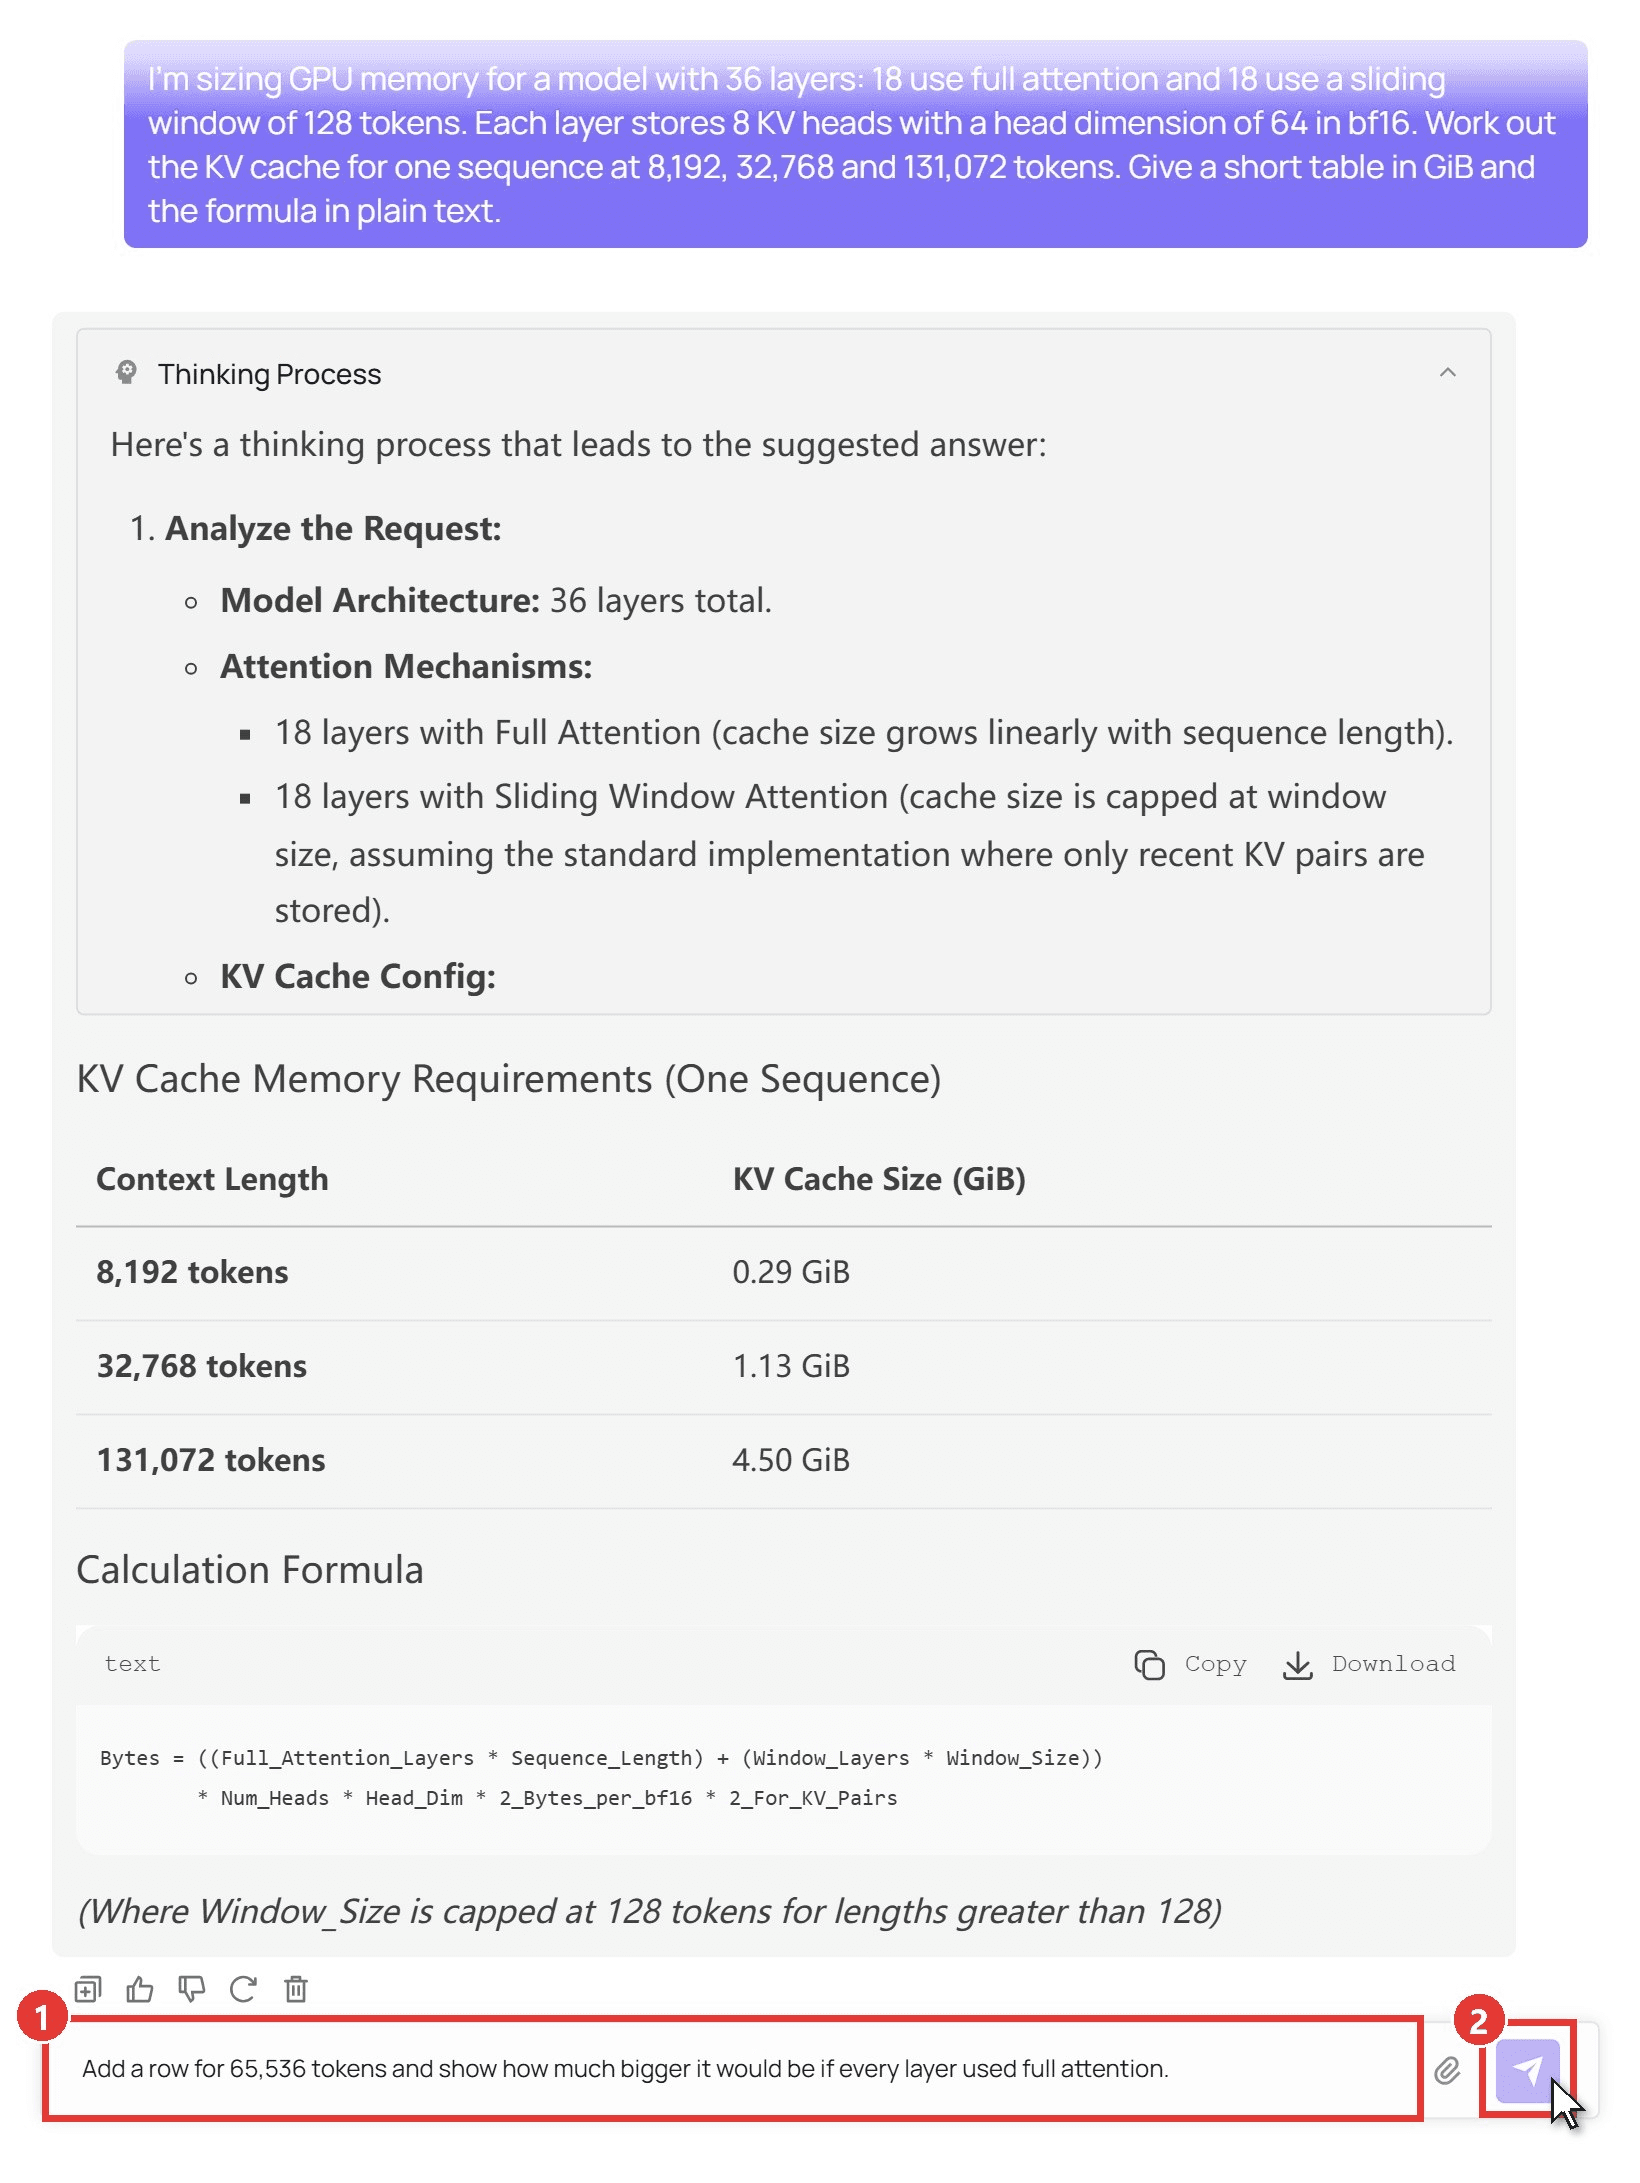
gpt-oss config의 어텐션 레이아웃을 주고 세 가지 길이에서 KV 캐시를 요청했습니다. 그 표는 우리 계산과 소수점 둘째 자리까지 일치했습니다. 나중에 자신의 장비용 Qwen을 원하신다면, 로컬 코딩에 가장 좋은 Qwen 모델 가이드에서 RAM별로 크기를 정합니다.
방법 1: 플레이그라운드에서 Qwen3.5 122B A10B 사용해 보기
로그인하고 Qwen3.5 122B A10B 플레이그라운드를 연 다음:
- 메시지 상자에 질문을 입력합니다.
- 전송 화살표를 클릭합니다. 추론은 답변 위의 Thinking Process 패널에 나타납니다.
방법 2: Atlas Cloud API로 Qwen3.5 122B A10B 호출하기
스크립트와 앱의 경우:
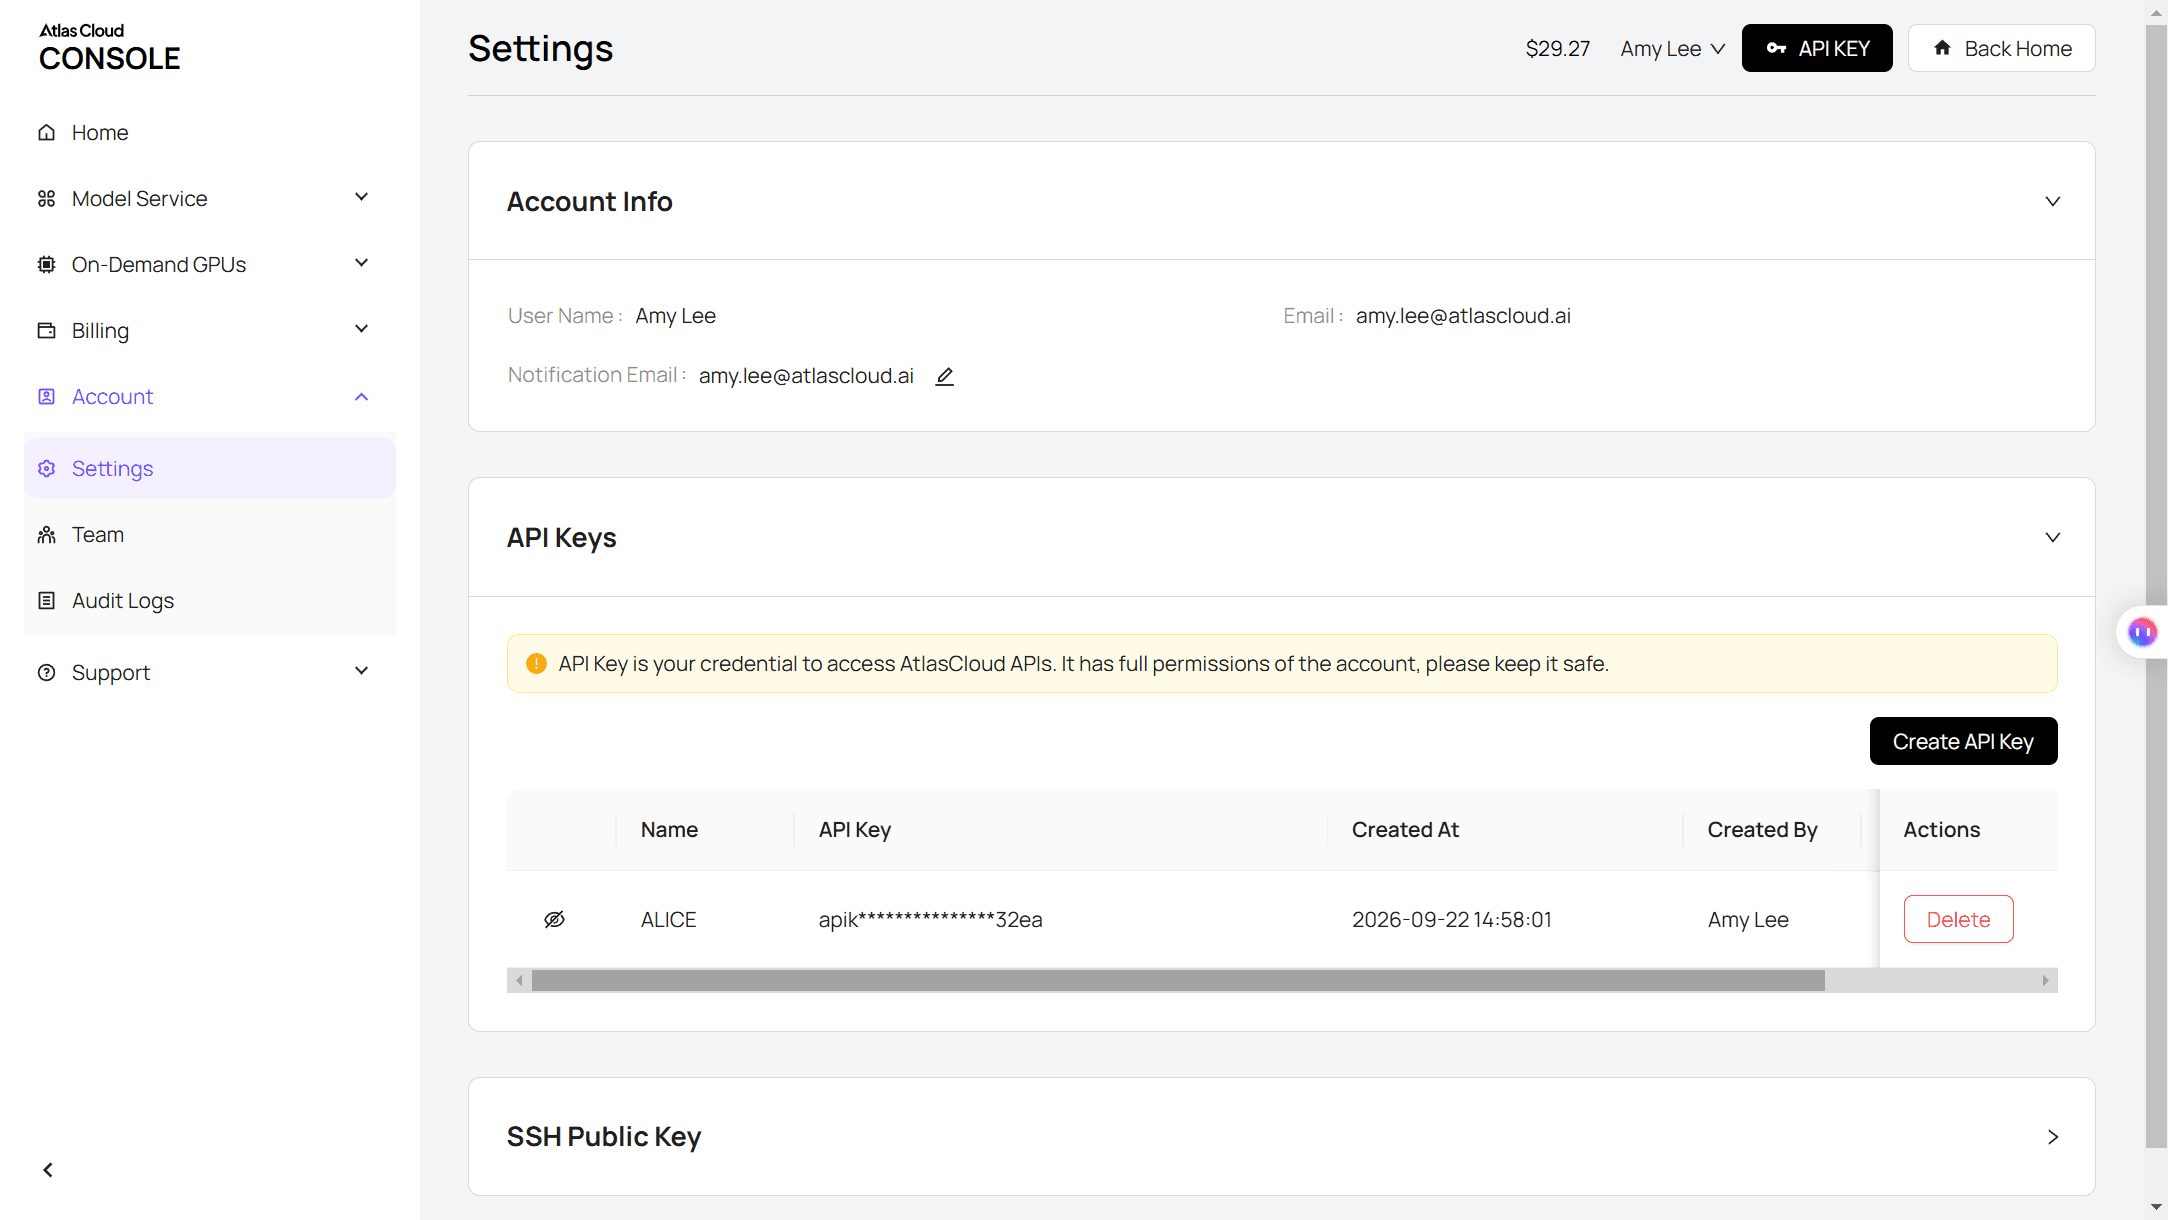
1단계: API 키 생성. 콘솔에서 Settings를 열고 API Keys로 이동하여 Create API Key를 클릭합니다. 서버 측에 보관하세요.
2단계: 요청 형식 확인. API 문서에서 채팅 완성 형식을 다루며, 모델 페이지에는 바로 사용할 수 있는 예제가 있는 API 탭이 있습니다.
3단계: 첫 요청 전송.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
답변은 choices[0].message.content로 돌아옵니다. 엔드포인트가 OpenAI 형식을 따르므로, 로컬 gpt-oss 서버용으로 작성된 코드는 보통 새 base URL, 키, 모델 문자열만 있으면 됩니다. 동일한 키는 플랫폼의 다른 채팅 모델에서도 작동하며, 통합 LLM API 게이트웨이에 관한 저희 글에서 자세히 다룹니다.
GPT-OSS-120B vs GPT-OSS-20B: 메모리와 벤치마크 트레이드오프
더 작은 형제 모델은 메모리의 5분의 1이 필요합니다. gpt-oss-20b는 20.9B 파라미터에 활성 3.6B이며, OpenAI는 "최소 16GB 메모리"에서 실행된다고 합니다. 문제는 무엇을 포기하는가입니다.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | 8K 컨텍스트에서의 메모리 (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (도구 없음) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (도구 없음) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
점수는 높은 추론 노력에서의 모델 카드에서 가져왔습니다. 코딩 격차는 SWE-Bench Verified에서 2점 미만인 반면, 지식 격차는 대학원 수준 과학에서 약 9점, HealthBench에서 15점입니다. 대부분 코드 작업을 16GB~24GB 카드에서 한다면 20b가 합리적인 선택입니다. 추가 지식이 필요하신가요? 그때가 바로 120b가 메모리 비용을 정당화하는 지점입니다.
GGUF, Ollama, vLLM: 메모리 예산에 맞는 런타임 선택
각각은 OpenAI가 출시한 MXFP4 가중치를 실행하지만, 해당 가중치가 어디에 위치할 수 있는지가 다릅니다.
| 런타임 | 다운로드 | 최적 용도 |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | 전체 모델을 담을 수 있는 장비에서 한 사용자 |
| LM Studio | 65 GB | Mac 또는 Windows PC의 데스크톱 앱 |
| llama.cpp (ggml-org GGUF) | 약 63 GB | VRAM이 65GB 미만이며, 전문가 레이어를 RAM으로 오프로드 |
| vLLM | 약 65 GB의 safetensors | 하나 이상의 데이터 센터 GPU에서 다수 사용자 서비스 |
대용량 메모리 장비에서 빠르게 시작하려면:
plaintext1ollama run gpt-oss:120b
더 작은 GPU의 경우 llama.cpp를 사용하고 오프로드 수를 조정하세요:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
네 가지 모두 모델이 제대로 작동하는 데 필요한 OpenAI의 harmony 채팅 형식을 처리합니다. 자체 서빙 코드를 작성하는 경우에만 중요합니다.
FAQ
GPT-OSS-120B가 GPT-5나 Gemini 3 Pro보다 나은가요?
이들은 서로 다른 범주에 속합니다. GPT-5와 Gemini는 앱이나 API를 통해 접근하는 폐쇄형 모델인 반면, gpt-oss-120b는 자체 하드웨어에서 실행됩니다. Gemini 3 Pro Preview는 2026년 3월 9일에도 종료되었으며, 그 이름은 이제 Gemini 3.1 Pro Preview를 가리킵니다. 로컬 제어가 중요하다면 Google의 오픈 웨이트 라인은 Gemma 4 제품군입니다.
일부 사이트에서 GPT-OSS-120B가 255GB가 필요하다고 하는 이유는 무엇인가요?
그 수치는 16비트 가중치를 가정합니다. 대략 117B 파라미터 곱하기 2바이트에 오버헤드가 더해집니다. OpenAI가 게시한 체크포인트는 이미 MXFP4이므로, 현실적인 다운로드는 61GB 범위입니다.
추론 노력이 메모리 사용을 바꾸나요?
가중치에는 아닙니다. low, medium, high 설정은 모델이 얼마나 오래 생각하는지를 바꿉니다. 높은 노력은 더 많은 추론 토큰을 생성하며, 이는 컨텍스트 윈도우를 채우고 KV 캐시를 키우므로, 긴 세션은 위 차트의 더 큰 총계로 서서히 다가갑니다.
사람들이 GPT-OSS-120B가 텍스트 기반 게임에 약하다고 하는 이유는 무엇인가요?
증거는 일화적입니다. 모델의 Hugging Face 토론 페이지에서 일부 사용자는 폭력적인 소설을 쓸 때 거부가 발생한다고 보고하는 반면, 다른 이들은 롤플레이가 잘 작동한다고 합니다. 인터랙티브 픽션의 경우, 하드웨어를 구매하기 전에 자신의 프롬프트로 테스트하세요.
호스팅된 120B급 모델의 비용은 얼마인가요?
2026년 10월 기준으로 Qwen3.5 122B A10B는 Atlas Cloud에서 백만 입력 토큰당 $0.3, 백만 출력 토큰당 $2.4입니다. 이는 정가인 $0.4와 $3.2 대비 25% 할인입니다. 저희 크기 산정 질문은 추론이 계산된 후 약 5,000개의 출력 토큰을 사용했으며, 할인 요율로 약 1센트입니다.
결론
GPT-OSS-120B는 파라미터 수가 시사하는 것보다 적재하기 쉽습니다. 일상적인 컨텍스트 길이에서는 약 65GB, 전체 131K에서는 70GB 미만을 예상하세요. 80GB GPU 하나, 96GB 이상의 Mac, 또는 128GB 미니 PC가 이를 담을 수 있으며, 더 작은 카드는 전문가 레이어를 시스템 RAM으로 옮겨 실행할 수 있습니다.
이 숫자들이 여러분의 장비를 배제한다면, 대부분 코딩 작업에는 gpt-oss-20b로 낮추거나, 하드웨어를 구매하지 않고 더 큰 두뇌가 필요할 때 호스팅된 오픈 웨이트 모델을 호출하세요. 어느 쪽이든, 가중치가 61GB를 차지하고 나머지는 여유 공간이라는 것을 알면 gpt oss 120b 메모리 요구 사항은 더 이상 추측 게임이 아닙니다.


