캐릭터가 드디어 제대로 나왔습니다. 조명도, 움직임도, 구도도 모두 완벽하죠. 그런데 입이 움직이는 순간 대사와 전혀 맞지 않습니다. 그 한 순간에 클립 전체가 무너집니다.
바로 그 불일치를 해결하기 위해 만들어진 것이 PixVerse Lip Sync입니다. 비디오와 오디오 트랙을 입력받아 입 모양을 소리에 맞추기 때문에, 대사든 노래든 내레이션이든 더빙한 티가 나지 않고 실제처럼 보입니다. 이 가이드에서는 pixverse ai lip sync 기능이 실제로 어떻게 작동하는지, 비용은 얼마인지, 그리고 2026년 현재 여전히 부족한 점은 무엇인지 다룹니다.
핵심 요약
- PixVerse의 Speech (Lip Sync) 기능은 오디오와 입 움직임을 함께 분석해 서로 맞아떨어지도록 비디오를 다시 렌더링하며, 여러 언어의 대사와 노래, 광고를 지원합니다.
- 소스 비디오는 MP4 또는 MOV 형식으로 30초, 1920p, 50MB까지 지원되며, 오디오는 직접 준비한 MP3/WAV 파일이나 PixVerse 내장 텍스트-음성 변환을 쓸 수 있고 요청당 약 140자로 제한됩니다.
- PixVerse 자체 플랫폼에서 립싱크는 오디오 1초당 4크레딧, TTS 텍스트 15바이트당 4크레딧이 부과되며, 이는 소스 비디오에 이미 들어간 비용에 더해집니다.
- Atlas Cloud는 별도의 재더빙 엔드포인트를 제공하지 않지만, PixVerse V6와 C1은 생성 과정에서 동기화된 음성과 입 움직임을 네이티브로 만들어냅니다. 360p 오디오 포함 기준 초당 $0.035 (V6) 또는 $0.04 (C1)입니다.
PixVerse Lip Sync란 무엇인가요?
PixVerse 립싱크는 공식 명칭으로 Speech (Lip Sync) 기능이며, 비디오와 오디오 소스를 받아 말하는 내용에 맞도록 입 모양을 다시 렌더링합니다. PixVerse 플랫폼 문서에 따르면, 시스템은 오디오와 화자의 기존 입 움직임을 함께 분석한 뒤 어긋난 부분을 보정합니다. 여러 언어의 대사, 노래, 광고형 내레이션에 두루 작동합니다.
이미 갖고 있는 비디오를 넣어도 되고, PixVerse가 방금 생성해 준 비디오를 넣어도 됩니다. 어느 쪽이든 입력과 출력은 동일한 제한을 그대로 따릅니다.
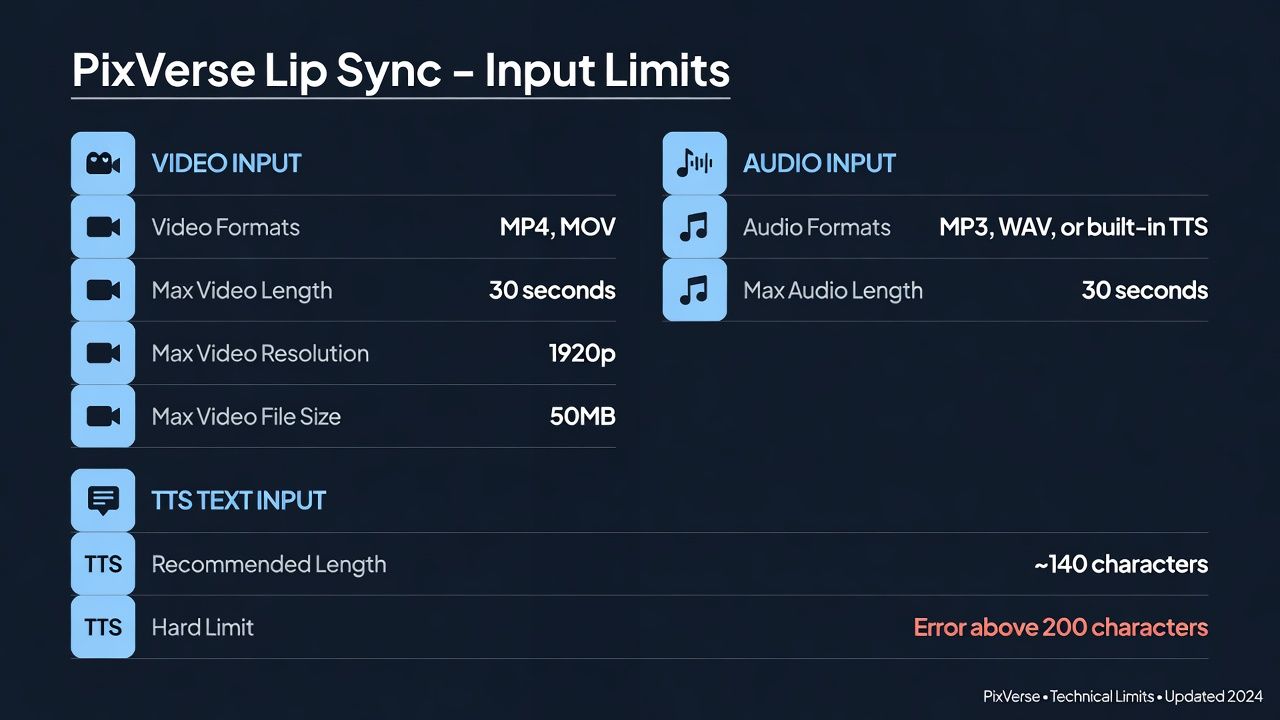
30초를 넘는 소재는 먼저 잘라야 합니다. 현재로서는 이 상한을 부분적으로라도 우회할 방법이 없습니다.
누가, 왜 PixVerse AI 립싱크를 사용하나요?
이 기능은 정지 이미지나 소리 없는 클립이 무언가를 말해야 하는 곳이라면 어디에나 등장합니다. 이들 모두를 관통하는 공통점은 같습니다. 아무것도 다시 촬영하지 않고 목소리를 얼굴에 맞추는 것이죠.
| 사용 사례 | 립싱크가 해결하는 것 |
|---|---|
| 더빙 및 현지화 | 재촬영 없이 새로운 언어로 클립을 다시 더빙 |
| 말하는 아바타 | 정지된 인물 사진을 말하는 발표자로 전환 |
| 소셜 클립 | 기존 영상에 내레이션이나 보이스오버 대사를 추가 |
| 음악 및 노래 클립 | 대사뿐 아니라 보컬 트랙에도 입 움직임을 맞춤 |
| 광고 보이스오버 | 이미 촬영된 캐릭터에 브랜드 스크립트를 동기화 |
더빙 사례는 대부분의 가이드가 건너뛰는 활용법입니다. 이 기능은 지원되는 언어라면 어떤 오디오 트랙에서도 작동하기 때문에, 소스 비디오 하나를 영상 자체를 다시 생성하지 않고도 목표 언어마다 한 번씩 여러 차례 다시 동기화할 수 있습니다. 재촬영하거나 시장마다 목소리를 맞춰 줄 편집자를 따로 고용하는 것보다 확실히 저렴한 현지화 사이클입니다.
Atlas Cloud로 PixVerse Lip Sync 기능을 대규모로 운영하기
PixVerse 앱에서 클립 하나를 손으로 동기화하는 것은 게시물 한 건이라면 충분합니다. 하지만 하루에 수십 개의 말하는 클립을 렌더링하는 파이프라인에 pixverse ai lip sync를 연결하는 일은 전혀 다른 문제이고, 바로 그 문제를 풀기 위해 만들어진 것이 Atlas Cloud입니다.
먼저 솔직한 단서를 달아두겠습니다. Atlas Cloud에는 PixVerse의 Speech (Lip Sync) 도구처럼 기존 비디오를 재더빙해 주는 단독 엔드포인트가 없습니다. 대신 PixVerse 모델 제품군 전체를 호스팅합니다. V6와 C1 모두 비디오와 동일한 패스에서 동기화된 음성과 입 움직임을 네이티브로 생성합니다. 프롬프트를 작성하면 모델이 첫 프레임부터 오디오가 맞물린 말하는 캐릭터를 만들어냅니다.
사후 보정 도구와는 다른 워크플로우입니다. 하지만 근본적으로 같은 과제를 해결합니다. 입 모양이 대사와 맞는 캐릭터를 화면에 올리는 것이죠. 모든 등급에서 워터마크가 없고, 새로운 PixVerse 버전은 출시 당일부터 사용할 수 있습니다.
PixVerse Lip Sync 비용은 얼마인가요?
두 경로의 과금 방식은 깔끔하게 맞아떨어지지 않으므로, 계산을 나란히 놓고 보겠습니다.
PixVerse 자체 플랫폼에서 Speech (Lip Sync) 엔드포인트는 직접 오디오를 제공할 경우 초당 4크레딧, 내장 TTS를 사용할 경우 UTF-8로 인코딩된 텍스트 15바이트당 4크레딧을 부과합니다. 이는 소스 비디오에 이미 들어간 비용에 더해지는 금액입니다. 15,000크레딧에 $100인 Essential API 플랜 요율, 즉 크레딧당 약 $0.0067로 계산하면 직접 준비한 오디오로 5초를 동기화할 때 약 20크레딧, 즉 $0.13 정도가 들고, 여기에 월 $100의 최저 금액은 별도입니다.
Atlas Cloud에는 별도의 동기화 요금이 아예 없습니다. 오디오와 입 움직임이 비디오와 함께 생성되고, 클립 전체가 월 최저 사용액 없이 초 단위로 과금됩니다. V6는 360p 기준 오디오 없이 초당 $0.025부터, 오디오를 포함하면 초당 $0.035부터이므로 5초짜리 말하는 클립은 전부 합쳐 $0.175입니다. 멀티샷 C1 버전은 360p 오디오 포함 초당 $0.04로 약간 더 비쌉니다.
| 경로 | 과금 기준 | 5초짜리 말하는 클립 |
|---|---|---|
| PixVerse 플랫폼 (Speech/Lip Sync) | 오디오 초당 4크레딧, 소스 비디오 자체 비용에 추가 | 20크레딧 ($0.13) + 월 $100 API 최저액 |
| Atlas Cloud (생성 시 네이티브 오디오) | 해상도별 초 단위 과금, 비디오와 오디오가 한 가격 | V6 360p 오디오 포함 시 $0.175 |
둘을 나란히 놓으면 패턴이 분명해집니다. 한 달에 클립 몇 개 이상을 렌더링하는 순간부터는 초 단위 과금이 선불 크레딧 최저액보다 유리합니다. PixVerse의 월 $100 최저 금액은 매 주기마다 15,000크레딧 중 상당 부분을 실제로 쓸 때에야 수지가 맞습니다. V6의 전체 요금표를 더 깊이 뜯어본 내용은 PixVerse V6 리뷰에서 모든 해상도 등급에 대한 초 단위 계산과 함께 확인할 수 있습니다.
Atlas Cloud에서 사용하는 방법
방법 1: 브라우저에서, 코드 없이. Atlas Cloud에 로그인해 PixVerse V6 텍스트-비디오 플레이그라운드를 엽니다. 프롬프트에 장면과 말하게 할 대사를 적고, 사운드 토글은 켠 채로 두고, 길이와 해상도를 고른 뒤 페이지에서 바로 생성하면 됩니다.
방법 2: API를 통해, 세 단계입니다:
-
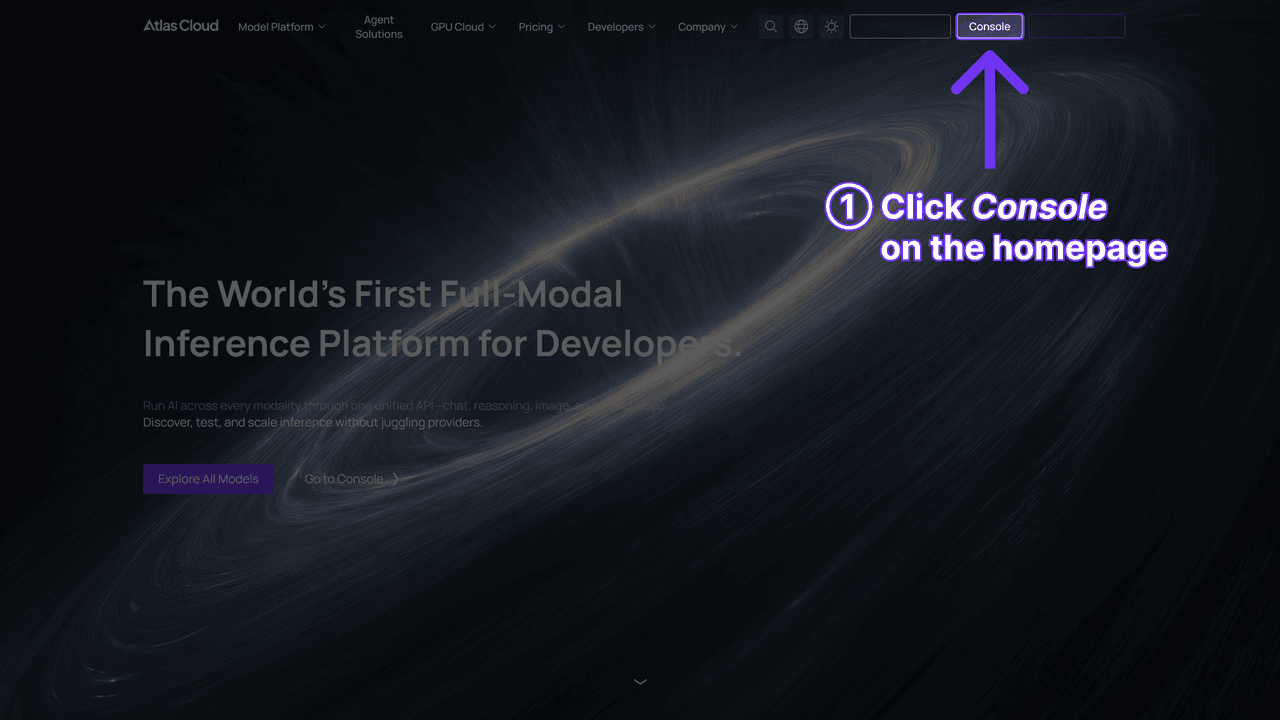
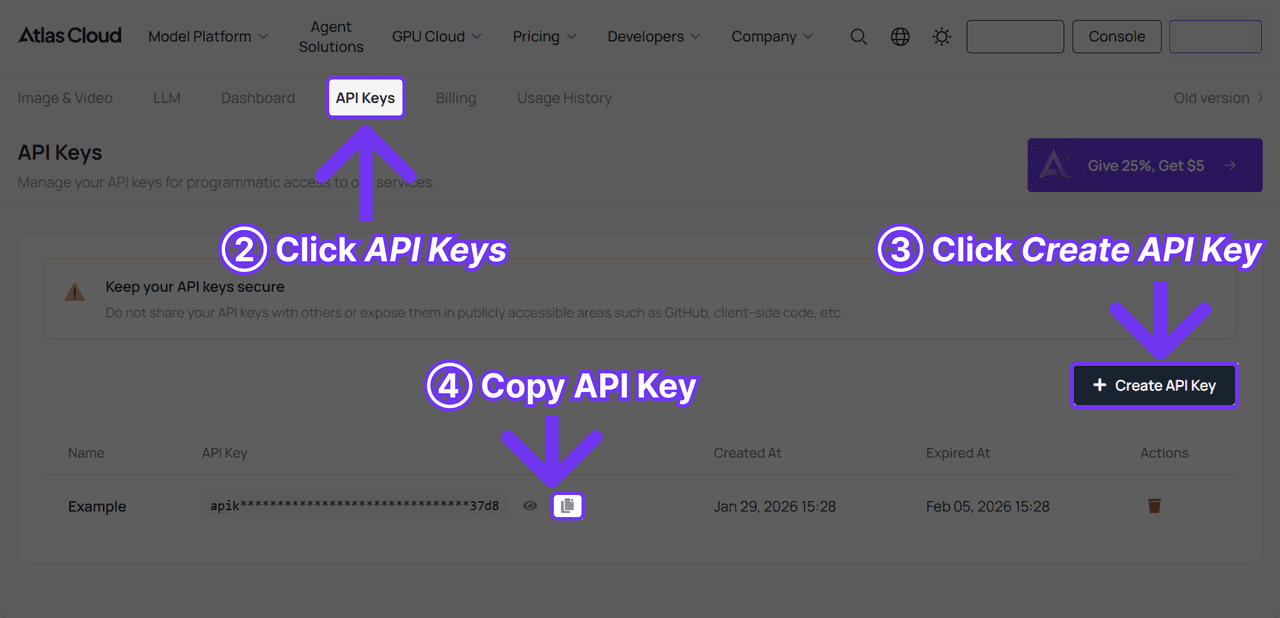
API 키를 발급받으세요. 콘솔 대시보드에서 키를 생성하고 복사합니다.
-
엔드포인트, 요청 매개변수, 인증 방식은 Atlas Cloud API 문서에서 확인하세요.
-
첫 요청을 보내세요. 플랫폼의 모든 모델이 하나의 API, 하나의 호출 규약을 씁니다. 새 모델이 나오면 요청에서 모델 이름만 바꾸면 됩니다.
pixverse/v6에서 Seedance, Kling, Wan으로 재통합 없이 전환할 수 있고, 덕분에 모델별 네이티브 오디오 품질 A/B 테스트도 한 줄만 고치면 끝납니다.
동기화 과정은 실제로 어떻게 작동하나요?
다시 PixVerse 자체 플랫폼으로 돌아가면, 같은 결과에 이르는 두 가지 경로가 있습니다. 직접 오디오 파일을 제공하거나, 텍스트를 입력해 PixVerse의 TTS 음성이 대신 말하게 할 수 있습니다. 둘 다 입력만 다를 뿐 같은 엔드포인트를 거칩니다.
PixVerse의 사용 가이드는 네 가지 유효한 조합을 제시합니다. 어느 조합이든 도착점은 같습니다. 비디오 ID 하나와 오디오 소스 하나가 있으면 시스템이 매칭을 처리합니다.
| 비디오 소스 | 오디오 소스 |
|---|---|
| 이미 생성된 PixVerse 비디오 | 직접 업로드한 오디오 |
| 이미 생성된 PixVerse 비디오 | 내장 TTS 텍스트 |
| 새로 업로드한 비디오 | 직접 업로드한 오디오 |
| 새로 업로드한 비디오 | 내장 TTS 텍스트 |
작동 방식은 단순합니다. 비디오를 업로드하고, 오디오를 업로드하거나 생성하고, 둘을 짝지어 제출한 뒤 렌더링이 끝날 때까지 폴링하면 됩니다. 문서에 명시된 함정이 하나 있습니다. 비디오보다 긴 TTS 오디오는 클립을 늘리는 대신 잘려 나가므로, 제출 전에 대사 길이를 영상에 맞춰 두세요.
더 깔끔한 PixVerse 립싱크 결과를 위한 팁
오디오 품질이 가장 큰 지렛대입니다. PixVerse 공식 문서도 이 점을 분명히 말합니다. 입 모양 매칭이 제대로 맞으려면 오디오가 깨끗해야 합니다. 잡음이 많은 녹음이나 웅얼거리는 TTS 대사는 모델이 참고할 신호를 줄일 뿐입니다.
실제로 차이를 만드는 두 가지 습관이 있습니다:
- 렌더링 전에 스크립트 분량을 맞추세요. TTS 대사 한 줄을 140자 안팎으로 유지하고 클립 길이에 맞춰 타이밍을 잡으면, 오류가 나거나 단어 중간에서 잘리는 일이 없습니다. 스크립트가 길어지면 클립 구간마다 하나씩 여러 번의 동기화 호출로 나뉩니다.
- 입이 잘 보이는 소스 영상을 고르세요. 측면 샷이나 일부가 가려진 얼굴은 정면이 깨끗하게 보이는 프레임보다 모델이 맞출 근거를 적게 줍니다.
특별할 것 없는 이야기입니다. 오디오 기반 비디오 도구 전반을 지배하는 원칙과 똑같습니다. 깨끗한 입력이 들어가야 깨끗한 동기화가 나옵니다.
PixVerse Lip Sync의 한계는 어디인가
실전에서 가장 빨리 부딪히는 제한이 두 가지 있습니다. 30초, 50MB의 소스 상한 때문에 이 기능은 짧은 클립용 도구가 되며, 영상을 먼저 나누지 않고는 긴 독백을 감당하지 못합니다. 그리고 TTS 글자 수 상한 탓에 실제 스크립트는 한 번에 끝나지 않고 여러 번의 동기화 호출을 이어 붙여야 합니다.
연기 전체를 옮겨 오는 기능도 아닙니다. 입 모양은 소리에 잘 맞추지만 눈썹, 시선, 고개 기울기 같은 나머지 연기는 건드리지 않고 여전히 원본 영상에서 그대로 가져옵니다. 얼굴 전체가 장면을 이끄는 클로즈업 대사에서는 이 간극이 넓은 샷에서보다 더 눈에 띕니다.
자주 묻는 질문
PixVerse 립싱크란 무엇인가요?
PixVerse의 Speech (Lip Sync) 기능입니다. 비디오와 오디오 소스를 제공하면 시스템이 둘을 함께 분석한 뒤, 말하는 내용에 맞도록 입 모양을 다시 렌더링합니다. 여러 언어의 대사, 노래, 광고 내레이션을 지원합니다.
PixVerse 립싱크 기능의 비용은 얼마인가요?
PixVerse 자체 플랫폼에서는 오디오 1초당 4크레딧, TTS 텍스트 15바이트당 4크레딧이며, 소스 비디오 자체 비용에 더해집니다. 15,000크레딧에 $100인 Essential 요율 기준으로 직접 준비한 오디오로 5초를 동기화하면 약 $0.13이 들고, 여기에 플랜의 월 최저 금액은 별도로 계산해야 합니다.
pixverse ai lip sync에서 오디오를 업로드하는 대신 텍스트-음성 변환을 쓸 수 있나요?
가능합니다. PixVerse의 내장 TTS가 음성을 직접 생성하므로 오디오 파일이 필요 없습니다. 매개변수 사양은 대사 한 줄을 140자 안팎으로 유지하도록 권장하며, 200자를 넘으면 요청이 오류를 냅니다. 따라서 더 긴 스크립트는 여러 번의 동기화 호출로 나눠야 합니다.
Atlas Cloud는 PixVerse 립싱크 API를 제공하나요?
단독 재더빙 엔드포인트는 없습니다. Atlas Cloud는 PixVerse V6와 C1을 호스팅하며, 이 모델들은 이미 갖고 있는 영상에 새 오디오를 입히는 방식이 아니라 텍스트-비디오 또는 이미지-비디오 생성 과정에서 동기화된 음성과 입 움직임을 네이티브로 만들어냅니다. 360p 오디오 포함 기준 V6는 초당 $0.035, C1은 초당 $0.04입니다.
pixverse 립싱크 기능은 어느 정도 길이의 비디오를 지원하나요?
소스 비디오는 MP4 또는 MOV 형식으로 30초, 1920p 해상도, 50MB까지 지원됩니다. 그보다 긴 영상은 동기화하기 전에 더 짧은 구간으로 나눠야 합니다.
결론
PixVerse 립싱크는 좁지만 실재하는 문제를 잘 해결합니다. 아무것도 다시 촬영하지 않고 입 모양을 목소리에 맞추는 일이죠. 30초 상한과 TTS 글자 수 제한 탓에 짧은 클립용 도구에 머물지만, 더빙이나 말하는 아바타, 빠른 보이스오버 작업이라면 속도가 빠르고 초당·바이트당 요율만 알면 크레딧 계산도 간단합니다.
워크플로우에 맞춰 경로를 고르세요. 이미 갖고 있는 영상을 동기화하는 일은 PixVerse 자체 기능의 몫입니다. 첫 프레임부터 오디오가 담긴 말하는 캐릭터를 처음부터 생성하는 일은 Atlas Cloud의 PixVerse V6가 맡으며, 미리 계획해야 할 월 최저 금액 없이 초 단위로 과금됩니다. 어느 경로든 한 번에 원하는 결과를 얻게 해 주는 프롬프트 작성법은 [PixVerse 프롬프트 가이드](pixverse-prompts-guide.md)에서 다루며, 재렌더링이 필요 없게 만드는 표현들을 정리했습니다.


