De downloadbalk tikt 65 GB aan, de ventilatoren gaan draaien en dan komt de echte vraag: laadt het daadwerkelijk? Het korte antwoord op GPT-OSS-120B-geheugenvereisten is ongeveer 61 GB voor de gewichten plus nog wat extra voor werkruimte, daarom positioneert OpenAI het als een model voor één 80GB-GPU.
Hieronder splitsen we dat getal op in onderdelen, laten we de hardware zien waarop het is gedraaid met gemeten snelheden, en behandelen we de gehoste route voor wanneer jouw setup tekortschiet.
Belangrijkste punten
- GPT-OSS-120B wordt geleverd als een 60,8 GiB MXFP4-checkpoint, daarom richt OpenAI zich op één 80GB-GPU.
- Contextlengte voegt weinig geheugen toe: de KV-cache bereikt slechts ongeveer 4,5 GiB bij de volledige 131K tokens.
- Met minder dan 80GB VRAM kan llama.cpp expertlagen naar systeem-RAM offloaden en het toch draaien.
- Macs met meer dan 96GB geheugen en 128GB-mini-pc's kunnen het volledige model op één machine bevatten.
- Geen geschikte hardware? Roep Qwen3.5 122B A10B op Atlas Cloud aan via één OpenAI-compatibele API.
GPT-OSS-120B-geheugenvereisten: gewichten plus KV-cache
OpenAI bracht gpt-oss-120b op 5 augustus 2025 uit onder de Apache 2.0-licentie. Het is een mixture-of-experts-model, dus slechts 5,1B van zijn 116,8B parameters werken per token. Dat helpt de snelheid, niet het geheugen: elke expert moet nog steeds in het geheugen staan om gekozen te kunnen worden.
De truc die het klein houdt, is MXFP4. Volgens de gpt-oss-modelkaart worden de expertgewichten, die meer dan 90% van de parameters vormen, opgeslagen met 4,25 bits elk. Een 16-bits kopie van hetzelfde model zou ongeveer vier keer zoveel ruimte nodig hebben.
| Specificatie | GPT-OSS-120B |
|---|---|
| Totaal aantal parameters | 116,8B |
| Actieve parameters per token | 5,1B |
| Lagen en experts | 36 lagen, 128 experts, 4 actief per token |
| Gewichtsformaat | MXFP4 voor expertlagen, BF16 voor de rest |
| Checkpointgrootte | 60,8 GiB |
| Contextvenster | 131.072 tokens |
Hoe het contextvenster de GPT-OSS-120B-geheugenvereisten verandert
Elk token laat een sleutel en een waarde achter in elke attentielaag. Die opslag is de KV-cache, en wanneer elke laag op de volledige context let, groeit die mee met de contextlengte.
GPT-OSS-120B ontwijkt het grootste deel. De helft van zijn 36 lagen gebruikt een schuifvenster dat slechts 128 tokens terugkijkt, en elke laag slaat slechts 8 KV-heads van 64 dimensies op. Alleen 18 lagen bewaren de volledige context. We hebben de KV-cache afgeleid uit de config van het model en die komt overeen met de gemeten totalen in de llama.cpp gpt-oss-gids.
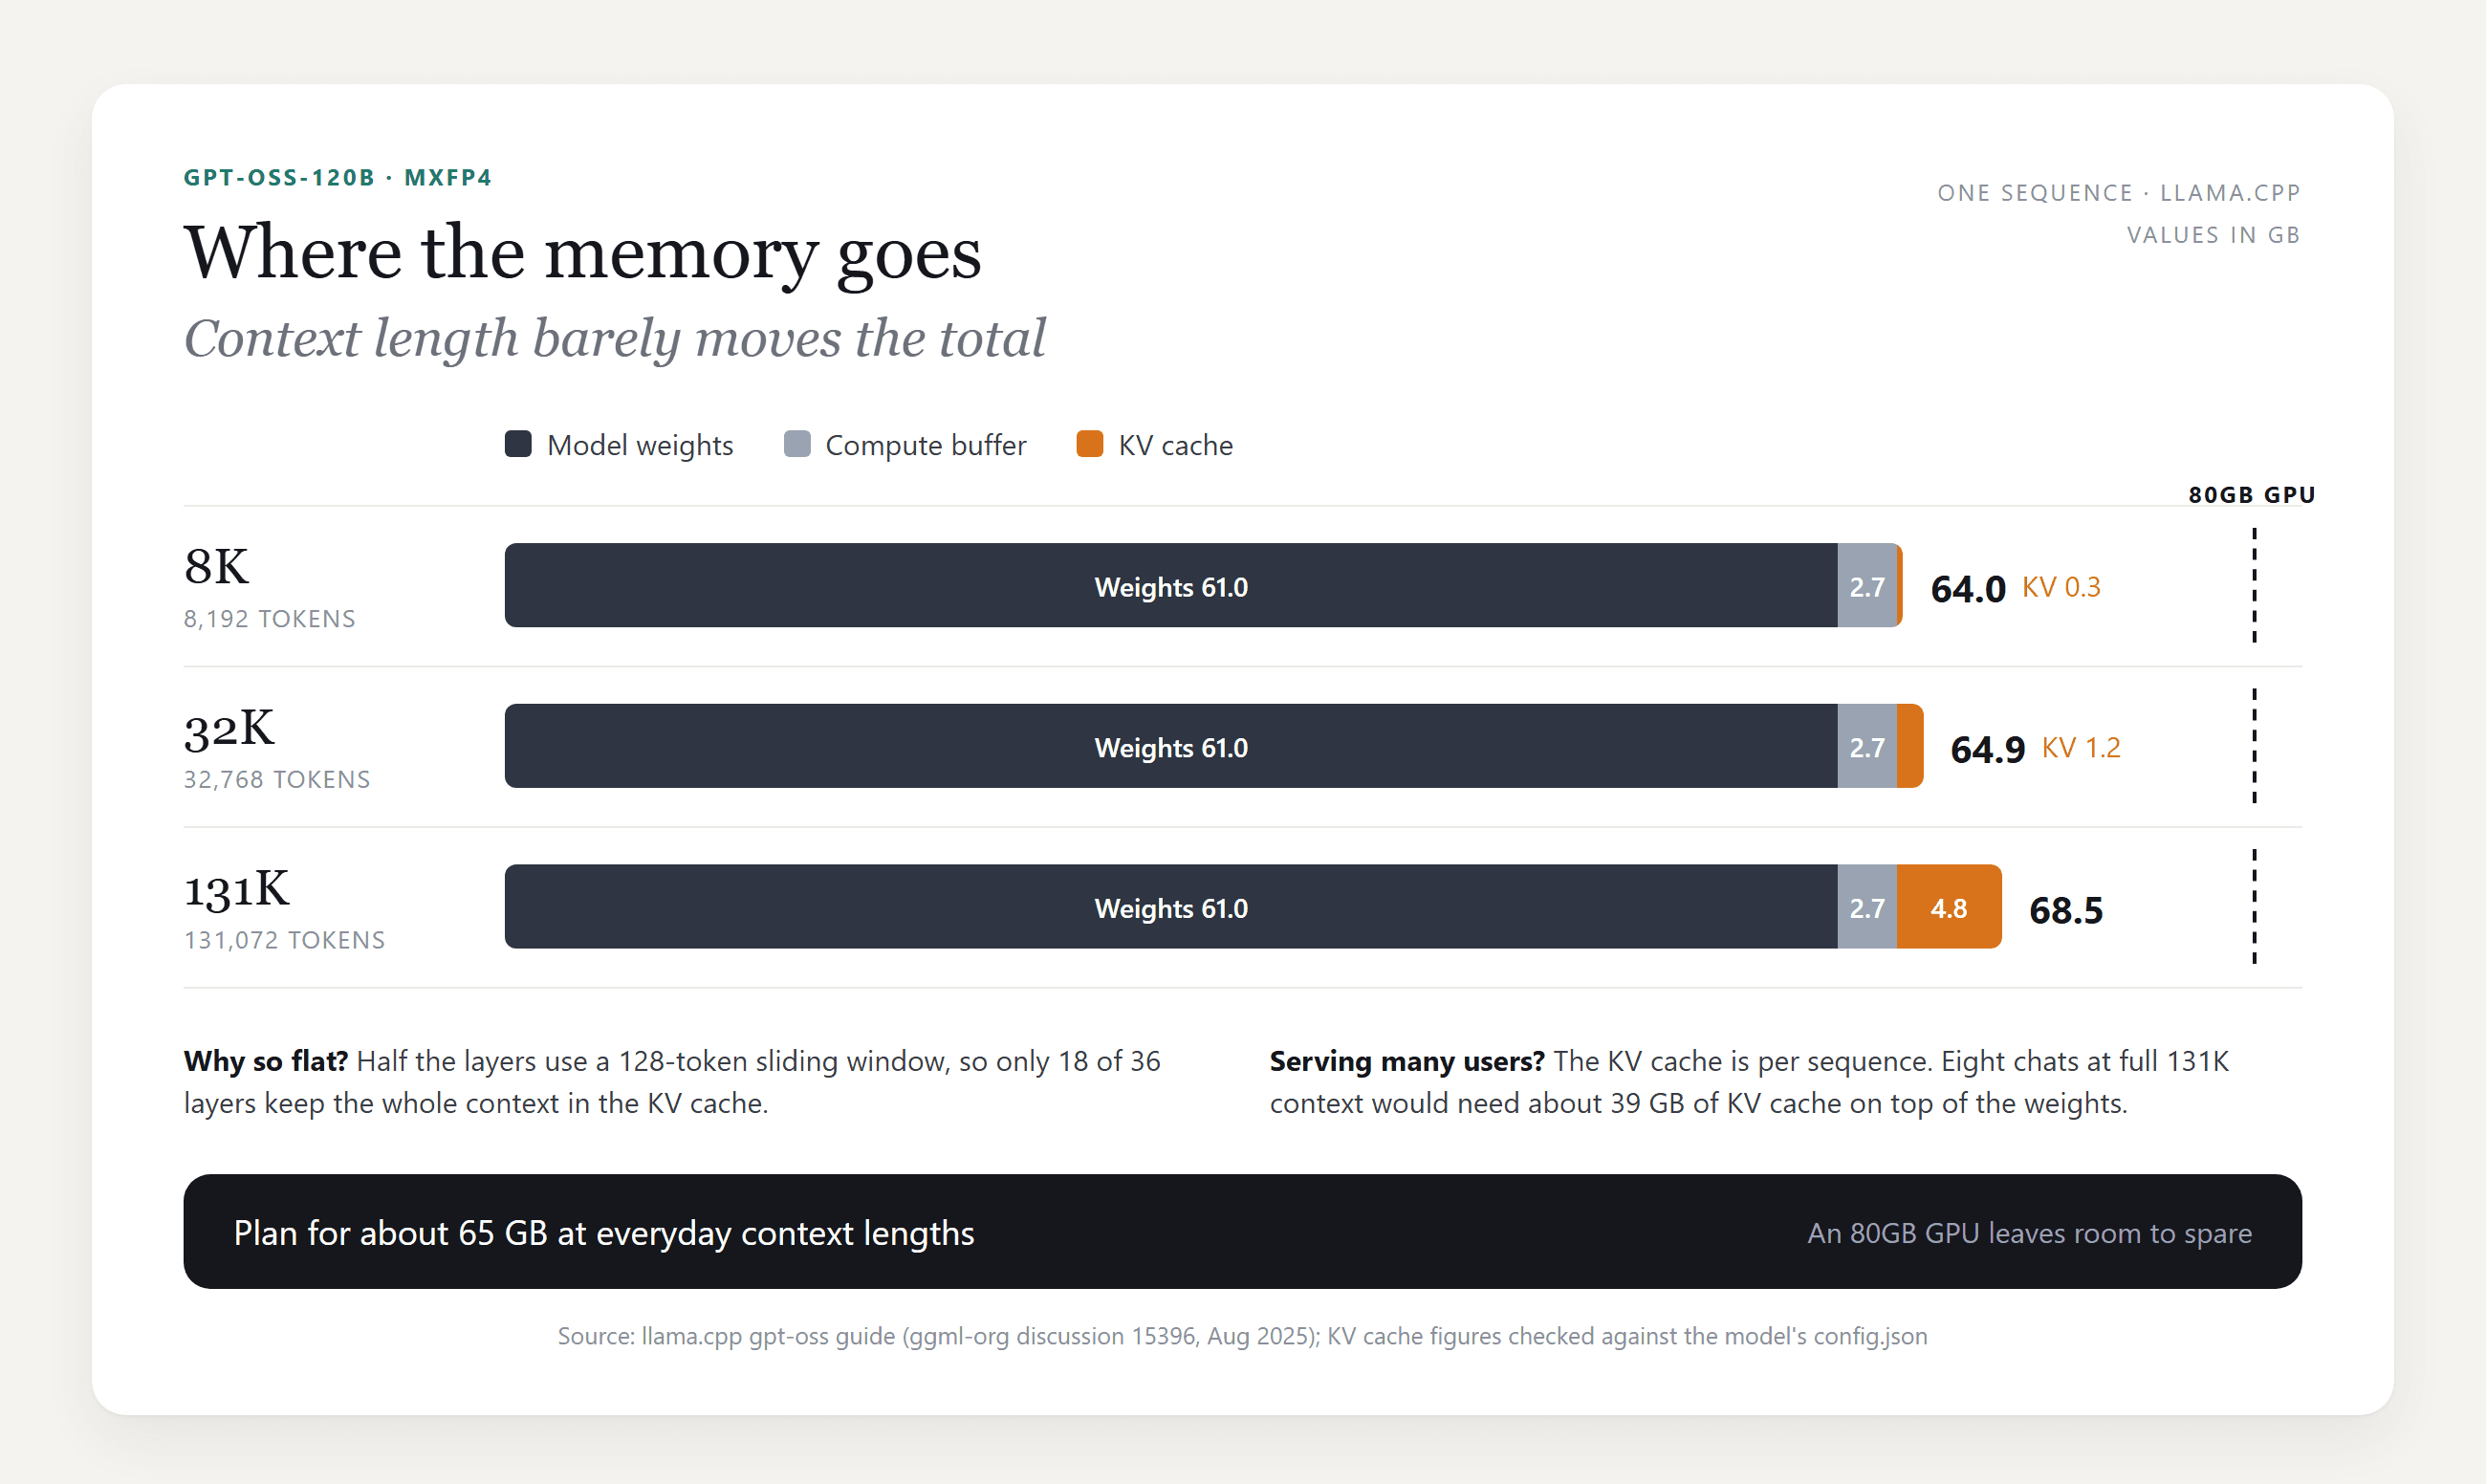
Van 8K naar de volledige 131K gaan kost minder dan 5 GB. Waar het oploopt, is gelijktijdigheid: de KV-cache is per gesprek, dus een server met acht gesprekken van volledige lengte heeft ongeveer 39 GB bovenop de gewichten nodig.
Kan ik GPT-OSS-120B lokaal draaien? Hardwarevereisten per opstelling
Ja, als je ongeveer 65 GB ergens snels kunt plaatsen: één grote GPU, een GPU plus systeem-RAM, of een machine met geünificeerd geheugen.
GPT-OSS-120B-GPU-vereisten
Het eenvoudigste geval is één datacenterkaart van 80GB. Het vLLM-recept voor gpt-oss zegt dat het 120b-model "op één A100 (80GB) past", en dat het splitsen over meer GPU's de doorvoer helpt.
Onder 80GB biedt de llama.cpp-gids een uitweg. De --n-cpu-moe-flag houdt sommige expertlagen in systeem-RAM en de rest op de GPU. De gids noemt ongeveer 8GB VRAM als minimum, zolang GPU- en systeemgeheugen samen het model nog kunnen bevatten.
| Opstelling | Waar de gewichten staan | Gerapporteerde generatiesnelheid |
|---|---|---|
| RTX Pro 6000, 96GB | Allemaal op de GPU | 196 tokens/s (llama.cpp-gids) |
| A100 of H100, 80GB | Allemaal op de GPU | Past op één kaart (vLLM-recept) |
| RTX 5090, 32GB, plus systeem-RAM | 21 expertlagen in systeem-RAM gehouden | Ongeveer 30 tokens/s bij nul context (llama.cpp-gids) |
Eén Windows-valkuil uit dezelfde gids: de driver kan stilletjes naar systeem-RAM wegschrijven wanneer VRAM vol raakt, waardoor het model laadt en daarna kruipt. Let op GPU Memory in Taakbeheer en verhoog het offload-aantal tot het onder de grootte van je kaart blijft.
GPT-OSS-120B draaien op een Mac of 128GB-mini-pc
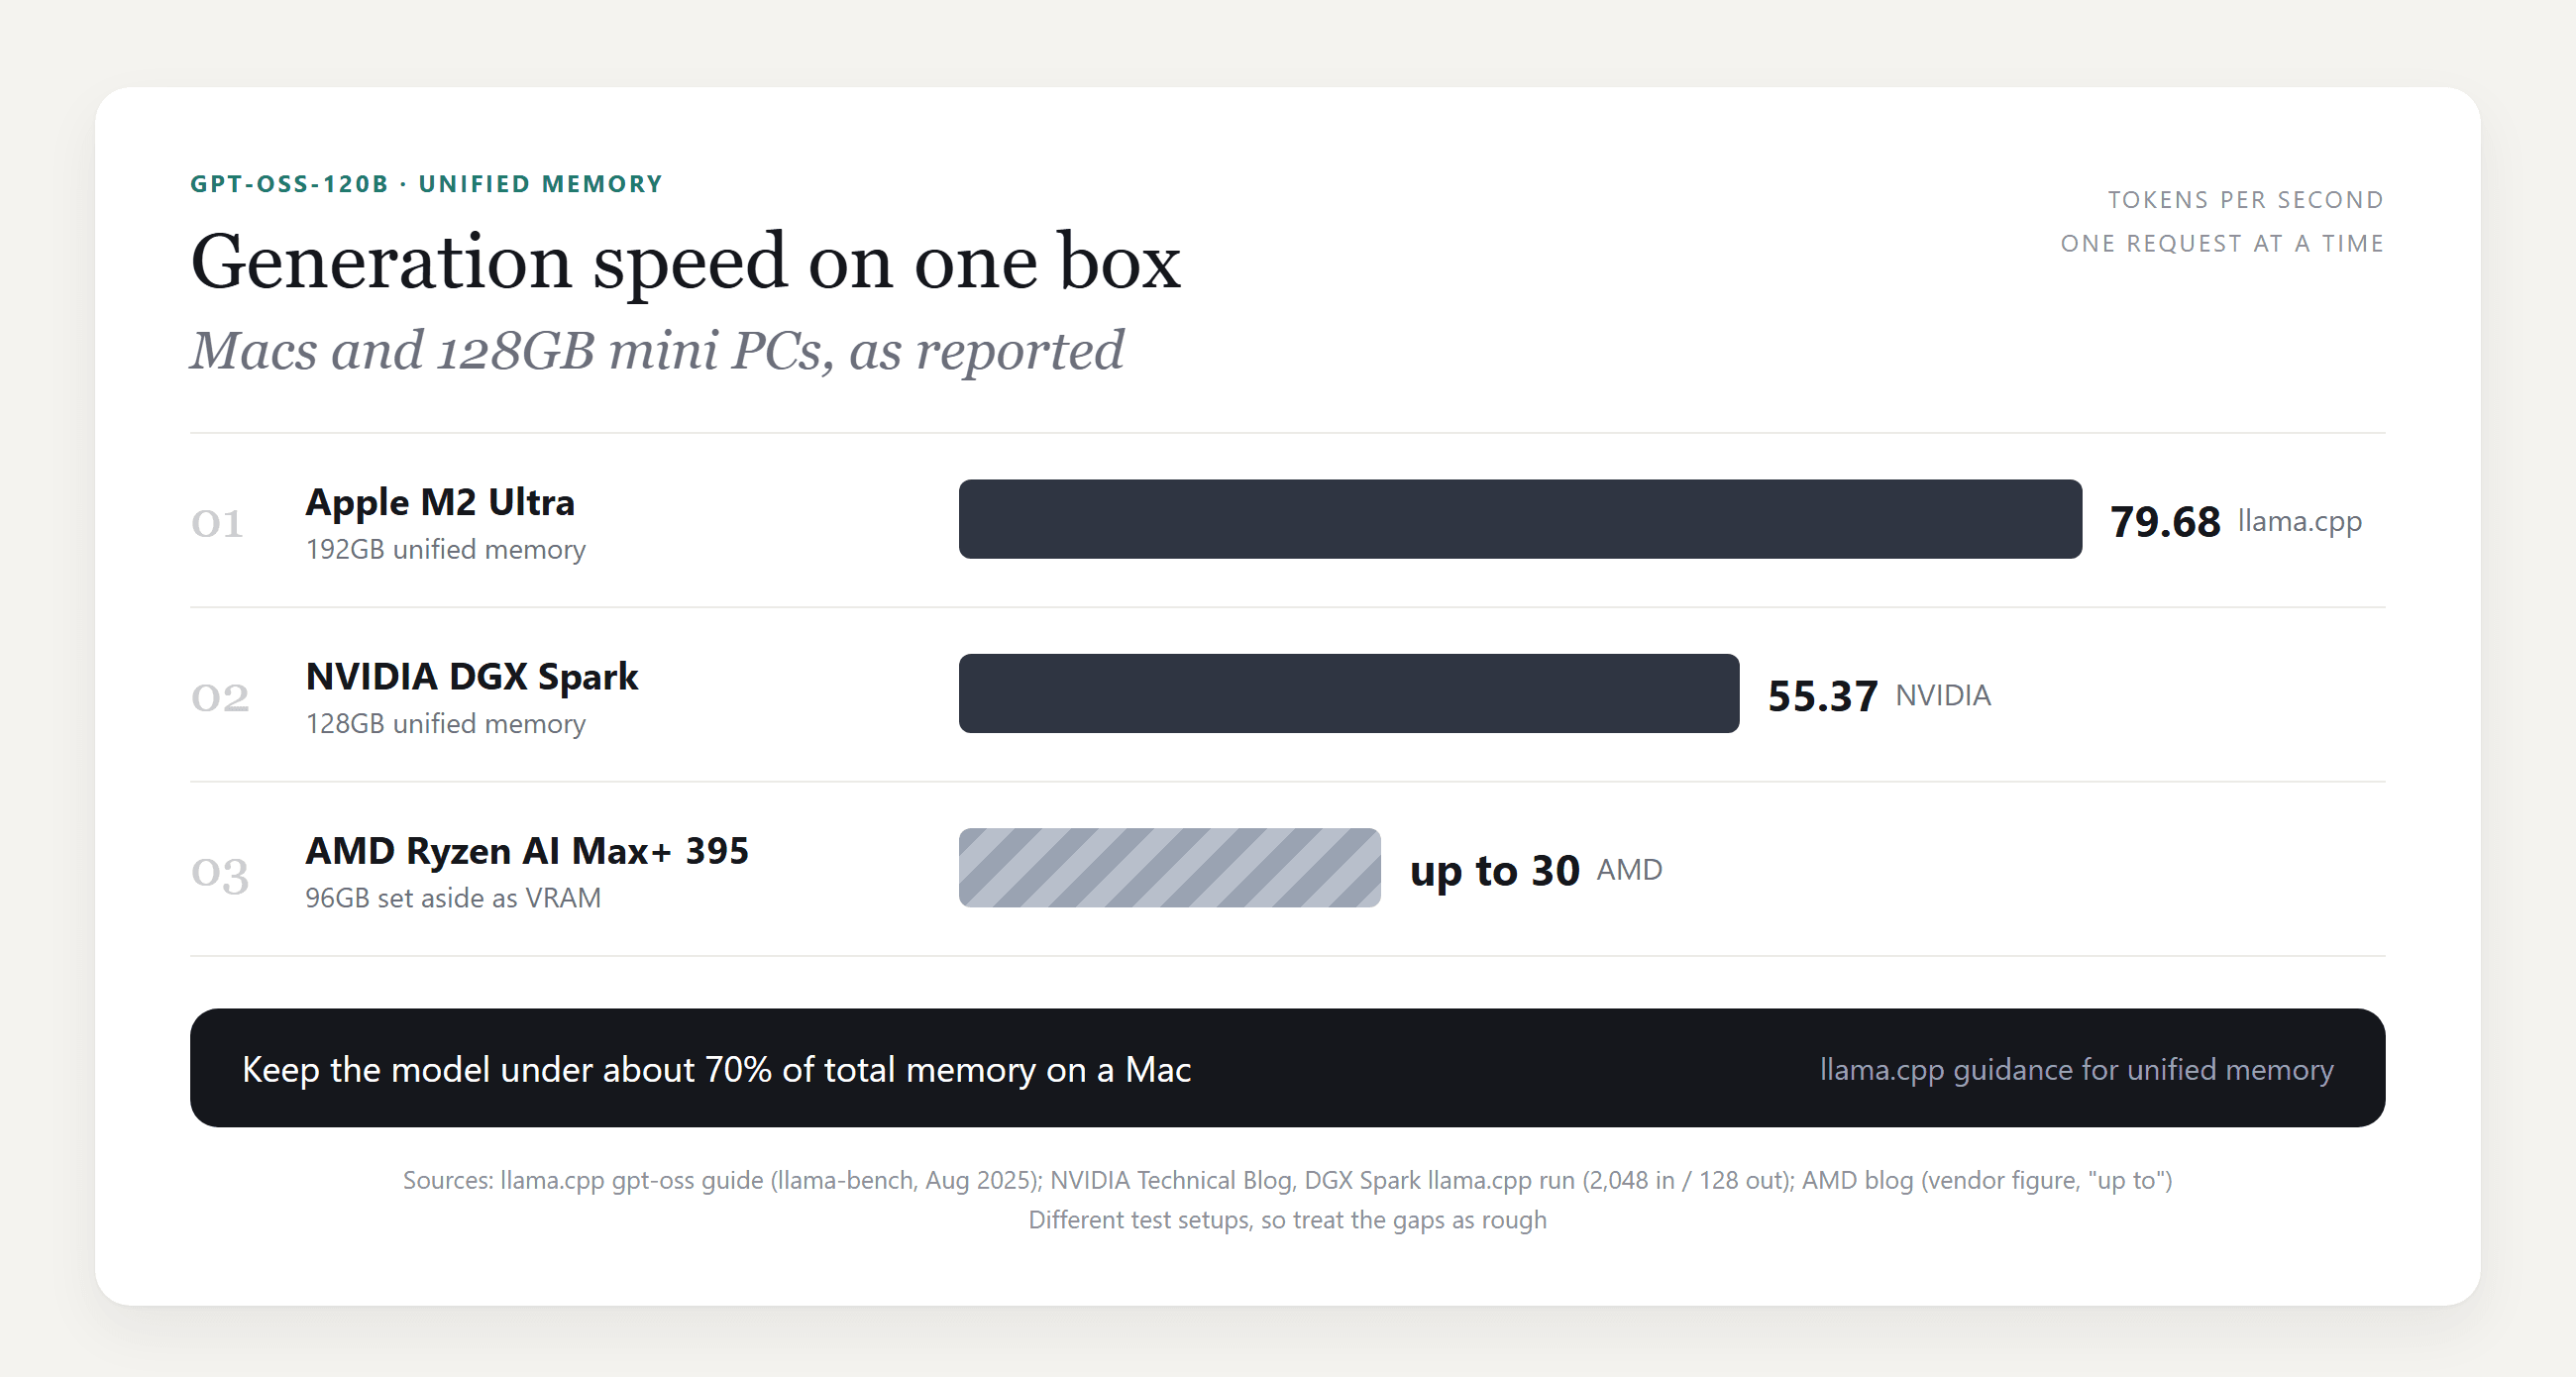
Geünificeerd geheugen haalt de scheiding tussen GPU en RAM weg. De llama.cpp-gids zegt dat Macs met meer dan 96GB RAM, zoals M2 Ultra- of M3 Max-machines, het model op volledige context kunnen draaien, en adviseert onder ongeveer 70% van het totale geheugen te blijven.
macOS beperkt standaard hoeveel geheugen de GPU kan vastzetten. Op een machine met 192GB verhoogt de gids die limiet van 154GB naar 180GB met één opdracht:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
De nieuwe 128GB-mini-pc's vallen in dezelfde klasse. NVIDIA rapporteert 55,37 tokens/s voor gpt-oss-120b op een DGX Spark met llama.cpp. AMD zegt dat een Ryzen AI Max+ 395-machine met 96GB gereserveerd als VRAM "tot 30 tokens per seconde" haalt, wat het cijfer van het bedrijf zelf is.
Niet genoeg geheugen? Gebruik een gehost open-weightmodel via een API
Als geen van die machines op je bureau staat, slaat een gehost open-weightmodel de hardwarevraag volledig over.
Atlas Cloud serveert Qwen3.5 122B A10B, onderdeel van zijn Qwen-modelline-up. Op papier is het een goede match voor gpt-oss-120b: een Apache 2.0 mixture-of-experts-model van het Qwen-team van Alibaba, met 122B totaal en 10B actieve parameters. Het leest tot 262.144 tokens context.
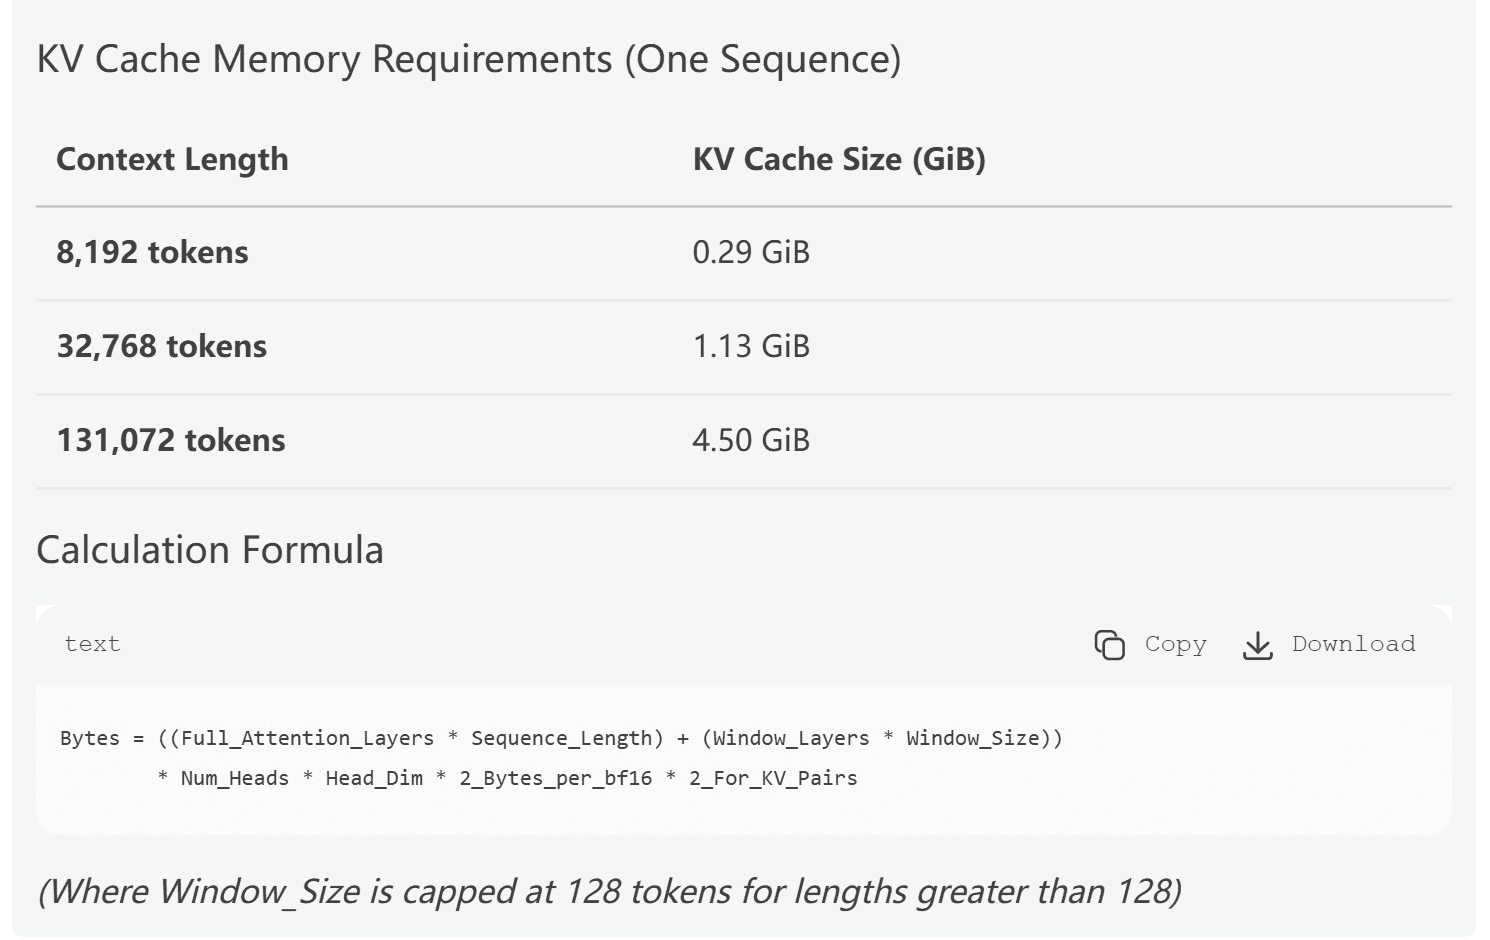
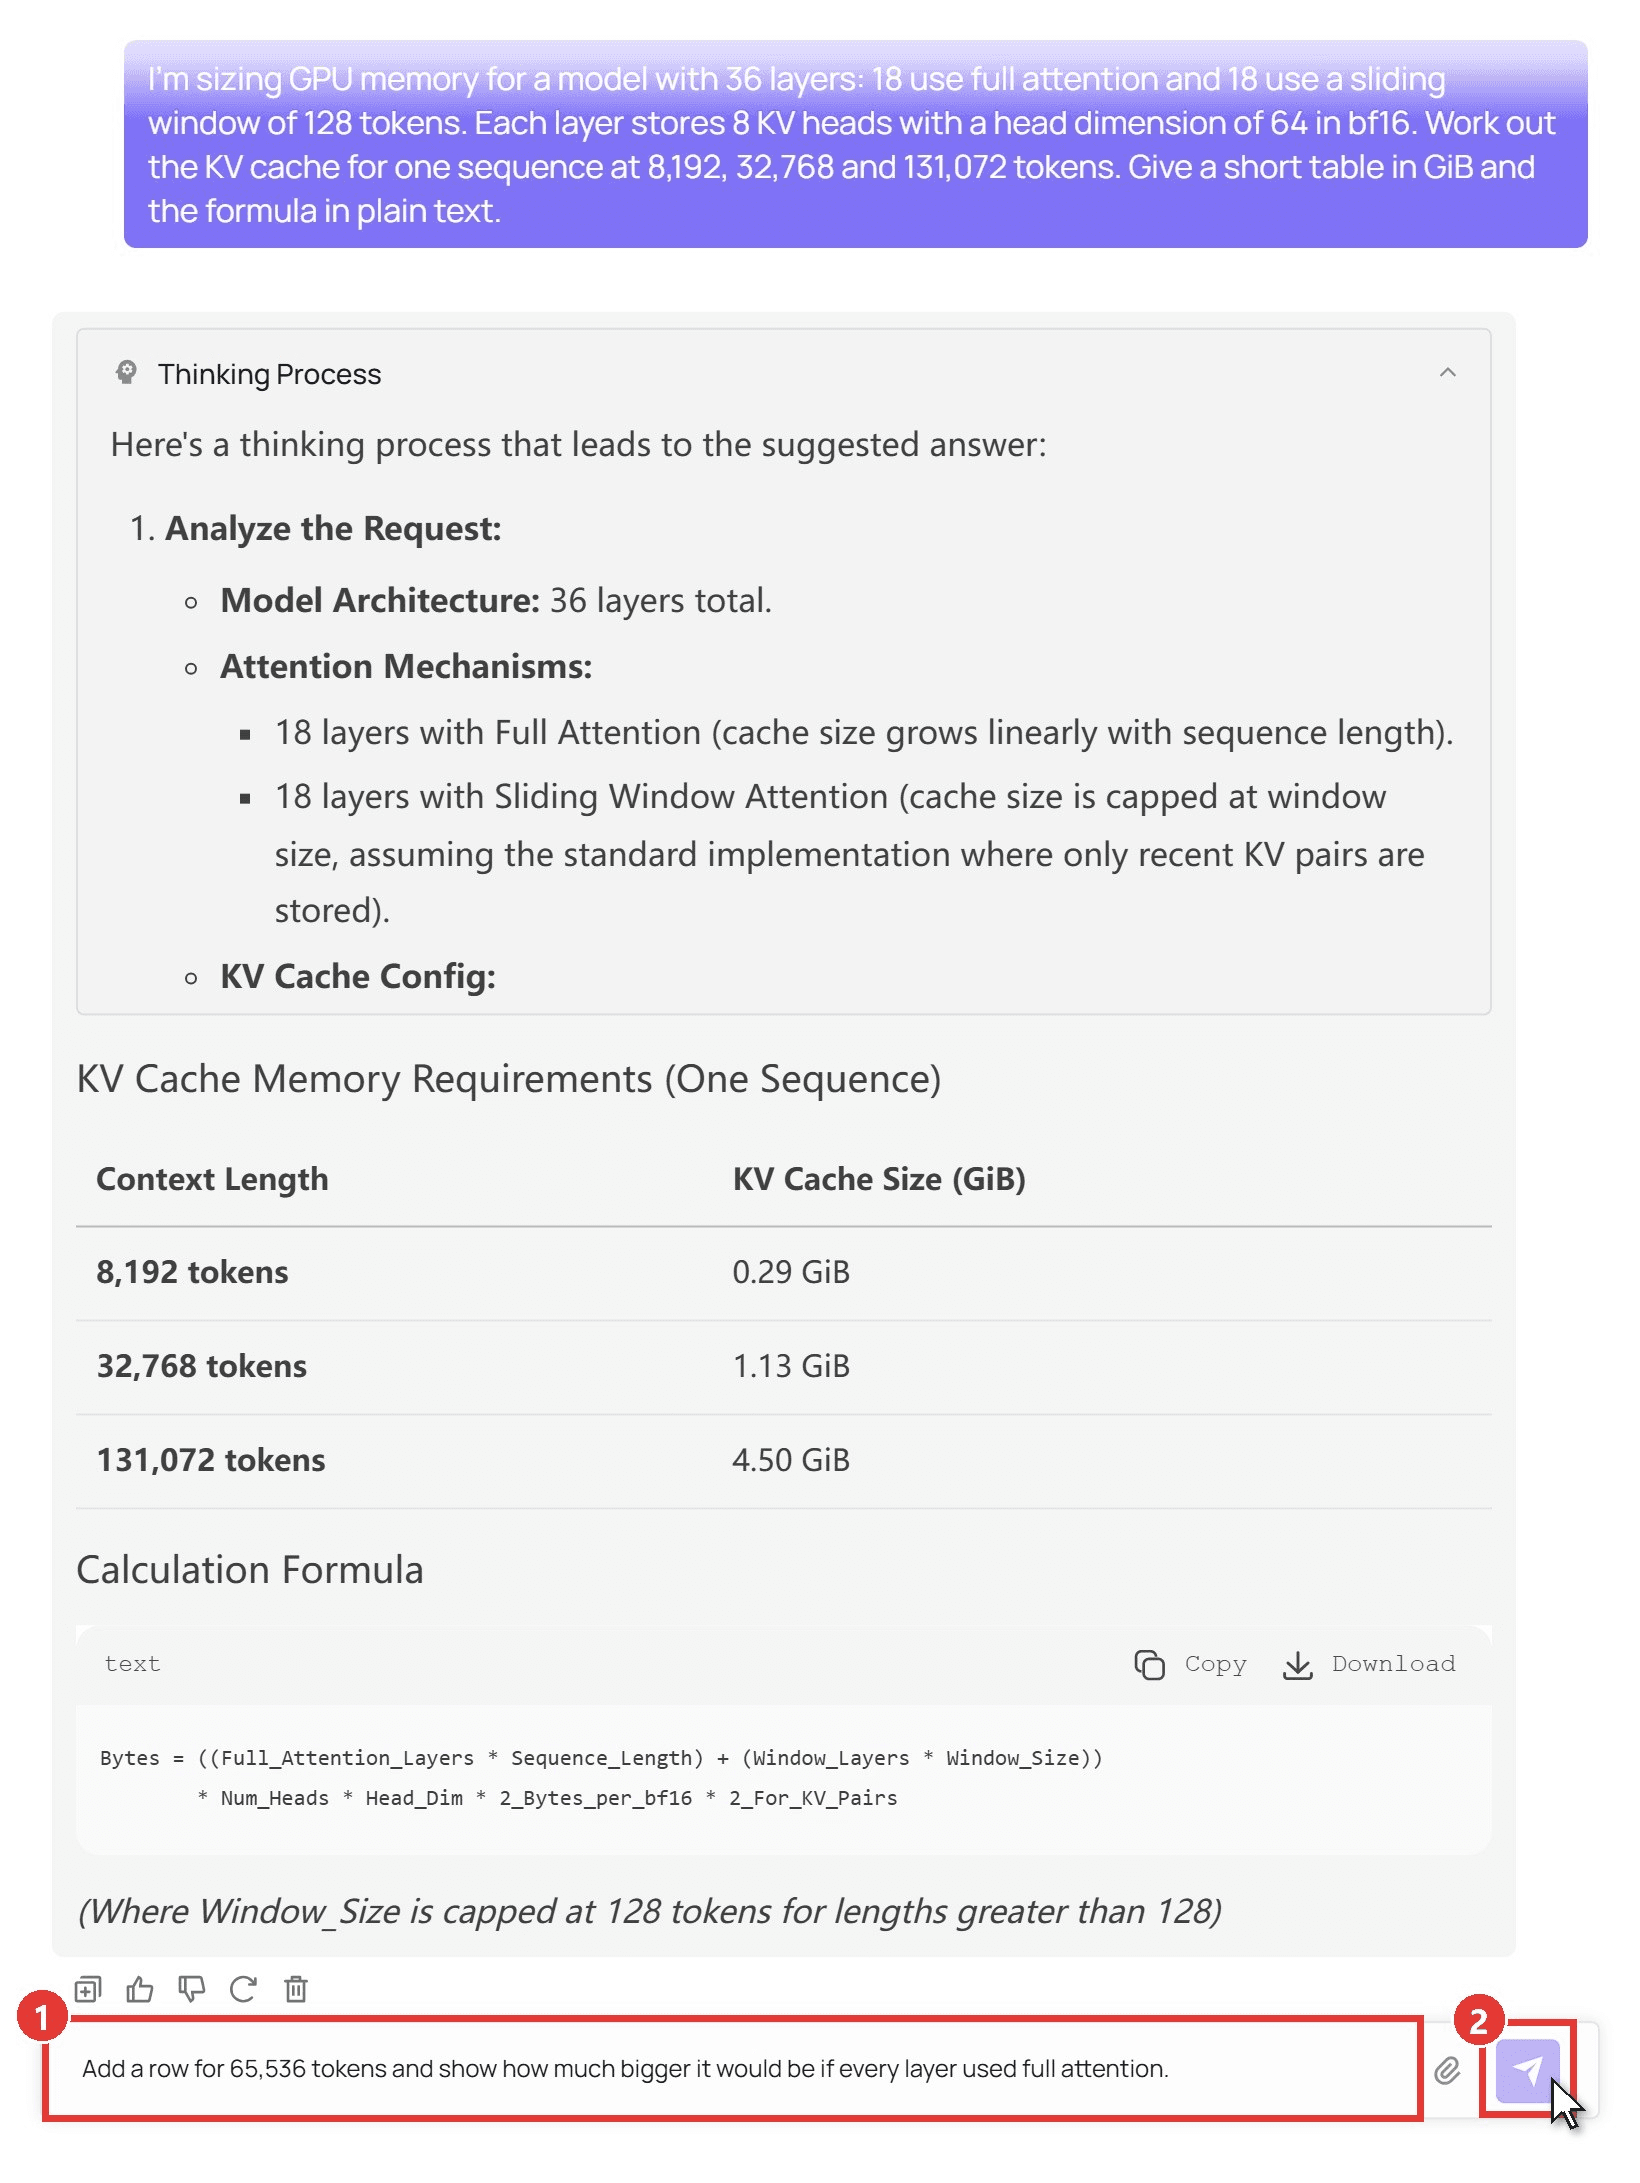
We gaven het de attention-layout uit de gpt-oss-config en vroegen om de KV-cache bij drie lengtes. De tabel kwam tot twee decimalen overeen met onze eigen berekening. Als je later een Qwen voor je eigen machine wilt, helpt onze gids over het beste Qwen-model voor lokaal programmeren je ze op RAM te dimensioneren.
Methode 1: Probeer Qwen3.5 122B A10B in de Playground
Meld je aan en open de Qwen3.5 122B A10B-playground, en dan:
- Typ je vraag in het berichtvak.
- Klik op de verzendpijl. De redenering verschijnt in een Thinking Process-paneel boven het antwoord.
Methode 2: Roep Qwen3.5 122B A10B aan met de Atlas Cloud API
Voor scripts en apps:
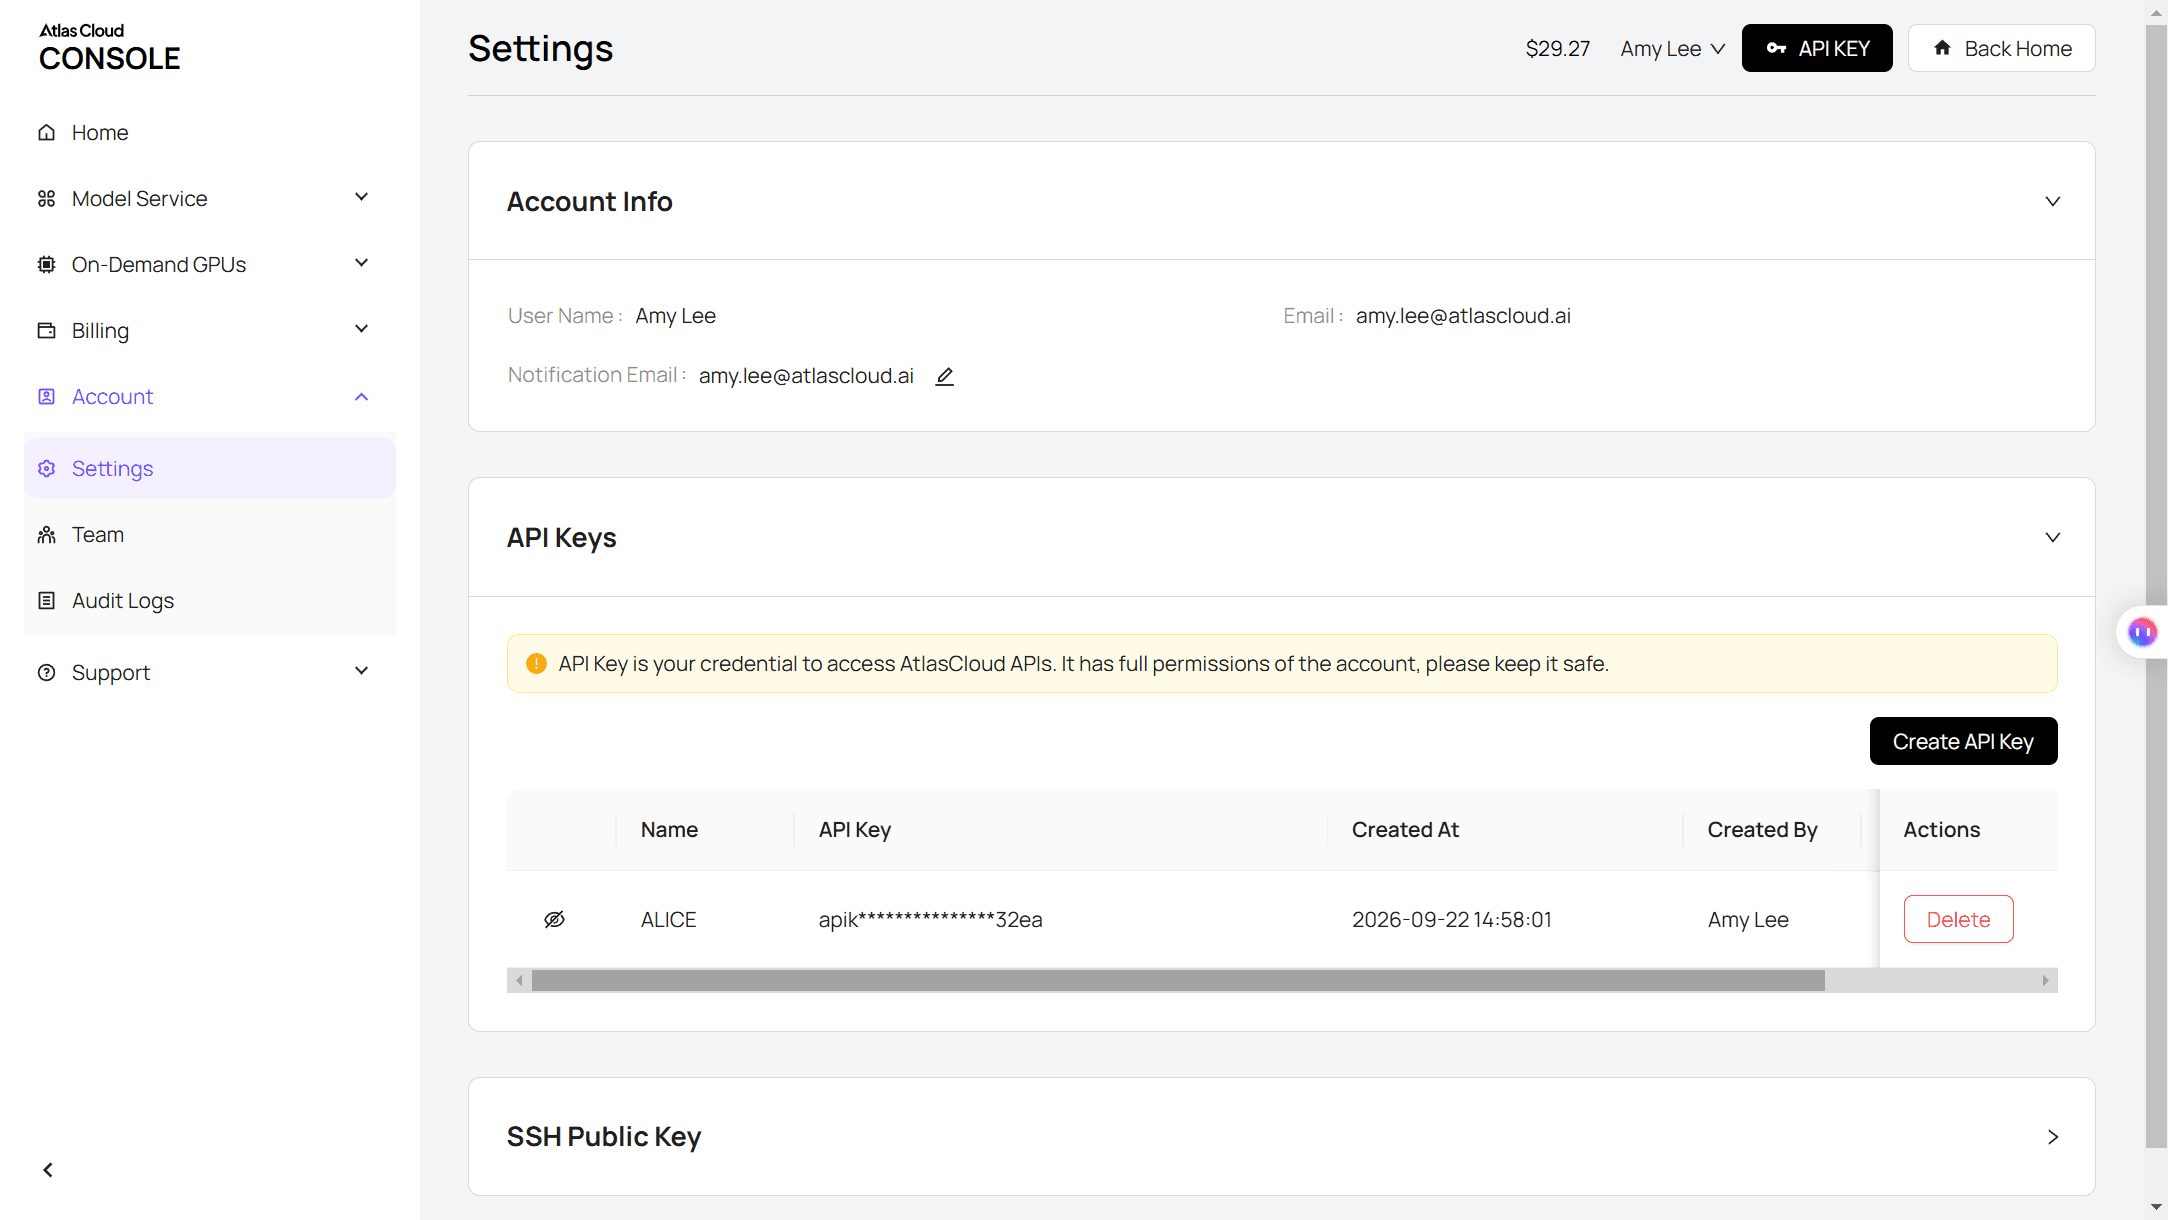
Stap 1: Maak een API-sleutel. Open Settings in de console, ga naar API Keys en klik op Create API Key. Bewaar die aan de serverzijde.
Stap 2: Controleer het aanvraagformaat. De API-documentatie behandelt het chat completions-formaat, en de modelpagina heeft een API-tab met een kant-en-klaar voorbeeld.
Stap 3: Verstuur je eerste aanvraag.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
Het antwoord komt terug in choices[0].message.content. Omdat het endpoint het OpenAI-formaat volgt, heeft code die voor een lokale gpt-oss-server is geschreven meestal alleen een nieuwe base-URL, sleutel en modelstring nodig. Dezelfde sleutel werkt ook voor de andere chatmodellen op het platform, zoals ons stuk over een geünificeerde LLM-API-gateway uiteenzet.
GPT-OSS-120B vs GPT-OSS-20B: geheugen- en benchmarkafweging
Het kleinere broertje heeft een vijfde van het geheugen nodig. gpt-oss-20b heeft 20,9B parameters met 3,6B actief, en OpenAI zegt dat het draait op "slechts 16GB geheugen". De vraag is wat je opgeeft.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Geheugen bij 8K-context (llama.cpp) | 64,0 GB | 14,9 GB | | MMLU | 90,0 | 85,3 | | GPQA Diamond (geen tools) | 80,1 | 71,5 | | SWE-Bench Verified | 62,4 | 60,7 | | Codeforces Elo (geen tools) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
Scores komen uit de modelkaart bij hoge redeneerinspanning. Het codeerverschil is minder dan twee punten op SWE-Bench Verified, terwijl het kennisverschil ongeveer 9 punten is op wetenschap op masterniveau en 15 op HealthBench. Voor vooral code op een kaart van 16GB tot 24GB is 20b de verstandige keuze. Heb je de extra kennis nodig? Dan verdient 120b zijn geheugenrekening.
GGUF, Ollama of vLLM: een runtime kiezen voor je geheugenbudget
Elk draait de MXFP4-gewichten die OpenAI heeft uitgebracht; ze verschillen in waar die gewichten kunnen staan.
| Runtime | Download | Beste keuze |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Eén gebruiker op een machine die het volledige model bevat |
| LM Studio | 65 GB | Een desktopapp op een Mac of Windows-pc |
| llama.cpp (ggml-org GGUF) | Ongeveer 63 GB | Minder dan 65 GB VRAM, met expertlagen offloaded naar RAM |
| vLLM | Ongeveer 65 GB aan safetensors | Veel gebruikers bedienen vanaf een of meer datacenter-GPU's |
Voor een snelle start op een machine met veel geheugen:
plaintext1ollama run gpt-oss:120b
Gebruik voor een kleinere GPU llama.cpp en stem het offload-aantal af:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Alle vier ondersteunen OpenAI's harmony-chatformaat, dat het model nodig heeft om goed te werken. Het maakt alleen uit als je je eigen serveercode schrijft.
FAQ
Is GPT-OSS-120B beter dan GPT-5 of Gemini 3 Pro?
Ze vallen in verschillende categorieën: GPT-5 en Gemini zijn gesloten modellen die je via een app of API bereikt, terwijl gpt-oss-120b op je eigen hardware draait. Gemini 3 Pro Preview is ook op 9 maart 2026 stopgezet, en de naam verwijst nu naar Gemini 3.1 Pro Preview. Als lokale controle belangrijk is, is de open-weightlijn van Google de Gemma 4-familie.
Waarom zeggen sommige sites dat GPT-OSS-120B 255 GB nodig heeft?
Die cijfers gaan uit van 16-bits gewichten: ruwweg 117B parameters keer 2 bytes, plus overhead. Het checkpoint dat OpenAI publiceert is al MXFP4, dus de realistische download ligt in de buurt van 61 GB.
Verandert redeneerinspanning het geheugengebruik?
Niet voor de gewichten. De instellingen laag, gemiddeld en hoog veranderen hoe lang het model nadenkt. Hoge inspanning schrijft meer redeneertokens, die het contextvenster vullen en de KV-cache laten groeien, dus lange sessies kruipen richting de grotere totalen in de grafiek hierboven.
Waarom zeggen mensen dat GPT-OSS-120B moeite heeft met tekstgebaseerde games?
Het bewijs is anekdotisch. Op de Hugging Face-discussiepagina van het model melden sommige gebruikers weigeringen bij het schrijven van gewelddadige fictie, terwijl anderen zeggen dat rollenspel prima werkt. Test voor interactieve fictie je eigen prompts voordat je hardware ervoor koopt.
Hoeveel kost een gehost model van de 120B-klasse?
Vanaf oktober 2026 kost Qwen3.5 122B A10B $0.3 per miljoen inputtokens en $2.4 per miljoen outputtokens op Atlas Cloud. Dat is een korting van 25% op de reguliere tarieven van $0.4 en $3.2. Onze sizing-vraag gebruikte ongeveer 5.000 outputtokens nadat de redenering was meegeteld, ongeveer één cent tegen het kortingstarief.
Conclusie
GPT-OSS-120B past gemakkelijker dan zijn parameteraantal suggereert. Reken op ongeveer 65 GB bij alledaagse contextlengtes en minder dan 70 GB bij de volledige 131K. Eén 80GB-GPU, een Mac met meer dan 96GB of een 128GB-mini-pc kan het bevatten, en kleinere kaarten kunnen het draaien door expertlagen naar systeem-RAM te verplaatsen.
Als die cijfers jouw machine uitsluiten, stap dan over op gpt-oss-20b voor vooral programmeerwerk, of roep een gehost open-weightmodel aan wanneer je het grotere brein nodig hebt zonder hardware te kopen. Hoe dan ook: de gpt oss 120b-geheugenvereisten zijn geen gokspel meer zodra je weet dat de gewichten 61 GB innemen en de rest speelruimte is.


