
GLM API for Autonomous Task Execution
GLM is de vlaggenschip-LLM-serie van Z.ai van Zhipu AI, en de GLM API omvat alles van de agentic GLM-5 tot de efficiënte 357B MoE GLM-4.6. Deze modellen zijn gespecialiseerd in autonome taakuitvoering, complexe agent-orkestratie en programmeren op productieniveau. Op Atlas Cloud geeft één uniforme endpoint je Day-0 access tot de volledige GLM-familie, met prijsstelling op basis van gebruik en betrouwbare uptime in productie. Begin vandaag nog met bouwen.
GLM is ontwikkeld door Z.ai. Atlas Cloud (geëxploiteerd door Atlas Cloud AI LLC) biedt toegang tot het model maar is niet de eigenaar ervan. Alle handelsmerken zijn eigendom van hun respectieve eigenaren.
Verken Toonaangevende Modellen
Atlas Cloud biedt u de nieuwste toonaangevende creatieve modellen in de industrie.
GLM API-modellen vergeleken: van GLM-4.6 tot GLM-5.2
Koppel elk endpoint aan je workload en budget.
| Modaliteit | Beschrijving |
|---|---|
| GLM-5.2 | GLM-5.2 is doelgericht gebouwd als agentgeoriënteerd model en zet prompts in natuurlijke taal en tool-call-context om in gestructureerde redeneringen, functieaanroepen en autonome taakuitvoering. Het is afgestemd op complexe problemen waarbij het model zelfstandig moet plannen, handelen en itereren. Kies dit model voor autonome agents en workflows met tools over een lange horizon, voor $1.4 per miljoen input tokens en $4.4 per miljoen output tokens. |
| GLM-5.1 | Geef GLM-5.1 een programmeertaak of een meerstapsprobleem en het levert sterke programmeeroutput samen met stabiele stapsgewijze uitvoering. Als nieuwste flagship van Z.AI biedt het ook natuurlijkere conversaties en verfijndere front-end-esthetiek. Het past bij teams die complexe webapps en agent-pipelines bouwen, met input voor $1.4 en output voor $4.4 per miljoen tokens. |
| GLM-5v Turbo | GLM-5v Turbo zet tekstprompts om in snelle completions, terwijl de verbeterde programmeercapaciteiten en stabiele meerstapsuitvoering van het flagship behouden blijven. Deze turbo-variant geeft prioriteit aan lagere latency voor interactieve producten met hoge throughput, zonder in te leveren op conversationele afwerking. Kies dit model wanneer reactiesnelheid het belangrijkst is, voor $1.2 per miljoen input tokens en $4 per miljoen output tokens. |
| GLM-5 Turbo | Tekst erin, razendsnelle completions eruit met GLM-5 Turbo: een voor latency geoptimaliseerd flagship, gebouwd voor verbeterd programmeren en betrouwbare meerstapsredenering. Het houdt antwoorden natuurlijk en front-end-generatie netjes, terwijl de throughput voor realtime gebruik wordt versneld. Zeer geschikt voor chatinterfaces en snelle agent-loops, afgerekend tegen $1.2 per miljoen input tokens en $4 per miljoen output tokens. |
| GLM-5 | GLM-5 neemt tekstinstructies en genereert code, redeneerketens en conversationele antwoorden als de kernrelease van Z.AI's flagship. De belangrijkste verbeteringen richten zich op sterker programmeren en stabielere meerstapsuitvoering bij complexe agent-taken. Een uitgebalanceerde keuze voor full-stackontwikkeling en dagelijkse redeneertaken, aangeboden voor $1 input en $3.2 output per miljoen tokens. |
| GLM-4.7 | Vraag GLM-4.7 om code of agent-orchestratie en het antwoordt met betrouwbare meerstapsuitvoering en natuurlijke dialoog. Dit model op flagship-niveau combineert verbeterd programmeren met verzorgde front-end-output tegen een toegankelijkere prijs. Het past bij kostengevoelige productieworkloads, afgerekend tegen $0.6 per miljoen input tokens en $2.2 per miljoen output tokens. |
| GLM-4.6 | GLM-4.6 is een efficiënt Mixture-of-Experts-model met 357B parameters van Zhipu AI, dat tekstprompts omzet in hoogwaardige completions met sterke throughput. Het MoE-ontwerp activeert alleen de experts die elke aanvraag nodig heeft, waardoor inference efficiënt blijft bij analyse- en contenttaken. Zet het in voor data-analyse, het opstellen van slides en webcontent, voor $0.6 input en $2.2 output per miljoen tokens. |
Wat de GLM API aandrijft
Van een sparse Mixture-of-Experts-kern en een context van 200K tokens tot native tool calling en schakelbare denkmodi: de GLM API brengt Z.ai's toonaangevende reasoning- en coding-stack samen achter één OpenAI-compatible endpoint.
Sparse Mixture-of-Experts op schaal
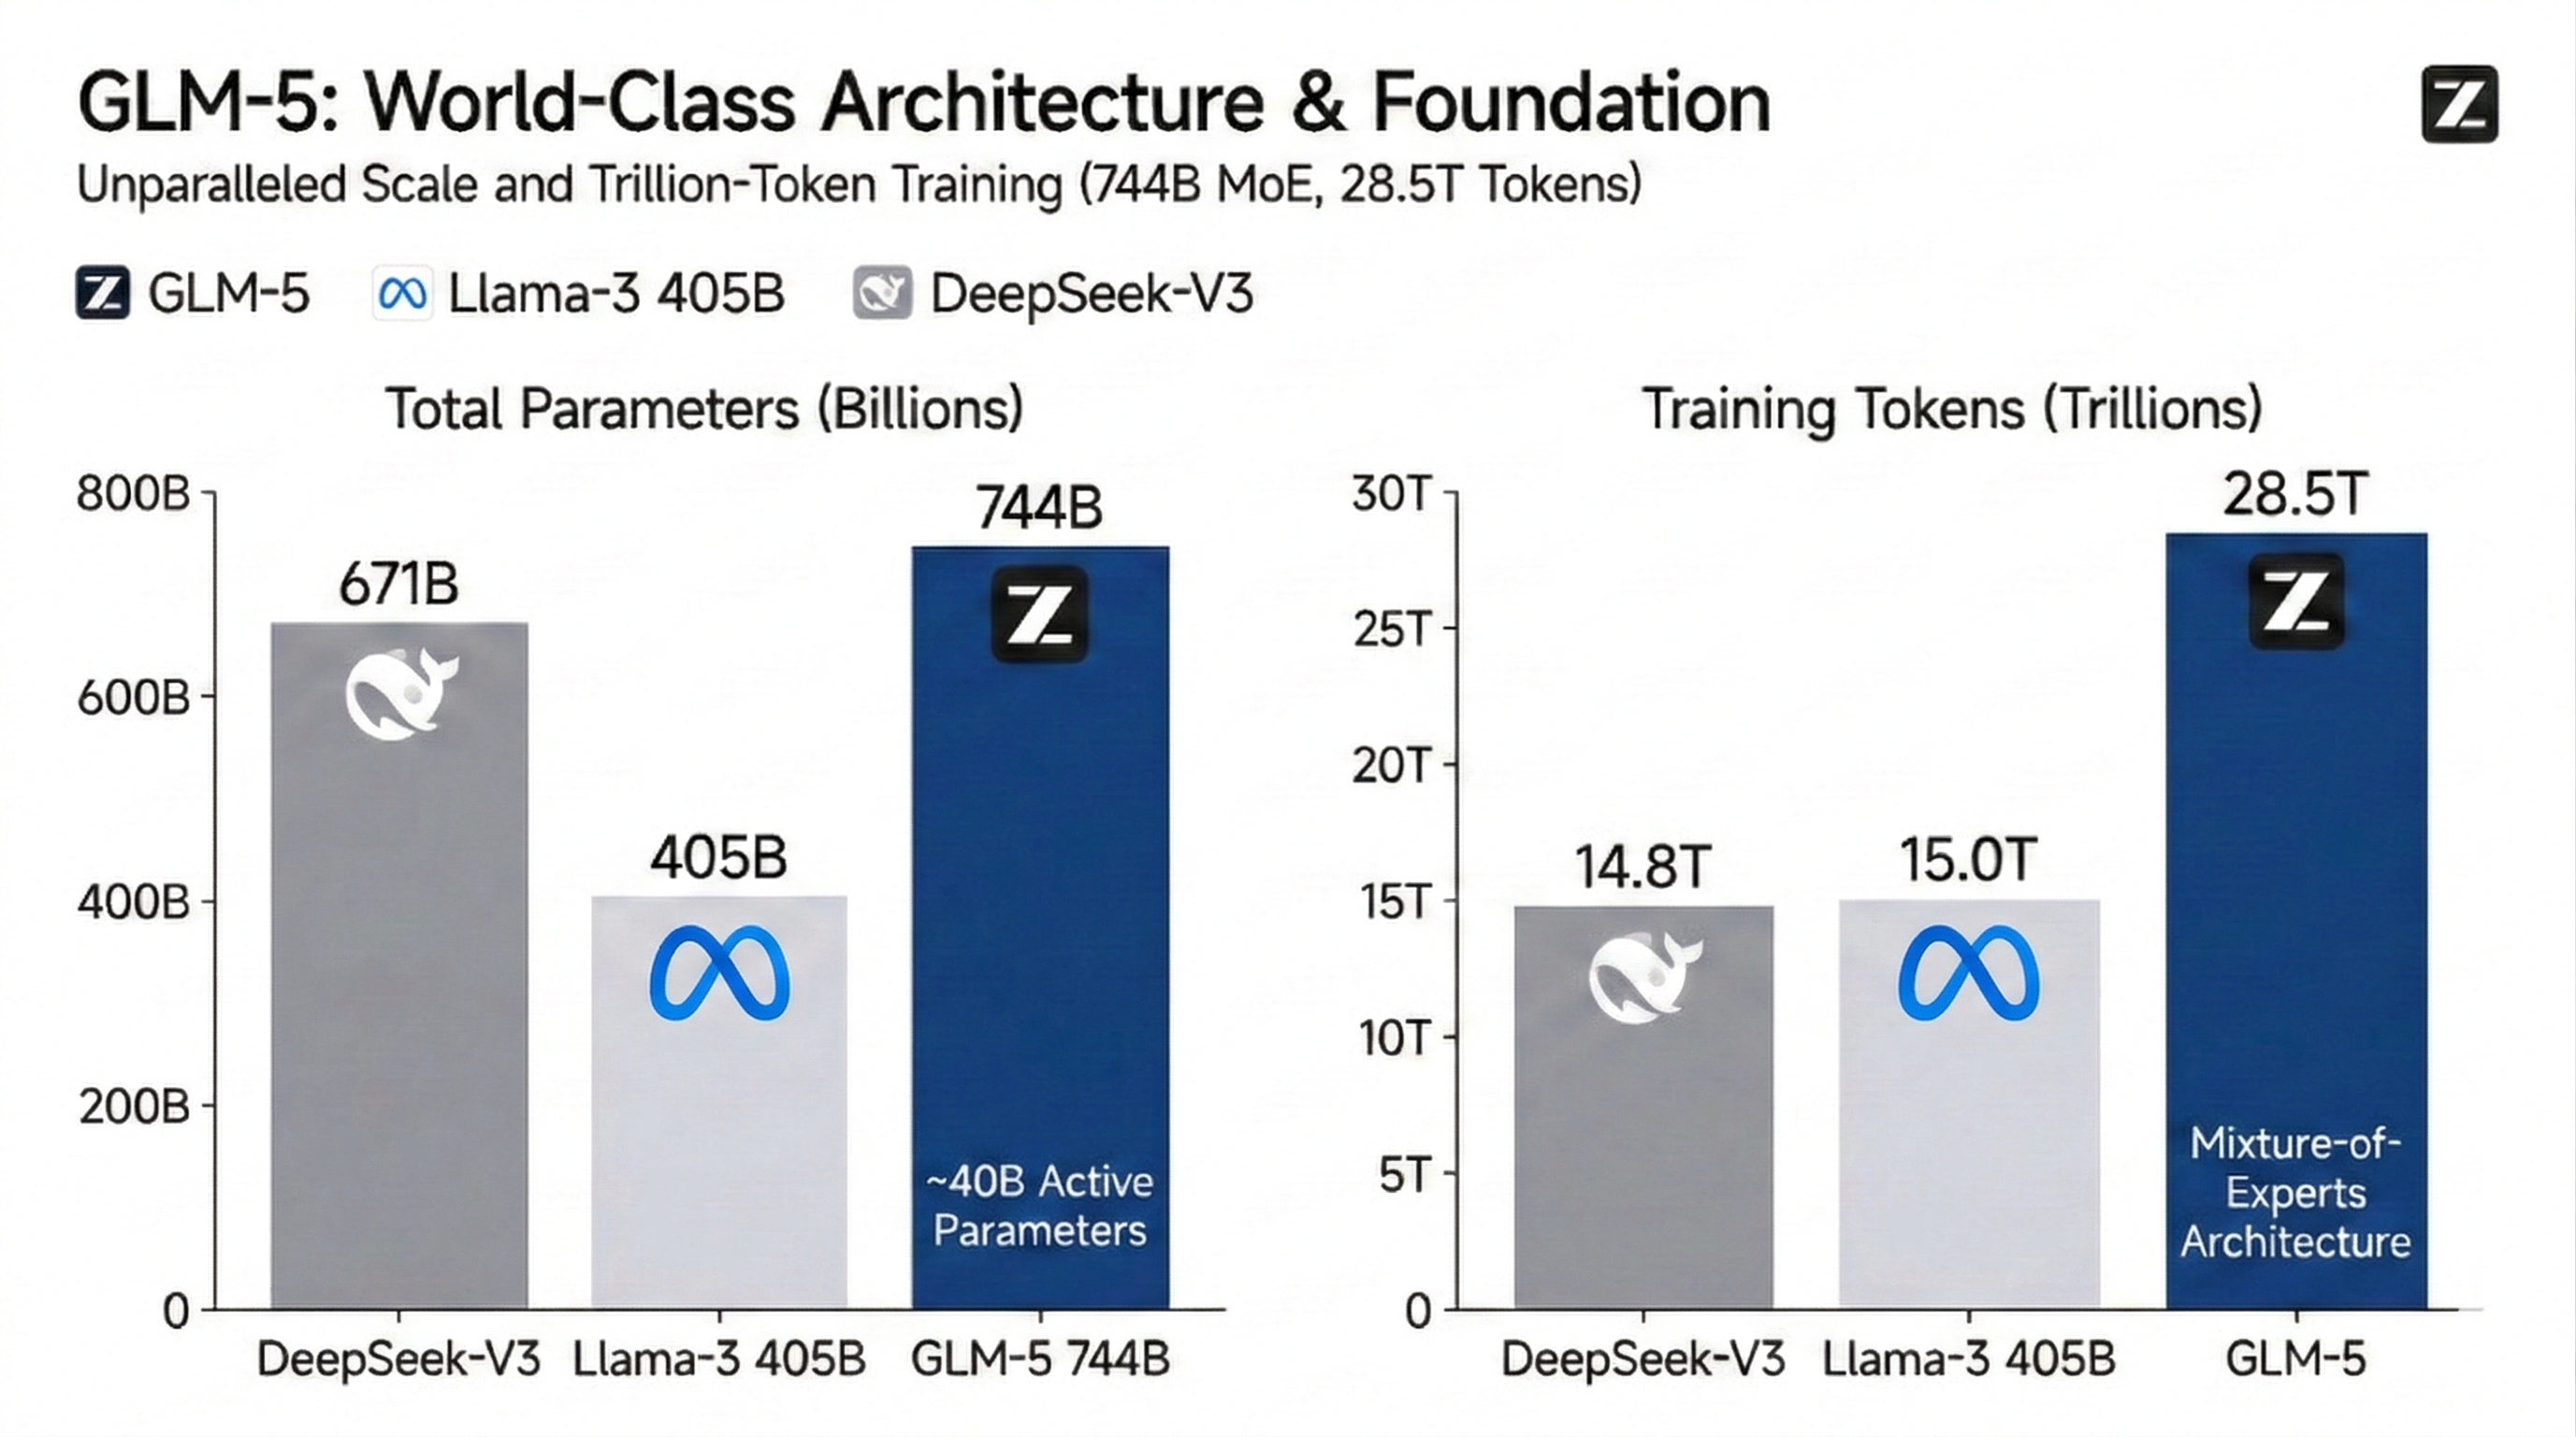
Een sparse Mixture-of-Experts-kern activeert per query slechts ongeveer 40 miljard parameters, terwijl hij put uit een veel grotere pool van experts. Het resultaat is diepgaande kennis en nauwkeurige recall zonder de kosten van een dense model bij elke call.
Agentic uitvoering ingebouwd in de GLM API
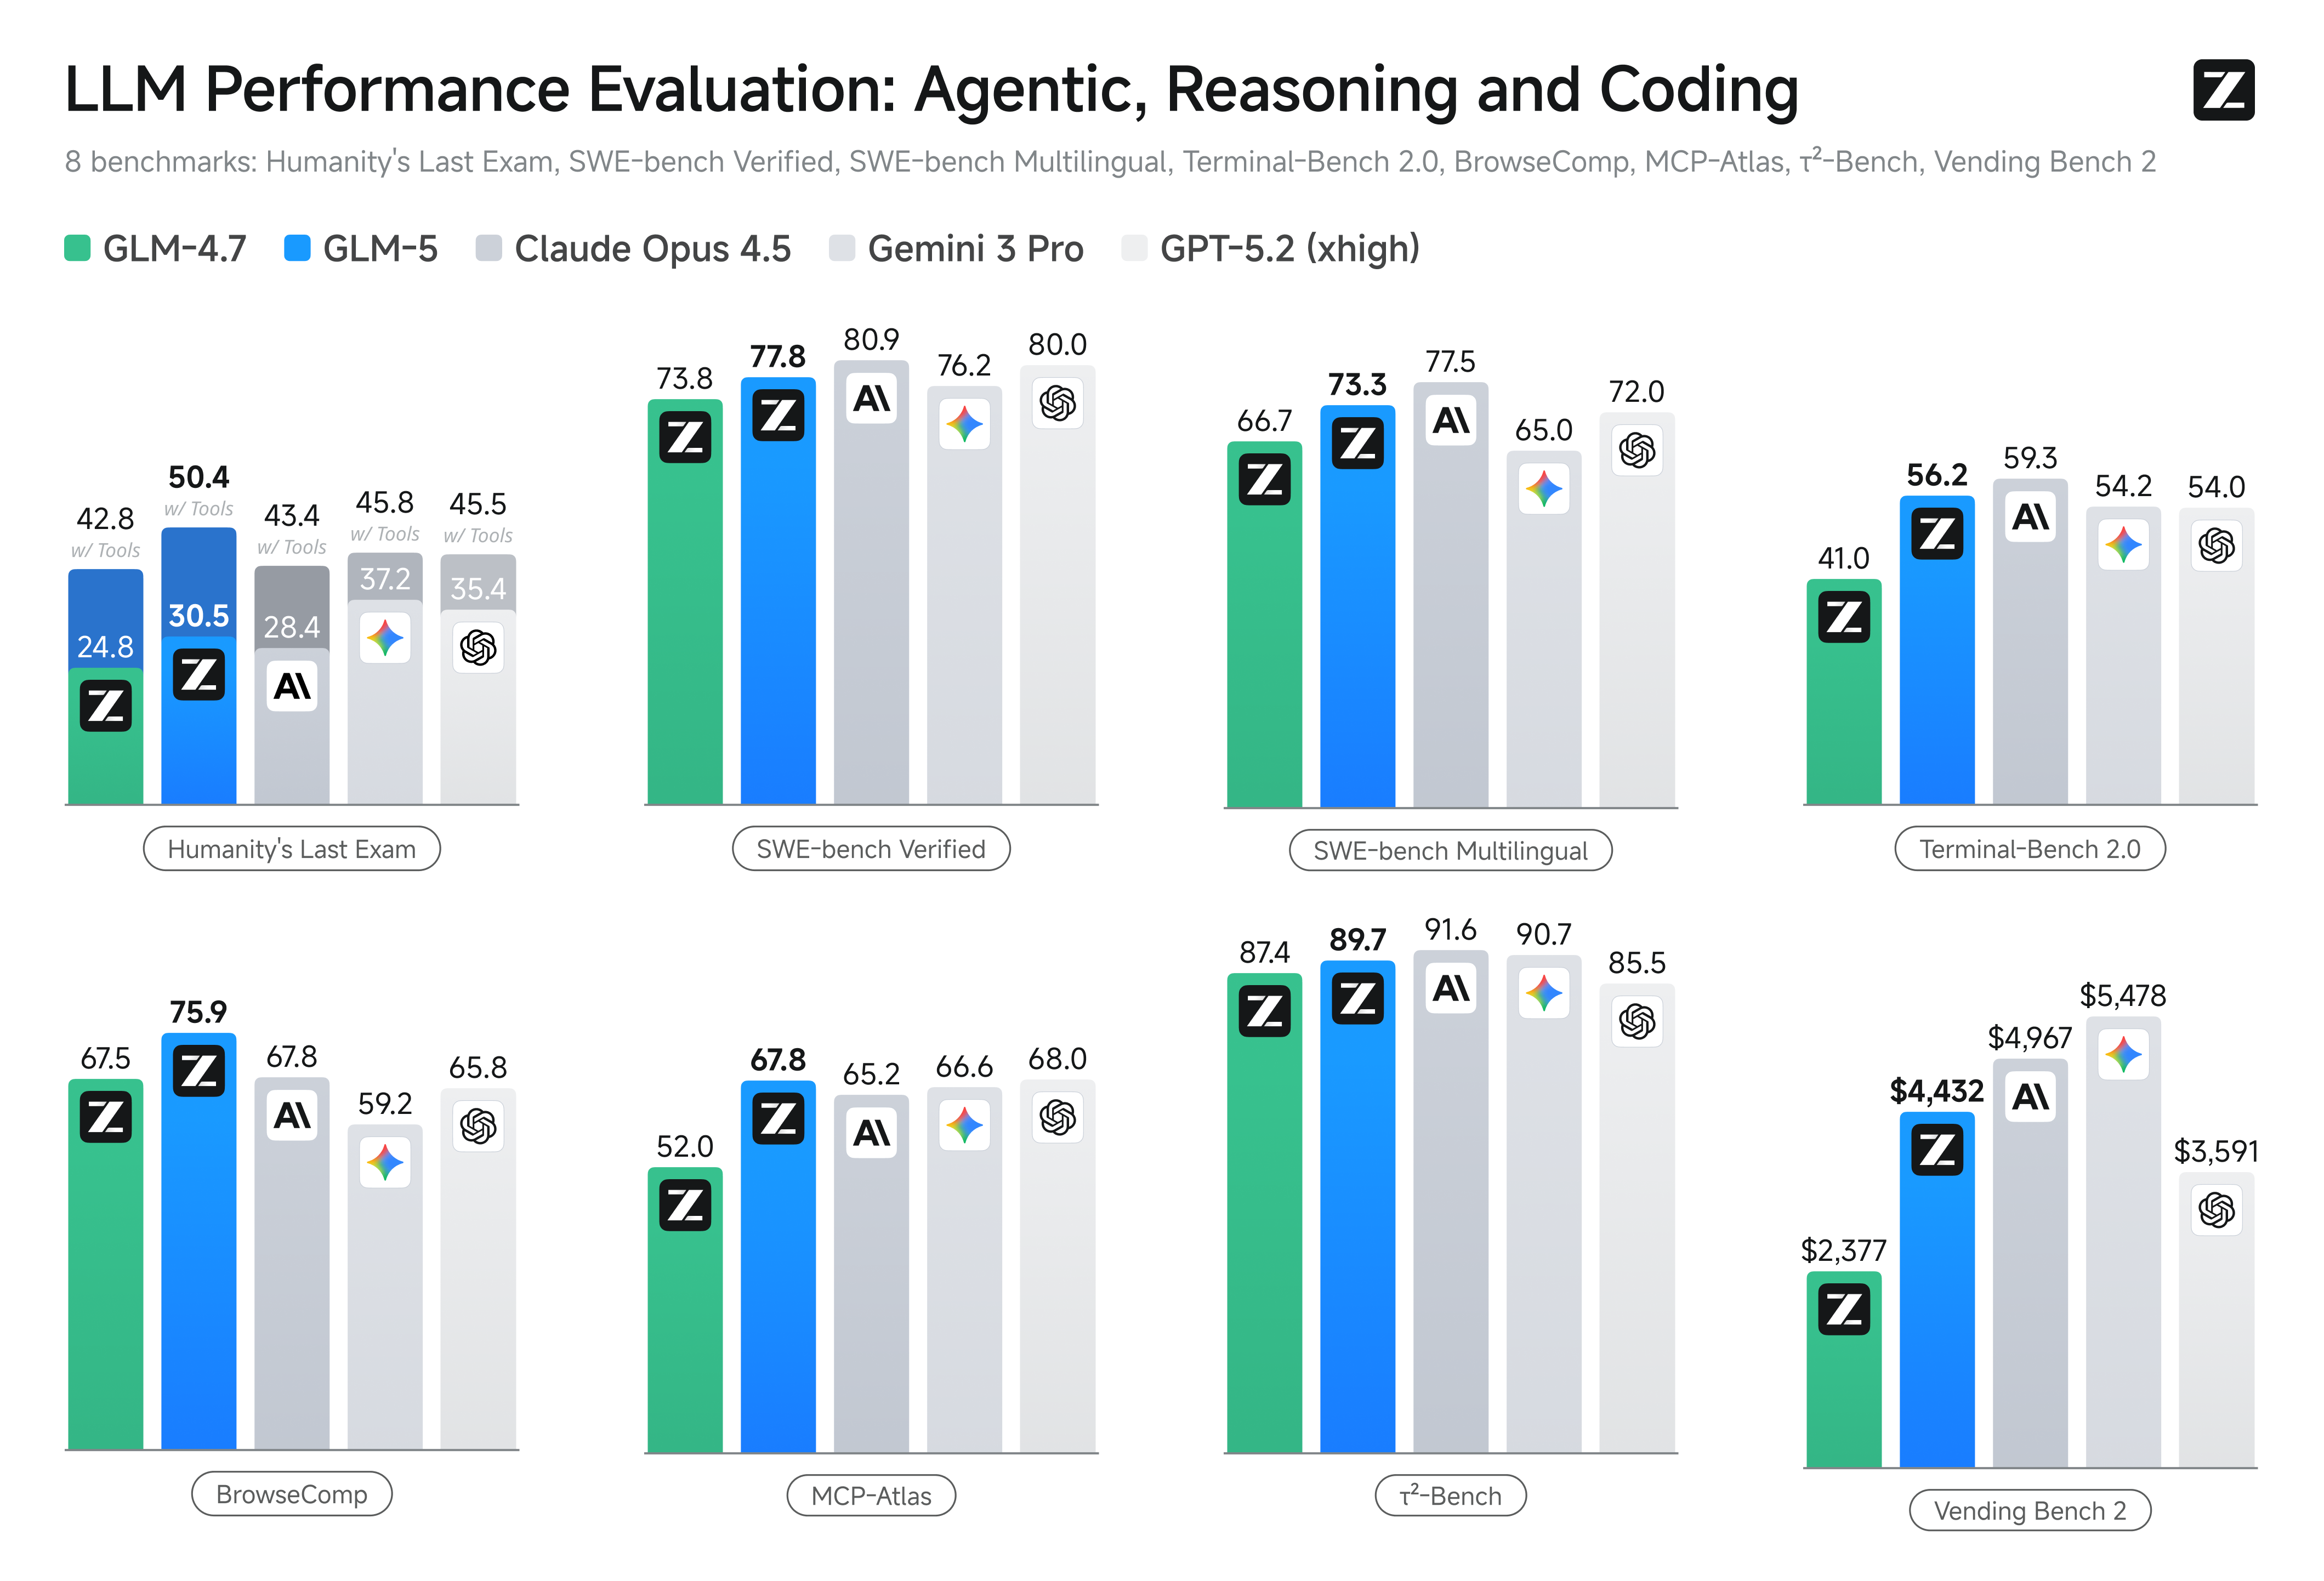
Planningslogica is ingebouwd in de GLM API, zodat agents langlopende, meerstapstaken uitvoeren zonder van koers te raken. Die stabiliteit is geschikt voor geautomatiseerde softwareontwikkeling, research-pipelines en workflows die over veel stappen coherent blijven.
Met reinforcement learning verfijnde coding en reasoning
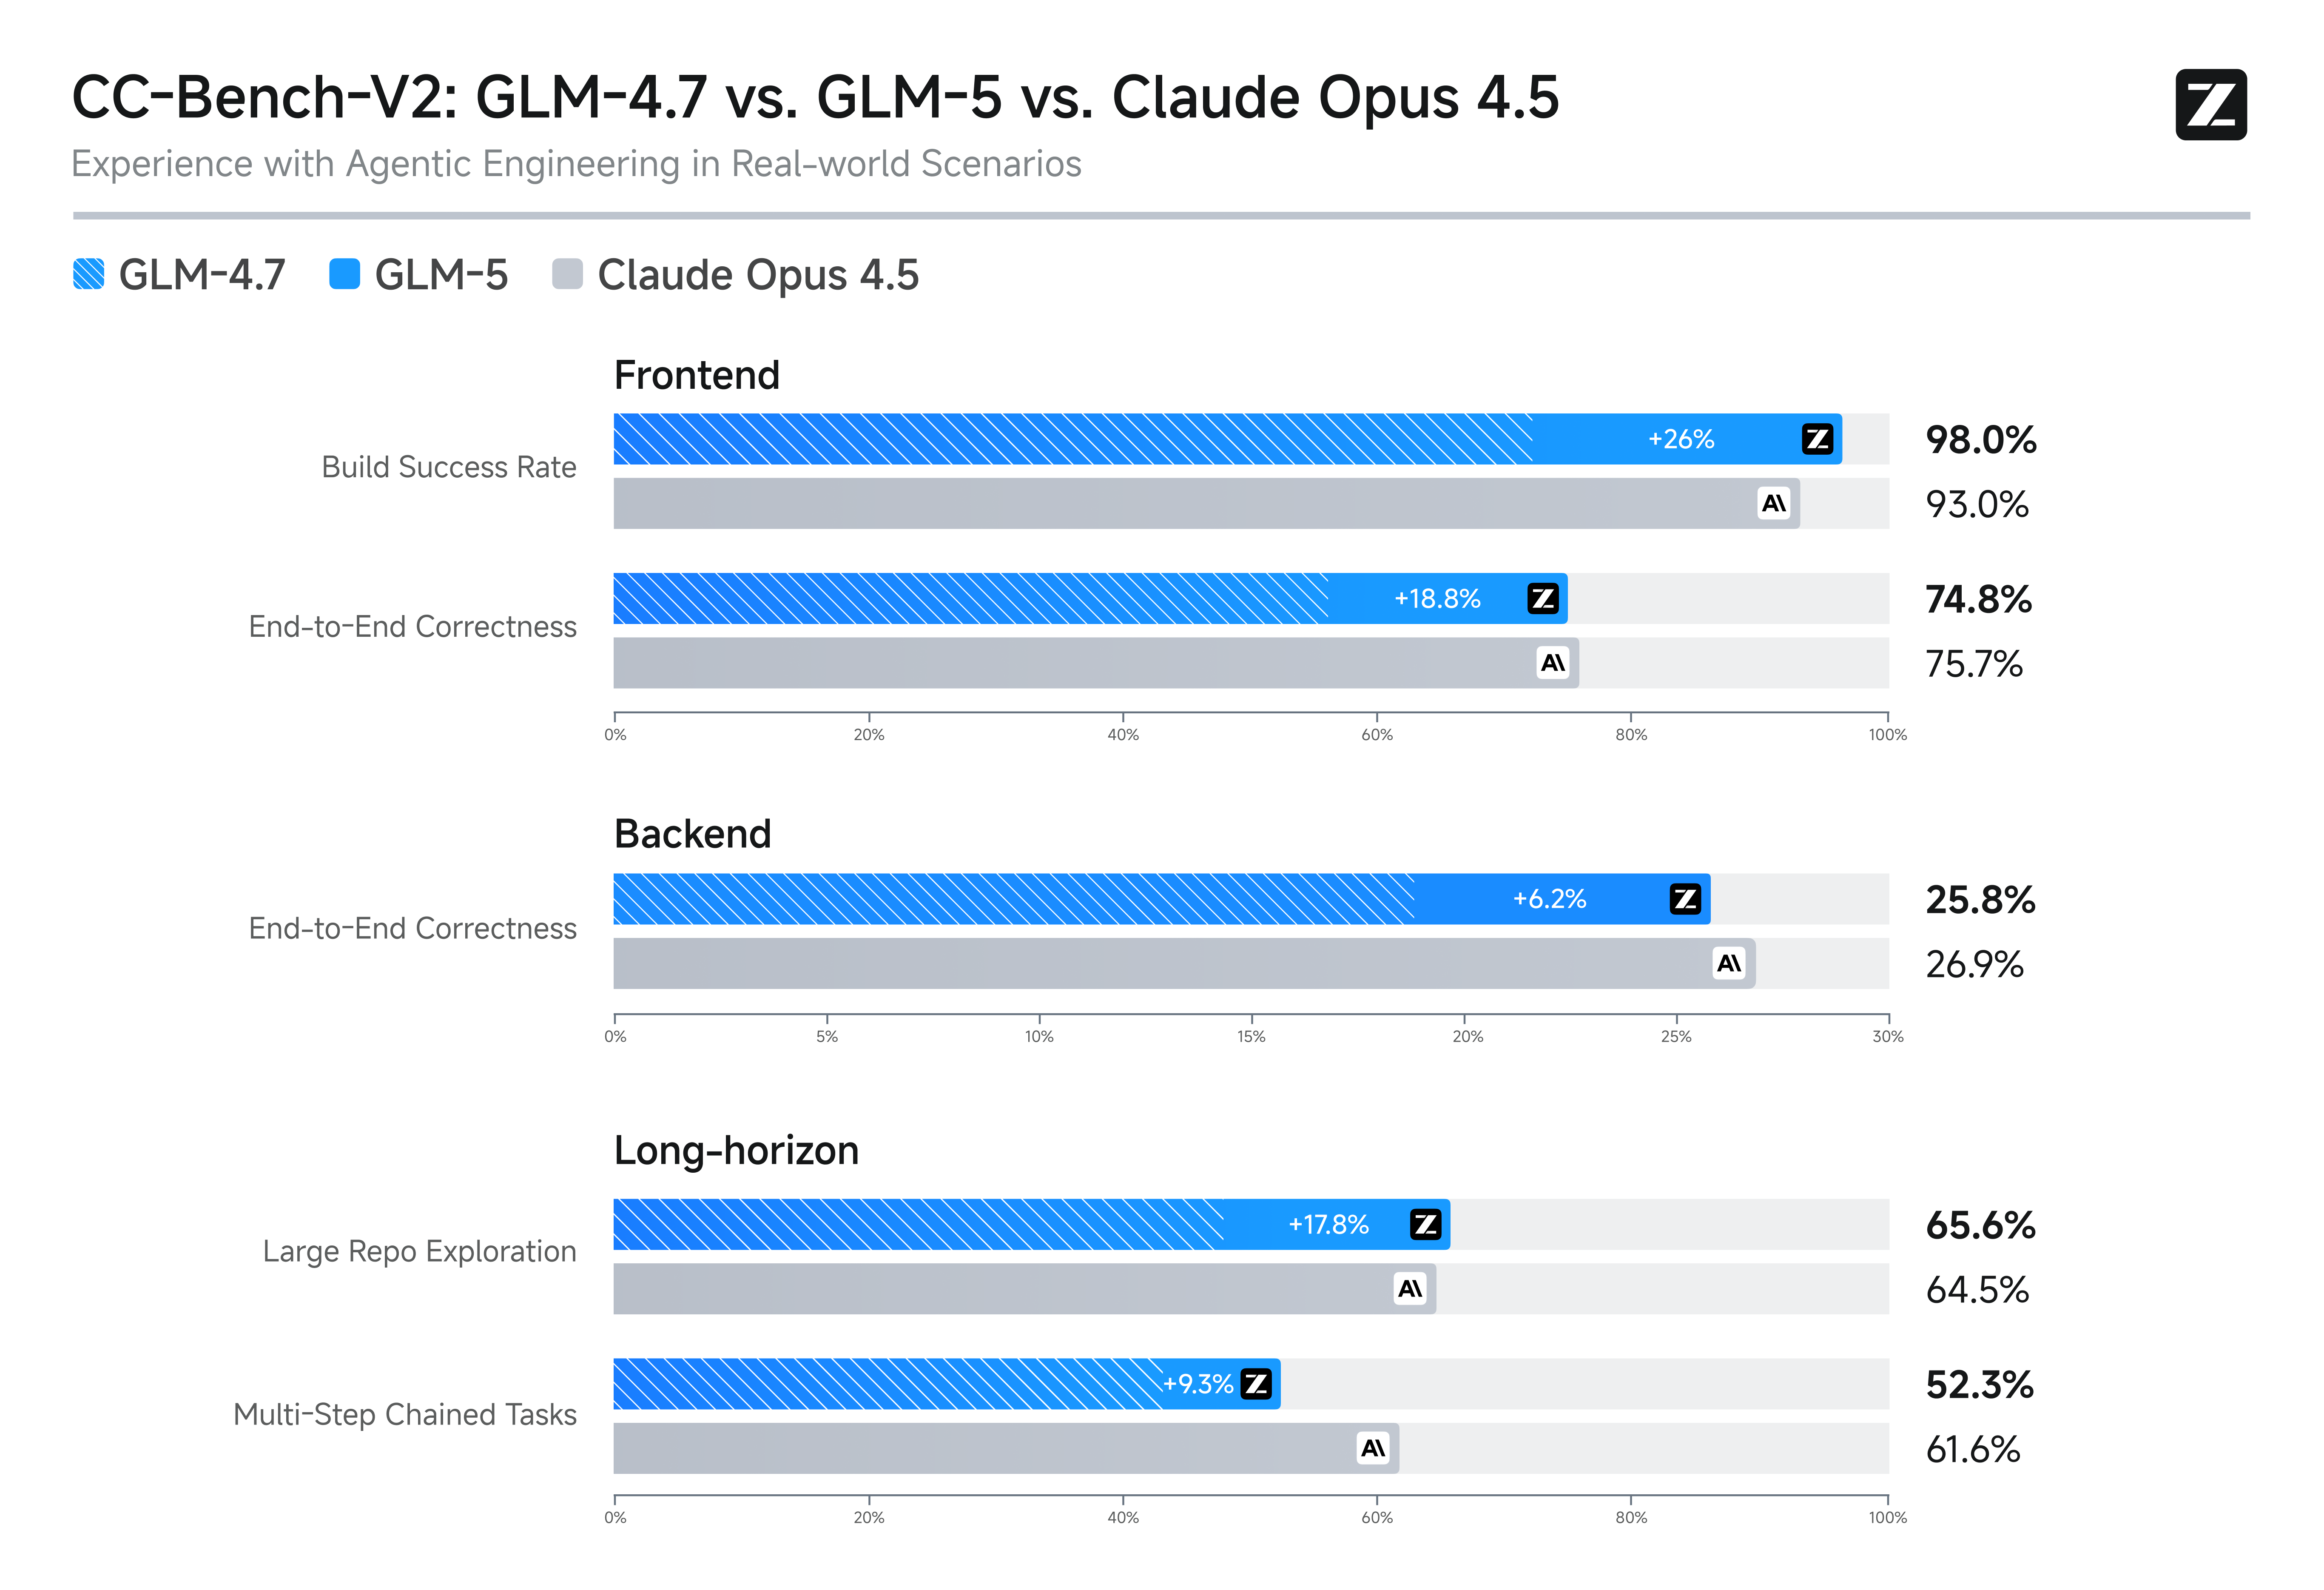
Post-training met reinforcement learning scherpt de codegeneratie en algoritmische reasoning van het model sterk aan ten opzichte van eerdere GLM-releases. Developers krijgen betrouwbaardere full-stack output en sterkere structurele probleemoplossing waar kleine logische fouten zich anders snel opstapelen.
Een context window van 200K met sparse attention
Elk model verwerkt 200K contexttokens of meer, met tot 128K outputtokens, en sparse attention houdt die schaal betaalbaar. Volledige repositories, lange contracten en research-briefs blijven in één keer in beeld.
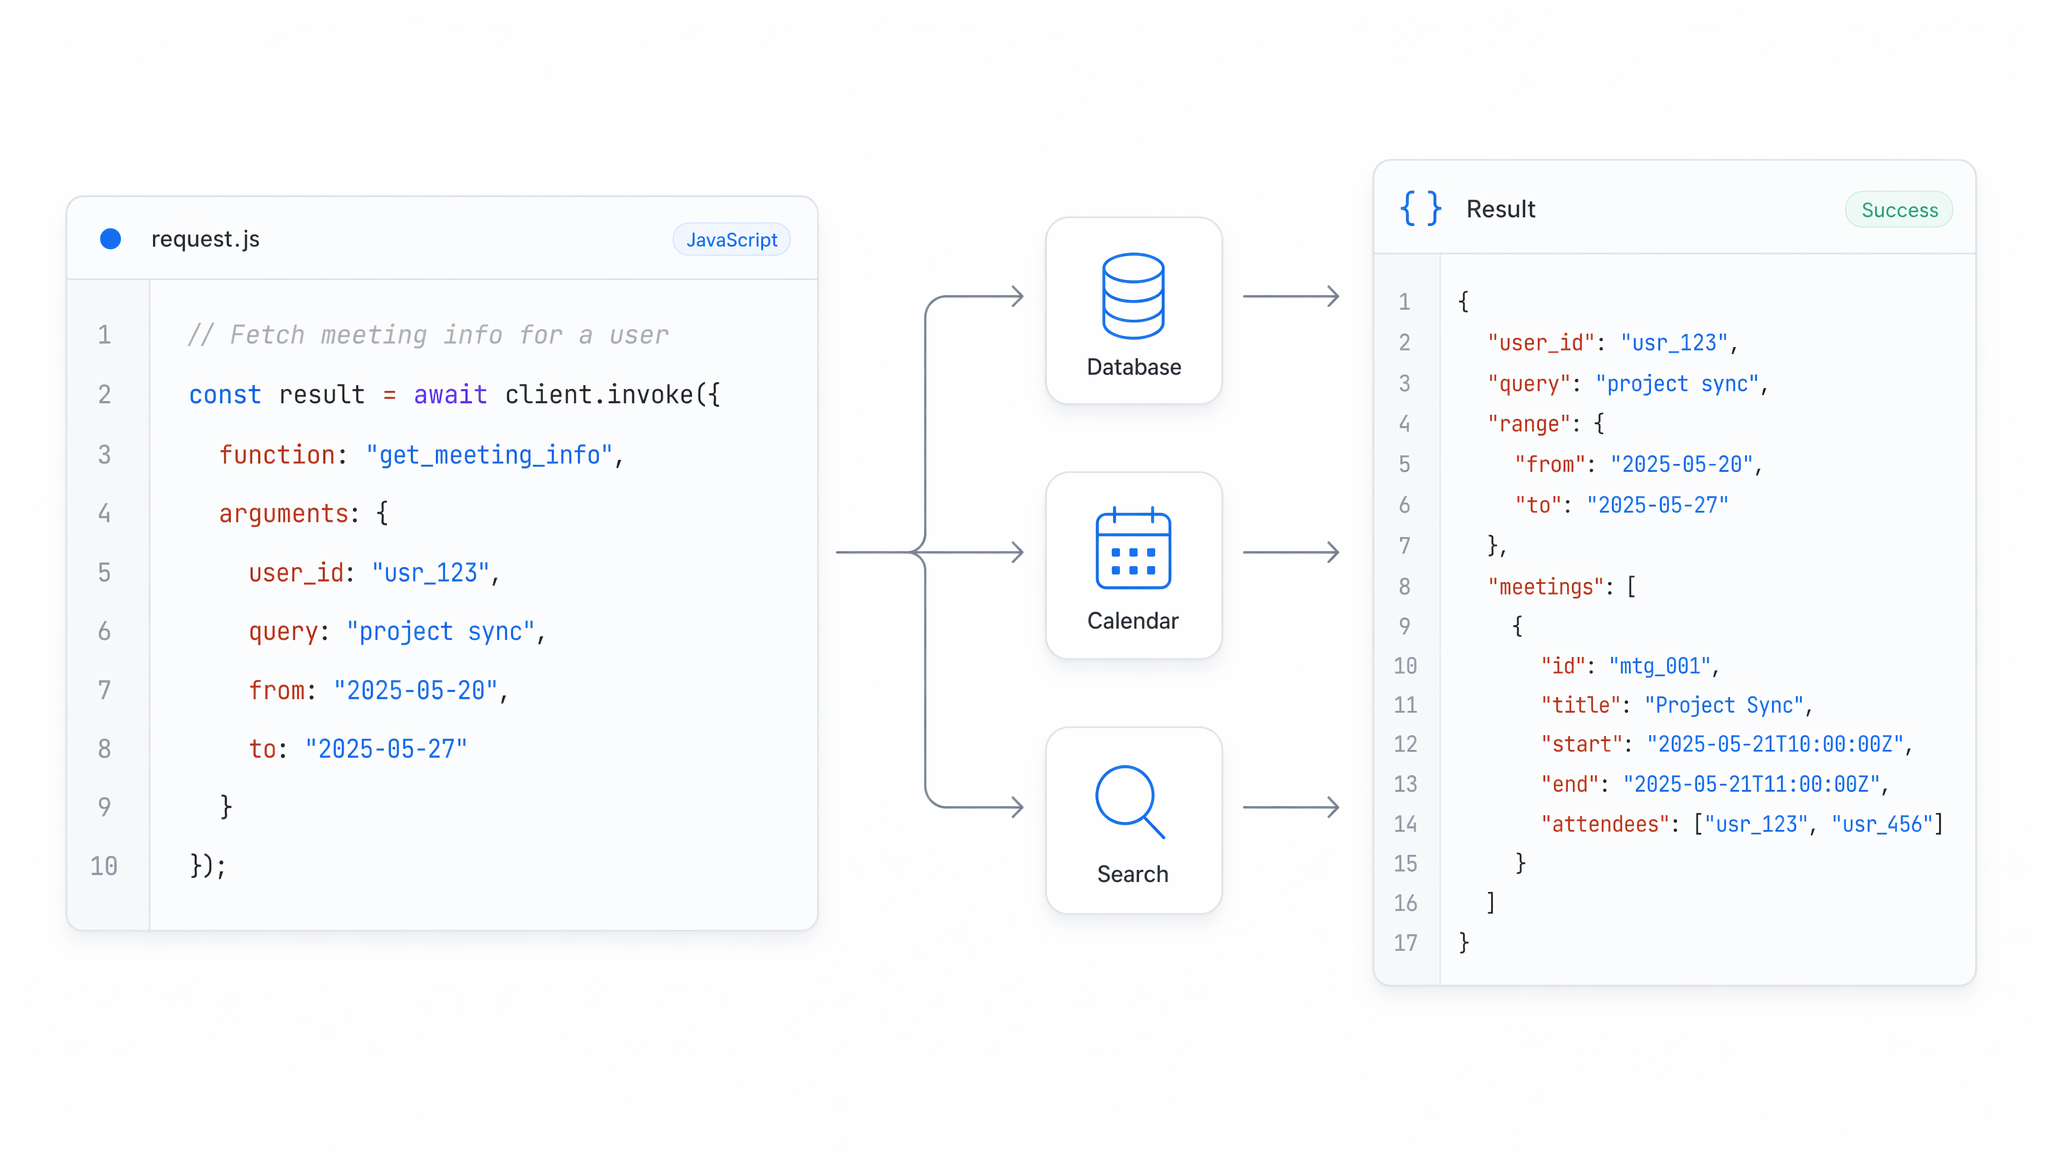
Native tool calling via de GLM API
Koppel externe tools en services aan de GLM API via native function calling en gestructureerde JSON-output. Het model bepaalt wanneer het een tool aanroept, formatteert argumenten volgens je schema en retourneert machineleesbare resultaten.
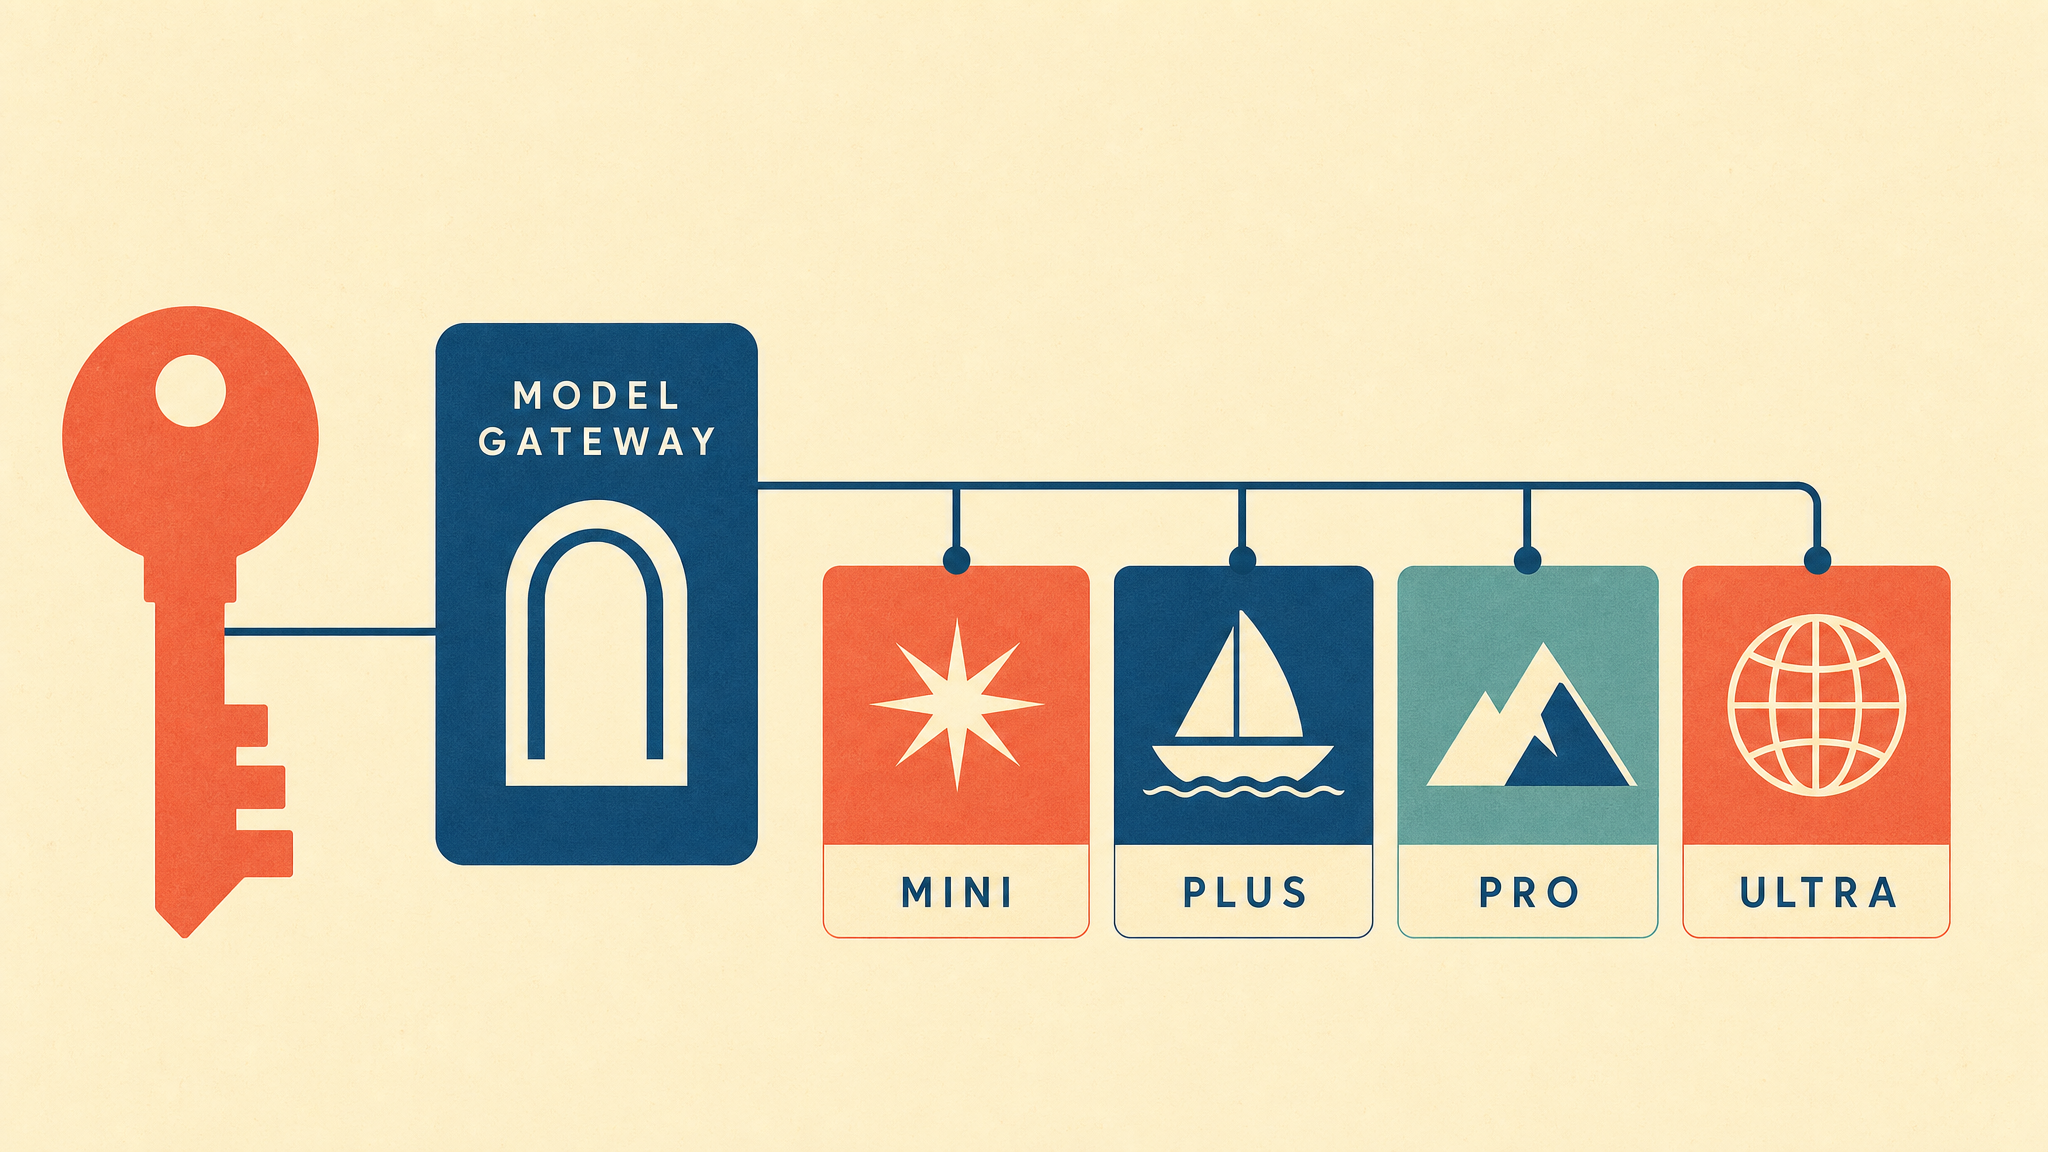
De volledige GLM API-line-up onder één key
Met één OpenAI-compatible key bereik je de volledige GLM API-line-up, van het vlaggenschip GLM-5.2 tot de Turbo-tiers en de kostenefficiënte GLM-4.6. Prototype op een lichtere tier en promoveer daarna naar productie met één regel en pay-as-you-go pricing.
GLM API Head-to-Head: één briefing, drie modellen vergeleken
Stuur één build-request door de GLM API en zie hoe GLM 5.2, DeepSeek V4 Pro en GLM 5 dezelfde instructie omzetten in een werkende interactieve pagina, zodat je front-endkwaliteit, lay-outlogica en interactie-afwerking in één oogopslag kunt afwegen.
Genereer een compleet, single-file, zelfstandig HTML-document (alle CSS en JavaScript inline, absoluut geen externe afhankelijkheden, geen CDNs, geen afbeeldings-URLs, geen externe fonts) dat een interactieve "Aurora Tuning Console" rendert — een WebGL-ervaring op volledig viewportformaat van een middernachtelijke poolhemel waarin het poollicht in realtime wordt berekend binnen een GLSL fragment shader, nooit nagebootst met sprites, textures of particle stacks. Kernvereiste voor rendering: render één fullscreen quad en doe al het visuele werk in een fragment shader. De aurora borealis moet procedureel worden gegenereerd uit gelaagde fractal value/simplex noise (fbm, 4–6 octaven) die in de tijd stroomt en vervormt via een uniform clock, waardoor hoge verticale lichtgordijnen ontstaan die ademen, rimpelen, knopen vormen en vervagen. Modelleer de aurora als self-emissive volumetric glow: accumuleer helderheid langs een verticale falloff, voeg zachte bloom toe aan de basis van elk gordijn en verstrooi subtiele, drijvende star-dust noise door de donkere bovenhemel. Stel het frame samen als een minimalistische blik omhoog met lage horizon — ongeveer 80% hemel, met een donkere silhouet-bergrug en een spiegelstil meer onderaan dat de aurora en sterren weerspiegelt in een zacht rimpelende, verticaal gespiegelde kopie. Het basispalet is bijna zwart indigo (diep blauw-violette nacht); de aurora is het enige element met hoge saturatie — ingetogen, lichtgevend, doorschijnend, nooit schreeuwerig. Interacties (allemaal realtime, vloeiend en duidelijk responsief): - Slepen met de muis over de hemel "trekt" aan de lichtgordijnen als aan stof — voer de pointerpositie/-snelheid door naar shader uniforms zodat de aurora naar de cursor buigt, uitrekt en stroomt, en daarna met zachte traagheid terugveert wanneer wordt losgelaten. - Scrollen met het muiswiel wisselt het "seizoen", waarbij de kleurband van de aurora continu interpoleert van smaragdgroen → magenta → indigo (en terug), weergegeven als een vloeiende gradiëntverschuiving, niet als discrete sprongen. - Dubbelklikken ontsteekt een nieuwe ster op dat punt in de hemel: die pulseert (sinusvormige helderheid) en werpt een bijpassende reflectie op het meer. Ondersteun veel gelijktijdige sterren. - Houd een subtiele idle-animatie aan zodat het eerste lichtgordijn bij het laden langzaam lijkt te ontwaken en zich te ontvouwen — een stille, sacrale, koude en verstilde sfeer. UI & polish: een kleine, elegante, semi-transparante control overlay in een hoek die het huidige seizoen/de huidige kleur toont en een subtiele hintregel met de bediening (slepen / scrollen / dubbelklikken), vormgegeven in een strak modern, koud getint esthetisch ontwerp met zachte fade-overgangen. Maak het volledig responsive: wijzig de grootte van het WebGL-canvas en update resolution uniforms bij window resize, zodat het elke viewport vult en scherp blijft op high-DPI-schermen. Mik op een stabiele 60fps met requestAnimationFrame. Voeg een nette fallbackmelding toe als WebGL niet beschikbaar is. Geef prioriteit aan de wiskundige kwaliteit van de noise-flow, de volumetric glow en de vloeiendheid van de interacties — dit is waar een capabel model zichtbaar zou moeten uitblinken boven een zwakker model.
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
Bouw een compleet, single-file, zelfstandig HTML-document (alle CSS en JavaScript inline in één bestand, absoluut nul externe afhankelijkheden — geen CDNs, geen externe scripts, geen webfonts, geen afbeeldings-URLs, geen SVG-assets die via het netwerk worden opgehaald; genereer elk geluid met de native Web Audio API en teken elk visueel element met CSS en Canvas/DOM) dat direct in elke moderne browser opent en een speelbare cyberpunk step-sequencer drum machine draait in de beeldtaal van synthwave-neon uit de jaren 80. Kerninstrument: render een gloeiende step matrix van 16 kolommen × 6 tracks, horizontaal over het scherm geplaatst, één rij per voice — Kick, Snare, Closed Hi-Hat, Open Hi-Hat, Clap en Synth Bass. Elk van de 96 cellen is een klikbare pad; klikken schakelt die aan/uit, een actieve cel licht op met een verzadigde magenta-naar-cyaan gloed, een inactieve cel ligt als een gedimde verzonken rechthoek op de bijna zwarte indigoblauwe achtergrond. De gebruiker programmeert een beat door cellen kolom voor kolom te laten oplichten. Ondersteun click-and-drag painting over cellen om er veel tegelijk te toggelen. Audio: synthetiseer alle drum voices live met de Web Audio API — kick als een pitch-swept sine met snelle amplitude decay, snare en clap als gefilterde white-noise bursts met envelope, closed en open hi-hats als high-passed noise met korte versus lange decay, en synth bass als een detuned saw/square door een resonant low-pass filter dat een selecteerbare root note speelt. Plan stappen met een nauwkeurige look-ahead clock (geen naïeve setInterval-timing), zodat de loop rotsvast blijft bij hoog tempo. Loop het 16-step patroon continu wanneer er wordt afgespeeld. Transport en controls, gedockt in een symmetrische control bar die onderaan vastgepind is: een grote Play/Stop-knop, een BPM dial of rotary knob (sleepbaar, bereik ~60–200 BPM, standaard 120) met een live numerieke uitlezing, een master volume fader, mute-knoppen per track, een Clear-knop en een Randomize-knop die een plausibele beat genereert. Een bewegende playhead — een verticaal lichtzwaard — veegt perfect synchroon met de audio over de grid, en elke actieve cel die hij raakt bloeit op met een radiale ripple pulse die vervaagt. Voeg een live oscilloscope/waveform display toe dat de amplitude van de master output in realtime visualiseert en op het geluid reageert. Visuele stijl: een diep indigo-naar-violet gradiëntachtergrond die zo donker is dat hij bijna zwart oogt, gridlijnen en UI-accenten in elektrisch magenta en cyaan, waarbij alle lichtkracht komt uit self-glow van elementen en hit-flash bloom (box-shadow glow, additive-feeling highlights) om een nachtelijke undergroundclub op te roepen die pulseert op de loop. Centreer de volledige grid op het scherm, houd de lay-out symmetrisch met de control bar die de basis comprimeert, en maak hem responsive zodat de grid soepel schaalt naar kleinere viewports. Voeg subtiele geanimeerde scanlines of chromatic shimmer toe voor sfeer zonder de leesbaarheid te schaden. Interactierequirements: alles reageert direct — pads klikken, de BPM knob en volume fader slepen, mutes toggelen, op de spatiebalk drukken voor Play/Stop en cijfertoetsen gebruiken om naar de bass root note te springen. State (welke cellen actief zijn, BPM, volume, mutes, afspeelstatus) moet netjes worden beheerd, zodat UI en audio nooit uit sync raken. De eerste interactie met de pagina moet ook de AudioContext unlocken/hervatten. Geef prioriteit aan strakke audio-visuele synchronisatie, vloeiende 60fps-animatie van de playhead en ripples, en een werkelijk bevredigend, muzikaal resultaat direct uit de doos.
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
Waar developers de GLM API inzetten
Van autonome coding agents en langlopende research tot conversationele producten en grootschalige data-analyse: de GLM API biedt developers één OpenAI-compatible endpoint voor het bouwen van betrouwbare, agent-gedreven software.

Autonome coding agents met de GLM API
GLM models zijn gebouwd voor autonome taakuitvoering en plannen, schrijven en verfijnen code binnen workflows met meerdere stappen, zonder projectcontext kwijt te raken. Development teams vertrouwen hierop voor PR review bots, refactoring assistants en build pipelines.

Langlopende research en workflow-orchestratie
Stabiel redeneren over meerdere stappen laat deze models uitgebreide researchvragen opsplitsen, externe tools aanroepen en context vasthouden over lange reeksen afhankelijke acties. Dit past goed bij analisten en productteams die synthese uit meerdere bronnen en cross-platform operations automatiseren.

Verfijnde front-endinterfaces bouwen
GLM models zetten ruwe mockups en eenvoudige beschrijvingen om in schone, responsieve interfacecode met een sterk gevoel voor visuele afwerking. Solo founders en designgerichte developers leveren functionele prototypes en productie-UIs veel sneller op.

Conversationele producten op de GLM API
Wil je assistants die menselijk aanvoelen? De GLM API levert natuurlijke conversationele ervaringen, ondersteund door stabiel redeneren, voor chatbots, support copilots en in-app assistants die coherent blijven in lange, vertakkende dialogen.

Tool-calling backends en functie-uitvoering
Omdat deze models zijn gebouwd voor toolgebruik, selecteren ze functies, formatteren ze argumenten en koppelen ze API calls binnen agentic systemen. Engineers gebruiken dit om GLM te verbinden met orchestration layers, RAG pipelines en multi-agent stacks.

Data-analyse opschalen met de GLM API
Gebruik de GLM API om te redeneren over grote documenten, spreadsheets en rapporten, en gestructureerde inzichten te extraheren via een efficiënt Mixture-of-Experts design. Ideaal voor finance-, legal- en operations-teams die betrouwbare analyse op hoog volume nodig hebben.
GLM API versus concurrerende LLMs: specificatie- en prijsmatrix
Vergelijk elk GLM API-model met toonaangevende tekst-LLMs op Atlas Cloud op contextlengte, uitvoerlimieten en transparante pay-as-you-go-prijzen.
| Model | Contextvenster | Maximale uitvoer | Invoer ($/1M tokens) | Uitvoer ($/1M tokens) |
|---|---|---|---|---|
| GLM 5.2 | 1M | 128K | $1.40 | $4.40 |
| GLM 5.1 | 203K | 203K | $1.40 | $4.40 |
| GLM 5 | 203K | 203K | $1.00 | $3.20 |
| GLM 4.7 | 203K | 203K | $0.60 | $2.20 |
| DeepSeek V4 Pro | 1M | 384K | $1.74 | $3.45 |
| Kimi K2.7 Code | 256K | 256K | $0.95 | $4.00 |
| MiniMax M3 | 512K | 512K | $0.60 / $1.20 >512K | $2.40 / $4.80 >512K |
Hoe GLM te gebruiken op Atlas Cloud
Binnen enkele minuten aan de slag — volg deze eenvoudige stappen om modellen te integreren en uit te rollen via het platform van Atlas Cloud.
Maak een Atlas Cloud-account aan
Registreer bij atlascloud.ai en voltooi de verificatie. Nieuwe gebruikers ontvangen gratis credits om het platform te verkennen en modellen te testen.
Waarom GLM Gebruiken Op Atlas Cloud
De combinatie van GLM's geavanceerde modellen met het GPU-versnelde platform van Atlas Cloud biedt ongeëvenaarde prestaties, schaalbaarheid en ontwikkelaarservaring.
Prestatie & Flexibiliteit
Lage Latentie:
GPU-geoptimaliseerde inferentie voor realtime reasoning.
Uniforme API:
Voer GLM, GPT, Gemini en DeepSeek uit met één integratie.
Transparante Prijzen:
Voorspelbare op tokens gebaseerde facturering met serverloze opties.
Onderneming & Schaling
Ontwikkelaarservaring:
SDK's, analytics, fine-tuning tools en sjablonen.
Betrouwbaarheid:
99,99% beschikbaarheid, RBAC en compliance-ready logging.
Beveiliging & Compliance:
SOC 2 Type II, HIPAA-afstemming, gegevenssoevereiniteit in VS.
GLM API: antwoorden op veelgestelde vragen van ontwikkelaars
De GLM API geeft ontwikkelaars toegang tot Z.ai's (Zhipu AI) GLM-serie van open-weight large language models, waaronder GLM-5.2, GLM-5, GLM-4.7 en GLM-4.6. Deze modellen zijn ontworpen voor programmeren, redeneren in meerdere stappen en taken voor autonome agents. Op Atlas Cloud bereik je de hele familie via één OpenAI-compatibel endpoint met pay-as-you-go-prijzen.
Atlas Cloud host de huidige GLM-line-up, waaronder GLM-5.2, GLM-5.1, GLM-5, GLM-5 Turbo, GLM-5v Turbo, GLM-4.7 en GLM-4.6. Flagship-versies richten zich op complex agentic en programmeerwerk, terwijl de Turbo-varianten snellere responses met lagere latency prioriteren. Wisselen tussen modellen vereist alleen een wijziging van de model identifier in je request.
Meld je aan voor Atlas Cloud, genereer één API key en laat je bestaande OpenAI-compatibele client naar ons endpoint wijzen. Omdat de GLM API het OpenAI-requestformaat volgt, hoeven de meeste integraties alleen de base URL en modelnaam aan te passen om requests te kunnen versturen. Toegang is pay-as-you-go met transparante prijzen per call en zonder abonnement.
De prijzen zijn pay-as-you-go en worden per token gefactureerd, zonder verplicht abonnement. GLM-4.7 en GLM-4.6 beginnen bij $0.60 per miljoen input tokens en $2.20 per miljoen output tokens, GLM-5 kost $1.00 input en $3.20 output, en GLM-5.2 kost $1.40 input en $4.40 output. Gecachte input wordt tegen een lager tarief gefactureerd, wat de kosten verlaagt bij herhaalde context.
GLM-modellen op Atlas Cloud bieden een groot context window van ongeveer 200K tokens, met een maximale output van circa 131K tokens op flagship-versies. Die capaciteit is voldoende om volledige repositories, lange documenten of uitgebreide agent-histories in één request te laden. Binnen de GLM-familie bestaan varianten met langere context, dus controleer de exacte limiet op de pagina van elk model.
Ja. GLM-modellen ondersteunen tool en function calling in combinatie met structured JSON output, waardoor ze direct passen in agentic pipelines en productiesystemen die machineleesbare responses verwachten. Dankzij het OpenAI-compatibele formaat is de GLM API eenvoudig aan te sluiten op bestaande workflows voor toolgebruik.
Deze modellen zijn gebouwd voor programmeren, long-horizon reasoning en uitvoering door autonome agents. Veelvoorkomende toepassingen zijn codeanalyse van volledige repositories, full-stack prototyping en onderzoek in meerdere stappen of workflowautomatisering. De flagship GLM-5-serie verwerkt het meest veeleisende agentic werk, terwijl GLM-4.6 een sterke balans biedt tussen snelheid en capaciteit voor dagelijkse taken.
GLM's flagship-modellen worden gepositioneerd als concurrerende open-weight alternatieven voor toonaangevende closed-source modellen op benchmarks voor programmeren en agentic taken. De belangrijkste praktische aantrekkingskracht is de prijs, omdat de prijs per token een fractie is van vergelijkbare proprietary modellen terwijl de programmeerprestaties sterk blijven. Voor teams die budget tegen kwaliteit afwegen, biedt GLM frontier-level capaciteit tegen een lager tarief.
Ja. Atlas Cloud levert GLM-modellen via een OpenAI-compatibel endpoint, zodat elk framework of elke SDK die een custom base URL en modelnaam accepteert ze met minimale wijzigingen kan aanroepen. Zo kun je GLM direct inzetten in tool-calling agents, coding assistants en orchestration pipelines in meerdere stappen die je al gebruikt. Begin vandaag nog met bouwen.
Ja. De GLM-serie wordt door Z.ai (Zhipu AI) uitgebracht als open-weight modellen onder een permissive license, waardoor ze breed worden gezien als een toonaangevende open-source optie. Op Atlas Cloud krijg je beheerde, productieklare toegang tot deze modellen zonder zelf infrastructuur te hosten of te onderhouden.
Verken Meer Families
Kling 4.0
Kling V4, ontwikkeld door Kuaishou, is een videomodel voor professionele productie. Het combineert stabiele, complexe bewegingen met een ultrabreedbeeldformaat van 21:9 en gerichte bewerking van gezichtsuitdrukkingen, camerahoeken, achtergronden, visuele stijlen en dialogen. Atlas Cloud bereidt toegang vanaf dag 0 voor via één OpenAI-compatibele sleutel, met transparante tarieven op basis van verbruik voor flexibele integratie. Begin vandaag nog met bouwen.

Seedance 2.5
De Seedance 2.5 API is nu beschikbaar op Atlas Cloud! Het biedt ontwikkelaars het nieuwste videomodel van ByteDance. Het genereert tot 30 seconden native video in één enkele doorgang vanuit tekst, een enkele afbeelding, of tot wel 50 multimodale referenties, met gesynchroniseerde audio en meertalige tekst in het frame. Op Atlas Cloud heeft u er toegang toe via één sleutel, waarbij onderwerpconsistentie en verbeterde fysica lange opnames coherent houden.
Wan 3.0
De Wan 3.0 API is de volgende generatie van Alibaba's Wan-videofamilie, gebouwd om het genereren van lange formaten, multi-referentie controle en audiovisuele kwaliteit naar nieuwe hoogten te tillen. Atlas Cloud host al Wan 2.7, 2.6 en 2.5, en Wan 3.0 draait op dezelfde uniforme sleutel zonder afzonderlijke configuratie. Begin vandaag nog met bouwen. Scroll naar beneden naar de showcase om te zien wat Wan 3.0 kan creëren.
MiniMax H3
MiniMax H3 is MiniMax’ multimodale videofamilie voor creatie op basis van tekst, afbeeldingen en referenties. Via de ondersteunde routes blijven onderwerpen uit referentiemedia behouden, zijn flexibele beeldverhoudingen beschikbaar en worden gegenereerde geluiden via H3 Developer gekoppeld aan de beelden, met uitvoerprofielen die per endpoint worden geselecteerd. Atlas Cloud brengt de hele familie samen achter één OpenAI-compatibele sleutel, met transparante betaling naar gebruik vanaf het standaardtarief van $0.038 per seconde. Begin vandaag nog met bouwen.
GPT Image 2.5
De gpt-image-2.5-familie van OpenAI biedt ontwikkelaars de keuze uit Flare en Sunburst voor productie-workflows voor afbeeldingen. Render in willekeurige resoluties tot 3840x2160 en kies uit vijf kwaliteitsniveaus, waaronder xhigh en max, om aan specifieke uitvoervereisten te voldoen. Atlas Cloud biedt direct inzetbare REST-inferentie zonder cold starts en met standaardprijzen vanaf $0.004 per generatie. Begin vandaag nog met bouwen.
Seedream 5.0 Pro
De Seedream 5.0 Pro API biedt ontwikkelaars het bestuurbare beeldbewerkingsmodel van ByteDance op Atlas Cloud. Het plaatst bewerkingen nauwkeurig met ankers en coördinaten, scheidt afbeeldingen in bewerkbare lagen, fuseert meerdere referenties en matcht exacte kleuren en materialen, met meertalige tekst in 2K en 3K. Op Atlas Cloud heeft u er toegang toe via één enkele sleutel!
Seedance 2.0
Seedance 2.0 is het productievideomodel van ByteDance voor nauwkeurige shotcreatie. Zet prompts om in video, animeer een afbeelding als eerste frame met optionele begeleiding door een laatste frame, of stuur de resultaten met referentiemedia en optioneel zoeken op het web. Atlas Cloud bundelt deze workflows in één uniforme API met transparante tarieven op basis van gebruik en één OpenAI-compatibele sleutel. Begin vandaag nog met bouwen.
Kling V3.0
Van Kuaishou: de Kling V3 API-familie ondersteunt workflows voor tekst, afbeeldingen en referentievideo’s. Draag beweging over met behoud van de identiteit van personages, stuur generatie aan met visuele referenties en bewerk video’s met opdrachten in natuurlijke taal. Atlas Cloud biedt Standard- en Pro-endpoints voor verschillende productiebehoeften. Maak je al content met Kling 3.0? Kling V4 is nu beschikbaar op Atlas Cloud. Ontdek het op de [Kling V4](https://www.atlascloud.ai/models/kling-v4)-modellenfamiliepagina.
Grok Imagine Video
Grok Imagine Video geeft ontwikkelaars toegang tot xAI's videofamilie voor het maken, animeren, uitbreiden en bewerken van clips. Genereer video's van 1 tot 15 seconden op basis van prompts, stuur mensen, objecten of stijlen aan met maximaal zeven referentieafbeeldingen en werk in 480p of 720p. Atlas Cloud brengt deze mogelijkheden samen via OpenAI-compatibele endpoints met transparante prijzen op basis van gebruik. Begin vandaag nog met bouwen.
Vidu Q4 Preview
Vidu Q4 is het nieuwste vlaggenschipvideomodel van Vidu, ontworpen voor image-to-video- en reference-to-video-generatie. Het kan één stilstaand beeld animeren en automatisch scèneovergangen creëren, zodat ontwikkelaars twee invoerpaden hebben voor verschillende productworkflows. Atlas Cloud biedt speciale API-endpoints met gepubliceerde parameterschema's tegen de geverifieerde standaardprijs van $0,04 per seconde. Begin vandaag nog met bouwen.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash is Google DeepMind’s van nature multimodale videofamilie voor flexibele productie-workflows. Bewerk bestaande beelden met tekstinstructies, behoud visuele consistentie met maximaal 10 referentieafbeeldingen en 3 videoclips, of verleng een shot in aan elkaar te koppelen segmenten tot 40 seconden. Krijg toegang tot elke workflow op Atlas Cloud met één OpenAI-compatibele API-sleutel, betalen naar gebruik en Day-0-beschikbaarheid. Begin vandaag met bouwen.
Nano Banana 2.1
Nano Banana 2.1 is Google's beeldmodellenfamilie, gebouwd op Gemini 3.6 Flash. Het biedt generatie en bewerking op Pro-niveau met de snelheid van Flash, ondersteunt bewerkingen in natuurlijke taal en samenvoegingen van 1 tot 14 invoerafbeeldingen, en behoudt consistentie voor maximaal 4 personages en 10 objecten. Via Atlas Cloud krijgen ontwikkelaars toegang tot deze familie met één OpenAI-compatibele sleutel, betrouwbare uptime en beschikbaarheid vanaf dag 0. Begin vandaag nog met bouwen.
Aanbevolen artikelen
Handleidingen, tutorials en productupdates om het meeste uit Atlas Cloud te halen.





