Nedladdningsfältet når 65 GB, fläktarna varvar upp och den verkliga frågan landar: kommer den faktiskt att laddas? Det korta svaret på GPT-OSS-120B:s minneskrav är cirka 61 GB för vikterna plus några GB till för arbetsutrymme, vilket är anledningen till att OpenAI marknadsför den som en modell för en enda 80GB-GPU.
Nedan delar vi upp siffran i delar, visar hårdvaran som har kört den med uppmätta hastigheter och går igenom den hostade vägen för när din egen hårdvara inte räcker.
Viktiga insikter
- GPT-OSS-120B levereras som en 60,8 GiB MXFP4-checkpoint, vilket är varför OpenAI siktar på en enda 80GB-GPU.
- Kontextlängd tillför lite minne: KV-cachen når bara cirka 4,5 GiB vid fulla 131K tokens.
- Med mindre än 80GB VRAM kan llama.cpp flytta expertlager till system-RAM och ändå köra den.
- Mac-datorer med mer än 96GB minne och 128GB mini-PC:ar kan rymma hela modellen på en enda maskin.
- Ingen lämplig hårdvara? Anropa Qwen3.5 122B A10B på Atlas Cloud via ett OpenAI-kompatibelt API.
GPT-OSS-120B minneskrav: vikter plus KV-cache
OpenAI släppte gpt-oss-120b den 5 augusti 2025 under Apache 2.0-licensen. Det är en mixture-of-experts-modell, så bara 5,1B av dess 116,8B parametrar arbetar per token. Det hjälper hastigheten, inte minnet: varje expert måste fortfarande ligga i minnet redo att väljas.
Tricket som håller den liten är MXFP4. Enligt gpt-oss-modellkortet lagras expertvikterna, som utgör över 90 % av parametrarna, med 4,25 bitar vardera. En 16-bitars kopia av samma modell skulle behöva ungefär fyra gånger så mycket utrymme.
| Specifikation | GPT-OSS-120B |
|---|---|
| Totala parametrar | 116,8B |
| Aktiva parametrar per token | 5,1B |
| Lager och experter | 36 lager, 128 experter, 4 aktiva per token |
| Viktformat | MXFP4 för expertlager, BF16 för resten |
| Checkpoint-storlek | 60,8 GiB |
| Kontextfönster | 131 072 tokens |
Hur kontextfönstret förändrar GPT-OSS-120B:s minne
Varje token lämnar en nyckel och ett värde efter sig i varje attention-lager. Den lagringen är KV-cachen, och när varje lager beaktar hela kontexten växer den i takt med kontextlängden.
GPT-OSS-120B undviker det mesta. Hälften av dess 36 lager använder ett glidande fönster som bara tittar tillbaka 128 tokens, och varje lager lagrar bara 8 KV-huvuden med 64 dimensioner. Endast 18 lager behåller hela kontexten. Vi räknade ut KV-cachen från modellens konfiguration och den matchar de uppmätta totalerna i llama.cpp:s gpt-oss-guide.
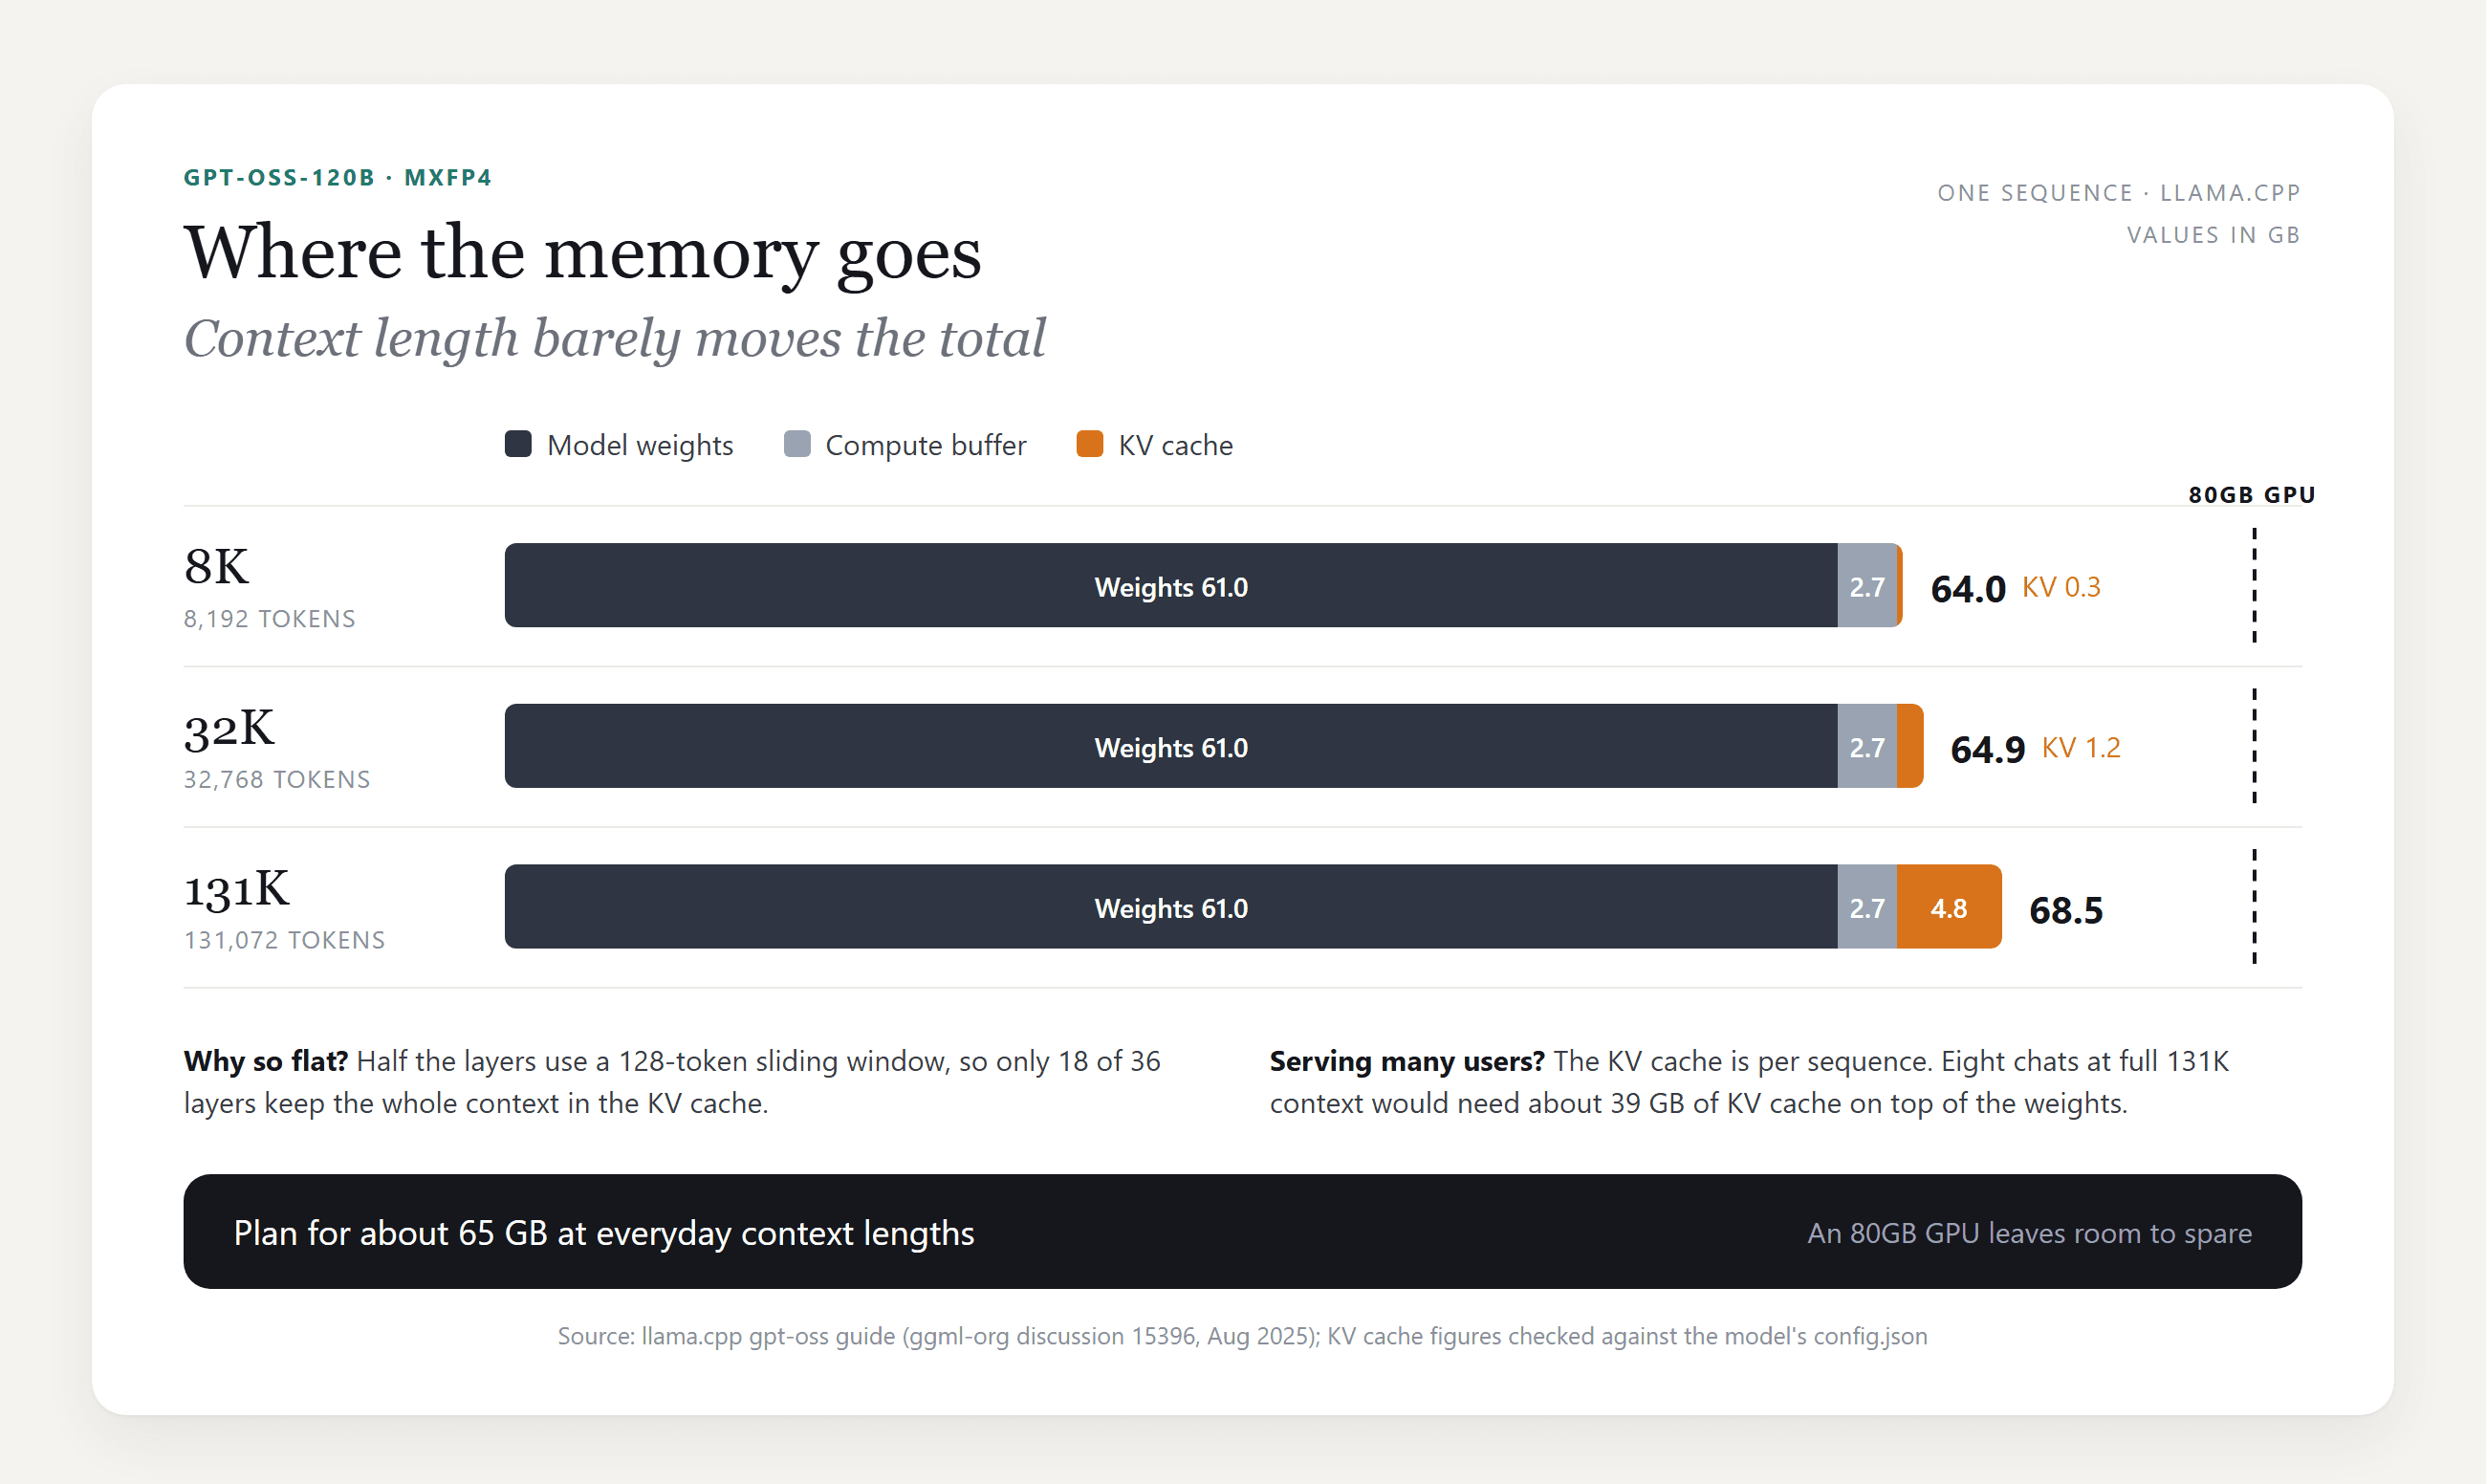
Att gå från 8K till fulla 131K kostar under 5 GB. Där det drar iväg är vid samtidighet: KV-cachen är per konversation, så en server som håller åtta fullängdschattar behöver ungefär 39 GB utöver vikterna.
Kan jag köra GPT-OSS-120B lokalt? Hårdvarukrav per uppsättning
Ja, om du kan placera cirka 65 GB någonstans snabbt: en stor GPU, en GPU plus system-RAM eller en maskin med enhetligt minne.
GPT-OSS-120B GPU-krav
Det enklaste fallet är ett 80GB datacenterkort. vLLM-receptet för gpt-oss säger att 120b-modellen "får plats på ett enda A100 (80GB)" och att dela upp den över fler GPU:er förbättrar genomströmningen.
Under 80GB erbjuder llama.cpp-guiden en väg ut. Flaggan --n-cpu-moe håller vissa expertlager i system-RAM och resten på GPU:n. Guiden anger minimum till cirka 8GB VRAM, så länge GPU- och systemminne tillsammans fortfarande rymmer modellen.
| Uppsättning | Var vikterna ligger | Rapporterad genereringshastighet |
|---|---|---|
| RTX Pro 6000, 96GB | Alla på GPU:n | 196 tokens/s (llama.cpp-guide) |
| A100 eller H100, 80GB | Alla på GPU:n | Får plats på ett kort (vLLM-recept) |
| RTX 5090, 32GB, plus system-RAM | 21 expertlager kvar i system-RAM | Cirka 30 tokens/s vid noll kontext (llama.cpp-guide) |
En Windows-fälla från samma guide: drivrutinen kan tyst spilla över i system-RAM när VRAM tar slut, så modellen laddas och kryper sedan fram. Håll koll på GPU-minne i Aktivitetshanteraren och höj offload-antalet tills det stannar under kortets storlek.
Köra GPT-OSS-120B på en Mac eller 128GB mini-PC
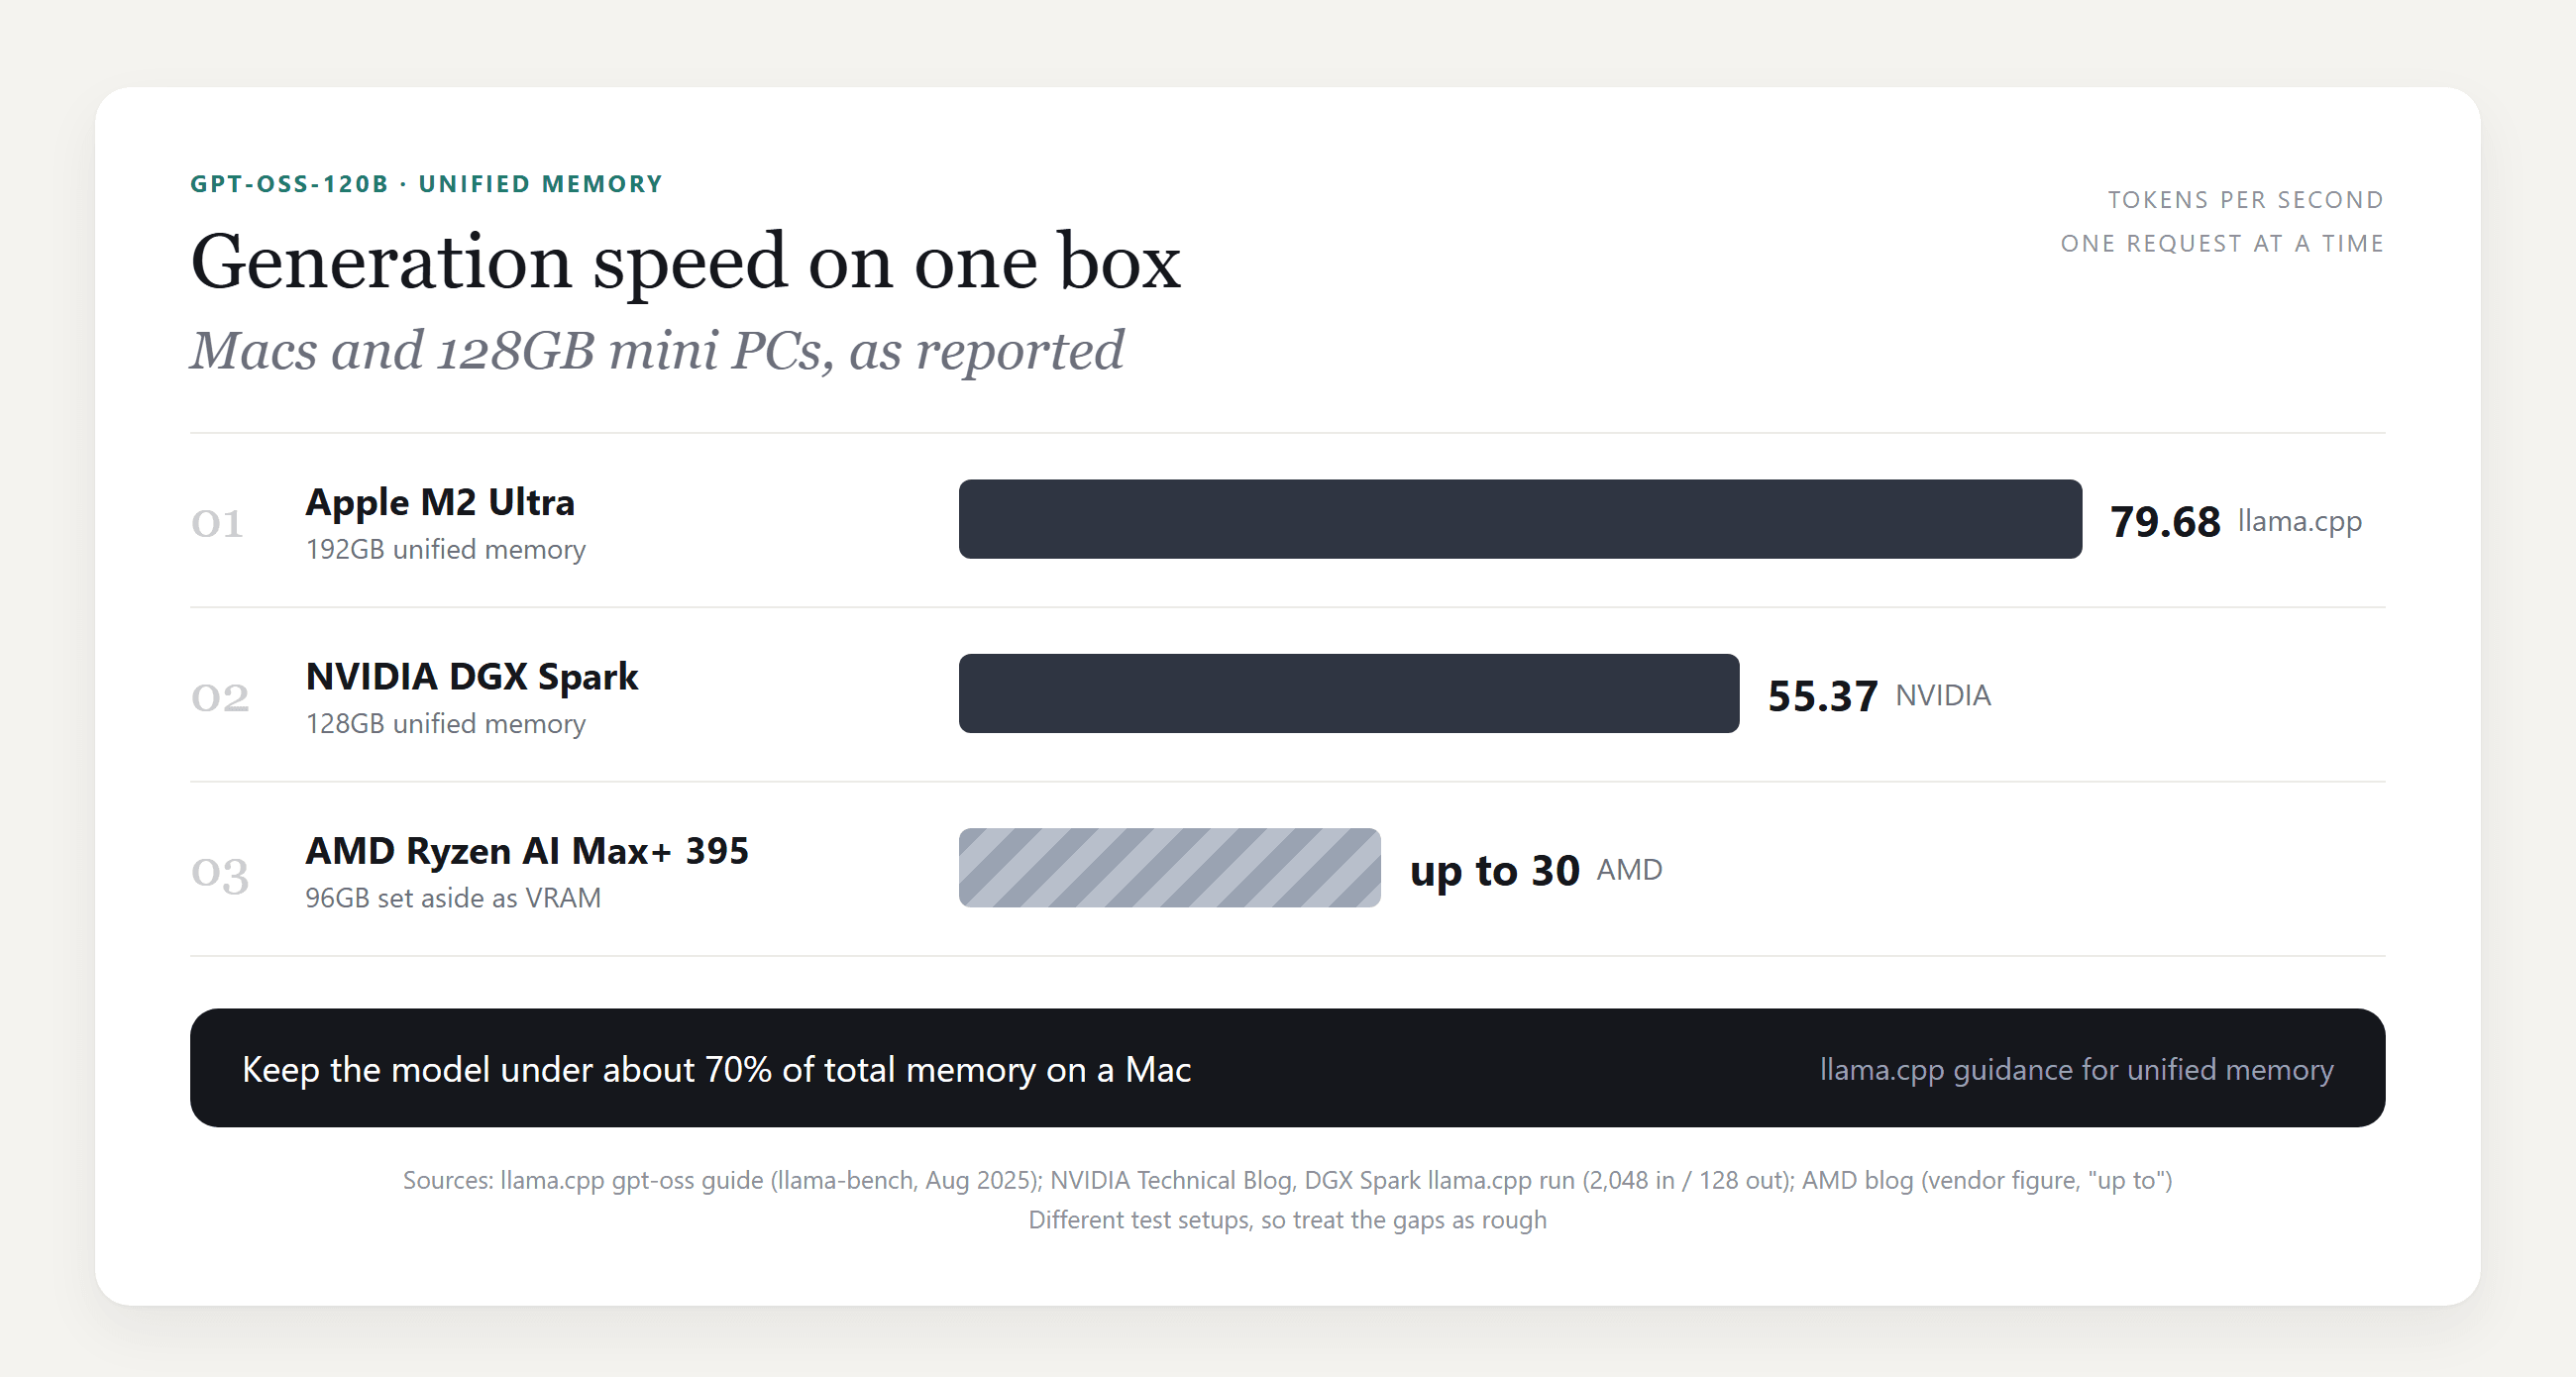
Enhetligt minne tar bort uppdelningen mellan GPU och RAM. llama.cpp-guiden säger att Mac-datorer med mer än 96GB RAM, som M2 Ultra- eller M3 Max-maskiner, kan köra modellen med full kontext, och den rekommenderar att hålla sig under cirka 70 % av det totala minnet.
macOS begränsar hur mycket minne GPU:n kan låsa som standard. På en 192GB-maskin höjer guiden taket från 154GB till 180GB med ett kommando:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
De nya 128GB mini-PC:arna hamnar i samma klass. NVIDIA rapporterar 55,37 tokens/s för gpt-oss-120b på en DGX Spark som kör llama.cpp. AMD säger att en Ryzen AI Max+ 395-maskin med 96GB avsatt som VRAM når "upp till 30 tokens per sekund", vilket är företagets egen siffra.
Inte tillräckligt med minne? Använd en hostad modell med öppna vikter via ett API
Om ingen av dessa maskiner står på ditt skrivbord hoppar en hostad modell med öppna vikter över hårdvarufrågan helt och hållet.
Atlas Cloud tillhandahåller Qwen3.5 122B A10B, en del av dess Qwen-modellutbud. På papperet är den en nära matchning för gpt-oss-120b: en Apache 2.0 mixture-of-experts-modell från Alibabas Qwen-team, med 122B totalt och 10B aktiva parametrar. Den läser upp till 262 144 tokens kontext.
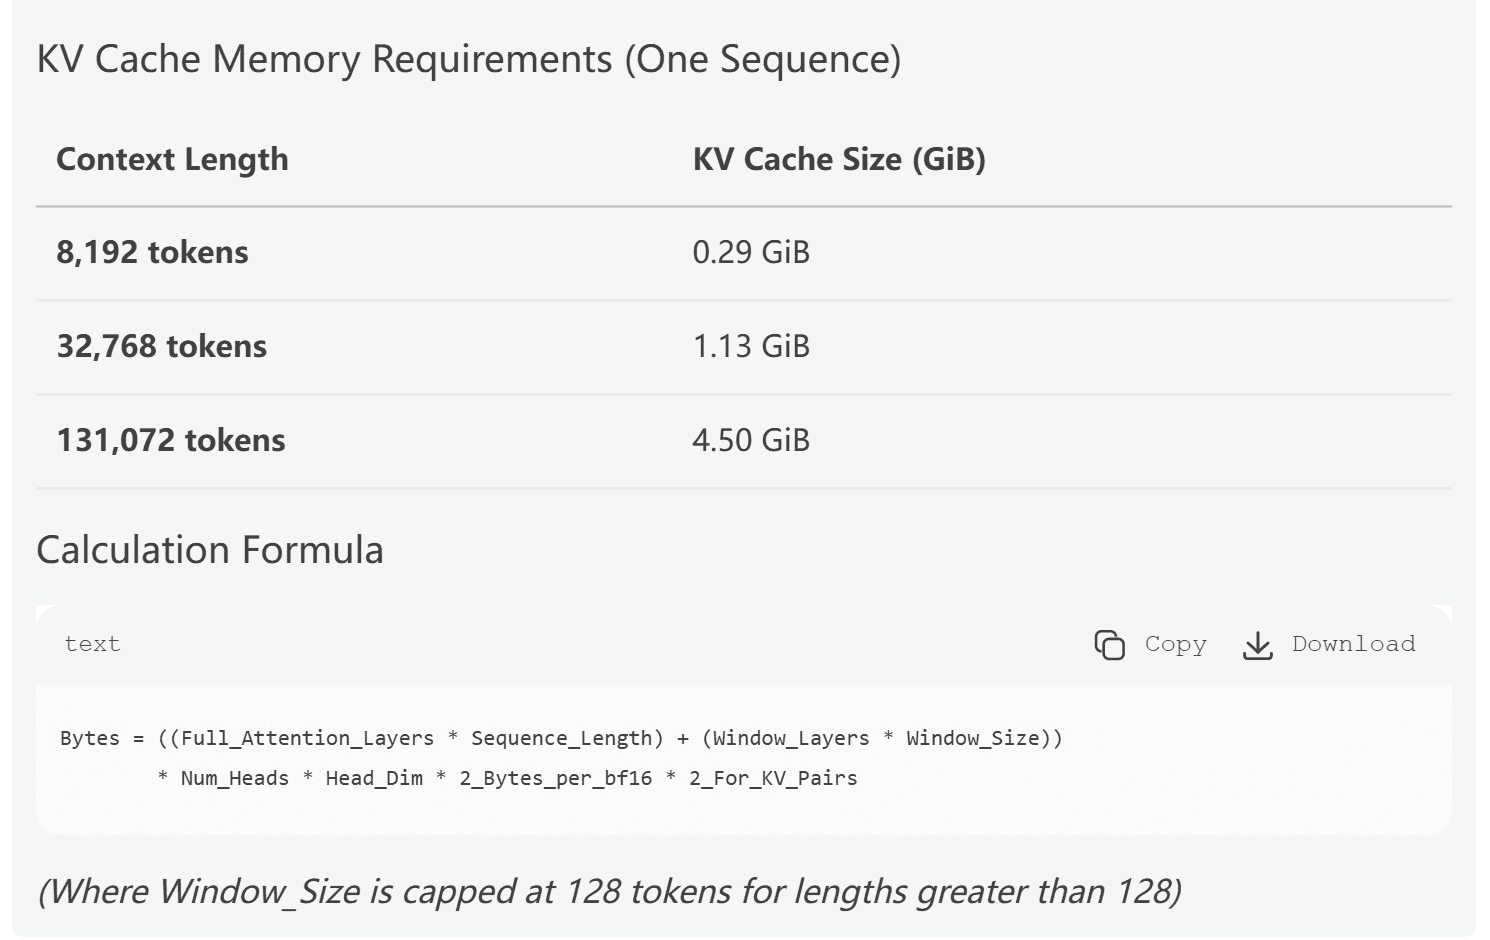
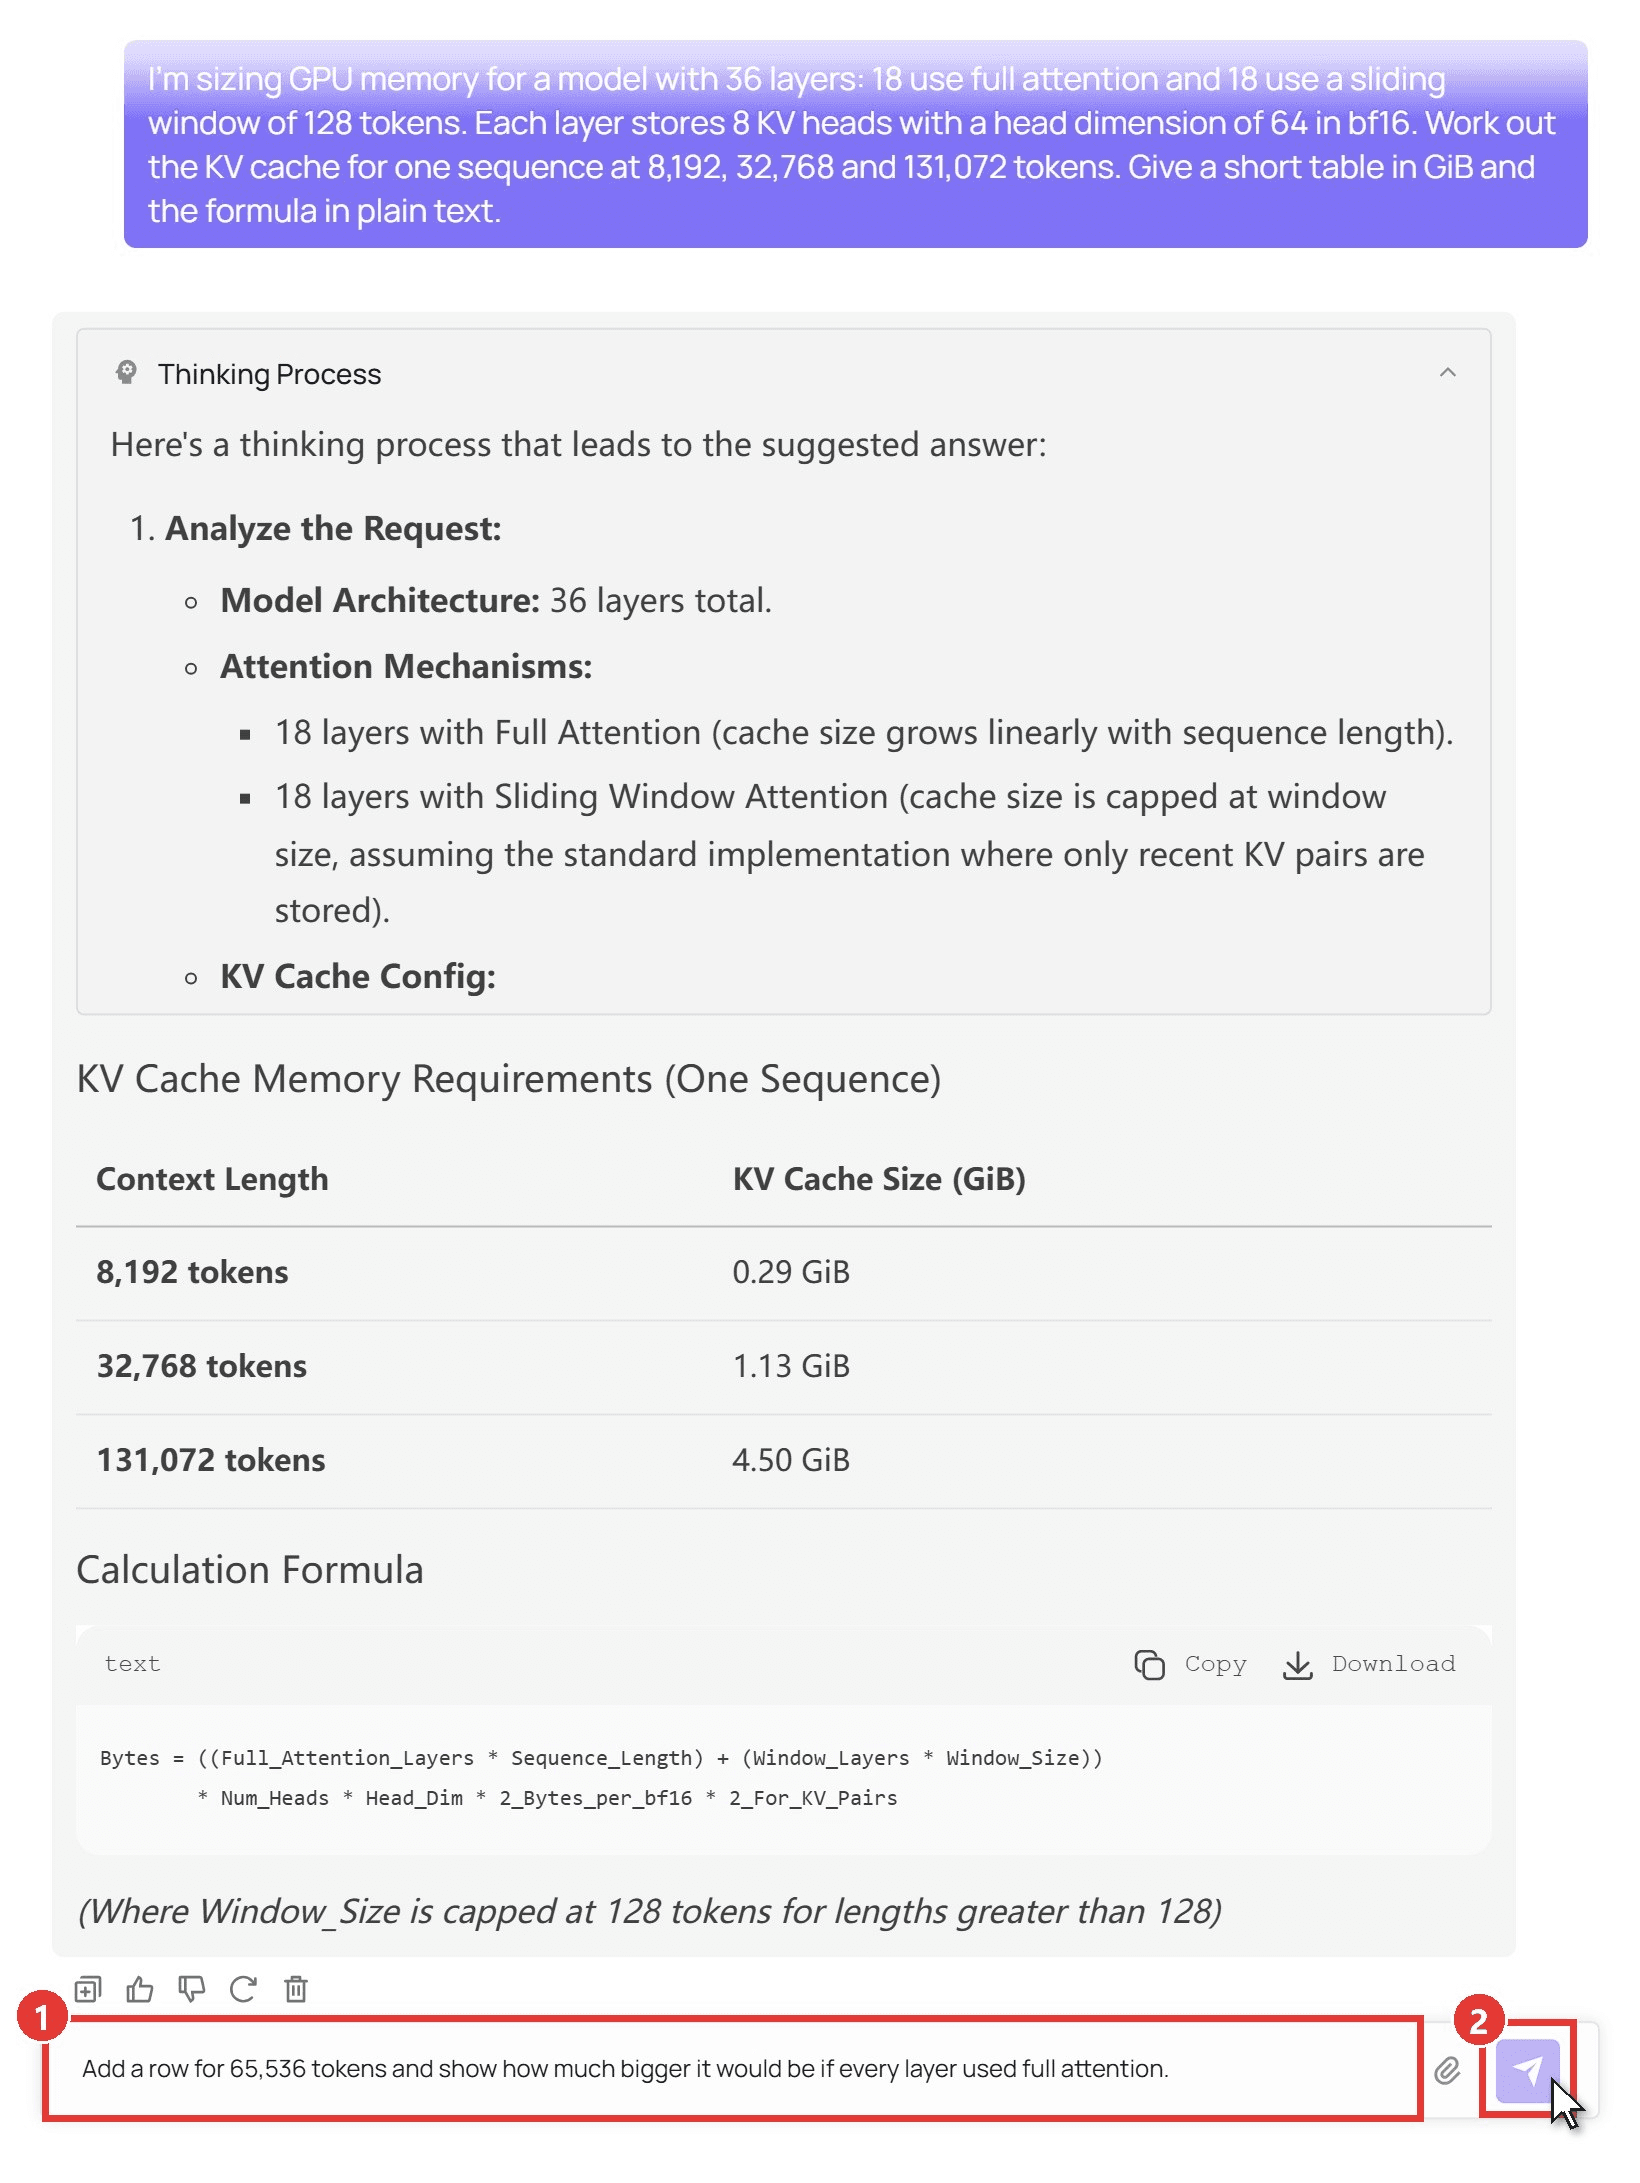
Vi gav den attention-layouten från gpt-oss-konfigurationen och bad om KV-cachen vid tre längder. Dess tabell matchade vår egen uträkning till två decimaler. Om du senare vill ha en Qwen för din egen maskin dimensionerar vår guide till den bästa Qwen-modellen för lokal kodning dem efter RAM.
Metod 1: Prova Qwen3.5 122B A10B i Playground
Logga in och öppna Qwen3.5 122B A10B-playgrounden och gör sedan:
- Skriv din fråga i meddelanderutan.
- Klicka på skicka-pilen. Resonemanget visas i en Thinking Process-panel ovanför svaret.
Metod 2: Anropa Qwen3.5 122B A10B med Atlas Cloud-API:et
För skript och appar:
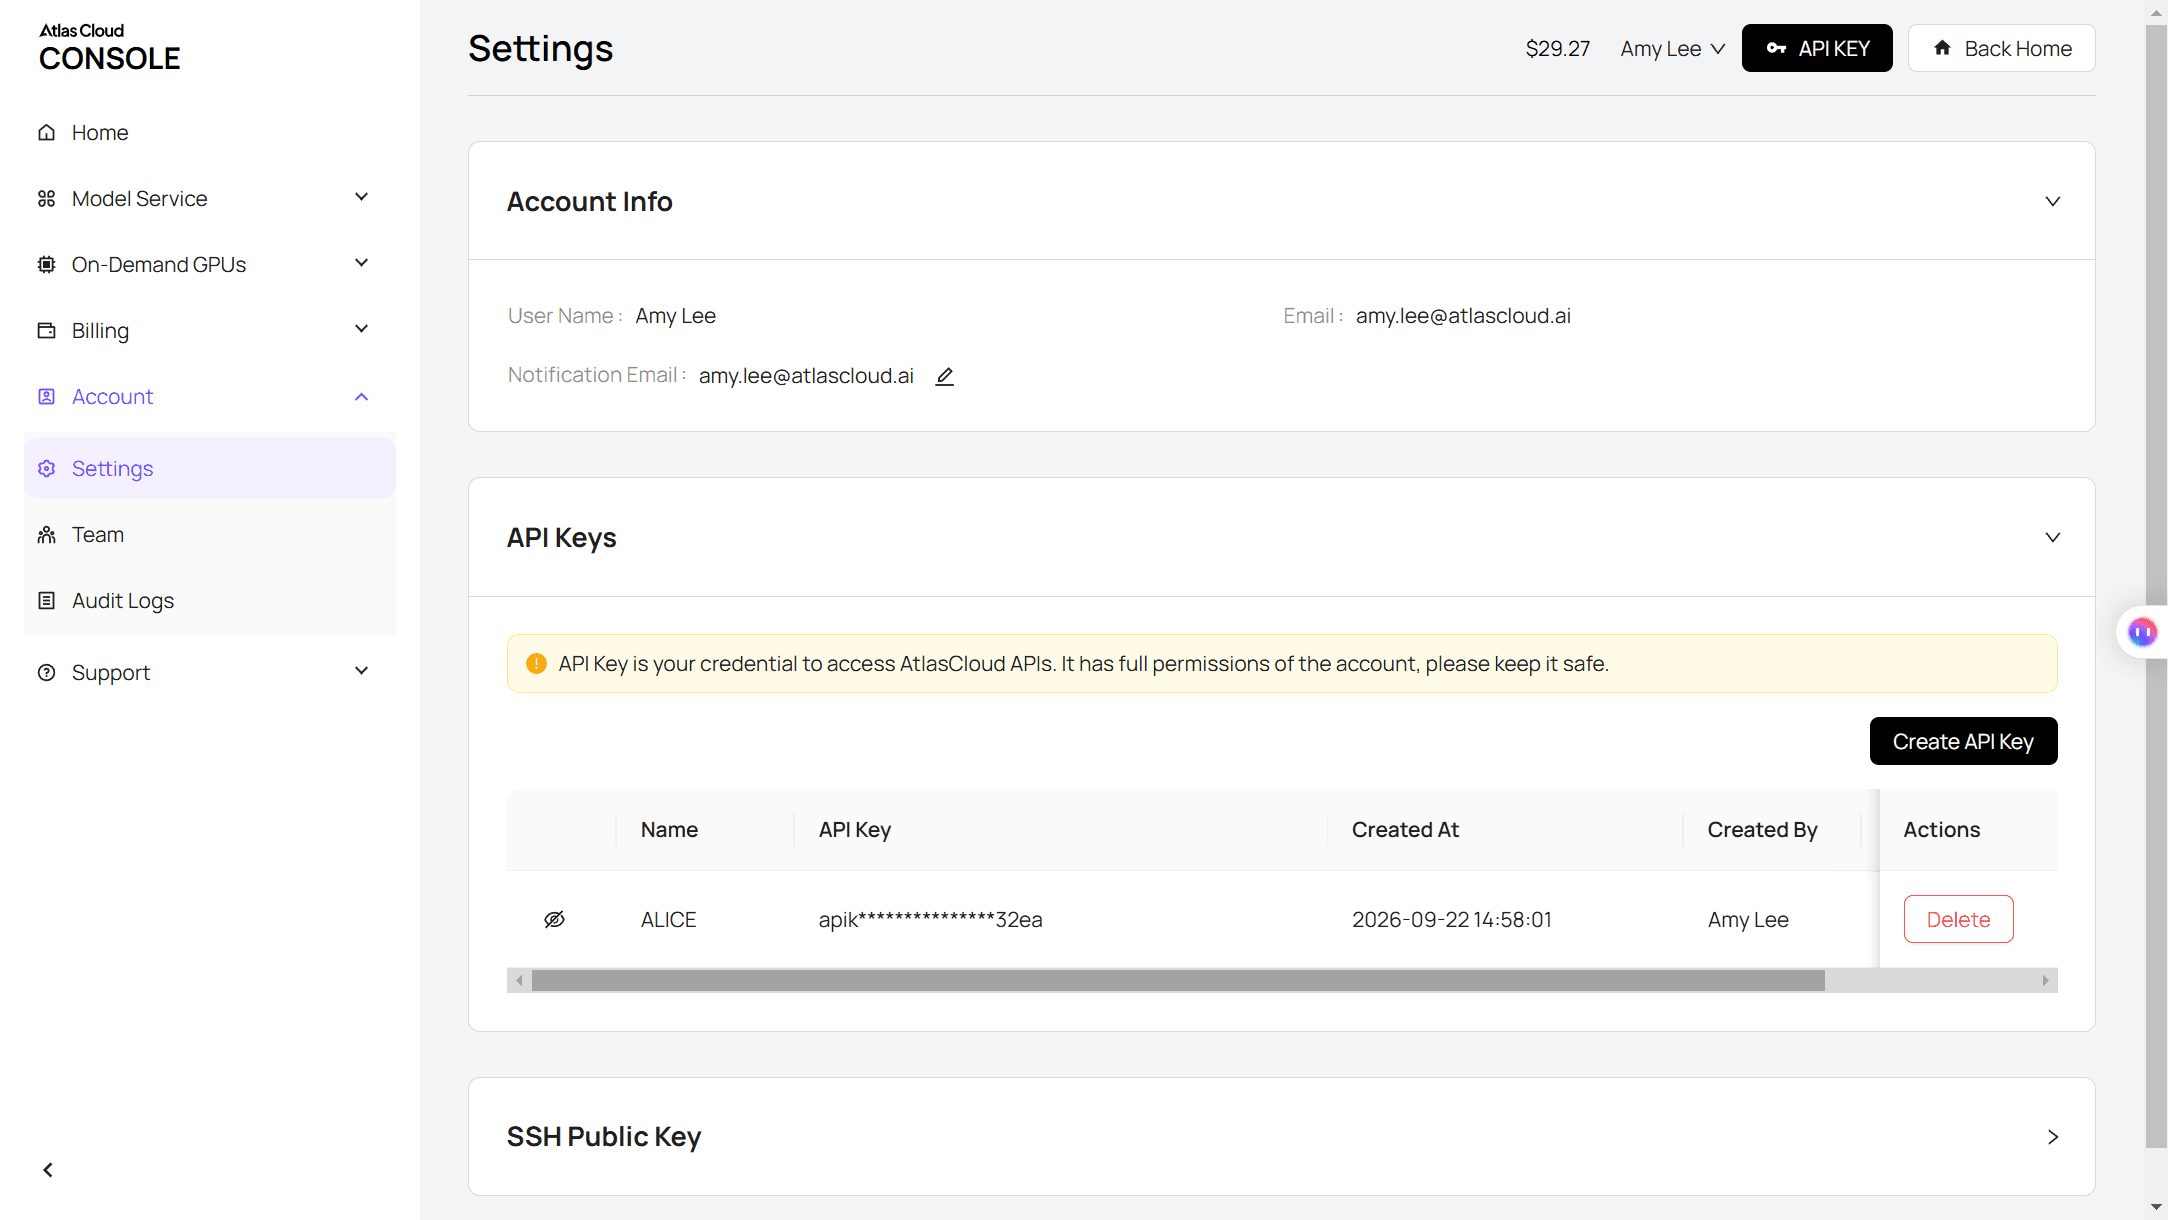
Steg 1: Skapa en API-nyckel. Öppna Inställningar i konsolen, gå till API-nycklar och klicka på Skapa API-nyckel. Förvara den på serversidan.
Steg 2: Kontrollera begäransformatet. API-dokumentationen täcker chat completions-formatet, och modellsidan har en API-flik med ett färdigt exempel.
Steg 3: Skicka din första begäran.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
Svaret kommer tillbaka i choices[0].message.content. Eftersom slutpunkten följer OpenAI-formatet behöver kod skriven för en lokal gpt-oss-server oftast bara en ny bas-URL, nyckel och modellsträng. Samma nyckel fungerar även för de andra chattmodellerna på plattformen, vilket vår artikel om en enhetlig LLM-API-gateway går igenom.
GPT-OSS-120B vs GPT-OSS-20B: avvägning mellan minne och benchmark
Det mindre syskonet behöver en femtedel av minnet. gpt-oss-20b har 20,9B parametrar med 3,6B aktiva, och OpenAI säger att den körs på "så lite som 16GB minne". Frågan är vad du ger upp.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Minne vid 8K-kontext (llama.cpp) | 64,0 GB | 14,9 GB | | MMLU | 90,0 | 85,3 | | GPQA Diamond (inga verktyg) | 80,1 | 71,5 | | SWE-Bench Verified | 62,4 | 60,7 | | Codeforces Elo (inga verktyg) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
Poängen kommer från modellkortet vid hög resonemangsinsats. Kodgapet är under två punkter på SWE-Bench Verified, medan kunskapsgapet är cirka 9 punkter inom naturvetenskap på forskarnivå och 15 på HealthBench. För mestadels kod på ett 16GB till 24GB-kort är 20b det förnuftiga valet. Behöver du den extra kunskapen? Det är där 120b förtjänar sin minneskostnad.
GGUF, Ollama eller vLLM: välj en körmiljö för din minnesbudget
Alla kör de MXFP4-vikter som OpenAI släppte; de skiljer sig i var dessa vikter kan ligga.
| Körmiljö | Nedladdning | Bäst lämpad |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | En användare på en maskin som rymmer hela modellen |
| LM Studio | 65 GB | En skrivbordsapp på en Mac eller Windows-PC |
| llama.cpp (ggml-org GGUF) | Cirka 63 GB | Mindre än 65 GB VRAM, med expertlager utflyttade till RAM |
| vLLM | Cirka 65 GB safetensors | Servera många användare från en eller flera datacenter-GPU:er |
För en snabb start på en maskin med stort minne:
plaintext1ollama run gpt-oss:120b
För en mindre GPU, använd llama.cpp och justera offload-antalet:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Alla fyra hanterar OpenAIs harmony-chattformat, som modellen behöver för att fungera korrekt. Det spelar bara roll om du skriver din egen serveringskod.
Vanliga frågor
Är GPT-OSS-120B bättre än GPT-5 eller Gemini 3 Pro?
De tillhör olika kategorier: GPT-5 och Gemini är stängda modeller som du når via en app eller ett API, medan gpt-oss-120b körs på din egen hårdvara. Gemini 3 Pro Preview stängdes också ner den 9 mars 2026, och dess namn pekar nu på Gemini 3.1 Pro Preview. Om lokal kontroll spelar roll är Googles serie med öppna vikter Gemma 4-familjen.
Varför säger vissa sidor att GPT-OSS-120B behöver 255 GB?
Dessa siffror antar 16-bitarsvikter: ungefär 117B parametrar gånger 2 byte, plus overhead. Checkpointen som OpenAI publicerar är redan MXFP4, så den realistiska nedladdningen ligger i intervallet 61 GB.
Förändrar resonemangsinsats minnesanvändningen?
Inte för vikterna. Inställningarna låg, medel och hög ändrar hur länge modellen tänker. Hög insats skriver fler resonemangstokens, vilket fyller kontextfönstret och gör KV-cachen större, så långa sessioner närmar sig de större totalerna i diagrammet ovan.
Varför säger folk att GPT-OSS-120B har svårt med textbaserade spel?
Bevisen är anekdotiska. På modellens Hugging Face-diskussionssida rapporterar vissa användare att modellen vägrar när de skriver våldsam fiktion, medan andra säger att rollspel fungerar bra. För interaktiv fiktion: testa dina egna prompter innan du köper hårdvara för det.
Vad kostar en hostad modell i 120B-klassen?
I oktober 2026 kostar Qwen3.5 122B A10B $0.3 per miljon indatatokens och $2.4 per miljon utdatatokens på Atlas Cloud. Det är 25 % rabatt på ordinarie priser på $0.4 och $3.2. Vår dimensioneringsfråga använde omkring 5 000 utdatatokens när resonemanget räknades med, ungefär en cent till det rabatterade priset.
Slutsats
GPT-OSS-120B är lättare att rymma än vad dess parameterantal antyder. Räkna med cirka 65 GB vid vanliga kontextlängder och under 70 GB vid fulla 131K. En 80GB-GPU, en Mac med mer än 96GB eller en 128GB mini-PC rymmer den, och mindre kort kan köra den genom att flytta expertlager till system-RAM.
Om dessa siffror utesluter din maskin, gå ner till gpt-oss-20b för mestadels kodarbete, eller anropa en hostad modell med öppna vikter när du behöver den större hjärnan utan att köpa hårdvara. Hur som helst slutar minneskraven för gpt oss 120b vara en gissningslek när du vet att vikterna tar 61 GB och resten är marginal.


