当你能看到并听到每句台词属于谁时,双人场景才会令人信服。为了让 Gemini Omni 1.2 Flash 多说话人对话 易于理解,请给每个角色固定的视觉与声音身份,按说话顺序编写短台词,并用眼睛和耳朵审查完成后的视频。Google 2026 年 11 月的更新支持更自然的多说话人语音,以及最长 15 秒的片段,但提示词无法保证首次渲染就能干净地分配说话人。先从简单的 2 人交流开始,只有在你能够判断基本交接之后,再添加第三轮对话或街道环境音。
核心要点
- Gemini Omni 1.2 Flash 生成带原生声音的视频,包括对话;它不同于仅音频的 Gemini 文本转语音模型。
- 为每一轮使用具名说话人、精确引用的台词、清晰的位置,以及沉默的倾听者。
- 在 15 秒上限内为停顿留出空间,然后对照片段检查每一句台词。
- 根据所选时长和分辨率计算一次渲染的价格,而不是平台宣传的最低费率。
Gemini Omni 1.2 Flash 中的多说话人对话意味着什么?
该模型会制作一个短场景,其中人物作为生成音频和视频的一部分说话。实际测试是:观众能否在不阅读文字稿的情况下分辨出每句台词是谁说的。词语、声音、可见人物和嘴部动作需要同时一致。一个片段即使静音时看起来有说服力,也可能无法通过该测试。
Google 于 2026 年 11 月 5 日宣布推出 Gemini Omni 1.2 Flash,支持最长 15 秒的生成或编辑视频。它描述了更流畅的对话、更清晰的口型同步,以及更明确的多说话人条件控制。这些是能力声明,并不承诺每个脚本都会完全按所写内容交付(Google 2026 年 11 月公告)。
Google 发布的演示展示了其宣布的能力。它与下面提供的三个视频案例是分开的。
从 Gemini Omni 1.1 Flash 发生了什么变化?
官方对比给 1.2 更长的上限:15 秒而不是 10 秒。它还指出了语音、口型同步、参考遵循和对话式编辑方面的改进。多出的 5 秒使 3 轮交流在脚本上更可行,但如果导演还要求停顿、身体反应和场景变化,更长的时长并不会创造更多说话时间。
最稳妥的理解是方向性的。更好的条件控制可能使对话更容易导演,但每个交付的片段仍需检查。创作者可以用 15 秒上限来设定脚本目标。如果制片人承诺精确的法律文案或精确的声音匹配,应将生成输出视为草稿,直到它通过审查。
视频对话与多说话人文本转语音
Gemini 文本转语音模型接受文本并返回音频。它们的说话人设置和声音选择属于该音频工作流,Google 对此单独记录(Google 的 Gemini 文本转语音文档,访问于 2026 年 11 月)。Gemini Omni 1.2 Flash 的文本转视频路线接受场景提示词,并生成带原生声音的视频。文本转语音的 speech_config 示例不是 Gemini Omni 1.2 Flash 的视频控制。这些示例以文本描述声音特征;它们并不声称上传、克隆或选择录制的声音。如果简报要求特定演员的声音,请在规划镜头前单独核实该访问权限和同意。
如果你的交付物是播客对话或已锁定的旁白,请使用文本转语音,并围绕该音频剪辑画面。如果是两个人在生成场景中可见地说话,请使用 Gemini Omni 1.2 Flash 视频,并在实际输出中测试对齐情况。
你可以在哪里运行它,以及一个片段会花费多少?
选择文本转视频路线
Google 在其创意和开发者产品中列出了 Gemini Omni 1.2 Flash。要进行可复现的测试,请使用一种路线:Atlas Cloud 提供该模型,其 Gemini Omni 1.2 Flash 文本转视频 playground 是粘贴下方提示词的地方。路线 ID 是 google/gemini-omni-1.2-flash/text-to-video。下方提示词仅使用文本,不含图像、运动或声音参考。
这些提示词请求办公室 16:9 的 12 秒、咖啡馆 16:9 的 15 秒,以及街头采访 16:9 的 12 秒。提供的三个文件均为 720p。在按下 Run 之前,确认实时控件和所选值。产品页面上宣传的设置并不能证明某次特定测试运行接受了它。将所选值和报价与每个输出一起保存。这使每次渲染都成为有用证据:在审查输出时,你可以将提示词与所选分辨率和路线进行比较。本指南指定的是文本转视频路线,因此来自图生视频或参考生视频路线的结果应单独标识。
提供的视频文件不包含完成的 playground 截图、所选设置或提交前报价。因此,它们的路线和配置仍未经验证。
| 路线 | 本指南的输入 | 最适合 | 在哪里核实成本 |
|---|---|---|---|
| Google 的创意产品 | 场景提示词;控件因产品而异 | 在 Google 的编辑器中手动创作 | 当前套餐或积分界面 |
| Google API | 开发者视频请求 | 应用集成 | Google 针对确切分辨率的价格 |
| Atlas Cloud 文本转视频 | 提示词、时长、宽高比、分辨率 | 在一个 playground 中重复这些纯文本测试 | 所选配置的提交前报价 |
渲染前检查价格
Google 通过其 API 报价 720p 每生成秒 $0.07,比 Gemini Omni 1.1 Flash 低 30%。按该报价费率,720p 的 12 秒是 $0.84,不含任何其他计费工作。该计算不是针对所提供文件的 Atlas Cloud 报价;它们的路线和计费未经验证。Flow 或其他编辑器中的积分遵循该产品自己的规则。
Atlas Cloud 在其 模型目录 上列出了更低的_起始_每秒费率,但最低价可能对应另一种分辨率或配置。选择时长和分辨率后,请查看实时报价。360p 草稿有助于探索提示词;它是一次单独的生成,而不是后续 1080p 渲染的逐帧预览。
将两个声音放入 15 秒场景
给每个说话人视觉与声音身份
编写审查者可以核实的描述。“说话人 A 在左侧,穿海军蓝衬衫”比“第一个同事”更清晰。添加可听出的区别,例如中音高与更低音。在提示词中保持姓名、服装、位置和声音一致。这些锚点使掉换的台词更容易被发现。
视觉身份很重要,因为仅凭音频可能会欺骗审查者。如果声音不同但错误的嘴在动,片段就有口型同步问题。如果正确的嘴在动,但 A 的声音在 A 的第二轮发生变化,就有声音漂移。咖啡馆示例让 A 在 B 之后回来,以便审查者检查 A 的声音是否保持一致。
为说话和反应预留时间
按预期节奏大声朗读脚本。在每次交接处加入自然停顿,然后为倾听者反应和开场镜头建立两张面孔留出空间。修订后的办公室脚本在 12 秒内有 5 轮。咖啡馆在 15 秒内有 8 个短轮,使其成为这里要求最高的时间测试。这些是示例脚本,不是通用的每秒词数阈值,也不是对输出的承诺。
| 场景预算 | 说话顺序 | 词语之外所需时间 |
|---|---|---|
| 12 秒办公室 | A-B-A-B-A | 建立两个人并容纳 4 次交接 |
| 15 秒咖啡馆 | 八个交替轮次 | 七次交接,几乎没有多余时间 |
| 12 秒街头 | A-B-A-B-A | 在街道环境音中进行四次交接 |
长台词容易在结尾附近被赶完或遗漏。如果草稿朗读几乎占满 15 秒,请在生成前缩短它。如果场景需要更多对话,请规划单独镜头,并将连续性验证作为另一项制作任务。第一次尝试时,在台词期间保持面孔可见。快速剪辑和遮挡的嘴会使说话人分配更难判断。如果台词顺序很重要,请与两个人进行计时桌读。让一个人说 A,另一个人说 B,同时第三个人记录每句话在哪里结束。如果最后一个词落在片段上限,请在渲染前删除一个从句或一个反应节拍。较短的脚本更容易审查,因为审查者可以重放整个交流,而不必猜测某句台词是否本应继续到画面外。
如何为 2 个说话人提示 Gemini Omni 1.2 Flash
有用的提示词读起来像一份紧凑的拍摄简报:场景和摄影机、身份、精确对话,然后是声音和排除规则。这个顺序也为审查者提供了检查清单。这是一种提示方法,不是有文档保证的控制。从身份段落一直到对话块,保持角色标签完全相同。除非映射已经明确,否则在关于后续轮次的指令中,避免将同一个人既称为 A 又称为“顾客”。读者应能画出两栏,每人一栏,并将每个请求的动作和台词准确放入其中一栏。
使用明确的说话人标签和引用台词
每轮使用一行,包含 Speaker A: 或 Speaker B: 以及引用的词语。指定谁保持沉默。要求“关于发布准备情况的讨论”会允许即兴发挥。精确脚本让你可以立即标记缺失或被改写的词。
这是第一个可复制的提示词。它让两个成年人处于一个连续镜头中,以便观众检查每张嘴。
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
提供的 12 秒、720p 办公室渲染。两个人始终可见;五句台词和口型同步仍需要听觉审查。
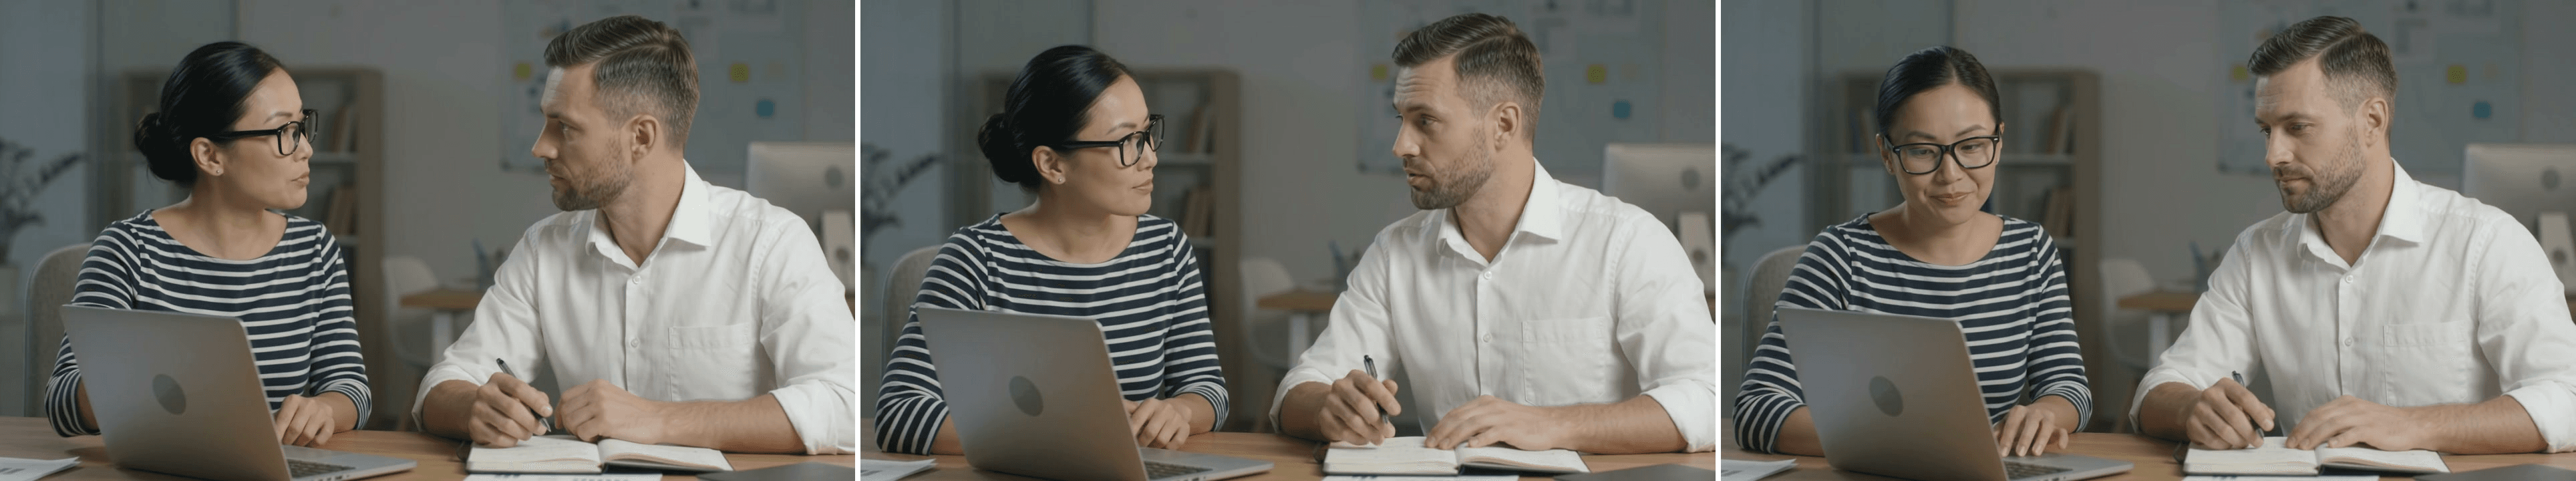 案例 A 帧,从左到右(约 0:02、0:05、0:10):女人面对她的同事;他似乎正在回答,同时两人都留在画面中;他们把注意力转回笔记本电脑和笔记本。
控制摄影机而不丢失说话人
连续中景双人镜头是一种诊断性选择。两张面孔都保持在视野中,因此错过的交接无法隐藏在剪辑背后。模型仍可能改变构图,这就是为什么最终文件需要检查。
一旦交接符合你的目的,尝试一个保留两张面孔的适度运动。街头提示词要求在 16:9 画幅中进行一次运动,同时保持两张面孔可见,使嘴部动作更容易判断。这就是先建立办公室基线的理由。
保持背景音频低于对话
命名环境音及其优先级。安静的房间底噪让办公室片段几乎没有与语音竞争的东西。柔和的咖啡馆声音增加背景,同时让台词仍可测试。街头提示词要求脚步声和远处声音低于两个声音,且没有旁观者说话。
否定指令可能会减少不需要的音频,但它们仍然是请求。注意听是否有第三个声音、旁白、音乐和品牌音频。也要检查画面中是否有字幕和标志。
3 个展示谁在何时说话的对话场景
提供的三个视频文件展示了预期的办公室、咖啡馆和街头场景。这里可以检查它们的视觉内容,但这些文件并未确定是由哪条路线或哪些设置生成的。下面的提示词是可复现的请求,并不声称输出正确说出了每个词。办公室检查 5 轮,咖啡馆测试 8 个快速轮次,街头增加环境声音。
| 案例 | 提示词请求 | 提供的文件 | 主要检查 |
|---|---|---|---|
| A:办公室交接 | 12 秒,16:9,5 轮 | 12 秒,16:9,720p | 五句台词,正确的嘴 |
| B:咖啡馆交流 | 15 秒,16:9,8 轮 | 15 秒,16:9,720p | 八句台词,稳定声音 |
| C:街头采访 | 12 秒,16:9,5 轮 | 12 秒,16:9,720p | 街头可听度和说话人轮次 |
五轮办公室交接
使用上面的完整提示词和视频。两个同事留在同一镜头中,因此五个请求轮次中的每一轮都有一个可见的人可供检查。将每条可听台词与文本对照记录,并检查正在动的嘴。提供的文件建立了场景和时长,但其词语和口型同步尚未经过独立验证。
一个片段中的清晰交接只能支持关于该片段本身的结论,而不是整个模型的成功率。保留第一个结果,以便任何修订都可以与原始结果比较。
八轮咖啡馆交流
请求 16:9 的 15 秒。八个短轮次会让重复的声音归属和时间安排承受压力。比较每个人的第一句和最后一句,然后检查是否有任何台词重叠或消失。提供的文件是 720p。
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
户外问答
请求 16:9 的 12 秒。这增加了轻微的摄影机运动和环绕声。提供的文件是 16:9、720p,可以审查五个说话人轮次和街头可听度。
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
合并播放:0:00–0:15 是案例 B,咖啡馆交流;0:15–0:27 是案例 C,街头采访。两个源片段均完整包含。
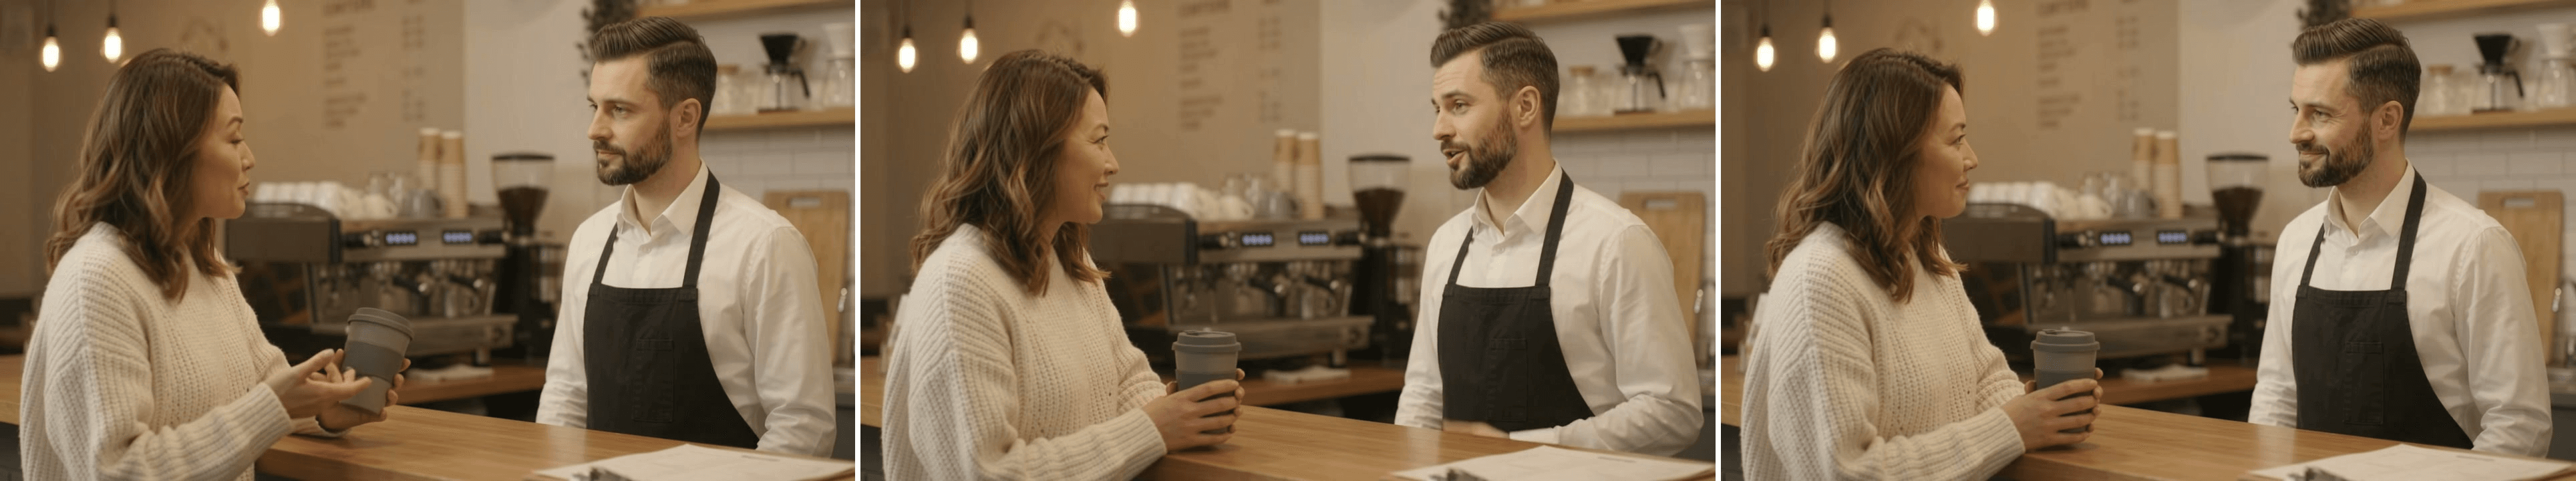 案例 B 帧,从左到右(合并视频约 0:02、0:08、0:13):顾客展示她的杯子;咖啡馆员工似乎在回答;他们在结尾面对面。
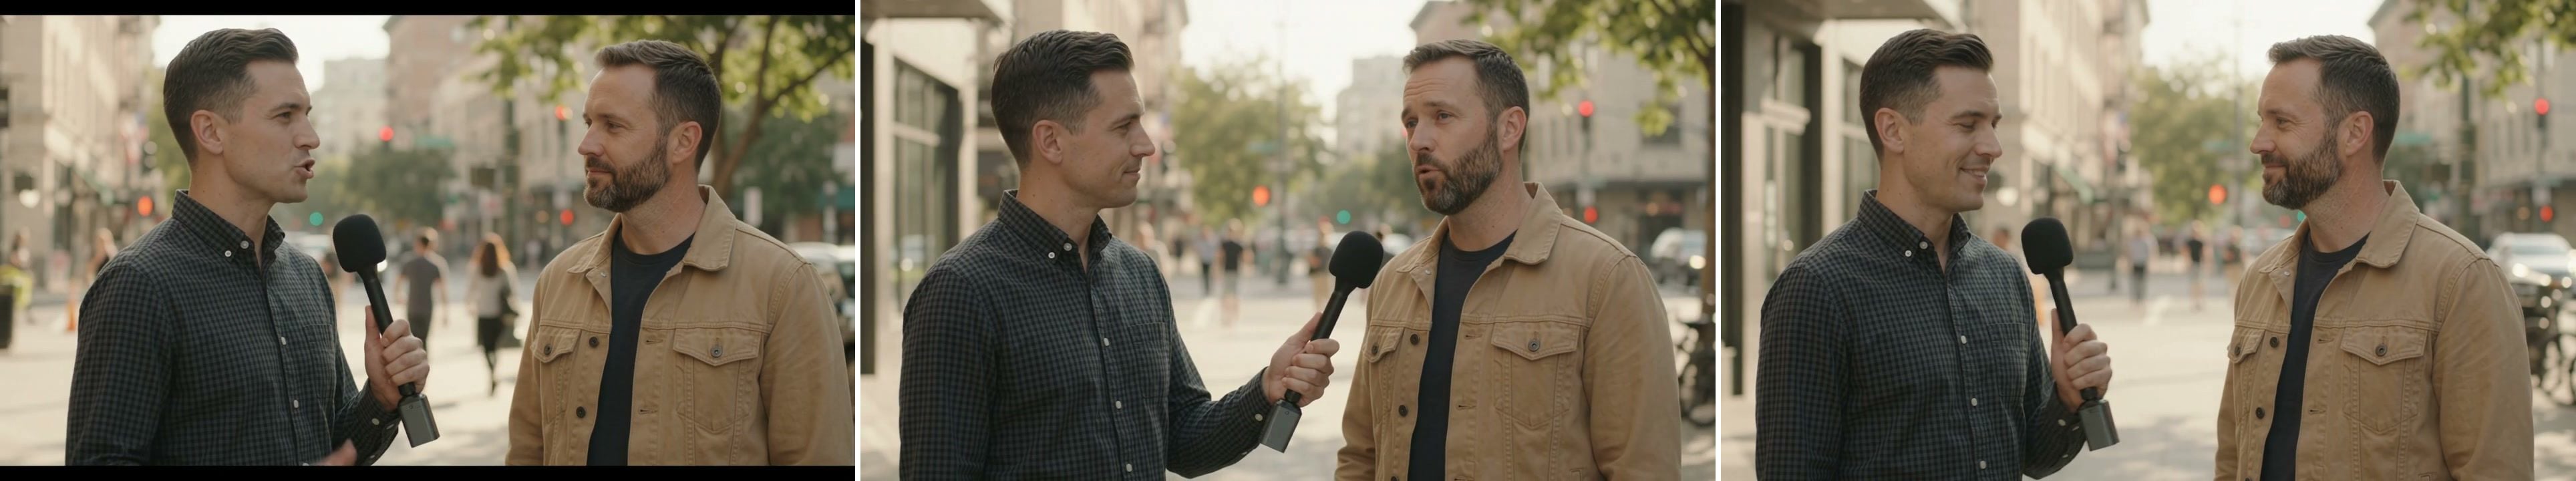
案例 C 帧,从左到右(合并视频约 0:16、0:19、0:26):采访者拿着麦克风;他把它转向受访者;最后两人面对面。
发布前检查说话人顺序、口型同步和声音漂移
逐句审查片段
下载视频。先不看脚本播放一次,以发现明显的混乱,然后在旁边放着提示词重放。在每个轮次暂停,写下你听到的内容。检查两张嘴,并记录脚本轮次之外的说话。为了可重复审查,记录每条可听台词的开始和结束时间、预期说话人、你听到的声音,以及可见的正在动的嘴。如果脸被遮挡或声音掩盖了某个词,写“不明确”。不要因为场景其余部分看起来有说服力,就把不明确的单元格改成通过。未看过提示词的第二位听众可以指出他们认为谁在说话;在决定公众观众是否会理解该场景之前,将该判断与脚本比较。
对每句台词检查 4 件事:
- 词语: 引用的词语是否按顺序说出,没有遗漏结尾或添加句子?
- 声音归属: 具名的人听起来是否像说话人,尤其是当 A 回来时?
- 可见时机: 那个人的嘴是否在动,而倾听者保持沉默?
- 其他内容: 片段是否添加了旁白、旁观者、字幕、标志或音乐?
在音频和嘴部动作逐句审查之前,带时间戳的质量保证时间线仍待完成。
一次只修改一个约束
如果最后一句消失,请缩短脚本,或在 15 秒上限内给它更多时长。如果错误角色说话,请重复视觉位置,并指定倾听者保持沉默。如果环境音盖住某个词,请降低或移除它。如果剪辑遮住了正在动的嘴,请回到连续双人镜头。每次重试只改变一个因素,以便下一个输出回答一个清晰的问题。
这些编辑都不保证能修复。如果一次渲染需要修订,请保存其文件、设置以及你想解决的问题。制片人随后可以决定另一次渲染是否值得成本,或者录制声音和手动编辑是否会提供所需精度。对于简短、可见说话的交流,从办公室提示词开始,并且只有在逐句检查后才接受片段。这就是 Gemini Omni 1.2 Flash 多说话人对话 的标准。
常见问题
Gemini Omni 1.2 Flash 能否在单独片段之间保持相同声音?
一个声音在一个生成片段内保持可识别,比在不同生成之间保持它,是更窄的要求。这些纯文本示例测试的是第一种情况。不要从它们承诺跨片段声音身份。需要一位反复出现说话人的活动应运行单独的连续性测试。
Gemini Omni 1.2 Flash 能否生成英语以外的其他语言对话?
该模型可能生成其他语言,但这些提示词是英语。请与流利的听众逐词审查目标语言,包括姓名、数字和本地化声明。另一位创作者成功的语言测试是该测试的证据,不是对你脚本的保证。
如何让每句台词分配给正确的说话人?
给每个人一个视觉位置和声音,标记每句引用台词,并指定在另一人轮次期间谁保持沉默。逐句审查生成的视频。如果一次渲染不符合简报,请缩短交流,或使用受控音频工作流来实现精确交付。
15 秒的 Gemini Omni 1.2 Flash 片段能容纳多少轮对话?
咖啡馆提示词请求在 15 秒内进行八个简短轮次,而办公室和街头提示词请求在 12 秒内进行五个轮次。这些是脚本示例,不是保证限制。大声朗读台词,为停顿留出余量,如果最后一轮到达片段末尾,就缩短它们。
Gemini Omni 1.2 Flash 的双说话人对话需要参考图像吗?
这三个文本转视频提示词不使用参考图像。它们以文本描述每个说话人的位置、服装和声音。如果项目需要特定面孔或视觉风格,请测试一条接受参考的路线,并单独审查其输出。


