

how i become a millionaire in 30 days 这个片段是一个玩笑,讲的是向聊天机器人询问一条奇迹般的捷径,却得到了最不神奇的答案:“去找份工作。”角色受伤的凝视、疯狂的打字以及第二次尝试才是真正的故事。下面有两个在线示例,展示了同样的设定如何在人类和宠物身上奏效。然后我们用一个原创角色、一个新场景、清晰的对话以及足够长到能击中人心的反应,来构建一个更长的全新版本。
关键要点
- 可识别的顺序是充满希望的问题、直截了当的回复、被冒犯的停顿,以及再试一次。
- 在线的人类和宠物版本改变了表演者,同时保留了笑点的节奏。
- 我们原创的26秒游乐场版本使用儿童表演者,并在剪辑中添加可读的对话,而不是要求视频模型绘制手机界面。
- 将“去找份工作”视为脚本中的点睛之笔,而不是聊天机器人会回答什么或真实财富计划的证据。
在线版本中发生了什么?
第一个在线示例让这个笑话贴近日常的电话对话。一个人满怀信心地举起手机,低头看答案,然后突然失去了那份信心。注意姿势的变化。铺垫是朝着手机说的,但笑点却是朝着观众表演的。反应让这句简短的台词令人难忘。
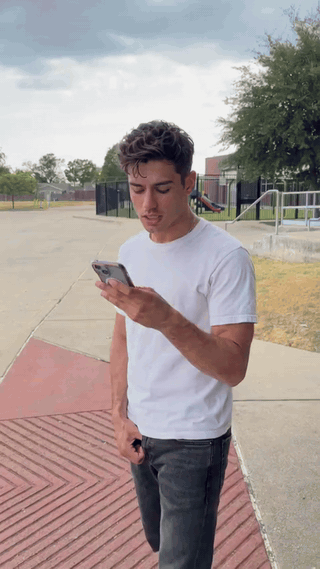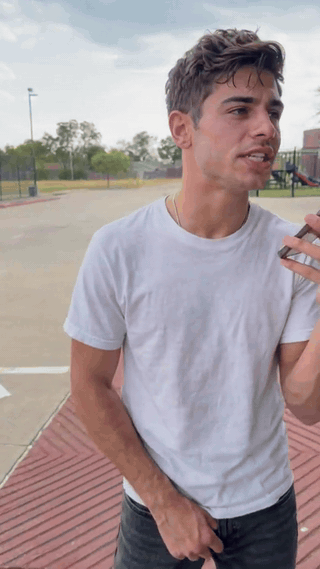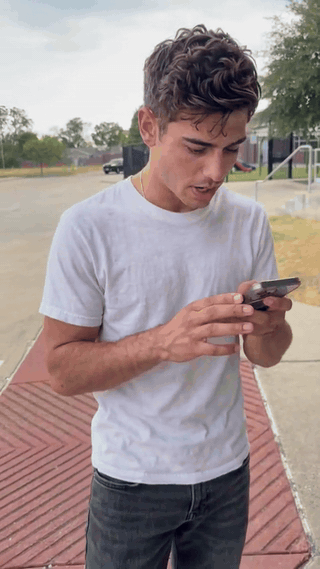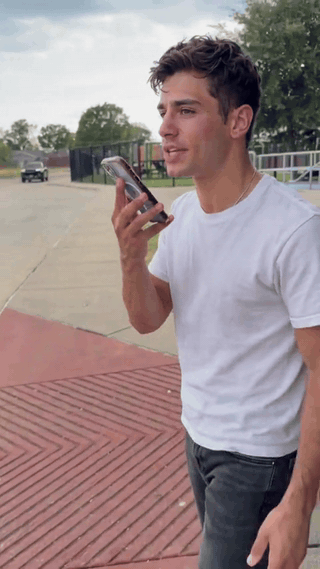
在线示例,人类版本。关键的视觉节拍是从满怀希望的传递到明显的难以置信的转变。
第二个在线示例让宠物扮演同样的角色。它直立的姿势和手机道具在答案到来之前就让这份野心显得荒谬。一个转头和长时间盯着镜头的注视,完成了人类演员会用眉毛和低声抗议来做的工作。这不仅仅是服装的替换:动物的肢体语言改变了笑点的感觉,而问题和回复仍然易于识别。
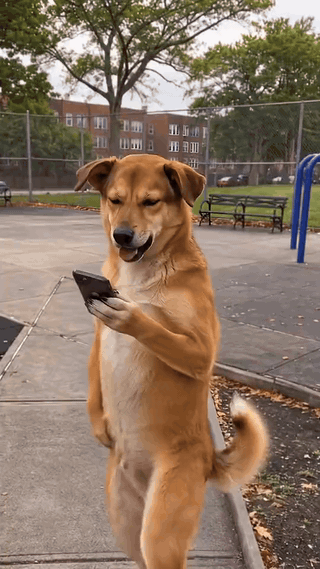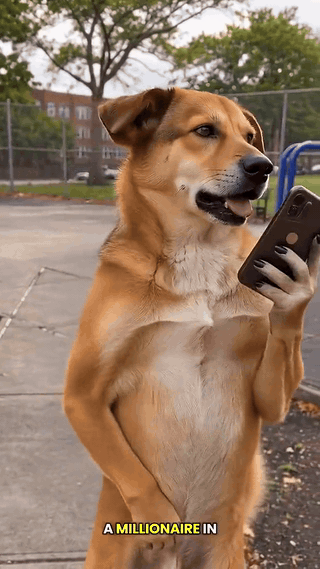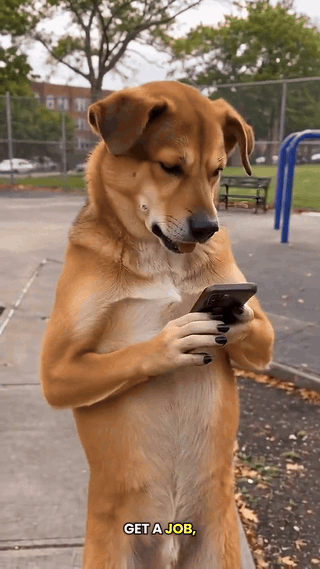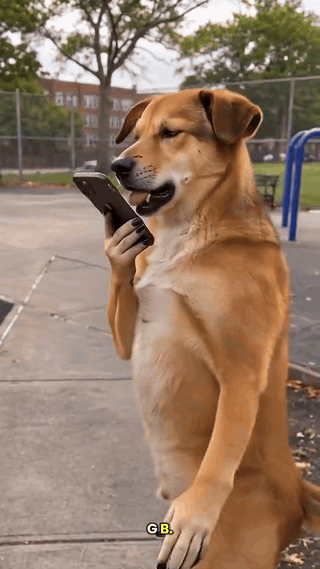
在线示例,宠物版本。表演依赖于直立的姿势、可读的手机手势,以及延迟的被冒犯的表情。
这些是流传的视频格式的示例,而不是确立特定聊天机器人回复的录音。喜剧短剧可以编排这种交流;AI重制可以生成表演者。这里保留了短语“how I become”,因为它是搜索迷因台词的一部分,尽管“how do I become”是普通的英语。这两个短语都不使视频成为财务建议。
让它易于识别的四个节拍
| 节拍 | 观众看到什么 | 为什么重要 |
|---|---|---|
| 提问 | 手机被举起,仿佛它能揭示一个秘密 | 角色的信心设定了一个过高的期望。 |
| 回复 | “去找份工作。”出现或被朗读出来 | 答案故意平淡而简短。 |
| 反应 | 角色僵住、抬头或盯着镜头 | 停顿让观众和角色一起发现这个侮辱。 |
| 再次提问 | 快速打字或另一条语音消息 | 角色拒绝普通的答案,并延长了笑话。 |
顺序比确切的镜头长度更重要。如果回复在观众理解问题之前出现,就没有对比。如果反应被立即剪掉,笑点就没有呼吸的空间。如果角色只是走开,片段就失去了让这种格式独特的固执的第二次尝试。
如何制作你自己的版本?
从笑话的结构开始,然后改变表演、场景和结局。逐镜头重放别人的素材会让结果更难区分,并且让你对对话的控制更少。在我们的演示中,我们把一个虚构的孩子放在阳光明媚的游乐场里。孩子带着灿烂的乐观询问成为百万富翁的捷径,然后遇到了直截了当的“去找份工作。”回复。这个建议对孩子来说故意荒谬;从欣喜到难以置信的转变承载了笑话。手机屏幕面向孩子,所以模型永远不需要发明应用按钮或可读的消息。
有用的设计约束是将表演与文本分开。视频模型可以动画化一个人举起手机、阅读、退缩和打字。它在渲染移动手机上的确切聊天文本方面不太可靠。因此,我们首先生成表演,然后添加干净的编辑字幕。字幕报告笑话的脚本台词;它们不是作为真实ChatGPT会话的截图呈现的。
1. 构建一致的第一帧
使用横向16:9的图像,显示孩子的脸、双手和手机。半身构图留出空间让表情变化,同时不失去孩子身后色彩鲜艳的滑梯和秋千。留出一些整洁的空间用于字幕。第一帧应该看起来充满希望,而不是已经震惊。
在本文中,第一帧是用Seedream v5.0 Pro on Atlas Cloud生成的。提示词故意写得具体:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
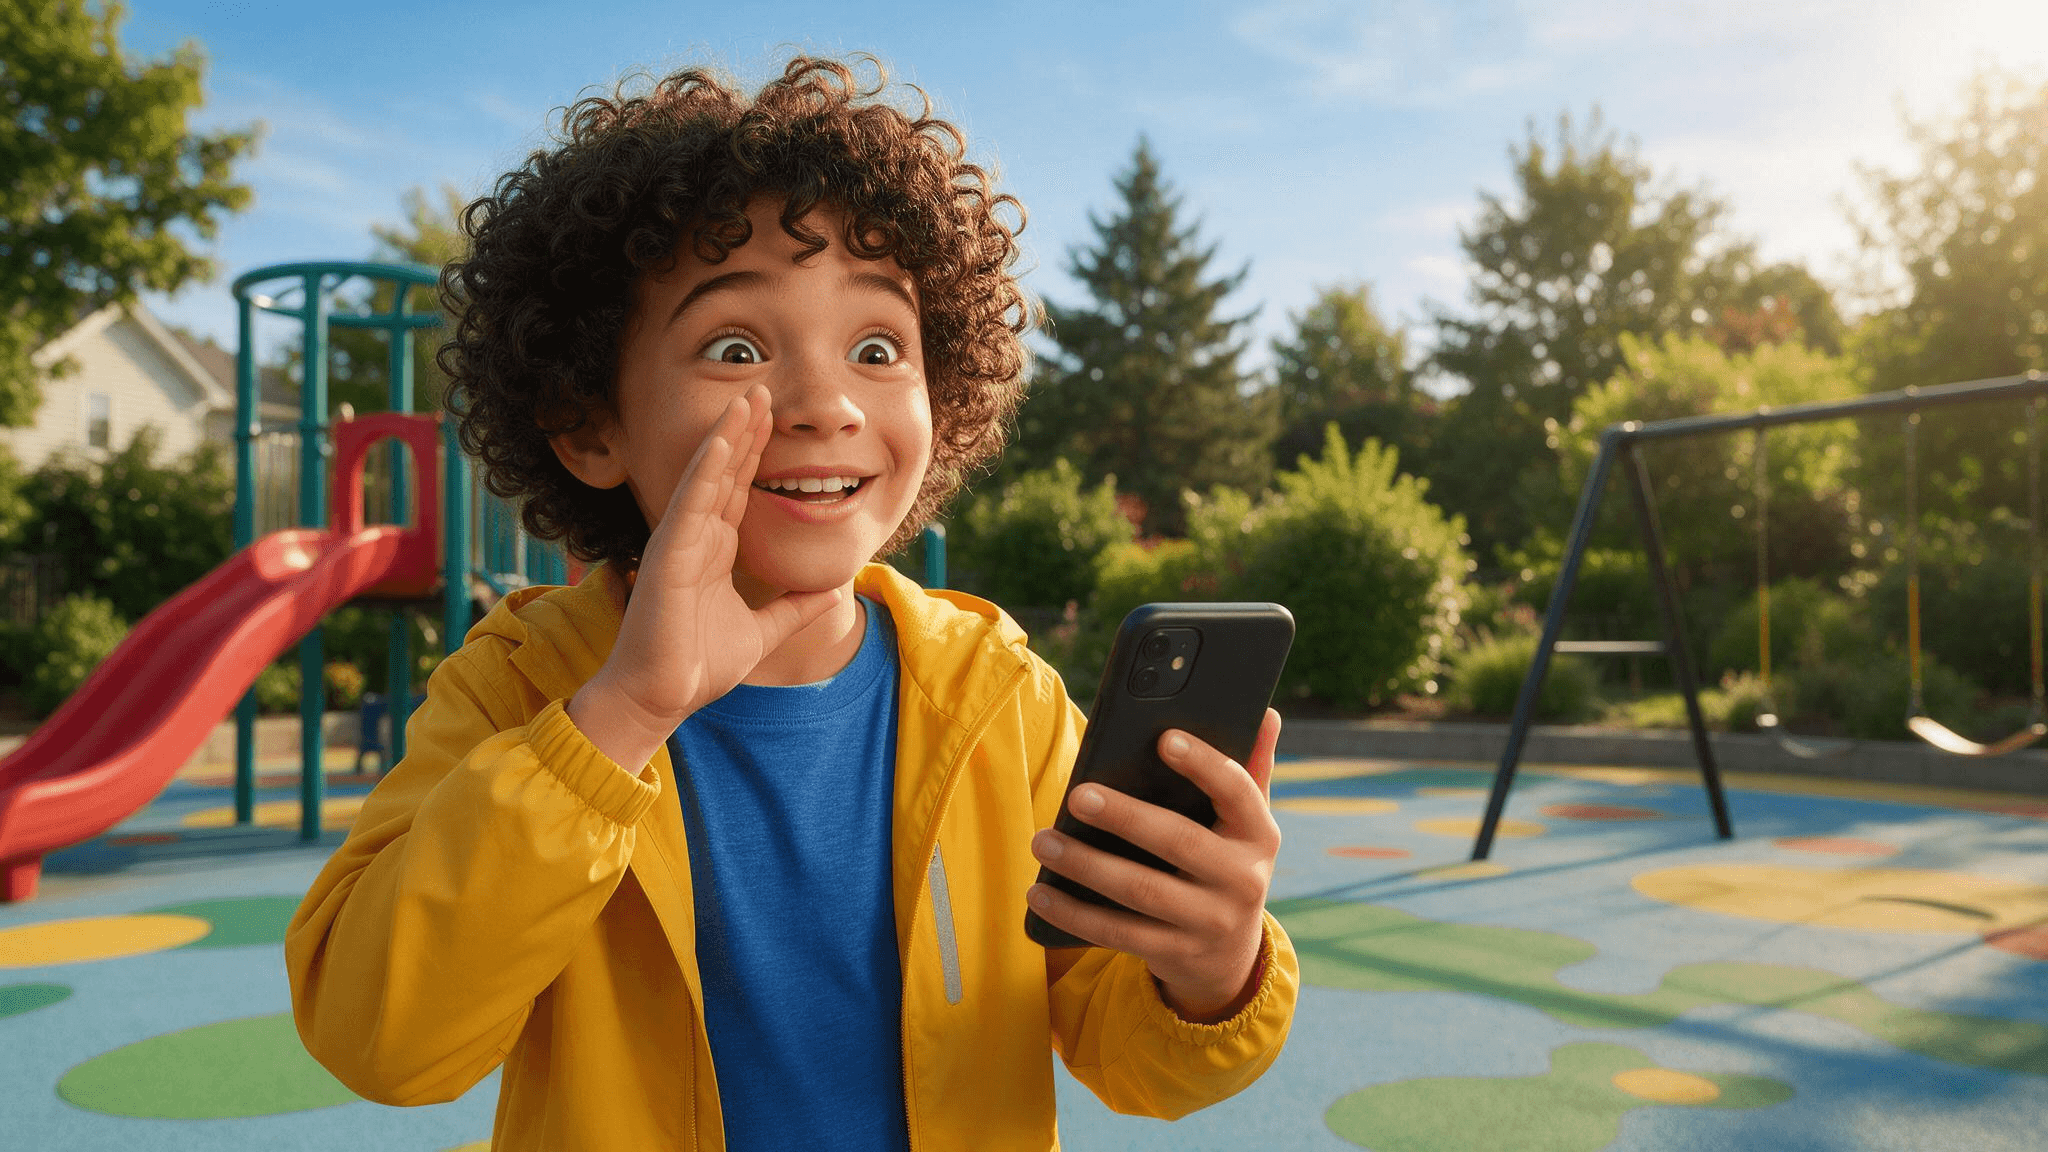
我们生成的起始帧。孩子灿烂的笑容和扬起的眉毛确立了充满希望的开场;滑梯和秋千让新场景一目了然。
2. 动画化一个完整的反应,而不是一个移动的肖像
将第一帧用作Seedance 2.5 Image-to-Video on Atlas Cloud的图像输入。我们将目标设置为26秒,横向16:9,带声音。提示词要求一系列不同的面部反应。它不要求模型显示聊天气泡或拼出笑点,因为那些确切的词语是在剪辑中添加的。
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
交付的片段让情感变化易于跟随:孩子从咧嘴笑开始,对第一个回复惊讶地张开嘴,皱眉,打出另一个问题,最后无奈地耸耸肩。下面的额外静帧分离出平凡答案推翻孩子百万富翁计划的那一刻。
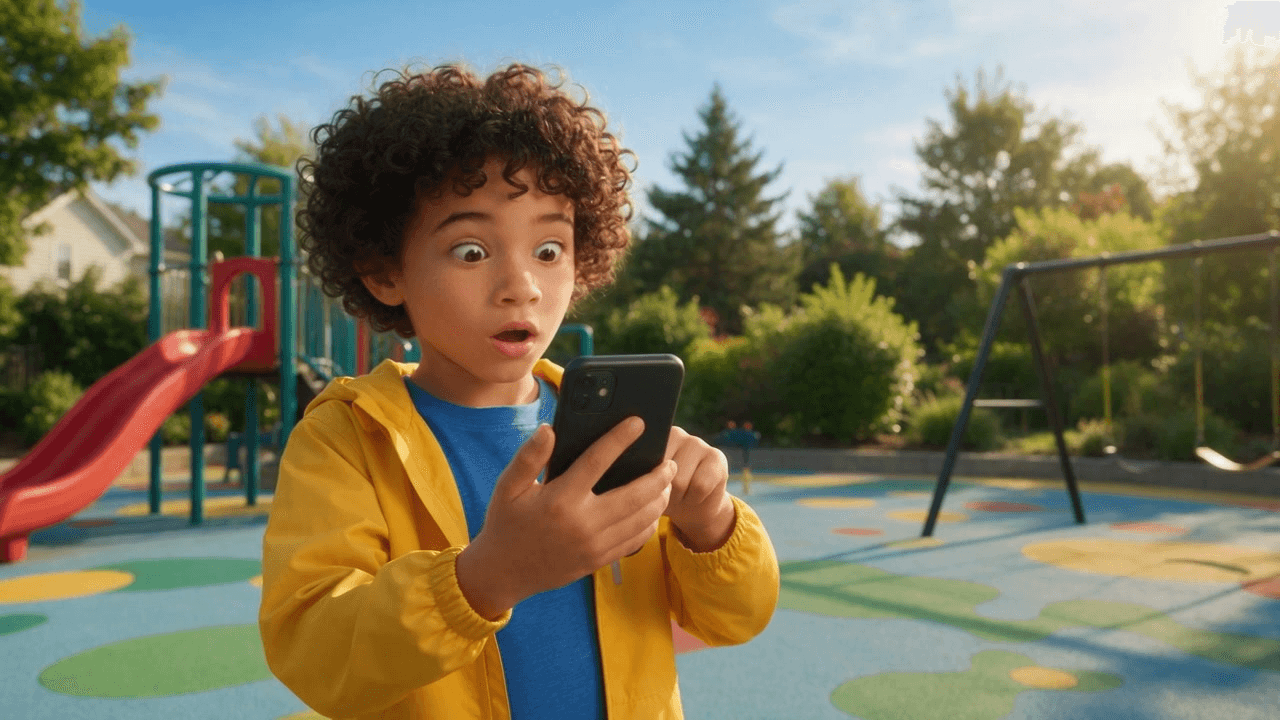
生成视频约6秒处的帧。与充满希望的第一张图像相比,睁大的眼睛和张开的嘴让笑点的效果立即可见。
3. 添加确切的对话,并让笑话在无声时也可读
简短的脚本就足够了。当孩子对着手机说话时,把问题放在屏幕上,只有当孩子阅读回复时才引入“去找份工作。”,并在抗议之前留一个节拍。对于后续,使用一个新问题,而不是逐字重复开场白。字幕应位于一致的安全区域,具有强烈的对比度,并且永远不要覆盖脸部或手部。
| 在我们26秒剪辑中的时刻 | 编辑字幕 | 表演提示 |
|---|---|---|
| 开场 | “我如何在30天内成为百万富翁?” | 明亮、确定地对着手机说。 |
| 回复 | “去找份工作。” | 眼睛垂到屏幕;笑容消失。 |
| 反应 | “说真的?” | 惊讶在打字前让位于皱眉。 |
| 第二次尝试 | “好吧,但如果我跳过那部分呢?” | 手机再次举起;语气变得恳求。 |
保持文字简短到可以一眼读完。不要伪造一个逼真的聊天截图来证明这句话是由应用生成的。一个设计清晰的字幕诚实地传达了脚本中的交流,并让16:9的片段在静音时也能理解。原始音频保留在视频中;显示的四行是编辑字幕。
4. 导出、检查并标注
导出一个连续的MP4,而不是将源片段剪成几个文章嵌入。导出后检查其实际时长。请求的26秒只有在文件确实长于20秒并且额外时间包含有意义的动作时才重要。在本文中,最终的原创示例嵌入在下面,带有海报帧,以便读者可以看到完整的序列。
我们的原创示例:一个孩子在游乐场里提问,收到直截了当的回复,难以置信地盯着看,打字,并在一个26秒的横向视频中再次尝试。字幕是对生成的表演的编辑添加。
在发布AI生成的逼真场景之前,在适用的情况下使用平台的AI内容标签。TikTok的AI生成内容指南解释了其标签工具和对逼真AI媒体的要求。YouTube的更改或合成内容指南描述了上传时的披露。使用你自己的肖像、虚构角色或同意出镜的参与者。上面的两个在线GIF是用于分析的示例;发布重制版需要你自己的素材、声音和许可。
是什么让笑点在更长的剪辑中击中人心?
26秒的版本需要的不仅仅是两个13秒迷因的复制品。我们给孩子一个明显的策略变化。起初,手机被当作捷径机器。收到回复后,孩子不只是重复要求:他们皱眉、打字、重新表述,并试图与答案谈判。这种转变将最后一个节拍变成了一个新的笑话,而不是填充。
静音可读性也改变了剪辑。在信息流中,观众可能会在静音状态下遇到这个片段。字幕需要在正确的时刻揭示问题和回复,而演员的动作提供情感。延迟的“说真的?”字幕不应该出现在第一个震惊的帧期间;无声的注视先出现。那个微小的停顿是观众读取面部表情的地方。
最后,保持设定真实。视频是一个编排的喜剧场景,台词是脚本中的笑料。它不展示真实的聊天机器人会话,也不承诺任何人都能在30天内致富。下一个有用的行动是选择一个原创的表演者和场景,为四个节拍绘制故事板,并测试是否有人能在关闭声音的情况下理解你的草稿。如果他们能识别出问题和被冒犯的第二次尝试,这个格式就奏效了。
常见问题
聊天机器人真的回答了“去找份工作”吗?
这个短语是喜剧格式中的笑点。展示它的视频并不是真实聊天机器人交流或你将总是收到的回复的证据。
我可以用宠物或朋友制作这个迷因吗?
是的,如果你有一张合适的照片以及任何出镜者的许可。宠物版本需要清晰的眼睛、口鼻和皮毛标记。朋友版本需要清晰的脸部以及他们同意被描绘成说这些台词。
为什么使用视频模型然后单独添加字幕?
模型处理运动和表演;编辑器处理确切的文本。将这两项工作分开可以避免手机屏幕乱码,并让你控制笑点的时机。
这里的原创示例超过20秒吗?
是的。交付的MP4在导出后经过验证,而不是仅仅依赖生成器中选择的时长。额外的时间用于第二次尝试和最终反应。





