使用MiniMax H3就像写一个简短的项目简报,而不是单个图像提示。这个可复用的结构很简单:绑定所有参考素材,陈述核心想法,然后将场景写成一个带有时间线的视听序列,包含摄像机运动、对话、环境音、音乐和约束条件,各自分块。
本指南将45个官方MiniMax H3示例逆向拆解成一个六部分提示公式,展示end_image的归属,说明原生音频提示如何改变结果,并给出一个生成片段中文字乱码的实用修复方法。
你已经知道如何为视频模型写提示。“电影级灯光,慢推,4K。”这套词汇你用了两年。
然后你把它粘贴到MiniMax H3里,得到一个自带音轨的2K片段。画面看起来很棒。节奏是糊的。你的标题里有两个字母拼错了。音频是模型替你选的一些环境音。
问题不在模型。你给了一个句子。它想要一份时间表。
所以我读完了MiniMax随H3发布的所有45个示例提示,连同它们附带的成品片段,并把帧拆开来看。官方提示不是描述。好的提示是一份附带了音乐提示表的拍摄清单。下面介绍结构、当前实际暴露的参数,以及一个你大约二十分钟就能复现的演示。
关键要点
- H3提示是时间线,不是描述。最强的官方示例直接用[0s-2s]、[2s-4s]标记把片段切分,成片做到了每一个节拍。
- 声音和画面出自同一轮生成,所以音频必须存在于提示正文中。官方提示给它一个单独的块,精确到“6秒时爵士贝斯律动进入”。
- 你拼写出来的文字回来是干净的。你没拼写出来的文字回来是字母形状的噪声。 我有一份官方片段中同时证明这两点的帧截图。
- 图生视频接受end_image。给它一个首帧和一个尾帧,在你花费任何算力之前,情感弧线就已经固定了。
- 提示长度不是优点。有参考图像做描述时,短的官方提示也能工作。长度反映了你拒绝交给参考图像完成的工作量。
两侧是同一幅画。左侧是KC Green的原始单格,未修改。右侧是一次图生视频调用:输入首帧,输入尾帧,十秒输出,火焰噼啪声和平淡的“this is fine”是模型自己的音轨。没有人配乐。本指南中的一切目标就是让你达到那个后半部分。
MiniMax H3提示实际上长什么样(我读了全部45个)
目前搜索首页上的每一个“MiniMax H3提示指南”都是一份规格表:2K,24fps,5到15秒,原生音频。那是模型卡片。不是提示。
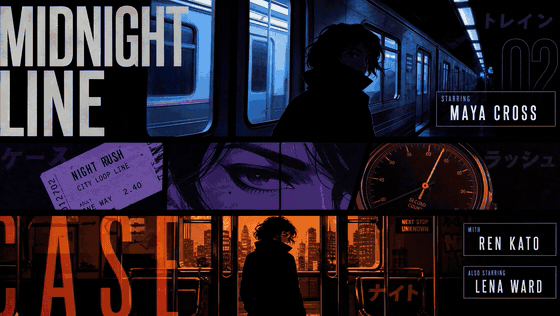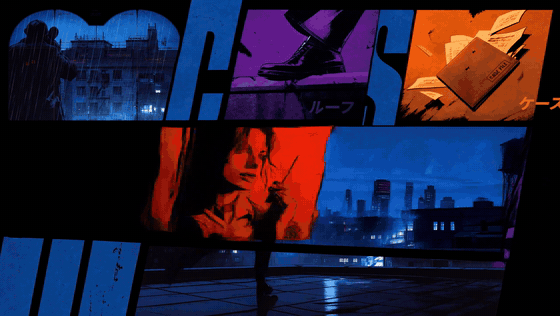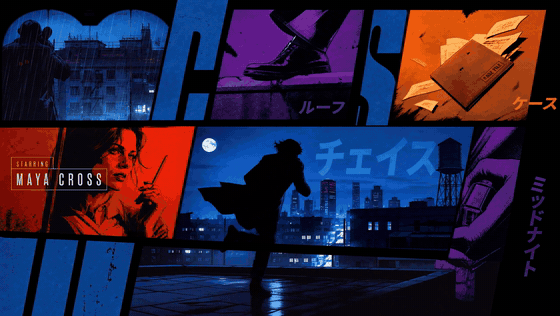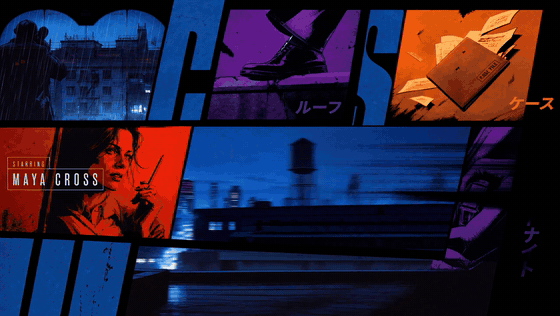
下面是一个真实的。这是MiniMax黑色电影标题序列官方提示的一部分,从中文原文翻译而来,大约是其完整长度的三分之一:
生成一段15秒16:9的轻悬疑犯罪片标题序列。整体风格参考这些图像的视觉语言:复古日式动画标题卡、硬边剪影、漫画拼贴、不对称分屏、强烈的几何色块、英文演职员表、少量日文片假名装饰、爵士犯罪感。情绪60%悬疑,40%爵士:神秘、酷、灵巧、都市犯罪,不要恐怖,不要沉重,不要变成欢快的爵士MV。
[……] 英文演职员表必须清晰可辨 [……] 不要添加中文,不要产生乱码,不要拼错英文。整条规则:每个英文演职员表和职位名称只出现一次。不要重复职位名称,不要重复姓名,不要给一个人多个头衔。
转场必须多样:圆形黑胶唱片遮罩、垂直车门划像、人物长影扫过画面、红线切、巨型英文遮罩、分屏画面重组、硬色块切、面板逐块粘贴。所有转场落在鼓点节拍上:清脆、悬疑、灵巧、漫画拼贴。不要软溶解,不要流畅转场。
BGM:原创15秒标题音乐,60%悬疑,40%爵士。由持续低音、紧张拨弦、冷合成器脉冲、底鼓、稀疏爵士刷子、行走贝斯片段、短小男中音萨克斯乐句和简短铜管刺音构成。前2秒用低频和踩镲建立悬疑,3秒时低鼓进入,6秒时爵士贝斯律动加入,10秒时出现短萨克斯/铜管乐句,最后2秒用紧张和弦与鼓点击收尾。
看看文字都用在了哪里。几乎没有用在“美丽”或“电影感”上。它们用在了负面列表、转场列表和逐秒音乐提示表上。这就是这份工作的形态。
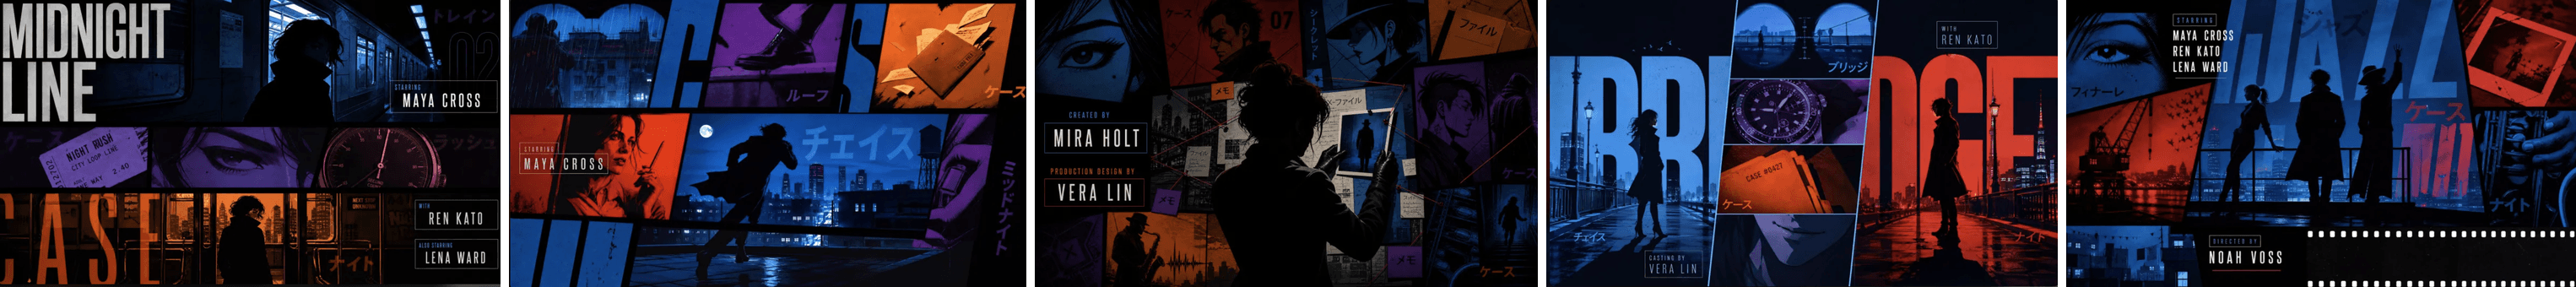 MiniMax H3官方黑色电影标题序列:MIDNIGHT LINE,带有清晰的STARRING演职员表
看看那个片段中的演职员表。MIDNIGHT LINE, STARRING, MAYA CROSS, REN KATO, LENA WARD, DIRECTED BY NOAH VOSS。拼写正确,没有职位名称使用两次,片假名装饰放在要求的位置。提示没有说“做漂亮的标题”。它说了不能重复、不能拼错、不能有中文,并以五种不同方式命名了美学风格。
 随黑色电影标题提示一起交给MiniMax H3的五张风格参考板
那五张板和文字一起输入。五张图加一个长简报,一次生成。这就是现在这份工作的样子。
而45个提示中有那么多都很短的原因就在那张图里。在整个集合中,中位提示约为130个中文字符,但最长的两个分别有657和858个字符。短的提示之所以短,是因为参考板承担了描述工作。长的提示之所以长,是因为没有别的办法来承担。
为什么大多数MiniMax H3提示效果平淡,以及乱码文字修复
有三件事会出错,它们都是缺失,而不是错误。
没有时间线。 你要求十秒却只描述了一个瞬间,所以你得到的是一个慢推镜头拉长到十秒。模型在第七秒无事可做。
没有音频块。 声音与画面在同一轮生成。如果你什么也不说,模型仍然会给你一个音轨。它只是随便选一个。
没有负面列表。 不干预的话,模型会倾向于软溶解,凭空创造额外的屏幕文字,并添加没人要的字幕条。
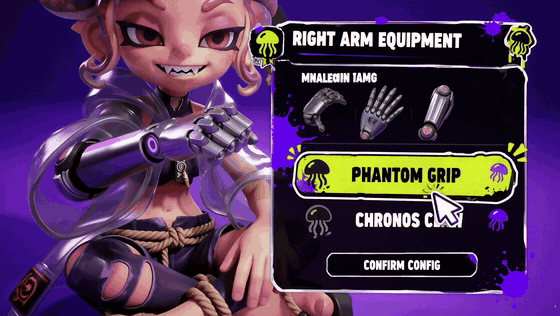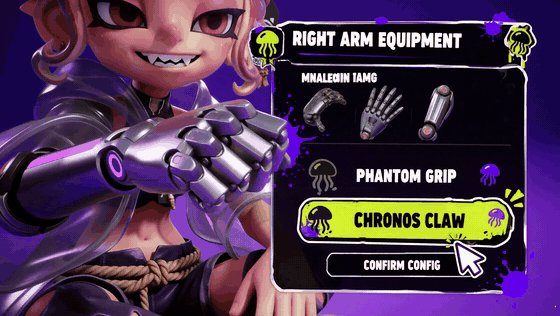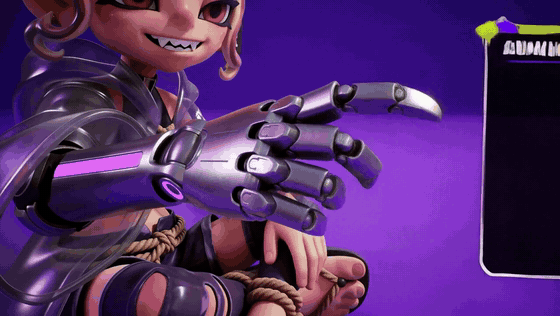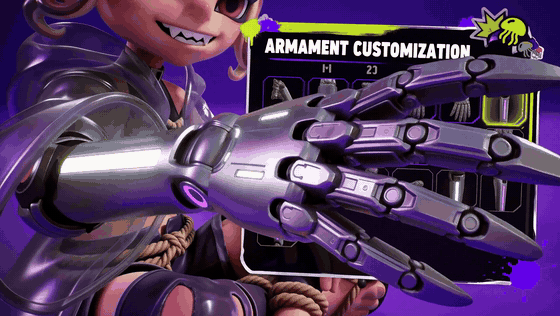
最清晰的证据是官方游戏UI提示,它由六个时间戳节拍构成:[0s-2s] 菜单,[2s-4s] 右臂面板,[4s-7s] 武器网格,[7s-8.5s] 确认,[8.5s-10s] 加载条,[10s-15s] 世界加载完成。成品片段按顺序准时击中了所有六个节拍。
 MiniMax H3游戏UI片段:菜单、装备面板、加载条、世界加载
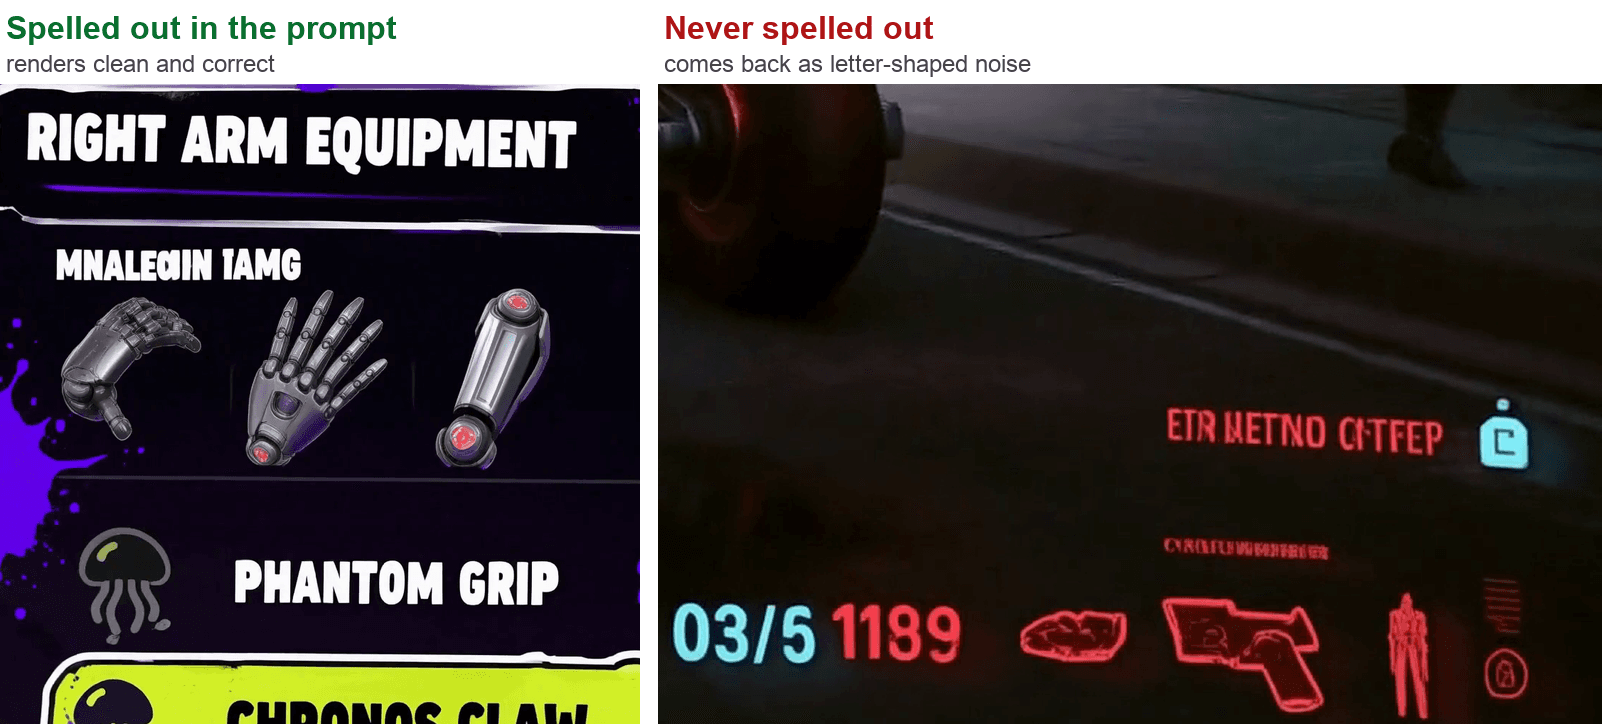
现在诚实的一面,来自同一个片段,全分辨率为2560x1440。
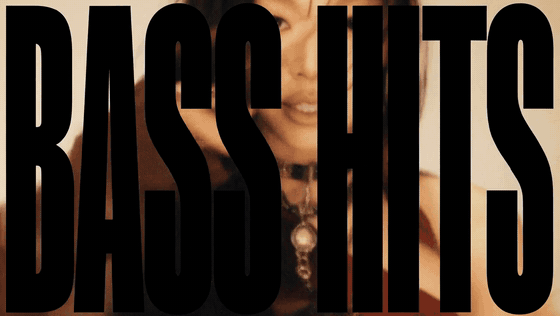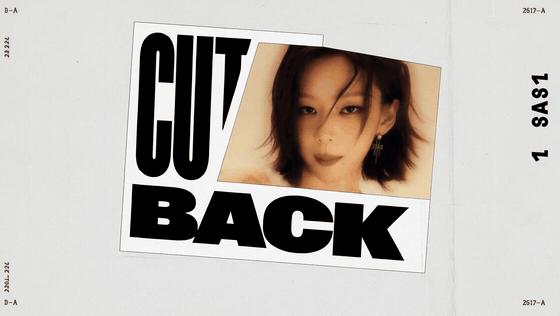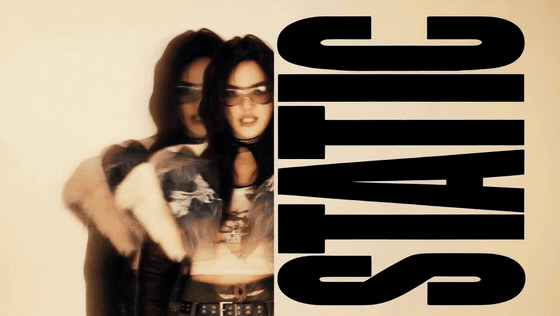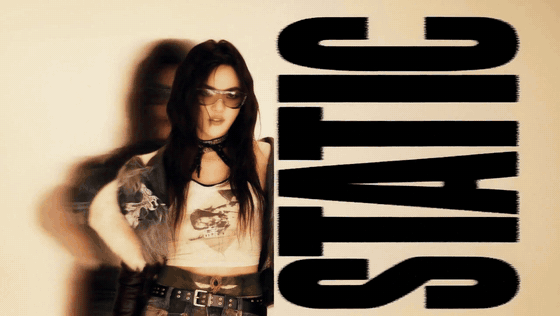 左:提示中拼写出来的文字渲染清晰。右:未拼写的文字渲染为字母形状噪声
左侧,提示实际打出的每一个字符串:RIGHT ARM EQUIPMENT, PHANTOM GRIP, CHRONOS CLAW。清晰、正确、字距像真正的游戏菜单。
右侧,最终街道镜头中的HUD,提示只称之为“HUD元素”。它显示为ETR METNO CITFEP。在装备图标上方,提示什么都没说的地方,你得到的是MNALEαIN IAMG。这不是渲染错误。模型在绘制英文的纹理,因为它从未被给予字符串。
所以修复方法不是设置。而是习惯:
如果一个词需要可读,就把这个词打出来。 然后加上一行负面指令:不要拼错,不要添加其他文字,不要添加字幕。
以下是每个强官方提示最终共享的六块结构。
| 块 | 内容 | 官方提示示例 | 跳过它你会得到 |
|---|---|---|---|
| 1. 风格约定 | 媒介、纹理、色调、时代、不能丢失的外观 | “复古日式动画标题卡、硬边剪影、漫画拼贴、强烈几何色块” | 第六秒就开始漂移的通用光泽渲染 |
| 2. 时间线 | 字面时间切片,每个切片内有一个动作 | [2s-4s] 平滑缩放到她的右臂。UI面板从右侧滑入 | 一个想法拉伸到整个时长 |
| 3. 摄像机 | 运动,或明确拒绝运动 | “锁定机位,静态全景,不要推,不要切” | 你没要求的默认慢推 |
| 4. 音频 | 每种声音及其进入时间 | “6秒时爵士贝斯律动加入,最后2秒用紧张和弦锁住” | 模型今天喜欢的任何环境音 |
| 5. 文字,拼写出来 | 字面字符串,用引号 | “THIS IS FINE.” / CONFIRM CONFIG | 字母形状噪声,如上文 |
| 6. 负面列表 | 要拒绝的转场、物体和陈词滥调 | “不要软溶解,不要流畅转场,不要添加中文,不要重复职位名称” | 软溶解、凭空文字、不自然的漂移 |
第5块和第6块是免费的。它们不额外产生任何生成成本,而且大部分质量都存在于这里。
MiniMax H3提示工作流程:你的提示属于哪个端点
同样的键,同样的提交-轮询形态,三个入口。你选择哪个入口决定了你的提示还需要做什么。
| 端点 | 你提供什么 | 它为你锁定什么 | 值得知道的参数 | 什么时候使用 | 计费 |
|---|---|---|---|---|---|
| minimax/h3/text-to-video | 仅提示 | 没有。文字承担一切 | duration 5-10(默认8),分辨率2K,比例必须显式设置 | 在投入之前测试外观或声音设计 | 按输出每秒计费,当前费率在模型页面 |
| minimax/h3/image-to-video | 提示 + 图像(首帧),可选end_image | 片段从哪里开始,以及可选地在哪里结束 | end_image, duration 5-10(默认8),比例默认自适应 | 你有美术作品,希望它动起来而不被重绘 | 按输出每秒计费 |
| minimax/h3/reference-to-video | 提示 + refers[] | 主体身份和风格,跨越你创作的场景 | refers[] 混合数组,duration 5-15,比例最高21:9 | 相同角色或产品,新环境 | 按输出每秒计费 |
refers[] 是目前在外部真正缺乏文档的那一个,所以这里是它想要的格式:
json1"refers": [ 2 { "url": "https://.../subject.png", "type": "image" }, 3 { "url": "https://.../style-board.png" }, 4 { "url": "https://.../motion-ref.mp4", "type": "video" }, 5 { "url": "https://.../beat.mp3", "type": "audio" } 6]
四个规则,每个都能节省你一次浪费的生成:
- 音频不能单独存在。 数组中必须至少有一个图像或视频。单独的节拍轨会被拒绝。
- type 是可选的。 从URL推断,但当扩展名有歧义时仍要指明。
- 上限是真实的。 最多9个图像,3个视频和3个音频片段,共12个文件,参考视频和音频各2到15秒(MiniMax API文档,2026年7月)。
- 在提示正文中给每个参考分配一个任务。 这是这个列表中最具杠杆作用的习惯。官方提示开头写着“图像1是整体情绪和风格参考,图像2是主角参考”。没有这句话,模型必须猜测哪个板子是什么意思。
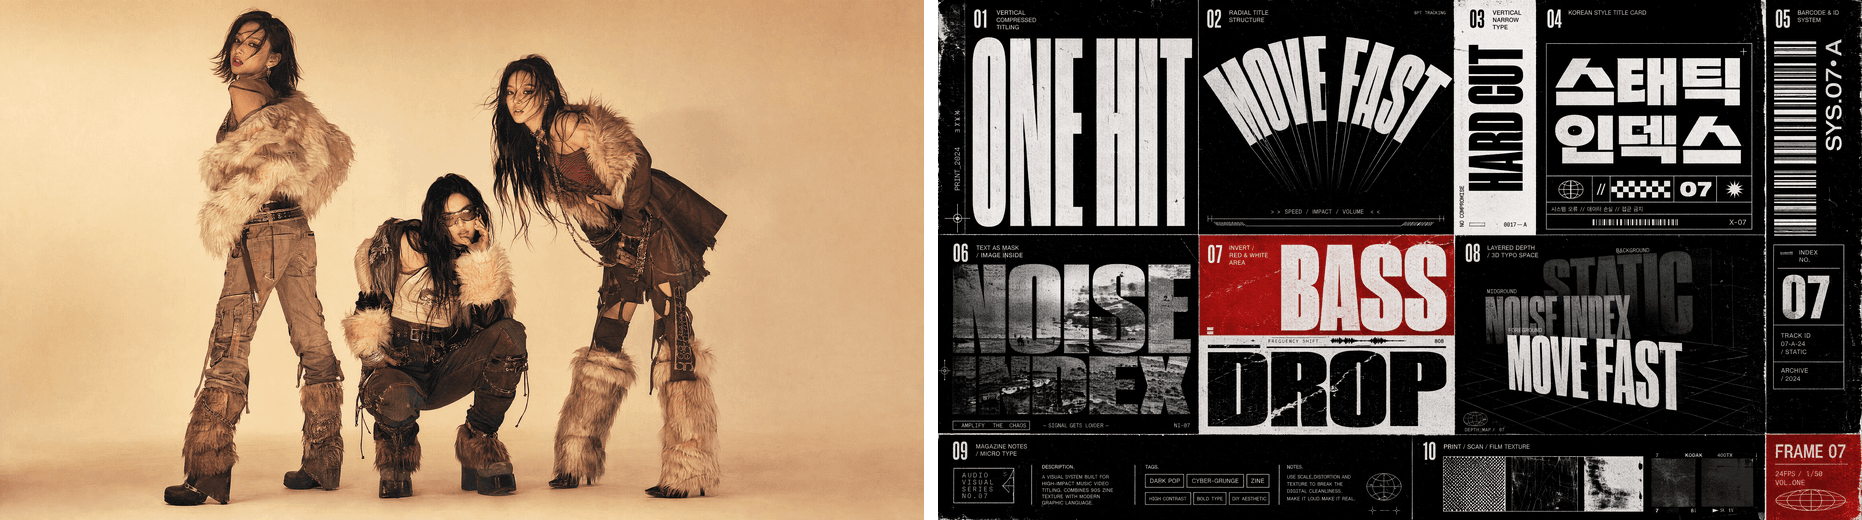 MiniMax H3暗黑流行音乐视频:CUT BACK, ONE LOOK, DETONATE 排版
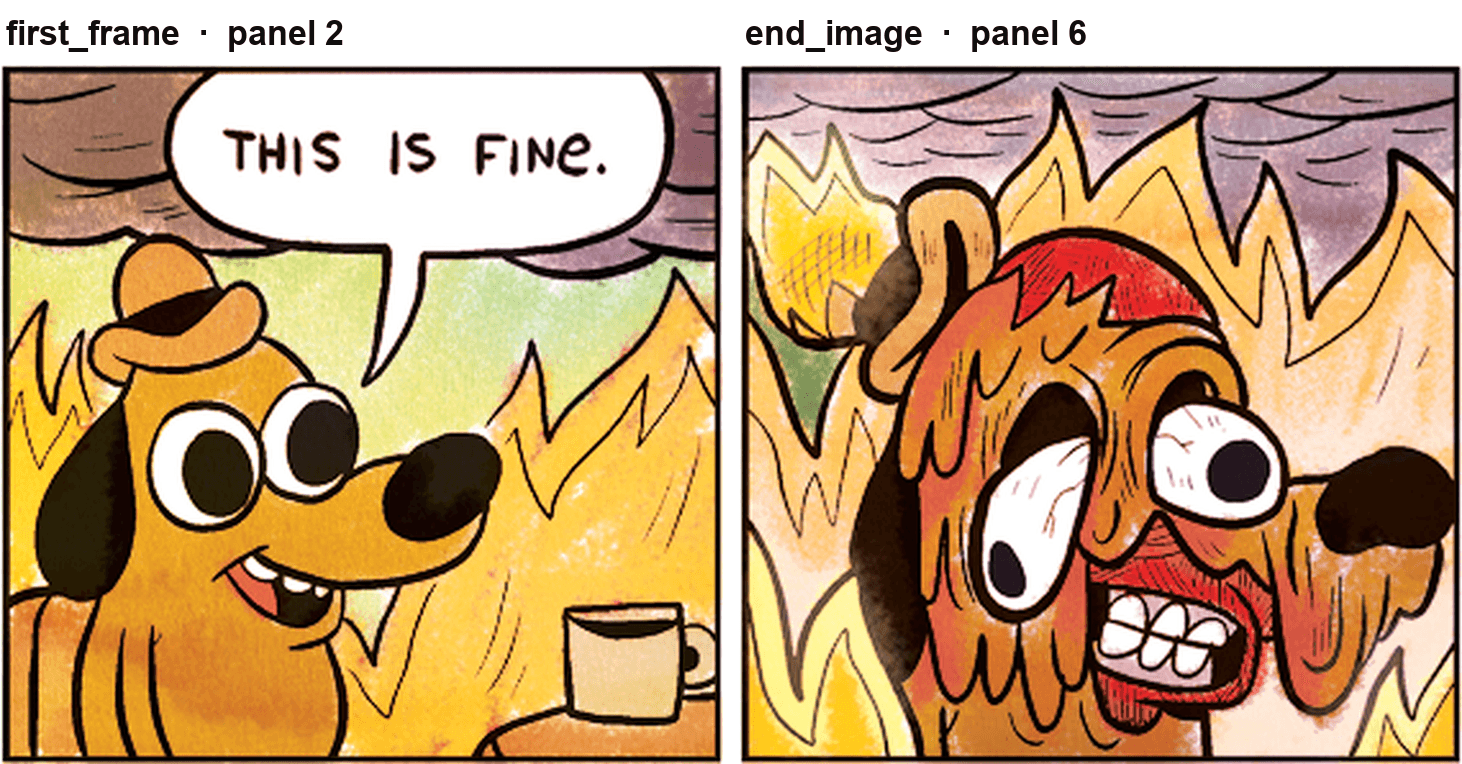 暗黑流行片段背后的两个排版参考板
那个片段是规则4的论据。它的提示从未描述任何一个字母形状。它说“文字包装风格和纹理参考这些图像”,然后交出了两块板子。布局之所以出现,是因为它被展示出来,而不是被描述出来。
还有一张表,因为模型卡片和API目前说的不是同一件事,而这个差距是人们会浪费一个下午的地方。
| 项目 | MiniMax自己的文档 | 端点目前实际接受的内容 | 对你的提示意味着什么 |
|---|---|---|---|
| 时长 | 4到15秒,仅整数 | text-to-video和image-to-video:5到10,默认8。reference-to-video:5到15,默认8 | 15秒的拍摄清单目前只适合reference-to-video。将较长的板子重写为10秒 |
| 分辨率 | 2K | 分辨率默认为2K,目前2K是唯一运行的值。768p作业会返回MiniMax-H3不支持分辨率768P,支持的分辨率:2K,尽管定价表中出现了768p | 为1440px短边编写。你要求的细节会实际存活 |
| 宽高比 | 常见比例或自适应 | image-to-video和reference-to-video默认自适应。纯文本拒绝自适应并返回其允许的集合:16:9、4:3、1:1、3:4、9:16、21:9 | 在text-to-video上,显式设置比例,否则作业会验证失败 |
| 混合参考 | 9个图像,3个视频,3个音频,12个文件,音频不能单独 | refers[] 接受{url, type},包含图像、视频或音频,至少一个图像或视频 | 你真的可以将运动同步到提供的节拍。只是不能只提供节拍。 |
| 原生音频 | 同一轮生成中的立体声音频 | 我探测的九个官方片段每一个:2560x1440,24fps,AAC立体声,32kHz | 音频块不是装饰。它是交付物的一半 |
以上所有内容都在Atlas Cloud上运行,那里所有三个H3端点都位于同一个键和同一个提交-轮询循环后面,所以在它们之间切换只是改变模型字符串,没有其他区别。
MiniMax H3提示教程:把“This Is Fine”的狗点燃,带声音
下面是完整的端到端过程。这个梗之所以有效,是因为狗什么也没做。把这种拒绝状态拉伸到十秒的真实时间,加上真实的火焰,让最后两秒去往原始漫画实际去的地方,这会让它变得更有趣,同时也对你来说稍微更糟糕。大多数人只见过前两个画格。
步骤1:下载原始漫画。不要让AI重绘它。
这条漫画是六格,两列三行,600x887。我们只需要画格2和画格6。
bash1curl -L -o gunshow-648.png https://gunshowcomic.com/comics/20130109.png 2# 600x887, 6格, 2列 x 3行 3 4# 裁剪画格2(“THIS IS FINE.”画格): x 302-584, y 20-293 5# 裁剪画格6(融化的狗): x 302-584, y 595-868 6# 每个用Lanczos 4x放大 -> 1128x1092
直说:不要要求图像模型绘制“看起来像This Is Fine的狗”。 AI重绘会在半秒内被识破为假货,梗就死了。水彩渲染、摇晃的手写字体和纸张纹理是整个契约。4x Lanczos放大只是为了让282像素的源图不至于太薄;它给模型提供了真实的像素来抓住,而不会凭空创造任何东西。
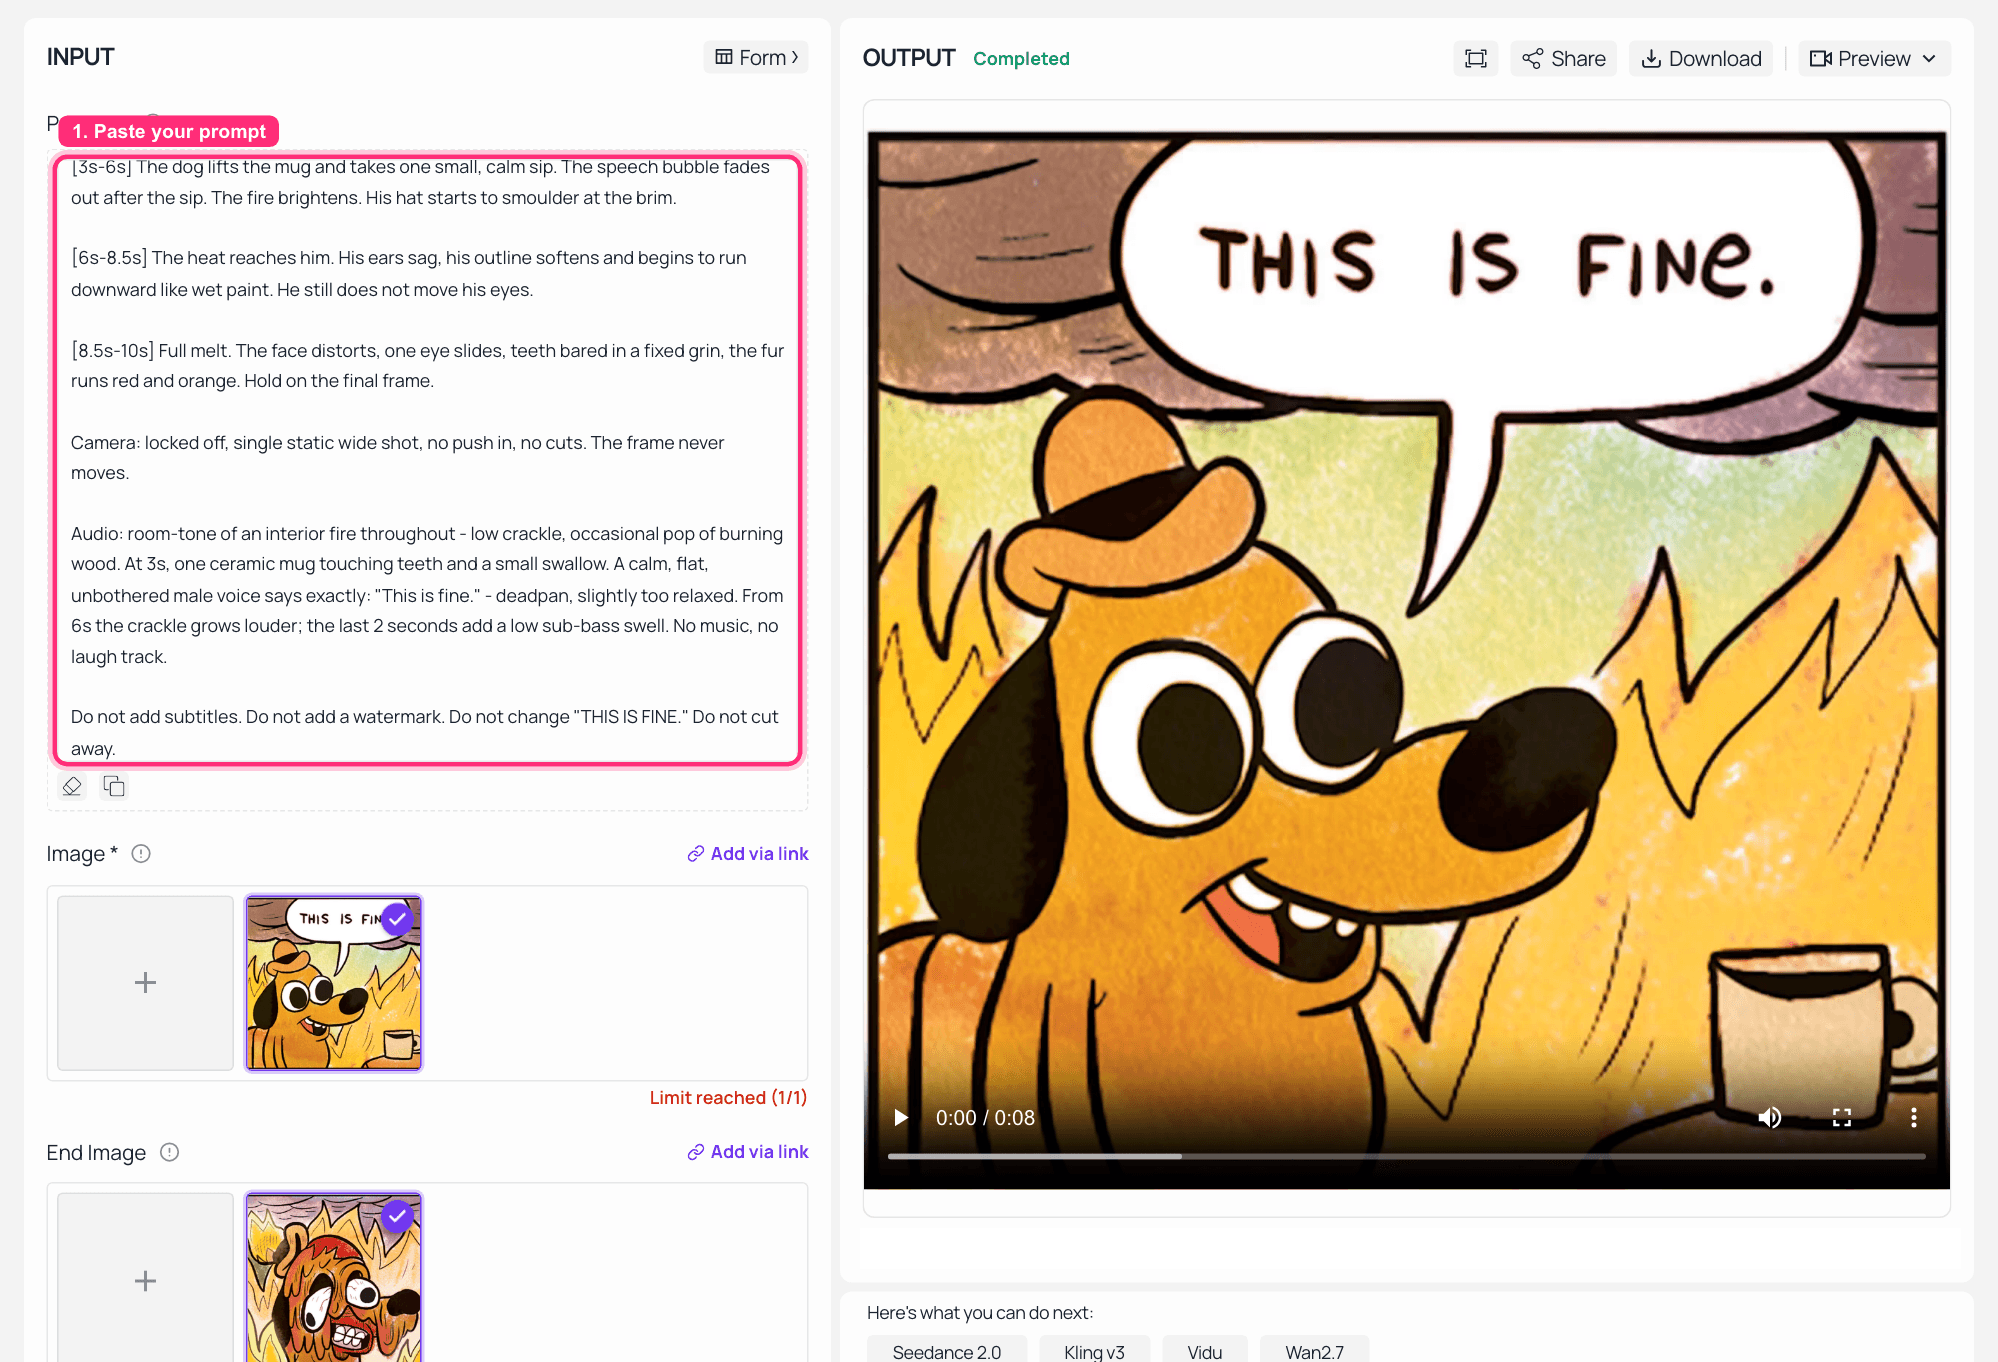 原始漫画的画格2和画格6,标记为首帧和尾帧输入
步骤2:在 image-to-video 上运行,使用 end_image。
模型:minimax/h3/image-to-video。设置:分辨率2K,image = 画格2,end_image = 画格6,比例1:1以匹配近方形的源。设置时长为10;滑块默认在8,所以拖到10。
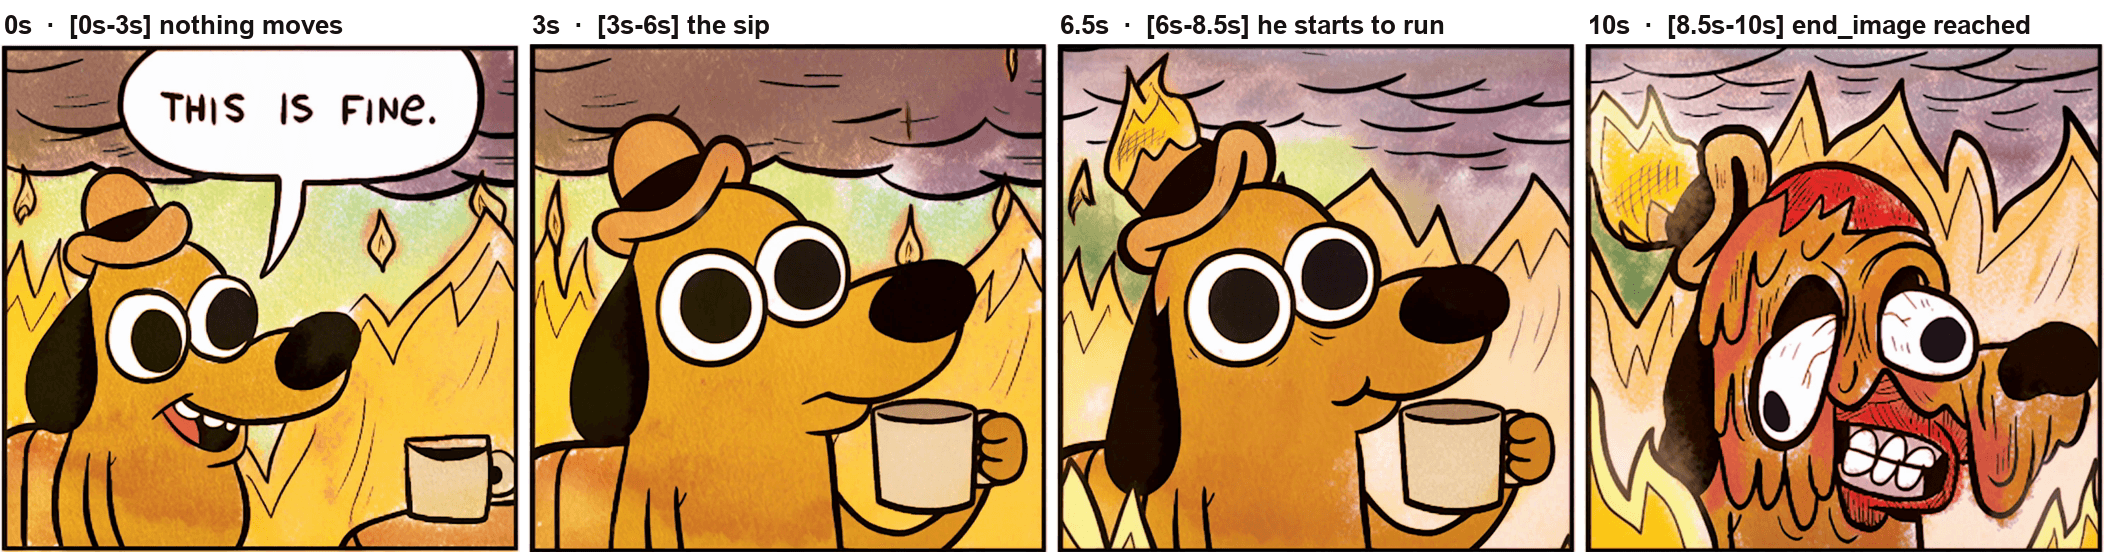
text1手绘2D网络漫画画格,赋予生命。保留每一帧中的原始水彩纹理、可见墨水轮廓、错位纸张纹理和平坦漫画调色板。不要平滑,不要用3D重新渲染,不要清理线条,不要添加新物体,不要添加新文字。 2 3[0s-3s] 几乎没有任何移动。狗完全静止地坐着,拿着杯子,眼睛直视前方。只有他身后的火焰在移动:缓慢的橙色火舌爬上墙壁,一粒余烬飘起。写着“THIS IS FINE.”的气泡保持在原位,完全清晰可读,未改变,手写字体。 4 5[3s-6s] 狗举起杯子,喝了一小口,镇定自若。喝完一口后,气泡淡出。火焰变亮。他身后的墙壁开始因热量而变形。他的帽子边缘开始冒烟。 6 7[6s-8.5s] 热量触及他。他的耳朵下垂,轮廓变软并开始向下流淌,像湿漆一样。他的眼睛仍然不动。杯子握在他的爪子里。 8 9[8.5s-10s] 完全融化。脸部扭曲,一只眼睛滑落,牙齿露出固定的咧嘴笑,皮毛变成红色和橙色。他保持着姿势。在最后半秒保持最后一帧。 10 11摄像机:锁定机位,单一静态全景,不要推,不要手持,不要切。画面从不移动。这是一个漫画画格内的单次连续镜头。 12 13音频:全程室内火灾环境音——低噼啪声,偶尔的木头爆裂声,微弱的建筑吱嘎声。3秒时,陶瓷杯接触牙齿和一小口吞咽声。一个平静、平淡、不慌不忙的男性声音准确地说:“This is fine.”——面无表情,毫无感情,稍微过于放松。从6秒开始,噼啪声变大,环境音变厚;最后2秒加入一个低沉次低频膨胀。没有音乐,没有笑声音轨,没有不在此列表中的音效。 14 15不要添加字幕。不要添加水印。不要拼写图像中已有的任何单词以外的单词。不要更改“THIS IS FINE.”。不要切走。 16
那个提示就是结构表的活体。第一段是风格约定。四个括号内的切片是时间线。然后是摄像机,音频,然后是负面列表。其中没有装饰性的东西。
 Atlas Cloud上的MiniMax H3 image-to-video:首帧和尾帧已加载,10秒2K,输出面板中完成片段
步骤3:像QA检查一样阅读输出。
四个检查,每个测试提示的不同块。
- 气泡中的THIS IS FINE.是否仍然清晰可读且拼写正确?测试块5。
- 线条是否存活,还是有什么东西把它“改善”成了干净的3D?测试块1。
- 音频是否只包含你列出的声音?探测容器:它应该返回h264加AAC立体声。
- 最终帧是否落在画格6的姿势上?测试end_image。
bash1ffprobe -v error -show_entries stream=codec_type,codec_name,width,height,r_frame_rate,channels,sample_rate \ 2 -of default=noprint_wrappers=1 output.mp4
我的返回结果是1472x1440,24fps,h264加AAC立体声,10.13秒。值得注意:我要求比例1:1,得到了1472x1440,所以在image-to-video上,源帧的形状获胜。将你的两个画格对齐到你实际想要的形状。
 完成片段在0s、3s、6.5s和10s的四个帧,与提示中的四个时间切片匹配
步骤4:使用 reference-to-video 将狗移到新地方。
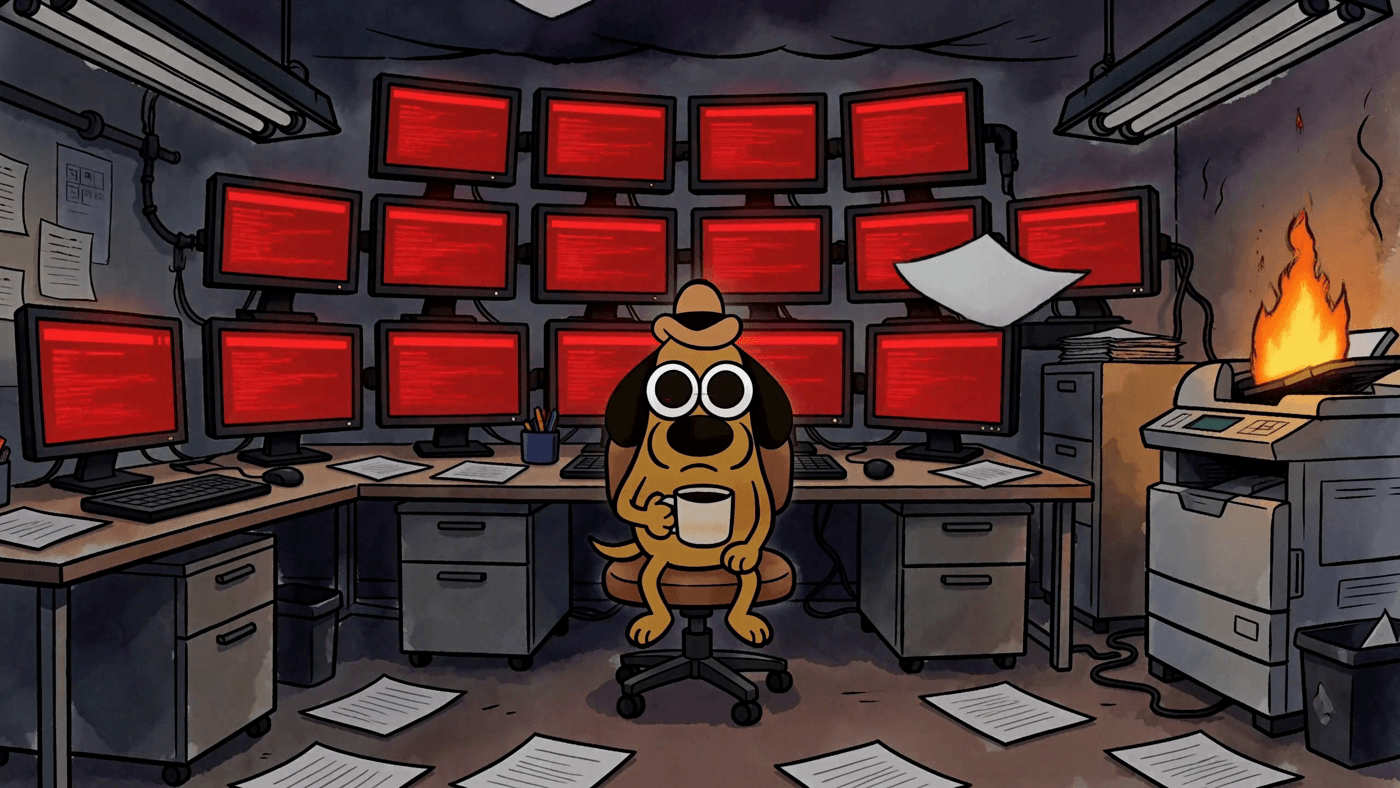
相同角色,新房间。模型:minimax/h3/reference-to-video。设置:refers[] = 画格2作为图像,时长8,分辨率2K,比例16:9。
text1图像1是角色和艺术风格参考:保持这个精确的手绘2D网络漫画外观,相同的水彩纹理,相同的墨水轮廓粗细,相同的狗,相同的小帽子,相同的杯子。不要用3D重绘他,不要改变他的比例,不要清理线条。 2 3把他放在一个不同的房间里,保持他的镇定。一个狭窄的开放式办公室,夜晚,荧光灯管闪烁,一面墙的显示器都显示红色错误状态,打印纸从画面中飘落,角落里有一个小电火。他坐在画面中央的办公椅上,爪子拿着杯子,直视镜头,完全放松。 4 5摄像机:锁定机位,静态全景。不要推,不要切。 6 7音频:荧光灯嗡嗡声,打印机摩擦声,每两秒重复一次的柔和警报声,远处电火噼啪声,4秒时有一个平静的啜饮声。没有音乐。没有语音。 8 9不要添加任何屏幕文字。不要添加字幕。不要添加其他角色。 10
可迁移规则:refers[] 携带身份和风格,文字携带场景。 这个分割是整个角色一致性技巧,也是为什么提示的第一行存在的原因。
 同一只网络漫画狗被重新安置到夜间燃烧的开放式办公室,由MiniMax H3 reference-to-video生成
相同的帽子,相同的杯子,相同的墨水粗细,新房间。一张参考图像完成了所有这些。
另外三个值得借鉴的MiniMax H3提示模式
模式1:动态海报,布局不能动。
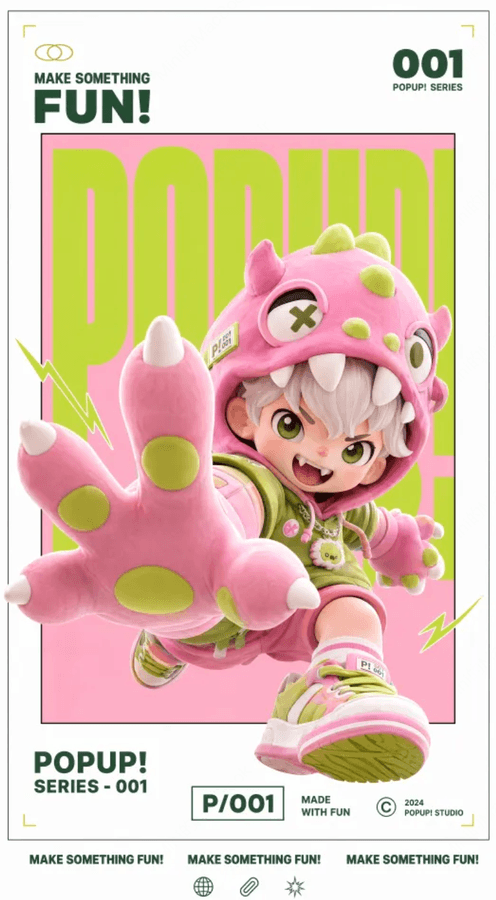 MiniMax H3动态海报:POPUP!布局动画,框架和排版保持锁定
 交给MiniMax H3的原始静态海报
整个提示只有两行:保持画廊白色画框、内框、红白黑色调、3D角色感觉和布局结构不变,并在文字进入时添加一个灵巧的音效。规则:命名必须存活的部分。 “保持布局”不是风格说明,而是一个约束,模型会像对待约束一样对待它。
模式2:界面演示,动词胜过形容词。
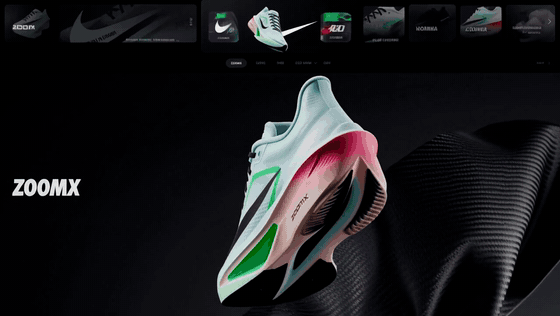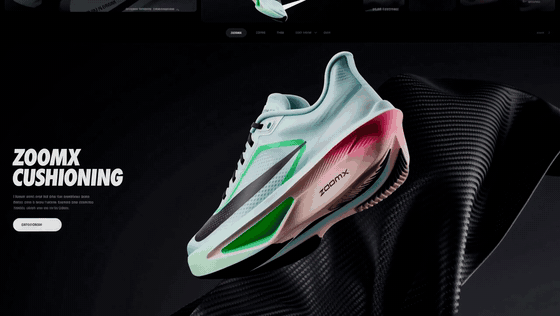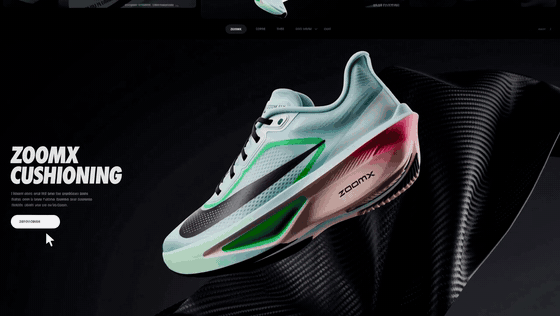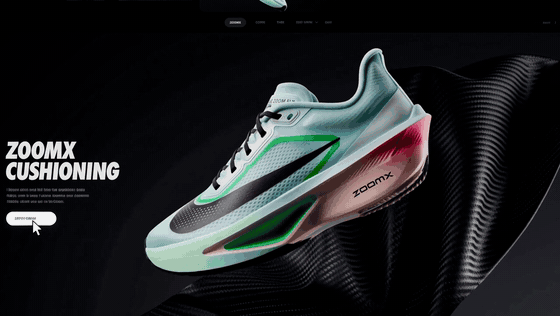
 MiniMax H3落地页演示:滚动、悬停、产品页面上的颜色反转
 落地页片段背后的单个产品参考图像
那个提示要求向下滚动页面、悬停状态、强烈放大和颜色反转。四个动词。它从未说“现代”或“光滑”。交互是动作,所以把它们写成动作。 超大斜体字和碳纤维编织背景来自形容词;让它看起来像真实页面的东西来自动词。
模式3:真人实拍加手绘,靠拒绝来维持。
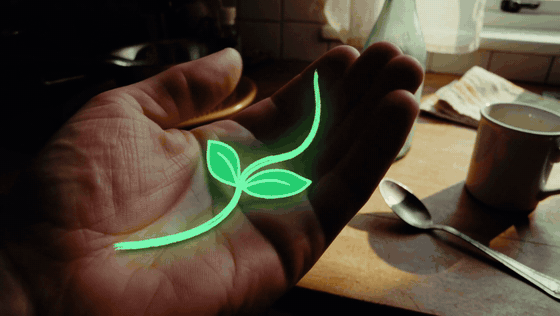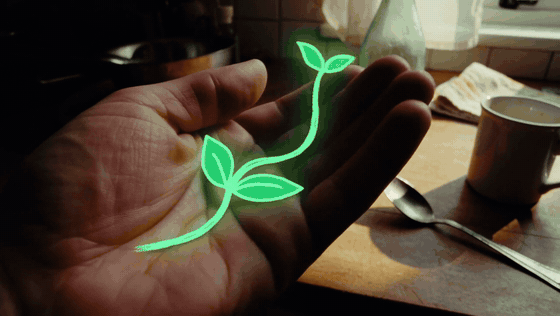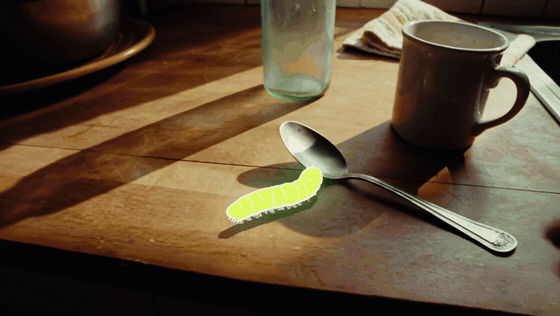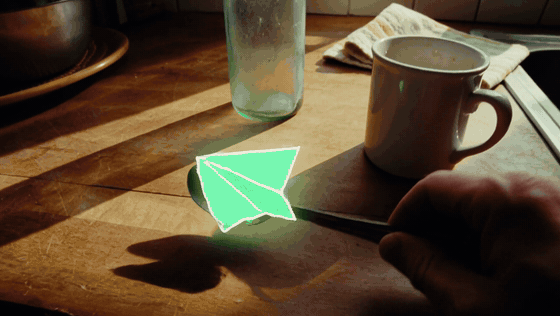
 MiniMax H3片段,融合真人实拍厨房画面与手绘发光生物
这是一个手机拍摄的傍晚厨房,里面有小的发光手绘生物,它之所以保持迷人而不是变成恐怖短片,是因为一组禁令:没有大眼睛,没有裂口嘴,没有尖牙,没有威胁姿势,没有猛扑,没有突然黑屏,没有惊吓。负面列表是主要的风格控制,而不是补丁。 它也是你编码品味的地方。
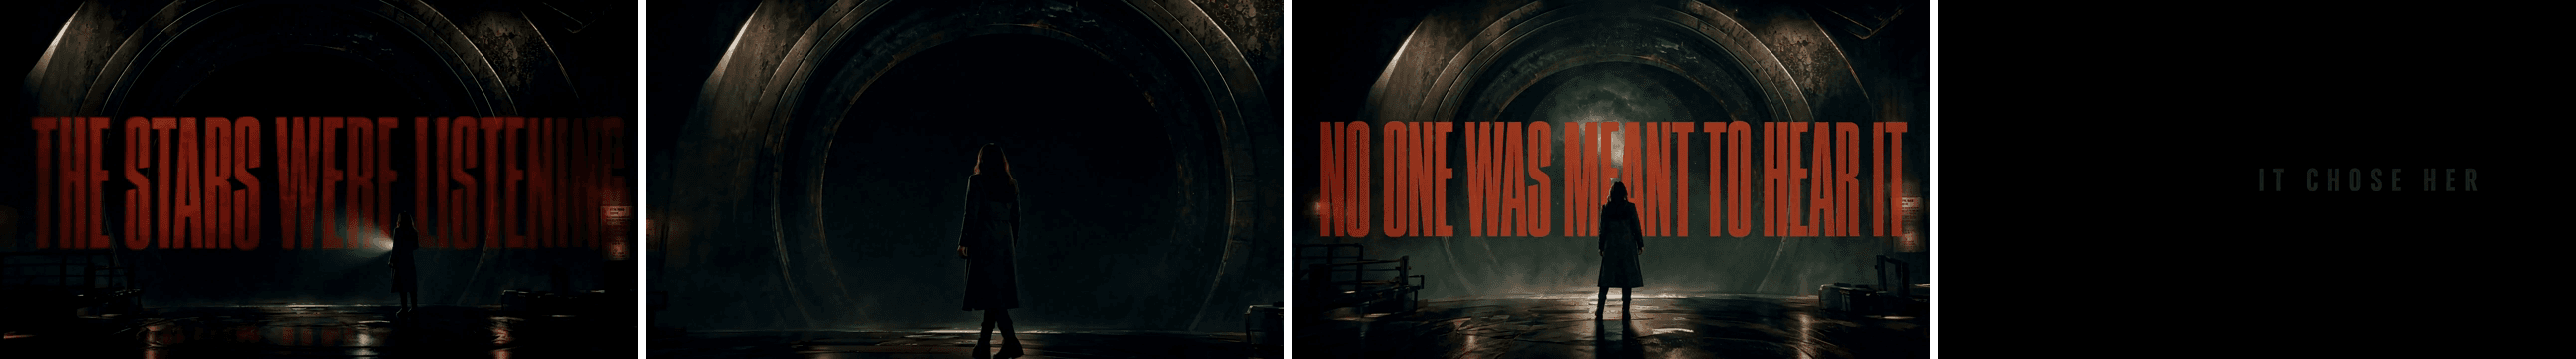
 官方科幻预告片中的四帧:THE STARS WERE LISTENING
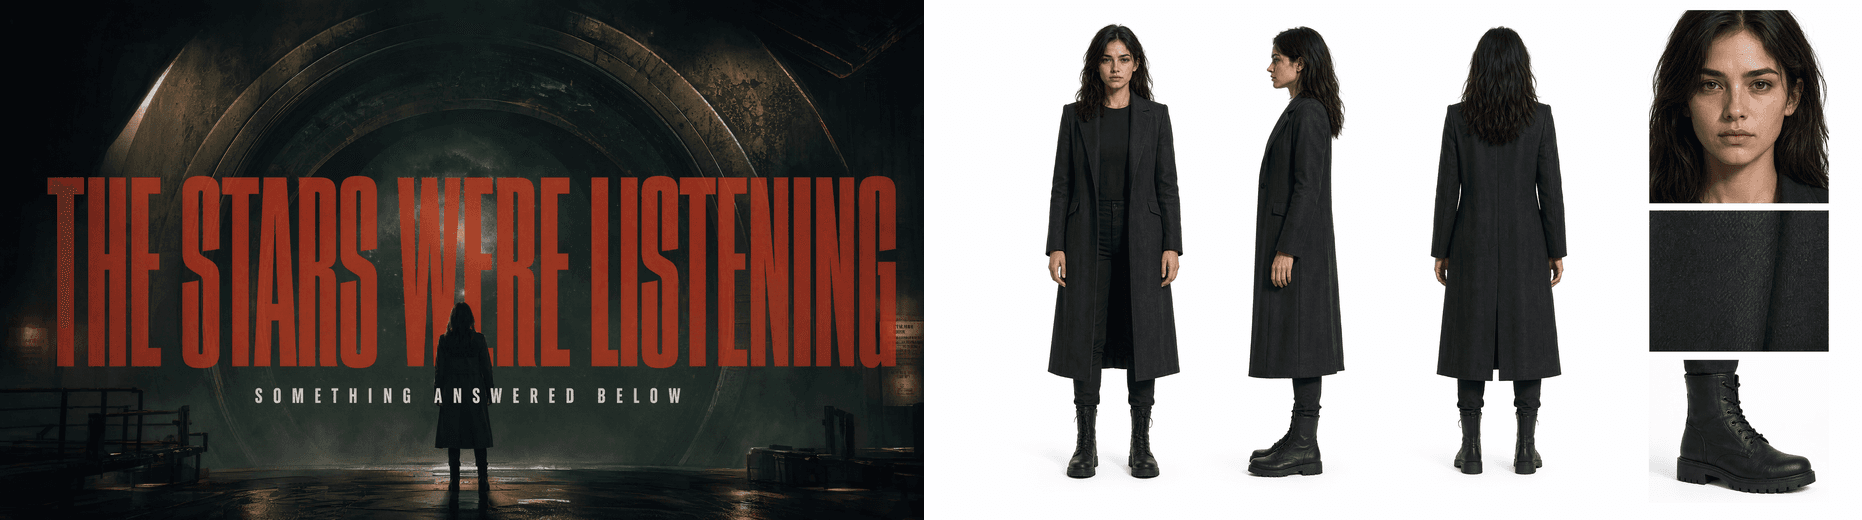
 预告片背后的情绪板和角色参考
上面的预告片将两个想法闭环。提示详细拼写了一个标题,THE STARS WERE LISTENING:极窄、粗体、全大写、暗红色混合铁锈色、轻微颗粒感和雾化边缘。那个标题按原样返回。两个参考板处理情绪和主角,所以文字从来不需要描述一张脸。分工,贯穿始终。
运行这些MiniMax H3提示的成本是多少
H3按生成的视频秒数、按分辨率计费,所以成本模型出奇地简单:一个15秒的镜头大约花费三个5秒尝试的成本。其他一切由此而来。
- 在5秒时迭代,在10或15秒时交付。 构图、调色板和声音设计都在5秒时解决。锁定机位的镜头没有任何需要完整时长才能告诉你它错了。
- end_image 是一个成本工具,而不仅仅是创意工具。 大多数重跑是因为结尾跑偏了。锁定最后一帧在付费之前就消除了这种失败模式。
- 负面列表和拼写出来的文字是免费的。 它们为提示增加字符,但提示是按秒计费,而不是按token。大力使用它们。
- 在编写之前将时长匹配到端点。 构建一个15秒的拍摄清单,然后发现你的端点上限是10秒,会导致重写,而不仅仅是重跑。
现在还不能计划的一件事:定价表列出了更便宜的768p层级,但截至本文撰写时,768p作业被直接拒绝,2K是唯一运行的分辨率。预算时假设每秒都是2K秒。当前每秒费率在模型页面上,该页面也是768p层级一旦开放时出现的地方。
MiniMax H3提示、表情包和版权
这只狗不属于公共领域。This Is Fine来自KC Green的网络漫画Gunshow #648,发布于2013年1月9日,只有前两个画格曾经走红(Know Your Meme,2013年1月)。Green公开谈论过,并且相当疲惫地,看着这幅图像被无限重复使用,包括被他不同意其政治立场的人使用(NPR,2023年1月)。
本教程是评论和教学,而不是素材库。如果你想发布商业用途的东西,自己绘制帧或使用你获得许可的帧。在客户项目之前运行你自己的政策检查:H3将内容规则应用于可识别的真实人物和知名IP,在截止日期中途发现这一点并不有趣。
常见问题
MiniMax H3生成音频,还是我之后添加?
同一轮。画面和声音一起出来,这正是为什么音频必须写在提示正文中,而不是之后附加。给它一个单独的音频:块,并说明每种声音进入的时间。我探测的九个官方片段每一个都返回AAC立体声,32kHz,伴随2560x1440、24fps视频流。
MiniMax H3提示最长可以是多少?
最多7,000个字符,根据MiniMax文档。实际上官方示例范围很广,中位大约130个中文字符,最长的两个分别是657和858。当参考图像在描述时,短提示效果很好。如果你没有参考,预计要写一个拍摄清单。
为什么我的MiniMax H3视频中的文字乱码?
因为你没有把它打出来。在提示中字面出现的字符串渲染清晰;你笼统地指代的东西(“HUD元素”,“一些标签”)会以字母形状纹理返回。拼写每一个必须可读的单词,然后添加“不要拼错,不要添加其他文字,不要添加字幕”。
一个MiniMax H3提示可以使用多少参考图像、视频和音频片段?
九个图像,三个视频和三个音频片段,共十二个文件,参考视频和音频各2到15秒。音频不能是唯一的参考。注意,模型能力与某个端点暴露的内容是两回事,所以检查当前输入列表的模型页面。
MiniMax H3提示能否控制片段如何结束,而不仅仅是开始?
可以,在image-to-video上,通过可选的end_image参数。给一个首帧和一个尾帧,片段在它们之间插值。上述演示就是如此:漫画画格2输入,漫画画格6输出。保持两个图像宽高比相似,否则过渡会变得难看。
我现在实际能获得什么时长和分辨率?
2K,而且只有2K。768p作业目前被拒绝,返回“支持的分辨率:2K”,尽管定价表中出现了768p。时长因端点而异:text-to-video和image-to-video接受5到10秒,默认8;而reference-to-video接受5到15。还有一个陷阱:在纯文本生成上,API拒绝自适应并要求显式比例。


