

这句台词讲的是思念一个人。语音是在悲伤情感设置下生成的,但参考肖像却带着灿烂笑容。这正是静态分镜无法回答的那类冲突。为了让 OmniHuman 2.0 情感语音与面部表情匹配变得具体,我们首先固定一张肖像和一条 9.68 秒的语音轨道,然后用相反的面部方向生成了两个视频。另外两个视频使用相互匹配的愤怒和悲伤肖像、语音演绎与方向。无声 GIF 让你可以检查可见的表情。
有一个重要的版本边界。Atlas Cloud 现已列出 Avatar Omni Human 2.0。我们在 2026 年 10 月 20 日于 Atlas 测试环境中的运行,在渲染前返回了上游不支持模型错误。本文中所有四个已完成的数字人视频都是在同一环境用 Avatar Omni Human 1.5 生成的。它们展示的是一套相关的音频驱动工作流和一种有用的诊断方法,而不是实测的 OmniHuman 2.0 性能。
核心要点
- 先听提供的音频。在下面的测试中,同一段悲伤录音在方向改变时,产生了明显不同的视线、嘴部和手势选择。
- 一个微笑的源肖像会将其表情带入开头帧,即使提示词要求克制。
- 第二组通过让起始肖像、语音演绎和方向与每种情绪相匹配,使愤怒和悲伤在视觉上明显区分。它并没有把某一个输入隔离为原因。
- 对比相同时间点在有声和无声下的表现;描述实际发生了什么变化,而不是假设提示词完全按所写生效。
- 在使用一个版本的结果来说明另一个版本之前,先检查模型版本和一个已完成的输出。
音频、肖像和提示词各自贡献什么
Atlas 将 Omni Human 2.0 描述为一个音频驱动的数字人模型,接受参考图像、WAV 或 MP3 轨道,以及可选的文本提示词。其公开模型页面列出 720p 输出和 4 到 300 秒的输入音频。页面称提示词可以指导手势、动作、场景细节和镜头运动。这些是产品页面规格,并不表示每个要求的面部表现点都会出现在生成的片段中(Atlas Omni Human 2.0 模型页面)。
较早的 OmniHuman-1 论文将该研究系列描述为以图像、音频、文本和其他信号为条件的人类动画。它并未确立后续产品版本的确切控制方式或结果(OmniHuman-1 论文,ICCV 2025)。对于准备做一次测试的创作者来说,更简单的分工更有用:
| 输入 | 在测试中的职责 | 需要检查什么 |
|---|---|---|
| 肖像 | 锚定人物身份和初始表情 | 脸部是否可见,起始微笑是否与预期情绪冲突? |
| 音频 | 提供实际词语、时机、停顿和演绎 | 录音听起来是否像脚本暗示的情绪? |
| 提示词 | 请求录音周围的可见行为 | 脸部、视线和手势是否真的遵循了这些方向? |
嘴部运动和情绪表达是分开的检查项。一张脸可以看起来在说话,而眼睛和微笑却传达错误含义。静态帧可以揭示表情,但只有带原始音频的视频才能让你判断语音与面部的关系。
真实测试输入:一句悲伤台词和一张微笑源图像
我们故意使用了 Atlas 的微笑示例肖像,而不是一张已经悲伤的脸。脸部清晰且正面朝向,这让生成的表情容易检查,但起始的笑容为一句悲伤台词制造了苛刻的案例。
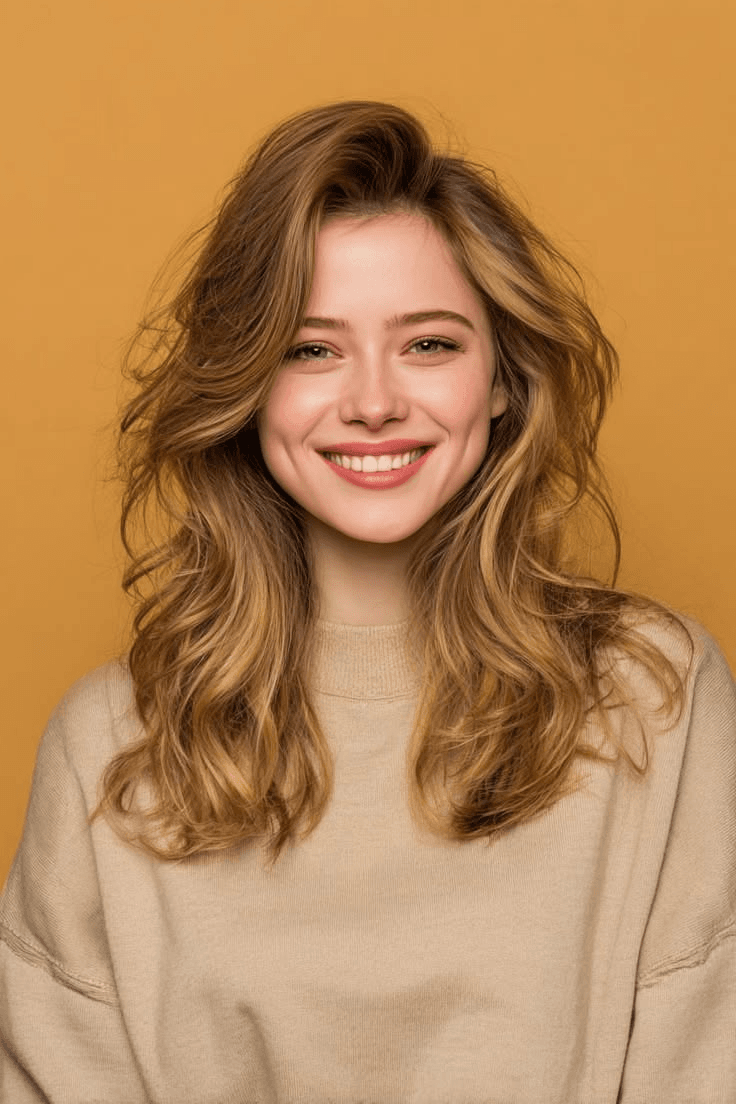 两个视频的固定输入图像。微笑是源图像的一部分,因此请将开头几秒与后面的表演分开检查。
音频方面,我们使用 Atlas 测试环境的 MiniMax Speech 2.6 HD Playground,采用英语 “Upset Girl” 语音和 sad 情感设置。确切脚本是:“我以为你今天会在这里。我一直看着门口,哪怕所有人都已经走了。我对你的思念难以言表。”生成的 MP3 时长 9.68 秒。两次数字人生成使用同一个音频文件和同一张肖像;只有可选的方向提示词发生变化。两者都返回了带音轨的 9.8 秒 MP4。这是一次小型实用对比,不是正式的模型基准测试。
这个输入选择很重要。脚本给了说话者低头或忍住微笑的理由,而参考照片却暗示相反。如果脸一直微笑,首先要问在这个片段中,是源图像还是方向承担了更大影响。不要假设加入更多情绪形容词就能解决冲突。
两个真实视频结果:同一语音,不同面部方向
运行 A:要求克制的脸
以下是第一次完成的 Omni Human 1.5 运行所使用的方向:
女人安静而悲伤地对镜头说话。她最初的大笑在第一个词之前淡去。眉毛轻轻蹙起,眼睛湿润并低垂,嘴部保持克制。到最后一句时,她重新看向镜头,但不微笑。头部和手部动作尽量少;稳定的中近景。
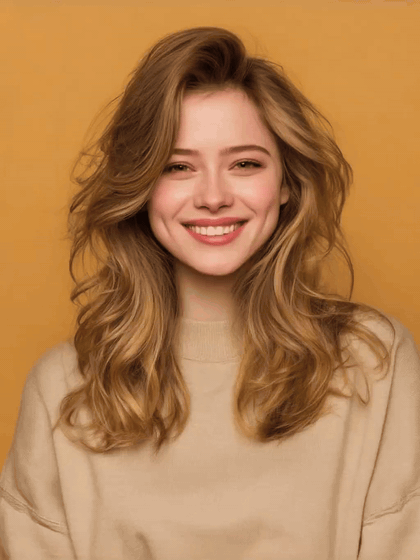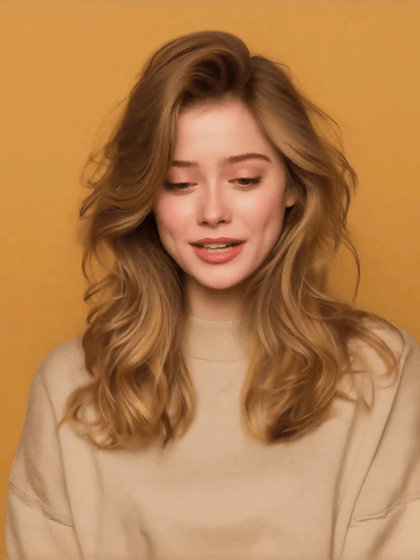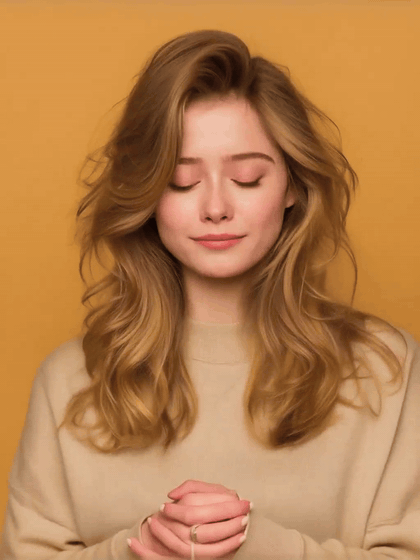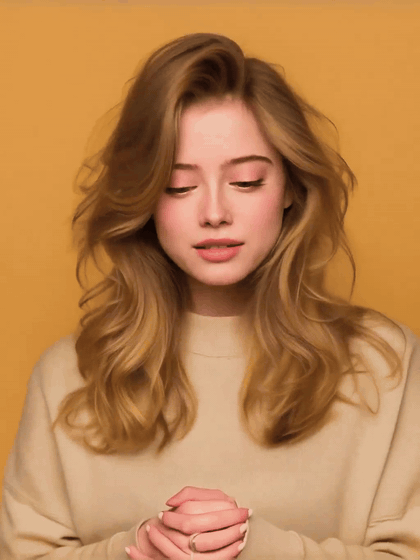
运行 A,Atlas 测试环境,Avatar Omni Human 1.5。此 GIF 无声。开头帧仍带有源图像的微笑;大约 2 到 4 秒时视线下降,嘴部放松,接近 6 到 8 秒时眼睛低垂或闭上。提示词并没有完全按要求在第一个词之前移除微笑。
运行 B:要求与台词冲突的微笑
肖像和悲伤 MP3 保持不变。我们只改变了方向:
女人在整个音频中带着灿烂、愉快的微笑,明亮地对镜头说话。眼睛保持有神,眉毛放松;说话时加入一个小幅轻快点头。绝不让微笑淡去,即使到最后一句。手部动作尽量少;稳定的中近景。
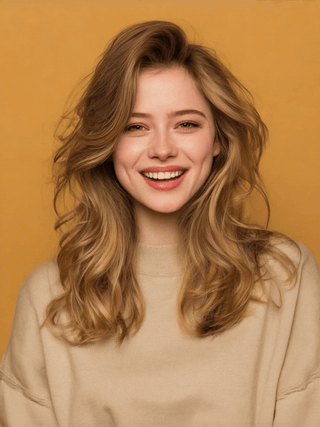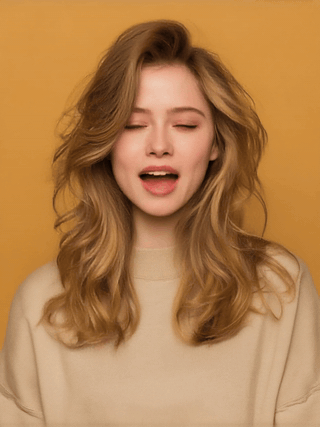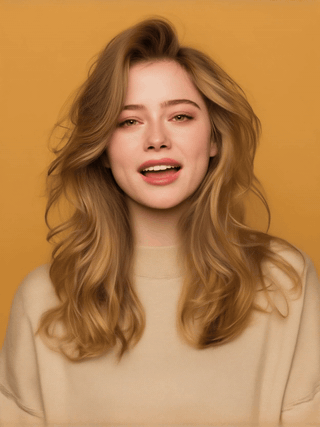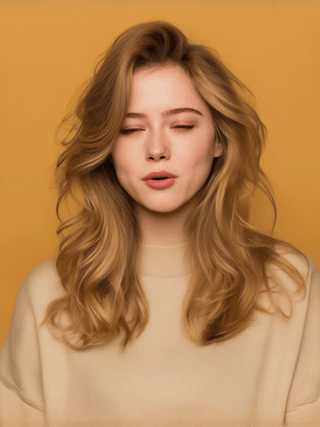
运行 B,Atlas 测试环境,Avatar Omni Human 1.5。在 2 到 6 秒时,她更常看向镜头,并保持轻微微笑。微笑在接近结尾时变淡,所以“全程”并未被字面遵循。与运行 A 相比,视觉线索仍然更不符合提供的悲伤台词。
这两个结果比一个泛泛的“要有情绪”提示词更清楚地回答了标题中的实际问题。单靠音频并没有在两次生成中强制产生相同的可见情绪。文本方向影响了生成的视线和表情,而强烈微笑的输入在开头仍然可见。这些观察适用于这两次 1.5 运行。它们并不能量化 Omni Human 2.0 的表情准确度。
检查相同时间点,然后只改一处
下面这组帧来自两个真实视频的大约六秒处。左侧结果低头并双手合拢;右侧结果面向观众,带着轻微微笑。这是输出的视觉对比,不能替代带声音播放片段。
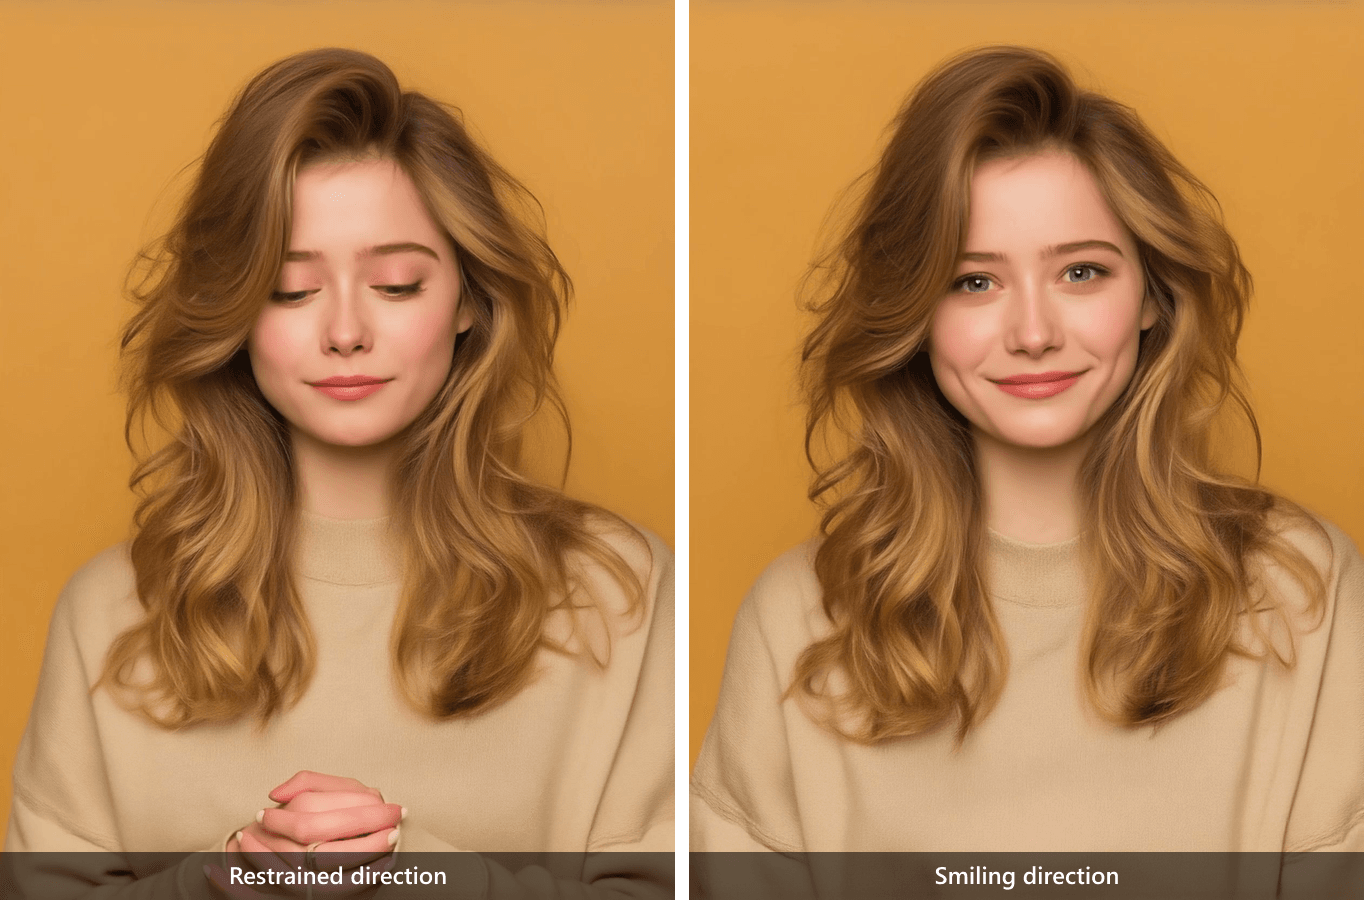 相同肖像和悲伤音频,大约 00:06。左:克制方向。右:微笑方向。两帧都来自实际的 Omni Human 1.5 输出。
对你自己的片段进行三遍检查:
- 只听不看。 标出承载情绪的词语和停顿。在这个测试中,关于看着门口和思念某人的台词是要保护的含义。
- 在这些时刻静音观看。 检查眼睛、嘴角、头部角度和手势。说话者可以动嘴唇,却仍然显得愉快或疏离。
- 将声音和画面一起播放。 判断脸部是支持台词、削弱台词,还是改变其含义。如果失败,只改变一个输入或指令,然后再次检查相同时间点。
| 这两个片段中的时刻 | 运行 A,克制方向 | 运行 B,微笑方向 | 对比支持什么 |
|---|---|---|---|
| 开头 | 两者都继承源肖像的大笑 | 两者都继承源肖像的大笑 | 在请求的变化生效之前,源表情已经可见 |
| 大约 00:04 | 视线下降,嘴部相对中性 | 视线更靠近镜头,表情更轻 | 方向改变的不只是嘴唇运动 |
| 大约 00:06 | 眼睛仍然低垂;双手紧握 | 眼睛面向镜头;仍留有轻微微笑 | 同一音频可以伴随不同的可见情绪线索 |
| 大约 00:08 | 眼睛闭上,表情保持克制 | 直接注视回归,尽管微笑已变淡 | 两个提示词都没有全程被逐字遵循 |
这是一个有用的复查表,不是数值质量评分。我们没有运行足够多的样本,无法将提示词效应与模型的随机变化分开。视频让创作者判断这个特定片段是否服务于预期句子。
更广泛的对比:同一句台词中的愤怒与悲伤
运行 A 和运行 B 固定肖像和录音,以考察一次方向变化。为了获得更明显的情绪对比,我们用同一位说话者和同一份脚本制作了两个新的短片。这一次,源表情、语音演绎和视频方向都分别与预期情绪相匹配。目的是展示两个实用的最终结果,而不是声称单靠某一个参数造成了差异。
共享脚本是:你答应过你会在这里。我等了一整夜,盯着门口。经历了这些,我不知道该怎么再信任你。 在 Atlas 测试环境中,MiniMax Speech 2.6 HD 用同一个 English_captivating_female1 语音、英语语言、速度 1、音量 1 和音高 0 朗读了两次。我们将第一段录音(6.73 秒)的情感设为 angry,第二段(7.34 秒)设为 sad。本文没有嵌入任何音频文件;GIF 是无声的。
从上面使用的同一张微笑照片开始,我们用 Seedream v4.7 Edit 制作了两张参考肖像。这些是数字人模型的实际图像输入:
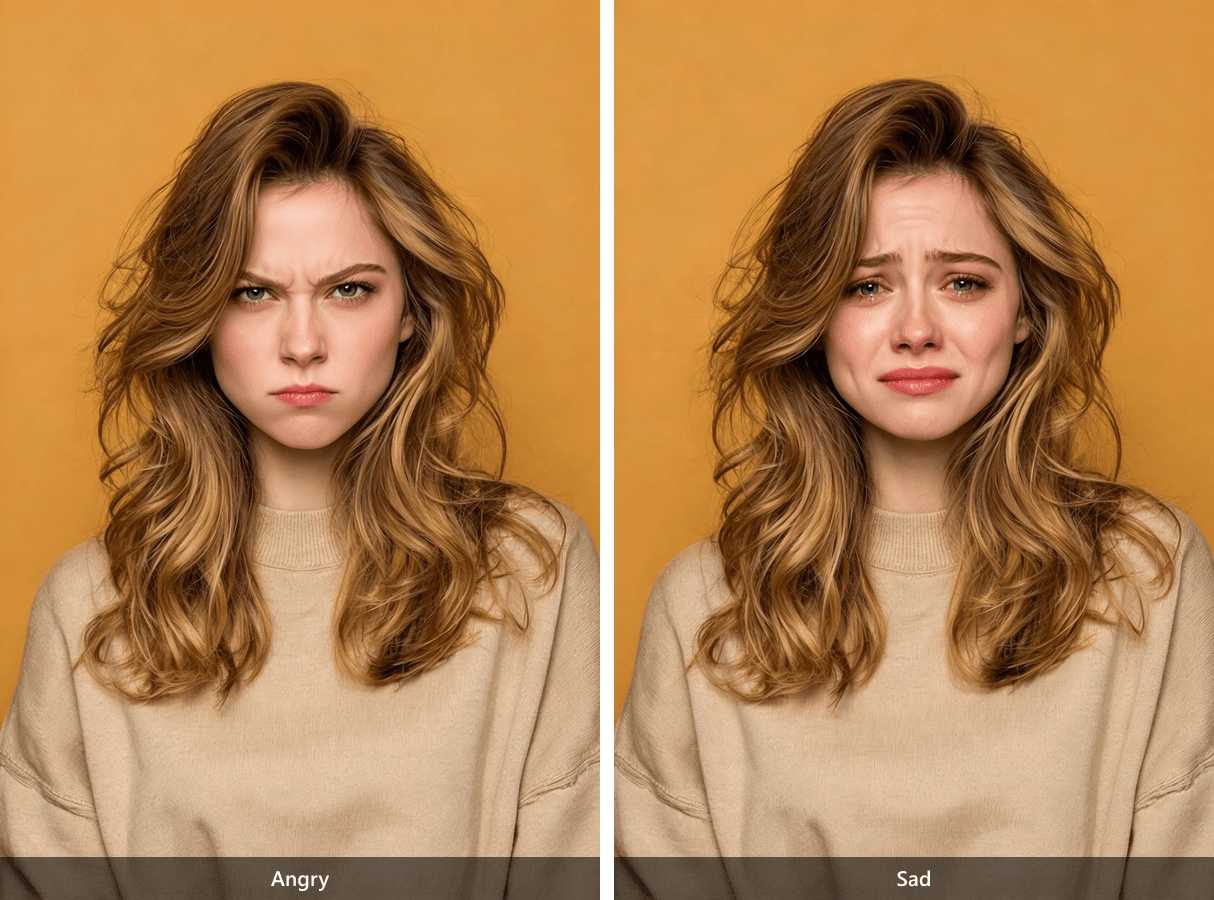
左:眉毛压低、紧蹙,嘴部坚定。右:内眉抬起,眼睛湿润,嘴角下垂。两者都是从原始微笑肖像编辑而来;编辑也改变了细微面部细节,因此两个源图像除了表情外并非像素级相同。
愤怒肖像的完整 Seedream 编辑指令是:
将女人的脸编辑成明显愤怒、克制的表情:眉毛压低并紧蹙,眼睛眯起,形成严厉直接的怒视,下颌紧绷,双唇紧紧抿住。保持同一个女人的身份、发型、米色毛衣、橙色背景、光线、摄影风格、相机角度和中景肖像构图。不要微笑,不要眼泪,不要额外人物或物体。
对于悲伤肖像,我们使用:
将女人的脸编辑成明显的悲伤:内眉抬起并紧蹙,眼睛湿润且低垂,嘴角向下,双唇轻轻闭合,肩膀略微下沉。保持同一个女人的身份、发型、米色毛衣、橙色背景、光线、摄影风格、相机角度和中景肖像构图。不要微笑,不要愤怒怒视,不要额外人物或物体。
两个完成的数字人片段都使用 Avatar Omni Human 1.5、1080p 输出和种子 20261021。它们分别运行 6.76 秒和 7.40 秒,接近对应的录音。
运行 C:违背承诺后的愤怒
愤怒肖像和 angry 录音与以下完整视频方向配对:
她以克制的愤怒直接对镜头说话。眉毛保持压低并紧蹙,眼睛眯起,下颌收紧,说话间隙双唇紧抿。说到“promised”时,她略微前倾,并抬起一只手做一个短暂指点手势;到最后一句时,她保持严厉的直接注视。不要微笑,不要眼泪。保持相机稳定,中近景,橙色背景不变。
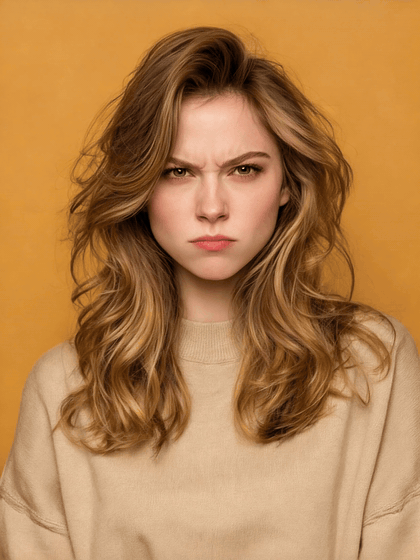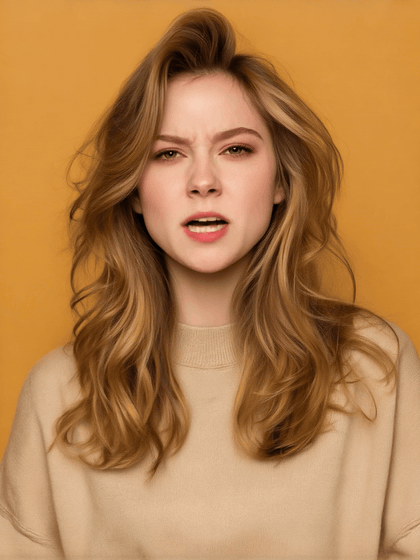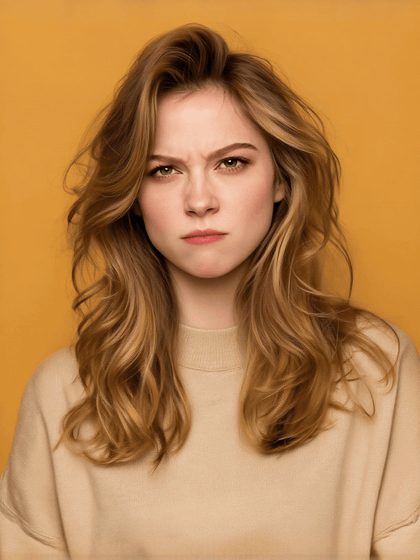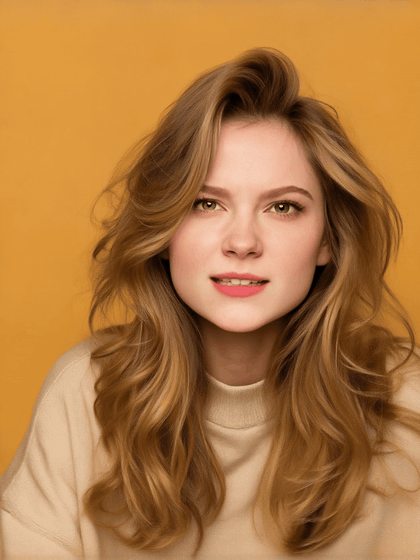
运行 C,Atlas 测试环境,Avatar Omni Human 1.5。在开头和中间,她眯着眼睛、皱着眉说话。表情在接近结尾时变柔和;要求的指点手势并不清晰可见。此 GIF 没有声音。
运行 D:同一违背承诺后的悲伤
悲伤肖像和 sad 录音与另一个方向配对:
她带着悲伤对镜头说话。内眉抬起并紧蹙,眼睛变得湿润并低垂,肩膀下沉,嘴部放松成轻微下撇。说到“waited all night”时,她低下头并停顿;接近最后一句时,她重新抬头,但不微笑。不要愤怒怒视或指点手势。保持相机稳定,中近景,橙色背景不变。
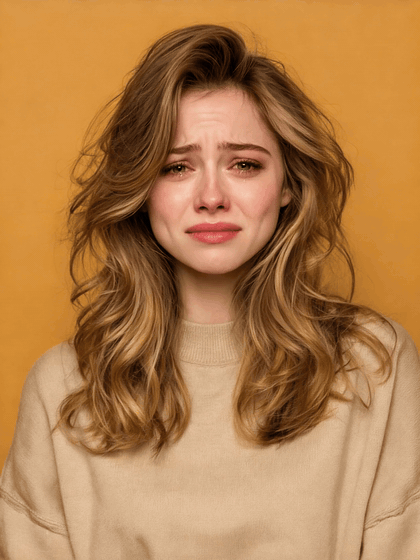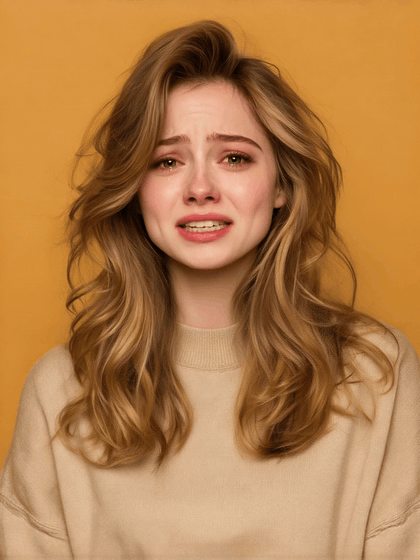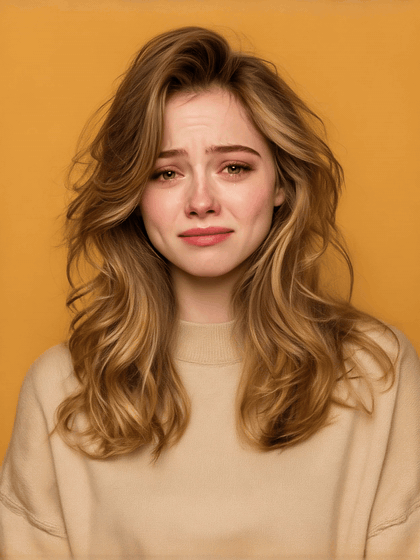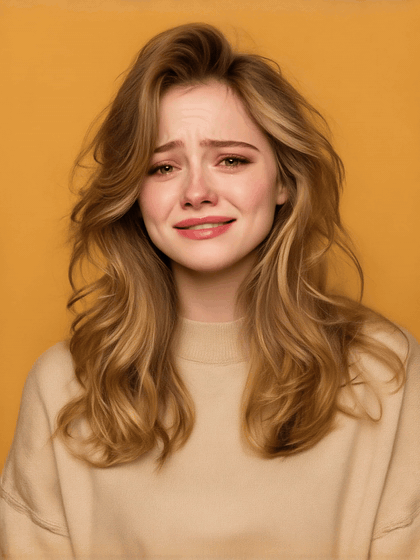
运行 D,Atlas 测试环境,Avatar Omni Human 1.5。湿润的眼睛、泪水以及抬起的内眉在整个片段中都可见。她大多面向镜头,而不是在要求的短语处明显低头。此 GIF 没有声音。
在相同时间点,C 看起来紧张且具有对抗性,而 D 看起来痛苦。差异在完成的视频中可见,而不仅仅在编辑后的起始帧中。由于肖像、录音和方向都一起改变,这些示例展示的是一种匹配输入的工作流,而不是仅针对语音情绪的受控测试。要判断任一脸部是否精确跟随演绎,请带声音查看其原始视频;无声 GIF 无法确定语音到表情的时序。
为说话或唱歌编写提示词,而不要与轨道对抗
从你希望观众注意到的音频事件开始,然后命名最小的可见动作。对于安静台词,要求低垂视线或克制的嘴部,而不是“最大悲伤”。对于演绎中的真实变化,把微笑或点头放在可听见的停顿之后。如果录音从头到尾都悲伤,那么全程愉快表情就是像运行 B 那样的有意不匹配。
唱歌使用相同的复查原则,尽管本文没有生成唱歌片段。一个可测试的方向是:中近景。歌手看起来专注,在持续音期间短暂闭眼,然后在乐句结束时低下下巴。保持相机稳定。 提供的歌曲仍然决定歌词、音符长度和时机。带着音乐判断真实的唱歌输出;静态分镜无法确定脸部是否跟随持续音。
只有当录音有清晰节拍时,才保留“然后”或“最后”这类时间词。避免堆叠相互冲突的方向,例如“固定相机”和“环绕相机”。如果提示词错过了一个节拍,简化或移动一个线索,而不是一次性重写肖像、音频和方向。
排查平淡或不匹配的表情
| 你注意到什么 | 可能检查哪里 | 最小下一步测试 |
|---|---|---|
| 一句悲伤台词以咧嘴笑开始 | 肖像本身在微笑 | 尝试一个开头表情适合场景的源肖像,同时保持音频和提示词不变 |
| 在严肃句子中脸仍保持愉快 | 提示词要求微笑或轻快演绎 | 移除该指令,并要求一个具体的克制动作 |
| 脸发生变化,但嘴部时机感觉不对 | 源录音、编辑或生成的片段 | 使用更干净、更短的音频编辑,并对比相同词语 |
| 提示词要求一个从未出现的节拍 | 录音没有可听见的停顿或转变 | 将方向移到实际停顿处,或将其移除 |
| 两个输出差异小于预期 | 模型可能不会遵循每个表情线索 | 再试一次生成,然后判断这个限制对你的用例是否重要 |
运行 A 和运行 B 也说明了为什么“更多提示词细节”不是通用修复方法。两者都没有遵循方向中的每一个词。有用的结果是更具体的诊断:源微笑在开头持续存在,而之后的视线和表情可以不同。这告诉你下一步该改哪一部分。
OmniHuman 2.0 在 Atlas Cloud 上可用吗?
是的,当前英文 Atlas 模型页面列出了 Avatar Omni Human 2.0。这更正了本文较早版本中称该模型不在目录中的说法。被列出并不等于在每个环境中都能成功生成。2026 年 10 月 20 日,我们通过 Atlas 开发 Playground 发出的 2.0 请求在上游消息 req_key <realman_avatar_picture_omni20_cv> not supported 处停止;其页面称失败请求未收费。那次尝试没有生成任何 2.0 视频。出于这个原因,上面成功的片段都标记为 1.5。
对于实时项目,请打开确切的模型页面,并用自己的输入确认一次已完成的运行。2.0 页面列出图像、4 到 300 秒的 MP3 或 WAV、可选提示词方向,以及 720p 输出。1.5 文档有不同的限制和分辨率选项,因此不要将本文的 1.5 片段视为 2.0 基准。请查看当前 Atlas 模型目录,了解实时可用性和定价。
发布前检查权利和背景
在分享一个动画人物之前,确认已获得为预期目的使用该肖像和声音的许可。还要审查该背景下的音乐、肖像、声音和发行权利。当观众可能将合成或编辑过的素材误认为纪实材料或真实人物的当前声明时,请标注出来。将源图像、音频、提示词和输出保存在一起,以便协作者理解实际生成的内容。
对于 OmniHuman 2.0 情感语音与面部表情匹配,下一个有用的步骤是用一个已完成的 2.0 输出进行受控测试:选择一张起始表情适合录音的图像,标记一个情绪节拍,写一个可见方向,然后在有声和无声下对比相同时间点。上面的四个 1.5 视频展示了如何进行这项检查,以及冲突的微笑可能是什么样子。
常见问题
OmniHuman 2.0 会在这个工作流中生成语音吗?
Atlas 模型页面将上传的音频轨道描述为必需输入。在本文中,一个单独的 MiniMax 语音模型先生成了语音录音;数字人模型则根据该 MP3 驱动肖像动画。不要将数字人输出视为它发明了所说台词的证据。
为什么悲伤的语音仍然有一张微笑的脸?
起始图像和可选的轻快提示词,即使在词语悲伤时也可能有利于微笑。运行 A 和运行 B 从同一张微笑照片开始,但当方向改变时,后续视线和表情有所不同。在判断哪个线索占主导之前,请带声音复查你自己的片段。
OmniHuman 2.0 能让唱歌动起来吗?
Atlas 将唱歌列为 2.0 的一个用例,由音频提供表演。我们这里没有完成 2.0 唱歌运行。使用一段简短、突出人声的部分,并在带声音的真实视频中检查持续音和乐句结尾。
提示词应该重复对白或歌词吗?
通常不应该。音频已经提供了词语和时机。用与录音一致的表述来指导可见的表情、手势、构图或场景。
本文生成了 OmniHuman 2.0 视频吗?
没有。Atlas 测试环境中的 2.0 请求在渲染前失败了。这里以 GIF 展示的两个结果是在同一环境用 Avatar Omni Human 1.5 生成的,并相应标注。





