


角色在镜头之间换了外套。产品看起来没问题,直到镜头移动。三个新的广告开场发来,但每个还改了场景和信息,所以没人知道该保留什么。
高效的 Seedance 2.5 Flash AI 短剧与广告工作流 让每次生成都有可审查的任务:确立故事节拍,分配参考角色,生成基线,测试一项改动,然后修复或替换受影响的镜头。在扩大批次之前,先组装已通过的片段。
以下七个示例将这些决策连接到短剧和广告制作。四个已发布的 Seedance 2.5 Flash 示例,与文章创作者提供的三个原创制作示例并列。基于来源的提示词胶囊用英文概述了已发布的说明;它们并非逐字原文。面包店、咖啡和花园简报描述了为这些示例提供的制作方向。嵌入的结果可用于审查实际动作;它们不能证明可重复性或广告表现。
要点
- 在生成素材之前,定义每个镜头的动作和验收检查。
- 为角色、产品、地点、动作和声音分别分配参考。
- 测试一个创意变量时,冻结参考包和设置。
- 对局部缺陷进行编辑;当故事动作或镜头方案错误时重新生成。
- 审查完整序列,包括连续性、音频和实际文件长度。
1. 将简报转化为可被批准通过的镜头
从观众的下一个想法开始。短剧需要改变观众已知的信息。广告需要一个可见动作来传达产品的用途。在描述镜头或灯光之前,先写下这个结果。
对于对话场景,决策可能是:在切到听者之前,要停留多久来呈现一句承认。对于产品影片,决策可能是:开场是否在细节镜头前先建立物体。这些是不同的任务。给两者相同的戏剧性揭示,可能会掩盖产品,或让表演变得仓促。
建立一个镜头台账,包含 ID、预期时长、起始状态、动作、结束状态、参考要求和拒绝条件。将时间安排视为需要测试的方向。生成的文件可能合并、缩短或重新分配所请求的节拍。
案例 1:雨窗餐馆对话
已发布的 Seedance 2.5 Flash 对话场景,约 18.08 秒,带原始声音。致谢与提交说明:创作者的场景与提示词页面。
基于来源的提示词胶囊,经过压缩而非逐字原文:
plaintext1An 18-second rainy-night diner scene: establish two adults over coffee, move to her question about a missed train, briefly insert his hand at the mug, then hold his admission, her silent reaction, and an invitation to stay. Preserve seating, eyelines, wardrobe and mugs. Use distinct voices, continuous rain ambience and no music or subtitles.
| 节拍 | 镜头的任务 | 审查问题 |
|---|---|---|
| 建立视图 | 放置两位说话者和反复出现的道具 | 观众能理解他们的位置吗? |
| 提问与承认 | 承载交流 | 每位说话者都有时间说完吗? |
| 物体插入与反应 | 标记注意力的变化 | 这个剪辑揭示了有用的东西吗? |
| 共同结尾 | 让场景沉淀 | 最后的回应是否可读? |
用台账来决定修订必须改变什么。如果听者的回应感觉仓促,调整那个节拍,而不是重写整个设定。如果杯子在镜头之间移动,将道具不连续单独记录下来,与对对话的判断分开。
先不看画面审查一次声音。然后不看声音观看画面。这能把不清楚的语音与不清楚的调度区分开。保留完整源文件,这样后续剪辑可以缩短停顿,而不丢失原始表演或环境声。
2. 给每个参考一个明确任务
只准备下一次决策所需的材料。一文件夹有吸引力的图像会让你有更多东西需要协调。一个带有明确角色的小型参考包,使结果更容易检查和修订。
对于角色场景,将外观与地点和动作分开。对于广告,从展示其机制所需的任何角度拍摄实际产品。只显示一侧的参考无法确立未看见的结构。请求另一个真实视图,或选择不超出可用证据范围的镜头方案。
保持文件名和上传顺序稳定。提示词中的图像编号必须与界面的实际标记匹配。替换附件后,检查每条针对它的说明。一个正确的句子如果指向错误的图像,可能会悄悄改变任务。
案例 2:三个角色的面包店交接
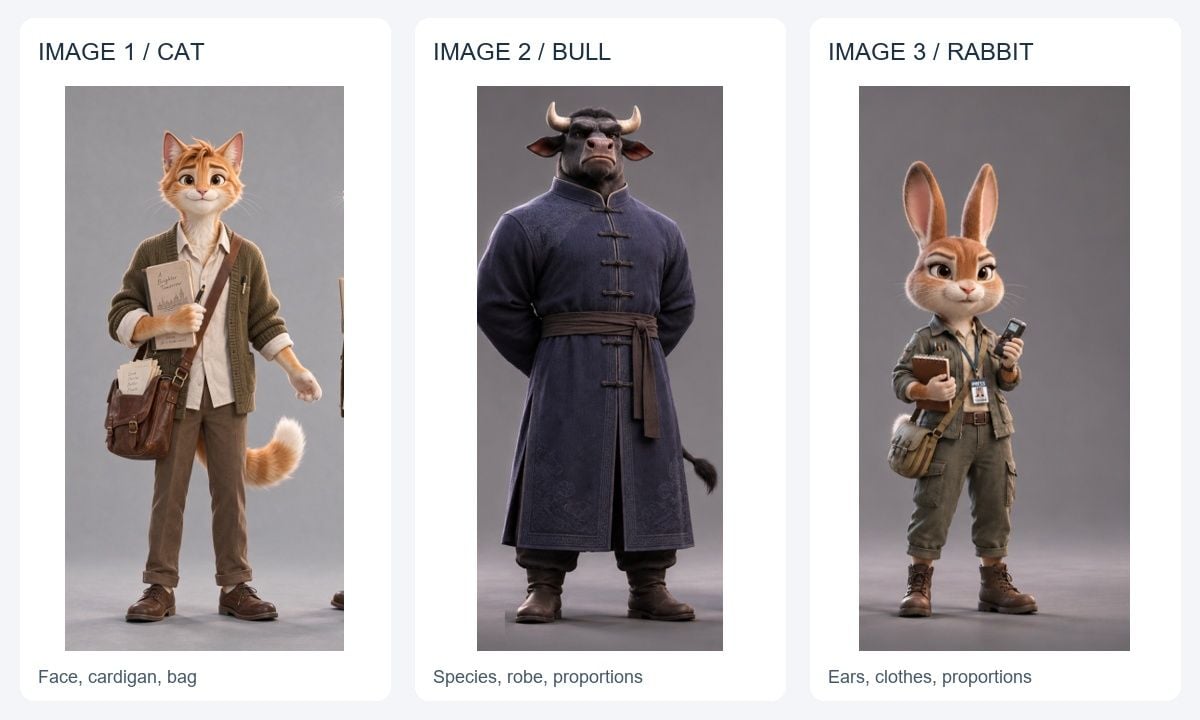
来自已发布的多角色 Seedance 2.5 Flash 演示的真实参考材料,为本示例裁剪并排列。下面的三角色面包店场景是单独生成并由文章创作者提供的原创变体。
| 上传 | 提供 | 不提供 |
|---|---|---|
| 图像 1:猫 | 脸、毛发、开衫和包 | 公牛或兔子的身份 |
| 图像 2:公牛 | 物种、深色长袍和更大的身体 | 猫的新服装 |
| 图像 3:兔子 | 长耳朵、服装和更小的身体 | 面包道具的替代品 |
原创制作简报,最终对话版本:
plaintext1Create a 15-second 3D animated bakery comedy, 16:9, with synchronized English dialogue. @Image1 defines the cat; @Image2 the bull; @Image3 the rabbit. Preserve identity, proportions and clothing. Omit the reference notebooks and phone. Warm morning light, detailed fur, tactile clothing, lively real-time movement and planted footsteps. 2 30-4s: The cat offers one paper bag containing a round loaf. The bull takes the handles and supports the base before the cat releases. 4CAT: "Fresh bread! Careful, it's warm." 5BULL: "Thanks. I've got it." 6 74-8s: The bull turns and lowers the bag to the approaching rabbit. The cat gestures toward the breakfast table. 8RABBIT: "Are we sharing that?" 9CAT: "Of course. Breakfast together." 10 118-12s: The rabbit takes the handles and supports the bag underneath. The bull releases only after the rabbit has a secure grip. 12BULL: "Support it underneath. Ready?" 13RABBIT: "Got it! Let's eat!" 14 1512-15s: The rabbit turns toward the table, and the others follow. Use readable cuts, natural weight shifts and visible hand contact. One bag and one loaf. Six distinct lines, no overlapping speech. Paper rustle and footsteps; no music, subtitles or logos.
用户提供的 15.04 秒面包店结果,作为带原始音频的完整视频保留。将两次交接与六行对话简报一起审查;所请求的对话和时间仍然是对照结果检查的说明。
将身份与交接分开判断。一个可识别的角色仍可能在袋子到达之前抓住它,或在接收者接触之前松开。直接标记该动作失败。下一次修订应解决转移问题,而不是增加更多关于视觉风格的文字。
BytePlus 提示词指南将主体参考与首帧输入区分开来。身份图像引导外观;首帧输入还锚定开场构图。根据你需要控制的决策在两者之间选择。
3. 选择任务并确定设置
在 Atlas Cloud 上,选择 Seedance 2.5 Flash Reference-to-Video 用于混合角色、产品、动作或音频参考。使用 Seedance 2.5 Flash Text-to-Video 进行书面调度测试。确认所选模型是 Seedance 2.5 Flash。
当前的 Seedance 2.5 Flash 路线支持 4–30 秒生成、原生 480p 或 720p 输出、可选同步音频,以及最多 10 个图像、5 个视频和 5 个音频参考。这些允许量并不保证主体一致。从最小且连贯的输入集开始。
当 4–6 秒镜头能回答该决策时,就使用它。宽泛调度可在 480p 下评估;更精细的接触或产品检查可能需要 720p。在表单中选择时长、比例、分辨率和声音,然后确认每个控件都保留了其选择。提示词措辞不能确定表单提交了什么。
案例 3:微型邮政机器人
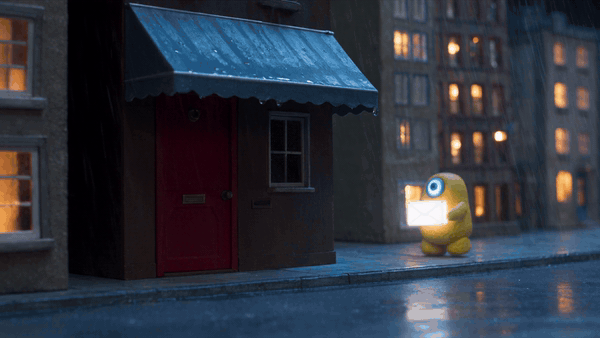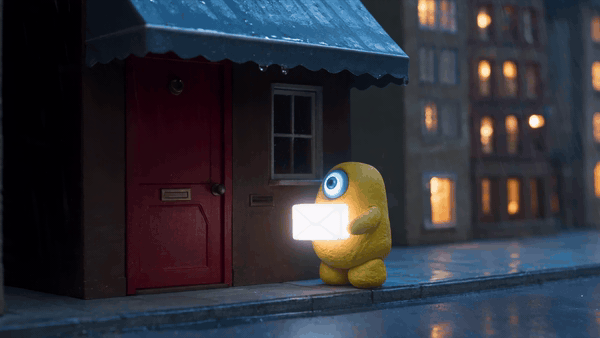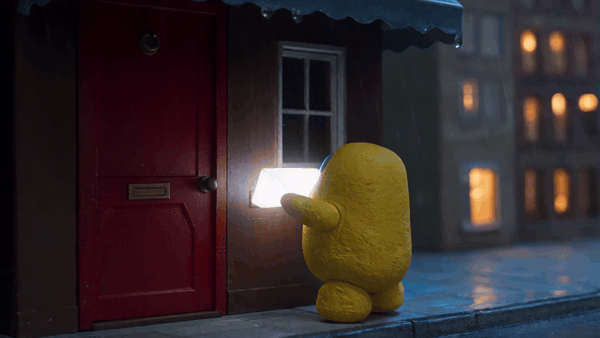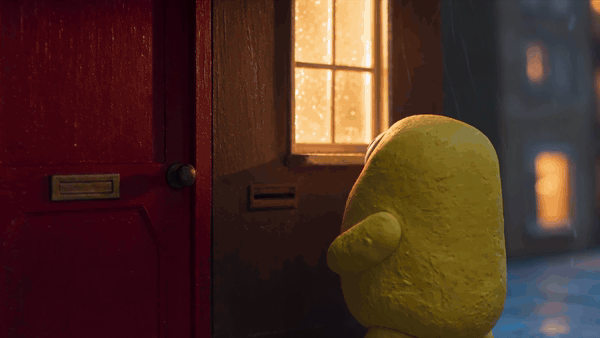
已发布的完整 8.06 秒预览,转换为无声 GIF。此来源示例使用文本到视频,而不是提供的首帧。其来源致谢见下方案例 4。
基于来源的提示词胶囊,经过压缩而非逐字原文:
plaintext1An 8-second miniature rainy street shot: a yellow postal robot with one blue eye carries a glowing envelope to a red door and posts it. After delivery, illuminate the window above the door. Keep the robot, envelope and door consistent, with clay materials, rain and small mechanical steps. No dialogue, captions or cuts.
可见的投递位置与请求的布局不同。对于严格的故事板,准备一个已批准的首帧,同时显示门、投递口和窗户,然后测试动作是否遵循这些位置。该提议改动尚未由此来源片段证明。
将该构图决策与模型设置分开。更高分辨率不能修复含糊的位置描述。更长时长不能确保信封进入预期的开口。给模型清晰的视觉证据,并检查物理关系。
参考生成、编辑和延展也有不同约束。在当前 Atlas Cloud 路线上,显式子任务参数仅限 API;不要假设浏览器会暴露对应按钮。严格编辑使用源视频并保留其宽高比,同时有自适应比例和自动时长要求。将重新构图视为单独操作。
4. 生成带有可观察动作的基线
基线应回答核心动作和构图是否有效。将次要风格决策留到后续变体。如果每个请求都改变主体、光线、镜头、环境和动作,下一个结果几乎无法告诉你哪个选择起了作用。
对于产品影片,写一份买家会注意到的属性短清单:轮廓、瓶盖结构、材质、标记和可见连接。在完整镜头运动中检查这些。准确的开场帧不能验证中间或结尾。
案例 4:琥珀玻璃香水研究
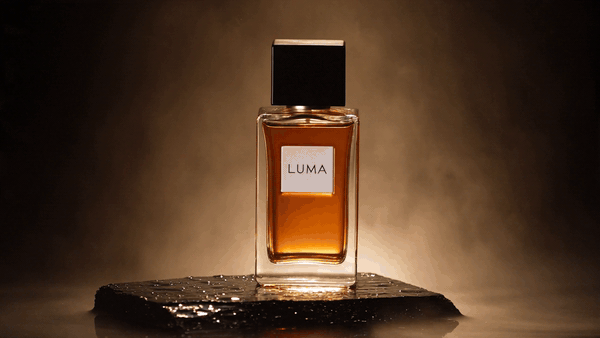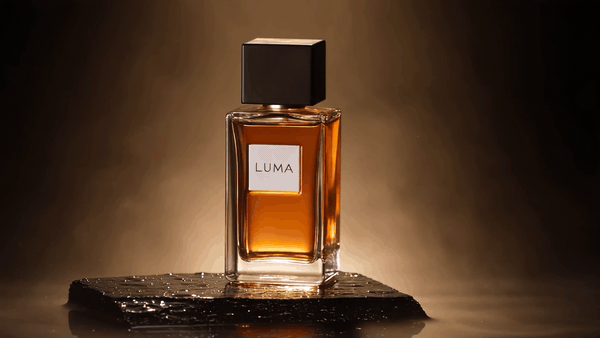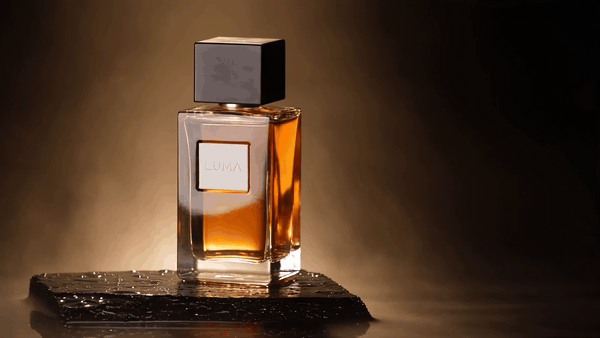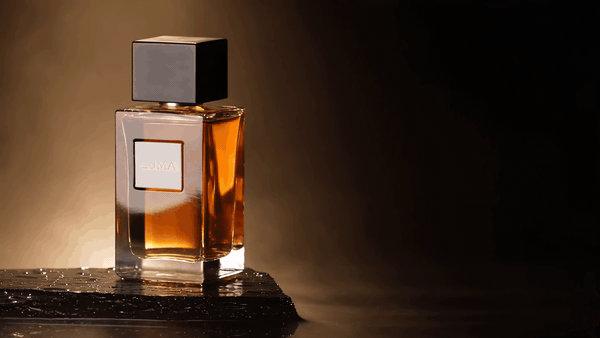
已发布的完整 8.06 秒产品研究,以无声 GIF 显示。案例 3 和 4 来自同一已发布测试和提示词记录;来源细节保留在媒体来源记录中。
基于来源的提示词胶囊,经过压缩而非逐字原文:
plaintext1An 8-second perfume shot: one rectangular amber bottle with a black cap and a LUMA label stands on wet dark stone. Arc from a frontal view to a three-quarter view, retaining the product and reflections. Finish with the complete bottle left of center and dark space for copy. Warm backlight, light mist, no cuts or additional bottles.
使用开场帧和最终帧审查所请求的产品处理,然后检查中间的运动。已发布结果中标签的对比度发生变化。因此,真实品牌批准应包括包装检查,而不是仅凭结尾构图就接受该片段。
将准确的优惠文本、价格、标题和 CTA 保留在编辑器中。这些元素通常需要独立于产品表现进行修订。干净的源片段允许另一种文案处理,而无需让模型重新创建物体。
如果你将此概念修订为液滴演示,定义新动作并创建另一个结果。不要将新说明与现有弧线搭配,并暗示液滴发生了。液滴演示需要自己的产品参考、动作提示词和新生成的结果。
5. 围绕一个决策批量测试创意
批量测试从矩阵开始,即使任务是一次提交一个。它不需要未经验证的批量生成功能。冻结基线,命名改动,只排队有助于解决它的变体。
三个开场和两个镜头选择可以变成六种组合。先筛选三个开场,然后尝试所选开场的替代构图,会产生四个初始候选。这是规划算术,而不是对交互的详尽测试,也不是经过测量的节省。
案例 5:来自一个参考的三个咖啡广告方向
此制作示例在三个八秒竖版片段中使用一个共享的杯子、壶、桌子和灯光参考。最终简报改变完整动作:香气与倾倒、搅拌,然后提起并放回杯子。将此视为对创意方向的探索性筛选。它并不单独隔离开场,也不衡量哪个方向卖出更多咖啡。
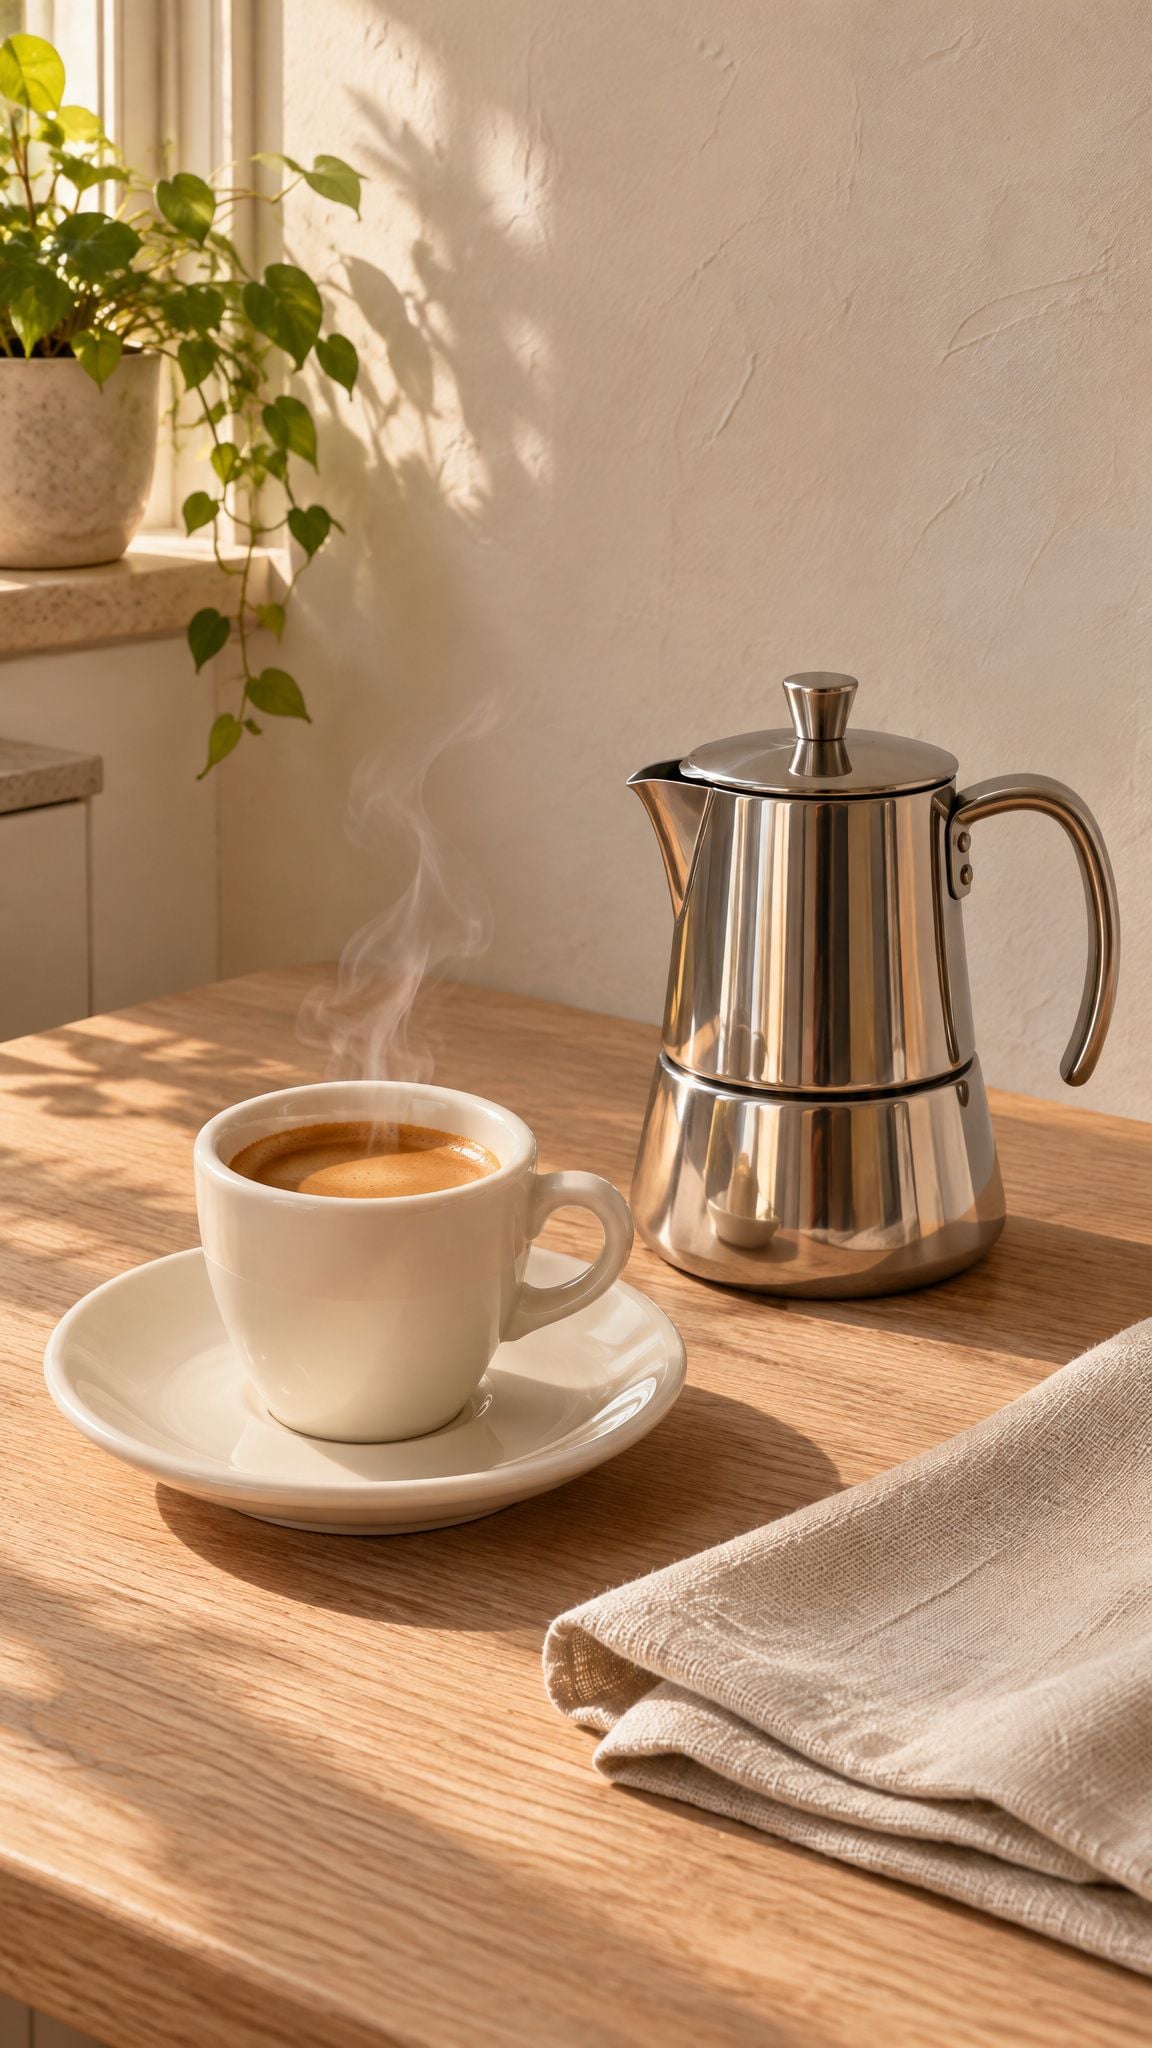
随生成片段提供的实际共享参考。用它比较三个方向中的杯柄、碟子、壶和光线。
| 变体 | 故意改变的动作 | 物理检查 |
|---|---|---|
| A:香气与倾倒 | 蒸汽细节过渡到可见的咖啡倾倒 | 水流连接壶嘴和杯子;在壶移开之前停止倾倒 |
| B:搅拌 | 一只手稳住杯子,另一只手搅拌 | 勺子进入咖啡;杯子和碟子保持支撑 |
| C:提起并放回 | 一只手提起杯子并放回 | 抓握先于提起;底部在释放之前接触碟子 |
原创制作简报,经过压缩:
plaintext1Shared: 8 seconds, vertical 9:16. Use @Image1 for the same cream-white cup and saucer, metal pot, pale oak table, linen and soft morning light. Preserve product geometry and warm-neutral colors. Every object movement needs visible hand contact. No branding or generated copy. 2 3A / Aroma and pour: 40-2s: Steam close-up; rack focus toward the cup rim. 52-5s: A hand pours a connected espresso stream into the cup. 65-8s: Stop pouring, place the pot on the table and withdraw the hand. Finish with a small sideways camera move and a clear product view. 7 8B / Stir: 90-2s: One hand steadies the handle; the other lowers a teaspoon. 102-5s: Make two small stirring circles, with gentle liquid ripples. 115-8s: Lift the spoon, let a drop return to the coffee, then place it on the linen and withdraw both hands. Keep the cup and saucer still. 12 13C / Lift and return: 140-2s: A hand visibly establishes a secure grip on the handle. 152-4s: Lift the upright cup a short distance above the stationary saucer. 164-5s: Hold it in the window light as the camera moves slightly sideways. 175-8s: Lower the cup onto the saucer, then release and withdraw. 18 19Natural room tone and object sounds in the source clips; no voice or music. The article GIFs are silent visual previews.
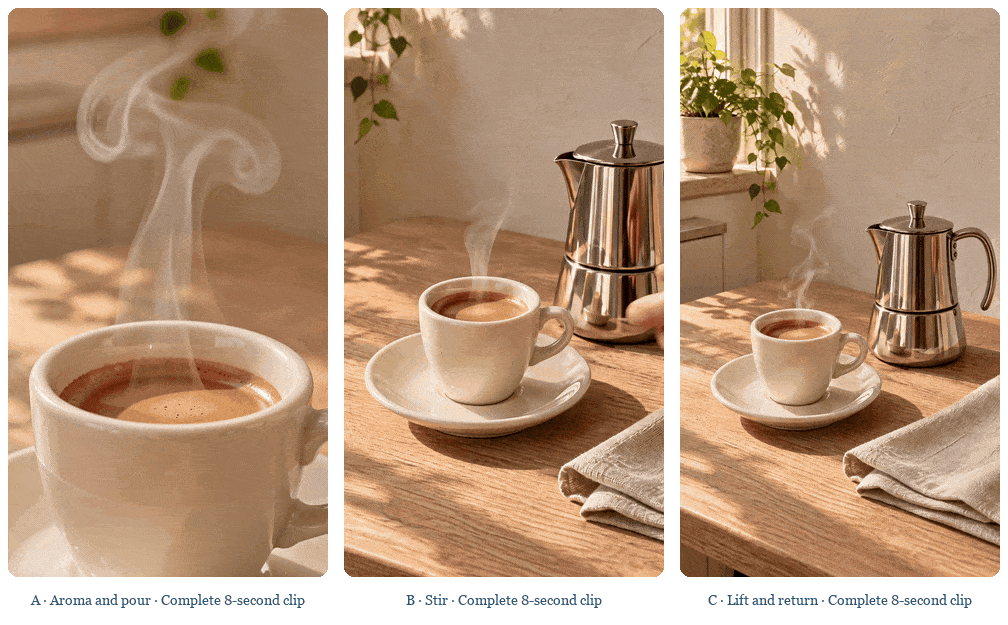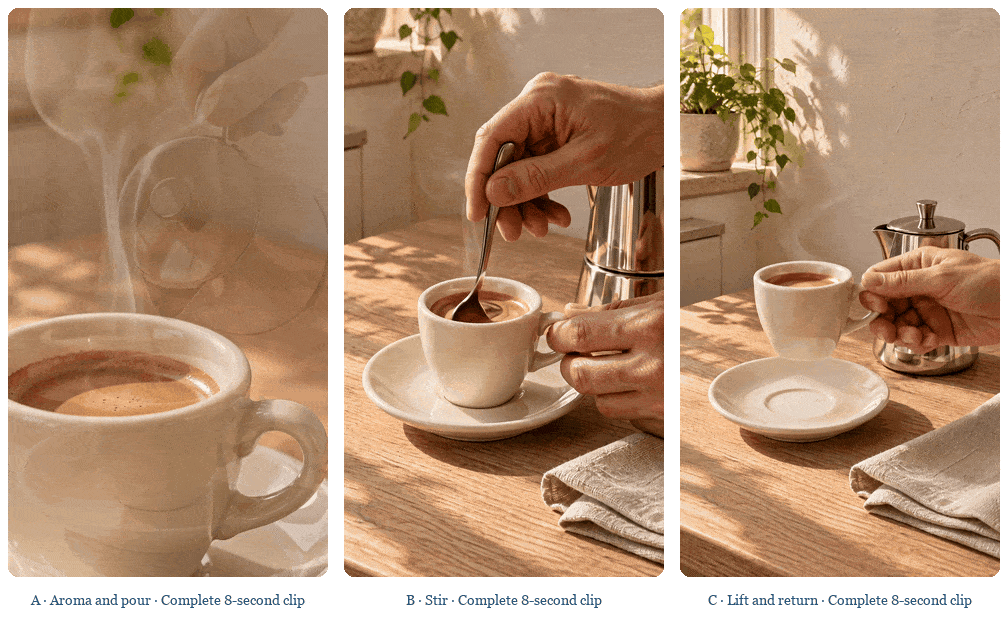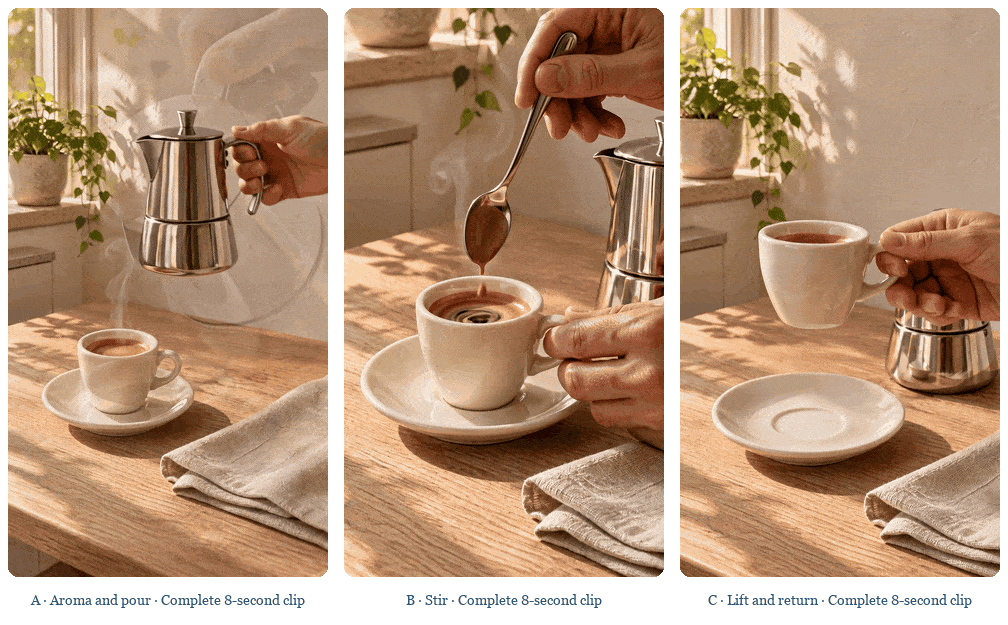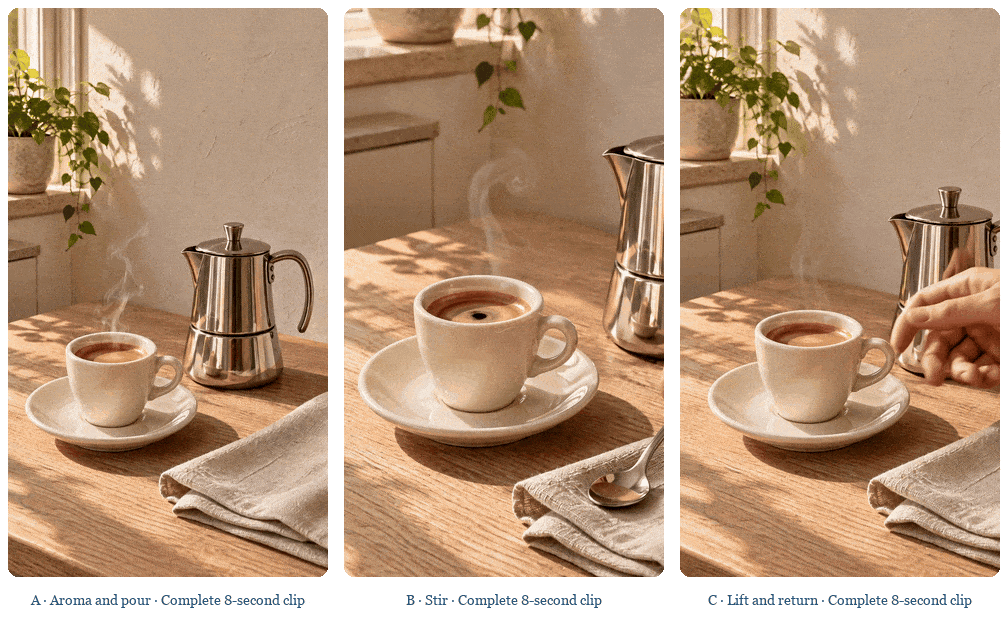
三个完整的用户提供结果同步在一个无声比较 GIF 中:A,香气与倾倒;B,搅拌;C,提起并放回。它们的动作和构图不同,因此结果差异可能有多种原因。共享参考支持比较,但不会使输出完全相同。
对于受控开场测试,选择一个已通过的主体和结尾,然后在编辑器中附加替代开场,同时保持优惠、文案和活动条件不变。记录用于测试的实际剪辑。将这些完整序列概念放在单独的创意 ID 下,而不是将其标记为已完成的仅钩子实验。
在将选定的方向视为可复用配方之前,先做一次重复。如果两个镜头不一致,检查参考包和动作描述。一个有用的镜头是你可以保留的素材,而可重复性是一个单独的问题。
plaintext1SHOT_ID / VARIANT_ID / PARENT_TAKE 2MODEL_AND_MODE / ORDERED_REFERENCE_FILES / PROMPT_VERSION 3REQUESTED_SETTINGS / ACTUAL_DURATION_AND_DIMENSIONS / AUDIO_PRESENT 4CHANGED_VARIABLE / ISSUE_AND_TIMESTAMP / ACCEPT_OR_REVISE 5ACTUAL_CHARGE / REVIEW_MINUTES / FINAL_EDIT_USED
制作审查可以确定动作是否清晰。广告表现需要活动数据。TikTok 的广告测试指南建议定义目标、控制变量、有意义的样本,以及与活动目标匹配的指标。将创意 ID 带入活动日志,并保持投放条件可比。
6. 当缺陷是局部时,编辑选中的镜头
在编写另一个请求之前,先对失败进行分类。服装颜色错误是外观问题。手从未接触到产品是动作问题。解释谜团的结尾是写作问题。编辑一种颜色不能解决所有三个问题。
当源提供你想保留的镜头、时间和表演时,使用视频编辑。命名源、目标、区间、请求的改动和不受影响的内容。保留说明定义了任务;返回的视频仍需要与其源进行比较。
案例 6:象牙色外套变为蓝色外套
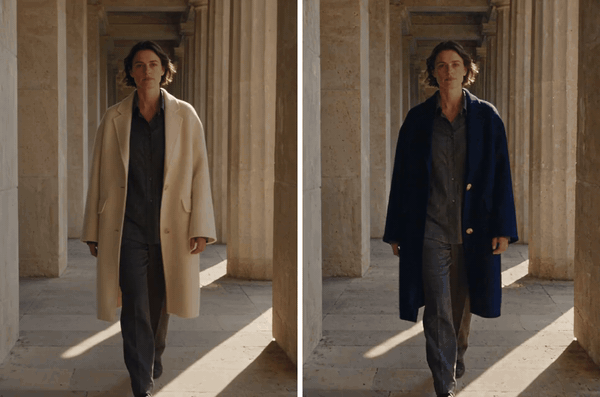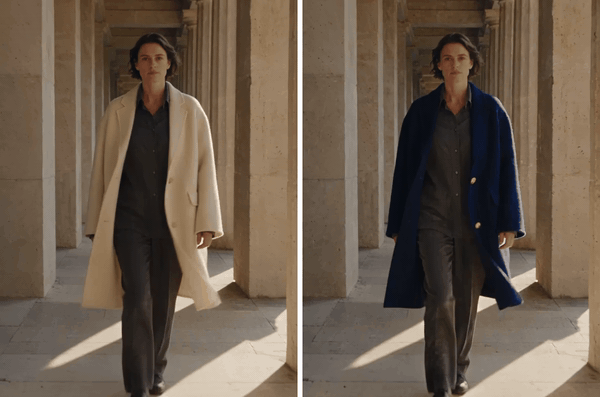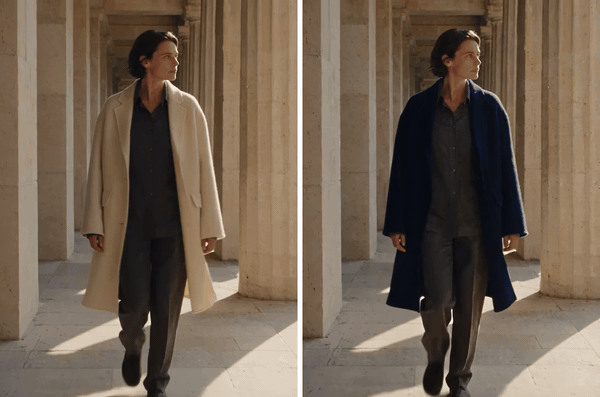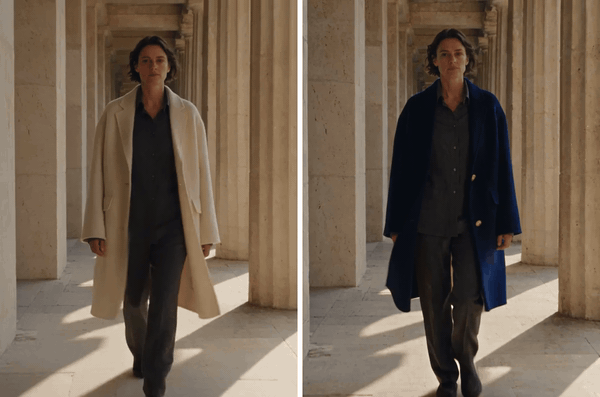
已发布的服装编辑:左侧为源,右侧为编辑结果。两个完整片段均以原生速度播放。编辑侧结束得更早,并保持其最后一帧。致谢:创作者的前后对比帖子。
基于来源的提示词胶囊,经过压缩而非逐字原文:
plaintext1Edit the source video by changing the ivory wool coat to deep petrol blue. Retain its cut, length, fastenings, folds and texture. Preserve the person, other clothes, walk, camera, courtyard, light and original sound. Request the same continuous action with no new shots or text.
下载的容器长度分别约为 6.08 秒和 5.73 秒。该比较保留了这个差异,而不是修剪源来隐藏它。在批准替换之前,检查移动的下摆、扣件、脸部和画面边界。
比较受影响的区间及其周围内容。如果校正产生了不同的手或脸,该新失败也属于决策的一部分。将原始源保留在每个修订旁边,以便下一位编辑可以恢复已通过的表演。
当动作或空间关系错误时,重新生成受影响的镜头。回到其起始和结束状态,然后更改能解释失败的最小说明。不要不断向一个包含不兼容动作的简报追加禁止项。
当已通过的结尾需要延续时,使用延展。说明什么延续下去,以及接下来是什么新节拍。仅凭最后一个姿势可能无法确立身体的运动相位,因此在进一步延展序列之前,以正常速度检查衔接处。
7. 在批准批次之前组装序列
一旦完整动作可用,就将已通过的片段放入粗剪。一个镜头可以单独成立,但在剪辑点失败。检查衔接处的屏幕方向、道具状态、光线、服装和声音;以正常速度观看后检查相邻帧。
编辑可以缩短停顿、放置反应或替换不需要的声音。缺失的物理动作可能需要另一个镜头。在花费另一次生成去解决时间线调整就能解决的问题之前,先确定实际修复方式。
案例 7:一片叶子、一个秋千和一个彩绘花园结尾
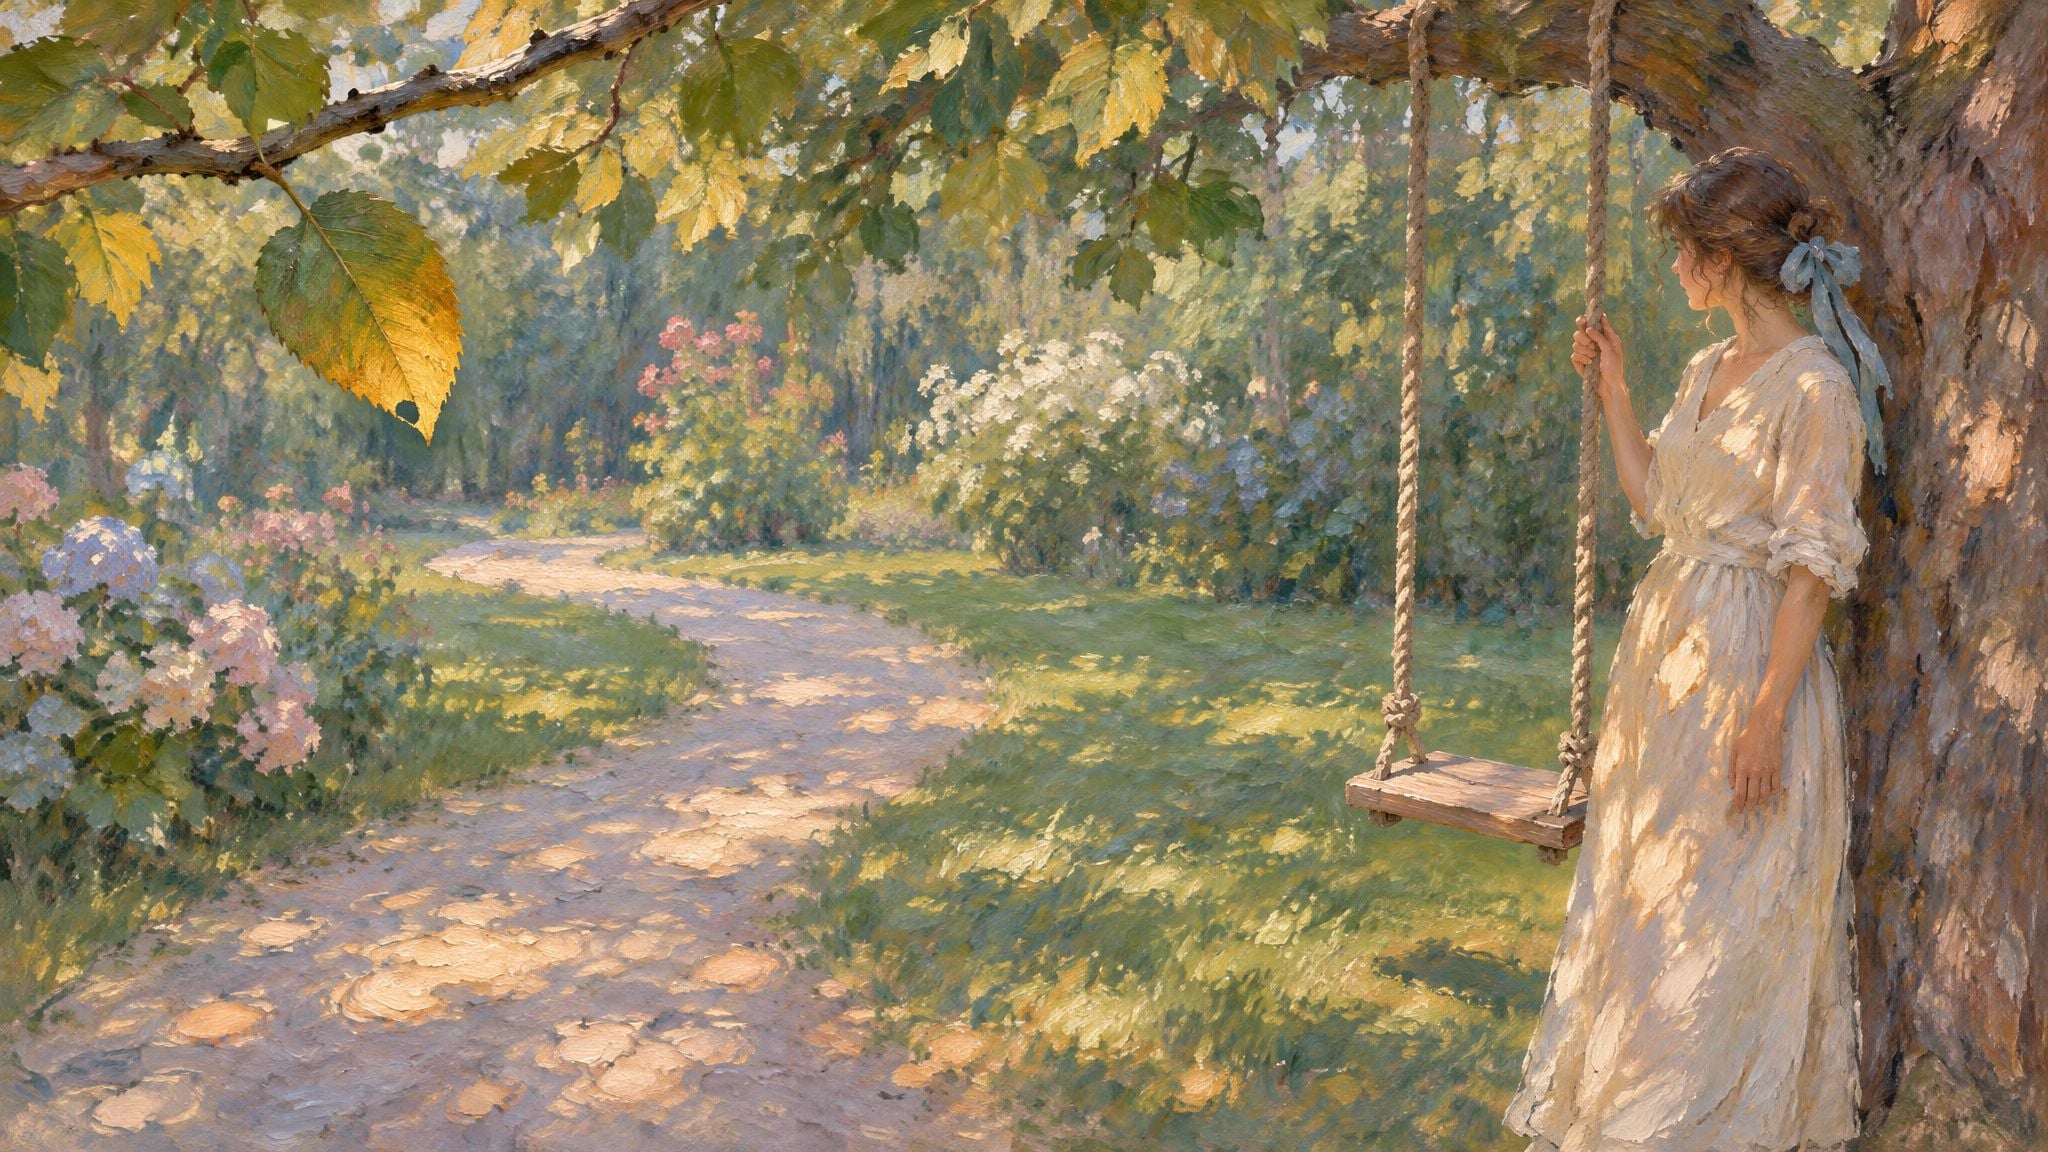
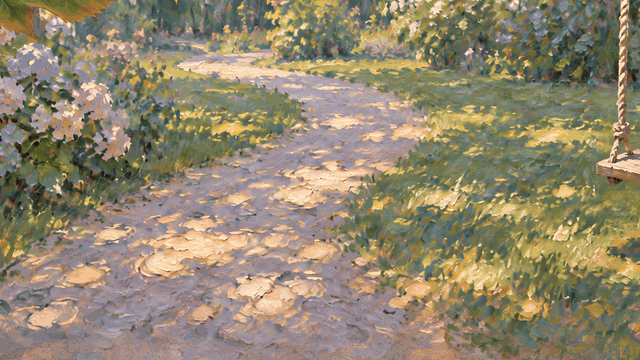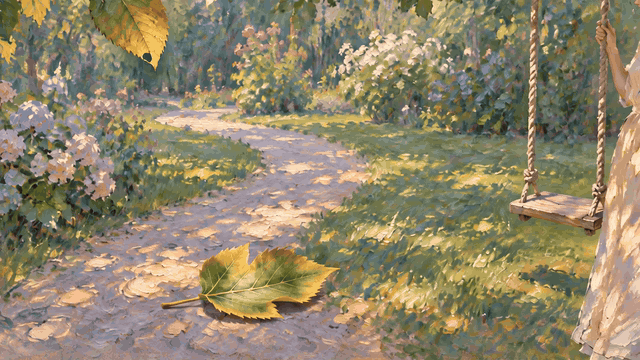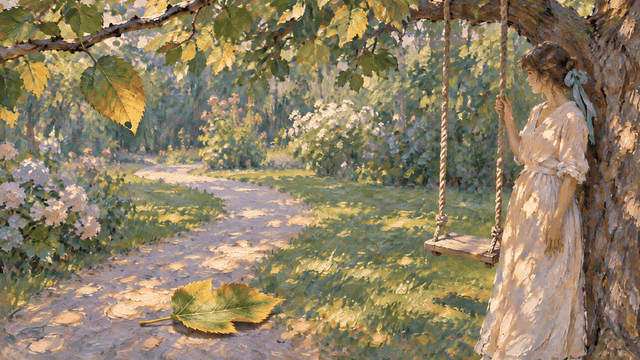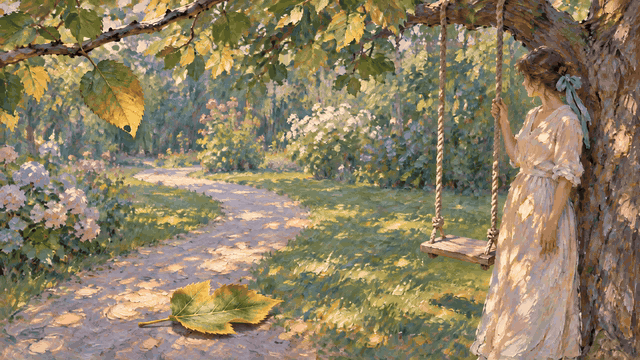
此画廊式制作使用三个独立的五秒镜头:一片飘落的叶子、一位在秋千上轻轻移动的女士,以及一片落在花园小径旁的叶子。一个共享参考提供女士、象牙色连衣裙、蓝色丝带、树、秋千和彩绘光线。每个镜头为剪辑贡献不同的主体或尺度。
文章创作者提供的完整花园参考。这取代了此处展示的早期仅叶子风格插图,作为制作输入。
原创制作简报,最终三镜头版本:
plaintext1Shared: Use @Image1 for the same garden, woman, ivory dress, blue hair ribbon, wooden swing and warm-green light. Generate three separate 5-second 16:9 clips. Preserve layered oil brushwork throughout; no change to live action, generated lettering or music. 2 3A / Leaf departure: 4Begin close to the notched green-gold leaf on a low branch. A breeze bends the stem; the leaf detaches and drifts diagonally down-right. Track sideways and end while the complete leaf is still moving. 5 6B / Swing cutaway: 7Begin with the woman seated, both hands holding the ropes and both feet touching the ground. She pushes gently with her feet, lifts them slightly, and swings through a small natural arc. Keep the seat supporting her, ropes taut and dress movement subtle. Show her whole seated figure from the side. Do not follow a falling leaf in this shot. 8 9C / Landing and reveal: 10Begin low beside the pale path. The leaf enters from upper left, lands and comes to rest. Rise into a wider garden view, preserving the resting leaf, woman and swing, with quiet space for later copy.
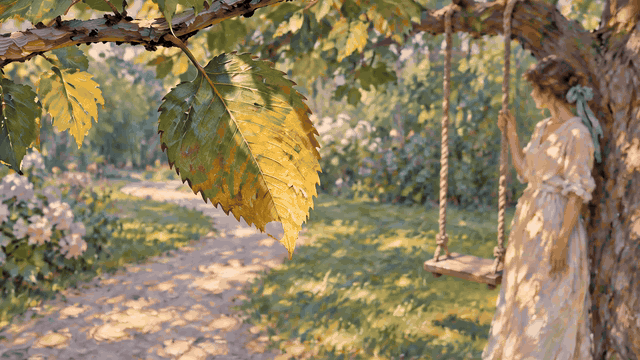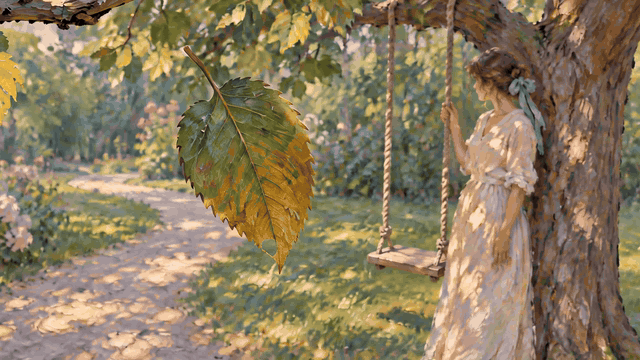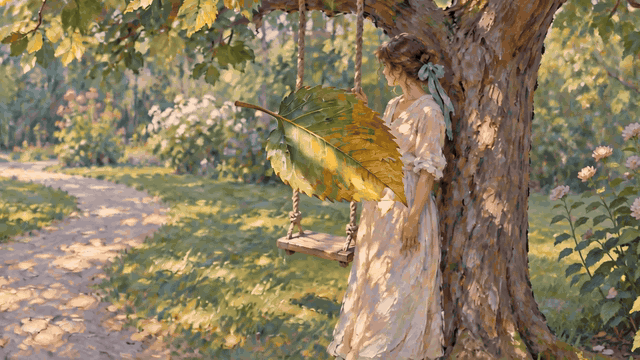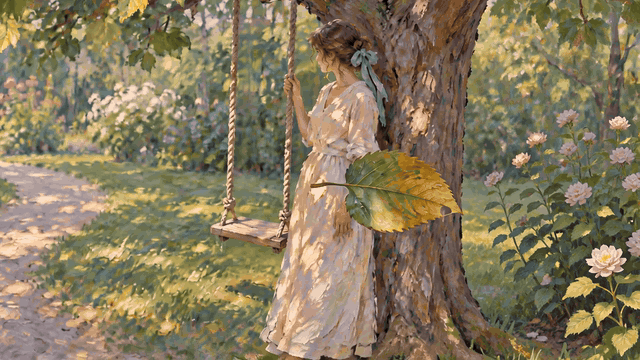
A · 叶子离开。完整的五秒用户提供片段,以无声 GIF 呈现。
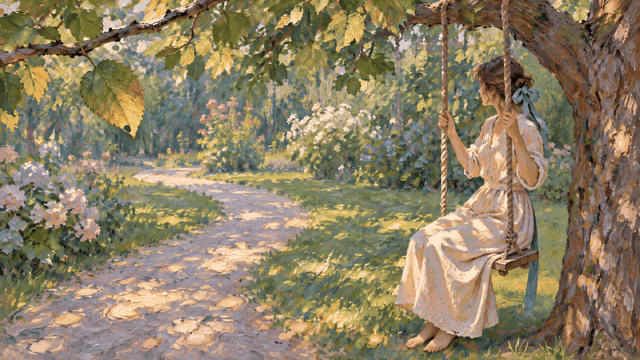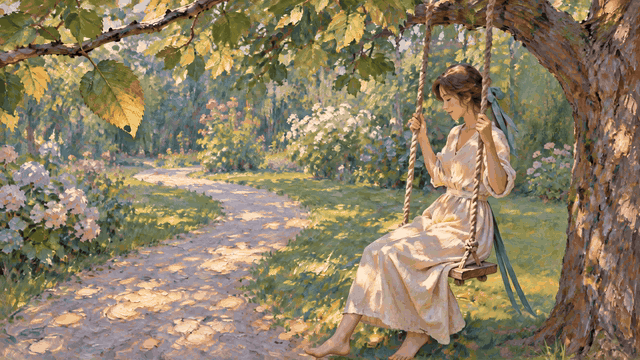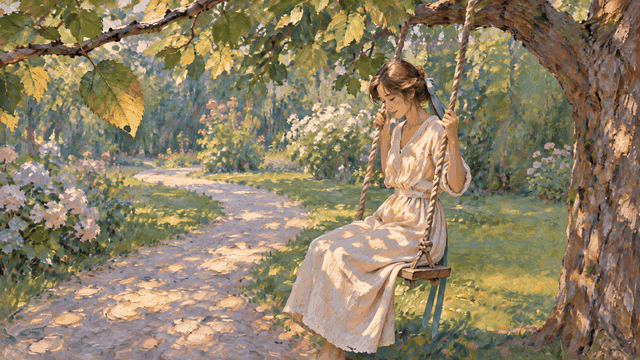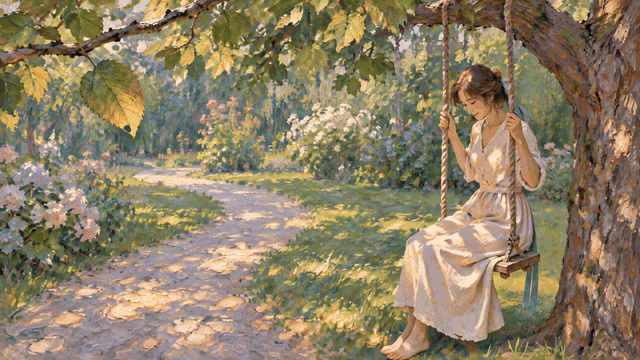
B · 秋千切换镜头。一个单独的角色动作取代了早先第二个跟随叶子的镜头。完整五秒片段,以无声 GIF 呈现。
C · 落地与花园揭示。完整五秒片段,以无声 GIF 呈现。
在组装之前,将这些作为单独镜头审查。B 显示叶子仍在树枝上,并将女士的姿势改为坐姿;C 回到站立人物。因此,共享参考并未建立不间断的道具和姿势连续性。B 可以作为有意的切换镜头使用,但严格的连续事件需要在衔接处匹配角色状态和叶子位置。替换那个镜头比称该序列无缝更精确。只有在选定的剪辑成立后,才添加展示文案。
最终交付干净的源片段、最终时间线、有序参考、提示词版本、实际输出规格、批准说明和费用日志。将品牌导出与干净素材分开,以便下一种格式或语言修订不需要重新创建每个表演。
将每个已通过镜头的成本衡量为总实际生成费用,包括被拒绝的尝试和编辑,除以已通过镜头数。单独记录审查和组装时间。例如,八次尝试产出三个已通过镜头,得到 37.5% 的通过率。这是假设性算术,不是 Seedance 2.5 Flash 基准。失败类别告诉你应改进参考、简化动作,还是选择另一条路线。
常见问题
Seedance 2.5 Flash 能生成完整的短剧集吗?
单次生成当前支持最长 30 秒。用已通过的片段构建更长的剧集,并在剪辑中审查连续性。多镜头文件不保证不间断镜头,也不消除转场检查。
应该上传每个参考吗?
使用定义所需主体和动作的最小连贯集合。当另一个角度提供缺失证据时再添加。不同的产品版本或不兼容的服装会使下一个结果更难诊断。
提示词胶囊会完全复现已发布的请求吗?
它们是源说明的简短英文摘要。完整源细节保留在文章的媒体来源记录中。面包店、咖啡和花园简报是原创制作方向;其用户提供的结果嵌入在旁边。提示词描述所请求的动作,因此将其与实际输出比较,而不是假设每条说明都被遵循。
编辑能保证其他一切保持不变吗?
将完整修订与其源进行比较,包括未受影响的区域、声音和长度。仅成功的颜色更改不能确立所有其他内容都得到保留。
已通过的 Seedance 2.5 Flash 片段必须在另一个模型中重新生成吗?
保留符合交付简报的素材。如果另一个输出规格需要另一个模型,转移已批准的参考和镜头简报,再次生成,并审查新结果。不要假设已通过的表演会原样转移。




