


一位舞者转身,但镜头却丢失了她的双脚。一则产品广告在播放中途换掉了瓶子。一个情感场景在你想要安静反应时加入了演讲。每份创意简报都留下了不同的未决决策。
这份 Seedance 2.5 Flash 提示指南与示例 从一个实用公式开始:确定主体、描述可观察的动作、建立场景、指导镜头,并指定声音。当你上传参考素材时,为每个文件分配明确的职责。下面 12 个可复制提示将这一方法应用于舞蹈、广告、动作、情感、动画和环境音。
关键要点
- 编写观众能够识别的动作,然后定义其开始和结束。
- 将镜头运动与主体运动分开,并将时长放入实际生成设置中。
- 为图像、视频和音频参考赋予不同的职责。
- Seedance 2.5 Flash 支持原生 480p 和 720p 输出;标准 Seedance 2.5 规格不会自动适用。
- 根据几项验收检查审阅完整片段,然后一次只更改一条指令。
从正确的 Seedance 2.5 Flash 模式开始
在打磨提示之前,先选择你的输入模式。文生视频在场景可以自由描述时很有用。图生视频从特定图像开始。参考生视频在你希望将选定的身份、运动、场景或声音信息带入新构图时很有用。
在 Atlas Cloud 上,这三种模式有单独的 Seedance 2.5 Flash 模型条目。检查完整名称,包括“Seedance 2.5 Flash”和输入模式。将产品图像上传到首帧工作流,与将其用作宽松的产品参考,是不同的创意决策。
| 你的起始素材 | 合适的模式 | 主要写作任务 |
|---|---|---|
| 没有上传媒体的想法 | 文生视频 | 建立主体、动作、场景、构图和声音 |
| 应该作为镜头开头的图像 | 图生视频 | 解释什么开始移动以及场景如何发展 |
| 单独的外观、运动或音频参考 | 参考生视频 | 为每个输入分配角色并描述新场景 |
| 你打算修改的现有片段 | 通过参考工作流进行视频编辑 | 说明更改并保留相关源内容 |
当前的 Atlas Cloud Seedance 2.5 Flash 文生视频条目支持 4–30 秒生成、480p 或 720p 输出、可选宽高比和生成音频。对于此处的示例,使用 720p 和 MP4,然后设置提示旁边列出的时长和比例。这些是起始设置,并不保证所请求的编舞或时间安排会成功。规格已于 2026 年 11 月 17 日检查。
让片段长度与其目的挂钩。一个 8 秒的镜头可以建立主体、发展一个动作并落到一个结尾。更长的序列需要足够的新动作来证明额外时间的合理性。用一个模糊指令填满 30 秒会留下许多未决决策。
当你需要从开场帧就呈现可识别的产品时,使用 Seedance 2.5 Flash 图生视频条目。此模式使用自适应宽高比,保留源图像的比例。以你实际想要动画化的构图准备图像。紧凑的产品特写无法在不发明信息的情况下揭示缺失的腿部或整个房间。
提示公式:从想法到可拍摄的简报
官方系列教程建议组织主体、动作、环境、视觉风格、镜头方向和声音。其记法用圆括号区分音乐,用尖括号区分效果,用花括号区分对话,用特殊括号区分字幕。这些是文档化的写作惯例;它们不是设置控件。(BytePlus 系列教程,2026 年 11 月。)
使用这个紧凑的工作公式:
主体 + 可观察动作 + 场景 + 视觉处理 + 镜头起始/路径/结束 + 声音 + 关键连续性。
最后的连续性行是本指南中的编辑补充。它告诉你,在决定是否保留一条镜头时,哪些细节重要。其他字段帮助将一个想法转化为你可以想象和检查的内容。
plaintext1[具有 2–3 个定义细节的主体] 执行 [一个可观察动作] 2在 [具体场景] 中,采用 [灯光和视觉处理]。 3 4开场:[景别、角度、主体位置]。 5发展:[动作进展和镜头运动]。 6结尾:[最终动作和构图]。 7 8声音:[对话或前景事件],伴随 [背景层或音乐]。 9连续性:[要保留的身份、物体特征或空间关系]。
从观众应该注意到的变化开始。“一个女人感到如释重负”命名了一种情绪。“她松开握着信封的手,呼气,让肩膀落下”提供了可见行为。第二种描述即使面部表情微妙,也给了你一个验收检查。
使用少量识别细节。红色夹克、深色短发和银色单肩包可能比一段罗列每条缝线的文字更容易追踪。选择在预期构图中保持可见的细节。雕刻戒指在全身跑步镜头中作用甚微。
给场景一个物理功能。门口让角色可以进入并停下。附近的桌边为移动镜头提供深度线索。木板为刀声提供可见的接触面。这些细节让场景更容易导演和审阅。
考虑这个刻意模糊的简报:
plaintext1一个电影级高级瓶子广告,具有动态镜头运动和美丽灯光。
它未指定瓶子设计、运动、视角和结尾。一个更有用的修订版会说,一个琥珀色瓶子立在石质台面上,镜头从左侧前方移动到侧面轮廓,一个矩形窗户倒影穿过玻璃。然后你可以分别检查瓶子轮廓、倒影和最终侧视图。
保持第一版可读。如果一条指令不会改变屏幕上或声音中应该发生的事情,考虑删除它。一堆华丽形容词可能掩盖模型需要解读的动作。
官方提示指南描述了先概述,然后详细镜头或时间线以及额外一致性说明。它还记录了剩余的局限性,包括不需要的字幕。将其示例视为系列指导,然后在你使用的模型中检查 Seedance 2.5 Flash 特定的限制。(BytePlus 提示指南,2026 年 11 月。)
编写具有可见回报的镜头方向
有用的镜头指令回答四个问题:镜头从哪里开始,镜头走什么路径,主体独立做什么,以及观众最后应该看到什么?你可以不用专业词汇来表达。
对于舞蹈片段,从实际要求开始:脚必须保持可见。然后选择广角或全身构图,并描述适度的镜头弧线。在同一短段落中要求特写、快速剪辑和不间断步法,会造成相互竞争的优先级。
对于产品镜头,决定应该出现哪个新表面。“绕着瓶子移动,直到其右侧变得可见”提供了一个目的地。“史诗环绕”命名了一种感觉,但没有定义镜头应该揭示多少新信息。
| 镜头请求 | 添加这个物理细节 | 在输出中检查这一点 |
|---|---|---|
| 跟踪镜头 | 镜头以相似速度在主体旁边移动 | 主体保持在构图中,同时周围环境经过 |
| 环绕 | 主体保持固定,镜头从一侧向另一侧移动 | 可见侧面和背景重叠一起变化 |
| 摇臂上升 | 镜头从低视角上升到主体上方视角 | 先前隐藏的顶部表面变得可见 |
| 横摇 | 镜头从指定位置转向指定目标 | 目标连贯地进入构图 |
| 特写 | 命名细节以及何时切到它 | 细节保持可读并与更广阔场景相连 |
在句子中将动作与镜头运动分开。“骑自行车的人经过商店;镜头在她旁边跟踪”比“一个扫掠、旋转的自行车手镜头”更容易解读。如果产品保持静止而镜头应该移动,明确说明。
对于 8 秒场景,两到三个节拍是有用的起草约束。它们是这些示例的编辑选择,不是官方镜头限制。留出时间让动作开始、发展和稳定。接住、冲刺、跳跃、落地、对话和反应通常需要比一个短片提供更多的空间。
时间戳描述预期时间。也在生成表单中设置实际时长。如果你要求 10 秒时间线,但将时长留为 5 秒,书面时间并不能修复这种不匹配。在判断节奏之前,检查下载片段的真实长度。
使用多模态参考而不混淆其职责
将参考选择视为向一个小型制作团队做简报。一个输入提供主体外观,另一个提供运动模式,第三个提供音乐或声音。在描述新场景之前解释这些分配。
Seedance 2.5 Flash 参考生视频条目 目前列出最多 10 张图像、5 个视频和 5 个音频片段。其模式将组合参考视频时长限制为 30 秒,组合参考音频时长限制为 30 秒。它使用索引令牌,如 @Image1、@Video1 和 @Audio1。在提交前确认你的界面显示的标签。
这些是 Seedance 2.5 Flash 限制,不是 Seedance 2.5 更大的参考允许量。更重要的是,最大值不是目标。从能解决你实际不确定性的最小参考集开始。三张冲突的服装图像可能比一张干净图像让主体简报更难解读。
| 输入 | 给它一个明确职责 | 指定什么可以改变 |
|---|---|---|
| 产品或角色图像 | 外观、轮廓、服装或材质 | 背景、姿势或构图 |
| 运动参考视频 | 特定动作、节奏或镜头路线 | 表演者、服装、地点和源声音 |
| 音频参考 | 节拍、声音特质或声音模式 | 无关源视觉和任何不需要的人声 |
| 首帧图像 | 镜头的开场构图 | 后续动作和视角 |
对于下面的舞蹈示例,上传一张干净的角色图像、一个短运动参考和一个音乐片段。提示告诉模型使用视频的运动,同时从图像中获取服装。没有这种分离,“遵循视频”也可能引入其服装、背景或镜头行为。
使用你拥有或有权使用的素材,包括任何人的肖像或声音。真人输入要求可能因提供商和访问途径而异,因此遵循你选择界面中当前的上传和审核流程。参考的存在并不保证精确的身份或表演再现。
将参考与编辑保持区分。“将此片段中的运动用于一个新的舞者”请求一个新场景。“替换此片段中的表演者”要求修改所提供的视频,并可能激活不同要求。当前 Atlas 编辑模式要求自动时长并保留源宽高比。切换任务时重新检查这些控件。
如果参考与提示矛盾,在重试前解决冲突。一张紧凑裁剪的坐姿主体图像对于立即全身跳跃来说是一个薄弱的起点。使用更合适的图像或简化动作,而不是添加几行要求两个约束同时成立。
12 个可复制的 Seedance 2.5 Flash 提示示例
文生视频示例将提示与其结果配对。图生视频和图像参考示例还包括实际输入图像。案例 5、6 和 12 使用具有完整开场、发展和结尾的较长场景。
提示保留了已发布的场景简报,没有添加新镜头。这些是已发布输出,不是对下面所示确切措辞的新测试。案例 6 和 12 使用带声音的可播放视频。所有其他预览保持为无声 GIF;声音指令保留在提示中,以便在你生成自己的视频时使用。
1. 舞蹈:环绕镜头下的全身步法
模式: 文生视频。设置: 请求 5 秒,720p,16:9。
提示
plaintext1以全身景别拍摄一位三十多岁的男子,穿着翠绿色天鹅绒在日落屋顶上跳舞。 2 3镜头与运动 4缓慢环绕他;展示精确、流畅的步法以及他的夹克摆动。发光的天际线,温暖胶片色彩,24 mm。 5 6声音 7听到混凝土摩擦声、城市环境和微风;省略音乐。
生成结果
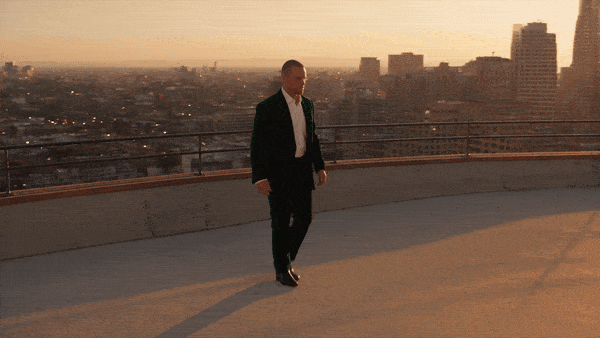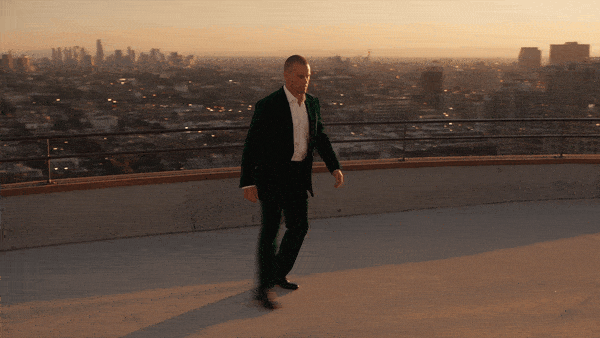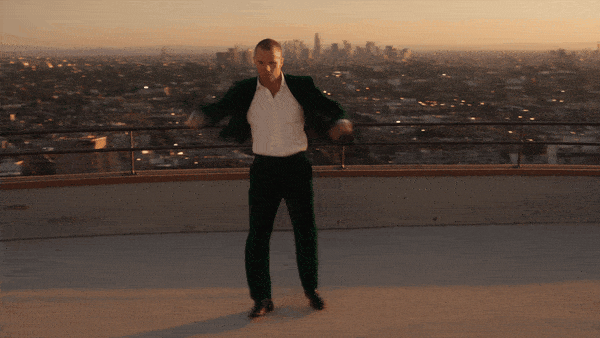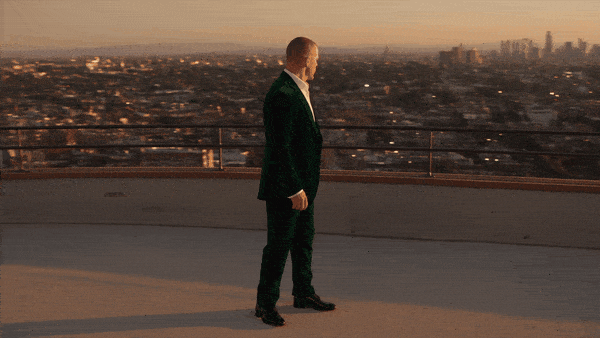
输出时长:5.06 秒。
全身视角让步法保持可读,同时移动的天际线揭示镜头的弧线。夹克在每次改变方向后摆动,给运动带来第二种视觉节奏。对于舞蹈简报,这种脚部接触、面料响应和镜头移动的组合比一长串情绪词汇更有用。
2. 美妆广告:玻璃、金属和液体揭示
模式: 文生视频。设置: 请求 5 秒,720p,16:9。
提示
plaintext1一个无品牌磨砂精华液瓶子,带有玫瑰金瓶盖,从乳白色液体中浮现。 2 3材质与镜头 4通过 100 mm 微距镜头以慢动作展示流动的水滴和扩散的涟漪。粉色背光和受控光线扫过揭示光泽玻璃。 5 6声音 7听到液体涌动和滴落,没有音乐。
生成结果
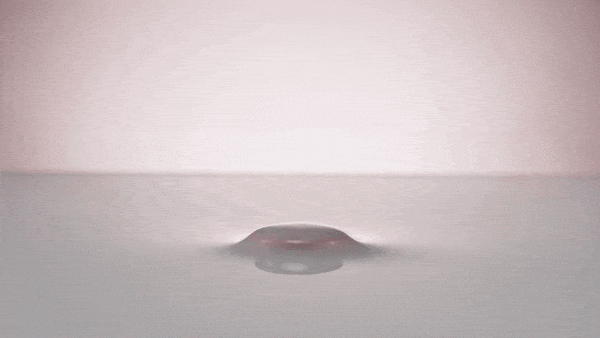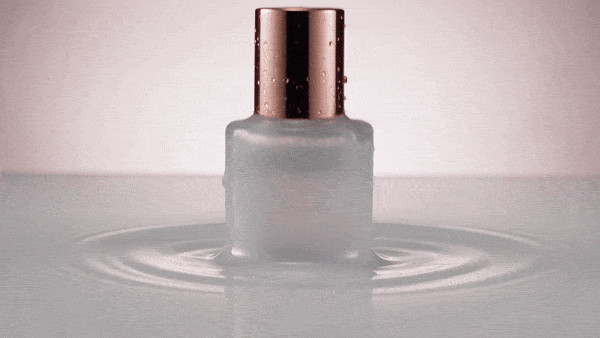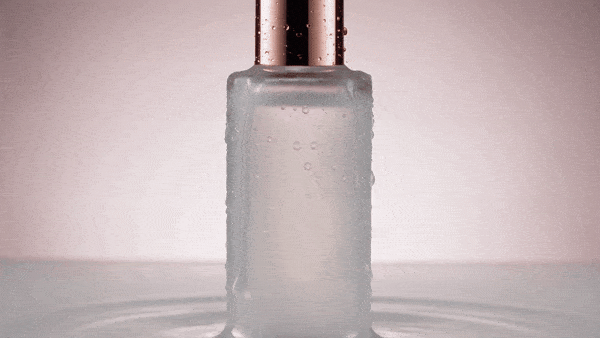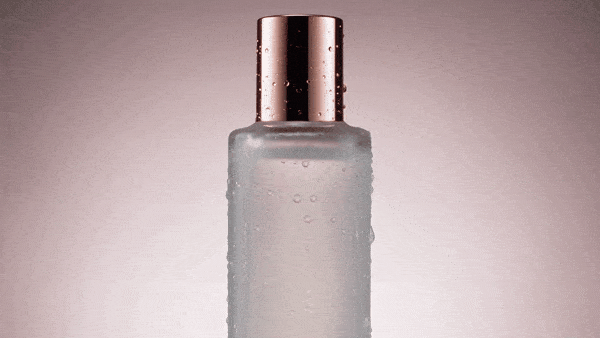
输出时长:5.06 秒。
瓶子从明亮的液体表面浮现,同时水滴和扩散的圆环使揭示变得可见。瓶盖捕捉到与磨砂玻璃不同的反射,因此材质对比在浅色调中依然存在。有用的提示细节是液体的运动和控制的光线扫过,它们给简单的产品构图提供了具体可做的事情。
3. 动作:接触瞬间的粉笔灰
模式: 文生视频。设置: 请求 5 秒,720p,16:9。
提示
plaintext1从下方拍摄一位扎辫子的年轻女性,穿着黑色运动服,将右直拳打入沙袋。 2 3灯光与镜头 4慢动作揭示手套粉笔灰和空气中的汗水。一束硬光穿过健身房雾气,高对比 35 mm。 5 6声音 7听到撞击、呼吸和链条嘎嘎声,没有音乐。
生成结果
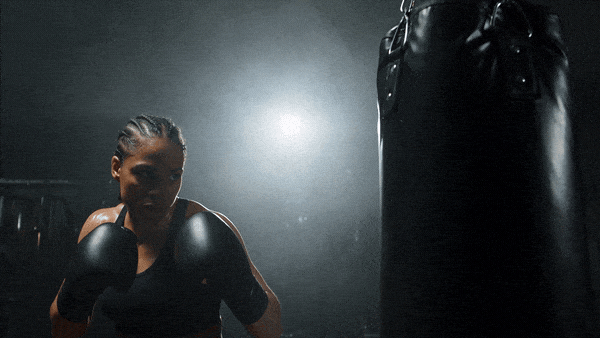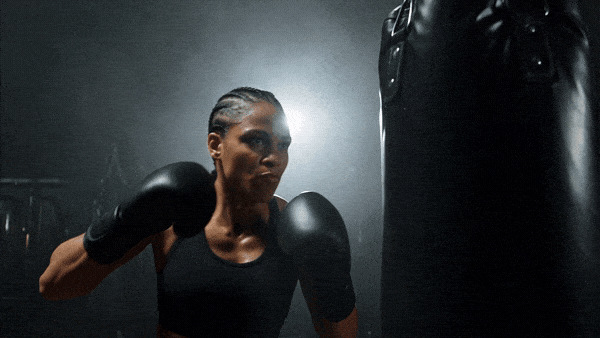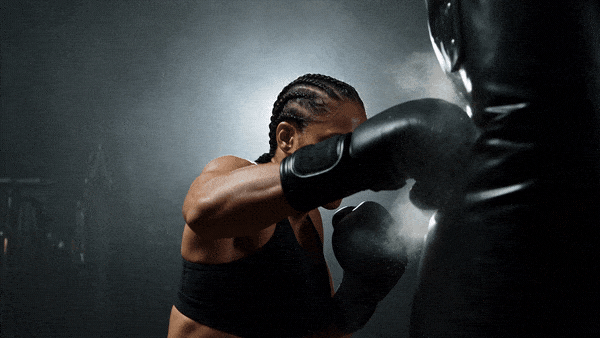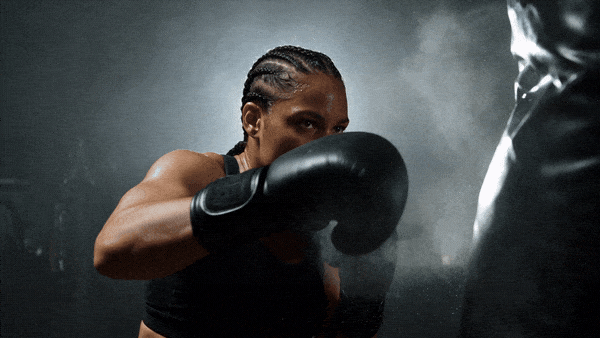
输出时长:5.06 秒。
手套在粉笔云在光线中扩散之前缩小了与沙袋的距离。这个顺序给冲击一个可见的原因和结果。黑暗的健身房和单一光束让小颗粒在没有繁忙背景的情况下保持可读。清晰的接触瞬间和可读的回弹给动作提示比单独“电影级冲击”这句话更多的方向。
4. 情感:动画化肖像而不发明新场景
模式: 图生视频,首帧输入。设置: 使用已发布的首帧;源未列出完整设置记录。
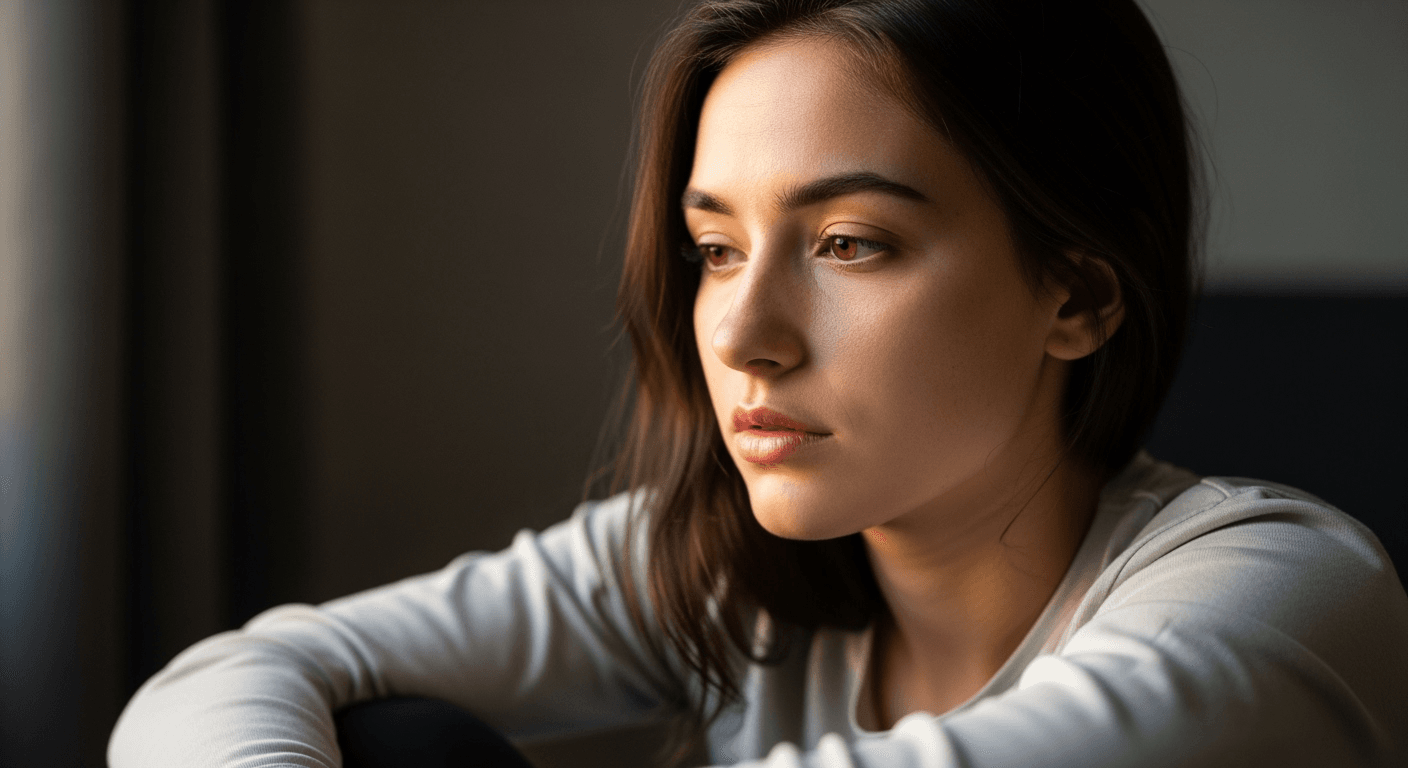
原始输入图像
提示
plaintext1动画化所提供首帧中的女性:让她逐渐转向镜头并形成温柔微笑,同时温暖日光穿过她的脸。镜头微妙地更近。包括微弱呼吸和室内环境音。
生成结果
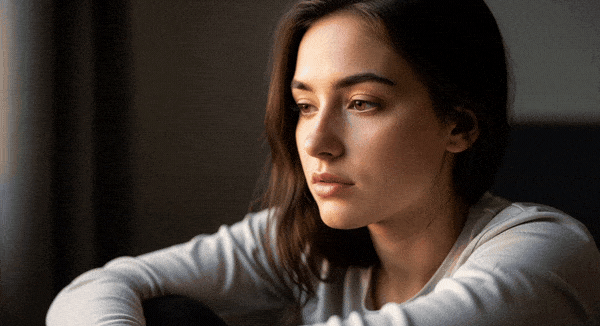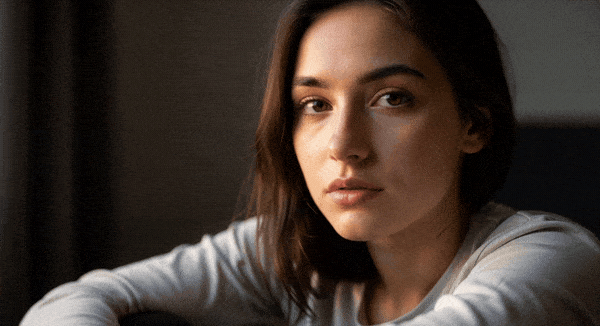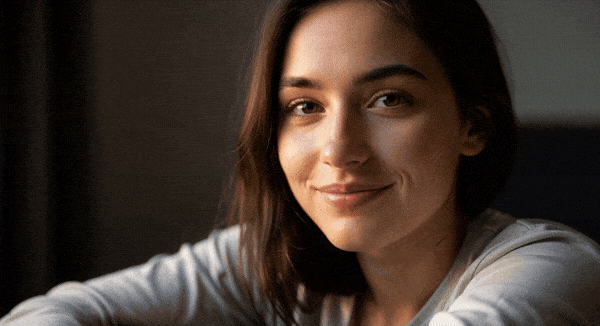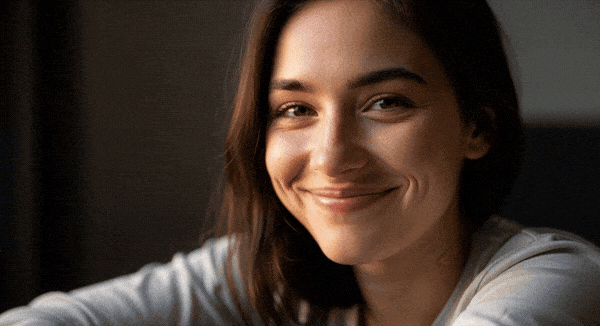
输出时长:5.06 秒。
原始肖像提供了脸、服装和窗边构图。在动画中,女性转向观众,她的中性表情展开为微笑。凝视的小变化承载了场景。当照片已有强烈构图且目标是克制的情感运动时,这是一个有用的图生视频模式。
5. 街头美食:纸灯笼下的 15 秒旅程
模式: 文生视频。设置: 请求 15 秒,480p,9:16。
提示
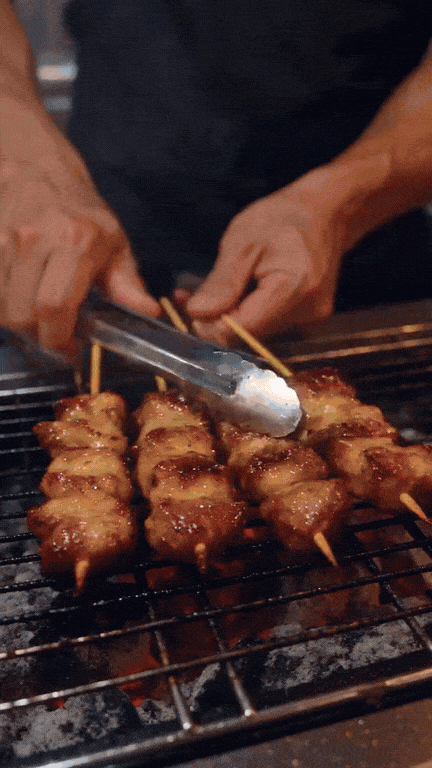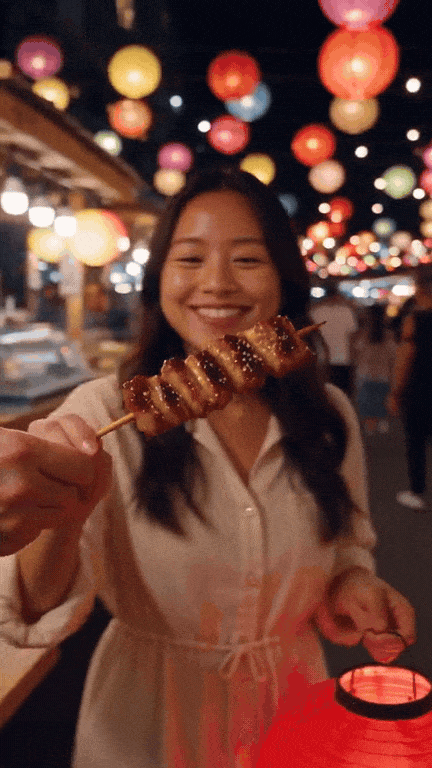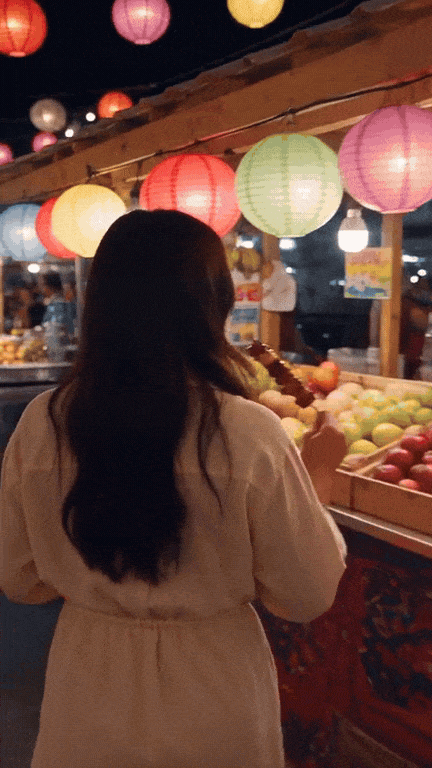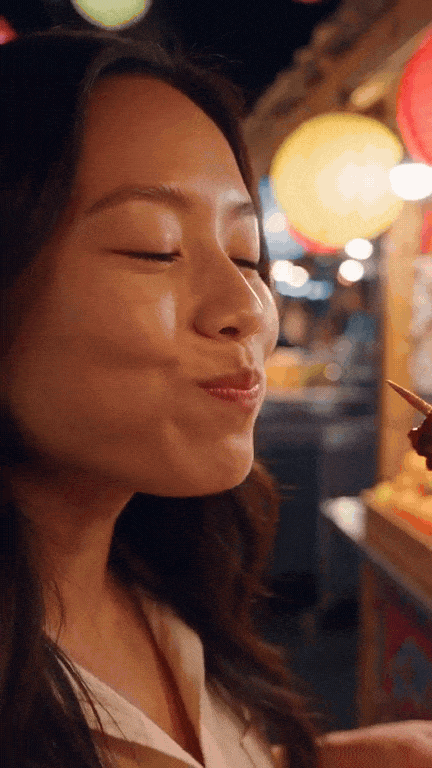
plaintext1拍摄一个垂直、手持的夜市场景,一镜到底。从烤架上翻转的串开始。摊主看向镜头说:“刚出炉。谁饿了?” 2 3他把一串递给一位女性。跟着她穿过市场,在彩色纸灯笼下,经过一个果汁摊,并跟随她直到她停下来品尝食物。 4 5保持从烹饪到递交给行走再到第一口的连续进展。包括烤架的滋滋声、人群中的声音和远处听到的音乐。
生成结果
输出时长:15.07 秒。
烤串将注意力从烤架带到顾客,然后镜头跟随她穿过一排排发光的灯笼。食物上的温暖高光和柔和的彩色灯光让繁忙的市场保持可读。结尾的一口完成了从摊位开始的动作。这是一个有用的长镜头结构,因为每个运动都自然引向下一事件。
6. 长镜头:从巷子到市集广场的 30 秒骑行
模式: 文生视频。设置: 请求 30 秒,720p,16:9。
提示
plaintext1在黄金时段的老山坡小镇中制作一个单一、不间断的 30 秒跟踪镜头。紧跟在一位置身于绿色衣服的女性自行车快递员身后,后架上固定着一个黄色包裹。 2 3沿着鹅卵石小巷下行,经过头顶晾晒的衣物和窗台上的猫。左转穿过石拱门进入水果市场广场。快递员减速、下车,将自行车靠在喷泉旁,并将包裹交给门口的一位老年店主;他微笑着点头致意。 4 5最后将镜头抬升到广场上方。使用自然阳光、拉长阴影和可信运动。听到自行车轮胎、铃声、购物者和喷泉。排除音乐、字幕和可见标题。
生成结果
输出时长:30.08 秒。
黄色包裹在快递员从狭窄小巷穿过拱门进入开阔广场时始终是一个强烈的视觉锚点。前景石砌在镜头旁滑过,然后最终上升揭示更广阔的场景。提示给长镜头一条路线和一个目的地;变化的尺度提供了多样性,而不需要无关场景的蒙太奇。
7. 航拍:通过景观揭示构建运动
模式: 文生视频。设置: 请求 5 秒,720p,16:9。
提示
plaintext1黎明时分快速掠过翠绿稻梯田上方,擦过棕榈树,然后上升揭示雾谷中的高瀑布。金色光线穿透薄雾。使用清晰、鲜艳的 16 mm 视角。听到呼啸空气和瀑布越来越响;省略音乐。
生成结果
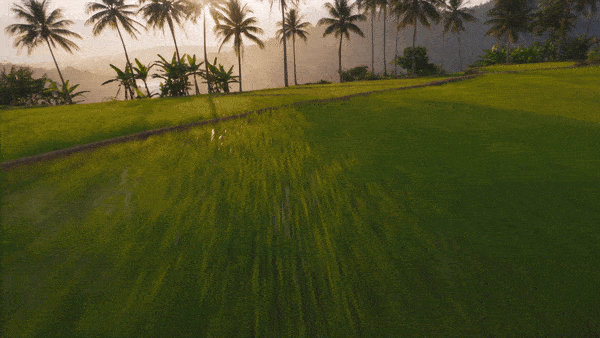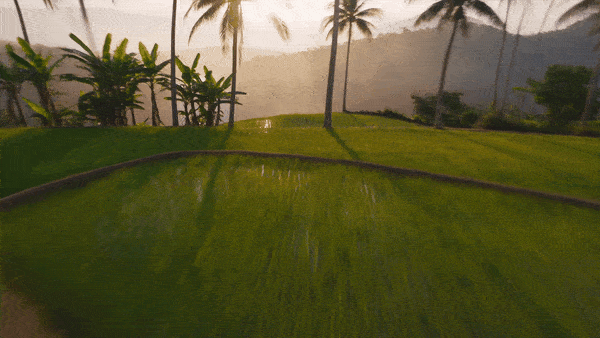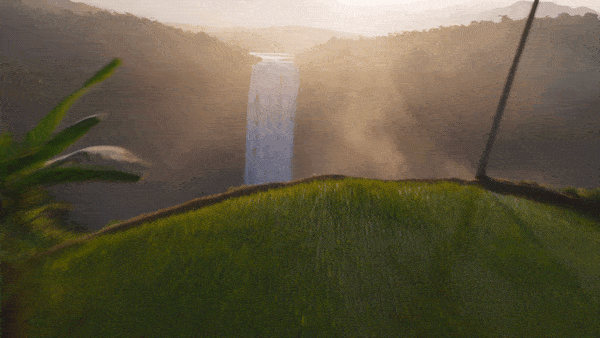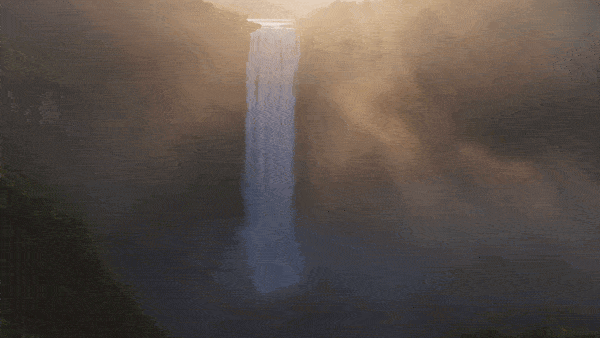
输出时长:5.06 秒。
镜头首先靠近梯田飞行,棕榈树和田野边缘提供附近的深度线索,然后向瀑布上升。揭示改变了高度和可见景观的数量。命名这条路线让镜头比简单要求“史诗航拍”更容易导演;瀑布成为运动的目的地。
8. 风景:使用实际图像作为视觉参考
模式: 图像引导参考生视频;不是首帧任务。设置: 已发布输入记录中为 16:9;未附加输入视频。
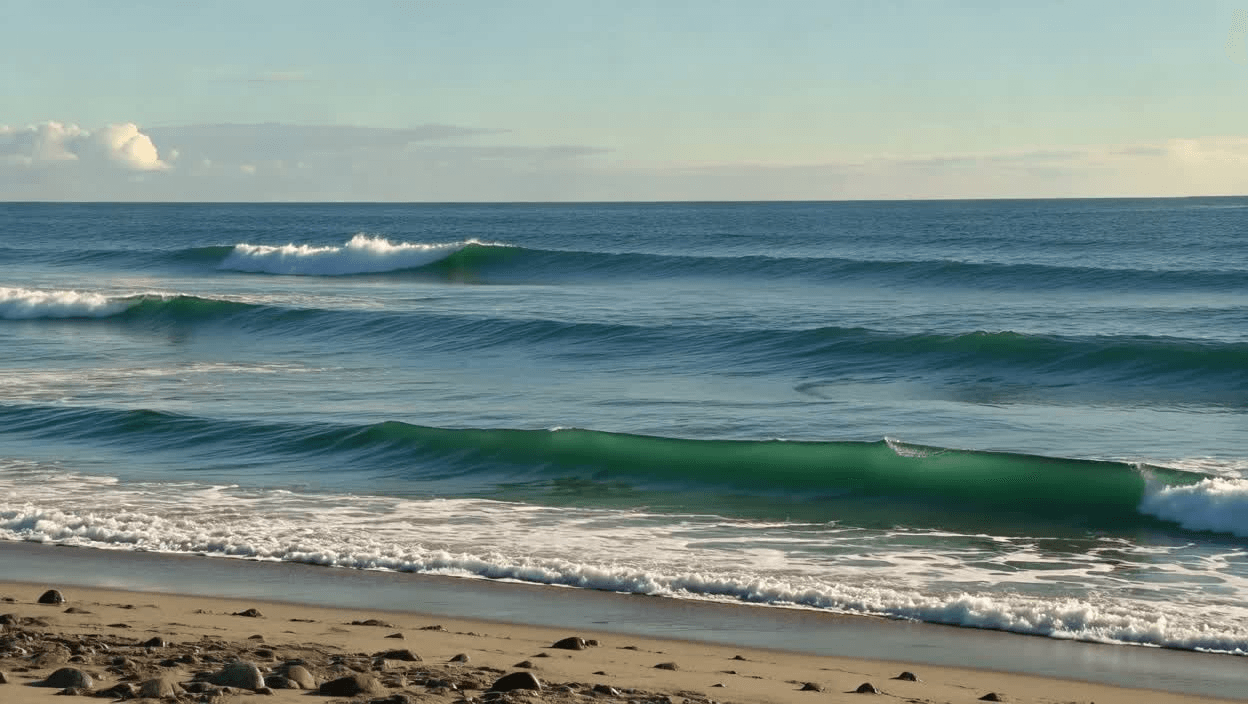
原始输入图像
提示
plaintext1让 @Image1 建立海岸线的外观。在黎明,以类似无人机的镜头缓慢滑翔在海岸上方并沿岸飞行。展示悬挂在海面上的薄雾和小浪冲刷海滩。
生成结果
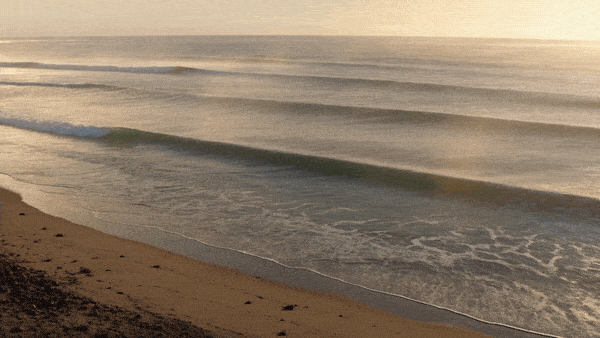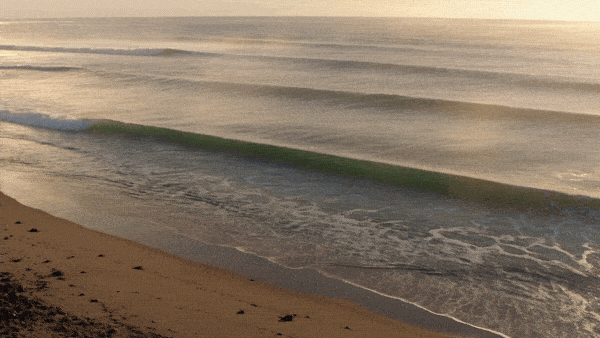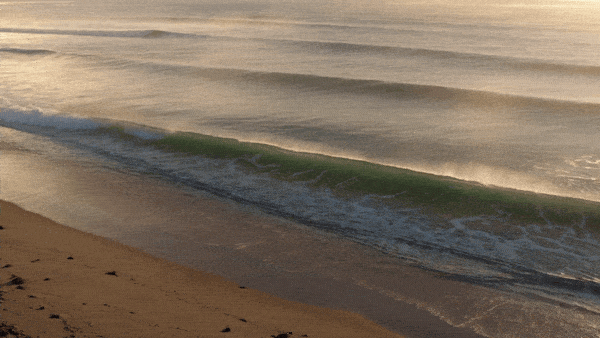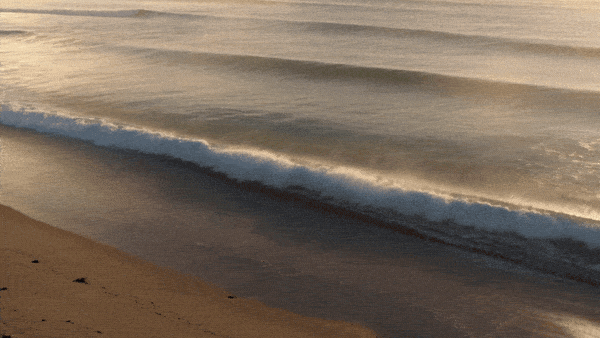
输出时长:5.06 秒。
参考图像建立了海、海岸线和蓝绿色调,而结果引入了暖光和连续的浪花线。观看泡沫沿着海滩推进和退去。这是外观指导,而不是精确的首帧匹配:参考暗示了地点的视觉特征,提示提供了移动的水和航拍视角。
9. 动物运动:将镜头保持在主体高度
模式: 文生视频。设置: 保存的示例未暴露完整设置记录;使用下面的测量输出。
提示
plaintext1以草地高度跟踪一只小狗在阳光明媚的田野中朝镜头跑来,耳朵弹跳。使用温暖的傍晚光线。添加欢快的吠叫和吹过草地的微风。
生成结果
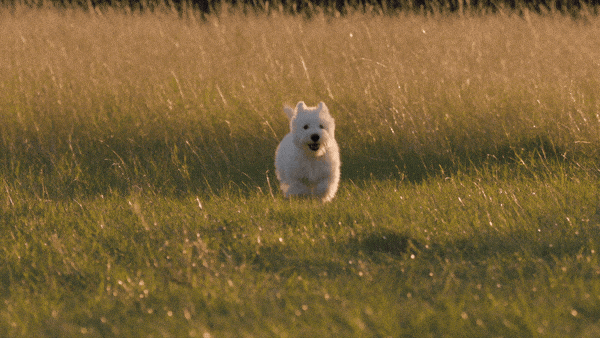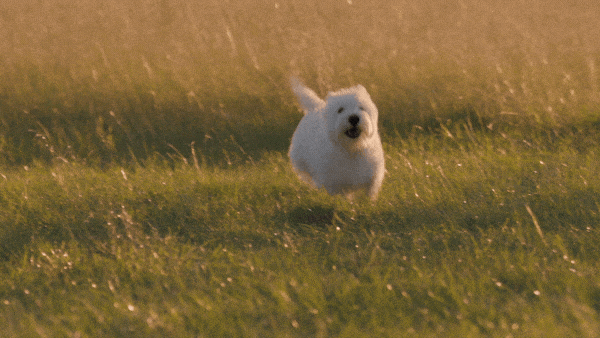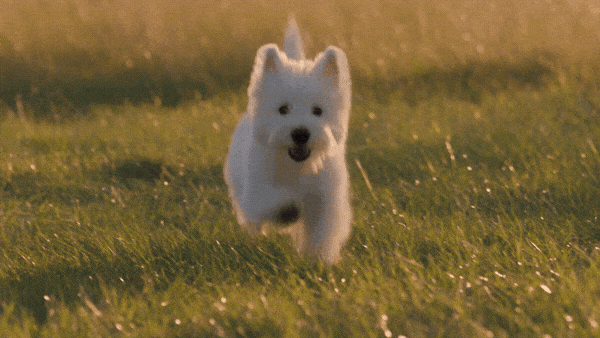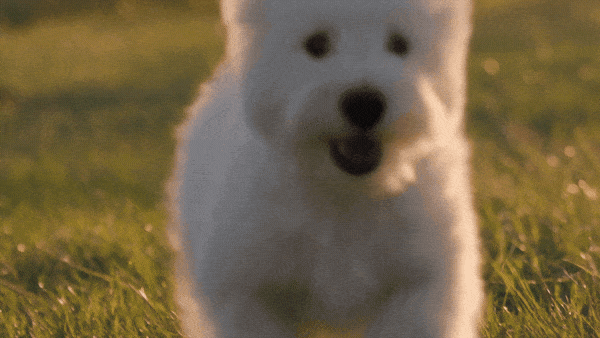
输出时长:5.06 秒。
狗的接近将画面从草地中的小身影变为其脸部的近景。弹跳的耳朵和重复的步伐让运动始终清晰。低镜头将观众置于动物的高度,并给简单的奔跑一个清晰终点,而不需要剪切或第二个角色。
10. 图生视频:水上飞机离开其原始码头
模式: 图生视频,首帧输入。设置: 8 秒,720p,自适应比例,音频开启;已发布种子 42。
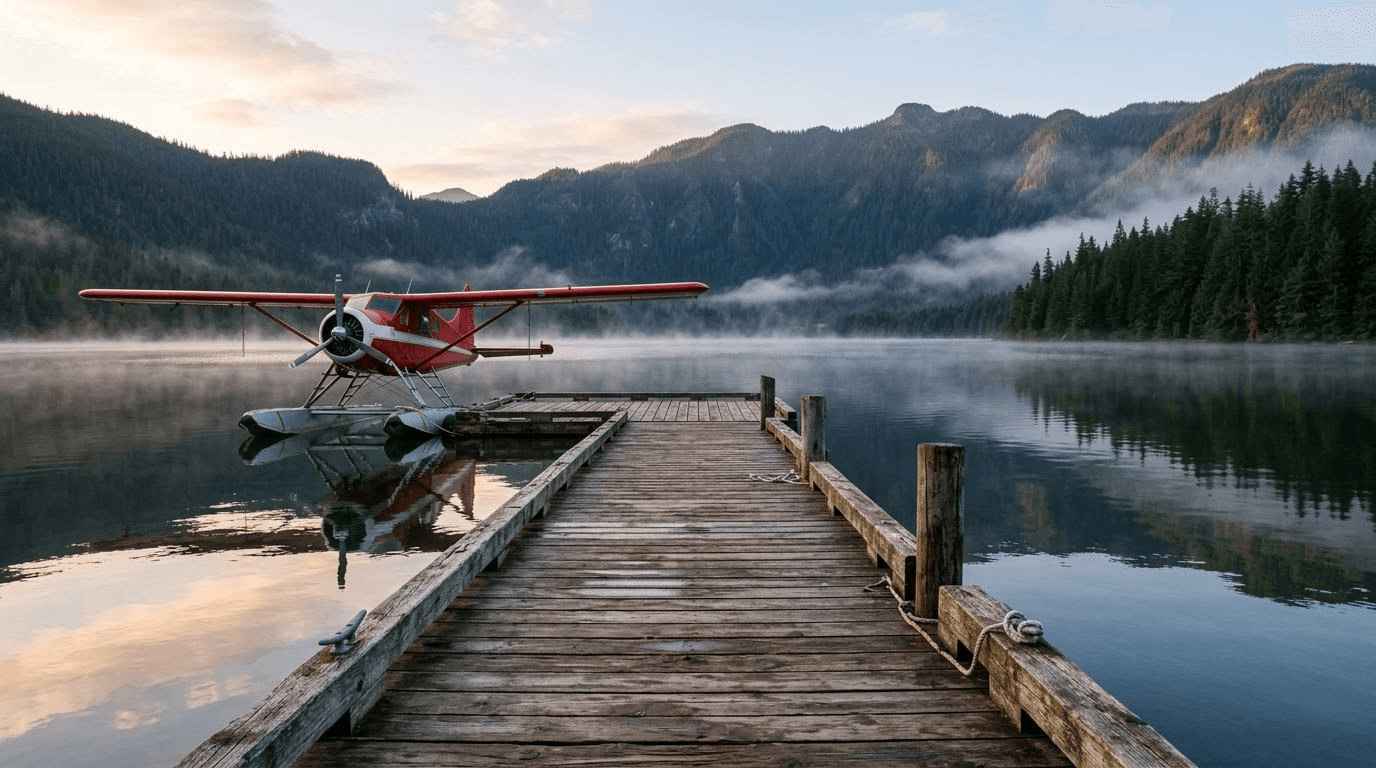
原始输入图像
提示
plaintext1动画化所提供的水上飞机:螺旋桨启动,它带着白色尾流滑行离开,然后朝山飞去。从码头平移跟随;雾气在湖面移动。听到点火、引擎轰鸣、水拍打码头桩,然后是远去的引擎。无音乐。
生成结果
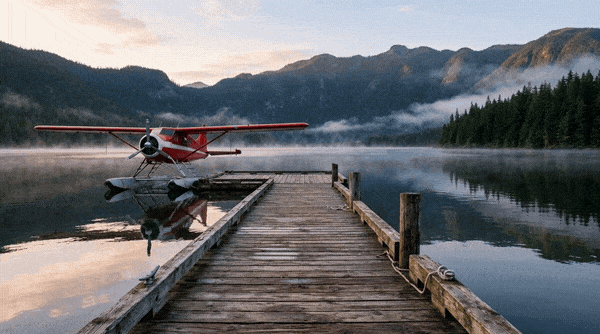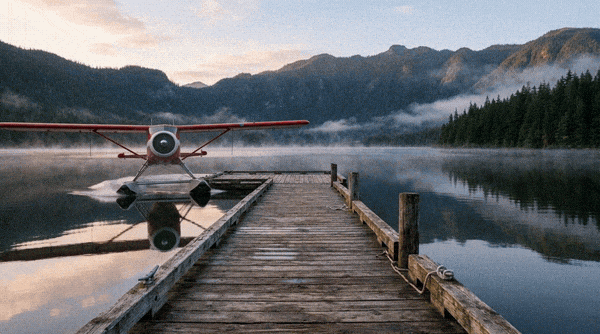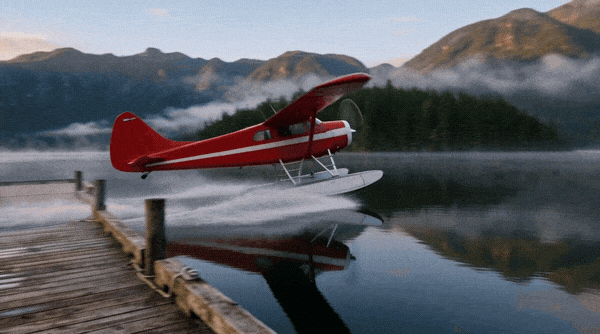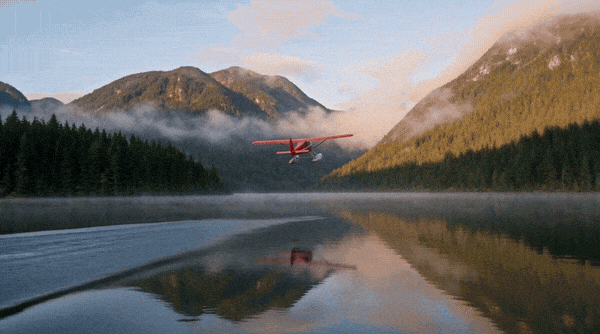
输出时长:8.06 秒。
源图像固定了红色水上飞机、木码头、山天际线和湖面倒影。结果从离开发展到水上加速,尾流加宽,然后飞机离开水面。关键是有序的动作链:启动、滑行和起飞是分开的可见阶段,而不是一个模糊的“让飞机飞起来”的指令。
11. 图像参考:将一瓶带入山地场景
模式: 图像引导参考生视频;产品参考,不是首帧。设置: 8 秒,720p,16:9,音频开启;已发布种子 42。
原始输入图像
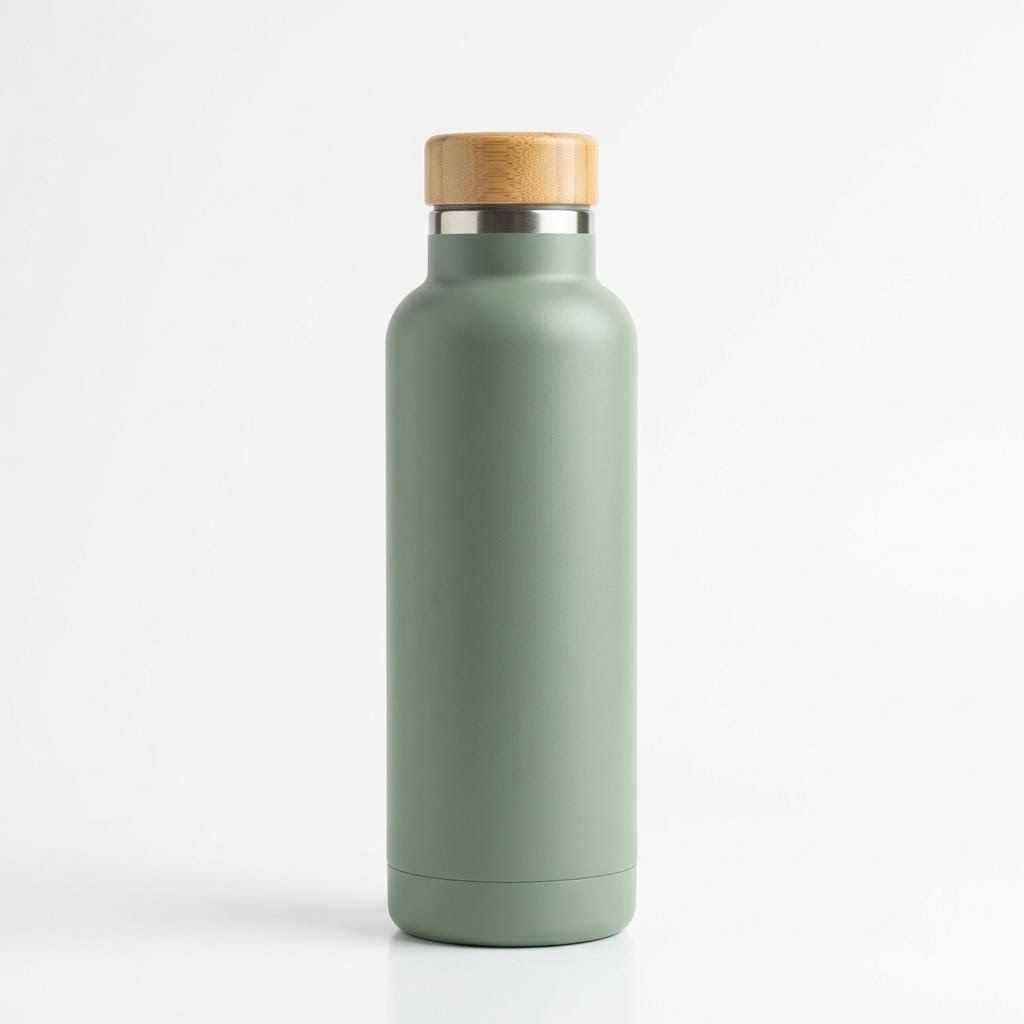
提示
plaintext1@Image1 识别瓶子:鼠尾草色哑光饰面、竹盖、钢环、无品牌。在日落时的岩石山脊上,一位穿红色夹克的女性徒步者从背包中取出它,打开,喝水并眺望山谷。从手和瓶子细节拉到景观广角。听到风、碎石和拧开声;排除音乐。
生成结果
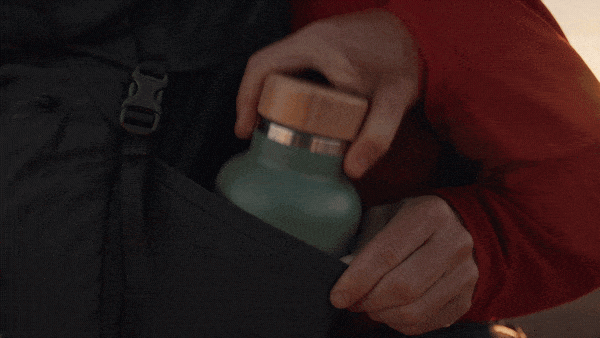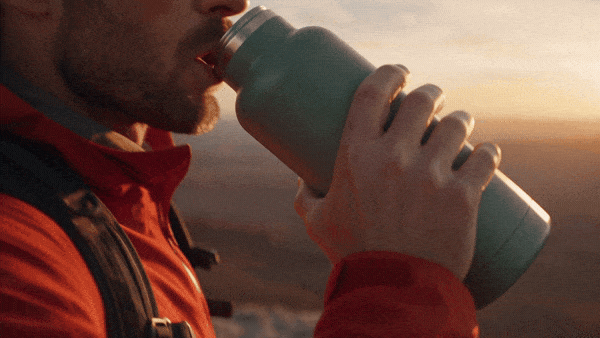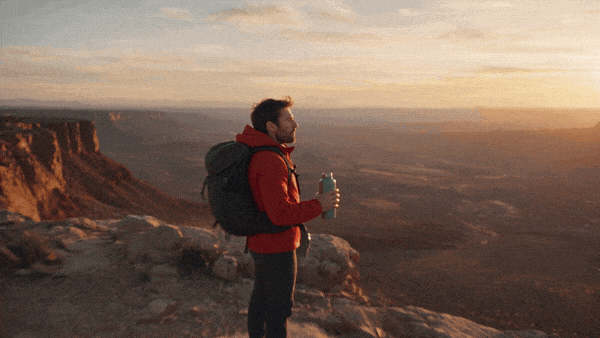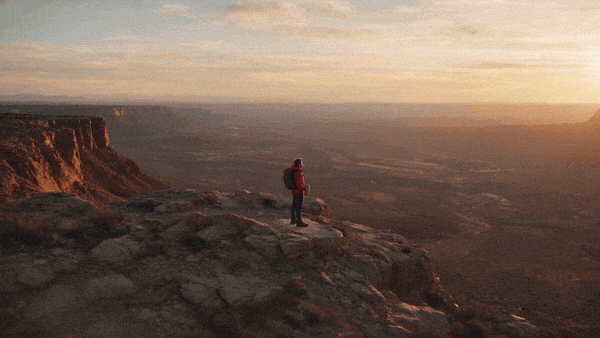
输出时长:8.06 秒。
结果将瓶子的整体轮廓和哑光表面带入更广阔的户外场景,然后从喝水拉回到峡谷景观。它也显示了参考的局限性:瓶子偏向青色,请求的女性徒步者变成了男性。当图像仅分配给产品时,分别检查产品颜色和人物主体。
12. 情感:三个相连镜头中的 20 秒风筝故事
模式: 文生视频。设置: 请求 20 秒,720p,16:9;已发布种子 42。
提示
plaintext1在风中和傍晚光线中创建一个三镜头、20 秒的海滩场景。 2 30–6 秒:一位穿灰色羊毛毛衣的老年男子跪在一位八岁女孩旁边,帮助她握住一个黄色菱形风筝。他说:“等风来。现在放手。” 4 56–13 秒:一阵风将风筝抬起。线从女孩手中滑过,她笑着在湿沙上向后跑。 6 713–20 秒:以广角构图从背后展示两个人物,风筝在淡蓝色天空下的海浪上方高高飞翔。女孩说:“爷爷,它飞起来了!” 8 9使用风、破碎海浪、海鸥和风筝面料拍打声。不要添加配乐或字幕。
生成结果
输出时长:20.06 秒。
黄色风筝将沙滩上的亲密互动与结尾广角镜头中的开阔天空连接起来。场景随着共同任务变成释放时刻而改变尺度,因此情感通过动作发展,而不是要求看起来开心。三个镜头块给准备、发射和回报留出在完整二十秒中阅读的空间。
运行一个简报,然后修复实际失败
打开 Seedance 2.5 Flash 文生视频游乐场 进行纯文本示例。对于参考示例,使用前面链接的相应条目。明确选择分辨率、比例、时长和音频,并在提交前检查所选值保持可见。
下载完整结果,并将其与提示和设置一起保留原件。先以正常速度观看,然后检查单个帧。静帧可以暴露扭曲的手,但无法确定镜头路径、落地或声音过渡是否有效。
在运行前编写三项验收检查。对于舞蹈示例,它们可以是脚可见、一次完整转身和可识别的服装连续性。对于瓶子广告,使用稳定轮廓、实际视角变化和清晰结尾。这些检查将“让它更好”变成具体修订。
| 观察到的问题 | 第一个有用的修订 |
|---|---|
| 主体几乎不动 | 用具有可见终点的动作替换情绪词汇 |
| 镜头缩放而不是改变视角 | 命名起始和结束侧面,并包括背景深度线索 |
| 剪切后服装或产品变化 | 减少剪切、简化遮挡,并使用合适的外观参考 |
| 太多动作仍未完成 | 删除一个节拍或延长实际时长设置 |
| 参考背景压过新场景 | 将该输入限制为外观或运动,并指定新场景 |
| 环境音场景中出现音乐 | 删除音乐语言并仅请求环境声音 |
| 语音改变或出现额外词语 | 缩短台词并确定一个说话者和语言 |
| 文本错误或不稳定 | 在后期制作中添加精确文案和已批准图形 |
一次只更改一个类别:动作、镜头、参考或声音。保持其他请求的设置稳定。输出在运行之间仍可能变化,因此一次成功拍摄并不能证明措辞更改提高了成功率。在做出该声明之前记录重复结果。
保持简短的修订日志:你看到的失败、你更改的句子,以及新拍摄是否解决了它。然后你可以重用有效的镜头简报,而不积累每次失败尝试中的每条指令。臃肿的提示通常包含不再服务于当前场景的旧约束。
将这份 Seedance 2.5 Flash 提示指南与示例用作可改编的提示库:选择一个场景,保留其动作和镜头逻辑,只替换主体特定细节。先从一个简短、可检查的结果开始,然后再围绕它构建更长的序列。
常见问题
有官方的 Seedance 2.5 Flash 提示公式吗?
BytePlus 发布了 Seedance 2.5 系列教程和提示指南,涵盖结构化写作并区分模型变体。本文中的公式将这些原则改编为工作简报,并添加了明确的连续性检查。它不是强制解析格式,也不承诺精确的镜头执行。
我应该用英语还是中文编写 Seedance 2.5 Flash 提示?
当前 Atlas Cloud Seedance 2.5 Flash 文生视频模式支持两者。使用你能精确描述动作的语言。对于对话,直接确定口语语言和说话者。本指南不声称英语比中文产生更好的结果。
我需要单独的负面提示吗?
已检查的 Atlas Cloud Seedance 2.5 Flash 文生视频模式未列出单独的负面提示字段。将有用的排除项放在主提示中,尤其是音乐、语音、字幕或添加文本。也正面描述期望行为,例如保持头到脚构图。
Seedance 2.5 Flash 可以生成原生 1080p 视频吗?
当前 Atlas Cloud Seedance 2.5 Flash 条目列出原生 480p 和 720p 输出。不要从标准 Seedance 2.5 页面或从放大导出来推断原生 1080p 支持。如果交付需要更高的原生分辨率,请选择明确支持它的模型和配置。
这 12 个示例是经过测试且保证结果的提示吗?
这些示例将已发布的 Seedance 2.5 Flash 输出与改编自其场景简报的提示配对。它们不是对这里所示确切措辞的新测试,也不建立成功率。检查完整预览,并将任何提供的图像与结果比较;案例 11 显示了为什么参考不保证每个请求细节。
Seedance 2.5 Flash 提示应该多长?
使用足够的细节来建立动作、镜头、声音和重要连续性,而不引入冲突。从一个紧凑场景开始。当它回答特定需求时,添加第二个节拍或参考分配。当更长的提示更清晰地指导更多场景时,它是有用的,而不是重复相同请求。




