

对你手头的任务来说,顶级万圣节图像生成器取决于你的起点。空白提示词需要文生图。你自己穿新服装的照片需要一个能把照片作为参考的编辑器。一张应该看起来像手持自拍的肖像,需要先改变相机角度,然后再添加精细的万圣节效果。先选好路径,提示词写起来就会容易得多。
关键要点
- 要制作原创万圣节艺术,从文生图开始;要保留真实人物或物体,从图像编辑开始。
- 自拍生成器解决相机取景问题,而通用编辑器让你能更好地控制场景。
- 查看具体产品和账户的免费生成条款;一次免费 Playground 尝试并不代表每个生成器都免费运行。
- 将输出与你的需求简报比较,而不是听信某个模型能赢过所有图像任务的笼统说法。
万圣节图像生成器究竟应该为你做什么?
人们搜索万圣节图像生成器时,可能想制作截然不同的素材:带有可读文字的派对邀请函、自己的恐怖肖像、手机壁纸、服装样机或社交帖子。这些任务使用不同的输入。一个能从文本创造出引人注目的新城堡的模型,并不能证明它能在上传照片中保留你的脸。一个能把肖像变成自然自拍的工具,也不能证明它能设计海报标题。
首先用一句话说出你的交付物。“我需要一张 4:5 的、我戴女巫帽的肖像,脸部保持不变”就给了你源图、宽高比和保留要求。“我需要一张方形邀请函,上面有确切的 OCTOBER 31 字样”要求新构图和文字检查。“我需要三个万圣节壁纸创意”需要变化,而不是身份一致性。
| 你的起点 | 选择此路线 | 导出前检查什么 |
|---|---|---|
| 没有源图;你想要原创场景、海报或插图 | 文生图 | 主体数量、构图、可读文字、裁剪 |
| 人物、宠物、产品或房间的照片必须保持可识别 | 基于参考图像的编辑 | 身份或物体细节、手、连接点、背景变化 |
| 非自拍肖像应变成随意的手机自拍 | 自拍重构,然后可选场景编辑 | 脸、服装、手臂长度的透视,以及第二次编辑是否会改变人物 |
这是一张决策表,而不是视觉质量排名。Atlas Cloud 图像生成器和编辑器 在一个工作区中描述了文生图、参考图生成和定向编辑。它还提供模型、宽高比和分辨率的选择。公开页面确定了这些可用路径;它并没有告诉我们哪个模型最准确地遵循你特定的万圣节需求简报。
Google 的 万圣节图像创意 在实践中展示了同样的差异:恐怖场景、服装创意和经过转换的个人照片都是万圣节图像,但各自要求工具保留不同的信息。好的候选清单始于你的最终素材不能失去的信息。
对于新的万圣节艺术,从文生图开始
当没有真实人物或现有产品必须在转换后保留时,文生图生成器是直接路线。给它一个主体、一个瞬间、一个场景、一种相机或插画风格,以及输出形状。一个具体的互动比一堆氛围词更容易评估。“一个孩子伸手去够门廊灯笼,同时一个友好的纸幽灵在微风中飘起”有可见的动作。“恐怖、电影感、惊艳的万圣节”则让生成器几乎凭空发明一切。
下图仅由文本生成:一个虚构人物穿着手工稻草人服装,在万圣节街头集市中穿过彩带。它展示了提示词如何控制主体、动作、场景和光线。因为没有提供源肖像,这个结果无法证明身份保留能力。当你在 AI 万圣节图片生成器和照片编辑器之间做选择时,这一区别很重要。
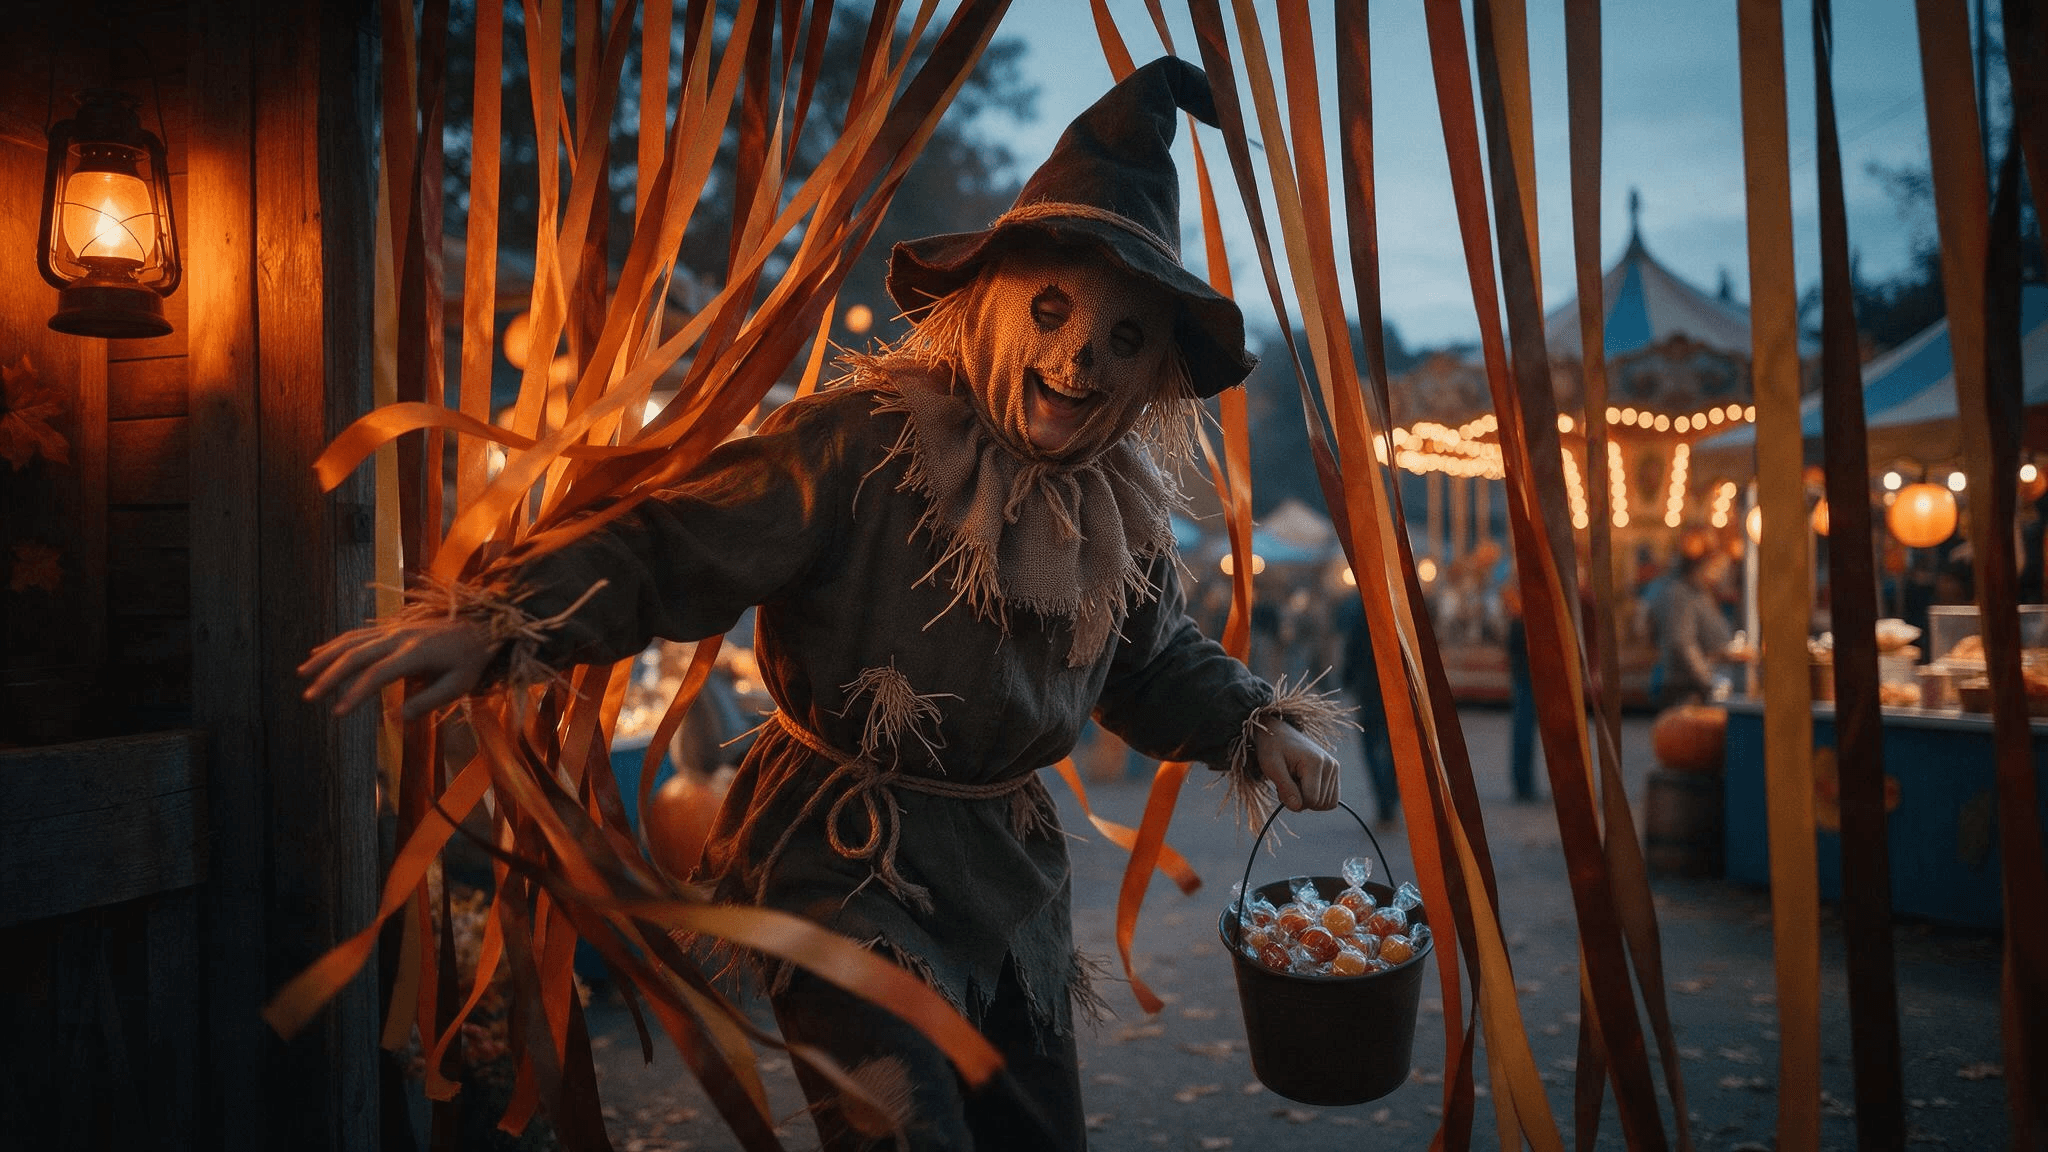
用户提供的生成结果,来自 Seedream 5.0 Pro Text-to-Image。人物和街头集市来自文本提示词,没有参考照片。
对于派对海报,把艺术指导与所需文字分开。你可以要求模型设计带有确切文字的设计,但要检查每一个字母。如果标题很关键而输出拼错了,就把生成的图像用作背景,然后在设计编辑器中放置经过核验的文字。这对于日期、地址和安全信息尤其有用,因为这些绝不应依赖模型的拼写。
以下是街头集市示例所用的提示词。它要求一个虚构人物和一个可见动作,不要求任何人的真实面孔或受版权保护的角色:
plaintext1A candid editorial photograph at a small-town Halloween street fair. One young adult wearing a handmade scarecrow costume steps through a curtain of autumn-colored ribbons, laughing as a gust of wind lifts the loose fabric; a bucket of wrapped candy swings naturally from one hand. Food stalls and a carousel are softly visible in the distance. Directional amber lantern light from the left, cool blue-hour ambient light, restrained orange-and-blue palette. Wide 35mm documentary composition with a little foreground blur and generous uncluttered space in the upper right for a headline to be added later. Real fabric weave, worn wood, natural skin texture, slight motion in the ribbons. Exactly one prominent person, believable hands, no lettering, no logos, no watermark. Horizontal 16:9.
对标题空间的要求在这个结果中并没有产生完全清晰的区域:彩带和集市帐篷穿过了右上角。对于邀请函,请在单独的文字面板中添加经过核验的文字,或在导出前修改构图。如果你需要的是壁纸,请把画布改成你设备的比例,并将主要主体移离时钟或应用图标。这些是输出决策,而不是重写整个视觉概念的理由。
下面的邀请函示例采用第二条路线。一个新的万圣节场景在左侧留出一面空白墙;“HALLOWEEN NIGHT”和“OCTOBER 31”这些文字是之后作为经过核验的文字排版上去的。图像模型提供的是场景,而不是字母。
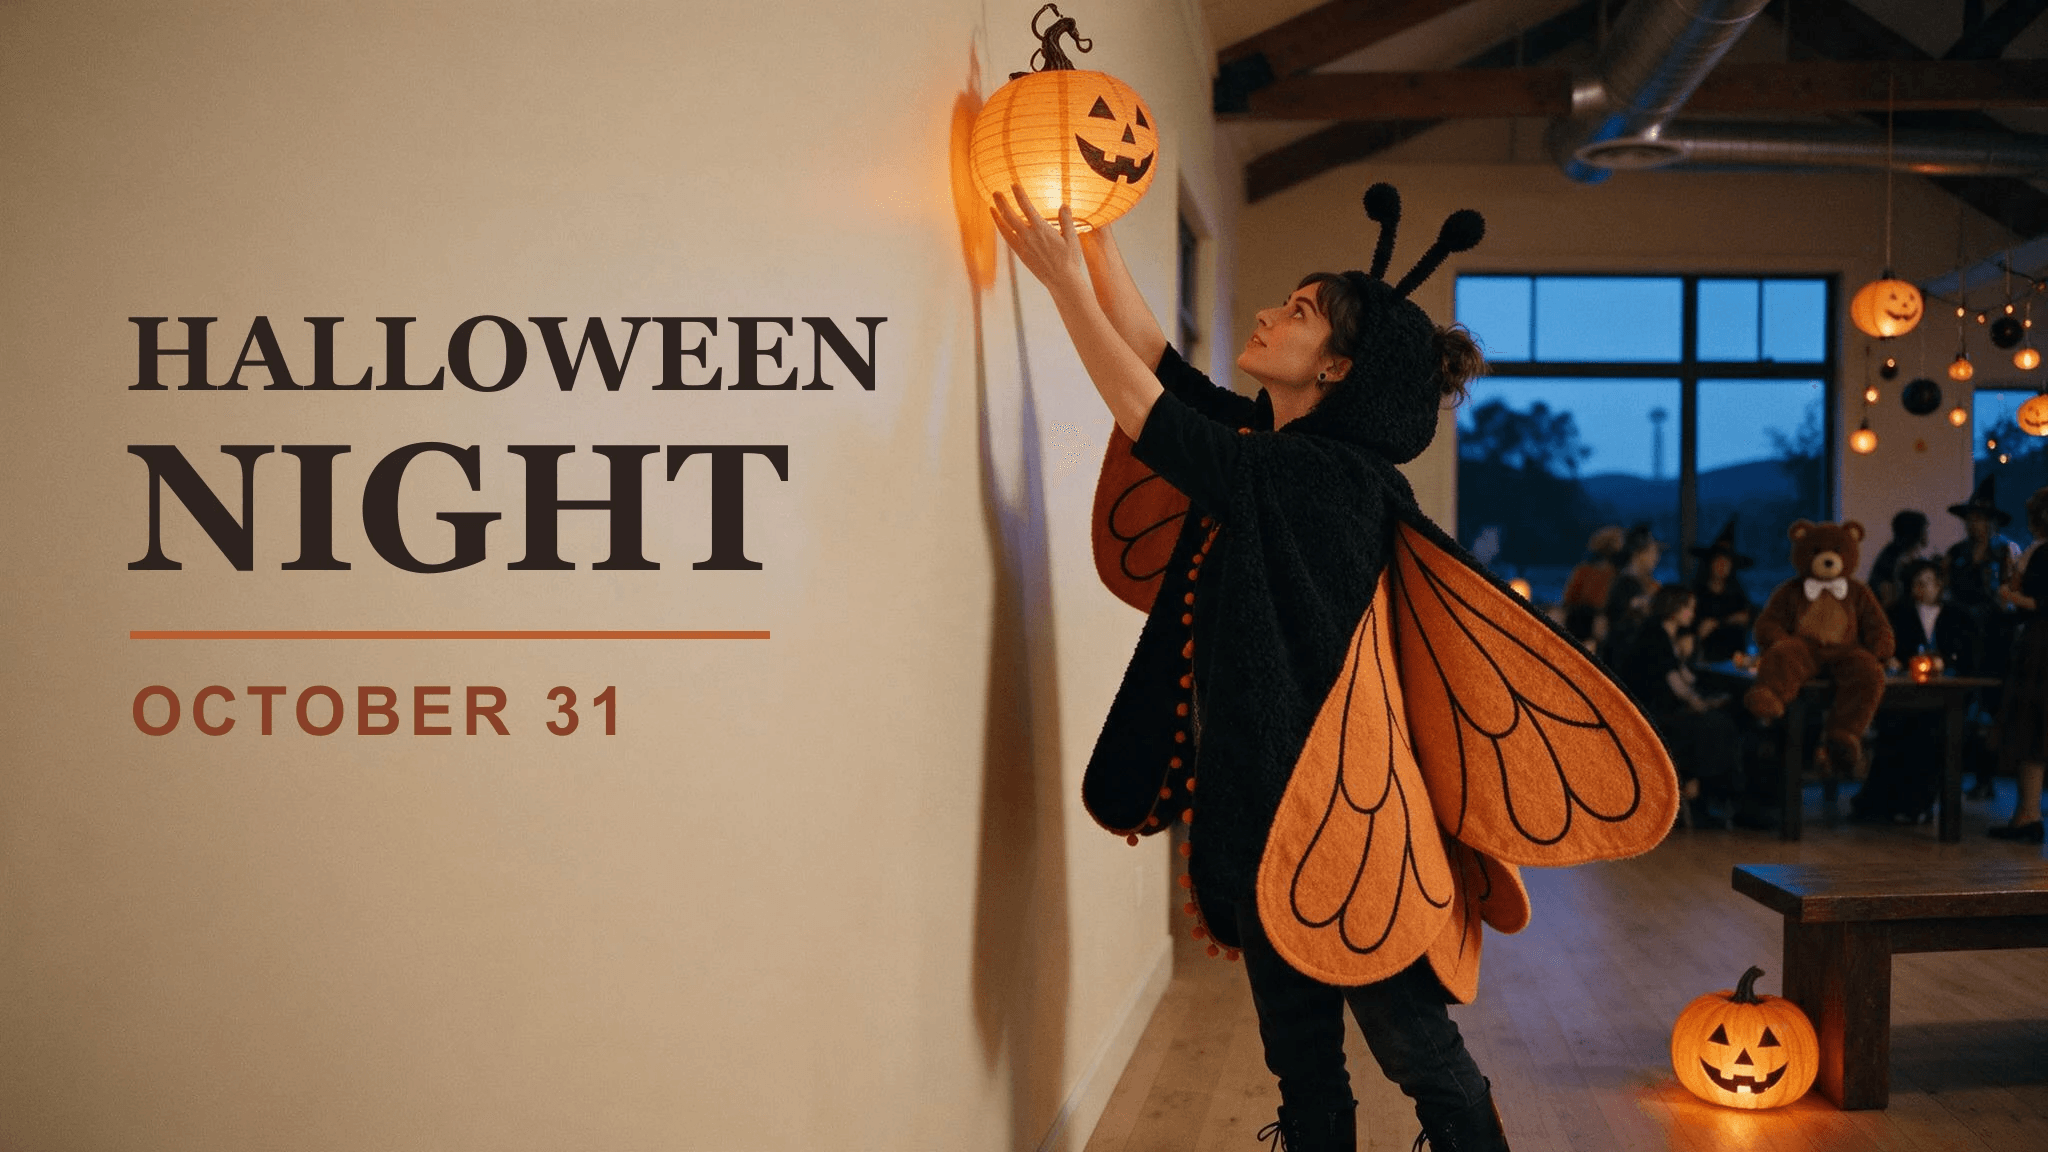
用户提供的场景,使用 Seedream 5.0 Pro Text-to-Image 生成;示例邀请函文字是另行添加的。这是一个示例布局,不是活动公告。
比较两个模型时,在两者都支持的情况下,运行相同的提示词和设置。保存确切的提示词、分辨率、宽高比和每个结果。如果一个模型把主体数量弄对了,另一个模型做出了更吸引人的色彩方案,你就有了一个有意义的权衡来判断。用不同提示词制作的一张图片展示,无法确定哪个生成器更适合你的任务。
对于你自己的万圣节照片,选择编辑
当最终图像应该展示的是 你 时,AI 万圣节照片生成器应该接受你的源照片。寻找参考上传和编辑模式,而不仅仅是带有恐怖缩略图的样式预设。从一张眼睛、发际线和服装都清晰可见的照片开始。如果你想要背景中有幽灵,就给模型实际可用的背景空间。如果你想更换服装,就展示足够的上半身,让配饰或服装显得合理。
把提示词写成编辑指令,带有明确的保留指令和一处局部更改。要求保留面部并不能保证结果;你仍然需要与原始图像比较。下面的成对示例从一张新生成的书店肖像开始,然后添加一顶毛毡女巫帽,同时保留人物、夹克和场景。它演示的是针对虚构人物的编辑工作流,而不是对真实人物身份的验证。
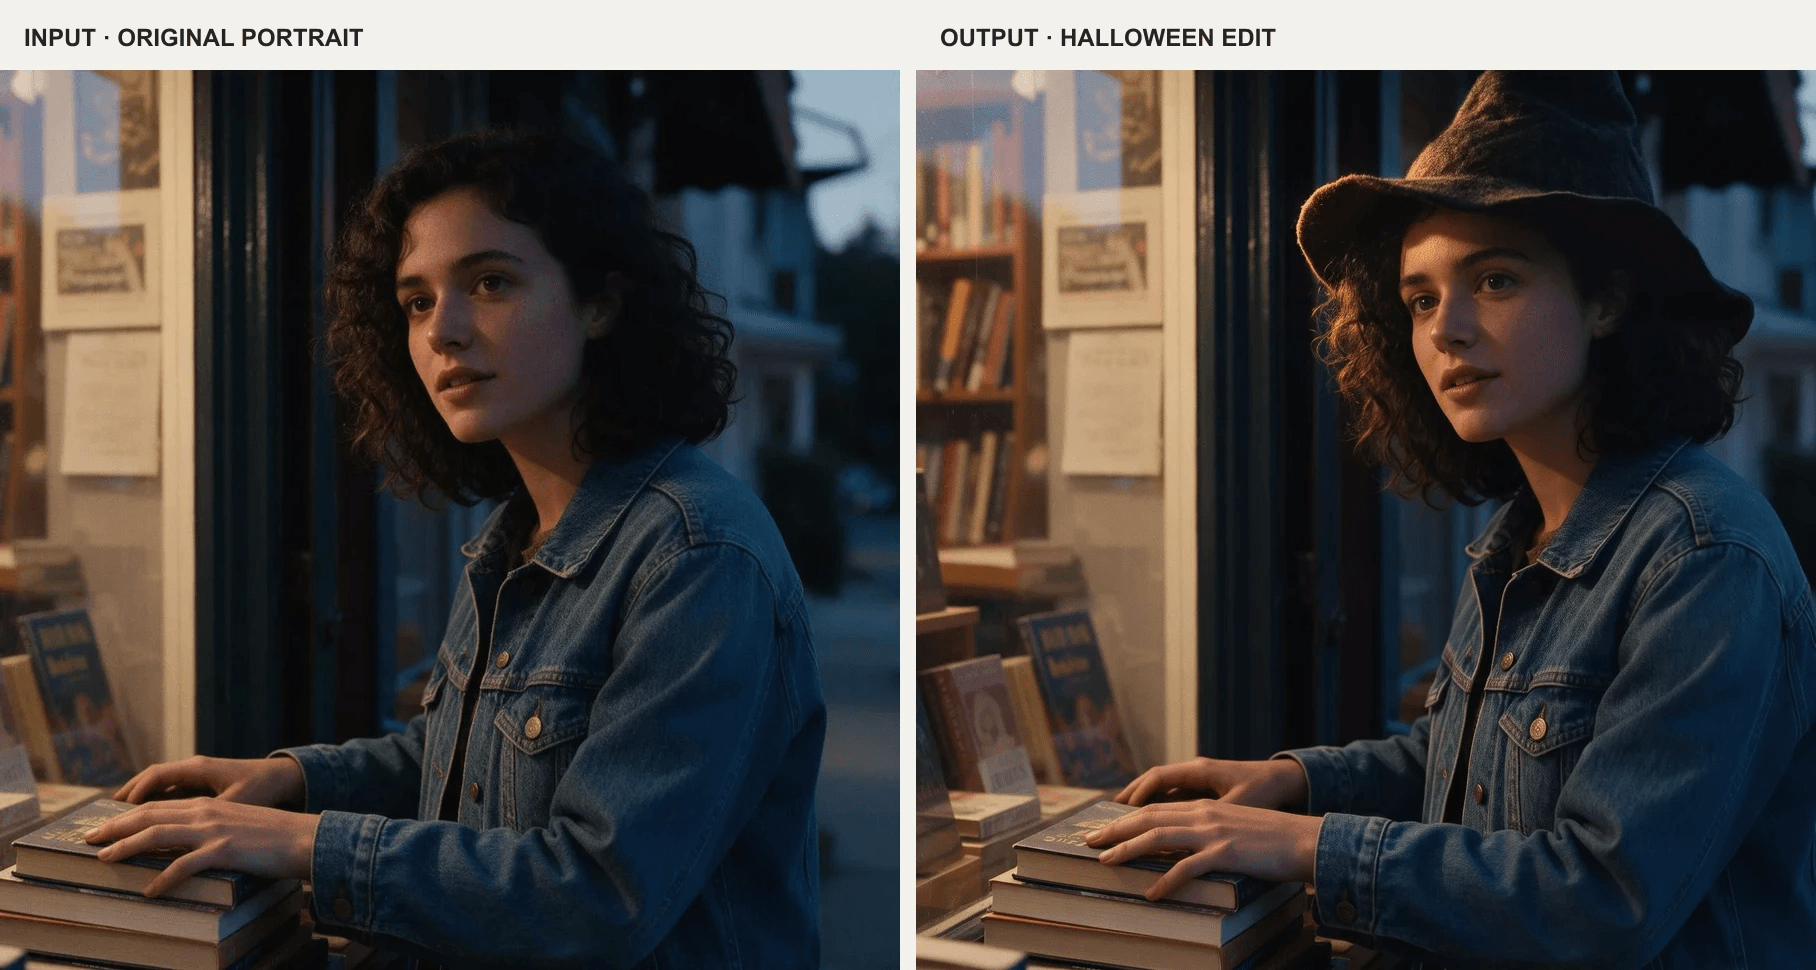
用户提供的源肖像,使用 Seedream 5.0 Pro Text-to-Image 生成;用户提供的编辑使用 Nano Banana 2 Edit 完成。帽子是所要求的更改。
编辑指令是:
plaintext1Edit the uploaded photograph of the same woman. Preserve her recognizable face, dark curly hair, expression, body proportions, blue denim jacket, bookshop window, camera angle, and the original direction of light. Add one modest Halloween change: a handmade black felt witch hat resting naturally on her hair, with a believable contact shadow. Keep the moment candid and photographic; do not redesign the shop or change her identity. No mask, floating hat, extra fingers, altered face, text, or watermark. Keep the original horizontal 16:9 framing.
为什么要保留夹克和相机角度?每增加一项更改,都会给编辑器多一次偏离输入的机会。如果你首先需要一个服装概念,就把它生成为单独的图像。当你选定了真正想要的细节后,就用那一处更改来编辑真实照片。一个好的万圣节照片生成器让你能进行有针对性的后续操作,例如“把帽子压低到头发上;保持脸和夹克不变”,而不是强制完全重新生成。
照片编辑也是宠物或房间需要保持可识别时的正确路线。说出你想保留的特征:狗的毛色图案、雕刻南瓜的实际面孔、房间的窗户位置或产品标签。避免含糊的“同一张图像,但变成万圣节”。具体的锚点让你看出结果是真正编辑了源图,还是用一个相似场景替换了它。
什么时候自拍生成器是更好的第一步?
有时源照片是别人拍的肖像,但期望结果应该看起来像你自己拍的。这首先是相机几何问题,其次才是万圣节问题。前置摄像头自拍有手臂长度的透视、合理握持的手臂,而且画面中通常看不到手机。镜面自拍通常会显示手机和物理上一致的反射。混用这些指令可能会多出一只手或重复的设备。
Atlas Cloud 免费 AI 自拍生成器 围绕一张上传的肖像和可选的简短氛围描述构建。当源图看起来太摆拍、不适合作为社交万圣节帖子时,它就派得上用场。这个工具的主要工作是自拍取景;复杂的服装、幽灵或海报布局之后可能需要单独的图像编辑。
下面的示例使用一张新生成的肖像作为源图,并用单独的基于参考的编辑来演示相机变化。它不是消费者自拍工具的输出。
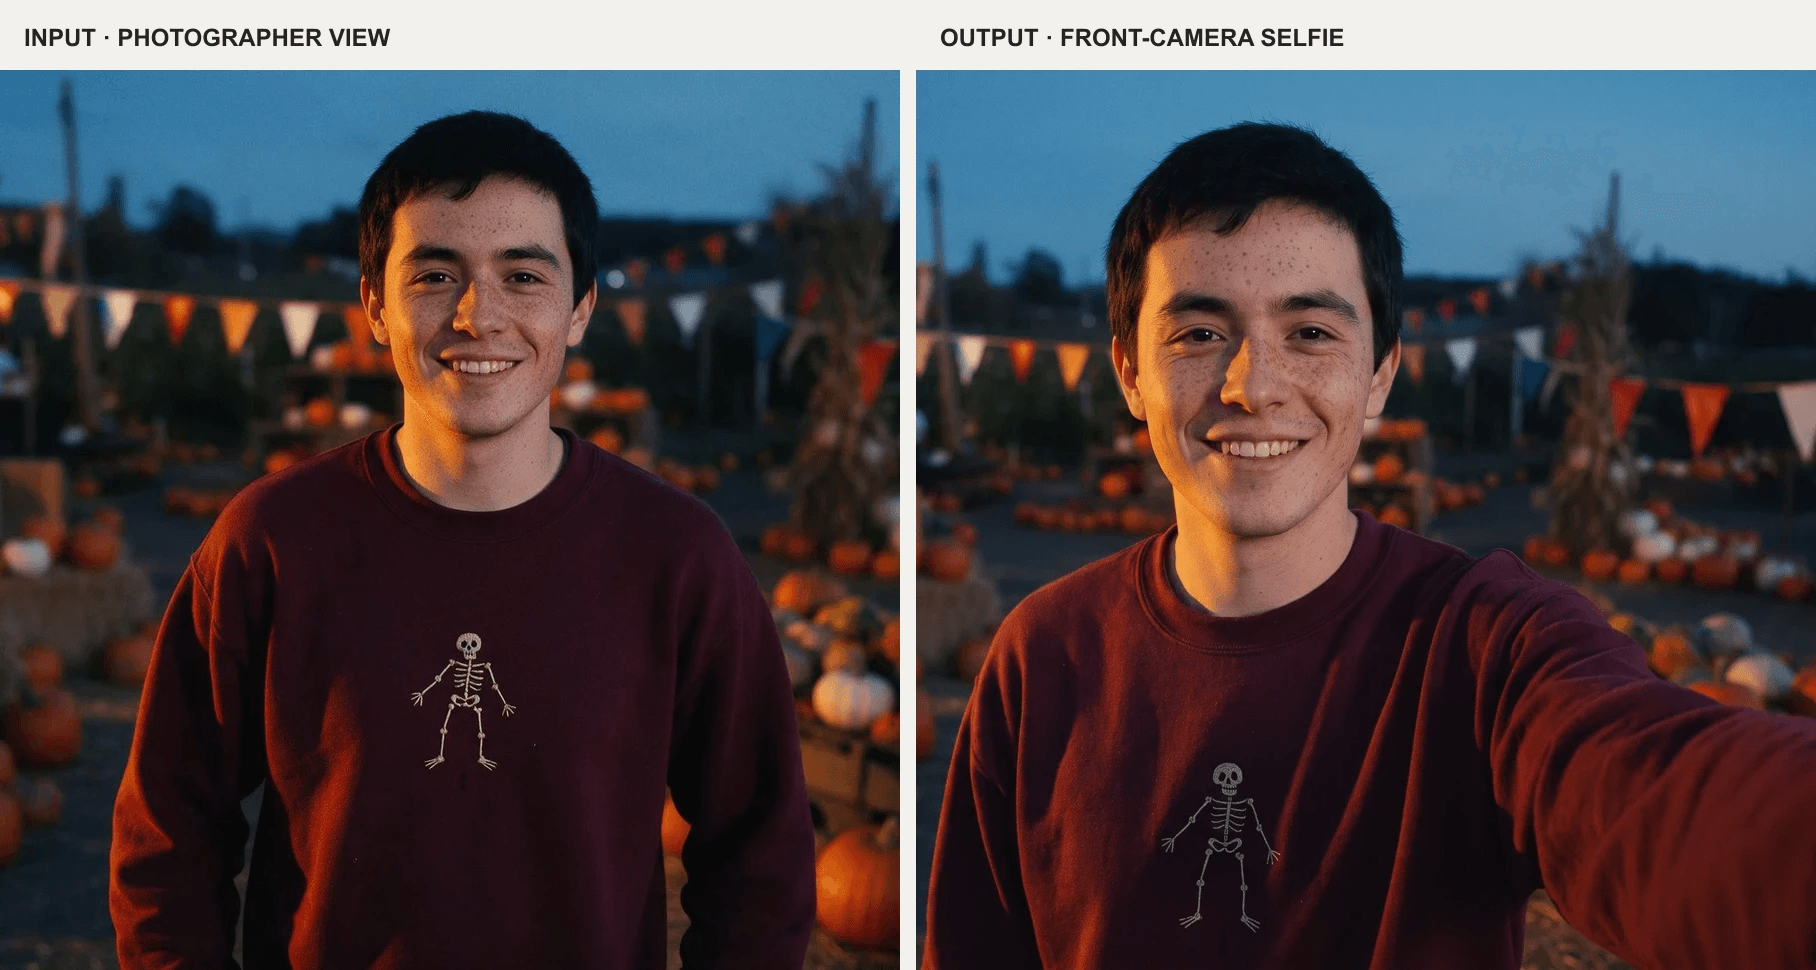
用户提供的源肖像,使用 Seedream 5.0 Pro Text-to-Image 生成;用户提供的自拍重构使用 Nano Banana 2 Edit 完成。伸出的手臂和更近的视角是可见的变化。
第一步使用原始肖像。检查脸和服装在重构后是否保留下来,然后保存结果。在这个示例中,南瓜地场景和骷髅运动衫已经承载了万圣节主题,所以第二次编辑没有必要。如果你之后确实添加了新的服装或道具,请将最终图像与原始肖像比较,因为每一次额外编辑都会给身份漂移多一次机会。
如果你已经有一张好的自拍,就跳过重构。万圣节图像编辑器可以直接处理你拍摄的照片。额外工具只有在解决真实取景问题时才有用。这能让工作流更短,也更容易找出是哪一步引入了错误。
免费的 AI 万圣节图像生成器够用吗?
一次免费尝试可以回答一个早期问题:这个工具是否足够理解需求简报,能继续用下去?它不应被当作每条路线都免费的证明。Atlas Cloud 的 Free GPT Image 2.5 Playground 页面 目前表示,参与的模型共享五次免费生成尝试,且这些尝试适用于 Playground。同一页面说 Generator、Model Explorer 和 API 运行单独计费。运行前请检查你账户中的当前额度,因为资格和剩余尝试次数可能会变化。
把第一次符合条件的尝试用作受控测试。粘贴一条具体提示词,将请求的尺寸保持适中,并以全分辨率检查结果。如果你在测试海报,检查确切的字母和间距。如果你在测试编辑过的照片,检查相似度,以及更改的部分是否自然地融入场景。在决定是否花费更多尝试之前,保存提示词和输出。
带有狭窄预设的免费 AI 万圣节生成器可能便于快速制作社交帖子,但预设会隐藏你在意的决定:主体站在哪里、是否出现第二个人,或源图有多大程度保留下来。通用编辑器需要多写一点,但对这些细节提供更清晰的控制。根据你需要的图像来选择,而不是只看 免费 这个词。
在投入前进行公平测试
你不需要实验室基准测试来为单个万圣节素材找到合适工具。你需要一份可重复的需求简报和一份简短的失败检查清单。在路线允许的情况下,使用相同的源照片或相同的文本提示词,并保持输出目标固定。只在生成完成后记录结果;落地页上的图库示例是用别人的输入和提示词制作的。
这里有两个用户提供的结果,针对同一个请求场景:一个人在一只狗身上系带有蝙蝠图案的方巾,旁边是一个打翻的糖果桶。在这对结果中,左边把方巾放在狗头后方很高的位置,并让狗的脸偏暗;右边让颈部位置和脸更容易查看。源导出文件具有不同的像素尺寸,所以这是对两个实际输出的检查,而不是匹配分辨率的基准测试或通用模型排名。
用户提供的输出,分别标记为 Seedream 5.0 Pro Text-to-Image(左)和 GPT Image 2 Text-to-Image(右)。比较这些结果中指定的方巾位置、主体数量和可见性。
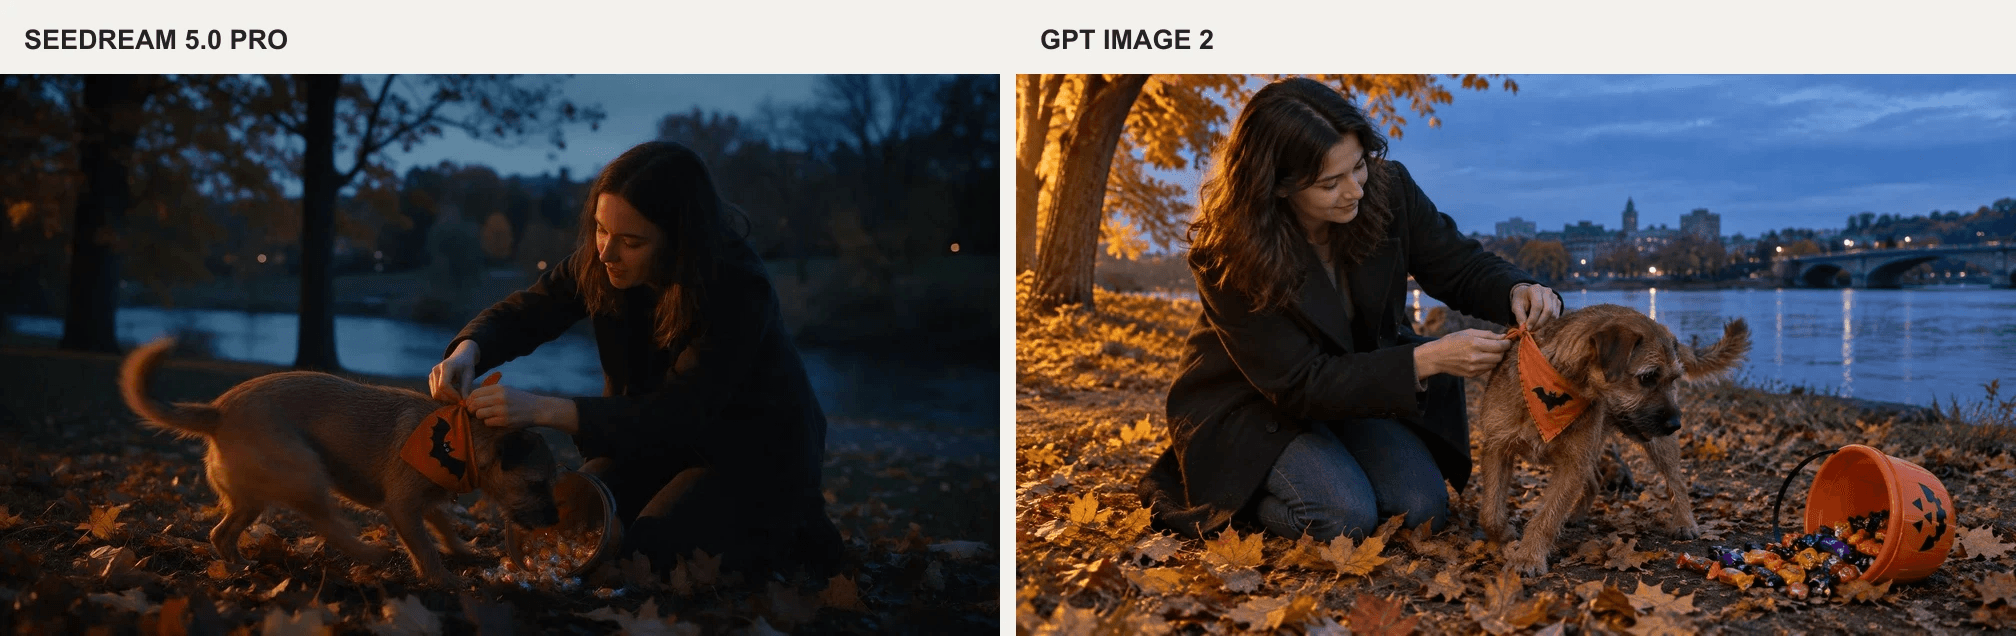
共用的提示词是:
plaintext1A candid Halloween photograph in an autumn riverside park at blue hour. Exactly one young adult woman in a simple dark coat kneels to tie a small orange bandana with a stitched black bat motif around the neck of exactly one brown terrier. The dog twists toward a tipped bucket of wrapped candy, while both of the woman's hands visibly and plausibly attach the bandana. No other people or animals. Directional amber light from the left against cool blue shadows, restrained orange-and-blue palette, 35mm documentary photography, foreground leaves, natural skin, fur and fabric texture, slight movement in the dog. Keep both faces, the woman's hands, and the bandana clearly visible with room around them for a horizontal crop. No lettering, logos, or watermark. Horizontal 16:9.
在运行测试之前,把目标具体化。头像图片需要一张在缩略图尺寸下也能辨认的脸。故事图片需要在边缘附近为界面叠加层留出空间。印刷邀请函需要文件具有足够细节,以满足最终物理尺寸。这些要求可能使带有便捷预设的生成器不如一个具有合适宽高比和可编辑结果的生成器有用。检查下载的文件,而不只是工具中的预览。
对于文生图需求简报,给四件事打分:正确的主体数量、可读的动作、为你最终裁剪留出的空间,以及任何必需的文字。对于照片编辑,把文字检查替换为相似度或源物体连续性。对于自拍,检查手臂、手机位置、脸,以及服装是否保持合理。这些检查足够简单,可应用于单个结果,也足够具体,能指出该在哪里修改。
| 检查 | 通过的样子 | 针对性修复 |
|---|---|---|
| 主体和身份 | 人数正确;所需的脸或物体与源图匹配 | 重新上传原始图像,并要求保留指定特征 |
| 相机几何 | 一个可信的视角、手臂和手机位置 | 明确指定直接自拍、镜面自拍或摄影师视角 |
| 万圣节放置 | 服装接触身体;幽灵或道具位于指定区域 | 只移动放错位置的元素;保持其余部分固定 |
| 导出适配 | 重要特征在预期裁剪后保留下来 | 在工具设置中添加负空间或更改宽高比 |
Google 的 图像提示词指南 建议写明主体、构图、动作、场景、风格和编辑指令。上面的清单把这些提示词要素变成了你可以在成品文件上验证的内容。修复请求应该指出一个观察到的缺陷,而不是一个新的情绪板。
例如,如果生成器把南瓜放在脸前面,下一条指令就是“把南瓜移到右下背景;保留脸和光线。”如果帽子漂浮在头发上方,就要求它落在头发上并带有自然阴影。如果海报日期被拼错两次,就不要继续让图像模型排版它,而是在之后添加经过核验的文字。每个决定都应让素材更接近其预期用途。
对你项目而言,顶级万圣节图像生成器是能以最少代价高昂的修改通过这些检查的那个。从你的输入所需的路线开始,运行一个小型受控测试,并在将其用于帖子、邀请函或活动之前检查导出文件。
常见问题
什么是最适合我自己照片的万圣节图像生成器?
选择基于参考图像的编辑器,它允许你上传原始图像并描述有针对性的更改。将最终的脸、服装和背景与源图比较。纯文本生成器可以制作万圣节肖像,但无法验证新人物就是你。
我可以使用 AI 万圣节图片生成器制作派对邀请函吗?
可以。文生图对于场景或插画背景很有用。如果邀请函包含日期、地址或确切标题,请检查每一个字符,并考虑在生成艺术后于设计编辑器中添加最终文字。
Atlas Cloud 图像生成器免费吗?
不要假设某个 Atlas Cloud 页面上的免费优惠适用于每个产品。GPT Image 2.5 页面目前描述参与 Playground 模型的共享免费尝试,并说 Generator、Model Explorer 和 API 运行单独计费。生成前请检查你已登录账户中的当前额度。
我应该使用哪种万圣节艺术生成器制作壁纸?
如果你想要新场景,就使用文生图,然后在工具允许的情况下将画布设置为你的设备形状。让焦点主体远离时钟和应用图标,并检查最终裁剪。如果壁纸必须包含你实际的宠物或房间,就改用基于参考的编辑。
如何让万圣节自拍看起来像我?
从一张清晰、能露出双眼和你平时发型的肖像或自拍开始。要求保留这些特征,一次只更改一个万圣节元素,并将每个输出与原始图像比较。如果照片已经是自拍,就直接进行图像编辑;再次重构只会增加不必要的步骤。





