
MiniMax API
作为 MiniMax AI 开发的顶级 Large Language Models (LLMs) 套件,MiniMax 旨在通过前沿人工智能重塑真实场景中的生产力。该生态系统包含专为高效率专业环境打造的 MiniMax M2.5,以及在多语言编程能力上显著增强、能够驾驭复杂大规模技术任务的 MiniMax M2.1。凭借在编码、智能体式工具使用、智能搜索和办公流程自动化方面达到 SOTA 性能,MiniMax 能够帮助用户以无与伦比的精度和可靠性,精简各类具有经济价值的运营流程。
MiniMax 由 MiniMax 开发。Atlas Cloud(由 Atlas Cloud AI LLC 运营)仅提供接入服务,并不拥有该模型。所有商标均归其各自所有者所有。
探索领先模型
Atlas Cloud 为您提供最新的行业领先创意模型。



MiniMax API 模型阵容对比
清晰了解各个 MiniMax endpoint 的输入、输出与成本,覆盖文本、编程、智能体工作流和音乐生成。
| 模态 | 描述 |
|---|---|
| MiniMax M3 API (Text) | 需要一款快速的智能体模型?MiniMax M3 基于轻量级 10 billion 激活参数核心,可将文本提示转换为代码、工具调用和推理能力,专为低延迟和可扩展性而构建。标准定价为每百万输入 tokens $0.6、每百万输出 tokens $2.4;当 prompt 超过 512K tokens 后,将适用单独的计费档位。它适合长上下文、工具调用密集的智能体会话以及现代应用开发。 |
| MiniMax M2.7 (Text) | MiniMax M2.7 可将自然语言指令转化为生产级代码和多步骤智能体动作,并采用同样的 10 billion 激活参数设计以实现高吞吐。标准定价为每百万输入 tokens $0.3、每百万输出 tokens $1.2,让大规模智能体运行更具成本效益。当你更看重可靠的编程和应用构建能力,而不是单纯的模型规模时,可以选择它。 |
| MiniMax M2.5 (Text) | 如果你的工作负载需要经济、可扩展的推理能力,MiniMax M2.5 可通过紧凑的 10 billion 激活参数引擎处理编程、智能体编排和日常应用开发。其标价为每百万输入 tokens $0.3、每百万输出 tokens $1.2,缓存输入价格为每百万 $0.03,可降低重复上下文的成本。因此,它非常适合作为高容量、上下文复用型流水线的实用默认选择。 |
| MiniMax Music 2.6 API (Text to Music) | 描述一种风格,并提供带有 [Verse]、[Chorus] 等标签的结构化歌词,MiniMax Music 2.6 即可通过单次生成请求返回一首完整的人声或器乐曲目。输出格式包括 MP3、WAV 和 PCM,采样率最高 44.1 kHz、比特率最高 256 kbps;支持最长 2,000 字符的 prompts 和最长 3,500 字符的歌词。每次生成 $0.15,适用于原声带原型制作、广告短曲,以及应用和视频的背景音乐。 |
MiniMax 新功能 + 展示
将先进模型与 Atlas Cloud 的 GPU 加速平台相结合,为图像和视频生成提供无与伦比的速度、可扩展性和创意控制。
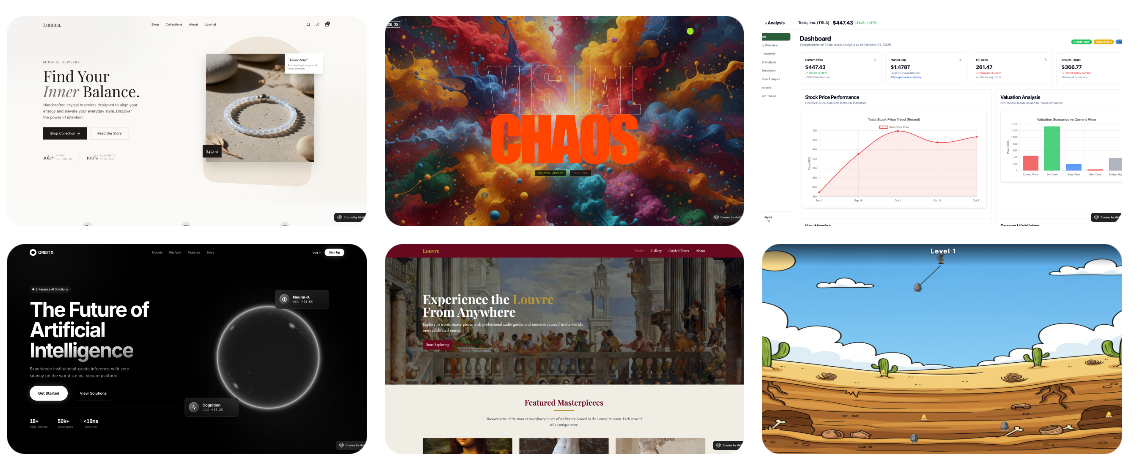
使用 MiniMax M2.5 实现高级编码与 Agent 规划
MiniMax M2.5 支持 10 多种编程语言,包括 Rust、Go 和 Python,助力在 Web、移动端和桌面平台上进行全面的全栈开发。通过融合专业文档排版和金融建模方面的深厚行业知识,它能够从系统架构设计无缝推进到最终交付物测试。它是复杂软件工程和高风险办公生产力工作流的权威解决方案。
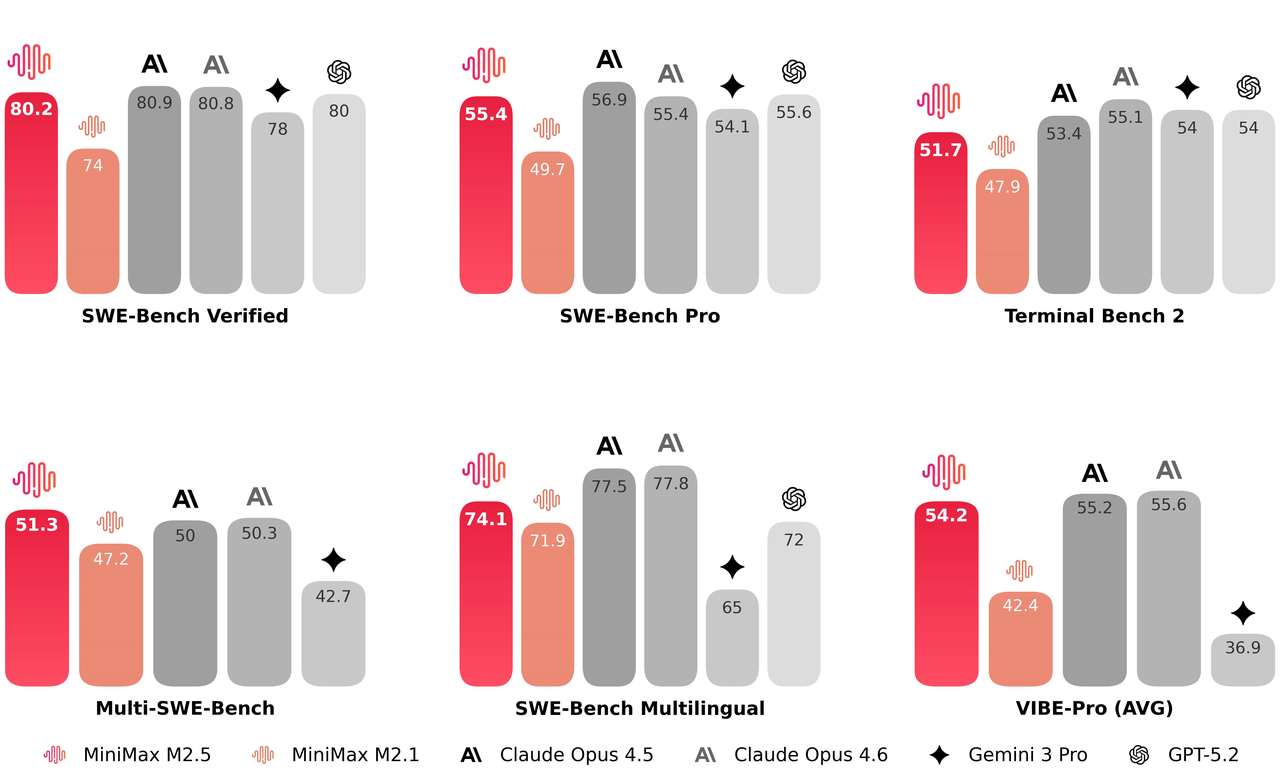
使用 MiniMax M2.5 提升快速响应与任务决策效率
M2.5 架构将端到端执行速度提升 37%,在 SWE-bench 上显著将复杂任务耗时从 31.3 分钟缩短至 22.8 分钟。通过优化任务拆解逻辑,该模型在 BrowseComp 等基准测试中达成目标所需的 token 和搜索轮次减少 20%。它为高速决策提供了更精简的解决方案,同时消除冗余的计算开销。
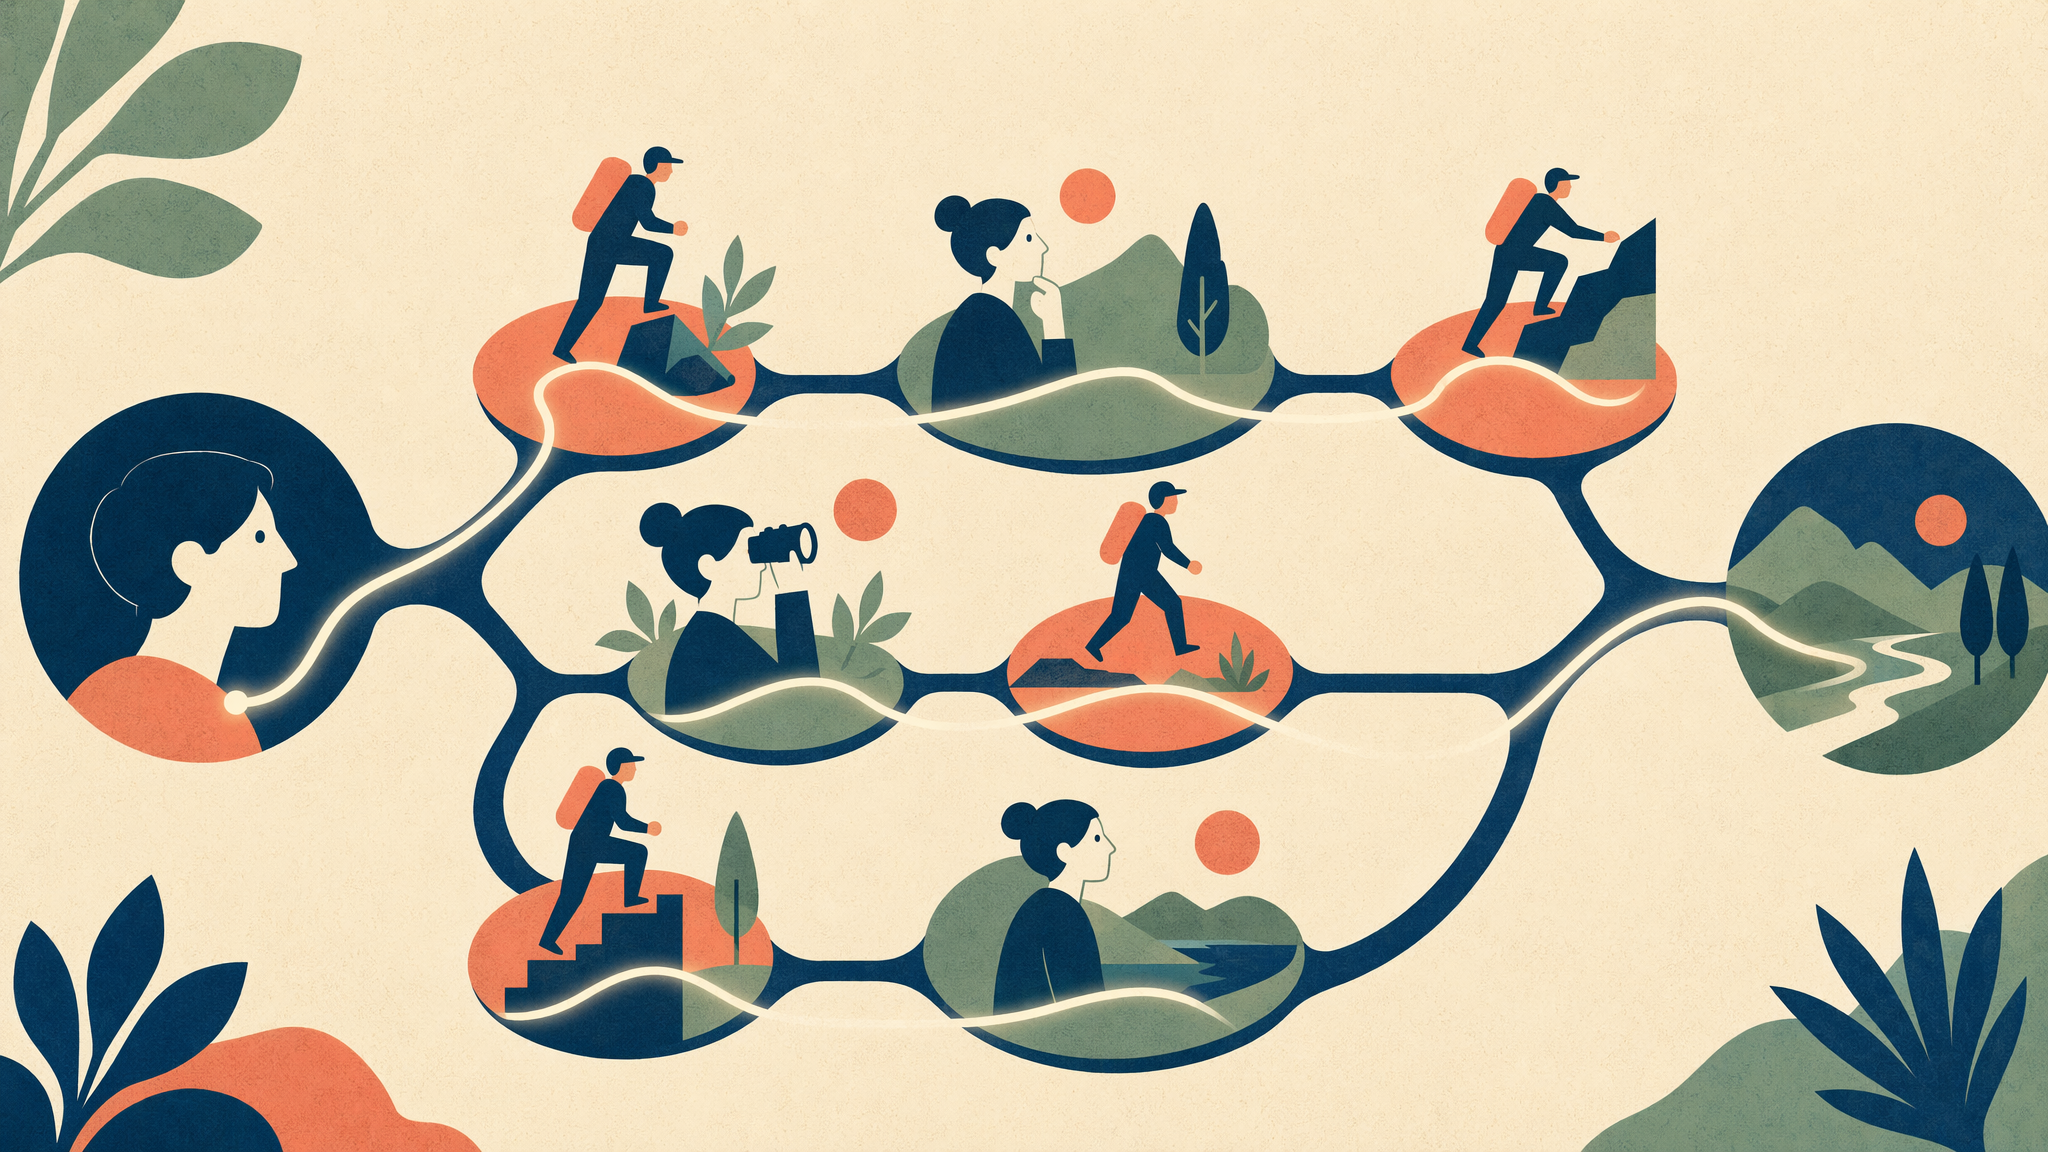
可保留推理链路的交错式思考
推理 token 会在多轮对话之间保留,因此模型在多轮 Agent 对话的每一步都能延续先前的思考过程。交错式思考让它能够规划、行动、观察并优化,而不会丢弃通向当前结果的逻辑。其收益是更稳定的长程决策能力;当单个任务跨越许多连续工具调用时,这就是决定性优势。
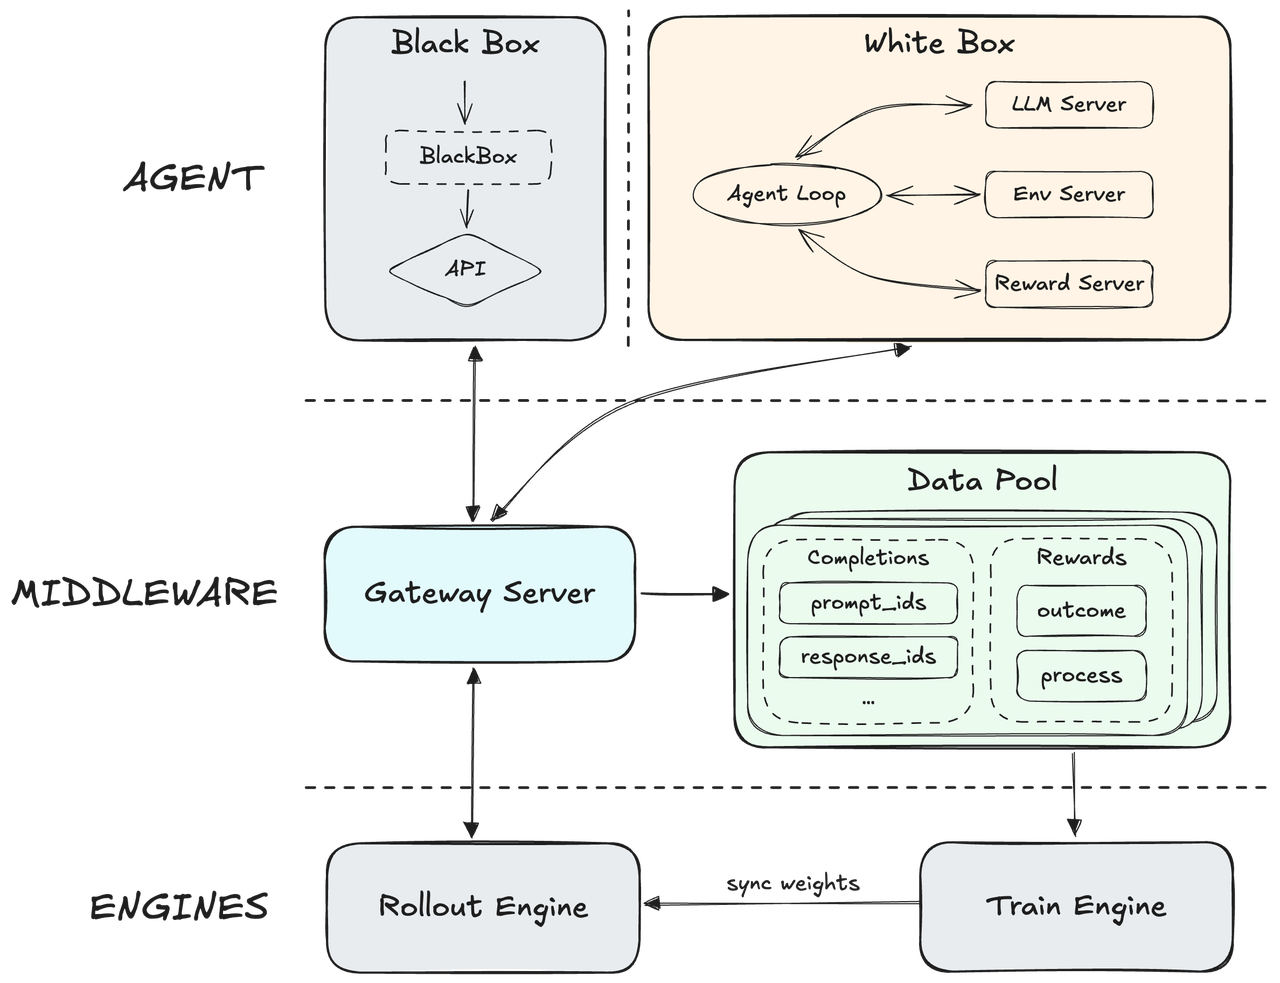
使用 MiniMax M2.5 通过大规模 RL 实现演进式架构
MiniMax 基于原生 Agent RL 框架构建,将核心引擎与 Agent 脚手架解耦,从而能够泛化到数十万个多样化的真实世界环境。它引入了先进的过程奖励机制,利用实时执行反馈来优化推理路径,并确保顶级输出质量。这打造了一个高度自适应的系统,能够在最大化整体运行响应速度的同时保持卓越准确性。
MiniMax API 中的 196K-token 上下文窗口
发送给 MiniMax M2.1 的每个请求都配备 196,608-token 上下文窗口,足以在单次处理中容纳庞大的 monorepo、数百页规格说明,或冗长的 Agent 转录记录。由于完整上下文始终驻留,模型能够跨文件追踪依赖关系,而不会在任务中途丢失脉络。处理大型代码库和高密度研究语料的团队,将获得短上下文模型无法比拟的连贯性。
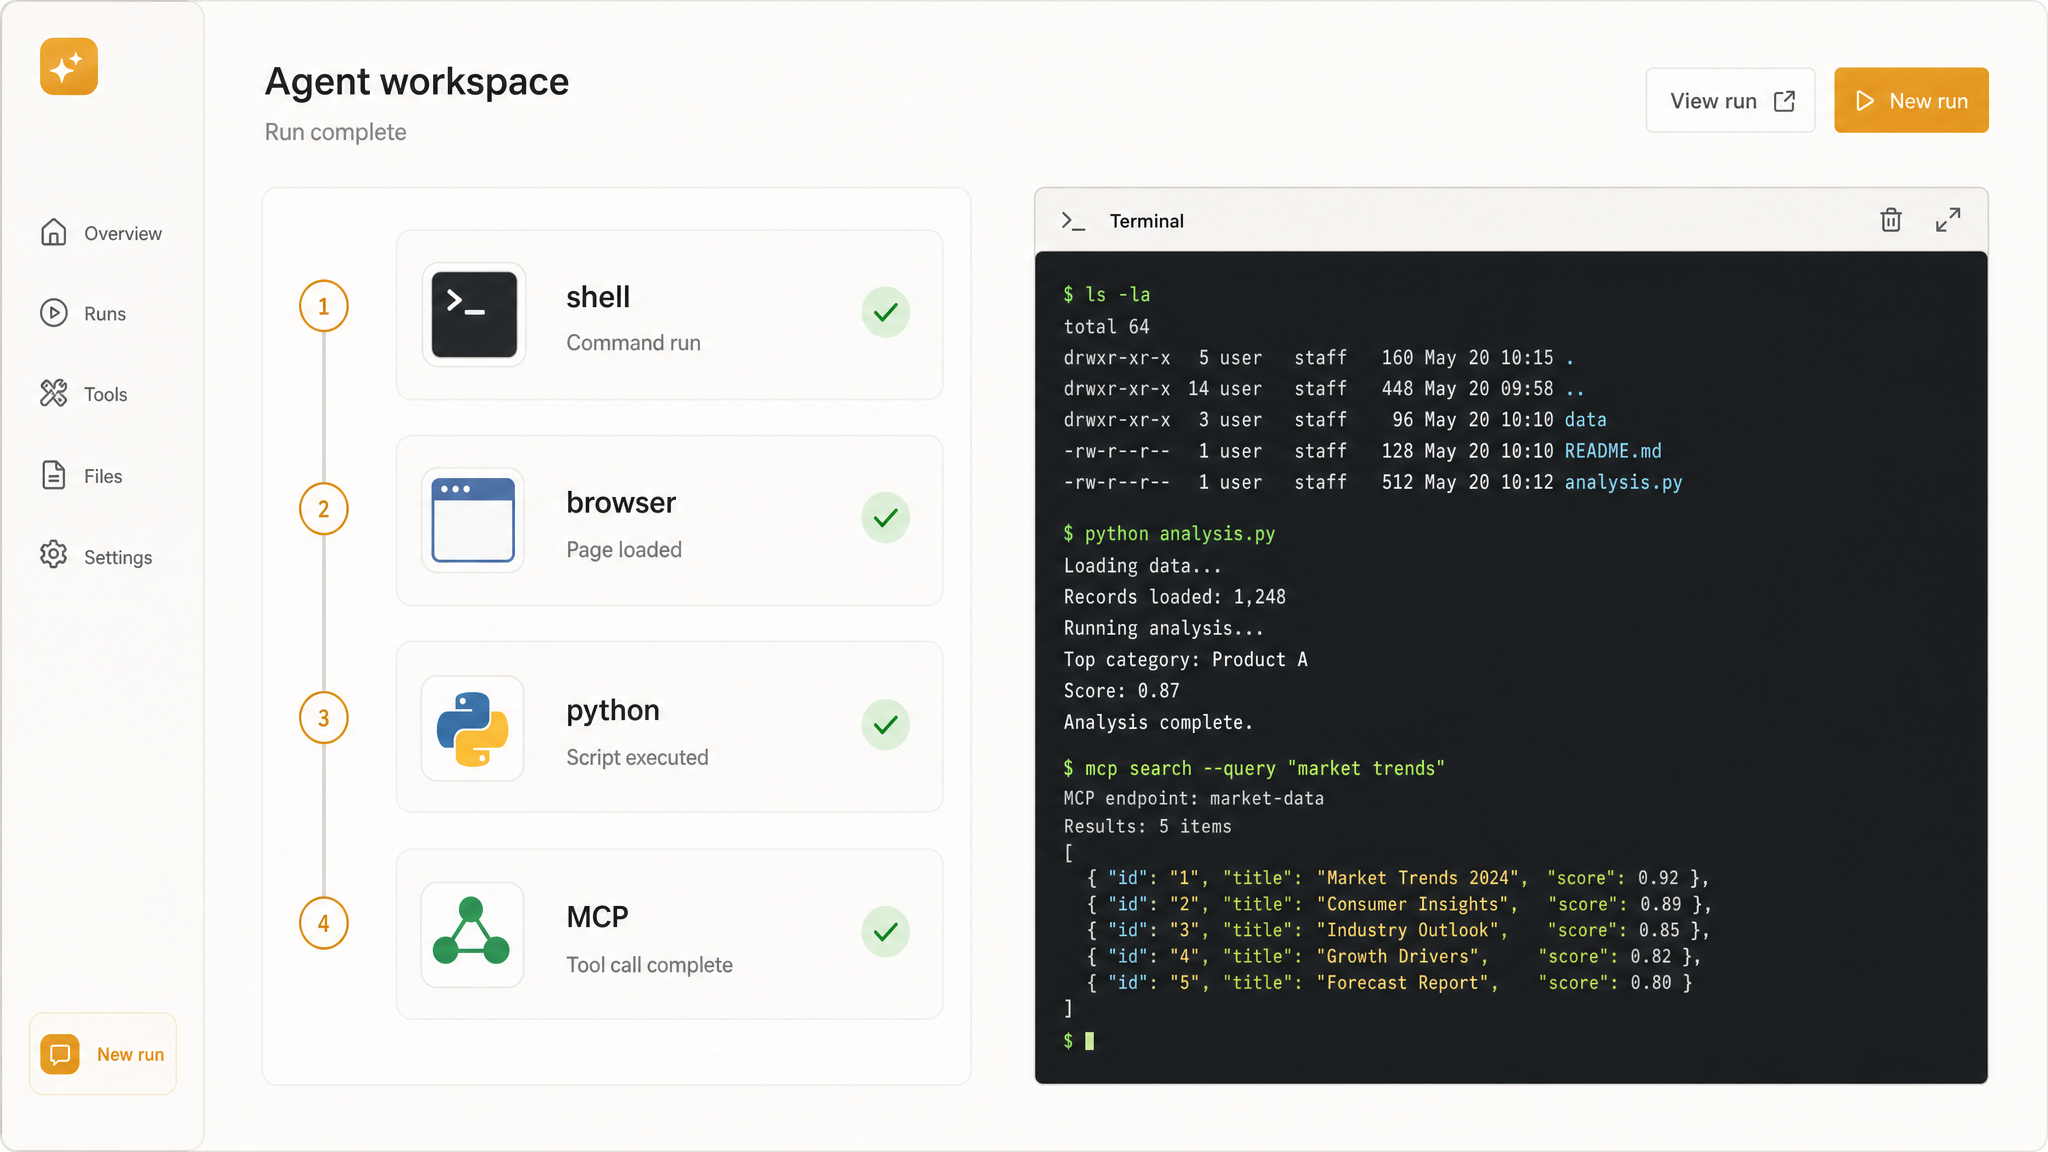
使用 MiniMax API 编排 Shell、Browser 和 Code
函数调用将 MiniMax M2.1 转化为主动式 Agent,可在长程计划中编排 shell 命令、浏览器会话、Python 执行和 MCP 工具。它能够串联数十个步骤,读取执行反馈并自我纠错,而不是在得到第一个结果时就停止。它在 Terminal-bench 2.0 上取得 47.9 percent 的得分,可作为自主构建、测试和部署循环的可靠基础。
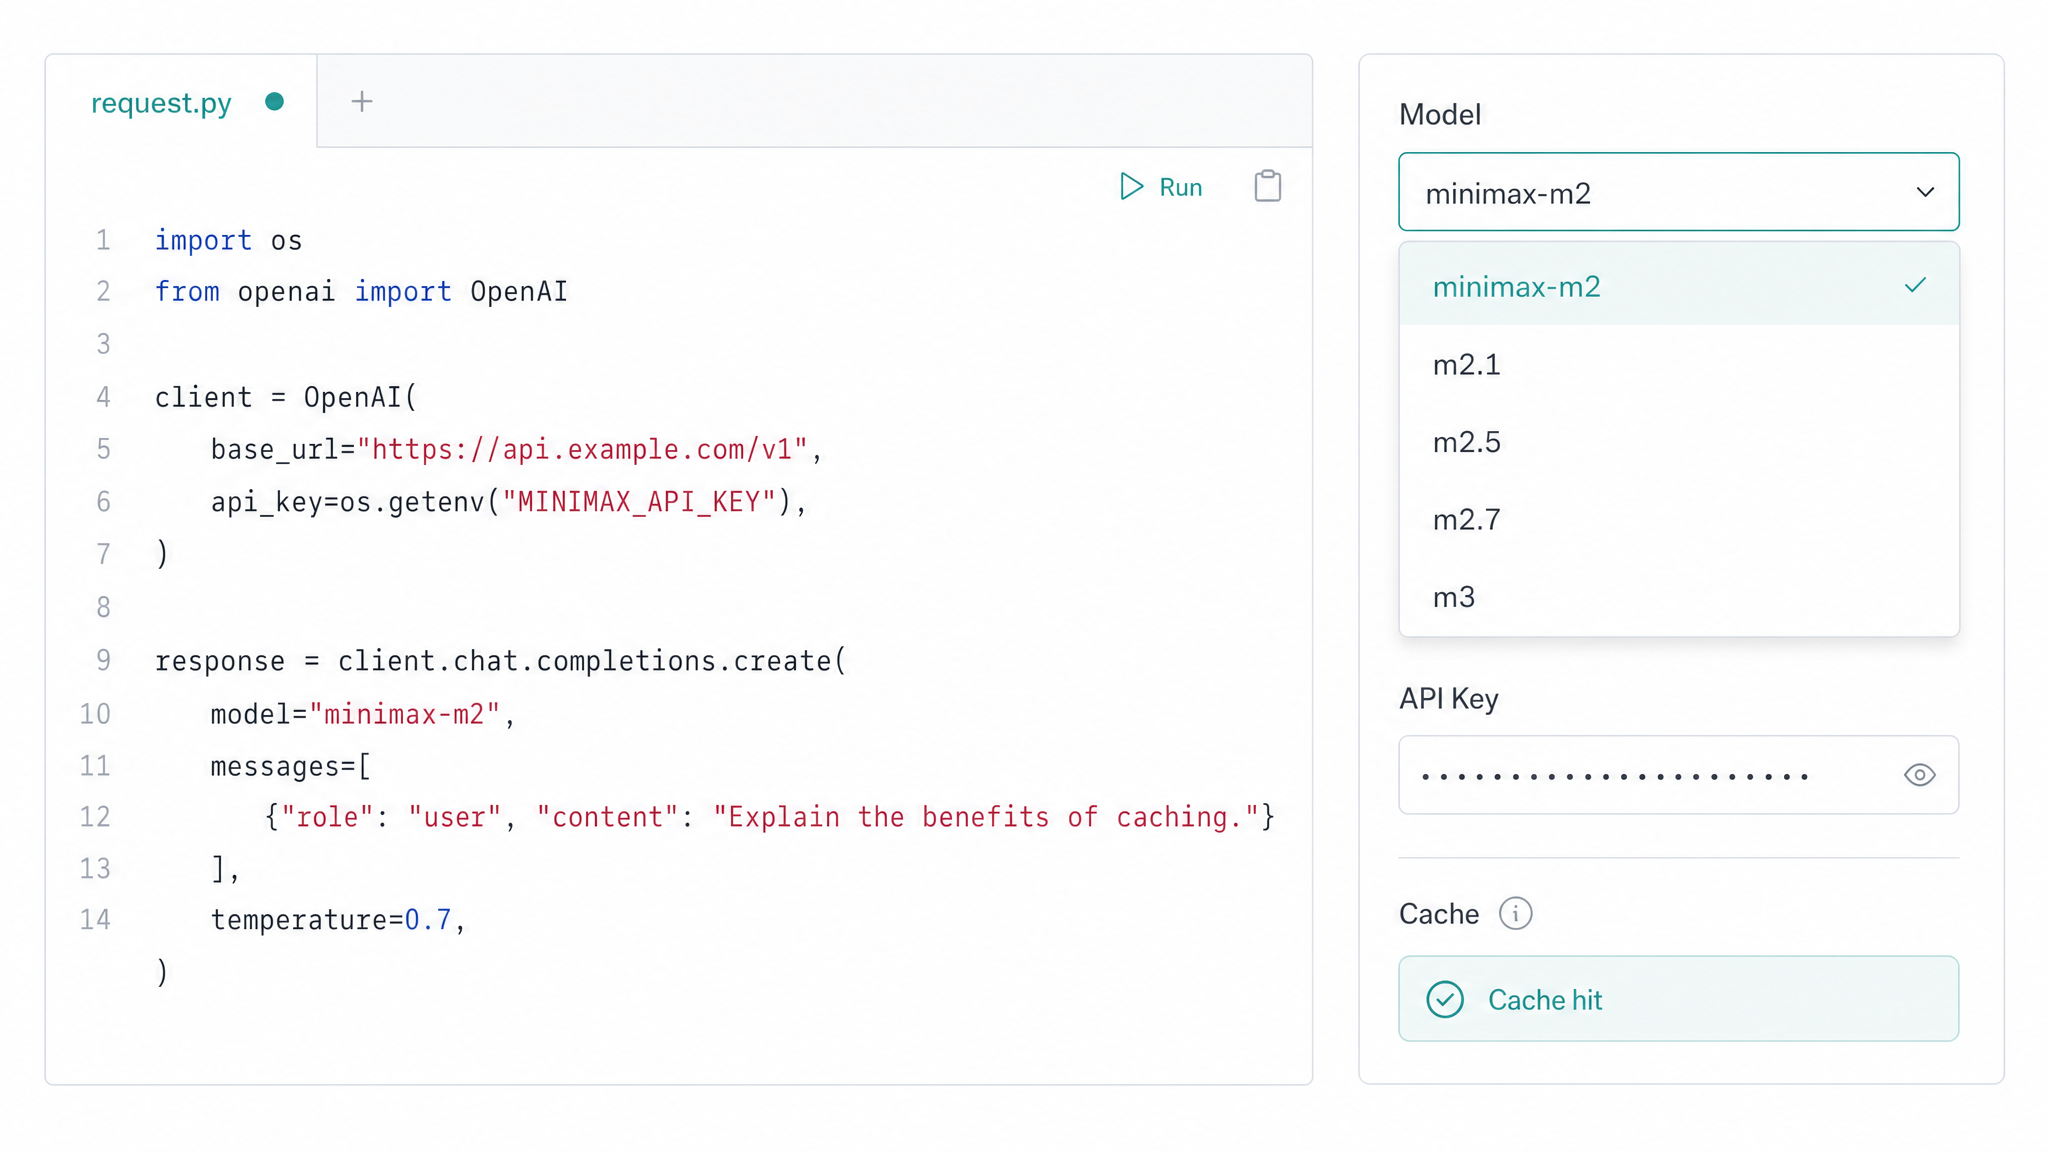
一个 MiniMax API Key 覆盖所有模型层级
一个兼容 OpenAI 的 key 即可解锁完整 MiniMax 产品线,从 M2、M2.1 到 M2.5、M2.7 和 M3,同时支持 Anthropic SDK 和原始 HTTP 访问。只需编辑一个模型字符串即可切换层级,无需重新改造你的技术栈。Prompt caching 会以每百万 token $0.03 的价格对重复上下文计费,因此迭代式 Agent 循环和长系统提示词在规模化使用时依然经济实惠。
一个提示,三个模型:MiniMax API 编码对决
将完全相同的构建提示分别输入 MiniMax API 和两个竞品模型,然后观察它们如何把一条指令转化为可运行的单文件网页。
一个精致、单文件、自包含的 HTML 页面(仅使用内联 CSS 和 JavaScript——绝对不使用外部库、CDN、字体或图片 URL;所有纹理都必须完全由 CSS 渐变、box-shadow 和 inset shadow 构建),渲染一个可交互、拟物化的 LETTERPRESS TYPESETTING WORKBENCH:用温暖的胡桃木工作台面填满视口(分层棕色渐变 + 通过 repeating linear-gradients 和类似噪点的阴影点描营造细微木纹),由左上方一盏温暖的钨丝灯照亮,使拉丝金属部件捕捉到柔和的镜面高光,并让每个凸起物体向右下方投下长而柔和的阴影。左侧:一个分隔式字盘(California job case),网格格子中放置微小的浮雕铅字字模(字母、数字、标点),每个字模都是带斜角的金属字块,正面有凸起的镜像反转字形。中央:一个打开的排字夹 / 活版托盘,用来累积已排好的铅字。提供完整可用的排字流程:(1) 用户通过实体键盘输入,或点击字盘中的字形;每输入一个字符,一个铅字字模就从对应格子中飞出并落入排字夹,伴随清脆的“咔嗒”微弹跳落定动画;(2) 字模之间可拖拽的细铅质空铅块允许用户通过拖动调整字距 / 字偶距,并实时重排版面;(3) 一个可旋转的上墨滚筒(brayer),用户可将其拖过锁版后的版面,在凸起字面上留下有光泽的深靛蓝油墨光泽(带有移动镜面反射动画);(4) 一个下拉式压印手柄,用户按下(点击并按住或按钮)后,会将一张奶油色纹理纸降到已上墨的版面上并压印——高潮时刻是手柄回弹,同时新印出的文字出现在纸面上,呈现真正凹陷的活版印刷质感:每个字母都被压入纸中,通过内阴影表现物理凹痕,油墨略微渗开 / 羽化到可见的纸纤维纹理中,版块周围有淡淡的压印光晕。配色:焦赭色、拉丝黄铜金和温暖的奶油 / 宣纸米白占主导,深靛蓝油墨是唯一的冷色点缀。加入可触摸的细节:黄铜手拧螺丝、锁版楔块、木色按钮及其逼真的按下 / 激活状态,以及每个过渡都采用令人满足的缓动(类似弹簧的 cubic-bezier)。实现响应式布局(可优雅缩放到平板宽度),所有状态使用 vanilla JS 管理,并允许用户排出一整句简短诗行、上墨并拉印出一张可供欣赏的成品——一切都必须有手工感、厚重感和仪式感,通过运动和阴影而非任何外部资源传达下落、拖拽和压印的物理感。
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
创建一个完整的、单文件、自包含的 HTML 文件,可在任何现代浏览器中直接打开且零外部依赖——所有 CSS 和 JavaScript 必须内联,不允许使用外部库、CDN、字体或图片 URL(所有内容都用 Canvas 2D 或代码生成的 SVG 绘制)。构建一个交互式“Brass Gear Train Workbench”:一个在布满灰尘的工程蓝图桌面上渲染的可拼装机械齿轮模拟器,用户可以组装一套可运行的齿轮传动系统,并观察真实且符合物理精度的旋转如何沿链路传递。 核心交互与仿真要求: - 将主舞台渲染为蓝图绘图台面:深工程蓝纸面上的细密青色网格,带有淡淡的灰尘薄膜和暗角,边缘还有尺寸刻度线与制图标注。 - 提供左侧零件箱 / 侧边栏,放置多种不同尺寸的齿轮(不同齿数 / 模数,例如 12、18、24、36、48 齿)。用户从零件箱拖拽齿轮到舞台上,松开时吸附到网格。 - 每个齿轮都必须绘制成真实的渐开线风格齿轮,采用黄铜色调——温暖金色主体、老化铜绿边缘、象牙色高光、可见轮毂、辐条和中心孔——并带有细腻的斜面明暗,让金属看起来就是金属。 - 实现真正的啮合检测:当两个已放置齿轮的中心距等于其节圆半径之和(module × teeth / 2)并在容差范围内时,它们会自动啮合并锁定为被驱动链路;在齿牙咬合处绘制啮合指示。链路可以通过多个齿轮分支。 - 在左下角放置一个曲柄手轮,作为视觉和机械起点。用户转动曲柄(拖拽旋转,或按住按钮);整个啮合链随后按顺序旋转。严格根据齿轮传动比计算每个下游齿轮的角速度和方向(ω_out = ω_in × N_in / N_out,每次啮合方向交替),并让齿牙在接触点保持完美相位锁定,使齿牙不会出现明显重叠或穿透。 - 链路中的最后一个齿轮驱动指针扫过带编号的表盘;指针必须显示由累计传动比得出的真实读数(实时文本显示计算得到的输出 RPM 和总传动比)。 - 如果用户尝试放置齿形无法啮合的齿轮(间距 / 模数不兼容),该连接必须卡死:红色闪烁,停止继续向坏连接之后传播,并显示一个小的“tooth mismatch”警告。 - 添加一束光:一束温暖的清晨阳光从上方窗户斜射穿过舞台,光束中有漂浮的尘埃微粒动画,并在齿轮转动时让温暖的镜面闪光掠过齿牙,使机器看起来像正在苏醒。 视觉与 UX 打磨: - 美术方向:复古工程手绘线稿与写实金属融合——蓝图细网格铺在黄铜、老化青铜、铜绿蓝绿和象牙白之下;温暖侧光配合长而柔和的投影,塑造体积与深度。 - 构图应让曲柄成为入口点,传动链沿画面对角线切入。 - 包含一个简洁 HUD,显示曲柄速度、总传动比、输出 RPM 和齿轮数量,并提供小型控件用于反转曲柄、清空舞台,以及用滑块调整曲柄速度。 - 一切都必须流畅(requestAnimationFrame)、响应窗口尺寸,并持续交互运行——拖拽、吸附、啮合和读数更新都应实时响应。让它具有可触摸的质感、精密感和生命力。
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
使用 MiniMax API 构建生产级软件
从多语言全栈构建到自主办公代理,MiniMax API 将 M2.1 的编码深度与长周期工具使用能力转化为您的团队每天都能交付的工作流。

跨语言全栈开发
MiniMax M2.1 可用 Rust、Go、TypeScript、C++ 等语言编写和审查生产代码,覆盖从底层系统到应用层的各个环节。构建多语言服务的团队可依靠它保持每一层的一致性。

通过 MiniMax API 构建原生移动应用
当 Android 和 iOS 功能需要同步交付时,MiniMax API 可生成符合平台规范的 Kotlin、Swift 和 Objective-C 代码。这让小团队无需拆分工程投入,也能同时维护两个应用商店。

基于 MiniMax API 的自主编码智能体
通过 function calling 将 M2.1 接入你的智能体循环,用于规划多步骤任务、运行工具,并在长周期任务中自我纠错。开发者可用它构建能完成真实工单的助手,而不只是生成代码片段。

面向办公工作流的数字员工
作为数字员工,M2.1 可根据纯文本指令,端到端执行行政、财务、数据科学和 HR 等领域的任务。运营团队可大规模部署它,清理重复性的后台办公工作。

196K Context 下的全代码库推理
需要在不熟悉的代码库中进行跨文件重构?凭借 196.61K token 的上下文窗口,M2.1 可一次读取数百个文件,追踪依赖关系,并找出迁移真正需要的改动。

通过 MiniMax API 构建交互式 Web 界面
强大的设计理解能力让 MiniMax API 能够构建精美的 Web 前端、复杂交互,甚至 3D 科学场景模拟。产品团队只需一个 prompt,就能直接交付数据密集型仪表板和可视化内容。
MiniMax API 与其他编程和智能体 LLMs 的对比
在 Atlas Cloud 上将 MiniMax API 与竞争的智能体和编程模型进行对比,详细评估其上下文窗口、输出上限以及按需付费的 token 定价。
| Model | Context Window | Max Output | Input Price ($/1M) | Output Price ($/1M) |
|---|---|---|---|---|
| MiniMax M3 | 524K tokens | 512K tokens | $0.60 / $1.20 (>512K) | $2.40 / $4.80 (>512K) |
| MiniMax M2.7 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| MiniMax M2.5 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| Kimi K2.7 Code | 262K tokens | 262K tokens | $0.95 | $4.00 |
| GLM 4.7 | 203K tokens | 203K tokens | $0.60 | $2.20 |
| DeepSeek V4 Flash | 1M tokens | 393K tokens | $0.14 | $0.28 |
如何在 Atlas Cloud 上使用 MiniMax
几分钟即可上手 — 按照以下简单步骤,通过 Atlas Cloud 平台集成和部署模型。
创建 Atlas Cloud 账户
在 atlascloud.ai 注册并完成验证。新用户可获得免费额度,用于探索平台和测试模型。
为何在 Atlas Cloud 使用 MiniMax
将先进的 MiniMax 模型与 Atlas Cloud 的 GPU 加速平台相结合,提供无与伦比的性能、可扩展性和开发体验。
性能与灵活性
低延迟:
GPU 优化推理,实现实时响应。
统一 API:
一次集成,畅用 MiniMax、GPT、Gemini 和 DeepSeek。
透明定价:
按 Token 计费,支持 Serverless 模式。
企业与规模
开发者体验:
SDK、数据分析、微调工具和模板一应俱全。
可靠性:
99.99% 可用性、RBAC 权限控制、合规日志。
安全与合规:
SOC 2 Type II 认证、HIPAA 合规、美国数据主权。
MiniMax API 常见问题解答
MiniMax API 让开发者能够以编程方式访问由 MiniMax AI 构建的 MiniMax 大语言模型家族。这一系列模型围绕编码、智能体工具使用和长程推理进行工程化设计。在 Atlas Cloud 上,你可以通过一个兼容 OpenAI 的 endpoint 访问这些模型,并享受透明的按量付费价格以及新版本 Day-0 访问权限。
Atlas Cloud 托管了 M-series 文本模型,包括 MiniMax M2.5、MiniMax M2.7 和旗舰模型 MiniMax M3,同时还提供用于 text-to-music 生成的 MiniMax Music 2.6。所有模型共用同一套身份验证和 endpoint,因此在它们之间切换只需更改请求中的一个 model identifier。
这些模型针对端到端软件工程进行了优化,能够处理多文件编辑、compile-run-fix 循环,以及跨多种编程语言、经测试验证的修复任务。它们在需要 function calling、多步规划和从执行错误中恢复的智能体场景中也表现稳定,因此非常适合自主编码智能体和工具驱动型工作流。
由于 MiniMax API 兼容 OpenAI,你可以将标准 OpenAI SDK 指向 Atlas Cloud base URL,传入你的 key,并将 model 字段设置为所需版本。Streaming、function calling 和 JSON-structured output 都通过同一接口运行,因此大多数现有集成只需更改 base URL 和 key 即可开始使用。
上下文窗口因版本而异。MiniMax M2 支持约 200K tokens,足以在单次请求中加载大型代码库或篇幅较长的文档;更新的 M3 则将其扩展到约 1 million tokens。当任务跨越许多文件或需要处理较长参考资料时,应选择更高上下文的模型。
计费采用按量付费并按 token 计量,无需订阅。M2-series 文本模型起价为每 million input tokens $0.30、每 million output tokens $1.20;更高容量的 M3 价格为每 million input $0.60、每 million output $2.40,cached input 按更低费率计费。
是的。MiniMax 已根据修改版 MIT license 开源 M-series weights,该许可针对超大规模商业部署增加了署名要求。你可以自行托管这些 weights 进行评估;当需要托管式基础设施、稳定在线服务以及免 GPU 维护时,再迁移到 Atlas Cloud API。
MiniMax 旨在以大型专有模型一小部分的成本,提供前沿级别的编码和智能体能力。它采用 mixture-of-experts 设计,每个 token 只激活其 230 billion parameters 中约 10 billion。 如果你的工作负载是代码生成、重构,或预算紧张的工具调用型智能体,它能在能力、速度和价格之间提供很强的平衡。基准排名会随每次发布而变化,因此在投入使用前,请用你自己的任务验证当前版本。
探索更多系列
Seedance 2.5
Seedance 2.5 API 现已在 Atlas Cloud 上线!它为开发者提供了 ByteDance 最新的视频模型。该模型可通过文本、单张图像或多达 50 个多模态参考,一次性生成长达 30 秒的原生视频,并包含同步音频和画面内的多语言文本。在 Atlas Cloud 上,您可以通过单个密钥访问它,其主体一致性和改进的物理特性能够保持长镜头的连贯性。

Wan 3.0
Wan 3.0 API 是阿里巴巴 Wan 视频系列的下一代产品,旨在将长视频生成、多参考控制和音视频质量推向新的高度。Atlas Cloud 已经托管了 Wan 2.7、2.6 和 2.5,而 Wan 3.0 使用相同的统一密钥运行,无需额外设置。立即开始构建吧。向下滚动至展示区,查看 Wan 3.0 的创作能力。
MiniMax H3
MiniMax H3 是 MiniMax 的视频模型系列,支持文本、图像和参考图驱动的生成。创建 5 至 15 秒的视频片段,使用可选的末帧引导运动,保留参考图像中的主体;如果生成音频符合工作流,也可以选择 H3 Developer。Atlas Cloud 将 H3、H3 Fast、H3 Max 和 H3 Developer 纳入统一的 API 工作流,标准价格从 $0.038/秒起。立即开始构建。
Seedream 5.0 Pro
Seedream 5.0 Pro API 为开发者在 Atlas Cloud 上提供了字节跳动的可控图像编辑模型。它通过锚点和坐标精确定位编辑,将图像分离为可编辑图层,融合多个参考,并精准匹配颜色和材质,支持 2K 和 3K 分辨率的多语言文本。在 Atlas Cloud 上,您只需一个密钥即可访问!
Seedance 2.0
Seedance 2.0 API 为您提供 ByteDance 多模态视频模型的生产级访问权限——支持四模态输入(文本、图像、视频、音频),以及行业领先的“Universal Reference”(通用参考)系统,可在不同镜头间锁定构图、运镜和角色动作。只需一次 API 调用即可集成导演级控制,固定费率为 $0.09/秒,即时获取密钥,无需排队——由企业级正常运行时间和合规性提供保障。Seedance 2.0 原生 4K 现已上线!
GPT Image 2.5
OpenAI 的 GPT Image 2.5 系列为开发者在生产图像工作流中提供了 Flare 和 Sunburst 两种选择。支持高达 3840x2160 的任意分辨率渲染,并可从包含 xhigh 和 max 的五个质量等级中进行选择,以满足特定的输出要求。Atlas Cloud 提供即用型的 REST 推理服务,无冷启动,标准定价为每次生成 0.004 美元起。立即开始构建吧。
GPT Image 2
GPT Image 2 API 为开发者提供了访问 OpenAI 最新图像模型的途径,它是 GPT Image 1.5 的继任者。该模型可生成和编辑图像,能够在拉丁和 CJK 文字上实现准确的文本渲染,并在海报、样机和信息图表方面具备强大的排版能力。在 Atlas Cloud 上,您可以通过一个统一的 API 与 300 多个模型一起访问它,并享受免费额度、99.99% 的正常运行时间,且无需 OpenAI 组织验证。
Gemini Omni Flash
gemini omni API 将 Google DeepMind 原生多模态的 Gemini Omni Flash 系列(包括 Gemini Omni 1.1 Flash)带给开发者。创建带同步原生音频的电影级视频,使用精确的起始帧和结束帧控制为静态图像制作动画,或通过文本引导式编辑修改现有视频,同时保留未编辑的内容。Atlas Cloud 提供一个 OpenAI 兼容密钥、统一访问能力以及透明的按量付费定价。立即开始构建。
Grok Imagine
Grok Imagine API 涵盖 xAI 的图像、视频和语音模型,包括 Image 2.0、Video 1.5 和 xAI TTS v1。支持生成跨 14 种宽高比的 1K 或 2K 静帧、生成最长 15 秒的 1080p 视频、通过最多 7 张参考图像引导镜头、或用 20 种语言进行配音。Atlas Cloud 在单一端点上运行所有功能,采用按量计费,起价为每张图像 $0.02、每秒 $0.05。立即开始使用。
Google最强大的创意模型现已在Atlas Cloud上全面可用。Veo 3.1提供电影级别的视频生成,Nano Banana 2支持高保真图像创建,而Gemini为每个工作流带来多模态智能。通过单一API key即可访问完整的Google模型套件,提供Day-0可用性和按需付费(pay-as-you-go)定价。
Seedance 2.0 Mini
Seedance 2.0 Mini 将 ByteDance 的多模态视频生成技术引入到对速度和成本要求极高的工作流中。它以更轻量的占用空间提供 Seedance 2.0 的核心能力——更快的生成速度、更低的单条视频成本,并且使用您现有的同款 API 集成。对于运行高吞吐量流水线或进行大规模原型设计的团队来说,Mini 是最实用的默认选择。
ByteDance
从电影级视频生成到高保真图像创建,ByteDance 最强大的模型现已在 Atlas Cloud 上线。以最低的推理定价和零基础设施开销,大规模运行 Seedance 和 Seedream。


