
 Atlas Cloud 现已成为 Dreamina Seedance 2.5 与 Seedream 5.0 Pro 的美国授权经销商。Atlas Cloud 现已成为 Dreamina Seedance 2.5 与 Seedream 5.0 Pro 的美国授权经销商。
Gemini Omni 是 Google DeepMind 原生多模态视频系列,支持通过提示词引导创作与编辑。可从文本生成视频、让静态图像动起来,或在可选视觉参考的辅助下修改现有素材,同时保留未改动的内容。灵活的分辨率、宽高比和时长控制,满足多样化的制作流程。Atlas Cloud 通过透明的按需付费定价模式,统一提供访问能力。立即开始构建。
Gemini Omni Flash 由 Google 开发。Atlas Cloud(由 Atlas Cloud AI LLC 运营)仅提供接入服务,并不拥有该模型。所有商标均归其各自所有者所有。
Atlas Cloud 为您提供最新的行业领先创意模型。
对比七个专业视频端点的 Gemini Omni 输入路径、输出能力和生产应用场景。
| 模态 | 描述 |
|---|---|
| Gemini Omni Flash R2V API (Reference To Video) | 将文本提示与 1 到 5 张参考图片结合,即可生成带原生声音的电影感视频。主体、场景和风格的一致性,使该端点适用于品牌系列内容、 recurring 角色和协调统一的视觉叙事。 |
| Gemini Omni Flash I2V API (Image To Video) | 以静态图片和文本提示为基础,该端点可生成带声音的电影感视频,同时保留源主体和构图。适用于产品动画、肖像动态化和视觉概念开发。 |
| Gemini Omni Flash Video Edit API | 提交现有视频、文本指令和可选参考图片,即可在保持场景一致性的情况下进行修改,并保留原生音频。由于未修改的素材会得到保留,编辑人员可以进行针对性调整,无需重建整个场景。 |
| Gemini Omni Flash T2V API (Text To Video) | 仅凭文本提示即可生成带同步原生音频的电影感视频,动作符合现实世界物理规律。其可控的高速生成能力支持概念可视化、故事开发和快速视频原型制作。 |
| Gemini Omni Flash R2V Developer API | 如需进行引导式转换,可将现有视频片段与参考图片和文本提示结合使用。该端点支持视频风格迁移、场景编辑和角色插入,适用于根据所提供素材生成定向变体的创意应用。 |
| Gemini Omni Flash I2V Developer API | 最多可使用 7 张参考图片引导文本生成视频,同时在整个结果中保持视觉身份一致。对于 recurring 角色、一致的产品视觉素材或贯穿整个营销活动的统一资产,可选择此路径。 |
| Gemini Omni Flash T2V Developer API | 结合文本提示以及所需的分辨率、宽高比和时长,生成可控的电影感视频。灵活的输出设置可帮助开发者创建适配特定平台的内容、自动化生成工作流,并测试多种创意方向。 |
每个 Gemini Omni Flash API 请求都可以接收任意组合的文本、图片、视频和音频,生成同步声音,模拟真实世界物理规律,并通过对话不断优化结果。
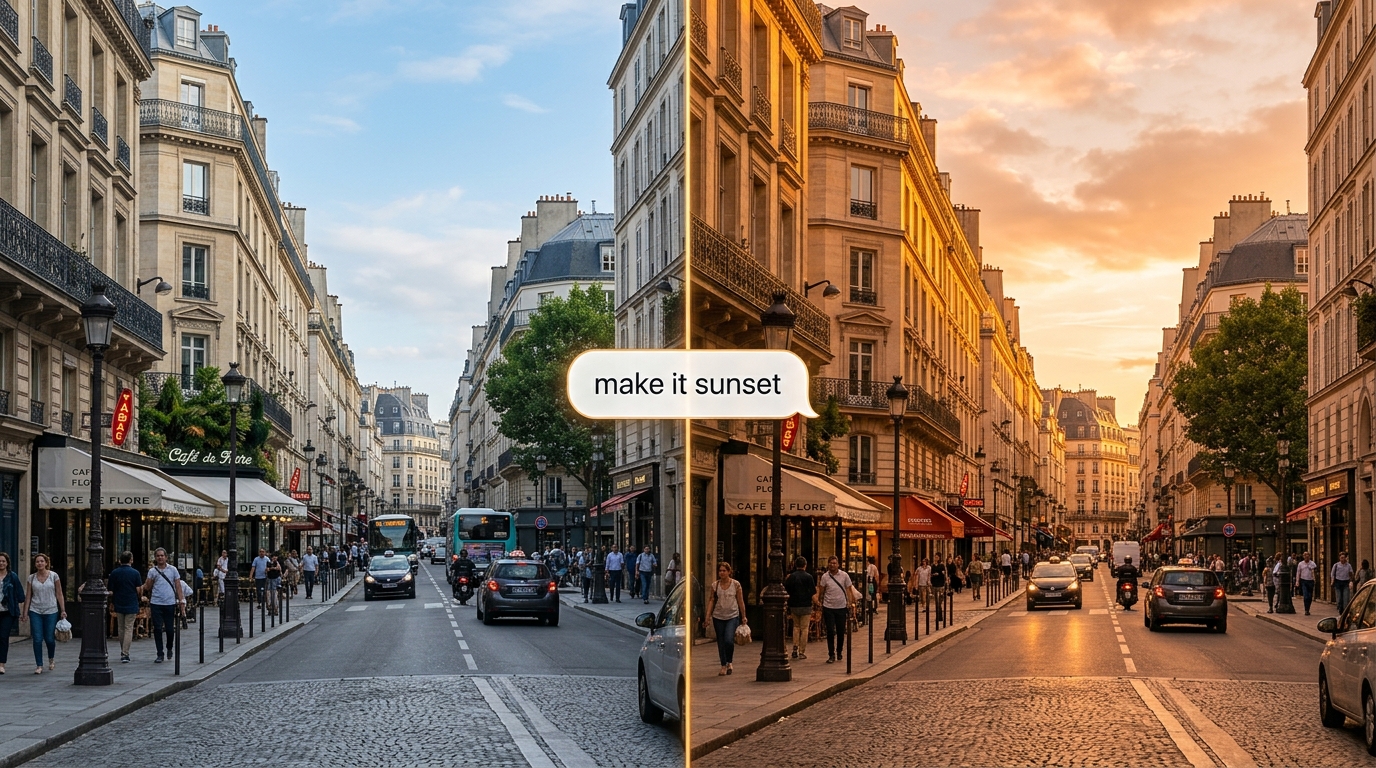
使用自然语言优化片段,Gemini Omni Flash API 会应用相应修改,同时保留场景的其他部分。其有状态的 Interactions API 会记住每一轮对话,让每次编辑都能基于之前的修改继续进行。
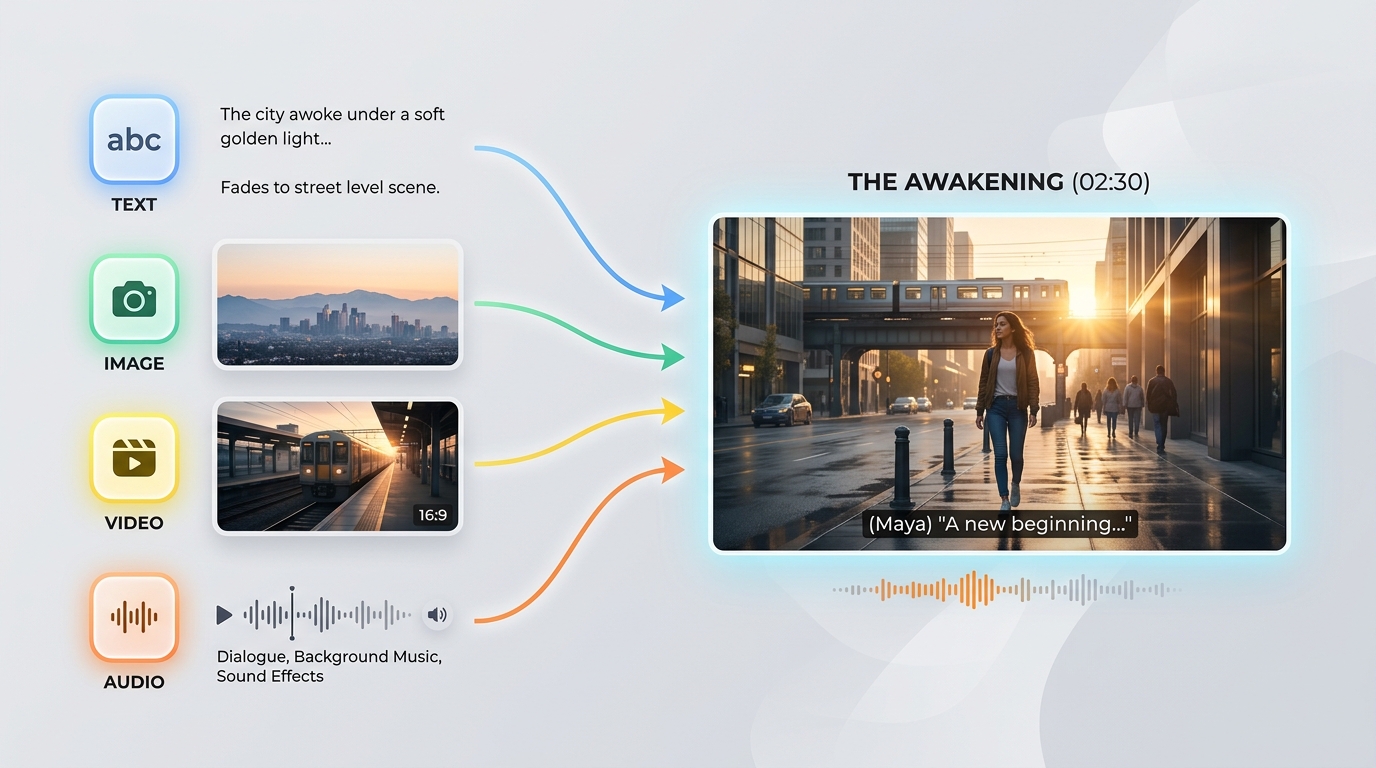
Gemini Omni Flash API 支持在单个提示中接收任意组合的文本、图片、视频和音频。这种“万物皆可输入”的能力,让你可以使用已有的任何素材驱动生成。
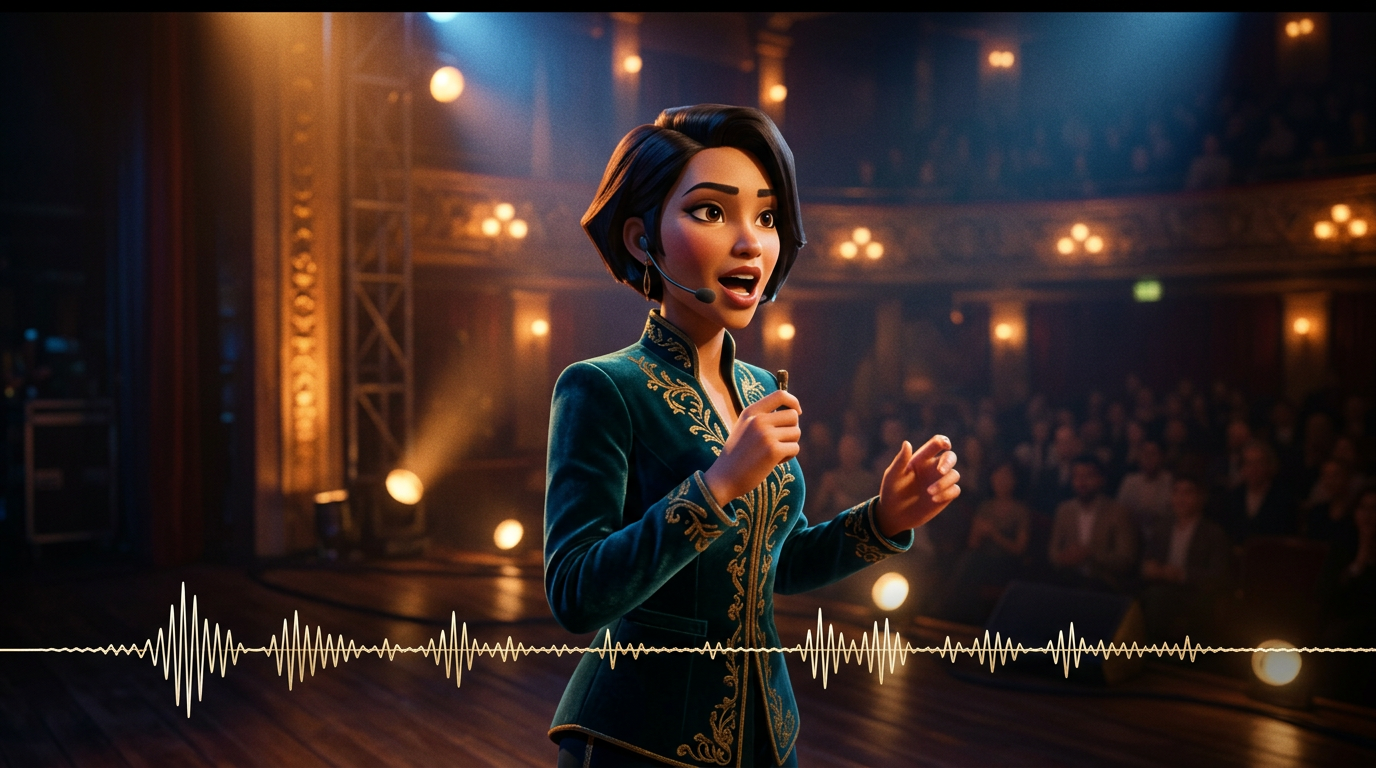
声音与画面在一次推理中同步生成,因此对白、音效和环境声始终与动作保持一致。Gemini Omni Flash API 无需之后再单独处理音频。
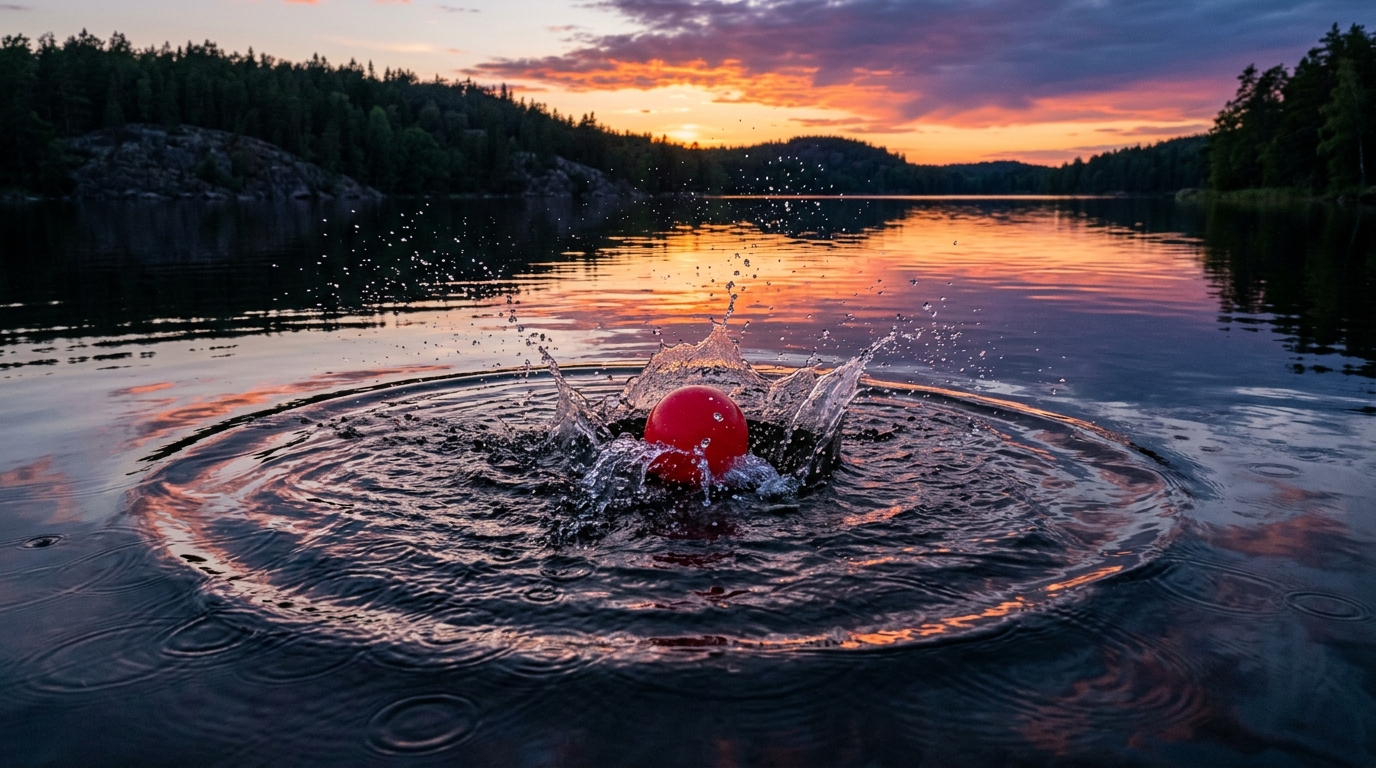
Gemini Omni Flash API 基于真实世界物理规律的模型,能够渲染逼真的反射、重力、光照和天气效果。即使在动态镜头中,场景也能保持视觉上的连贯,而不会逐渐出现伪影。
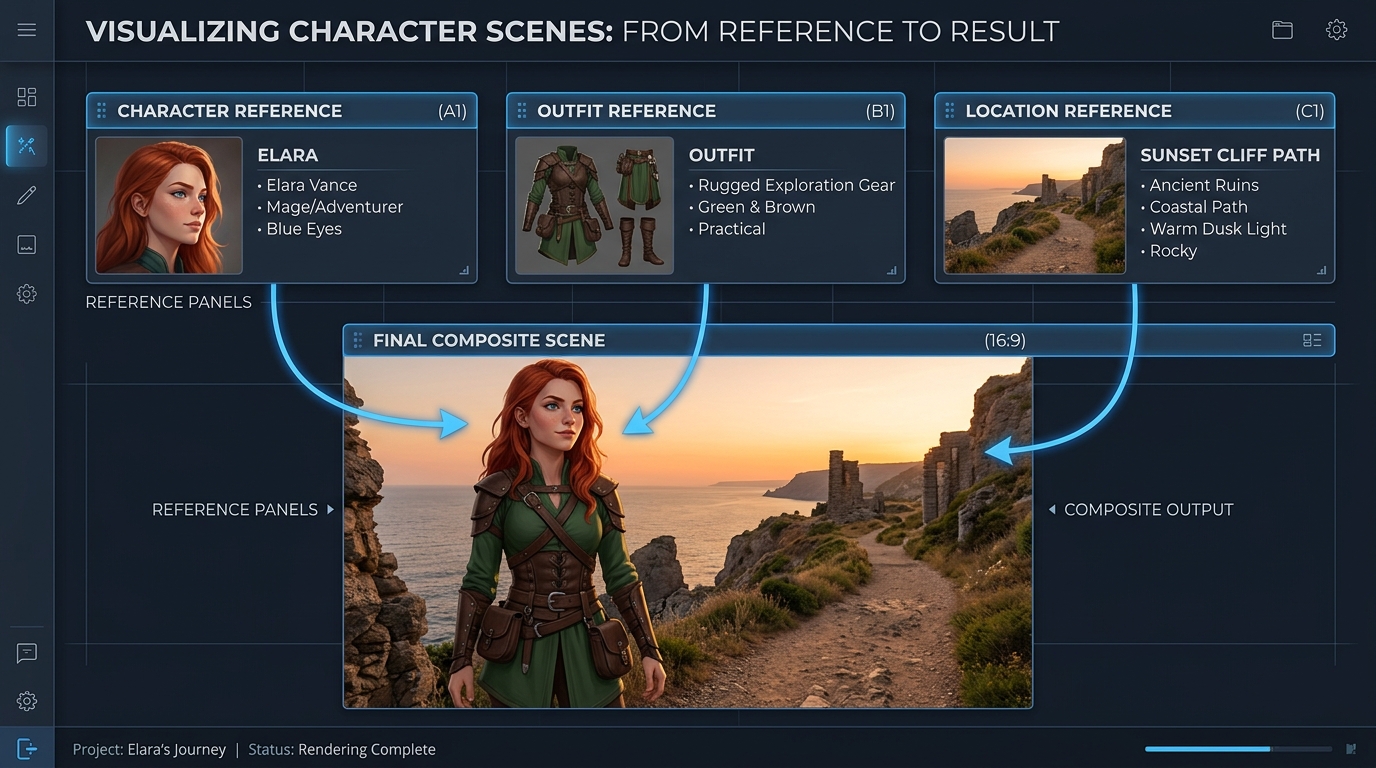
你可以使用最多七张参考图片和三段短视频引导生成,Gemini Omni Flash API 会保持主体、风格和场景的一致性。这能让主体身份在多次编辑和不同镜头之间保持稳定。
Gemini Omni 与其他领先视频模型使用相同提示词生成:多镜头与高端商业影片
生成一个由 3 个场景连续组成的视频: 场景 1: 一名女子站在东京一条下着雨的街道上,霓虹灯在她身上闪烁。湿润地面映出倒影,具有电影感的景深和手持摄影机运动。 场景 2: 摄影机缓慢切换到更近的镜头。她与提供的语音同步轻声说话,唇部动作与语音完美匹配。背景中的交通流畅自然地持续着。 场景 3: 她走进一座地铁站。光线、天气和氛围保持一致。摄影机从后方跟随她,同时保持人物身份的一致性。 约束条件: - 确保所有场景中的面部身份完全一致 - 保持光线连续性(雨水、霓虹灯倒影) - 确保物理真实感(雨水互动、湿润表面) - 确保与输入语音保持视听同步 - 转场之间不得重置场景;保持连续的世界状态 风格: 高端电影级写实风格、胶片颗粒、变形宽银幕镜头、浅景深、4K 胶片质感
Gemini Omni
Wan 2.7
Kling v3.0
生成一个由 4 个场景连续组成的视频: 场景 1: 午夜时分,在一间昏暗的公寓里,一台小型白色机器人静静地坐在木桌上。月光透过窗户照进来。机器人的眼睛缓慢亮起,随后响起微弱的机械嗡鸣声。 场景 2: 机器人小心翼翼地从桌上爬下来。它小巧的金属脚在木地板上发出轻微的咔哒声。摄影机以低角度跟拍,保持机器人大小和形状的一致性。 场景 3: 机器人走进厨房。冰箱门和瓷砖地板上的倒影随着它的移动自然变化。上一场景中的月光和宁静的夜间氛围延续至此。 场景 4: 机器人在窗边停下,望向窗外的城市灯光。摄影机从后方缓慢推进,同时保持机器人在身份、材质、比例、光线和声音上的连续性。 要求: - 确保所有场景中的机器人设计完全一致 - 保持公寓布局连续,不得重置场景 - 确保不同房间之间的光线保持一致 - 使脚步声和机械嗡鸣与机器人的动作匹配 - 使用符合物理规律的倒影、阴影和物体互动 - 场景之间平滑过渡,仿佛在拍摄一个连续的世界 风格: 电影级写实风格、宁静的科幻氛围、柔和月光、细致材质、真实的摄影机运动、浅景深、高端商业影片质感
Gemini Omni
Kling V3.0
Pixverse v6
Gemini Omni 通过文本、图像、参考素材和视频编辑工作流,结合同步原生音频,贯穿营销活动制作、对话式修改、预可视化、视觉化学习、品牌连续性和内置创作者工具。

将已获批准的产品静帧制作成电影感动态画面,同时保留主体和构图。营销团队可以制作新品预告、社交广告和精美的产品展示,并配以同步原生音频。

描述需要调整的部分,Gemini Omni 即可编辑现有素材,同时保持未修改内容不变。剪辑师无需重建已获批准的场景,就能制作不同版本、适配本地化的变体和客户修改稿。

使用参考图像引导生成,让产品、角色和视觉风格在整个片段中保持一致。制片公司可以跨渠道打造协调统一的营销素材、持续发展的品牌世界和易于识别的系列内容。

从文本提示开始,生成带同步音频且符合现实世界物理规律的电影感视频。导演和设计师可以在制作前探索故事节点、镜头创意和面向不同平台的格式。

通过描述场景、动作和预期的学习顺序,将抽象概念转化为简短的视觉化讲解。教育团队可以制作科学演示、流程演示和培训模块,并配以原生音效。

在一个 Gemini Omni 集成中,整合文本生成、静态图像动画、参考素材引导创作和视频编辑。创作者平台无需组装独立的视觉与音频管线,即可提供相互连接的制作工具。
对比 Gemini Omni API 参考视频模型(包括 Gemini Omni 1.1 Flash)与主流替代方案,比较其支持的输入类型、参考容量、音频生成能力和标准价格。
| 模型 | 接受的输入 | 参考容量 | 音频生成 | 标准价格 | Standard Base Price |
|---|---|---|---|---|---|
| Gemini Omni 1.1 Flash Reference-to-Video | Text, source video, reference images | Conversational additions, removals, replacements, and restyling | 360p, 720p, upscaled 1080p, upscaled 4K | Native synchronized audio | $0.041 |
| Gemini Omni Flash Reference-to-Video | Text, source video, up to 5 reference images | Scene-consistent edits that preserve untouched footage | 720p | Native audio editing | $0.14 |
| Seedance 2.0 Reference-to-Video | Text, source video, up to 5 reference images | Instruction-guided video changes with visual references | 720p, 1080p | Automatic audio or original audio retention | $0.14 |
| Wan-2.7 Reference-to-video | Text, source video, reference images, optional driving audio | Style transfer, scene changes, and element replacement | 720p, 1080p | Original audio retention, regeneration, or driving audio | $0.10 |
几分钟即可上手 — 按照以下简单步骤,通过 Atlas Cloud 平台集成和部署模型。
在 atlascloud.ai 注册并完成验证。新用户可获得免费额度,用于探索平台和测试模型。
将先进的 Gemini Omni Flash 模型与 Atlas Cloud 的 GPU 加速平台相结合,提供无与伦比的性能、可扩展性和开发体验。
低延迟:
GPU 优化推理,实现实时响应。
统一 API:
一次集成,畅用 Gemini Omni Flash、GPT、Gemini 和 DeepSeek。
透明定价:
按 Token 计费,支持 Serverless 模式。
开发者体验:
SDK、数据分析、微调工具和模板一应俱全。
可靠性:
99.99% 可用性、RBAC 权限控制、合规日志。
安全与合规:
SOC 2 Type II 认证、HIPAA 合规、美国数据主权。
Gemini Omni API 通过 Atlas Cloud 为开发者提供 Google DeepMind 原生多模态视频生成与编辑系列模型的使用能力。根据所选 endpoint,它可以根据文本或图像生成视频、使用参考媒体、编辑现有素材,并生成与画面同步的原生音频。
Gemini Omni 1.1 Flash 新增视频延展、首尾帧插值、从 360p 到 4K 的输出分辨率,以及更丰富的参考引导功能。其延展版本每次请求可增加 3 到 10 秒,并且可以链式调用,生成最长 40 秒、内容连贯的视频。
创建 Atlas Cloud 账户,将 API key 保存在服务器端,并选择与工作流匹配的模型 endpoint。Atlas Cloud 提供一个兼容 OpenAI 的 key,而每个 endpoint 发布的 schema 会定义所需的 prompt、媒体输入和生成设置。
从 prompt 开始时选择 text to video;为静态图像添加动画时选择 image to video;需要保持人物或物体身份及风格一致时选择 reference to video。修改现有素材时使用 video edit;要延续场景时使用 Gemini Omni 1.1 Flash video extend endpoint。
参考媒体的限制因 endpoint 和模型版本而异。Gemini Omni 1.1 Flash Reference to Video 最多接受 10 张参考图像和 3 段参考视频,而较早的 endpoint 支持不同的数量限制,因此提交媒体前请先检查所选 endpoint 的 schema。
Gemini Omni 1.1 Flash 支持时长为 3 到 10 秒、帧率为 24 FPS 的输出,并提供 360p、720p、upscaled 1080p 和 upscaled 4K 分辨率选项。支持的宽高比为 16:9 和 9:16,但具体可用控制项可能因 Atlas Cloud endpoint 而异。
可以。video edit 版本会根据文本指令添加、移除、替换或重设元素样式,同时保留 prompt 未提及的画面内容。进行迭代修改时,请使用聚焦明确的指令,以及所选工作流支持的交互上下文。
要延续场景,请向 Gemini Omni 1.1 Flash video extend endpoint 提供现有视频片段,并请求额外增加 3 到 10 秒。延展内容最多可链式生成至总计 40 秒;image to video 版本则可以在提供的首帧和尾帧之间进行插值。
Gemini Omni 1.1 Flash 在 Atlas Cloud 上的标准定价为:text to video、reference to video、视频编辑和视频延展均为每秒 $0.041;image to video 为每秒 $0.043。较早的 Gemini Omni Flash endpoint 起价为每秒 $0.112,按使用量计费且无需订阅。
每个生成的视频都包含不可见的 SynthID 水印,并且可以通过程序检测。安全过滤器会同时应用于 prompt 和生成结果;处理时间则取决于时长、分辨率和服务负载。不支持专用的 negative prompt、system instruction、temperature、top_p 和 stop sequence 控制项,因此请将排除条件写入主 prompt。
Seedance 2.5 API 现已在 Atlas Cloud 上线!它为开发者提供了 ByteDance 最新的视频模型。该模型可通过文本、单张图像或多达 50 个多模态参考,一次性生成长达 30 秒的原生视频,并包含同步音频和画面内的多语言文本。在 Atlas Cloud 上,您可以通过单个密钥访问它,其主体一致性和改进的物理特性能够保持长镜头的连贯性。

Wan 3.0 API 是阿里巴巴 Wan 视频系列的下一代产品,旨在将长视频生成、多参考控制和音视频质量推向新的高度。Atlas Cloud 已经托管了 Wan 2.7、2.6 和 2.5,而 Wan 3.0 使用相同的统一密钥运行,无需额外设置。立即开始构建吧。向下滚动至展示区,查看 Wan 3.0 的创作能力。
MiniMax H3 是 MiniMax 的多模态视频系列,支持文本、图像和参考内容引导创作。在支持的路由中,它能够保留参考媒体中的主体,提供灵活的宽高比,并通过 H3 Developer 将生成的声音与画面结合;输出配置则由 endpoint 选择。Atlas Cloud 通过一个 OpenAI 兼容密钥统一接入整个系列,并提供透明的按量付费定价,标准费率为每秒 $0.038。立即开始构建。
OpenAI 的 gpt-image-2.5 系列为开发者提供 Flare 和 Sunburst 两种选择,满足生产级图像工作流需求。支持最高 3840x2160 的任意分辨率渲染,并提供包括 xhigh 和 max 在内的五档质量等级,以匹配特定的输出要求。Atlas Cloud 提供开箱即用的 REST 推理服务,无冷启动,每次生成起价 $0.004,采用标准定价。立即开始构建。
Seedream 5.0 Pro API 为开发者在 Atlas Cloud 上提供了字节跳动的可控图像编辑模型。它通过锚点和坐标精确定位编辑,将图像分离为可编辑图层,融合多个参考,并精准匹配颜色和材质,支持 2K 和 3K 分辨率的多语言文本。在 Atlas Cloud 上,您只需一个密钥即可访问!
Seedance 2.0 是 ByteDance 面向生产环境的视频模型,专用于精准镜头创作。将提示词转换为视频,使用首帧图像生成动画并可选用尾帧引导,或结合参考媒体和可选的联网搜索来塑造结果。Atlas Cloud 将这些工作流整合到统一的 API 中,提供透明的按量付费定价和一个兼容 OpenAI 的密钥。立即开始构建。
Kling 3.0 API 通过一个 OpenAI 兼容的密钥,将 Kuaishou 的旗舰视频套件引入 Atlas Cloud。它包含两个模型:Kling 3.0 用于 AI Director 叙事、多语言唇形同步和精准的屏幕文本;Kling 3.0 Omni (O3) 用于通过短视频或图像进行主体和声音克隆。两者都能在同一次处理中生成原生音频,最高支持 4K 输出。在可靠的基础设施上构建电影级叙事、全球营销、多语言广告和系列化角色内容。
Grok Imagine Video 为开发者提供访问 xAI 视频模型家族的能力,用于创建、制作动画、延展和编辑视频片段。通过提示词生成 1 至 15 秒的视频,使用最多 7 张参考图像引导人物、物体或风格,并支持 480p 或 720p。Atlas Cloud 通过兼容 OpenAI 的端点整合这些能力,并提供透明的按需付费定价。立即开始构建。
Vidu Q4 是 Vidu 最新的旗舰视频模型,专为图像转视频和参考图转视频生成而设计。它可以让单张静态图像动起来,并自动创建场景转场,为不同的产品工作流提供两种输入路径。Atlas Cloud 提供专用 API 端点,并以经验证的标准价格 $0.04/second 发布参数 schema。立即开始构建。
Gemini Omni 1.1 Flash 是 Google DeepMind 推出的原生多模态视频系列,适用于灵活的生产工作流。通过文本指令编辑现有素材,借助最多 10 张参考图像和 3 段视频片段保持视觉一致性,或以可串联的片段延长镜头,最长可达 40 秒。在 Atlas Cloud 上使用一个 OpenAI-compatible API key 即可访问所有工作流,按量付费,并支持 Day-0 上线。立即开始构建。
Nano Banana 2.1 是 Google 基于 Gemini 3.6 Flash 打造的图像模型系列。它以 Flash 级速度提供 Pro 级生成与编辑能力,支持通过自然语言对 1 到 14 张输入图像进行编辑和融合,并可保持最多 4 个角色和 10 个对象的一致性。通过 Atlas Cloud,开发者只需使用一个 OpenAI-compatible 密钥,即可访问该系列模型,享受可靠的运行时间保障和 Day-0 可用性。立即开始构建。
使用由 Google 的 Gemini 3.1 Flash Image 模型驱动的 Nano Banana 2 API 进行构建。它可生成分辨率高达 4096x2304 的原生 4K 视觉效果,具备准确的文本渲染能力,并在生成和编辑过程中支持多达 14 张参考图像的角色一致性。在 Atlas Cloud 上,您可以通过一个统一的 API 访问它以及其他 300 多个模型,价格低至每张图像 0.04 美元,提供 99.99% 的正常运行时间,并附赠免费额度供您开始使用。
指南、教程与产品动态,助你充分发挥 Atlas Cloud 的价值。


