




男士们,在拿起理发器之前,先试戴你的下一款发型
上传照片,通过AI发型变换器免费试戴男士发型、渐变发型和男士丸子头。在坐上理发椅之前,先预览剪发效果。
选填,1 张。不传就按商品调性自动设计一个虚拟模特
上传服装,并说明应由谁穿着。模板会推算出这件服装如何垂坠、如何固定,在模特身上确定合身效果,然后据此渲染影片。
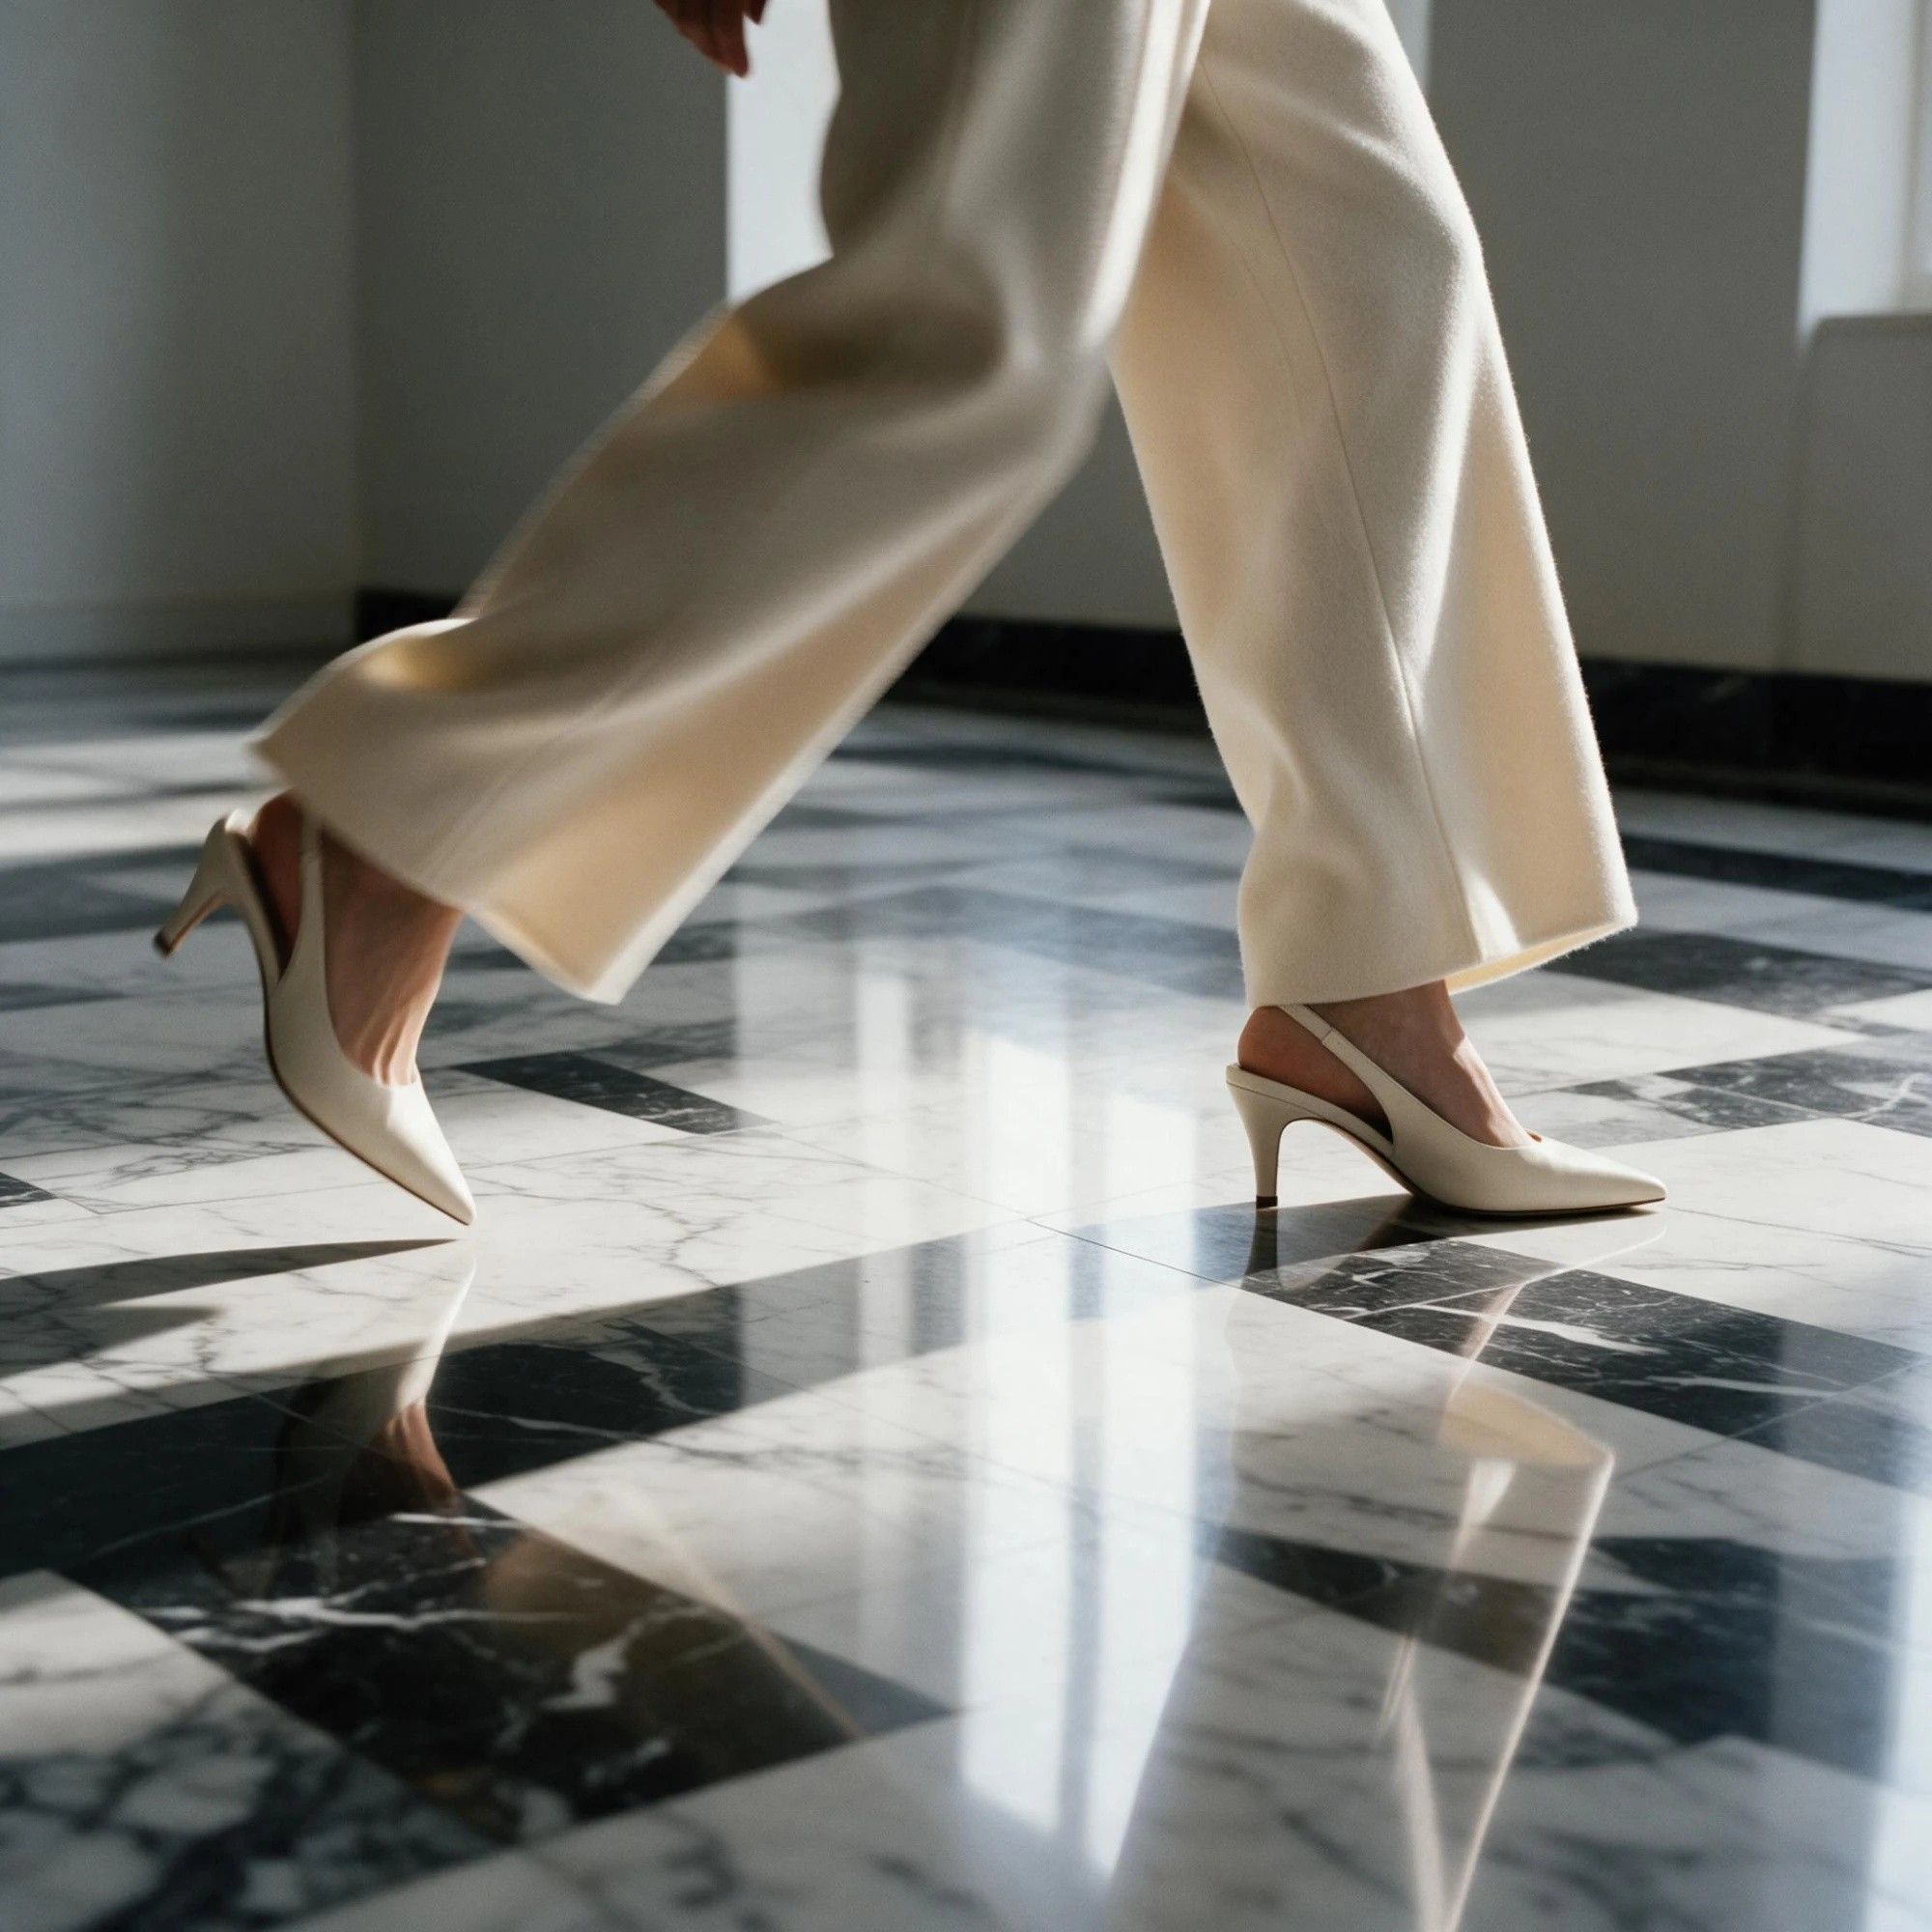
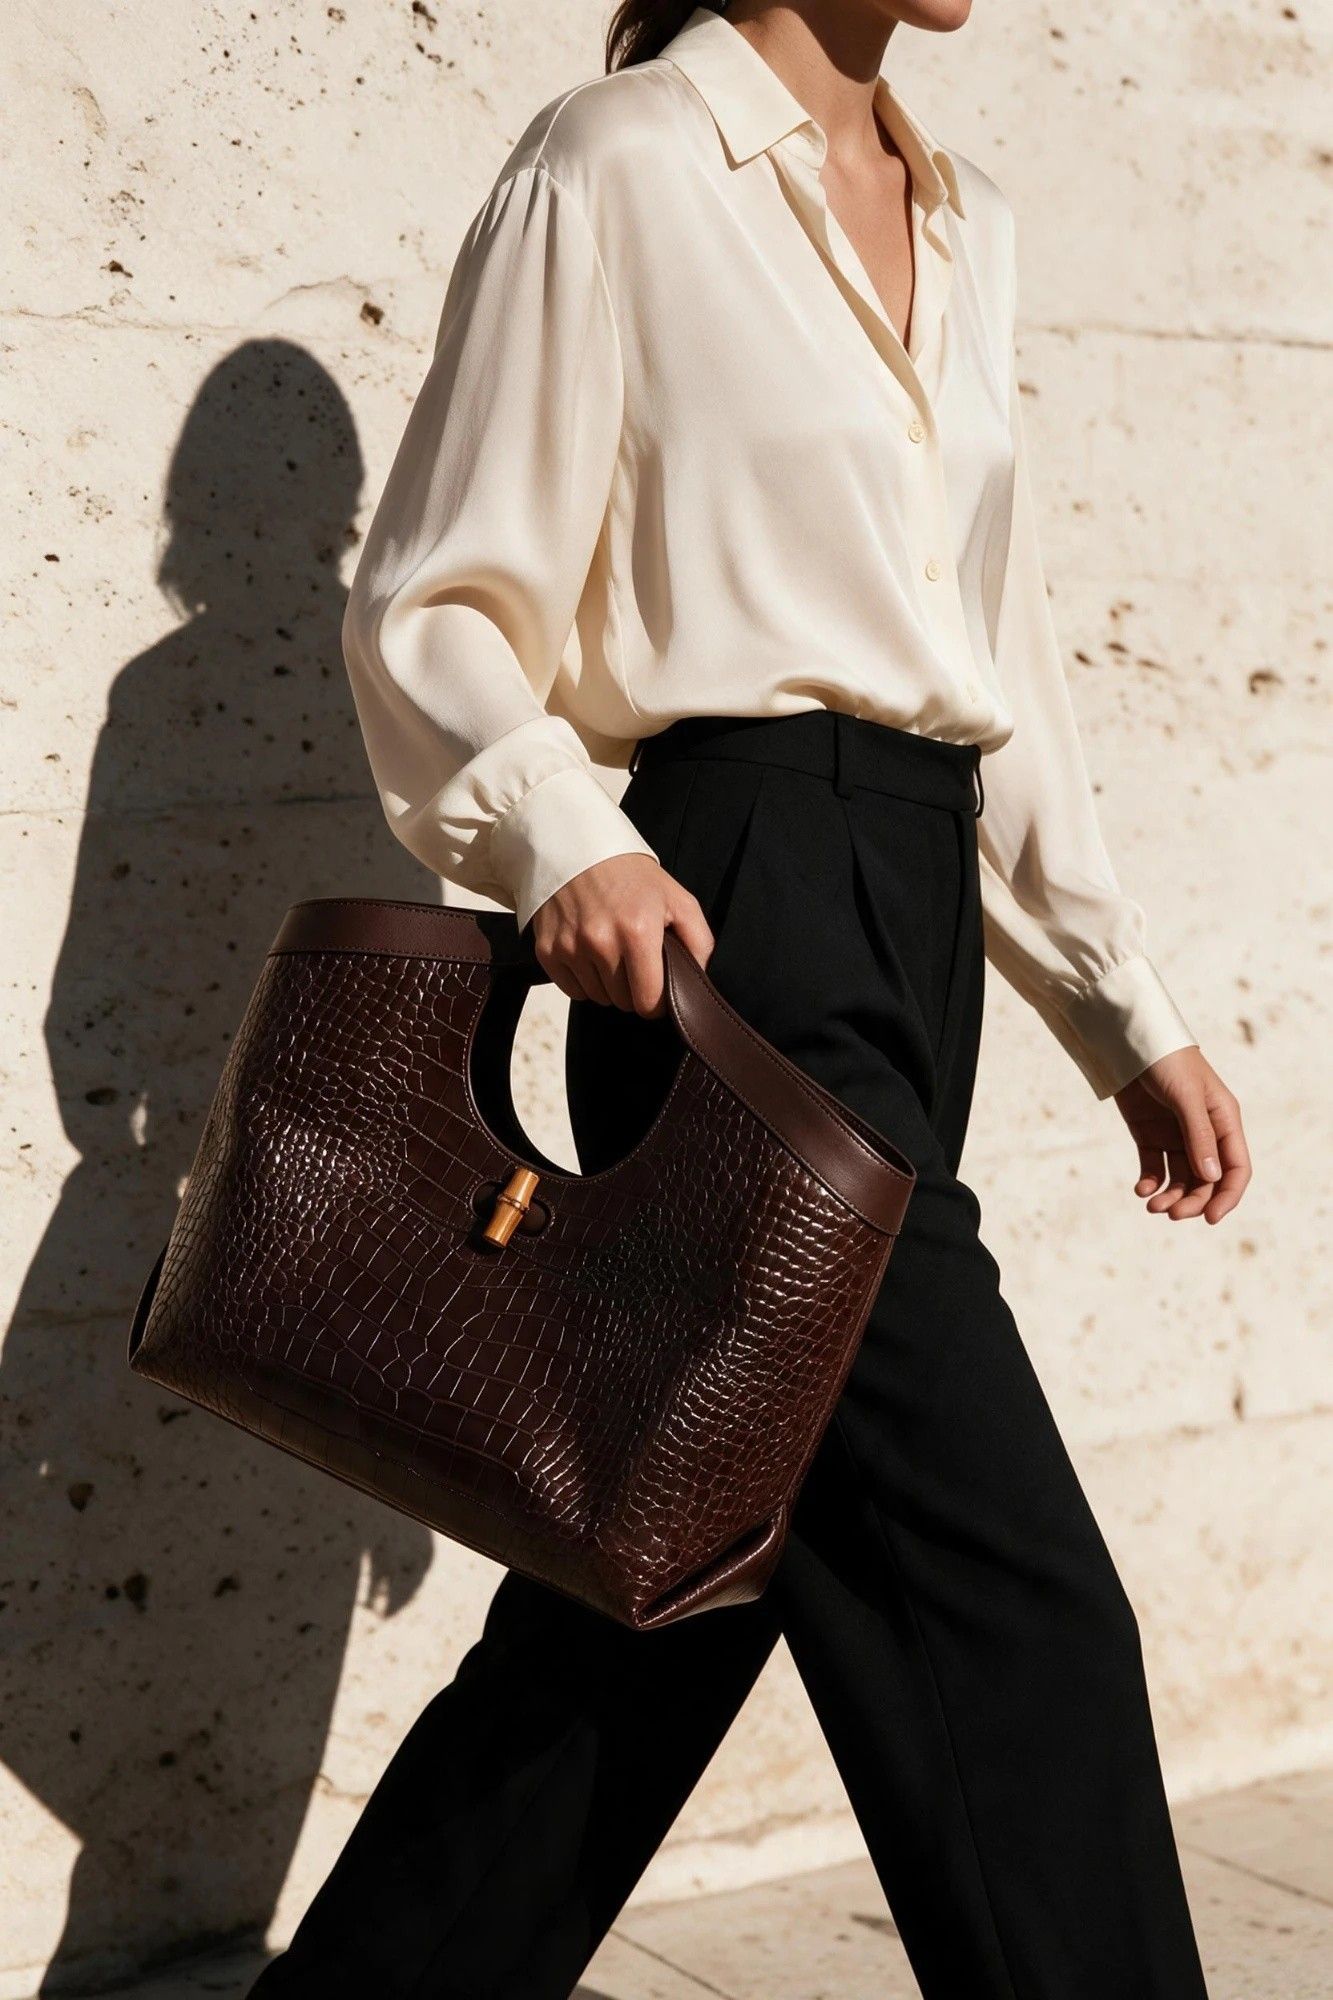
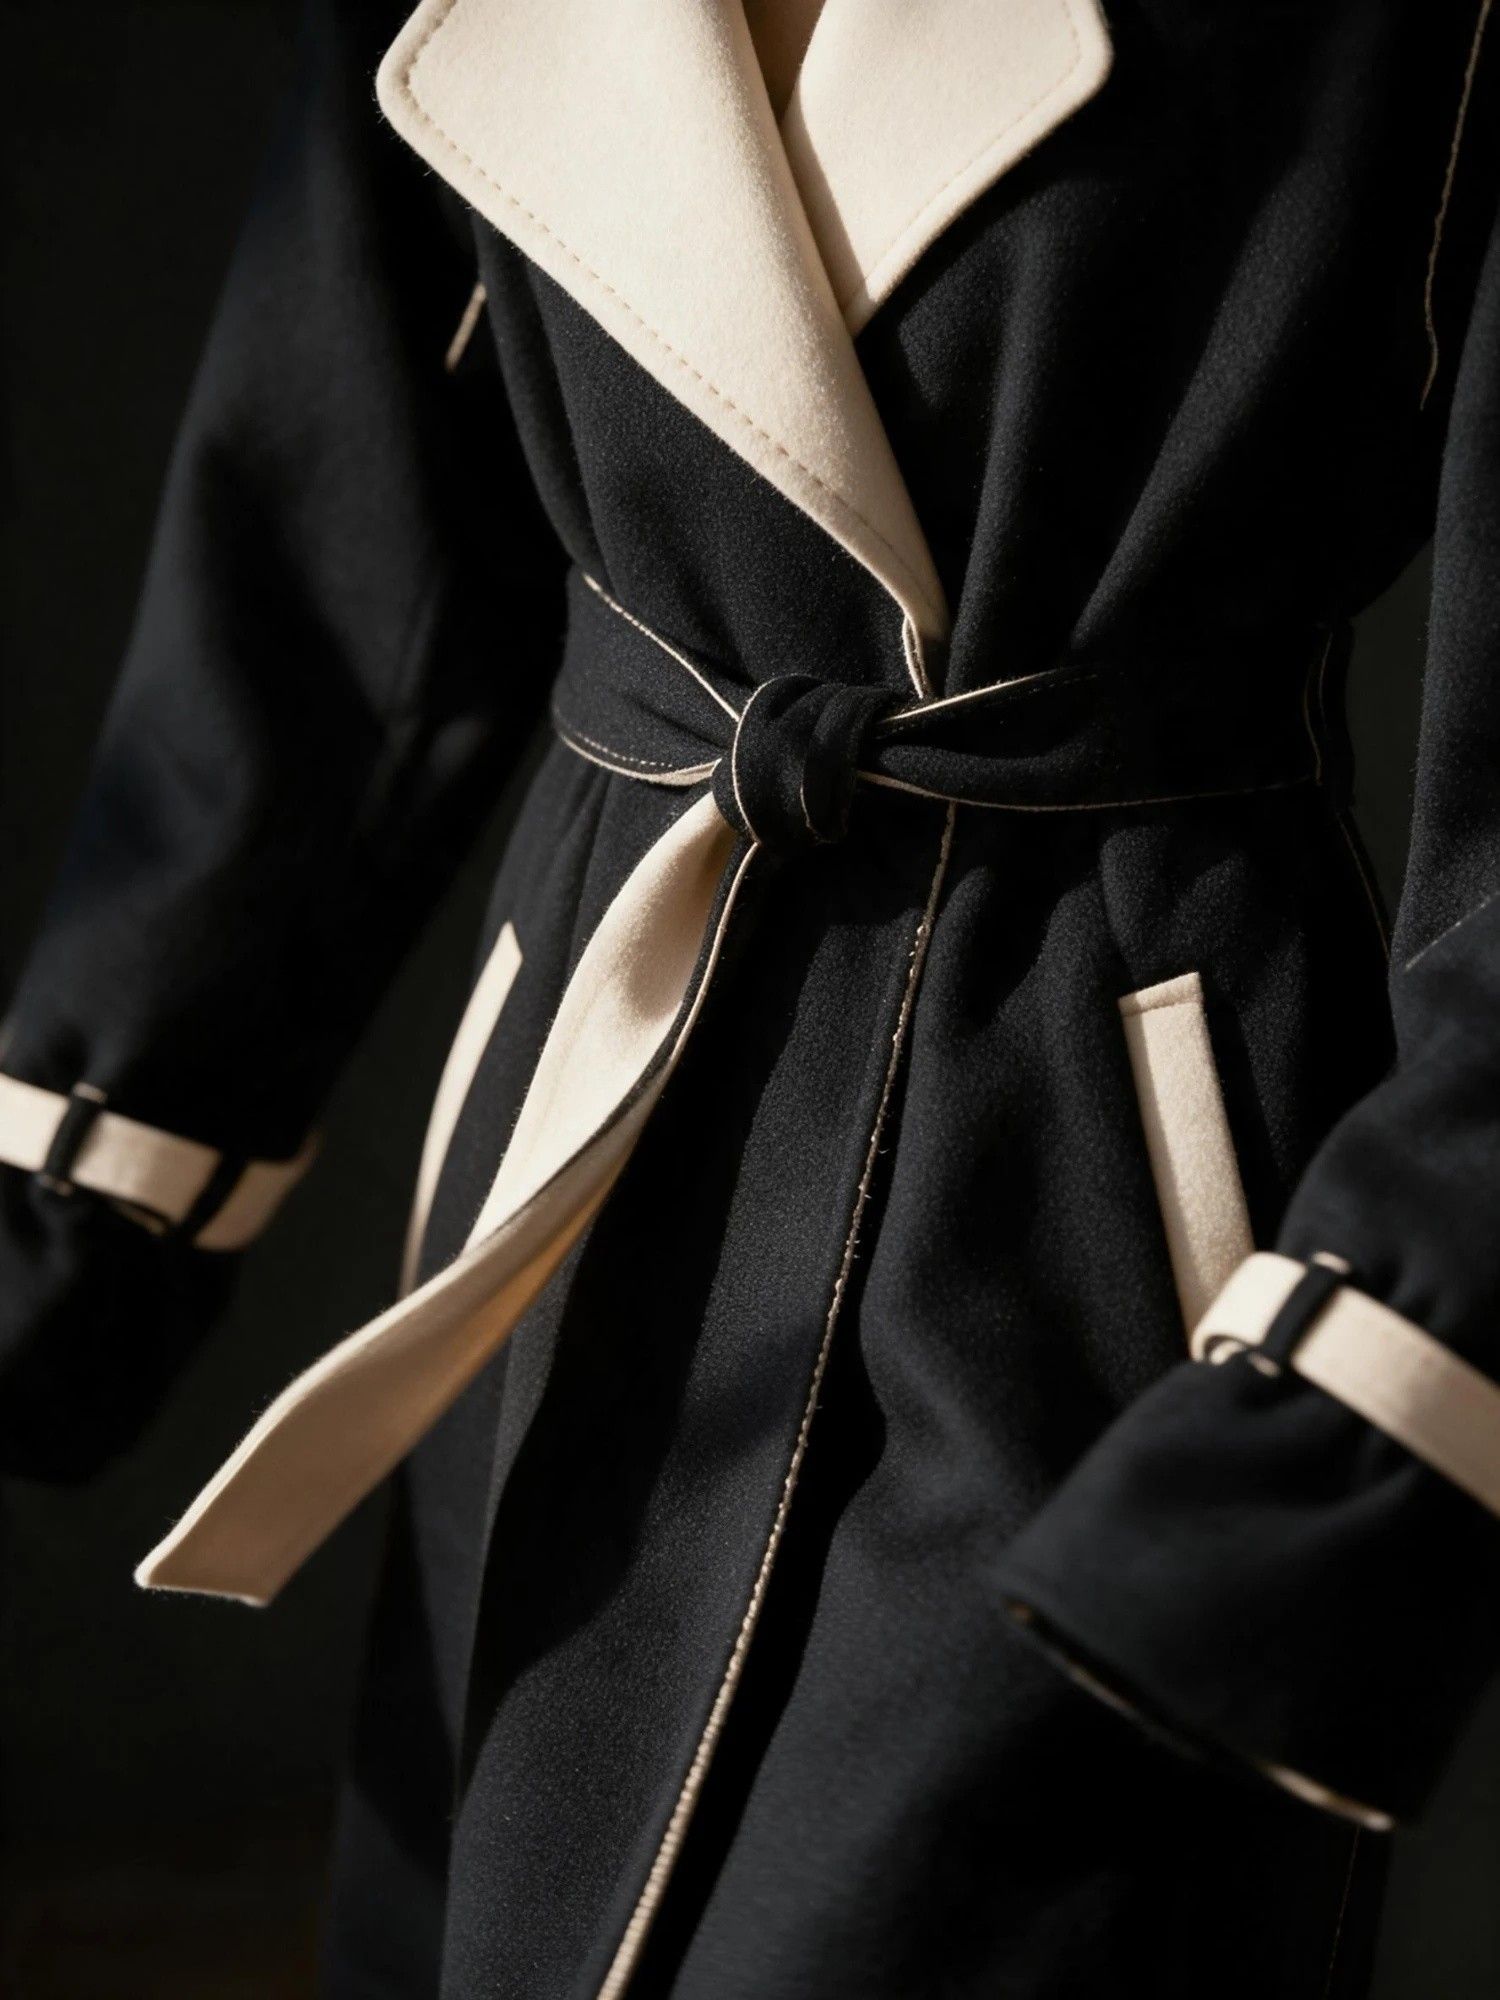
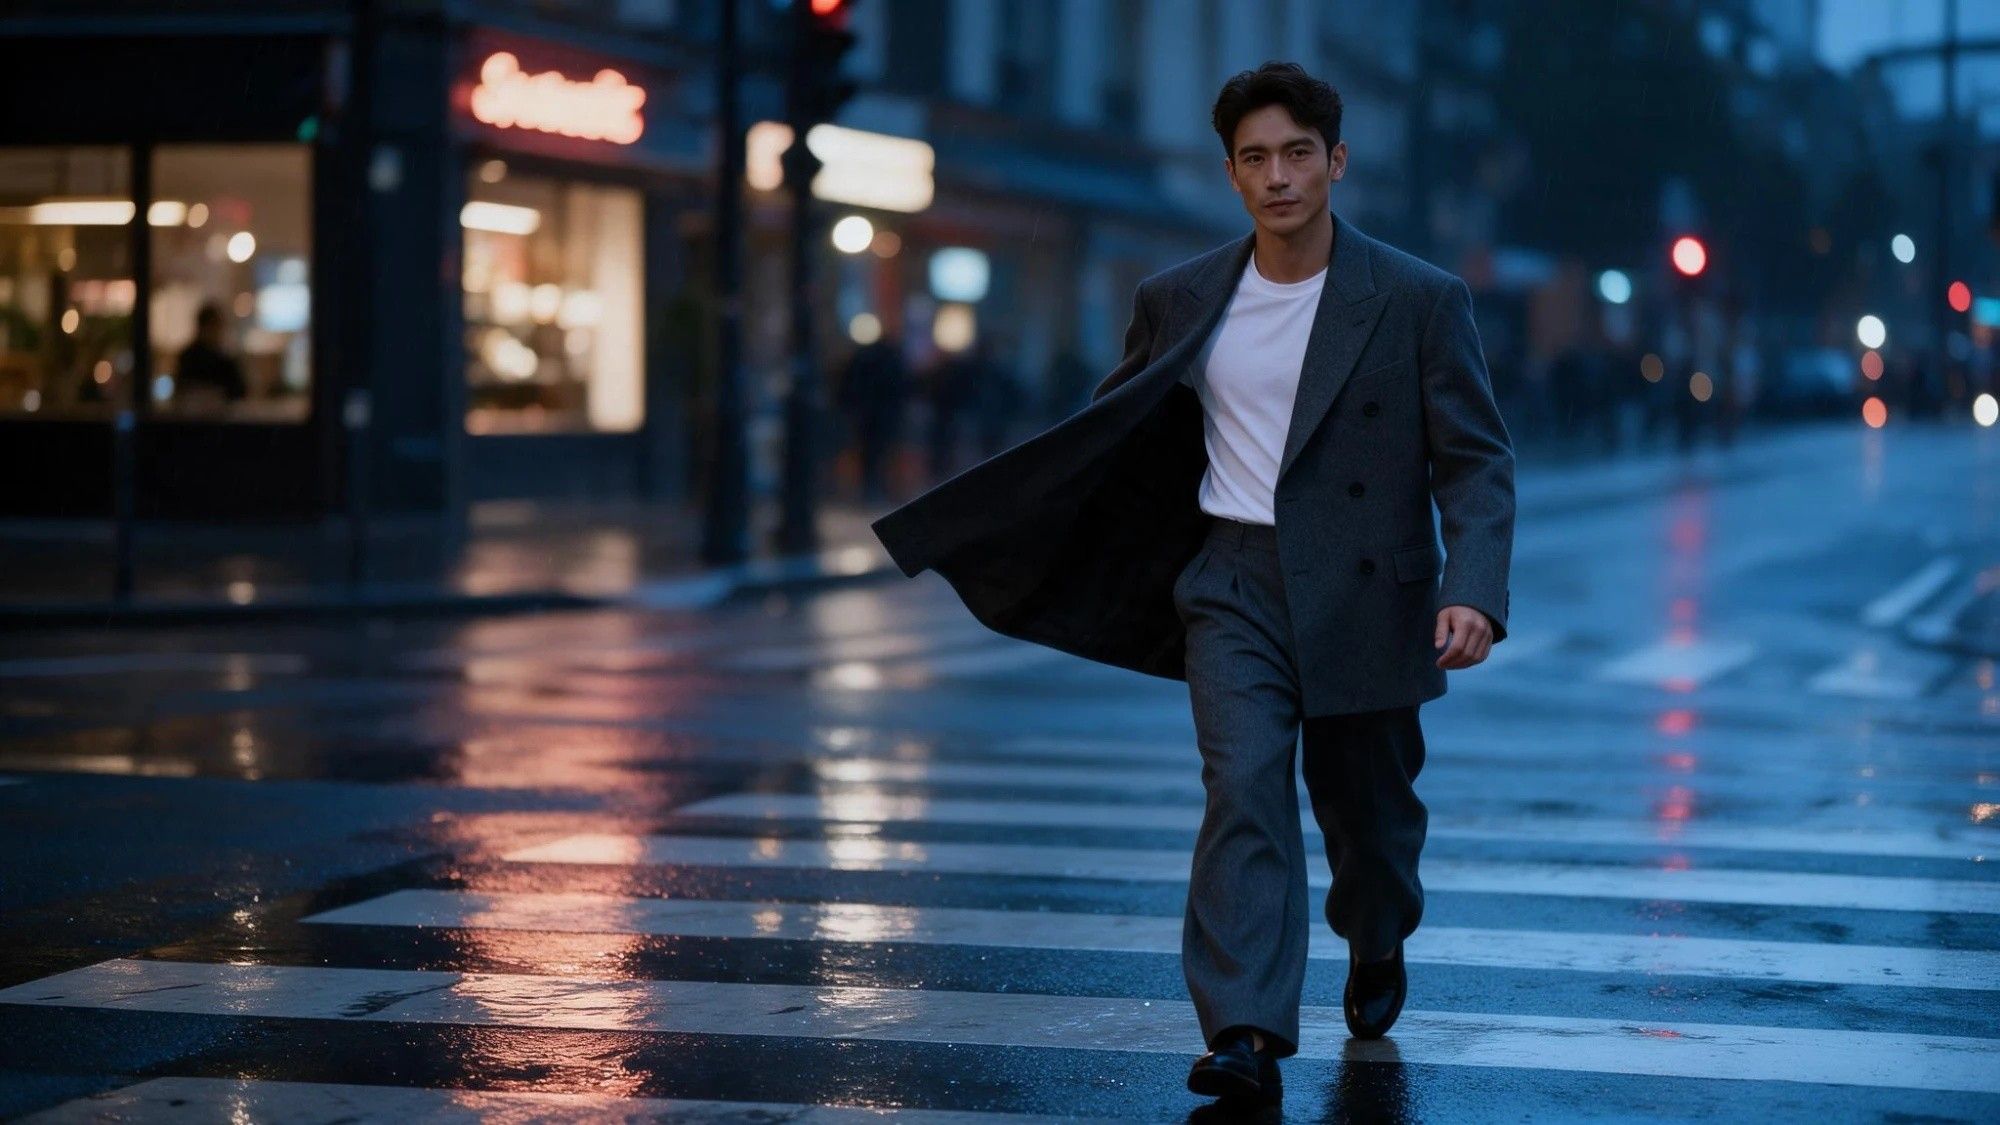
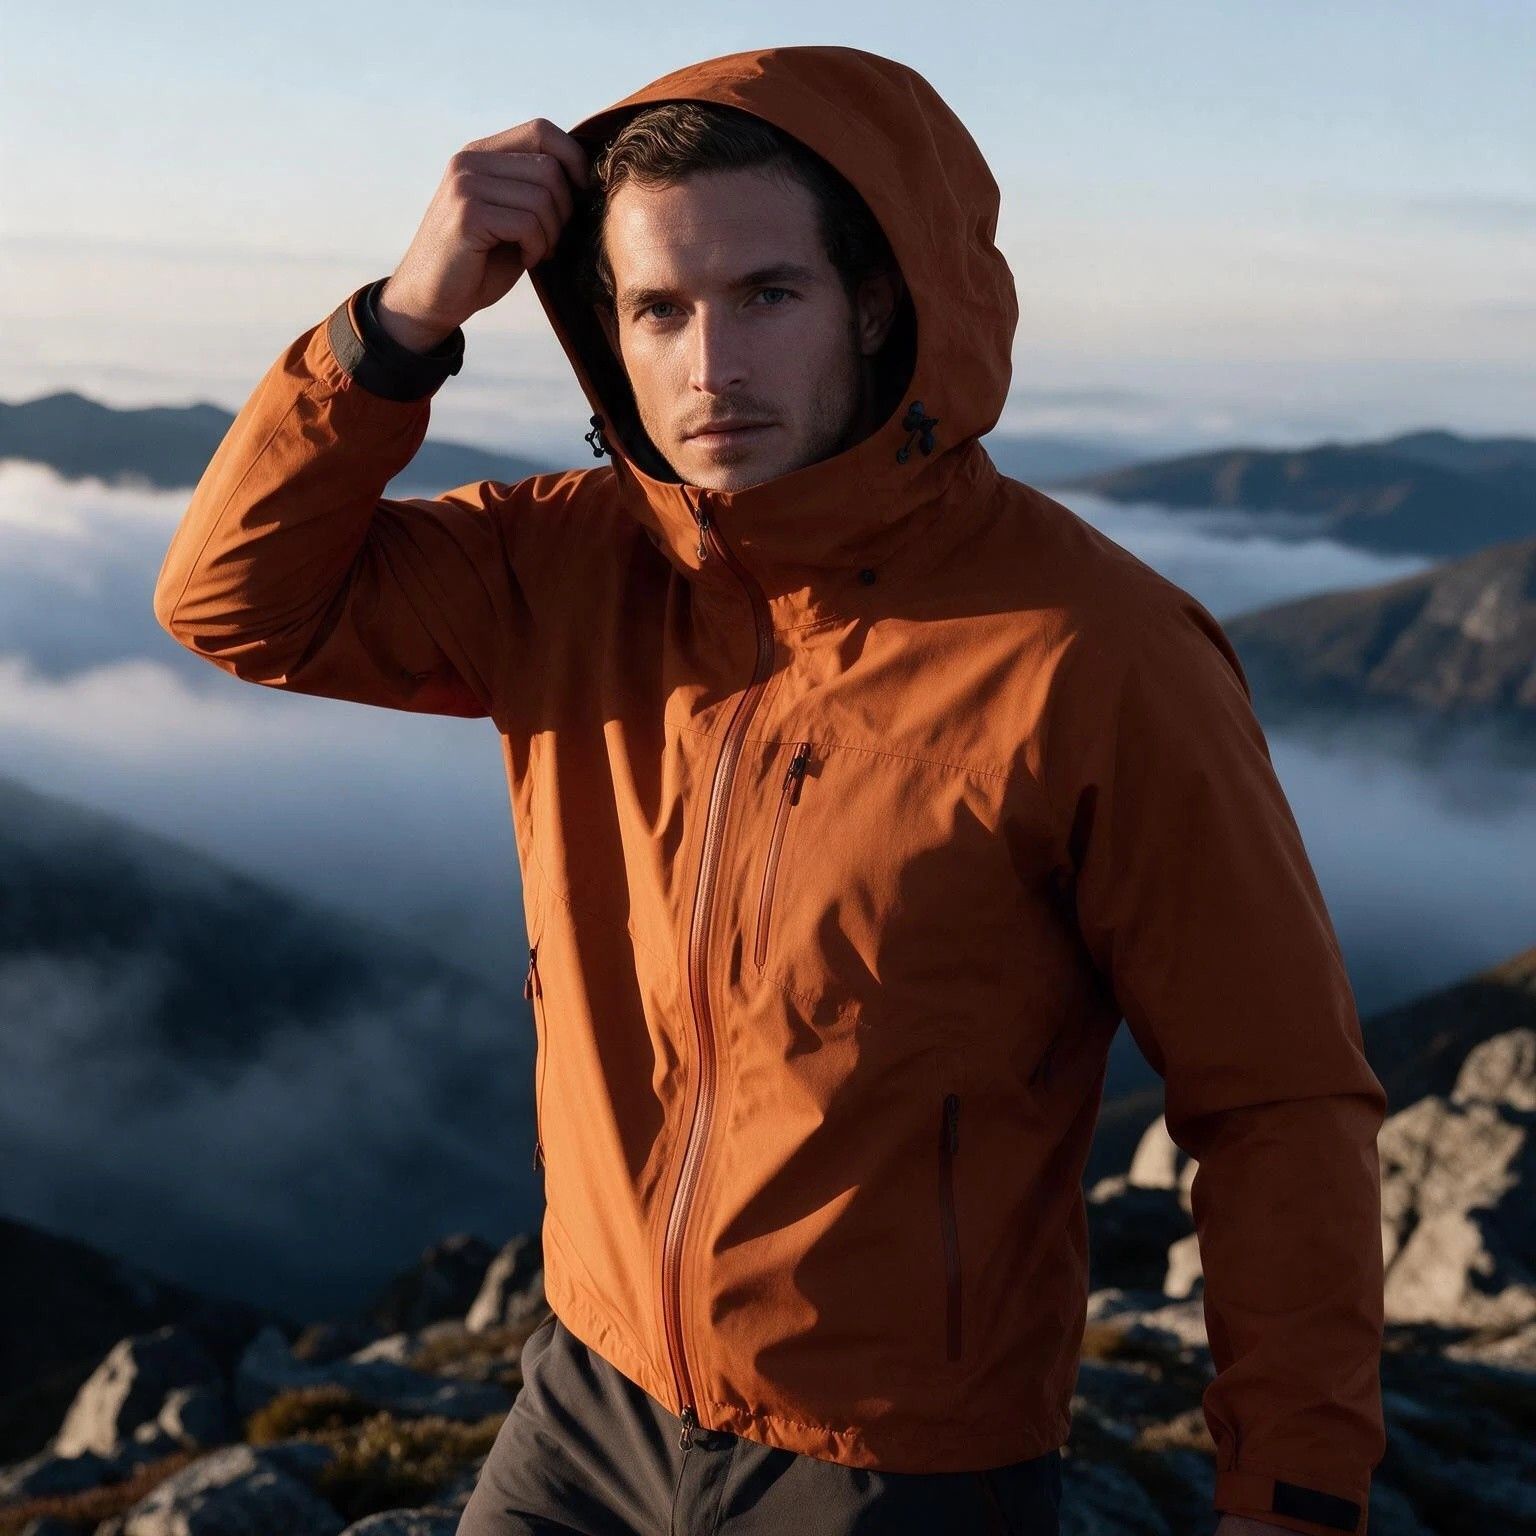
一件衣服拍成照片很容易,却卖得不好,因为照片无法展示它穿在身上的样子。下面讲的是影片如何拍成:合身度、模特、镜头组合,以及动态画面能增添什么。
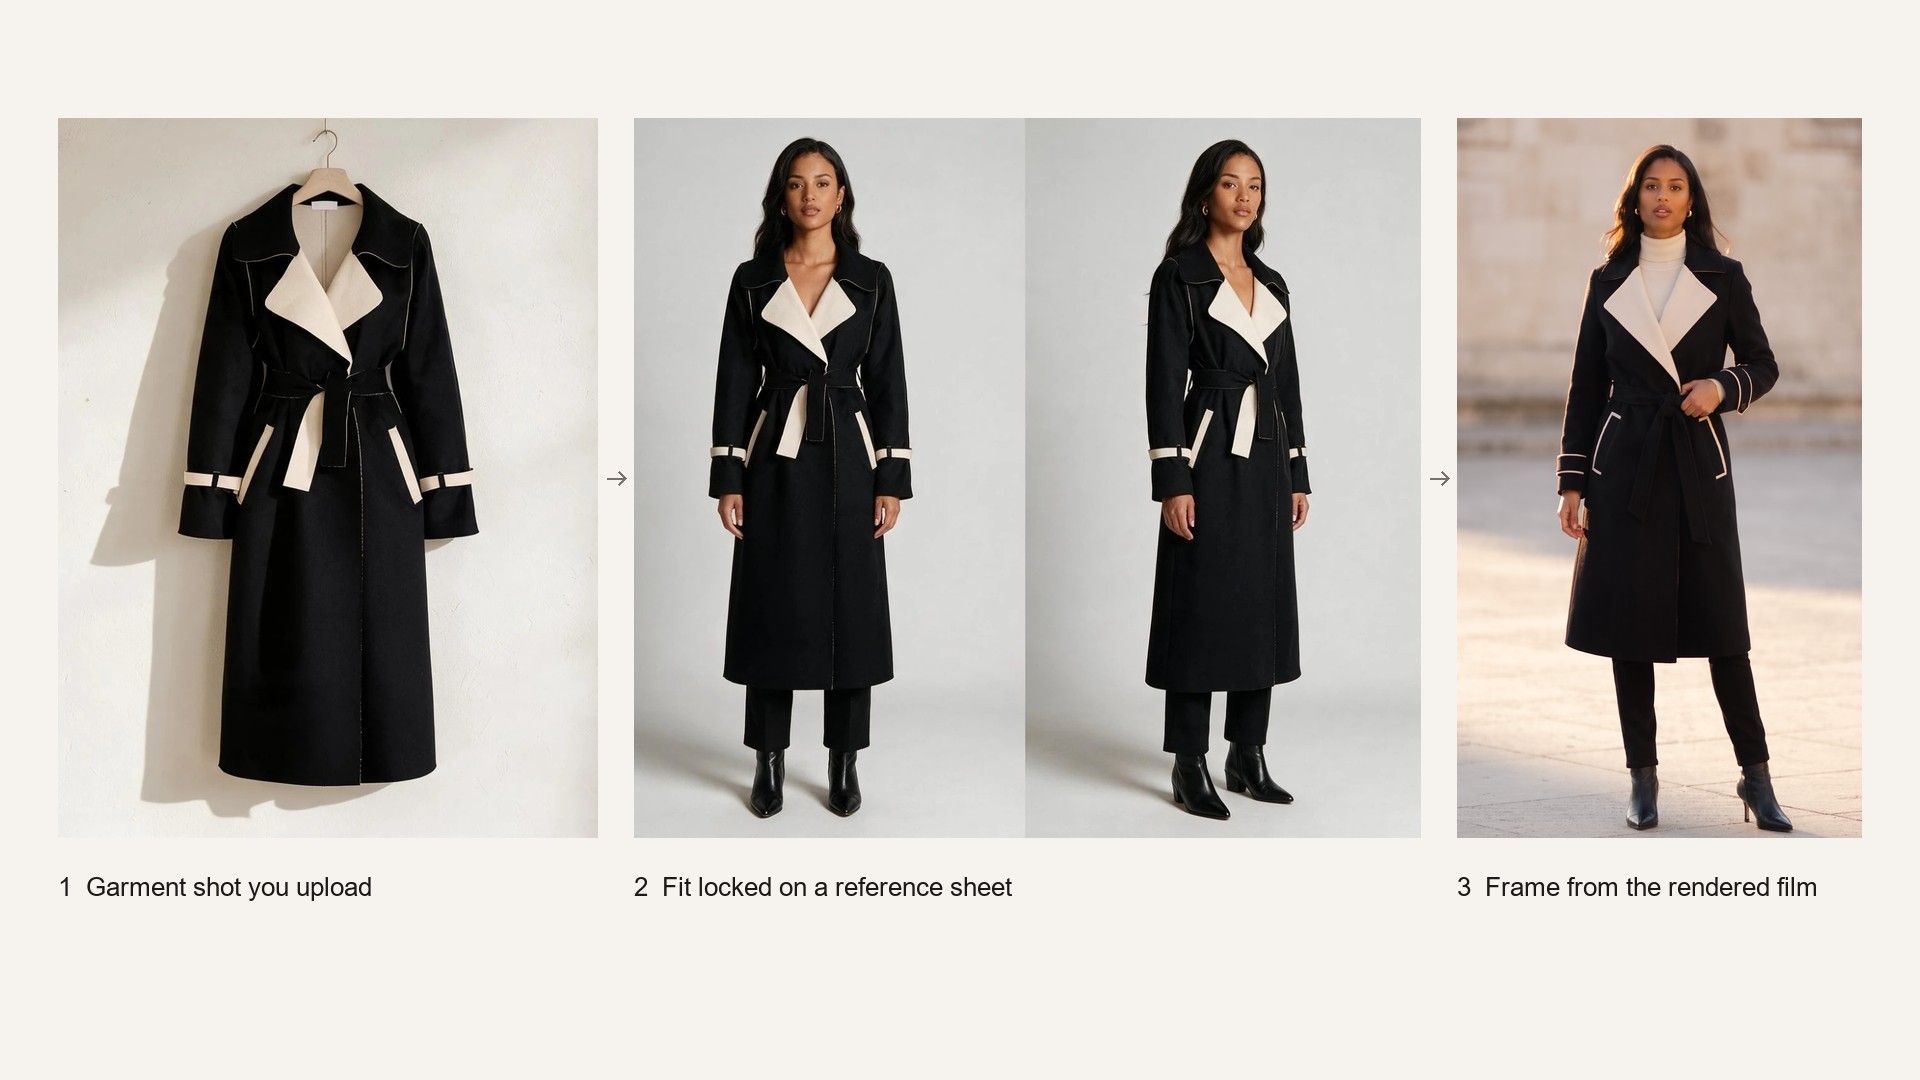
夹克与针织衫的垂坠方式不同,肩带也不会落在袖子所在的位置。在任何内容开始渲染之前,模板会读取你上传内容的结构与穿着逻辑,为产品和模特分别建立参考图,然后用一张试穿静帧锁定贴合效果。影片由此渲染而成,而不是逐帧即兴生成。
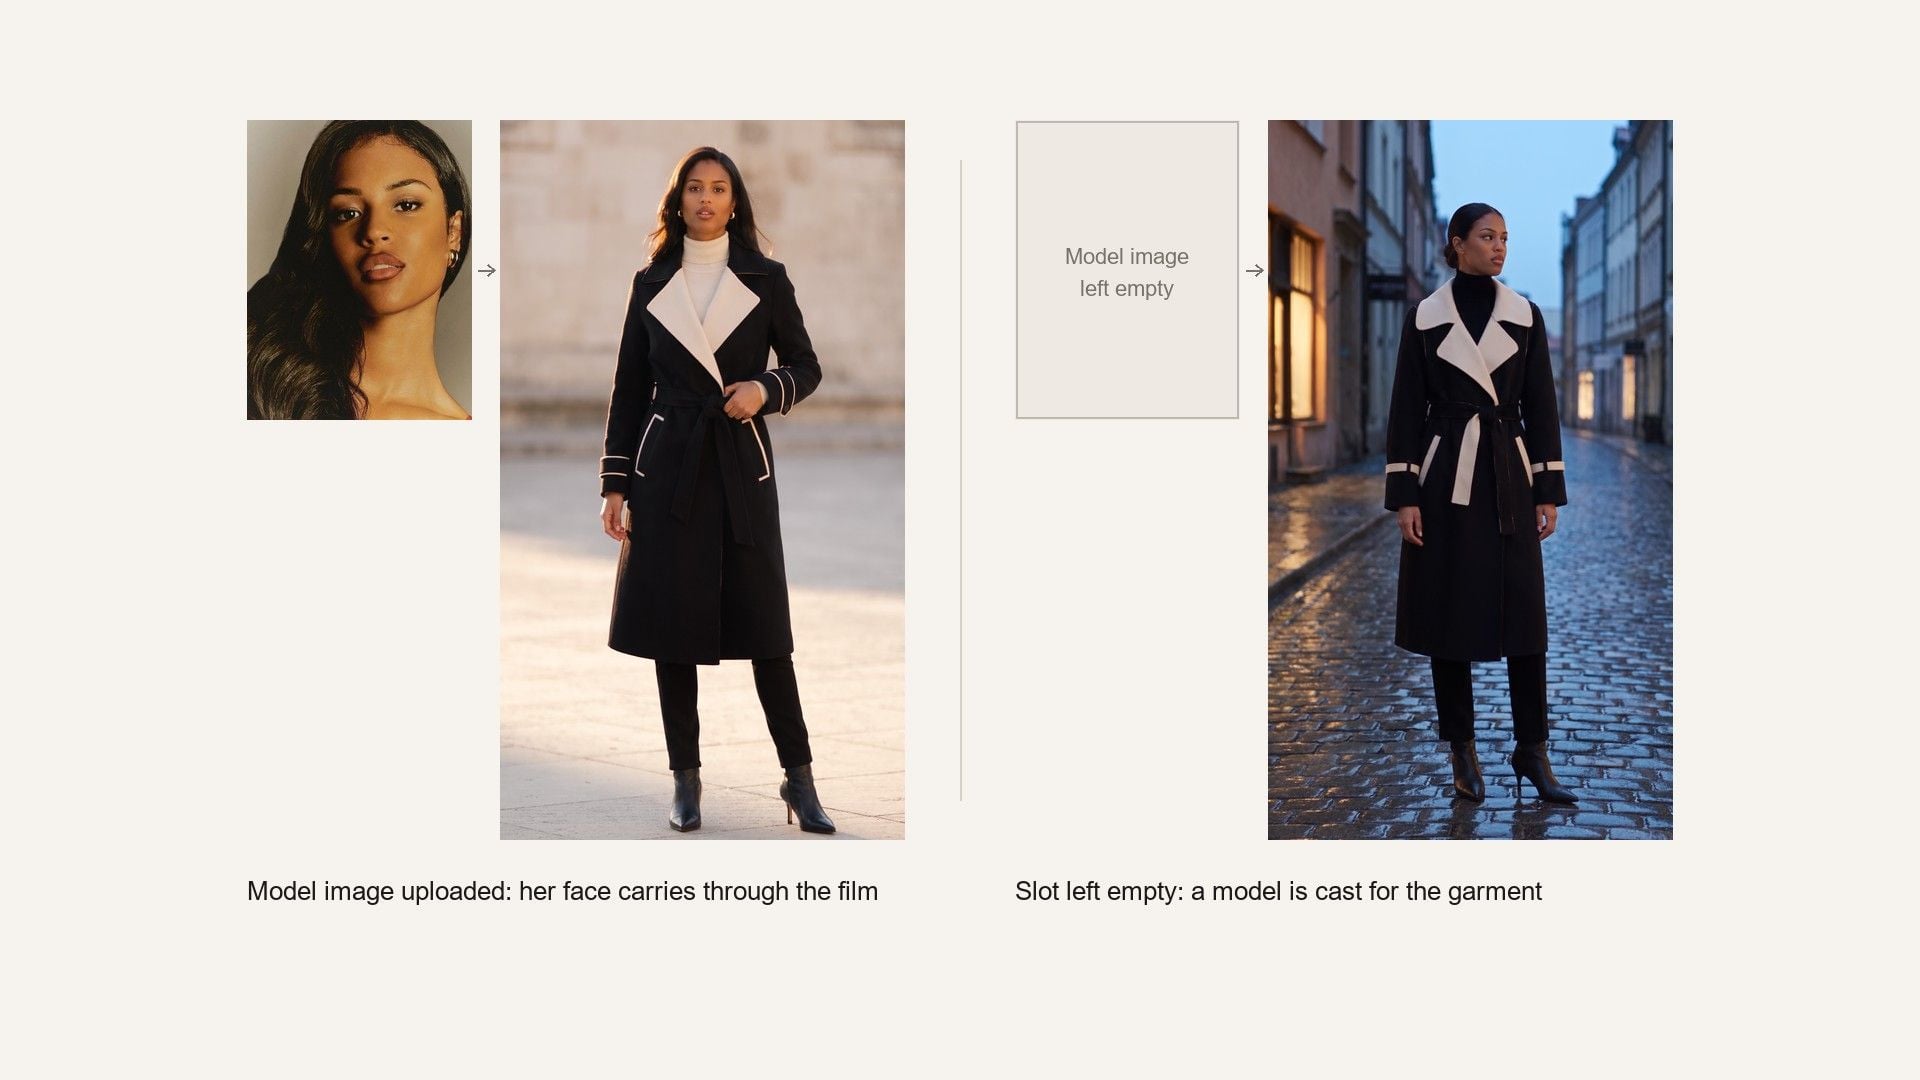
上传你希望穿着它的人的照片,那张面孔会贯穿整部影片——这正是让一季二十件单品保持统一的关键。若将该位置留空,则会为这件服装另选一位模特。
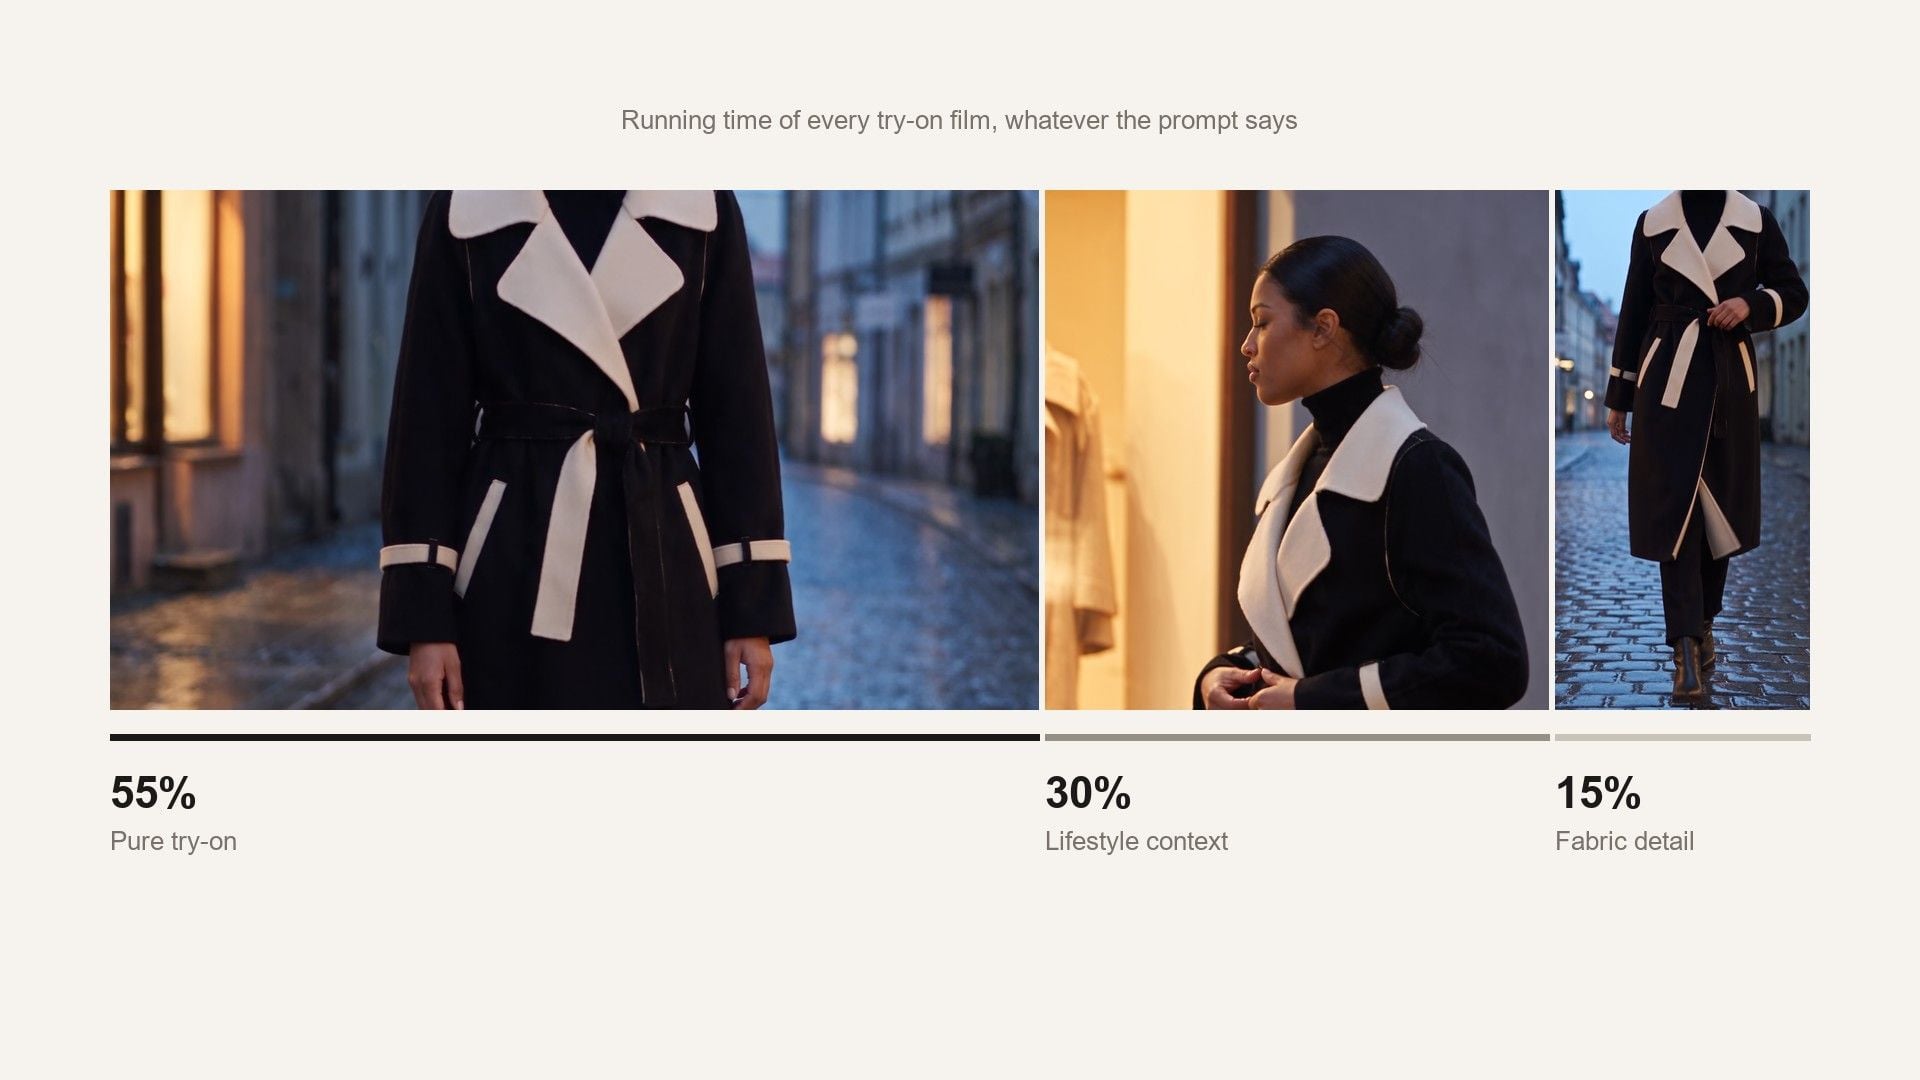
生活方式素材容易生成,也容易用力过猛,而一部把时间花在风景上的影片卖不出夹克。模板固定了镜头配比,你的提示词无法改变它:大部分片长都是衣服穿在身上的画面,配上刚好足够的场景背景,以及对布料的一次近距离扫拍。
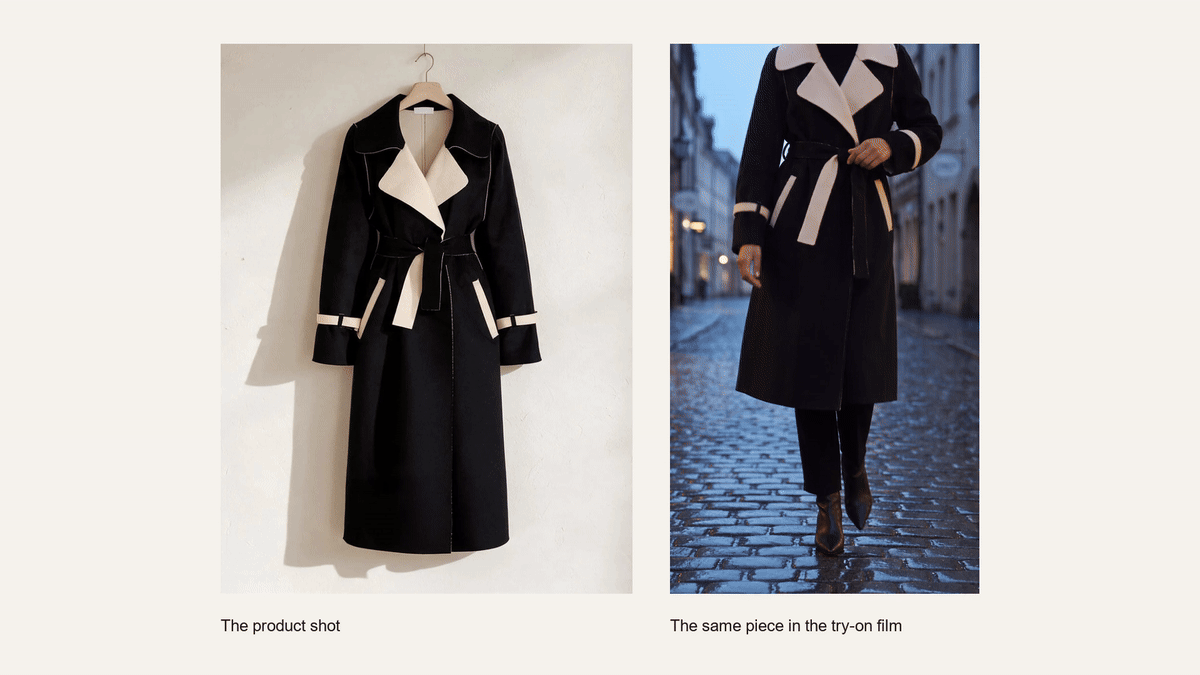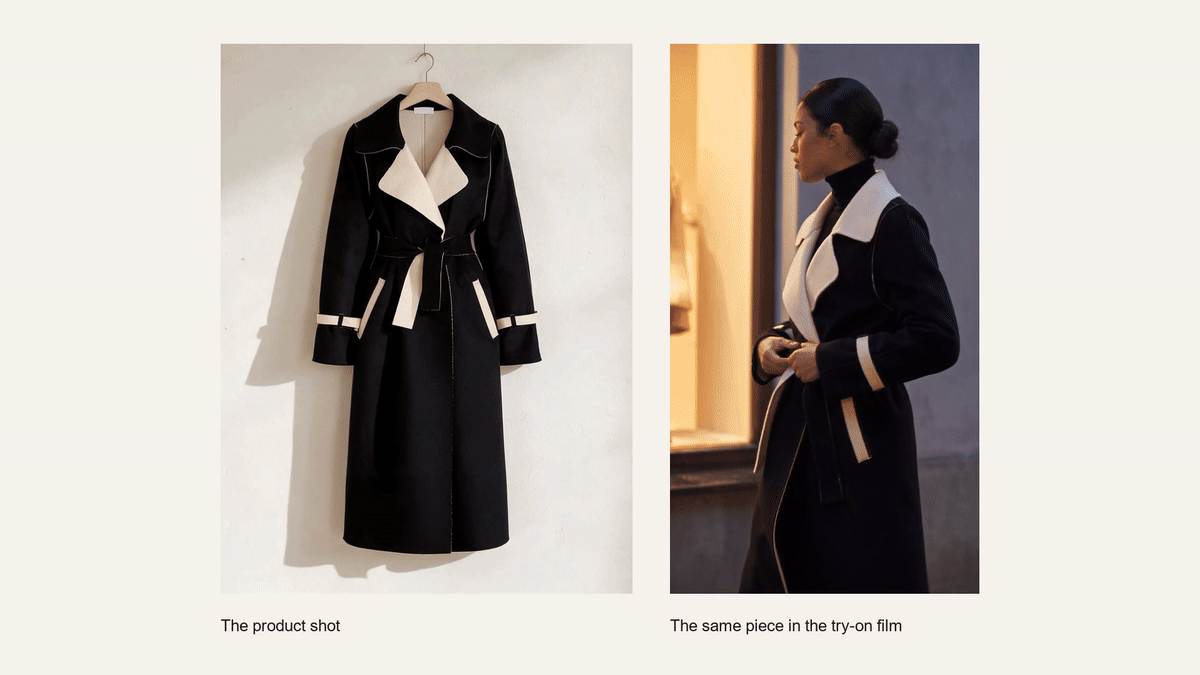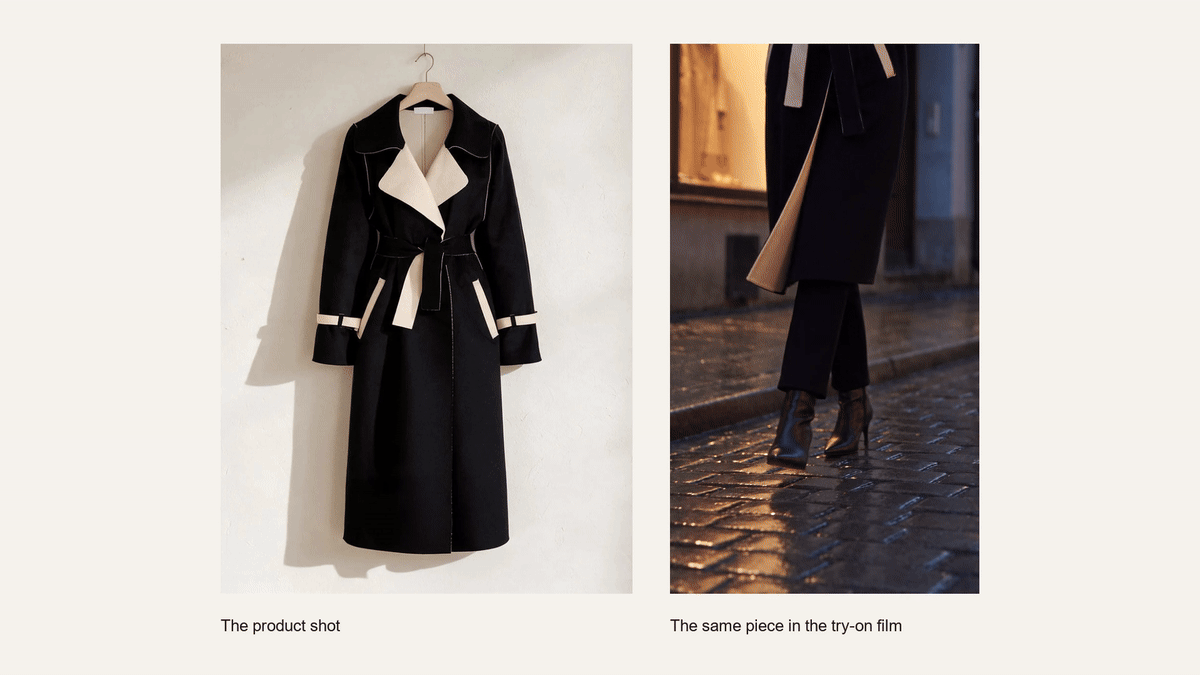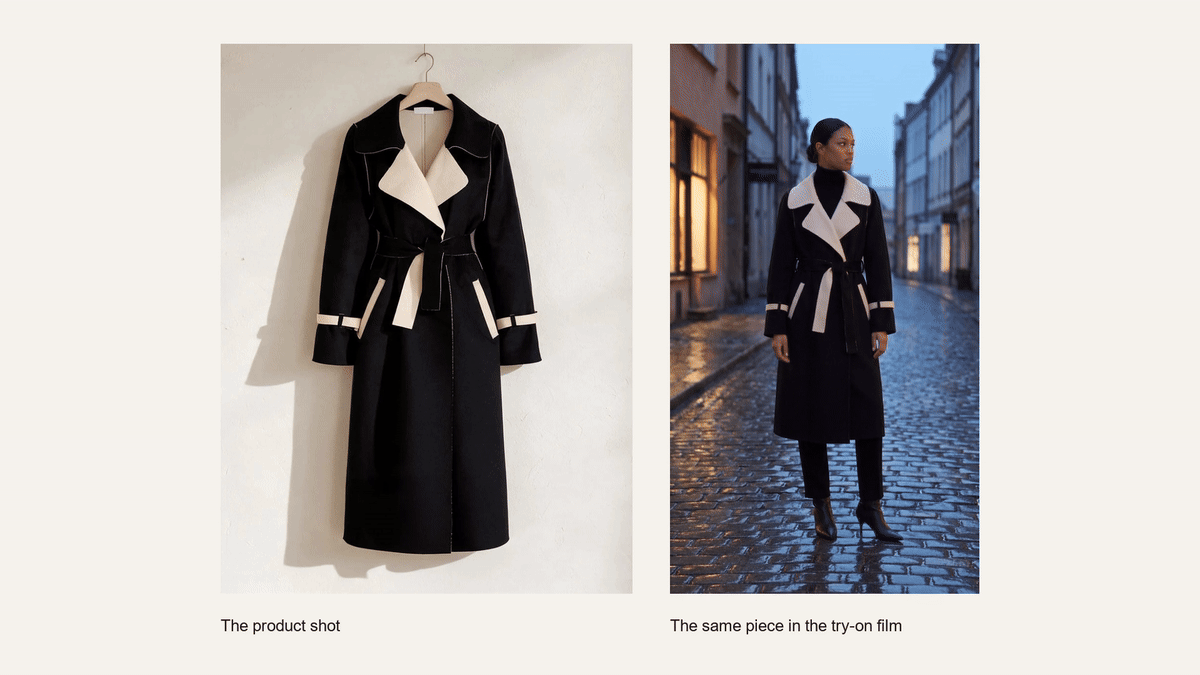
有什么是购物者想知道、而照片却回答不了的?有人走动时下摆如何垂落,以及面料动起来是否像它标称的材质。静态图只把服装定格在一个姿势里;视频则展示它的动态。这就是为什么一次运行会返回 4 到 15 秒的视频素材,默认竖屏,并可在造型册需要时提供另外四种画幅。
拍摄一张单品的干净照片,平铺或挂在衣架上。
说明谁穿着它、在哪里,以及任何值得展示的动作,例如调整兜帽。如果特定人物很重要,也请上传一张面部照片。
设置长度和形状,然后运行。垂直方向已选中。
选择与你工作最接近的选项卡。
一个 lookbook 拍摄日就能覆盖主打单品,其余上新则因为模特只订了八小时,只能以平铺图形式上线。把剩余 SKU 套进模板,整个系列就能推进起来。那些从来不值得安排拍摄的单品,通常也是页面上信息最少的单品。
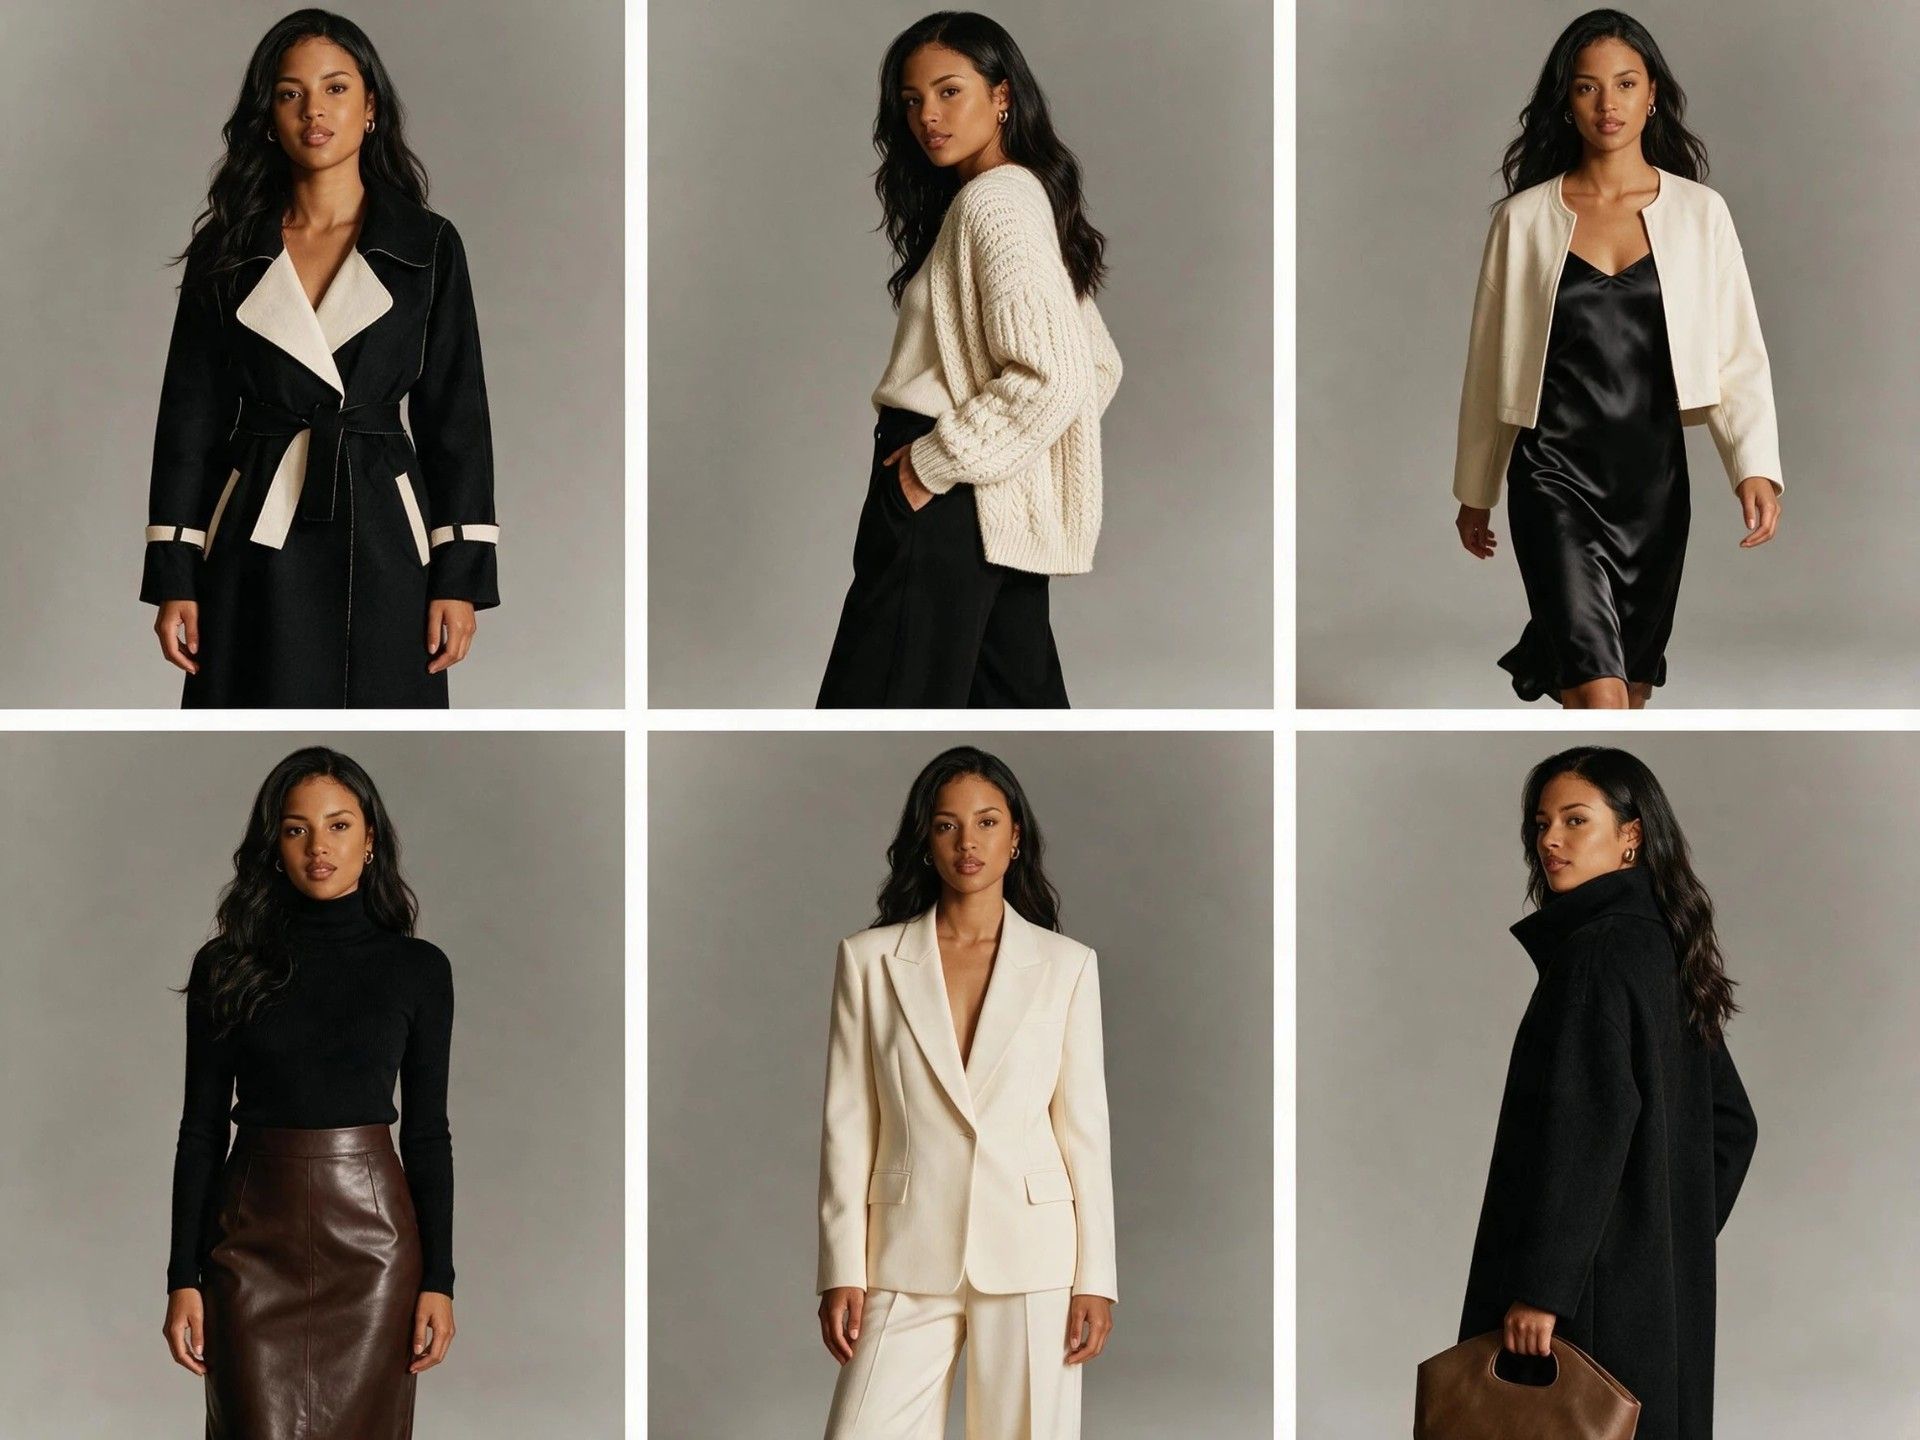
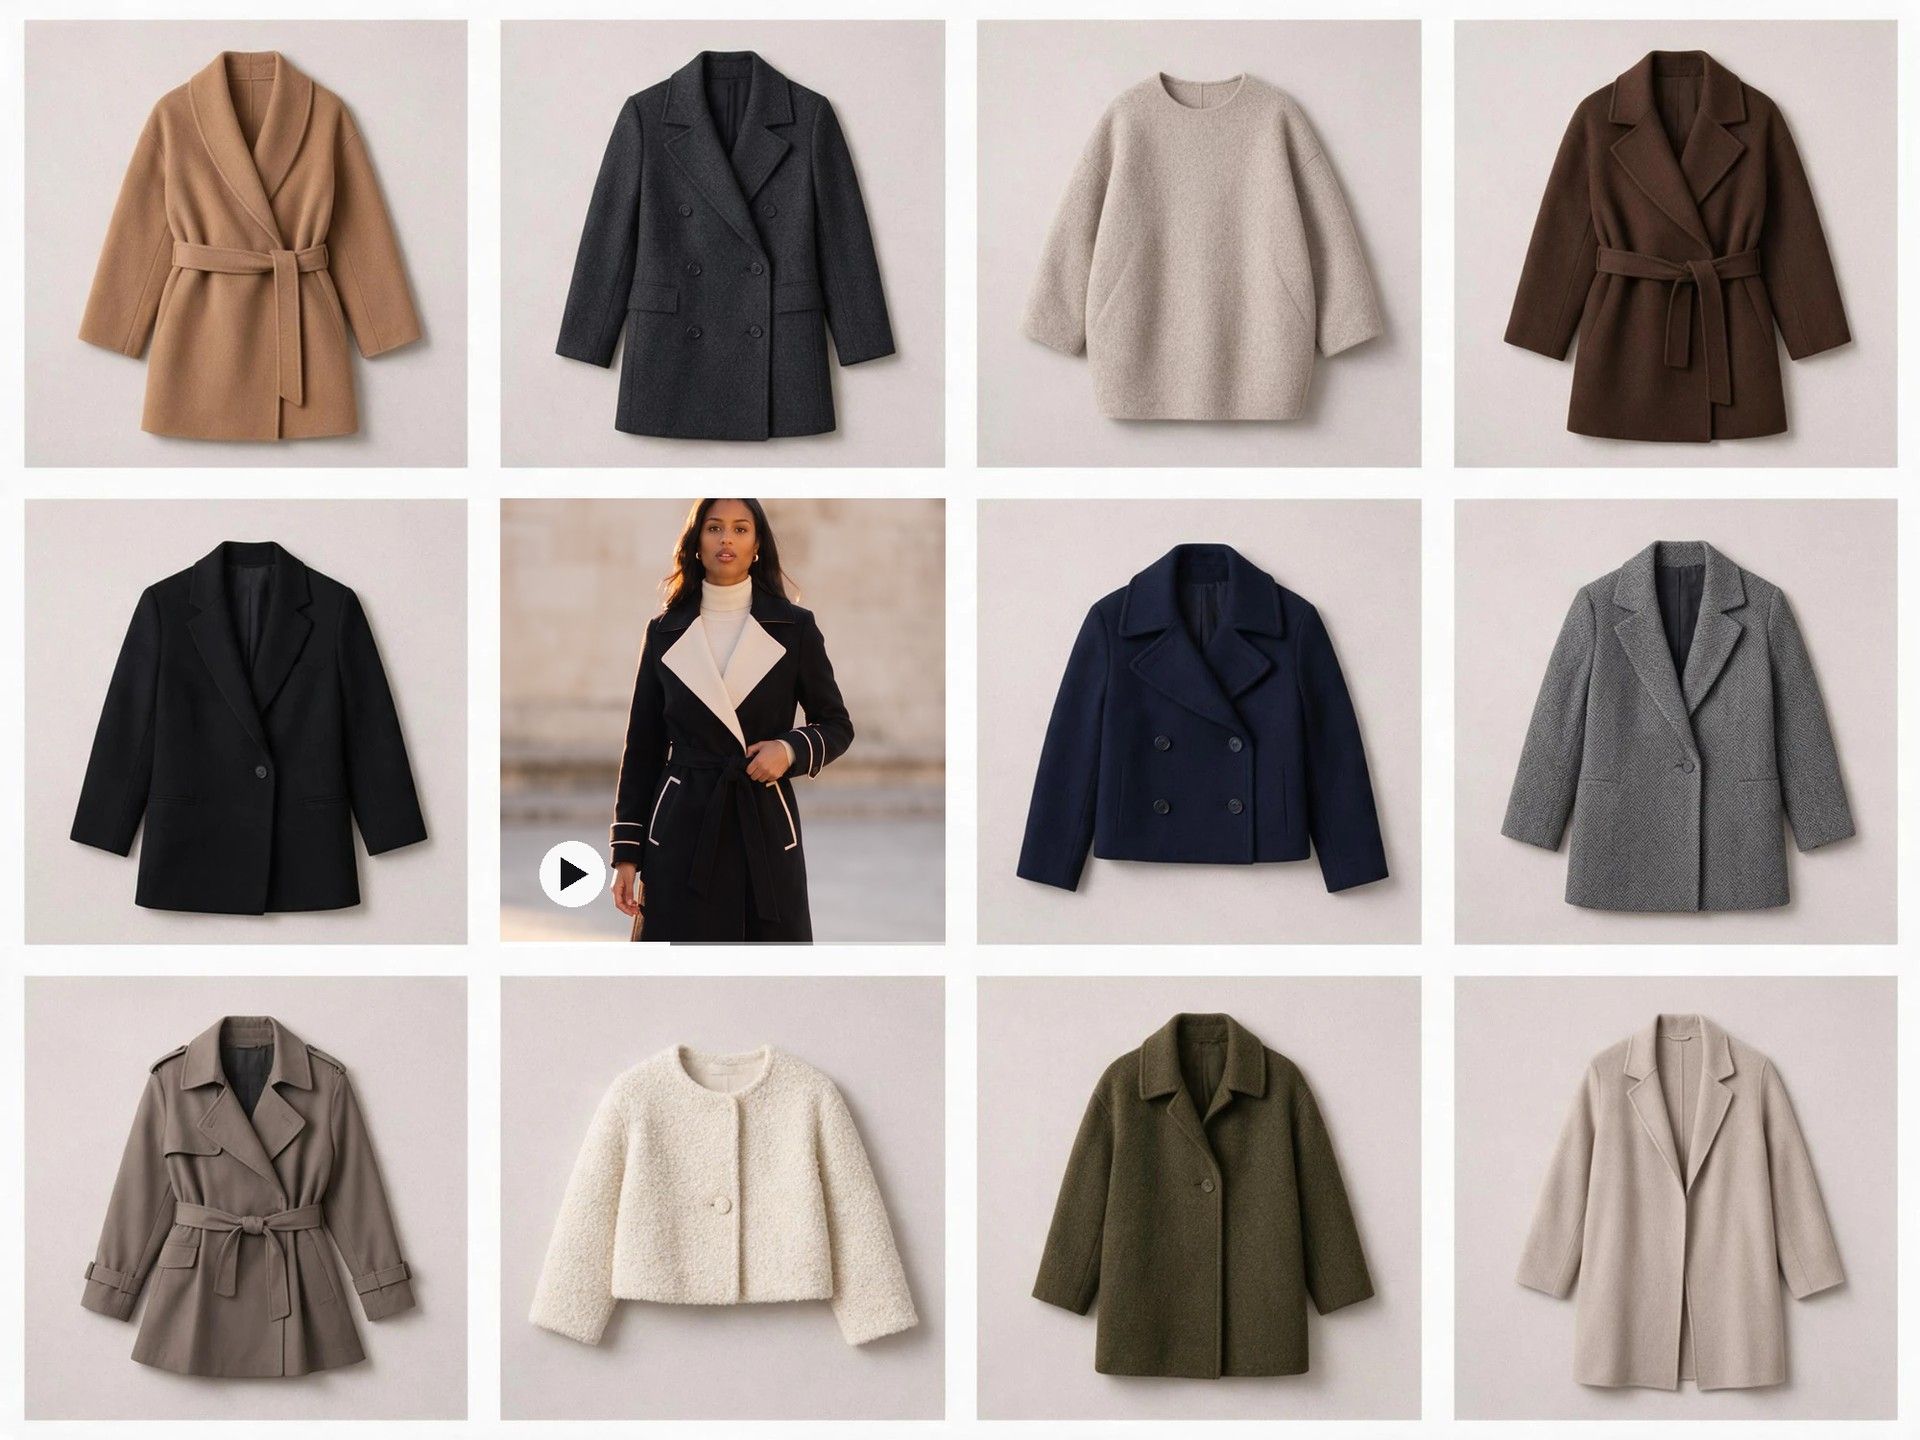
品类页满屏都是千篇一律的商品静物图,而且很多都来自同一个批发商,打光也一模一样。几秒钟的单品上身画面,是那个页面上别人都没有的东西。它还能展示衣长和垂坠感,而这正是大多数服装退货的根源所在。
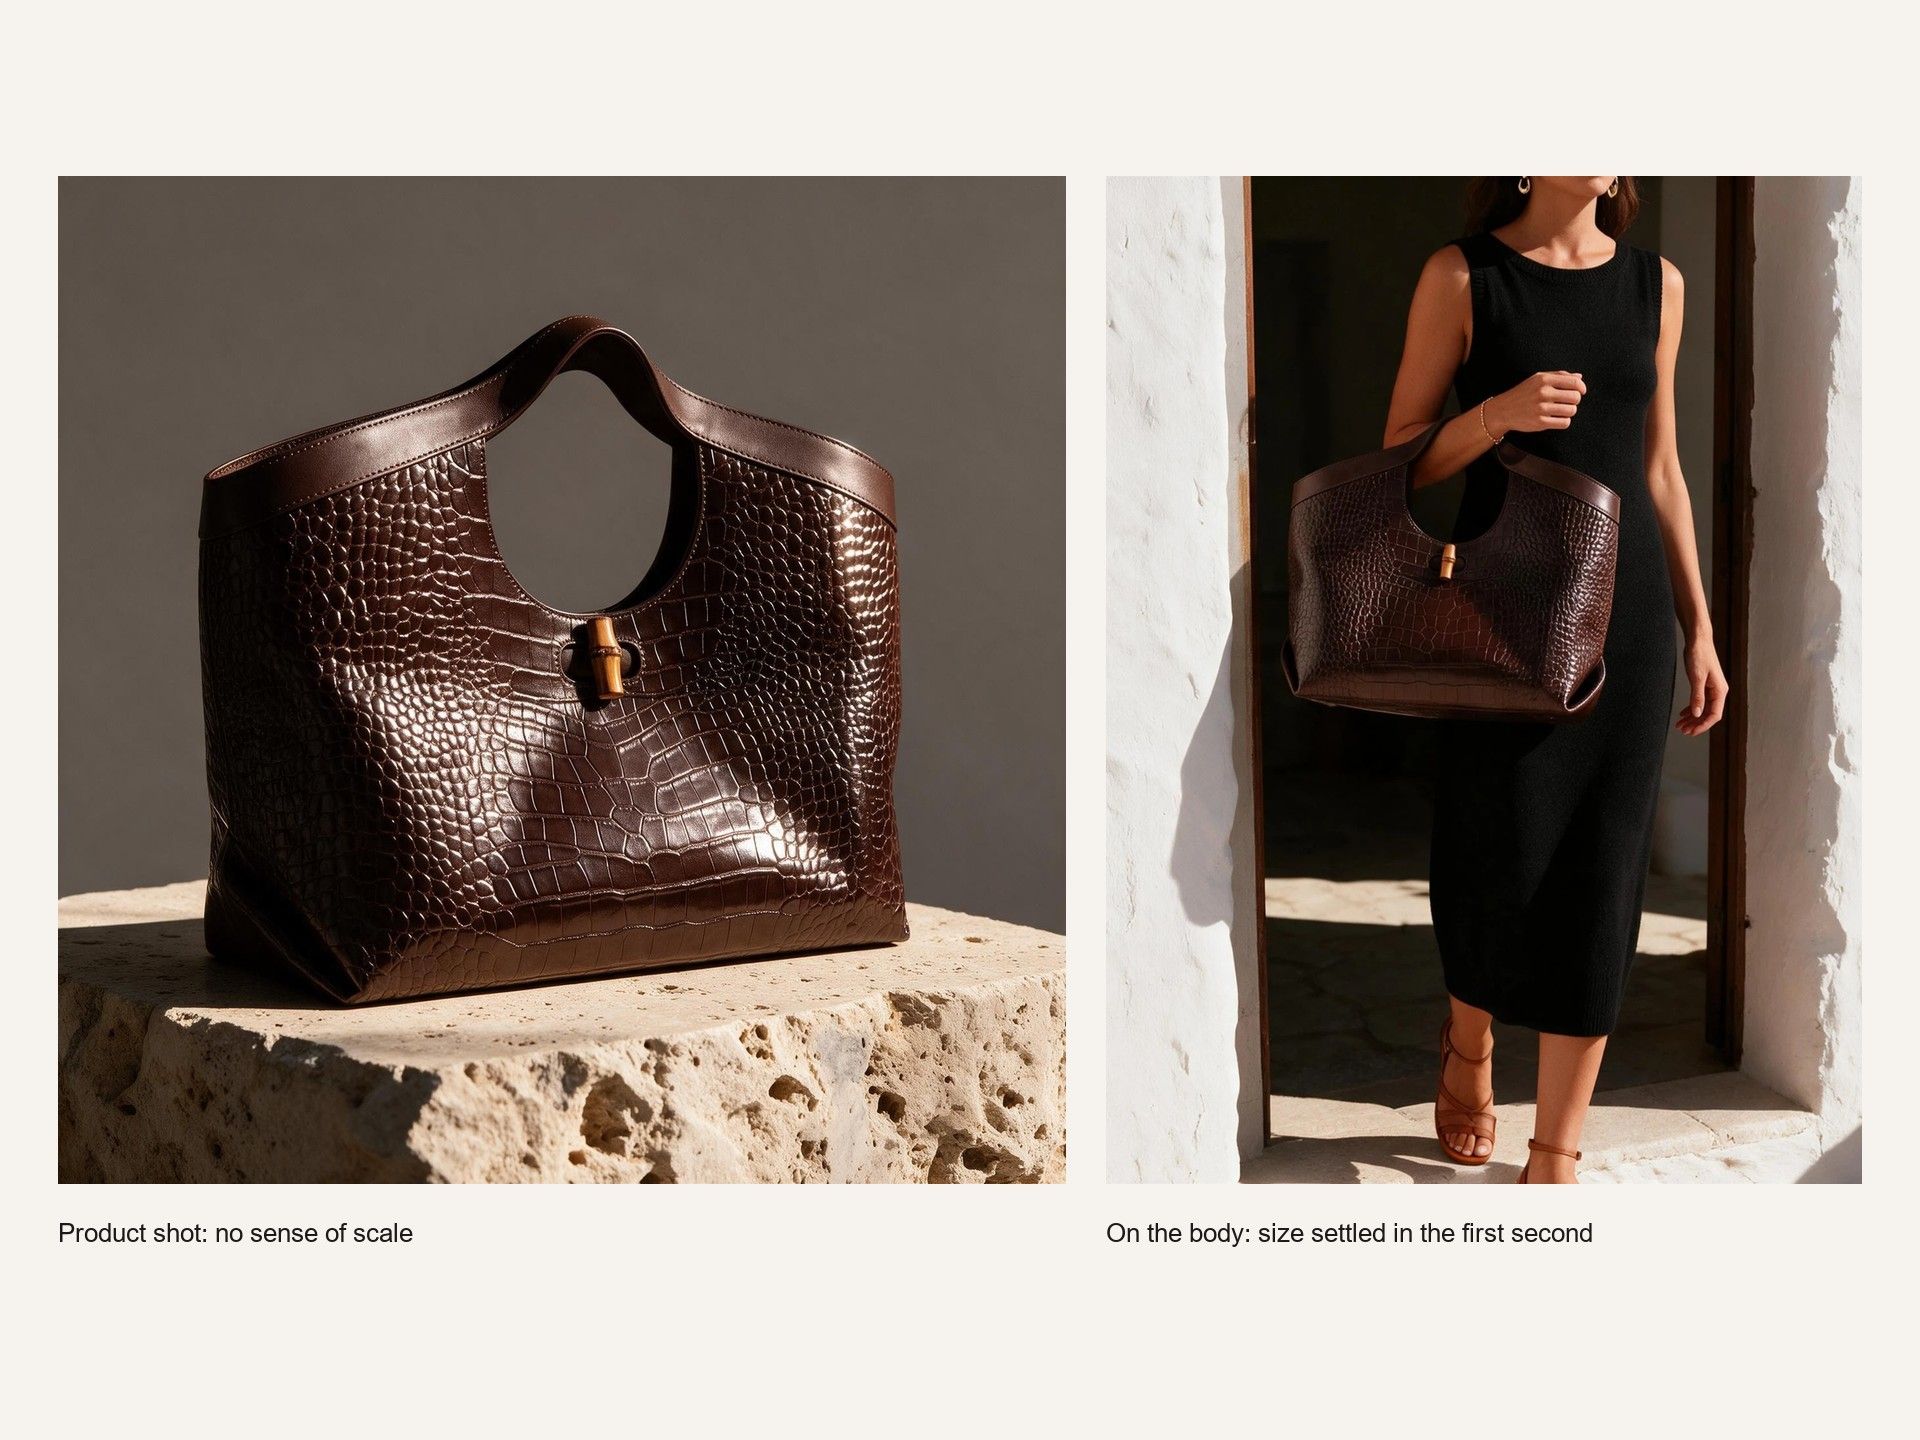
戒指或包袋很难仅凭产品图判断大小,而购物者最先问的往往是它到底有多大。为小件商品目录聘请手模,很少能收回成本。试戴或上身实拍视频能在第一秒就解决尺寸问题,而人们通常也只会看这么久。
推销营销活动方向时,有东西可看会更容易;而情绪板只会让客户自己去想象。一件成衣加一份简报,就能让会议有一部影片可看、可回应。如果方向不对,在拍摄排期确定之前发现,是发现代价最低的时候。
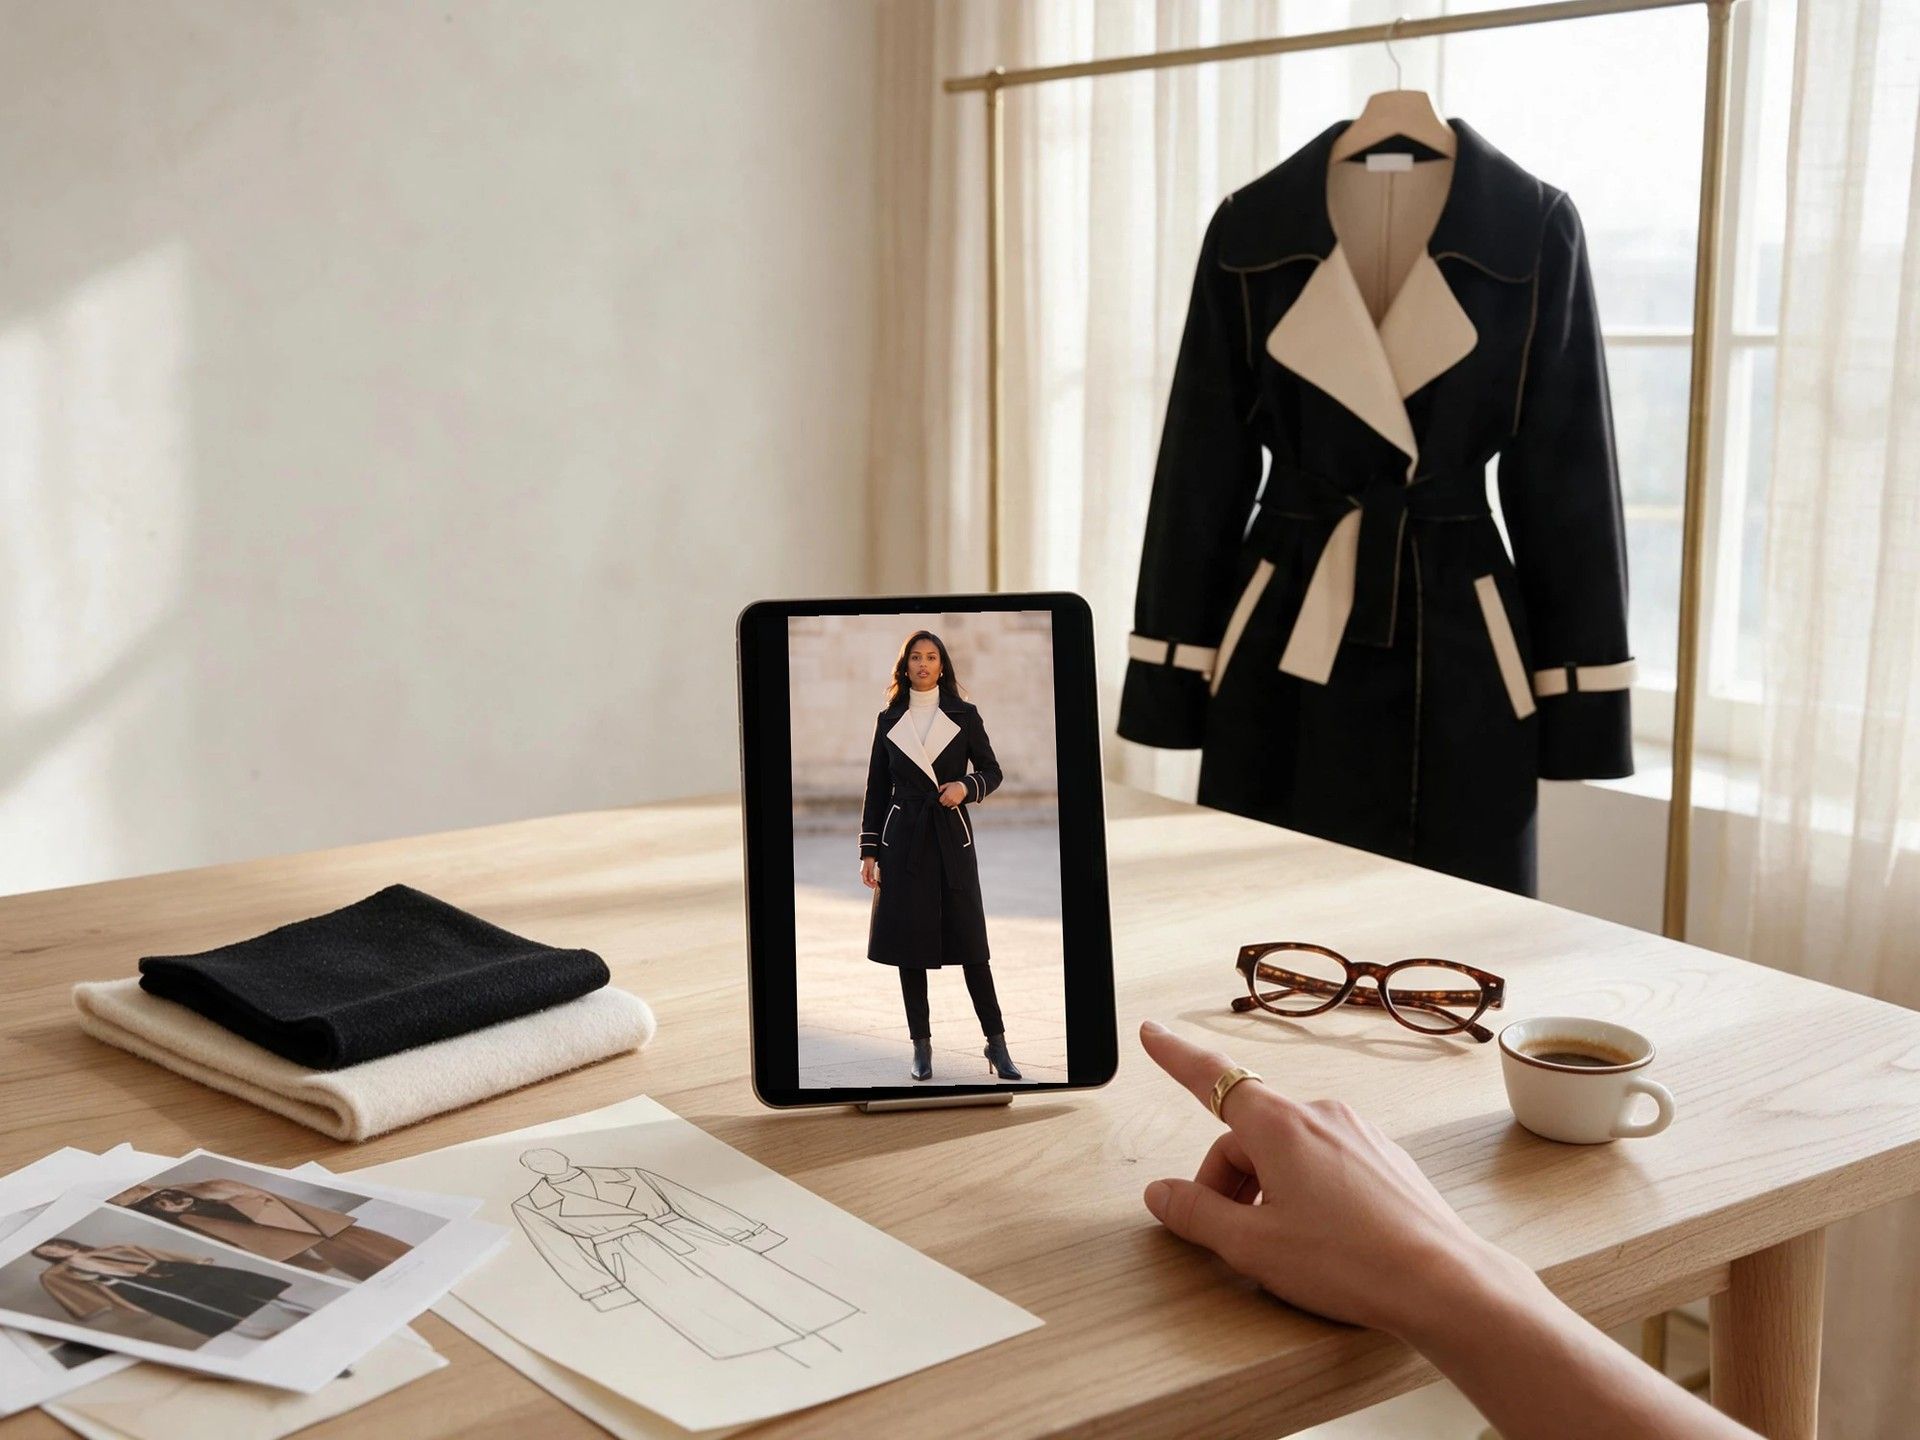
这是一段展示服装穿着效果的短片,由产品照片生成,而不是由模特实拍。你提供服装照片和一句描述穿着者的文字,模型会计算合身效果、渲染影像并返回一个视频文件。
两者都可行,人台也可以。关键是单品的轮廓要清晰可辨:接缝、下摆、扣合件的位置。皱巴巴的平铺图,比同一件衣服的挂拍图,能让合身度环节参考的东西更少。
该模板设定为55%纯试穿、30%生活方式场景和15%面料细节,因此即便是四秒的片段,大部分时间也用在所穿服装上。
4 到 15 之间的任意整数秒。表单打开时默认为 8,即模板自身示例渲染时所用的时长。
定价取决于时长和分辨率。在 720p 下,一段 4 秒视频约 $1.76,10 秒约 $3.58,完整的 15 秒约 $5.09。渲染失败无需付费。
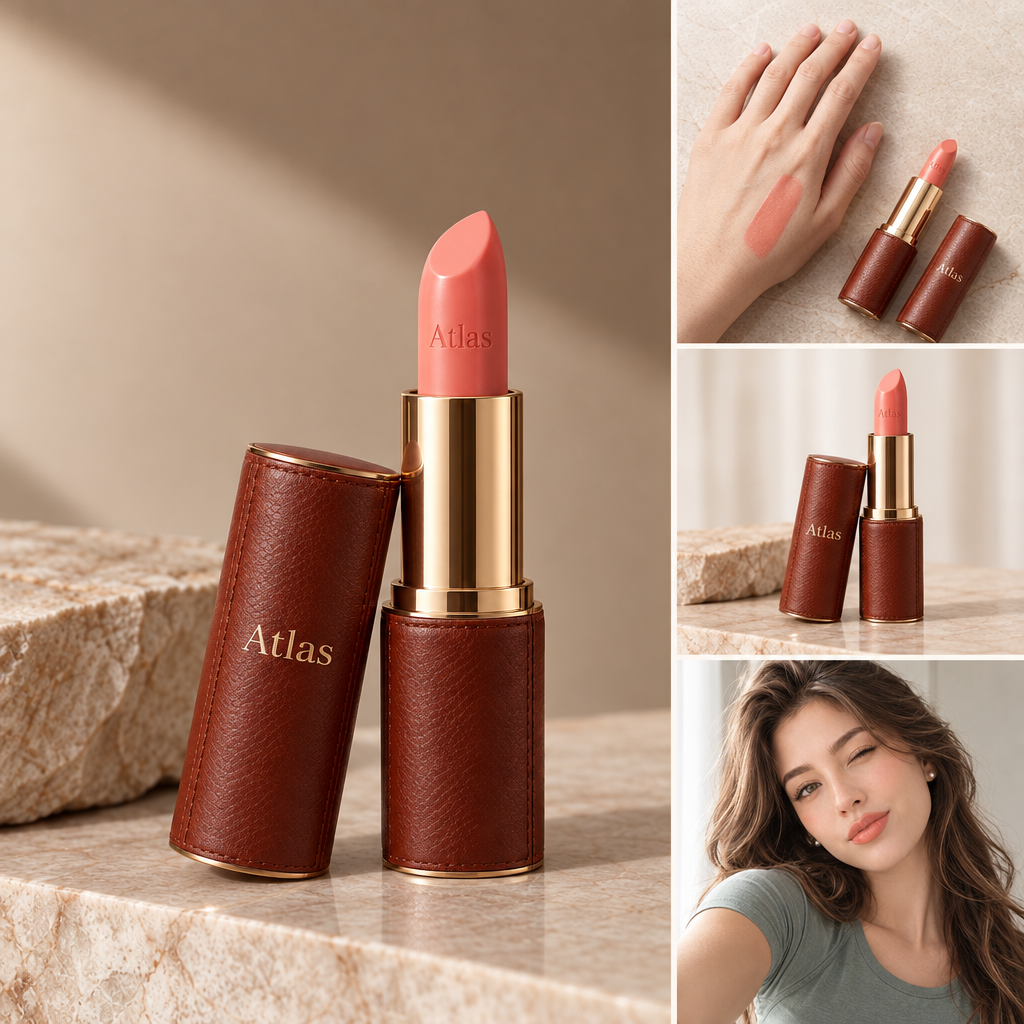
手袋、帽子和珠宝首饰与服装一样,也要经过相同的步骤:从照片中读取,贴合到模特上,然后进行拍摄。上传单品时,请按佩戴或携带的状态上传,而不是装在盒子里或折叠起来,这样贴合步骤才有内容可读取。
剪裁、面料、五金件和任何印花都取自你上传的照片,因此清晰的图案照片能让渲染有最多可依据的信息。移动衣物上的繁复印花是这里最难处理的情况,在其他任何地方也一样。
Seedance 2.5。服装读取、参考表和合身静帧是此模板在渲染开始前提供的内容。
广告平台和零售渠道对广告中的合成人物以及生成的模特图像各有自己的规定,而且这些规定都不会长期不变。视频上线前,请先查看投放目标当前关于生成人物的规定。
是的,每件单品调用一次。向 /api/v1/model/generateVideo 发送 POST 请求,并将 model 设置为 atlascloud/studio/virtual-try-on,然后轮询 /api/v1/model/prediction/{request_id},直到状态返回 completed。每次调用都传入相同的 model_image,才能在整个系列中保持同一张脸。从 API 文档开始。
拍什么、选谁出演,以及每个剪辑点该放在哪里。
上传照片,通过AI发型变换器免费试戴男士发型、渐变发型和男士丸子头。在坐上理发椅之前,先预览剪发效果。
AI试衣详解:虚拟试衣如何运作,一个今天即可在浏览器中测试的免费虚拟试衣间,以及购买前需检查什么。
Compare the FitRoom AI clothes changer with a free alternative on Atlas Cloud. See pricing, credits, and how each virtual try-on tool works in 2026.
Seedance 2.5 vs Seedance 2:字节跳动刚刚预览了一款原生4K、支持50个参考输入的30秒模型。以下是已发生的变化,以及尚未验证的部分。