تقرير اختبار API أخضر يبدو مطمئنًا حتى تلاحظ أن كل تأكيد يتحقق فقط من HTTP 200. قد تحتوي الاستجابة على سجل عميل خاطئ ومع ذلك تنجح.
اختر أدوات الذكاء الاصطناعي لاختبار API بناءً على العمل الموجود لديك بالفعل. قيّم Postman Agent Mode إذا كان فريقك يحتفظ بمجموعات، وKushoAI إذا كانت المواصفة نقطة انطلاقك، وKeploy إذا كنت بحاجة إلى تدفقات مُولّدة أو اختبارات انحدار مبنية من حركة مُسجّلة. راجع الاختبارات الناتجة ونفّذها قبل الوثوق بها.
يغطي هذا الدليل مساعدة الذكاء الاصطناعي لاختبار واجهات API العادية. أما اختبار دقة إجابات نموذج ذكاء اصطناعي فمشكلة تقييم منفصلة.
النقاط الرئيسية
- وفّر العقد، واعتماديات الطلبات، وتوقعات الأعمال المعتمدة.
- تحقق مما إذا كانت التأكيدات ترفض البيانات الخاطئة والحقول المفقودة والأنواع المعطوبة.
- لا تشترِ إلا بعد أن تعمل الاختبارات المراجَعة بشكل متكرر في بيئة CI المقصودة.
تعكس مقارنة المنتجات أدناه الوثائق الرسمية التي تم التحقق منها في 21 سبتمبر 2026. وهي ليست مقارنة مباشرة بين ثلاثة حسابات مدفوعة.
يستخدم المثال العملي مواصفة Swagger Petstore مثبّتة ويفصل بين توقعات العقد والسلوك الملاحَظ ونسخ الاستجابات المعدّلة عمدًا.
نجح تشغيلنا المحلي في 5 اختبارات حية ورفض جميع نسخ الاستجابات الثلاث المعدّلة عمدًا. ولا يزال فحص منفصل لاسم مفقود يعيد 200، ما يوضح لماذا يهم نطاق التقرير الأخضر.
ما الذي تفعله أدوات الذكاء الاصطناعي لاختبار API فعليًا
تدخل مساعدة الذكاء الاصطناعي عادةً في أربعة أجزاء من اختبار API. يقرأ النموذج مواصفتك، ويقترح سيناريوهات، ويصوغ التأكيدات، ويساعد في تفسير حالات الفشل. يتطلب كل جزء أدلة مختلفة. لا يثبت التفسير المعقول لفشل ما أن الإصلاح المقترح صحيح.
لمراجعة المواصفة، وفّر ملف OpenAPI وقواعد الأعمال ذات الصلة. لتخطيط السيناريوهات، أضف أمثلة على البيانات الصالحة والحدود المعروفة. للسكربتات القابلة للتنفيذ، ضمّن مشغّلك وإعداد المصادقة واصطلاحات الـ fixtures. للتشخيص، وفّر الطلب الفعلي والاستجابة ورسالة الفشل بعد إزالة الأسرار.
حافظ على فصل هذه الآليات الأربع عند تقييم المنتجات:
- توليد LLM: يقترح اختبارات من اللغة والمخططات والأمثلة. يجب أن يتحقق المراجع من النتائج المتوقعة.
- إعادة تشغيل حركة المرور: يقارن السلوك اللاحق بالتفاعلات الملتقطة، غالبًا باستخدام استجابات التبعيات المسجلة.
- الاختبار القائم على الخصائص: يبني مدخلات بشكل منهجي لتحدي خصائص مثل مطابقة المخطط.
- تنفيذ الاختبار: يرسل الطلبات، ويقيّم التأكيدات، ويعيد التقارير ورموز الخروج.
قد يجمع منتج ما بين عدة آليات. اسأل أي آلية أنتجت كل اختبار وما الذي يحدد نتيجته المتوقعة. إن تسجيل استجابة غير صحيحة يمكن أن يحفظ الخطأ نفسه كخط أساس للانحدار. كما أن توليد اسم اختبار مصقول قد يخفي توقعًا غير مدعوم.
فكّر في التأكيدات على ثلاثة مستويات. أولًا، هل استجاب الخادم بنجاح؟ ثانيًا، هل يحتوي الجسم على الحقول والأنواع الموثقة؟ ثالثًا، هل يمثل هذا الجسم المورد والعملية الذين طلبتهما؟
في البحث عن حيوان أليف، يظل كائن صالح بمعرّف عدد صحيح يفشل في الفحص الثالث إذا كان ذلك المعرّف يخص حيوانًا آخر. وبالمقابل، لا تثبت مطابقة المعرّف المطلوب أن كل حقل يفي بالمخطط. استخدم كلا الفحصين، وأضف قواعد الأعمال فقط حيث يكون لدى الفريق مصدر متفق عليه لها.
الناتج العملي الذي تريده هو أصل اختباري قابل للصيانة مع oracle قابل للتفسير: سبب واضح يجعل كل نتيجة تنجح أو تفشل. عُدّ السيناريوهات المفيدة بعد المراجعة، بما في ذلك تلك التي ترفضها، بدلًا من الاحتفاء بطول القائمة المولّدة الأولية.
أدوات الذكاء الاصطناعي لاختبار API مقارنة حسب سير العمل
ابدأ بالأصل الذي يمكن لفريقك توفيره اليوم. إن ترحيل مجموعة قائمة، وإعادة بناء قواعد أعمال مفقودة، وإعداد تسجيل التبعيات هي مشاريع مختلفة. الأداة التي تناسب نقطة انطلاق واحدة قد تخلق عملًا إضافيًا عند نقطة أخرى.
| الأداة أو النهج | المدخل المفيد | دور الذكاء الاصطناعي أو الأتمتة | مسار التنفيذ وCI | المخرجات القابلة للمراجعة | سؤال التجربة الرئيسي |
|---|---|---|---|---|---|
| Postman Agent Mode | المجموعات، والطلبات، والاستجابات، والبيئات، والمواصفات | يصوغ ويحرر سكربتات الاختبار في سياق مساحة العمل | Collection Runner وسير عمل CLI متوافق | تأكيدات Postman JavaScript القياسية | هل يحافظ على متغيراتك ويختبر العقد؟ |
| KushoAI | OpenAPI، مجموعة Postman، cURL | يولّد السيناريوهات وأجنحة الاختبار؛ ويدعم التحسين باللغة الطبيعية | تنفيذ المنصة وتكامل CI موثق؛ تحقق من الاستحقاق | افحص الطلبات المولّدة والتبعيات والنتائج المتوقعة | هل يمكن لخطتك المختارة تشغيل الجناح والاحتفاظ به حيث تحتاجه؟ |
| Keploy | المواصفات أو تعريفات الطلبات؛ أو حركة المرور الحقيقية بدلًا من ذلك | توليد بالذكاء الاصطناعي ومسار منفصل للتسجيل/الإعادة | تدفقات مولّدة أو اختبارات مسجلة في بيئات محلية/CI مدعومة | راجع تعريفات الاختبار وخطوط الأساس وmocks التبعيات | أي مسار يغطي أنماط الفشل الفعلية لديك؟ |
| مشغّل موجود بالإضافة إلى LLM | مصفوفة معتمدة، ومواصفة، واصطلاحات fixtures | يصوغ كودًا للمراجعة | pytest لديك أو أي مشغّل آخر راسخ | كود مُلتزم به في مستودعك | هل المراجعة أرخص من كتابة الاختبارات نفسها مباشرة؟ |
Postman Agent Mode للمجموعات الموجودة
يُعد Postman تقييمًا أوليًا معقولًا عندما تحتوي مجموعتك بالفعل على ترتيب طلبات مفيد، ومتغيرات بيئة، وإعداد مصادقة. يمكن لـ Agent Mode استخدام هذا السياق لتوليد سكربتات اختبار JavaScript قياسية. ويمكن لتلك السكربتات الدخول في سير عمل تنفيذ المجموعة الحالي بدلًا من طلب لغة تأكيد جديدة.
التجربة المركّزة أكثر كشفًا من مطالبتها باختبار كل شيء. اختر الطلب الذي يسترجع موردًا أُنشئ سابقًا في المجموعة. وفّر مخططه واطلب التحقق من الحقول المطلوبة، وأنواع الحقول الموثقة، وتأكيدًا يربط المعرّف المعاد بمعرّف الإنشاء المخزّن.
ثم افحص التغييرات المقترحة قبل قبولها. قد يحتوي مثال استجابة على حيوان أليف اسمه Milo. تكون المساواة مع Milo ذات معنى إذا أنشأ الـ fixture الخاص بك Milo صراحةً؛ وتكون هشة إذا نسخ المولّد اسمًا من سجل عينة مشترك. يمكن أن يكون النص الحرفي نفسه تأكيدًا صالحًا أو اعتمادية عرضية، حسب مصدره.
تحقق من نطاق المتغير بعناية. يجب أن يكون المعرّف المخزّن في متغير بيئة متاحًا للطلب اللاحق وأن ينتمي إلى ذلك التشغيل. يمكن أن تخلق المتغيرات المشتركة عبر تشغيلات متزامنة حالات فشل متقطعة تشبه عيوب الخادم. اطلب من المولّد شرح الإعداد والتنظيف إلى جانب التأكيدات.
لاختبار القبول الأول، شغّل المجموعة مرتين مقابل بيانات معزولة، ثم افحص التمثيل المُصدَّر أو المُدار بالإصدارات. تأكد من أن زميلًا يمكنه مراجعة السكربتات المتغيرة دون تكرار محادثة الذكاء الاصطناعي. وتحقق أيضًا من أن CLI والمُبلّغ والخطة الذين اخترتهم يدعمون مسار التنفيذ الذي تنوي استخدامه.
لا يُعرض هنا أي توليد Postman مُشغَّل. السؤال التقييمي المفيد هو ما إذا كان سياق مساحة العمل يقلل عمل المراجعة لديك على مجموعة موجودة. يتطلب ذلك مجموعتك الخاصة وتجربة على مستوى الحساب، وليس استنتاجًا مستخلصًا من لقطة شاشة لمنتج.
KushoAI لتوليد الاختبارات القائم على المواصفة
يقبل KushoAI مدخلات Swagger/OpenAPI وPostman وcURL ويوثّق توليد الاختبارات، والتحسين باللغة الطبيعية، وتنفيذ CI. وهذا يجعله مرشحًا عندما يمتلك الفريق تعريفات API مفيدة لكن لديه تراكم اختبارات غير مكتوبة. هذه قدرات وصفها البائع، وليست نتائج كشف عيوب مقاسة. (وثائق KushoAI، سبتمبر 2026)
اختر المدخل ذا السياق الأغنى والأكثر موثوقية. يمكن لطلب cURL أن يصف طلبًا صالحًا واحدًا، لكنه عادةً لا يقول إلا القليل عن الحقول الاختيارية، أو قيم enum المسموح بها، أو الأخطاء الموثقة. يضيف ملف OpenAPI بنية؛ وتضيف مصفوفة سيناريوهات معتمدة القصد الذي قد تتركه البنية غامضًا.
لتجربة Petstore، اطلب حالات منفصلة لحيوان أليف صالح، واسم مطلوب مفقود، ومعرّف بنوع خاطئ، ومرشّح حالة غير صالح. راجع ما إذا كانت الأداة تميز متطلبات جسم الطلب عن متطلبات مخطط الاستجابة. قد تبدو هذه متشابهة في مثال بينما تفرض التزامات مختلفة.
بعد ذلك، افحص تدفقًا متصلًا للإنشاء-القراءة-التحديث. يجب أن تستخدم القراءة المعرّف المرتبط بالإعداد الحالي. ويجب أن يستهدف التحديث المورد نفسه، ويجب أن تتحقق قراءة لاحقة من الحقل المتغير. أربعة طلبات مستقلة بأسماء اختبارات جذابة لا تثبت أن سلسلة التبعية تعمل.
تعامل مع التوليد الأول كمقترح. احتفظ بالتوقعات الموثقة، وراجع السكربتات ذات تدفق البيانات غير الصحيح، وأشر إلى النتائج ناقصة المواصفة لاتخاذ قرار بشأن المتطلبات. إذا اقترحت الأداة عدة حالات مكافئة لحقل مفقود، فاحتفظ بالفروق المفيدة بدلًا من الدفع لصيانة تكرارات.
قبل الشراء، اطلب تنفيذ الجناح من خط الأنابيب المقصود لديك وافحص أثر الفشل. أكّد أذونات CI الحالية، ومعالجة بيانات الاعتماد، وصيغ التصدير المتاحة في الخطة المختارة. لا تفترض أن تجربة تفاعلية مجانية تمنح حقوق الأتمتة نفسها التي يمنحها نشر فريق.
Keploy للاختبارات المولّدة وإعادة تشغيل حركة المرور
تعرض وثائق Keploy مساري بداية متميزين. يقبل توليد الذكاء الاصطناعي موارد مثل OpenAPI أو Postman أو cURL أو نقاط النهاية ويبني تدفقات API متصلة. ويلتقط التسجيل وإعادة التشغيل تفاعلات API وتبعياتها لتنفيذها لاحقًا مع mocks. لا ينبغي التعامل مع وصف تدفق الذكاء الاصطناعي ووصف تسجيل التبعيات كآليتين متطابقتين. (وثائق Keploy، سبتمبر 2026)
إذا كانت صعوبتك هي إعادة إنتاج ما فعله تطبيق ما مع قاعدة بيانات أو خدمة upstream، فقيّم مسار التسجيل. التقط رحلة صغيرة للإنشاء-القراءة-التحديث في بيئة معزولة، وافحص التبعيات الملتقطة، ثم أعد التشغيل بعد تغيير مضبوط في التطبيق. تحقق مما يدعمه runtime قبل التخطيط لنشر أوسع.
إذا كانت صعوبتك هي استخلاص حالات من مواصفة، فقيّم مسار التوليد بشكل منفصل. اسأل كيف تحصل طلباته المقترحة على بيانات الاعتماد، وتنقل المعرّفات بين الخطوات، وتنظف البيانات. وجود ميزات التسجيل في مكان آخر من المنتج لا يجيب عن تلك الأسئلة بالنسبة لجناح مولّد.
تحتاج القيم الديناميكية إلى تقدير. قد يختلف الطابع الزمني بشكل مشروع؛ وقد يربط معرّف مورد بين طلبين وبالتالي يحتاج إلى مقارنة. إن تجاهل كل حقل متغير على نطاق واسع يمكن أن يخفي الأخطاء. راجع الاستثناءات حقلًا بحقل واحتفظ بالمقارنات التي تعبّر عن علاقات ذات معنى.
افحص أيضًا خط الأساس قبل قبوله. إن تسجيلًا يحتوي على إجمالي خاطئ، أو استجابة احتياطية عرضية، أو بيانات قديمة يمكن أن يُعاد تشغيله باستمرار. تساعد الاتساقية في كشف التغيير، لكن الفريق يقرر مع ذلك ما إذا كان السلوك الملتقط صحيحًا.
ملحق مفيد: يوفر Schemathesis اختبار API قائمًا على الخصائص ومدفوعًا بالمخطط. يمكنه تحدي API بمدخلات مولّدة إلى جانب أمثلة مراجَعة. تعامل معه كآلية اختبار مختلفة، وليس كمرادف لمولّد اختبارات LLM. لا تزال نتائجه تحتاج إلى تفسير مقابل العقد والتنفيذ.
أدوات الذكاء الاصطناعي المجانية لاختبار API: الحدود والتكاليف
يمكن أن تصف كلمة "مجاني" عميلًا، أو حصة ذكاء اصطناعي محدودة، أو مشغّلًا مفتوح المصدر، أو تجربة مؤقتة. تغطي هذه العروض أجزاء مختلفة من سير العمل. لا يثبت العميل المجاني أن التوليد الآلي أو التنفيذ المجدول أو تصدير التقارير مجاني أيضًا.
وفقًا لما تم التحقق منه في 21 سبتمبر 2026، تسرد خطة Postman المجانية 50 رصيد ذكاء اصطناعي شهريًا. الأرصدة هي وحدة الفوترة لديها؛ وهي لا تعني 50 اختبارًا أو 50 جناحًا كاملًا. يميز جدول المقارنة الخاص بها حصة الذكاء الاصطناعي عن التنفيذ والميزات المدفوعة بالبيانات وتصدير النتائج. (أسعار Postman، سبتمبر 2026)
يستخدم عرض أسعار KushoAI الحالي إصدار Developer Edition وEnterprise. وتميز Keploy بين Playground وPro وEnterprise، إلى جانب عرضها مفتوح المصدر. استخدم شاشة الشراء الحالية لتأكيد الحدود ذات الصلة. يمكن أن تصف جولات الأدوات الأقدم أسماء خطط مسحوبة أو تجمع حصصًا تُفوتَر بشكل منفصل.
| مكوّن التكلفة | ما يجب تسجيله في تجربة | ما قد يجعل الفاتورة مضللة |
|---|---|---|
| المقاعد والخطة | المحررون، والمراجعون، وفترة الفوترة، والميزات المطلوبة | مقارنة الأسعار السنوية الرئيسية بالالتزامات الشهرية |
| توليد الذكاء الاصطناعي | استخدام الأرصدة للمهمة المعتمدة نفسها، بما في ذلك المحاولات المتكررة | افتراض أن رصيدًا واحدًا يساوي اختبارًا واحدًا |
| التنفيذ | التشغيلات المحلية، والتشغيلات المستضافة، ومهام CI، والجداول، والتقارير | التعامل مع التشغيلات التفاعلية كإذن لكل مسار أتمتة |
| نموذج مستقل | رموز الإدخال والإخراج للصياغة والمراجعة | تجاهل عمليات الإرسال المتكررة للمواصفة الكاملة |
| وقت الهندسة | المراجعة، وإصلاح fixtures، وفرز الفشل، والصيانة | حساب وقت التوليد الأولي كوقت التسليم الكلي |
استخدم مهمة قبول صغيرة لتقدير التكلفة. أعطِ كل مرشح العمليات والتوقعات نفسها، ثم سجّل عدد السيناريوهات التي تنجو من المراجعة. واحتفظ بوقت التوليد ووقت المراجعة اليدوية ووقت التنفيذ في أعمدة منفصلة. إن الانتظار لنموذج وتصحيح تأكيد خطِر يفرضان تكاليف مختلفة على الفريق.
المقام المفيد هو السيناريوهات المراجَعة والقابلة للتشغيل التي سيحتفظ بها فريقك. فهو يمنع مولّدًا ذا حالات مكررة كثيرة من أن يبدو أرخص لمجرد أن مخرجاته أطول. سجّل الحالات غير المدعومة التي أزلتها والمتطلبات التي لا تزال غير محلولة.
لا يدّعي هذا المقال نسبة موفرة للعمل مقاسة أو يقارن إنتاجية الخطط المدفوعة. تحتاج تلك الأرقام إلى تجربة مضبوطة بمدخلات مكافئة. لاتخاذ قرار شراء، ضمّن تغييرًا صيانياً واقعيًا واحدًا، مثل إضافة حقل مطلوب، بحيث يغطي التقدير السبرنت التالي وكذلك العرض الأول.
أدوات الذكاء الاصطناعي لاختبار API: من OpenAPI إلى أول تشغيل
استخدم نسخة محلية معزولة من مشروع Swagger Petstore الحقيقي. ثبّت الإيداع d57941e8fe959e508796b27469b1e8bba73392dc؛ إذ تعلن مواصفته OpenAPI 3.0.4 وإصدار التطبيق 1.0.29-SNAPSHOT. اقرأ الملف المثبّت بدلًا من عرض عام مُحدَّث بشكل مستقل. (مواصفة Swagger Petstore، سبتمبر 2026)
1. جهّز الخدمة وسجّل البيئة. احصل على المستودع عبر صفحة المصدر تلك، واستخرج المراجعة المثبّتة، وثبّت JDK وMaven متوافقين. يعطي README الخاص بالمشروع أمر التشغيل هذا من دليل المستودع:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
يستخدم Jetty المنفذ 8080. اضبط BASE_URL على أصل HTTP loopback لديك على ذلك المنفذ مع إلحاق /api/v3. أكّد أن /openapi.json قابل للقراءة نسبةً إلى ذلك الأساس قبل الاختبار.
استخدم هذا التشغيل Temurin JDK 17.0.20.1، وMaven 3.9.9، وPython 3.12، وpytest 9.1.1، وjsonschema 4.26.0. سجّل إصداراتك أيضًا. ينزّل بناء المصدر التبعيات وSwagger UI، لذا فإن إيداع تطبيق مثبّت وحده ليس بناءً محكم الإغلاق بالكامل.
2. استورد المواصفة المثبّتة. حدد /pet و/pet/{petId} و/pet/findByStatus. أبقِ delete متاحًا للتنظيف. تجاوز موقع الخادم العام في المواصفة باستخدام أساسك المحلي. تحقق من هذا الإعداد قبل إرسال أي طلب كتابة.
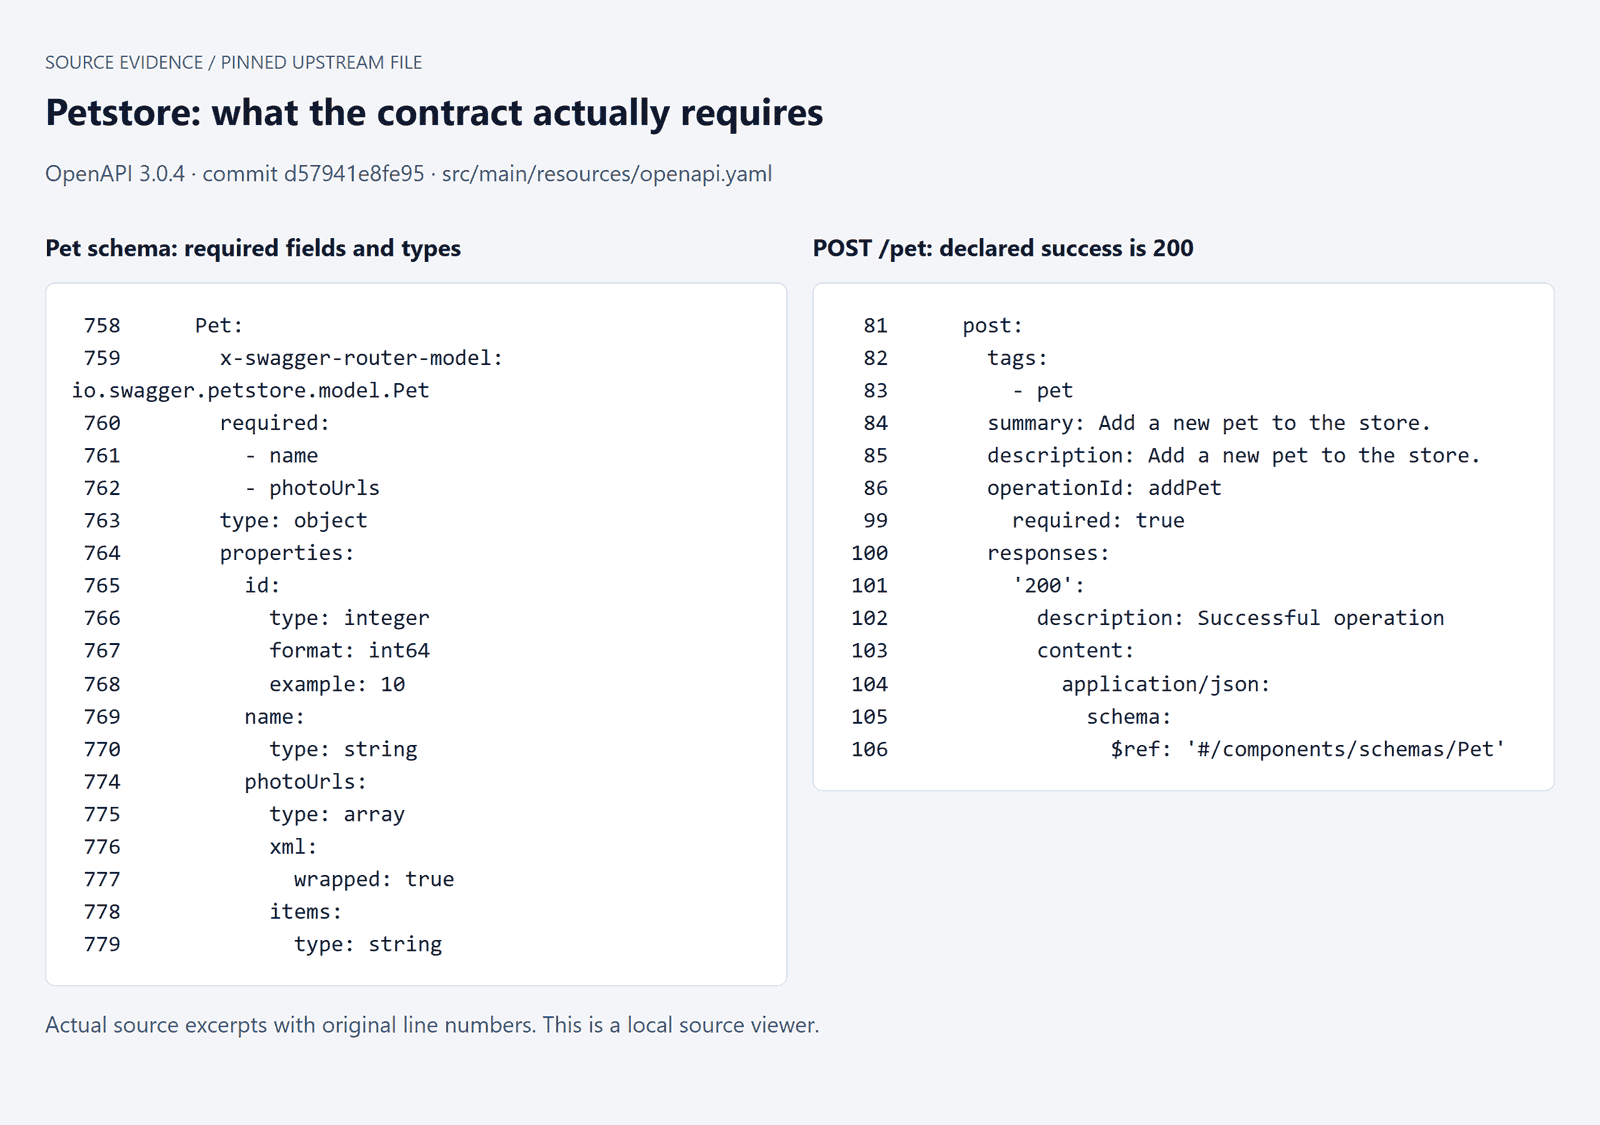 مصدر OpenAPI Petstore المثبّت يعرض الحقول المطلوبة وتعريفات العمليات المختارة
مقتطفات مصدر حقيقية معروضة محليًا: يتطلب Pet الحقلين name وphotoUrls؛ ويعلن POST /pet عن 200 للنجاح. يتم الحفاظ على أرقام الأسطر الأصلية.
3. ولّد مصفوفة قبل الكود القابل للتنفيذ (Prompt A). أرفق المواصفة وألصق هذا الطلب في المولّد الذي اخترته:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. راجع الـ oracle لكل سيناريو. توثّق Petstore الإنشاء الناجح كـ 200. يتطلب مخطط Pet الحقلين name وphotoUrls؛ وللمعرّف id نوع عدد صحيح لكنه ليس في قائمة الحقول المطلوبة تلك. لذلك يحتاج التحقق من الحقل المفقود وهوية الطلب-الاستجابة إلى فحوص مختلفة.
| العملية | المدخل أو التسلسل | دليل النتيجة المتوقعة | التأكيد المطلوب مراجعته | حالة التنفيذ |
|---|---|---|---|---|
| addPet, getPetById | إنشاء، ثم قراءة المعرّف الحالي | 200 موثق ومخطط Pet؛ توقع تدفق صريح | تحقق من الجسم وقارن المعرّف المعاد | نجح محليًا |
| updatePet, getPetById | غيّر الاسم واقرأ مرة أخرى | عملية التحديث بالإضافة إلى قصد fixture المعتمد | المعرّف نفسه، اسم جديد، مخطط صالح | نجح محليًا |
| findPetsByStatus | استعلم عن available بعد الإعداد | enum موثق واستجابة مصفوفة ناجحة | كل الحالات المعادة متطابقة؛ المعرّف المنشأ موجود | نجح محليًا |
| getPetById | معرّف مسار غير صحيح | 400 موثق لمعرّف غير صالح | الحالة الدقيقة لهذه الحالة الموثقة | نجح: 400 |
| findPetsByStatus | قيمة enum غير موثقة | 400 موثق لحالة غير صالحة | الحالة الدقيقة، واحتفظ بأي عدم تطابق | نجح: 400 |
| addPet | احذف name المطلوب | حقل مخطط مطلوب؛ ووصفا 400 و422 لا يغطيان كل تنويع | سجّل السلوك؛ وحل التعيين الدقيق قبل البوابة | أعاد 200 بدون name؛ تم الاحتفاظ بعدم التطابق |
5. ولّد ملف التنفيذ وافحصه (Prompt B). أرفق المصفوفة المعتمدة والمواصفة مع هذا الطلب:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. نفّذ، واحفظ، ونظّف. استخدم معرّف حيوان أليف خاصًا بالتشغيل، والتقط استجابة الإنشاء، ومرّر معرّفه إلى الطلبات اللاحقة. تحقق من التحديث عبر قراءة جديدة. لا تثبت استجابة تحديث ناجحة وحدها أن الخادم حفظ التغيير.
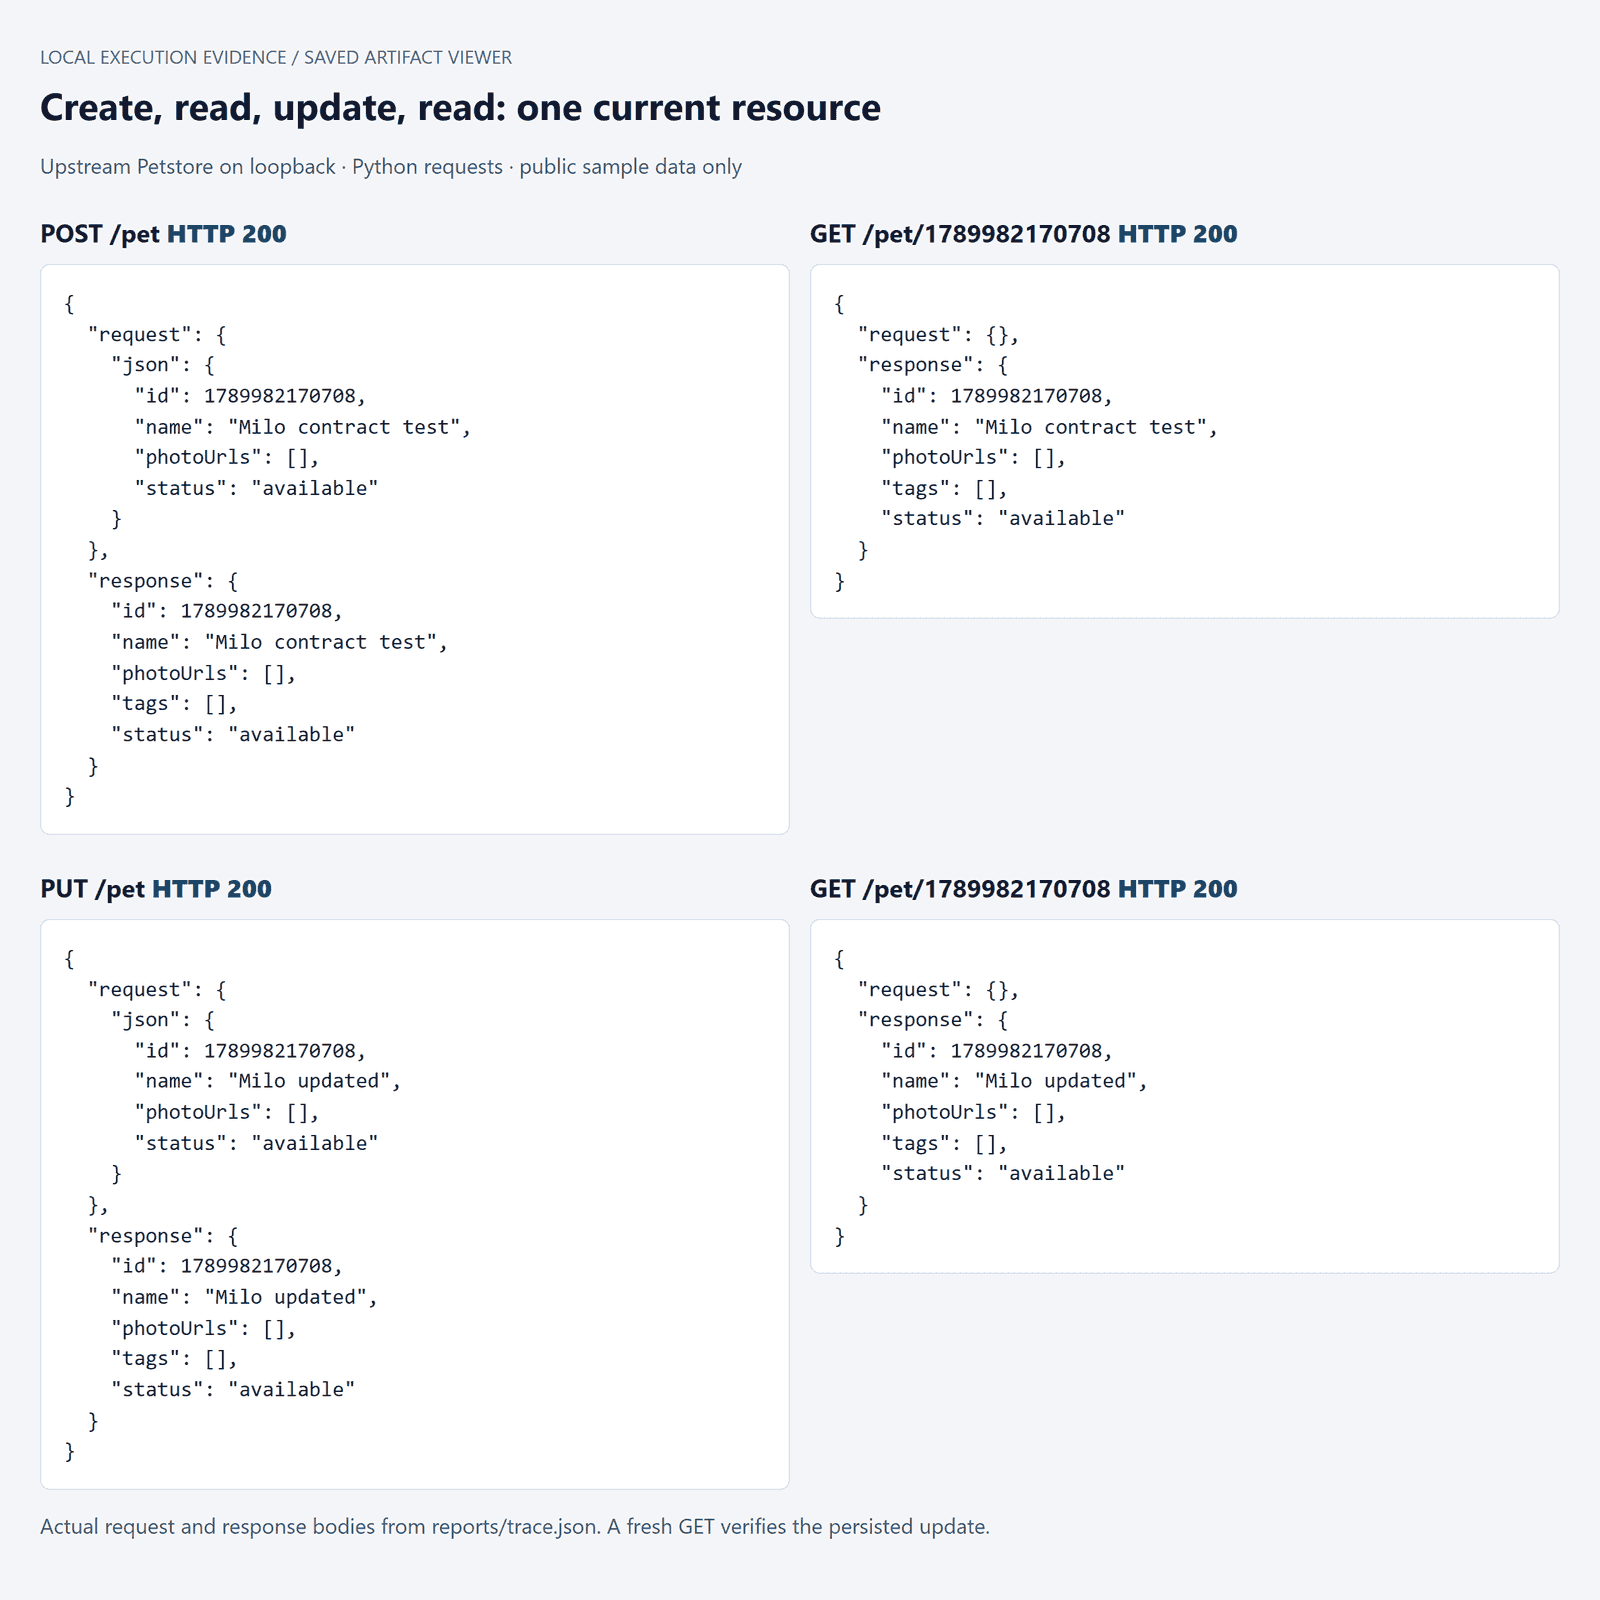 دليل سلسلة طلبات Petstore المحلية يعرض الإنشاء والبحث والتحديث ونقل المعرّف
طلبات واستجابات محلية محفوظة: يبقى المعرّف نفسه الخاص بالتشغيل عبر الإنشاء والقراءة والتحديث وقراءة جديدة. جميع الطلبات الأربعة المعروضة أعادت 200.
احفظ أجسام الطلبات، والاستجابات، وإخفاقات التأكيد، ونتيجة التنظيف. واقصر الحذف على المعرّفات التي أنشأها هذا التشغيل. واحتفظ بالاستجابات غير المتوقعة كنتائج، بما في ذلك الحالات التي يقبل فيها تنفيذ العرض مدخلات غير صالحة. لا تعدّل التأكيدات فقط للحصول على لقطة شاشة خضراء.
ما وجده هذا التشغيل: نجحت دوال الاختبار الحية الخمس، بما في ذلك فحوص المعرّف غير الصالح والحالة غير الصالحة التي أعادت 400. وأعاد الفحص المنفصل للاسم المفقود 200 وجسمًا بدون name. احتفظنا بعدم تطابق المخطط هذا خارج الجناح الأخضر؛ ولا يزال تعيين الخطأ المقصود الدقيق بحاجة إلى توضيح. وقد حُذف السجلان المنشآن بنجاح.
صيغت الاختبارات المحلية في تشغيل هذا المقال، بشكل مستقل عن الأدوات التجارية الثلاث. احتُفظ بجميع الاختبارات الحية الخمس؛ ولم يُحذف أي منها أو تُخفف توقعاته بعد التنفيذ. لم يُقس وقت المراجعة البشرية. يحتوي مجلد الأدلة على ملفات الاختبار، وقفل التبعيات، والاستجابات الخام، وتعليمات إعادة الإنتاج.
كيفية التحقق من أدوات الذكاء الاصطناعي لاختبار API
يجب أن يرفض التأكيد المفيد إجابة خاطئة ذات صلة. يمكنك اختبار هذه الخاصية دون تغيير الخدمة قيد التشغيل: احفظ استجابة ناجحة حقيقية، وانسخها، وعدّل حقلًا واحدًا في كل مرة عمدًا. هذه طفرات استجابة مضبوطة، وليست ثغرات إنتاجية أو معيارًا كاملًا لاختبار الطفرات.
أبقِ الحالة والجسم الأصليين معًا. شغّل المدقق أولًا مقابل الاستجابة غير المعدلة وتحقق من قبوله لخط الأساس. ثم أنشئ ثلاث نسخ مستقلة. غيّر المعرّف، وغيّر نوع الاسم، وأزل الاسم المطلوب. يجب أن تفشل كل نسخة لسبب يطابق التعديل.
| خط الأساس المحفوظ | التعديل المضبوط | الفحص ذو الصلة | النتيجة الفعلية |
|---|---|---|---|
| بحث ناجح عن الحيوان الأليف الحالي | استبدل بمعرّف عدد صحيح آخر؛ أبقِ الحالة 200 | المعرّف المعاد يساوي المعرّف المتوقع لهذا التشغيل | فشل: المعرّفان المتوقع والفعلي مختلفان |
String name | استبدل name برقم | نوع السلسلة في مخطط Pet | فشل: 42 ليست سلسلة |
name المطلوب موجود | أزل name | قائمة الحقول المطلوبة في مخطط Pet | فشل: name مطلوب |
يكشف مثال المعرّف عن ضعف شائع. يمكن لمدقق المخطط قبول العدد الصحيح الخاطئ لأن الشكل يبقى صالحًا. ويوفر تأكيد العلاقة القيد المفقود. في المثالين الآخرين، يوفر التحقق من المخطط قيودًا لا يستطيع فحص الحالة وحده رؤيتها.
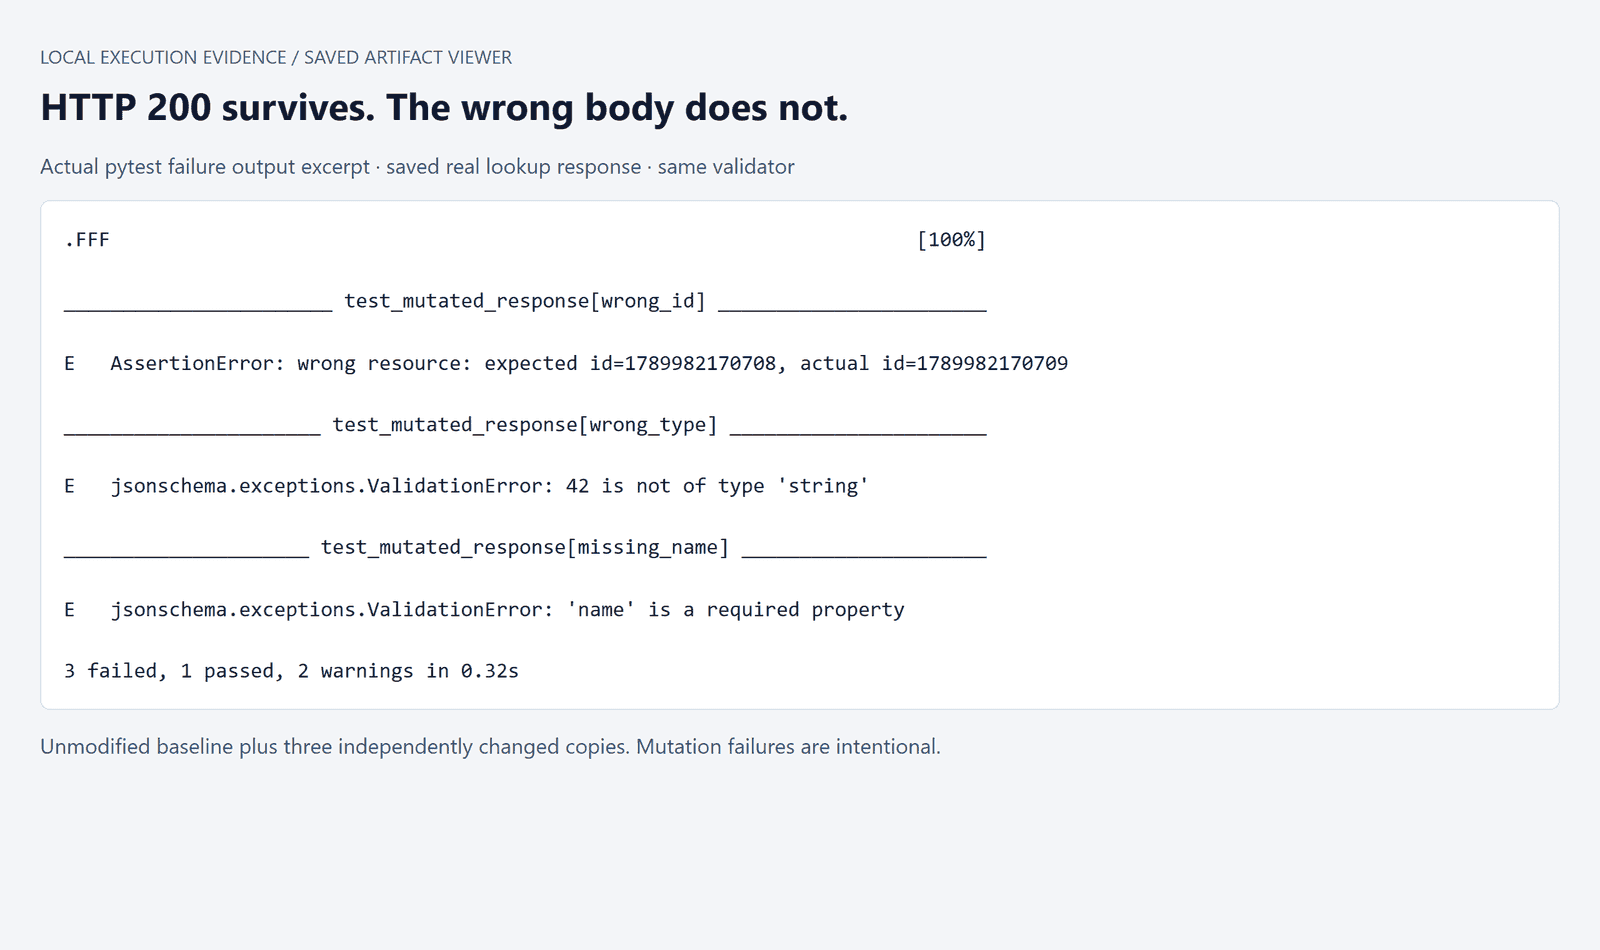 مخرجات إخفاق التأكيد الفعلية لطفرات استجابة Petstore المضبوطة
مقتطفات فشل pytest الفعلية: نجحت الاستجابة الأصلية، وفشلت جميع الطفرات المستقلة الثلاث. وقد أُحدثت هذه الإخفاقات عمدًا في نسخ محفوظة.
في هذا التشغيل، نجح خط الأساس غير المتغير وفشلت 3 من 3 نسخ معدلة. وأعاد تشغيل الطفرات رمز الخروج 1، مع الحفاظ على إشارة الفشل. يطبق المدقق قيود البنية ذات الصلة في مخطط Pet وفحصًا منفصلًا لعلاقة المعرّف؛ وهذا العرض الصغير ليس مدققًا كاملًا لمطابقة OpenAPI.
لتدقيق قابل للتكرار، أرفق ملف الاختبار والمواصفة المثبّتة بـ Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
راجع التغييرات المقترحة "ذاتية الإصلاح" بعناية خاصة. إن استبدال 400 متوقعة بـ 200 قد يخفي انحدارًا. يحتاج تغيير العقد المشروع إلى مرجع متطلبات وتغيير اختبار مراجَع. الاستجابة الملاحَظة دليل للتحقيق، وليست إذنًا تلقائيًا لإعادة تعريف الصواب.
افصل فئات الفشل قبل طلب إصلاح من الذكاء الاصطناعي. قد يشير انتهاء المهلة إلى بيئة غير متاحة. وقد يأتي فشل البحث من fixture معطوب. وينتمي خطأ الاستيراد إلى كود الاختبار. وقد ينتمي عدم التطابق القابل لإعادة الإنتاج مع العقد المتفق عليه إلى المنتج. احتفظ بسياق كافٍ لتمييزها.
أبلغ عن المقام بأمانة. إن كشف ثلاثة تغييرات استجابة مختارة يثبت الحساسية لتلك التغييرات الثلاثة. ولا يثبت تغطية نقاط النهاية، أو تغطية الكود، أو التغطية الأمنية، أو معدل كشف عيوب عام. وبالمثل، لا يقول عدد اختبارات كبير إلا القليل عن السيناريوهات المكررة أو قوة تأكيداتها.
تستحق المصادقة والتصريح اختبارات مستقلة في تطبيق مناسب: بيانات اعتماد مفقودة، وبيانات اعتماد منتهية، والوصول إلى موارد مستخدم آخر. لا يمكن لسلوك العرض في Petstore أن يثبت أن ضوابط الوصول الإنتاجية لديك تعمل.
أدوات الذكاء الاصطناعي لاختبار API في CI/CD
بمجرد أن يقبل المراجع الجناح، ثبّت تلك النسخة بالضبط. يجب أن ينفذ البناء توقعات معروفة مقابل التطبيق المرشح. إن إعادة توليد الاختبارات أثناء كل بناء تُدخل مكوّنًا متغيرًا آخر وتجعل حالات الفشل أصعب في إعادة الإنتاج.
ثبّت المشغّل، والتبعيات، وfixtures، والمواصفة. خزّن قفل تبعيات إلى جانب الاختبارات واحفظ مراجعة التطبيق في التقرير. استخرج الأسرار من بيئة CI، وأبقِها خارج الملفات المولّدة، وتحقق من أن سجلات الفشل لا تكشفها.
مع pytest، يكون شكل الإبلاغ الأساسي بسيطًا:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
وفّر BASE_URL عبر بيئة المهمة. ابدأ الخدمة المحلية في دورة حياة المهمة، وانتظر الجاهزية، ثم شغّل الجناح. اجمع التقرير وسجل الخدمة دائمًا، حتى عند الفشل. أنهِ بإيقاف خدمة المهمة نفسها وتنظيف بياناتها؛ وتجنب أوامر التنظيف على مستوى العملية في الوكلاء المشتركين.
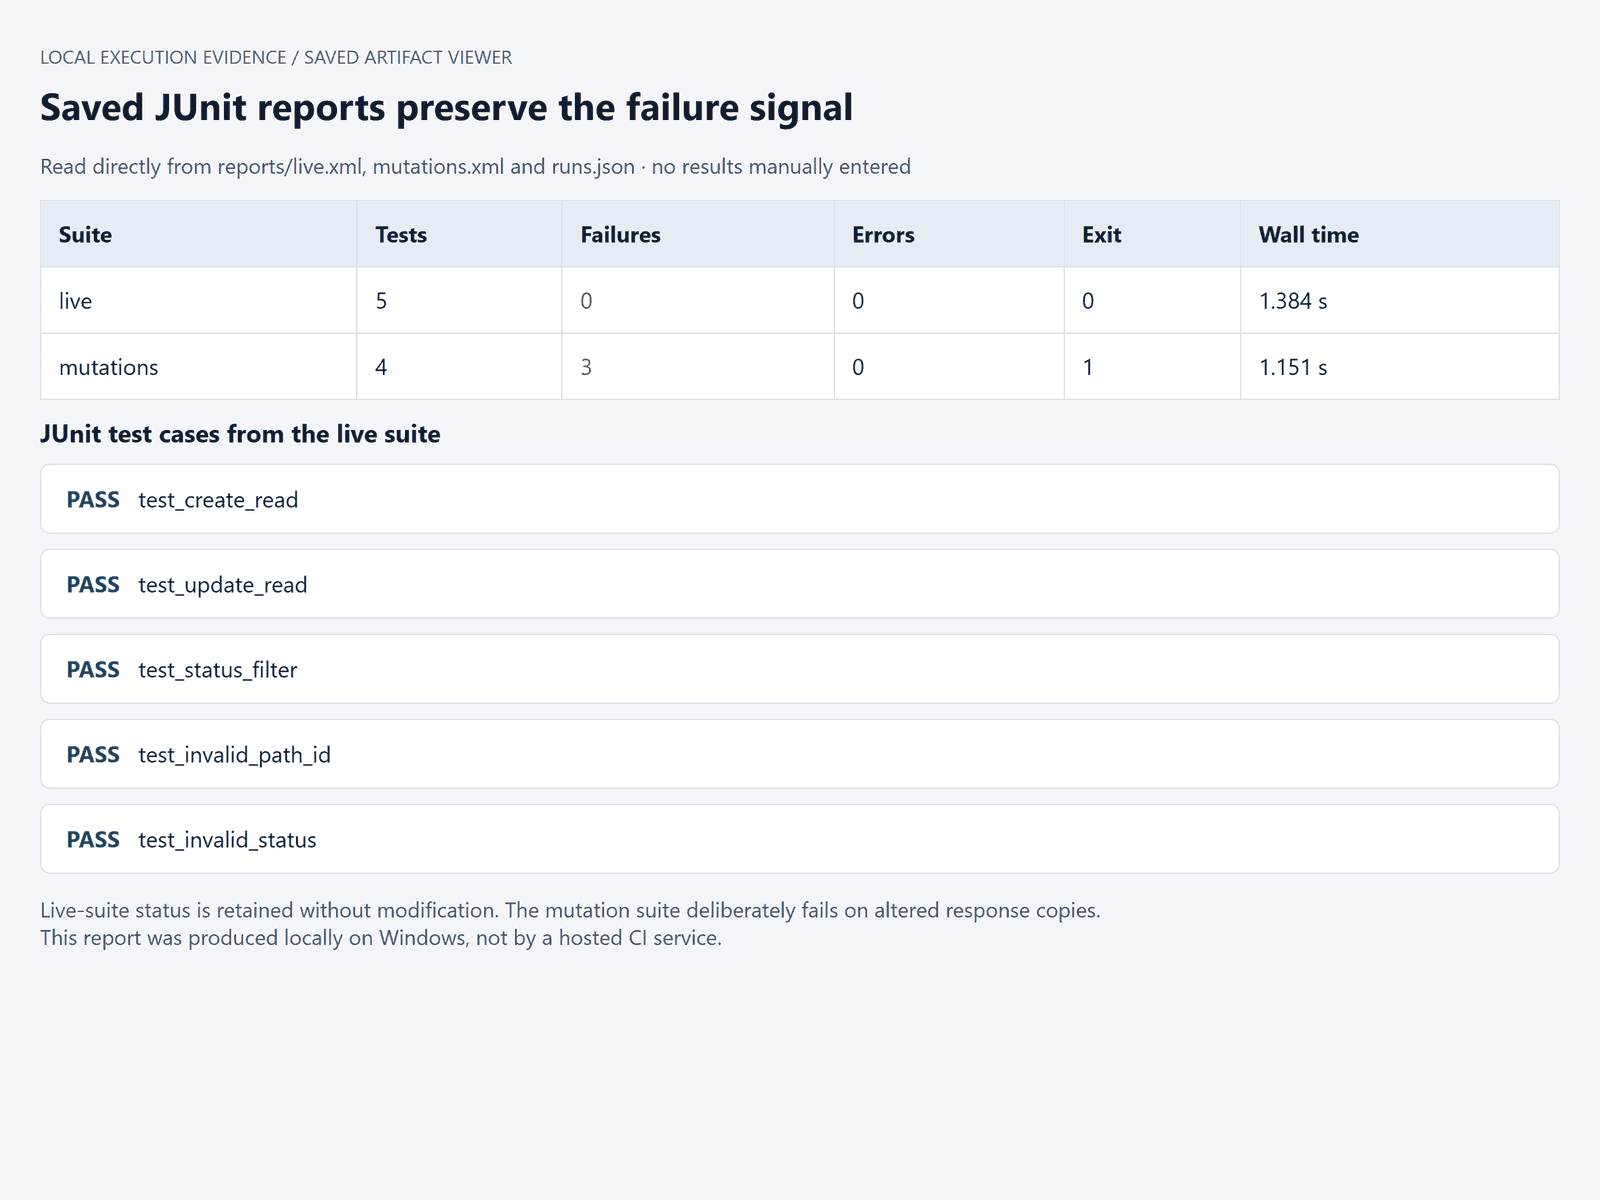 تقرير pytest JUnit محلي مع نتائج منفصلة للعقد الحي وفحص التأكيداتsActual local
نتائج JUnit: نجحت 5 اختبارات حية؛ ويحتوي جناح النسخ المضبوطة على خط أساس ناجح واحد و3 إخفاقات متعمدة. لا يُدّعى أي تشغيل CI مستضاف.
كانت الأزمنة الفعلية المقاسة، بما في ذلك بدء عملية Python، 1.384 ثانية للجناح الحي و1.151 ثانية لجناح النسخ المضبوطة. وهي تستبعد بناء/بدء الخدمة، وتثبيت التبعيات، والصياغة، والمراجعة. حُفظت ملفات JUnit والسجلات غير المختصرة بشكل منفصل.
اختبر مسار الفشل قبل الاعتماد على البوابة. يجب أن ينتج تأكيد فاشل رمز خروج مهمة فاشلًا. يجب أن تكون المحاولات المتكررة محدودة ومبررة للاضطرابات المعروفة في البنية التحتية؛ فالمرات المتكررة التي تخفي في النهاية فشل منتج تجعل البوابة أقل إفادة.
تعامل مع إخفاقات التنظيف صراحةً. أبقِ إخفاق التأكيد الأساسي ظاهرًا، وسجّل المورد الذي بقي، ودع teardown يبلّغ عن مشكلته الخاصة. تحتاج المهام المتوازية إلى معرفات أو مساحات أسماء منفصلة. الاختبار الذي ينجح وحده لكنه يقرأ بيانات مهمة أخرى ليس جاهزًا للاستخدام دون إشراف.
إذا كان لديك pytest بالفعل، يمكنك اختيار نموذج الصياغة بشكل منفصل. يناسب Atlas Cloud هذا الدور الأضيق: طبقة نموذج لسير عمل مخصص يوجد فيه التنفيذ والإبلاغ بالفعل. ولا يُعرض هنا كمنصة كاملة لاختبار API أو كخلفية أصلية للمنتجات الثلاثة أعلاه.
لذلك التقييم، افتح DeepSeek V4.1 Flash، بمعرّف النموذج deepseek-ai/deepseek-v4.1-flash، وقدّم المواصفة العامة نفسها والمصفوفة المراجَعة المستخدمة محليًا. استخدم Prompt B، ثم احفظ المسودة المعادة بشكل منفصل عن الاختبار المراجَع. قارن افتراضاتها بالعقد قبل تنفيذ أي شيء.
إذا أتاحت الواجهة ذلك، فإن درجة حرارة 0.2 هي إعداد بداية للصياغة، وليست ضمانًا للحتمية. تحقق من حد المخرجات المتاح مقابل حجم جناحك. راجع كتالوج النماذج الحالي لأسعار الرموز بدلًا من وضع ميزانية من مقال قديم.
يبقى تقسيم العمل صريحًا: يقترح النموذج كودًا، ويوافق المراجع على التوقعات، وينتج المشغّل النتائج. وقد منعت بوابة الوصول إلى بيئة الاختبار إتمام تشغيل Atlas لهذا المقال، لذا فهذه وصفة تقييم وليست نتيجة نموذج مقاسة. يمكنك تقييم هذا المسار دون ترحيل مشغّل اختبارات عامل أو تسليم مسؤوليات تنفيذه إلى نموذج محادثة.
اختيار أدوات الذكاء الاصطناعي لاختبار API لفريقك
اختر أصغر تقييم يمكنه تغيير قرارك. استخدم سير عمل متصلًا واحدًا، وحالة سلبية موثقة واحدة، وعددًا قليلًا من الاستجابات الخاطئة المضبوطة. أبقِ المدخلات مكافئة بين المرشحين. لا ينبغي لتجربة إعداد أولي مصقولة أن ترجح على اختبار لا يستطيع تحديد المورد الخاطئ.
بالنسبة لسير عمل مجموعة ناضج، ابدأ بتقييم ميزات الذكاء الاصطناعي في مساحة العمل تلك. إن إعداد البيئة الحالي واعتماديات الطلبات سياق قيّم. قِس ما إذا كانت التغييرات المولّدة توفر جهد المراجعة دون إدخال افتراضات هشة.
بالنسبة لفريق لديه مواصفة متينة وتراكم كتابة، قيّم التوليد القائم على المواصفة. انتبه إلى ما يحدث عندما تكون المواصفة غير مكتملة. إن المولّد الذي يحدد التوقعات المفقودة بوضوح أسهل في المراجعة من الذي يختلقها بثقة.
بالنسبة لتطبيق تعتمد إخفاقاته على سلوك upstream، قيّم التسجيل وإعادة التشغيل. افحص خطوط الأساس الملتقطة ودعم التبعيات قبل الاستثمار في تسجيلات كبيرة. قرر أي الحقول الديناميكية قد تتغير وأي العلاقات يجب أن تبقى سليمة.
بالنسبة لفريق لديه مشغّل مستقر، قيّم نموذجًا مستقلًا للصياغة والمراجعة. تحتفظ بصيغة التنفيذ التي تعرفها بالفعل، لكنك تملك أيضًا التكامل، وتصميم fixtures، والصيانة. ضمّن هذه الملكية في حساب التكلفة.
قبل الدفع مقابل أدوات الذكاء الاصطناعي لاختبار API، اطلب خمسة عروض ملموسة:
- أن يعمل الجناح المراجَع مقابل بيئتك المقصودة.
- أن تجعل الأخطاء المضبوطة ذات الصلة التأكيدات المناسبة تفشل.
- أن يمكن الاحتفاظ بالاختبارات والتقارير المفيدة بصيغة مقبولة.
- أن تحافظ التشغيلات المتكررة، بما في ذلك تنفيذ CI، على العزل وإشارات الفشل.
- أن تناسب تكاليف التوليد والتنفيذ والصيانة ميزانية الفريق.
عيّن شخصًا لصيانة الجناح المقبول. يجب أن يُفعّل تغيير المواصفة مراجعة للتأكيدات وfixtures والمستهلكين المتأثرين. واحتفظ بأدلة الفشل القديمة حتى يُفهم التغيير. وهذا يجعل الإصدار التالي أسهل في التقييم ويمنح الفريق سببًا للثوق بتقرير أخضر.
الأسئلة الشائعة
أي أداة ذكاء اصطناعي يجب أن أستخدم لاختبار API؟
ابدأ بمدخلاتك الموجودة. قيّم Postman Agent Mode للمجموعات القائمة، وKushoAI للتوليد القائم على المواصفة، وKeploy لمساريها المتميزين للتوليد والتسجيل. إذا كان فريقك يحتفظ بالفعل بـ pytest أو مشغّل آخر، فقد يناسبك نموذج صياغة منفصل. استخدم سير العمل الصغير نفسه لتقييم تأكيدات كل مرشح وتنفيذه وجهد مراجعته.
هل توجد أدوات ذكاء اصطناعي مجانية لاختبار API؟
توجد عملاء مجانيون، وأدوات اختبار مفتوحة المصدر، وحصص ذكاء اصطناعي محدودة. وهي تغطي احتياجات مختلفة. تسرد خطة Postman المجانية 50 رصيد ذكاء اصطناعي شهريًا اعتبارًا من 21 سبتمبر 2026؛ وهذا ليس عدد اختبارات. تحقق مما إذا كانت ميزات التصدير والأتمتة والإبلاغ والتعاون المطلوبة لديك مضمنة قبل التعامل مع تجربة تفاعلية كحل CI مجاني.
هل يمكن للذكاء الاصطناعي توليد اختبارات API من مواصفة OpenAPI؟
نعم، يمكن للمولّد استخدام العمليات والمخططات والمعاملات وتعريفات الاستجابة لاقتراح اختبارات. وقد تظل المواصفة تحذف قواعد أعمال أو تترك تعيينات الأخطاء غامضة. وفّر توقعات معتمدة وراجع النتيجة. في مثال Petstore المثبّت، يُوثّق الإنشاء الناجح كـ 200، مما يوضح لماذا لا يمكن لاصطلاحات REST المألوفة أن تحل محل العقد الفعلي.
كيف أعرف ما إذا كانت التأكيدات المولّدة بالذكاء الاصطناعي مفيدة؟
تحقق من ثلاثة أمور: قيود المخطط الموثقة، والعلاقات بين الطلبات والاستجابات، والحساسية لبيانات خاطئة عمدًا. احفظ استجابة حقيقية، وعدّل خاصية واحدة ذات صلة، وأعد تشغيل المدقق نفسه. واحتفظ برسالة الفشل. يمنحك هذا دليلًا ضيقًا قابلًا لإعادة الإنتاج حول تلك التأكيدات مع إبقاء أسئلة التغطية الأوسع والأمان مفتوحة لاختبار منفصل.
هل يمكنني تشغيل اختبارات API المولّدة بالذكاء الاصطناعي في CI/CD؟
نعم، عندما تدعم الصيغة المولّدة والمشغّل والبيئة والخطة ذلك المسار. ثبّت الاختبارات المراجَعة، وثبّت التبعيات، واستخدم fixtures معزولة، وصدّر تقريرًا منظمًا مثل JUnit. تحقق من أن الإخفاقات تعيد رمز خروج غير صفري. إن التشغيل المحلي الناجح يجهّز الجناح لـ CI؛ لكنه لا يثبت أن خط أنابيب مستضافًا قد عمل.
هل يمكن للذكاء الاصطناعي استبدال اختبار API اليدوي؟
يمكن للذكاء الاصطناعي تقليل الصياغة المتكررة ومساعدة المراجعين في العثور على تأكيدات ضعيفة. ولا يزال البشر يقررون السلوك المقصود، ويحققون في حالات الفشل الغامضة، ويستكشفون مخاطر خارج الأمثلة المقدمة. استخدم أدوات الذكاء الاصطناعي لاختبار API لإنتاج أصول اختبار قابلة للمراجعة، ثم احكم عليها بأدلة قابلة لإعادة الإنتاج. إن جناحًا أصغر يلتقط أخطاء ذات معنى أسهل في الثوق به من مجموعة غير مفسرة من الفحوص الخضراء.


