يمكن أن يعلن فريقان عن مئات الرموز في الثانية لـ DeepSeek V4.1 Flash ومع ذلك يقيسان أشياء مختلفة. قد يعني أحدهما سرعة فك التشفير لطلب واحد؛ وقد يعني الآخر الإخراج الإجمالي عبر عشرات الطلبات المتزامنة. لتحسين تحسين إنتاجية استدلال DeepSeek V4.1 Flash، اختر أولاً المقياس الذي يحتاجه خدمتك، ثم قِس مزيج طلباتك الخاص، وغيّر متغير خدمة واحدًا في كل مرة، وتحقق من زمن الاستجابة والجودة والتكلفة معًا. تتضمن عائلة النماذج الآن تحديث Flash-1017 بتاريخ 17 أكتوبر، لذا سجّل نقطة التحقق الدقيقة قبل مقارنة النتائج. تُظهر التقارير العامة مسارات تحسين مفيدة، لكن لا شيء منها يغني عن اختبار مطابق على أجهزتك.
النقاط الرئيسية
- يقيس إجمالي tokens/s للإخراج السعة عبر الطلبات؛ بينما تقيس سرعة فك التشفير لكل طلب تجربة المستخدم الفردي.
- أعد إنتاج أطوال المطالبات وحدود الإخراج والتزامن والحالة الساخنة وهدف زمن الاستجابة قبل الضبط.
- تقلل ذاكرة KV المضغوطة وإعادة التشغيل المحدودة في V4.1 Flash ضغط الذاكرة، لكنها لا تضمن تسريعًا ثابتًا من البداية إلى النهاية.
- قارن vLLM و SGLang فقط في ظروف متطابقة من حيث النموذج والعتاد وحمل العمل وقياس.
ماذا تعني الإنتاجية بالنسبة إلى DeepSeek V4.1 Flash؟
الإنتاجية معدل، لكن البسط وحدود الاختبار يهمان. بالنسبة لخدمة استدلال، سجّل خمسة قياسات على الأقل:
| المقياس | ما الذي يخبرك به | الاستخدام النموذجي |
|---|---|---|
| إجمالي tokens/s للإخراج | رموز الإخراج التي تنتجها كل الطلبات النشطة في الثانية | تخطيط السعة وكفاءة الأسطول |
| tokens/s لفك التشفير لكل طلب | سرعة التوليد التي يختبرها طلب فردي | الاستجابة التفاعلية أثناء التوليد |
| prefill tokens/s | رموز الإدخال المعالجة في الثانية | المطالبات الطويلة وأحمال العمل كثيفة الاسترجاع |
| زمن الوصول إلى أول رمز (TTFT) | الوقت من وصول الطلب إلى أول رمز إخراج | تأخر البدء الملموس |
| زمن الاستجابة من البداية إلى النهاية، p50/p95 | المدة الإجمالية للطلب عبر توزيع حركة المرور | أهداف مستوى الخدمة وسلوك الذيل |
يمكن للخادم رفع الإنتاجية الإجمالية عبر تجميع المزيد من التسلسلات مع جعل كل مستخدم ينتظر وقتًا أطول بين الرموز. وبالمقابل، قد يقدم إعداد مضبوط لالتزامن المنخفض استجابات فردية سريعة بينما يترك المسرّعات غير مستغلة بالكامل. لا توجد نتيجة أفضل بشكل مطلق. الهدف الصحيح هو نقطة على منحنى الإنتاجية-زمن الاستجابة تلبي هدف خدمة منتجك.
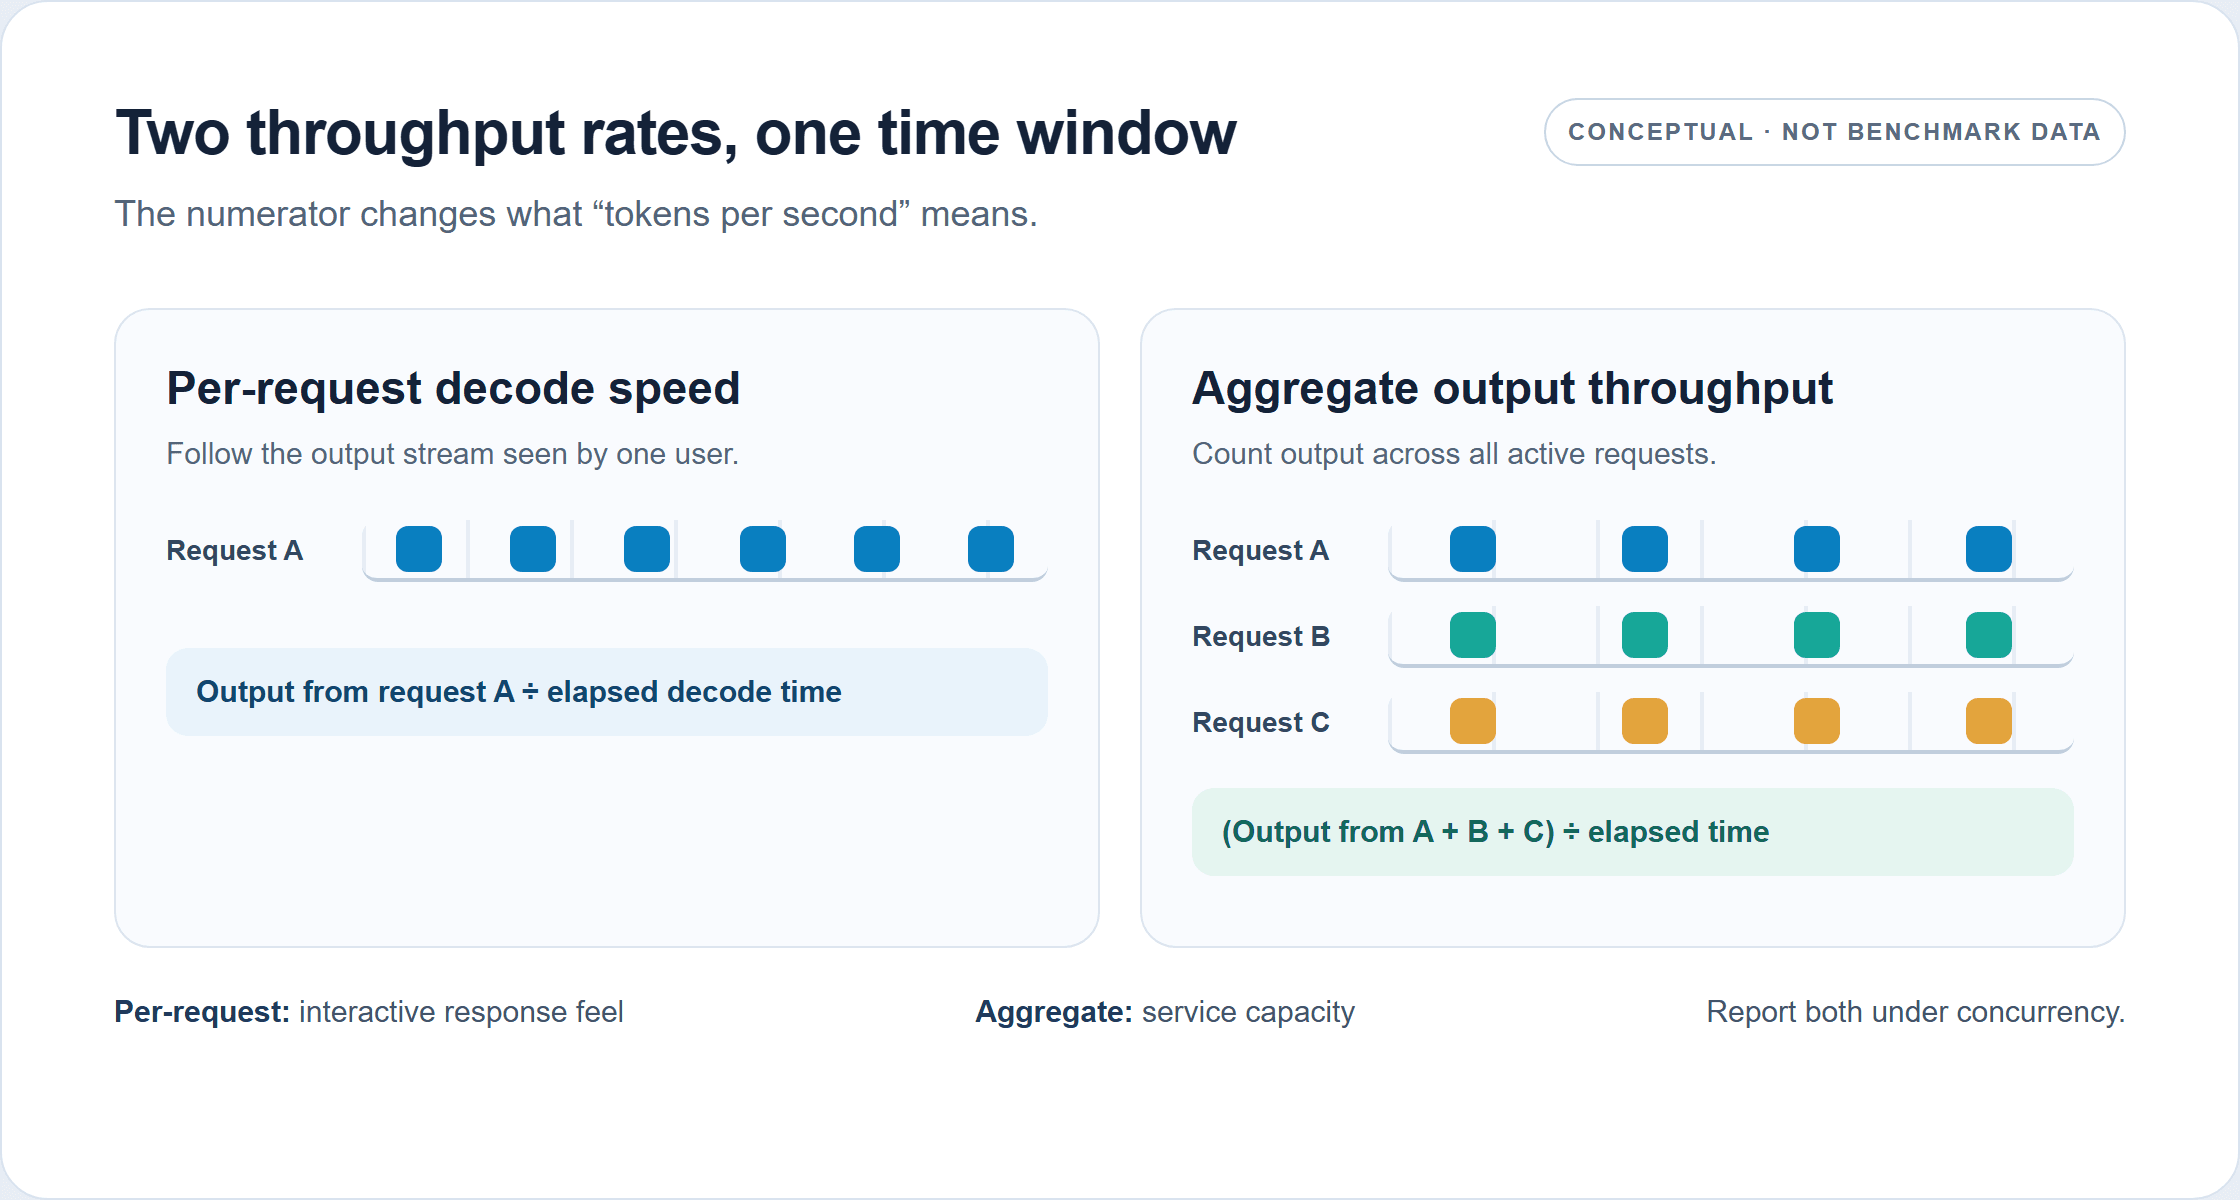
يعد المعدلان تدفقات إخراج مختلفة. هذا مخطط مفاهيمي، وليس أداءً مقيسًا لـ DeepSeek V4.1 Flash.
حدد ما إذا كانت الإنتاجية تشمل prefill أو فك التشفير أو كليهما. اذكر ما إذا كنت تقسم على عدد وحدات GPU. أبلغ عن رموز الإخراج الناجحة بدلاً من الحد الأقصى المطلوب من الرموز، وافصح عن الإلغاءات أو الأخطاء. بدون هذه التفاصيل، لا يمكن لرقم tokens/s أن يخبر المشغّل ما إذا كان يتنبأ بتطبيقه.
ابنِ خط أساس قابلًا لإعادة الإنتاج لـ DeepSeek V4.1 Flash
يشبه خط الأساس المفيد حركة مرور الإنتاج بقدر كافٍ لكشف عنق الزجاجة. المطالبة القصيرة الواحدة بديل ضعيف عن وكيل يرسل بشكل متكرر سجل محادثة كبير، كما أن إخراجًا ثابتًا من 1,024 رمزًا يفوّت أحمال العمل التي تتوقف مبكرًا أو تتباين كثيرًا.
ثبّت حمل العمل ونافذة القياس
أنشئ مجموعات طلبات من حركة المرور الملاحظة. لكل مجموعة، حافظ على الطول التقريبي للإدخال، وطول الإخراج المتوقع، ونمط الوصول، وأي بادئات مشتركة. ضمّن جولات الأدوات أو الاستدلال إذا كانت تشكل جزءًا من مسار الطلب الحقيقي. أبقِ المطالبات وإعدادات أخذ العينات وشروط التوقف وحدود الإخراج ثابتة بين التشغيلات.
شغّل حالة تزامن منخفض وحالة التزامن التي تتوقعها خدمتك عند الذروة. ثم أضف مستويات تزامن وسيطة لكشف النقطة التي تتوقف عندها الإنتاجية عن الارتفاع أو يتجاوز فيها زمن الاستجابة حده. استخدم نافذة قياس مستقرة بعد الإحماء، وكرّر كل نقطة، وأبلغ عن الوسيط مع النطاق. قد تقيس الدفعة القصيرة سلوك بدء التشغيل بدلًا من سعة الخدمة المستقرة.
افصل قياسات البدء البارد عن الخدمة الساخنة. تتضمن التشغيلات الباردة تحميل النموذج، أو التقاط الرسم البياني، أو ملء الذاكرة المؤقتة حسب الحزمة؛ أما التشغيلات الساخنة فتصف نظامًا جاهزًا للخدمة. بالنسبة لحمل عمل التخزين المؤقت للبادئات، قِس حركة إصابة الذاكرة المؤقتة وحركة عدم إصابتها بشكل منفصل. لا تدمجهما في متوسط واحد إلا إذا طابق المزيج الإنتاج.
احتفظ بسجل قياس مرجعي
احفظ صفًا لكل تشغيل يتضمن هذه الحقول: نقطة التحقق أو مراجعة النموذج؛ بيئة التشغيل و commit؛ طراز GPU وعدده؛ الترابط البيني؛ الدقة والتكميم؛ تخطيط التوازي التنسوري، أو الخبير، أو الأنبوبي؛ توزيع رموز الإدخال والإخراج؛ التزامن ونمط وصول الطلبات؛ الحالة الساخنة أو الباردة؛ مدة التشغيل؛ معدل النجاح؛ الإنتاجية الإجمالية؛ سرعة فك التشفير لكل طلب؛ TTFT؛ وزمن الاستجابة من البداية إلى النهاية p50/p95.
هذا السجل أكثر فائدة من رقم لوحة الصدارة لأنه يجعل التجربة التالية قابلة لإعادة الإنتاج. جمّده قبل الضبط. إذا تغيّر حمل العمل أو نقطة التحقق، ابدأ خط أساس جديدًا بدلًا من عزو الفرق إلى إشارة خدمة.
شخّص prefill أو فك التشفير أو ذاكرة KV أو الجدولة
استخدم الأعراض لاختيار القياس التالي، لا للتخمين في إصلاح. ارتفاع TTFT مع سرعة فك تشفير مقبولة يشير إلى معالجة الإدخال أو الاصطفاف أو إخفاقات الذاكرة المؤقتة أو كلفة بدء التشغيل. بطء فك التشفير عند تزامن منخفض يدفع إلى فحص النوى وعرض نطاق الذاكرة والاتصال المتوازي ومسار تنفيذ النموذج. الإنتاجية الإجمالية التي تستوي مع ارتفاع التزامن قد تدل على ضغط الذاكرة أو حدود المجدول أو كلفة الاتصال أو مسار حسابي مشبع. تدهور السياق الطويل يستدعي قياس إقامة الذاكرة المؤقتة وعمل prefill والحركة من المضيف إلى الجهاز.
| الملاحظة | الفحوص الأولى |
|---|---|
| يزداد TTFT مع طول المطالبة | معدل prefill، زمن الانتظار في الطابور، معدل إصابة ذاكرة البادئة المؤقتة، إحماء الرسم البياني أو الترجمة |
| سرعة فك التشفير منخفضة حتى عند التزامن 1 | مسار النموذج في بيئة التشغيل، دعم النوى، الدقة، استخدام GPU، كلفة الاتصال |
| تستوي إجمالي tokens/s مع ارتفاع التزامن | سعة ذاكرة KV، تجميع المجدول، عرض نطاق الذاكرة، الطوبولوجيا المتوازية |
| يرتفع زمن الاستجابة p95 بحدة بينما يتحسن الإخراج الإجمالي | حجم الدفعة، سياسة الاصطفاف، مزيج أطوال الطلبات، هدف الخدمة |
| تطرد المطالبات الطويلة طلبات نشطة مفيدة | إقامة ذاكرة KV، تخصيص الذاكرة المؤقتة، توزيع السياق، حركة ذاكرة المضيف |
يمتلك V4.1 Flash ميزات معمارية تهدف إلى تخفيف بعض هذه الضغوط. يصف تقرير النموذج CSA2 مع إعادة استخدام الذاكرة المؤقتة عبر الطبقات والتخزين المؤقت العالمي KV بدقة FP4، ما يعطي بصمة KV عالمية معلنة تبلغ 890 بايت لكل رمز، أي نحو ربع البصمة المقابلة لـ V4-Flash. تعالج SWA Bounded Replay مقايضة تخزين مختلفة: بدلًا من إبقاء كل حالة انتباه النافذة المنزلقة، يمكن لنشر ما إعادة بناء الحالة المفقودة عبر إعادة تشغيل النافذة الأخيرة. تذكر DeepSeek أن ذاكرة KV الدائمة تقارب ثُمن بصمة V4-Flash لهذا التصميم، مع قدر صغير من إعادة حساب prefill الإضافية. هذه نتائج معمارية ونشر، وليست وعدًا بإنتاجية تبلغ ثمانية أضعاف. (تقرير DeepSeek الفني، سبتمبر 2026)
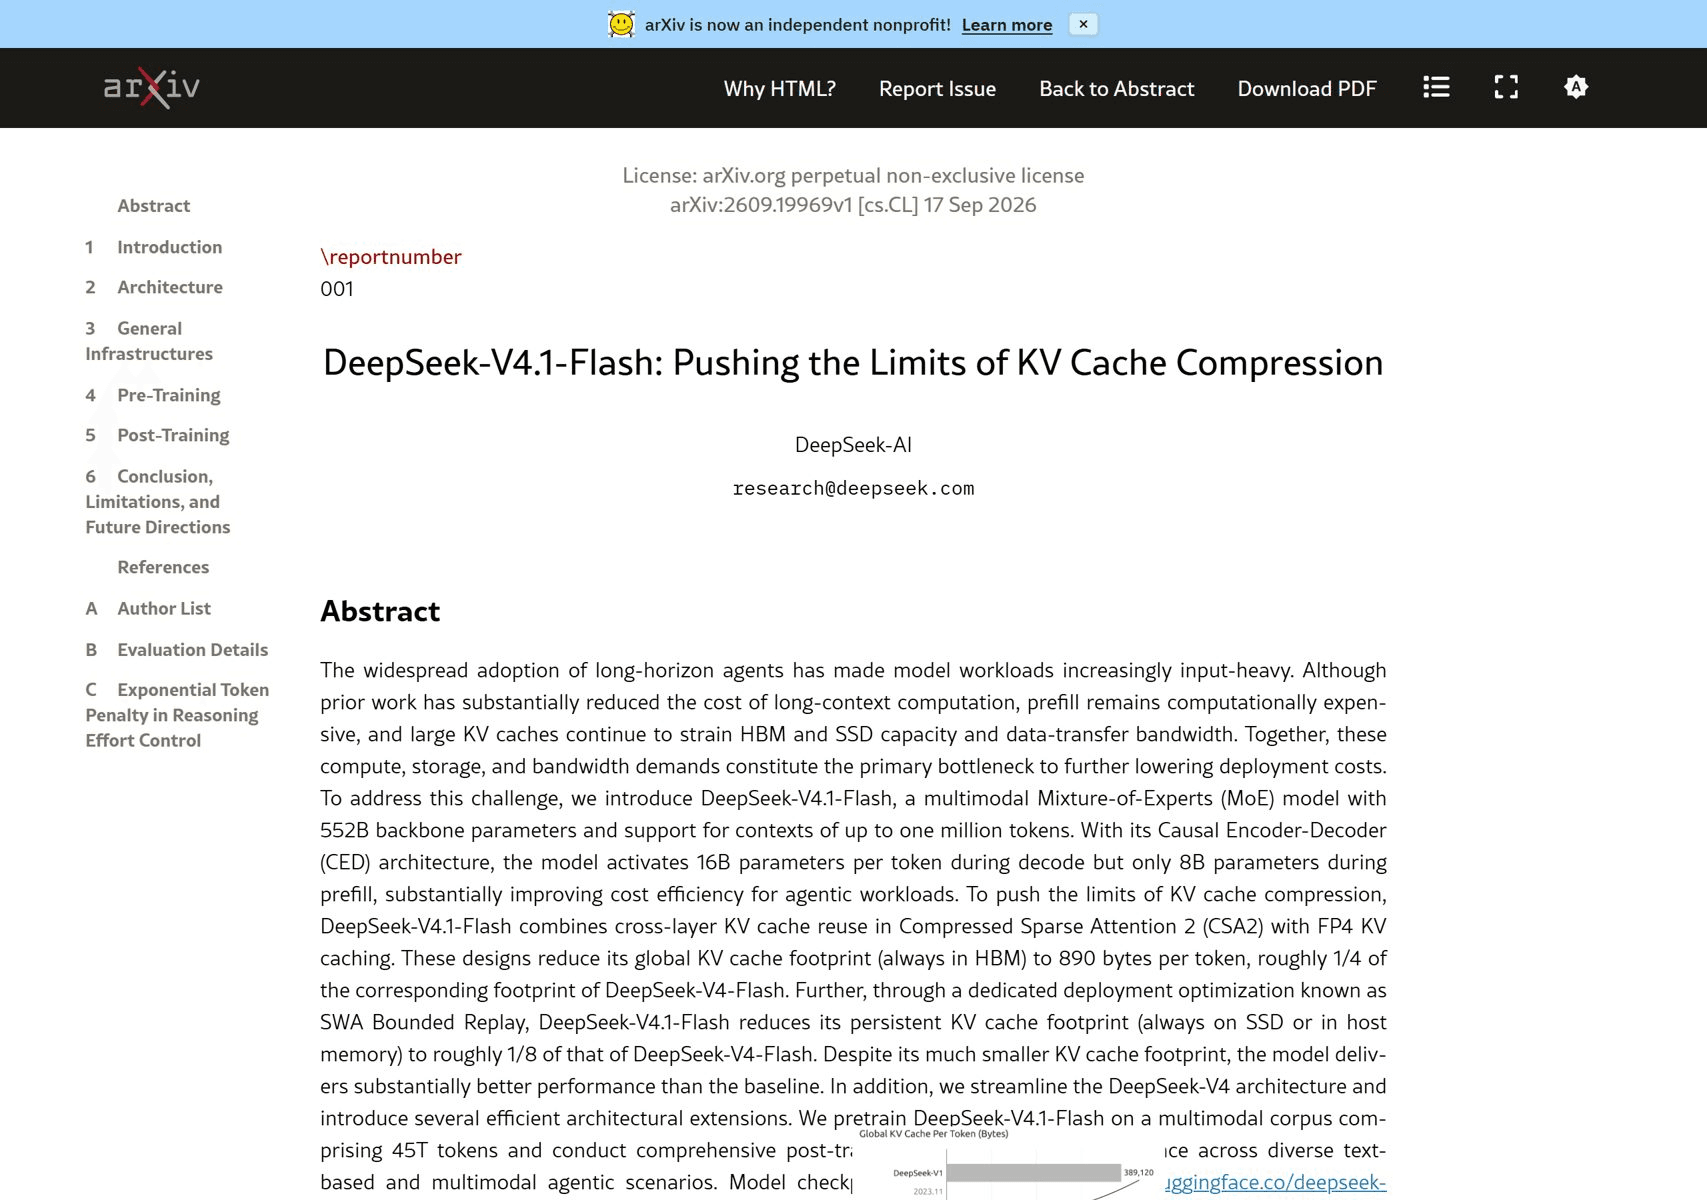
يصف الشكل المصدر سعة الذاكرة المؤقتة، وليس مضاعِف إنتاجية من البداية إلى النهاية لكل نشر.
عندما يكون التشخيص غير واضح، حلّل تشغيلًا تمثيليًا واحدًا وافحص زمن الانتظار في الطابور، واستخدام GPU، واستخدام الذاكرة، وتوقيت كل مرحلة. غيّر متغيرًا واحدًا، وأعد تشغيل حمل العمل نفسه، وتحقق من صحة الإخراج أو جودة المهمة. يمنع ذلك تسريعًا ظاهريًا من إخفاء تراجع في الخدمة أو الإجابات.
اضبط vLLM أو SGLang مقابل الهدف نفسه
اختر بيئة تشغيل يدعم مسار نموذجها الحالي نقطة التحقق والعتاد الذي تنوي نشره. تحقق من الإصدار الدقيق والنوى وسلوك الرسم البياني والتخطيط المتوازي. إدراج نموذج على أنه مدعوم لا يعني أن كل تكميم أو طوبولوجيا محسّن بالقدر نفسه.
vLLM: تحقق من مسار النموذج الخاص بالإصدار
يصف تقرير فريق vLLM الصادر في أكتوبر تطورًا على معيار AgentX الخاص به: تحسن بنحو 1.9× في نتيجة زمن الاستجابة المنخفض، ونحو 5.3× في الإنتاجية ضمن قيد 150 TPS مقارنة بخط أساس اليوم صفر. تضمن العمل إعادة تشغيل SWA محدودة مع رسوم CUDA البيانية وتكامل نوى خاص بالنموذج. تعامل مع هذه القيم كدليل على أن الحزمة تغيرت جوهريًا بمرور الوقت ضمن ذلك المعيار، لا كمضاعِفات تُطبّق على عنقود آخر. ( تقرير vLLM الهندسي، أكتوبر 2026)
بالنسبة لتشغيلك، ثبّت أولًا إصدارًا مدعومًا وتكوينًا معروفًا بأنه جيد. ثم قِس سلوك التقاط الرسم البياني أو إعادة تشغيله، والتجميع، والتوازي كلًا على حدة. حافظ على قيد زمن الاستجابة المستخدم لاختيار نقطة إنتاجية أعلى. إذا غيّر التقاط الرسم البياني احتياجات بدء التشغيل أو الذاكرة، فضمّن هذه الكلف في قرار النشر.
SGLang: طابق ملف التزامن الخاص به
يقدم تقرير فريق SGLang مثالًا واضحًا بشكل غير معتاد على سبب أهمية سياق الاختبار. على 8 وحدات H200 GPU، ارتفع تشغيله المحسّن دون فك تشفير تخميني من نحو 76 إلى 168 tokens/s لكل مستخدم عند التزامن واحد، ومن نحو 96 إلى 221 رمز إخراج/s لكل GPU عند التزامن 64. استخدم مدخلات ثابتة من 8,192 رمزًا ومخرجات من 1,024 رمزًا. استخدمت نتائجه المنفصلة 4×GB300 أطوال مطالبات وإعدادات توازي وفك تشفير تخميني DSpark مختلفة. لذلك يدعم التقرير تقييم تحسينات SGLang على حركة مرورك، لا ترتيبه مباشرة مقابل أرقام vLLM AgentX. ( تقرير تحسين LMSYS/SGLang، سبتمبر 2026)
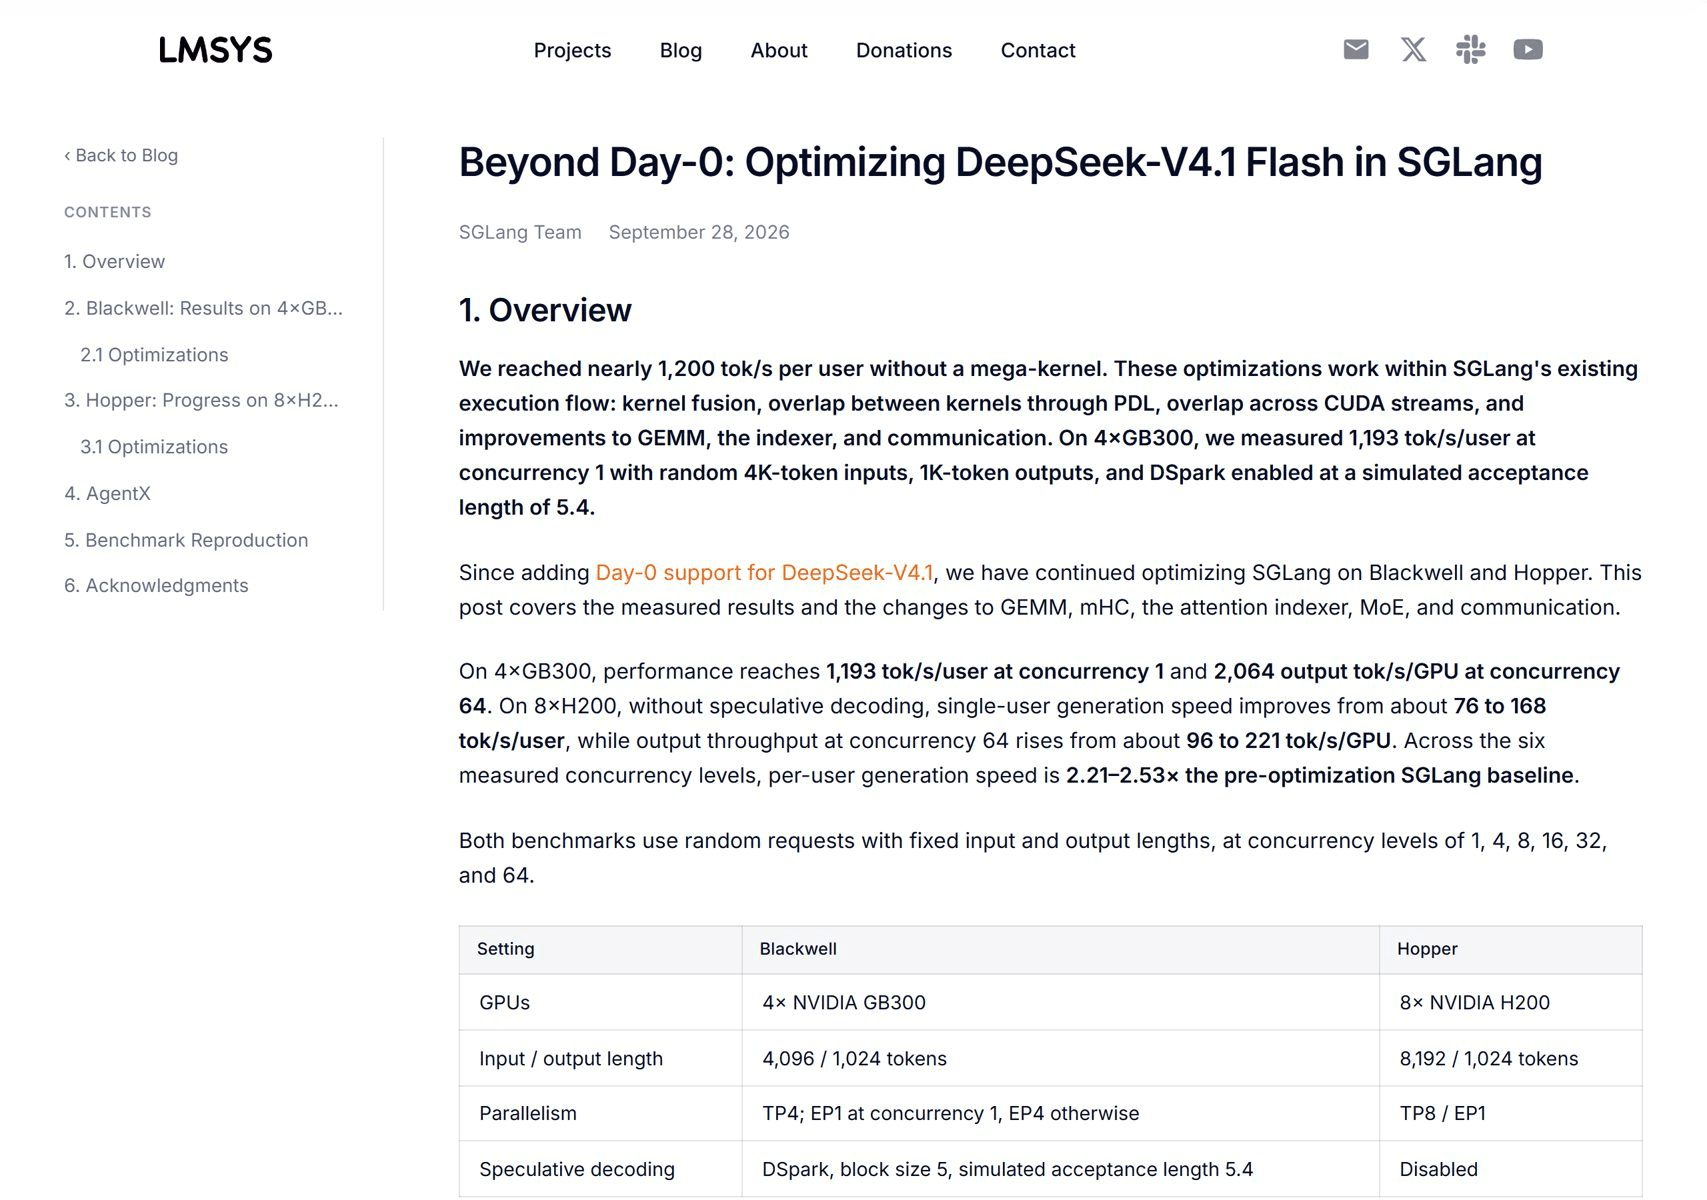
تستخدم التقارير المصدر أحمال عمل وعتادًا مختلفين؛ لا ينبغي قراءة أرقامها كمخطط مواجهة مباشرة.
ابدأ ببيئة تشغيل واحدة وحسّن مسارها المدعوم. لا تبنِ مقارنة ببيئة تشغيل ثانية إلا إذا استطعت إبقاء نقطة التحقق، وتخصيص GPU، وتوزيعات المطالبات والمخرجات، والتزامن، والإحماء، وهدف الخدمة ثابتة. تكلّف هذه المقارنة وقتًا هندسيًا، لذا تأكد أولًا من أن الحزمة الحالية هي بالفعل العامل المحدد.
حسّن التزامن والسياق الطويل دون خرق SLO
ارفع التزامن على خطوات والتقط الإخراج الإجمالي، وسرعة فك التشفير لكل طلب، وTTFT، وزمن استجابة p95، واستخدام الذاكرة، والإخفاقات عند كل خطوة. أبقِ نقطة الإنتاجية الأعلى فقط إذا ظل زمن استجابتها ومعدلات أخطائها يلبّيان هدف خدمتك. إذا اصطفت الطلبات قبل التوليد، فقد تحسّن دفعة أكبر استخدام الجهاز بينما تجعل المنتج يبدو أبطأ.
بالنسبة لحركة السياق الطويل، قِس توزيع السياق النشط ومعدل إصابة الذاكرة المؤقتة. لا يعني حد السياق الأقصى المعلن أن كل طلب يمكن خدمته بالتزامن عند هذا الطول. تنافس ذاكرة KV على الذاكرة مع الأوزان والتفعيلات ومجمعات الرسوم البيانية ومخازن بيئة التشغيل المؤقتة. اترك هامشًا لأطوال الطلبات المتغيرة وقِس الإخلاء أو الاستباق تحت حركة مرور واقعية.
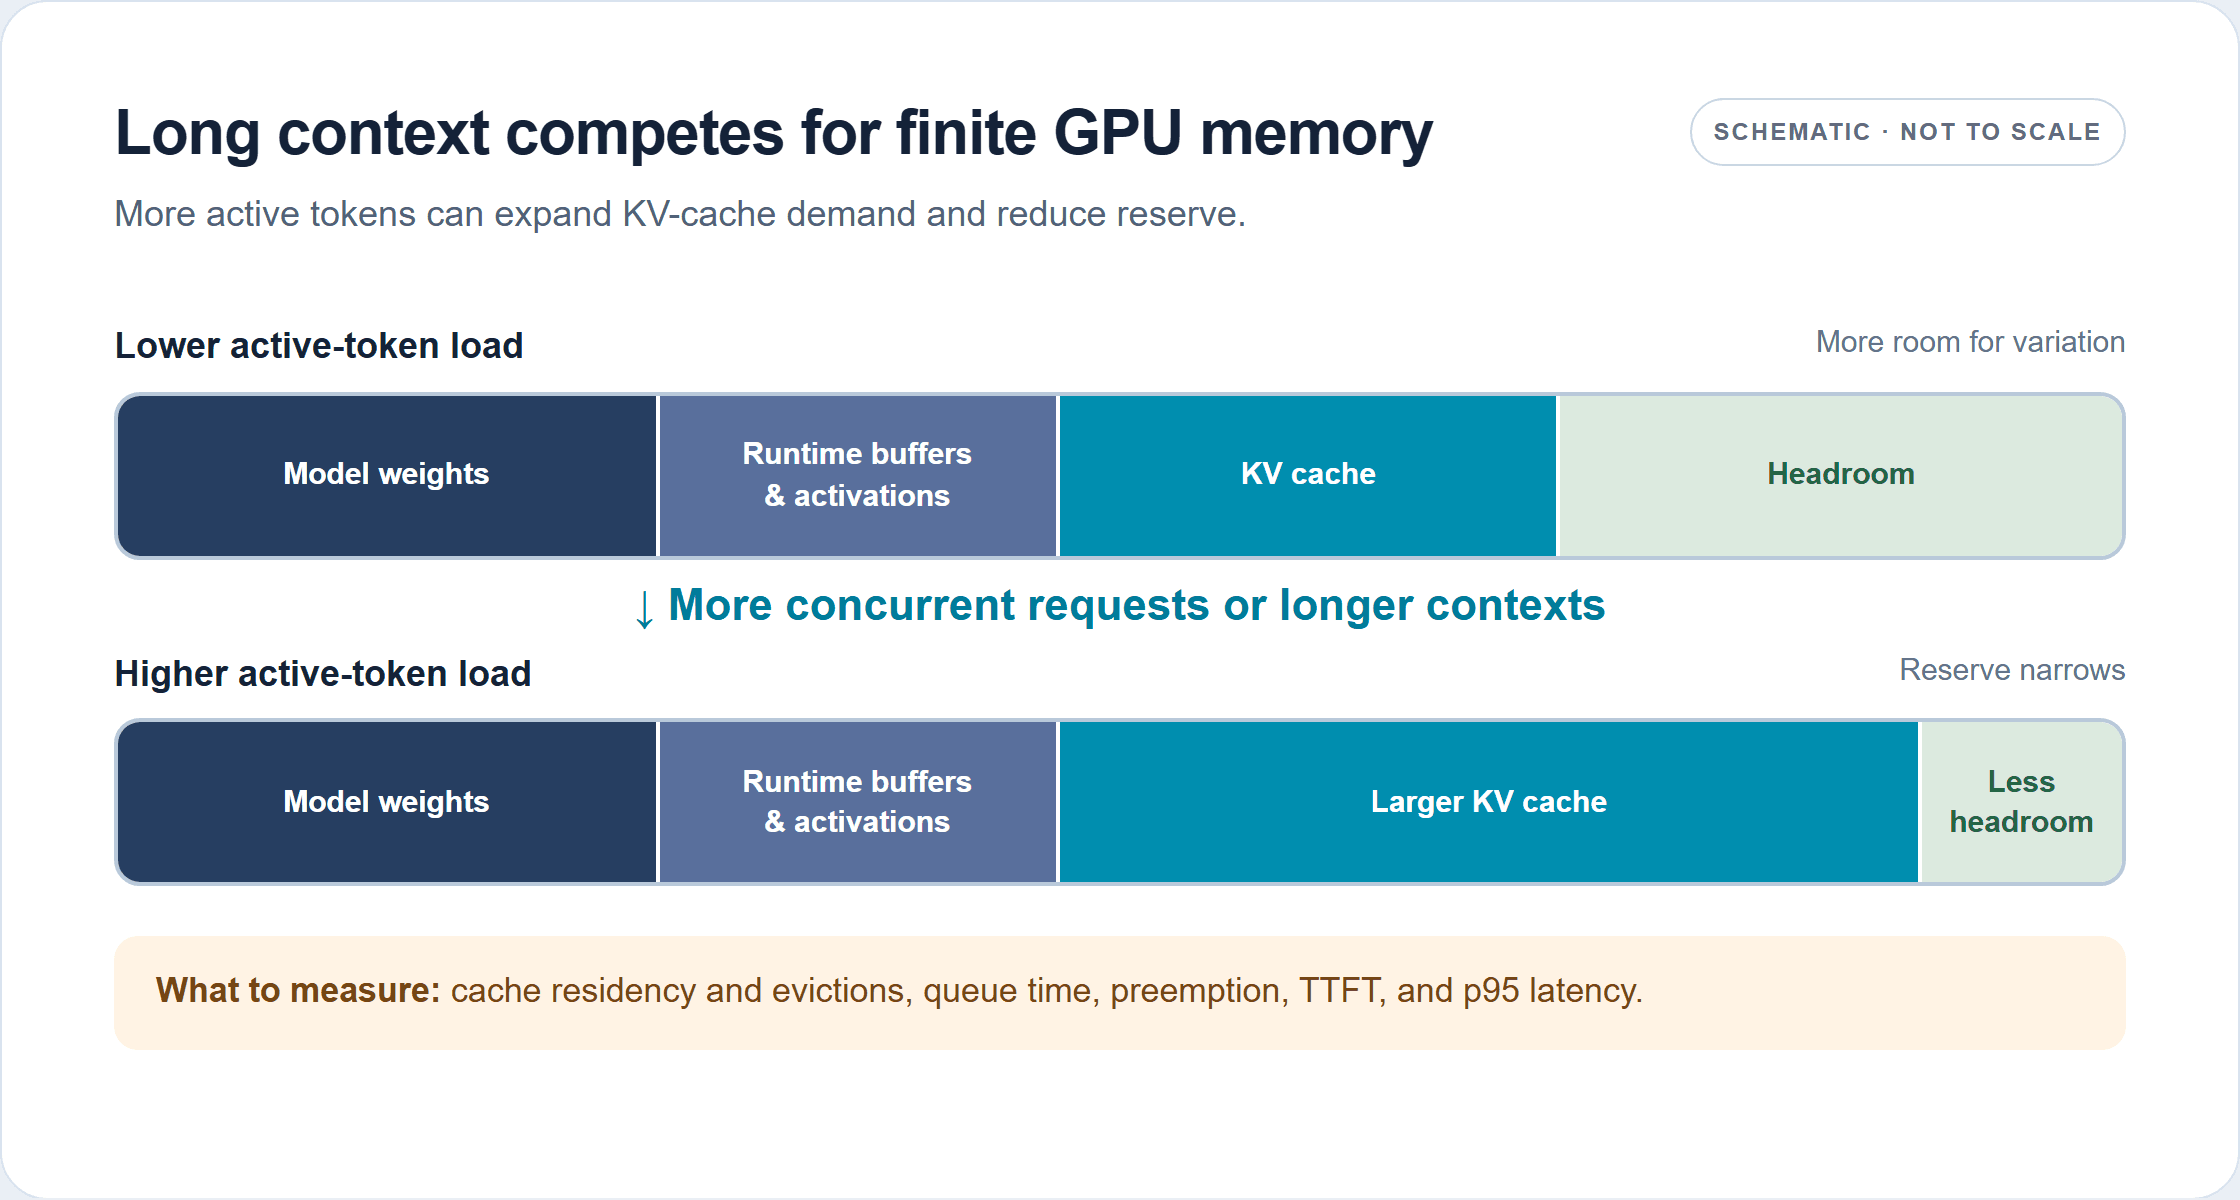
قد تزيد السياقات الأطول أو الطلبات المتزامنة الأكثر الطلب على ذاكرة KV. كتل الذاكرة تخطيطية وليست بمقياس دقيق.
تعامل مع التكميم، ودقة ذاكرة KV، والتوازي التنسوري، والتوازي الخبير، وفصل prefill/فك التشفير كتجارب منفصلة. يمكنها تغيير استخدام الذاكرة، والاتصال، واختيار النوى، وجودة الإخراج، وزمن الاستجابة. يعتمد أفضل تخطيط على نوع GPU والترابط البيني؛ وقد تؤدي إضافة مزيد من وحدات GPU إلى رفع كلف الاتصال أو إبقاء بعض الموارد خاملة. تحقق من جودة الإخراج الدقيقة وأوضاع الفشل بعد تغيير الدقة أو تنفيذ النموذج.
التسلسل العملي بسيط: أعد إنتاج خط الأساس، وحدد المقياس الذي يخفق في بلوغ هدفه، وصِغ فرضية واحدة لعنق الزجاجة، وغيّر إعدادًا واحدًا، وكرّر. إذا حسّن الإعداد مقياسًا وأضر بآخر، فقرر صراحةً ما إذا كانت هذه المقايضة تناسب المنتج. يجعل هذا التحسين قرارًا مضبوطًا بدلًا من كومة من الأعلام.
تحقق من فك التشفير التخميني وكل تسريع مُدّعى
يمكن لفك التشفير التخميني أن يقلل العمل التسلسلي للنموذج الهدف عندما تُقبل رموز المسودة بكفاءة وتنفذ بيئة التشغيل التحقق جيدًا. تعتمد فائدته على مسار المسودة، وسلوك القبول، وشكل الدفعة، والعتاد، ومزيج المطالبات/المخرجات. قد يساعد حركة المرور المرتبطة بفك التشفير وله قيمة ضئيلة عندما يهيمن prefill أو الاصطفاف أو الاتصال.
شغّل اختبار A/B مع تمكين التخمين وتعطيله. أبقِ نقطة تحقق النموذج، ومجموعة المطالبات، وحد الرموز، ونمط الوصول، والتزامن، والإحماء، ونافذة القياس ثابتة. سجّل الرموز المقبولة لكل خطوة تحقق إن توفرت، إلى جانب الإنتاجية الإجمالية، والسرعة لكل طلب، وTTFT، وزمن استجابة p95، واستخدام GPU، والإخفاقات، وجودة المهمة. طول القبول المحاكى في معيار منشور هو شرط اختبار، وليس قيمة يُفترض تطبيقها على مطالباتك.
لا يكون التسريع المُدّعى مفيدًا إلا إذا اجتاز ثلاثة اختبارات: هدف الخدمة نفسه، وجودة إجابة مقبولة، ومقارنة كلفة عادلة. أبلغ عن السياق الكامل مع أي رقم تنشره. تجنب مقارنة أعداد GPU مختلفة، أو أطوال مطالبات، أو أطوال مخرجات، أو أنماط دقة، أو مراجعات نموذج، أو مقاييس كما لو كانت تجربة مضبوطة.
هل تستضيفه ذاتيًا أم تستخدم DeepSeek V4.1 Flash API مُدارة؟
تكون الاستضافة الذاتية منطقية عندما تكون حركة المرور مستقرة بما يكفي لإبقاء وحدات GPU مفيدة، ويستطيع الفريق تشغيل بنية الاستدلال التحتية، ويبرر التحكم في العتاد أو التنفيذ العمل التشغيلي. ضمّن التكلفة الكاملة للمسرّعات، وهامش السعة، والطاقة، والشبكات، والتخزين، والصيانة، ووقت الهندسة. لا تثبت نتيجة ذروة tokens/s عالية وحدها تكلفة أقل لكل مهمة ناجحة.
تكون API المُدارة مفيدة عندما يحتاج فريق إلى التحقق من طلب المنتج بسرعة، أو تجنب تشغيل أسطول خدمة، أو مقارنة خط أساس API بنشره الخاص. يُدرج Atlas Cloud DeepSeek V4.1 Flash تحت معرّف النموذج deepseek-ai/deepseek-v4.1-flash مع API متوافق مع OpenAI. تعرض صفحة نموذج DeepSeek V4.1 Flash حاليًا $0.30 لكل مليون رمز إدخال، و$1.20 لكل مليون رمز إخراج، و$0.03 لكل مليون رمز قراءة من الذاكرة المؤقتة، مع عدم عرض أي خصم حتى أكتوبر 2026. تحقق من قائمة الأسعار الحالية قبل تقدير الإنفاق. لا تلغي نقطة النهاية المُدارة الحاجة إلى قياس زمن استجابة طلباتك أو اقتصاديات حركة المرور.
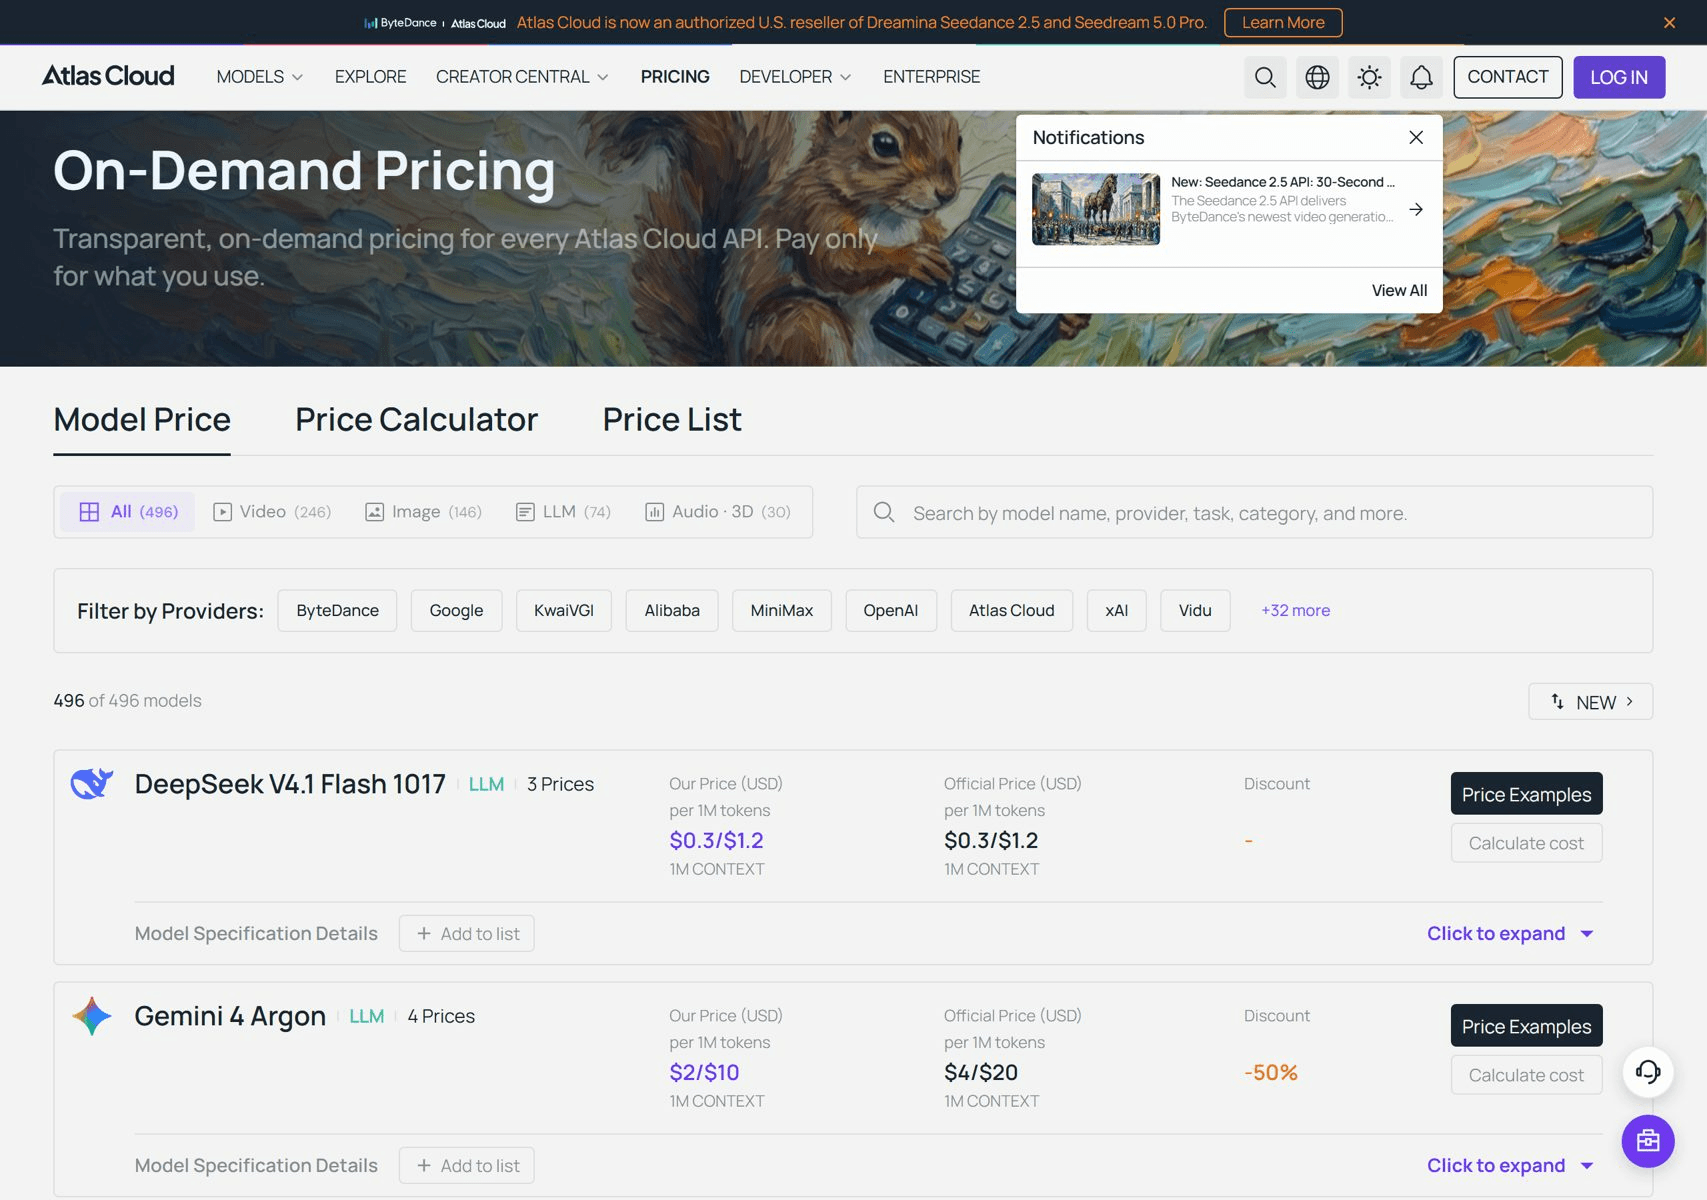
تحدد القائمة خيار API مُدارة؛ وليس معيار خدمة.
لاتخاذ قرار نشر عادل، أعد تشغيل طلبات الأعمال نفسها مقابل الخدمة المستضافة ذاتيًا ونقطة النهاية المُدارة. قارن التكلفة لكل مهمة مكتملة، وتوزيع زمن الاستجابة، والموثوقية، ووقت الموظفين اللازم لصيانة كل خيار. إذا كان هدفك الأساسي هو تحسين إنتاجية استدلال DeepSeek V4.1 Flash، فأبقِ حمل العمل نفسه ومعايير النجاح نفسها للمسارين.
الأسئلة الشائعة
ما الفرق بين الإنتاجية والرموز في الثانية لكل مستخدم؟
تحسب الإنتاجية الإجمالية الإخراج عبر الطلبات النشطة. يقيس tokens/s لكل مستخدم معدل فك التشفير لطلب واحد. يمكن أن يزيد التجميع الأول بينما يقلل الثاني، لذا أبلغ عن كليهما للخدمات التفاعلية.
هل يؤدي زيادة التزامن دائمًا إلى تحسين الإنتاجية؟
لا. قد يرتفع الإخراج الإجمالي حتى تشبع الحوسبة أو الذاكرة، ثم يستوي. يمكن أن يستمر الاصطفاف وزمن استجابة الذيل في التدهور بعد تلك النقطة. توقف عن زيادة التزامن عندما يفشل هدف الخدمة.
هل يمكن مقارنة أرقام معياري vLLM و SGLang مباشرة؟
فقط إذا تطابقت مراجعة النموذج، والعتاد، وأطوال المطالبات والمخرجات، والتزامن، والحالة الساخنة، وحدود القياس، وقيد زمن الاستجابة. تستخدم التقارير المنشورة إعدادات مختلفة، لذا فهي توضح مسارات تحسين لا فائزًا مباشرًا بين بيئتي التشغيل.
متى ينبغي استخدام API مُدارة بدلًا من الاستضافة الذاتية؟
استخدم API مُدارة عندما تكون سرعة التكامل وتقليل عمل البنية التحتية أهم من امتلاك حزمة الخدمة. استضف ذاتيًا عندما يبرر الاستخدام، والخبرة التشغيلية، والتحكم، وحالة تكلفة إجمالية مقيسة تشغيل وحدات GPU.





