يصبح مشهد شخصين مقنعًا عندما ترى وتسمع من يملك كل جملة. لجعل حوار Gemini Omni 1.2 Flash متعدد المتحدثين سهل المتابعة، امنح كل شخصية هوية بصرية وصوتية ثابتة، واكتب جملًا قصيرة بترتيب الكلام، وراجع الفيديو النهائي بعينيك وأذنيك. يدعم تحديث Google لنوفمبر 2026 كلامًا متعدد المتحدثين أكثر طبيعية ومقاطع تصل إلى 15 ثانية، لكن لا يمكن للطلب أن يضمن إسنادًا نظيفًا للمتحدثين في العرض الأول. ابدأ بتبادل بسيط بين شخصين، ثم أضف دورًا ثالثًا أو أجواء شارع فقط بعد أن تستطيع الحكم على التسليم الأساسي.
النقاط الرئيسية
- يُنشئ Gemini Omni 1.2 Flash فيديو بصوت أصلي، بما في ذلك الحوار؛ وهو مختلف عن نماذج Gemini للنص إلى كلام الصوتية فقط.
- استخدم متحدثين مسمّين، وجملًا مقتبسة بدقة، ومواضع واضحة، ومستمعًا صامتًا في كل دور.
- اترك مجالًا للوقفات ضمن الحد الأقصى البالغ 15 ثانية، ثم تحقق من كل جملة مقابل المقطع.
- سعّر عملية التوليد بناءً على المدة والدقة المحددتين، لا على أقل سعر معلن من المنصة.
ماذا يعني الحوار متعدد المتحدثين في Gemini Omni 1.2 Flash؟
ينشئ النموذج مشهدًا قصيرًا يمكن للناس فيه أن يتكلموا كجزء من الصوت والفيديو المولّدين. الاختبار العملي هو ما إذا كان المشاهد يستطيع معرفة من يقول كل جملة دون قراءة نص مكتوب. يجب أن تتوافق الكلمات والصوت والشخص الظاهر وحركة الفم في الوقت نفسه. قد يبدو المقطع مقنعًا وصوته مكتوم ومع ذلك يفشل في هذا الاختبار.
أعلنت Google عن Gemini Omni 1.2 Flash في 5 نوفمبر 2026، مع ما يصل إلى 15 ثانية من الفيديو المولّد أو المحرّر. وتصف حوارًا أكثر سلاسة، ومزامنة شفاه أوضح، وتكييفًا مميزًا لعدة متحدثين. هذه ادعاءات قدرات، وليست وعدًا بأن كل نص سيُنفّذ تمامًا كما كُتب (إعلان Google لنوفمبر 2026).
يُظهر العرض المنشور من Google القدرة التي أعلنت عنها. وهو منفصل عن حالات الفيديو الثلاث المرفقة أدناه.
ما الذي تغير عن Gemini Omni 1.1 Flash؟
يمنح المقارنة الرسمية الإصدار 1.2 سقفًا أطول: 15 ثانية بدلًا من 10. كما يذكر تحسينات في الكلام، ومزامنة الشفاه، واتباع المراجع، والتحرير الحواري. الثواني الخمس الإضافية تجعل تبادلًا من 3 أدوار أكثر منطقية لكتابة النص، لكن المدة الأطول لا تخلق وقتًا أكبر للكلام إذا طلب المخرج أيضًا وقفات وردود فعل جسدية وتغييرات مشهد.
التفسير الأكثر أمانًا هو أنه اتجاهي. قد يجعل التكييف الأفضل الحوار أسهل في الإخراج، بينما يظل كل مقطع مُسلّم بحاجة إلى فحص. يمكن لمنشئ المحتوى استخدام حد الـ15 ثانية لتحديد هدف النص. وينبغي للمنتج الذي يعد بنص قانوني مطابق أو مطابقة صوتية دقيقة أن يتعامل مع المخرجات المولّدة كمسودة حتى تجتاز المراجعة.
حوار الفيديو مقابل النص إلى كلام متعدد المتحدثين
تقبل نماذج Gemini للنص إلى كلام النص وتعيد صوتًا. تنتمي إعدادات المتحدثين وخيارات الأصوات إلى سير عمل الصوت هذا، الذي توثقه Google بشكل منفصل (توثيق Google للنص إلى كلام في Gemini، تم الوصول إليه في نوفمبر 2026). يقبل مسار النص إلى فيديو في Gemini Omni 1.2 Flash طلب مشهد وينتج فيديو بصوت أصلي. مثال speech_config للنص إلى كلام ليس عنصر تحكم في فيديو Gemini Omni 1.2 Flash. تصف هذه الأمثلة شخصية صوتية في النص؛ وهي لا تدّعي رفع صوت مسجل أو استنساخه أو اختياره. إذا كان الموجز يتطلب صوت ممثل معين، فتحقق من ذلك الوصول والموافقة بشكل منفصل قبل التخطيط للقطة.
إذا كان ما ستسلّمه محادثة بودكاست أو تعليقًا صوتيًا نهائيًا، فاستخدم النص إلى كلام وحرّر الصورة حول ذلك الصوت. وإذا كان شخصين يتحدثان بشكل مرئي في مشهد مولّد، فاستخدم فيديو Gemini Omni 1.2 Flash واختبر المواءمة في المخرجات الفعلية.
أين يمكنك تشغيله، وكم سيكلف المقطع؟
اختر مسار النص إلى فيديو
تُدرج Google Gemini Omni 1.2 Flash ضمن منتجاتها الإبداعية ومنتجات المطورين. لاختبار قابل للتكرار، استخدم مسارًا واحدًا: Atlas Cloud يوفّر النموذج، وملعب Gemini Omni 1.2 Flash للنص إلى فيديو هو المكان الذي تلصق فيه الطلبات أدناه. معرّف المسار هو google/gemini-omni-1.2-flash/text-to-video. تستخدم الطلبات أدناه النص فقط، دون مراجع صور أو حركة أو صوت.
تطلب الطلبات 12 ثانية بنسبة 16:9 للمكتب، و15 ثانية بنسبة 16:9 للمقهى، و12 ثانية بنسبة 16:9 لمقابلة الشارع. الملفات الثلاثة المرفقة بدقة 720p. أكّد عناصر التحكم المباشرة والقيم المحددة قبل الضغط على Run. الإعداد المُعلن في صفحة منتج ليس دليلًا على أن تشغيل اختبار معين قد قبله. احفظ القيم المحددة وعرض السعر مع كل مخرجات. هذا يجعل كل عملية توليد دليلًا مفيدًا: يمكنك مقارنة الطلب بالدقة والمسار المحددين عند مراجعة مخرجاته. يحدد هذا الدليل مسار النص إلى فيديو، لذا يجب تحديد نتيجة من مسار صورة إلى فيديو أو مرجع إلى فيديو بشكل منفصل.
لا تتضمن ملفات الفيديو المرفقة لقطة مكتملة من الملعب، أو إعدادات محددة، أو عرض سعر قبل الإرسال. لذلك يظل مسارها وتكوينها غير موثّقين.
| المسار | المدخل لهذا الدليل | الأنسب لـ | أين تتحقق من التكلفة |
|---|---|---|---|
| منتجات Google الإبداعية | طلب مشهد؛ تختلف عناصر التحكم حسب المنتج | الإنشاء اليدوي في محرر Google | الخطة الحالية أو شاشة الرصيد |
| Google API | طلب فيديو للمطور | تكامل التطبيقات | سعر Google للدقة المحددة |
| Atlas Cloud نص إلى فيديو | طلب، مدة، نسبة عرض، دقة | تكرار هذه الاختبارات النصية فقط في ملعب واحد | عرض السعر قبل الإرسال للتكوين المحدد |
تحقق من السعر قبل التوليد
تسعّر Google $0.07 لكل ثانية مولّدة بدقة 720p عبر API الخاص بها، أي أقل بنسبة 30% من Gemini Omni 1.1 Flash. وبهذا السعر المعلن، تكون 12 ثانية بدقة 720p بسعر $0.84 قبل أي عمل آخر قابل للفوترة. هذا الحساب ليس عرض سعر من Atlas Cloud للملفات المرفقة؛ فمسارها وفوترتها غير موثّقين. تخضع الأرصدة في Flow أو أي محرر آخر لقواعد ذلك المنتج نفسه.
تدرج Atlas Cloud سعرًا ابتدائيًا أقل لكل ثانية على كتالوج النماذج، لكن الحد الأدنى قد يقابل دقة أو تكوينًا آخر. اقرأ عرض السعر المباشر بعد اختيار المدة والدقة. يمكن أن تساعد مسودة بدقة 360p في استكشاف طلب؛ فهي عملية توليد منفصلة وليست معاينة إطارًا بإطار لعرض لاحق بدقة 1080p.
لائم صوتين في مشهد مدته 15 ثانية
امنح كل متحدث هوية بصرية وصوتية
اكتب أوصافًا يستطيع المراجع التحقق منها. "المتحدث A على اليسار بقميص كحلي" أوضح من "الزميل الأول". أضف تمييزًا مسموعًا، مثل نبرة متوسطة مقابل أعمق. حافظ على اتساق الأسماء والملابس والموضع والأصوات عبر الطلب. تجعل هذه المراسي اكتشاف الجملة المتبادلة أسهل.
الهوية البصرية مهمة لأن الصوت وحده قد يخدع المراجع. إذا اختلفت الأصوات لكن تحرك الفم الخاطئ، فالمقطع يعاني مشكلة في مزامنة الشفاه. وإذا تحرك الفم الصحيح لكن تغير صوت A في الدور الثاني لـA، فهناك انزياح صوتي. يعيد مثال المقهى A بعد B كي يتحقق المراجع مما إذا ظل صوت A متسقًا.
خصص وقتًا للكلام ورد الفعل
اقرأ النص بصوت عالٍ بالوتيرة المقصودة. ضمّن وقفة طبيعية عند كل تسليم، ثم اترك مساحة ليتفاعل المستمع ولتؤسس اللقطة الافتتاحية كلا الوجهين. يحتوي نص المكتب المنقّح على 5 أدوار في 12 ثانية. ويحتوي المقهى على 8 أدوار قصيرة في 15 ثانية، مما يجعله اختبار التوقيت الأكثر تحديًا هنا. هذه نصوص أمثلة، وليست حدًا عالميًا للكلمات في الثانية أو وعدًا بشأن المخرجات.
| ميزانية المشهد | التسلسل المنطوق | الوقت اللازم بعد الكلمات |
|---|---|---|
| مكتب 12 ثانية | A-B-A-B-A | تأسيس الشخصين واستيعاب 4 عمليات تسليم |
| مقهى 15 ثانية | ثمانية أدوار متناوبة | سبع عمليات تسليم مع وقت فائض قليل |
| شارع 12 ثانية | A-B-A-B-A | أربع عمليات تسليم فوق أجواء الشارع |
الجملة الطويلة تدعو إلى التسرع أو الحذف قرب النهاية. إذا استغرقت المسودة قراءةً كل 15 ثانية تقريبًا، فاختصرها قبل التوليد. وإذا كان السيناريو يحتاج حوارًا أكثر، فخطط للقطات منفصلة وتحقق من الاستمرارية كمهمة إنتاج أخرى. أبقِ الوجهين ظاهرين أثناء الجمل المنطوقة في المحاولة الأولى. القطع السريع والأفواه المحجوبة يجعلان الحكم على إسناد المتحدثين أصعب. أجرِ قراءة طاولة موقوتة مع شخصين إذا كان ترتيب الجمل مهمًا. اجعل شخصًا يقول A والآخر B بينما يدوّن شخص ثالث أين تنتهي كل جملة. إذا وقعت الكلمة الأخيرة عند حد المقطع، فاحذف عبارة أو لحظة رد فعل قبل التوليد. النص الأقصر أسهل في التدقيق لأن المراجع يمكنه إعادة تشغيل التبادل كاملًا دون تخمين ما إذا كانت جملة مقصودًا أن تستمر خارج الشاشة.
كيفية كتابة طلب لـ Gemini Omni 1.2 Flash لمتحدثين اثنين
يُقرأ الطلب المفيد كموجز تصوير مختصر: المكان والكاميرا، والهويات، والحوار الدقيق، ثم الصوت وقواعد الاستبعاد. يمنح هذا الترتيب المراجع أيضًا قائمة تحقق. إنه أسلوب لكتابة الطلبات، وليس ضمانًا موثّقًا للتحكم. أبقِ تسميات الشخصيات متطابقة من فقرة الهوية حتى كتلة الحوار. تجنّب الإشارة إلى الشخص نفسه بوصفه A و"العميل" في تعليمات دور لاحق ما لم يكن الربط واضحًا بالفعل. ينبغي أن يستطيع القارئ رسم عمودين، واحد لكل شخص، ووضع كل إجراء مطلوب وكل جملة منطوقة في عمود واحد فقط.
استخدم تسميات متحدثين صريحة وجملًا مقتبسة
استخدم سطرًا واحدًا لكل دور مع Speaker A: أو Speaker B: وكلمات مقتبسة. حدد من يبقى صامتًا. طلب "نقاش حول جاهزية الإطلاق" يسمح بالارتجال. أما النص الدقيق فيتيح لك وسم كلمة مفقودة أو معاد كتابتها فورًا.
إليك أول طلب لنسخه. يُبقي كلا البالغين في لقطة مستمرة واحدة كي يتمكن المشاهد من فحص كل فم.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
عرض المكتب المرفق مدته 12 ثانية بدقة 720p. يبقى الشخصان ظاهرين؛ ولا تزال الجمل المنطوقة الخمس ومزامنة الشفاه بحاجة إلى مراجعة سمعية.
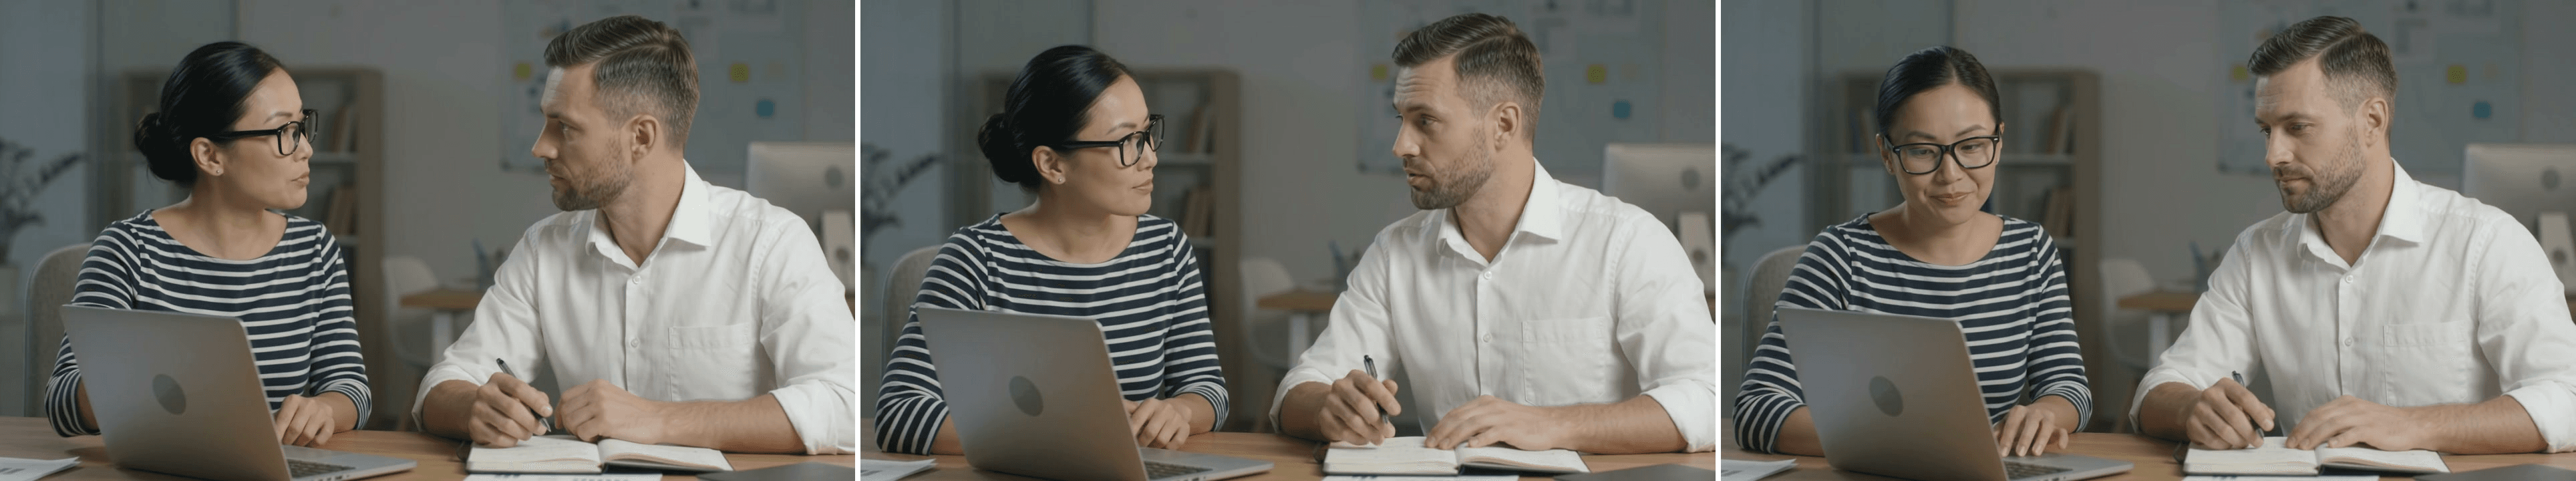 إطارات الحالة A، من اليسار إلى اليمين (حوالي 0:02، 0:05، 0:10): المرأة تواجه زميلها؛ يبدو أنه يرد بينما يبقى كلاهما في الإطار؛ ويعيدان انتباههما إلى الحاسوب المحمول والدفتر.
تحكم في الكاميرا دون فقدان المتحدث
اللقطة المتوسطة المستمرة لشخصين خيار تشخيصي. يبقى الوجهان في المشهد، لذا لا يمكن لعملية تسليم فائتة أن تختبئ خلف المونتاج. قد يغيّر النموذج التأطير مع ذلك، ولهذا يحتاج الملف النهائي إلى فحص.
بمجرد أن يعمل التسليم لغرضك، جرّب حركة متواضعة تحافظ على الوجهين. يطلب طلب الشارع حركة في إطار 16:9 يُبقي كلا الوجهين ظاهرين، مما يسهّل الحكم على حركات الفم. وهذا سبب لتأسيس خط الأساس في المكتب أولًا.
أبقِ صوت الخلفية أدنى من الحوار
سمِّ الأجواء وأولويتها. نبرة الغرفة الهادئة تمنح مقطع المكتب القليل مما ينافس الكلام. صوت المقهى الخفيف يضيف سياقًا مع إبقاء الجمل قابلة للاختبار. يطلب طلب الشارع خطوات وأصواتًا بعيدة أدنى من كلا الصوتين، دون كلام المارة.
قد تقلل التعليمات السلبية الصوت غير المرغوب، لكنها تبقى طلبات. استمع لصوت ثالث أو تعليق صوتي أو موسيقى أو صوت علامة تجارية. وتحقق من الصورة بحثًا عن تسميات توضيحية وشعارات أيضًا.
3 مشاهد حوار تُظهر من يتحدث ومتى
تُظهر ملفات الفيديو الثلاثة المرفقة مشاهد المكتب والمقهى والشارع المقصودة. يمكن فحص محتواها البصري هنا، لكن الملفات لا تثبت أي مسار أو إعدادات أنتجتها. الطلبات أدناه طلبات قابلة للتكرار، وليست ادعاءً بأن المخرجات نطقت كل كلمة بشكل صحيح. يختبر المكتب 5 أدوار، ويختبر المقهى 8 أدوار سريعة، ويضيف الشارع صوت البيئة.
| الحالة | طلب البرومبت | الملف المرفق | الفحص الرئيسي |
|---|---|---|---|
| A: تسليم المكتب | 12 ثانية، 16:9، 5 أدوار | 12 ثانية، 16:9، 720p | خمس جمل، أفواه صحيحة |
| B: تبادل المقهى | 15 ثانية، 16:9، 8 أدوار | 15 ثانية، 16:9، 720p | ثماني جمل، أصوات مستقرة |
| C: مقابلة الشارع | 12 ثانية، 16:9، 5 أدوار | 12 ثانية، 16:9، 720p | سماعية الشارع وأدوار المتحدثين |
تسليم مكتبي من خمسة أدوار
استخدم الطلب والفيديو الكاملين أعلاه. يبقى الزميلان في اللقطة نفسها، لذا لكل دور من الأدوار الخمسة المطلوبة شخص ظاهر لفحصه. سجّل كل جملة مسموعة مقابل النص وافحص الفم النشط. يثبت الملف المرفق المشهد والمدة، لكن كلماته ومزامنة شفاه لم يتم التحقق منهما بشكل مستقل.
التسليم الواضح في مقطع واحد يدعم استنتاجًا حول ذلك المقطع وحده، لا معدل نجاح على مستوى النموذج. احتفظ بالنتيجة الأولى كي يمكن مقارنة أي مراجعة بالأصل.
تبادل في المقهى من ثمانية أدوار
اطلب 15 ثانية بنسبة 16:9. تضع ثمانية أدوار قصيرة ملكية الصوت المتكررة والتوقيت تحت الضغط. قارن أول جملة وآخر جملة لكل شخص، ثم تحقق مما إذا كانت أي جملة تتداخل أو تختفي. الملف المرفق بدقة 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
أسئلة وأجوبة في الهواء الطلق
اطلب 12 ثانية بنسبة 16:9. يضيف هذا حركة كاميرا خفيفة وصوت بيئة. الملف المرفق بنسبة 16:9 وبدقة 720p ويمكن مراجعته من حيث أدوار المتحدثين الخمسة وسماعية الشارع.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
تشغيل مدمج: 0:00–0:15 هي الحالة B، تبادل المقهى؛ 0:15–0:27 هي الحالة C، مقابلة الشارع. يتضمن كلا المقطعين المصدرين كاملين.
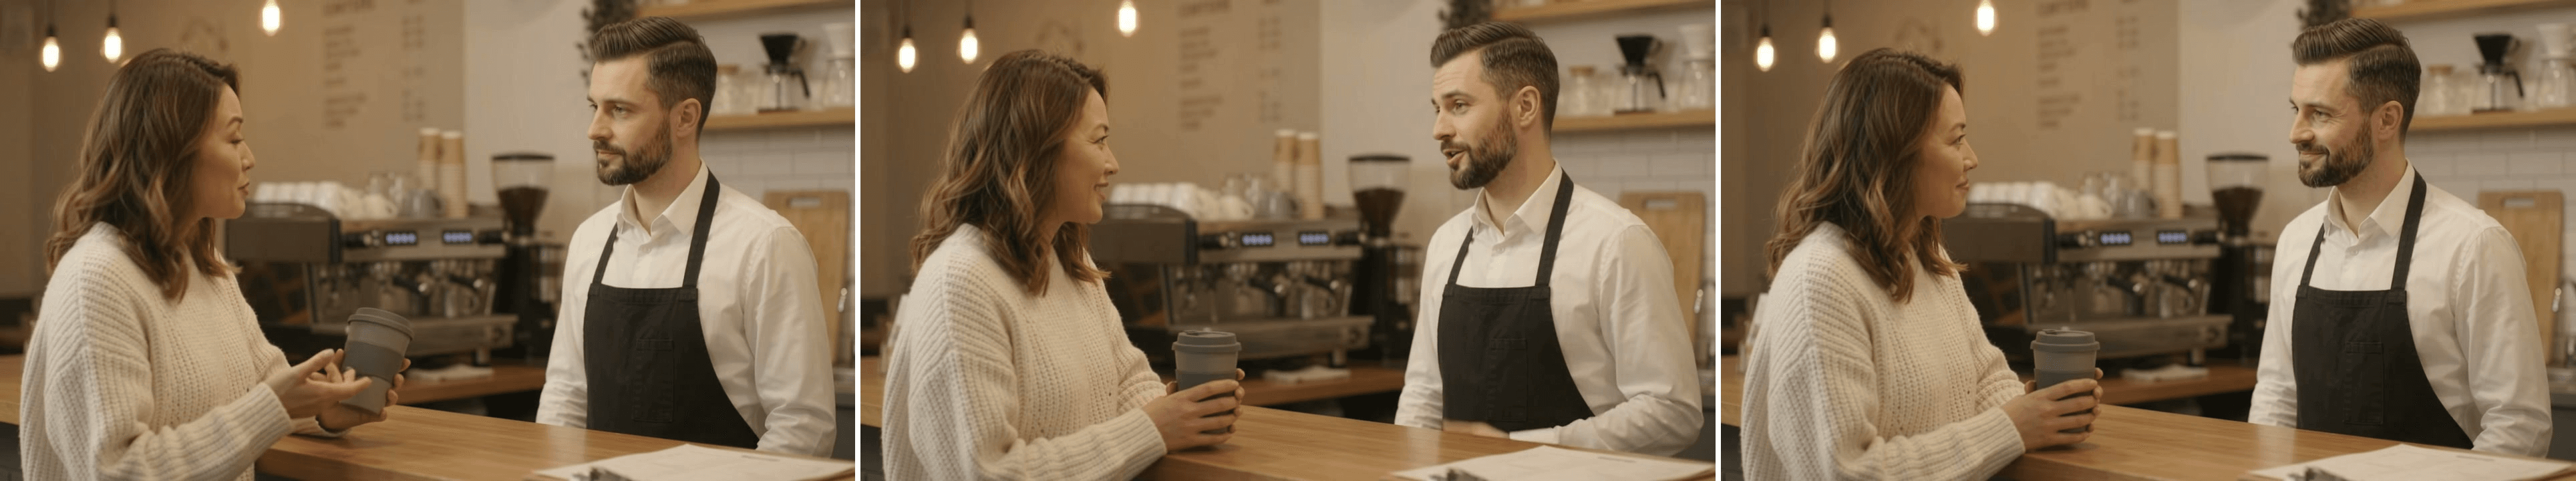 إطارات الحالة B، من اليسار إلى اليمين (حوالي 0:02، 0:08، 0:13 من الفيديو المدمج): العميلة تعرض كوبها؛ يبدو أن عاملة المقهى ترد؛ ويتواجهان في الختام.
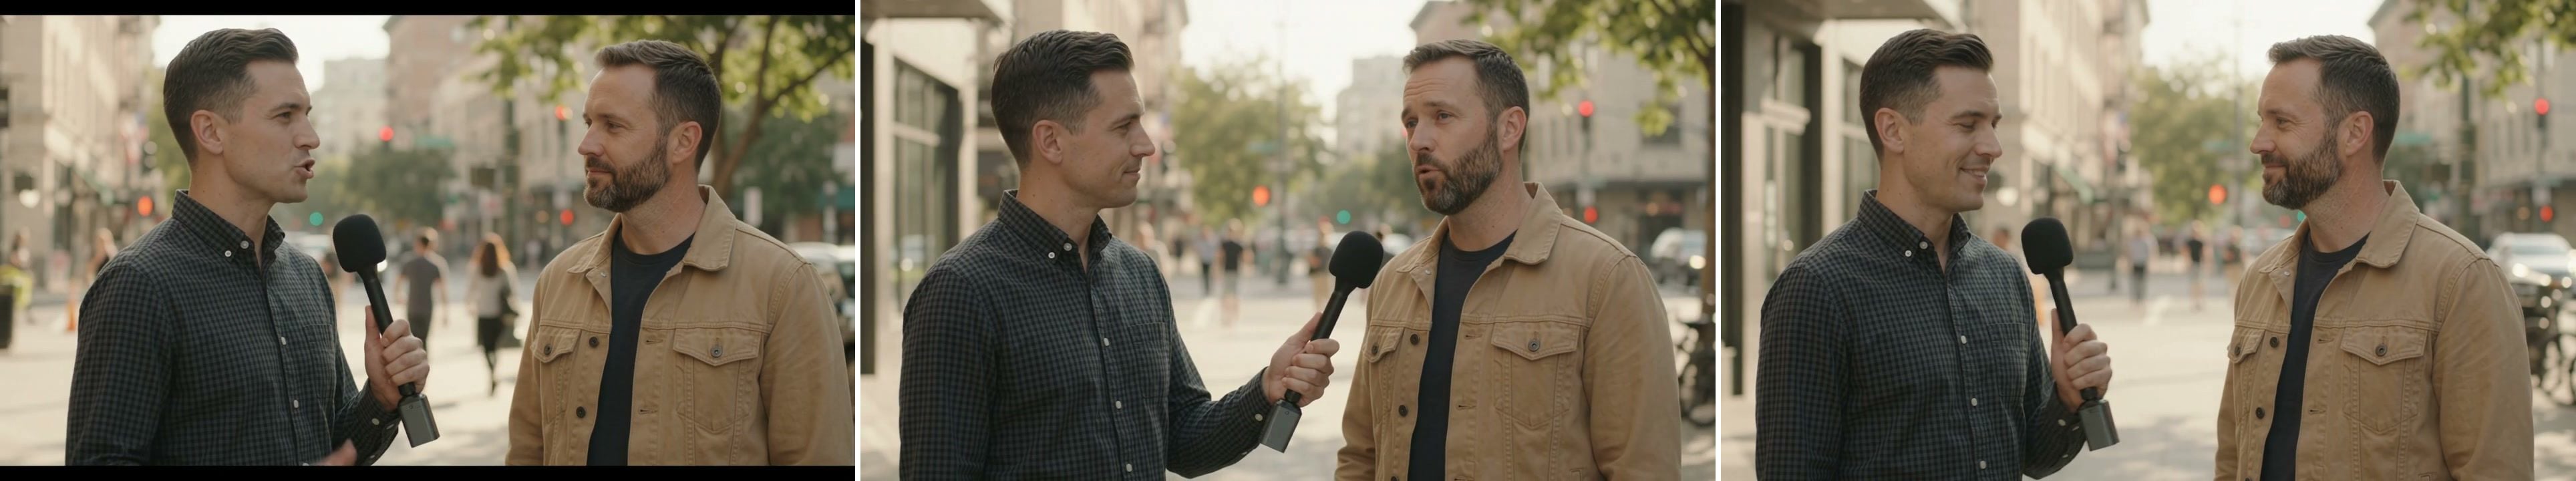
إطارات الحالة C، من اليسار إلى اليمين (حوالي 0:16، 0:19، 0:26 من الفيديو المدمج): المحاور يحمل الميكروفون؛ يوجهه نحو المُقابَل؛ ويتواجهان في النهاية.
تحقق من ترتيب المتحدثين ومزامنة الشفاه وانزياح الصوت قبل النشر
راجع المقطع سطرًا بسطر
نزّل الفيديو. شغّله مرة دون قراءة النص لاكتشاف أي ارتباك واضح، ثم أعد تشغيله والطلب بجانبه. توقف عند كل دور واكتب ما تسمعه. افحص كلا الفمين، ولاحظ أي كلام خارج الأدوار المكتوبة. لمراجعة قابلة للتكرار، سجّل وقت بداية ونهاية كل جملة مسموعة، والمتحدث المتوقع، والصوت الذي سمعته، والفم الظاهر الذي تحرك. اكتب "غير واضح" إذا كان وجه مخفيًا أو كان الصوت يحجب كلمة. لا تحوّل خانة غير واضحة إلى نجاح لأن بقية المشهد تبدو مقنعة. يمكن لمستمع ثانٍ لم يرَ الطلب أن يحدد من يعتقد أنه يتحدث؛ قارن هذا الحكم بالنص قبل أن تقرر ما إذا كان مشاهد عام سيفهم المشهد.
تحقق من 4 أشياء لكل جملة:
- الكلمات: هل نُطقت الكلمات المقتبسة بالترتيب، دون حذف نهاية أو إضافة جملة؟
- صاحب الصوت: هل بدا الشخص المسمّى هو المتحدث، خصوصًا عندما عاد A؟
- التوقيت المرئي: هل تحرك فم ذلك الشخص بينما بقي المستمع صامتًا؟
- محتوى آخر: هل أضاف المقطع تعليقًا صوتيًا أو مارًا أو تسميات توضيحية أو شعارًا أو موسيقى؟
يبقى الجدول الزمني لضمان الجودة الموقّت معلّقًا حتى تتم مراجعة الصوت وحركات الفم سطرًا بسطر.
راجع قيدًا واحدًا في كل مرة
إذا اختفت الجملة الأخيرة، فاختصر النص أو امنحه مدة أطول ضمن سقف الـ15 ثانية. وإذا تحدث الشخصية الخطأ، فأعد ذكر الموضع البصري وحدد أن المستمع يبقى صامتًا. وإذا غطت الأجواء كلمة، فاخفضها أو أزلها. وإذا أخفى قطع ما الفم النشط، فعُد إلى لقطة مستمرة لشخصين. غيّر عاملًا واحدًا في كل محاولة كي تجيب المخرجات التالية عن سؤال واضح.
لا يضمن أي من هذه التعديلات حلًا. إذا احتاج العرض مراجعة، فاحفظ ملفه وإعداداته والمشكلة التي تريد معالجتها. يمكن للمنتج حينها أن يقرر ما إذا كان عرض آخر يستحق التكلفة أو ما إذا كانت الأصوات المسجلة والتحرير اليدوي سيمنحان الدقة المطلوبة. لتبادل قصير ومنطوق بشكل مرئي، ابدأ بطلب المكتب واقبل المقطع فقط بعد الفحص سطرًا بسطر. هذا هو المعيار لـ حوار Gemini Omni 1.2 Flash متعدد المتحدثين.
الأسئلة الشائعة
هل يمكن لـ Gemini Omni 1.2 Flash الحفاظ على الأصوات نفسها عبر مقاطع منفصلة؟
بقاء الصوت متعرفًا عليه ضمن مقطع مولّد واحد مطلب أضيق من الحفاظ عليه عبر عمليات توليد منفصلة. تختبر هذه الأمثلة النصية فقط الحالة الأولى. لا تَعِد بهوية صوتية عابرة للمقاطع بناءً عليها. يجب أن تُجري حملة تحتاج متحدثًا متكررًا واحدًا اختبار استمرارية منفصلًا.
هل يمكن لـ Gemini Omni 1.2 Flash توليد حوار بلغات غير الإنجليزية؟
قد ينتج النموذج لغات أخرى، لكن هذه الطلبات بالإنجليزية. راجع اللغة الهدف كلمة بكلمة مع مستمع متقن، بما في ذلك الأسماء والأرقام والادعاءات المحلية. اختبار لغة ناجح لمنشئ آخر دليل على ذلك الاختبار، وليس ضمانًا لنصك.
كيف أحافظ على إسناد كل جملة إلى المتحدث الصحيح؟
امنح كل شخص موضعًا بصريًا وصوتًا، وسمِّ كل جملة مقتبسة، وحدد من يبقى صامتًا خلال دور الشخص الآخر. راجع الفيديو المولّد سطرًا بسطر. إذا لم يستوفِ العرض الموجز، فاختصر التبادل أو استخدم سير عمل صوتيًا مضبوطًا لتسليم دقيق.
كم عدد أدوار الحوار التي تتسع في مقطع Gemini Omni 1.2 Flash مدته 15 ثانية؟
يطلب طلب المقهى ثمانية أدوار قصيرة في 15 ثانية، بينما يطلب طلبا المكتب والشارع خمسة أدوار في 12 ثانية. هذه أمثلة نصوص، وليست حدودًا مضمونة. اقرأ الجمل بصوت عالٍ، واسمح بوقفات، واختصرها إذا وصل الدور الأخير إلى نهاية المقطع.
هل يحتاج Gemini Omni 1.2 Flash إلى صورة مرجعية لحوار بين متحدثين اثنين؟
لا تُستخدم صورة مرجعية في طلبات النص إلى فيديو الثلاثة هذه. فهي تصف موضع كل متحدث وملابسه وصوته في النص. إذا احتاج مشروع وجهًا محددًا أو نمطًا بصريًا، فاختبر مسارًا يقبل المراجع وراجع مخرجاته بشكل منفصل.


