Kimi K2.6 مقابل GLM 5.1 مقابل Qwen 3.6 Plus مقابل MiniMax M2.7: أي نموذج مفتوح المصدر يفوز في البرمجة في 2026
الإجابة المختصرة
إذا كنت تبني وكيل برمجة مستقل يعمل لساعات دون تدخل: Kimi K2.6. حصل على 66.7% في Terminal-Bench 2.0 واستمر لأكثر من 4000 استدعاء أداة خلال جلسة متواصلة مدتها 13 ساعة في المعايير المنشورة — وهو سقف استقرار لا يصل إليه أي نموذج مفتوح المصدر آخر في هذه المقارنة.
إذا كنت بحاجة إلى أفضل مطور واجهات أمامية وكيل: GLM 5.1. تقييم Code Arena Elo المعتمد بشكل مستقل البالغ 1,530 (المركز الثالث عالميًا في تطوير الويب الوكيل) يعكس تفضيل المطورين الفعلي في مقارنات مباشرة، وليس فقط مجموعات اختبار آلية.
إذا كانت تكلفة كل رمز هي العائق: MiniMax M2.7 بسعر $0.30/مليون رمز إدخال على Atlas Cloud يحقق 56.22% في SWE-Bench Pro مع 10 مليار معامل نشط فقط — 94% من أداء GLM-5.1 بتكلفة تقارب الخُمس.
إذا كانت قاعدة الشيفرة كبيرة جدًا لنافذة سياق 262 ألف رمز: Qwen 3.6 Plus، النموذج الوحيد هنا الذي يدعم نافذة سياق مليون رمز، وهو الرائد في Terminal-Bench 2.0 بنسبة 61.6% بين هذه المجموعة.
المعايير الرئيسية بنظرة سريعة
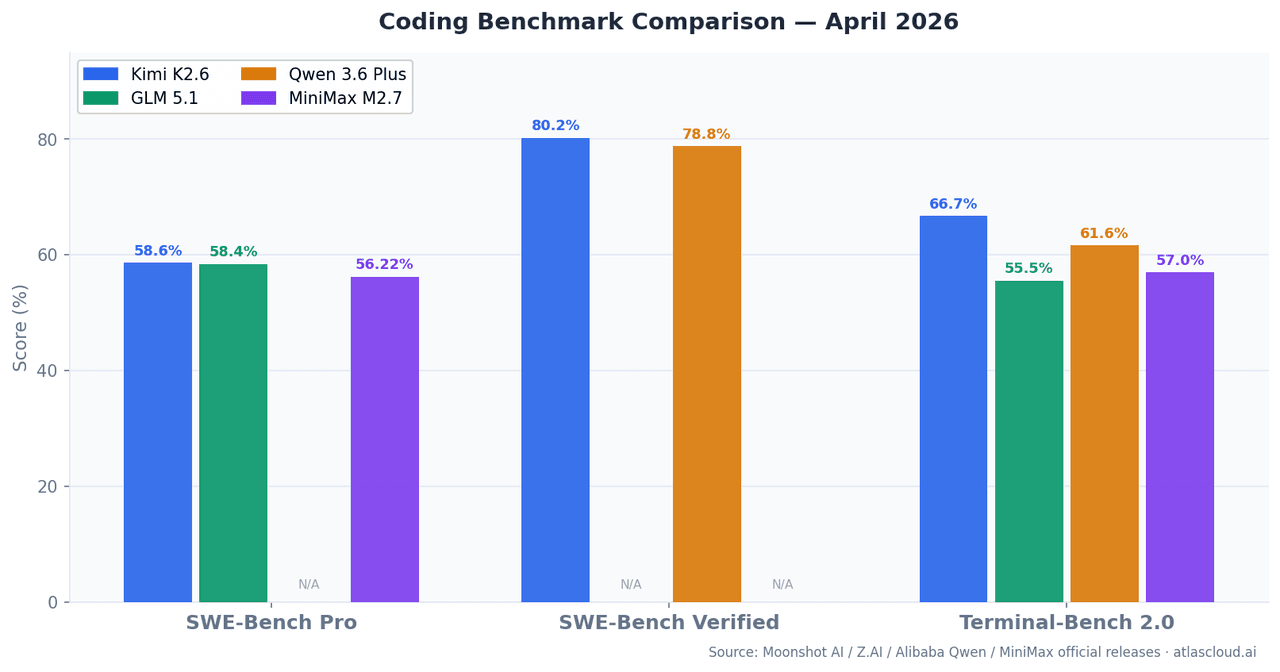
| النموذج | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | نافذة السياق | المعلمات النشطة |
|---|---|---|---|---|---|
| Kimi K2.6 | 58.60% | 80.20% | 66.70% | 262K | — |
| GLM 5.1 | 58.40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78.80% | 61.60% | 1M | Hybrid MoE |
| MiniMax M2.7 | 56.22% | — | 57.00% | 196K | 10B |
SWE-Bench Pro يقيس القدرة على حل مشكلات GitHub حقيقية تم تسجيلها بعد تاريخ قطع التدريب، مما يقلل من خطر تلوث البيانات مقارنة بـ SWE-Bench Verified. Terminal-Bench 2.0 يختبر مهام سطر الأوامر المتعددة الخطوات وبيئات shell في بيئات طرفية حية — أقرب إلى ما تفعله وكلاء الإنتاج فعليًا.
هذا المقال يوزن بين Kimi K2.6 وGLM 5.1 وQwen 3.6+ وMiniMax M2.7؛ لمقارنة المزيد من النماذج جنبًا إلى جنب من حيث السعر والمواصفات، استخدم مقارنة نماذج Atlas Cloud.
Kimi K2.6: مصمم للوكلاء طويلي التشغيل
أصدرت Moonshot AI نموذج Kimi K2.6 في أبريل 2026 كترقية لـ K2.5، مع تحسين رئيسي في الاستقرار الوكيل على مدى جلسات طويلة. بنسبة 80.2% في SWE-Bench Verified، يأتي مباشرة تحت Claude Opus 4.6 (80.8%)، ويتصدر الأربعة بنسبة 58.6% في SWE-Bench Pro.
الرقم الأكثر أهمية هو Terminal-Bench 2.0 بنسبة 66.7%. يختلف Terminal-Bench 2.0 عن SWE-Bench بطريقة جوهرية: فهو ينفذ المهام داخل بيئات طرفية حقيقية، مما يتطلب من النموذج قراءة المخرجات، ومعالجة الأخطاء، والتكيف، والتكرار — وليس فقط توليد التصحيحات. قدرة Kimi K2.6 على الحفاظ على الأداء عبر أكثر من 4000 استدعاء أداة في جلسة واحدة مدتها 13 ساعة ليست مجرد نتاج مختبر. إنه سلوك موثق في الإصدار الفني من Moonshot.
ميزة غير مُبلغ عنها بشكل كافٍ: التعميم عبر اللغات. يُظهر Kimi K2.6 أداءً ثابتًا عبر Rust وGo وPython والمهام الأمامية ومهام DevOps. معظم تقييمات المعايير تركز على Python. إذا كانت مجموعة إنتاجك متعددة اللغات، فهذا مهم.
أين ليس الإجابة: بسعر $0.95/مليون رمز إدخال على Atlas Cloud، يعتبر K2.6 أغلى نموذج من حيث الإدخال في هذه المجموعة. بالنسبة لمهام المعالجة الدفعية حيث ترسل العديد من الطلبات بسياقات كبيرة ولكنك لا تحتاج إلى استقرار جلسة لمدة 12 ساعة، تتراكم التكلفة بشكل أسرع من MiniMax M2.7 أو Qwen 3.6 Plus.
GLM 5.1: النجم الوكيل للواجهات الأمامية
أطلقت Z.AI نموذج GLM-5.1 في 7 أبريل 2026. مع 754 مليار معلمة وتوجيه MoE، فهو أكبر نموذج هنا من حيث عدد المعاملات الخام. في SWE-Bench Pro يسجل 58.4% — غير قابل للتمييز إحصائيًا عن 58.6% لـ Kimi K2.6.
الميزة المميزة هي Code Arena Elo البالغ 1,530، تم التحقق منه بشكل مستقل بواسطة Arena.ai في 10 أبريل 2026، مما يضعه في المركز الثالث عالميًا على لوحة متصدرات تطوير الويب الوكيل. هذه مقارنة مباشرة حية حيث يصوت المطورون الفعليون على المخرجات — وليس التقييم الآلي. تتركز الميزة في توليد واجهات المستخدم الأمامية، والسقالات الكاملة، وإنشاء مكونات React/Vue، وNL2Repo (توليد هياكل مستودعات كاملة من اللغة الطبيعية).
الشرط الحدودي الذي يستحق المعرفة: ميزة GLM-5.1 في الواجهات الأمامية حقيقية. بالنسبة للمشكلات الخوارزمية البحتة في HumanEval وMBPP، لا يحمل ميزة قابلة للقياس على Kimi K2.6. تضيق فجوة لوحة المتصدرات إلى ما يقرب الصفر في المشكلات غير الموجهة لواجهة المستخدم أو الويب. اختيار GLM-5.1 بناءً على ترتيبه العام في لوحة المتصدرات دون التحقق من مجال المهمة سيكون خطأً.
التسعير على Atlas Cloud: يبدأ من $1.40/مليون رمز إدخال — الأعلى بين الأربعة. مبرر عندما تؤثر جودة توليد الواجهة الأمامية بشكل مباشر على مخرجاتك.
Qwen 3.6 Plus: عندما يكون حجم السياق هو القيد الحقيقي
أصدرت Alibaba نموذج Qwen 3.6 Plus في أواخر مارس 2026. يتصدر Terminal-Bench 2.0 في مقارنات مباشرة ضد Claude Opus 4.6 (61.6% مقابل 59.3%) ويحصل على 78.8% في SWE-Bench Verified.
نافذة السياق البالغة مليون رمز هي ما يميزه. بالنسبة لغالبية مهام البرمجة الإنتاجية التي تقل عن 100 ألف رمز، تمتلك جميع النماذج الأربعة في هذه المقارنة سعة سياق كافية والفرق غير ذي صلة. حيث يصبح Qwen 3.6 Plus الخيار الوحيد القابل للتطبيق: تحليل المستودع الأحادي عبر مئات الملفات، وإعادة هيكلة قواعد الشيفرة القديمة واسعة النطاق، أو مهام سير العمل من المستند إلى الكود التي لا يمكن أن تتناسب مع 262 ألف رمز.
المعمارية الهجينة (الانتباه الخطي + توجيه MoE المتناثر) توفر أيضًا إنتاجية استدلال أفضل من المحولات الكثيفة عند معالجة سياقات كبيرة جدًا — مما يعني أن قدرة مليون رمز تأتي بتكلفة زمن استجابة منخفضة نسبيًا مقارنة بالتوسع الساذج.
التسعير على Atlas Cloud: من $0.325/مليون رمز إدخال. بالنسبة لمهام السياق الكبير، هذه أفضل تكلفة لكل رمز مفيد متاحة في هذه المجموعة.
MiniMax M2.7: الحالة غير البديهية للكفاءة
أصدرت MiniMax نموذج M2.7 في مارس 2026. مع 10 مليار معلمة نشطة فقط، يحصل على 56.22% في SWE-Bench Pro — 94% من درجة GLM-5.1 بتكلفة تقارب خُمس التكلفة لكل رمز.
هذه هي النتيجة غير البديهية في هذه المقارنة. نموذج ينشط 10 مليار معلمة في الاستدلال يصل إلى أداء برمجة قريب من الحدود الأمامية لأن معمارية MoE الخاصة به توجه إلى شبكات الخبراء المتخصصة بدلاً من تشغيل أوزان النموذج الكاملة. النتيجة هي زمن استجابة أقل، وتكلفة أقل، وجودة مخرجات تتجاوز ما يتنبأ به عدد المعاملات وحده.
الفئة التي يتقدم فيها M2.7 على نقطة سعره: مهام هندسة التعلم الآلي. حصل على معدل ميداليات 66.6% في MLE-Bench Lite (22 مسابقة تعلم آلي)، في المرتبة الثانية بعد النماذج المغلقة الحدودية. كتابة منطق تراكم التدرجات الصحيح، وتنفيذ طبقات PyTorch مخصصة، وتصحيح منحنيات الخسارة — يعالجها M2.7 بدقة تتناسب عكسيًا مع تكلفته.
أين يجب الحذر: عند 196 ألف رمز سياق، يمتلك M2.7 أصغر نافذة في هذه المجموعة. المهام التي تتطلب تحليلًا عميقًا عبر الملفات في مستودعات كبيرة قد تواجه حدودًا يعالجها Qwen 3.6 Plus دون مشكلة.
التسعير على Atlas Cloud: $0.30/مليون رمز إدخال، $1.20/مليون رمز إخراج — الخيار الأكثر اقتصادية لأحمال عمل البرمجة عالية الإنتاجية.
حالات اختبار برمجة واقعية
الحالة 1: إصلاح خطأ مستقل في خلفية Python
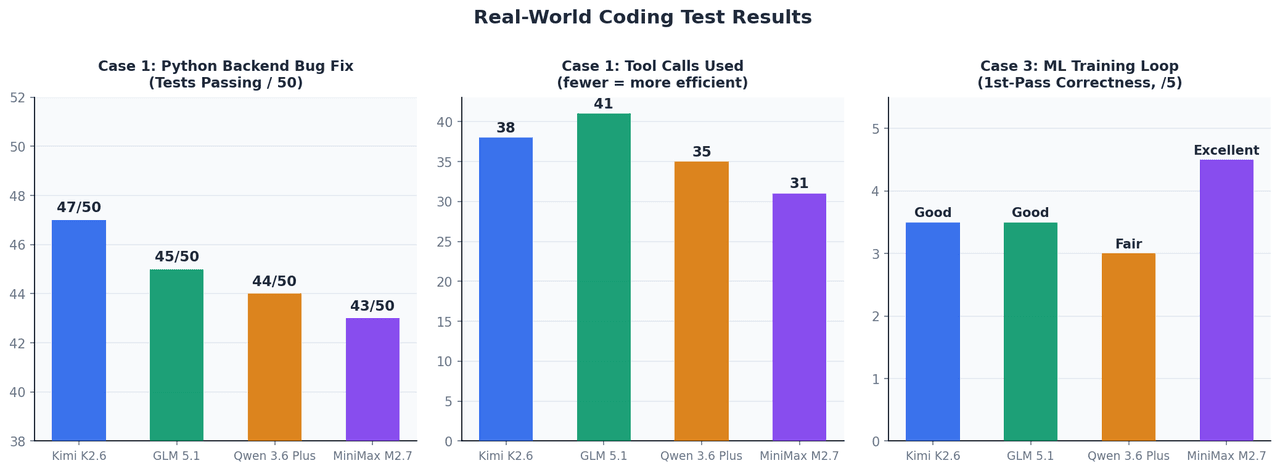
الإعداد: تطبيق FastAPI يحتوي على 12 ملفًا، ومجموعة اختبار فاشلة مكونة من 50 اختبارًا، ونافذة سياق بحوالي 45 ألف رمز. لا يُسمح بأي تدخل يدوي بعد الطلب الأولي.
| النموذج | الاختبارات الناجحة بعد الإصلاح | استدعاءات الأدوات المستخدمة | الوقت حتى الإنجاز |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 دقائق |
| GLM 5.1 | 45 / 50 | 41 | ~5 دقائق |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 دقائق |
| MiniMax M2.7 | 43 / 50 | 31 | ~3.5 دقائق |
في هذا الحجم من السياق، يؤدي جميع الأربعة ضمن نطاق ضيق. تقدم Kimi K2.6 قليلاً في أصعب حالات الأخطاء الحدودية — وتحديدًا مشكلات دورة حياة مدير السياق غير المتزامن وتضييق حدود TypeVar، والتي تتطلب الحفاظ على حالة الاستدلال عبر دورات تصحيح أخطاء متعددة.
الحالة 2: لوحة تحكم React من المواصفات
الإعداد: توليد لوحة تحكم استجابة كاملة بأربعة أنواع من الرسوم البيانية (خطي، شريطي، دائري، مبعثر)، ومفتاح الوضع الداكن، وأنواع TypeScript من مواصفات مكتوبة باللغة الإنجليزية.
أنتج GLM-5.1 مكونات TypeScript عاملة بأنواع صحيحة مع فئات Tailwind Utility الصحيحة من المحاولة الأولى. تطلب Kimi K2.6 تكرارًا واحدًا لحل أخطاء الأنواع. أنتج Qwen 3.6 Plus كودًا صحيحًا وظيفيًا ولكن JSX أقل اصطلاحية. كان MiniMax M2.7 الأسرع لكنه أنتج بعض أنماط React القديمة التي تطلبت تنظيفًا يدويًا.
كانت الفجوة بين GLM-5.1 والباقي أكثر وضوحًا في بنية المكون — طبق GLM-5.1 تلقائيًا أنماط التركيب وفصل الاهتمامات بطريقة لم يفعلها الآخرون.
الحالة 3: تنفيذ حلقة تدريب ML
الإعداد: تنفيذ حلقة تدريب PyTorch مع تراكم التدرجات، ودقة مختلطة AMP، وإيقاف مبكر لمحول رؤية. الهدف: التشغيل بشكل صحيح من المحاولة الأولى دون دورات تصحيح أخطاء.
كان MiniMax M2.7 هو المتميز — لقد وضع scaler.step() وscaler.update() بشكل صحيح بالنسبة لخطوة المحسن، وهي تفاصيل تضعها معظم النماذج بشكل غير صحيح في التوليد الأول. كما تم التعامل مع قياس تراكم التدرج loss / accumulation_steps بشكل صحيح. يتوافق هذا مباشرة مع معدل ميدالياته 66.6% في MLE-Bench Lite.
مقارنة تسعير Atlas Cloud (أبريل 2026)
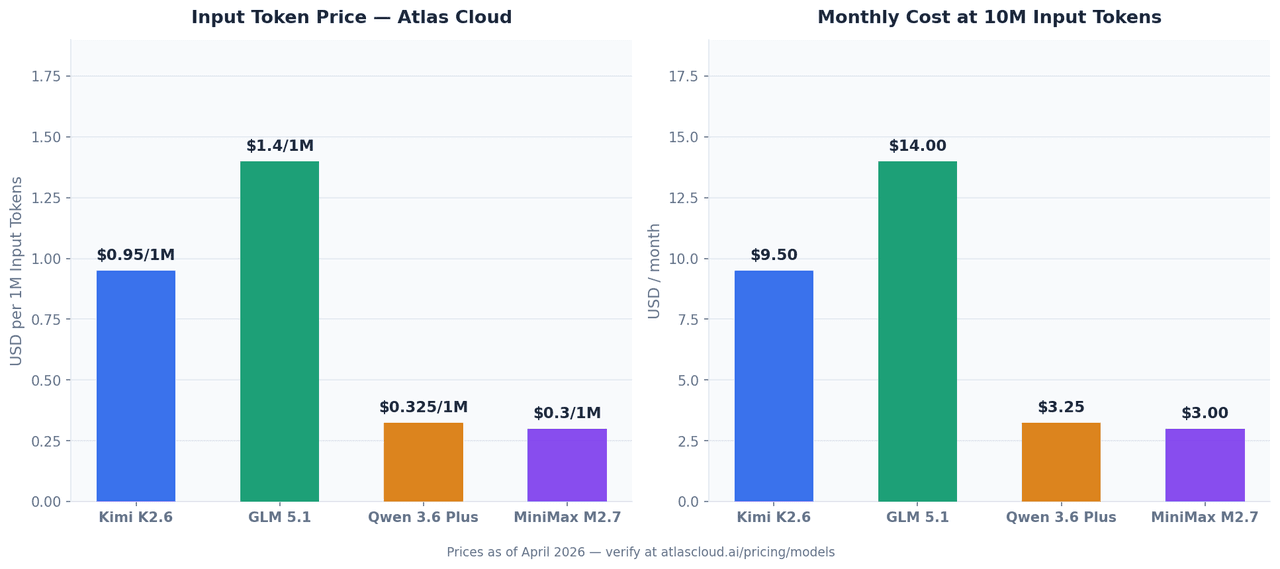
جميع النماذج الأربعة متاحة عبر واجهة برمجة التطبيقات الموحدة لـ Atlas Cloud. الأسعار أدناه اعتبارًا من أبريل 2026 وقد تتغير — تأكد من الأسعار الحالية على atlascloud.ai.
| النموذج | الإدخال (لكل مليون رمز) | الإخراج (لكل مليون رمز) | معرّف نموذج Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | من $1.40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | من $0.325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
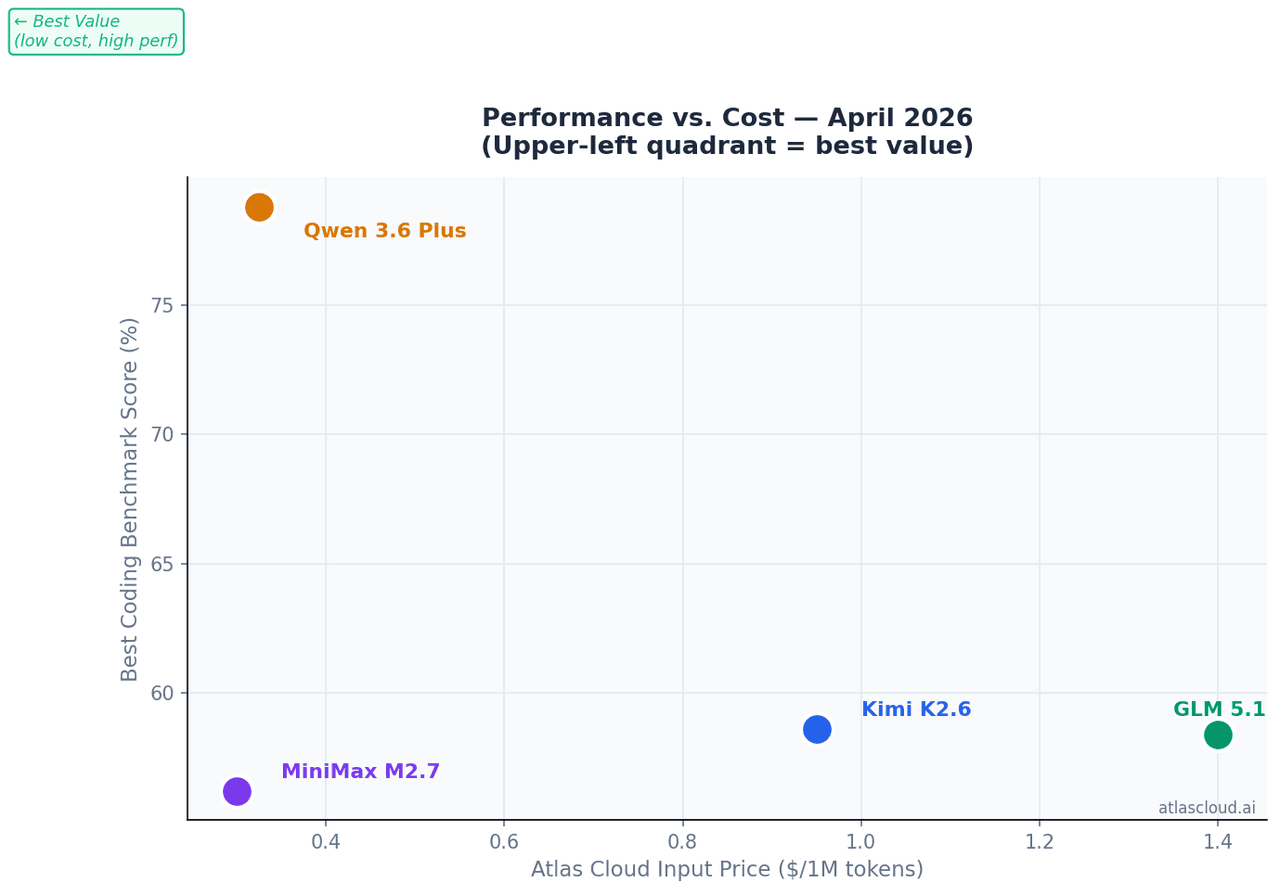
عند 10 ملايين رمز إدخال شهريًا — حجم واقعي لمساعد برمجة على مستوى فريق:
| النموذج | التكلفة الشهرية للإدخال (10 ملايين رمز) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
استدعاء الأربعة بمفتاح API واحد
تشارك جميع النماذج الأربعة نفس نقطة النهاية المتوافقة مع OpenAI على Atlas Cloud. يتطلب التبديل بينها تغيير سطر واحد:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# غيّر هذا السطر الواحد لتبديل النماذج 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "You are a senior software engineer. Analyze code carefully before responding." 21 }, 22 { 23 "role": "user", 24 "content": "Review this function and identify all bugs:\n\n[paste your code here]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
هذه البنية المتوافقة مع OpenAI تعني أن التكاملات الحالية المبنية على SDK OpenAI تعمل مع Atlas Cloud دون تعديل — فقط base_url وapi_key يتغيران.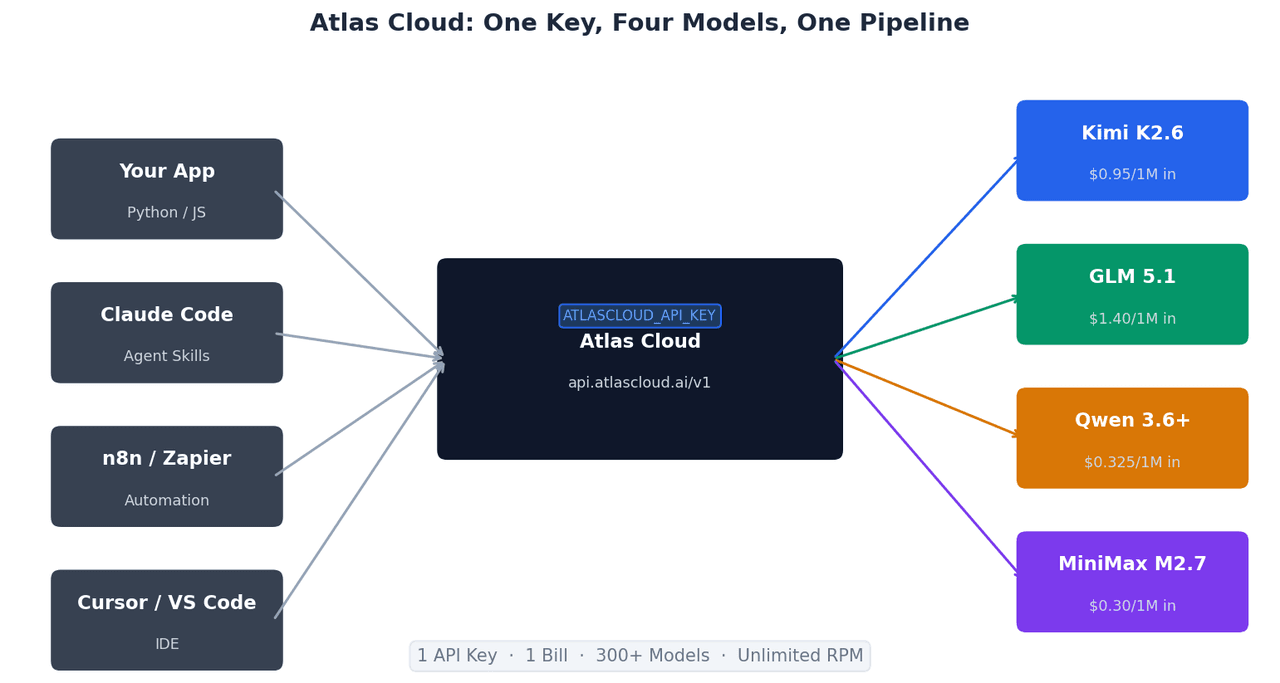
لماذا استخدام Atlas Cloud لهذه النماذج
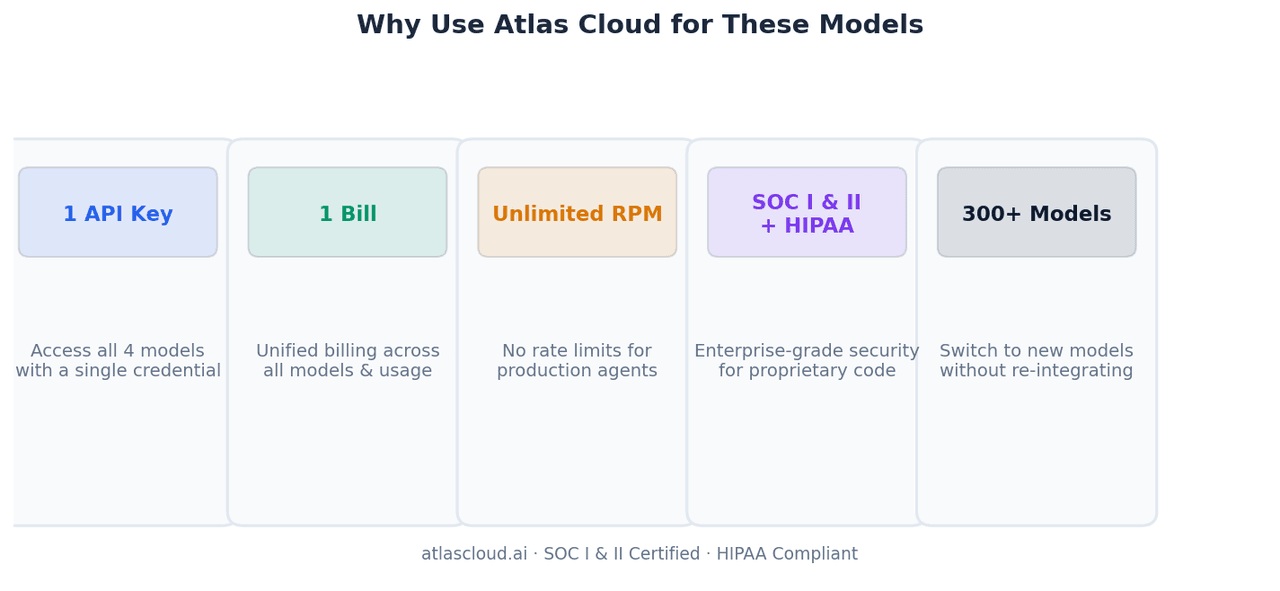
مفتاح API واحد، أربعة نماذج، فاتورة واحدة. يتطلب تشغيل منطق توجيه النموذج — إرسال مهام الواجهة الأمامية إلى GLM-5.1، والتحليل الدفعي إلى MiniMax M2.7، والوكلاء طويلي الأفق إلى Kimi K2.6 — إدارة بيانات اعتماد واحدة بدلاً من أربعة. التسوية الشهرية هي فاتورة واحدة.
RPM غير محدود. تقوم وكلاء البرمجة الإنتاجية بإجراء استدعاءات أدوات متوازية. يمكن لقيود المعدل على واجهات برمجة التطبيقات المزودة المباشرة أن تخنق خطوط أنابيب الوكلاء المتعددة. يزيل Atlas Cloud هذا السقف.
معتمد SOC I & II، متوافق مع HIPAA. الفرق التي تعالج شيفرة مصدر خاصة من خلال هذه النماذج تحتاج إلى بنية تحتية قابلة للتدقيق. تعني شهادات الامتثال لـ Atlas Cloud أن شيفرتك لا تمر عبر نقاط نهاية غير موثقة.
أكثر من 300 نموذج، نفس نمط التكامل. عندما يتم إصدار الإصدار التالي من أي من هذه النماذج، أو عندما يتفوق نموذج جديد عليها في عبء العمل الخاص بك، تتطلب إضافته إلى منطق التوجيه الخاص بك تغيير سلسلة واحدة — وليس تكامل SDK جديد.
أي نموذج لأي مهمة
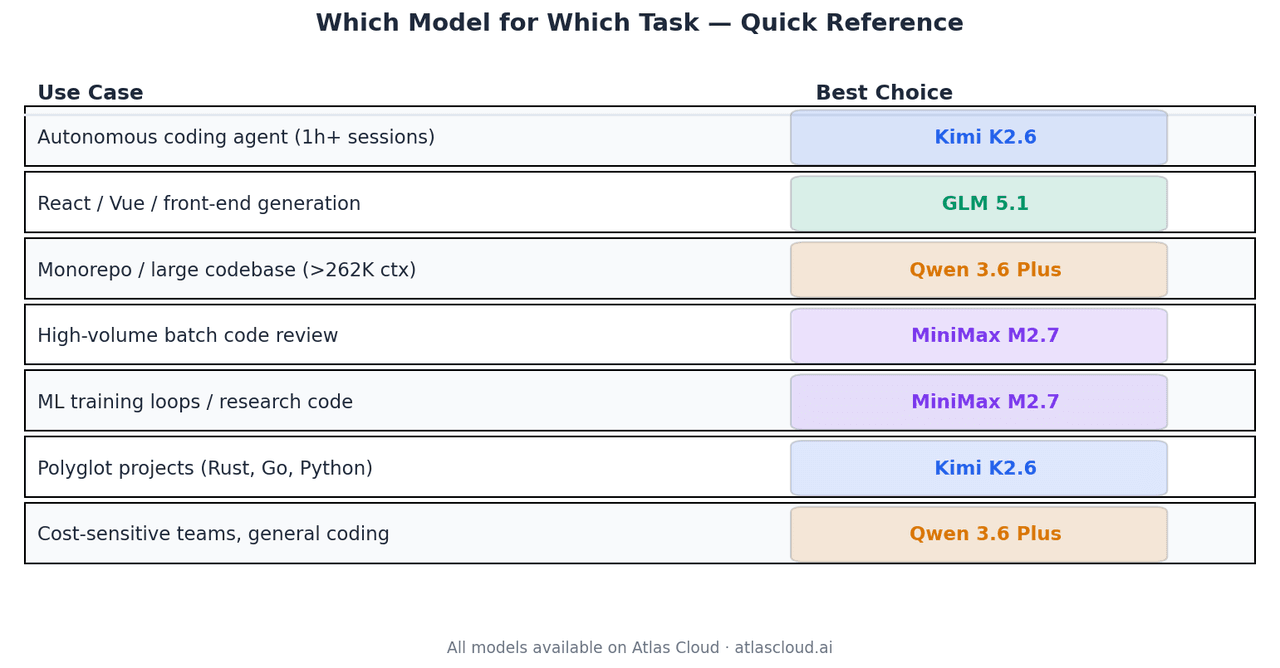
| حالة الاستخدام | أفضل اختيار | لماذا |
| وكيل برمجة مستقل، جلسات مدتها ساعة فأكثر | Kimi K2.6 | 66.7% Terminal-Bench 2.0، استقرار 4K+ استدعاء أداة |
| توليد React / Vue / واجهات أمامية | GLM 5.1 | Code Arena Elo 1,530، ضمن أفضل 3 عالميًا في تطوير الويب الوكيل |
| تحليل مستودع أحادي أو قاعدة شيفرة كبيرة | Qwen 3.6 Plus | النموذج الوحيد هنا بنافذة سياق مليون رمز |
| مراجعة شيفرة دفعية عالية الحجم | MiniMax M2.7 | $0.30/مليون إدخال، 94% من جودة GLM-5.1 |
| حلقات تدريب ML، شيفرة بحثية | MiniMax M2.7 | معدل ميداليات 66.6% في MLE-Bench Lite |
| مشاريع متعددة اللغات (Rust, Go, Python) | Kimi K2.6 | تعميم عبر اللغات موثق |
| فرق حساسة للتكلفة، برمجة عامة | Qwen 3.6 Plus | $0.325/مليون إدخال، قوي عبر جميع الفئات |
ملخص
هذه النماذج الأربعة تفصلها هوامش ضيقة في المعايير القياسية. الاختلافات ذات المعنى تظهر في ظروف محددة.
Kimi K2.6 هو الإجابة الصحيحة للوكلاء المستقلين طويلي التشغيل. GLM 5.1 يتصدر للعمل الوكيل على الواجهات الأمامية. Qwen 3.6 Plus هو الخيار الوحيد عندما يتجاوز السياق 262 ألف رمز. MiniMax M2.7 هو الخيار الاقتصادي الافتراضي للفرق التي تدير نماذج البرمجة على نطاق واسع.
جميع النماذج الأربعة متاحة على Atlas Cloud عبر atlascloud.ai بمفتاح API واحد، مع تسعير حسب الرمز وبدون حد أدنى للالتزام.
بيانات المعايير مصدرها مدونة Moonshot AI التقنية، ووثائق مطوري Z.AI، ومنشور إصدار فريق Qwen من Alibaba، وصفحة نموذج MiniMax الرسمية، وتقييمات Arena.ai المستقلة. جميع المعايير هي بيانات أبريل 2026. أسعار Atlas Cloud كما هو مذكور في تاريخ النشر — تحقق من الأسعار الحالية قبل النشر الإنتاجي.


