

قد تبدو نتيجة اختبار قياسي حاسمة، إلى أن يفوّت النموذج نفسه أحد المتطلبات في الجولة التالية. يطرح اختبار موثوقية Muse Wonder المفيد سؤالًا أضيق: هل يكمل النموذج مهمتك، وفق معيارك، بشكل متكرر، وفي ظل الظروف نفسها؟
الأدلة المبكرة متباينة لأن الاختبارات تقيس أشياء مختلفة. منحت مجموعة مهام في يوم الإطلاق نموذج Muse Wonder القياسي درجة عالية جدًا بعد تشغيل واحد لكل مهمة. وكشف تقييم آخر عن نقاط قوة في تحليل الأبحاث إلى جانب ضعف في تصميم الاستبيانات والادعاءات البيعية وتنسيق الشرائح. ولا يثبت أي من النتيجتين مدى الاتساق الذي سيتعامل به مع قاعدة شفرتك أو سير عمل وكيلك.
النقاط الرئيسية
- اعتبر اختبارات القياس عند الإطلاق مؤشرات على القدرات، لا ضمانات للإنتاج.
- Muse Wonder وMuse Wonder Full متغيران منفصلان. احتفظ بنتائجهما منفصلة.
- قِس معدل النجاح وقابلية التكرار والإكمال والاستعادة كنتائج مختلفة.
- ابدأ بـ 10 إلى 20 مهمة حقيقية، وثبّت الإعداد، وكرّر المهام المهمة ثلاث مرات على الأقل.
- اختر عتبة بناءً على تكلفة الإجابة الخاطئة وعملية المراجعة البشرية لديك.
هل Muse Wonder موثوق؟ الإجابة المختصرة
تدعم الأدلة المتاحة حتى 15 أكتوبر 2026 تقييمًا مهمة بمهمة، لا حكمًا شاملًا على الموثوقية. فقد أبلى Muse Wonder بلاءً حسنًا في بعض الفحوص المبكرة، بينما كشفت جولات أخرى عن أخطاء أو عمل عرضي ما زال بحاجة إلى مراجعة. وتختلف الدراسات في المطالبات وإعدادات الاستدلال والمقيّمين وأحجام العينات وعدد المحاولات.
تقول (Meta، 12 أكتوبر 2026) إن Muse Wonder وMuse Wonder Full مصممان لمهام الوكلاء المهنية والشخصية، بميزات تسميها Active Memory وActive Focus. وهذه ادعاءات منتج حول السلوك المقصود. والادعاء بأن النموذج قادر على التعافي من الأخطاء هو سبب لاختبار الاستعادة في سير عملك، وليس دليلًا على أنه سيتعافى بموثوقية.
أبقِ Wonder القياسي منفصلًا عن Wonder Full. تُدرج Meta نموذج Muse Wonder القياسي في Model API وMuse Code الخاصين بها، بينما يُقدَّم Full عبر اشتراكات Muse Code. وتشغيل Wonder القياسي بإعداد استدلال أعلى لا يجعله Full.
لاتخاذ قرار يمكنك الدفاع عنه، اختبر المتغير والمسار الدقيقين اللذين تعتزم نشرهما. ولا تعدّ المهمة ناجحة إلا عندما تستوفي قاعدة قبول مكتوبة ويمكن التحقق من نتيجتها.
ما الذي ينبغي أن يقيسه اختبار موثوقية Muse Wonder
الدقة والاتساق أمران مختلفان
يقيس معدل النجاح عدد المحاولات التي تستوفي معيارًا محددًا. ويقيس الاتساق ما إذا كانت الجولات المتكررة للمهمة نفسها تُنتج نتائج مقبولة في كل مرة. وقد يحقق النموذج معدل نجاح مرتفعًا بينما يظل متفاوتًا بطرق تهم سير عملك.
تتبّع أربعة أبعاد بشكل منفصل:
| المقياس | ما يجب تسجيله | مثال على الفحص |
|---|---|---|
| الدقة | المحاولات التي تستوفي المعيار | هل يتطابق الإجمالي المستخرج مع المستند المصدر؟ |
| الاتساق | ما إذا كانت المحاولات المتكررة تنجح وتتفق | هل تحافظ ثلاث جولات على القيود المطلوبة نفسها؟ |
| جودة الإكمال | ما إذا كانت كل مخرجات العمل المطلوبة موجودة | هل تم تضمين كل الملفات والاستشهادات والحقول المطلوبة؟ |
| الاستعادة | ما إذا كانت الجولة تستأنف بشكل صحيح بعد عطل | هل يبلّغ عن فشل أداة، ويعيد المحاولة بأمان، ثم يتحقق من الحالة النهائية؟ |
الإجابة التي تبدو مكتملة ليست بالضرورة مكتملة. فتغيير الشفرة يحتاج إلى اختبارات؛ وملخص البحث يحتاج إلى مصادر قابلة للتتبع؛ وجولة الوكيل تحتاج إلى دليل على أن إجرائه النهائي قد حدث.
افصل أعطال النموذج عن أعطال سير العمل
سجّل سياقًا كافيًا للتمييز بين خطأ النموذج ومشكلة التقديم أو الأداة. وعلى الأقل، سجّل متغير النموذج وإصداره، وإعداد الاستدلال، والمطالبة، وتكوين الأداة، والتاريخ، ومدة التشغيل، وتكلفة الرموز أو المهمة، والمخرجات الخام.
صنّف الأعطال قبل تقييمها:
- النموذج: حقيقة غير صحيحة، أو استدلال سيئ، أو متطلب مفوّت.
- الأداة: فشل استدعاء API، أو وسائط أداة غير صالحة، أو نتيجة خاطئة من نظام خارجي.
- التقديم: مهلة أو انقطاع أو نقطة نهاية غير متاحة.
- التقييم: معيار غير واضح أو فحص لا يميّز العمل المقبول من غير المقبول.
إذا دمجت الأربعة جميعًا في معدل عطل واحد، فلن تعرف ما ينبغي إصلاحه.
ما تكشفه اختبارات Muse Wonder الحالية
مقارنات القياس المنشورة من Meta هي أدلة مورّد حول أداء القياس. وهي ليست كتقييم سير عمل يُجرى بشكل مستقل. وللاختبارات المستقلة أيضًا حدودها: فمجموعة مهام عامة صغيرة، أو محاولة واحدة، أو مسار نموذج معيّن، أو تقييم تفضيل بشري لا يجيب إلا على سؤال ضيق.
يفصل الجدول أدناه الأدلة حسب المصدر والنطاق. وهو دليل على ما يمكن أن تدعمه كل نتيجة، لا درجة مجمّعة.
| مصدر الدليل | ما اختبره | التاريخ والإعداد | ما يمكن أن يخبرك به | الحد الرئيسي |
|---|---|---|---|---|
| إعلان Meta ومواد النموذج | اختبارات القياس للقدرات وميزات الوكيل المقصودة | أُعلن في 12 أكتوبر 2026؛ مقارنات أبلغ عنها المورّد | القدرات التي تشدد عليها Meta والمتغيرات التي أطلقتها | اختبار المورّد لا يثبت قابلية التكرار في سير عملك |
| (Spring Prompt، 13 أكتوبر 2026) | الاستبيانات وقوائم المنتجات والشرائح وتخطيط الإعلانات والشطرنج والبحث البصري | 13 أكتوبر؛ نموذج API القياسي، استدلال متوسط عمومًا؛ مهام عامة | اختلف الأداء حسب المهمة؛ شملت بعض التقييمات جولات متكررة لقوائم المنتجات | معظم المهام كانت عينات صغيرة؛ عديد من النتائج كان جولة واحدة لكل مهمة؛ ليس اختبار برمجة أو Muse Code |
| (Quantslant، 12 أكتوبر 2026) | 23 مهمة تشمل الوكلاء والبرمجة والكتابة والاستدلال ومستندًا طويلًا واحدًا | 12 أكتوبر؛ النموذج القياسي عبر OpenRouter، استدلال منخفض؛ جولة واحدة لكل مهمة | اجتاز النموذج مجموعة المهام المحددة تلك بمعدل مرتفع في ظل ذلك الإعداد | جولة واحدة لا يمكنها قياس الاتساق بين الجولات؛ النتائج القريبة من 100% تحتاج فحصًا على مستوى المهمة |
| منشورات المجتمع | تفاعلات فردية مع البرمجة والوكلاء والقياس | منشورات فترة الإطلاق؛ مستخدمون ومهام اختاروها بأنفسهم | مؤشرات مفيدة لما ينبغي اختباره تاليًا | الحكايات والأصوات ليست معدلات نجاح مقيسة |
التباين بين المصادر مهم. أبلغ Quantslant عن 99.7% عبر مجموعة مهامه المكوّنة من 23 مهمة، بجولة واحدة لكل مهمة وإعداد استدلال منخفض. وأشار أيضًا إلى اختبار وحدة فاشل واحد في مهمة برمجية لتحويل الأرقام إلى كلمات. وتلك النتيجة دليل على تلك المجموعة بعينها، وليست دليلًا على أن 99.7% من المهام اليومية ستنجح أو أن الجولات المتكررة ستتفق.
أبلغ Spring Prompt عن صورة أكثر تباينًا لـ Wonder القياسي عند الإعدادات الافتراضية لـ API في 13 أكتوبر. وكانت درجة تحليل الأبحاث لديه 93.6/100 عبر تسع مهام عامة، بينما لم تجتز سوى ثلاث من تسع خطط استبيان كل الفحوص. وبالنسبة لقوائم المنتجات، كانت النسبة التي اعتُبرت جاهزة للنشر بموثوقية عبر ثلاث جولات متكررة 66.1% للملخصات الوقائعية و51.8% للملخصات البيعية. واحتاجت خمس من ست شرائح عرض إلى إصلاحات تنسيق، وحُكم على واحدة بأنها قابلة للعرض. وهذه مقاييس منفصلة بمقامات منفصلة، وليست أجزاء من درجة إجمالية واحدة.
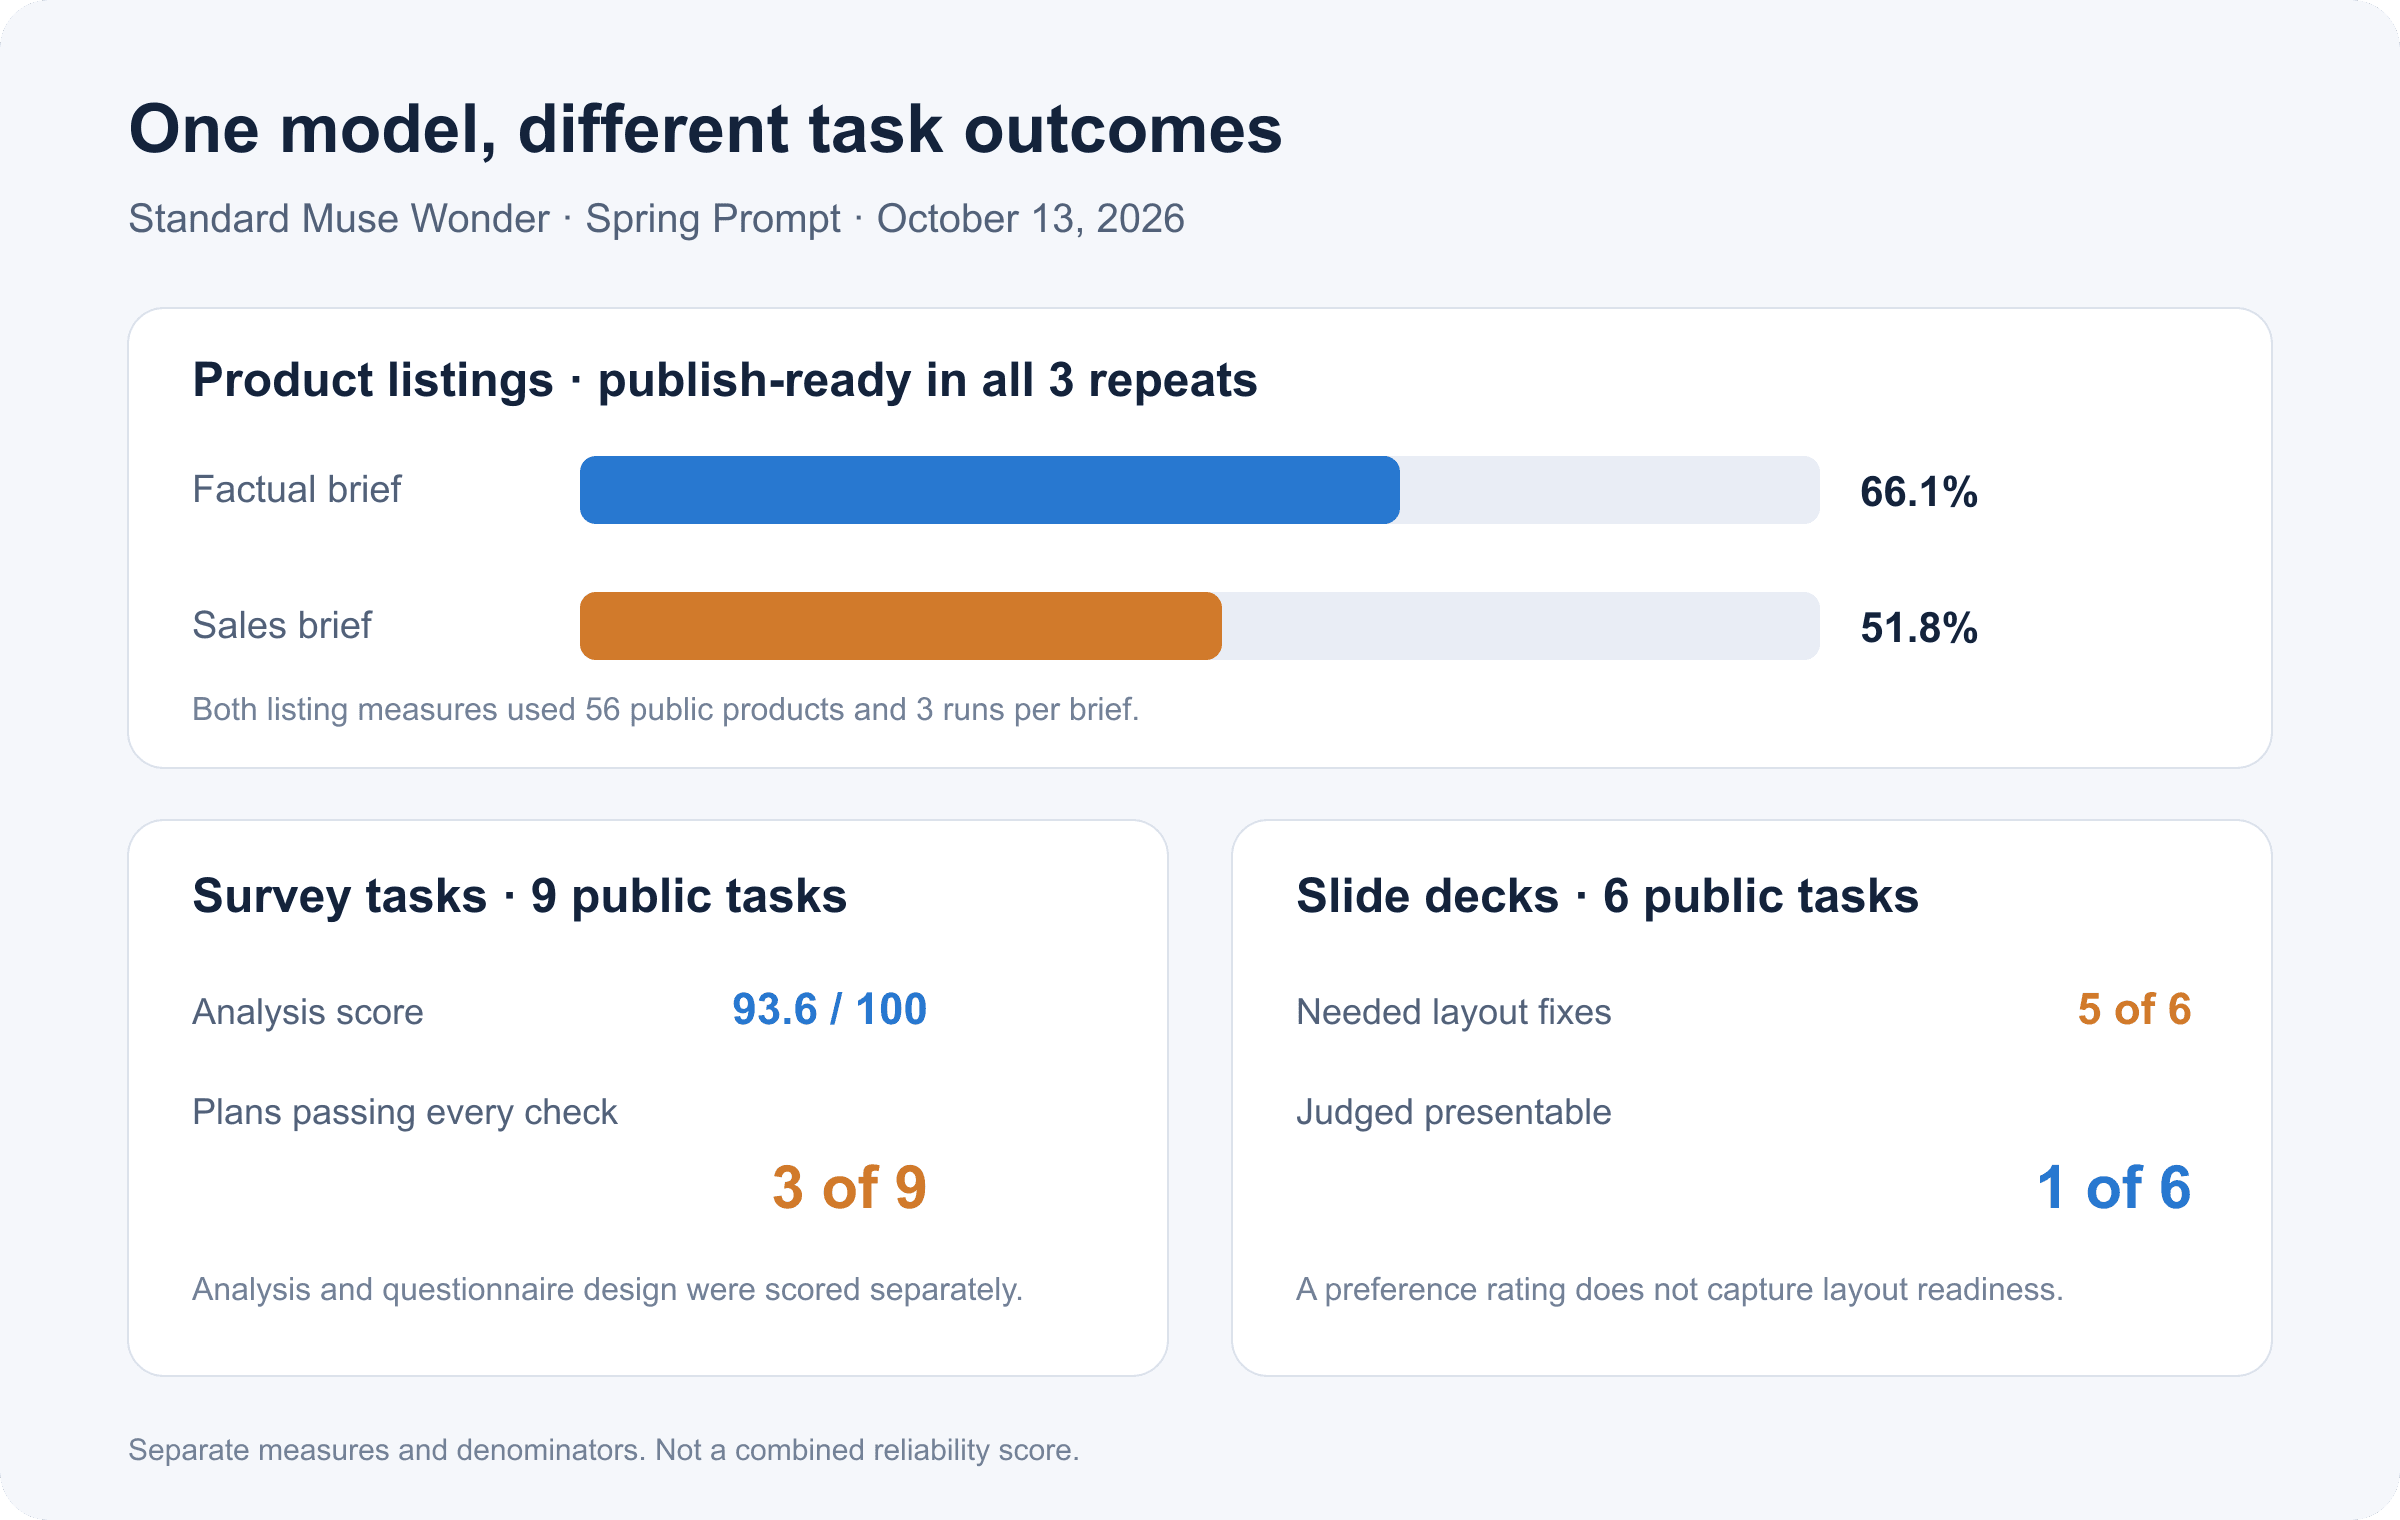
نتائج Muse Wonder القياسي لدى Spring Prompt في 13 أكتوبر 2026: معدلات نجاح القوائم المُختبَرة بشكل متكرر، ونتائج تحليل الاستبيانات ومراجعة الشرائح
نتائج مهام مستقلة من تقييم واحد. تستخدم المقاييس مقامات مختلفة وتُعرض بشكل منفصل، لا مجمّعة في درجة.
لم تقيس اختبارات Spring Prompt البرمجة أو الذاكرة الدائمة أو Muse Code. لذلك لا يمكن لمقارنته أن تحسم ما إذا كان Wonder موثوقًا للبرمجة أو ما إذا كان Full يؤدي بشكل أفضل. لكنه يُظهر لماذا يخفي التصنيف الواسع الواحد فروقًا مهمة بين المهام.
يقول مقال إطلاق Meta إن Muse Wonder القياسي متاح عبر Meta Model API وMuse Code، بينما Wonder Full متاح لمشتركي Muse Code. ويصف Active Memory وActive Focus كميزتين للاحتفاظ بالتفاصيل المفيدة ومواصلة العمل رغم الأخطاء. وتساعد هذه الأوصاف في تحديد حالات الاختبار، لكن مقال الإطلاق ليس دراسة مستقلة بجولات متكررة.
بالنسبة لادعاءات البرمجة والبناء ثلاثي الأبعاد التي نوقشت في خيوط المجتمع خلال أسبوع الإطلاق، تعامل مع المنشورات كفرضيات. حوّل شكوى محددة إلى مهمة قابلة للتكرار وتحقق من المخرجات. ولا تحوّل التعليقات أو التصويتات إلى معدل نجاح.
كيف تُجري اختبار موثوقية Muse Wonder قابلًا للتكرار
1. ابنِ مجموعة مهام صغيرة من العمل الحقيقي
اختر 10 إلى 20 مهمة يتوقع فريقك فعليًا أن يتعامل معها النموذج. وقسّمها إلى فئات مثل البرمجة والاستخراج الوقائعي واتباع التعليمات والسياق الطويل واستخدام الأدوات. وفضّل المهام ذات الاختبارات الموضوعية أو الإجابات المرجعية أو المعيار الواضح.
ضمّن حالات حدية واقعية: مدخلات ناقصة، ومتطلبات متعارضة، وأداة غير متاحة، ومهمة ينبغي أن تثير سؤال توضيحي. وابقِ البيانات الحساسة أو الخاضعة للتنظيم خارج ذلك ما لم تسمح بها عمليتك المعتمدة.
2. ثبّت المطالبة والنموذج والإعدادات
دوّن المطالبة وتعليمات النظام الدقيقة. وسجّل اسم النموذج وإصداره، ومستوى الاستدلال، والأدوات، والسياق المقدَّم، والتاريخ، وأي حد زمني. ولا تقارن Wonder القياسي بـ Full كما لو كانا النموذج نفسه.
يمكن لمطالبة اختبار مفيدة أن تطلب من النموذج إظهار أدلته وتحديد المتطلبات غير القابلة للاختبار:
اقرأ المواصفات والتنفيذ المرفقين. وأعد فقط: (1) كل متطلب موسومًا بـ PASS أو FAIL أو NOT TESTABLE؛ (2) الدليل الدقيق لكل حالة؛ (3) أي متطلب ناقص؛ (4) اختبارًا بسيطًا قابلًا للتكرار لكل حالة FAIL. ولا تدّعِ نجاح اختبار ما لم تستطع الإشارة إلى مخرجاته.
هذا مُدخل تقييم، وليس ضمانًا بأن النموذج سيتبعه. قيّم الإجابة الناتجة وتحقق من أي مخرجات اختبار مُدّعاة بشكل مستقل.
3. كرّر المهام وقيّم كل محاولة
شغّل كل مهمة عالية التأثير ثلاث مرات على الأقل بالإعداد نفسه. وإذا كانت الميزانية تسمح بمحاولة واحدة فقط، فصنّف النتيجة كعينة أولية لا كنتيجة اتساق. واحتفظ بكل استجابة خام؛ ولا تُبلّغ عن الأفضل فقط.
استخدم صفًا لكل محاولة. وأبقِ قاعدة القبول ثابتة عبر الجولات.
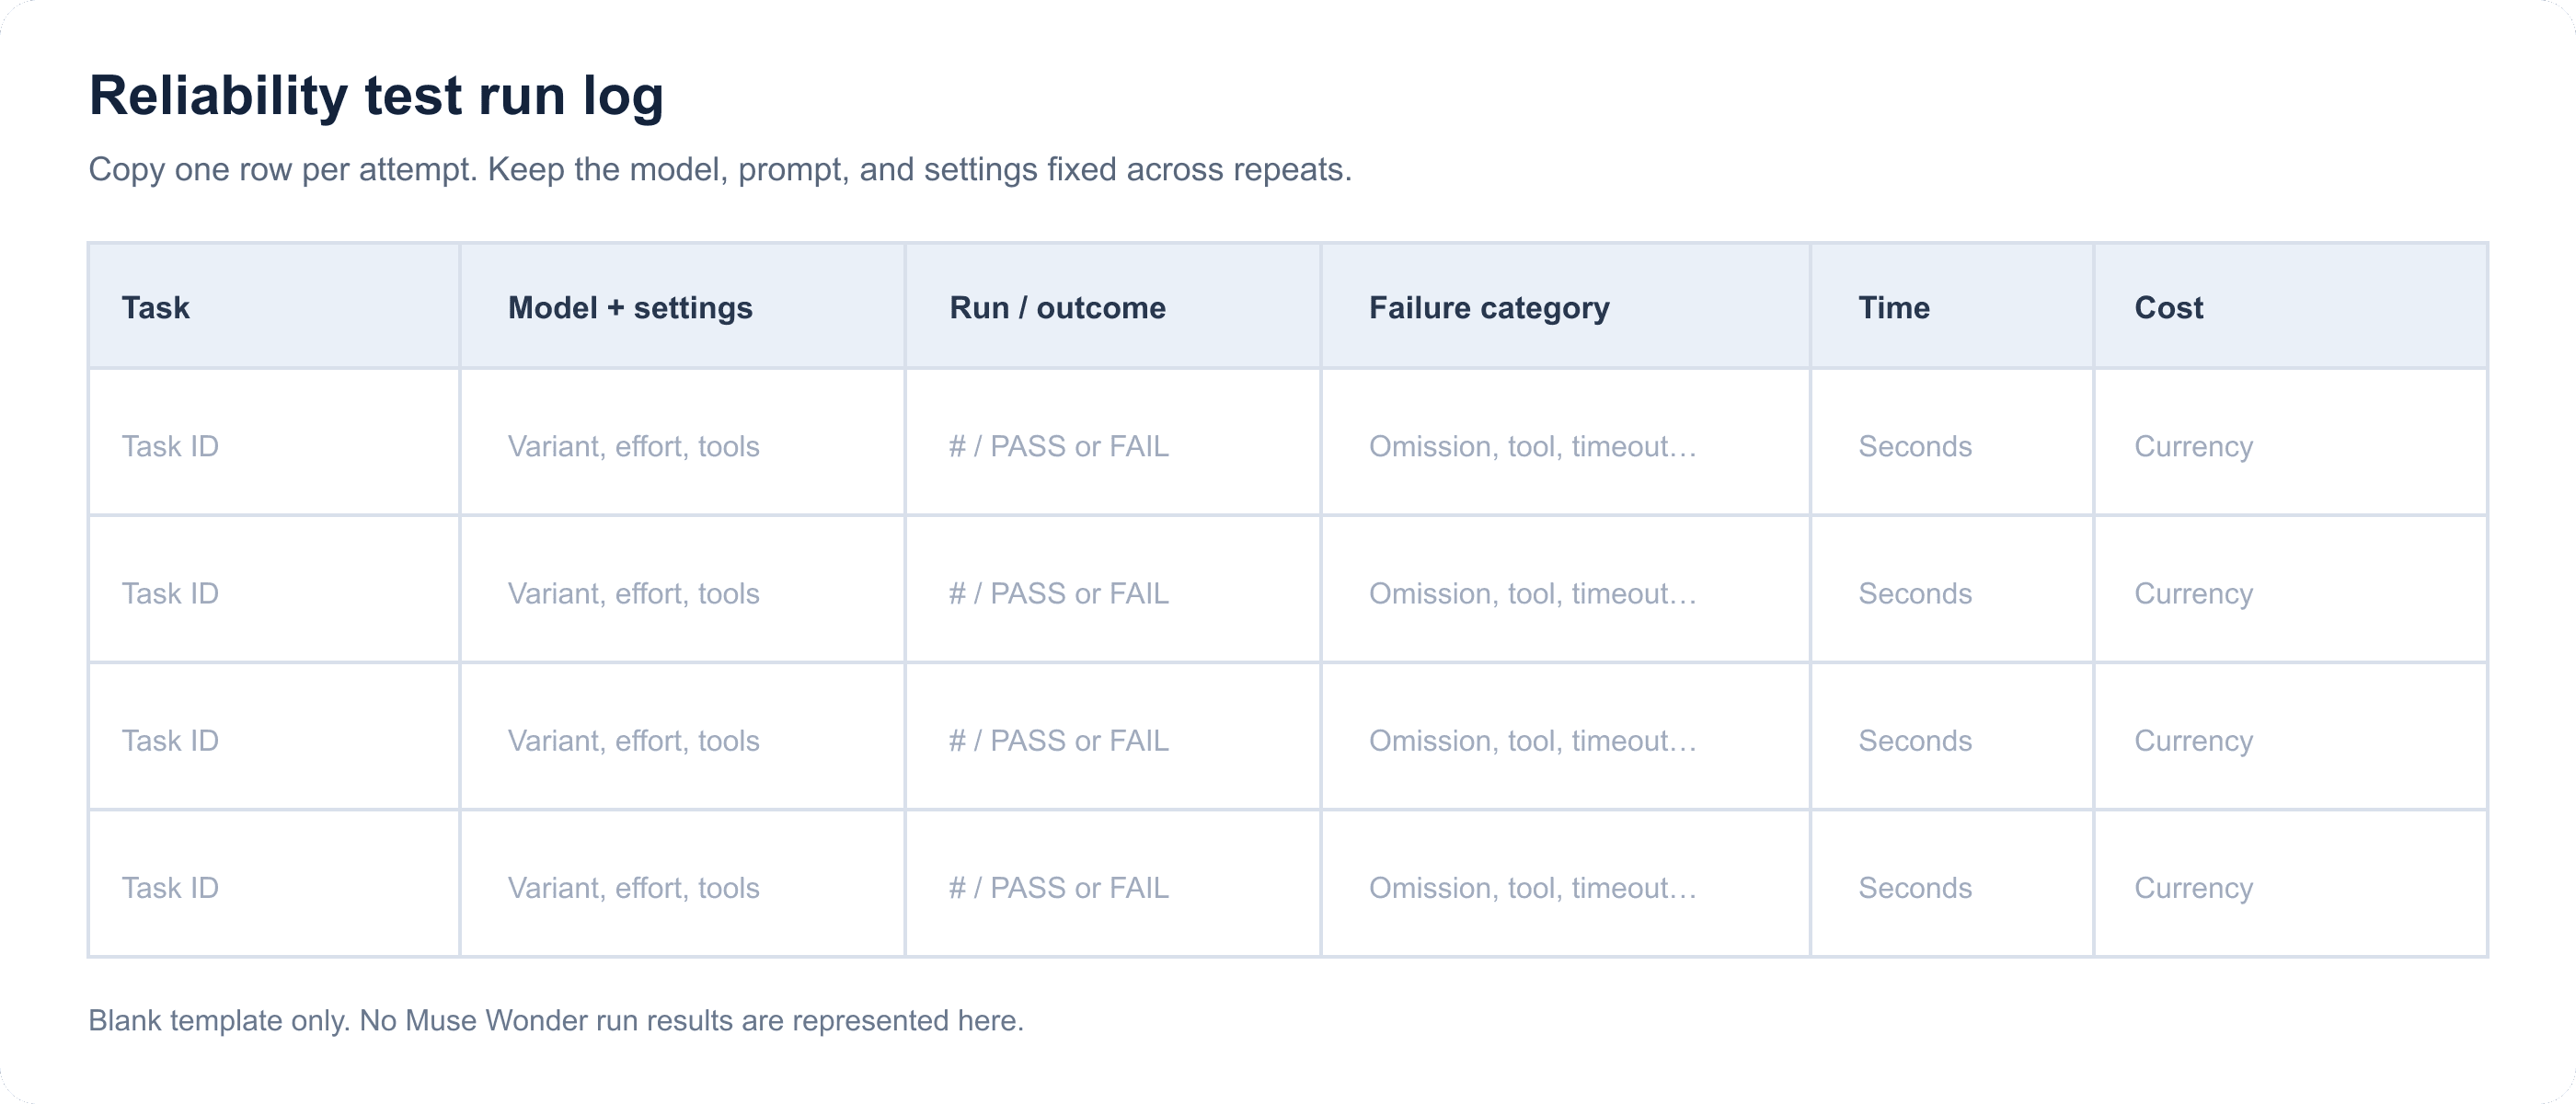
سجل اختبار موثوقية Muse Wonder فارغ يعرض حقول المهمة والنموذج والجولة والنتيجة والخطأ والوقت والتكلفة
قالب سجل فارغ قابل لإعادة الاستخدام. املأ صفًا لكل محاولة؛ ولا يحتوي على نتائج Muse Wonder مقيسة.
4. احتفظ بسجل أعطال وتحقق من الاستعادة
استخدم فئات محددة: خطأ وقائعي، أو إغفال، أو فشل اختبار شفرة، أو خطأ أداة، أو مهلة، أو ادعاء إكمال غير مدعوم، أو عدم تطابق التنسيق. وبالنسبة للعمل متعدد الخطوات، دوّن أين توقفت الجولة وما إذا كانت إعادة المحاولة قد كررت إجراءات مكتملة أو تحققت من الحالة النهائية.
الوكيل الذي يقول "تم" دون دليل لم يجتز فحص الإكمال. واطلب نتيجة اختبار، أو ملفًا محفوظًا، أو استشهادًا بمصدر، أو حالة مُتحققًا منها تطابق المهمة.
5. ضع عتبة قرار حول تكلفة الفشل
لا يوجد حد عالمي مفيد لمعدل النجاح. فالمسودة التي يراجعها شخص سطرًا بسطر لها ملف مخاطر مختلف عن ترحيل قاعدة بيانات أو دفعة آلية.
حدّد العتبة من ثلاثة عوامل:
- ما مدى ضرر أو تكلفة النتيجة الخاطئة؟
- هل يمكن لشخص التقاط الخطأ قبل أن يؤثر في أحد؟
- هل يفشل سير العمل بأمان، مع توقف واضح ومسار تدقيق؟
بالنسبة للمسودات منخفضة المخاطر، قد تكفي المراجعة. أما بالنسبة لتغييرات الشفرة أو المال أو القانون أو الصحة أو الإجراءات التي تؤثر في المستخدمين، فاستخدم اختبارات أقوى وتحققًا مستقلًا. ولا تدع متوسطًا مرتفعًا يخفي نمط فشل خطيرًا واحدًا.
موثوقية Muse Wonder حسب نوع المهمة
البرمجة والبناء متعدد الخطوات
شغّل مجموعة اختبارات المستودع الفعلية وتحقق من السلوك المطلوب. وقيّم تغطية المتطلبات، وفشل الارتداد، وما إذا كانت التغييرات المدّعاة من النموذج تطابق الملفات ومخرجات الاختبار. والتسجيل المرئي أو الشرح المقنع ليس بديلًا عن فحص قابل للتنفيذ.
تضمنت مجموعة Quantslant المبكرة أربع مهام برمجية وأبلغت عن نجاح 15 من 16 اختبار وحدة في مهمة واحدة لتحويل الأرقام إلى كلمات. وهذا مؤشر صغير من جولة واحدة. ولم يختبر Spring Prompt البرمجة صراحةً، لذا لا ينبغي استخدام نتائجه للتعميم حول موثوقية وكيل البرمجة.
الأبحاث والاستخراج الوقائعي
استخدم حزمة مصادر أو إجابات مرجعية يمكن لمُراجعك فحصها. وتحقق من كل ادعاء وقائعي مقابل مصدر أولي، وتتبّع الاستشهادات المختلقة والإسناد الخاطئ بشكل منفصل عن جودة الإجابة العامة.
كان تحليل الاستبيانات لدى Spring Prompt نقطة قوة نسبية في تقييمه الصغير، لكن تصميم أسئلة الاستبيان كان أضعف. ولا ينبغي لدرجة تحليل مرتفعة أن تصدّق ضمنيًا على أداة الاستبيان أو المصادر وراء مهمة بحثية جديدة.
السياق الطويل وسير عمل الوكلاء
تحقق مما إذا كان النموذج يحتفظ بكل قيد، ويستخدم كل أداة بشكل صحيح، ويتحقق من الحالة النهائية. واختبر استعادة الانقطاع عن قصد: أوقف جولة بعد خطوة معروفة، ثم انظر ما إذا كانت تستأنف من نقطة تحقق أم تكرر أحد الآثار الجانبية.
يصف إعلان Meta قدرات الذاكرة والاستعادة، لكن التقييمات المبكرة العامة المذكورة هنا لا تثبت اتساقًا طويل الأمد للذاكرة الدائمة أو استعادة الوكيل. وقِس تلك السلوكيات مباشرة قبل الاعتماد عليها.
Muse Wonder مقابل Muse Wonder Full: أبقِ الأدلة منفصلة
يُعد Muse Wonder وMuse Wonder Full متغيرين متميزين. وتصف معلومات إطلاق Meta مسارات وصول منفصلة، ولا تتحول اختبارات API المستقلة لـ Wonder القياسي إلى نتائج Full لمجرد تغيّر إعداد الاستدلال.
| سؤال المقارنة | ما تدعمه الأدلة المتاحة |
|---|---|
| هل Full هو نفسه Wonder القياسي عند أقصى استدلال؟ | لا. تعامل معهما كمتغيرين متميزين وسجّل الاسم الدقيق. |
| هل اختبر تقييم API المذكور من Spring Prompt نموذج Full؟ | لا. اختبر Wonder القياسي؛ وكان Full خارج تلك المقارنة. |
| هل يمكن لأرقام API القياسية المذكورة أن ترتّب Full؟ | لا. فهي لا تختبر Full. |
| ما الذي يجعل المقارنة عادلة؟ | مجموعة المهام نفسها، ومعيار التقييم، والنافذة الزمنية، والوصول إلى الأدوات، والإعدادات الموثقة، مع جولات متكررة لكلا المتغيرين. |
تبدأ المقارنة العادلة بمهام مقترنة وظروف متطابقة. وإذا فرضت مسارات الوصول مطالبات أو أدوات أو فوترة مختلفة، فوثّق تلك الفروق وسمِّ المقارنة استكشافية.
التكلفة والوصول وأين تختبر Muse Wonder
قارن التكلفة لكل مهمة مقبولة، لا السعر المدرج لكل رمز فقط. فالمطالبات الطويلة، وإعادات المحاولة، ورموز الاستدلال، واستدعاءات الأدوات، والمهلات، والمراجعة البشرية كلها تغيّر تكلفة النتيجة القابلة للاستخدام. أبلغ Quantslant عن أسعار رموز Wonder القياسي بـ $4 لكل مليون رمز إدخال و$20 لكل مليون رمز إخراج في 12 أكتوبر 2026، وكلفت جولته الخاصة المكوّنة من 23 مهمة $0.64. وهذا مسار وحجم عمل مبلَّغ عنهما، وليس سعر مهمة عالميًا.
يُدرج إعلان إطلاق Meta الحالي Wonder القياسي عبر Meta Model API وMuse Code، وFull عبر اشتراكات Muse Code. وأكّد الوصول والأهلية الإقليمية والفوترة الحالية في الواجهة الرسمية قبل وضع الميزانية.
ابدأ من Atlas Cloud للحصول على نظرة أوسع على منصتها للمطورين. وحتى 15 أكتوبر 2026، لم أتمكن من تأكيد وجود Muse Wonder في كتالوج النماذج، لذا لا يقدّم هذا المقال Atlas Cloud كمسار تنفيذ لهذا النموذج. وإذا كان فريقك يقارن نماذج أخرى مُدرجة هناك بالفعل، فيمكن أن تساعدك مكتبة نماذج Atlas Cloud في تحديد مرشحين لتشغيلهم مقابل مجموعة المهام نفسها.
النتيجة المفيدة لاختبار موثوقية Muse Wonder هي قرار نشر مرتبط بالأدلة: أي مهمة نجحت، وكم مرة نجحت، وكم كلفت، وما المراجعة التي لا تزال ضرورية.
الأسئلة الشائعة
هل Muse Wonder موثوق للبرمجة؟
تقدّم اختبارات الإطلاق المبكرة عينة برمجية صغيرة فقط. فقد أبلغ Quantslant عن أربع مهام برمجية، مع تفويت اختبار وحدة في مهمة واحدة، بينما لم يختبر Spring Prompt البرمجة. شغّل اختبارات المستودع على مهامك وكرّر المهام المهمة قبل اتخاذ قرار بشأن سير عمل برمجي.
كيف أختبر موثوقية Muse Wonder بنفسي؟
استخدم مجموعة ثابتة من المهام الحقيقية، وحافظ على إعدادات النموذج والمطالبة الدقيقة، وحدّد معايير النجاح مسبقًا، واحتفظ بكل مخرجات. وكرّر المهام المهمة وتحقق من النتائج بالاختبارات أو المستندات المصدر.
كم مرة ينبغي أن أكرر كل مهمة Muse Wonder؟
استخدم ثلاث جولات على الأقل للمهام عالية التأثير كفحص أولي للاتساق. وتبقى ثلاث محاولات عينة صغيرة، لذا وسّع المجموعة عندما تكون الأخطاء مكلفة أو تتفاوت المخرجات.
ما الفرق بين Muse Wonder وMuse Wonder Full؟
هما متغيران منفصلان للنموذج بمسارات إتاحة مختلفة. ولا تعامل Wonder القياسي عند أقصى استدلال على أنه Full، ولا تنقل النتائج بينهما دون اختبار متطابق.
هل يمكنني الوثوق بدرجات القياس الخاصة بـ Muse Wonder من Meta؟
استخدمها كأدلة قدرات أبلغ عنها المورّد واقرأ إعداد القياس. فهي لا تثبت أداءً متسقًا عبر مطالباتك وأدواتك وجولاتك المتكررة.
هل Muse Wonder متاح على Atlas Cloud؟
لم أتمكن من التحقق منه في كتالوج نماذج Atlas Cloud حتى 15 أكتوبر 2026. تحقق من الكتالوج المباشر قبل اختيار مزوّد تنفيذ.





